首页 文章 精选 留言 我的

精选列表

搜索[核心工具],共10010篇文章
优秀的个人博客,低调大师

Docker 核心组件之 联合文件系统

1. 联合文件系统的定义 联合文件系统(Union File System,Unionfs)是一种分层的轻量级文件系统,它可以把多个目录内容联合挂载到同一目录下,从而形成一个单一的文件系统,这种特性可以让使用者像是使用一个目录一样使用联合文件系统。 那联合文件系统对于 Docker 是一个怎样的存在呢?它可以说是 Docker 镜像和容器的基础,因为它可以使 Docker 可以把镜像做成分层的结构,从而使得镜像的每一层可以被共享。例如两个业务镜像都是基于 CentOS 7 镜像构建的,那么这两个业务镜像在物理机上只需要存储一次 CentOS 7 这个基础镜像即可,从而节省大量存储空间。 Docker 中最常用的联合文件系统有三种:AUFS、Devicemapper 和 OverlayFS。 本文主要讲解 Docker 中最常用的联合文件系统里的 AUFS,为什么呢?因为 AUFS 是 Docker 最早使用的文件系统驱动,多用于 Ubuntu 和 Debian 系统中。在 Docker 早期,OverlayFS 和 Devicemapper 相对不够成熟,AUFS 是最早也是最稳定的文件系统驱动。 2. 配置 Docker 的 AUFS 模式 AUFS 目前并未被合并到 Linux 内核主线,因此只有 Ubuntu 和 Debian 等少数操作系统支持 AUFS。你可以使用以下命令查看你的系统是否支持 AUFS: $ grep aufs /proc/filesystems nodev aufs 执行以上命令后,如果输出结果包含aufs,则代表当前操作系统支持 AUFS。AUFS 推荐在 Ubuntu 或 Debian 操作系统下使用,如果你想要在 CentOS 等操作系统下使用 AUFS,需要单独安装 AUFS 模块(生产环境不推荐在 CentOS 下使用 AUFS),安装完成后使用上述命令输出结果中有aufs即可。 当确认完操作系统支持 AUFS 后,你就可以配置 Docker 的启动参数了。 先在 /etc/docker 下新建 daemon.json 文件,并写入以下内容: { "storage-driver": "aufs" } 然后使用以下命令重启 Docker: $ sudo systemctl restart docker Docker 重启以后使用docker info命令即可查看配置是否生效: $ sudo docker info Client: Debug Mode: false Server: Containers: 0 Running: 0 Paused: 0 Stopped: 0 Images: 1 Server Version: 19.03.12 Storage Driver: aufs Root Dir: /var/lib/docker/aufs Backing Filesystem: extfs Dirs: 1 Dirperm1 Supported: true 可以看到 Storage Driver 已经变为 aufs,证明配置已经生效,配置生效后就可以使用 AUFS 为 Docker 提供联合文件系统了。 3. AUFS 工作原理 3.1 AUFS 如何存储文件 AUFS 是联合文件系统,意味着它在主机上使用多层目录存储,每一个目录在 AUFS 中都叫作分支,而在 Docker 中则称之为层(layer),但最终呈现给用户的则是一个普通单层的文件系统,我们把多层以单一层的方式呈现出来的过程叫作联合挂载。 如图 1 所示,每一个镜像层和容器层都是 /var/lib/docker 下的一个子目录,镜像层和容器层都在 aufs/diff 目录下,每一层的目录名称是镜像或容器的 ID 值,联合挂载点在 aufs/mnt 目录下,mnt 目录是真正的容器工作目录。 下面我们针对 aufs 文件夹下的各目录结构,在创建容器前后的变化做详细讲述。 当一个镜像未生成容器时,AUFS 的存储结构如下。 diff 文件夹:存储镜像内容,每一层都存储在以镜像层 ID 命名的子文件夹中。 layers 文件夹:存储镜像层关系的元数据,在 diif 文件夹下的每个镜像层在这里都会有一个文件,文件的内容为该层镜像的父级镜像的 ID。 mnt 文件夹:联合挂载点目录,未生成容器时,该目录为空。 当一个镜像已经生成容器时,AUFS 存储结构会发生如下变化。 diff 文件夹:当容器运行时,会在 diff 目录下生成容器层。 layers 文件夹:增加容器层相关的元数据。 mnt 文件夹:容器的联合挂载点,这和容器中看到的文件内容一致。 3.2 AUFS 如何工作 1. 读取文件 当我们在容器中读取文件时,可能会有以下场景。 文件在容器层中存在时:当文件存在于容器层时,直接从容器层读取。 当文件在容器层中不存在时:当容器运行时需要读取某个文件,如果容器层中不存在时,则从镜像层查找该文件,然后读取文件内容。 文件既存在于镜像层,又存在于容器层:当我们读取的文件既存在于镜像层,又存在于容器层时,将会从容器层读取该文件。 2. 修改文件或目录 AUFS 对文件的修改采用的是写时复制的工作机制,这种工作机制可以最大程度节省存储空间。 具体的文件操作机制如下。 第一次修改文件:当我们第一次在容器中修改某个文件时,AUFS 会触发写时复制操作,AUFS 首先从镜像层复制文件到容器层,然后再执行对应的修改操作。 AUFS 写时复制的操作将会复制整个文件,如果文件过大,将会大大降低文件系统的性能,因此当我们有大量文件需要被修改时,AUFS 可能会出现明显的延迟。好在,写时复制操作只在第一次修改文件时触发,对日常使用没有太大影响。 删除文件或目录:当文件或目录被删除时,AUFS 并不会真正从镜像中删除它,因为镜像层是只读的,AUFS 会创建一个特殊的文件或文件夹,这种特殊的文件或文件夹会阻止容器的访问。 4. AUFS 演示 4.1 准备演示目录和文件 首先我们在 /tmp 目录下创建 aufs 目录: $ cd /tmp /tmp$ mkdir aufs 准备挂载点目录: /tmp$ cd aufs /tmp/aufs$ mkdir mnt 接下来准备容器层内容: ## 创建镜像层目录 /tmp/aufs$ mkdir container1 ## 在镜像层目录下准备一个文件 /tmp/aufs$echo Hello, Container layer! > container1/container1.txt 最后准备镜像层内容: ## 创建两个镜像层目录 /tmp/aufs$mkdir image1 && mkdir image2 ## 分别写入数据 /tmp/aufs$echo Hello, Image layer1! > image1/image1.txt /tmp/aufs$echo Hello, Image layer2! > image2/image2.txt 准备好的目录和文件结构如下: /tmp/aufs$ tree . . |-- container1 | `-- container1.txt |-- image1 | `-- image1.txt |-- image2 | `-- image2.txt `-- mnt 4 directories, 3 files 4.2 创建 AUFS 联合文件系统 使用 mount 命令可以创建 AUFS 类型的文件系统,命令如下: /tmp/aufs$ sudo mount -t aufs -o dirs=./container1:./image2:./image1 none ./mnt mount 命令创建 AUFS 类型文件系统时,这里要注意,dirs 参数第一个冒号默认为读写权限,后面的目录均为只读权限,与 Docker 容器使用 AUFS 的模式一致。 执行完上述命令后,mnt 变成了 AUFS 的联合挂载目录,我们可以使用 mount 命令查看一下已经创建的 AUFS 文件系统: /tmp/aufs$ mount -t aufs none on /tmp/aufs/mnt type aufs (rw,relatime,si=4174b83d649ffb7c) 我们每创建一个 AUFS 文件系统,AUFS 都会为我们生成一个 ID,这个 ID 在 /sys/fs/aufs/ 会创建对应的目录,在这个 ID 的目录下可以查看文件挂载的权限。 tmp/aufs$ cat /sys/fs/aufs/si_4174b83d649ffb7c/* /tmp/aufs/container1=rw /tmp/aufs/image2=ro /tmp/aufs/image1=ro 64 65 66 可以看到 container1 目录的权限为 rw(代表可读写),image1 和 image2 的权限为 ro(代表只读)。 为了验证 mnt 目录下可以看到 container1、image1 和 image2 目录下的所有内容,我们使用 ls 命令查看一下 mnt 目录: /tmp/aufs$ls -l mnt/ total 12 -rw-rw-r-- 1 ubuntu ubuntu 24 Sep 9 16:55 container1.txt -rw-rw-r-- 1 ubuntu ubuntu 21 Sep 9 16:59 image1.txt -rw-rw-r-- 1 ubuntu ubuntu 21 Sep 9 16:59 image2.txt 可以看到 mnt 目录下已经出现了我们准备的所有镜像层和容器层的文件。下面让我们来验证一下 AUFS 的写时复制。 4.3 验证 AUFS 的写时复制 AUFS 的写时复制是指在容器中,只有需要修改某个文件时,才会把文件从镜像层复制到容器层,下面我们通过修改联合挂载目录 mnt 下的内容来验证下这个过程。 我们使用以下命令修改 mnt 目录下的 image1.txt 文件: /tmp/aufs$ echo Hello, Image layer1 changed! > mnt/image1.txt 然后我们查看下 image1/image1.txt 文件内容: /tmp/aufs$ cat image1/image1.txt Hello, Image layer1! 发现“镜像层”的 image1.txt 文件并未被修改。 然后我们查看一下"容器层"对应的 image1.txt 文件内容: /tmp/aufs$ ls -l container1/ total 8 -rw-rw-r-- 1 ubuntu ubuntu 24 Sep 9 16:55 container1.txt -rw-rw-r-- 1 ubuntu ubuntu 29 Sep 9 17:21 image1.txt ## 查看文件内容 /tmp/aufs$ cat container1/image1.txt Hello, Image layer1 changed! 发现 AUFS 在“容器层”自动创建了 image1.txt 文件,并且内容为我们刚才写入的内容。 至此,我们完成了 AUFS 写时复制的验证。我们在第一次修改镜像内某个文件时,AUFS 会复制这个文件到容器层,然后在容器层对该文件进行修改操作,这就是 AUFS 最典型的特性写时复制。

优秀的个人博客,低调大师

Netty核心概念之ChannelHandler&Pipeline&ChannelHandlerContext

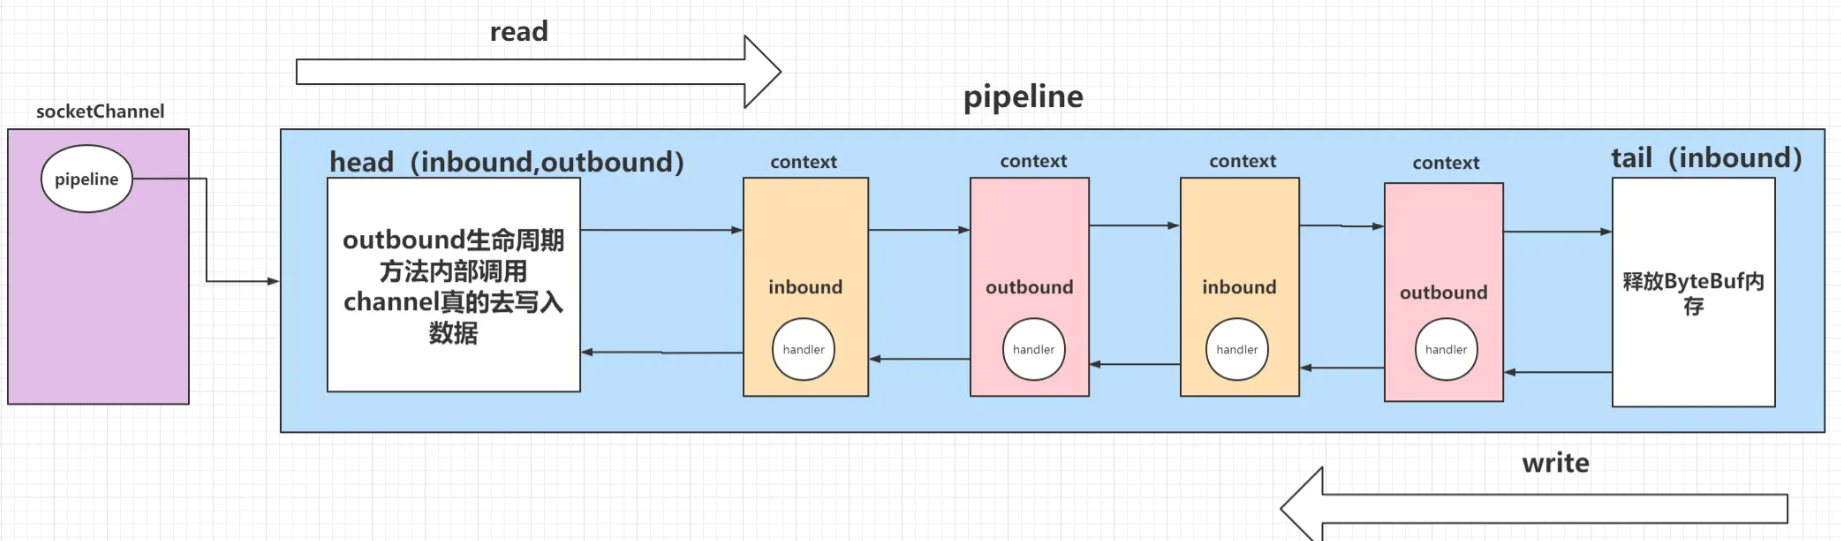
概述 之前学习的Reactor模型只是懂得了服务器端如何把一个连接放到workergroup中处理,那么真正处理某一个具体的请求的过程是什么样的呢 基本概念 我们知道数据的读取都是通过channel来完成的,Netty在channel的IO事件中定义了许多的生命周期函数,Netty将这些生命周期函数封装在Handler中,通过责任链的模式封装在了一个 pipeline中。当 channel中触发了对应的IO事件,就会调用pipeline中的头或者尾的一个handler,至于是否传递到下一级,由对应的handler判断. Netty把IO事件分成两类,一个是Netty从网络中读取数据,成为InBound。一个是Netty把数据写到网络中,成为OutBound。Handler也被分成ChannelInBoundHandler和ChannelOutBoundHandler,他们各自有着不同的生命周期函数 pipeline是要给双向链表,有着头尾两个指针,inbound事件是从head节点往后传播,outbound事件是从tail节点往前传播 为了能让handler更加的灵活,Netty给handler外面包了一层的 HandlerContext. context允许handler在生命周期方法中直接改变数据的流向,比如读完数据就可以让 context在把数据写出去,那么数据的流向就从 inbound变成了outbound InboundHandler public interface ChannelInboundHandler extends ChannelHandler { # channel 注册到eventLoop void channelRegistered(ChannelHandlerContext ctx) throws Exception; # channel从eventloop中取消注册 void channelUnregistered(ChannelHandlerContext ctx) throws Exception; # channel已经建立了连接 void channelActive(ChannelHandlerContext ctx) throws Exception; # channel结束了连接 void channelInactive(ChannelHandlerContext ctx) throws Exception; # channel从网络中读到了数据 void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception; # channel读取完数据 void channelReadComplete(ChannelHandlerContext ctx) throws Exception; # 读取数据中发生了异常调用该方法 void exceptionCaught(ChannelHandlerContext ctx, Throwable cause) throws Exception; } 复制代码 我们来看看-生命周期的调用源码。 channelRegistered: 在AbstractChannel方法中register方法中 private void register0(ChannelPromise promise) { try { # 这里就是让 channel注册到eventloop并且注册到selector中的方法 doRegister(); # 注册结束之后就会调用 pipeline的fireChannelRegistered方法 pipeline.fireChannelRegistered(); if (isActive()) { if (firstRegistration) { # 如果是激活状态还会调用 fireChannelActive 方法 pipeline.fireChannelActive(); } else if (config().isAutoRead()) { } } } catch (Throwable t) { } } 复制代码 那么我们来看看pipeline的源码 @Override public final ChannelPipeline fireChannelRegistered() { # 传了一个pipeline 的头结点进去,说明是从头开始传播的 AbstractChannelHandlerContext.invokeChannelRegistered(head); return this; } 复制代码 pipeline调用了 context的静态方法,下面的都是context内部的调用关系 # AbstractChannelHandlerContext 的 invokeChannelRegistered 方法 static void invokeChannelRegistered(final AbstractChannelHandlerContext next) { EventExecutor executor = next.executor(); if (executor.inEventLoop()) { # 又调用头结点的 invokeChannelRegistered 方法 next.invokeChannelRegistered(); } else { executor.execute(new Runnable() { @Override public void run() { next.invokeChannelRegistered(); } }); } } private void invokeChannelRegistered() { if (invokeHandler()) { try { # 拿到head节点的 handler调用handler的钩子函数 ((ChannelInboundHandler) handler()).channelRegistered(this); } catch (Throwable t) { notifyHandlerException(t); } } else { fireChannelRegistered(); } } 复制代码 最后调用到了就是我们自定义的handler的钩子函数,特别注意如果我们在这个函数里面没有调用super.channelRegistered(ctx);那么转播就会终止 @Override public void channelRegistered(ChannelHandlerContext ctx) throws Exception { System.out.println("channelRegistered----Inbound1"); super.channelRegistered(ctx); } 复制代码 如果我们继续转播的话, context就会找到下一个inbound的context然后再执行方法。 @Override public ChannelHandlerContext fireChannelRegistered() { invokeChannelRegistered(findContextInbound()); return this; } private AbstractChannelHandlerContext findContextInbound() { AbstractChannelHandlerContext ctx = this; do { ctx = ctx.next; } while (!ctx.inbound); return ctx; } 复制代码 outboundHandler public interface ChannelOutboundHandler extends ChannelHandler { # 当绑定端口成功后触发 void bind(ChannelHandlerContext ctx, SocketAddress localAddress, ChannelPromise promise) throws Exception; # 客户端连接到服务器触发 void connect( ChannelHandlerContext ctx, SocketAddress remoteAddress, SocketAddress localAddress, ChannelPromise promise) throws Exception; # 断开连接触发 void disconnect(ChannelHandlerContext ctx, ChannelPromise promise) throws Exception; void close(ChannelHandlerContext ctx, ChannelPromise promise) throws Exception; void deregister(ChannelHandlerContext ctx, ChannelPromise promise) throws Exception; void read(ChannelHandlerContext ctx) throws Exception; void write(ChannelHandlerContext ctx, Object msg, ChannelPromise promise) throws Exception; void flush(ChannelHandlerContext ctx) throws Exception; } 复制代码 outbound和inbound就是触发的时机不同,基本上用不太到,以后有用到再来补。 ChannelInitializer 在 BootstrapServer中,我们往往会创建一个 ChannelInitializer的 ChildHandler。然后在 initChannel方法中对新来的 channel的pipeline中添加handler。,我们来看看这个流程 在serverBootStrap中存放了ChannelInitializer public static void main(String[] args) throws Exception { new ServerBootstrap() .group(new NioEventLoopGroup(), new NioEventLoopGroup()) .channel(NioServerSocketChannel.class) # 保存childHandler .childHandler(new ChannelInitializer<SocketChannel>() { @Override protected void initChannel(SocketChannel ch) throws Exception { ch.pipeline().addLast(new Inbound1()); ch.pipeline().addLast(new OutBound1()); ch.pipeline().addLast(new Inbound2()); ch.pipeline().addLast(new OutBound2()); ch.pipeline().addLast(new Inbound3()); ch.pipeline().addLast(new OutBound3()); } }).bind(9090).sync().channel().closeFuture().sync(); } 复制代码 当客户端连接服务端的时候会触发 ServerBootStrap的 channelRead方法 public void channelRead(ChannelHandlerContext ctx, Object msg) { # 这就是客户端channel final Channel child = (Channel) msg; # 给客户端Channel添加了刚才写的ChannelInitializer child.pipeline().addLast(childHandler); } 复制代码 然后就是reactor的一系列东西,这个channel被bossgroup添加了一个handler后丢到了workergroup,然后准备注册到workergroup的channel的时候 private void register0(ChannelPromise promise) { try { # 这里就是让 channel注册到eventloop并且注册到selector中的方法 doRegister(); # 调用pipeline的添加handler的方法 pipeline.invokeHandlerAddedIfNeeded(); # 注册结束之后就会调用 pipeline的fireChannelRegistered方法 pipeline.fireChannelRegistered(); if (isActive()) { if (firstRegistration) { # 如果是激活状态还会调用 fireChannelActive 方法 pipeline.fireChannelActive(); } else if (config().isAutoRead()) { } } } catch (Throwable t) { } } 复制代码 然后最后掉到pipeline的 callHandlerAdded0方法,里面拿到handler执行handlerAdded方法 5. pipeline中的方法 总结 这几个流程就大体的梳理完了,总结一下 在创建ServerBootStrap的时候传了一个initHandler 在server端收到客户端连接的时候就把这个initHandler添加到这个客户端channel的pipeline中 然后客户端准备注册到eventLoop的时候会去调用一下pipeline中的inithandler,然后这时候客户端的pipeline就添加到了用户自定义的handler。 然后把这个初始化的handler给remove掉 最后 如果你觉得此文对你有一丁点帮助,点个赞。或者可以加入我的开发交流群:1025263163相互学习,我们会有专业的技术答疑解惑 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star:http://github.crmeb.net/u/defu不胜感激! PHP学习手册:https://doc.crmeb.com 技术交流论坛:https://q.crmeb.com

优秀的个人博客,低调大师

云计算产业链最核心环节

随5G商用进程的推进,万物互联时代开启,5G与各行各业融合发展,赋能市场经济增长。产业信息化、智能化转型带来数据量几何式爆炸增长。 据中国移动预测,到2025年全球物联网连接数将达到300亿个,全球数据量将成倍增长。 而云计算作为应对海量数据的最佳处理方案,市场需求量迅速上升,IDC作为云计算产业链中关键环节,景气度随之提升。 IDC产业链上游包括IDC机房建设所必须的基础设施和条件,包括土地房屋、电力电源设备、网络、IT设备、制冷设备、监控设备等。前期需投入土建、配套工程等支出,后期有电力、运维和带宽租赁等支出。 上游支出中,IT设备一般占比最大,但因价格透明,云计算服务厂商出于对服务器、存储的成本控制,大厂商走定制化的道路,价格竞争激烈。 上游中的一线城市土地及电力资源的稀缺通常是制约一线城市IDC发展的重要因素,因此,IDC行业逐渐向一线城市周边发展。 中游是IDC服务和解决方案提供商,是数据中心产业建设的主力军,对上游的资源进行整合,提供稳定高效的IDC服务和整体结局方案。 下游主要为需要使用IDC服务的企业,主要包括互联网企业、金融企业、制造及软件企业、政府机关央企、传统行业等客户。 目前三大运营商在我国IDC市场占据了63%的市场份额。其他企业包括金融、能源等众多行业、企事业单位及政府机关。 随着相关产业的不断升级转换,在技术发展、环境节能、适用性等方面提出了新的要求。未来市场应用的深度及广度将不断扩展。 在企业竞争方面,中国的三家运营商目前拥有充裕的IDC资源,目前合计市场份额在50%左右;第三方IDC市场的竞争较为充分,根据机柜数测算,排名前三的公司为万国数据、秦淮数据、世纪互联。 从IDC市场竞争格局来看,2019年我国IDC企业竞争格局中,中国的三家运营商目前拥有充裕的IDC资源,中国电信、中国联通、中国移动的市场份额占比位列前三,分别为30.6%、19.1%和12.6%;电信运营商在IDC上的业务相对单一,以托管、机房资源和带宽资源租赁服务为主。为保持在IDC高速发展市场中的优势,正不断改变传统IDC业务结构,进行新一代数据中心的建设布局。 第三方IDC市场的竞争较为充分,根据机柜数测算,排名前三的公司为万国数据、秦淮数据、世纪互联。 目前在国内市场,云计算厂商、互联网巨头为每年IDC增量市场的需求主力,IDC行业未来将继续受益数据量增长及云计算需求提升,并伴随5G、人工智能等新基建的加速部署,需求持续旺盛,整体增速将保持在25%以上,由此带来的资本开支料将对IDC形成正向支撑。 根据科智咨询的数据,预计中国IDC市场规模在2022年将达到3200.5亿元。

优秀的个人博客,低调大师

Spring 框架文档之核心技术—— AOP

AOP AOP 提供一种新的思考程序结构的方法来补充 OOP。OOP 中模块的关键是类,而 AOP 中模块的关键是切面。切面支持跨多个类型和对象的模块化(如事务管理)。 AOP 概念 切面 —— 在切入点进行通知操作的过程(包含通知和切人点的类 @Aspect) 连接点 —— 所有可能被织入通知的候选点(具体业务逻辑方法) 切入点 —— 满足匹配规则的连接点(@Pointcut) 目标对象 —— 被一到多个切面通知的对象 AOP 代理 —— AOP 框架基于切面规则创建的对象 织入 —— 创建通知对象关联切面和其他应用 通知 —— 对切入点进行的操作 前置通知 —— 在连接点之前执行的通知(@Before) 后置通知 —— 在连接点正常完成后执行的通知(@AfterReturning) 环绕通知 —— 在方法调用前后执行的通知(@Around) 异常通知 —— 方法抛出异常时执行的通知(@AfterThrowing) 最终通知 —— 从连接点退出后执行的通知(@After) Spring AOP 目标 纯 Java 实现。不需要特殊的编译过程。不需要控制类加载器层次结构,适合在 Servlet 容器或应用程序服务器中使用。 只支持方法执行连接点。如果需要字段拦截和更新连接点,考虑 AspectJ 之类的语言。 Spring AOP 不是提供最完整的 AOP 实现。其目标是提供 AOP 实现和 Spring IoC 之间的紧密集成。 AOP 代理 Spring AOP 默认使用标准 JDK 动态代理实现 AOP 代理。 Spring AOP 还可以使用CGLIB代理。 @Aspect 风格 激活 @AspectJ 支持 —— 通过自动代理,Spring 自动为被通知的 Bean 生成代理来拦截方法调用,确保按需执行通知 @Configuration @EnableAspectJAutoProxy public class AppConfig { } 定义一个切面 —— 在应用程序上下文中使用 @AspectJ 类定义 Bean 会被 Spring 自动检测到,并用于配置 Spring AOP @Aspect public class NotVeryUsefulAspect { } 定义一个切入点 —— 确定感兴趣的连接点,从而使我们能够控制何时执行通知。 @Pointcut("execution(* transfer(..))")// 切入点表达式 private void anyOldTransfer() {} execution —— 用于匹配方法执行连接点 within —— 将匹配限制为特定类型中的连接点 this —— 将匹配限制为 Bean 引用(AOP 代理)是给定类型实例的连接点 target —— 将匹配限制为目标对象是给定类型实例的连接点 args —— 将匹配限制为参数是给定类型实例的连接点 @target —— 将匹配限制为执行对象的类具有给定类型注解的连接点 @args —— 将匹配限制为传递的实际参数的运行时类型具有给定类型注解的连接点 @within —— 将匹配限制为与具有给定注解类型的连接点 @annotation —— 将匹配限制为连接点的主题具有给定类型注释的连接点 @Aspect public class SystemArchitecture { @Pointcut("within(com.xyz.someapp.web..*)") public void inWebLayer() {} @Pointcut("within(com.xyz.someapp.service..*)") public void inServiceLayer() {} @Pointcut("within(com.xyz.someapp.dao..*)") public void inDataAccessLayer() {} @Pointcut("execution(* com.xyz.someapp..service.*.*(..))") public void businessService() {} @Pointcut("execution(* com.xyz.someapp.dao.*.*(..))") public void dataAccessOperation() {} } execution(修饰符? 返回类型 包名?方法名称(参数类型) 异常类型?) //拦截任何公共方法的执行 execution(public * *(..)) //拦截任何以 set 开头的方法的执行 execution(* set*(..)) //拦截任何定义在 AccountService 接口中的方法的执行 execution(* com.xyz.service.AccountService.*(..)) //拦截任何定义在 service 包中的方法的执行 execution(* com.xyz.service.*.*(..)) //拦截任何定义在 service 包或者其一个子包中的方法的执行 execution(* com.xyz.service..*.*(..)) //拦截 service 包中的连接点 within(com.xyz.service.*) //拦截 service 包或者其一个子包中的连接点 within(com.xyz.service..*) //拦截实现 AccountService 接口的代理的连接点 this(com.xyz.service.AccountService) //拦截实现 AccountService 接口的目标对象的连接点 target(com.xyz.service.AccountService) //拦截参数只有一个 Serializable 的连接点 args(java.io.Serializable) //拦截目标对象有 @Transactional 注解的连接点 @target(org.springframework.transaction.annotation.Transactional) //拦截目标对象的声明类型有 @Transactional 注解的连接点 @within(org.springframework.transaction.annotation.Transactional) //拦截执行方法有 @Transactional 注解的连接点 @annotation(org.springframework.transaction.annotation.Transactional) //拦截参数只有一个 @Classified 注解的连接点 @args(com.xyz.security.Classified) 定义通知 —— 与切入点表达式相关联,并在匹配的方法执行之前、之后或前后运行 @Before("com.xyz.myapp.SystemArchitecture.dataAccessOperation()") public void doAccessCheck() { // ... } @AfterReturning("com.xyz.myapp.SystemArchitecture.dataAccessOperation()") public void doAccessCheck() { // ... } @AfterReturning( pointcut="com.xyz.myapp.SystemArchitecture.dataAccessOperation()", returning="retVal") public void doAccessCheck(Object retVal) { // ... } @AfterThrowing("com.xyz.myapp.SystemArchitecture.dataAccessOperation()") public void doRecoveryActions() { // ... } @AfterThrowing( pointcut="com.xyz.myapp.SystemArchitecture.dataAccessOperation()", throwing="ex") public void doRecoveryActions(DataAccessException ex) { // ... } @After("com.xyz.myapp.SystemArchitecture.dataAccessOperation()") public void doReleaseLock() { // ... } @Around("com.xyz.myapp.SystemArchitecture.businessService()") public Object doBasicProfiling(ProceedingJoinPoint pjp) throws Throwable { // start stopwatch Object retVal = pjp.proceed(); // stop stopwatch return retVal; } JoinPoint 参数 —— ProceedingJoinPoint 是 JoinPoint 的子类 getArgs(): 返回方法参数 getThis(): 返回代理对象 getTarget(): 返回目标对象 getSignature(): 返回被通知方法的描述 toString(): 打印被通知方法的描述 传递参数给通知 @Before("com.xyz.myapp.SystemArchitecture.dataAccessOperation() && args(account,..)") public void validateAccount(Account account) { // ... } @Pointcut("com.xyz.myapp.SystemArchitecture.dataAccessOperation() && args(account,..)") private void accountDataAccessOperation(Account account) {} @Before("accountDataAccessOperation(account)") public void validateAccount(Account account) { // ... } @Retention(RetentionPolicy.RUNTIME) @Target(ElementType.METHOD) public @interface Auditable { AuditCode value(); } @Before("com.xyz.lib.Pointcuts.anyPublicMethod() && @annotation(auditable)") public void audit(Auditable auditable) { AuditCode code = auditable.value(); // ... } public interface Sample<T> { void sampleGenericMethod(T param); void sampleGenericCollectionMethod(Collection<T> param); } @Before("execution(* ..Sample+.sampleGenericMethod(*)) && args(param)") public void beforeSampleMethod(MyType param) { // Advice implementation } @Before("execution(* ..Sample+.sampleGenericCollectionMethod(*)) && args(param)") public void beforeSampleMethod(Collection<MyType> param) { // Advice implementation } @Before(value="com.xyz.lib.Pointcuts.anyPublicMethod() && target(bean) && @annotation(auditable)", argNames="bean,auditable") public void audit(Object bean, Auditable auditable) { AuditCode code = auditable.value(); // ... use code and bean } //第一参数是 JoinPoint, ProceedingJoinPoint, 或者 JoinPoint.StaticPart 类型,argNames 中可以省略 @Before(value="com.xyz.lib.Pointcuts.anyPublicMethod() && target(bean) && @annotation(auditable)", argNames="bean,auditable") public void audit(JoinPoint jp, Object bean, Auditable auditable) { AuditCode code = auditable.value(); // ... use code, bean, and jp } @Before("com.xyz.lib.Pointcuts.anyPublicMethod()") public void audit(JoinPoint jp) { // ... use jp } @Around("execution(List<Account> find*(..)) && " + "com.xyz.myapp.SystemArchitecture.inDataAccessLayer() && " + "args(accountHolderNamePattern)") public Object preProcessQueryPattern(ProceedingJoinPoint pjp, String accountHolderNamePattern) throws Throwable { String newPattern = preProcess(accountHolderNamePattern); return pjp.proceed(new Object[] {newPattern}); } 代理机制 Spring AOP 使用 JDK 动态代理或 CGLIB 为给定的目标对象创建代理。 如目标对象实现至少一个接口,则使用 JDK 动态代理。如目标对象没有实现任何接口,则创建一个 CGLIB 代理。 public class SimplePojo implements Pojo { public void foo() { // this next method invocation is a direct call on the 'this' reference this.bar(); } public void bar() { // some logic... } } public class Main { public static void main(String[] args) { ProxyFactory factory = new ProxyFactory(new SimplePojo()); factory.addInterface(Pojo.class); factory.addAdvice(new RetryAdvice()); Pojo pojo = (Pojo) factory.getProxy(); // this is a method call on the proxy! pojo.foo(); } } API Pointcut public interface Pointcut { ClassFilter getClassFilter(); MethodMatcher getMethodMatcher(); } public interface ClassFilter { boolean matches(Class clazz); } public interface MethodMatcher { boolean matches(Method m, Class targetClass); boolean isRuntime(); boolean matches(Method m, Class targetClass, Object[] args); }


优秀的个人博客,低调大师

Spring 框架文档之核心技术—— Resource

Resource Resource 接口定义 public interface Resource extends InputStreamSource { /** * 返回此资源的 URL 句柄 */ URL getURL() throws IOException; /** * 返回此资源的 URI 句柄 */ URI getURI() throws IOException; /** * 返回此资源的 File 句柄 */ File getFile() throws IOException; /** * 创建此资源的关联资源 */ Resource createRelative(String relativePath) throws IOException; } public interface InputStreamSource { /** * 返回底层资源内容的 InputStream */ InputStream getInputStream() throws IOException; } 内置 Resource 实现者 UrlResource —— 封装 java.net.URL,用于访问通过URL访问的任何对象,例如 file:、http:、ftp: 等 ClassPathResource —— 使用线程上下文类加载器、给定的类加载器或给定的类从类路径加载资源。如 classpath: FileSystemResource —— 从文件系统加载资源 ServletContextResource —— 从 Web 应用根目录的相对路径中加载资源,支持 URL、流、File(资源位于文件系统)访问 InputStreamResource —— 在没有特定的资源实现时使用 ByteArrayResource —— 从任何给定的字节数组加载资源 ResourceLoader 返回资源类型确认 //对于 ClassPathXmlApplicationContext, 返回 ClassPathResource //对于 FileSystemXmlApplicationContext, 返回 FileSystemResource //对于 WebApplicationContext, 返回 ServletContextResource Resource template = ctx.getResource("some/resource/path/myTemplate.txt"); //指定 classpath:,返回 ClassPathResource Resource template = ctx.getResource("classpath:some/resource/path/myTemplate.txt"); //指定 file:、http:,返回 UrlResource Resource template = ctx.getResource("file:///some/resource/path/myTemplate.txt"); Resource template = ctx.getResource("https://myhost.com/resource/path/myTemplate.txt"); 与 ApplicationContext 协作 ApplicationContext ctx = new ClassPathXmlApplicationContext("conf/appContext.xml"); //注意:FileSystemXmlApplicationContext 强制将 FileSystemResource 路径当作相对路径 ApplicationContext ctx = new FileSystemXmlApplicationContext("conf/appContext.xml"); //如要使用绝对路径,推荐使用 file: 形式的 UrlResource ApplicationContext ctx = new FileSystemXmlApplicationContext("file:///conf/context.xml");

优秀的个人博客,低调大师

Flink实战(三) - 编程范式及核心概念

1 基本的 API 概念 Flink程序是实现分布式集合转换的常规程序(例如,过滤,映射,更新状态,加入,分组,定义窗口,聚合)。最初从源创建集合(例如,通过从文件,kafka主题或从本地的内存集合中读取)。结果通过接收器返回,接收器可以例如将数据写入(分布式)文件或标准输出(例如,命令行终端)。 Flink程序可以在各种环境中运行,独立运行或嵌入其他程序中。执行可以在本地JVM中执行,也可以在许多计算机的集群上执行。 根据数据源的类型,即有界或无界源,您可以编写批处理程序或流程序,其中 DataSet API用于批处理 DataStream API用于流式处理。 注意:在显示如何使用API的实际示例时,我们将使用StreamingExecutionEnvironment和DataStream API。 DataSet API中的概念完全相

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册