首页 文章 精选 留言 我的

精选列表

搜索[api],共10000篇文章
优秀的个人博客,低调大师

Hadoop MapReduce编程 API入门系列之小文件合并(二十九)

Hadoop 自身提供了几种机制来解决相关的问题,包括HAR,SequeueFile和CombineFileInputFormat。 Hadoop 自身提供的几种小文件合并机制 Hadoop HAR 将众多小文件打包成一个大文件进行存储,并且打包后原来的文件仍然可以通过Map-reduce进行操作,打包后的文件由索引和存储两大部分组成 缺点:一旦创建就不能修改,也不支持追加操作,还不支持文档压缩,当有新文件进来以后,需要重新打包。 SequeuesFile Sequence file由一系列的二进制key/value组成,如果key为小文件名,value为文件内容,则可以将大批小文件合并成一个大文件。 优缺点:对小文件的存取都比较自由,也不限制用户和文件的多少,但是该方法不能使用append方法,所以适合一次性写入大量小文件的场景。 CombineFileInputFormat CombineFileInputFormat是一种新的inputformat,用于将多个文件合并成一个单独的split作为输入,而不是通常使用一个文件作为输入。另外,它会考虑数据的存储位置。 目前很多公司采用的方法就是在数据进入 Hadoop 的 HDFS 系统之前进行合并(也是本博文这方法),一般效果较上述三种方法明显。 代码版本1 MergeSmallFilesToHDFS .java package zhouls.bigdata.myMapReduce.MergeSmallFiles; import java.io.IOException; import java.net.URI; import java.net.URISyntaxException; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.FSDataInputStream; import org.apache.hadoop.fs.FSDataOutputStream; import org.apache.hadoop.fs.FileStatus; import org.apache.hadoop.fs.FileSystem; import org.apache.hadoop.fs.FileUtil; import org.apache.hadoop.fs.Path; import org.apache.hadoop.fs.PathFilter; import org.apache.hadoop.io.IOUtils; /** * function 合并小文件至 HDFS * * */ public class MergeSmallFilesToHDFS { private static FileSystem fs = null; private static FileSystem local = null; /** * @function main * @param args * @throws IOException * @throws URISyntaxException */ public static void main(String[] args) throws IOException, URISyntaxException { list(); } /** * * @throws IOException * @throws URISyntaxException */ public static void list() throws IOException, URISyntaxException { // 读取hadoop文件系统的配置 Configuration conf = new Configuration(); //文件系统访问接口 URI uri = new URI("hdfs://HadoopMaster:9000"); //创建FileSystem对象aa fs = FileSystem.get(uri, conf); // 获得本地文件系统 local = FileSystem.getLocal(conf); //过滤目录下的 svn 文件 FileStatus[] dirstatus = local.globStatus(new Path("./data/mergeSmallFiles/*"),new RegexExcludePathFilter("^.*svn$")); //获取73目录下的所有文件路径 Path[] dirs = FileUtil.stat2Paths(dirstatus); FSDataOutputStream out = null; FSDataInputStream in = null; for (Path dir : dirs) { String fileName = dir.getName().replace("-", "");//文件名称 //只接受日期目录下的.txt文件a FileStatus[] localStatus = local.globStatus(new Path(dir+"/*"),new RegexAcceptPathFilter("^.*txt$")); // 获得日期目录下的所有文件 Path[] listedPaths = FileUtil.stat2Paths(localStatus); //输出路径 Path block = new Path("hdfs://HadoopMaster:9000/tv/"+ fileName + ".txt"); // 打开输出流 out = fs.create(block); for (Path p : listedPaths) { in = local.open(p);// 打开输入流 IOUtils.copyBytes(in, out, 4096, false); // 复制数据 // 关闭输入流 in.close(); } if (out != null) { // 关闭输出流a out.close(); } } } /** * * @function 过滤 regex 格式的文件 * */ public static class RegexExcludePathFilter implements PathFilter { private final String regex; public RegexExcludePathFilter(String regex) { this.regex = regex; } @Override public boolean accept(Path path) { // TODO Auto-generated method stub boolean flag = path.toString().matches(regex); return !flag; } } /** * * @function 接受 regex 格式的文件 * */ public static class RegexAcceptPathFilter implements PathFilter { private final String regex; public RegexAcceptPathFilter(String regex) { this.regex = regex; } @Override public boolean accept(Path path) { // TODO Auto-generated method stub boolean flag = path.toString().matches(regex); return flag; } } } 代码版本2 MergeSmallFilesToHDFS .java package zhouls.bigdata.myMapReduce.MergeSmallFiles; import java.io.IOException; import java.net.URI; import java.net.URISyntaxException; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.FSDataInputStream; import org.apache.hadoop.fs.FSDataOutputStream; import org.apache.hadoop.fs.FileStatus; import org.apache.hadoop.fs.FileSystem; import org.apache.hadoop.fs.FileUtil; import org.apache.hadoop.fs.Path; import org.apache.hadoop.fs.PathFilter; import org.apache.hadoop.io.IOUtils; /** * function 合并小文件至 HDFS , 文件与块大小(比如128M)来比,小的话,称为小文件。是一个相对概念!相对于数据块而言的! * @author 小讲 * */ public class MergeSmallFilesToHDFS { private static FileSystem fs = null; private static FileSystem local = null; /** * @function main * @param args * @throws IOException * @throws URISyntaxException */ public static void main(String[] args) throws IOException, URISyntaxException { list(); } /** * * @throws IOException * @throws URISyntaxException */ public static void list() throws IOException, URISyntaxException { // 读取hadoop文件系统的配置 Configuration conf = new Configuration(); //文件系统访问接口 URI uri = new URI("hdfs://master:9000"); // URL、URI与Path三者的区别 // Hadoop文件系统中通过Hadoop Path对象来代表一个文件 // URL(相当于绝对路径) -> (文件) -> URI(相当于相对路径,即代表URL前面的那一部分) // URI:如hdfs://master:9000 // 如,URL.openStream //获得FileSystem实例,即HDFS fs = FileSystem.get(uri, conf); //获得FileSystem实例,即Local local = FileSystem.getLocal(conf); // 为什么要获取到Local呢,因为,我们要把本地D盘下data/73目录下的文件要合并后,上传到HDFS里,所以,我们需先获取到Local,再来做合并工作啦! //过滤目录下的 svn 文件,globStatus从第一个参数通配符合到文件,剔除满足第二个参数到结果,因为PathFilter中accept是return! FileStatus[] dirstatus = local.globStatus(new Path("D://data/73/*"),new RegexExcludePathFilter("^.*svn$"));//一般这是隐藏文件,所以得排除 // ^表示匹配我们字符串开始的位置 *代表0到多个字符 $代表字符串结束的位置 // RegexExcludePathFilter来只排除我们不需要的,即svn格式 // RegexExcludePathFilter这个方法我们自己写 // 但是我们,最终是要处理文件里的东西,最终是要转成Path类型,因为Path对象f,它对应着一个文件。 //获取73目录下的所有文件路径,注意FIleUtil中stat2Paths()的使用,它将一个FileStatus对象数组转换为Path对象数组。 Path[] dirs = FileUtil.stat2Paths(dirstatus);//dirstatus是FileStatus数组类型 FSDataOutputStream out = null;//输出流 FSDataInputStream in = null;//输入流 // 很多人搞不清输入流和输出流,!!!! // 其实啊,输入流、输出流都是针对内存的 // 往内存里写,是输入流。 // 内存往文件里写,是输出Luis。 // // 比如一个文件A复制到另一文件B,那么,先写到内存里,再写到文件B。 // => 则文件A写到内存里,叫输入流。 // => 则内存里写到文件B,叫输出流 for (Path dir : dirs) {//for星型循环,即将dirs是Path对象数组,一一传给Path dir String fileName = dir.getName().replace("-", "");//文件名称 // 即获取到如2012-09-17,然后经过replace("-", ""),得到20120917 //只接受日期目录下的.txt文件,^匹配输入字符串的开始位置,$匹配输入字符串的结束位置,*匹配0个或多个字符。 FileStatus[] localStatus = local.globStatus(new Path(dir+"/*"),new RegexAcceptPathFilter("^.*txt$")); // FileStatus[] localStatus = local.listStatus(new Path(dir+"/*"),new RegexAcceptPathFilter("^.*txt$"));//试试,看有什么区别?出现错误的!为什么? //RegexAcceptPathFilter这个方法,我们自己写 // RegexAcceptPathFilter来只接收我们需要,即txt格式 // 这里,我们还可以只接收别的格式,自己去改,一定要锻炼学会改别人的代码 // 获得如2012-09-17日期目录下的所有文件 Path[] listedPaths = FileUtil.stat2Paths(localStatus); // 同样,但是我们,最终是要处理文件里的东西,最终是要转成Path类型,因为Path对象f,它对应着一个文件。 //输出路径 Path block = new Path("hdfs://master:9000/outData/MergeSmallFilesToHDFS/"+ fileName + ".txt"); // 打开输出流 out = fs.create(block);//因为,合并小文件之后,比如这是,合并2012-09-17日期目录下的所有小文件,之后,要上传到HDFS里。 // 类似于,文件A写到内存里,再内存里写到文件B。而这行代码out = fs.create(block);是相当于是,内存里写到文件B。所以是输出流,即是从内存里输出的,所以叫输出流。 // 这里,文件A是Local 文件B是HDFS // 文件与块大小(比如128M)来比,小的话,称为小文件。是一个相对概念!相对于数据块而言的! // 很多人搞不清输入流和输出流,!!!! // 其实啊,输入流、输出流都是针对内存的 // 往内存里写,是输入流。 // 内存往文件里写,是输出Luis。 // // 比如一个文件A复制到另一文件B,那么,先写到内存里,再写到文件B。 // => 则文件A写到内存里,叫输入流。 // => 则内存里写到文件B,叫输出流 for (Path p : listedPaths) {//for星型循环,即将listedPaths的值一一传给Path p in = local.open(p);// 打开输入流in // 类似于,文件A写到内存里,再内存里写到文件B。而这行代码in = local.open(p);是相当于是,文件A写到内存里。所以是输如流,即是写到内存里的,所以叫输入流。 // 这里,文件A是Local 文件B是HDFS IOUtils.copyBytes(in, out, 4096, false); // 复制数据,IOUtils.copyBytes可以方便地将数据写入到文件,不需要自己去控制缓冲区,也不用自己去循环读取输入源。false表示不自动关闭数据流,那么就手动关闭。 // IOUtils.copyBytes这个方法很重要 //是否自动关闭输入流和输出流,若是false,就要单独去关闭。则不在这个方法体里关闭输入和输出流了。 // 若是true,则在这个方法里关闭输入和输出流。不需单独去关闭了 // 明白,IOUtils类的copyBytes将hdfs数据流拷贝到标准输出流System.out中, // copyBytes前两个参数好理解,一个输入,一个输出,第三个是缓存大小,第四个指定拷贝完毕后是否关闭流。 // 要设置为false,标准输出流不关闭,我们要手动关闭输入流。即,设置为false表示关闭输入流 // 主要是把最后的这个参数定义好, 就可以了。 定义为true还是false,则决定着是否在这个方法体里关闭 // 若定义为true,则在这个方法体里直接关闭输入流、输出流。不需单独去关闭了 // 若定义为false,则不在这个方法体里直接关闭输入流、输出流。需单独去关闭了 // 关闭输入流 in.close();//若定义为false,则不在这个方法体里直接关闭输入流、输出流。需单独去关闭了。这就是单独在关闭输入流!!!懂了吗 } if (out != null) {//这里为什么不为空,空指针,则说明里面还有资源。 // 关闭输出流 out.close();//若定义为false,则不在这个方法体里直接关闭输入流、输出流。需单独去关闭了。这就是单独在关闭输出流!!!懂了吗 } } } /** * * @function 过滤 regex 格式的文件 * */ public static class RegexExcludePathFilter implements PathFilter { private final String regex;//变量 public RegexExcludePathFilter(String regex) {//这个是上面的那个,正在表达式 this.regex = regex;//将String regex的值,赋给RegexExcludePathFilter类里的private final String regex的值 } public boolean accept(Path path) {//主要是实现accept方法 // TODO Auto-generated method stub boolean flag = path.toString().matches(regex);//匹配正则表达式,这里是^.*svn$ return !flag;//如果要接收 regex 格式的文件,则accept()方法就return flag; 如果想要过滤掉regex格式的文件,则accept()方法就return !flag。 } } /** * * @function 接受 regex 格式的文件 * */ public static class RegexAcceptPathFilter implements PathFilter { private final String regex;//变量 public RegexAcceptPathFilter(String regex) {//这个是上面的那个,正在表达式 this.regex = regex;//将String regex的值,赋给RegexAcceptPathFilter类里的private final String regex的值 } public boolean accept(Path path) {//主要是实现accept方法 // TODO Auto-generated method stub boolean flag = path.toString().matches(regex);//匹配正则表达式,这里是^.*txt$ return flag;//如果要接收 regex 格式的文件,则accept()方法就return flag; 如果想要过滤掉regex格式的文件,则accept()方法就return !flag。 } } } 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/6171460.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

利用iOS API编写简单微博客户端全过程

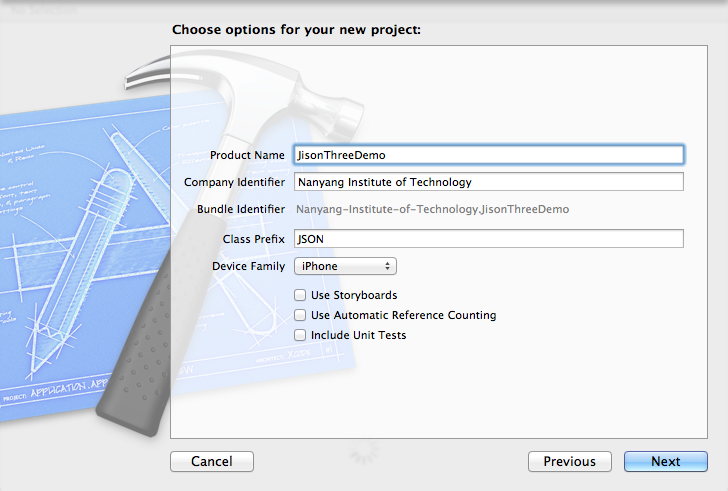
要编写社交网络客户端程序,可以大体上分为4个主要的步骤 下面我们按照这个流程,介绍一下: 1、引入Accounts和Social框架 工程中需要引入Accounts和Social框架,Accounts框架中有进行用户账户认证所需类,Social框架中SLRequest类是我们所需要的。添加具体步骤是选择工程中的TARGETS→WeiBo→Build Phases→Link Binary With Libraries,选择右下角的“+”按钮,打开框架和库选择对话框。 分别选择Social.framework添加,再选择Accounts.framework添加。 2、用户账户认证 用户账户认证使用ACAccount、ACAccountStore和ACAccountType类,ACAccount类是封装用户账户信息,这些信息存储在账户数据库中,ACAccountStore类用来管理账户数据库,ACAccountType类描述了账户类型。 认证过程的模板代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 ACAccountStore *account = [[ACAccountStore alloc] init]; ① ACAccountType *accountType = [account accountTypeWithAccountTypeIdentifier: ACAccountTypeIdentifierSinaWeibo]; ② [account requestAccessToAccountsWithType:accountType options:nil completion:^( BOOL granted, NSError *error) ③ { if (granted == YES) ④ { NSArray *arrayOfAccounts = [account accountsWithAccountType:accountType]; ⑤ if ([arrayOfAccounts count] > 0) ⑥ { <认证通过> } }; }]; 3、发送请求 用户认证通过就可以进行发送使用SLRequest对象发送请求,创建SLRequest对象可以使用类级构造方法requestForServiceType:requestMethod:URL:parameters:,下面是代码是创建SLRequest对象: 1 2 3 4 SLRequest *request = [SLRequest requestForServiceType:SLServiceTypeSinaWeibo requestMethod:SLRequestMethodGET URL:requestURL parameters:parameters]; 上面的代码还只是创建了SLRequest对象,我们还需要为请求对象设置账户信息,使用下面的语句: request.account = weiboAccount; weiboAccount账户信息是我们从用户账户信息数据库中获得的,设置给请求对象的account属性,然后才能提交给社交网络服务器进行认证。 具体开始请求是通过调用SLRequest 的performRequestWithHandler:方法实现的,代码如下: 1 2 3 4 [request performRequestWithHandler:^(NSData *responseData, NSHTTPURLResponse *urlResponse, NSError *error) { <处理请求结果> }]; 4、处理请求结果 请求结束会调用代码块,我们在代码块中处理请求结果。基本工作是解析数据,以及UI的更新等操作。这3个社交网络服务返回的都是JSON格式数据,其中代码块中的responseData参数可以使用NSJSONSerialization解析JSON对象: 1 2 id jsonObj = [NSJSONSerialization JSONObjectWithData:responseData options:NSJSONReadingAllowFragments error:&err]; 解析的jsonObj对象结构根据社交网络服务的不同而不同,详细参数情况请参考不同服务的开发者网站。 下面我们通过一个实例介绍一下SLRequest的使用,在表视图画面中,可以下拉刷新视图,获得最新的社交网络服务信息。点击画面导航栏的Action按钮,会弹出撰写信息的模态视图(右图所示),撰写完成之后点击“Save”按钮发送信息,可以点击“Cancel”按钮取消发送。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1197305,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop MapReduce编程 API入门系列之计数器(二十七)

MapReduce 计数器是什么? 计数器是用来记录job的执行进度和状态的。它的作用可以理解为日志。我们可以在程序的某个位置插入计数器,记录数据或者进度的变化情况。 MapReduce 计数器能做什么? MapReduce 计数器(Counter)为我们提供一个窗口,用于观察 MapReduce Job 运行期的各种细节数据。对 MapReduce 性能调优很有帮助,MapReduce 性能优化的评估大部分都是基于这些 Counter 的数值表现出来的。 MapReduce 都有哪些内置计数器? MapReduce 自带了许多默认 Counter,现在我们来分析这些默认 Counter 的含义,方便大家观察 Job 结果,如输入的字节数、输出的字节数、Map 端 输入/输出的字节数和条数、Reduce 端的输入/输出的字节数和条数等。下面我们只需了解这些内置计数器,知道计数器组名称(groupName)和计数器名称(counterName),以后使用计数器会查找groupName和counterName即可。 任务计数器 在任务执行过程中,任务计数器采集任务的相关信息,每个作业的所有任务的结果会被聚集起来。例如,MAP_INPUT_RECORDS 计数器统计每个 map 任务输入记录的总数, 并在一个作业的所有 map 任务上进行聚集,使得最终数字是整个作业的所有输入记录的总数。任务计数器由其关联任务维护,并定期发送给 TaskTracker,再由 TaskTracker 发送给 JobTracker。因此,计数器能够被全局地聚集。下面我们分别了解各种任务计数器。 1、MapReduce任务计数器 MapReduce 任务计数器的 groupName为org.apache.hadoop.mapreduce.TaskCounter,它包含的计数器如下表所示,计数器名称列的括号()内容即为counterName。 map 输入的记录数(MAP_INPUT_RECORDS) 作业中所有 map 已处理的输入记录数。每次 RecorderReader 读到一条记录并将其传给 map 的 map() 函数时,该计数器的值增加。 map 跳过的记录数(MAP_SKIPPED_RECORDS) 作业中所有 map 跳过的输入记录数。 map 输入的字节数(MAP_INPUT_BYTES) 作业中所有 map 已处理的未经压缩的输入数据的字节数。每次 RecorderReader 读到一条记录并 将其传给 map 的 map() 函数时,该计数器的值增加。 分片(split)的原始字节数(SPLIT_RAW_BYTES) 由 map 读取的输入-分片对象的字节数。这些对象描述分片元数据(文件的位移和长度),而不是分片的数据自身,因此总规模是小的。 map 输出的记录数(MAP_OUTPUT_RECORDS) 作业中所有 map 产生的 map 输出记录数。每次某一个 map 的Context 调用 write() 方法时,该计数器的值增加。 map 输出的字节数(MAP_OUTPUT_BYTES) 作业中所有 map 产生的 未经压缩的输出数据的字节数。每次某一个 map 的 Context 调用 write() 方法时,该计数器的值增加。 map 输出的物化字节数(MAP_OUTPUT_MATERIALIZED_BYTES) map 输出后确实写到磁盘上的字节数;若 map 输出压缩功能被启用,则会在计数器值上反映出来。 combine 输入的记录数(COMBINE_INPUT_RECORDS) 作业中所有 Combiner(如果有)已处理的输入记录数。Combiner 的迭代器每次读一个值,该计数器的值增加。 combine 输出的记录数(COMBINE_OUTPUT_RECORDS) 作业中所有 Combiner(如果有)已产生的输出记录数。每当一个 Combiner 的 Context 调用 write() 方法时,该计数器的值增加。 reduce 输入的组(REDUCE_INPUT_GROUPS) 作业中所有 reducer 已经处理的不同的码分组的个数。每当某一个 reducer 的 reduce() 被调用时,该计数器的值增加。 reduce 输入的记录数(REDUCE_INPUT_RECORDS) 作业中所有 reducer 已经处理的输入记录的个数。每当某个 reducer 的迭代器读一个值时,该计数器的值增加。如果所有 reducer 已经处理完所有输入, 则该计数器的值与计数器 “map 输出的记录” 的值相同。 reduce 输出的记录数(REDUCE_OUTPUT_RECORDS) 作业中所有 map 已经产生的 reduce 输出记录数。每当某一个 reducer 的 Context 调用 write() 方法时,该计数器的值增加。 reduce 跳过的组数(REDUCE_SKIPPED_GROUPS) 作业中所有 reducer 已经跳过的不同的码分组的个数。 reduce 跳过的记录数(REDUCE_SKIPPED_RECORDS) 作业中所有 reducer 已经跳过输入记录数。 reduce 经过 shuffle 的字节数(REDUCE_SHUFFLE_BYTES) shuffle 将 map 的输出数据复制到 reducer 中的字节数。 溢出的记录数(SPILLED_RECORDS) 作业中所有 map和reduce 任务溢出到磁盘的记录数。 CPU 毫秒(CPU_MILLISECONDS) 总计的 CPU 时间,以毫秒为单位,由/proc/cpuinfo获取 物理内存字节数(PHYSICAL_MEMORY_BYTES) 一个任务所用物理内存的字节数,由/proc/cpuinfo获取 虚拟内存字节数(VIRTUAL_MEMORY_BYTES) 一个任务所用虚拟内存的字节数,由/proc/cpuinfo获取 有效的堆字节数(COMMITTED_HEAP_BYTES) 在 JVM 中的总有效内存量(以字节为单位),可由 Runtime().getRuntime().totaoMemory()获取。 GC 运行时间毫秒数(GC_TIME_MILLIS) 在任务执行过程中,垃圾收集器(garbage collection)花费的时间(以毫秒为单位), 可由 GarbageCollector MXBean.getCollectionTime()获取;该计数器并未出现在1.x版本中。 由 shuffle 传输的 map 输出数(SHUFFLED_MAPS) 有 shuffle 传输到 reducer 的 map 输出文件数。 失败的 shuffle 数(SHUFFLE_MAPS) 在 shuffle 过程中,发生拷贝错误的 map 输出文件数,该计数器并没有包含在 1.x 版本中。 被合并的 map 输出数 在 shuffle 过程中,在 reduce 端被合并的 map 输出文件数,该计数器没有包含在 1.x 版本中。 2、文件系统计数器 文件系统计数器的 groupName为org.apache.hadoop.mapreduce.FileSystemCounter,它包含的计数器如下表所示,计数器名称列的括号()内容即为counterName。 文件系统的读字节数(BYTES_READ) 由 map 和 reduce 等任务在各个文件系统中读取的字节数,各个文件系统分别对应一个计数器,可以是 Local、HDFS、S3和KFS等。 文件系统的写字节数(BYTES_WRITTEN) 由 map 和 reduce 等任务在各个文件系统中写的字节数。 3、FileInputFormat 计数器 FileInputFormat 计数器的 groupName为org.apache.hadoop.mapreduce.lib.input.FileInputFormatCounter,它包含的计数器如下表所示,计数器名称列的括号()内容即为counterName。 读取的字节数(BYTES_READ) 由 map 任务通过 FileInputFormat 读取的字节数。 4、FileOutputFormat 计数器 FileOutputFormat 计数器的 groupName为org.apache.hadoop.mapreduce.lib.input.FileOutputFormatCounter,它包含的计数器如下表所示,计数器名称列的括号()内容即为counterName。 写的字节数(BYTES_WRITTEN) 由 map 任务(针对仅含 map 的作业)或者 reduce 任务通过 FileOutputFormat 写的字节数。 作业计数器 作业计数器由 JobTracker(或者 YARN 中的应用宿主)维护,因此无需在网络间传输数据,这一点与包括 “用户定义的计数器” 在内的其它计数器不同。这些计数器都是作业级别的统计量,其值不会随着任务运行而改变。 作业计数器计数器的 groupName为org.apache.hadoop.mapreduce.JobCounter,它包含的计数器如下表所示,计数器名称列的括号()内容即为counterName。 启用的 map 任务数(TOTAL_LAUNCHED_MAPS) 启动的 map 任务数,包括以 “推测执行” 方式启动的任务。 启用的 reduce 任务数(TOTAL_LAUNCHED_REDUCES) 启动的 reduce 任务数,包括以 “推测执行” 方式启动的任务。 失败的 map 任务数(NUM_FAILED_MAPS) 失败的 map 任务数。 失败的 reduce 任务数(NUM_FAILED_REDUCES) 失败的 reduce 任务数。 数据本地化的 map 任务数(DATA_LOCAL_MAPS) 与输入数据在同一节点的 map 任务数。 机架本地化的 map 任务数(RACK_LOCAL_MAPS) 与输入数据在同一机架范围内、但不在同一节点上的 map 任务数。 其它本地化的 map 任务数(OTHER_LOCAL_MAPS) 与输入数据不在同一机架范围内的 map 任务数。由于机架之间的宽带资源相对较少,Hadoop 会尽量让 map 任务靠近输入数据执行,因此该计数器值一般比较小。 map 任务的总运行时间(SLOTS_MILLIS_MAPS) map 任务的总运行时间,单位毫秒。该计数器包括以推测执行方式启动的任务。 reduce 任务的总运行时间(SLOTS_MILLIS_REDUCES) reduce任务的总运行时间,单位毫秒。该值包括以推测执行方式启动的任务。 在保留槽之后,map 任务等待的总时间(FALLOW_SLOTS_MILLIS_MAPS) 在为 map 任务保留槽之后所花费的总等待时间,单位是毫秒。 在保留槽之后,reduce 任务等待的总时间(FALLOW_SLOTS_MILLIS_REDUCES) 在为 reduce 任务保留槽之后,花在等待上的总时间,单位为毫秒 计数器的该如何使用? 下面我们来介绍如何使用计数器。 1、定义计数器 1)枚举声明计数器 Context context... //自定义枚举变量Enum Counter counter = context.getCounter(Enum enum) 2)自定义计数器 Context context... //自己命名groupName和counterName Counter counter = context.getCounter(String groupName,String counterName) 2、为计数器赋值 1)初始化计数器 counter.setValue(long value);//设置初始值 2)计数器自增 counter.increment(long incr);//增加计数 3、获取计数器的值 1) 获取枚举计数器的值 Job job... job.waitForCompletion(true); Counters counters=job.getCounters(); Counter counter=counters.findCounter("BAD_RECORDS");//查找枚举计数器,假如Enum的变量为BAD_RECORDS long value=counter.getValue();//获取计数值 2) 获取自定义计数器的值 Job job... job.waitForCompletion(true); Counters counters=job.getCounters(); Counter counter=counters.findCounter("ErrorCounter","toolong");//假如groupName为ErrorCounter,counterName为toolong long value=counter.getValue();//获取计数值 3) 获取内置计数器的值 代码 package zhouls.bigdata.myMapReduce.MyCounter; import java.io.IOException; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.conf.Configured; import org.apache.hadoop.fs.FileSystem; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.LongWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Counter; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import org.apache.hadoop.util.GenericOptionsParser; import org.apache.hadoop.util.Tool; import org.apache.hadoop.util.ToolRunner; public class MyCounter extends Configured implements Tool { public static class MyCounterMap extends Mapper <LongWritable, Text, Text, Text> { // 定义枚举对象 public static enum LOG_PROCESSOR_COUNTER {//枚举对象BAD_RECORDS_LONG来统计长数据,枚举对象BAD_RECORDS_SHORT来统计短数据 BAD_RECORDS_LONG,BAD_RECORDS_SHORT }; protected void map(LongWritable key, Text value, Context context) throws java.io.IOException, InterruptedException { String arr_value[] = value.toString().split("/t"); if (arr_value.length > 3) { /*动态自定义计数器*/ context.getCounter("ErrorCounter", "toolong").increment(1); /*枚举声明计数器*/ context.getCounter(LOG_PROCESSOR_COUNTER.BAD_RECORDS_LONG).increment(1); } else if (arr_value.length < 3) { // 动态自定义计数器 context.getCounter("ErrorCounter", "tooshort").increment(1); // 枚举声明计数器 context.getCounter(LOG_PROCESSOR_COUNTER.BAD_RECORDS_SHORT).increment(1); } else { context.write(value, new Text("")); } } } public int run(String[] args) throws Exception { //TODO Auto-generated method stub Configuration conf=new Configuration(); Path mypath=new Path(args[1]); FileSystem hdfs =mypath.getFileSystem(conf); if(hdfs.isDirectory(mypath)) { hdfs.delete(mypath,true); } Job job = new Job(conf, "MyCounter"); job.setJarByClass(MyCounter.class); job.setMapperClass(MyCounterMap.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(Text.class); FileInputFormat.addInputPath(job, new Path(args[0])); FileOutputFormat.setOutputPath(job, new Path(args[1])); job.waitForCompletion(true); return 0; } public static void main(String[] args) throws Exception { // String[] args0 ={"hdfs://HadoopMaster:9000/counter/counter.txt", // "hdfs://HadoopMaster:9000/out/counter"}; String[] args0 ={"./data/counter/counter.txt", "./out/counter"}; int ec = ToolRunner.run(new Configuration(),new MyCounter(),args0); System.exit(ec); } } 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/6169221.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

用户登录
用户注册