首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10011篇文章
优秀的个人博客,低调大师

Docker零碎笔记

001.查看镜像、容器、数据卷所占用的空间 docker system df 002.具体查看镜像内的历史记录 docker history nginx:v2 003.使用Dockerfile构建镜像(注意后面有个点) docker build -t myip . 004.使用compose对docker容器进行编排管理时,需要编写docker-compose.yml文件需要注意缩进 yml文件换行后的缩进,不允许使用tab键字符,只能使用空格,而空格的数量要一致 005.docker-compose 负责实现对 Docker 容器集群的快速编排 006.docker-machine 负责在多种平台上快速安装docker环境 007.swarm mode 负责将多个docker主机封装为单个大型的虚拟dockerd主机,快速打造一套容器云平台 008.安装virtualbox sudo apt-get purge virtualbox sudo apt-get install linux-generic linux-image-generic linux-headers-generic linux-signed-generic sudo apt-get install virtualbox 009.docker镜像加速器下载速度对比 加速器 地址 Httpd,177MB下载镜像耗时 MySQL,407MB下载镜像耗时 Nginx,109MB下载镜像耗时 官方 https://registry.docker-cn.com 52 s 42 s 20 s 阿里 https://2lqq34jg.mirror.aliyuncs.com 36 s 38 s 20 s 网易 http://hub-mirror.c.163.com 67 s 73 s 475 s 官方错误 http://registry.docker-cn.com 1770 s 不忍测试 闲时再测 不使用 --- 一个字慢! 不忍测试 闲时再测 结论:1、使用加速器后,下载速度飞快,家庭100Mb宽带环境下,镜像下载速度能达到3-5MB/s以上。2、由于Docker采用分层文件系统,不同镜像公用一些相同的层文件,在下载后续镜像时下载速度更快,比如阿里加速器下载MySQL镜像,“达到”了10.7MB/s;3、加速器地址一定要写对,官方加速器的不能写成http,一定要写https,否则无加速效果;4、加速器的加速效果差不多?官方的、阿里的、网易163的加速器效果如下:阿里 >官方 > 网易 > 不加速5、Docker支持同时配置多个加速器,建议依上面的次序同时配置多个加速器。6、代码: { "registry-mirrors": [ "https://2lqq34jg.mirror.aliyuncs.com", "https://registry.docker-cn.com", "http://hub-mirror.c.163.com" ] } 010.docker的run命令 docker run -it -v /usr/java/:/mnt/software/ myubuntu /bin/bash docker run <相关参数> <镜像ID 或者 仓库名:标签名> <初始命令> 相关参数包括: -i:表示以“交互模式”运行容器 -t:表示容器启动后会进入其命令行 -v:表示需要将本地哪个目录挂载到容器中,格式:-v <宿主机目录>:<容器目录> 初始命令表示一旦容器启动,需要运行的命令,若此处命令使用"/bin/bash",则表示什么也不做,只需进入命令行即可 退出容器使用Ctrl+d或输入exit 再次启动已启动过但现在是关闭的容器 docker start 容器ID或容器名 这个命令只会启动容器,不会进入容器。要进入容器得用命令 docker attach 容器ID或容器名 011.docker如何查看已存在的容器所挂载的目录 docker inspect container_name | grep Mounts -A 20 012.docker启动mysql容器 初次启动需要指定root用户密码, 也可在docker-compose中指定, 直接用docker-compose启动 docker run -e MYSQL_ROOT_PASSWORD=root -p 33066:3306 --name mysql-5.7 -d mysql:5.7 -v /data/mysql/my.cnf:/etc/mysql/mysql.conf.d -v /data/mysql/logs:/usr/local/mysql/logs -v /data/mysql/data:/var/lib/mysql 013.docker进入mysql容器 docker exec -it mysql-5.7 bash # 然后进入mysql服务 mysql -uroot -p 014.docker启动tomcat docker run --mount source=tomcat-8.5-xyj,target=/usr/local/tomcat/webapps -p 8081:8080 --name tomcat-8.5 -d tomcat:8.5 015.DockerCompose通过compose工程名以及服务名从dockerEngine获取当前所有含有此标记的容器以检查当前工程所包含的服务状态,根据当前状态为每个服务制定接下来的动作 若容器不存在,则服务动作设置为创建(create) 若容器存在但设置不允许重建,则服务动作设置为启动(start) 若容器配置发生变化(config-hash)或者设置强制重建标志,则服务动作设置为重建(recreate) 若容器状态为停止,则服务动作设置为启动(start) 若容器状态为运行但其依赖容器需要重建,则服务状态设置为重建(recreate) 若容器状态为运行其无配置改变则不作操作 016.docker查看某个容器大小 进入docker容器默认位置:/var/lib/docker/containers, 文件夹名称即为容器名,文件夹大小即为容器大小 17. Docker参考网站 Docker Hub官方网站(用于查找各种镜像): https://hub.docker.com/docker-compose.yml文件各个参数的官方说明: https://docs.docker.com/compose/compose-file/ 18. Docker的各种docker-compose.yml文件 (1) MySQL version: "3.5" services: mysql: image: mysql:5.7 restart: always container_name: mysql environment: MYSQL_ROOT_PASSWORD: root ports: - "3306:3306" networks: mysql: ipv4_address: 172.20.0.2 volumes: - type: volume source: data target: /var/lib/mysql - type: volume source: config target: /etc/mysql/mysql.conf.d - type: volume source: logs target: /usr/local/mysql/logs volumes: data: config: logs: networks: mysql: driver: bridge name: mysql ipam: driver: default config: - subnet: 172.20.0.0/24 (2) Redis version: "3.5" services: redis: image: redis:4.0.9 restart: always container_name: redis volumes: - type: volume source: config target: /usr/local/etc/redis - type: volume source: data target: /data command: redis-server /usr/local/etc/redis/redis.conf ports: - "6379:6379" networks: redis: ipv4_address: 172.20.0.2 volumes: config: data: networks: redis: driver: bridge name: redis ipam: driver: default config: - subnet: 172.20.0.0/24 (3) Tomcat version: "3.5" services: blog: image: tomcat:8.5 restart: always container_name: blog ports: - "8083:8080" networks: - mysql volumes: - type: volume source: blog target: /usr/local/tomcat/webapps volumes: blog: name: blog networks: mysql: external: true name: mysql (4) Java示例(执行了java -jar /opt/blogback.jar命令, 方便启动容器后自动运行Java程序, 也可用于SpringBoot项目的部署) version: "3.5" services: blogback: image: java:8 restart: always container_name: blogback ports: - "8082:8080" working_dir: /opt command: java -jar /opt/blogback.jar networks: - mysql volumes: - type: volume source: blogback target: /opt volumes: blogback: name: blogback networks: mysql: external: true name: mysql (5) GitLab version: "3.5" services: gitlab: image: gitlab/gitlab-ce:10.5.4-ce.0 restart: always container_name: gitlab ports: - "8085:80" - "2222:22" hostname: "gitlab.ywz.com" environment: GITLAB_OMNIBUS_CONFIG: | gitlab_rails['gitlab_shell_ssh_port'] = 2222 volumes: - type: volume source: config target: /etc/gitlab - type: volume source: logs target: /var/log/gitlab - type: volume source: data target: /var/opt/gitlab volumes: config: name: gitlab_config logs: name: gitlab_logs data: name: gitlab_data (6) Jenkins version: "3.5" services: jenkins: image: jenkins:2.60.3 restart: always container_name: jenkins ports: - "8080:8080" volumes: - type: bind source: /home/paul/docker/myvolume/jenkins/home target: /var/jenkins_home (7) Nexus version: "3.5" services: nexus: image: sonatype/nexus3:3.8.0 restart: always container_name: nexus ports: - "8081:8081" volumes: - type: volume source: data target: /nexus-data volumes: data: (8) Nginx version: "3.5" services: nginx: image: nginx:1.13 restart: always container_name: nginx ports: - "80:80" volumes: - type: volume source: config target: /etc/nginx volumes: config: (9) Python version: "3.5" services: python: image: python:3.5 restart: always container_name: python tty: true command: bash volumes: - type: volume source: workspace target: /home - type: volume source: lib target: /usr/local/lib volumes: workspace: name: python_workspace lib: name: python_lib (10) 多个Tomcat项目共用MySQL, Redis示例 version: "3.5" services: jn: image: tomcat:8.5 restart: always container_name: tomcat_oa_jn ports: - "8082:8080" networks: - mysql_oa - redis_oa volumes: - type: bind source: /home/paul/docker/myvolume/tomcat_oa_jn/webapps target: /usr/local/tomcat/webapps depends_on: - mysql_oa - redis_oa xq: image: tomcat:8.5 restart: always container_name: tomcat_oa_xq ports: - "8083:8080" networks: - mysql_oa - redis_oa volumes: - type: bind source: /home/paul/docker/myvolume/tomcat_oa_xq/webapps target: /usr/local/tomcat/webapps depends_on: - mysql_oa - redis_oa test: image: tomcat:8.5 restart: always container_name: tomcat_oa_test ports: - "8084:8080" networks: - mysql_oa - redis_oa volumes: - type: bind source: /home/paul/docker/myvolume/tomcat_oa_test/webapps target: /usr/local/tomcat/webapps depends_on: - mysql_oa - redis_oa mysql_oa: image: mysql:5.7 restart: always container_name: mysql_oa environment: MYSQL_ROOT_PASSWORD: root ports: - "3307:3306" networks: mysql_oa: ipv4_address: 172.20.0.2 volumes: - type: volume source: mysql_data target: /var/lib/mysql - type: volume source: mysql_config target: /etc/mysql/mysql.conf.d - type: volume source: mysql_logs target: /usr/local/mysql/logs redis_oa: image: redis:4.0.9 restart: always container_name: redis_oa command: redis-server /usr/local/etc/redis/redis.conf ports: - "6379:6379" networks: redis: ipv4_address: 172.21.0.2 volumes: - type: volume source: redis_config target: /usr/local/etc/redis - type: volume source: redis_data target: /data volumes: mysql_data: name: mysql_oa_data mysql_config: name: mysql_oa_config mysql_logs: name: mysql_oa_logs redis_config: name: redis_oa_config redis_data: name: redis_oa_data networks: mysql_oa: driver: bridge name: mysql_oa ipam: driver: default config: - subnet: 172.20.0.0/24 redis_oa: driver: bridge name: redis_oa ipam: driver: default config: - subnet: 172.21.0.0/24 19. Dockerfile实现在centos7-jdk8容器中安装应用(以libreoffice为例) (1) Dockerfile文件 FROM bpatterson/centos7-jdk8 RUN yum update -y RUN yum install -y libreoffice-headless libreoffice-writer libreoffice-calc libreoffice- libreoffice-impress libreoffice-langpack-zh-Hans libreoffice-langpack-zh-Hant libreoffice-langpack-ja ImageMagick curl RUN yum clean all WORKDIR / (2) 在Dockerfile文件所在目录下执行如下命令生成镜像 docker build -t libreoffice:1.0 . (3) 镜像生成后就可以通过compose文件或者直接使用命令启动容器了 version: "3.3" services: libreoffice: image: libreoffice:1.0 restart: always tty: true command: /bin/bash container_name: libreoffice ports: - "8192:8080" volumes: - type: bind source: /home/libreoffice/data target: /home/libreoffice/data (4) 启动容器后运行容器内应用 docker exec -t libreoffice libreoffice --headless --convert-to pdf /home/libreoffice/data/source/test.xls --outdir /home/libreoffice/data/target (5) libreoffice功能实现附件格式转换, 如: xls文件转换为doc文件, doc文件转换为pdf文件等等.

优秀的个人博客,低调大师

EMR学习笔记(1)HDFS

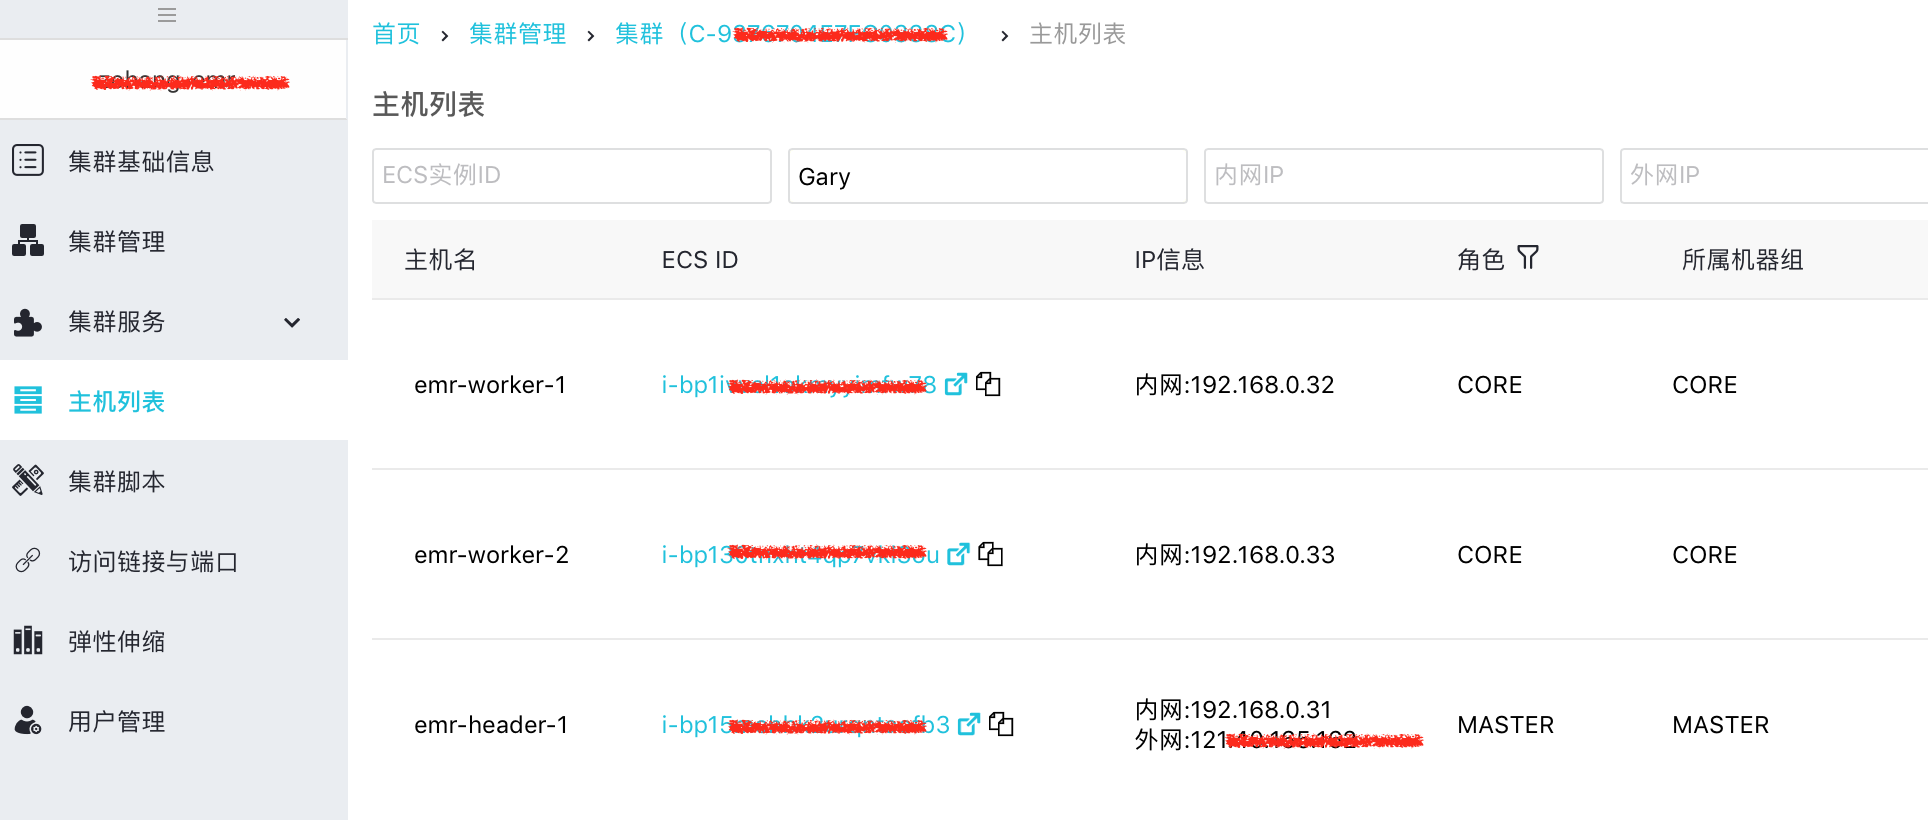
EMR HDFS Architecture 本文以非HA集群,2个worker的集群为例。 非HA集群,仅有一个Namenode实例,部署在Master节点。Namenode主要职责:-管理文件系统namespace,包括但不仅限于:开、关文件,文件改名,目录操作等。-管控客户端对文件的访问 EMR hadoop集群,每个Worker节点仅部署一个Datanode实例。Datanode主要职责:-管理所在节点挂载的存储-提供给客户端读写服务-block创建、删除以及replication 登录EMR集群实现基本运维 在较新的集群版本中(3.2 以上版本),所有的服务操作都可以通过集群的配置管理功能来完成。推荐优先使用 Web 页面的管理方式。 若您觉得在网页上的作业和执行计划无法满足您更加复杂的应用需求,您可以登录到 E-MapReduce 集群的主机上。找到集群的详情页,其中就有集群 master 机器的公网 IP 地址,您可以直接 SSH 登录到这台机器上,查看各种设置与状态。 登录 Master 主机步骤 使用如下命令 SSH 登录到 master 主机。请在集群详情页的主机信息栏中获取集群 master 机器的公网 IP。ssh root@ip.of.master 输入创建集群时设定的密码。 如何登录 Core 节点A:按照如下步骤: 首先在 Master 节点上切换到 Hadoop 账号:su hadoop 然后即可免密码 SSH 登录到对应的 Core 节点:ssh emr-worker-1 通过 sudo 可以获得 root 权限:sudo vi /etc/hosts 通过命令行方式启停服务进程操作用账号:hdfs NameNode (Master 节点) // 启动 /usr/lib/hadoop-current/sbin/hadoop-daemon.sh start namenode // 停止 /usr/lib/hadoop-current/sbin/hadoop-daemon.sh stop namenode DataNode (Core 节点) // 启动 /usr/lib/hadoop-current/sbin/hadoop-daemon.sh start datanode // 停止 /usr/lib/hadoop-current/sbin/hadoop-daemon.sh stop datanode 示例:登录实际emr集群演示停止datanode进程操作

优秀的个人博客,低调大师

Android笔记(四) | View基础

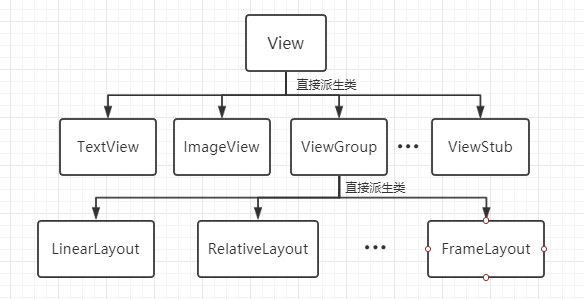
本文主要总结有关View的常用基础知识,作为V学习View相关内容的根基。 主要内容:View的位置参数、MotionEvent、TouchSlop对象、VelocityTracker、GestureDetector和Scroller对象。 View类 View类是Android中所有控件的基类,包括ViewGroup(控件组);这也就意味着,View本身可以是单个控件,也可以是包含多个控件的一组控件。 View的位置参数 View的位置主要由四个顶点决定,分别对应于四个属性:top、left、right、bottom。从Android3.0开始,增加了几个额外参数:x、y、translationx、translationY。这些参数都是相对于父容器的。 x:View发生平移后的左上角横坐标 y:View发生平移后的左上角纵坐标 translationX:View的横向偏移量(初始为0) translationY:View的纵向偏移量(初始为0) MotionEvent 手指触摸屏幕后的典型事件类型有: ACTION_DOWN——手指接触屏幕瞬间; ACTION_MOVE——手指在屏幕上滑动; ACTION_UP——手指离开屏幕瞬间; 通过MotionEvent对象可以得到点击事件发生的x、y坐标: getX()——获取触摸点相对于当前View左上角的横坐标; getY()——获取触摸点相对于当前View左上角的纵坐标; getRawX()——获取触摸点相对于手机屏幕左上角的横坐标; getRawY()——获取触摸点相对于手机屏幕左上角的纵坐标; TouchSlop TouchSlop是系统所能识别出的被认为是滑动的最小距离。 这是一个常量,和设备有关,在不同设备上这个值可能不同; 当手指在屏幕上滑动的距离小于这个值,系统就不会认为这是滑动操作; 获取方法: ViewConfiguration.get(getContext()).getScaledTouchSlop(); 这个常量的意义在于,当我们做滑动处理的时候,可以用它来做一些过滤。这样可以改善用户的使用体验。 VelocityTracker 速度追踪,用于追踪手指在滑动过程中的速度,包括水平和竖直方向的速度。下面是使用示例: @Override public boolean onTouchEvent(MotionEvent event) { //创建VelocityTracker对象,并将触摸界面的滑动事件 //加入到VelocityTracker当中。 VelocityTracker velocityTracker = VelocityTracker.obtain(); velocityTracker.addMovement(event); //指定时间间隔为1s,计算速度 velocityTracker.computeCurrentVelocity(1000); //获取水平速度和竖直速度(像素/s) int xVelocity = (int)velocityTracker.getXVelocity(); int yVelocity = (int)velocityTracker.getYVelocity(); //销毁对象,回收内存 velocityTracker.clear(); velocityTracker.recycle(); return super.onTouchEvent(event); } 速度 = (终点位置 - 起点位置)/时间段(可以为负值) GestureDetector 手势检测,用于辅助检测用户的单击、滑动、长按、双击等行为。下面是使用示例: public class MainActivity extends AppCompatActivity implements GestureDetector.OnGestureListener,GestureDetector.OnDoubleTapListener{ GestureDetector mGestureDetector; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); //首先,创建GestureDetector对象并根据需求实现OnGestureListener接口 //和OnDoubleTapListener接口 mGestureDetector = new GestureDetector(this,this); } @Override public boolean onTouchEvent(MotionEvent event) { //将目标View中的触摸事件交给GestureDetector处理(这里是MainActivity中的触摸事件) return mGestureDetector.onTouchEvent(event); } } 做完上面的事情之后,即可以选择性的实现OnGestureListener和OnDoubleTapListener中的方法了,这两个接口中的常用方法如下: 方法名 描述 所属接口 onDown 手指轻轻触摸屏幕瞬间,由一个ACTION_DOWN触发 OnGestureListener onSingleTapUp 手指(轻轻触摸屏幕后)松开,伴随一个ACTION_UP而触发,表示单击行为 OnGestureListener onScroll 手指按下屏幕并拖动,由一个ACTION_DOWN,多个ACTION_MOVE触发,表示拖动行为 OnGestureListener onFling 用户按下触摸屏,快速滑动后松开,由一个ACTION_DOWN、多个ACTION_MOVE和一个ACTION_UP触发,表示快速滑动行为 OnGestureListener onLoongPress 用户长久的按住屏幕不放,表示长按行为 OnGestureListener onDoubleTap 双击,由连续2次单击组成 OnDoubleTapListener 说明: 在实际开发中,可以不使用GestureDetector,完全可以自己在View中onTouchEvent方法中实现所需的监听。 建议:如果只是监听滑动相关,就在onTouchEvent中实现;如果要监听双击这种行为,就使用GestureDetector。

优秀的个人博客,低调大师

(一)Java并发学习笔记

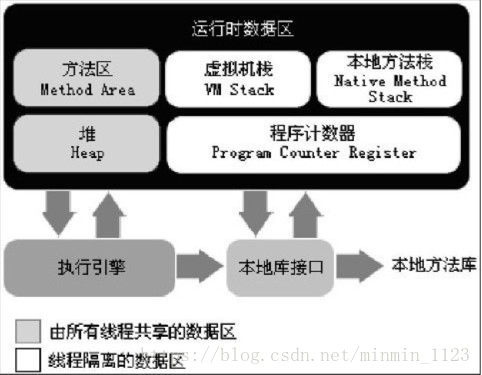
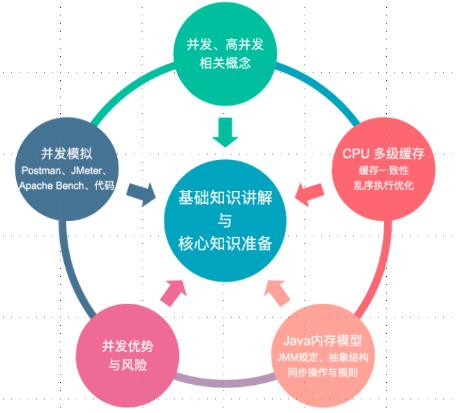
一、课程导学 二、基本概念 并发:同时拥有两个或者多个线程,如果程序在单核处理器上运行,多个线程将交替地换入或者换出内存,这些线程是同时“存在”的,每个线程都处于执行过程中的某个状态,高速切换感觉同时执行。如果运行多核处理器上,此时,程序中的每个线程将分配到一个处理器核上,因此可以真正的同时运行。 高并发:高并发(High Cuncurrency)是互联网分布式系统架构设计中必须考虑的因素之一,它通常是指,通过设计保证系统能够 同时并发处理 很多请求。 其实当我们讨论并发时主要关注的是以下几点: 多线程操作相同的资源 保证线程安全 合理分配和使用资源 而在讨论高并发是关注的是以下几点: 服务器能同时处理很多个请求 提高程序性能 比如在12306抢票,淘宝双11等都需要考虑高并发 三、并发编程基础 在单核时代处理器做出的乱序优化不会导致执行结果远离预期目标,但在多核环境下却并非如此。在多核时代,由多核cpu同时执行指令,同时还引入的l1、l2等缓存机制,每个核都有自己的缓存,就导致了逻辑顺序上后写入的数据未必真的最后写入。如果我们不做任何防护措施,就会出现处理器得出的结果和我们逻辑得出的结果大不相同。 比如:我们在一个cpu核心上执行写入操作,并在最后写入一个标记来表示该操作已经写入好了。然后从另外一个核上通过判断这个标记来确定所需要的数据是否已经就绪,这种做法就存在一定风险:标记位先被写入但数据操作并未完成。导致另外一个核使用了错误数据。 四、Java内存模型(Java Memory Model,JMM) 内存模型可以理解为在特定的操作协议下,对特定的内存或者高速缓存进行读写访问的过程抽象,不同架构下的物理机拥有不一样的内存模型,Java虚拟机也有自己的内存模型,即Java内存模型(Java Memory Model, JMM)。 在C/C++语言中直接使用物理硬件和操作系统内存模型,导致不同平台下并发访问出错。而JMM的出现,能够屏蔽掉各种硬件和操作系统的内存访问差异,实现平台一致性,是的Java程序能够“一次编写,到处运行”。 堆内存(Heap): 存放实例域, 静态域, 数组元素. 在线程间共享. 栈内存(Stack): 存放局部变量, 方法定义参数和异常处理器参数. 线程A和线程B要进行通信,必须先将数据刷新到主内存,线程B再从主内存读取线程A更新过的变量。 模拟场景: 比如多个线程同时修改一个变量:线程A 先从主内存中获取共享变量(a=2),然后在自己本地内存中计算(a+2),然后写入到主内存。 但此时B也从主内存获取(a=2),在本地内存改变(a+2).写入到主内存。 在计算过程中两个线程间的数据是不可见的,此时就会出现结果不正确情况。 Java内存模型-同步操作与规则 由上面的交互关系可知,关于主内存与工作内存之间的具体交互协议,即一个变量如何从主内存拷贝到工作内存、如何从工作内存同步到主内存之间的实现细节,Java内存模型定义了以下八种操作来完成: lock(锁定):作用于主内存的变量,把一个变量标识为一条线程独占状态。 unlock(解锁):作用于主内存变量,把一个处于锁定状态的变量释放出来,释放后的变量才可以被其他线程锁定。 read(读取):作用于主内存变量,把一个变量值从主内存传输到线程的工作内存中,以便随后的load动作使用 load(载入):作用于工作内存的变量,它把read操作从主内存中得到的变量值放入工作内存的变量副本中。 use(使用):作用于工作内存的变量,把工作内存中的一个变量值传递给执行引擎,每当虚拟机遇到一个需要使用变量的值的字节码指令时将会执行这个操作。 assign(赋值):作用于工作内存的变量,它把一个从执行引擎接收到的值赋值给工作内存的变量,每当虚拟机遇到一个给变量赋值的字节码指令时执行这个操作。 store(存储):作用于工作内存的变量,把工作内存中的一个变量的值传送到主内存中,以便随后的write的操作。 write(写入):作用于主内存的变量,它把store操作从工作内存中一个变量的值传送到主内存的变量中。 Java内存模型还规定了在执行上述八种基本操作时,必须满足如下规则: 不允许read和load、store和write操作之一单独出现 不允许一个线程丢弃它的最近assign的操作,即变量在工作内存中改变了之后必须同步到主内存中。 不允许一个线程无原因地(没有发生过任何assign操作)把数据从工作内存同步回主内存中。 一个新的变量只能在主内存中诞生,不允许在工作内存中直接使用一个未被初始化(load或assign)的变量。即就是对一个变量实施use和store操作之前,必须先执行过了assign和load操作。 一个变量在同一时刻只允许一条线程对其进行lock操作,lock和unlock必须成对出现 如果对一个变量执行lock操作,将会清空工作内存中此变量的值,在执行引擎使用这个变量前需要重新执行load或assign操作初始化变量的值 如果一个变量事先没有被lock操作锁定,则不允许对它执行unlock操作;也不允许去unlock一个被其他线程锁定的变量。 对一个变量执行unlock操作之前,必须先把此变量同步到主内存中(执行store和write操作)。 这8种内存访问操作很繁琐,后文会使用一个等效判断原则,即先行发生(happens-before)原则来确定一个内存访问在并发环境下是否安全。 五、并发的优势和风险 六、线程安全性 线程安全性主要体现在三个方面: 1. 原子性: 原子是世界上的最小单位,具有不可分割性。比如 a=0;(a非long和double类型)这个操作是不可分割的,那么我们说这个操作时原子操作。再比如:a++;这个操作实际是a = a + 1;是可分割的,所以他不是一个原子操作。非原子操作都会存在线程安全问题,需要我们使用同步技术(sychronized)来让它变成一个原子操作。一个操作是原子操作,那么我们称它具有原子性。java的concurrent包下提供了一些原子类,我们可以通过阅读API来了解这些原子类的用法。比如:AtomicInteger、AtomicLong、AtomicReference等。 Atomicxxx底层工作原理: 借助于Unsafe.compareAndSwapInt: CAS实现, 每次执行计算之前都会拿当前工作内存中的值和主内存的值比较,如果不相同就会从新从主内存中获取最新值赋值给当前对象,直到相同执行对应操作。 sun.misc.Unsafe源码: public final int getAndAddInt(Object var1, long var2, int var4) { int var5; do { var5 = this.getIntVolatile(var1, var2); } while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4)); return var5; } AtomicLong和AtomicAddr AtomicLong的原理是依靠底层的cas来保障原子性的更新数据,在要添加或者减少的时候,会使用死循环不断地cas到特定的值,从而达到更新数据的目的。在竞争不激烈时修改成功的概率很高,否则修改失败的概率就很高,在大量修改失败的情况下,这些原子操作就会进行大量的失败重尝试,性能就会受到影响。 总结: LongAdder在AtomicLong的基础上将单点的更新压力分散到各个节点,在低并发的时候通过对base的直接更新可以很好的保障和AtomicLong的性能基本保持一致,而在高并发的时候通过分散提高了性能。 缺点是LongAdder在统计的时候如果有并发更新,可能导致统计的数据有误差。 实际使用中在处理高并发计数时,推荐使用LongAddr,但如果遇到类似于序列号生成这种需要全局唯一的数据情况就需要使用AtomicLong. AtomicReference AtomicReference和AtomicInteger非常类似,不同之处就在于AtomicInteger是对整数的封装,而AtomicReference则对应普通的对象引用。也就是它可以保证你在修改对象引用时的线程安全性。在介绍AtomicReference的同时,我希望同时提出一个有关原子操作的逻辑上的不足。 之前我们说过,线程判断被修改对象是否可以正确写入的条件是对象的当前值和期望是否一致。这个逻辑从一般意义上来说是正确的。但有可能出现一个小小的例外,就是当你获得对象当前数据后,在准备修改为新值前,对象的值被其他线程连续修改了2次,而经过这2次修改后,对象的值又恢复为旧值。这样,当前线程就无法正确判断这个对象究竟是否被修改过。如图4.2所示,显示了这种情况。(ABA问题) 图4.2 对象值被反复修改回原数据 一般来说,发生这种情况的概率很小。而且即使发生了,可能也不是什么大问题。比如,我们只是简单得要做一个数值加法,即使在我取得期望值后,这个数字被不断的修改,只要它最终改回了我的期望值,我的加法计算就不会出错。也就是说,当你修改的对象没有过程的状态信息,所有的信息都只保存于对象的数值本身。 但是,在现实中,还可能存在另外一种场景。就是我们是否能修改对象的值,不仅取决于当前值,还和对象的过程变化有关,这时,AtomicReference就无能为力了。 打一个比方,如果有一家蛋糕店,为了挽留客户,绝对为贵宾卡里余额小于20元的客户一次性赠送20元,刺激消费者充值和消费。但条件是,每一位客户只能被赠送一次。 现在,我们就来模拟这个场景,为了演示AtomicReference,我在这里使用AtomicReference实现这个功能。首先,我们模拟用户账户余额。 static AtomicReference<Integer> money=newAtomicReference<Integer>(); // 设置账户初始值小于20,显然这是一个需要被充值的账户 money.set(19); 接着,我们需要若干个后台线程,它们不断扫描数据,并为满足条件的客户充值。 01 //模拟多个线程同时更新后台数据库,为用户充值 02 for(int i = 0 ; i < 3 ; i++) { 03 new Thread(){ 04 publicvoid run() { 05 while(true){ 06 while(true){ 07 Integer m=money.get(); 08 if(m<20){ 09 if(money.compareAndSet(m, m+20)){ 10 System.out.println("余额小于20元,充值成功,余额:"+money.get()+"元"); 11 break; 12 } 13 }else{ 14 //System.out.println("余额大于20元,无需充值"); 15 break ; 16 } 17 } 18 } 19 } 20 }.start(); 21 } 上述代码第8行,判断用户余额并给予赠予金额。如果已经被其他用户处理,那么当前线程就会失败。因此,可以确保用户只会被充值一次。 此时,如果很不幸的,用户正好正在进行消费,就在赠予金额到账的同时,他进行了一次消费,使得总金额又小于20元,并且正好累计消费了20元。使得消费、赠予后的金额等于消费前、赠予前的金额。这时,后台的赠予进程就会误以为这个账户还没有赠予,所以,存在被多次赠予的可能。下面,模拟了这个消费线程: 01 //用户消费线程,模拟消费行为 02 new Thread() { 03 public voidrun() { 04 for(inti=0;i<100;i++){ 05 while(true){ 06 Integer m=money.get(); 07 if(m>10){ 08 System.out.println("大于10元"); 09 if(money.compareAndSet(m, m-10)){ 10 System.out.println("成功消费10元,余额:"+money.get()); 11 break; 12 } 13 }else{ 14 System.out.println("没有足够的金额"); 15 break; 16 } 17 } 18 try{Thread.sleep(100);} catch (InterruptedException e) {} 19 } 20 } 21 }.start(); 上述代码中,消费者只要贵宾卡里的钱大于10元,就会立即进行一次10元的消费。执行上述程序,得到的输出如下: 余额小于20元,充值成功,余额:39元 大于10元 成功消费10元,余额:29 大于10元 成功消费10元,余额:19 余额小于20元,充值成功,余额:39元 大于10元 成功消费10元,余额:29 大于10元 成功消费10元,余额:39 余额小于20元,充值成功,余额:39元 从这一段输出中,可以看到,这个账户被先后反复多次充值。其原因正是因为账户余额被反复修改,修改后的值等于原有的数值。使得CAS操作无法正确判断当前数据状态。 虽然说这种情况出现的概率不大,但是依然是有可能的出现的。因此,当业务上确实可能出现这种情况时,我们也必须多加防范。体贴的JDK也已经为我们考虑到了这种情况,使用AtomicStampedReference就可以很好的解决这个(ABA)问题。 ABA问题:简单讲就是多线程环境,2次读写中一个线程修改A->B,然后又B->A,另一个线程看到的值未改变,又继续修改成自己的期望值。当然我们如果不关心过程,只关心结果,那么这个就是无所谓的ABA问题。 为了解决ABA问题,伟大的java为我们提供了AtomicMarkableReference和AtomicStampedReference类,为我们解决了问题 AtomicStampedReference是利用版本戳的形式记录了每次改变以后的版本号,这样的话就不会存在ABA问题了,在这里我借鉴一下别人举得例子 举个通俗点的例子,你倒了一杯水放桌子上,干了点别的事,然后同事把你水喝了又给你重新倒了一杯水,你回来看水还在,拿起来就喝,如果你不管水中间被人喝过,只关心水还在,这就是ABA问题。如果你是一个讲卫生讲文明的小伙子,不但关心水在不在,还要在你离开的时候水被人动过没有,因为你是程序员,所以就想起了放了张纸在旁边,写上初始值0,别人喝水前麻烦先做个累加才能喝水。这就是AtomicStampedReference的解决方案。 Synchronized关键字 在Java中,synchronized关键字是用来控制线程同步的,就是在多线程的环境下,控制synchronized代码段不被多个线程同时执行。 1. 修饰方法 Synchronized修饰一个方法很简单,就是在方法的前面加synchronized,synchronized修饰方法和修饰一个代码块类似,只是作用范围不一样,修饰代码块是大括号括起来的范围,而修饰方法范围是整个函数。 public synchronized void method() { // todo } 写法一修饰的是一个方法,锁定了整个方法时的内容。 synchronized关键字不能继承。 虽然可以使用synchronized来定义方法,但synchronized并不属于方法定义的一部分,因此,synchronized关键字不能被继承。如果在父类中的某个方法使用了synchronized关键字,而在子类中覆盖了这个方法,在子类中的这个方法默认情况下并不是同步的,而必须显式地在子类的这个方法中加上synchronized关键字才可以。当然,还可以在子类方法中调用父类中相应的方法,这样虽然子类中的方法不是同步的,但子类调用了父类的同步方法,因此,子类的方法也就相当于同步了。这两种方式的例子代码如下: 在子类方法中加上synchronized关键字 class Parent { public synchronized void method() { } } class Child extends Parent { public synchronized void method() { } } 在子类方法中调用父类的同步方法 class Parent { public synchronized void method() { } } class Child extends Parent { public void method() { super.method(); } } 在定义接口方法时不能使用synchronized关键字。 构造方法不能使用synchronized关键字,但可以使用synchronized代码块来进行同步。 2. 修饰代码块 1) 一个线程访问一个对象中的synchronized(this)同步代码块时,其他试图访问该对象的线程将被阻塞 注意下面两个程序的区别 class SyncThread implements Runnable { private static int count; public SyncThread() { count = 0; } public void run() { synchronized(this) { for (int i = 0; i < 5; i++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } } public int getCount() { return count; } } public class Demo00 { public static void main(String args[]){ //test01 // SyncThread s1 = new SyncThread(); // SyncThread s2 = new SyncThread(); // Thread t1 = new Thread(s1); // Thread t2 = new Thread(s2); //test02 SyncThread s = new SyncThread(); Thread t1 = new Thread(s); Thread t2 = new Thread(s); t1.start(); t2.start(); } } test01的运行结果 test02的运行结果 当两个并发线程(thread1和thread2)访问同一个对象(syncThread)中的synchronized代码块时,在同一时刻只能有一个线程得到执行,另一个线程受阻塞,必须等待当前线程执行完这个代码块以后才能执行该代码块。Thread1和thread2是互斥的,因为在执行synchronized代码块时会锁定当前的对象,只有执行完该代码块才能释放该对象锁,下一个线程才能执行并锁定该对象 为什么上面的例子中thread1和thread2同时在执行。这是因为synchronized只锁定对象,每个对象只有一个锁(lock)与之相关联。 2) 当一个线程访问对象的一个synchronized(this)同步代码块时,另一个线程仍然可以访问该对象中的非synchronized(this)同步代码块。 例: class Counter implements Runnable{ private int count; public Counter() { count = 0; } public void countAdd() { synchronized(this) { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } } //非synchronized代码块,未对count进行读写操作,所以可以不用synchronized public void printCount() { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + " count:" + count); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } public void run() { String threadName = Thread.currentThread().getName(); if (threadName.equals("A")) { countAdd(); } else if (threadName.equals("B")) { printCount(); } } } public class Demo00{ public static void main(String args[]){ Counter counter = new Counter(); Thread thread1 = new Thread(counter, "A"); Thread thread2 = new Thread(counter, "B"); thread1.start(); thread2.start(); } } 运行结果 可以看见B线程的调用是非synchronized,并不影响A线程对synchronized部分的调用。从上面的结果中可以看出一个线程访问一个对象的synchronized代码块时,别的线程可以访问该对象的非synchronized代码块而不受阻塞。 3)指定要给某个对象加锁 /** * 银行账户类 */ class Account { String name; float amount; public Account(String name, float amount) { this.name = name; this.amount = amount; } //存钱 public void deposit(float amt) { amount += amt; try { Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } //取钱 public void withdraw(float amt) { amount -= amt; try { Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } public float getBalance() { return amount; } } /** * 账户操作类 */ class AccountOperator implements Runnable{ private Account account; public AccountOperator(Account account) { this.account = account; } public void run() { synchronized (account) { account.deposit(500); account.withdraw(500); System.out.println(Thread.currentThread().getName() + ":" + account.getBalance()); } } } public class Demo00{ //public static final Object signal = new Object(); // 线程间通信变量 //将account改为Demo00.signal也能实现线程同步 public static void main(String args[]){ Account account = new Account("zhang san", 10000.0f); AccountOperator accountOperator = new AccountOperator(account); final int THREAD_NUM = 5; Thread threads[] = new Thread[THREAD_NUM]; for (int i = 0; i < THREAD_NUM; i ++) { threads[i] = new Thread(accountOperator, "Thread" + i); threads[i].start(); } } } 运行结果 在AccountOperator 类中的run方法里,我们用synchronized 给account对象加了锁。这时,当一个线程访问account对象时,其他试图访问account对象的线程将会阻塞,直到该线程访问account对象结束。也就是说谁拿到那个锁谁就可以运行它所控制的那段代码。 当有一个明确的对象作为锁时,就可以用类似下面这样的方式写程序。 public void method3(SomeObject obj) { //obj 锁定的对象 synchronized(obj) { // todo } } 当没有明确的对象作为锁,只是想让一段代码同步时,可以创建一个特殊的对象来充当锁: class Test implements Runnable { private byte[] lock = new byte[0]; // 特殊的instance变量 public void method() { synchronized(lock) { // todo 同步代码块 } } public void run() { } } 3. 修饰一个静态的方法 Synchronized也可修饰一个静态方法,用法如下: public synchronized static void method() { // todo } 静态方法是属于类的而不属于对象的。同样的,synchronized修饰的静态方法锁定的是这个类的所有对象。 /** * 同步线程 */ class SyncThread implements Runnable { private static int count; public SyncThread() { count = 0; } public synchronized static void method() { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } public synchronized void run() { method(); } } public class Demo00{ public static void main(String args[]){ SyncThread syncThread1 = new SyncThread(); SyncThread syncThread2 = new SyncThread(); Thread thread1 = new Thread(syncThread1, "SyncThread1"); Thread thread2 = new Thread(syncThread2, "SyncThread2"); thread1.start(); thread2.start(); } } syncThread1和syncThread2是SyncThread的两个对象,但在thread1和thread2并发执行时却保持了线程同步。这是因为run中调用了静态方法method,而静态方法是属于类的,所以syncThread1和syncThread2相当于用了同一把锁。 4. 修饰一个类 Synchronized还可作用于一个类,用法如下: class ClassName { public void method() { synchronized(ClassName.class) { // todo } } } /** * 同步线程 */ class SyncThread implements Runnable { private static int count; public SyncThread() { count = 0; } public static void method() { synchronized(SyncThread.class) { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } } public synchronized void run() { method(); } } 本例的的给class加锁和上例的给静态方法加锁是一样的,所有对象公用一把锁 总结 A. 无论synchronized关键字加在方法上还是对象上,如果它作用的对象是非静态的,则它取得的锁是对象;如果synchronized作用的对象是一个静态方法或一个类,则它取得的锁是对类,该类所有的对象同一把锁。 B. 每个对象只有一个锁(lock)与之相关联,谁拿到这个锁谁就可以运行它所控制的那段代码。 C. 实现同步是要很大的系统开销作为代价的,甚至可能造成死锁,所以尽量避免无谓的同步控制。 2. 线程可见性 可见性-synchronized 可见性-volatile 内存屏障(memory barrier) 是一个CPU指令。基本上,它是这样一条指令: a) 确保一些特定操作执行的顺序; b) 影响一些数据的可见性(可能是某些指令执行后的结果)。编译器和CPU可以在保证输出结果一样的情况下对指令重排序,使性能得到优化。插入一个内存屏障, 相当于告诉CPU和编译器先于这个命令的必须先执行,后于这个命令的必须后执行。内存屏障另一个作用是强制更新一次不同CPU的缓存。例如,一个写屏障会 把这个屏障前写入的数据刷新到缓存,这样任何试图读取该数据的线程将得到最新值,而不用考虑到底是被哪个cpu核心或者哪颗CPU执行的。 volatile使用场景: volatile很适合用作状态标示量: 有序性 happend-before原则 1.程序次序规则:一个线程内,按照代码顺序,书写在前面的操作先行发生于书写在后面的操作;2.锁定规则:一个unLock操作先行发生于后面对同一个锁额lock操作;3.volatile变量规则:对一个变量的写操作先行发生于后面对这个变量的读操作;4.传递规则:如果操作A先行发生于操作B,而操作B又先行发生于操作C,则可以得出操作A先行发生于操作C;5.线程启动规则:Thread对象的start()方法先行发生于此线程的每个一个动作;6.线程中断规则:对线程interrupt()方法的调用先行发生于被中断线程的代码检测到中断事件的发生;7.线程终结规则:线程中所有的操作都先行发生于线程的终止检测,我们可以通过Thread.join()方法结束、Thread.isAlive()的返回值手段检测到线程已经终止执行;8.对象终结规则:一个对象的初始化完成先行发生于他的finalize()方法的开始;

优秀的个人博客,低调大师

服务器安装笔记

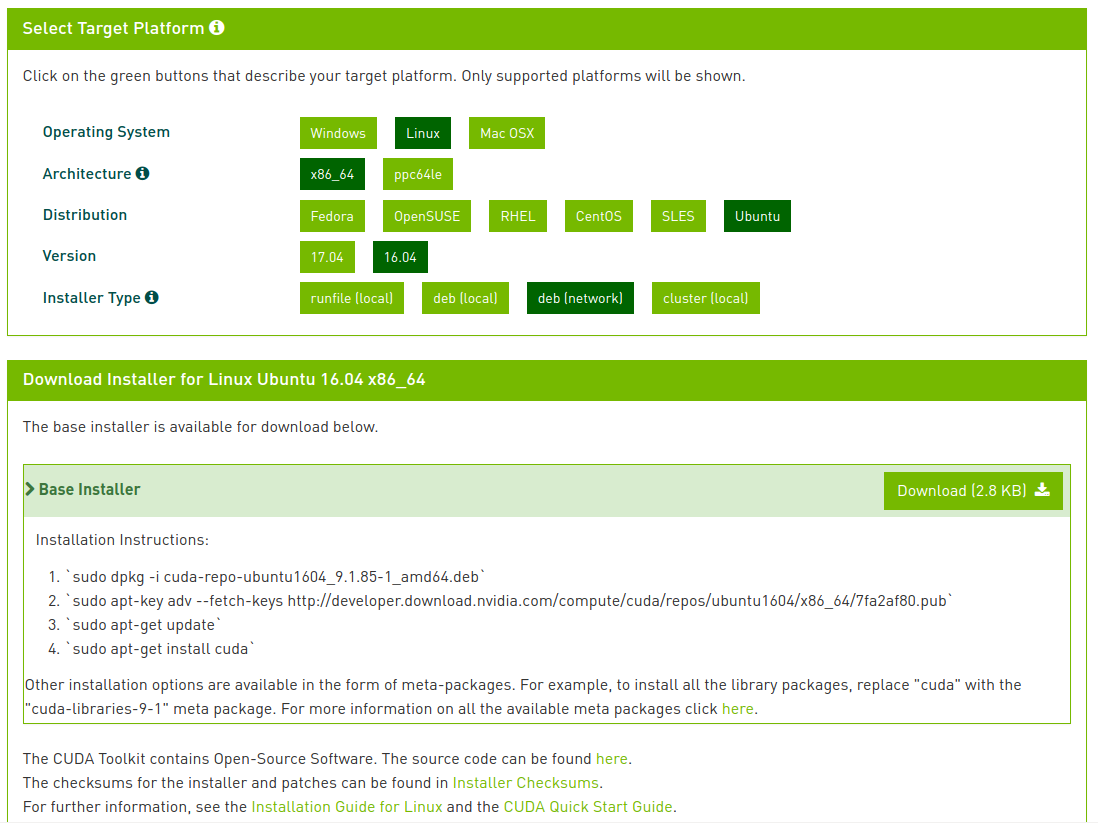
搞了一个月总算申请到了台 NVIDIA 机器, 接下来是安装过程 NVIDIA 驱动及Cuda环境安装 1. 查看系统架构 $ uname -am Linux aisrv 4.4.0-87-generic #110-Ubuntu SMP Tue Jul 18 12:55:35 UTC 2017 x86_64 x86_64 x86_64 GNU/Linux 安装 ubuntu 常用包 $ sudo apt install ubuntu-drivers-common $ ubuntu-drivers devices == /sys/devices/pci0000:00/0000:00:03.0/0000:03:00.0 == vendor : NVIDIA Corporation modalias : pci:v000010DEd00001B06sv00001462sd00003609bc03sc00i00 driver : nvidia-384 - distro non-free driver : nvidia-387 - third-party non-free recommended driver : xserver-xorg-video-nouveau - distro free builtin 安装docker $ sudo apt-get install \ apt-transport-https \ ca-certificates \ curl \ software-properties-common $ curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo apt-key add - $ sudo apt-key fingerprint 0EBFCD88 $ sudo add-apt-repository \ "deb [arch=amd64] https://download.docker.com/linux/ubuntu \ $(lsb_release -cs) \ stable" $ sudo apt-get update $ sudo apt-get install docker-ce # 免sudo 运行 docker # 查看是否存在 docker group $ cat /etc/group | grep docker docker:x:999: # 当前是存在 docker 组, 如不存在,通过 $ sudo groupadd docker 创建 # 添加当前用户到组中 $ sudo usermod -aG docker $(whoami) $ sudo service docker restart # 退出当前登录, 然后重新登录即可 2. 安装 GPU 驱动 安装 NVIDIA 驱动(可跳过) # 自动安装驱动,有可能失败 $ sudo ubuntu-drivers autoinstall # 手动安装, 如上述 ubuntu-drivers devices命令结果来看,安装 $ sudo apt install nvidia-384 $ sudo reboot 安装完成之后简单测试: $ nvidia-smi Sat Jan 6 12:12:43 2018 +-----------------------------------------------------------------------------+ | NVIDIA-SMI 384.90 Driver Version: 384.90 | |-------------------------------+----------------------+----------------------+ | GPU Name Persistence-M| Bus-Id Disp.A | Volatile Uncorr. ECC | | Fan Temp Perf Pwr:Usage/Cap| Memory-Usage | GPU-Util Compute M. | |===============================+======================+======================| | 0 GeForce GTX 108... Off | 00000000:03:00.0 Off | N/A | | 29% 37C P0 53W / 250W | 0MiB / 11171MiB | 3% Default | +-------------------------------+----------------------+----------------------+ +-----------------------------------------------------------------------------+ | Processes: GPU Memory | | GPU PID Type Process name Usage | |=============================================================================| | No running processes found | +-----------------------------------------------------------------------------+ 安装 cuda 包 $ lspci | grep -i nvidia 03:00.0 VGA compatible controller: NVIDIA Corporation Device 1b06 (rev a1) 03:00.1 Audio device: NVIDIA Corporation Device 10ef (rev a1) 进入到 GPU 官网, 按当前服务器配置进行选择,并配置: GPU配置 上述使用的是网络安装的方式进行安装. 安装完成之后需要重启机器 安装 cuDNN 库 caffe , tensorflow等DL专用的深度学习库 $ wget https://developer.nvidia.com/rdp/cudnn-download#a-collapse731-92 以 tensorflow为例: $ export DEVICES=$(\ls /dev/nvidia* | xargs -I{} echo '--device {}:{}') $ docker run -it --rm $DEVICES -v /usr/lib64/nvidia/:/usr/local/nvidia/lib64 tensorflow/tensorflow:latest-gpu bash 3. 安装docker 镜像 通过 tensorflow 官方镜像来构建自己的系统镜像 参见Dockerfile.gpu 4. 挂载 GPU 节点 如上述内容 tensorflow 的例子,相似 在 docker 环境内部安装 cuda 相关的 libraries 之后, 将主机上的设备节点直接映射到 docker 内部使用即可 其他问题 总结 在 docker 中使用宿主机的 GPU 主要是将对应的设备节点直接映射到 docker 内部即可 KVM 中使用 NVIDIA 则是通过虚拟化的方式,详细参见GPU Virtualization with KVM / QEMU 参考 GPU Virtualization with KVM / QEMUcuda – 从docker容器使用GPU?docker cuda - Dockerfiledocker-hub cudainstall-from-a-package

优秀的个人博客,低调大师

SDWebImage学习笔记之NSMapTable

NSDictionary/NSMutableArray浅析 我们在使用NSDictionary/NSMutableArray时,通常会使用NSString对象作为key,因为key必须遵循NSCopying协议,见NSMutableArray中的方法: - (void)setObject:(ObjectType)anObject forKey:(KeyType <NSCopying>)aKey; 在NSDictionary/NSMutableArray对象中,aKey对象被copy一份后存入,anObject对象则被强引用。来看一段代码: NSMutableDictionary *aDictionary = [[NSMutableDictionary alloc] initWithCapacity:0]; { NSString *aKey = @"akey"; NSObject *aObject = [[NSObject alloc] init]; [aDictionary setObject:aObject forKey:aKey]; } NSLog(@"dictionary: %@", aDictionary); 打印日志: dictionary: { akey = "<NSObject: 0x60400001d3b0>"; } 本来作用于结束后,aKey变量指向的NSString对象(简称aKey对象)和aObject变量指向的NSObject对象(简称aObject对象)应该被自动释放,但是aDictionary变量指向的NSMutableDictionary对象(简称aDictionary对象)持有一份aObject对象的强引用,所以打印日志时,aDictionary对象不为空。 现在有一个Teacher类表示班主任信息,包含姓名name属性和年龄age属性,另有一个Student类表示学生信息,也包含姓名name属性和年龄age属性。那么一个班包含一个班主任(Teacher对象)和n个学生(Student数组),为了统计一个班的信息,需要把班主任和学生的信息及对应关系保存下来。 // Teacher.h @interface Teacher : NSObject @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Teacher.m @implementation Teacher @end // Student.h @interface Student : NSObject @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Student.m @implementation Student @end // ViewController.m { NSMutableDictionary *aDictionary = [[NSMutableDictionary alloc] initWithCapacity:0]; Teacher *teacher = [[Teacher alloc] init]; teacher.name = @"teacher"; teacher.age = 30; NSMutableArray *aArray = [[NSMutableArray alloc] initWithCapacity:0]; for (int i = 0; i < 3; i++) { Student *student = [[Student alloc] init]; student.name = [NSString stringWithFormat:@"student%d", i]; student.age = i; [aArray addObject:student]; } [aDictionary setObject:aArray forKey:teacher.name]; NSLog(@"%@", aDictionary); } 打印日志: dictionary:{ teacher = ( "<Student: 0x60000003aa00>", "<Student: 0x60000003a9c0>", "<Student: 0x60000003aa80>" ); } 这里将班主任的姓名作为key,这样会损失其他信息。如果想要将teacher对象作为key,则需要让Teacher类遵循NSCopying协议,而且NSDictionary/NSMutable使用hash表来实现key和value之间的映射和存储,所以作为key值的类型必须重写++- (NSUInteger)hash++和++- (BOOL)isEqual:(id)object++两个方法,其中hash方法计算该对象的hash值,hash值决定该对象在hash表中存储的位置,isEqual方法通过hash值来定位对象在hash表中的位置。具体代码如下: // Teacher.h @interface Teacher : NSObject<NSCopying> @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Teacher.m @implementation Teacher - (id)copyWithZone:(NSZone *)zone { Teacher *teacher = [[Teacher allocWithZone:zone] init]; teacher.name = self.name; teacher.age = self.age; return teacher; } - (BOOL)isEqual:(id)object { // 比较hash值是否相等 return [self hash] == [object hash]; } - (NSUInteger)hash { // 调用父类的hash方法,也可以自定义 return [super hash]; } 打印日志: dictionary:{ "<Teacher: 0x600000027940>" = ( "<Student: 0x60c00022fa20>", "<Student: 0x60c00022fa00>", "<Student: 0x60c00022f960>" ); } NSMapTable浅析 NSMapTable继承自NSObject,自iOS6.0开始使用,NSMapTable是可变的。 NS_CLASS_AVAILABLE(10_5, 6_0) @interface NSMapTable<KeyType, ObjectType> : NSObject <NSCopying, NSCoding, NSFastEnumeration> NSMapTable有两个指定初始化方法和一个便捷初始化方法: // 指定初始化方法 - (instancetype)initWithKeyOptions:(NSPointerFunctionsOptions)keyOptions valueOptions:(NSPointerFunctionsOptions)valueOptions capacity:(NSUInteger)initialCapacity NS_DESIGNATED_INITIALIZER; - (instancetype)initWithKeyPointerFunctions:(NSPointerFunctions *)keyFunctions valuePointerFunctions:(NSPointerFunctions *)valueFunctions capacity:(NSUInteger)initialCapacity NS_DESIGNATED_INITIALIZER; // 便捷初始化方法 + (NSMapTable<KeyType, ObjectType> *)mapTableWithKeyOptions:(NSPointerFunctionsOptions)keyOptions valueOptions:(NSPointerFunctionsOptions)valueOptions; 初始化方法方法中有两个参数keyOptions和valueOptions,都是NSPointerFunctionsOptions类型,NSPointerFunctionsOptions是一个枚举类型, typedef NS_OPTIONS(NSUInteger, NSPointerFunctionsOptions) { // Memory options are mutually exclusive // default is strong NSPointerFunctionsStrongMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (0UL << 0), // use strong write-barrier to backing store; use GC memory on copyIn #if (TARGET_OS_MAC && !(TARGET_OS_EMBEDDED || TARGET_OS_IPHONE)) || TARGET_OS_WIN32 NSPointerFunctionsZeroingWeakMemory NS_ENUM_DEPRECATED_MAC(10_5, 10_8) = (1UL << 0), // deprecated; uses GC weak read and write barriers, and dangling pointer behavior otherwise #endif NSPointerFunctionsOpaqueMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (2UL << 0), NSPointerFunctionsMallocMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (3UL << 0), // free() will be called on removal, calloc on copyIn NSPointerFunctionsMachVirtualMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (4UL << 0), NSPointerFunctionsWeakMemory API_AVAILABLE(macos(10.8), ios(6.0), watchos(2.0), tvos(9.0)) = (5UL << 0), // uses weak read and write barriers appropriate for ARC // Personalities are mutually exclusive // default is object. As a special case, 'strong' memory used for Objects will do retain/release under non-GC NSPointerFunctionsObjectPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (0UL << 8), // use -hash and -isEqual, object description NSPointerFunctionsOpaquePersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (1UL << 8), // use shifted pointer hash and direct equality NSPointerFunctionsObjectPointerPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (2UL << 8), // use shifted pointer hash and direct equality, object description NSPointerFunctionsCStringPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (3UL << 8), // use a string hash and strcmp, description assumes UTF-8 contents; recommended for UTF-8 (or ASCII, which is a subset) only cstrings NSPointerFunctionsStructPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (4UL << 8), // use a memory hash and memcmp (using size function you must set) NSPointerFunctionsIntegerPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (5UL << 8), // use unshifted value as hash & equality NSPointerFunctionsCopyIn API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (1UL << 16), // the memory acquire function will be asked to allocate and copy items on input }; 常用的枚举值及对应的含义如下: NSPointerFunctionsStrongMemory: 强引用存储对象 NSPointerFunctionsWeakMemory: 弱引用存储对象 NSPointerFunctionsCopyIn:copy存储对象 就是说,如果NSMapTable的初始化方法为: NSMapTable *aMapTable = [[NSMapTable alloc] initWithKeyOptions:NSPointerFunctionsCopyIn valueOptions:NSPointerFunctionsStrongMemory capacity:0]; 或 NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsCopyIn valueOptions:NSPointerFunctionsStrongMemory]; 那么就等同于NSMutableDictionay的初始化方法: NSMutableDictionary *aDictionary = [[NSMutableDictionary alloc] initWithCapacity:0]; 或 NSMutableDictionary *aDictionary = [NSMutableDictionary dictionary]; 若初始方法修改为 NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsWeakMemory valueOptions:NSPointerFunctionsStrongMemory]; 即对key值进行弱引用,就可以不用让Teacher类遵循NSCopying协议和重新跟hash有关的两个方法,代码如下: // Teacher.h @interface Teacher : NSObject @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Teacher.m @implementation Teacher @end // ViewController.m Teacher *teacher = [[Teacher alloc] init]; teacher.name = @"teacher"; teacher.age = 30;NSMutableArray *aArray = [[NSMutableArray alloc] initWithCapacity:0]; for (int i = 0; i < 3; i++) { Student *student = [[Student alloc] init]; student.name = [NSString stringWithFormat:@"student%d", i]; student.age = i; [aArray addObject:student]; } NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsWeakMemory valueOptions:NSPointerFunctionsStrongMemory]; [aMapTable setObject:aArray forKey:teacher]; NSLog(@"%@", aMapTable); 打印日志: NSMapTable { [10] <Teacher: 0x604000038a40> -> ( "<Student: 0x60400003c640>", "<Student: 0x60400003c660>", "<Student: 0x60400003c620>" ) } 这样的方法可以快速的将NSObject对象作为key存入到“字典”中。 由于NSDictionary/NSMutableArray会强引用value,使得value的引用计数+1,加入不希望怎么做,可以用NSMapTable来实现。 NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsStrongMemory valueOptions:NSPointerFunctionsWeakMemory]; { NSObject *keyObject = [[NSObject alloc] init]; NSObject *valueObject = [[NSObject alloc] init]; [aMapTable setObject:valueObject forKey:keyObject]; NSLog(@"NSMapTable:%@", aMapTable); } NSLog(@"NSMapTable:%@", aMapTable); 打印日志: NSMapTable:NSMapTable { [6] <NSObject: 0x60c00000c690> -> <NSObject: 0x60c00000c730> } NSMapTable:NSMapTable { } 第一个NSLog打印出了key-value值,等到object对象指向的NSObject对象超出作用域,释放该对象,由于aMapTable弱引用object对象,aMapTable的中的key-value值会被安全的删除,第二个NSLog打印出的值为空。 NSMapTable与NSDictionary/NSMutableDictionary对比 NSDcitionary有一个可变类型NSMutableDictionary,NSMapTable没有可变类型,它本身就是可变的; NSDcitionary/NSMutableDictionary中对于key和value的内存管理方法唯一,即对key进行copy,对value进行强引用,而NSMapTable没有限制; NSDcitionary中对key值进行copy,不可改变,通常用字符串作为key值,只是key->object的映射,而NSMapTable的key是可变的对象,既可以实现key->object的映射,又可以实现object->object的映射。 遗留的问题 笔者才疏学浅,对NSMapTable与NSDictionary的内部结构了解不是很深,不清楚key-value是通过怎么样的方式绑定起来的,假如看到这篇文章的朋友有所了解,希望可以指点一二。

优秀的个人博客,低调大师

java并发编程笔记--CopyOnWriteArrayList

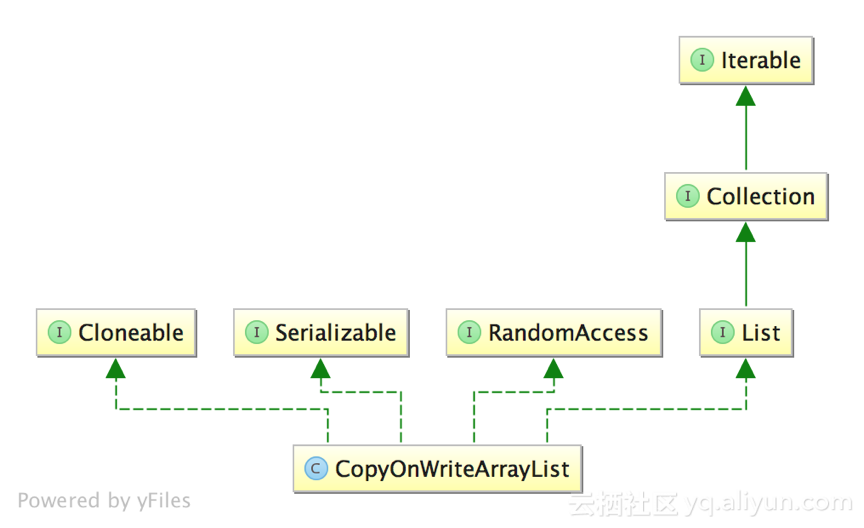
1 描述 1) CopyOnWriteArrayList是List的一种线程安全的实现;2) 其实现原理采用”CopyOnWrite”的思路(不可变元素),即所有写操作,包括:add,remove,set等都会触发底层数组的拷贝,从而在写操作过程中,不会影响读操作;避免了使用synchronized等进行读写操作的线程同步;3) CopyOnWrite对于写操作来说代价很大,故不适合于写操作很多的场景;当遍历操作远远多于写操作的时候,适合使用CopyOnWriteArrayList;4) 迭代器以”快照”方式实现,在迭代器创建时,引用指向List当前状态的底层数组,所以在迭代器使用的整个生命周期中,其内部数据不会被改变;并且集合在遍历过程中进行修改,也不会抛出ConcurrentModificationException;迭代器在遍历过程中,不会感知集合的add,remove,set等操作;5) 因为迭代器指向的是底层数组的”快照”,因此也不支持对迭代器本身的修改操作,包括add,remove,set等操作,如果使用这些操作,将会抛出UnsupportedOperationException;6) 相关Happens-Before规则:一个线程将元素放入集合的操作happens-before于其它线程访问/删除该元素的操作; 2 类图 主要角色:1) Iterable接口:定义创建迭代器操作,赋予实现类创建迭代器的能力;2) Collection接口:定义集合基本操作,所有集合类都需实现该接口;3) List接口:定义列表基本操作,所有列表类都需要实现该接口;4) Serializable接口:标记接口,允许对象序列化;5) Cloneable接口:标记接口,允许对象被克隆,如果类没有实现Cloneable接口,调用类对象的clone方法抛出CloneNotSupportedException;6) RandomAccess接口:标记接口,用来表明其支持快速(通常是固定时间)随机访问(比如:ArrayList支持快速随机访问,所以使用普通遍历方式效率更高;而LinkedList则更适合顺序访问,所以使用迭代器的方式效率更高);JDK中推荐的是对List集合尽量要实现RandomAccess接口;7) COWIterator:CopyOnWriteArrayList对应的迭代器;不支持写操作,当调用写操作时,将抛出UnsupportedOperationException异常;8) COWSubList:调用subList方法时,CopyOnWriteArrayList对应的子列表对象,和CopyOnWriteArrayList共享同一个array对象,使用使用offset和size维护对array的位置偏移;且当CopyOnWriteArrayList调用写操作更新array引用时,COWSubList对应的操作会抛出ConcurrentModificationException;9) COWSubListIterator:COWSubList对应的迭代器,底层通过COWIterator实现,使用offset和size维护对array的位置偏移;不支持写操作,当调用写操作时,将抛出UnsupportedOperationException异常; 3 主要实现 3.1 基本属性定义 /** * 互斥锁,用于保护所有修改操作,通过Unsafe进行初始化 */ final transient ReentrantLock lock = new ReentrantLock(); /** * 存放数据的底层数据结构,只能通过getArray()和setArray()两个方法访问; */ private transient volatile Object[] array; /** * <h2>array属性的getter和setter</h2> * <p>声明为非private类型,以便于CopyOnWriteArraySet访问</p> */ final Object[] getArray() { return array; } final void setArray(Object[] array) { this.array = array; } 1) lock属性:互斥锁,用于控制CopyOnWriteArrayList所有的写操作的同步,以及对应的COWSubList的所有读写操作的同步;2) array属性:Object[]数组,用于存放集合元素的底层数据结构;array只允许CopyOnWriteArrayList定义的getter和setter方法访问;(原因?) 3.2 构造器定义 /** * <h2>初始化array为空数组</h2> */ public CopyOnWriteArrayList() { setArray(new Object[0]); } /** * <h2>将集合参数中的元素作为当前集合对象的元素</h2> */ public CopyOnWriteArrayList(Collection<? extends E> c) { Object[] elements; if (c.getClass() == CopyOnWriteArrayList.class) { elements = ((CopyOnWriteArrayList<?>) c).getArray(); } else { elements = c.toArray(); //注:c.toArray()可能不一定返回Object[] if (elements.getClass() != Object[].class) { elements = Arrays.copyOf(elements, elements.length, Object[].class); } } } /** * <h2>将数组参数中的元素作为当前集合对象的元素</h2> */ public CopyOnWriteArrayList(E[] toCopyIn) { //注:传入数组对象并不是传递引用,而是新建一个数组拷贝原有数组 setArray(Arrays.copyOf(toCopyIn, toCopyIn.length, Object[].class)); } 1) 定义了3个构造函数,第一个构造函数为无参构造函数,默认初始化array为空数组;后两个构造函数分别接收Collection对象和数组对象作为参数,使用参数的元素作为初始化array的元素;2) 使用数组对象作为参数时,需要通过浅拷贝的方式初始化array,而非直接使用数组对象的引用; 3.3 查找元素 @Override public int size() { return getArray().length; } @Override public boolean isEmpty() { return size() == 0; } private static boolean eq(Object o1, Object o2) { return (o1 == null) ? o2 == null : o1.equals(o2); } private static int indexOf(Object o, Object[] elements, int index, int fence) { if (o == null) { for (int i = index; i < fence; i++) { if (elements[i] == null) { return i; } } } else { for (int i = index; i < fence; i++) { if (o.equals(elements[i])) { return i; } } } return -1; } private static int lastIndexOf(Object o, Object[] elements, int index) { if (o == null) { for (int i = index; i >= 0; i--) { if (elements[i] == null) { return i; } } } else { for (int i = index; i >= 0; i--) { if (o.equals(elements[i])) { return i; } } } return -1; } @Override public boolean contains(Object o) { Object[] elements = getArray(); return indexOf(o, elements, 0, elements.length) >= 0; } @Override public int indexOf(Object o) { Object[] elements = getArray(); return indexOf(o, elements, 0, elements.length); } public int indexOf(E e, int index) { Object[] elements = getArray(); return indexOf(e, elements, index, elements.length); } public int lastIndexOf(Object o) { Object[] elements = getArray(); return lastIndexOf(o, elements, elements.length - 1); } public int lastIndexOf(E e, int index) { Object[] elements = getArray(); return lastIndexOf(e, elements, index); } 1) CopyOnWriteArrayList的所有读操作都不需要加锁;2) 单个元素的访问,直接通过索引访问底层数组;3) 查找遍历等涉及多个元素的读操作,都会针对array的快照进行,即每次操作开始前使用名为elements的Object[]局部变量存放array当前的引用。在遍历过程中,array发生变化时,遍历操作遍历的依然是原来的快照,从而保证了读操作不需要加锁,写操作也不会发生ConcurrentModificationException异常; 3.4 新增元素 @Override public boolean add(E e) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); int len = elements.length; Object[] newElements = Arrays.copyOf(elements, len + 1); newElements[len] = e; setArray(newElements); return true; } finally { lock.unlock(); } } 1) 所有的新增元素操作都需要使用lock加互斥锁;2) 新增元素需要考虑添加元素的个数(单个/集合),添加元素的位置(末尾/非末尾); 3.5 更新元素 @Override public E set(int index, E element) { //加锁 final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); E oldValue = get(elements, index); //待更新元素不是原来的元素,才执行copyOnWrite if (oldValue != element) { int len = elements.length; Object[] newElements = Arrays.copyOf(elements, len); newElements[index] = element; setArray(newElements); } else { // 注:再次更新引用,为了触发volatile的语义,通知所有线程 setArray(elements); } return oldValue; } finally { //解锁 lock.unlock(); } } 1) 同添加元素操作一样,更新元素也需要使用lock加互斥锁;2) 需要注意的是,即使待更新元素和集合中元素引用相同,也需要执行setArray()操作,以便触发volatile语义,通知所有线程; 3.6 删除元素 @Override public E remove(int index) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); int len = elements.length; E oldValue = get(elements, index); //计算需要移动的元素个数 int numMoved = len - index - 1; //如果删除元素在数组末尾 if (numMoved == 0) { setArray(Arrays.copyOf(elements, len - 1)); } else { Object[] newElements = new Object[len - 1]; System.arraycopy(elements, 0, newElements, 0, index); System.arraycopy(elements, index + 1, newElements, index, numMoved); setArray(newElements); } return oldValue; } finally { lock.unlock(); } } private boolean remove(Object o, Object[] snapshot, int index) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] current = getArray(); int len = current.length; //如果此时已经进行过写操作 if (snapshot != current) { //校准索引 FINDINDEX: { //在当前代码获取锁时,有可能len已经小于index,故需要取二者中较小的; int prefix = Math.min(index, len); //情形1:[0,index)区间的元素有删除操作,导致index所指元素前移 for (int i = 0; i < prefix; i++) { //如果元素引用已经替换 if (current[i] != snapshot[i] && eq(o, current[i])) { index = i; break FINDINDEX; } } //情形2:当前数组删除元素较多,导致数组长度小于原先index if (index >= len) { return false; } //情形3:[0,index)区间的元素没有删除操作,index所指元素未移动 if (current[index] == o) { break FINDINDEX; } //情形4:[0,index)区间有添加元素操作,导致index所指元素后移,重新定位元素索引 index = indexOf(o, current, index, len); } } Object[] newElements = new Object[len - 1]; System.arraycopy(current, 0, newElements, 0, index); System.arraycopy(current, index + 1, newElements, index, len - index - 1); setArray(newElements); return true; } finally { lock.unlock(); } } @Override public boolean remove(Object o) { Object[] snapshot = getArray(); int index = indexOf(o, snapshot, 0, snapshot.length); return index >= 0 && remove(o, snapshot, index); } 1) 删除元素时,同样需要加互斥锁,但出于效率考虑,在加锁前都检测待删除元素是否存在,如果不存在则不加锁,直接返回false;2) 由于判断元素是否存在的操作时未加锁,不能保证删除方法执行过程中,其它线程进行写操作。故在加锁后,依然需要对索引进行校准,增加了删除操作实现难度; 3.7 迭代器实现 @Override public Iterator<E> iterator() { return new COWIterator<E>(getArray(), 0); } @Override public ListIterator<E> listIterator() { return new COWIterator<E>(getArray(), 0); } @Override public ListIterator<E> listIterator(int index) { Object[] elements = getArray(); int len = elements.length; if (index < 0 || index > len) { throw new IndexOutOfBoundsException("Index: " + index); } return new COWIterator<E>(elements, index); } /** * <h2>Copy-On-Write迭代器定义</h2> * <p>限定为final,表示不可以被继承</p> */ static final class COWIterator<E> implements ListIterator<E> { /** * 限定为final,指定为不可变对象,存放arry快照 */ private final Object[] snapshot; /** * 迭代器索引 */ private int cursor; private COWIterator(Object[] elements, int initialCursor) { cursor = initialCursor; snapshot = elements; } public boolean hasNext() { return cursor < snapshot.length; } public boolean hasPrevious() { return cursor > 0; } @SuppressWarnings("unchecked") public E next() { if (!hasNext()) { throw new NoSuchElementException(); } return (E) snapshot[cursor++]; } @SuppressWarnings("unchecked") public E previous() { if (!hasPrevious()) { throw new NoSuchElementException(); } return (E) snapshot[--cursor]; } public int nextIndex() { return cursor; } public int previousIndex() { return cursor - 1; } /** * Not supported. Always throws UnsupportedOperationException. * * @throws UnsupportedOperationException always; {@code remove} * is not supported by this iterator. */ public void remove() { throw new UnsupportedOperationException(); } /** * Not supported. Always throws UnsupportedOperationException. * * @throws UnsupportedOperationException always; {@code set} * is not supported by this iterator. */ public void set(E e) { throw new UnsupportedOperationException(); } /** * Not supported. Always throws UnsupportedOperationException. * * @throws UnsupportedOperationException always; {@code add} * is not supported by this iterator. */ public void add(E e) { throw new UnsupportedOperationException(); } @Override public void forEachRemaining(Consumer<? super E> action) { Objects.requireNonNull(action); Object[] elements = snapshot; final int size = elements.length; for (int i = cursor; i < size; i++) { @SuppressWarnings("unchecked") E e = (E) elements[i]; action.accept(e); } cursor = size; } } 1) COWIterator迭代器实现是基于快照的,即在调用iterator()方法创建迭代器时,传入array的引用作为快照; 通过一个整型游标记录当前访问到元素的索引;2) 因为迭代器是基于快照的,故所有读操作都无须加锁,且迭代过程中,对CopyOnWriteArrayList集合的修改不会影响到迭代操作,也不会抛出ConcurrentModificationException;3) 注意:因为COWSubList是作为CopyOnWriteArrayList的子列表的,所有操作都依赖于array,所以COWSubList的所有操作都必须检测array是否有改变,并且读写操作都要加锁,以保证写操作替换array的时候,没有读操作同步进行; 4 适用场景 4.1 小数据量,读多写少 数据量较小,读操作尤其是遍历操作远多于写操作时候,适合使用CopyOnWriteArrayList。 5 缺点&权衡点 5.1 写操作耗时更多 不可变对象的每次写操作就要进行一次copy/new操作,带来的性能消耗随着copy的数据量显著增加,包括内存的消耗以及copy/new过程的时间消耗;故不适合copy/new数据量很大,并且写操作很多的场景。 5.2 集合占用内存更多 使用Copy-On-Write,如果短时间有大量读伴随着写,则会有很多”快照”引用得不到释放,占用大量内存。 6 应用案例 7 相关知识点 7.1 迭代器模式 7.2 CopyOnWriteArraySet 8 问题思考 1)CopyOnWriteList如何保证在遍历的过程中修改集合不会触发ConcurrentModificationException?2)为什么CopyOnWriteList的迭代器不支持写操作?3)如下代码为什么不直接使用array,而要通过getArray方法? 4)加锁的代码为什么要按照如下方式写?是要防止锁的引用改变吗? 参考 [Java多线程系列--“JUC集合”02之 CopyOnWriteArrayList]()sun.misc.Unsafe类的使用CopyOnWriteArrayList解读

优秀的个人博客,低调大师

《大型网站技术架构》笔记

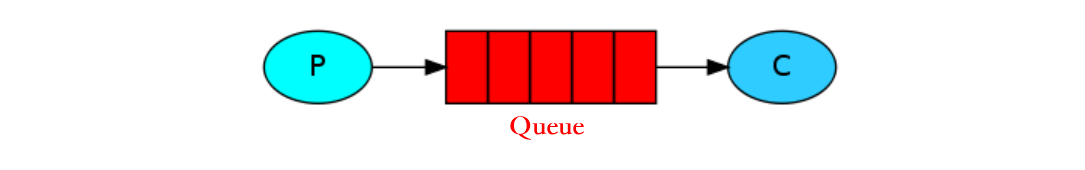
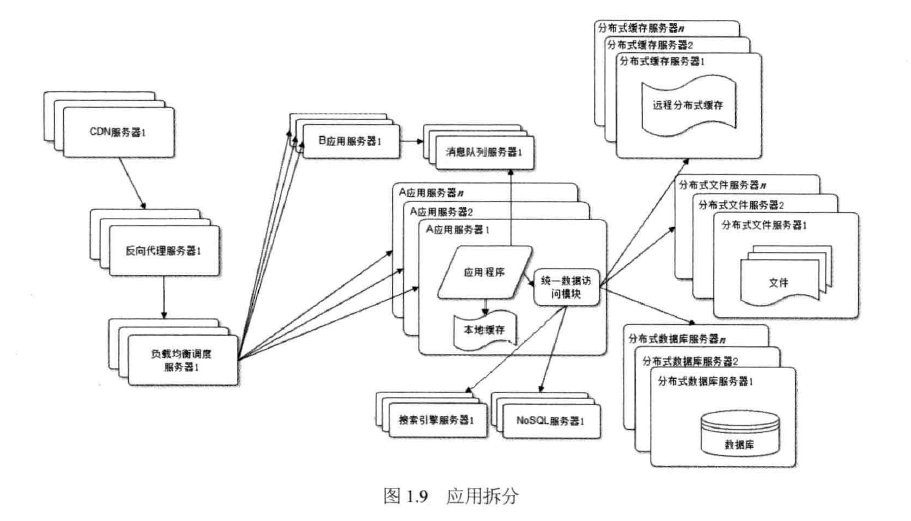
核心原理与案例分析 分为三个部分,应用区、文件区、DB区: 大型网站核心架构要素:性能、可用性、伸缩性、扩展性、安全性 WEB前端性能优化:减少http请求,合并CSS、合并JavaScript、合并图片。使用浏览器缓存。启用压缩。CSS放页面最上面,JS放页面最下面。减少Cookie传输。CDN加速。反向代理。 缓存:将数据存储在相对较高访问速度的存储介质中。缓存的内容为:读写比例高、很少变化的数据。 分布式缓存:memcached 消息队列异步处理 线程数量和CPU内核数成正比 RAID0:并发写入每块磁盘 RAID1:两块磁盘都写同样的 RAID10 RAID5: HDFS取代RAID 预发布服务器:不添加在负载均衡中的完全一样的服务器 灰度发布 几种负载均衡方式:HTTP重定向负载均衡、DNS域名解析负载均衡、反向代理负载均衡、IP负载均衡、直接路由负载均衡(修改MAC,LVS) 负载均衡算法:RR轮询、WRR加权轮询、随机、最少连接、源地址散列 70%的WEB攻击来自XSS攻击和SQL注入攻击 消毒、禁止页面JavaScript访问带有HttpOnly属性的Cookie CSRF:跨站点请求伪造 开源WAF,web应用防火墙:ModSecurity 信息加密技术:单向散列加密、对称加密、非对称加密 单向散列算法:MD5、SHA 对称加密:DES、RC 非对称加密:RSA 贝叶斯分类算法 秒杀系统的应对策略:秒杀系统独立部署、秒杀商品页面静态化、租借秒杀活动网络带宽、动态生成随机下单页面URL 首页不应该访问数据库,首页最好是静态的

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册