首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10011篇文章
优秀的个人博客,低调大师

PHP知识点笔记

显示错误:PDOException could not find driver. 是表示PDO没有安装对应数据库的扩展,比如没有安装PDO_mysql http://pecl.php.net/package/PDO_MYSQL 下载源码 phpize ./configure --with-php-config=/usr/local/php/bin/php-config ./make ./make install phpExcel的使用需要使用到php的xmlreader和xmlwriter扩展 如果你是使用yum安装php 就直接使用yum install php-xml来进行安装 php的define不能重复定义 比如: 1 2 3 4 5 6 7 <?php define( "TEST" , "11" ); define( "TEST" , "22" ); echo TEST; 1 1 2 3 4 5 6 7 [yejianfeng@xen193v ~/handcode]$ php test.php PHP Notice: Constant TEST already defined in /home/yejianfeng/handcode/test.php on line 4 Notice: Constant TEST already defined in /home/yejianfeng/handcode/test.php on line 4 11 PHP如何获取本地所有变量 $localVariables = compact(array_keys(get_defined_vars())); 安装php模块可以这么安装 PHP_PDO_SHARED=1 pecl install pdo_mysql mysql的字符编码 mysql一般默认的客户端字符编码为:latin1 mysql的字符编码有几种: mysql> show variables like "character_set_%"; +--------------------------+----------------------------+ | Variable_name | Value | +--------------------------+----------------------------+ | character_set_client | utf8 | | character_set_connection | utf8 | | character_set_database | latin1 | | character_set_filesystem | binary | | character_set_results | utf8 | | character_set_server | latin1 | | character_set_system | utf8 | | character_sets_dir | /usr/share/mysql/charsets/ | +--------------------------+----------------------------+ 其中信息输入路径是 client - connection - server 信息输出路径是 server - connection - result 输入set names utf8是临时设置client和connection的字符编码 如何在PHP中初始化mysql的字符编码? 有两种方法可以初始化设置: 1 1 2 3 $pdo = new PDO( "mysql:host={$config['host']};dbname={$config['dbname']};port={$config['port']}" , $config [ 'user' ], $config [ 'password' ], array (PDO::MYSQL_ATTR_INIT_COMMAND => "SET NAMES utf8" )); 2 1 2 3 4 5 $pdo = new PDO( "mysql:host={$config['host']};dbname={$config['dbname']};port={$config['port']}" , $config [ 'user' ], $config [ 'password' ]); $pdo -> exec ( 'set names utf8' ); PHP的PDO扩展 使用php如果要使用PDO,你需要安装的扩展除了PDO,还要各种数据库的驱动,PDO扩展是定义了一系列接口,但是你不可以使用PDO扩展直接操作数据库,需要安装制定PDO驱动扩展 PDO扩展的说明:http://www.php.net/manual/en/intro.pdo.php PDO扩展只能在PHP 5.0之上使用(使用了php的OO属性) 针对不同的数据库的扩展有: 为什么PDO的prepare不能打出最后的sql 使用PDO一直有一个郁闷的地方,就是使用prepare的时候想要将最后执行的sql打出来做log,发现没有方法。。。 后来想了想,prepare是mysql的语句,那么PDO的prepare和execute实际上是对mysql发送了几次请求,prepare,set,execute mysql> PREPARE stmt1 FROM 'SELECT SQRT(POW(?,2) + POW(?,2)) AS hypotenuse'; mysql> SET @a = 3; mysql> SET @b = 4; mysql> EXECUTE stmt1 USING @a, @b; +------------+ | hypotenuse | +------------+ | 5 | +------------+ mysql> DEALLOCATE PREPARE stmt1; 所以,如果要打出log,只有自己拼sql了。。。 本文转自轩脉刃博客园博客,原文链接:http://www.cnblogs.com/yjf512/archive/2013/05/10/3070760.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

数据分析学习笔记

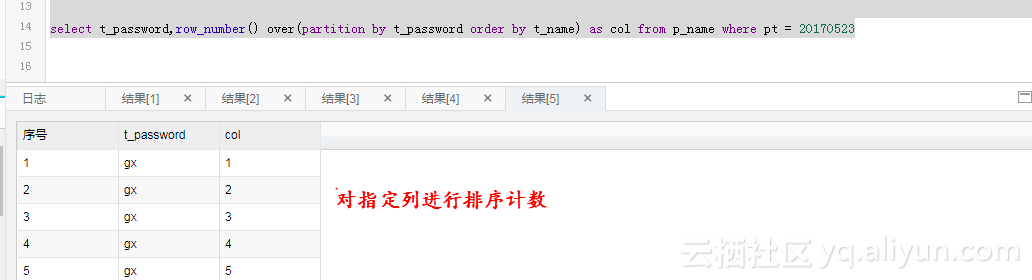
row_number() row_number() over(partition by col1[, col2…] order by col1 [asc|desc][, col2[asc|desc]…]) 函数说明: 可以用于开窗,排序,计数,返回当前窗口的排序值。 参数说明:partition by col1[, col2..]:指定开窗口的列。 order by col1 [asc|desc], col2[asc|desc]:指定结果返回时的排序的值。 WM_CONCAT 函数声明:string wm_concat(string separator, string str) 函数说明:该函数用指定的 spearator 做分隔符,链接 str 中的值。可以用于多行变一行。 参数说明:separator:String 类型常量,分隔符。其他类型或非常量将引发异常。str:String 类型,若输入为 Bigint,Double 或者 Datetime 类型,会隐式转换为 String 后参与运算,其它类型报异常。返回值:返回 String 类型。

优秀的个人博客,低调大师

阅读笔记-Hadoop入门实践

ASF:阿里软件开发平台服务框架SIP:服务集成平台BEA:应用基础结构软件公司分布式计算的应用场景:日志分析、索引建立Threshold:是一款IOS平台的应用。随时随地帮您监控行动数据使用奘况 无论是使用无限数据方案或是有限数据方案, Threshold 可以帮助您随时掌握最新数据使用状态, 提供客制化警示设定, 还可以设立一个您专属的行动数据区域, 以确保您不会被额外收费。 对于日志内容使用任务分解的多线程处理模式来分析统计,在比较简单的情况下,使用Memcache作为计数器,结合MySQL就能完成访问控制以及统计的工作,随着日志量的增加,未来可能不能满足要求。早期的多线程多任务分解日志模式,其实是分布式计算的一个单机版。将单机的工作进行分拆,变成协同工作的集群,其实就是分布式计算框架设计所涉及的。BEA和VMWare合作采用虚拟机来构建集群,就是希望使得计算机硬件能够类似于应用程序中资源池的资源,使用者无需关心资源分配情况,从而最大化了硬件资源的使用价值。分布式计算亦是如此,任务的分配和汇总都由分布式框架的Master来抉择,使用者需要提供待分析内容给分布式计算系统作为输入,等待结果。Hadoop是Apache开源组织的一个分布式计算开源框架,在很多大型网站上都已经得到了应用,比如亚马逊、Facebook和Yahoo等等。平台日志分析位常用,特别是集成平台的日志量会很大,非常适合分布式计算的适用场景。wwh学习:what? why? how? what:Hadoop框架中最核心的设计:MapReduce和HDFS。MapReduce:任务的分解与结果的汇总。HDFS:是Hadoop分布式文件系统(Hadoop Distributed File System)的缩写,为分布式计算存储提供了底层支持。MapReduce:Map&&Reduce,此处Map不适Map容器,作“展开”来讲,就是将一个任务分解为多个任务,Reduce就是将分解后多任务处理的结果汇总起来,得出最后的分析结果。类似于多线程,多任务。任务之间的关系可以分为两种:不相关的任务,可并行执行;人物之间有相互依赖,先后顺序不能够颠倒,这类任务是无法并行处理的。一般情况下,在Map前还可能会对输入的数据有Split(分割)的过程,保证任务并行效率,在Map之后,还会有Shuffer(混合)的过程,对于提高Reduce的效率以及减少数据传输的压力有很大的帮助。 HDFS:是分布式计算的存储基石。Hadoop的分布式文件系统和其他分布式文件系统有很多的类似的特质。分布式文件系统基本的几个特点。1、对于整个集群有单一的命名空间。2、数据一致性。适合一次写入多次读取的模型,客户端在文件没有被成功创建之前无法看到文件存在。3、文件会被分割成多个文件块,每个文件块被分配存储到数据节点上,而且根据配置会由赋值文件块来保证数据的安全性。 HDFS三个重要角色:NameNode、DataNode和Client。NameNode:可以看作是分布式文件系统中的管理者,主要负责管理文件系统的命名空间、集群配置信息和存储块的赋值等。NameNode会将文件系统的Meta-data存储在内存中,这些信息主要包括了文件信息、每一个文件对应的文件块的信息和每一个文件块在DataNode的信息等。DataNode:文件存储的基本单元,它将Block存储在本地文件系统中,保存了Block的Meta-data,同时周期性地将所有存在的Block信息发送给NameNode。Client:需要获取分布式文件系统文件的应用程序。三者关系样例说明:文件写入:1、Client向NameNode发起文件写入的请求。2、NameNode根据文件大小和文件块配置情况,返回给Client它所管理部分DataNode的信息。3、Client将文件划分为多个Block,根据DataNode的地址信息,按顺序写入到每一个DataNode块中。文件读取:1、Client向NameNode发起文件读取的请求。2、NameNode返回文件存储的DataNode的信息。3、Client读取文件信息。文件Bock复制:1、NameNode发现部分文件的Block不符合最小复制数或者部分DataNode失效。2、通知DataNode相互复制Block。3、DataNode开始直接相互复制。 HDFS的几个设计特点:1、Block的放置:默认不配置。一个Block会有三个备份,一份放在NameNode指定的DataNode,另一份放在与指定DataNode非同一个Rack上的DataNode,最后一份放在与指定DataNode同一Rack上的DataNode上。备份无非就是为了数据安全,考虑同一Rack的失败情况以及不同Rack之间数据拷贝性能问题就采用这种配置方式。2、心跳检测DataNode的健康状况,如果发现问题就采取数据备份的方式来保证数据的安全性。3、数据复制(场景为DataNode失败,需要平衡DataNode的存储利用率和需要平衡DataNode数据交互压力等情况):简述,使用HDFS的balancer命令,可以配置一个Threshold来平衡每一个DataNode磁盘利用率。例如设置了Threshold为10%,那么执行balancer命令的时候,首先统计所有DataNode的磁盘利用率平均值,然后判断如果某一个DataNode的磁盘利用率超过这个平均值Threshold以上,那么将会把这个DataNode的block转移到磁盘利用率低的DataNode,这对于新节点的加入来说十分有用。4、数据校验:采用CRC32作数据校验。在文件Block写入的时候除了写入数据还会写入校验信息,在读取的时候需要校验后在读入。5、NameNode是单点:如果失败的话,任务处理信息将会记录在本地文件系统和远端的文件系统中。6、数据管道性的写入:当客户端要写入文件到DataNode上,首先客户端读取一个Block然后写入到第一个DataNode上,然后由第一个DataNode传递到备份的DataNode上,一直到所有需要写入这个Block的DataNode都成功写入,客户端才会继续开始写下一个Block。7、安全模式:在分布式文件系统启动的时候,开始的时候会有安全模式,当分布式文件系统处于安全模式的情况下,文件系统中的内容不允许修改也不允许删除,直到安全模式结束。安全模式主要是为了系统启动的时候检查各个DataNode上数据块的有效性,同时根据策略必要的复制或删除部分数据块。运行期通过命令也可以进入安全模式。生产中,系统启动时修改和删除文件也会有安全模式不允许修改的出错提示,需要等待。 MapReduce&&HDFS来看Hadoop结构:在Hadoop的系统中,会有一台Master,主要负责NameNode的工作以及JobTracker的工作。JobTracker的主要职责就是启动、跟踪和调度各个Slave的任务执行。还会有多台Slave,每一台Slave通常具有DataNode的功能并负责TaskTracker的工作。TaskTracker根据应用要求来结合本地数据执行Map任务以及Reduce任务。Moving Computation is Cheaper than Moving Data:分布式计算最重要的一个设计点。就是在分布式处理中,移动数据的代价总是高于转移计算机的代价。简单来说就是分而治之的工作,需要将数据也分而存储,本地任务处理本地数据然会归总,这样才会保证分布式计算的高效性。 why:Hadoop的有点&适用场景:1、可扩展:不论是存储的可扩展性还是计算的可扩展性都是Hadoop的设计根本。2、经济:框架可以运行在任何普通的PC上。3、可靠:分布式文件系统的备份恢复机制以及MapReduce的任务监控保证了分布式处理的可靠性。4、高效:分布式文件系统的高效数据交互实现以及MapReduce结合Local Data处理的模式,为高效处理海量的信息作了基础准备。使用场景:海量数据的分析。海量数据被分割于多个节点,然后每一个节点并行计算,将得出的结果归并到输出。同时第一阶段的输出又可以作为下一阶段计算的输入,因此可以想象到一个树状结构的分布式计算图,在不同阶段都由不同产品,同时并行和串行结合的计算也可以很好地在分布式集群的资源下得以高效的处理。 Hadoop可以单机跑,也可以配置集群跑;集群配置运行的过程:环境:机器在多而不在精,JDK必须时1.5以上的,各个机器的机器名务必不同,机器名对于MapReduce有很大的影响。部署:对于Hadoop的集群来说,可以分成两大类角色:Master和Slave,前者主要配置NameNode和JobTracker的角色,负责总管分布式数据存储以及任务的执行。一般情况下,Master和Slave不会部署在同一台机器上。 实施步骤:1、在所有的机器上都建立相同的目录,也就可以建立相同的用户,以该用户的home路径来做Hadoop的安装路径。例如在所有机器上都建立了/home/Hado2、下载Hadoop,先解压到Master上。此时Hadoop的安装路径就是/home/Hado/版本。3、解压后进入conf目录,主要修改以下文件:Hadoop-env.sh, Hadoop-site.xml, masters, slavers。Hadoop的基础配置文件时Hadoop-default.xml,看Hadoop的代码可以知道,默认建立一个Job的时候会建立Job的Config,Config首先读入Hadoop-defaulg.xml的配置,然后再读入Hadoop-site.xml的配置(这个文件初始的时候配置为空),hadoop-site.xml中主要配置你需要覆盖的Hadoop-default.xml的系统级配置,以及你需要再你的MapReduce过程中使用的自定义配置(具体一些的使用例如final等参考文档)。以下是一个简单的hadoop-site.xml的配置:<?xml version="1.0"?><?xml-stylesheet type="text/xsl" href="configuration.xsl"?> fs.default.name dfs://10.2.224.46:54310/mapred.job.tracker hdfs://10.2.224.46:54311dfs.replication 1Hadoop.tmp.dir /home/Hado/Hadoop/tmp/mapred.child.java.opts -Xmx512mdfs.block.size 5120000The default block size for new files.Hadoop-env.sh文件只需要修改一个参数: The java implementation to use.Required. export JAVA_HOME=/usr/ali/jdk1.5.0_10(jdk版本)配置你的Java路径,记住一定要1.5版本以上,免得莫名其妙出现问题Masters中配置Masters的ip或者机器名,如果是机器名那么需要在/etc/hosts中有所设置。Slaves中配置的是Slaves的ip或者机器名,同样如果是机器名需要在etc/hosts中有所设置。范例如下:Masters: 10.2.224.46Slaves: 10.2.224.40 10.2.224.39 10.2.224.38 10.2.224.37 10.2.224.36 ...4、建立Masters到每一台Slave的SSH受信证书。由于Master将会通过SSH启动所有Slave的Hadoop,所以需要建立单向或者双向证书保证命令执行时不需要再输入密码。在Master和所有的Slave机器上执行:ssh-keygen -t rsa。执行此命令的时候,看到提示只需要回车。然后就会在/root/.ssh/下面产生id_rsa.pub的证书文件,通过scp将Master机器上的这个文件拷贝到Slave上(记得修改名称),例如:scp root@masterIP:/root/.ssh/id_rsa.pub /root/.ssh/46_rsa.pub,然后执行cat /root/.ssh/46_rsa.pub >>/root/.ssh/authorized_keys,建立authorized_keys文件即可,可以打开这个文件看看,也就是rsa的公钥作为key,user@IP作为value。此时可以试验一下,从master ssh到slave已经不需要密码了。由slave反向建立也是同样。为什么要反向呢?其实如果一直都是Master启动和关闭的话那就没有必要建立反向,只是如果想在Slave也可以关闭Hadoop就需要建立反向。5、将Master上的Hadoop通过scp拷贝到每一个Slave相同的目录下,根据每一个Slave的Java_HOME的不同修改器Hadoop-env.sh.6、修改Master上/etc/profile;新增一下内容:(具体的内容根据你的安装路径修改,这步只是为了方便使用)export HADOOP_HOME=/home/Hado/Hadoop_.. export PATH=$PATH:$HADOOP_HOME/bin修改完之后,执行source /etc/profile来使其生效。7、在Master上执行Hadoop namenode -format,这是第一需要做的初始化,可以看作格式化,以后除了上面提及的删除Master上的hadoop.tmp.dir目录,否则是不需要再次执行的。8、然后执行Master上的start-all.sh,这个命令可以直接执行,因为在6中已经添加到了path路径,这个命令是启动hdfs和mapreduce两部分,当然你也可以分开单独启动hdfs和mapreduce,分别是bin目录下的start-dfs.sh和start-mapred.sh.9、检查Master的logs目录,看看Namenode日志以及JobTracker日志是否正常启动。10、检查Slave的logs目录看看Datanode日志以及TaskTracker日志是否正常。11、如果需要关闭,那么就直接执行stop-all.sh即可。 感谢:岑文初!!!

优秀的个人博客,低调大师

构建之法阅读笔记1

软件=程序+软件工程 跟单纯的编写代码去实现自己想要看到的功能不同,软件工程是一个带有工程色彩的概念,不仅是为了满足个人的简单兴趣,而是有着明确的实用目标和更庞大、完善可靠的系统结构,而且也跟更多的人发生了联系(包括程序员和用户)。从工程的角度来看,写一个满足用户需求的软件:需要从用户需求的角度出发仔细分析,结合现有技术水平和人力物力,提出并逐步完善某个idea直至产品完成。工程问题更明显的特征是讲求实用和产品的工作效能(成本、稳定性...),我们面临的大多数问题都由实际的工程问题转化而来并逐步形成专业领域的各种技术和知识。 程序是基础,也是软件大厦的基石,但是只有程序并不是一个完整的软件。需要软件工程的支撑。由于在暑假已经整体的读过一遍了,现在再次翻看有种焕然领悟的感觉,之前只是枯燥的把它读完,现在再看它 的目录结构,整个软件的架构呈现在我面前。 个人感受: 过去的我只是看到一道题有一点思路就去写,不去考虑具体的规范和流程。 看到书上写的之后,大概懂得了拿到一个问题,基本的解决思路。 先构建一个程序的基本框架,分块去写,再分别验证。

优秀的个人博客,低调大师

Docker学习笔记之compose

一、compose compose 作用 你的应用可能需要很多个服务,比如web服务,数据库服务,缓存服务等等。我们可以把这些服务放到单独的容器里面,如果手工去配置这些服务会有些麻烦,docker compose可以帮我们解决这个问题。 我们可以创建一个compose文件,在这个文件上面描述你都需要哪些服务,服务使用什么镜像、数据卷、网络等等,然后再用一条命令就可以管理、启动所有的服务。 compose 文件 compose文件用的yml格式,docker规定了一些指令,使用它们可以去设置对应的东西,它主要分为了3个区域: services:是服务,在它下面可以定义应用需要的一些服务,每个服务都有自己的名字、使用的镜像、挂载的数据卷、所属的网络、依赖哪些其他服务等等; networks:是应用的网络,在它下面可以定义应用的名字、使用的网络类型等等; volumes:是数据卷,在它下面可以定义的数据卷(名字等等),然后挂载到不同的服务下去使用; 二、Services 先创建一个文件夹beck-docker,并在里面新建docker-compose.yml文件,然后使用version指定一下compose使用的版本号。 定义服务 在应用里需要定义的服务,可以放到services下面。比如,我们去定义一个dog的服务,使用nginx镜像,指定主机上的8080端口映射到容器中得80端口,也就是nginx的http的访问端口。 version:'2' services: dog: image:nginx ports: -"8080:80" 以同样的方式,定义一个cat的服务,同样使用nginx镜像,然后指8081端口对应80端口。 version:'2' services: dog: image:nginx ports: -"8080:80" cat: image:nginx ports: -"8081:80" 需要注意的是,cat与dog要在同一个级别,还有ports是个数组,可以指定多个端口映射关系。 启动服务 定义好服务以后,在项目的目录启动这些服务,可以执行: docker-composeup 这样会启动,在compose文件下定义的所有服务。由于这是第一次启动这个服务,所以可以看到它是creating,也就是去创建相关的东西。首先会创建这个服务使用的网络,这里是叫做「beckdocker_default」的网络,然后是dog和cat的服务,这些网络和服务的名字,默认会加上一个前缀,由于在创建应用的时候没有指定名字,所以会默认使用项目目录的名字,后面还有一个数字的后缀。最后会有一个「Attaching to …」,将网络应用到服务上。 启动成功后,在浏览器访问一下。8080对应的是dog的服务,8081是cat的服务。 回到终端,可以看到服务的访问日志,日志的开头会有服务的名字,标志着日志是从哪个服务来的: 如果希望服务在后台运行,可以使用-d选项(也就是detach): docker-composeup-d 服务的生命周期 查看正在运行的服务 docker-composeps 停止一个服务 docker-composestop[服务名] 如果后面不加服务名,会停止所有的服务。 启动某一个服务 docker-composestart[服务名] 如果后面不加服务名,会启动所有的服务。 查看服务运行的log docker-composelogs-f 加上-f选项,可以持续跟中服务产生的log。 进入服务容器中 docker-composeexecdogbash 删除服务 docker-composerm 注意这个docker-compose rm不会删除应用的网络和数据卷。查看一下网络,可以看到应用创建的网络「beckdocker_default」,如果要删除所有的这些,可以使用: docker-composedown 会提示我们删除网络 beckdocker_default。 三、Networks 网络决定了服务之间以及服务和外界之间如何去通信,在执行docker-compose up的时候,docker会默认创建一个默认的网络,创建的服务也会默认地属于这个默认网络。服务和服务之间,可以使用服务的名字进行通信。也可以自己创建网络,并将服务属于到这个网络之中,这样服务之间可以相互通信,而外界就不能够与这个网络中的服务通信,可以保持隔离性。 下面登录dog服务去连接cat服务,登录到cat服务连接dog服务: 可以通过服务的名称进行连接。 自定义网络 1、在networks中先定义一个名为animal,类型为bridge的网络: version:'2' services: dog: image:nginx ports: -"8080:80" cat: image:nginx ports: -"8081:80" networks: animal: driver:bridge 2、让dog和cat服务使用这个网络: **version:'2' services: dog: image:nginx ports: -"8080:80" networks: -"animal" cat: image:nginx ports: -"8081:80" networks: -"animal" networks: animal: driver:bridge 3、再增加一个叫pig的服务,使用默认网络,来体现于自定义网络的隔离性: version:'2' services: dog: image:nginx ports: -"8080:80" networks: -"animal" cat: image:nginx ports: -"8081:80" networks: -"animal" pig: image:nginx ports: -"8082:80" networks: -"default" networks: animal: driver:bridge 4、重新启动应用 5、登录cat服务,尝试去连接dog服务和pig服务: 因为cat与dog同在animal网络,所以可以通过名字连接,而pig在default网络中,所以不能。 四、Volumes 在compose文件中,还可以指定一些有名字的数据卷,让服务去使用。方法是:在与networks同级的地方,添加volumes,接着是数据卷的名字,下面使用driver去指定数据卷的类型。 定义好数据卷后,就将这个数据卷交给一个服务去使用。可以用volumes给服务指定需要使用的数据卷: dog: ... volumes: -nest:/mnt 以dog服务为例,volumes下指定使用的数据卷,冒号左边是数据卷名称,冒号右边是挂载到的docker对应目录位置。接着给cat服务也添加同样的数据卷。 回到终端,执行docker-compose up -d,下面测试一下数据卷: 因为cat与dog服务都使用nest的数据卷,所以在dog中/mnt目录下创建的data1,在cat服务的/mnt目录下可以看到。 指定位置的数据卷 dog和cat都是一个web服务,现在我想将主机的某一个位置当做是服务的一个内容,那么我们可以去创一个指定位置的数据卷。首先可以在当前目录,创建./app/web文件夹,在里面创建个index.html。 编辑内容: 内容编辑好后,就给dog与cat服务指定数据卷,冒号左边是主机上的目录,冒号右边是服务内挂载的目录: 说明:/usr/share/nginx/html 目录是nginx默认主机的根目录,也就是nginx欢迎界面的目录。 本文转自 dengaosky 51CTO博客,原文链接:http://blog.51cto.com/dengaosky/1854570,如需转载请自行联系原作者

优秀的个人博客,低调大师

【SIP协议】学习初学笔记

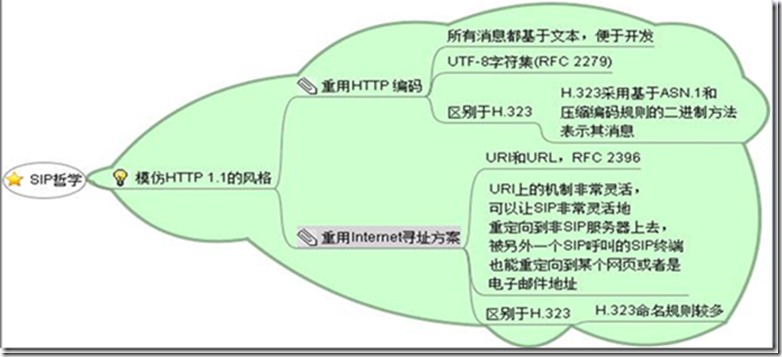
1.SIP这玩意是怎么走来和如何构建的? 通俗的说,SIP就是一个轻量级信令协议,它可以作为音频、视频、及时信息的信令。 说到SIP是怎么出来的就要提H.323,而提到这个标准由不得不提到ITU-T,我们就先说说指定SIP的IETF(Internet Engineering Task Force)和制定H.323的ITU-T(International Telecommunications Union–Telecommunications Standard Sector)之间一些小趣事吧。ITU-T和IETF想事儿总是不一样的,它们俩往往从两个不同的角度来进行。ITU-T作为一个隶属于美国的国际标准化组织,传承了美国政策的一致性和试图完成维护世界和平的角色,所以它制定出来的标准一定是经过无数轮的反复和草案,花了N年制定出一个最终的,广为接受的结果。而恰恰相反,IETF则更趋近于实用主义,信奉“rough consensus and running code”,也就是说能用进行,边用边补充呗。因此在大多数时候,IETF标准制定的周期要比ITU-T短一些,这可能也归因于IETF每年举办三次开放性论坛。这些春季、夏季、秋季会议会安排在世界各地,并且向各个对此感性趣的组织开放(去瞅一瞅吧:http://www.ietf.org/meetings/meetings.html )多个IETF工作组在这些会议上相聚,针对他们现在的系统开发敲定一些技术细节,对于要是到了会议结束时还是没有解决的问题那就几个月后的下次开会继续研究呗。简而言之,IETF以一种实际实用的角度去完善体系架构和协议设计。 说了这么多可能你还没有意识到我在扯这些是为了什么,但是请记住这些正是SIP(Session Initiation Protocol)架构所体现的核心思想——先用着,再扩展。SIP的结构是建立于两个常用协议之上的:在RFC 2821中的SMTP 协议(Simple Mail Transfer Protocol )——它定义了电子邮件的消息格式,以及定义在RFC 2616的HTTP协议 (Hypertext Transfer Protocol )——它定义了基于Web的多媒体通信消息。另外,SIP又使用了定义在RFC 3550中的RTP/RTCP协议(Real Time Transport Protocol/Real Time Control Protocol )——它定义了在IP网上的多媒体包格式,还使用了定义在RFC 2327的SDP协议(Session Description Protocol )——它定义了一个多媒体会话的参数和特征。因此,SIP是建立在其他IETF提出的协议之上的,这有点像H.323建立在诸如H.225.0和H.245等ITU-T制定的协议之上,它的两个比较基础的RFC分别是版本1.0 RFC2543和版本2.0 RFC3261。当然,SIP还运行于其他IETF定义的传输协议之上,比如TCP(Transport Control Protocol ), UDP(User Datagram Protocol ) 和IP (Internet Protocol )等。这样,这么多著名的,并且被广泛应用的协议为SIP提供了超于H.323的简单明了的特性。 在网上看到了这样三个MindMap,觉得很能表达SIP的基本核心思想: 关于SIP的架构,我们一定要知道这玩意不是什么新鲜玩意,你看看它基于什么就知道了,这么个拼出来的东东架构能崭新到什么地步呢?我的粗浅理解是SIP的主要架构其实就是一个典型的C-S架构:一个Client客户端在RFC3261中定义为一个发送SIP请求并接收SIP回应的网络元素,这个Client可能与也可能不与人进行交互。对应的,一个Server服务器是接受SIP请求并且给予其回应的网络元素。比如最典型的是一个SIP请求INVITE,邀请一个用户或者服务器参与会话,若得到的是肯定的响应的话,那么则会返回响应SUCCESS。要是再深入一点,我们可以将这样一个简单的分类进行细分: Client分为两类: 用户代理客户端User Agent Client :它是一个逻辑功能,它创建请求、并且使用这个功能实体的一些具体功能发送出请求。 代理Proxy :中文翻译过来还是代理,但是这个与上边的Agent不一样,它是一个中间设备,既作为Client,也作为Server ,可以解释、翻译、改写一个请求,并将请求转发给其他的服务器,完成路由功能。有时候有状态和无状态Proxy,所谓有状态就是Proxy根据不同的情形作出不同的处理,这些处理具有前后的相关性,比如三个人传数字,A要通过B给C传一个数字,一种情况是不管A说什么,B都说同一数字给C,这叫做无状态Proxy;另一种状态是A说1的话,B就传给C数字2,要是A说2的话,B就传给C数字3,这样就是一个有状态的Proxy。有些资料上有所为B2BUA,实质与Proxy很相似,只不过更加灵活。 Server分类三类: 用户代理服务器User Agent Server: 它是一个逻辑功能,它对一个请求产生应答。 重定向服务器Redirect Server: 一个将客户端的请求重定向去联系另一个服务器以完成请求的服务器。 注册服务器Registrar :一个接受REGISTER 注册请求,并将信息放置于位置服务器的服务器。 注意:我们在书上常常看到的UA是一个概括的说法,之所以区分UAS和UAC只是从逻辑上区分,实质上不一定是独立物理实体。 2.SIP该在哪,能干啥? 我们学习SIP就要知道它的地位,有个宏观的了解才能知道N多协议之间的关系: 既然根据RFC 3261,SIP是基于STMP和HTTP的,并且底层使用了IP、UDP和TCP,那么它就是一个应用层协议,也就是说,它能为End User提供服务,你能看得见摸得着。描述SIP应用服务的单位是会话,也就是英文中Session一词,意为在两个或多个参与者之间有顺序的交换信息,更深入一点,SIP必须先去扮演建立会话的角色,然后再在通信中管理会话。大家更关注的有三点: a.多于两个的参与者就意味着呼叫可能是多点的,而不仅仅是点对点的那样子。 b.End User可能总不是从相同的地点发起呼叫的,我们需要添加追踪这些End User的功能。 c.End User可能会使用文字、音频、视频等的混合媒体类型,这些在网路中对网络的带宽、最大传输延时等都有不同的要求和限制。SIP还需要对此进行有效处理。 针对以上的Concerns,RFC 3261主要定义了五个方面的SIP多媒体会话管理能力: · 用户位置管理:决定哪一个端系统用于这次通信。 · 用户可用性:决定被叫端是不是愿意参与这次通信。 · 用户容量:决定用于这次通信的媒体以及其参数。 · 会话建立:在被叫和主叫两端建立会话参数。 · 会话管理: 包含转接和终止会话、修改会话参数、调用会话业务。 3. SIP依靠怎么运作? 既然SIP是建立在SMTP和HTTP上的,那么其消息格式也有巨大的相似度,但是注意到一个SIP会话的资源是通信资源,而不是页面或者网页资源,这是与HTTP不同的地方。一个身份或者叫做一个寻址体制必须在请求/响应集有效建立之前建立。身份标识就是所谓的SIP URI(SIP Uniform Resource Indicator),其中包含了充足的信息来初始化一个会话。使用这个标识的资源的例子(RFC 3261中提供的)有:有在线业务的用户、在一个消息系统中的一个邮箱,在一个组织中的一组逻辑用户(例如销售部门),一个PSTN电话号码等等。SIP URI与电子邮件地址类似,这也是借用了SMTP协议中的规定:典型的包含两部分,第一部分为用户名,第二部分为主机名,sip:huangpc@bupt.cn, 这是RFC 2543所介绍的最通常的格式。 当然SIP URI还有其他的一些格式,比如在RFC 3261中引入的安全SIP URI:sips:huangpc@bupt.cn, 这个是在TCP上的TLS作为安全传输层的一种方式。 定义了用户标识后,我们就可以定义请求的标识了——SIP中称为方法(Method)。其他的扩展方法在后续的RFC中都有定义。 · REGISTER: 用于与SIP服务器进行注册。 · INVITE: 用于表明用户或者服务器被邀请参与这个会话。这个消息体中将包含一个对被叫端的会话描述。 · ACK: 仅用了INVITE请求,表明收到请求。 · CANCEL: 用于取消一个pending 的请求。 · BYE: User Agent Client用户代理客户端发送,来告诉服务器它希望结束通话。 · OPTIONS: 向服务器查询它的能力。 定义完请求,很自然我们需要回应的语言规范:包含状态码和描述性短语。分为六类: · 1xx: 暂时性回应,表明已经接收到,正在处理之中。 · 2xx: 成功回应,表明动作已经被接收,理解并且接受了。 · 3xx: 重定向回应,需要进一步的动作来处理处理这个请求。 · 4xx: 客户端错误回应,请求中语法不对,不能被服务器接受。 · 5xx: 服务器错误回应,服务器不能处理这个有效的请求。 · 6xx: 全局错误回应,这个请求不能被任何服务器接受。 你现在可能比较纳闷,这都是些关于SIP会话建立和拆除的部分,但关于这个会话中要传的文字、音视频等的格式等双方是怎么知道的呢?在INVITE中,就带有了这些信息,这个信息的格式则又引出了另一个RFC,RFC 2327,会话描述协议(Session Description Protocol (SDP))。 SIP和其他协议一样都有这样的一个要求:在会话开头时两端要有充分的信息交流。使用的两个协议就是定义在RFC 2974中的SAP(Session Announcement Protocol )和定义在RFC 2327的SDP (Session Description Protocol)。简单来说,SAP提供了一种定期宣传多媒体会话,向有意参与会话者传递相关会话信息的机制。使用它来支持Mbone(Internet Multicast Backbone),因此关兴趣的各方都会清楚的指导目前正在进行的一些会话。而SDP则定义了描述一个通信会话的格式,同样的,它也可以用于不同的传输协议,比如SAP、SIP、HTTP或其他等传输协议。学习时要注意SDP的载体是SIP。RFC 2327专门注明了一些SDP能提供的比较关键的信息: 会话名和目的。 会话激活的时间。 构成会话的媒体。 怎么样接收这些媒体(地址、端口号、格式等) 而另一些信息则是可选附带的,例如会议使用的带宽,负责这个会话的那个人的联系方式等等。 说到这些你可能觉得很抽象,我们赶紧那个例子RFC 2327中的例子来看看: v=0 o=mhandley 2890844526 2890842807 IN IP4 126.16.64.4 s=SDP Seminar i=A Seminar on the session description protocol u=http://www.cs.ucl.ac.uk/staff/M.Handley/sdp.03.ps e=mjh@isi.edu (Mark Handley) c=IN IP4 224.2.17.12/127 t=2873397496 2873404696 a=recvonly m=audio 49170 RTP/AVP 0 m=video 51372 RTP/AVP 31 m=application 32416 udp wb a=orient:portrait 我们看到SDP格式包含多行文本,都是以 = 的格式书写的,RFC中的星号*指的是选择项。我们主要有三类的会话描述:会话描述、时间描述、媒体描述,具体你可以参看RFC 2327。注意这个例子中,两个m开头的行,定义了音视频的概要,这些概要是在RFC 3550 Real Time Protocol (RTP)中的第13节和RFC 3551 RTP Profile for Audio and Video Conferences with Minimal Control 中的第6节,在编码最后的那个0和31,这是在后续RTP帧中要使用的负载类型值,用来确定媒体和编码类型。49170和51372都是接收者的端口,发送者端口分别加1,也就是说在这个例子中49171和51373是发送者的端口。 4.SIP到底怎么运作? 一个最简单的例子是在SIP呼叫建立两个直接相连的端对端的通话过程。发起者会发起一个INVITE消息给对端来发起会话,接着会收到Ringing和OK消息。被叫端返回ACK表明连接完成,可以进行信息交流了。当不需要这个连接时,任何一端发送BYE消息给对端,对端返回OK来终止呼叫。 注意,SIP消息和具体的媒体流并不是在一个层面运作的。例如,一个VoIP电话是先通过SIP信令完成交互后再开始具体媒体流的传输的,如下图,SIP的根本作用的完成点对点(或多点)的媒体流传输的前序工作。 在RFC 3261中描述了一个比较复杂的例子:使用了代理服务器作为通信通路。SIP代理服务器代表其他的Client发起请求,并且在许多时候作为路由模式,将SIP请求转发给另一个距离最终目的地(也就是被叫端)较近的设备。因此,SIP代理服务器扮演着两个角色——在接收请求时是server角色,在发送请求时是client角色。注意,代理服务器必须可以解释一个SIP消息,并且需要的时候转发这条消息前对其进行重写,大的网络中可能有多个代理服务器。在RFC3261中的第四节中有个比较有趣的例子,描述了两个SIP终端通过两个代理服务器建立呼叫的过程。在这个例子中,两个终端位于两个不同的城市:Atlanta and Biloxi,因此是在两个相互隔离的网络中。每个网络有它自己的代理服务器,分别称为atlanta.com 和 biloxi.com。 若在Atlanta的Alice想呼叫在Biloxi的Bob,那么Alice的电话就会发送以下的INVITE消息给它的代理服务器atlanta.com: Via: SIP/2.0/UDP pc33.atlanta.com;branch=z9hG4bK776asdhds Max-Forwards: 70 To: Bob From: Alice ;tag=1928301774 Call-ID: a84b4c76e66710@pc33.atlanta.com CSeq: 314159 INVITE Contact: Content-Type: application/sdp Content-Length: 142 当这个消息通过网络转到Bob后Bob要是愿意接受这个呼叫那么它就会返回一个OK,这个消息会先到biloxi.com 代理: SIP/2.0 200 OK Via: SIP/2.0/UDP server10.biloxi.com ;branch=z9hG4bKnashds8;received=192.0.2.3 Via: SIP/2.0/UDP bigbox3.site3.atlanta.com ;branch=z9hG4bK77ef4c2312983.1;received=192.0.2.2 Via: SIP/2.0/UDP pc33.atlanta.com ;branch=z9hG4bK776asdhds ;received=192.0.2.1 To: Bob ;tag=a6c85cf From: Alice ;tag=1928301774 Call-ID: a84b4c76e66710@pc33.atlanta.com CSeq: 314159 INVITE Contact: Content-Type: application/sdp Content-Length: 131 我们注意到有相同的Call-ID来保证这个会话的单一性。更多的细节参看RFC 3261里的这个例子的具体解释。 5.SIP中的信令和媒体之间的关系: SIP等于为媒体的建立进行实现的沟通,打个比喻,只有你知道你要说话的那个人在那,并且两个人都要找到彼此畅通的语言,这样才能更有效的沟通。 而真正开始两人滔滔不绝的倾心交谈了,就与前边这些对话前的相互了解和基本沟通没有关系了。 6.几个重要的概念: 呼叫(call): 呼叫是一个非正式的术语,用来表示一个多媒体会话,用Call-ID来标识;不论两方通话还是在多方通话中,在每个UA中是使用同一个Call-ID; 事务(transaction): 请求(UAC)+最终响应(相邻的UAS),SIP基于事务。所谓相邻就是说transaction存在于相邻的SIP实体,而不是存在于两个UA之间。CSeq标识。一个事务中包含一个请求消息、0个或多个临时响应消息、1个或多个最终响应消息(2xx~6xx)。SIP是事务性的协议。事务的区分通过Via字段栈顶的Branch的值来确定,这是由于对于请求消息每经过一个有事务状态的Proxy的时候,该Proxy需要为这个事务创建一个服务器端事务和一个客户端事务,并且将自己的URI添加到Via的栈顶,并生成一个Global ID做为Branch的值,以此值来表示一个与之相对应的事务。SIP在事务层面定义了状态机和定时器来实现重传。 下图是一个回复200 OK的成功的INVITE事务:是不是INVITE事务区别在于 UAC需要为每个INVITE最终请求(2xx~6xx)生成ACK响应,而其他的请求消息(INFO,OPTION,etc)则不必如此。因为INVITE的地位比较重要, 所以需要这样一个三次握手的机制来保证会话的双方都能够确保事务的完整性,这一点和TCP连接建立的三次握手比较像。 注意在上图这两个UA中,每一个代理服务器都将自己的地址加入返回的ACK的Via头域中,而非成功的transaction则不会加入,见RFC 3261 (p.24)。CSeq头域的值必须与INVITE相同,并且CSeq的方法必须是ACK。中间响应消息 1xx 的使用则是为了节省网络开销设计的,一旦 UC 收到任何一个中间响应消息,则 UC 必须停止消息重发定时器,不再从发这个请求消息,反之则直到收到最终响应消息或重发定时器超时。一旦客户端UAC的事务在Calling状态收到任何中间响应消息1xx,事务则自动切换到Processing状态,停止请求消息的重发。并且需要将中间响应消息传送给TU事务用户。在呼叫业务中,TU以及上层应用可以根据中间响应消息在用户界面上提示用户。一旦事务切换到Processing状态,任何其他中间响应消息也都要传送给TU。 而非INVITE事务则如下: 当UAC发出非INVITE请求时,它就会在事务管理子层上开启定时器F(TCP)或者是E(UDP),确保超时的时候进行重传。这适用于除了 ACK请求外的其他非INVITE请求。每次超时重传时E的时间都被翻倍,直到最大的4秒。而F超时时,UAC就会认为是Timeout,这个事务将被删除。 对话(dialog/leg): 代表着两个SIP UA之间持续一段时间的端到端的联系(如:一段通话)。也就说仅仅存在于端到端的信令关系。当一个UAS发出对于INVITE(或者REFER)的非失败最终响应<=>200OK(BYE),则Dialog建立,同时这也是session的开始。UA和SIP代理服务器之间不会有对话。在SIP中呼叫中包含一个或多个Dialog(这仅仅存在于多方通话中)。Dialog终结于任意一端发出 BYE。Early Dialog可以通过UAC发出的CANCEL进行终结,更确切的说,所有早期对话在接收到非2XX最终响应时就被终结了。 Call-ID-value、To、From进行标识。Forking时体现明显。 在这个Forking的例子中,这个用户注册了三个设备,在用户被呼叫时,INVITE的Contact头域就被转换为三个INVITE发往三个设备。后边的q指的是优先级,q越小,优先级越高。其中的SIP注册服务器相当于一个Forking代理,尽管这个实体接收到两个ACK,但是除了这些ACK外,它与主叫方的信令交互都是属于一个transaction的,而与被叫方则分别建立了Transaction。另外,被叫方收到的两个ACK由分别建立了Transaction。注意Device3返回了488这样的非成功响应,SIP注册服务器(Forking代理服务器)没有将该响应发回主叫方,这是SIP代理一个重要的特征,SIP代理还能自行发出Request:CANCEL消息。 UAS对话层接收到一个新的对话请求INVITE消息后,在建立会话的响应消息2xx中,将请求消息里面的所有Route-Record字段拷贝到2xx消息中,并且UAS的对话层必须添加一个Contact字段使得对话中后续的响应(INVITE在2xx响应的情况下也包括ACK消息)、请求消息可以直接和本UA联系。当UAC收到UAS的INVITE的2xx响应消息后,如果2xx中不包含任何Route-Record字段的,则UAC可以选择直接发送ACK到Contact中地址&端口。 会话(session): 多方用户的媒体关系,在对话的控制下建立。 下图是Early dialog、Session、Dialog、Transaction等的在一个UA-UA的呼叫中的体现: 在这个例子中,通过INVITE事务而成功建立起来的dialog必须有一个ACK进行回应,这是第二个transaction的开始,尽管ACK并没有回复,但是由于新的 branch-value被填入,所以这个ACK代表了一个新的Transaction的开始。注意,此时 transaction number (CSeq) 并没有根据INVITE而增加--也就是说若收到的最终响应不是2XX(是3XX--6XX),则该transaction中包含ACK,若最终响应是2XX,则ACK属于一个新的transaction(此处存疑,国外有资料将其视为一个新的transaction,但是RFC3261中的意思却是ACK不属于INVITE Transaction,也不创建新的Transaction,但会重新计算Transaction参数--branchID)。早期对话是UAS以一个1XX响应作为回应时建立的。这样做的好处是在UAC可能在早期对话中发出诸如UPDATE这样的SIP请求。 7.在线状态(Presence) 有人译为“呈现”,个人觉得译为在线状态比较贴切,这是一种激动人心的SIP应用,它使您能够确定用户位置,并判断是否能够通过电话、电子邮件/文本或视频与其进行通信。人员和应用都可以利用状态信息,从而使企业有机会将通信整合到业务流程之中。IETF指定了许许多多的SIP扩展来支持在线状态这个功能,我们列举如下: · RFC 2778: A Model for Presence and Instant Messaging · RFC 2779: Instant Messaging/Presence Protocol Requirements · RFC 3261 SIP: Session Initiation Protocol · RFC 3856: A Presence Event Package for the Session Initiation Protocol · RFC 3859: Common Profile for Presence 主要的组成有: Presence Agent(PA):PA为SIP使用者的代理人,能够接收和处理Presence的消息。它也能够回应和重新整理其它的消息(如公开的消息或SIP以外的任何消息)。当一个用户改变其状态时,它还能给订阅者发送通知。其可以与 SIP proxy server放在一起实现,也可以作为一个独立实体存在。 Presence User Agent (PUA) :查询更新PA。 8.全网看SIP 在非IMS网络中,拓扑结构如下: 在这个结构中,有三个主要的部分: 公网与业务定制者节点:这是PSTN网络以及在用户层面的设备。 DMZ区域:对接外网的一些网络元素,用于安全方面。 核心网:网络消息处理的核心区域。 需要的注意是: 1.在核心网部分的媒体服务器有时候也可以扮演UA的角色,比如你定制语音留言这个业务,那么这个媒体服务器就负责播放提示音和录音。网关在某个层面上也是扮演了UA的角色。 2.IP PBX是一种B2BUA,另外,SBC也是一种B2BUA,负责隐藏内网拓扑结构。应用服务器也是一种B2BUA,供修改业务参数等操作使用。 9.NAT问题 下图所示SIP可能会出现的NAT问题: 目前商用的方法是使用Session Border Controller (SBC),也就是说在应用层提供NAT服务,SBC监听SIP请求,当得到一个请求时,它不仅检查IP头以便路由这个包,它也查看SIP消息内部的contract地址,并且在将其路由到下一跳之前将该地址改为一个可路由的地址,这个可路由的地址不一定是公网地址,只要下一个节点可以路由即可,如下图所示: 本文转自gnuhpc博客园博客,原文链接:http://www.cnblogs.com/gnuhpc/archive/2012/01/16/2323637.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android笔记:Fragment相关问题

这两天在使用Fragment做播放器里的播放列表和歌词显示两个界面的替换与更新时发现了很多问题,在此记录下问题及解决方法: 1.多个Fragment在replace后(并且都加入了后退栈ft.addToBackStack(null)),通过点击按钮事件移除顶层的fragment(使用remove方法),返回后的fragment的oncreatview方法有执行,但是页面仍然没法自行更新数据,页面空白,UI控件都消失了。 解决:不用remove方法,改用通过popBackStack()方法直接将栈顶的fragment弹出,然后直接恢复到要返回的那个fragment。 1 getSupportFragmentManager().popBackStack(); 2.使用popBackStack()方法后,页面控件恢复了,但是数据并没有同步更新。 解决:这个问题困扰了很久,后来讲replace方法改成了add方法,并且在add之前将原先的fragment隐藏掉hide。这样在点击按钮收回播放列表的fragment后,返回的歌词fragment的显示进度是同步的了。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 // 打开播放列表 private void btnClick_playinglist() { FragmentTransaction ft = getSupportFragmentManager().beginTransaction(); Fragment fragment = new PlayingListFragment(); if (isOpenPlayingList) //播放类表是否已打开 { getSupportFragmentManager().popBackStack(); mPlaying_img_openlist.setImageResource(R.drawable.icon_playing_img_openlist); isOpenPlayingList = false ; } else { ft.hide(mFragment); ft.add(R.id.playing_fragment_layout, fragment); ft.setTransition(FragmentTransaction.TRANSIT_FRAGMENT_OPEN); ft.addToBackStack( null ); mFragment = fragment; mPlaying_img_openlist.setImageResource(R.drawable.icon_playing_img_openlist_press); isOpenPlayingList = true ; } ft.commit(); } 3.通过按钮点击可以正常弹出顶层的播放列表fragment了,同时歌词界面的fragment仍然同步更新。但是用按钮点击打开播放列表fragment,然后用back键返回,第一次正常,多次后歌词fragment就开始变成空白。将fragment的背景颜色修改成红色,异常界面就是红色。由此可见,通过back键返回的fragment仍然没有恢复和更新。 解决:这个不清楚具体原因,应该是使用back返回键和通过调用popBackStack()方法来移除fragment的机制不一样所导致的。这个找不到具体的解决办法,只能先采用规避方法,通过重写back监听方法,进而调用popBackStack()解决了这个问题。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 //重写监听back键按钮 @Override public void onBackPressed() { getSupportFragmentManager().popBackStack(); if (isOpenPlayingList) //判断播放列表是否打开 { mPlaying_img_openlist.setImageResource(R.drawable.icon_playing_img_openlist); isOpenPlayingList = false ; } else { super .onBackPressed(); } } 本文转自 glblong 51CTO博客,原文链接:http://blog.51cto.com/glblong/1252393,如需转载请自行联系原作者

优秀的个人博客,低调大师

Appium命令笔记之一

查看APK包名与其他信息命令: aapt l <你的apk文件>,这个命令就是查看apk内容 下面详细说下 aapt dump 这个查询命令 基本格式为 aapt dump [] <apk文件> 这里[ ]选择可以有以下几种: badging Print the label and icon for the app declared in APK permissions Print the permissions from the APK. resources Print the resource table from the APK. configurations Print the configurations in the APK. xmltree Print the compiled xmls in the given assets. xmlstrings Print the strings of the given compiled xml assets. 例如: C:\Users\lw>aapt d badging Desktop\zhihu.apk |findstr "package launchable-activity" package: name='com.zhihu.android' versionCode='507' versionName='4.54.1' platformBuildVersionName='7.1.1' launchable-activity: name='com.zhihu.android.app.ui.activity.MainActivity' label='鐭ヤ箮' icon='' //启动另外一个APP public void startapp() { //启动该apt driver.startActivity("com.zhihu.android","'com.zhihu.android.app.ui.activity.MainActivity"); } 使用场景: 1、用例之前的切换 2、场景切换使用 本文转自 知止内明 51CTO博客,原文链接:http://blog.51cto.com/357712148/1957817,如需转载请自行联系原作者

优秀的个人博客,低调大师

ElasticSearch API for JAVA 学习笔记

Client Client是一个类,通过这个类可以实现对ES集群的各种操作:Index, Get, Delete , Search,以及对ES集群的管理任务。 Client的构造需要基于TransportClient TransportClient TransportClient可以远程连接ES集群,通过一个传输模块,但是它不真正的连接到集群,只是获取集群的一个或多个初始传输地址,在每次请求动作时,才真正连接到ES集群。 Settings Settings类主要是在启动Client之前,配置一些属性参数,主要配置集群名称cluster.name,还有其他参数: client.transport.sniff 是否为传输client添加嗅探功能 client.transport.ignore_cluster_name 设为true,忽略连接节点的集群名称验证 client.transport.ping_timeout 设置ping节点时的时间限,默认5s client.transport.nodes_sampler_interval 设置sample/ping nodes listed 间隔时间,默认5s 1 2 3 4 5 6 7 8 9 10 11 12 13 //通过Settings类设置属性参数 Settingssettings=Settings.settingsBuilder().put( "cluster.name" , "index-name" ).build(); //启动Client Clientclient=TransportClient.builder().settings(settings).build(). addTransportAddress( new InetSocketTransportAddress(InetAddress.getByName( "192.168.xxx.xxx" ), 9300 )); //如果不需要设置参数,直接如下 /*Clientclient=TransportClient.builder().build(). addTransportAddress(newInetSocketTransportAddress(InetAddress.getByName("192.168.xxx.xxx"),9300));*/ //关闭Clinet client.close(); Document API 主要分为以下类:Index API , Get API , Delete API , Update API, Multi Get API, Bulk API es中的增删改查 Index API可以索引一个典型的JSON文档到指定的索引中,并且可以使它可以检索。 产生JSON JSON产生可以有以下几种方式: 手动拼接一个JSON字符串 使用Map 使用第三方库,比如Jackson 使用内置的XContentFactory.jsonBuilder() 每种类型都会转换为byte[],因此如果对象已经是这种形式,可以直接使用,jsonBuilder是一个高度优化了的JSON产生器,它直接构造byte[] 通过下边的代码讲解四种方法:index-api, get-api, delete-api, update-api 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 /** *es-api的方法学习: *1.prepareIndex方法:索引数据到ElasticSearch *2.prepareGet方法:获取信息 *3.prepareDelete方法:删除信息 *4.update方法:更新信息 *4.1upsert:在使用update方法时: *a:针对文档不存在的情况时,做出index数据的操作,update无效; *b:如果文档存在,那么index数据操作无效,update有效; */ public static void main(String[]args) throws IOException,InterruptedException,ExecutionException{ //通过Settings类设置属性参数 Settingssettings=Settings.settingsBuilder().put( "cluster.name" , "myApp" ).build(); //启动Client Clientclient= null ; try { client=TransportClient.builder().settings(settings).build(). addTransportAddress( new InetSocketTransportAddress(InetAddress.getByName( "101.200.124.27" ), 9300 )); } catch (UnknownHostExceptione){ e.printStackTrace(); } //执行操作 SimpleDateFormatdf= new SimpleDateFormat( "yyyy-MM-dd" ); XContentBuilderjsonBuilder=XContentFactory.jsonBuilder() .startObject() .field( "user" , "yuchen" ) .field( "interest" , "readingbook" ) .field( "insert_time" ,df.format( new Date())) .endObject(); //1.prepareIndex方法:索引数据到ElasticSearch IndexResponseresponse=client.prepareIndex( "index-test" , "weibo" , "4" ) .setSource(jsonBuilder) .get(); String_index=response.getIndex(); String_type=response.getType(); String_id=response.getId(); long _version=response.getVersion(); boolean created=response.isCreated(); System.out.println(_index+ "" +_type+ "" +_id+ "" +_version+ "" +created); //2.prepareGet方法:获取信息 GetResponsegetResponse=client.prepareGet( "index-test" , "weibo" , "1" ).get(); System.out.println(getResponse.getSourceAsString()); //3.prepareDelete方法:删除信息 DeleteResponsedeleteResponse=client.prepareDelete( "index-test" , "weibo" , "4" ).get(); System.out.println(deleteResponse.isFound()); //4.update方法:更新信息 UpdateRequestupdateRequest= new UpdateRequest(); updateRequest.index( "index-test" ); updateRequest.type( "weibo" ); updateRequest.id( "1" ); updateRequest.doc(XContentFactory.jsonBuilder().startObject().field( "interest" , "music" ).endObject()); UpdateResponseupdateResponse=client.update(updateRequest).get(); System.out.println(updateResponse.isCreated()); //update方法:可以为已有的文档添加新的字段 UpdateResponseupdateResponse2=client.prepareUpdate( "index-test" , "weibo" , "1" ) .setDoc(XContentFactory.jsonBuilder() .startObject() .field( "interest2" , "reading" ) .endObject()).get(); System.out.println(updateResponse2.isCreated()); //4.1upsert:在使用update方法时,a:针对文档不存在的情况时,做出index数据的操作,update无效; //b:如果文档存在,那么index数据操作无效,update有效; //先构建一个IndexRequest IndexRequestindexRequest= new IndexRequest( "index-test" , "weibo" , "14" ); indexRequest.source(XContentFactory.jsonBuilder() .startObject() .field( "user" , "yuchen2" ) .field( "interest" , "eating" ) .field( "insert_time" ,df.format( new Date())) .endObject()); //再构建一个UpdateRequest,并用IndexRequest关联 UpdateRequestupdateRequest3= new UpdateRequest( "index-test" , "weibo" , "14" ); updateRequest3.doc(XContentFactory.jsonBuilder() .startObject() .field( "interest2" , "love" ) .endObject() ).upsert(indexRequest); client.update(updateRequest3).get(); if (client!= null ){ client.close(); } } 批量操作 Multi Get Api 和 Bulk Api可进行批量的增删改查 使用Multi Get Api 批量获取: 1 2 3 4 5 6 7 8 9 10 //1.Muti-getApi //可以指定单个id,也在index,type下指定一个id-list;也可以指定别的index/type MultiGetResponsemultiGetResponse=client.prepareMultiGet() .add( "index-test" , "weibo" , "1" ) //指定单个id .add( "index-test" , "weibo" , "11" , "13" , "14" ) //指定一个id-list .add( "index-other" , "news" , "1" , "3" ).get(); //指定别的index/type for (MultiGetItemResponseitem:multiGetResponse){ GetResponseresponse=item.getResponse(); System.out.println(response.getSourceAsString()); } Bulk Api批量增加: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 //2.BulkApi:可以进行批量index和批量删除操作 //2.1批量增加 BulkRequestBuilderbulkRequest=client.prepareBulk(); bulkRequest.add(client.prepareIndex( "index-test" , "weibo" , "20" ) .setSource(XContentFactory.jsonBuilder() .startObject() .field( "user" , "yuchen20" ) .field( "postDate" , new Date()) .field( "message" , "tryingoutElasticsearch" ) .endObject() ) ); bulkRequest.add(client.prepareIndex( "index-test" , "weibo" , "21" ) .setSource(XContentFactory.jsonBuilder() .startObject() .field( "user" , "yuchen21" ) .field( "postDate" , new Date()) .field( "message" , "tryingoutElasticsearch" ) .endObject() ) ); BulkResponsebulkResponse=bulkRequest.get(); if (bulkResponse.hasFailures()){ //... } Bulk Api批量删除: 1 2 3 4 5 6 7 8 9 10 11 //2.2批量删除 BulkRequestBuilderbulkRequest=client.prepareBulk(); bulkRequest.add(client.prepareDelete( "index-test" , "weibo" , "20" ) ); bulkRequest.add(client.prepareDelete( "index-test" , "weibo" , "21" ) ); BulkResponsebulkResponse=bulkRequest.get(); if (bulkResponse.hasFailures()){ System.out.println( "bulkerror:" +bulkResponse.buildFailureMessage()); } Bulk Api 批量更新 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 //2.3批量更新 BulkRequestBuilderbulkRequest=client.prepareBulk(); bulkRequest.add(client.prepareUpdate( "index-test" , "weibo" , "11" ).setDoc(XContentFactory .jsonBuilder().startObject() .field( "country" , "China" ) //新添加字段 .endObject() ) ); bulkRequest.add(client.prepareUpdate( "index-test" , "weibo" , "13" ).setDoc(XContentFactory .jsonBuilder().startObject() .field( "user" , "yuchen13" ) //更新字段 .endObject() ) ); BulkResponsebulkResponse=bulkRequest.get(); if (bulkResponse.hasFailures()){ System.out.println( "bulkerror:" +bulkResponse.buildFailureMessage()); } BulkProcessor设置批量请求的属性 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 //BulkProcessor BulkProcessorbulkProcessor=BulkProcessor.builder(client, new BulkProcessor.Listener(){ @Override public void beforeBulk( long arg0,BulkRequestarg1){ //批量执行前做的事情 System.out.println( "bulkapiactionstarting..." ); } @Override public void afterBulk( long arg0,BulkRequestarg1,Throwablearg2){ System.out.println( "exception:buklapiactionending...:" +arg2.getMessage()); } @Override public void afterBulk( long arg0,BulkRequestarg1,BulkResponsearg2){ //正常执行完毕后... System.out.println( "normal:buklapiactionending..." ); } }) //设置多种条件,对批量操作进行限制,达到限制中的任何一种触发请求的批量提交 .setBulkActions( 1000 ) //设置批量操作一次性执行的action个数,根据请求个数批量提交 //.setBulkSize(newByteSizeValue(1,ByteSizeUnit.KB))//设置批量提交请求的大小允许的最大值 //.setFlushInterval(TimeValue.timeValueMillis(100))//根据时间周期批量提交请求 //.setConcurrentRequests(1)//设置允许并发请求的数量 //设置请求失败时的补偿措施,重复请求3次 //.setBackoffPolicy(BackoffPolicy.exponentialBackoff(TimeValue.timeValueMillis(100),3)) .build(); for ( int i= 0 ;i< 100000 ;i++){ bulkProcessor.add( new IndexRequest( "index-test" , "weibo2" , "" +i).source( XContentFactory .jsonBuilder() .startObject() .field( "name" , "yuchen" +i) .field( "interest" , "love" +i) .endObject())); } bulkProcessor.awaitClose( 5 ,TimeUnit.MINUTES); //释放bulkProcessor资源 System.out.println( "loadsucceed!" ); 默认的参数: sets bulkActions to1000 sets bulkSize to5mb does not set flushInterval sets concurrentRequests to 1 sets backoffPolicy to an exponential backoff with 8 retries and a start delay of 50ms. The total wait time is roughly 5.1 seconds. 参考地址: http://blog.csdn.net/wuyzhen_csdn/article/details/52381697 本文转自yunlielai51CTO博客,原文链接:http://blog.51cto.com/4925054/2084251,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android笔记:代码编写布局

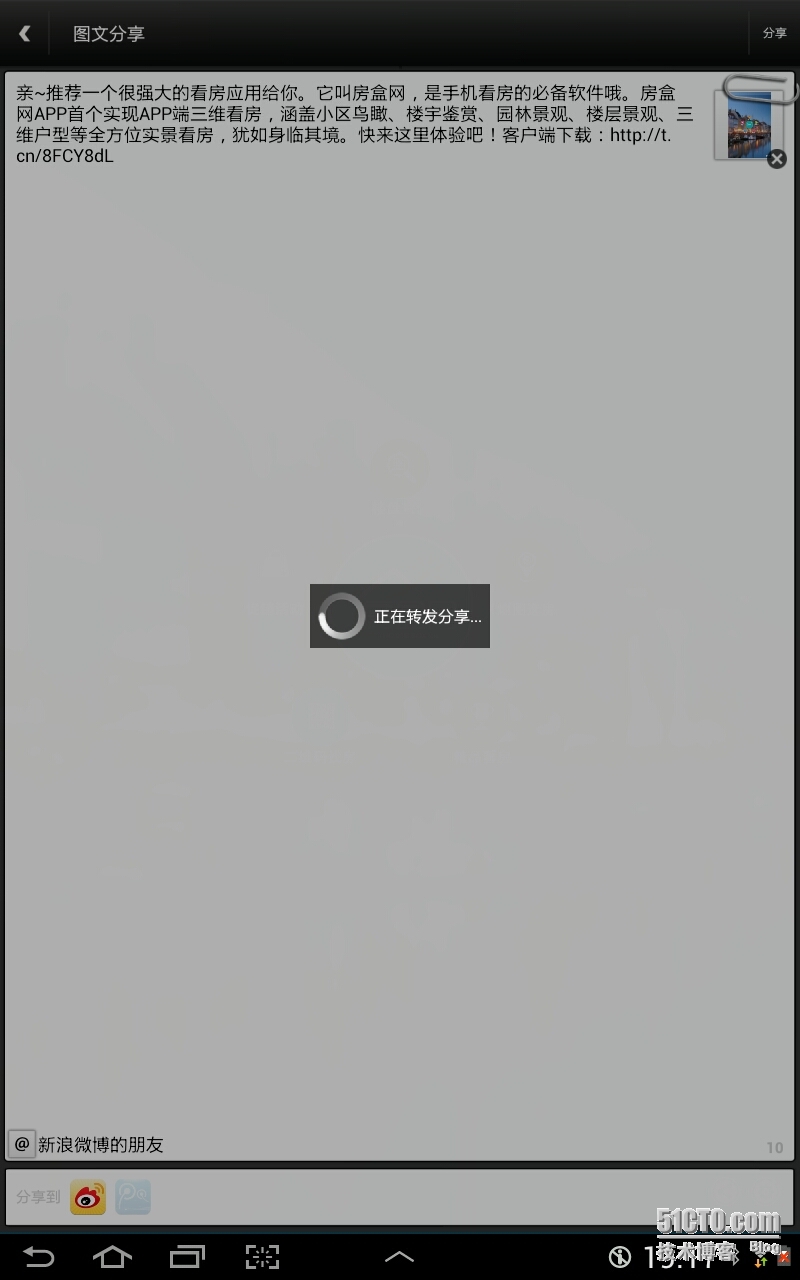
自己在shareSdk原有布局中添加一个加载过程的布局: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 /** 新增:分享发送进度 **/ private void setLoadingUI() { // 页面父布局 pageLayout = new RelativeLayout(getContext()); pageLayout.setLayoutParams( new RelativeLayout.LayoutParams(LayoutParams.FILL_PARENT, LayoutParams.FILL_PARENT)); // 填充编辑页布局 RelativeLayout.LayoutParams llPageLp = new RelativeLayout.LayoutParams(LayoutParams.FILL_PARENT, LayoutParams.FILL_PARENT); llPage.setLayoutParams(llPageLp); pageLayout.addView(llPage); // 加载过程布局 loadReLayout = new RelativeLayout(getContext()); loadReLayout.setLayoutParams( new RelativeLayout.LayoutParams(LayoutParams.FILL_PARENT, LayoutParams.FILL_PARENT)); loadReLayout.setClickable( true ); loadReLayout.setBackgroundColor( 0x50000000 ); loadReLayout.setVisibility(View.GONE); pageLayout.addView(loadReLayout); // 加载过程中间布局 LinearLayout loadCenterLayout = new LinearLayout(getContext()); RelativeLayout.LayoutParams lcLp = new RelativeLayout.LayoutParams(LayoutParams.WRAP_CONTENT, LayoutParams.WRAP_CONTENT); lcLp.addRule(RelativeLayout.CENTER_IN_PARENT); loadCenterLayout.setPadding( 8 , 8 , 8 , 8 ); loadCenterLayout.setBackgroundColor( 0xa5000000 ); loadCenterLayout.setOrientation(LinearLayout.HORIZONTAL); loadReLayout.addView(loadCenterLayout, lcLp); // 进度条和加载中说明 ProgressBar pb = new ProgressBar(getContext()); pb.setLayoutParams( new LinearLayout.LayoutParams(LayoutParams.WRAP_CONTENT, LayoutParams.WRAP_CONTENT)); loadCenterLayout.addView(pb); TextView loadText = new TextView(getContext()); LayoutParams ltlp = new LinearLayout.LayoutParams(LayoutParams.WRAP_CONTENT, LayoutParams.WRAP_CONTENT); ltlp.setMargins( 8 , 0 , 0 , 0 ); ltlp.gravity = Gravity.CENTER_VERTICAL; loadText.setLayoutParams(ltlp); loadText.setText( "正在转发分享..." ); loadText.setTextSize( 16 ); loadText.setTextColor(Color.WHITE); loadCenterLayout.addView(loadText); } 原布局部分代码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 private void initPageView() { // 编辑页父布局 llPage = new LinearLayout(getContext()); llPage.setBackgroundColor( 0xff323232 ); llPage.setOrientation(LinearLayout.VERTICAL); // 新增:分享发送过程 setLoadingUI(); // 标题栏 llTitle = new TitleLayout(getContext()); llTitle.setBackgroundResource(R.drawable.title_back); llTitle.getBtnBack().setOnClickListener( this ); llTitle.getTvTitle().setText(R.string.multi_share); llTitle.getBtnRight().setVisibility(View.VISIBLE); llTitle.getBtnRight().setText(R.string.share); llTitle.getBtnRight().setOnClickListener( this ); llTitle.setLayoutParams( new LinearLayout.LayoutParams(LayoutParams.FILL_PARENT, LayoutParams.WRAP_CONTENT)); llPage.addView(llTitle); FrameLayout flPage = new FrameLayout(getContext()); LinearLayout.LayoutParams lpFl = new LinearLayout.LayoutParams(LayoutParams.FILL_PARENT, LayoutParams.WRAP_CONTENT); lpFl.weight = 1 ; flPage.setLayoutParams(lpFl); llPage.addView(flPage); // 页面主体 LinearLayout llBody = new LinearLayout(getContext()); llBody.setOrientation(LinearLayout.VERTICAL); FrameLayout.LayoutParams lpLl = new FrameLayout.LayoutParams(LayoutParams.FILL_PARENT, LayoutParams.FILL_PARENT); lpLl.gravity = Gravity.LEFT | Gravity.TOP; llBody.setLayoutParams(lpLl); flPage.addView(llBody); // 别针图片 ivPin = new ImageView(getContext()); ivPin.setImageResource(R.drawable.pin); int dp_80 = cn.sharesdk.framework.utils.R.dipToPx(getContext(), 80 ); int dp_36 = cn.sharesdk.framework.utils.R.dipToPx(getContext(), 36 ); FrameLayout.LayoutParams lpPin = new FrameLayout.LayoutParams(dp_80, dp_36); lpPin.topMargin = cn.sharesdk.framework.utils.R.dipToPx(getContext(), 6 ); lpPin.gravity = Gravity.RIGHT | Gravity.TOP; ivPin.setLayoutParams(lpPin); flPage.addView(ivPin); ImageView ivShadow = new ImageView(getContext()); ivShadow.setBackgroundResource(R.drawable.title_shadow); ivShadow.setImageResource(R.drawable.title_shadow); FrameLayout.LayoutParams lpSd = new FrameLayout.LayoutParams(LayoutParams.FILL_PARENT, LayoutParams.WRAP_CONTENT); ivShadow.setLayoutParams(lpSd); flPage.addView(ivShadow); LinearLayout llInput = new LinearLayout(getContext()); llInput.setMinimumHeight(cn.sharesdk.framework.utils.R.dipToPx(getContext(), 150 )); llInput.setBackgroundResource(R.drawable.edittext_back); LinearLayout.LayoutParams lpInput = new LinearLayout.LayoutParams(LayoutParams.FILL_PARENT, LayoutParams.WRAP_CONTENT); int dp_3 = cn.sharesdk.framework.utils.R.dipToPx(getContext(), 3 ); lpInput.setMargins(dp_3, dp_3, dp_3, dp_3); lpInput.weight = 1 ; llInput.setLayoutParams(lpInput); llBody.addView(llInput); //... } 效果图: 本文转自 glblong 51CTO博客,原文链接:http://blog.51cto.com/glblong/1370018,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android笔记:图片倒影、ReflectionImage

ReflectionImage类代码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 import android.content.Context; import android.graphics.Bitmap; import android.graphics.Bitmap.Config; import android.graphics.BitmapFactory; import android.graphics.Canvas; import android.graphics.LinearGradient; import android.graphics.Matrix; import android.graphics.Paint; import android.graphics.PorterDuff.Mode; import android.graphics.PorterDuffXfermode; import android.graphics.Shader.TileMode; import android.graphics.drawable.BitmapDrawable; import android.util.AttributeSet; import android.widget.ImageView; //图片倒影 public class ReflectionImage extends ImageView { // 是否为Reflection模式 private boolean mReflectionMode = true ; public ReflectionImage(Context context) { super (context); } public ReflectionImage(Context context, AttributeSet attrs) { super (context, attrs); // 取得原始图片的bitmap并重画 BitmapDrawable bd = (BitmapDrawable) this .getDrawable(); Bitmap originalImage = bd.getBitmap(); DoReflection(originalImage); } public ReflectionImage(Context context, AttributeSet attrs, int defStyle) { super (context, attrs, defStyle); Bitmap originalImage = ((BitmapDrawable) this .getDrawable()).getBitmap(); DoReflection(originalImage); } public void setReflectionMode( boolean isRef) { mReflectionMode = isRef; } public boolean getReflectionMode() { return mReflectionMode; } // 只重写了setImageResource,和构造函数里面干了同样的事情 @Override public void setImageResource( int resId) { Bitmap originalImage = BitmapFactory.decodeResource(getResources(), resId); DoReflection(originalImage); // super.setImageResource(resId); } private void DoReflection(Bitmap originalImage) { final int reflectionGap = 4 ; // 原始图片和反射图片中间的间距 int width = originalImage.getWidth(); int height = originalImage.getHeight(); // 反转 Matrix matrix = new Matrix(); matrix.preScale( 1 , - 1 ); // reflectionImage就是下面透明的那部分,可以设置它的高度为原始的3/4,这样效果会更好些 Bitmap reflectionImage = Bitmap.createBitmap(originalImage, 0 , 0 , width, height, matrix, false ); // 创建一个新的bitmap,高度为原来的两倍 Bitmap bitmapWithReflection = Bitmap.createBitmap(width, (height + height), Config.ARGB_8888); Canvas canvasRef = new Canvas(bitmapWithReflection); // 先画原始的图片 canvasRef.drawBitmap(originalImage, 0 , 0 , null ); // 画间距 Paint deafaultPaint = new Paint(); canvasRef.drawRect( 0 , height, width, height + reflectionGap, deafaultPaint); // 画被反转以后的图片 canvasRef.drawBitmap(reflectionImage, 0 , height + reflectionGap, null ); // 创建一个渐变的蒙版放在下面被反转的图片上面 Paint paint = new Paint(); LinearGradient shader = new LinearGradient( 0 , originalImage.getHeight(), 0 , bitmapWithReflection.getHeight() + reflectionGap, 0x80ffffff , 0x00ffffff , TileMode.CLAMP); // Set the paint to use this shader (linear gradient) paint.setShader(shader); // Set the Transfer mode to be porter duff and destination in paint.setXfermode( new PorterDuffXfermode(Mode.DST_IN)); // Draw a rectangle using the paint with our linear gradient canvasRef.drawRect( 0 , height, width, bitmapWithReflection.getHeight() + reflectionGap, paint); // 调用ImageView中的setImageBitmap this .setImageBitmap(bitmapWithReflection); } } 本文转自 glblong 51CTO博客,原文链接:http://blog.51cto.com/glblong/1290667,如需转载请自行联系原作者

优秀的个人博客,低调大师

ios ionic 装平台 笔记

1.安装cnpm : npm install -g cnpm --registry=https://registry.npm.taobao.org 2.An error occurred when I was running ” ionic cordova platform add ios “.It noticed me with the information : Using cordova-fetch for cordova-ios@^4.4.0 This problem had been resolved by using commands: cordova platform rm ios cordova platform add ios --nofetch ionic build ios / sudo ionic cordova build ios sudo ionic cordova run ios 安装模拟器: sudo npm install -g ios-sim //代表模拟器运行环境, sudo npm install -g ios-deploy //代表真机运行环境。 ionic emulate –list ionic emulate ios ionic emulate ios –target=”iPhone-6, 10.0” 3. 在mac 系统下安装cordova和ionic的命令 sudo npm install -g cordova ionic 如果您已经安装,要确保已经更新到最新的版本,使用下面的命令 sudo npm update -g cordova ionic 使用ionic创建一个应用名为 myApp以tabbar为基础(除了tabs,还包括slidemenu等) $ ionic start myApp tabs 5.设置ionic的编译的平台 $ ionic login $ cd myApp Sudo cordova platform add ios --nofetch $ ionic build android $ ionic run android —————————————— cd demo_1 isudo cordova build ios : 不要ionic sudo ionic cordova emulate ios //模拟器运行 右击button:Touch Up inside是点击事件,可以看见绑定的代码。 一个按钮可以连接多个方法,一个文本框可以连接多个属性。 判断一个对象是否能连线方法:看该对象是否继承UIControl, UIControl类是用来做控制的。 连线:control+控件,拖到代码处,写方法名,id是控件本身。 /* 判断一个对象是否能连线方法: 看该对象的类是否继承于UIControl 经典的错误:看控制台的reason, 1. 错误一 描述: reason: '[<MainViewController 0x7ffebbc1a880> setValue:forUndefinedKey:]: this class is not key value coding-compliant for the key testLabel.' 原因: 有多余的连线 解决: 删除多余的连线 2.错误二 描述: reason: '-[MainViewController clickBtn:]: unrecognized selector sent to instance 0x7feb69418640' 原因:找不到对应的方法 解决:1.添加对应的方法 2.删除多余的连线 */ 右边的面板:Placehoider(默认显示值),Keyboard Type(键盘类型), http://www.easyicon.net 图标资源。 按钮跳到下一个控制器:点击按钮————拖着指向下一个控制器———点击show 跳转的控制器有返回键:Editor———Embed in ——Navigation Control 将拖过去的StoryBoard保存成左边文件夹里面去:点击故事板的圆圈————editor———refacter to StoryBoard——选择他所对应的控制器的类所在的文件夹. 本文转自农夫山泉别墅博客园博客,原文链接:http://www.cnblogs.com/yaowen/p/7462882.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

android152 笔记 4

42. Android中Task任务栈的分配。 首先我们来看下Task的定义,Google是这样定义Task的:a task is what the user experiences as an "application." It's a group of related activities, arranged in a stack. A task is a stack of activities, not a class or an element in the manifest file. 这意思就是说Task实际上是一个Activity栈,通常用户感受的一个Application就是一个Task。从这个定义来看,Task跟Service或者其他Components是没有任何联系的,它只是针对Activity而言的。 Activity有不同的启动模式, 可以影响到task的分配 Task,简单的说,就是一组以栈的模式聚集在一起的Activity组件集合。它们有潜在的前后驱关联,新加入的Activity组件,位于栈顶,并仅有在栈顶的Activity,才会有机会与用户进行交互。而当栈顶的Activity完成使命退出的时候,Task会将其退栈,并让下一个将跑到栈顶的Activity来于用户面对面,直至栈中再无更多Activity,Task结束。 事件 Task栈(粗体为栈顶组件) 点开Email应用,进入收件箱(ActivityA) A 选中一封邮件,点击查看详情(ActivityB) AB 点击回复,开始写新邮件(ActivityC) ABC 写了几行字,点击选择联系人,进入选择联系人界面(ActivityD) ABCD 选择好了联系人,继续写邮件 ABC 写好邮件,发送完成,回到原始邮件 AB 点击返回,回到收件箱 A 退出Email程序 null 如上表所示,是一个实例。从用户从进入邮箱开始,到回复完成,退出应用整个过程的Task栈变化。这是一个标准的栈模式,对于大部分的状况,这样的Task模型,足以应付,但是,涉及到实际的性能、开销等问题,就会变得残酷许多。 比如,启动一个浏览器,在Android中是一个比较沉重的过程,它需要做很多初始化的工作,并且会有不小的内存开销。但与此同时,用浏览器打开一些内容,又是一般应用都会有的一个需求。设想一下,如果同时有十个运行着的应用(就会对应着是多个Task),都需要启动浏览器,这将是一个多么残酷的场面,十个Task栈都堆积着很雷同的浏览器Activity, 是多么华丽的一种浪费啊。 于是你会有这样一种设想,浏览器Activity,可不可以作为一个单独的Task而存在,不管是来自那个Task的请求,浏览器的Task,都不会归并过去。这样,虽然浏览器Activity本身需要维系的状态更多了,但整体的开销将大大的减少,这种舍小家为大家的行为,还是很值得歌颂的 standard", "singleTop", "singleTask", "singleInstance"。 standard模式, 是默认的也是标准的Task模式,在没有其他因素的影响下,使用此模式的Activity,会构造一个Activity的实例,加入到调用者的Task栈中去,对于使用频度一般开销一般什么都一般的Activity而言,standard模式无疑是最合适的,因为它逻辑简单条理清晰,所以是默认的选择。 而singleTop模式,基本上于standard一致,仅在请求的Activity正好位于栈顶时,有所区别。此时,配置成singleTop的Activity,不再会构造新的实例加入到Task栈中,而是将新来的Intent发送到栈顶Activity中,栈顶的Activity可以通过重载onNewIntent来处理新的Intent(当然,也可以无视...)。这个模式,降低了位于栈顶时的一些重复开销,更避免了一些奇异的行为(想象一下,如果在栈顶连续几个都是同样的Activity,再一级级退出的时候,这是怎么样的用户体验...),很适合一些会有更新的列表Activity展示。一个活生生的实例是,在Android默认提供的应用中,浏览器(Browser)的书签Activity(BrowserBookmarkPage),就用的是singleTop。 singleTask,和singleInstance,则都采取的另辟Task的蹊径。 标志为singleTask的Activity,最多仅有一个实例存在,并且,位于以它为根的Task中。所有对该Activity的请求,都会跳到该Activity的Task中展开进行。singleTask,很象概念中的单件模式,所有的修改都是基于一个实例,这通常用在构造成本很大,但切换成本较小的Activity中。最典型的例子,还是浏览器应用的主Activity(名为Browser...),它是展示当前tab,当前页面内容的窗口。它的构造成本大,但页面的切换还是较快的,于singleTask相配,还是挺天作之合的。 singleInstance显得更为极端一些。在大部分时候singleInstance与singleTask完全一致,唯一的不同在于,singleInstance的Activity,是它所在栈中仅有的一个Activity,如果涉及到的其他Activity,都移交到其他Task中进行。这使得singleInstance的Activity,像一座孤岛,彻底的黑盒,它不关注请求来自何方,也不计较后续由谁执行。在Android默认的各个应用中,很少有这样的Activity,在我个人的工程实践中,曾尝试在有道词典的快速取词Activity中采用过, 是因为我觉得快速取词入口足够方便(从notification中点选进入),并且会在各个场合使用,应该做得完全独立。 大的apk 拆成 很多小的apk ●Activity的android:affinity属性 1.配置后 当启动这个activity时就先去找有没有activity的亲和力属性相同 有就加入这个 activity所在的任务中没有就新开任务(照相和图库就是有亲缘关系的,在照相里面可以点击进去图库。) 2.affinity起作用需要的条件二者具备一个: 1.intent包含FLAG_ACTIVITY_NEW_TASK标记 2.activity元素启用了allowTaskReparenting属性. 43. 在Android中,怎么节省内存的使用,怎么主动回收内存? 回收已经使用的资源,置为null. 合理的使用缓存 合理设置变量的作用范围… application 对象 //未来的某一段时间执行 System.gc(); 44. 不同工程中的方法是否可以相互调用? 可以,列举aidl访问远程服务的例子. 45. 在Android中是如何实现判断区分电话的状态,去电,来电、未接来电? Day8 showAddressService.java 46. dvm的进程和Linux的进程, 应用程序的进程是否为同一个概念 Dvm的进程是dalivk虚拟机进程运行在linux里面,每个android程序都会开启一个Dvm的进程,都运行在自己的进程里面, 每个android程序系统都会给他分配一个单独的liunx uid(user id), 每个dvm都是linux里面的一个进程.所以说这两个进程是一个进程. 47. sim卡的EF 文件有何作用 Sim卡相关的东西,没接触过,sim的存储空间。 48. 如何判断是否有SD卡? 配置文件中有sd卡的权限, 通过environment的静态方法, if (Environment.getExternalStorageState().equals(Environment.MEDIA_MOUNTED)) { 49. 嵌入式操作系统内存管理有哪几种, 各有何特性。 页式,段式,段页,等 … 50. 什么是嵌入式(对CPU和内存要求比较低,单片机就是嵌入式操作系统)实时操作系统, Android 操作系统属于实时操作系统吗? 实时操作系统是指当外界事件或数据产生时,能够接受并以足够快的速度予以处理,其处理的结果又能在规定的时间之内来控制生产过程或对处理系统作出快速响应,并控制所有实时任务协调一致运行的嵌入式操作系统。主要用于工业控制、军事设备、航空航天等领域对系统的响应时间有苛刻的要求,这就需要使用实时系统。又可分为软实时和硬实时两种,而android是基于linux内核的,因此属于软实时。 51. 一条最长的短信息约占多少byte? 中文70(包括标点),英文160,160个字节 这个说法不准确, 要跟手机制式运营商等信息有关. 做实验,看源码 ArrayList<String> msgs = sms.divideMessage(message); for (String msg : msgs) { sms.sendTextMessage(phoneNumber, null, msg, pi, null); } 本文转自农夫山泉别墅博客园博客,原文链接:http://www.cnblogs.com/yaowen/p/5170778.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

openstack学习笔记十一 Nova

计算节点 跑虚拟机 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 [root@hequan~] #yuminstallopenstack-nova.noarchopenstack-nova-api.noarchopenstack-nova-conductor.noarch openstack-nova-novncproxy.noarchopenstack-nova-scheduler.noarchopenstack-nova-console.noarch ##控制节点 [root@hequan~] #yuminstallopenstack-nova-compute.noarch##计算节点 keystoneuser-create--namenova--passhequan keystoneuser-role-add--usernova--roleadmin--tenantservices keystoneservice-create--namenova-- type compute--descriptionnova |7708b5c40aec4cf3b59d6d84596a5f6b|nova|compute|OpenstackComputeService| |017bdbf9f335436cbd7f65fe74089b28|nova_ec2|ec2|EC2Service| |4f7b60427d304fd89658f4f8c23dd708|novav3|computev3|OpenstackComputeServicev3| +----------------------------------+-----------+-------------------------------------------------+-------------------------------------------------+--------------------------------------------+----------------------------------+ | id |region|publicurl|internalurl|adminurl|service_id| +----------------------------------+-----------+-------------------------------------------------+-------------------------------------------------+--------------------------------------------+----------------------------------+ |0bda7145ebc944a99112c53e97362fa1|RegionOne|http: //115 .29.107.17:8774 /v2/ %(tenant_id)s|http: //115 .29.107.17:8774 /v2/ %(tenant_id)s|http: //115 .29.107.17:8774 /v2/ %(tenant_id)s|7708b5c40aec4cf3b59d6d84596a5f6b| |731be711c3be4497b57c8751ce111986|RegionOne|http: //115 .29.107.17:8773 /services/Cloud |http: //115 .29.107.17:8773 /services/Cloud |http: //115 .29.107.17:8773 /services/Admin |017bdbf9f335436cbd7f65fe74089b28| |7ec9cb12959f4bedb7e0757c79b636fd|RegionOne|http: //127 .0.0.1:8774 /v3 |http: //127 .0.0.1:8774 /v3 |http: //127 .0.0.1:8774 /v3 |4f7b60427d304fd89658f4f8c23dd708| keystoneendpoint-create--service- id --publicul '' --internalurl '' --adminurl '' openstack-db--init--servicenova--passwordhequan--root123456 [root@hequan~] #ls-ld/var/log/nova/ drwxr-x---2novaroot40967月2300:08 /var/log/nova/ [root@hequan~] #chownnova.nova/var/log/nova/-R [root@hequannova(keystone_admin)] #mvnova.confnova.conf.bak [root@hequannova(keystone_admin)] #systemctllist-unit-files|grepnova openstack-nova-api.serviceenabled openstack-nova-cert.serviceenabled openstack-nova-compute.serviceenabled openstack-nova-conductor.serviceenabled openstack-nova-console.servicedisabled openstack-nova-consoleauth.serviceenabled openstack-nova-metadata-api.servicedisabled openstack-nova-novncproxy.serviceenabled openstack-nova-scheduler.serviceenabled openstack-nova-xvpvncproxy.servicedisabled vncserver_proxyclient_address=115.29.107.17 ##改成本机的IP vim nova.conf 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 [DEFAULT] internal_service_availability_zone=internal default_availability_zone=nova novncproxy_host=0.0.0.0 novncproxy_port=6080 notify_api_faults=False state_path= /var/lib/nova report_interval=10 enabled_apis=ec2,osapi_compute,metadata ec2_listen=0.0.0.0 ec2_listen_port=8773 ec2_workers=1 osapi_compute_listen=0.0.0.0 osapi_compute_listen_port=8774 osapi_compute_workers=1 metadata_listen=0.0.0.0 metadata_listen_port=8775 metadata_workers=1 compute_manager=nova.compute.manager.ComputeManager service_down_time=60 rootwrap_config= /etc/nova/rootwrap .conf volume_api_class=nova.volume.cinder.API auth_strategy=keystone use_forwarded_for=False heal_instance_info_cache_interval=60 reserved_host_memory_mb=512 cpu_allocation_ratio=16.0 ram_allocation_ratio=1.5 network_api_class=nova.network.neutronv2.api.API default_floating_pool=public force_snat_range=0.0.0.0 /0 metadata_host=115.29.107.17 dhcp_domain=novalocal security_group_api=neutron scheduler_default_filters=RetryFilter,AvailabilityZoneFilter,RamFilter,ComputeFilter,ComputeCapabilitiesFilter,ImagePropertiesFilter,CoreFilter scheduler_driver=nova.scheduler.filter_scheduler.FilterScheduler compute_driver=libvirt.LibvirtDriver vif_plugging_is_fatal=True ##修改False如果有报错实例执行请求失败 vif_plugging_timeout=300 ##修改为0 firewall_driver=nova.virt.firewall.NoopFirewallDriver force_raw_images=True debug=False verbose=True log_dir= /var/log/nova use_syslog=False syslog_log_facility=LOG_USER use_stderr=True notification_topics=notifications rpc_backend=rabbit amqp_durable_queues=False sql_connection=mysql: //nova :hequan@115.29.107.17 /nova image_service=nova.image.glance.GlanceImageService lock_path= /var/lib/nova/tmp osapi_volume_listen=0.0.0.0 vncserver_proxyclient_address=115.29.107.17 ##修改本机地址 vnc_keymap=en-us vnc_enabled=True vncserver_listen=0.0.0.0 novncproxy_base_url=http: //115 .29.107.17:6080 /vnc_auto .html [api_database] [barbican] [cells] [cinder] catalog_info=volumev2:cinderv2:publicURL [conductor] [cors] [cors.subdomain] [database] [ephemeral_storage_encryption] [glance] api_servers=115.29.107.17:9292 [guestfs] [hyperv] [image_file_url] [ironic] [keymgr] [keystone_authtoken] auth_uri=http: //115 .29.107.17:5000 /v2 .0 identity_uri=http: //115 .29.107.17:35357 admin_user=nova admin_password=hequan admin_tenant_name=services [libvirt] virt_type=qemu inject_password=False inject_key=False inject_partition=-1 live_migration_uri=qemu+tcp: //nova @%s /system cpu_mode=none vif_driver=nova.virt.libvirt.vif.LibvirtGenericVIFDriver [matchmaker_redis] [matchmaker_ring] [metrics] [neutron] service_metadata_proxy=True metadata_proxy_shared_secret=hequan url=http: //115 .29.107.17:9696 admin_username=neutron admin_password=hequan admin_tenant_name=services region_name=RegionOne admin_auth_url=http: //115 .29.107.17:5000 /v2 .0 auth_strategy=keystone ovs_bridge=br-int extension_sync_interval=600 timeout=30 default_tenant_id=default [osapi_v21] [oslo_concurrency] [oslo_messaging_amqp] [oslo_messaging_qpid] [oslo_messaging_rabbit] kombu_reconnect_delay=1.0 rabbit_host=115.29.107.17 rabbit_port=5672 rabbit_hosts=115.29.107.17:5672 rabbit_use_ssl=False rabbit_userid=guest rabbit_password=guest rabbit_virtual_host=/ rabbit_ha_queues=False heartbeat_timeout_threshold=0 heartbeat_rate=2 [oslo_middleware] [rdp] [serial_console] [spice] [ssl] [trusted_computing] [upgrade_levels] [vmware] [vnc] [workarounds] [xenserver] [zookeeper] [osapi_v3] enabled=False 1 2 3 4 5 6 7 8 9 10 11 12 [root@hequan~] #nova-manageservicelist [root@hequan~(keystone_admin)] #novahost-list +---------------+-------------+----------+ |host_name|service|zone| +---------------+-------------+----------+ |hequan.lol|consoleauth|internal| |hequan.lol|scheduler|internal| |hequan.lol|conductor|internal| |hequan.lol|compute|nova| |hequan.lol|cert|internal| [root@hequan~] #systemctlis-activelibvirtd.service active 本文转自 295631788 51CTO博客,原文链接:http://blog.51cto.com/hequan/1832697,如需转载请自行联系原作者

优秀的个人博客,低调大师

RHCE 学习笔记(15)- KVM

这一节和老师简单的学习了下KVM的入门知识,主要包括了如何通过图形界面安装VM,基本的配置以及最基本的几个命令。 豆子对其他平台的虚拟机比较熟悉,ESXi,Hyper-V,XenServer 等等,KVM和这3大平台比较起来,知名度要低一些,豆子搜索了一下网上的对比评价,Flexiant发布了一份白皮书,结论让我有点小意外,作为企业级的龙头产品,肯定还是ESXi,但是考虑到性价比,KVM的排名居然还在Hyper-V和Xen之上。 KVM(Kernel-based VM),意思是基于内核的虚拟机。具体的原理和架构豆子不过多阐述,因为我现在也是菜鸟这里有个博客解释的还是比较清楚 https://www.linuxwind.org/html/learning-the-kvm-01.html 下面演示记录一下实验的步骤,实际是在我现有的一个ESXi的RHEL虚拟机上做一个嵌套的操作。 首先RHEL的CPU需要设置支持虚拟化 查看一下配置文件,确认vmx已经添加 配置Yum 源 ,查看组 安装组 装完以后看看服务是否启动 如果没装virt-manager,安装一下 装好之后后台打开 virt-manger & 就可以创建虚拟机了 一路点下去,根据自己需求酌情修改 豆子安装了一个Ubuntu12的虚拟机 大概20分钟装完了,打开虚拟机,点击灯泡图案,可以查看配置 默认的网络配置是NAT 在宿主机上看看,会多了一个虚拟的网卡出来,这个虚拟网卡对于虚拟机来说,相当于一个交换机 他是可以从宿主机Ping 通 虚拟机的,甚至虚拟机可以直接ping 通我的物理机,相当于虚拟机的eth0网卡连接到了virbr0,然后virbr0又连接到了RHEL的eno网卡,这样一层层的转发出来 切换到root 用户,可以执行命令行来进行操作,virsh有上百个选项,最简单的比如查看,启动,关闭 注意virsh shutdown 和 virsh destroy 的区别,前者是正常关闭,后面那个相当于poweroff(直接断电) 对于宿主机,我们也可以进行配置,比如添加新的网络,这个和vmware workstation很像。 随便添加一个 Host的修改完毕之后,在VM上就能看见新的网络选项了,相当于多了一个交换机的选择出来 重启以后进去就能看见两个网卡都配置好了 最后说说存储池,这个是默认的VM文件存放点 查看一下 本文转自 beanxyz 51CTO博客,原文链接:http://blog.51cto.com/beanxyz/1600499,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android笔记:关于so文件

项目里包含了多个带有so文件的第三方库,支持的平台数不一样。当应用跑在5.0系统上便会崩溃,后发现是有些第三方库的x86-64的so文件没有安装。 查看了官网的ABIManager,似乎写得并不够清晰。处理过程中,发现信鸽sdk附带的一份说明倒是让人很容易的理解so文件的安装机制。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 1 .信鸽的.so支持所有的android平台,但考虑到平时接入一般只需要armeabi平台,因此libs目录只提供该平台的.so,其它平台可在上层目录的All-Platform-SO找到。 2 .嵌入.so可能存在的问题: a.so文件与jar包不匹配。 解决办法:在更新jar时同时更新对应的so文件; b.当前工程已有某些平台的so,如只有armeabi平台,却添加信鸽所有平台导致打包时异常。 解决办法:只添加当前工程已有的平台的信鸽so文件。具体可参考网上或以下示例: armeabi !此平台既有当前存在so又有信鸽,正常! --libCurrent.so 当前工程已有so --libtpnsSecurity.so 信鸽 --libtpnsWatchdog.so 信鸽 armeabi-v7a !此平台既有当前存在so又有信鸽,正常! --libCurrent.so 当前工程已有so --libtpnsSecurity.so 信鸽 --libtpnsWatchdog.so 信鸽 mips !!!错误,由于此平台只有信鸽,必须删掉mips目录!!! --libtpnsSecurity.so 信鸽 --libtpnsWatchdog.so 信鸽 x86 !!!错误,由于此平台只有信鸽,必须删掉x86目录!!! --libtpnsSecurity.so 信鸽 --libtpnsWatchdog.so 信鸽 c.若当前工程不存在so文件。 解决办法:可复制所有信鸽平台或只复制armeabi平台 再结合其他参考文章,应该可以大概总结如下: 至少包含armeabi平台 多个不同库都有so文件时 就以包含支持最少平台的那个为准 其他参考: 1.http://www.open-open.com/lib/view/open1440421271716.html 2.http://stackoverflow.com/questions/30782848/how-to-use-32-bit-native-libaries-on-64-bit-android-device 本文转自 glblong 51CTO博客,原文链接:http://blog.51cto.com/glblong/1698839,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册