首页 文章 精选 留言 我的

精选列表

搜索[玩转EdgeOne],共1751篇文章
优秀的个人博客,低调大师

看看大厂是如何玩转线程池

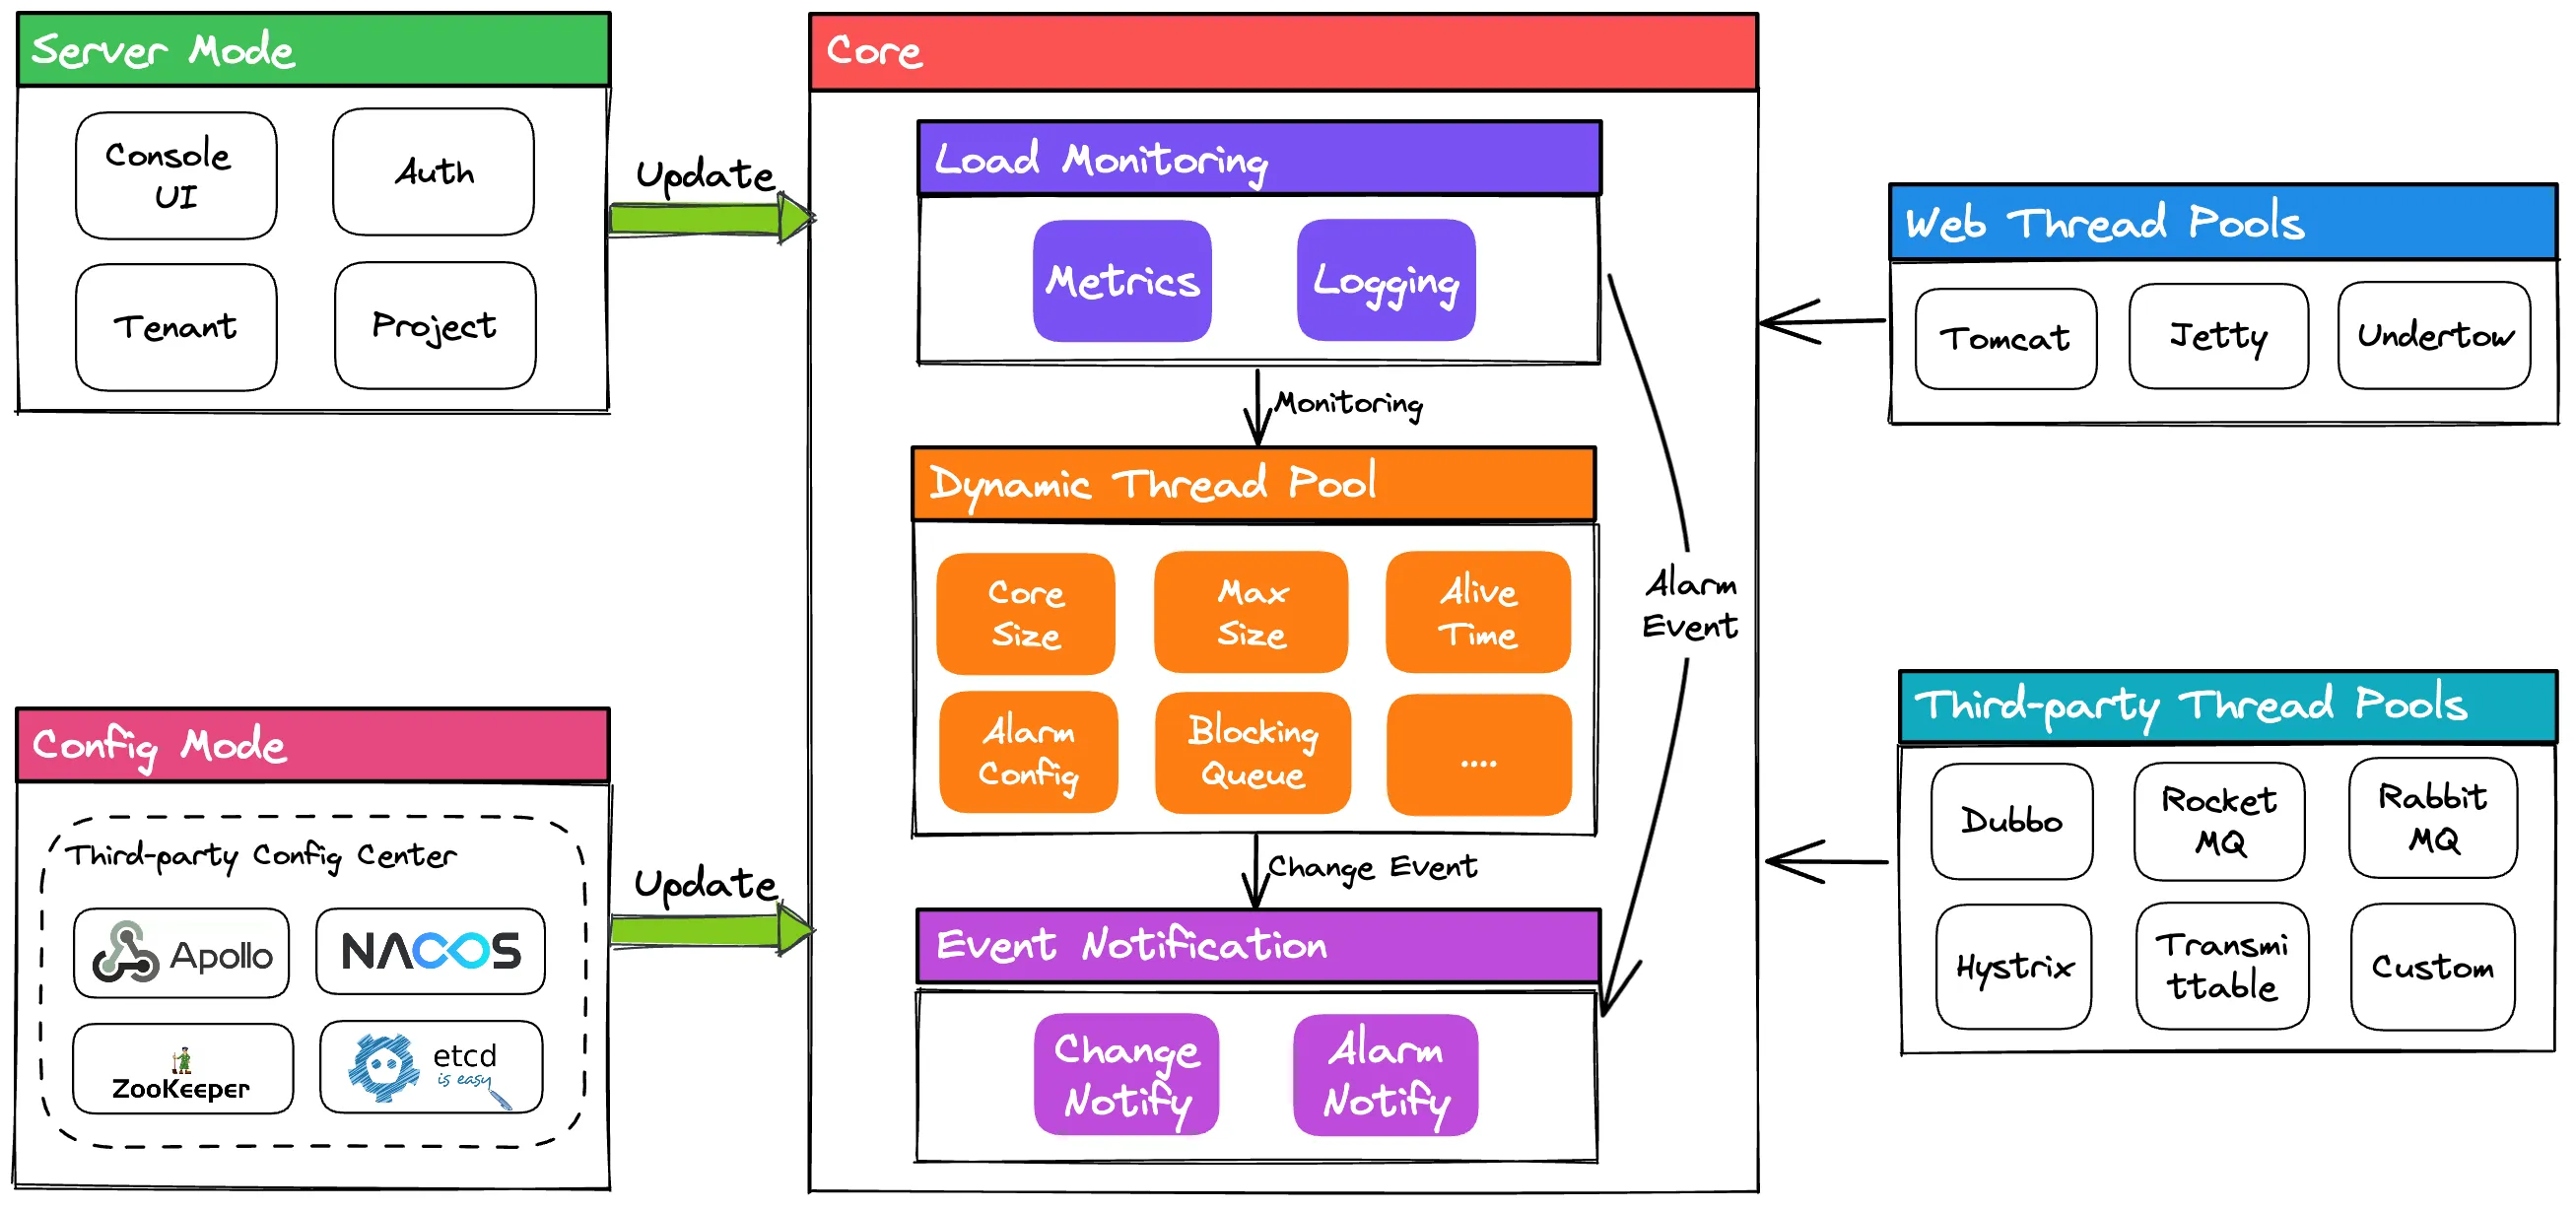
### 写在前面 大家好,这里是**IT学习日记**。今日推荐项目:**hippo4j,获取方式在文后!** 1000+优质开源项目推荐进度:**42/1000**。如需更多类型优质项目推荐,请在文章后留言。 ### 项目简介 **线程池的使用在项目过程中是非常常见的,它可以有效减少创建和销毁线程的开销,提高效率,但是定义不规范也容易引发许多问题如:定义过多,导致服务器高负载等。** 那么有没有一款工具能够可视化观察线程池的状况,并根据实际情况动态调整呢,异常时可以告警通知呢?经过在开源社区的一番探索,我找到了这款工具-hippo4j。 ![](https://developer.qcloudimg.com/http-save/yehe-9303198/0e7c2e40711e4f6fdb635791975bd8f2.png) **hippo4j:是一款基于JAVA语言实现的动态可观测线程池项目,能够有效提高系统运行保障能力,它支持全局管控线程池实例、应用运行时动态变更线程池参数如最大线程数,拒绝策略等,从而优化线程池的性能和资源利用率。** ![](https://developer.qcloudimg.com/http-save/yehe-9303198/060f011f2a17d6248443d27fb6fe6c92.png) ### 线程池痛点 **尽管线程池的使用带来了诸多优势,但也伴随不少隐患。** - 随意定义线程池导致线程资源过多,造成服务器高负载。 - 难以评估线程池参数,随着业务并发增加,故障风险也随之上升。 - 线程池任务执行时间超出平均周期,开发人员难以察觉。 - 任务堆积触发拒绝策略,影响业务正常运行。 - 业务出现超时、熔断等问题时,由于缺乏监控,无法确认是否由线程池引发。 - 原生线程池不支持运行时变量传递,如 MDC 上下文在遇到线程池时失效。 - 无法优雅关闭项目,导致正在运行的线程池任务在项目关闭时被强制丢弃。 - 线程池运行中,任务执行中断,可能是死锁或耗时操作引起,但无法定位原因。 ### 项目特点 **如何解决原生线程池带来的诸多弊端呢?Hippo4j在设计层面考虑并解决了这类问题。通过全局管控进行对线程池统一管理,支持可视化监控和动态变更可以更灵活控制线程池,并提供通知策略作为兜底方案,异常情况下可以人为介入避免系统出现崩溃。** ![](https://developer.qcloudimg.com/http-save/yehe-9303198/3bc841726c87da781606d76441e50bbc.png) - **全局管控** - 统一管理应用中的线程池实例。 - **动态变更** - 支持应用运行时动态调整线程池参数,包括但不限于核心线程数、最大线程数、阻塞队列容量和拒绝策略。 - **通知报警** - 内置四种报警策略,涵盖线程池活跃度、容量水位、拒绝策略和任务执行时间过长。 - **数据采集** - 支持多种数据采集方式,如日志、内置采集、Prometheus、InfluxDB、ElasticSearch 等。 - **运行监控** - 实时监控线程池运行数据,并可视化展示自定义时间段内的运行情况。 - **功能扩展** - 支持线程池任务上下文传递;项目关闭时,可等待线程池在指定时间内完成任务。 - **多种模式** - 内置两种使用模式:依赖配置中心模式和无中间件依赖模式。 - **容器管理** - 支持 Tomcat、Jetty、Undertow 容器线程池的实时查看和线程数动态调整。 - **框架适配** - 适配 Dubbo、Hystrix、RabbitMQ、RocketMQ 等框架的消费线程池运行数据查看和线程数调整。 - **变更审核** - 提供多用户角色管理,普通用户变更线程池参数需经过 Admin 审核后方可生效。 - **动态化插件** - 内置多种线程池插件,支持用户自定义插件及运行时扩展。 - **多版本适配** - 经过测试,支持客户端 SpringBoot 1.5.x 到 2.7.5 版本(更高版本尚未测试)。 ![](https://developer.qcloudimg.com/http-save/yehe-9303198/ae7c95a67b25223835cf42094a6060e3.png) ### 功能展示 - **租户管理**:租户基础信息维护,用于数据隔离 ![](https://developer.qcloudimg.com/http-save/yehe-9303198/5e92228b724285274c67ccbe6f60f93d.png) - **动态线程池**:统一管理线程信息,包括动态变更线程池参数和线程池监控可视化 ![](https://developer.qcloudimg.com/http-save/yehe-9303198/7f8a529f8003c9f75458001effa41af6.png) - **线程池审核**:管理变更线程池参数的审核,只有审核通过才会实际变更线程池参数 ![](https://developer.qcloudimg.com/http-save/yehe-9303198/e98507174d2748570153ed0e8cc2414c.png) - **容器线程池**:统一管理第三方容器的线程池基础信息如:Tomcat、Jetty等 ![](https://developer.qcloudimg.com/http-save/yehe-9303198/6fd9af4a48e525404b32809d5380ff71.png) - **通知报警**:支持监控线程池异常,并推送异报警通知。现阶段已集成钉钉、企业微信、飞书的消息推送,后续会持续接入邮箱、短信和自定义通知渠道。 ![](https://developer.qcloudimg.com/http-save/yehe-9303198/dd45f6addcb5da7cc13db2ebd34d8c7b.png) ![](https://developer.qcloudimg.com/http-save/yehe-9303198/b5d79c566775aa5e434dc8b235d145d6.png) ![](https://developer.qcloudimg.com/http-save/yehe-9303198/00b9fca3dc66b470bfbd35ffd359736b.png) ![](https://developer.qcloudimg.com/http-save/yehe-9303198/ebf517877d8ef476c03dda9d474facd8.png) ### 项目获取 **在文后留言:项目,即可获取!** 如果这篇文章对您有帮助,请一定帮我点个 “点赞” 和 “收藏”, 这对我非常重要。我将会继续推荐更多优质项目和新闻

优秀的个人博客,低调大师

玩转 deepin 工作区,从这篇文章开始

本文来自社区用户“树哥”的投稿,给大家介绍一下 deepin 的“四大天王”工作区。 工作区(类似“多任务桌面”):位于任务栏的左侧,你可以通过点击快速切换工作区视图,也可以通过点击任务栏-应用区域的“多任务视图”来关闭多余的工作区。 在介绍 deepin 系统的四大工作区时,我将采用“四大天王”的比喻方式,可以生动形象地阐述这些工作区的特点与优势。以下是我在日常生活中使用多工作区管理这个功能的一些场景: deepin 系统的工作区功能强大,如同佛教中的“四大天王”,各自镇守一方,共同维护系统的稳定与高效。这四大工作区分别代表不同的工作环境和场景,小伙伴们可以根据需求灵活切换,提高工作效率。以下是对 deepin 系统四大工作区的详细介绍: 第一工作区:高效办公之“持国天王” 特点:持国天王象征着稳定与秩序,对应 deepin 系统中的高效办公工作区。这个工作区注重在进行日常办公任务时的效率与专注度。 功能:我们可以在此工作区内设置常用的办公软件和工具,如文档编辑器、电子表格、邮件客户端等。通过优化桌面布局和窗口管理,实现快速启动和切换,提高办公效率。 第二工作区:创意设计之“多闻天王” 特点:多闻天王象征着知识与智慧,对应 deepin 系统中的创意设计工作区。这个工作区专为设计师和创意工作者打造,提供丰富的图形处理、视频编辑和动画制作工具。 功能:大家可以在此工作区内找到专业的设计软件,如图像处理软件、三维建模工具等。同时,系统还支持高性能的图形加速和硬件加速,确保创意设计工作的流畅进行。 第三工作区:娱乐休闲之“广目天王” 特点:广目天王象征着广阔的视野和丰富的娱乐,对应 deepin 系统中的娱乐休闲工作区。这个工作区为大家提供轻松愉悦的娱乐体验,包括音乐、视频、游戏等多媒体内容。 功能:我们可以在此工作区内享受高品质的音乐和视频播放,还可以畅玩各类游戏。系统优化了多媒体处理性能,确保娱乐体验的流畅和舒适。 第四工作区:学习研究之“增长天王” 特点:增长天王象征着不断学习和成长,对应 deepin 系统中的学习研究工作区。这个工作区专注于提供优质的学习资源和研究工具,帮助我们不断提升自我。 功能:我们可以在此工作区内找到各类学习资源,如电子书、在线课程、学术数据库等。同时,系统还支持多种学习工具,如笔记软件、思维导图等,方便大家进行知识整理和思维拓展。 四大工作区的协同与切换 deepin 系统的四大工作区并不是孤立的,它们之间可以相互协同工作。各位小伙伴可以像我一样根据需要灵活切换工作区,实现多任务处理的高效管理。通过快捷键或鼠标手势等操作方式,我们就可以轻松地在不同工作区之间进行切换,提高工作效率和灵活性。 deepin 工作区快捷键 综上所述,deepin 系统的四大工作区如同“四大天王”一样,各自镇守一方,提供高效、便捷、多样化的使用体验。无论是办公、创意设计、娱乐休闲还是学习研究,小伙伴们都能在 deepin 系统中找到适合自己的工作区和工具。 小tips:工作区最多可以添加6个,不同的工作区可以设置不同的壁纸哟! 感谢社区用户树哥的投稿,也欢迎其他 deepiner 们投稿,分享你们与 deepin 的故事。 相关阅读: (1)支持 deepin(深度)社区 (2)Linux 上 Steam 游戏配置教程合集 (3)DDE 深度桌面环境详情 询问AI

优秀的个人博客,低调大师

玩转Spring状态机 | 京东云技术团队

说起Spring状态机,大家很容易联想到这个状态机和设计模式中状态模式的区别是啥呢?没错,Spring状态机就是状态模式的一种实现,在介绍Spring状态机之前,让我们来看看设计模式中的状态模式。 1. 状态模式 状态模式的定义如下: 状态模式(State Pattern)是一种行为型设计模式,它允许对象在内部状态发生变化时改变其行为。在状态模式中,一个对象的行为取决于其当前状态,而且可以随时改变这个状态。状态模式将对象的状态封装在不同的状态类中,从而使代码更加清晰和易于维护。当一个对象的状态改变时,状态模式会自动更新该对象的行为,而不需要在代码中手动进行判断和处理。 通常业务系统中会存在一些拥有状态的对象,而且这些状态之间可以进行转换,并且在不同的状态下会表现出不同的行为或者不同的功能,比如交通灯控制系统中会存在红灯、绿灯和黄灯,再比如订单系统中的订单会存在已下单、待支付、待发货、待收货等状态,这些状态会通过不同的行为进行相互转换,这时候在系统设计时就可以使用状态模式。 下面是状态模式的类图: 可以看到状态模式主要包含三种类型的角色: 1、上下文(Context)角色:封装了状态的实例,负责维护状态实例,并将请求委托给当前的状态对象。 2、抽象状态(State)角色:定义了表示不同状态的接口,并封装了该状态下的行为。所有具体状态都实现这个接口。 3、具体状态(Concrete State)角色:具体实现了抽象状态角色的接口,并封装了该状态下的行为。 下面是使用状态模式实现红绿灯状态变更的一个简单案例: 抽象状态类: /** * @description: 抽象状态类 */ public abstract class MyState { abstract void handler(); } 具体状态类A /** * @description: 具体状态A */ public class RedLightState extends MyState{ @Override void handler() { System.out.println("红灯停"); } } 具体状态类B /** * @description: 具体状态B */ public class GreenLightState extends MyState{ @Override void handler() { System.out.println("绿灯行"); } } 环境类:维护当前状态对象,并提供了切换状态的方法。 /** * @description: 环境类 */ public class MyContext { private MyState state; public void setState(MyState state) { this.state = state; } public void handler() { state.handler(); } } 测试类 /** * @description: 测试状态模式 */ public class TestStateModel { public static void main(String[] args) { MyContext myContext = new MyContext(); RedLightState redLightState = new RedLightState(); GreenLightState greenLightState = new GreenLightState(); myContext.setState(redLightState); myContext.handler(); //红灯停 myContext.setState(greenLightState); myContext.handler(); //绿灯行 } } 下面是对应的执行结果  可以发现,使用状态模式中的状态类在一定程度上也消除了if-else逻辑校验,看到这里, 有些人可能会有疑问:状态模式和策略模式的区别是什么呢? 状态模式更关注对象在不同状态的行为和状态之间的流转,而策略模式更关注对象不同策略的选择。 上面我们介绍了设计模式中的状态模式,接下来我们来看看Spring状态机。 2. Spring状态机 状态机,也就是 State Machine ,不是指一台实际机器,而是指一个数学模型 。说白了,就是指一张状态转换图。 状态机是状态模式的一种应用,相当于上下文角色的一个升级版。在工作流或游戏等各种系统中有大量使用,如各种工作流引擎,它几乎是状态机的子集和实现,封装状态的变化规则。Spring也提供了一个很好的解决方案。Spring中的组件名称就叫作状态机(StateMachine)。状态机帮助开发者简化状态控制的开发过程,让状态机结构更加层次化。 通过定义,我们很容易分析得到状态机应当具备一下几个要素: 1. 当前状态:也就是状态流转的起始状态。 2. 触发事件:引起状态之间流转的一些列动作。 3. 响应函数:触发事件到下一个状态之间的规则。 4. 目标状态:状态流转的目标状态。 对于组件化的状态机,当前使用较多的主要是两种:一种是Spring 状态机,一种是COLA状态机,这两种状态机的对比如下表所示:  Spring 状态机 COLA 状态机 API 调用 使用 Reactive 的 Mono、Flux 方式进行 API 调用 同步的 API 调用,如果有需要也可以将方法通过 消息队列、定时任务、多线程等方式进行异步调用 代码量 core 包 284 个接口和类 36 个接口和类 生态 非常丰富 较为贫瘠 定制化难度 困难 简单 可以看到,Spring状态机锁提供的内容较为丰富,当然对于自定义的支持就不如COLA状态机好,如果对自定义的需求比较高,那建议使用COLA状态机。 本文以Spring状态机为例,展示如何在业务系统中使用状态机。 为了便于大家了解Spring状态机的实现原理和使用方式以及其提供的功能,下面列出了官方文档和源码,感兴趣的同学可以阅读阅读。 官方文档: https://docs.spring.io/spring-statemachine/docs/4.0.0/reference/index.html#statemachine-config-states 源代码: https://github.com/spring-projects/spring-statemachine 3. Spring状态机实现订单状态流转 对于状态模式,Spring封装好了一个组件,就叫状态机(StateMachine)。Spring状态机可以帮助我们开发者简化状态控制的开发过程,让状态机结构更加层次化。下面用Spring状态机模拟一个订单状态流转的过程。 3.1 环境准备 首先,如果要使用spring状态机,需要引入对应的jar包,这里我的springboot版本是:2.2.1.RELEASE <dependency> <groupId>org.springframework.statemachine</groupId> <artifactId>spring-statemachine-core</artifactId> <version>${springboot.version}</version> </dependency> 下面是简化的订单的定义,以及订单状态和订单转换行为的枚举 /** * @description: 模拟订单类 */ @Data public class Order { private Long orderId; private OrderStatusEnum orderStatus; } /** * @description: 订单状态 */ public enum OrderStatusEnum { // 待支付 WAIT_PAYMENT, // 待发货 WAIT_DELIVER, // 待收货 WAIT_RECEIVE, // 完成 FINISH; } /** * @description:订单状态转换行为 */ public enum OrderStatusChangeEventEnum { //支付 PAYED, //发货 DELIVERY, //收货 RECEIVED; } 3.2 构造订单状态机 在引入jar包之后,需要构建一个针对订单状态流转的状态机 订单状态机配置类如下: /** * @description: 订单状态机 */ @Configuration @EnableStateMachine public class OrderStatusMachineConfig extends StateMachineConfigurerAdapter<OrderStatusEnum, OrderStatusChangeEventEnum> { /** * 配置状态 */ @Override public void configure(StateMachineStateConfigurer<OrderStatusEnum, OrderStatusChangeEventEnum> states) throws Exception { states.withStates() .initial(OrderStatusEnum.WAIT_PAYMENT) .end(OrderStatusEnum.FINISH) .states(EnumSet.allOf(OrderStatusEnum.class)); } /** * 配置状态转换事件关系 */ @Override public void configure(StateMachineTransitionConfigurer<OrderStatusEnum, OrderStatusChangeEventEnum> transitions) throws Exception { transitions.withExternal().source(OrderStatusEnum.WAIT_PAYMENT).target(OrderStatusEnum.WAIT_DELIVER) .event(OrderStatusChangeEventEnum.PAYED) .and() .withExternal().source(OrderStatusEnum.WAIT_DELIVER).target(OrderStatusEnum.WAIT_RECEIVE) .event(OrderStatusChangeEventEnum.DELIVERY) .and() .withExternal().source(OrderStatusEnum.WAIT_RECEIVE).target(OrderStatusEnum.FINISH) .event(OrderStatusChangeEventEnum.RECEIVED); } } 3.3 编写状态机监听器 监听状态变更事件,完成状态转换。 /** * @description: 状态监听 */ @Component @WithStateMachine @Transactional public class OrderStatusListener { @OnTransition(source = "WAIT_PAYMENT", target = "WAIT_DELIVER") public boolean payTransition(Message message) { Order order = (Order) message.getHeaders().get("order"); order.setOrderStatus(OrderStatusEnum.WAIT_DELIVER); System.out.println("支付,状态机反馈信息:" + message.getHeaders().toString()); return true; } @OnTransition(source = "WAIT_DELIVER", target = "WAIT_RECEIVE") public boolean deliverTransition(Message message) { Order order = (Order) message.getHeaders().get("order"); order.setOrderStatus(OrderStatusEnum.WAIT_RECEIVE); System.out.println("发货,状态机反馈信息:" + message.getHeaders().toString()); return true; } @OnTransition(source = "WAIT_RECEIVE", target = "FINISH") public boolean receiveTransition(Message message) { Order order = (Order) message.getHeaders().get("order"); order.setOrderStatus(OrderStatusEnum.FINISH); System.out.println("收货,状态机反馈信息:" + message.getHeaders().toString()); return true; } } 3.4 编写订单服务类 模拟对订单的一些业务操作 /** * @description: 订单服务 */ @Service public class OrderServiceImpl implements OrderService { @Resource private StateMachine<OrderStatusEnum, OrderStatusChangeEventEnum> orderStateMachine; private long id = 1L; private Map<Long, Order> orders = Maps.newConcurrentMap(); @Override public Order create() { Order order = new Order(); order.setOrderStatus(OrderStatusEnum.WAIT_PAYMENT); order.setOrderId(id++); orders.put(order.getOrderId(), order); System.out.println("订单创建成功:" + order.toString()); return order; } @Override public Order pay(long id) { Order order = orders.get(id); System.out.println("尝试支付,订单号:" + id); Message message = MessageBuilder.withPayload(OrderStatusChangeEventEnum.PAYED). setHeader("order", order).build(); if (!sendEvent(message)) { System.out.println(" 支付失败, 状态异常,订单号:" + id); } return orders.get(id); } @Override public Order deliver(long id) { Order order = orders.get(id); System.out.println(" 尝试发货,订单号:" + id); if (!sendEvent(MessageBuilder.withPayload(OrderStatusChangeEventEnum.DELIVERY) .setHeader("order", order).build())) { System.out.println(" 发货失败,状态异常,订单号:" + id); } return orders.get(id); } @Override public Order receive(long id) { Order order = orders.get(id); System.out.println(" 尝试收货,订单号:" + id); if (!sendEvent(MessageBuilder.withPayload(OrderStatusChangeEventEnum.RECEIVED) .setHeader("order", order).build())) { System.out.println(" 收货失败,状态异常,订单号:" + id); } return orders.get(id); } @Override public Map<Long, Order> getOrders() { return orders; } /** * 发送状态转换事件 * @param message * @return */ private synchronized boolean sendEvent(Message<OrderStatusChangeEventEnum> message) { boolean result = false; try { orderStateMachine.start(); result = orderStateMachine.sendEvent(message); } catch (Exception e) { e.printStackTrace(); } finally { if (Objects.nonNull(message)) { Order order = (Order) message.getHeaders().get("order"); if (Objects.nonNull(order) && Objects.equals(order.getOrderStatus(), OrderStatusEnum.FINISH)) { orderStateMachine.stop(); } } } return result; } } 3.5 测试入口 这里编写一个controller模拟c端用户请求,为了便于展示,这里使用一个测试方法完成所有的操作 @RestController public class OrderController { @Resource private OrderService orderService; @RequestMapping("/testOrderStatusChange") public String testOrderStatusChange(){ orderService.create(); orderService.create(); orderService.pay(1L); orderService.deliver(1L); orderService.receive(1L); orderService.pay(2L); orderService.deliver(2L); orderService.receive(2L); System.out.println("全部订单状态:" + orderService.getOrders()); return "success"; } } 下面是对应的执行结果  可以看到spring状态机很好的控制了订单在各个状态之间的流转。 4. 思考与总结 思考:针对状态机的特点,还有其他思路实现一个状态机吗?下面是一些常规思路,如果还有其他方法欢迎在评论区留言。 1. 消息队列方式 订单状态的流转可以通过MQ发布一个事件,消费者根据业务条件把订单状态进行流转,可以根据不同的事件发送到不同的Topic。 2. 定时任务驱动 每隔一段时间启动一下job,根据特定的状态从数据库中拿对应的订单记录,然后判断订单是否有条件到达下一个状态。 3. 规则引擎方式 业务团队可以在规则引擎里编写一系列的状态及其对应的转换规则,由规则引擎根据已经加载的规则对输入数据进行解析,根据解析的结果执行相应的动作,完成状态流转。 总结: 本文主要介绍了设计模式中的状态模式,并在此基础上介绍了Spring状态机相关的概念,并根据常见的订单流转场景,介绍了Spring状态机的使用方式。文中如有不当之处,欢迎在评论区批评指正。 5. 参考内容 https://docs.spring.io/spring-statemachine/docs/4.0.0/reference/index.html#statemachine-config-states https://cloud.tencent.com/developer/article/2198477?areaId=106001 https://cloud.tencent.com/developer/article/2360708?areaId=106001 https://juejin.cn/post/7087064901553750030 https://my.oschina.net/u/4090830/blog/10092135 https://juejin.cn/post/7267506576448929811 作者:京东科技 孙扬威 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

【案例分享】OneOS带你玩转高精度定位组件

一、服务简介 OneOS高精度定位服务基于中移智行的高精度定位平台,可以为搭载OneOS的物联网硬件提供最高动态厘米级、静态毫米级的卫星定位能力;并且针对性优化了物联网硬件在使用差分服务时资源占用过大的问题。包含三种服务:厘米级RTK、亚米级RTK、亚米级RTD,开发者可根据使用场景和硬件配置灵活选用相应服务。服务详细介绍如下: 二、高精度定位组件 OneOS高精度定位组件是一种端云融合组件,需要搭配OneOS的CMS(China Mobile Service,即中国移动服务框架,是中国移动OneOS操作系统服务合集)服务平台使用,搭载OneOS的物联网端侧使用CMS组件接入平台后即可使用高精度定位功能。OneOS中高精度定位组件具体配置开启方式参考文档。 1、环境准备 本次采用OneOS万耦创世开发板(STM32L475VGT6) + 蜂窝模组(ML302)+ GNSS模块(ublox-f9p)的方案进行演示! (1)OneOS下载 地址:https://os.iot.10086.cn/download/ (2)OneOS Cube下载并安装 地址:https://os.iot.10086.cn/download/tool (3)开发板准备与连接 开发板的console对应的是MCU的uart3 ML302与MCU的uart4连接 GNSS模块与MCU的uart2连接 (4)工程生成与配置 解压OneOS源码,然后进入projects目录 右键选择OneOS Cube并打开 键入oos project命令后,会弹出工程选择菜单 选择开发版本对应的工程,然后保存配置 进入刚生成的工程目录中,用oosinit -i keil命令进行工程编译 编译无误后打开keil工程,然后编译生成可执行文件,并烧录 连接console并键入version命令验证开发板是否启动正常 2、CMS服务配置 物联网设备调用CMS服务时需要在“CMS工作台”中创建自己的产品,然后为产品开通相应的定位服务;商用的高精度服务是一个收费的服务,具体配置参考《OneOS定位服务-专用服务功能手册》](OneOS定位服务-专用服务功能手册 v0.1 20230621.pdf)。 点击左侧产品列表,选择要配置的产品,然后点击服务配置,选择右侧的具体服务,这里选择高精度服务中对应的测试服务(为方便开发者们尝鲜试用与临时调试,OneOS提供了测试用的高精度定位服务)。 3、组件配置 (1)组件下载 位置服务组件已上传OneOS的组件中心,可在工程目录中使用命令oos pack download position下载位置服务组件;下载位置服务组件时会自动将所依赖的组件(CMS组件和cJSON组件)一起下载。 (2)网络组件配置 进入工程目录,使用OneOS Cube工具进行工程配置; 键入 oos config命令打开配置菜单; 本次演示使用cat.1模组进行网络通信,在配置菜单中进行如下配置。 (3)CMS组件配置 在工程中配置进刚才在CMS平台新建的产品ID和其对应密钥; ​​​​​​​(4)高精度定位组件配置 在位置服务组件中开启高精度定位功能 ​​​​​​​​​​​​​​(5)工程编译与烧录 保存配置,使用oos init -i keil命令进行工程编译配置,然后打开keil工程,点击编译选项,编译工程,生成可执行文件并进行烧录。 ​​​​​​​4、定位结果展示 在户外场景,连接开发板的console,使用shell命令onepos gnss_test开启gnss功能。 ​​​​​​​​​​​​​​(1)静态定位结果 平台页面 相对精度 (2)​​​​​​​动态定位结果 相对精度 绝对精度

优秀的个人博客,低调大师

Llama 2 来袭 - 在 Hugging Face 上玩转它

🤗 宝子们可以戳 阅读原文 查看文中所有的外部链接哟! 引言 今天,Meta 发布了 Llama 2,其包含了一系列最先进的开放大语言模型,我们很高兴能够将其全面集成入 Hugging Face,并全力支持其发布。Llama 2 的社区许可证相当宽松,且可商用。其代码、预训练模型和微调模型均于今天发布了🔥。 通过与 Meta 合作,我们已经顺利地完成了对 Llama 2 的集成,你可以在 Hub 上找到 12 个开放模型 (3 个基础模型以及 3 个微调模型,每个模型都有 2 种 checkpoint: 一个是 Meta 的原始 checkpoint,一个是 transformers 格式的 checkpoint)。以下列出了 Hugging Face 支持 Llama 2 的主要工作: Llama 2 已入驻 Hub: 包括模型卡及相应的许可证。 支持 Llama 2 的 transformers 库 使用单 GPU 微调 Llama 2 小模型的示例 Text Generation Inference (TGI) 已集成 Llama 2,以实现快速高效的生产化推理 推理终端 (Inference Endpoints) 已集成 Llama 2 目录 何以 Llama 2? 演示 推理 使用 transformers 使用 TGI 和推理终端 用 PEFT 微调 其他资源 总结 何以 Llama 2? Llama 2 引入了一系列预训练和微调 LLM,参数量范围从 7B 到 70B (7B、13B、70B)。其预训练模型比 Llama 1 模型有了显著改进,包括训练数据的总词元数增加了 40%、上下文长度更长 (4k 词元🤯),以及利用了分组查询注意力机制来加速 70B 模型的推理🔥! 但最令人兴奋的还是其发布的微调模型 (Llama 2-Chat),该模型已使用 基于人类反馈的强化学习 (Reinforcement Learning from Human Feedback,RLHF) 技术针对对话场景进行了优化。在相当广泛的有用性和安全性测试基准中,Llama 2-Chat 模型的表现优于大多数开放模型,且其在人类评估中表现出与 ChatGPT 相当的性能。更多详情,可参阅其 论文。 模型训练与微调工作流 图来自 Llama 2: Open Foundation and Fine-Tuned Chat Models 一文 如果你一直在等一个闭源聊天机器人的开源替代,那你算是等着了!Llama 2-Chat 将是你的最佳选择! 模型 许可证 可否商用? 预训练词元数 排行榜得分 Falcon-7B Apache 2.0 ✅ 1,500B 47.01 MPT-7B Apache 2.0 ✅ 1,000B 48.7 Llama-7B Llama 许可证 ❌ 1,000B 49.71 Llama-2-7B Llama 2 许可证 ✅ 2,000B 54.32 Llama-33B Llama 许可证 ❌ 1,500B * Llama-2-13B Llama 2 许可证 ✅ 2,000B 58.67 mpt-30B Apache 2.0 ✅ 1,000B 55.7 Falcon-40B Apache 2.0 ✅ 1,000B 61.5 Llama-65B Llama 许可证 ❌ 1,500B 62.1 Llama-2-70B Llama 2 许可证 ✅ 2,000B * Llama-2-70B-chat* Llama 2 许可证 ✅ 2,000B 66.8 *目前,我们正在对 Llama 2 70B (非聊天版) 进行评测。评测结果后续将更新至此表。 演示 你可以通过这个空间或下面的应用轻松试用 Llama 2 大模型 (700 亿参数!): 它们背后都是基于 Hugging Face 的 TGI 框架,该框架也支撑了 HuggingChat,我们会在下文分享更多相关内容。 推理 本节,我们主要介绍可用于对 Llama 2 模型进行推理的两种不同方法。在使用这些模型之前,请确保你已在 Meta Llama 2 存储库页面申请了模型访问权限。 **注意: 请务必按照页面上的指示填写 Meta 官方表格。填完两个表格数小时后,用户就可以访问模型存储库。 使用 transformers 从 transformers 4.31 版本开始,HF 生态中的所有工具和机制都可以适用于 Llama 2,如: 训练、推理脚本及其示例 安全文件格式 ( safetensors ) 与 bitsandbytes (4 比特量化) 和 PEFT 等工具 帮助模型进行文本生成的辅助工具 导出模型以进行部署的机制 你只需确保使用最新的 transformers 版本并登录你的 Hugging Face 帐户。 pipinstalltransformershuggingface-clilogin 下面是如何使用 transformers 进行推理的代码片段: fromtransformersimportAutoTokenizerimporttransformersimporttorchmodel="meta-llama/Llama-2-7b-chat-hf"tokenizer=AutoTokenizer.from_pretrained(model)pipeline=transformers.pipeline("text-generation",model=model,torch_dtype=torch.float16,device_map="auto",)sequences=pipeline('Iliked"BreakingBad"and"BandofBrothers".DoyouhaveanyrecommendationsofothershowsImightlike?\n',do_sample=True,top_k=10,num_return_sequences=1,eos_token_id=tokenizer.eos_token_id,max_length=200,)forseqinsequences:print(f"Result:{seq['generated_text']}") Result:Iliked"BreakingBad"and"BandofBrothers".DoyouhaveanyrecommendationsofothershowsImightlike?Answer:Ofcourse!Ifyouenjoyed"BreakingBad"and"BandofBrothers,"herearesomeotherTVshowsyoumightenjoy:1."TheSopranos"-ThisHBOseriesisacrimedramathatexploresthelifeofaNewJerseymobboss,TonySoprano,ashenavigatesthecriminalunderworldanddealswithpersonalandfamilyissues.2."TheWire"-ThisHBOseriesisagrittyandrealisticportrayalofthedrugtradeinBaltimore,exploringtheimpactofdrugsonindividuals,communities,andthecriminaljusticesystem.3."MadMen"-Setinthe1960s,thisAMCseriesfollowsthelivesofadvertisingexecutivesonMadisonAvenue,expl 另外,尽管模型本身的上下文长度 仅 4k 词元,但你可以使用 transformers 支持的技术,如旋转位置嵌入缩放 (rotary position embedding scaling) ,进一步把它变长! 使用 TGI 和推理终端 Text Generation Inference (TGI) 是 Hugging Face 开发的生产级推理容器,可用于轻松部署大语言模型。它支持流式组批、流式输出、基于张量并行的多 GPU 快速推理,并支持生产级的日志记录和跟踪等功能。 你可以在自己的基础设施上部署并尝试 TGI,也可以直接使用 Hugging Face 的 推理终端。如果要用推理终端部署 Llama 2 模型,请登录 模型页面 并单击 Deploy -> Inference Endpoints 菜单。 要推理 7B 模型,我们建议你选择 “GPU [medium] - 1x Nvidia A10G”。 要推理 13B 模型,我们建议你选择 “GPU [xlarge] - 1x Nvidia A100”。 要推理 70B 模型,我们建议你选择 “GPU [xxxlarge] - 8x Nvidia A100”。 注意: 如果你配额不够,请发送邮件至 api-enterprise@huggingface.co 申请升级配额,通过后你就可以访问 A100 了。 你还可以从我们的另一篇博文中了解更多有关 如何使用 Hugging Face 推理终端部署 LLM 的知识 , 文中包含了推理终端支持的超参以及如何使用其 Python 和 Javascript API 实现流式输出等信息。 用 PEFT 微调 训练 LLM 在技术和计算上都有一定的挑战。本节,我们将介绍 Hugging Face 生态中有哪些工具可以帮助开发者在简单的硬件上高效训练 Llama 2,我们还将展示如何在单张 NVIDIA T4 (16GB - Google Colab) 上微调 Llama 2 7B 模型。你可以通过 让 LLM 更可得 这篇博文了解更多信息。 我们构建了一个 脚本,其中使用了 QLoRA 和 trl 中的 SFTTrainer 来对 Llama 2 进行指令微调。 下面的命令给出了在 timdettmers/openassistant-guanaco 数据集上微调 Llama 2 7B 的一个示例。该脚本可以通过 merge_and_push 参数将 LoRA 权重合并到模型权重中,并将其保存为 safetensor 格式。这样,我们就能使用 TGI 和推理终端部署微调后的模型。 首先安装 trl 包并下载脚本: pipinstalltrlgitclonehttps://github.com/lvwerra/trl 然后,你就可以运行脚本了: pythontrl/examples/scripts/sft_trainer.py\--model_namemeta-llama/Llama-2-7b-hf\--dataset_nametimdettmers/openassistant-guanaco\--load_in_4bit\--use_peft\--batch_size4\--gradient_accumulation_steps2 其他资源 论文 Hub 上的模型 Open LLM 排行榜 Meta 提供的 Llama 2 模型使用大全 总结 Llama 2 的推出让我们非常兴奋!后面我们会围绕它陆陆续续推出更多内容,包括如何微调一个自己的模型,如何在设备侧运行 Llama 2 小模型等,敬请期待! 🤗 宝子们可以戳 阅读原文 查看文中所有的外部链接哟! 英文原文:https://hf.co/blog/llama2 原文作者: Philipp Schmid,Omar Sanseviero,Pedro Cuenca,Lewis Tunstall 译者: Matrix Yao (姚伟峰),英特尔深度学习工程师,工作方向为 transformer-family 模型在各模态数据上的应用及大规模模型的训练推理。 审校/排版: zhongdongy (阿东) 本文分享自微信公众号 - Hugging Face(gh_504339124f0f)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

GOTC 2023 圆满落幕,openKylin 带你玩转开源峰会

5月28日,全球开源技术峰会(GOTC)在上海张江科学会堂圆满落幕。GOTC 2023是由开放原子开源基金会、Linux基金会亚太区、上海浦东软件园和开源中国联合发起的,面向全球开发者的一场盛大开源技术盛宴。 为期2天的开源行业盛会,邀请了来自全球各个顶级开源基金会的负责人、开源社区参与者,以及全世界的开源爱好者共聚一堂。各位开源业内的专家以开源为题,以大会为媒,围绕元宇宙、安全、3D引擎、eBPF、Web3.0、区块链等热门技术主题,以及开源治理、汽车软件、AIGC、AI编程、开源教育培训、云原生等热门话题展开了一场深刻的行业趋势大讨论。 openKylin作为国内优秀开源社区代表,社区理事长朱晨受邀出席峰会基础设施与软件架构专题论坛,并带来《openKylin开源操作系统的技术创新与实践》主题分享,基于openKylin的开源实践历程,介绍了麒麟团队在内核、桌面环境、关键应用等领域的开源创新成果,并分享麒麟团队在开源技术研发、开源社区建设、开源人才培养等方面的实践经验。 朱晨表示,截至目前,openKylin社区单位会员超200家,社区活跃用户超80万,社区开发者超3000名,并自主搭建超20个社区基础设施平台,实现从源码到镜像100%自主构建,以及社区开发过程自动化,有效降低社区贡献者的开发门槛,提升社区开发效率、代码和版本质量。 同时,围绕创新硬件、互联协同、云端融合、人机交互等技术领域成立了66个SIG组开展研究与创新,构建系统应用“分级冻结”机制,深化软硬件生态“原生兼容”技术和解锁VirtIO-GPU硬件视频加速机制。 此外,在大会展厅,openKylin社区与三十多家优秀的开源技术社区以创意“摆摊儿” 的方式,打造了一场身临其境的沉浸式市集体验,展示开源项目、周边商品,交流开源技术、开源理念及开放协作方式。其中,默认搭载openKylin操作系统的全球首款RISC-V笔记本电脑ROMA也在本次市集亮相,吸引了众多开发者和开源爱好者围聚展台前,共同体验。 GOTC 2023虽已落幕,但有关开源的讨论和实践还在继续。openKylin作为国内桌面操作系统开源社区,自成立起便大力推进开源建设,积极构建开源安全机制和平台。未来,openKylin也将持续加强技术研究,集社区的力量不断发展创新,助推中国开源领域迈向安全创新新阶段。

优秀的个人博客,低调大师

带你玩转ChatGPT

作者:京东零售 栗鸿宇 ChatGPT简介 ChatGPT是一款基于AI技术的机器人对话软件,它能够与用户进行智能化的聊天对话,帮助用户解决日常生活中的问题,为用户提供丰富的信息和服务。它集成了海量知识库,能够回答用户的各种问题,包括日常生活中的常识性问题、文理科专业问题等,并且能够根据用户的需求提供个性化的信息服务。 同时,ChatGPT还拥有强大的学习能力,通过收集互联网上海量的文本资源,并在交流中不断地学习用户的交流习惯和语言表达方式,从而不断优化自身的对话能力,让用户在使用ChatGPT时感到越来越自然和舒适。 总之,ChatGPT是一款先进的机器人对话软件,能够为用户提供丰富的信息和服务,让用户在日常生活中获得更多便利和乐趣。 让ChatGPT自己介绍一下自己:    训练机制 官方博客中介绍到,ChatGPT是基于GPT-3.5(模型card:https://datalearner.com/ai-resources/pretrained-models/gpt-3-5 )微调的结果。ChatGPT是InstructGPT的兄弟模型(InstructGPT是官方训练的一个比GPT-3更好的遵循用户意图的语言模型,是基于OpenAI的alignment research技术研发的,比GPT-3更强的语言模型)。ChatGPT的训练使用了基于人类反馈的强化学习( Reinforcement Learning from Human Feedback,RLHF)。这点与InstructGPT一样,但是在数据收集方面有差异。OpenAI使用监督下的微调训练了一个初始模型:人类人工智能trainer提供对话,他们在对话中扮演双方—用户和人工智能助理。这可以让训练者接触到模型编写的建议,以帮助组成对应的回应。   编程能力 目前几家硅谷大厂都在朝着AI自动化编程努力: •DeepMind的AlphaCode,据说「吊打72%人类程序员」,但尚未开放; •传闻中谷歌的「神秘项目」Pitchfork,也还在酝酿中; •前段时间大火的GitHub Copilot主要是一个代码补全工具。 但是要说以上工具完全代替人类程序员,它们还不够格😕。那么号称能学习人类思维来编程的ChatGPT能做到什么程度呢? 笔者首先丢给他一个LeetCode上经典的Hard难度问题:接雨水( https://leetcode.cn/problems/trapping-rain-water/ ) 我在提问时并没有说明这是一道编程题,ChatGPT也能够正确识别并回答,说明拥有了一些理解提问者思想的能力😯。不到10秒钟,他就给出来了相应的示例代码,而且代码在leetcode上是可以AC的   但是上面的这些问题是不是直接通过搜索引擎搜出来,甚至是从AC的Solution里面摘抄出来的呢?🤔 接着我给了一个面试时经常会问到的SQL问题:   这种应该就不是搜出来的,但是AI算法经过学习还是能够理解并写出答案。虽然这段代码还不能拿过来直接使用,但是基本逻辑是正确的,开发者可以按照真实的表结构修改后使用。 在回答的最后,ChatGPT甚至还会简单分析下代码的逻辑,因此这款工具对于理解复杂算法提供了很好的辅助手段😏。 作为实验,我又让他解释了下快速排序的时间复杂度:   可以看出虽然解释的内容相对简单,但是对于有一定基础的人还是可以快速理解的。 所以各位远程面试的面试官要小心咯!因为你不知道电话另一边的回答是不是来自于一个机器人的手笔😱😱 程序员终结者? 我在日常沟通、专业解答、编程方案等方面和ChatGPT聊了很久,发现这个AI确实要比之前那些聊天机器人强很多,大多数情况下给出的回答都能够符合预期😬    但是聊得多了就能发现,ChatGPT解决问题的策略更像是一个优秀的答案缝合思路,看到题目先联想是否做过类似的,然后通过已知的答案缝合成另一个答案,所以我觉得现阶段ChatGPT让大量程序员失业还不太可能😎    从已有的成果和调研来看,AI绘画出的图片(如Deep Dream、stable diffusion)可以抵得上很多有较长练习经验的人的水平,但是chatGPT输出的程序尚且达不到中高级程序员的可靠性,而且其给出的代码全部是方法级、片段式的,无法直接满足一个完整需求。如果把AI当做是一个私人助理,chatGPT是合格的,虽然他说的很多都是车轱辘话,但是也能保证说出的是“正确的,客观的,中肯的...”,尤其是针对编程问题和理科问题, 大部分时候给出的建议还是挺靠谱的 (不靠谱的回答会非常明显,一眼看穿)。 因此,作为一个类似于Siri或是Google Assistant的聊天机器人来说,是绝对比之前的AI好的,但是拿来写代码,我觉得基本上不太可能。因为程序员的工作不仅仅需要写代码,更需要遵循逻辑、根据复杂的需求场景构思出符合要求的完整工程。另外,根据我自身对于ChatGPT的测试结果来看,目前阶段,靠ChatGPT去写代码还不如靠搜索引擎,最多能看作一个助手,对于广大程序员来说是一个不错的辅助工具。 至于替代程序员的工作,只能说如果有人如果能被这玩意替代,应该也找不到什么好工作…… 但是,这AI写车轱辘话的水平一流!营销号狂喜!🤣🤣    注册使用流程 😡技术有国界,想玩用梯子😡 要注册使用 ChatGPT,我们需要准备以下内容: •能够访问Google的全局代理,推荐美国节点(实测亚洲节点如香港、新加坡节点会被ban); •一个邮箱用于注册,如Gmail,Outlook; •一个国外手机号,如果没有可以在第1步中通过第三方接码平台来完成注册 1. 账号注册 进入注册页面:https://chat.openai.com/auth/login   点击注册按钮,输入邮箱,还有你的注册账号,并设置密码   邮箱确认好之后,接下来要填入电话。   这里请大家注意,中国区的+86是不行的,如果你用GoogleVoice的话,也会被判别是虚拟电话,而做不了验证码。 需要通过下方平台接收短信 2. 使用第三方接码平台 打开网站:https://sms-activate.org/cn    点击右上角的注册按钮,在注册页面输入自己的邮箱账号,设置密码后提交。会给你的邮箱发一条验证邮件,点击邮件中的链接确认即完成注册。 我们注册后登录,在「余额」那里点击「充值」,使用支付宝充值 0.2 美金即可    然后,回到首页,搜索并选择OpenAi服务,加车后购买即可    3. 使用购买的号码激活 购买完成后,然后就可以在激活区域看到待使用的号码。 复制这个号码,然后把这个号码放在第1步最后的验证码接收区 点击接收验证码按钮后,可以回到第三方接码平台网站,看到验证码(从上面的截图中应该能够看到我有一个印度号码的使用记录),再次复制这个验证码填进去,这样就成功完成注册了   注册完后,就可以ChatGPT网站去登陆: https://chat.openai.com/auth/login 大家快去调戏ChatGPT吧~~

优秀的个人博客,低调大师

博云带你玩转新特性

三个月转瞬即逝,Kubernetes 如约发布了 V1.25 版本,新版本在诸多领域都有增强。 Kubernetes 1.25 带来了 40 余项功能增强,其中 13 个功能成为稳定状态;10 个是对于现有功能的改进;15 个全新功能;还有 2 个废弃功能。在功能增强的数量上,1.25 与之前的两个版本大致相同,Kubernetes 依然在按自己的节奏稳步推进中。 本文将在众多特性中选择几个进行介绍,涵盖安全、存储、网络等领域。 01 存储 CSI Migration Kubernetes 的存储插件分为树内(in-tree)和树外(out-of-tree)两种。简单说 in-tree 是指在 Kubernetes 主仓库维护的插件,而 out-of-tree 是指独立维护的插件。在之前,Kubernetes 有很多插件都是 in-tree 的,这样会使得 Kubernetes 代码维护困难,并且造成 Kubernetes 主库的臃肿,所以三年前 storage SIG 就开始从 Kubernetes 核心中迁移 in-tree 的存储插件到外面,变为 out-of-tree 存储插件。V1.25 版本中,很多 in-tree 的存储插件都将被删除,包括 GlusterFS, flocker, quobyte, storageos 等,具体列表请参考 deprecations-and-removals-for-storage-drivers [1] 。举例而言,从 1.25 版本开始,用户在使用以下 yaml 对接 GFS 存储时,将得到警告信息“this feature will be removed soon after in a subsequent release”。 apiVersion:v1kind:Podmetadata:name:glusterfsspec:containers:-name:glusterfsimage:nginxvolumeMounts:-mountPath:"/mnt/glusterfs"name:glusterfsvolvolumes:-name:glusterfsvolglusterfs:endpoints:glusterfs-clusterpath:kube_volreadOnly:true 在 1.25 中迁移的特性终于达到了 GA 状态,感谢 storage SIG 长久以来孜孜不倦的工作。 Container Object Storage Interface 对象存储的标准来了。这个功能是一项迟到了很久的功能,在 2020 年时就已经被提出了,并且差点合入 Kubernetes 1.24 版本。不过由于时间来不及,所以被放到了 1.25,现在它终于要成为一个 alpha 功能了。文件和块存储通过 CSI 在 Kubernetes 生态中被视为一等公民。但是对象存储却没有得到这么高的待遇。近年来,对象存储作为文件系统和块设备的替代存储形式越来越受到欢迎,对象存储存进了计算和存储的分解。它也更加易于管理、扩展和自动化。当前 COSI 设计文档提出的的目标是: 功能上 支持自动创建桶 支持自动删除桶 支持自动生成访问凭证 支持自动访问凭证撤销 支持工作负载的自动化 Bucket Provisioning(使 Pod 能够访问 Bucket) 支持桶重用(通过 COSI 使用现有的桶) 支持跨命名空间的自动存储桶共享 系统属性上 支持跨集群的工作负载可移植性 以供应商中立的方式实现上述目标 标准化第三方供应商与 COSI 轻松集成的机制 允许用户(非管理员)创建和使用存储桶(自助服务) 为存储桶创建和共享建立一流的访问控制实践 COSI 的设计文档可以参考 object-storage-support [2] 博云 & Kubernetes & 存储 讲了有关于存储的新特性后,也向大家介绍下由博云开源的 CSI -- Carina,它是一个为 Kubernetes 而生的高性能本地存储组件,专门针对云原生的有状态应用而生。Carina 项目前期由博云独自研发,现在已经开源。它的地址是 https://github.com/carina-io/carina 经过了一段时间的发展,Carina 社区的活跃度取得了令人惊喜的增长。最近 Carina 社区正在对社区成员的身份进行规划,Carina 社区非常欢迎各位使用者和贡献者的加入。 02 网络 multiple ClusterCIDRs 在用户初始化一个集群时,找到一个恰当的 CIDR 很难,如果太大的话会造成浪费,如果太小的话,等到业务增多了 IP 可能会不够用,到时候就会如鲠在喉了。 由于 CIDR 是在集群启动时设置的,而且以后不能修改,严重的可能会铲掉集群重新开始。 Kubernetes 1.25 带来了一个新功能,通过 ClusterCIDRConfig 来动态的配置 CIDR,这个方式可以很好解决上面提出的问题。 Reserve Service IP ranges for dynamic and static IP allocation 还记得在上篇 Kubernetes 1.24 发布的文章中提到过的 service 动态和静态 IP 的预留功能吗,在 1.25 中这个功能已经从 alpha 版本进化到了 beta 版本,想尝鲜的已经可以用起来了。 博云 & Kubernetes & 网络 在 Kubernetes 相关的组件中,博云对于网络的投入是时间最久、精力最多的。博云自研的 CNI -- fabric 已经在诸多客户中被长时间使用,其中不乏金融类、科研类的用户,作为一个支持 linux 、windows 操作系统,amd64 、arm64 架构的软件,fabric 将继续支撑用户的作业,为用户的云应用提供高效稳定的运行环境。 在最近的更新中,fabric 将在可观测性方面做出巨大提升,敬请期待! 03 安全 在 Kubernetes 1.21 中 PodSecurityPolicy 被标记为弃用,而在 1.25 中,这个功能被正式删除了。 不过不用担心,Kubernetes 对于每个破坏性的变更都是慎之又慎的,PodSecurityPolicy 的删除也不例外。 之所以删除它,是因为它被多方诟病使用上的晦涩难懂,Kubernetes 社区经过考虑后,选择删除这个功能。 并且提供了一个更好的替代品 -- Pod Security Admission,目前 Pod Security Admission 在 1.25 中达到了稳定阶段,用户可以放心迁移到 Pod Security Admission。之前博云公众号也曾经系统介绍过PSA,欢迎大家查阅。 结语 Kubernetes 1.25 也许不如上个版本夺人眼球,但它足够优秀。 很多不需要的功能被清除,很多功能达到稳定状态,值得我们去好好使用。 尽可能升级手边的 Kubernetes 吧,感受新版本带来的新鲜感! 引用: [1]https://kubernetes.io/blog/2022/08/04/upcoming-changes-in-kubernetes-1-25/#deprecations-and-removals-for-storage-drivers [2]https://github.com/kubernetes/enhancements/tree/master/keps/sig-storage/1979-object-storage-support 参考内容: https://github.com/kubernetes/enhancements/tree/master/keps/sig-storage/1979-object-storage-support https://kubernetes.io/blog/2022/08/04/upcoming-changes-in-kubernetes-1-25/ https://sysdig.com/blog/kubernetes-1-25-whats-new/

优秀的个人博客,低调大师

如何在 Zadig 上玩转自动化测试

如何利用 Zadig 配置并运行自动化测试?如何分析测试报告?怎么度量改进自动化测试效果? 其实 Zadig 不但能提供强大的测试环境支持,还支持性能、功能、接口、UI、端到端自动化测试等诸多测试场景。 Zadig on Githubhttps://github.com/koderover/zadig Zadig on Giteehttps://gitee.com/koderover/zadig 本文通过一个案例实战,来了解在 Zadig 中如何实践自动化测试,为业务质量保障提供最大价值。 配置测试 Zadig 测试主要包含自动化测试集管理、测试环境的支持、测试执行和结果分析,同时支持标准 Junit / HTML 测试报告的输出。 准备工作 本例中的自动化测试源码 fork 自测试用例,用于自动验证 KodeRover 官网https://www.koderover.com及文档站https://docs.koderover.com访问无异常 用例源码使用 Go 语言实现,测试框架选用 ginkgo + gomega 配置基本信息 进入项目的测试模块,点击新建测试,配置基本信息。 相关参数说明: 测试名称:对该测试的标识,可阅读有意义即可 依赖的软件包:运行测试用例时的软件应用、框架依赖,本例依赖 go1.16.13 代码信息:测试用例所在的代码仓库,根据集成的代码源实际情况填写 测试变量:根据情况设置,这里可以不设置。值得注意的是内置测试变量提供了几个非常贴合微服务架构验证的相关的变量,比如 LINKED_ENV(被测环境的命名空间)、ENV_NAME(被测环境的名称)、SERVICES(上游工作流传递的服务组) 配置自动化测试脚本 设置测试报告输出 此例中为生成的报告位置:$WORKSPACE/zadig/examples/test-demo/test,在相应位置填写即可,若路径下有多个 Junit xml 文件,Zadig 会自动分析合并汇总后输出测试报告结果。 运行测试 执行自动化测试 在测试任务执行时,可查看执行日志 查看测试报告 待测试任务运行完毕,点击测试结果中的链接可查看测试报告。可概览测试用例的运行结果和耗时,不同结果用例的比例,对失败/错误的用例进行过滤分析,查看失败信息以辅助定位分析等。 分析测试效能 在测试中心中提供了整个系统的测试集看板,可全局预览所有项目的测试用例总数量、执行次数、平均执行时间、通过率等指标,一览无余。 在数据视图 - 效能洞察中,可对指定项目中测试的趋势、健康度、平均测试时长、周交付部署次数以及周测试收益进行查看分析,做到有的放矢。 解锁更多姿势 关于自动化测试在 Zadig 中更多的使用姿势,为业务质量保障提供更多价值 对更新的服务进行实时测试验证 将测试和开发过程的工作流关联起来,实际场景中可以并行开发代码、并行部署后自动化验证测试。 当运行 koderover-doc-update 工作流对https://docs.koderover.com进行部署更新后,会自动执行自动化测试,确认更新后的站点是否能正常工作。 质量保证前置到研发环节:对每一次代码变更做保障 将测试和工作流关联后,开启工作流的触发器功能。提交代码变更后,会自动触发工作流执行,部署更新服务并执行自动化测试,降低测试开发工程师的介入成本。在代码变更(eg:PullRequest / MergeRequest)下可看到工作流的执行情况,将这段代码变更的质量反馈到变更阶段,尽早暴露质量风险。 (也可修改测试配置,针对测试单独配置触发器,效果同理,此处不赘述。) IM 通知:让测试价值产生于无形之中 为工作流配置通知功能,和 IM 系统(飞书/企业微信/钉钉)对接。工作流运行完毕后即将运行结果/测试报告等详细信息发送至 IM 系统。和触发器结合起来使用,研发工程师提交代码变更后,便可在 IM 中便捷地获得自动化测试结果,及时反馈质量风险,让研发工程师专注在创造业务价值上。 (也可修改测试配置,针对测试单独配置通知,此处不赘述。) 基于一套测试套件对不同的环境做验证 巧妙利用内置的环境变量,可复用一套测试套件对多套集成环境进行测试验证。对上述源码做简单的改造/github.com/koderover/zadig),利用内置 ENV_NAME(被测环境的名称) 环境变量控制不同被测对象。当集成环境增多时,可直接复用已有测试套件对其进行质量保障。 解锁更多测试场景 如果内置的软件包/测试框架无法满足测试需求,可以在系统设置中添加新的软件包应用来支持更多测试场景/测试框架。 软件包管理可参考:docs.koderover.com/zadig10.0/settings/app/ 如果需要对接企业内部现成的自动化测试平台,可以编辑工作流,添加“扩展”模块 ~ 见文档站的 “工作流 - 扩展”:/docs.koderover.com/zadig工作流 欢迎加入开源吐槽群进一步学习交流。 Zadig on Githubhttps://github.com/koderover/zadig Zadig on Giteehttps://gitee.com/koderover/zadig

优秀的个人博客,低调大师

玩转可迭代对象迭代器生成器

在Python中,经常可以看到可迭代对象、迭代器、生成器,如何得到一个可迭代对象,如何把它变成迭代器,如何得到生成器,它们到底有什么区别和联系呢? 简单来说,它们的关系如下图 从概念上来说,可迭代对象 > 迭代器 > 生成器。 可迭代对象 可迭代对象Iterable,可以认为是一个容器,其中有N个元素,可以迭代。 在Python中可以简单的认为,能够使用for循环遍历的,都是可迭代对象。常见的类型由list、tuple、range对象、str、bytes、bytearra、set、dict等。 自定义可迭代对象 自定义类型,如何变成一个可迭代对象? class MyIterable: def __str__(self): return "我还不是一个可迭代对象"mi = MyIterable()print(mi)for i in mi: print(i) # 抛异常'MyIterable' object is not iterable 实现__iter__魔术方法 class MyIterable: def __iter__(self): print('iter~~~~~~~')mi = MyIterable()print(mi)for i in mi: print(i) # 抛异常iter() returned non-iterator of type 'NoneType' 可以看到实例mi确实是可迭代对象了,但是返回值是None,所以报错了,看异常提示,__iter__返回一个迭代器才是正确的。 迭代器 迭代器Iterator 迭代器是一种特殊可迭代对象,一定能迭代 可以使用内建函数next()来获取它的下一个元素 使用next迭代完所有元素后,如果继续获取下一个元素,则抛出StopIteration异常 使用next迭代完所有元素后,不可再次迭代 判断是否是迭代器,其实如果可以使用next函数来获取元素的对象,一定是迭代器。 那么,列表是迭代器吗? a = [1, 2]print(next(a)) # 'list' object is not an iterator 列表对象是可迭代对象,但不是迭代器。如何把一个可迭代对象转成迭代器呢? 使用内建函数iter 包装成生成器对象 a = [1, 2]# print(next(a)) # 'list' object is not an iteratorb = iter(a) # 内建函数iterprint(next(b))print(next(b))print(next(b)) # StopIteration 很多函数都能返回迭代器,例如enumerate a = [1, 2]c = enumerate(a) # 返回迭代器print(next(c))print(next(c))for x in c: # 已经迭代完了,没有什么元素可以迭代了 print(x)print('=' * 30)print(next(c)) # StopIteration 自定义迭代器对象 那么,上面MyIterable的例子可以修改如下 class MyIterable: def __init__(self): self.items = [1,2,3,4,5] def __iter__(self): print('iter~~~~~~~') return iter(self.items)mi = MyIterable()print(mi)for i in mi: # mi可以迭代了 print(i)for i in mi: # 可迭代对象可再次迭代 print(i)print(next(mi)) # 不可以使用next,说明mi不是迭代器 mi对象成为了可迭代对象,但是它不是迭代器。 如何得到迭代器呢?使用__next__魔术方法 class MyIterable: def __init__(self): self.items = [1,2,3,4,5] self.count = 0 def __iter__(self): print('iter~~~~~~~') return iter(self.items) def __next__(self): print('next ~~~~') try: count = self.count n = self.items[count] self.count = count + 1 return n except IndexError: raise StopIterationmi = MyIterable()print(mi)print(next(mi))print(next(mi))print(next(mi))print(next(mi))print(next(mi))print(next(mi)) # StopIteration 代码再改进一下 class MyIterable: def __init__(self): self.items = [1,2,3,4,5] self.count = 0 def __iter__(self): print('iter~~~~~~~') #return iter(self.items) return self # 有__iter__我就是可迭代对象,因为有__next__,我自己就是迭代器 def __next__(self): print('next ~~~~') try: count = self.count n = self.items[count] self.count = count + 1 except: raise StopIteration return nmi = MyIterable()print(mi)print(next(mi)) # 迭代器for i in mi: # mi也是可迭代对象 print(i)print('-' * 30)for i in mi: # 已经不能再次迭代 print(i)print('-' * 30)print(next(mi)) # StopIteration 生成器 Python中使用2种方式获得生成器对象 生成器表达式 生成器函数 生成器是特殊的迭代器,但迭代器不一定是生成器。它是Python提供的通过编程方式快速便捷得到迭代器的手段 g1 = (i for i in range(5)) # 生成器表达式print(g1) # 生成器对象print(next(g1))print(next(g1))print('=' * 30)def counter(): # 生成器函数 for i in range(5, 10): # 可以使用yield from yield ig2 = counter() # 生成器函数调用不返回结果,返回一个生成器对象print(g2)print(next(g2))print(next(g2)) 总结 Python 3开始,推荐在能使用迭代器的地方,考虑使用迭代器,它是惰性计算对象,不会短时间对内存和CPU造成大的压力。 可以使用生成器表达式非常便利得到一个迭代器,稍微复杂一些可以考虑使用生成器函数获得一个迭代器,如果更加复杂可以使用类来构造。

优秀的个人博客,低调大师

Windows下如何玩转火热的go-zero

作者:阿啄debugIT 前言 > go-zero 是一个集成了各种工程实践的 web 和 rpc 框架。通过弹性设计保障了大并发服务端的稳定性,经受了充分的实战检验。 > > go-zero 包含极简的 API 定义和生成工具 goctl,可以根据定义的 api 文件一键生成 Go, iOS, Android, > Kotlin, Dart, TypeScript, JavaScript 代码,并可直接运行。 这么牛,怎么不想去试一下?! go语言环境搭建 配置GO语言环境 新增go的代理 GOPROXY=https://goproxy.io,direct,https://mirrors.aliyun.com/goproxy/,https://goproxy.cn,https://athens.azurefd.net,https://gonexus.dev 设置环境变量 环境变量path中添加 %GOROOT%\bin;%GOPATH%\bin 在vscode的配置 安装插件 关键是go语言环境在vscode的配置,如下: { "go.goroot": "D:\\go", "go.gopath": "D:\\go_project", "go.inferGopath": false, "go.toolsGopath": "D:\\go_project", "window.zoomLevel": 0, "git.autofetch": true, "terminal.integrated.shell.windows": "powershell.exe", // 也可以使用 cmd.exe "workbench.colorTheme": "Monokai Pro (Filter Machine)", "workbench.iconTheme": "Monokai Pro (Filter Machine) Icons", "editor.renderControlCharacters": false, "editor.snippetSuggestions": "top", "editor.suggest.snippetsPreventQuickSuggestions": true, "breadcrumbs.enabled": true, "terminal.explorerKind": "external", "editor.cursorStyle": "block", "editor.links": false, "editor.mouseWheelZoom": true, "editor.renderLineHighlight": "all", "editor.suggest.shareSuggestSelections": true, "outline.icons": true, "search.showLineNumbers": true, "search.smartCase": true, // package 查找模式 "go.gocodePackageLookupMode": "go", "go.gotoSymbol.includeGoroot": true, "go.gotoSymbol.includeImports": true, // build 相关 "go.buildOnSave": "off", "go.gocodeAutoBuild": true, "go.installDependenciesWhenBuilding": true, "go.buildFlags": [], "go.buildTags": "", "go.coverOnSingleTest": true, "go.useCodeSnippetsOnFunctionSuggest": true, "go.useCodeSnippetsOnFunctionSuggestWithoutType": true, "go.docsTool": "guru", "go.formatTool": "goimports", "go.lintTool": "golangci-lint", "go.lintOnSave": "package", "go.lintFlags": [ "--fast" ], "go.formatFlags": [], "go.vetFlags": [], "go.vetOnSave": "package", "go.generateTestsFlags": [], "go.liveErrors": { "enabled": true, "delay": 500 }, "go.gocodeFlags": [ "-builtin", "-ignore-case", "-unimported-packages" ], "go.enableCodeLens": { "references": true, "runtest": true }, "go.delveConfig": { "dlvLoadConfig": { "followPointers": true, "maxVariableRecurse": 1, "maxStringLen": 64, "maxArrayValues": 64, "maxStructFields": -1 }, "apiVersion": 2, "showGlobalVariables": true }, "go.editorContextMenuCommands": { "toggleTestFile": true, "addTags": true, "removeTags": true, "testAtCursor": true, "testFile": true, "testPackage": true, "generateTestForFunction": true, "generateTestForFile": true, "generateTestForPackage": true, "addImport": true, "testCoverage": true, "playground": true, "debugTestAtCursor": true }, "go.playground": { "openbrowser": false, "share": false, "run": false }, "go.addTags": { "tags": "json", "options": "json=omitempty", "promptForTags": true, "transform": "snakecase" }, "go.removeTags": { "tags": "", "options": "", "promptForTags": false }, "[go]": { "editor.codeActionsOnSave": { "source.organizeImports": true }, }, "go.alternateTools": { "go-langserver": "gopls", }, "go.useLanguageServer": false, "go.languageServerFlags": [], "go.languageServerExperimentalFeatures": { "format": true, "autoComplete": true, "rename": true, "goToDefinition": true, "hover": true, "signatureHelp": true, "goToTypeDefinition": true, "goToImplementation": true, "documentSymbols": true, "workspaceSymbols": true, "findReferences": true, "diagnostics": false } } 参考链接:https://www.cnblogs.com/chnmig/p/10796316.html 克隆go-zero github地址:https://github.com/tal-tech/go-zero 学习视频地址:https://talkgo.org/t/topic/729 语雀文档资料:https://www.yuque.com/tal-tech/go-zero/tdsgkg 玩goctl工具 goctl是go-zero微服务框架下的代码生成工具,其可以快速提升开发效率,让开发人员将时间重点放在业务coding上…… 查询很多资料都不说的,不清晰,总是报command not found: goctl错误。 我也是将goctl工具安装到 $GOPATH/bin 目录下 ?x-oss- 环境变量也配置了,最后发现,所有网上博客都没有说,把 $GOPATH/bin,加入系统环境path变量。加入以后,重启电脑,就可以正常使用goctl工具。 接下来,就是体验goctl工具。 体验goctl工具 C:\Users\domin&gt;d: D:\&gt;cd D:\go-learn D:\go-learn&gt;goctl api new greet [32mDone.[0m D:\go-learn&gt;cd greet D:\go-learn\greet&gt;go mod init go mod init: go.mod already exists D:\go-learn\greet&gt;go mod tidy go: finding module for package github.com/tal-tech/go-zero/core/logx go: finding module for package github.com/tal-tech/go-zero/rest go: finding module for package github.com/tal-tech/go-zero/rest/httpx go: finding module for package github.com/tal-tech/go-zero/core/conf go: found github.com/tal-tech/go-zero/core/conf in github.com/tal-tech/go-zero v1.1.2 go: found github.com/tal-tech/go-zero/rest in github.com/tal-tech/go-zero v1.1.2 go: found github.com/tal-tech/go-zero/rest/httpx in github.com/tal-tech/go-zero v1.1.2 go: found github.com/tal-tech/go-zero/core/logx in github.com/tal-tech/go-zero v1.1.2 D:\go-learn\greet&gt;go run greet.go -f etc/greet-api.yaml Starting server at 0.0.0.0:8888... {"@timestamp":"2021-01-10T01:04:05.746+08","level":"stat","content":"CPU: 0m, MEMORY: Alloc=0.6Mi, TotalAlloc=0.6Mi, Sys=6.6Mi, NumGC=0"} {"@timestamp":"2021-01-10T01:04:05.751+08","level":"stat","content":"(api) shedding_stat [1m], cpu: 0, total: 0, pass: 0, drop: 0"} {"@timestamp":"2021-01-10T01:05:05.747+08","level":"stat","content":"CPU: 0m, MEMORY: Alloc=0.6Mi, TotalAlloc=0.6Mi, Sys=6.6Mi, NumGC=0"} {"@timestamp":"2021-01-10T01:05:05.751+08","level":"stat","content":"(api) shedding_stat [1m], cpu: 0, total: 0, pass: 0, drop: 0"} {"@timestamp":"2021-01-10T01:06:05.746+08","level":"stat","content":"CPU: 0m, MEMORY: Alloc=0.6Mi, TotalAlloc=0.6Mi, Sys=6.6Mi, NumGC=0"} {"@timestamp":"2021-01-10T01:06:05.750+08","level":"stat","content":"(api) shedding_stat [1m], cpu: 0, total: 0, pass: 0, drop: 0"} {"@timestamp":"2021-01-10T01:07:05.746+08","level":"stat","content":"CPU: 0m, MEMORY: Alloc=0.6Mi, TotalAlloc=0.6Mi, Sys=6.6Mi, NumGC=0"} {"@timestamp":"2021-01-10T01:07:05.752+08","level":"stat","content":"(api) shedding_stat [1m], cpu: 0, total: 0, pass: 0, drop: 0"} {"@timestamp":"2021-01-10T01:08:05.744+08","level":"stat","content":"CPU: 0m, MEMORY: Alloc=0.6Mi, TotalAlloc=0.6Mi, Sys=6.6Mi, NumGC=0"} {"@timestamp":"2021-01-10T01:08:05.750+08","level":"stat","content":"(api) shedding_stat [1m], cpu: 0, total: 0, pass: 0, drop: 0"} {"@timestamp":"2021-01-10T01:09:05.746+08","level":"stat","content":"CPU: 0m, MEMORY: Alloc=0.6Mi, TotalAlloc=0.6Mi, Sys=6.6Mi, NumGC=0"} {"@timestamp":"2021-01-10T01:09:05.750+08","level":"stat","content":"(api) shedding_stat [1m], cpu: 0, total: 0, pass: 0, drop: 0"} 再另外开一个cmd窗口 C:\Users\domin&gt;d: D:\&gt;cd D:\go-learn\greet D:\go-learn\greet&gt;goctl api java -api greet.api -dir greet [32mDone.[0m D:\go-learn\greet&gt;curl -i http://localhost:8888/from/you HTTP/1.1 200 OK Content-Type: application/json Date: Sat, 09 Jan 2021 17:09:06 GMT Content-Length: 14 生成的代码 总结 除了goctl神器,go-zero还有很多的小工具。 流数据处理利器:fx。如java8的lambda,,go-zero也有了!fx.Filter().Sort().Head() ,让数组的复杂处理变得简单。 List itemmapReduce降低服务相应时间:mr.Finish(), mr.Map().Reduce(), 跟并发处理waitGroup说拜拜。 etcd服务发现的集成:p2c的算法发现服务,避免开发人员点对点或nginx的转发服务,安装一个etcd就完事了。 jwt集成api:轻松拥有一个jwt的后台服务。 集成Prometheus:轻松拥有一个带监控的golang后台服务。 Go语言主要用作服务器端开发,其定位是用来开发“大型软件”的,适合于很多程序员一起开发大型软件,并且开发周期长,支持云计算的网络服务。Go语言能够让程序员快速开发,并且在软件不断的增长过程中,它能让程序员更容易地进行维护和修改。它融合了传统编译型语言的高效性和脚本语言的易用性和富于表达性。 Go语言作为服务器编程语言,很适合处理日志、数据打包、虚拟机处理、文件系统、分布式系统、数据库代理等;网络编程方面,Go语言广泛应用于Web应用、API应用、下载应用等;除此之外,Go语言还可用于内存数据库和云平台领域,目前国外很多云平台都是采用Go开发。 参考链接:https://www.jianshu.com/p/6fbba7f7ced3 go-zero地址: https://github.com/tal-tech/go-zero https://github.com/kevwan/go-zero

优秀的个人博客,低调大师

手把手带你玩转 openEuler | openEuler 的使用

本文章分为四部分,教你怎么使用 openEuler,学完之后你可以了解到 openEuler 的基本配置、软件包的使用、基本语法以及服务搭建: 第 1 部分:openEuler 基本配置(网络配置、查看系统信息、管理用户和用户组) 第 2 部分:openEuler 的软件包管理(使用 DNF 管理软件包) 第 3 部分:systemd 基本用法(管理服务) 第 4 部分:服务搭建(搭建服务) 文档指导 openEuler 官网文档:管理员指南 相关文档说明可以查看管理员指南[1] 1. openEuler 基本配置 1.1 openEuler 基本配置之网络配置 本部分教会大家怎么去配置 openEuler 的静态 ip。如果您想了解更多的网络配置,请参考 openEuler 的网络配置文档[2])。 这里我们使用第三方的终端软件 ssh 登录之后进行操作,这样的话终端软件的优化是比较好的,使用起来比较方便。 由于 openEuler 默认的 ip 是 DHCP 动态分配的,这个 ip 可能会变,有些需求需要 ip 是固定的,这里就需要我们将动态 ip 改成静态 ip 了,配置方法如下: 获取 ip:ip a 通过终端软件 ssh 登录机器操作:ssh root@ip 配置静态 ip:修改 /etc/sysconfig/network-scripts/ifcfg-ens33,配置如下: 设置好静态 ip 后,现在还没发生效,需要重启一下网络服务,命令行: systemctl restart NetworkManager 1.2 openEuler 基本配置之用户管理 在 Linux 中,每个普通用户都有一个账户,包括用户名、密码和主目录等信息。除此之外,还有一些系统本身创建的特殊用户,它们具有特殊的意义,其中最重要的是管理员账户,默认用户名是 root。同时 Linux 也提供了用户组,使每一个用户至少属于一个组,从而便于权限管理。 用户和用户组管理是系统安全管理的重要组成部分,下面介绍 openEuler 提供的用户管理和组管理命令,以及为普通用户分配特权的方法。 1.2.1 管理用户 常用的管理用户的命令如下: useradd name:增加用户—在 root 权限下,通过 useradd 命令可以为系统添加新用户信息 passwd name:修改用户密码—使用 passwd 命令修改用户的密码,没有设置密码的新账号不能登录系统。修改用户密码时需要满足密码复杂度要求,密码的复杂度的要求如下: 口令长度至少 8 个字符。 口令至少包含大写字母、小写字母、数字和特殊字符中的任意 3 种。 口令不能和账号一样。 口令不能使用字典词汇。 userdel name:删除用户—在 root 权限下,使用 userdel 命令可删除现有用户。如果想同时删除该用户的主目录以及其中所有内容,要使用-r 参数递归删除 id name:使用 id 命令查看新建的用户信息 usermod -s newshell_path username:修改用户 shell 设置—用户也可以使用 usermod 命令修改 shell 信息,在 root 权限下执行如下命令,其中 _new_shell_path为目标 shell 路径,username为要修改用户的用户名 usermod -d newhome_directory username:修改主目录—修改主目录,可以在 root 权限下执行如下命令,其中 _new_home_directory为已创建的目标主目录的路径,username为要修改用户的用户名 usermod -u UID username:修改用户 ID—修改用户 ID,在 root 权限下执行如下命令,其中UID代表目标用户 ID,username代表用户名 usermod -e MM/DD/YY username:修改账户有效期—如果使用了影子口令,则可以在 root 权限下,执行如下命令来修改一个账号的有效期,其中MM代表月份,DD代表某天,YY代表年份,username代表用户名 用户信息文件 下面介绍与用户账号信息有关的文件: /etc/passwd:用户账号信息文件。 /etc/shadow:用户账号信息加密文件。 /etc/group:组信息文件。 /etc/default/useradd:定义默认设置文件。 /etc/login.defs:系统广义设置文件。 /etc/skel:默认的初始配置文件目录。 1.2.2 管理用户组 常用的管理用户组的命令如下: groupadd name:增加用户组—在 root 权限下,通过 groupadd 命令可以为系统添加新用户组信息,其中options为相关参数,groupname为用户组名称 groupmod -g GID groupname:修改用户组 ID—修改用户组 ID,在 root 权限下执行如下命令,其中GID代表目标用户组 ID,groupname代表用户组 groupmod -n newgroupname oldgroupname:修改用户组名称—修改用户组名,在 root 权限下执行如下命令,其中newgroupname代表新用户组名,oldgroupname代表已经存在的待修改的用户组名 groupdel groupname:删除用户组—在 root 权限下,使用 groupdel 命令可删除用户组。groupdel 不能直接删除用户的主组,如果需要强制删除用户主组,请使用 groupdel -fgroupname命令 gpasswd -a username groupname:将用户加入用户组—将用户username加入用户组groupname gpasswd -d username groupname:从用户组中移除用户—将用户username从groupname用户组中移除 newgrp newgroupname:切换用户组—一个用户同时属于多个用户组时,则在用户登录后,使用 newgrp 命令可以切换到其他用户组,以便具有其他用户组的权限 用户组信息文件 下面介绍与用户组账号信息有关的文件: /etc/gshadow:用户组信息加密文件。 /etc/group:组信息文件。 /etc/login.defs:系统广义设置文件。 sudo:允许普通用户执行管理员账户才能执行的命令 sudo ls /root 如果该用户在 root 下没有权限,需要在 root 下给该用户添加权限 vi /etc/sudoers visudoUser host=(run as user) command 1.3 openEuler 基础配置之系统信息 系统信息查看官方文档[3] 想要了解系统的其他信息,比如系统信息、CPU、内存、磁盘、系统资源实时信息、版本信息,这里有几个常用的命令行提供给大家: 查看系统信息:cat /etc/os-release 查看 CPU 信息:lscpu(Lx cache 非单个 cup 值) 查看内存信息:free 查看磁盘信息:fdisk -l 查看系统资源实时信息:top 查看版本信息:cat /etc/openEuler-latest 系统语言及键盘官方文档[4] 大家可以通过 localectl 修改系统的语言环境,对应的参数设置保存在/etc/locale.conf 文件中。这些参数会在系统启动过程中被 systemd 的守护进程读取。 也可以通过 localectl 修改系统的键盘设置,对应的参数设置保存在/etc/locale.conf 文件中。这些参数,会在系统启动的早期被 systemd 的守护进程读取。 给大家提供一些系统语言和键盘的命令行: 当前环境语言:localectl status 可用环境语言/键盘:localectl list-locales/list-keymaps 设置环境语言/键盘:localectl set-locale/set-keymap LANG=zh_CN.UTF-8/cn 更改语言环境之后,需要重新登录,或者 root 权限下执行source /etc/locale.conf 刷新配置文件,使其生效 系统日期和时间官方文档[5] 有些时候我们需要修改系统的日期、时间、时区,有哪些调整的方式呢,下面提供的很多命令行,我们可以通过使用 timedatectl、date、hwclock 命令来设置系统的日期、时间和时区等。 当前系统时间:timedatectl 时钟自动同步:timedatectl set-ntp yes/no 修改系统日期:timedatectl set-time YYYY-MM-DD 修改系统时间:timedatectl set-time HH:MM:SS 显示可用时区:timedatectl list-timezones 修改系统时区:timedatectl set-timezone time_zone 显示当前的日期和本地时间:date 显示当前的日期和 UTC 时间:date --utc/--u 自定义 date 命令的输出:date +"%Y-%m-%d %H:%M:%S" 修改时间:date --set HH:MM:SS 修改日期:date --set YYYY-MM-DD 硬件日期时间 :hwclock 设置硬件日期和时间:hwclock --set --date "dd mm yyyy HH:MM" 常用技巧 这里有个小 Tips 分享给大家,ssh 登录一段时间后出现过期推出的情况,使得大家比较烦恼,该如何解决呢? 简单的给大家提供了两种方式: 第一种是 TMOUT 环境变量不为 0 导致的 ssh 登出,我们可以在/etc/profile 内加入 export TMOUT=0,source /etc/profile 来解决。 我们可以在 /etc/profile.d 加入要执行的脚本文件,登录时自动触发该操作,这样也可以避免 ssh 经常登出的情况。 2. openEuler 软件包管理 软件包管理官方文档[6] 给大家介绍一下,用来管理 openEuler 的软件包的工具 DNF。 DNF 是一款 Linux 软件包管理工具,用于管理 RPM 软件包。DNF 可以查询软件包信息,从指定软件库获取软件包,自动处理依赖关系以安装或卸载软件包,以及更新系统到最新可用版本。 简单的小说明:- DNF 与 YUM 完全兼容,提供了 YUM 兼容的命令行以及为扩展和插件提供的 API,所以在 openEuler 使用命令行的工具中,可以使用 DNF 也可以使用 YUM,根据自己的喜欢来用。- 后面主要使用 YUM 来给大家进行演示,在使用 YUM 的时候需要管理员权限,所有命令需要在管理员权限下执行。 2.1 openEuler 源配置 YUM 给大家提供两种下载软件的方式: 利用本地 iso 挂载源,当作光驱一样(离线),这种方式是比较有限的,需要离线使用。mount iso /mnt 该源的配置文件:编辑/etc/yum.repos.d/xxx.repo(/etc/dnf/dnf.cong) 利用 openEuler 官方提供的源(在线),这种方式是比较全的,比较新的,里面有许多源地址可供选择,但该方式需要在线使用。源网址[7]该源的配置文件:编辑/etc/yum.repos.d/xxx.repo(/etc/dnf/dnf.conf) 2.2 openEuler update 源配置 openEuler update 源:openEuler 升级软件包的 repo 源,用于已发布版本的 bug、CVE 的修复和部分软件因特性增强后的更新发布。提供在线下载和版本内软件升级功能。目录下区分 AArch64 架构和 x86 架构。 安全公告里的很多 CVE 漏洞是实时修复的,修复完之后,修复的包大家可以通过 yum update 命令将系统上所有的包进行升级。 2.3 openEuler 使用 dnf/yum 下载软件包 下载/安装/更新软件包时(yum 和 dnf 本质相同),大家可以根据自己使用习惯使用相应的终端命令。下表就是常用的 yum 命令行,查看系统包的相关内容。 注意:有时候在包升级过程中,部分包的升级会有一些冲突,你需要在 update 命令最后面使用 --allowerasing 先移除之前的包,然后再升级该包。 2.3 openEuler 使用 rpm 管理本地软件包 除了 dnf 和 yum 也可以使用 rpm 针对本地的管家包进行管理。rpm 与 yum 的区别是 rpm 不会从固定的地方去取,它是先将所有的包下载下来再去安装,使用起来比较复杂,建议大家使用 yum。下面也提供了一些 rpm 对软件包操作的命令行,感兴趣的同学可以试一试。 3. systemd 基本用法 官方文档[8] systemd 是在 Linux 下,与 SysV 和 LSB 初始化脚本兼容的系统和服务管理器。systemd 使用 socket 和 D-Bus 来开启服务,提供基于守护进程的按需启动策略,支持快照和系统状态恢复,维护挂载和自挂载点,实现了各服务间基于从属关系的一个更为精细的逻辑控制,拥有更高的并行性能。 systemd 有哪些优点 并行启动能力强(SysVinit 是串行启动,UpStart 有依赖关系的是串行启动) 按需启动,只有真正被请求时才启动(SysVinit 将可能用到的进程全部启动) 利用内核提供的 cgroup 确保跟踪所有子进程 systemd 对 SysV 和 LSB 兼容 systemd 作为 1 号进程 systemd 取代了 initd 成为了系统的第一个进程,我们称之为 1 号进程。 内核空间初始化完成后,加载 init(/sbin/init)程序拉起 1 号进程;1 号进程通过 systemd 目标(target)拉起必须的进程,实现初始化。 下图命令是指向了 systemd 文件: 启动级别 systemd 目前有 7 个启动级别,下表中详细的说明了每个级别的作用及命令行。 以下命令可以查看我们运行了哪些级别/更改默认的启动级别/当前立马更改级别 systemctl get-default/set-default/isolate name.target 单元文件 systemd 开启和监督整个系统是基于 unit 的概念。unit 是由一个与配置文件对应的名字和类型组成的(例如:avahi.service unit 有一个具有相同名字的配置文件,是守护进程 Avahi 的一个封装单元)。所有的可用 systemd unit 类型路径如下: 服务文件介绍 常用的 systemd 服务文件格式固定:[Unit]:服务简单描述及文档,以及依赖关系 [Service]:定义服务如何启动当前的服务 [Install]:定义如何安装文件,即如何做到开机启动 常见用法 systemctl start/restart/stop/reload/status/enable/disable/daemon-reload name.unit Systemd 命令和 sysvinit 命令的对照表 systemd 提供 systemctl 命令与 sysvinit 命令的功能类似。当前版本中依然兼容 service 和 chkconfig 命令,相关说明如下表,但建议用 systemctl 进行系统服务管理。 启动流程 启动服务需要使用三个主线 target 去拉取上。每个 target 都会拉取各自需要的服务进程,拉取完成后系统准备就绪可以使用了。 multi-user.target -> basic.target -> sysinit.target 日志查看 常见日志存储目录:/var/log/(由 rsyslog 转储 systemd-journald 而来,所以必须开机并完成 rsyslogd 之后才会有日志) 查看内核日志的命令行:dmesg systemd 日志 systemd-journald 服务是 systemd init 系统提供的收集系统日志的服务。可以记录开机过程中的所有信息,包括启动服务等情况。 systemd 日志常见用法 journalctl:全部日志 journalctl -f:实时日志 journalctl _SYSTEMD_UNIT=NetworkManager.service journalctl --since "2020-08-05 12:20" (yesterday,today) 日志默认保存在 /run/log 中,重启丢失,保存重启前日志方法。 创建/var/log/journal 目录 修改/etc/systemd/journald.conf,将 Storage=auto 改为 persistent,重启日志服务 这两个方法可以使得您的日志不至于丢失,有时候需要定位一些问题,将日志改成 debug 级别,这对日志定位问题有很大的帮助。 修改日志为 debug 级别​​​​​​​ /etc/systemd/system.conf loglevel=debug/etc/profile 中加:export SYSTEMD_LOG_LEVEL=debug修改完进行重启。 4. 服务搭建 这里介绍四种服务器搭建: Repo 服务器:openEuler 提供了多种 repo 源供用户在线使用,各 repo 源含义可参考系统安装[9]。若用户无法在线获取 openEuler repo 源,则可使用 openEuler 提供的 ISO 发布包创建为本地 openEuler repo 源。 FTP 服务器搭建:FTP(File Transfer Protocol)即文件传输协议,是互联网最早的传输协议之一,其最主要的功能是服务器和客户端之间的文件传输。FTP 使用户可以通过一套标准的命令访问远程系统上的文件,而不需要直接登录远程系统。 Web 服务器搭建:Web(World Wide Web)是目前最常用的 Internet 协议之一。目前在 Unix-Like 系统中的 web 服务器主要通过 Apache 服务器软件实现。为了实现运营动态网站,产生了 LAMP(Linux + Apache +MySQL + PHP)。web 服务可以结合文字、图形、影像以及声音等多媒体,并支持超链接(Hyperlink)的方式传输信息。openEuler 系统中的 web 服务器版本是 Apache HTTP 服务器 2.4 版本,即 httpd,一个由 Apache 软件基金会发展而来的开源 web 服务器。 数据库服务器搭建:数据库服务器使用 PostgreSql 具体详细四种服务器搭建方式可以参考官方文档[10] 5. 欢迎关注 参考资料 [1]管理员指南:https://openeuler.org/zh/docs/20.03_LTS/docs/Administration/administration.html [2]文档:https://openeuler.org/zh/docs/20.03_LTS/docs/Administration/配置网络.html [3]官方文档:https://openeuler.org/zh/docs/20.03_LTS/docs/Administration/%E6%9F%A5%E7%9C%8B%E7%B3%BB%E7%BB%9F%E4%BF%A1%E6%81%AF.html [4]官方文档:https://openeuler.org/zh/docs/20.03_LTS/docs/Administration/%E5%9F%BA%E7%A1%80%E9%85%8D%E7%BD%AE.html [5]官方文档:https://openeuler.org/zh/docs/20.03_LTS/docs/Administration/%E5%9F%BA%E7%A1%80%E9%85%8D%E7%BD%AE.html [6]软件包管理官方文档:https://openeuler.org/zh/docs/20.03_LTS/docs/Administration/使用DNF管理软件包.html [7]源网址:http://repo.openeuler.org/ [8]官方文档:https://openeuler.org/zh/docs/20.03_LTS/docs/Administration/%E7%AE%A1%E7%90%86%E6%9C%8D%E5%8A%A1.html [9]系统安装:https://openeuler.org/zh/docs/20.03_LTS/docs/Releasenotes/系统安装.html [10]官方文档:https://openeuler.org/zh/docs/20.03_LTS/docs/Administration/%E6%90%AD%E5%BB%BA%E6%9C%8D%E5%8A%A1.html 作者: syyhao ​​​​​​​

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册