首页 文章 精选 留言 我的

精选列表

搜索[云数据库 Redis®],共10034篇文章
优秀的个人博客,低调大师

Chromium Viz 浅析 - SkiaRenderer & SkiaOutputSurface

关于 Viz 的系列文章 Chromium Viz 浅析 - 介绍篇Chromium Viz 浅析 - 合成器架构篇 Chromium 关于光栅化和合成的一些主要性能优化项目包括 OOPD (Out of Process Display Compositor,进程外 Display 合成器), OOPR (Out of Process Rasterization,进程外光栅化) 和 SkiaRenderer。 我们在Chromium Viz 浅析 - 合成器架构篇介绍过 OOPD,它的主要目的是将 Display Compositor 从 Browser 进程迁移到 Viz 进程(也就是原来的 GPU 进程),Browser 则变成了 Viz 的一个 Client,Renderer 跟 Viz 建立链接(CompositorFrameS

优秀的个人博客,低调大师

Centos&Ubuntu 安装 Impala

环境如下 linux版本:ubuntu 14.04 LTS jdk版本:jdk1.7.0_67 hadoop版本:hadoop-2.0.0-cdh4.1.0.tar.gz impala版本:impala_1.4.0-1.impala1.4.0.p0.7~precise-impala1.4.0_all.deb hadoop-cdh下载地址:http://archive.cloudera.com/cdh4/cdh/4/ ubuntu impala下载地址:http://archive.cloudera.com/impala/ubuntu/precise/amd64/impala/pool/contrib/i/impala/ 建议:hadoop的版本不要太高,还是用cdh4比较靠谱,之前我用了apache-hadoop2.7,hadoop2.6-cdh5,impala启动时都报了错误,原因为protobuf不兼容,该错误我查了几天。 为了方便,以下教程我在root用户下进行,及root作为使用用户。 1、安装hadoop # apt-get install openssh-server 设置免密码登录 # ssh-keygen -t rsa -P "" # cat .ssh/id_rsa.pub >> .ssh/authorized_keys 下载jdk-7u67-linux-x64.tar.gz,解压后配置环境变量 # tar -vzxf jdk-7u67-linux-x64.tar.gz # mkdir /usr/java # mv jdk1.7.0_67 /usr/java/ # vi /etc/profile export JAVA_HOME=/usr/java/jdk1.7.0_67 export PATH=$JAVA_HOME/bin:$JAVA_HOME/jre/bin:$PATH export CLASSPATH=$CLASSPATH:.:$JAVA_HOME/lib:$JAVA_HOME/jre/lib # tar -xvzf hadoop-2.0.0-cdh4.1.0.tar.gz # mv hadoop-2.0.0-cdh4.1.0 /usr/local/ # vi /etc/profile export HADOOP_HOME=/usr/local/hadoop-2.0.0-cdh4.1.0 export PATH=$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$PATH export HADOOP_PREFIX=$HADOOP_HOME export HADOOP_MAPRED_HOME=$HADOOP_HOME export HADOOP_COMMON_HOME=$HADOOP_HOME export HADOOP_HDFS_HOME=$HADOOP_HOME export HADOOP_YARN_HOME=$HADOOP_HOME export HADOOP_LIB=$HADOOP_HOME/lib export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop export HADOOP_OPTS="-Djava.library.path=$HADOOP_HOME/lib" # source /etc/profile 2、配置hadoop,伪分布式配置 # cd /etc/local/hadoop-2.0.0-cdh4.1.0 # cd /etc/hadoop # vi hadoop-env.sh export JAVA_HOME=/usr/java/jdk1.7.0_67 # vi core-site.xml <configuration> <property> <name>hadoop.tmp.dir</name> <!-- 临时目录 --> <value>file:/root/hadoop/tmp</value> </property> <property> <name>fs.defaultFS</name> <value>hdfs://localhost:9000</value> </property> </configuration> # vi hdfs-site.xml <configuration> <property> <name>dfs.replication</name> <value>1</value> </property> <property> <name>dfs.namenode.name.dir</name> <!-- namenode目录--> <value>file:/root/hadoop/tmp/dfs/name</value> </property> <property> <name>dfs.datanode.data.dir</name> <!-- datanode目录 --> <value>file:/root/hadoop/tmp/dfs/data</value> </property> </configuration> # cd ~ # mkdir -p hadoop/tmp/dfs/name # mkdir hadoop/tmp/dfs/data 注:需要保证用户为hadoop-2.0.0-cdh4.1.0目录、namenode目录和datanode目录的拥有者 3、启动hadoop 格式化namenode # hadoop namenode -format # start-all.sh (该命令在$HADOOP_HOME/sbin) 测试 # hadoop fs -ls / #查看hdfs的/目录 # hadoop fs -mkdir /user #在hdfs创建目录user # hadoop fs -put a.out /user #在hdfs的/user下上传文件a.out # hadoop fs -get /user/a.out #下载a.out文件到本地 关闭hadoop # stop-all.sh 4、安装impala 修改源: # vi /etc/apt/sources.list.d/cloudera.list deb [arch=amd64] http://archive.cloudera.com/cm5/ubuntu/trusty/amd64/cm trusty-cm5 contrib deb-src http://archive.cloudera.com/cm5/ubuntu/trusty/amd64/cm trusty-cm5 contrib deb [arch=amd64] http://archive.cloudera.com/impala/ubuntu/precise/amd64/impala precise-impala1 contrib deb-src http://archive.cloudera.com/impala/ubuntu/precise/amd64/impala precise-impala1 contrib # apt-get update # apt-get install bigtop-utils 用apt-get下载impala太慢了,可在http://archive.cloudera.com/impala/ubuntu/precise/amd64/impala/pool/contrib/i/impala/ 下载相应安装包。 # dpkg -i impala_1.4.0-1.impala1.4.0.p0.7~precise-impala1.4.0_all.deb # dpkg -i impala-server_1.4.0-1.impala1.4.0.p0.7-precise-impala1.4.0_all.deb # dpkg -i impala-state-store_1.4.0-1.impala1.4.0.p0.7-precise-impala1.4.0_all.deb # dpkg -i impala-catalog_1.4.0-1.impala1.4.0.p0.7-precise-impala1.4.0_all.deb # apt-get install python-setuptools 出错则根据错误修改(apt-get -f install) # dpkg -i impala-shell_1.4.0-1.impala1.4.0.p0.7-precise-impala1.4.0_all.deb impala安装完毕。 5、impala配置 # vi /etc/hosts 127.0.0.1 localhost 在$HADOOP_HOME/etc/hadoop下将core-site.xml及hdfs-site.xml拷贝到/etc/impala/conf # cd /usr/local/hadoop-2.0.0-cdh4.1.0/etc/hadoop/ # cp core-site.xml hdfs-site.xml /etc/impala/conf # cd /etc/impala/conf # vi hdfs-site.xml 增加: <property> <name>dfs.client.read.shortcircuit</name> <value>true</value> </property> <property> <name>dfs.domain.socket.path</name> <value>/var/run/hadoop-hdfs/dn._PORT</value> </property> <property> <name>dfs.datanode.hdfs-blocks-metadata.enabled</name> <value>true</value> </property> <property> <name>dfs.client.use.legacy.blockreader.local</name> <value>true</value> </property> <property> <name>dfs.datanode.data.dir.perm</name> <value>750</value> </property> <property> <name>dfs.block.local-path-access.user</name> <value>impala</value> </property> <property> <name>dfs.client.file-block-storage-locations.timeout</name> <value>3000</value> </property> # mkdir /var/run/hadoop-hdfs 注:保证/var/run/hadoop-hdfs为用户所有 6、impala启动 # service impala-state-store start # service impala-catalog start # service impala-server start 查看是否启动: # ps -ef | grep impala 错误信息查看日志 启动impala-shell # impala-shell -i localhost --quiet [localhost:21000] > select version(); ... [localhost:21000] > select current_database(); ... impala-shell操作见http://www.cloudera.com/documentation/enterprise/latest/topics/impala_tutorial.html#tutorial 7、impala日志错误处理 impala日志位置为:/var/log/impala impala启动错误1: Failed on local exception: com.google.protobuf.InvalidProtocolBufferException: Message missing required fields: callId, status; Host Details : local host is: "database32/127.0.1.1"; destination host is: "localhost":9000; 原因: hadoop2.6的protobuf版本为2.5,为impala用的版本为protobuf2.4 解决: 将hadoop的版本降低时与impala的版本匹配,这里impala采用二进制方式安装,无法 重新编译,解决为将hadoop的版本与impala版本一致。我下载的hadoop为hadoop-2.0.0-cdh4.1.0,impala为impala_1.4.0 impala启动错误2: dfs.client.read.shortcircuit is not enabled because - dfs.client.use.legacy .blockreader.local is not enabled 原因: hdfs-site.xml配置出错 解决: 将dfs.datanode.hdfs-blocks-metadata.enabled选项设为true impala启动错误3: Impalad services did not start correctly, exiting. Error: Couldn't open transport for 127.0.0.1:24000(connect() failed: Connection refused) 原因: 未启动impala-state-store,impala-catalog 解决: # service impala-state-store start # service impala-catalog start # service impala start Centos部分: 安装Impala过程 摘要:与Hive类似,Impala也可以直接与HDFS和HBase库直接交互。只不过Hive和其它建立在MapReduce上的框架适合需要长时间运行的批处理任务。例如:那些批量提取,转化,加载(ETL)类型的Job,而Impala主要用于实时查询。 与Hive类似,Impala也可以直接与HDFS和HBase库直接交互。只不过Hive和其它建立在MapReduce上的框架适合需要长时间运行的批处理任务。例如:那些批量提取,转化,加载(ETL)类型的Job,而Impala主要用于实时查询。 Hadoop集群各节点的环境设置及安装过程见使用yum安装CDH Hadoop集群,参考这篇文章。 1. 环境 CentOS 6.4 x86_64 CDH 5.0.1 jdk1.6.0_31 集群规划为3个节点,每个节点的ip、主机名和部署的组件分配如下: 192.168.56.121 cdh1 NameNode、Hive、ResourceManager、HBase、impala 192.168.56.122 cdh2 DataNode、SSNameNode、NodeManager、HBase、impala 192.168.56.123 cdh3 DataNode、HBase、NodeManager、impala 2. 安装 目前,CDH 5.0.1中 impala 版本为1.4.0,下载repo文件到 /etc/yum.repos.d/: 如果你安装的是 CDH4,请下载Red Hat/CentOS 6 如果你安装的是 CDH5,请下载Red Hat/CentOS 6 然后,可以执行下面的命令安装所有的 impala 组件。 $ sudo yum install impala impala-server impala-state-store impala-catalog impala-shell -y 但是,通常只是在需要的节点上安装对应的服务: 在 hive metastore 所在节点安装impala-state-store和impala-catalog 在 DataNode 所在节点安装 impala-server 和 impala-shell 3. 配置 3.1 修改配置文件 查看安装路径: $ find / -name impala /var/run/impala /var/lib/alternatives/impala /var/log/impala /usr/lib/impala /etc/alternatives/impala /etc/default/impala /etc/impala /etc/default/impala impalad的配置文件路径由环境变量IMPALA_CONF_DIR指定,默认为/usr/lib/impala/conf,impala 的默认配置在/etc/default/impala,修改该文件中的IMPALA_CATALOG_SERVICE_HOST和IMPALA_STATE_STORE_HOST IMPALA_CATALOG_SERVICE_HOST=cdh1 IMPALA_STATE_STORE_HOST=cdh1 IMPALA_STATE_STORE_PORT=24000 IMPALA_BACKEND_PORT=22000 IMPALA_LOG_DIR=/var/log/impala IMPALA_CATALOG_ARGS=" -log_dir=${IMPALA_LOG_DIR} " IMPALA_STATE_STORE_ARGS=" -log_dir=${IMPALA_LOG_DIR} -state_store_port=${IMPALA_STATE_STORE_PORT}" IMPALA_SERVER_ARGS=" \ -log_dir=${IMPALA_LOG_DIR} \ -catalog_service_host=${IMPALA_CATALOG_SERVICE_HOST} \ -state_store_port=${IMPALA_STATE_STORE_PORT} \ -use_statestore \ -state_store_host=${IMPALA_STATE_STORE_HOST} \ -be_port=${IMPALA_BACKEND_PORT}" ENABLE_CORE_DUMPS=false # LIBHDFS_OPTS=-Djava.library.path=/usr/lib/impala/lib # MYSQL_CONNECTOR_JAR=/usr/share/java/mysql-connector-java.jar # IMPALA_BIN=/usr/lib/impala/sbin # IMPALA_HOME=/usr/lib/impala # HIVE_HOME=/usr/lib/hive # HBASE_HOME=/usr/lib/hbase # IMPALA_CONF_DIR=/etc/impala/conf # HADOOP_CONF_DIR=/etc/impala/conf # HIVE_CONF_DIR=/etc/impala/conf # HBASE_CONF_DIR=/etc/impala/conf 设置 impala 可以使用的最大内存:在上面的IMPALA_SERVER_ARGS参数值后面添加-mem_limit=70%即可。 如果需要设置 impala 中每一个队列的最大请求数,需要在上面的IMPALA_SERVER_ARGS参数值后面添加-default_pool_max_requests=-1,该参数设置每一个队列的最大请求数,如果为-1,则表示不做限制。 在节点cdh1上拷贝hive-site.xml、core-site.xml、hdfs-site.xml至/usr/lib/impala/conf目录并作下面修改在hdfs-site.xml文件中添加如下内容: <property> <name>dfs.client.read.shortcircuit</name> <value>true</value> </property> <property> <name>dfs.domain.socket.path</name> <value>/var/run/hadoop-hdfs/dn._PORT</value> </property> <property> <name>dfs.datanode.hdfs-blocks-metadata.enabled</name> <value>true</value> </property> 同步以上文件到其他节点。 3.2 创建socket path 在每个节点上创建/var/run/hadoop-hdfs: $ mkdir -p /var/run/hadoop-hdfs 拷贝postgres jdbc jar: $ ln -s /usr/share/java/postgresql-jdbc.jar /usr/lib/impala/lib/ 3.3 用户要求 impala 安装过程中会创建名为 impala 的用户和组,不要删除该用户和组。 如果想要 impala 和 YARN 和 Llama 合作,需要把 impala 用户加入 hdfs 组。 impala 在执行 DROP TABLE 操作时,需要把文件移到到 hdfs 的回收站,所以你需要创建一个 hdfs 的目录 /user/impala,并将其设置为impala 用户可写。同样的,impala 需要读取 hive 数据仓库下的数据,故需要把 impala 用户加入 hive 组。 impala 不能以 root 用户运行,因为 root 用户不允许直接读。 创建 impala 用户家目录并设置权限: sudo -u hdfs hadoop fs -mkdir /user/impala sudo -u hdfs hadoop fs -chown impala /user/impala 查看 impala 用户所属的组: $ groups impala impala : impala hadoop hdfs hive 由上可知,impala 用户是属于 imapal、hadoop、hdfs、hive 用户组的 4. 启动服务 在 cdh1节点启动: $ service impala-state-store start $ service impala-catalog start 如果impalad正常启动,可以在/tmp/ impalad.INFO查看。如果出现异常,可以查看/tmp/impalad.ERROR定位错误信息。 5. 使用shell 使用impala-shell启动Impala Shell,连接 cdh1,并刷新元数据 >impala-shell [Not connected] >connect cdh1 [cdh1:21000] >invalidate metadata [cdh2:21000] >connect cdh2 [cdh2:21000] >select * from t 当在 Hive 中创建表之后,第一次启动 impala-shell 时,请先执行INVALIDATE METADATA语句以便 Impala 识别出新创建的表(在 Impala 1.2 及以上版本,你只需要在一个节点上运行INVALIDATE METADATA,而不是在所有的 Impala 节点上运行)。 你也可以添加一些其他参数,查看有哪些参数: # impala-shell -h Usage: impala_shell.py [options] Options: -h, --help show this help message and exit -i IMPALAD, --impalad=IMPALAD <host:port> of impalad to connect to -q QUERY, --query=QUERY Execute a query without the shell -f QUERY_FILE, --query_file=QUERY_FILE Execute the queries in the query file, delimited by ; -k, --kerberos Connect to a kerberized impalad -o OUTPUT_FILE, --output_file=OUTPUT_FILE If set, query results will written to the given file. Results from multiple semicolon-terminated queries will be appended to the same file -B, --delimited Output rows in delimited mode --print_header Print column names in delimited mode, true by default when pretty-printed. --output_delimiter=OUTPUT_DELIMITER Field delimiter to use for output in delimited mode -s KERBEROS_SERVICE_NAME, --kerberos_service_name=KERBEROS_SERVICE_NAME Service name of a kerberized impalad, default is 'impala' -V, --verbose Enable verbose output -p, --show_profiles Always display query profiles after execution --quiet Disable verbose output -v, --version Print version information -c, --ignore_query_failure Continue on query failure -r, --refresh_after_connect Refresh Impala catalog after connecting -d DEFAULT_DB, --database=DEFAULT_DB Issue a use database command on startup. 例如,你可以在连接时候字段刷新: $ impala-shell -r Starting Impala Shell in unsecure mode Connected to 192.168.56.121:21000 Server version: impalad version 1.1.1 RELEASE (build 83d5868f005966883a918a819a449f636a5b3d5f) Invalidating Metadata Welcome to the Impala shell. Press TAB twice to see a list of available commands. Copyright (c) 2012 Cloudera, Inc. All rights reserved. (Shell build version: Impala Shell v1.1.1 (83d5868) built on Fri Aug 23 17:28:05 PDT 2013) Query: invalidate metadata Query finished, fetching results ... Returned 0 row(s) in 5.13s [192.168.56.121:21000] > 使用 impala 导出数据: $ impala-shell -i '192.168.56.121:21000' -r -q "select * from test" -B --output_delimiter="\t" -o result.txt 版权声明:本文内容由互联网用户自发贡献,版权归作者所有,本社区不拥有所有权,也不承担相关法律责任。如果您发现本社区中有涉嫌抄袭的内容,欢迎发送邮件至: yqgroup@service.aliyun.com进行举报,并提供相关证据,一经查实,本社区将立刻删除涉嫌侵权内容。


优秀的个人博客,低调大师

hadoop&amp;spark安装(上)

硬件环境: hddcluster1 10.0.0.197 redhat7 hddcluster2 10.0.0.228 centos7 这台作为master hddcluster3 10.0.0.202 redhat7 hddcluster4 10.0.0.181 centos7 软件环境: 关闭所有防火墙firewall openssh-clients openssh-server java-1.8.0-openjdk java-1.8.0-openjdk-devel hadoop-2.7.3.tar.gz 流程: 选定一台机器作为 Master 在 Master 节点上配置 hadoop 用户、安装 SSH server、安装 Java 环境 在 Master 节点上安装 Hadoop,并完成配置 在其他 Slave 节点上配置 hadoop 用户、安装 SSH server、安装 Java 环境 将 Master 节点上的 /usr/local/hadoop 目录复制到其他 Slave 节点上 在 Master 节点上开启 Hadoop 1 2 3 4 5 6 7 8 #节点的名称与对应的IP关系 [hadoop@hddcluster2~]$ cat /etc/hosts 127.0.0.1localhostlocalhost.localdomainlocalhost4localhost4.localdomain4 ::1localhostlocalhost.localdomainlocalhost6localhost6.localdomain6 10.0.0.228hddcluster2 10.0.0.197hddcluster1 10.0.0.202hddcluster3 10.0.0.181hddcluster4 1 2 3 4 5 创建hadoop用户 su #上述提到的以root用户登录 useradd -mhadoop-s /bin/bash #创建新用户hadoop passwd hadoop #设置hadoop密码 visudo #rootALL=(ALL)ALL这行下面添加hadoopALL=(ALL)ALL 1 2 3 4 5 6 7 8 9 10 11 #登录hadoop用户,安装SSH、配置SSH无密码登陆 [hadoop@hddcluster2~]$rpm-qa| grep ssh [hadoop@hddcluster2~]$ sudo yum install openssh-clients [hadoop@hddcluster2~]$ sudo yum install openssh-server [hadoop@hddcluster2~]$ cd ~/. ssh / #若没有该目录,请先执行一次sshlocalhost [hadoop@hddcluster2~]$ ssh -keygen-trsa #会有提示,都按回车就可以 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .publocalhost #加入授权 [hadoop@hddcluster2~]$ chmod 600. /authorized_keys #修改文件权限 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .pubhadoop@hddcluster1 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .pubhadoop@hddcluster3 [hadoop@hddcluster2~]$ ssh -copy- id -i~/. ssh /id_rsa .pubhadoop@hddcluster4 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 #解压hadoop文件到/usr/local/hadoop [hadoop@hddcluster2~]$ sudo tar -zxfhadoop-2.7.3. tar .gz-C /usr/local/ [hadoop@hddcluster2~]$ sudo mv /usr/local/hadoop-2 .7.3 /usr/local/hadoop [hadoop@hddcluster2~]$ sudo chown -Rhadoop:hadoop /usr/local/hadoop cd /usr/local/hadoop . /bin/hadoop version #安装java环境 [hadoop@hddcluster2~]$ sudo yum install java-1.8.0-openjdkjava-1.8.0-openjdk-devel [hadoop@hddcluster2~]$rpm-qljava-1.8.0-openjdk-devel| grep '/bin/javac' /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 /bin/javac [hadoop@hddcluster2~]$vim~/.bashrc export JAVA_HOME= /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 export HADOOP_HOME= /usr/local/hadoop export HADOOP_INSTALL=$HADOOP_HOME export HADOOP_MAPRED_HOME=$HADOOP_HOME export HADOOP_COMMON_HOME=$HADOOP_HOME export HADOOP_HDFS_HOME=$HADOOP_HOME export YARN_HOME=$HADOOP_HOME export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME /lib/native export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin export HADOOP_PREFIX=$HADOOP_HOME export HADOOP_OPTS= "-Djava.library.path=$HADOOP_PREFIX/lib:$HADOOP_PREFIX/lib/native" #测试java环境 source ~/.bashrc java-version $JAVA_HOME /bin/java -version #与直接执行java-version一样 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 #修改hadoop文件配置 [hadoop@hddcluster2hadoop]$ pwd /usr/local/hadoop/etc/hadoop [hadoop@hddcluster2hadoop]$ cat core-site.xml <?xmlversion= "1.0" encoding= "UTF-8" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>fs.defaultFS< /name > <value>hdfs: //hddcluster2 :9000< /value > < /property > <property> <name>hadoop.tmp. dir < /name > <value> file : /usr/local/hadoop/tmp < /value > <description>Abase for othertemporarydirectories.< /description > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ cat hdfs-site.xml <?xmlversion= "1.0" encoding= "UTF-8" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>dfs.namenode.secondary.http-address< /name > <value>hddcluster2:50090< /value > < /property > <property> <name>dfs.replication< /name > <value>3< /value > < /property > <property> <name>dfs.namenode.name. dir < /name > <value> file : /usr/local/hadoop/tmp/dfs/name < /value > < /property > <property> <name>dfs.datanode.data. dir < /name > <value> file : /usr/local/hadoop/tmp/dfs/data < /value > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ [hadoop@hddcluster2hadoop]$ cat mapred-site.xml <?xmlversion= "1.0" ?> <?xml-stylesheet type = "text/xsl" href= "configuration.xsl" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <!--Putsite-specificpropertyoverrides in this file .--> <configuration> <property> <name>mapreduce.framework.name< /name > <value>yarn< /value > < /property > <property> <name>mapreduce.jobhistory.address< /name > <value>hddcluster2:10020< /value > < /property > <property> <name>mapreduce.jobhistory.webapp.address< /name > <value>hddcluster2:19888< /value > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ [hadoop@hddcluster2hadoop]$ cat yarn-site.xml <?xmlversion= "1.0" ?> <!-- LicensedundertheApacheLicense,Version2.0(the "License" ); youmaynotusethis file except in compliancewiththeLicense. YoumayobtainacopyoftheLicenseat http: //www .apache.org /licenses/LICENSE-2 .0 Unlessrequiredbyapplicablelaworagreedto in writing,software distributedundertheLicenseisdistributedonan "ASIS" BASIS, WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. SeetheLicense for thespecificlanguagegoverningpermissionsand limitationsundertheLicense.SeeaccompanyingLICENSE file . --> <configuration> <!--SitespecificYARNconfigurationproperties--> <property> <name>yarn.resourcemanager. hostname < /name > <value>hddcluster2< /value > < /property > <property> <name>yarn.nodemanager.aux-services< /name > <value>mapreduce_shuffle< /value > < /property > < /configuration > [hadoop@hddcluster2hadoop]$ [hadoop@hddcluster2hadoop]$ cat slaves hddcluster1 hddcluster2 hddcluster3 hddcluster4 1 2 3 4 5 6 7 8 $ cd /usr/local $ sudo rm -r. /hadoop/tmp #删除Hadoop临时文件 $ sudo rm -r. /hadoop/logs/ * #删除日志文件 $ tar -zcf~ /hadoop .master. tar .gz. /hadoop #先压缩再复制 $ cd ~ $ scp . /hadoop .master. tar .gzhddcluster1: /home/hadoop $ scp . /hadoop .master. tar .gzhddcluster3: /home/hadoop $ scp . /hadoop .master. tar .gzhddcluster4: /home/hadoop 1 2 3 4 在salve节点上操作,安装软件环境并配置好.bashrc sudo tar -zxf~ /hadoop .master. tar .gz-C /usr/local sudo chown -Rhadoop /usr/local/hadoop 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 [hadoop@hddcluster2~]$hdfsnamenode- format #首次运行需要执行初始化,之后不需要 接着可以启动hadoop了,启动需要在Master节点上进行启动命令: $start-dfs.sh $start-yarn.sh $mr-jobhistory-daemon.shstarthistoryserver 通过命令jps可以查看各个节点所启动的进程。正确的话, 在Master节点上可以看到NameNode、ResourceManager、SecondrryNameNode、JobHistoryServer进程, 另外还需要在Master节点上通过命令hdfsdfsadmin-report查看DataNode是否正常启动,如果Livedatanodes不为0,则说明集群启动成功。 [hadoop@hddcluster2~]$hdfsdfsadmin-report ConfiguredCapacity:2125104381952(1.93TB) PresentCapacity:1975826509824(1.80TB) DFSRemaining:1975824982016(1.80TB) DFSUsed:1527808(1.46MB) DFSUsed%:0.00% Underreplicatedblocks:0 Blockswithcorruptreplicas:0 Missingblocks:0 Missingblocks(withreplicationfactor1):0 ------------------------------------------------- Livedatanodes(4): 也可以通过Web页面看到查看DataNode和NameNode的状态:http: //hddcluster2 :50070/。如果不成功,可以通过启动日志排查原因。 1 在Slave节点操作可以看到DataNode和NodeManager进程 1 2 3 4 5 6 7 8 9 10 测试hadoop分布式实例 首先创建HDFS上的用户目录: hdfsdfs- mkdir -p /user/hadoop 将 /usr/local/hadoop/etc/hadoop 中的配置文件作为输入文件复制到分布式文件系统中: hdfsdfs- mkdir input hdfsdfs-put /usr/local/hadoop/etc/hadoop/ *.xmlinput 通过查看的DataNode的状态(占用大小有改变),输入文件确实复制到了DataNode中。 接着就可以运行MapReduce作业了: hadoopjar /usr/local/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples- *.jar grep inputoutput 'dfs[a-z.]+' 等待执行完毕后的输出结果: 1 2 3 4 5 6 7 8 hadoop启动命令: start-dfs.sh start-yarn.sh mr-jobhistory-daemon.shstarthistoryserver hadoop关闭命令: stop-dfs.sh stop-yarn.sh mr-jobhistory-daemon.shstophistoryserver PS:如果集群有一两台无法启动的话,先尝试一下删除hadoop临时文件 cd /usr/local sudo rm -r ./hadoop/tmp sudo rm -r ./hadoop/logs/* 然后执行 hdfs namenode -format 再启动 本文参考了一下网站并实验成功: http://www.powerxing.com/install-hadoop-cluster/ 本文转自 yanconggod 51CTO博客,原文链接: http://blog.51cto.com/yanconggod/1884998

优秀的个人博客,低调大师

hadoop&amp;spark安装(下)

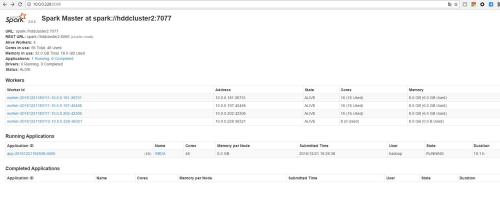
上一遍文章中其实最主要的就是JAVA环境变量以及hadoop环境变量的设置,这两个设置好了的话,运行hadoop基本上不会出问题。 在hadoop的基础上安装spark好简单。 安装Spark之前需要先安装Hadoop集群,因为之前已经安装了hadoop,所以我直接在之前的hadoop集群上安装spark。 硬件环境: hddcluster1 10.0.0.197 redhat7 hddcluster2 10.0.0.228 centos7 这台作为master hddcluster3 10.0.0.202 redhat7 hddcluster4 10.0.0.181 centos7 软件环境: scala-2.11.7 spark-2.0.2-bin-hadoop2.7.tgz #所有操作用hadoop 基本流程: 1、master解压scala-2.11.7和spark-2.0.2-bin-hadoop2.7.tgz到相应的目录 2、配置scala和spark环境变量 3、修改配置文件 4、拷贝scala和spark到各个节点,授权 5、启动spark集群 1 2 3 4 5 6 7 8 9 10 11 #hadoop用户下操作,下载scala,安装 wgethttp: //downloads .lightbend.com /scala/2 .11.7 /scala-2 .11.7.tgz tar -zxvfscala-2.11.7.tgz mv scala-2.11.7 /usr/local/scala sudo mv scala-2.11.7 /usr/local/scala vim.bashrc #添加 export SCALA_HOME= /usr/local/scala export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin :$SCALA_HOME /bin source .bashrc [hadoop@hddcluster2~]$scala-version Scalacoderunnerversion2.11.7--Copyright2002-2013,LAMP /EPFL 1 2 3 4 5 6 7 #在官网下载spark-2.0.2-bin-hadoop2.7.tgz tar -zxvfspark-2.0.2-bin-hadoop2.7.tgz mv spark-2.0.2-bin-hadoop2.7spark sudo mv spark /usr/local/ vim.bashrc #添加 export SPARK_HOME= /usr/local/spark export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin :$SCALA_HOME /bin :$SPARK_HOME 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 #修改spark配置文件 cd /usr/local/spark/conf cp spark- env .sh.templatespark- env .sh vi spark- env .sh #添加下面内容 ###jdkdir export JAVA_HOME= /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 ###scaladir export SCALA_HOME= /usr/local/scala ###theipofmasternodeofspark export SPARK_MASTER_IP=10.0.0.228 ###themaxmemorysizeofworker export SPARK_WORKER_MEMORY=8G ###hadoopconfigurationfiledir export HADOOP_CONF_DIR= /usr/local/hadoop/etc/hadoop/ #修改slave cp slaves.templateslaves vi slaves #把localhost改为下面内容 hddcluster1 hddcluster2 hddcluster3 hddcluster4 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 #把/usr/local/spark和/usr/local/scala打包,然后复制到slave节点、 cd /usr/local tar -zcf~ /master .spark. tar .gz. /spark tar -zcf~ /master .scala. tar .gz. /scala scp master.spark. tar .gzhddcluster1:~ scp master.scala. tar .gzhddcluster1:~ #登录各个节点进行解压到/usr/local tar -zxfmaster.spark. tar .gz-C /usr/local/ tar -zxfmaster.scala. tar .gz-C /usr/local/ chown -Rhadoop:hadoop /usr/local/spark chown -Rhadoop:hadoop /usr/local/scala 再配置.bashrc环境变量和master的一样。 加上hadoop上一篇的.bashrc内容是这样子: #scala export SCALA_HOME= /usr/local/scala #spark export SPARK_HOME= /usr/local/spark #javaandhadoop export JAVA_HOME= /usr/lib/jvm/java-1 .8.0-openjdk-1.8.0.111-2.b15.el7_3.x86_64 export HADOOP_HOME= /usr/local/hadoop export HADOOP_INSTALL=$HADOOP_HOME export HADOOP_MAPRED_HOME=$HADOOP_HOME export HADOOP_COMMON_HOME=$HADOOP_HOME export HADOOP_HDFS_HOME=$HADOOP_HOME export YARN_HOME=$HADOOP_HOME export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME /lib/native export PATH=$PATH:$HADOOP_HOME /sbin :$HADOOP_HOME /bin :$SCALA_HOME /bin :$SPARK_HOME export HADOOP_PREFIX=$HADOOP_HOME export HADOOP_OPTS= "-Djava.library.path=$HADOOP_PREFIX/lib:$HADOOP_PREFIX/lib/native" 到此Spark集群搭建完毕 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 .启动Spark集群: 启动Spark之前需要先将hadoop的dfs以及yarn启动。 /usr/local/spark/sbin/start-all .sh 启动所有服务之后,在命令行输入jps: [hadoop@hddcluster2~]$jps 29601ResourceManager 32098SparkSubmit 29188DataNode 29364SecondaryNameNode 29062NameNode 29915NodeManager 30251Master 30380Worker 30062JobHistoryServer 18767Jps 比hadoop集群启动时多了Master和worker /usr/local/spark/bin/spark-shell .sh 出现scala>时说明成功。 在浏览器中输入10.0.0.228:8080时,会看到如下图,有4个Worker 本文转自 yanconggod 51CTO博客,原文链接:http://blog.51cto.com/yanconggod/1885082

优秀的个人博客,低调大师

华为手机升级HarmonyOS完全攻略:消费者公测&amp;内测&amp;线下升级

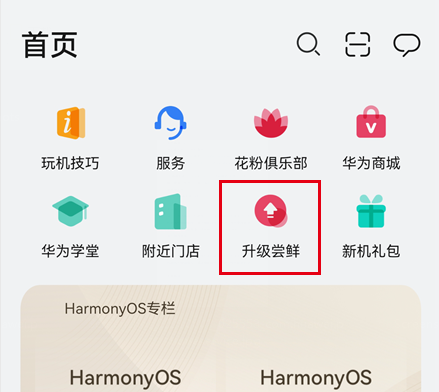
写在前面:本文旨在帮助社区各位小伙伴选择合适的渠道尽早升级HarmonyOS系统,深夜撸稿,还望三连支持一哈!! 目前正在进行的升级活动:消费者公测、消费者内测、HarmonyOS体验官(线下) 必要说明: 所有消费者公测渠道最终都会跳转到花粉俱乐部; 初期申请量巨大,花粉俱乐部很容易就挂掉,心急的小伙伴可尝试线下渠道或者多次尝试或者深夜(两点以后)申请; 申请前务必将“花粉俱乐部”、“我的华为”、“会员中心”升级到最新版本,尤其是“花粉俱乐部”。 ——消费者公测—— 包含机型: Mate X2 Mate40、Mate40E、Mate 40 Pro、Mate 40 Pro+、Mate 40 RS 保时捷设计 P40 5G、P40 4G、P40 Pro、P40 Pro+ Mate 30 4G、Mate 30 Pro 4G、Mate 30 5G、Mate 30 Pro 5G、Mate 30 RS保时捷设计、Mate 30E Pro 5G MatePad Pro、MatePad Pro 5G 我的华为/花粉俱乐部:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 1.打开“我的华为”,点击“升级尝鲜” / 打开“花粉俱乐部”,点击“公测尝鲜”。 △我的华为 △花粉俱乐部 2.页面加载完成后,点击“公测尝鲜”下的“立即尝鲜”按钮。(花粉俱乐部进入的请忽略此步骤,直接进入下步) 3.接下来在列表中找到当前手机型号对应的公测活动,点击“报名公测”。由于不同手机对应的系统版本不一样,请务必仔细核实你的机器型号。 4.此处会跳转到“花粉论坛”的一篇帖子,划到这篇帖子的末尾,点击“参加公测活动”。接下来系统会引导用户签订《华为公测协议》和《华为公测与隐私声明》,等待10秒点击通过。 5.通过两个协议后,系统会引导你下载协议文件。这个过程会验证你的机型是否符合要求,且下载的文件也是将来升级为正式版的必要文件,如果找到(反正我是没找到)请勿删除!! 6.下载并提示安装完描述文件后,就可以去检测系统更新,下载并更新HarmonyOS了。(P40系列当前版本116) ——消费者内测—— 包含机型: Mate XS、Mate 20、Mate 20 Pro、Mate 20 RS(保时捷)、Mate 20 X(4G) nova 8、nova 8 Pro、nova 8 SE、nova 7 5G、nova 7 Pro 5G、nova 7 SE 5G、nova 7 SE 5G活力版、nova 7 SE 5G乐活版、nova 6、nova 6 5G、nova 6 SE 华为畅享20 Plus 5G、华为畅享Z 5G、华为畅享20 Pro5G 华为麦芒9 5G MatePad 10.8、MatePad 5G 10.4、MatePad 10.4 内测时间:6月2日~6月9日上午10:00 渠道一 会员中心:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 1.打开会员中心,首页上找到“体验先锋”,点击进入。 2.点击顶部的HarmonyOS 2升级尝鲜。 3.进入页面点击报名。如果机型不符合,会弹出提示框。 4.接下来根据流程提示,填写信息,等待审核,坐等更新就好了。 渠道二 花粉俱乐部:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 1.进入首页点击内测报名 2.跳转后,点击立即报名 3.接下来根据流程提示,填写信息,等待审核,坐等更新就好了。 ——HarmonyOS体验官(线下)—— 包含机型: 我的华为:请先更新到最新版本,如果卸载了,请在华为应用商店下载安装。 方法: 在APP首页点击“HarmonyOS体验官”海报,经过简单的互动问答即可参加。期间需要提交信息、预约门店时间和信息,最终会生成一张包含数字的海报,用户需要保存此海报才可参与活动。 活动仅在部分门店进行,具体店面和城市请在活动页面查询。到店会提供礼品,并可在线下由店面工作人员协助完成升级。 ——重要的补充说明—— 1.消费者公测仅审核设备型号是否合规,避免出现系统和硬件不适配的情况。 2.消费者内测仍然会存在审核机制,但仅审核设备型号是否合规,避免出现系统和硬件不适配的情况。 3.最终稳定的系统版本号预计为:HarmonyOS 2.0.0.116(以实际推送版本号为准!) 4.老荣耀系列机型不在本次消费者公测列表中。 想了解更多关于鸿蒙的内容,请访问: 51CTO和华为官方战略合作共建的鸿蒙技术社区 https://harmonyos.51cto.com/#bkwz

优秀的个人博客,低调大师

SpringBoot 手写过滤器&amp;amp;加载第三方过滤器

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_36367789/article/details/81665638 如何手写一个过滤器呢。假设我现在需要一个计时过滤器,我想把每一次调用服务锁花费的时间打印到控制台,我该怎么做呢? 拦截机制有三种: 1. 过滤器(Filter)能拿到http请求,但是拿不到处理请求方法的信息。 2. 拦截器(Interceptor)既能拿到http请求信息,也能拿到处理请求方法的信息,但是拿不到方法的参数信息。 3. 切片(Aspect)能拿到方法的参数信息,但是拿不到http请求信息。 他们三个各有优缺点,需要根据自己的业务需求来选择最适合的拦截机制。 好了下面开始正文。 本教程大概目录: 1. 手写过滤器 2. 加载第三方过滤器 好了,开始正文。 1. 手写过滤器 特别容易,继承Filter ,然后根据需求重写它的三个方法。 /** * TimeFilter 计时过滤器 * Created by Fant.J. */ @Component public class TimeFilter implements Filter { @Override public void init(FilterConfig filterConfig) throws ServletException { System.out.println("time filter init"); } @Override public void doFilter(ServletRequest servletRequest, ServletResponse servletResponse, FilterChain filterChain) throws IOException, ServletException { System.out.println("time filter start"); long start = new Date().getTime(); filterChain.doFilter(servletRequest,servletResponse); System.out.println("耗时:"+(new Date().getTime() - start)); System.out.println("time filter finish"); } @Override public void destroy() { System.out.println("time filter destroy"); } } 其中 init方法是初始化方法,最先执行。 然后执行doFilter方法,熟悉servlet的应该都知道,它其实就是调用业务。 最后destroy方法,是最后执行的。 然后我们启动服务,随便调用一个controller,控制台打印如下: 2. 加载第三方过滤器 一般在开发的时候,我们可能用到第三方的过滤器,我们不可能在其源码上添加@Component注解。所以我们必须写一个配置类来引入它。 下面我们把上面的例子当作第三方过滤器,把TimeFilter类上面的@Component注解去掉。做一个模拟练习。 /** * 引入第三方过滤器 将其放入spring容器 * Created by Fant.J. */ @Configuration public class WebConfig { @Bean public FilterRegistrationBean timeFilter(){ //创建 过滤器注册bean FilterRegistrationBean registrationBean = new FilterRegistrationBean(); TimeFilter timeFilter = new TimeFilter(); registrationBean.setFilter(timeFilter); List urls = new ArrayList(); urls.add("/*"); //给所有请求加过滤器 //设置 有效url registrationBean.setUrlPatterns(urls); return registrationBean; } } 注意一定要去掉TimeFilter类上面的@Component注解,否则过滤器会失效。 介绍下我的所有文集: 流行框架 SpringCloud springboot nginx redis 底层实现原理: Java NIO教程 Java reflection 反射详解 Java并发学习笔录 Java Servlet教程 jdbc组件详解 Java NIO教程 Java语言/版本 研究

优秀的个人博客,低调大师

php防止sql注入漏洞代码 &amp;&amp; 几种常见攻击的正则表达式

注入漏洞代码和分析 先上代码 sql 分析 如果使用这个函数的话,这个函数会绕开PHP的标准出错处理,所以说得自己定义报错处理程序(die())。 其次,如果代码执行前就发生了错误,那个时候用户自定义的程序还没有执行,所以就不会用到用户自己写的报错处理程序。 那么,PHP里有一套错误处理机制,可以使用set_error_handler()接管PHP错误处理,也可以使用trigger_error()函数主动抛出一个错误。 set_error_handler()函数设置用户自定义的错误处理函数。函数用于创建运行期间的用户自己的错误处理方法。它需要先创建一个错误处理函数,然后设置错误级别。 关于的用法: 1 function customError($errno, $errstr, $errfile, $errline) 2 3 { 4 5 echo "<b>错误代码:</b> [${errno}] ${errstr}\r\n"; 6 7 echo " 错误所在的代码行: {$errline} 文件{$errfile}\r\n"; 8 9 echo " PHP版本 ",PHP_VERSION, "(" , PHP_OS, ")\r\n"; 10 11 // die(); 12 13 } 14 15 set_error_handler("customError",E_ALL| E_STRICT); 在这个函数里,可以做任何要做的事情,包括对错误的详情进行格式化输出,记入log文件。 1 function slog($logs) 2 { 3 $toppath="log.htm"; 4 $Ts=fopen($toppath,"a+"); 5 fputs($Ts,$logs."\r\n"); 6 fclose($Ts); 7 } 自定义的错误处理函数一定要有这四个输入变量$errno、$errstr、$errfile、$errline。 errno是一组常量,代表错误的等级,同时也有一组整数和其对应,但一般使用其字符串值表示,这样语义更好一点。比如E_WARNING,其二进制掩码为4,表示警告信息。 接下来,就是将这个函数作为回调参数传递给set_error_handler。这样就能接管PHP原生的错误处理函数了。要注意的是,这种托管方式并不能托管所有种类的错误,如E_ERROR、E_PARSE、E_CORE_ERROR、E_CORE_WARNING、E_COMPILE_ERROR、E_COMPILE_WARNING,以及E_STRICT中的部分。这些错误会以最原始的方式显示,或者不显示。 StopAttack()函数是将传递过来的POST、GET、COOKIE进行正则表达式和调用slog()写入log文件。 几种常见攻击的正则表达式 1 $Exec_Commond = "( \\s|\\S)*(exec(\\s|\\+)+(s|x)p\\w+)(\\s|\\S)*"; 2 $Simple_XSS = "( \\s|\\S)*((%3C)|<)((%2F)|/)*[a-z0-9%]+((%3E)|>)(\\s|\\S)*"; 3 $Eval_XSS = "( \\s|\\S)*((%65)|e)(\\s)*((%76)|v)(\\s)*((%61)|a)(\\s)*((%6C)|l)(\\s|\\S)*"; 4 $Image_XSS = "( \\s|\\S)*((%3C)|<)((%69)|i|I|(%49))((%6D)|m|M|(%4D))((%67)|g|G|(%47))[^\\n]+((%3E)|>)(\\s|\\S)*" ; 5 $Script_XSS = "( \\s|\\S)*((%73)|s)(\\s)*((%63)|c)(\\s)*((%72)|r)(\\s)*((%69)|i)(\\s)*((%70)|p)(\\s)*((%74)|t)(\\s|\\S)*"; 6 $SQL_Injection = "( \\s|\\S)*((%27)|(')|(%3D)|(=)|(/)|(%2F)|(\")|((%22)|(-|%2D){2})|(%23)|(%3B)|(;))+(\\s|\\S)*"; 总结 PHP遇到错误时,就会给出出错脚本的位置、行数和原因,有很多人说,这并没有什么大不了。但泄露了实际路径的后果是不堪设想的,对于某些入侵者,这个信息可是非常重要,而事实上现在有很多的服务器都存在这个问题。 有些网管干脆把PHP配置文件中的 display_errors 设置为 Off 来解决,但本人认为这个方法过于消极。有些时候,我们的确需要PHP返回错误的信息以便调试。而且在出错时也可能需要给用户一个交待,甚至导航到另一页面。但是有了 set_error_handler()之后,这些矛盾也都可以解决掉了。 但是发现很少用这个函数。 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3496855.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册