首页 文章 精选 留言 我的

精选列表

搜索[搭建],共10000篇文章
优秀的个人博客,低调大师

Elasticsearch、Logstash、Kibana搭建统一日志分析平

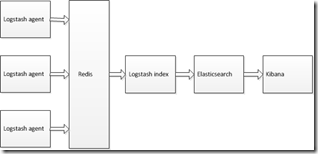
ELKstack是Elasticsearch、Logstash、Kibana三个开源软件的组合。目前都在Elastic.co公司名下。 ELK是一套常用的开源日志监控和分析系统,包括一个分布式索引与搜索服务Elasticsearch, 一个管理日志和事件的工具logstash,和一个数据可视化服务Kibana logstash_1.5.3 负责日志的收集,处理和储存 elasticsearch-1.7.2 负责日志检索和分析 kibana-4.1.2-linux-x64.tar.gz 负责日志的可视化 redis-2.4.14 DB以及日志传输的通道来处理 用一张图来表示他们之间的关系 此文以两个服务器为例来部署 服务器A:192.168.0.1 java elasticsearch redis kibana logstash(agent indexer) 服务器B:192.168.0.2 java logstash(agent) 首先安装服务器A相关软件 一、安装基础软件 yum -y install curl wget lrzsz axel 二、安装配置redis服务 1、安装tcl8.6.1 a) tar -xf tcl8.6.1-src.tar.gz --strip-components=1 b) cd tcl8.6.1/unix c) ./configure --prefix=/usr/local d) make e) make test f) make install g) make install-private-headers h) ln -v -sf tclsh8.6 /usr/bin/tclsh i) chmod -v 755 /usr/lib/libtcl8.6.so(可选,并且如报找不到文件,没关系) 2、安装redis-3.0.2 wget http://download.redis.io/releases/redis-3.0.2.tar.gz tar xzf redis-3.0.2.tar.gz /usr/local/redis cd redis-3.0.2 make MALLOC=libc make test make install 2、配置redis a) mkdir /etc/redis b) mkdir /var/redis c) cp utils/redis_init_script /etc/init.d/redis d) vim /etc/init.d/redis 头部添加: #chkconfig: 345 60 60 #!/bin/bash e) mkdir /var/redis/6379 f) cp redis.conf /etc/redis/6379.conf g) vim /etc/redis/6379.conf #设置daemonize为yes #设置pidfile为/var/run/redis_6379.pid #设置loglevel #设置logfile为/var/log/redis_6379.log #设置dir为/var/redis/6379 h) sysctl vm.overcommit_memory=1 i) chkconfig --add redis j) chkconfig redis on 3、重启服务 service redis start/stop 4、查看进程和端口 1)查看进程 ps -ef |grep redis root 31927 25099 0 18:26 pts/0 00:00:00 vi /etc/init.d/redis 2)查看端口 netstat -tupnl |grep redis tcp 0 0 0.0.0.0:6379 0.0.0.0:* LISTEN 31966/redis-server tcp 0 0 :::6379 :::* LISTEN 31966/redis-server 三、安装java环境 1、安装包 yum -y list java* yum -y install openjdk-7-jdk 2、查看版本 java -version java version "1.7.0_91" OpenJDK Runtime Environment (rhel-2.6.2.2.el6_7-x86_64 u91-b00) OpenJDK 64-Bit Server VM (build 24.91-b01, mixed mode) 四、安装elasticsearch 1、下载elasticsearch wget https://download.elastic.co/elasticsearch/elasticsearch/elasticsearch-1.7.2.noarch.rpm 2、安装elasticsearch rpm -ivh elasticsearch-1.7.2.noarch.rpm 3、配置 1)备份配置 cp /etc/elasticsearch/elasticsearch.yml /etc/elasticsearch/elasticsearch.yml.bak 2)修改配置 echo "network.bind_host: 192.168.0.1" >> /etc/elasticsearch/elasticsearch.yml 4、启动elasticsearch服务 /etc/init.d/elasticsearch start /etc/init.d/elasticsearch stop 5、查看进程和端口 1)查看进程 ps -ef |grep java 2)查看端口 netstat -tupnl |grep java 6、测试 curl -X GET http://192.168.54.147:9200 { "status" : 200, "name" : "Miguel O'Hara", "cluster_name" : "elasticsearch", "version" : { "number" : "1.7.2", "build_hash" : "e43676b1385b8125d647f593f7202acbd816e8ec", "build_timestamp" : "2015-09-14T09:49:53Z", "build_snapshot" : false, "lucene_version" : "4.10.4" }, "tagline" : "You Know, for Search" } 7、添加到开机启动 update-rc.d elasticsearch defaults update-rc.d: using dependency based boot sequencing 五、安装logstash 1、下载logstash wget https://download.elastic.co/logstash/logstash/packages/centos/logstash-1.5.4-1.noarch.rpm 2、安装logstash rpm -ivh logstash-1.5.4-1.noarch.rpm 3、配置(默认没有这个配置文件) vim /etc/logstash/conf.d/logstash_indexer.conf input { redis { host => "192.168.0.1" data_type => "list" key => "logstash:redis" type => "redis-input" port => "6379" } } output { elasticsearch { host => "192.168.0.1" } } 4、启动服务 /etc/init.d/logstash start 5、使用jps -mlv或ps -ef来查看下进程 ps -ef|grep logst 6、设置开机启动 update-rc.d logstash defaults update-rc.d: using dependency based boot sequencing 六、安装kibana(前端web) 1、下载 wget https://download.elastic.co/kibana/kibana/kibana-4.1.2-linux-x64.tar.gz 2、解压到指定目录 tar zxvf kibana-4.1.2-linux-x64.tar.gz -C /opt 3、创建日志目录 mkdir -p /opt/kibanalog 4、配置 1)备份配置 cp /opt/kibana-4.1.2-linux-x64/config/kibana.yml /opt/kibana-4.1.2-linux-x64/config/kibana.yml.bak 2)修改配置 sed -i 's!^elasticsearch_url: .*!elasticsearch_url: "http://192.168.0.1:9200"!g' /opt/kibana-4.1.2-linux-x64/config/kibana.yml sed -i 's!^host: .*!host: "192.168.0.1"!g' /opt/kibana-4.1.2-linux-x64/config/kibana.yml 5、启动服务 cd /opt/kibanalog && nohup /opt/kibana-4.1.2-linux-x64/bin/kibana & 6、查看进程和端口 1)查看进程 ps aux |grep kibana 2)查看端口 netstat -tupnl|grep 5601 7、在windows上访问 http://192.168.0.1:5601 8、设置开机启动 echo "cd /opt/kibanalog && nohup /opt/kibana-4.1.2-linux-x64/bin/kibana &" >> /etc/rc.local 到此服务器A的相关软件全部安装完成; 现在安装日志采集端的程序(服务器B),可以有多个 clientB安装配置logstash(agent) 1、安装java环境 yum -y list java* yum -y install openjdk-7-jdk 1、下载logstash wget https://download.elastic.co/logstash/logstash/packages/centos/logstash-1.5.4-1.noarch.rpm 2、安装logstash rpm -ivh logstash-1.5.4-1.noarch.rpm 3、配置(默认没有这个配置文件) 1)配置logstash_agent vim /etc/logstash/conf.d/logstash_agent.conf input { file { path => "/tmp/*.log" start_position => beginning } } output { redis { host => "192.168.0.1" data_type => "list" key => "logstash:redis" } } 5、启动服务 /etc/init.d/logstash start logstash started. 6、使用jps -mlv或ps -ef来查看下进程 ps -ef|grep logst 7、设置开机启动 update-rc.d logstash defaults update-rc.d: using dependency based boot sequencing 至此服务器B也安装配置完成,根据日志采集端的需要可以配置N个服务B 如何查看日志: 1、查看redis日志 cat /var/log/redis/redis-server.log 2、查看elasticsearch日志 cat /var/log/elasticsearch/elasticsearch.log tail -300f /var/log/elasticsearch/elasticsearch.log 3、查看logstash日志 cat /var/log/logstash/logstash.errtail -30f /var/log/logstash/logstash.err 4、查看kibana日志 cat /opt/kibanalog/nohup.out tail -30f /opt/kibanalog/nohup.out 错误处理 1)unable to fetch mapping, do you have indices matching the pattem? kibana 报这个错误就是因为没有从logstash 过来任何数据一般检查一下数据传输 作者:纯洁的微笑 出处:www.ityouknow.com 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。本文如对您有帮助,还请多帮【推荐】下此文。如果喜欢我的文章,请关注我的公众号 分类: 系统架构 本文转自纯洁的微笑博客博客园博客,原文链接:http://www.cnblogs.com/ityouknow/p/4933103.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

ELK日志服务器的快速搭建并收集nginx日志

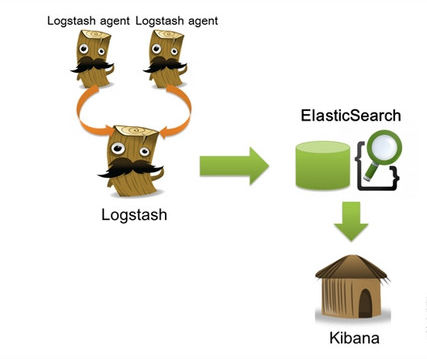
今天给大家带来的是开源实时日志分析 ELK , ELK 由 ElasticSearch 、 Logstash 和 Kiabana 三个开源工具组成。官方网站:https://www.elastic.co 其中的3个软件是: Elasticsearch 是个开源分布式搜索引擎,它的特点有:分布式,零配置,自动发现,索引自动分片,索引副本机制, restful 风格接口,多数据源,自动搜索负载等。 Logstash 是一个完全开源的工具,他可以对你的日志进行收集、分析,并将其存储供以后使用(如,搜索)。 kibana 也是一个开源和免费的工具,他 Kibana 可以为 Logstash 和 ElasticSearch 提供的日志分析友好的 Web 界面,可以帮助您汇总、分析和搜索重要数据日志 系统 系统需要安装的软件 ip 描述 centos6.4 Elasticsearch/test5 192.168.48.133 搜索存储日志 centos6.4 Elasticsearch/test4 192.168.48.131 搜索存储日志 centos6.4 Logstash/nginx/test1 192.168.48.129 用来收集日志给上面 centos6.4 kibana,nginx/test2 192.168.48.130 用来后端的展示 软件下载:链接:链接:http://share.weiyun.com/3b6c27e33cbf4d0acc0ccfa14877bd05 (密码:IWLe) 架构原理图: 一、先安装elasticsearch集群,并测试通过再进行其他软件安装。 在test5,test4上安装分别安装elasticsearch-2.3.3.rpm 前提要安装java1.8 步骤如下: yumremovejava-1.7.0-openjdk rpm-ivhjdk-8u91-linux-x64.rpm yumlocalinstallelasticsearch-2.3.3.rpm 配置elasticsearch 在目录/etc/elasticsearch目录下面 lasticsearch.yml elasticsearch.yml.bak logging.yml scripts 编辑lasticsearch.yml 修改如下配置 cluster.name: myelk #设置集群的名称,在一个集群里面都是这个名称,必须相同 node.name: test5 #设置每一个节点的名,每个节点的名称必须不一样。 path.data: /path/to/data #指定数据的存放位置,线上的机器这个要放到单一的大分区里面。 path.logs: /path/to/logs #日志的目录 bootstrap.mlockall: true #启动最优内存配置,启动就分配了足够的内存,性能会好很多,测试我就不启动了。 network.host: 0.0.0.0 #监听的ip地址,这个表示所有的地址。 http.port: 9200 #监听的端口号 discovery.zen.ping.unicast.hosts: ["192.168.48.133", "192.168.48.131"] #知道集群的ip有那些,没有集群就会出现就一台工作 建立目录 mkdir-pv/pach/to/{data,logs} chownelasticsearch.elasticsearch/path-R 启动服务器 service elasticsearch start 并查看监控端口启动 访问9200端口查看服务 两台的配置都一样就是上面的IP和note名称要配置不一样就行 安装插件 head和kopf 之后访问ip:9200/_plugin/head 和ip:9200/_plugin/kopf (插件可以图形查看elasticsearch的状态和删除创建索引) /usr/share/elasticsearch/bin/plugininstalllmenezes/elasticsearch-kopf /usr/share/elasticsearch/bin/plugininstallmobz/elasticsearch-head 二、安装nginx和logstash软件 在test1上安装好nginx服务 就是收集它的日志呢 yum-yinstallzlibzlib-developensslopenssl--develpcrepcre-devel ./configure--prefix=/usr/local/nginx--with-pcre--with-openssl=--with-zlib= make&&makeinstall 日志在/usr/local/nginx/logs/access.log 然后在test1上安装logstash-2.3.3-1.noarch.rpm yumremovejava-1.7.0-openjdk rpm-ivhjdk-8u91-linux-x64.rpm rpm-ivhlogstash-2.3.3-1.noarch.rpm /etc/init.d/logstashstart#启动服务 /opt/logstash/bin/logstash-e"input{stdin{}}output{stdout{codec=>"rubydebug"}}"#检测环境执行这个命令检测环境正常否,启动完成后直接输入东西就会出现 之后输入/opt/logstash/bin/logstash -e 'input {stdin{}} output{ elasticsearch { hosts => ["192.168.48.131:9200"] index => "test"}}' 就是输入东西到48.131的elasticsearch上 会在/path/to/data/myelk/nodes/0/indices 生成你名称test索引文件目录 可以多输入几个到48.131的目录看看有没有文件有就证明正常。 之后在/etc/logstash/conf.d 建立以.conf结尾的配置文件,我收集nginx就叫nginx.conf了内容如下; ########################################################################################### input { file { type => "accesslog" path => "/usr/local/nginx/logs/access.log" #日志的位置 start_position => "beginning" #日志收集文件,默认end } } output { if [type] == "accesslog" { elasticsearch { hosts => ["192.168.0.87"] ###elasticearch的地址 index => "nginx-access-%{+YYYY.MM.dd}" #生成的索引和刚才的test一样会在那里生成后面的是日期变量。 } } } ########################################################################################## 一定要仔细,之后运行/etc/init.d/logstash configtest检测配置是否正常。 查看进程是否启动 之后在elasticearch查看有没有索引生成。多访问下nginx服务 如果没有就修改这个文件 vi /etc/init.d/logstash ###################################################################################################### LS_USER=root ###把这里换成root或者把访问的日志加个权限可以让logstash可以读取它 重启服务就会生成索引了 LS_GROUP=root LS_HOME=/var/lib/logstash LS_HEAP_SIZE="1g" LS_LOG_DIR=/var/log/logstash LS_LOG_FILE="${LS_LOG_DIR}/$name.log" LS_CONF_DIR=/etc/logstash/conf.d LS_OPEN_FILES=16384 LS_NICE=19 KILL_ON_STOP_TIMEOUT=${KILL_ON_STOP_TIMEOUT-0} #default value is zero to this variable but could be updated by user request LS_OPTS="" ####################################################################################################### 看logstash的日志有下面的信息就成功了 三、安装kibana软件 上面的都安装完成后在test2上面安装kibana rpm-ivhkibana-4.5.1-1.x86_64.rpm 编辑配置文件在这里/opt/kibana/config/kibana.yml 就修改下面几项就行 ####################################################################################################### server.port: 5601 端口 server.host: "0.0.0.0" 监听 elasticsearch.url: "http://192.168.48.131:9200"elasticsearch地址 ###################################################################################################### /etc/init.d/kibana start 启动服务 访问kibana http://ip:5601 添加展示的索引,就是在上面定义的 nginx-access-2016.07.03 四、其他的一些配置。 kibana是直接访问的比较不安全,我们需要用nginx访问代理,并设置权限用户名和密码访问 先在kibana服务器上安装nginx 不介绍了 在nginx里面配置 ################################################################################# server { listen 80; server_name localhost; auth_basic "Restricted Access"; auth_basic_user_file /usr/local/nginx/conf/htpasswd.users; #密码和用户 location / { proxy_pass http://localhost:5601; #代理kibana的5601之后就可以直接80访问了 proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header REMOTE-HOST $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; } } #################################################################################### 创建密码和用户文件:htpasswd.users 需要安装httpd-tool包先安装它 htpasswd -bc /usr/local/nginx/conf/htpasswd.users admin paswdadmin #前面是用户后面是密码 ################################################################################## 之后通过访问需要密码和用户并且是80端口了 到这里就完成了,谢谢你的阅读。

优秀的个人博客,低调大师

kvm虚拟化学习笔记(十九)之convirt集中管理平台搭建

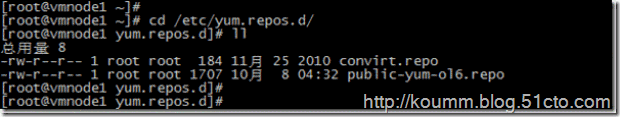
原创作品,允许转载,转载时请务必以超链接形式标明文章 原始出处、作者信息和本声明。否则将追究法律责任。 http://koumm.blog.51cto.com/703525/1305553 kvm虚拟化学习笔记(二十)之convirt安装linux系统 http://koumm.blog.51cto.com/703525/1306526 情况说明: (1)本文采用OEL6.3x64操作系统,需要有KVM安装环境。(2)convirt2.1.1采用源码方式安装,convirt环境分别两部分,一部分是cms,用于管理kvm/xen虚拟主机上的虚拟机,一部分做为客户端安装到kvm/xen虚拟主机上。(3)convirt2.1.1是开源的管理xen/kvm虚拟化管理工具,是众多开源工具中的一种。 1.安装convirt环境 (1)安装KVM环境 kvm虚拟化学习笔记(一)之kvm虚拟化环境安装:http://koumm.blog.51cto.com/703525/1288795 (2)准备convirt安装源 1 2 # cd /etc/yum.repos.d # wget --no-cache http: //www.convirture.com/repos/definitions/rhel/6.x/convirt.repo (3)下载convirt与cms安装包 1 2 3 # cd /root/ # wget --no-cache http: //www.convirture.com/downloads/convirt/2.1.1/convirt-2.1.1.tar.gz # wget --no-cache http: //www.convirture.com/downloads/convirt/2.1.1/convirt-install-2.1.1.tar.gz (4)安装convirt安装包 1 2 # tar -xzvf convirt-install- 2.1 . 1 .tar.gz # cd convirt-install/install/cms/scripts/ && ./install_dependencies 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 … 初始化 MySQL 数据库: Installing MySQL system tables... OK Filling help tables... OK To start mysqld at boot time you have to copy support-files/mysql.server to the right place for your system PLEASE REMEMBER TO SET A PASSWORD FOR THE MySQL root USER ! To do so, start the server, then issue the following commands: /usr/bin/mysqladmin -u root password 'new-password' /usr/bin/mysqladmin -u root -h vmnode1 password 'new-password' Alternatively you can run: /usr/bin/mysql_secure_installation which will also give you the option of removing the test databases and anonymous user created by default . This is strongly recommended for production servers. See the manual for more instructions. You can start the MySQL daemon with : cd /usr ; /usr/bin/mysqld_safe & You can test the MySQL daemon with mysql-test-run.pl cd /usr/mysql-test ; perl mysql-test-run.pl Please report any problems with the /usr/bin/mysqlbug script! [确定] 正在启动 mysqld: [确定] Running mysql_secure_installation. Current root password for fresh installation is blank. So simple press enter. NOTE: RUNNING ALL PARTS OF THIS SCRIPT IS RECOMMENDED FOR ALL MySQL SERVERS IN PRODUCTION USE! PLEASE READ EACH STEP CAREFULLY! In order to log into MySQL to secure it, we'll need the current password for the root user. If you've just installed MySQL, and you haven't set the root password yet, the password will be blank, so you should just press enter here. Enter current password for root (enter for none): OK, successfully used password, moving on... Setting the root password ensures that nobody can log into the MySQL root user without the proper authorisation. Set root password? [Y/n] y New password: Re-enter new password: Password updated successfully! Reloading privilege tables.. ... Success! By default , a MySQL installation has an anonymous user, allowing anyone to log into MySQL without having to have a user account created for them. This is intended only for testing, and to make the installation go a bit smoother. You should remove them before moving into a production environment. Remove anonymous users? [Y/n] y ... Success! Normally, root should only be allowed to connect from 'localhost' . This ensures that someone cannot guess at the root password from the network. Disallow root login remotely? [Y/n] y ... Success! By default , MySQL comes with a database named 'test' that anyone can access. This is also intended only for testing, and should be removed before moving into a production environment. Remove test database and access to it? [Y/n] y - Dropping test database... ... Success! - Removing privileges on test database... ... Success! Reloading the privilege tables will ensure that all changes made so far will take effect immediately. Reload privilege tables now? [Y/n] y ... Success! Cleaning up... All done! If you've completed all of the above steps, your MySQL installation should now be secure. Thanks for using MySQL! mysqld (pid 2691 ) 正在运行... MySQL service is already running. Prerequsite for ConVirt Management Server (CMS) installed. 说明:安装过程会安装mysql数据库,并输入mysql数据库root帐号密码。 (5)修改mysql数据库配置文件 (6)解压CMS软件包并安装 1 2 3 4 5 # cd /root/ # cd convirt-install/install/cms/scripts/ && source install_config # cd /root && tar -xzf convirt- 2.1 . 1 .tar.gz -C $CONVIRT_BASE # ./setup_tg2 # ./setup_convirt 安装过程略… (7)启动与关闭convirtCMS 启动convirt 关闭convirt 1 # /root/convirt/convirt-ctl stop (8)打开convirt2.1.1 http://192.168.233.170:8081 输入admin/admin 还需要在kvm虚拟主机上安装convirt-tools工具之后才能添加。 2.在KVM虚拟主机上安装convirt-tools工具 注:在kvm虚拟主机上安装convirt-tools工具。 1 2 3 4 5 # wget http: //www.convirture.com/downloads/convirture-tools/2.1.1/convirture-tools-2.1.1.tar.gz # tar zxvf convirture-tools- 2.1 . 1 .tar.gz # cd convirture-tools/install/managed_server/scripts # ./convirt-tool install_dependencies # ./convirt-tool setup 3.在convirtcms上添加KVM虚拟主机 添加KVM虚拟主机。 本文出自 “koumm的linux技术博客” 博客,请务必保留此出处http://koumm.blog.51cto.com/703525/1305553

优秀的个人博客,低调大师

容器服务之快速搭建使用阿里云rds的wordpress网站

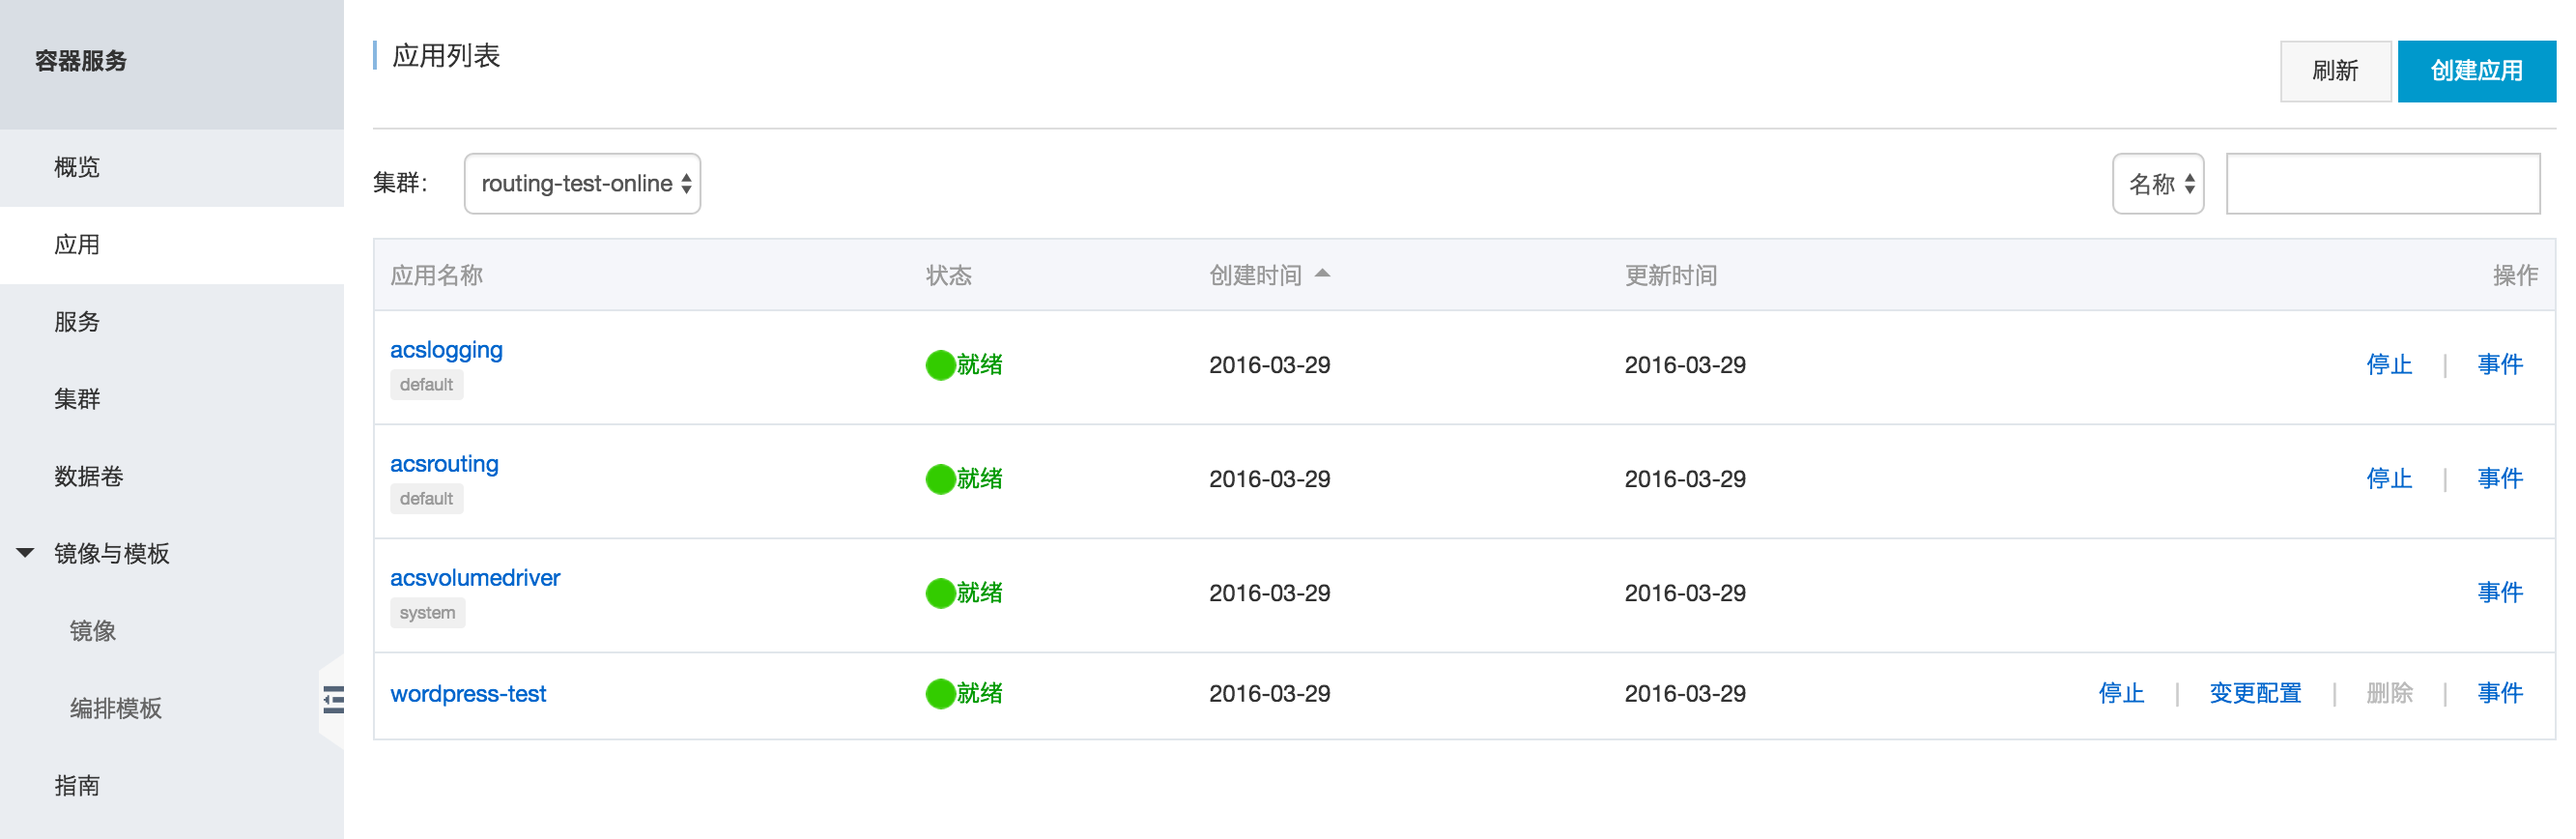
登录容器服务控制台,创建好集群,如果用户已有ECS机器,可以创建0节点的集群,然后将已有机器加入集群。 登录容器服务控制台,选择侧边栏的应用,在下拉框选择相应的集群,选择创建应用 填写应用名称,本例为wordpress-rds, 选择使用编排模板创建 在编辑框中输入以下编排模板请注意将WORDPRESS_DB_USER修改为您数据库用户名,将WORDPRESS_DB_PASSWORD修改为您数据库的密码,将WORDPRESS_DB_NAME修改为您数据库的名称,同时将db服务下面的host修改为您要连接的数据库的域名,将ports修改为您要连接的数据库的端口。 web: image: wordpress ports: - '80' restart: always li

优秀的个人博客,低调大师

使用Eclipse开发及测试Spark的环境搭建及简单测试

一、下载专门开发的Scala的Eclipse 1、下载地址:http://scala-ide.org/download/sdk.html,或链接:http://pan.baidu.com/s/1hrexmx2 密码:x0za 2、打开后新建一个名为WordCount的工程(这个应该都知道吧File-->New-->Scala Project),会发现有个Scala Library container[2.11.7],因为这个不是我们需要的版本,需要改一下;即右击WordCount-->Properties-->Scala Compile-->Use Project Settings-->Scala Installation,选择第二个,即Latest 2.10 bundle (dynamic),然后点击OK PS:如果你的scala版本是2.11.x,则可以忽略这步。 3、右击WordCount-->Build Path-->Configure Build Path-->Libraries-->Add External JARs...选择你解压的spark-assembly-1.0.0-hadoop1.0.4.jar,然后点击OK 下载地址:http://spark.apache.org/downloads.html,或链接:http://pan.baidu.com/s/1eRpWIdG 密码:ue3l,下载后解压即可。 4、此时所有的包依赖都导入成功,然后新建一个Scala类,即可开发Spark。 二、具体开发程序 下面给出史上最详细的程序: 1、如果想要在本地上搞Spark的话: 1 package com.df.spark 2 import org.apache.spark.SparkConf 3 import org.apache.spark.SparkContext 4 import org.apache.spark.SparkContext._ 5 import org.apache.spark.rdd.RDD 6 /** 7 * 使用Scala开发集群运行的Spark WordCount程序 8 * @author liuzhongfeng 9 */ 10 object WordCount_Cluster { 11 def main(args: Array[String]){ 12 /** 13 * 第一步:创建Spark的配置对象SparkConf,设置Spark程序的运行时的配置信息 14 * 例如说通过setMaster来设置程序要链接的Spark集群的Master的URL,如果设置为local, 15 * 则代表Spark程序在本地运行,特别适合机器配置条件差的初学者。 16 */ 17 val conf=new SparkConf()//创建SparkConf对象 18 conf.setAppName("My First Spark App!")//设置应用程序的名称,在程序运行的监控界面可以看到名称 19 conf.setMaster("spark://cMaster-spark:7077")//程序此时运行在Spark集群 20 21 /** 22 * 第二步:创建SparkContext对象, 23 * SparkContext是Spark程序所有功能的唯一入口,无论是采用Scala、Java、Python、R等都必须有一个SparkContext 24 * SparkContext的核心作用:初始化Spark应用程序运行所需要的核心组件,包括DAGScheduler、TaskScheduler、SchedulerBacken 25 * 同时还会负责Spark程序往Master注册程序等 26 * SparkContext是整个Spark应用程序中至关重要的一个对象 27 */ 28 val sc=new SparkContext(conf)//通过创建SparkContext对象,通过传入SparkConf实例来定制Spark运行的具体参数和配置信息 29 30 /** 31 * 第三步:根据具体的数据来源(HDFS、HBase、Local FS、S3)通过SparkContext来创建RDD 32 * RDD的创建基本有三种方式:根据外部的数据来源(例如HDFS)、根据Scala集合、由其他的RDD操作 33 * 数据会被RDD划分称为一些列的Partitions,分配到每个Partition的数据属于一个Task的处理范畴 34 */ 35 // val lines: RDD[String]=sc.textFile("H://下载//linux软件包//linux-spark的文件//spark//spark-1.0.0-bin-hadoop1//README.md", 1) 36 //读取本地文件并设置为一个Partition 37 //val lines=sc.textFile("H://下载//linux软件包//linux-spark的文件//spark//spark-1.0.0-bin-hadoop1//README.md", 1) 38 val lines=sc.textFile("/in", 1) 39 /** 40 * 第四步:对初始的RDD进行Transformation级别的处理,例如map、filter等高阶函数的编程,来进行具体的数据计算 41 * 第4.1步:将每一行的字符串拆分成单个的单词 42 */ 43 val words=lines.flatMap { line => line.split(" ")}//对每一行的字符串进行单词切分,并把所有行的切分结果通过flat合并成一个大的单词集合 44 /** 45 * 第四步:对初始的RDD进行Transformation级别的处理,例如map、filter等高阶函数的编程,来进行具体的数据计算 46 * 第4.2步:在单词切分的基础上,对每个单词实例的计数为1,也就是word=>(word,1) 47 */ 48 val pairs=words.map { word => (word,1) } 49 /** 50 * 第四步:对初始的RDD进行Transformation级别的处理,例如map、filter等高阶函数的编程,来进行具体的数据计算 51 * 第4.3步:在每个单词实例计数为1的基础之上统计每个单词在文件中出现的总次数 52 */ 53 val wordCounts=pairs.reduceByKey(_+_)//对相同的Key,进行Value的累计(包括Local和Reducer级别同时Reduce) 54 wordCounts.collect.foreach(wordNumberPair=>println(wordNumberPair._1+" : "+wordNumberPair._2)) 55 sc.stop() 56 } 57 } View Code 通过点击右键,选择Run As-->Scala Application,然后出现运行结果: 16/01/27 16:55:27 INFO SecurityManager: Using Spark's default log4j profile: org/apache/spark/log4j-defaults.properties 16/01/27 16:55:27 INFO SecurityManager: Changing view acls to: liuzhongfeng 16/01/27 16:55:27 INFO SecurityManager: SecurityManager: authentication disabled; ui acls disabled; users with view permissions: Set(liuzhongfeng) 16/01/27 16:55:28 INFO Slf4jLogger: Slf4jLogger started 16/01/27 16:55:28 INFO Remoting: Starting remoting 16/01/27 16:55:28 INFO Remoting: Remoting started; listening on addresses :[akka.tcp://spark@Frank:38059] 16/01/27 16:55:28 INFO Remoting: Remoting now listens on addresses: [akka.tcp://spark@Frank:38059] 16/01/27 16:55:28 INFO SparkEnv: Registering MapOutputTracker 16/01/27 16:55:28 INFO SparkEnv: Registering BlockManagerMaster 16/01/27 16:55:28 INFO DiskBlockManager: Created local directory at C:\Users\LIUZHO~1\AppData\Local\Temp\spark-local-20160127165528-81e4 16/01/27 16:55:28 INFO MemoryStore: MemoryStore started with capacity 1068.9 MB. 16/01/27 16:55:28 INFO ConnectionManager: Bound socket to port 38062 with id = ConnectionManagerId(Frank,38062) 16/01/27 16:55:28 INFO BlockManagerMaster: Trying to register BlockManager 16/01/27 16:55:28 INFO BlockManagerInfo: Registering block manager Frank:38062 with 1068.9 MB RAM 16/01/27 16:55:28 INFO BlockManagerMaster: Registered BlockManager 16/01/27 16:55:28 INFO HttpServer: Starting HTTP Server 16/01/27 16:55:28 INFO HttpBroadcast: Broadcast server started at http://192.168.1.107:38063 16/01/27 16:55:28 INFO HttpFileServer: HTTP File server directory is C:\Users\LIUZHO~1\AppData\Local\Temp\spark-59ecde39-31f6-4f84-ac49-e86194415dec 16/01/27 16:55:28 INFO HttpServer: Starting HTTP Server 16/01/27 16:55:28 INFO SparkUI: Started SparkUI at http://Frank:4040 16/01/27 16:55:29 INFO MemoryStore: ensureFreeSpace(32816) called with curMem=0, maxMem=1120822886 16/01/27 16:55:29 INFO MemoryStore: Block broadcast_0 stored as values to memory (estimated size 32.0 KB, free 1068.9 MB) 16/01/27 16:55:29 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable 16/01/27 16:55:29 WARN LoadSnappy: Snappy native library not loaded 16/01/27 16:55:29 INFO FileInputFormat: Total input paths to process : 1 16/01/27 16:55:29 INFO SparkContext: Starting job: foreach at WordCount.scala:53 16/01/27 16:55:29 INFO DAGScheduler: Registering RDD 4 (reduceByKey at WordCount.scala:52) 16/01/27 16:55:29 INFO DAGScheduler: Got job 0 (foreach at WordCount.scala:53) with 1 output partitions (allowLocal=false) 16/01/27 16:55:29 INFO DAGScheduler: Final stage: Stage 0(foreach at WordCount.scala:53) 16/01/27 16:55:29 INFO DAGScheduler: Parents of final stage: List(Stage 1) 16/01/27 16:55:29 INFO DAGScheduler: Missing parents: List(Stage 1) 16/01/27 16:55:29 INFO DAGScheduler: Submitting Stage 1 (MapPartitionsRDD[4] at reduceByKey at WordCount.scala:52), which has no missing parents 16/01/27 16:55:29 INFO DAGScheduler: Submitting 1 missing tasks from Stage 1 (MapPartitionsRDD[4] at reduceByKey at WordCount.scala:52) 16/01/27 16:55:29 INFO TaskSchedulerImpl: Adding task set 1.0 with 1 tasks 16/01/27 16:55:29 INFO TaskSetManager: Starting task 1.0:0 as TID 0 on executor localhost: localhost (PROCESS_LOCAL) 16/01/27 16:55:29 INFO TaskSetManager: Serialized task 1.0:0 as 2172 bytes in 2 ms 16/01/27 16:55:29 INFO Executor: Running task ID 0 16/01/27 16:55:29 INFO BlockManager: Found block broadcast_0 locally 16/01/27 16:55:29 INFO HadoopRDD: Input split: file:/H:/下载/linux软件包/linux-spark的文件/spark/spark-1.0.0-bin-hadoop1/README.md:0+4221 16/01/27 16:55:29 INFO Executor: Serialized size of result for 0 is 775 16/01/27 16:55:29 INFO Executor: Sending result for 0 directly to driver 16/01/27 16:55:29 INFO Executor: Finished task ID 0 16/01/27 16:55:29 INFO TaskSetManager: Finished TID 0 in 231 ms on localhost (progress: 1/1) 16/01/27 16:55:29 INFO DAGScheduler: Completed ShuffleMapTask(1, 0) 16/01/27 16:55:29 INFO TaskSchedulerImpl: Removed TaskSet 1.0, whose tasks have all completed, from pool 16/01/27 16:55:29 INFO DAGScheduler: Stage 1 (reduceByKey at WordCount.scala:52) finished in 0.240 s 16/01/27 16:55:29 INFO DAGScheduler: looking for newly runnable stages 16/01/27 16:55:29 INFO DAGScheduler: running: Set() 16/01/27 16:55:29 INFO DAGScheduler: waiting: Set(Stage 0) 16/01/27 16:55:29 INFO DAGScheduler: failed: Set() 16/01/27 16:55:29 INFO DAGScheduler: Missing parents for Stage 0: List() 16/01/27 16:55:29 INFO DAGScheduler: Submitting Stage 0 (MapPartitionsRDD[6] at reduceByKey at WordCount.scala:52), which is now runnable 16/01/27 16:55:29 INFO DAGScheduler: Submitting 1 missing tasks from Stage 0 (MapPartitionsRDD[6] at reduceByKey at WordCount.scala:52) 16/01/27 16:55:29 INFO TaskSchedulerImpl: Adding task set 0.0 with 1 tasks 16/01/27 16:55:29 INFO TaskSetManager: Starting task 0.0:0 as TID 1 on executor localhost: localhost (PROCESS_LOCAL) 16/01/27 16:55:29 INFO TaskSetManager: Serialized task 0.0:0 as 2003 bytes in 1 ms 16/01/27 16:55:29 INFO Executor: Running task ID 1 16/01/27 16:55:29 INFO BlockManager: Found block broadcast_0 locally 16/01/27 16:55:29 INFO BlockFetcherIterator$BasicBlockFetcherIterator: maxBytesInFlight: 50331648, targetRequestSize: 10066329 16/01/27 16:55:29 INFO BlockFetcherIterator$BasicBlockFetcherIterator: Getting 1 non-empty blocks out of 1 blocks 16/01/27 16:55:29 INFO BlockFetcherIterator$BasicBlockFetcherIterator: Started 0 remote fetches in 6 ms For : 5 Programs : 1 gladly : 1 Because : 1 The : 1 agree : 1 cluster. : 1 webpage : 1 its : 1 under : 2 legal : 1 1.x, : 1 have : 2 Try : 1 MRv1, : 1 add : 2 through : 1 several : 1 This : 2 Whether : 1 "yarn-cluster" : 1 % : 2 storage : 1 To : 2 setting : 1 any : 2 Once : 1 application : 1 explicitly, : 1 use: : 1 prefer : 1 SparkPi : 2 version : 3 file : 1 documentation, : 1 Along : 1 the : 28 entry : 1 author. : 1 are : 2 systems. : 1 params : 1 not : 2 different : 1 refer : 1 Interactive : 2 given. : 1 if : 5 file's : 1 build : 3 when : 2 be : 2 Tests : 1 Apache : 6 ./bin/run-example : 2 programs, : 1 including : 1 <http://spark.apache.org/documentation.html>. : 1 Spark. : 2 2.0.5-alpha : 1 package. : 1 1000).count() : 1 project's : 3 Versions : 1 HDFS : 1 license : 3 email, : 1 <artifactId>hadoop-client</artifactId> : 1 >>> : 1 "org.apache.hadoop" : 1 <version>1.2.1</version> : 1 programming : 1 Testing : 1 run: : 1 environment : 2 pull : 3 1000: : 2 v2 : 1 <groupId>org.apache.hadoop</groupId> : 1 Please : 1 is : 6 run : 7 URL, : 1 SPARK_HADOOP_VERSION=2.2.0 : 1 threads. : 1 same : 1 MASTER=spark://host:7077 : 1 on : 4 built : 2 against : 1 tests : 1 examples : 2 at : 1 usage : 1 using : 3 Maven, : 1 talk : 1 submitting : 1 Shell : 2 class : 2 adding : 1 abbreviated : 1 directory. : 1 README : 1 overview : 1 dependencies. : 1 `examples` : 2 example: : 1 ## : 9 N : 1 set : 2 use : 3 Hadoop-supported : 1 running : 1 find : 1 via : 2 contains : 1 project : 3 SPARK_HADOOP_VERSION=2.0.5-alpha : 1 Pi : 1 need : 1 request, : 1 or : 5 </dependency> : 1 <class> : 1 uses : 1 "hadoop-client" : 2 Hadoop, : 1 (You : 1 requires : 1 Contributions : 1 SPARK_HADOOP_VERSION=1.2.1 : 1 Documentation : 1 of : 3 cluster : 1 using: : 1 accepted : 1 must : 1 "1.2.1" : 1 1.2.1 : 2 built, : 1 Hadoop : 11 means : 1 Spark : 12 this : 4 Python : 2 original : 2 YARN, : 3 2.1.X, : 1 pre-built : 1 [Configuration : 1 locally. : 1 ./bin/pyspark : 1 A : 1 locally : 2 # : 6 sc.parallelize(1 : 1 only : 1 library : 1 Configuration : 1 basic : 1 MapReduce : 2 documentation : 1 first : 1 which : 2 following : 2 changed : 1 also : 4 Cloudera : 4 without : 1 should : 2 for : 1 "yarn-client" : 1 [params]`. : 1 `SPARK_YARN=true`: : 1 setup : 1 mesos:// : 1 <http://spark.apache.org/> : 1 GitHub : 1 requests : 1 latest : 1 your : 6 test : 1 MASTER : 1 example : 3 authority : 1 SPARK_YARN=true : 3 scala> : 1 guide](http://spark.apache.org/docs/latest/configuration.html) : 1 configure : 1 artifact : 1 can : 7 About : 1 you're : 1 instructions. : 1 do : 3 2.0.X, : 1 easiest : 1 no : 1 When : 1 how : 1 newer : 1 `./bin/run-example : 1 source : 2 copyrighted : 1 material : 2 Note : 1 2.10. : 1 by : 3 please : 1 Lightning-Fast : 1 spark:// : 1 so. : 1 Scala : 3 Alternatively, : 1 If : 1 Cluster : 1 variable : 1 submit : 1 an : 2 thread, : 1 them, : 1 2.2.X : 1 And : 1 application, : 1 return : 2 developing : 1 ./bin/spark-shell : 1 `<dependencies>` : 1 warrant : 1 "local" : 1 start : 1 You : 4 <dependency> : 1 Spark](#building-spark). : 1 one : 2 help : 1 with : 8 print : 1 CDH : 4 2.2.X, : 1 $ : 5 SPARK_HADOOP_VERSION=2.0.0-mr1-cdh4.2.0 : 1 in : 4 Contributing : 1 downloaded : 1 versions : 4 online : 1 `libraryDependencies`: : 1 - : 1 section: : 1 4.2.0 : 2 comes : 1 [building : 1 Python, : 1 0.23.x, : 1 `SPARK_HADOOP_VERSION` : 1 Many : 1 other : 4 Running : 1 sbt/sbt : 5 building : 1 way : 1 SBT, : 1 Online : 1 change : 1 MRv2, : 1 contribution : 1 from : 1 Example : 1 POM : 1 open : 2 sc.parallelize(range(1000)).count() : 1 you : 8 runs. : 1 Building : 1 protocols : 1 that : 4 a : 5 their : 1 guide, : 1 name : 1 example, : 1 state : 2 work : 2 will : 1 instance: : 1 to : 19 v1 : 1 core : 1 : 149 license. : 1 "local[N]" : 1 programs : 2 package.) : 1 shell: : 2 ./sbt/sbt : 2 assembly : 6 specify : 1 and : 9 Computing : 1 command, : 2 SPARK_HADOOP_VERSION=2.0.0-cdh4.2.0 : 1 sample : 1 requests, : 1 16/01/27 16:55:29 INFO Executor: Serialized size of result for 1 is 825 16/01/27 16:55:29 INFO Executor: Sending result for 1 directly to driver 16/01/27 16:55:29 INFO Executor: Finished task ID 1 16/01/27 16:55:29 INFO DAGScheduler: Completed ResultTask(0, 0) 16/01/27 16:55:29 INFO DAGScheduler: Stage 0 (foreach at WordCount.scala:53) finished in 0.126 s 16/01/27 16:55:29 INFO TaskSetManager: Finished TID 1 in 123 ms on localhost (progress: 1/1) 16/01/27 16:55:29 INFO TaskSchedulerImpl: Removed TaskSet 0.0, whose tasks have all completed, from pool 16/01/27 16:55:29 INFO SparkContext: Job finished: foreach at WordCount.scala:53, took 0.521885349 s 16/01/27 16:55:29 INFO SparkUI: Stopped Spark web UI at http://Frank:4040 16/01/27 16:55:29 INFO DAGScheduler: Stopping DAGScheduler 16/01/27 16:55:31 INFO MapOutputTrackerMasterActor: MapOutputTrackerActor stopped! 16/01/27 16:55:31 INFO ConnectionManager: Selector thread was interrupted! 16/01/27 16:55:31 INFO ConnectionManager: ConnectionManager stopped 16/01/27 16:55:31 INFO MemoryStore: MemoryStore cleared 16/01/27 16:55:31 INFO BlockManager: BlockManager stopped 16/01/27 16:55:31 INFO BlockManagerMasterActor: Stopping BlockManagerMaster 16/01/27 16:55:31 INFO BlockManagerMaster: BlockManagerMaster stopped 16/01/27 16:55:31 INFO SparkContext: Successfully stopped SparkContext 16/01/27 16:55:31 INFO RemoteActorRefProvider$RemotingTerminator: Shutting down remote daemon. 16/01/27 16:55:31 INFO RemoteActorRefProvider$RemotingTerminator: Remote daemon shut down; proceeding with flushing remote transports. View Code 2、如果想要在集群上搞Spark的话: 1 package com.df.spark 2 import org.apache.spark.SparkConf 3 import org.apache.spark.SparkContext 4 import org.apache.spark.SparkContext._ 5 import org.apache.spark.rdd.RDD 6 /** 7 * 使用Scala开发集群运行的Spark WordCount程序 8 * @author liuzhongfeng 9 */ 10 object WordCount_Cluster { 11 def main(args: Array[String]){ 12 /** 13 * 第一步:创建Spark的配置对象SparkConf,设置Spark程序的运行时的配置信息 14 * 例如说通过setMaster来设置程序要链接的Spark集群的Master的URL,如果设置为local, 15 * 则代表Spark程序在本地运行,特别适合机器配置条件差的初学者。 16 */ 17 val conf=new SparkConf()//创建SparkConf对象 18 conf.setAppName("My First Spark App!")//设置应用程序的名称,在程序运行的监控界面可以看到名称 19 conf.setMaster("spark://cMaster-spark:7077")//程序此时运行在Spark集群 20 21 /** 22 * 第二步:创建SparkContext对象, 23 * SparkContext是Spark程序所有功能的唯一入口,无论是采用Scala、Java、Python、R等都必须有一个SparkContext 24 * SparkContext的核心作用:初始化Spark应用程序运行所需要的核心组件,包括DAGScheduler、TaskScheduler、SchedulerBacken 25 * 同时还会负责Spark程序往Master注册程序等 26 * SparkContext是整个Spark应用程序中至关重要的一个对象 27 */ 28 val sc=new SparkContext(conf)//通过创建SparkContext对象,通过传入SparkConf实例来定制Spark运行的具体参数和配置信息 29 30 /** 31 * 第三步:根据具体的数据来源(HDFS、HBase、Local FS、S3)通过SparkContext来创建RDD 32 * RDD的创建基本有三种方式:根据外部的数据来源(例如HDFS)、根据Scala集合、由其他的RDD操作 33 * 数据会被RDD划分称为一些列的Partitions,分配到每个Partition的数据属于一个Task的处理范畴 34 */ 35 36 val lines=sc.textFile("/in", 1)//导入你的hdfs上的文件 37 /** 38 * 第四步:对初始的RDD进行Transformation级别的处理,例如map、filter等高阶函数的编程,来进行具体的数据计算 39 * 第4.1步:将每一行的字符串拆分成单个的单词 40 */ 41 val words=lines.flatMap { line => line.split(" ")}//对每一行的字符串进行单词切分,并把所有行的切分结果通过flat合并成一个大的单词集合 42 /** 43 * 第四步:对初始的RDD进行Transformation级别的处理,例如map、filter等高阶函数的编程,来进行具体的数据计算 44 * 第4.2步:在单词切分的基础上,对每个单词实例的计数为1,也就是word=>(word,1) 45 */ 46 val pairs=words.map { word => (word,1) } 47 /** 48 * 第四步:对初始的RDD进行Transformation级别的处理,例如map、filter等高阶函数的编程,来进行具体的数据计算 49 * 第4.3步:在每个单词实例计数为1的基础之上统计每个单词在文件中出现的总次数 50 */ 51 val wordCounts=pairs.reduceByKey(_+_)//对相同的Key,进行Value的累计(包括Local和Reducer级别同时Reduce) 52 wordCounts.collect.foreach(wordNumberPair=>println(wordNumberPair._1+" : "+wordNumberPair._2)) 53 sc.stop() 54 } 55 } View Code (1)将你的程序打包到你的linux,运行Spark集群。具体的打包过程为:右键你需要打包的文件名如:WordCount.scala,然后-->Export-->Java-->JAR file,选择想要导出的路径,点击OK! (2)然后导出的包复制到你的linux系统上,我的目录为 然后打开你的hadoop集群和spark集群,用jps查看一下。 然后执行命令: 此时运行成功!当神已无能为力,那便是魔渡众生

优秀的个人博客,低调大师

docker 中 NGINX+PHP+MYSQL+REDIS+Elasticsearch 环境搭建 (windows系统)

windows 下 boot2docker fox.风来了 1.boot2docker 先安装这个: Docker虽然是Linux内核,但是官方还是支持了Windows和OS X。Boot2Docker官方下载地址:https://github.com/boot2docker/windows-installer/releasesBoot2Docker官方安装手顺:http://docs.docker.com/installation/windows/ 启动方法 windows 桌面 打开Boot2Docker Start 这个快捷方式,出现的命令界面中执行 2.启动不成功 #先关闭 boot2docker stop #然后启动 boot2docker start 如果出现以下错误 Writing /Users/mylxsw/.boot2docker/certs/boot2docker-vm/ca.pem Writing /Users/mylxsw/.boot2docker/certs/boot2docker-vm/cert.pem Writing /Users/mylxsw/.boot2docker/certs/boot2docker-vm/key.pem export DOCKER_HOST=tcp://192.168.59.103:2376 export DOCKER_CERT_PATH=/Users/mylxsw/.boot2docker/certs/boot2docker-vm export DOCKER_TLS_VERIFY=1解决方法: 设置三个变量 可以手动 到WINDOWS里面设置也可以,用以下命令设置 eval "$(boot2docker shellinit)" #命令查看状态 bash-4.3$ boot2docker status running #命令查看版本 bash-4.3$ boot2docker version Boot2Docker-cli version: v1.8.0 Git commit: 9a26066 bash-4.3$ 3.进入docker boot2docker ssh 4.文件夹项目 windows boot2docker 默认共享 /c/当前用户名 例如(我的本地):/c/Users/lanmps/ 如果在一个分区可以使用 mklink /H "C:\Users\lanmps\git" "C:\git" MKLINK [[/D] | [/H] | [/J]] Link Target /D 创建目录符号链接。默认为文件 符号链接。 /H 创建硬链接,而不是符号链接。 /J 创建目录联接。 Link 指定新的符号链接名称。 Target 指定新链接引用的路径 (相对或绝对)。 5. 设置其他盘文件夹为 项目文件夹 5.1 先关闭boot2docker windows 桌面 打开Boot2Docker Start 这个快捷方式,出现的命令界面中执行 boot2docker stop 5.2 设置共享文件夹 在虚拟机管理界面中, boot2docker-vm 一定要是 关闭状态(图中是我已经设置好的所以是运行的) 设置的共享文件夹名称 c/Users 不能改变,如果改变了一定要改回来 5.3 boot2docker启动 boot2docker start启动成功后,如果有问题, 重复 2 3 两个步骤就可以了 #进入docker boot2docker ssh #进入共享目录 cd /c/Users #查看列表 ll 发现e:\git目录下的全都有了 6.注意 因为boot2docker使用的是 内存 linux,所以只要关机/重启 时候,没有把该 boot2docker-vm 设置为 休眠或者 快照,那么关机/重启 之后,虚拟机内所有数据全部都是不存在的。 x.镜像下载 和 linux 一样 http://blog.csdn.net/fenglailea/article/details/50100311

优秀的个人博客,低调大师

docker 中 NGINX+PHP+MYSQL+REDIS+Elasticsearch 环境搭建 (linux系统)

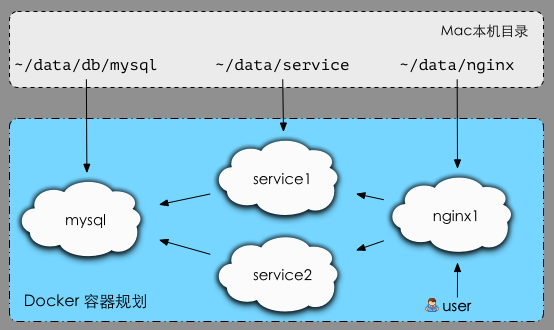
项目中N次使用PHP+MYSQL+NGINX+REDIS+ Elasticsearch,为了方便所以使用了docker fox.风来了 完整版地址: http://blog.csdn.net/fenglailea/article/details/50451555 目前是 LINUX 下,稍后制作 WINDOWS下的 1.docker 环境安装 http://blog.csdn.net/fenglailea/article/details/44886427 推荐使用方法二 2.下载镜像 国外和国内的docker hub 是两种速度体验,访问国外的HUB 的时间,可以和朋友一起搓一顿都够了。 可以使用国内的docker HUB 使用国外下载 docker hub 时,有时会报错,比如超时,或者有代理什么的,直接PASS,重新PULL 2.1 nginx+php+redis 镜像下载 docker pull foxiswho/docker-nginx-php大约2小时,docker hub 国内没有服务器就是慢,可以使用国内的一些docker 仓库如 阿里云等 2.2elasticsearch 镜像下载 docker pull elasticsearch大约 1 小时 2.3 mysql 或其他 docker pull mysql:5.5.27大约1小时 3. 启动设置容器 3.1elasticsearch docker run --name es -p 9200:9200 -p 9300:9300 -d elasticsearch:latest --name 容器别名 -p 主机端口:容器端口 -d 镜像 3.2 mysql docker run --name mysql -p 3306:3306 -e MYSQL_ROOT_PASSWORD=root -d mysql:5.6.27 3.3 nginx+php+redis docker run --name web --link mysql:db --link es:es -p 8080:80 -v /www/wwwroot/web:/usr/share/nginx/html -d foxiswho/docker-nginx-php:latest--link 容器内之间链接,比如访问数据库 原来 是 localhost或者 127.0.0.1 ,现在只要填写 db 就可以了 -v 本地目录:容器目录 ,例如 本地目录/www/wwwroot/web 注意 本地 目录设置权限和用户组 chown -R www-data:www-data/www/wwwroot/web chmod -R 777/www/wwwroot/web 这个时候访问本机 127.0.0.1:8080 就可以看到 你的项目站点了 4.容器操作 4.1 已启动的容器 如果启动成功了使用命令就可以看到已启动的容器: docker ps 4.1 所有容器 docker ps -a

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册