首页 文章 精选 留言 我的

精选列表

搜索[笔记软件],共10010篇文章
优秀的个人博客,低调大师

Android Animation学习笔记

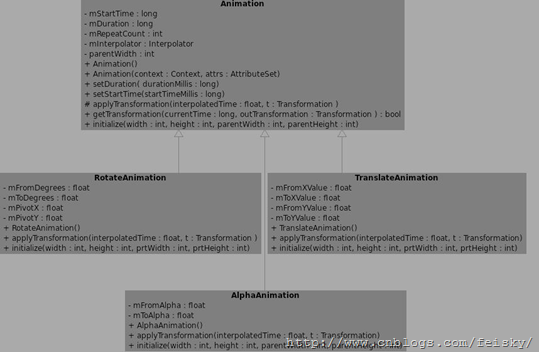
关于动画的实现,Android提供了Animation,在Android SDK介绍了2种Animation模式: 1. Tween Animation:通过对场景里的对象不断做图像变换(平移、缩放、旋转)产生动画效果,即是一种渐变动画; 2. Frame Animation:顺序播放事先做好的图像,是一种画面转换动画。 动画类型 下面先来看看Android提供的动画类型。Android的animation由四种类型组成 在XML文件中: alpha 渐变透明度动画效果 scale 渐变尺寸伸缩动画效果 translate 画面转换位置移动动画效果 rotate 画面转移旋转动画效果 在Java 源码中定义了相应的类,可以使用这些类的方法来获取和操作相应的属性: AlphaAnimation渐变透明度动画效果 ScaleAnimation渐变尺寸伸缩动画效果 TranslateAnimation画面转换位置移动动画效果 RotateAnimation画面转移旋转动画效果 Tween Animation 一个tween动画将对视图对象中的内容进行一系列简单的转换(位置,大小,旋转,透明性)。如果你有一个文本视图对象,你可以移动它,旋转它,让它变大或让它变小,如果文字下面还有背景图像,背景图像也会随着文件进行转换。 使用XML来定义Tween Animation 动画的XML文件在工程中res/anim目录,这个文件必须包含一个根元素,可以使<alpha><scale> <translate> <rotate>插值元素或者是把上面的元素都放入<set>元素组中,默认情况下,所以的动画指令都是同时发生的,为了让他们按序列发生,需要设置一个特殊的属性startOffset。动画的指令定义了你想要发生什么样的转换,当他们发生了,应该执行多长时间,转换可以是连续的也可以使同时的。例如,你让文本内容从左边移动到右边,然后旋转180度,或者在移动的过程中同时旋转,没个转换需要设置一些特殊的参数(开始和结束的大小尺寸的大小变化,开始和结束的旋转角度等等,也可以设置些基本的参数(例如,开始时间与周期),如果让几个转换同时发生,可以给它们设置相同的开始时间,如果按序列的话,计算开始时间加上其周期。 Tween Animation共同的节点属性 属性[类型] 功能 备注 Duration[long] 属性为动画持续时间 时间以毫秒为单位 fillAfter [boolean] 当设置为true ,该动画转化在动画结束后被应用 fillBefore[boolean] 当设置为true ,该动画转化在动画开始前被应用 interpolator 指定一个动画的插入器 有一些常见的插入器 accelerate_decelerate_interpolator 加速-减速 动画插入器 accelerate_interpolator 加速-动画插入器 decelerate_interpolator 减速- 动画插入器 其他的属于特定的动画效果 repeatCount[int] 动画的重复次数 RepeatMode[int] 定义重复的行为 1:重新开始 2:plays backward startOffset[long] 动画之间的时间间隔,从上次动画停多少时间开始执行下个动画 zAdjustment[int] 定义动画的Z Order的改变 0:保持Z Order不变 1:保持在最上层 -1:保持在最下层 表二 XML节点 功能说明 alpha 渐变透明度动画效果 <alpha android:fromAlpha=”0.1″ android:toAlpha=”1.0″ android:duration=”3000″ /> fromAlpha 属性为动画起始时透明度 0.0表示完全透明 1.0表示完全不透明 以上值取0.0-1.0之间的float数据类型的数字 duration为动画持续时间,ms单位 toAlpha 属性为动画结束时透明度 表三 scale 渐变尺寸伸缩动画效果 <scale android:interpolator= “@android:anim/accelerate_decelerate_interpolator” android:fromXScale=”0.0″ android:toXScale=”1.4″ android:fromYScale=”0.0″ android:toYScale=”1.4″ android:pivotX=”50%” android:pivotY=”50%” android:fillAfter=”false” android:startOffset=“700” android:duration=”700″ android:repeatCount=”10″ /> fromXScale[float] fromYScale[float] 为动画起始时,X、Y坐标上的伸缩尺寸 0.0表示收缩到没有 1.0表示正常无伸缩 值小于1.0表示收缩 值大于1.0表示放大 toXScale [float] toYScale[float] 为动画结束时,X、Y坐标上的伸缩尺寸 pivotX[float] pivotY[float] 为动画相对于物件的X、Y坐标的开始位置 属性值说明:从0%-100%中取值,50%为物件的X或Y方向坐标上的中点位置 表四 translate 画面转换位置移动动画效果 <translate android:fromXDelta=”30″ android:toXDelta=”-80″ android:fromYDelta=”30″ android:toYDelta=”300″ android:duration=”2000″ /> fromXDelta toXDelta 为动画、结束起始时 X坐标上的位置 fromYDelta toYDelta 为动画、结束起始时 Y坐标上的位置 表五 rotate 画面转移旋转动画效果 <rotate android:interpolator=”@android:anim/accelerate_decelerate_interpolator” android:fromDegrees=”0″ android:toDegrees=”+350″ android:pivotX=”50%” android:pivotY=”50%” android:duration=”3000″ /> fromDegrees 为动画起始时物件的角度 说明 当角度为负数——表示逆时针旋转 当角度为正数——表示顺时针旋转 (负数from——to正数:顺时针旋转) (负数from——to负数:逆时针旋转) (正数from——to正数:顺时针旋转) (正数from——to负数:逆时针旋转) toDegrees 属性为动画结束时物件旋转的角度 可以大于360度 pivotX pivotY 为动画相对于物件的X、Y坐标的开始位 说明:以上两个属性值 从0%-100%中取值 50%为物件的X或Y方向坐标上的中点位置 下面给出一个完整的XML定义(SDK提供) <set android:shareInterpolator="false" xmlns:android="http://schemas.android.com/apk/res/android"> <scale android:interpolator="@android:anim/accelerate_decelerate_interpolator" android:fromXScale="1.0" android:toXScale="1.4" android:fromYScale="1.0" android:toYScale="0.6" android:pivotX="50%" android:pivotY="50%" android:fillAfter="false" android:duration="700" /> <set android:interpolator="@android:anim/decelerate_interpolator"> <scale android:fromXScale="1.4" android:toXScale="0.0" android:fromYScale="0.6" android:toYScale="0.0" android:pivotX="50%" android:pivotY="50%" android:startOffset="700" android:duration="400" android:fillBefore="false" /> <rotate android:fromDegrees="0" android:toDegrees="-45" android:toYScale="0.0" android:pivotX="50%" android:pivotY="50%" android:startOffset="700" android:duration="400" /> </set> </set> Tween Animation如何使用 使用AnimationUtils类的静态方法loadAnimation()来加载XML中的动画XML文件 //main.xml中的ImageView ImageView spaceshipImage = (ImageView) findViewById(R.id.spaceshipImage); //加载动画 Animation hyperspaceJumpAnimation =AnimationUtils.loadAnimation(this, R.anim.hyperspace_jump); //使用ImageView显示动画 spaceshipImage.startAnimation(hyperspaceJumpAnimation); 如何在Java代码中定义动画 //在代码中定义 动画实例对象 private Animation myAnimation_Alpha; private Animation myAnimation_Scale; private Animation myAnimation_Translate; private Animation myAnimation_Rotate; //根据各自的构造方法来初始化一个实例对象 myAnimation_Alpha=new AlphaAnimation(0.1f, 1.0f); myAnimation_Scale =new ScaleAnimation(0.0f, 1.4f, 0.0f, 1.4f, Animation.RELATIVE_TO_SELF, 0.5f, Animation.RELATIVE_TO_SELF, 0.5f); myAnimation_Translate=new TranslateAnimation(30.0f, -80.0f, 30.0f, 300.0f); myAnimation_Rotate=new RotateAnimation(0.0f, +350.0f, Animation.RELATIVE_TO_SELF,0.5f,Animation.RELATIVE_TO_SELF, 0.5f); interpolator的解释 interpolator定义一个动画的变化率(the rate of change)。这使得基本的动画效果(alpha, scale, translate, rotate)得以加速,减速,重复等。 Interpolator 定义了动画的变化速度,可以实现匀速、正加速、负加速、无规则变加速等。Interpolator 是基类,封装了所有 Interpolator 的共同方法,它只有一个方法,即 getInterpolation (float input),该方法 maps a point on the timeline to a multiplier to be applied to the transformations of an animation。Android 提供了几个 Interpolator 子类,实现了不同的速度曲线,如下: AccelerateDecelerateInterpolator 在动画开始与介绍的地方速率改变比较慢,在中间的时候加速 AccelerateInterpolator 在动画开始的地方速率改变比较慢,然后开始加速 CycleInterpolator 动画循环播放特定的次数,速率改变沿着正弦曲线 DecelerateInterpolator 在动画开始的地方速率改变比较慢,然后开始减速 LinearInterpolator 在动画的以均匀的速率改变 Frame Animation Frame Animation是顺序播放事先做好的图像,跟电影类似。不同于animation package, Android SDK提供了另外一个类AnimationDrawable来定义、使用Frame Animation。 Frame Animation可以在XML Resource定义(还是存放到res\anim文件夹下),也可以使用AnimationDrawable中的API定义。由于Tween Animation与Frame Animation有着很大的不同,因此XML定义的格式也完全不一样,其格式是:首先是animation-list根节点,animation-list根节点中包含多个item子节点,每个item节点定义一帧动画,当前帧的drawable资源和当前帧持续的时间。下面对节点的元素加以说明: XML属性 说明 drawable 当前帧引用的drawable资源 duration 当前帧显示的时间(毫秒为单位) oneshot 如果为true,表示动画只播放一次停止在最后一帧上,如果设置为false表示动画循环播放。 variablePadding If true, allows the drawable’s padding to change based on the current state that is selected. visible 规定drawable的初始可见性,默认为flase; 下面就给个具体的XML例子,来定义一帧一帧的动画: <animation-list xmlns:android="http://schemas.android.com/apk/res/android" android:oneshot="true"> <item android:drawable="@drawable/rocket_thrust1" android:duration="200" /> <item android:drawable="@drawable/rocket_thrust2" android:duration="200" /> <item android:drawable="@drawable/rocket_thrust3" android:duration="200" /></animation-list> 上面的XML就定义了一个Frame Animation,其包含3帧动画,3帧动画中分别应用了drawable中的3张图片:rocket_thrust1,rocket_thrust2,rocket_thrust3,每帧动画持续200毫秒。 然后我们将以上XML保存在res/anim/文件夹下,命名为rocket_thrust.xml,显示动画的代码: AnimationDrawable rocketAnimation;public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.main); ImageView rocketImage = (ImageView) findViewById(R.id.rocket_image); rocketImage.setBackgroundResource(R.anim.rocket_thrust); rocketAnimation = (AnimationDrawable) rocketImage.getBackground();}public boolean onTouchEvent(MotionEvent event) { if (event.getAction() == MotionEvent.ACTION_DOWN) { rocketAnimation.start(); return true; } return super.onTouchEvent(event);} 代码运行的结果:3张图片按照顺序的播放一次. 有一点需要强调的是:启动Frame Animation动画的代码rocketAnimation.start();不能在OnCreate()中,因为在OnCreate()中AnimationDrawable还没有完全的与ImageView绑定,在OnCreate()中启动动画,就只能看到第一张图片。这里实在拖曳事件中实现的。 下面,阅读Android SDK中对AnimationDrawable的介绍,有个简单的了解: AnimationDrawable 获取、设置动画的属性 int getDuration() 获取动画的时长 int getNumberOfFrames() 获取动画的帧数 boolean isOneShot() Void setOneShot(boolean oneshot) 获取oneshot属性 设置oneshot属性 void inflate(Resurce r,XmlPullParser p, AttributeSet attrs) 增加、获取帧动画 Drawable getFrame(int index) 获取某帧的Drawable资源 void addFrame(Drawable frame,int duration) 为当前动画增加帧(资源,持续时长) 动画控制 void start() 开始动画 void run() 外界不能直接掉调用,使用start()替代 boolean isRunning() 当前动画是否在运行 void stop() 停止当前动画 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/01/11/1644482.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android Service学习笔记

一 什么是Service 服务是运行在后台的一段代码。它可以运行在它自己的进程,也可以运行在其他应用程序进程的上下文(context)里面,这取决于自身的需要。其它的组件可以绑定到一个服务(Service)上面,通过远程过程调用(RPC)来调用这个方法。例如媒体播放器的服务,当用户退出媒体选择用户界面,仍然希望音乐依然可以继续播放,这时就是由服务(service)来保证当用户界面关闭时音乐继续播放的。 它跟Activity的级别差不多,但是他不能自己运行,需要通过某一个Activity或者其他Context对象来调用,Context.startService()和Context.bindService()。两种启动Service的方式有所不同。这里要说明一下的是如果你在Service的onCreate或者onStart做一些很耗时间的事情,最好在Service里启动一个线程来完成,因为Service是跑在主线程中,会影响到你的UI操作或者阻塞主线程中的其他事情。什么时候需要Service呢?比如播放多媒体的时候用户启动了其他Activity这个时候程序要在后台继续播放,比如检测SD卡上文件的变化,再或者在后台记录你地理信息位置的改变等等。 二 如何使用Service 1.第一种是通过调用Context.startService()启动,调用Context.stopService()结束,startService()可以传递参数给Service。 2.第二种方式是通过调用Context.bindService()启动,调用Context.unbindservice()结束,还可以通过ServiceConnection访问Service。 二者可以混合使用,比如说我可以先startService再bindservice。 三 service生命周期 startService后,即使调用startService的进程结束了,Service仍然还存在,直到有进程调用stopService,或者Service自己自杀(stopSelf())。bindService后,Service就和调用bindService的进程同生共死了,也就是说当调用bindService的进程死了,那么它bind的Service也要跟着被结束,当然期间也可以调用unbindservice让Service结束。 两种方式混合使用时,比如说你startService了,我bindService了,那么只有你stopService了而且也unbindservice了,这个Service才会被结束。 Android系统将会尝试保留那些启动了的或者是绑定了服务的进程。如果该服务正在进程的onCreate(), onStart(),或者onDestroy()这些方法中执行时,那么主进程将会成为一个前台进程,以确保此代码不会被停止。如果服务已经开始,那么它的主进程会就重要性而言低于所有可见的进程但高于不可见的进程,由于只有少数几个进程是用户可见的,所以只要不是内存特别低,该服务不会停止.。如果有多个客户端绑定了服务,只要客户端中的一个对于用户是可见的,即认为该服务可见。 如果Service还没有运行,则android先调用onCreate()然后调用onStart();如果Service已经运行,则只调用onStart(),所以一个Service的onStart方法可能会重复调用多次。 stopService的时候直接onDestroy,如果是调用者自己直接退出而没有调用stopService的话,Service会一直在后台运行。该Service的调用者再启动起来后可以通过stopService关闭Service。 所以调用startService的生命周期为:onCreate --> onStart(可多次调用) --> onDestroy 使用context.bindService()启动Service会经历: context.bindService()->onCreate()->onBind()->Service running onUnbind() -> onDestroy() ->Service stop onBind将返回给客户端一个IBind接口实例,IBind允许客户端回调服务的方法,比如得到Service运行的状态或其他操作。这个时候把调用者(Context,例如Activity)会和Service绑定在一起,Context退出了,Srevice就会调用onUnbind->onDestroy相应退出。 所以调用bindService的生命周期为:onCreate --> onBind(只一次,不可多次绑定) --> onUnbind --> onDestory。 所以,在Service每一次的开启关闭过程中,只有onStart可被多次调用(通过多次startService调用),其他onCreate,onBind,onUnbind,onDestory在一个生命周期中只能被调用一次。 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/06/14/1758336.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Python 学习笔记 - Memcached

Memcached是一个分布式内存对象缓存系统,他把数据缓存在内存里面来减少对数据库的访问,从而提高动态网页的访问速度。他的基本结构是key/value(键值对)。下面看看在Python里面如何使用。 首先来安装一下服务器端,豆子直接在一个CentOS7的机器上安装 [root@sydnagios~]#yuminstallmemcachedLoadedplugins:fastestmirror,langpacksRepodataisover2weeksold.Installyum-cron?Orrun:yummakecachefastbase|3.6kB00:00epel/x86_64/metalink|2.0kB00:00epel|4.3kB00:00extras|3.4kB00:00updates|3.4kB00:00(1/5):epel/x86_64/group_gz|170kB00:00(2/5):epel/x86_64/updateinfo|671kB00:00 然后服务器端跑起来,这个里面我指定的端口是12000,因此如果有防火墙别忘记打开对应端口 [root@sydnagios~]#memcached-d-m10-uroot-l10.2.1.107-p12000-c256-P/tmp/memcached.pid 参数说明: - d 是启动一个守护进程 - m 是分配给Memcache使用的内存数量,单位是MB - u 是运行Memcache的用户 - l 是监听的服务器IP地址 - p 是设置Memcache监听的端口,最好是 1024 以上的端口 - c 选项是最大运行的并发连接数,默认是 1024 ,按照你服务器的负载量来设定 - P 是设置保存Memcache的pid文件 打开防火墙端口 firewall-cmd--add-port=12000/tcp--permanent 接下来安装Python的客户端模块 从这里下载https://pypi.python.org/pypi/python-memcached 解压拷贝到sys.path对应的目录,就能直接用了 看看第一个例子,可以通过set来设置数据,get来获取数据。里面debug是为了显示错误的 生产环境里面不要用 #!/usr/bin/envpython#-*-coding:utf-8-*-#AuthorYuanLiimportmemcachemc=memcache.Client(['10.2.1.107:12000'],debug=True)mc.set("foo","bar")mc.add("name","John")print(mc.get('foo'))print(mc.get('name'))-----------barJohn memcached的第二个特点是他默认支持集群,原理是内存里面创建一个主机的列表;每个主机有一个权重,权重的数目和主机在列表里面出现的数目成正比。通过算法可以决定把键值对放在哪个服务器的内存里面。 例2 mc=memcache.Client([('1.1.1.1:12000',1),('1.1.1.2:12000',2),('1.1.1.3:12000',1)],debug=True)mc.set('k1','v1') 除了get和set以外,他还具有以下常用函数 add添加一条键值对,如果已经存在的 key,重复执行add操作异常 replacereplace 修改某个key的值,如果key不存在,则异常 set 和 set_multi set 设置一个键值对,如果key不存在,则创建,如果key存在,则修改set_multi 设置多个键值对,如果key不存在,则创建,如果key存在,则修改 delete 和 delete_multi delete 在Memcached中删除指定的一个键值对delete_multi 在Memcached中删除指定的多个键值对 append 和 prepend append 修改指定key的值,在该值 后面 追加内容prepend 修改指定key的值,在该值 前面 插入内容 decr 和 incr incr 自增,将Memcached中的某一个值增加 N ( N默认为1 )decr 自减,将Memcached中的某一个值减少 N ( N默认为1 ) gets 和cas 这个组合可以避免脏数据的产生,如果在gets数据,和cas数据回去这个过程中有其他用户执行了get,那么则不允许修改

优秀的个人博客,低调大师

Storm Ack框架笔记

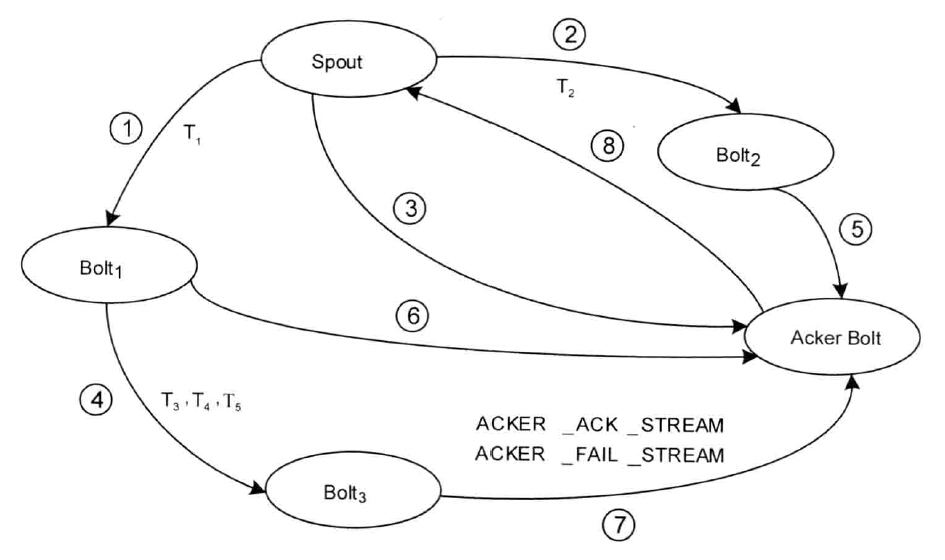
Storm利用Acker Bolt节点跟踪消息,当Spout发送出去的消息以及这些消息所衍生出来的消息均被处理后,Spout将受到对应于该消息的Ack。实现要点: 1、Storm中每条发送出去的消息都会对应一个随机的消息ID。 2、Spout发送消息后,将向Acker Bolt发送一条消息,该消息内容为<RootId,消息ID>,Acker bolt将为该消息创建一条跟踪项。 3、Bolt产生要发送的消息时,会计算每条新消息的消息ID,并将消息ID发送至Acker Bolt,Acker Bolt对消息ID进行异或后存储。于是,Storm对新发送的消息进行了跟踪。 4、Blot对输入的消息进行Ack时,也会将该消息ID发送到Acker Bolt,Acker Bolt对每条消息ID进行异或存储,由于该消息在被发送时,已经向Acker Bolt发送过消息ID,之后再被Acker时又再次发送该消息ID。根据异或的语义,这相当于对该消息的跟踪结束。 5、Acker Bolt在更新某一个消息的跟踪值时,若发现其跟踪值变为零,则向Spout节点发送消息,表明Spout发送的这条消息已经被成功处理。 6、若Spout在发送消息时未指定用于消息跟踪的ID,系统则不对消息进行跟踪,Blot新产生的消息并不会被单独跟踪。 7、Spout的每条消息以及由该消息演化而来的所有消息的跟踪负载为16个字节,8个字节的根消息ID以及8个字节的消息跟踪值AckValue.但是,由于Storm中采用HashMap对其进行存储,在32位的JVM中,每条消息至少需要20个字节的额外负载,故一条消息的跟踪需要40个字节左右的负载。 (一)1与2中,Spout发送T1到Bolt1,发送T2到Bolt2.T1和T2具有相同的内容,但表示不同的备份,每条消息都会对应一个ID,消息T1的anchors为<RootId,T1>,消息T2的anchors为<RootId,T2> (二)3中,Spout在Acker Bolt中注册了一条记录RootId=T1^T2。 (三)4与6中,Bolt1发送新的消息T3、T4、T5到Blot3,同时对输入的消息进行Ack操作,消息内容为<RootId,T1^T3^T4^T5>,此时,Acker Bolt中的跟踪项为<RootId,T1^T2^T1^T3^T4^T5=>T2^T3^T4^T5>。 (四)在5中,Bolt2对输入的消息T2进行Ack操作,它没有产生新的消息,发送到Acker Bolt的消息为<RootId,T2>,T2异或后消失。 (五)在7中,Blot3对输入的消息进行Ack操作,发送的消息为<RootId,T3^T4^T5>,此时Acker Bolt中的跟踪项为<RootId,T3^T4^T5^T3^T4^T5 =>0> (六)Acker Bolt发现RootId对应的值为零,它认为该RootId对应的消息以及所有衍生出来的消息均已经被成功处理,于是它向Spout发送消息,而Spout将调用Ack回调方法。 那么每条被处理的消息必须进行Ack或者Fail操作,否则,虽然有超时机制可以对过期消息进行清空,但可能导致消息不断重传。(所以项目中每次进入bolt都有唯一性过滤?) 参考:《Storm 源码分析》

优秀的个人博客,低调大师

docker app 打包笔记

docker介绍 https://www.docker.io/ 我的需求 此次希望将要发布的app和执行环境进行打包, app使用python django开发。 这次我打算打包的步骤为: 自己制作docker的base image 配置app执行环境 将制作好的容器导出成文件,用于其他机器的导入 开始执行 制作base image 首先我们先提取一个最小的rootfs, 我现在使用的系统是ubuntu12.04, 我想制作一个12.04的也就是precise的rootfs: sudo debootstrap precise ubuntu #precise 为 /usr/share/debootstrap/scripts 下存在的debootstrap script #ubuntu 就是当前目录下的一个目录 制作过程比较长,制作完成后我们来把它导入到docker中成为一个image: tar -C ubuntu -c . | sudo docker import - ubuntu 完成后我们就制作好了一个docker的base image, 我们可以同做下面这个命令来查看: sudo docker images 配置app环境 首先我要把app代码拷进容器中,这个是可以通过dockerfile 中的ADD来做的,不过我还没有仔细看dockerfile,就先手动通过qiniu上传在下载到运行中的容器中的. 首先我们要用docker使用我们前面制作好的image跑起一个shell sudo docker run -i -t ubuntu bash => root@210ae349a593:/# 然后我们就可以在这个启动中的bash中来执行我们的常用操作了,我把上传的代码wget下来到/docker_app, 对我把它放在了启动的容器的根目录下的docker_app,现在我要安装我app的依赖。 我先手动wget下来python的setuptools和pip,手动安装好.因为依赖中有MySQL-python,如果要用pip来安装的话要编译,编译的话需要安装mysql的一些lib,会使image变大,所以直接用apt-get安装了二进制的,并在requirments.txt中删掉了MySQL-python. 因为依赖中还有一个Pillow需要编译,所以忍痛装上的gcc和python-dev. 然后在docker_app目录下 pip install -r requirments.txt -i http://pypi.douban.com/simple 修改app配置文件中的数据库的地址,我们要查看我们本机docker0虚拟网卡的ip, 我机器的显示是: ifconfig => docker0 Link encap:Ethernet HWaddr 76:71:61:ca:84:1b inet addr:172.17.42.1 Bcast:0.0.0.0 Mask:255.255.0.0 inet6 addr: fe80::c10:64ff:fe74:c0c6/64 Scope:Link UP BROADCAST RUNNING MULTICAST MTU:1500 Metric:1 RX packets:617463 errors:0 dropped:0 overruns:0 frame:0 TX packets:678907 errors:0 dropped:0 overruns:0 carrier:0 collisions:0 txqueuelen:0 RX bytes:56062519 (56.0 MB) TX bytes:267105247 (267.1 MB) 所以我就把数据库ip改成 172.17.42.1, ok,环境配置好的,我们保持这个shell session,然后打开另一个shell session执行以下命令查看现在运行的这个容器的id: sudo docker ps => CONTAINER ID IMAGE .... 210ae349a593 ubuntu:latest .... 然后我们将这个容器commit 成 docker_app: sudo docker commit 210ae349a593 docker_app 我们再次执行sudo docker images, 就会发现我们生成的 docker_app 的image 下面我们 exit 刚才我们配置环境的那个 shell, 来测试一下我们配置的环境的image. sudo docker run -i -t -d -p 8000:8000 docker_app python /docker_app/manage.py runserver 0.0.0.0:8000 这样我们就把本地8000端口和任务容器的8000端口做了映射,接下来我们就可以在本地浏览器上访问我们http://127.0.0.1:8000来访问我们的应用了, 我们还可以查看容器的输出日志,容器id为我们sudo docker ps出来的CONTAINER ID: sudo docker logs -f <容器id> => Validating models... 0 errors found March 27, 2014 - 14:14:10 Django version 1.6.1, using settings 'app.settings' Starting development server at http://0.0.0.0:8000/ Quit the server with CONTROL-C. 导出我们制作好的image docker 本身是有push 来上传的 index.docker.io 的,使用是用pull来拉取,但是由于在天朝,网络不给力。所以就导出成文件吧,docker官方也有给出自建image server的方案,貌似项目还不太成熟,以后再研究. 现在我们 docker ps 出刚才运行的那个容器的 id, 将它导出 sudo docker export <容器id> > docker_app.tar 完成后我们刚才制作的容器就导出成了 docker_app.tar 文件, 以后在其他机器部署的时候执行导入 cat docker_app.tar | sudo docker import - docker_app 管道后面的 docker_app 为导入后image命名,自己指定

优秀的个人博客,低调大师

NDK抄书笔记【枯燥】

版权归他们:《Android高级开发实战---UI、NDK与安全》 王氏兄弟 1.何为JNI JNI (Java Native Interface) 即Java本地开发接口,也是C/C++与Java通信的一个协议,这个协议可以使Java代码与C/C++代码之间进行沟通,通过该协议,Java代码就可以调用C/C++代码,C/C++代码也可以调用Java代码,这样就可以将Java程序与C/C++程序集成到一起。 2.为什么要用JNI a. JNI扩张了Java虚拟机的能力。Java语言是不能够直接操作硬件的(Java在实现跨平台操作时,将硬件操作全部封装起来)。例如,Java语言是不能够直接用来开发驱动的,但Java可以通过JNI来做一些驱动开发(驱动开发需要操作硬件,而C语言可以实现对硬件的操作,Java通过JNI协议,可以实现对C的调用) b. C/C++语言的运行效率高(Java的执行效率相对低一点,魔乐科技的李兴华说:java实在c++的基础上改写而来,C#是由java和c++改写而来),应用比较广泛例如,数学运算、实时渲染Opengl、音/视频处理ffmpeg c. 直接复用C/C++中的优秀代码(文件压缩、人脸识别) d. Java不可以手动释放内存,而C/C++可以实现手动控制内存,如果对内存的利用有较高要求时,需要使用C/C++来实现。 e.特殊的业务场景,如高级汽车上安装的车载电脑的onboard debug system,需要获取硬件的电信号 3.如何使用JNI NDK,Natvie Develop Kits,·可以将C/C++语言写出来的源代码编译成可执行的文件(文件格式以.so为 扩展名,该文件组成的库称之为“可执行动态库”)。 Java端需要有JVM和Class类(得到Class对象后,就可以调用该Class中的方法);C/C++端需要有function函数与function.lib函数库。C/C++的函数通过JNI机制去调用Java端的Class方法;Java端通过JNI机制去调用C/C++端的函数或者函数库。JNI在此充当C/C++与Java通信的桥梁。 Java源码经过被编译后生成了.class文件(Java字节码),通过类加载器将字节码加载到Java类库中,然后再JVM中对字节码进行解释 、翻译后才可以被计算机所识别出来;而C/C++经过编译后,生成了一个.exe文件,没有Java中将数据装载到虚拟机中进行解释、翻译这一步,两者从编译到运行的基本过程比较:C/C++-->(*.exe)-->机器,Java-->(*.class)-->JVM-->机器,这是 C/C++的运行效率高于Java的原因。 4.NDK与JNI的关系 Java通过JNI机制和C/C++沟通的具体步骤: a.编写包含native本地方法的Java类 b.通过javah工具生成C/C++语言的头文件 c.使用C/C++语言实现头文件 d.使用交叉编译工具对C/C++本地代码进行编译,最后通过链接生成*.so可执行的C/C++库 e.实际执行Java代码去和本地的C/C++代码相互沟通 5.JNI中的Java VM与JNIEnv对象 在标准的Java平台下,每一个进程里可以产生很多Java VM对象,每一个Java VM对象都有一个与之对应的Java VM对象,但是在Android平台上,每一个进程只能产生一个Dalvik VM对象,也就是说一个Android的进程中是通过有且只有一个虚拟器对象来服务所有的Java和C/C++代码 Android中的JNIEnv对象与Dalvik的Java VM具体关系: a. JNIEnv *内部包含一个指针,指针指向Dalvik的Java VM对象的Function Table,JNIEnv *关于程序执行环境众多函数正式来源于Dalvik虚拟机 b.Android中每当一个Java线程第一次要调用本地C/C++代码时,Dalvik虚拟机实例会为该Java线程产生一个JNIEnv*指针 c.Java每条线程在和C/C++相互调用时的JNIEnv*是相互独立的,互不干扰,这就提升了并发执行时的安全性 d.当本地的C/C++代码想获得当前线程所要使用的JNIEnv时可以使用Dalvik VM对象的Java VM* jvm->GetEnv()方法,该方法即会返回当前线程所在的JNIEnv * 6.Java、Dalvik VM、C/C++的运行机制与流程 a.Java的dex字节码和C/C++的*.so同时运行Dalvik VM之内,共同使用一个进程空间。 b.Java和C/C++可以相互调用,其调用的关键均是Dalvik VM c.一般而言,比较经典的模式是Java通过JNI的C组件和C++相互沟通,一般的业务处理代码是放在C++中的 d.C++代码处于核心的控制地位具有更高的价值 当Java代码需要C/C++代码时,在Dalvik虚拟机加载进*.so库时,会先调用JNI_OnLoad()函数,此时就会把Java VM对象的指针存储于C层JNI组件的全局环境中。在Java层调用C层的本地函数时,调用C本地函数的线程必然会通过Dalvik VM来调用C层的本地函数,此时Dalvik虚拟机会为本地的C组件实例化一个JNIEnv指针,该指针指向Dalvik 虚拟机的具体的函数列表,当JNI 的C组件调用Java成的方法或者属性时,需要通过JNIEnv指针来进行调用 当C++组件主动调用Java的方法或属性时,需要 通过JNI的C组件把JNIEnv指针传递给C++组件,此后,C++组件即可通过JNIEnv指针来掌控Java层代码。 关于android系统的图像处理再多说一句,运行时间长的操作尽量都放在服务器端,否则用户会崩溃的。

优秀的个人博客,低调大师

深度学习入门笔记系列 ( 七 ) ——循环神经网络(RNN)学习笔记

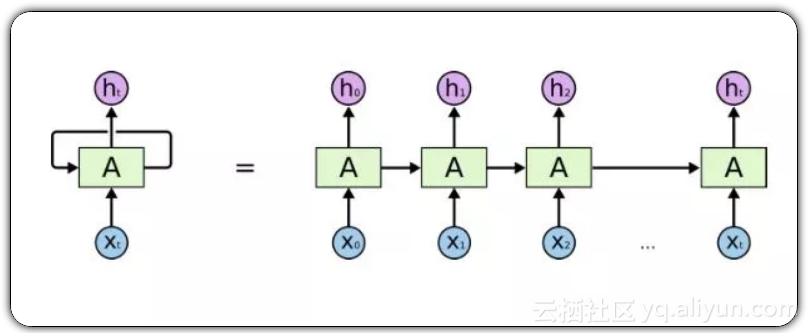
1.引言 在传统的神经网络模型中 ,是从输入层到隐含层再到输出层 ,层与层之间是全连接的 ,每层之间的节点是无连接的 。但是这种普通的神经网络对于很多问题却无能无力 。例如 ,你要预测句子的下一个单词是什么 ,一般需要用到前面的单词 ,因为一个句子中前后单词并不是独立的 。于是乎 ,我们就名正言顺的引出了这篇文章的 RNN 。 2.什么是RNN RNN(Recurrent Neural Networks)翻译为循环神经网路 ,与传统神经网络模型对比 ,RNN 一个序列当前的输出与前面的输出也有关 。具体的表现形式为网络会对前面的信息进行记忆并应用于当前输出的计算中 。重点的讲就是 ,隐藏层之间的节点之间是有连接的 ,并且隐藏层的输入不仅包括输入层的输出还包括上一时刻隐藏层的输出 。 例如上图 ,中间A表示隐含层 ,能够看出来从左到右的序列中 ,隐含层输入不仅包括输入层还有上一个序列的隐含层输出 。 3.RNN 能干些啥 理论上 ,RNN 能够对任何长度的序列数据进行处理 。但是在实践中 ,为了降低复杂性往往假设当前的状态只与前面的几个状态相关 ,下图便是一个典型的RNN : 坦白讲 ,小詹对 RNN 只知道基础概念 ,用的很少很少 。因为个人感觉 RNN 更多的应用到 NLP 即自然语言处理中 ,如如词向量表达 、语句合法性检查 、词性标注 。与之相对的 ,在计算机视觉领域 ,可能 CNN 及其变种使用的更为频繁 ,但是 RNN 也并非无用武之地 。 RNN 可以应用的领域大致有 : ●语言模型与文本生成(Language Modeling and Generating Text) ●机器翻译(Machine Translation) ●语音识别(Speech Recognition) ●图像描述生成 (Generating Image Descriptions) 4.LSTM网络 和 CNN 一样 ,基础的 RNN 网络也存在很多改进和拓展 ,相信大家听到比较多的是 LSTM(Long Short Term Memory)。 它与一般的 RNN 结构本质上并没有什么不同 ,只是使用了不同的函数去去计算隐藏层的状态 。在 LSTM 中 ,i 结构被称为 cells ,可以把 cells 看作是黑盒用以保存当前输入 xt 之前的保存的状态 ht−1 ,这些 cells 更加一定的条件决定哪些 cell 抑制哪些 cell 兴奋 。它们结合前面的状态 、当前的记忆与当前的输入 。已经证明 ,该网络结构在对长序列依赖问题中非常有效 。 原文发布时间为:2018-09-4 本文作者:小詹 本文来自云栖社区合作伙伴“小詹学Python”,了解相关信息可以关注“小詹学Python”。

优秀的个人博客,低调大师

shell总结笔记——关于变量

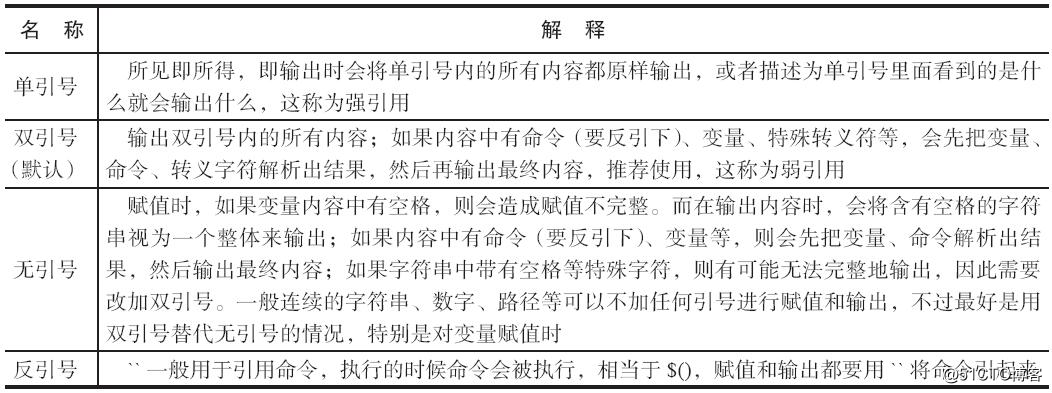
BASH:主要的优点: 命令编修能力; 命令与文件补全功能; 命令别名设置功能; 工作控制、前景背景控制; 程序化脚本; 万用字符; 1、什么是变量? 1、 让某一个特定的字符串代表不固定的内容。2、 变量就是让一组文字或符号等来取代一些设置,或者是一串保留的数据。3、变量的格式:变量名=变量内容(变量名一般设置为大写字母,专业一些)。 设置变量的规则:1、 变量与变量内容以一个等号“=”来链接;2、 等号两边不能直接接空白字符;3、 变量名称只能是英文字母与数字,但是开头字符不能是数字;4、 变量内容若有空白字符可以使用双引号,或单引号讲变量内容结合起来。双引号内的特殊字符如$等,可以保有原本的特性;单引号内的特殊字符则仅作为一般字符(纯文本)。5、 可用转义符“\”将特殊符号变成一般字符;6、 在一串指令的执行中,还需要借由其他额外的指令所提供的信息时,可以使用反撇号,而不是单引号。7、 若该变量需要在其他子程序执行,则需要一export来使自定义变量变成环境变量。8、 通常大写字符为系统默认变量,自行设置变量可以使用小写字符,方便判断;9、 取消变量的方法为使用unset: “unset 变量名称”例如取消myname的设置:unset myname。 有关shell变量定义、赋值及变量输出加单引号、双引号、反引号与不加引号的简要说明,如下表所示: 建议: 在脚本中定义普通字符串变量时,应尽量把变量的内容用双引号括起来;单纯数字的变量内容可以不加引号;希望变量的内容原样输出时需要加单引号;希望变量值引用命令并获取命令的结果时就用反单引号或$( )。env命令——查询环境变量。random命令:随机产生的数字是在0——32768之间。 set命令:查询的是所有的变量,包括环境变量和自定义变量。 $:代表的是当前shell的PID号,如echo $$; ?:代表的是上一个指令的回传值,如echo $? 自定义变量与环境变量最大的区别是:该变量是否会被子程序(子shell)继续使用。 各种变量定义的作用域: 环境变量=全域变量 自定义变量=区域变量 关于系统中的环境变量解释: PS1——系统特定变量名 其中PS1这个变量需要解释下,其他可以自行看懂,PS1可用的选项如下: \d :可显示出“星期月日”的日期格式,如:"Mon Feb 2" \H :完整的主机名称。举例来说,我的练习机为“study.centos.vbird” \h :仅取主机名称在第一个小数点之前的名字,如我主机则为“study”后面省略 \t :显示时间,为 24 小时格式的“HH:MM:SS” \T :显示时间,为 12 小时格式的“HH:MM:SS” \A :显示时间,为 24 小时格式的“HH:MM” \@ :显示时间,为 12 小时格式的“am/pm”样式 \u :目前使用者的帐号名称,如“dmtsai”; \v :BASH 的版本信息,如我的测试主机版本为 4.2.46(1)-release,仅取“4.2”显示 \w :完整的工作目录名称,由根目录写起的目录名称。但主文件夹会以 ~ 取代; \W :利用 basename 函数取得工作目录名称,所以仅会列出最后一个目录名。 #:下达的第几个指令。 \$ :提示字符,如果是 root 时,提示字符为 # ,否则就是 $ 用法示例: [root@localhost ~]# PS1='[\u@\h\w\A#\#]\$' #添加上面的一些选项 [root@localhost~13:07#5]#cd /etc #多执行两下命令 [root@localhost/etc13:07#6]#cd /boot [root@localhost/boot13:07#7]#exit #可以发现,执行PS1这个变量并结合一些选项的使用,可以暂时改变命令提示符的变化, #并且后面的数字会每执行一次,就增加一个数,这是\#的作用 设置变量的方式1 [root@localhost ~]# path=$PATH #先自定义一个变量,引用“PATH”的值,用“path”变量做测试 [root@localhost ~]# echo $path #输出进行确认下 /usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/root/bin [root@localhost ~]# echo ${path#/*local/sbin:} #试着删除一个 /usr/local/bin:/usr/sbin:/usr/bin:/root/bin #在上面的命令中,“$”是关键字,用在这种删除模式所必须存在的; #“path”就是原本的变量名称; #“#”代表从变量内容的最前面开始向右删除,且只删除最短的那个; #“/*local/sbin:”代表要被删除的部分,由于“#”代表从前面开始删除, #所以这里就从“/”写起,并且可以使用“*”这个万用字符,可以代表任意内容。 #但这条命令并没有改变“path”变量的内容,可以将“echo”换为“path=”即可直接改变变量内容。 #如下: [root@localhost ~]# path=${path#/*local/sbin:} [root@localhost ~]# echo $path /usr/local/bin:/usr/sbin:/usr/bin:/root/bin #这就将原本的变量值更改成功了。 关于其他的更改方式,参考上面的表格即可咯! (2) 示例1——测试一下是否存在username这个变量,若不存在则赋值username为root。 [root@localhost ~]# echo $username #查看username变量是否存在 [root@localhost ~]# username=${username-root} #如果变量内容不存在就赋值为root [root@localhost ~]# echo $username #变量不存在,所以将它赋值了root root [root@localhost ~]# username='lv jian zhao' #那么现在给它赋值 [root@localhost ~]# username=${username-root} #再次使用这个,表示如果值不存在,则将它赋值为root [root@localhost ~]# echo $username #再次输出,会发现还是我们手工赋的值,并没有给它赋值为root lv jian zhao #从上面可以看出“-”号的作用,就是如果值不存在,就给它赋值“-”号后面的值,若存在,则放弃。 示例2——若username未设置或为空字串,则将username内容设置为root [root@localhost ~]# username="" #将username设置为空字串 [root@localhost ~]# username=${username-root} #若值不存在,则赋值为root [root@localhost ~]# echo $username #输出该变量,会发现还是空的,因为username的值是存在的,只不过是空字串而已,所以并没有赋值为root [root@localhost ~]# username=${username:-root} #使用“:-”试试 [root@localhost ~]# echo $username #会发现已经赋值为root了 root #说明:“:-”的作用就是如果值为空或是未设置,都能被后面的内容替换。 设置变量的方式2 环境变量一般是指用export内置命令导出的变量,用于定义Shell的运行环境,保证Shell命令的正确执行。Shell通过环境变量来确定登录用户名、命令路径、终端类型、登录目录等,所有的环境变量都是系统全局变量,可用于所有子进程中,这包括编辑器、Shell脚本和各类应用。环境变量可以在命令行中设置和创建,但用户退出命令行时这些变量值就会丢失,因此,如果希望永久保存环境变量,可在用户家目录下的.bash_profile或.bashrc(非用户登录模式特有,例如远程文件中,或者全局配置/etc/bashrc(非用户登录模式特有,例如远程SSH)或/etc/profile文件中定义。在将环境变量放入上述的文件中后,每次用户登录时这些变量都将被初始化。按照系统规范,所有环境变量的名字均采用大写形式。在将环境变量应用于用户进程程序之前,都应该用export命令导出定义,例如:正确的环境变量定义方法为export OLDGIRL=1。有一些环境变量,比如HOME、PATH、SHELL、UID、USER等,在用户登录之前就已经被/bin/login程序设置好了。通常环境变量被定义并保存在用户家目录下的.bash_profile文件或全局的配置文件/etc/profile中,具体的环境变量说明请参考下表:在查看设置的变量时,有3个命令可以显示变量的值:set、env和declare(替代早期的typeset)。set命令输出所有的变量,包括全局变量和局部变量;env命令只显示全局变量;declare命令输出所有的变量、函数、整数和已经导出的变量。set-o命令显示bash Shell的所有参数配置信息。查看举例: [root@localhost ~]# env | tail #使用env命令进行查看全局变量 [root@localhost ~]# set -o #使用set -o查看bash shell的所有参数配置信息 设置环境变量的方式 如果想要设置环境变量,就要在给变量赋值之后或在设置变量时使用export命令,具体设置见下文的示例。其实,除了export命令,带-x选项的declare内置命令也可以完成同样的功能(注意:此处不要在变量名前面加$):export命令和declare命令的格式如下: ①export 变量名=value②变量名=value ; export 变量名③declare -x 变量名=value #以上就是三种设置环境变量的三种方法 上面设置的全局变量只是临时设置的,重启系统后,就失效了,那么可以将变量写入以下几个文件其中之一即可,使其永久生效: 1、只对用户的环境变量配置 [lv@localhost ~]$ ls ~/.bashrc ~/.bash_profile #对于用户的环境变量设置,比较常见的是用户家目录下的这两个目录,推荐写入第一个文件“.bashrc” 2、全局环境变量的配置常见的全局环境变量的配置文件如下: /etc/profile /etc/bashrc #推荐在此文件中优先设置 /etc/profile.d/ 环境变量总结 环境变量的定义: 变量名通常要大写; 变量可以在自身的shell及子shell中使用; 常用export来定义环境变量; 数字内容的变量定义可以不加引号,其他没有特殊要求的字符串等定义最好都加上双引号;如果真的需要原样输出就加单引号;定义变量加双引号是最常见的使用场景; 如果需要获取命令结果赋值给变量,则可以使用反撇号``(tab键上面的那个按键)或者括号“()”将命令字括起来; 执行env默认可以显示所有的环境变量名称及对应的值; 输出时用“echo $变量名”,取消时用“unset 变量名”; 书写crond定时任务时要注意,脚本要用到环境变量最好现在所执行的shell脚本中重新定义; 如果希望环境变量永久生效,则可以将其放在用户环境变量文件或全局环境变量文件里; 环境变量初始化与对应文件的生效顺序:在登录Linux系统并启动一个bash shell时,默认情况下bash会在若干个文件中查找环境变量的设置这些文件,这些文件可统称为系统环境文件。bash检查的环境变量文件的情况取决于系统运行shell的方式。系统运行shell的方式一般有3种:①通过系统用户登录后默认运行的shell;②非登录交互式运行shell;③执行脚本运行非交互式shell。 用户登录系统后首先会加载/etc/profile全局环境变量文件,这是Linux系统上默认的shell主环境变量文件,系统上每个用户登录都会加载这个文件。 当加载完/etc/profile文件后,才会执行/etc/profile.d目录下的脚本文件,这个目录下的脚本文件有很多,例如:系统的字符集设置(/etc/sysconfig/il8n)等。 之后开始运行$HOME/.bash_profile(用户环境变量文件),在这个文件中,又会去找$HOME/.bashrc(用户环境变量文件),如果有,则执行,如果没有,则不执行。在$HOME/.bashrc文件中又会去找/etc/bashrc(全局环境变量文件),如果有,则执行,如果没有,则不执行。 如果用户的shell不是登录时启动的(比如手动敲下bash时或者其他不需要输入密码的登录及远程连接情况),那么这种非登录shell只会加载$HOME/.bashrc,并会去找/etc/bashrc文件。因此如果希望在非登录shell下也可以督导设置的环境变量等内容,就需要将变量设定等写入$HOME/.bashrc或者/etc/bashrc,而不是$HOME/.bash_profile或/etc/profile。 ———————— 本文至此结束,感谢阅读 ————————

优秀的个人博客,低调大师

Docker零碎笔记

001.查看镜像、容器、数据卷所占用的空间 docker system df 002.具体查看镜像内的历史记录 docker history nginx:v2 003.使用Dockerfile构建镜像(注意后面有个点) docker build -t myip . 004.使用compose对docker容器进行编排管理时,需要编写docker-compose.yml文件需要注意缩进 yml文件换行后的缩进,不允许使用tab键字符,只能使用空格,而空格的数量要一致 005.docker-compose 负责实现对 Docker 容器集群的快速编排 006.docker-machine 负责在多种平台上快速安装docker环境 007.swarm mode 负责将多个docker主机封装为单个大型的虚拟dockerd主机,快速打造一套容器云平台 008.安装virtualbox sudo apt-get purge virtualbox sudo apt-get install linux-generic linux-image-generic linux-headers-generic linux-signed-generic sudo apt-get install virtualbox 009.docker镜像加速器下载速度对比 加速器 地址 Httpd,177MB下载镜像耗时 MySQL,407MB下载镜像耗时 Nginx,109MB下载镜像耗时 官方 https://registry.docker-cn.com 52 s 42 s 20 s 阿里 https://2lqq34jg.mirror.aliyuncs.com 36 s 38 s 20 s 网易 http://hub-mirror.c.163.com 67 s 73 s 475 s 官方错误 http://registry.docker-cn.com 1770 s 不忍测试 闲时再测 不使用 --- 一个字慢! 不忍测试 闲时再测 结论:1、使用加速器后,下载速度飞快,家庭100Mb宽带环境下,镜像下载速度能达到3-5MB/s以上。2、由于Docker采用分层文件系统,不同镜像公用一些相同的层文件,在下载后续镜像时下载速度更快,比如阿里加速器下载MySQL镜像,“达到”了10.7MB/s;3、加速器地址一定要写对,官方加速器的不能写成http,一定要写https,否则无加速效果;4、加速器的加速效果差不多?官方的、阿里的、网易163的加速器效果如下:阿里 >官方 > 网易 > 不加速5、Docker支持同时配置多个加速器,建议依上面的次序同时配置多个加速器。6、代码: { "registry-mirrors": [ "https://2lqq34jg.mirror.aliyuncs.com", "https://registry.docker-cn.com", "http://hub-mirror.c.163.com" ] } 010.docker的run命令 docker run -it -v /usr/java/:/mnt/software/ myubuntu /bin/bash docker run <相关参数> <镜像ID 或者 仓库名:标签名> <初始命令> 相关参数包括: -i:表示以“交互模式”运行容器 -t:表示容器启动后会进入其命令行 -v:表示需要将本地哪个目录挂载到容器中,格式:-v <宿主机目录>:<容器目录> 初始命令表示一旦容器启动,需要运行的命令,若此处命令使用"/bin/bash",则表示什么也不做,只需进入命令行即可 退出容器使用Ctrl+d或输入exit 再次启动已启动过但现在是关闭的容器 docker start 容器ID或容器名 这个命令只会启动容器,不会进入容器。要进入容器得用命令 docker attach 容器ID或容器名 011.docker如何查看已存在的容器所挂载的目录 docker inspect container_name | grep Mounts -A 20 012.docker启动mysql容器 初次启动需要指定root用户密码, 也可在docker-compose中指定, 直接用docker-compose启动 docker run -e MYSQL_ROOT_PASSWORD=root -p 33066:3306 --name mysql-5.7 -d mysql:5.7 -v /data/mysql/my.cnf:/etc/mysql/mysql.conf.d -v /data/mysql/logs:/usr/local/mysql/logs -v /data/mysql/data:/var/lib/mysql 013.docker进入mysql容器 docker exec -it mysql-5.7 bash # 然后进入mysql服务 mysql -uroot -p 014.docker启动tomcat docker run --mount source=tomcat-8.5-xyj,target=/usr/local/tomcat/webapps -p 8081:8080 --name tomcat-8.5 -d tomcat:8.5 015.DockerCompose通过compose工程名以及服务名从dockerEngine获取当前所有含有此标记的容器以检查当前工程所包含的服务状态,根据当前状态为每个服务制定接下来的动作 若容器不存在,则服务动作设置为创建(create) 若容器存在但设置不允许重建,则服务动作设置为启动(start) 若容器配置发生变化(config-hash)或者设置强制重建标志,则服务动作设置为重建(recreate) 若容器状态为停止,则服务动作设置为启动(start) 若容器状态为运行但其依赖容器需要重建,则服务状态设置为重建(recreate) 若容器状态为运行其无配置改变则不作操作 016.docker查看某个容器大小 进入docker容器默认位置:/var/lib/docker/containers, 文件夹名称即为容器名,文件夹大小即为容器大小 17. Docker参考网站 Docker Hub官方网站(用于查找各种镜像): https://hub.docker.com/docker-compose.yml文件各个参数的官方说明: https://docs.docker.com/compose/compose-file/ 18. Docker的各种docker-compose.yml文件 (1) MySQL version: "3.5" services: mysql: image: mysql:5.7 restart: always container_name: mysql environment: MYSQL_ROOT_PASSWORD: root ports: - "3306:3306" networks: mysql: ipv4_address: 172.20.0.2 volumes: - type: volume source: data target: /var/lib/mysql - type: volume source: config target: /etc/mysql/mysql.conf.d - type: volume source: logs target: /usr/local/mysql/logs volumes: data: config: logs: networks: mysql: driver: bridge name: mysql ipam: driver: default config: - subnet: 172.20.0.0/24 (2) Redis version: "3.5" services: redis: image: redis:4.0.9 restart: always container_name: redis volumes: - type: volume source: config target: /usr/local/etc/redis - type: volume source: data target: /data command: redis-server /usr/local/etc/redis/redis.conf ports: - "6379:6379" networks: redis: ipv4_address: 172.20.0.2 volumes: config: data: networks: redis: driver: bridge name: redis ipam: driver: default config: - subnet: 172.20.0.0/24 (3) Tomcat version: "3.5" services: blog: image: tomcat:8.5 restart: always container_name: blog ports: - "8083:8080" networks: - mysql volumes: - type: volume source: blog target: /usr/local/tomcat/webapps volumes: blog: name: blog networks: mysql: external: true name: mysql (4) Java示例(执行了java -jar /opt/blogback.jar命令, 方便启动容器后自动运行Java程序, 也可用于SpringBoot项目的部署) version: "3.5" services: blogback: image: java:8 restart: always container_name: blogback ports: - "8082:8080" working_dir: /opt command: java -jar /opt/blogback.jar networks: - mysql volumes: - type: volume source: blogback target: /opt volumes: blogback: name: blogback networks: mysql: external: true name: mysql (5) GitLab version: "3.5" services: gitlab: image: gitlab/gitlab-ce:10.5.4-ce.0 restart: always container_name: gitlab ports: - "8085:80" - "2222:22" hostname: "gitlab.ywz.com" environment: GITLAB_OMNIBUS_CONFIG: | gitlab_rails['gitlab_shell_ssh_port'] = 2222 volumes: - type: volume source: config target: /etc/gitlab - type: volume source: logs target: /var/log/gitlab - type: volume source: data target: /var/opt/gitlab volumes: config: name: gitlab_config logs: name: gitlab_logs data: name: gitlab_data (6) Jenkins version: "3.5" services: jenkins: image: jenkins:2.60.3 restart: always container_name: jenkins ports: - "8080:8080" volumes: - type: bind source: /home/paul/docker/myvolume/jenkins/home target: /var/jenkins_home (7) Nexus version: "3.5" services: nexus: image: sonatype/nexus3:3.8.0 restart: always container_name: nexus ports: - "8081:8081" volumes: - type: volume source: data target: /nexus-data volumes: data: (8) Nginx version: "3.5" services: nginx: image: nginx:1.13 restart: always container_name: nginx ports: - "80:80" volumes: - type: volume source: config target: /etc/nginx volumes: config: (9) Python version: "3.5" services: python: image: python:3.5 restart: always container_name: python tty: true command: bash volumes: - type: volume source: workspace target: /home - type: volume source: lib target: /usr/local/lib volumes: workspace: name: python_workspace lib: name: python_lib (10) 多个Tomcat项目共用MySQL, Redis示例 version: "3.5" services: jn: image: tomcat:8.5 restart: always container_name: tomcat_oa_jn ports: - "8082:8080" networks: - mysql_oa - redis_oa volumes: - type: bind source: /home/paul/docker/myvolume/tomcat_oa_jn/webapps target: /usr/local/tomcat/webapps depends_on: - mysql_oa - redis_oa xq: image: tomcat:8.5 restart: always container_name: tomcat_oa_xq ports: - "8083:8080" networks: - mysql_oa - redis_oa volumes: - type: bind source: /home/paul/docker/myvolume/tomcat_oa_xq/webapps target: /usr/local/tomcat/webapps depends_on: - mysql_oa - redis_oa test: image: tomcat:8.5 restart: always container_name: tomcat_oa_test ports: - "8084:8080" networks: - mysql_oa - redis_oa volumes: - type: bind source: /home/paul/docker/myvolume/tomcat_oa_test/webapps target: /usr/local/tomcat/webapps depends_on: - mysql_oa - redis_oa mysql_oa: image: mysql:5.7 restart: always container_name: mysql_oa environment: MYSQL_ROOT_PASSWORD: root ports: - "3307:3306" networks: mysql_oa: ipv4_address: 172.20.0.2 volumes: - type: volume source: mysql_data target: /var/lib/mysql - type: volume source: mysql_config target: /etc/mysql/mysql.conf.d - type: volume source: mysql_logs target: /usr/local/mysql/logs redis_oa: image: redis:4.0.9 restart: always container_name: redis_oa command: redis-server /usr/local/etc/redis/redis.conf ports: - "6379:6379" networks: redis: ipv4_address: 172.21.0.2 volumes: - type: volume source: redis_config target: /usr/local/etc/redis - type: volume source: redis_data target: /data volumes: mysql_data: name: mysql_oa_data mysql_config: name: mysql_oa_config mysql_logs: name: mysql_oa_logs redis_config: name: redis_oa_config redis_data: name: redis_oa_data networks: mysql_oa: driver: bridge name: mysql_oa ipam: driver: default config: - subnet: 172.20.0.0/24 redis_oa: driver: bridge name: redis_oa ipam: driver: default config: - subnet: 172.21.0.0/24 19. Dockerfile实现在centos7-jdk8容器中安装应用(以libreoffice为例) (1) Dockerfile文件 FROM bpatterson/centos7-jdk8 RUN yum update -y RUN yum install -y libreoffice-headless libreoffice-writer libreoffice-calc libreoffice- libreoffice-impress libreoffice-langpack-zh-Hans libreoffice-langpack-zh-Hant libreoffice-langpack-ja ImageMagick curl RUN yum clean all WORKDIR / (2) 在Dockerfile文件所在目录下执行如下命令生成镜像 docker build -t libreoffice:1.0 . (3) 镜像生成后就可以通过compose文件或者直接使用命令启动容器了 version: "3.3" services: libreoffice: image: libreoffice:1.0 restart: always tty: true command: /bin/bash container_name: libreoffice ports: - "8192:8080" volumes: - type: bind source: /home/libreoffice/data target: /home/libreoffice/data (4) 启动容器后运行容器内应用 docker exec -t libreoffice libreoffice --headless --convert-to pdf /home/libreoffice/data/source/test.xls --outdir /home/libreoffice/data/target (5) libreoffice功能实现附件格式转换, 如: xls文件转换为doc文件, doc文件转换为pdf文件等等.

优秀的个人博客,低调大师

EMR学习笔记(1)HDFS

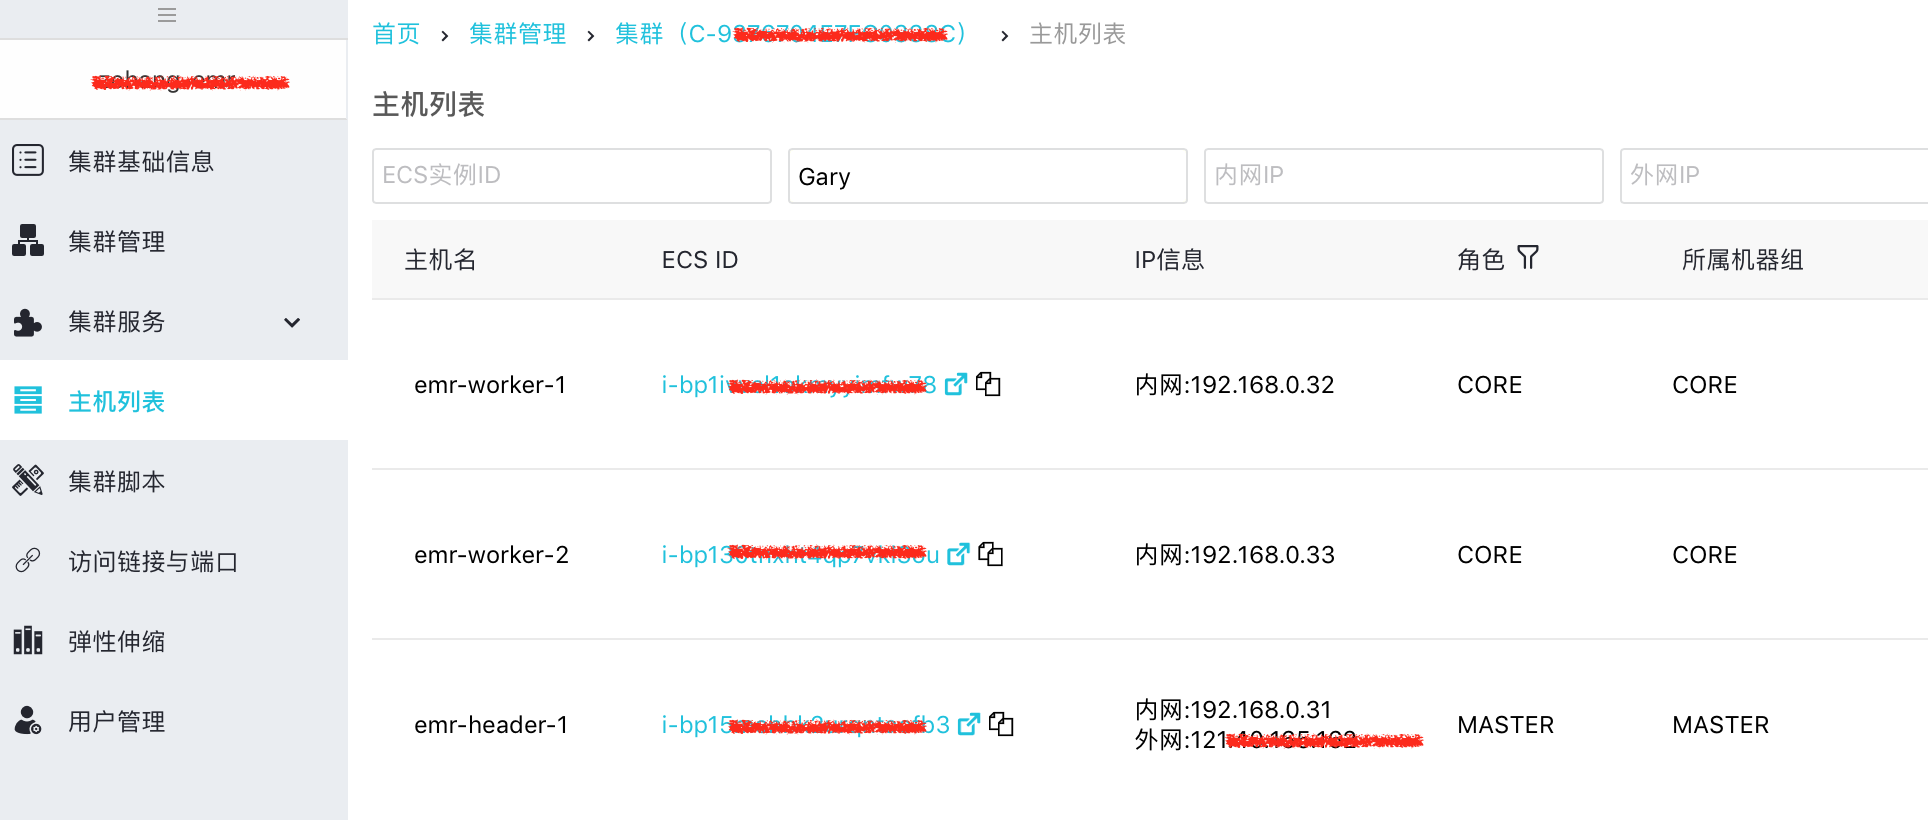
EMR HDFS Architecture 本文以非HA集群,2个worker的集群为例。 非HA集群,仅有一个Namenode实例,部署在Master节点。Namenode主要职责:-管理文件系统namespace,包括但不仅限于:开、关文件,文件改名,目录操作等。-管控客户端对文件的访问 EMR hadoop集群,每个Worker节点仅部署一个Datanode实例。Datanode主要职责:-管理所在节点挂载的存储-提供给客户端读写服务-block创建、删除以及replication 登录EMR集群实现基本运维 在较新的集群版本中(3.2 以上版本),所有的服务操作都可以通过集群的配置管理功能来完成。推荐优先使用 Web 页面的管理方式。 若您觉得在网页上的作业和执行计划无法满足您更加复杂的应用需求,您可以登录到 E-MapReduce 集群的主机上。找到集群的详情页,其中就有集群 master 机器的公网 IP 地址,您可以直接 SSH 登录到这台机器上,查看各种设置与状态。 登录 Master 主机步骤 使用如下命令 SSH 登录到 master 主机。请在集群详情页的主机信息栏中获取集群 master 机器的公网 IP。ssh root@ip.of.master 输入创建集群时设定的密码。 如何登录 Core 节点A:按照如下步骤: 首先在 Master 节点上切换到 Hadoop 账号:su hadoop 然后即可免密码 SSH 登录到对应的 Core 节点:ssh emr-worker-1 通过 sudo 可以获得 root 权限:sudo vi /etc/hosts 通过命令行方式启停服务进程操作用账号:hdfs NameNode (Master 节点) // 启动 /usr/lib/hadoop-current/sbin/hadoop-daemon.sh start namenode // 停止 /usr/lib/hadoop-current/sbin/hadoop-daemon.sh stop namenode DataNode (Core 节点) // 启动 /usr/lib/hadoop-current/sbin/hadoop-daemon.sh start datanode // 停止 /usr/lib/hadoop-current/sbin/hadoop-daemon.sh stop datanode 示例:登录实际emr集群演示停止datanode进程操作

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册