首页 文章 精选 留言 我的

精选列表

搜索[笔记软件],共10010篇文章
优秀的个人博客,低调大师

RabbitMQ消息队列学习笔记

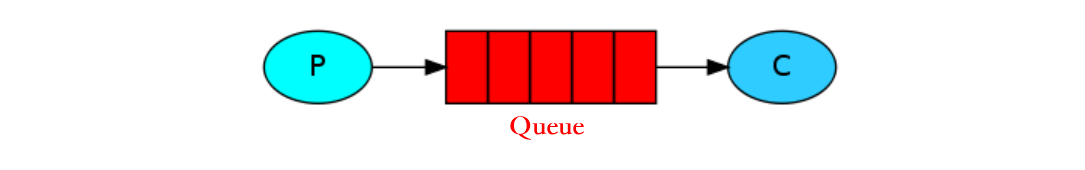
概述 初次使用AMQP的过程中,总是容易被AMQP支持的消息模型绕晕,这里结合官方的教程,对AMQP的消息模型做一个简要总结,供参考。目前官方给出了六种消息发送/接收模型,这里主要介绍前五种消息模型。 消息模型 1、Hello World 简单模式就是生产者将消息发送到队列、消费者从队列中获取消息。一条消息对应一个消费者。 示例代码说明: 测试使用的是阿里云的AMQP消息队列服务,具体的代码配置过程可以参考阿里云官方链接。 工具类 import AMQP.AliyunCredentialsProvider; import com.rabbitmq.client.Connection; import com.rabbitmq.client.ConnectionFactory; public class ConnectionUtil { pu

优秀的个人博客,低调大师

Android笔记(四) | View基础

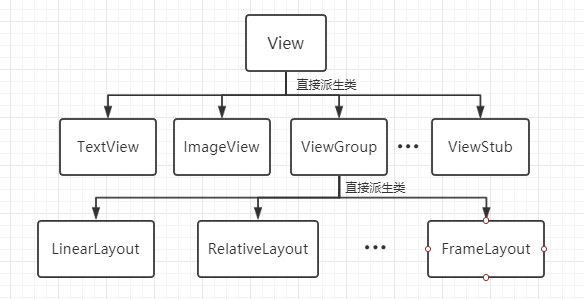
本文主要总结有关View的常用基础知识,作为V学习View相关内容的根基。 主要内容:View的位置参数、MotionEvent、TouchSlop对象、VelocityTracker、GestureDetector和Scroller对象。 View类 View类是Android中所有控件的基类,包括ViewGroup(控件组);这也就意味着,View本身可以是单个控件,也可以是包含多个控件的一组控件。 View的位置参数 View的位置主要由四个顶点决定,分别对应于四个属性:top、left、right、bottom。从Android3.0开始,增加了几个额外参数:x、y、translationx、translationY。这些参数都是相对于父容器的。 x:View发生平移后的左上角横坐标 y:View发生平移后的左上角纵坐标 translationX:View的横向偏移量(初始为0) translationY:View的纵向偏移量(初始为0) MotionEvent 手指触摸屏幕后的典型事件类型有: ACTION_DOWN——手指接触屏幕瞬间; ACTION_MOVE——手指在屏幕上滑动; ACTION_UP——手指离开屏幕瞬间; 通过MotionEvent对象可以得到点击事件发生的x、y坐标: getX()——获取触摸点相对于当前View左上角的横坐标; getY()——获取触摸点相对于当前View左上角的纵坐标; getRawX()——获取触摸点相对于手机屏幕左上角的横坐标; getRawY()——获取触摸点相对于手机屏幕左上角的纵坐标; TouchSlop TouchSlop是系统所能识别出的被认为是滑动的最小距离。 这是一个常量,和设备有关,在不同设备上这个值可能不同; 当手指在屏幕上滑动的距离小于这个值,系统就不会认为这是滑动操作; 获取方法: ViewConfiguration.get(getContext()).getScaledTouchSlop(); 这个常量的意义在于,当我们做滑动处理的时候,可以用它来做一些过滤。这样可以改善用户的使用体验。 VelocityTracker 速度追踪,用于追踪手指在滑动过程中的速度,包括水平和竖直方向的速度。下面是使用示例: @Override public boolean onTouchEvent(MotionEvent event) { //创建VelocityTracker对象,并将触摸界面的滑动事件 //加入到VelocityTracker当中。 VelocityTracker velocityTracker = VelocityTracker.obtain(); velocityTracker.addMovement(event); //指定时间间隔为1s,计算速度 velocityTracker.computeCurrentVelocity(1000); //获取水平速度和竖直速度(像素/s) int xVelocity = (int)velocityTracker.getXVelocity(); int yVelocity = (int)velocityTracker.getYVelocity(); //销毁对象,回收内存 velocityTracker.clear(); velocityTracker.recycle(); return super.onTouchEvent(event); } 速度 = (终点位置 - 起点位置)/时间段(可以为负值) GestureDetector 手势检测,用于辅助检测用户的单击、滑动、长按、双击等行为。下面是使用示例: public class MainActivity extends AppCompatActivity implements GestureDetector.OnGestureListener,GestureDetector.OnDoubleTapListener{ GestureDetector mGestureDetector; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); //首先,创建GestureDetector对象并根据需求实现OnGestureListener接口 //和OnDoubleTapListener接口 mGestureDetector = new GestureDetector(this,this); } @Override public boolean onTouchEvent(MotionEvent event) { //将目标View中的触摸事件交给GestureDetector处理(这里是MainActivity中的触摸事件) return mGestureDetector.onTouchEvent(event); } } 做完上面的事情之后,即可以选择性的实现OnGestureListener和OnDoubleTapListener中的方法了,这两个接口中的常用方法如下: 方法名 描述 所属接口 onDown 手指轻轻触摸屏幕瞬间,由一个ACTION_DOWN触发 OnGestureListener onSingleTapUp 手指(轻轻触摸屏幕后)松开,伴随一个ACTION_UP而触发,表示单击行为 OnGestureListener onScroll 手指按下屏幕并拖动,由一个ACTION_DOWN,多个ACTION_MOVE触发,表示拖动行为 OnGestureListener onFling 用户按下触摸屏,快速滑动后松开,由一个ACTION_DOWN、多个ACTION_MOVE和一个ACTION_UP触发,表示快速滑动行为 OnGestureListener onLoongPress 用户长久的按住屏幕不放,表示长按行为 OnGestureListener onDoubleTap 双击,由连续2次单击组成 OnDoubleTapListener 说明: 在实际开发中,可以不使用GestureDetector,完全可以自己在View中onTouchEvent方法中实现所需的监听。 建议:如果只是监听滑动相关,就在onTouchEvent中实现;如果要监听双击这种行为,就使用GestureDetector。

优秀的个人博客,低调大师

AndroidStudio笔记(2)插件介绍

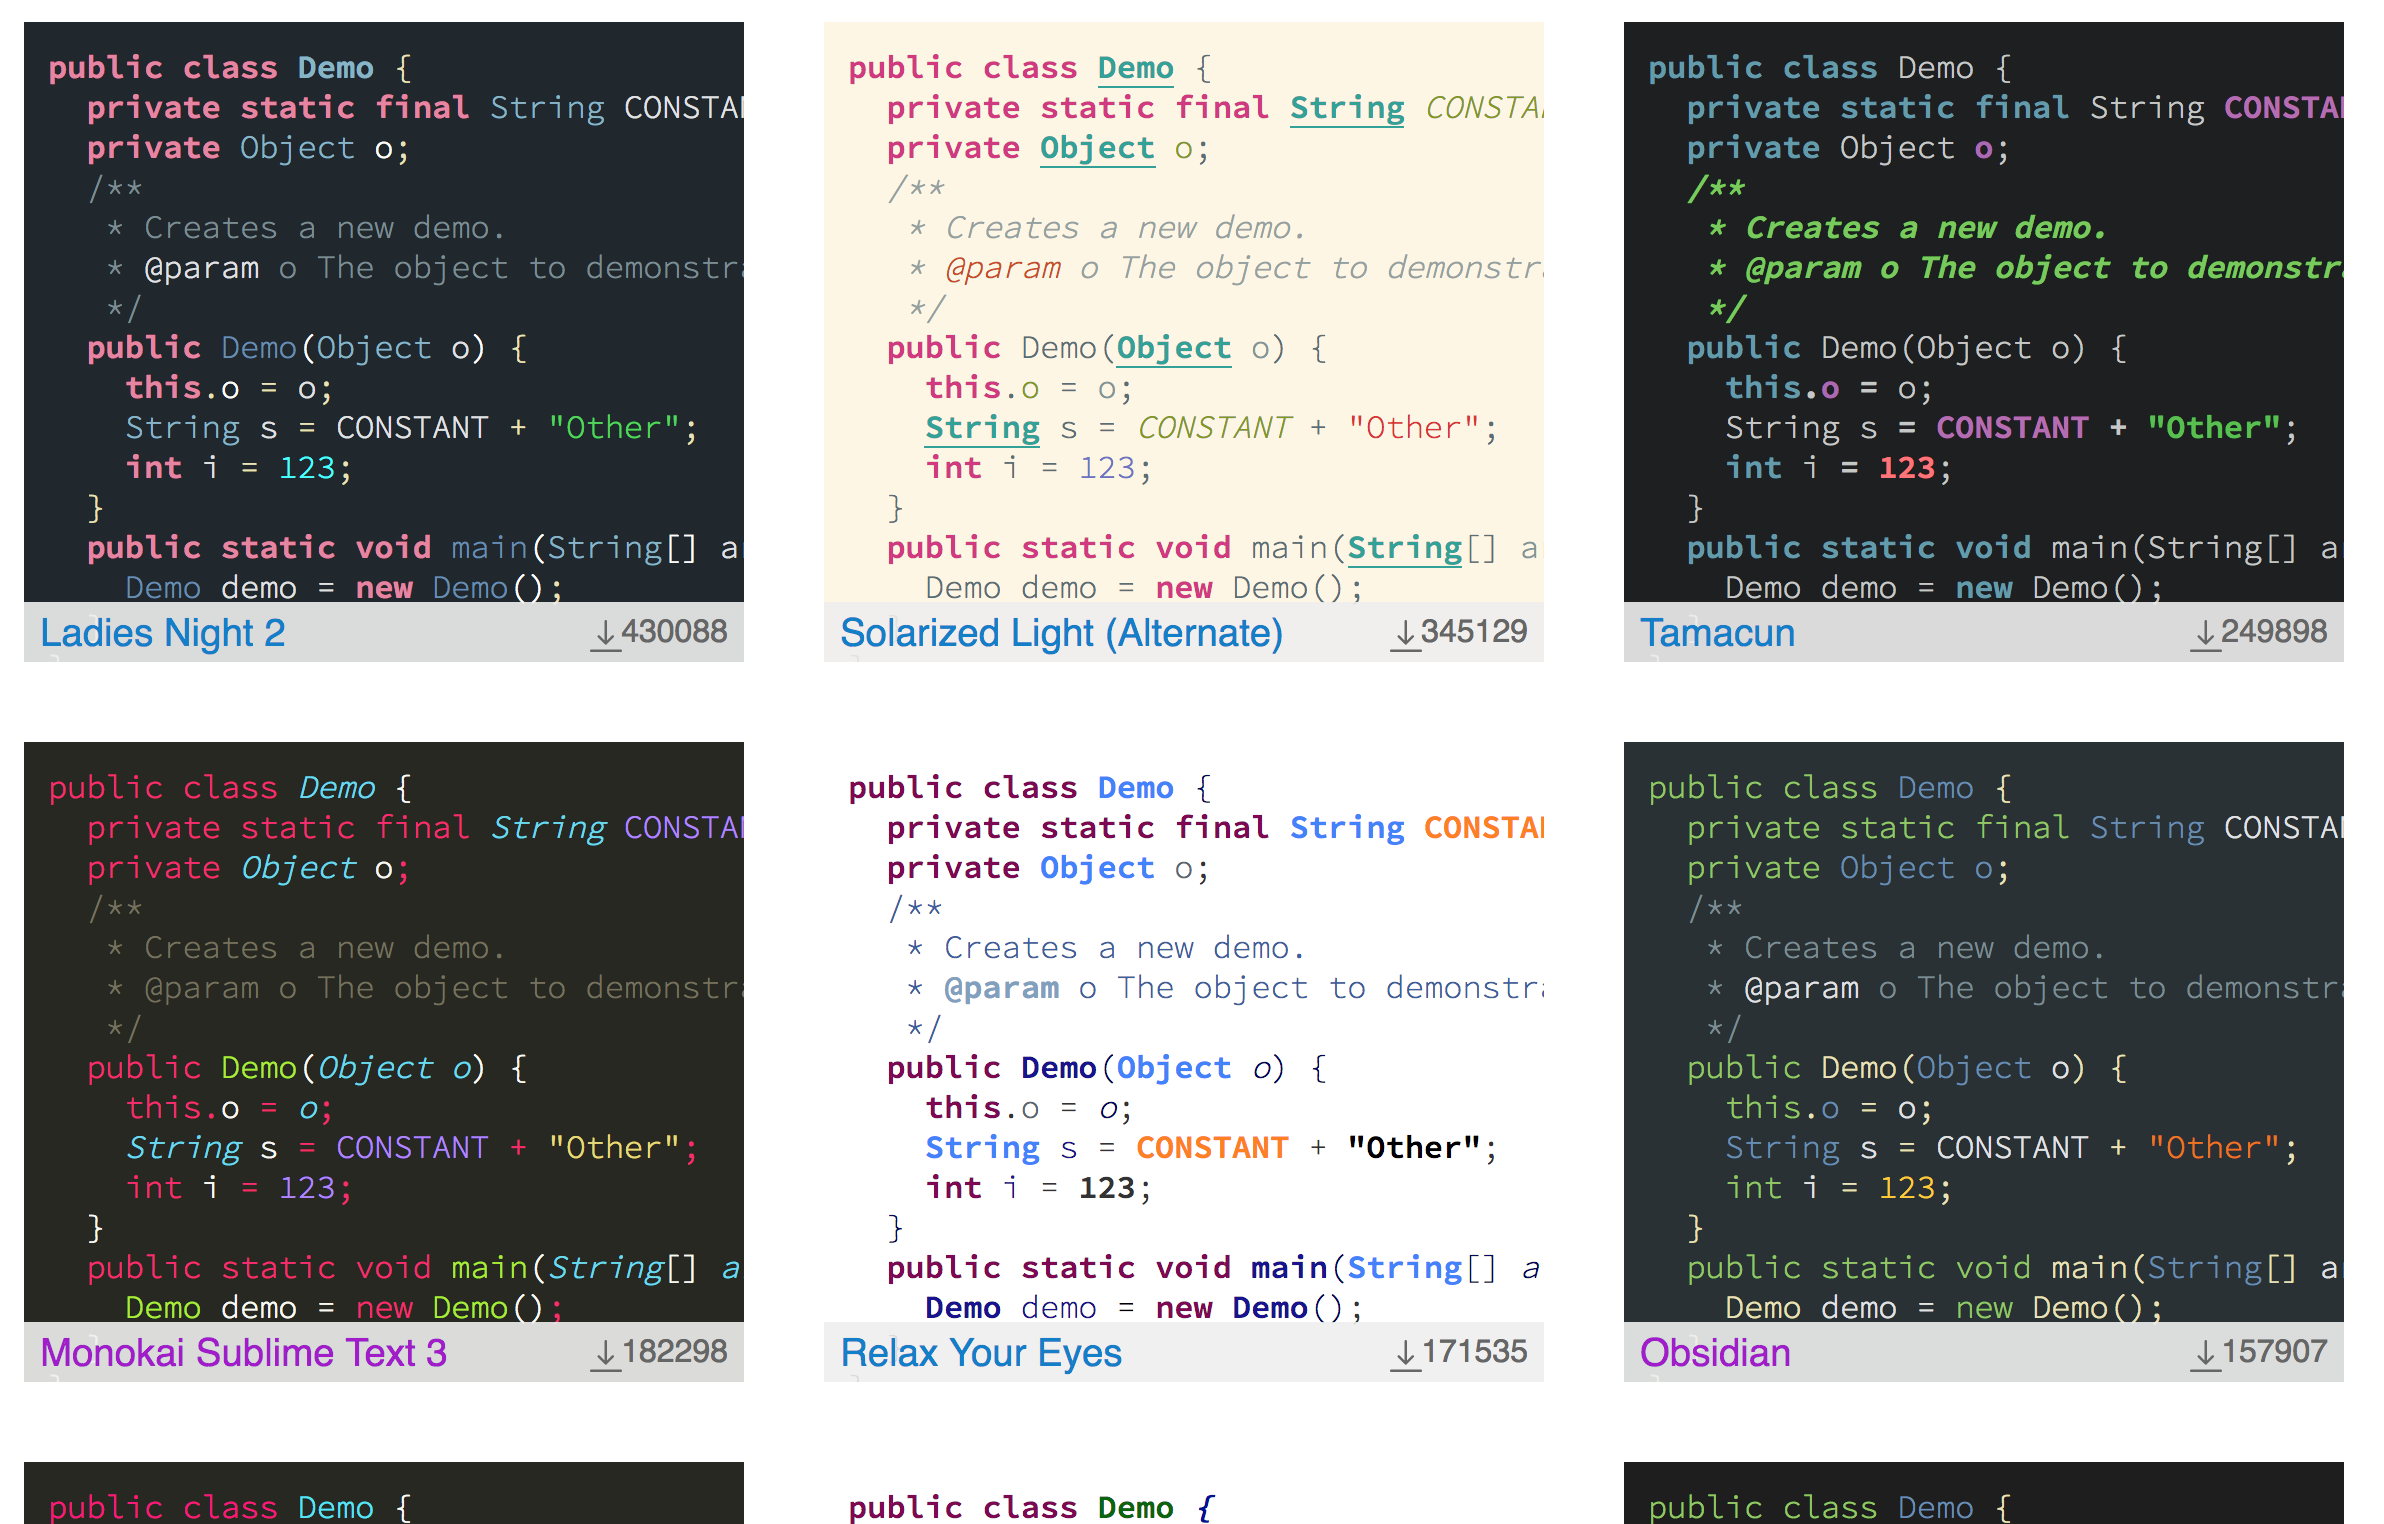
前言 Android Studio作为基于IDE的专业开发Android的开发工具,插件市场为我们提供了各种方便快捷、提高工作效率的插件,本文记录一些比较常用的插件。 插件 IDEA themes 严格意义上讲,这个并不算是插件,但是的确能为我们提供愉悦的编码心情。 就像这样的: ide themes 这里是地址:http://color-themes.com/ 1. 下载主题 选择你喜欢的主题进行下载,下载主题后会得到一个jar文件。 主题包 2. 导入主题 File –> Import Setttings –> 选中下载的主题jar文件 –> 确定->确定 –> 重启编译器 setting file GsonFormat 直接上图吧,将 JSON 字符串转换为Java实体bean GsonFormat GitHub地址 JsonToKotlinClass 与 GsonFormat 一样,对于使用 kotlin 开发的人也有类型的插件,能够直接将 JSON 字符串转换为 data class JsonToKotlinClass GitHub地址 CodeGlance 在编译器的右边会有一个小地图的菜单栏,我们可以直接通过点击、拖动来快速滑动代码。 CodeGlance GitHub地址 eventbus3-intellij-plugin 如果我们的项目中使用了EventBus3.0,那么使用这个插件我们就可以快速的在各个事件中切换,追踪调用链。 eventbus3-intellij-plugin GitHub地址 Android ButterKnife Zelezny 使用 Butter Knife 开发的伙伴会用得上,能够一键绑定 view 和 事件等。 Android ButterKnife Zelezny GitHub地址 RemoveButterKnife 这个插件可以移除 ButterKnife 的绑定,回归为原生,什么情况会使用到呢?比如说使用 kotlin 的时候,控件根本就不需要进行绑定了,直接通过id像使用变量那样直接调用即可。 RemoveButterKnife GitHub地址 .ignore 使用版本工具的时候肯定是需要忽略一些文件和文件夹不上传的,.ignore 为我们提供了更快捷的方式,直接右键加入忽略。 .ignore .ignore GitHub地址 Lifecycle Sorter 将 Activity 或者 Fragment 的生命周期方法进行排序。 GitHub地址 Key Promoter 对你当前的鼠标行为进行快捷键提示,比如点击 project 打开菜单栏的时候会进行提示你应该用什么快捷键,加入没有快捷键,也会提示让你自己设定快捷键,当初可是靠了它才熟悉了快捷键。 Key Promoter 1 Key Promoter 2 GitHub地址 AndroidProguardPlugin 一键生成 混淆 文件内容的插件,再也不怕到处找混淆 内容了: [图片上传失败...(image-e3adb7-1536677588455)] GitHub地址 最后 未完待续、敬请期待!我的博客地址 FullScreenDeveloper

优秀的个人博客,低调大师

【笔记】Python安装和使用

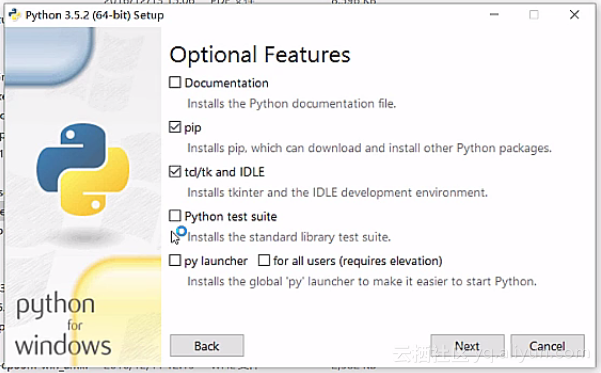
1.1.1 Python环境搭建 Python可应用于多平台包括Windows、 Linux/Unix 和 Mac OS。 Python下载 Python最新源码,二进制文档,新闻资讯等可以在Python的官网查看到: Python官网:http://www.python.org/ 你可以在以下链接中下载 Python 的文档,你可以下载 HTML、PDF 和 PostScript 等格式的文档。 Python文档下载地址:www.python.org/doc/ Unix & Linux 平台安装 Python:(源码式安装) 以下为在Unix & Linux 平台上安装 Python 的简单步骤: 打开WEB浏览器访问http://www.python.org/download/ 选择适用于Unix/Linux的源码压缩包。 下载及解压压缩包。 如果你需要自定义一些选项修改Modules/Setup 执行 ./configure 脚本 make make install 执行以上操作后,Python会安装在 /usr/local/bin 目录中,Python库安装在/usr/local/lib/pythonXX,XX为你使用的Python的版本号。 通过ubuntu官方的apt工具包安装 $ sudo apt-get install python $ sudo apt-get install python2.7 $ sudo apt-get install python3.6 Mac安装Python3 $ brew sreach python $ brew install python3 //在/usr/local/Cellar/这个目录下 Windows下直接下载安装就可以了 首先访问http://www.python.org/download/去下载最新的python版本 安装下载包,一路next,注意选择安装pip 为计算机添加安装目录搭到环境变量,如图把python的安装目录添加到pth系统变量中即可。 1.1.2 运行Python 有三种方式可以运行Python: 1、交互式解释器: 你可以通过命令行窗口进入python并开在交互式解释器中开始编写Python代码。 你可以在Unix,DOS或任何其他提供了命令行或者shell的系统进行python编码工作。 $ python # Unix/Linux 或者 C:>python # Windows/DOS 以下为Python命令行参数: 选项 描述 -d 在解析时显示调试信息 -O 生成优化代码 ( .pyo 文件 ) -S 启动时不引入查找Python路径的位置 -V 输出Python版本号 -X 从 1.6版本之后基于内建的异常(仅仅用于字符串)已过时。 -c cmd 执行 Python 脚本,并将运行结果作为 cmd 字符串。 file 在给定的python文件执行python脚本。 2、命令行脚本 在你的应用程序中通过引入解释器可以在命令行中执行Python脚本,如下所示: $ python script.py # Unix/Linux 或者 C:>python script.py # Windows/DOS 3、集成开发环境(IDE:Integrated Development Environment): PyCharm PyCharm 是由 JetBrains 打造的一款 Python IDE,支持 macOS、 Windows、 Linux 系统。 PyCharm 功能 : 调试、语法高亮、Project管理、代码跳转、智能提示、自动完成、单元测试、版本控制…… PyCharm 下载地址 :https://www.jetbrains.com/pycharm/download/

优秀的个人博客,低调大师

MyBatis学习笔记(一)入门

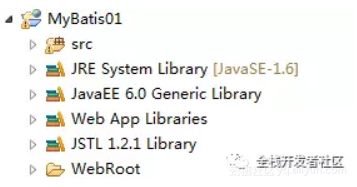
一、理解什么是MyBatis? MyBatis 是支持普通 SQL 查询,存储过程和高级映射的优秀持久层框架。 MyBatis 消除了几乎所有的 JDBC 代码和参数的手工设置以及对结果集的检索。 MyBatis 可以使用简单的XML 或注解用于配置和原始映射,将接口和 Java 的 POJO( Plain Old Java Objects,普通的Java 对象)映射成数据库中的记录. 1)MyBATIS 目前提供了三种语言实现的版本,包括:Java、.NET以及Ruby。(我主要学习java,就讲java的使用) 2)它提供的持久层框架包括SQL Maps和Data Access Objects(DAO)。 3)mybatis与hibernate的对比? mybatis提供一种“半自动化”的ORM实现。 这里的“半自动化”,是相对Hibernate等提供了全面的数据库封装机制的“全自动化”ORM实现而言,“全自动”ORM实现了POJO和数据库表之间的映射,以及 SQL 的自动生成和执行。 而mybatis的着力点,则在于POJO与SQL之间的映射关系。 二、简单例子(快速入门) 1)首先建立项目java web 2)导入mybatis所需的jar包 mybatis需要jar包:mybatis-3.3.0.jar mysql驱动jar包:mysql-connector-java-5.1.15.-bin.jar 日志记录jar包:log4j.jar 3)创建数据库数据(mysql) 4)mysql驱动配置文件(这样可以优化性能) 我个人喜欢把所需要使用到的包先建立好。配置文件先创建好。 5)添加mybatis配置文件mybatis.cfg.xml <?xml version="1.0"encoding="UTF-8"?> <!DOCTYPE configuration PUBLIC "-//mybatis.org//DTD Config 3.0//EN" "http://mybatis.org/dtd/mybatis-3-config.dtd"> <configuration> <!-- 引入外部配置文件 --> <propertiesresource="mysql.properties"></properties> <!-- 配置mybatis运行环境 --> <environmentsdefault="cybatis"> <environmentid="cybatis"> <!-- type="JDBC" 代表使用JDBC的提交和回滚来管理事务 --> <transactionManagertype="JDBC"/> <!-- mybatis提供了3种数据源类型,分别是:POOLED,UNPOOLED,JNDI --> <!-- POOLED 表示支持JDBC数据源连接池 --> <!-- UNPOOLED 表示不支持数据源连接池 --> <!-- JNDI 表示支持外部数据源连接池 --> <dataSourcetype="POOLED"> <propertyname="driver"value="${jdbc.driver}"/> <propertyname="url"value="${jdbc.url}"/> <propertyname="username"value="${jdbc.username}"/> <propertyname="password"value="${jdbc.password}"/> </dataSource> </environment> </environments> </configuration> 6)创建对应的实体对象 7)创建方法接口UserMapper.java和定义操作t_user表的sql映射文件UserMapper.xml 提供简单的增删改查数据信息。 packagecom.cy.mybatis.mapper; importjava.util.List; importcom.cy.mybatis.beans.UserBean; publicinterfaceUserMapper{ /** * 新增用戶 *@paramuser *@return *@throwsException */ publicintinsertUser(UserBean user)throwsException; /** * 修改用戶 *@paramuser *@paramid *@return *@throwsException */ publicintupdateUser(UserBean user,intid)throwsException; /** * 刪除用戶 *@paramid *@return *@throwsException */ publicintdeleteUser(intid)throwsException; /** * 根据id查询用户信息 *@paramid *@return *@throwsException */ publicUserBeanselectUserById(intid)throwsException; /** * 查询所有的用户信息 *@return *@throwsException */ publicList<UserBean>selectAllUser()throwsException; } UserMapper.xml <?xml version="1.0"encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org/DTD Mapper 3.0" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mappernamespace="com.cy.mybatis.mapper.UserMapper"> <!-- 自定义返回结果集 --> <resultMapid="userMap"type="UserBean"> <idproperty="id"column="id"javaType="java.lang.Integer"></id> <resultproperty="username"column="username"javaType="java.lang.String"></result> <resultproperty="password"column="password"javaType="java.lang.String"></result> <resultproperty="account"column="account"javaType="java.lang.Double"></result> </resultMap> <!-- 在各种标签中的id属性必须和接口中的方法名相同 , id属性值必须是唯一的,不能够重复使用。parameterType属性指明查询时使用的参数类型,resultType属性指明查询返回的结果集类型--> <!-- useGeneratedKeys:( 仅 对 insert 有 用 ) 这 会 告 诉 MyBatis 使 用 JDBC 的getGeneratedKeys 方法来取出由数据(比如:像 MySQL 和 SQLServer 这样的数据库管理系统的自动递增字段)内部生成的主键。默认值: false。 --> <!--keyProperty: (仅对 insert有用)标记一个属性, MyBatis 会通过 getGeneratedKeys或者通过 insert 语句的 selectKey 子元素设置它的值。默认:不设置。 --> <!--#{}中的内容,为占位符,当参数为某个JavaBean时,表示放置该Bean对象的属性值 --> <insertid="insertUser"useGeneratedKeys="true"keyProperty="id"> insert into t_user (username,password,account) values (#{username},#{password},#{account}) </insert> <updateid="updateUser"> update t_user set username=#{username},password=#{password},account=#{account} where id=#{id} </update> <deleteid="deleteUser"parameterType="int"> delete from t_user where id=#{id} </delete> <selectid="selectUserById"parameterType="int"resultMap="userMap"> select * from t_user where id=#{id} </select> <selectid="selectAllUser"resultMap="userMap"> select * from t_user </select> </mapper> 这时需要为mybatis.cfg.xml里注册UserMapper.xml文件。 <?xml version="1.0"encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org/DTD Mapper 3.0" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mappernamespace="com.cy.mybatis.mapper.UserMapper"> <!-- 自定义返回结果集 --> <resultMapid="userMap"type="UserBean"> <idproperty="id"column="id"javaType="java.lang.Integer"></id> <resultproperty="username"column="username"javaType="java.lang.String"></result> <resultproperty="password"column="password"javaType="java.lang.String"></result> <resultproperty="account"column="account"javaType="java.lang.Double"></result> </resultMap> <!-- 在各种标签中的id属性必须和接口中的方法名相同 , id属性值必须是唯一的,不能够重复使用。parameterType属性指明查询时使用的参数类型,resultType属性指明查询返回的结果集类型--> <!-- useGeneratedKeys:( 仅 对 insert 有 用 ) 这 会 告 诉 MyBatis 使 用 JDBC 的getGeneratedKeys 方法来取出由数据(比如:像 MySQL 和 SQLServer 这样的数据库管理系统的自动递增字段)内部生成的主键。默认值: false。 --> <!--keyProperty: (仅对 insert有用)标记一个属性, MyBatis 会通过 getGeneratedKeys或者通过 insert 语句的 selectKey 子元素设置它的值。默认:不设置。 --> <!--#{}中的内容,为占位符,当参数为某个JavaBean时,表示放置该Bean对象的属性值 --> <insertid="insertUser"useGeneratedKeys="true"keyProperty="id"> insert into t_user (username,password,account) values (#{username},#{password},#{account}) </insert> <updateid="updateUser"> update t_user set username=#{username},password=#{password},account=#{account} where id=#{id} </update> <deleteid="deleteUser"parameterType="int"> delete from t_user where id=#{id} </delete> <selectid="selectUserById"parameterType="int"resultMap="userMap"> select * from t_user where id=#{id} </select> <selectid="selectAllUser"resultMap="userMap"> select * from t_user </select> </mapper> 8)需要建立一个工具类文件 packagecom.cy.mybatis.tools; importjava.io.Reader; importorg.apache.ibatis.io.Resources; importorg.apache.ibatis.session.SqlSession; importorg.apache.ibatis.session.SqlSessionFactory; importorg.apache.ibatis.session.SqlSessionFactoryBuilder; publicclassDBTools{ publicstaticSqlSessionFactory sessionFactory; static{ try{ //使用MyBatis提供的Resources类加载mybatis的配置文件 Reader reader = Resources.getResourceAsReader("mybatis.cfg.xml"); //构建sqlSession的工厂 sessionFactory =newSqlSessionFactoryBuilder().build(reader); }catch(Exception e) { e.printStackTrace(); } } //创建能执行映射文件中sql的sqlSession publicstaticSqlSessiongetSession(){ returnsessionFactory.openSession(); } } 9)写个测试 package com.cy.mybatis.service; importjava.util.List; importorg.apache.ibatis.session.SqlSession; importcom.cy.mybatis.beans.UserBean; importcom.cy.mybatis.tools.DBTools; importcom.cy.mybatis.mapper.UserMapper; publicclassUserService{ 15 publicstaticvoidmain(String[] args) { insertUser(); // deleteUser(); // selectUserById(); // selectAllUser(); } /** * 新增用户 */ privatestaticvoidinsertUser() { SqlSession session = DBTools.getSession(); UserMapper mapper = session.getMapper(UserMapper.class); UserBean user =newUserBean("懿","1314520",7000.0); try{ mapper.insertUser(user); System.out.println(user.toString()); session.commit(); }catch(Exception e) { e.printStackTrace(); session.rollback(); } } /** * 删除用户 */ privatestaticvoiddeleteUser(){ SqlSession session=DBTools.getSession(); UserMapper mapper=session.getMapper(UserMapper.class); try{ mapper.deleteUser(1); session.commit(); }catch(Exception e) { e.printStackTrace(); session.rollback(); } } /** * 根据id查询用户 */ privatestaticvoidselectUserById(){ SqlSession session=DBTools.getSession(); UserMapper mapper=session.getMapper(UserMapper.class); try{ UserBean user= mapper.selectUserById(2); System.out.println(user.toString()); session.commit(); }catch(Exception e) { e.printStackTrace(); session.rollback(); } } /** * 查询所有的用户 */ privatestaticvoidselectAllUser(){ SqlSession session=DBTools.getSession(); UserMapper mapper=session.getMapper(UserMapper.class); try{ List<UserBean> user=mapper.selectAllUser(); System.out.println(user.toString()); session.commit(); }catch(Exception e) { e.printStackTrace(); session.rollback(); } } } 测试结果 insert。 原文发布时间为:2018-08-29本文来自云栖社区合作伙伴“ 全栈开发者社区”,了解相关信息可以关注“ 全栈开发者社区”。

优秀的个人博客,低调大师

(一)Java并发学习笔记

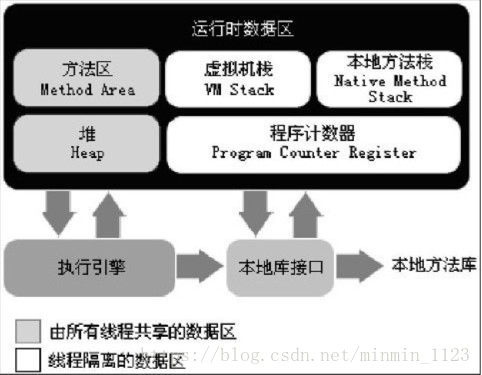
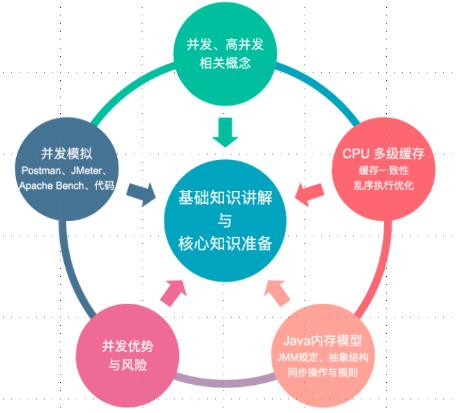
一、课程导学 二、基本概念 并发:同时拥有两个或者多个线程,如果程序在单核处理器上运行,多个线程将交替地换入或者换出内存,这些线程是同时“存在”的,每个线程都处于执行过程中的某个状态,高速切换感觉同时执行。如果运行多核处理器上,此时,程序中的每个线程将分配到一个处理器核上,因此可以真正的同时运行。 高并发:高并发(High Cuncurrency)是互联网分布式系统架构设计中必须考虑的因素之一,它通常是指,通过设计保证系统能够 同时并发处理 很多请求。 其实当我们讨论并发时主要关注的是以下几点: 多线程操作相同的资源 保证线程安全 合理分配和使用资源 而在讨论高并发是关注的是以下几点: 服务器能同时处理很多个请求 提高程序性能 比如在12306抢票,淘宝双11等都需要考虑高并发 三、并发编程基础 在单核时代处理器做出的乱序优化不会导致执行结果远离预期目标,但在多核环境下却并非如此。在多核时代,由多核cpu同时执行指令,同时还引入的l1、l2等缓存机制,每个核都有自己的缓存,就导致了逻辑顺序上后写入的数据未必真的最后写入。如果我们不做任何防护措施,就会出现处理器得出的结果和我们逻辑得出的结果大不相同。 比如:我们在一个cpu核心上执行写入操作,并在最后写入一个标记来表示该操作已经写入好了。然后从另外一个核上通过判断这个标记来确定所需要的数据是否已经就绪,这种做法就存在一定风险:标记位先被写入但数据操作并未完成。导致另外一个核使用了错误数据。 四、Java内存模型(Java Memory Model,JMM) 内存模型可以理解为在特定的操作协议下,对特定的内存或者高速缓存进行读写访问的过程抽象,不同架构下的物理机拥有不一样的内存模型,Java虚拟机也有自己的内存模型,即Java内存模型(Java Memory Model, JMM)。 在C/C++语言中直接使用物理硬件和操作系统内存模型,导致不同平台下并发访问出错。而JMM的出现,能够屏蔽掉各种硬件和操作系统的内存访问差异,实现平台一致性,是的Java程序能够“一次编写,到处运行”。 堆内存(Heap): 存放实例域, 静态域, 数组元素. 在线程间共享. 栈内存(Stack): 存放局部变量, 方法定义参数和异常处理器参数. 线程A和线程B要进行通信,必须先将数据刷新到主内存,线程B再从主内存读取线程A更新过的变量。 模拟场景: 比如多个线程同时修改一个变量:线程A 先从主内存中获取共享变量(a=2),然后在自己本地内存中计算(a+2),然后写入到主内存。 但此时B也从主内存获取(a=2),在本地内存改变(a+2).写入到主内存。 在计算过程中两个线程间的数据是不可见的,此时就会出现结果不正确情况。 Java内存模型-同步操作与规则 由上面的交互关系可知,关于主内存与工作内存之间的具体交互协议,即一个变量如何从主内存拷贝到工作内存、如何从工作内存同步到主内存之间的实现细节,Java内存模型定义了以下八种操作来完成: lock(锁定):作用于主内存的变量,把一个变量标识为一条线程独占状态。 unlock(解锁):作用于主内存变量,把一个处于锁定状态的变量释放出来,释放后的变量才可以被其他线程锁定。 read(读取):作用于主内存变量,把一个变量值从主内存传输到线程的工作内存中,以便随后的load动作使用 load(载入):作用于工作内存的变量,它把read操作从主内存中得到的变量值放入工作内存的变量副本中。 use(使用):作用于工作内存的变量,把工作内存中的一个变量值传递给执行引擎,每当虚拟机遇到一个需要使用变量的值的字节码指令时将会执行这个操作。 assign(赋值):作用于工作内存的变量,它把一个从执行引擎接收到的值赋值给工作内存的变量,每当虚拟机遇到一个给变量赋值的字节码指令时执行这个操作。 store(存储):作用于工作内存的变量,把工作内存中的一个变量的值传送到主内存中,以便随后的write的操作。 write(写入):作用于主内存的变量,它把store操作从工作内存中一个变量的值传送到主内存的变量中。 Java内存模型还规定了在执行上述八种基本操作时,必须满足如下规则: 不允许read和load、store和write操作之一单独出现 不允许一个线程丢弃它的最近assign的操作,即变量在工作内存中改变了之后必须同步到主内存中。 不允许一个线程无原因地(没有发生过任何assign操作)把数据从工作内存同步回主内存中。 一个新的变量只能在主内存中诞生,不允许在工作内存中直接使用一个未被初始化(load或assign)的变量。即就是对一个变量实施use和store操作之前,必须先执行过了assign和load操作。 一个变量在同一时刻只允许一条线程对其进行lock操作,lock和unlock必须成对出现 如果对一个变量执行lock操作,将会清空工作内存中此变量的值,在执行引擎使用这个变量前需要重新执行load或assign操作初始化变量的值 如果一个变量事先没有被lock操作锁定,则不允许对它执行unlock操作;也不允许去unlock一个被其他线程锁定的变量。 对一个变量执行unlock操作之前,必须先把此变量同步到主内存中(执行store和write操作)。 这8种内存访问操作很繁琐,后文会使用一个等效判断原则,即先行发生(happens-before)原则来确定一个内存访问在并发环境下是否安全。 五、并发的优势和风险 六、线程安全性 线程安全性主要体现在三个方面: 1. 原子性: 原子是世界上的最小单位,具有不可分割性。比如 a=0;(a非long和double类型)这个操作是不可分割的,那么我们说这个操作时原子操作。再比如:a++;这个操作实际是a = a + 1;是可分割的,所以他不是一个原子操作。非原子操作都会存在线程安全问题,需要我们使用同步技术(sychronized)来让它变成一个原子操作。一个操作是原子操作,那么我们称它具有原子性。java的concurrent包下提供了一些原子类,我们可以通过阅读API来了解这些原子类的用法。比如:AtomicInteger、AtomicLong、AtomicReference等。 Atomicxxx底层工作原理: 借助于Unsafe.compareAndSwapInt: CAS实现, 每次执行计算之前都会拿当前工作内存中的值和主内存的值比较,如果不相同就会从新从主内存中获取最新值赋值给当前对象,直到相同执行对应操作。 sun.misc.Unsafe源码: public final int getAndAddInt(Object var1, long var2, int var4) { int var5; do { var5 = this.getIntVolatile(var1, var2); } while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4)); return var5; } AtomicLong和AtomicAddr AtomicLong的原理是依靠底层的cas来保障原子性的更新数据,在要添加或者减少的时候,会使用死循环不断地cas到特定的值,从而达到更新数据的目的。在竞争不激烈时修改成功的概率很高,否则修改失败的概率就很高,在大量修改失败的情况下,这些原子操作就会进行大量的失败重尝试,性能就会受到影响。 总结: LongAdder在AtomicLong的基础上将单点的更新压力分散到各个节点,在低并发的时候通过对base的直接更新可以很好的保障和AtomicLong的性能基本保持一致,而在高并发的时候通过分散提高了性能。 缺点是LongAdder在统计的时候如果有并发更新,可能导致统计的数据有误差。 实际使用中在处理高并发计数时,推荐使用LongAddr,但如果遇到类似于序列号生成这种需要全局唯一的数据情况就需要使用AtomicLong. AtomicReference AtomicReference和AtomicInteger非常类似,不同之处就在于AtomicInteger是对整数的封装,而AtomicReference则对应普通的对象引用。也就是它可以保证你在修改对象引用时的线程安全性。在介绍AtomicReference的同时,我希望同时提出一个有关原子操作的逻辑上的不足。 之前我们说过,线程判断被修改对象是否可以正确写入的条件是对象的当前值和期望是否一致。这个逻辑从一般意义上来说是正确的。但有可能出现一个小小的例外,就是当你获得对象当前数据后,在准备修改为新值前,对象的值被其他线程连续修改了2次,而经过这2次修改后,对象的值又恢复为旧值。这样,当前线程就无法正确判断这个对象究竟是否被修改过。如图4.2所示,显示了这种情况。(ABA问题) 图4.2 对象值被反复修改回原数据 一般来说,发生这种情况的概率很小。而且即使发生了,可能也不是什么大问题。比如,我们只是简单得要做一个数值加法,即使在我取得期望值后,这个数字被不断的修改,只要它最终改回了我的期望值,我的加法计算就不会出错。也就是说,当你修改的对象没有过程的状态信息,所有的信息都只保存于对象的数值本身。 但是,在现实中,还可能存在另外一种场景。就是我们是否能修改对象的值,不仅取决于当前值,还和对象的过程变化有关,这时,AtomicReference就无能为力了。 打一个比方,如果有一家蛋糕店,为了挽留客户,绝对为贵宾卡里余额小于20元的客户一次性赠送20元,刺激消费者充值和消费。但条件是,每一位客户只能被赠送一次。 现在,我们就来模拟这个场景,为了演示AtomicReference,我在这里使用AtomicReference实现这个功能。首先,我们模拟用户账户余额。 static AtomicReference<Integer> money=newAtomicReference<Integer>(); // 设置账户初始值小于20,显然这是一个需要被充值的账户 money.set(19); 接着,我们需要若干个后台线程,它们不断扫描数据,并为满足条件的客户充值。 01 //模拟多个线程同时更新后台数据库,为用户充值 02 for(int i = 0 ; i < 3 ; i++) { 03 new Thread(){ 04 publicvoid run() { 05 while(true){ 06 while(true){ 07 Integer m=money.get(); 08 if(m<20){ 09 if(money.compareAndSet(m, m+20)){ 10 System.out.println("余额小于20元,充值成功,余额:"+money.get()+"元"); 11 break; 12 } 13 }else{ 14 //System.out.println("余额大于20元,无需充值"); 15 break ; 16 } 17 } 18 } 19 } 20 }.start(); 21 } 上述代码第8行,判断用户余额并给予赠予金额。如果已经被其他用户处理,那么当前线程就会失败。因此,可以确保用户只会被充值一次。 此时,如果很不幸的,用户正好正在进行消费,就在赠予金额到账的同时,他进行了一次消费,使得总金额又小于20元,并且正好累计消费了20元。使得消费、赠予后的金额等于消费前、赠予前的金额。这时,后台的赠予进程就会误以为这个账户还没有赠予,所以,存在被多次赠予的可能。下面,模拟了这个消费线程: 01 //用户消费线程,模拟消费行为 02 new Thread() { 03 public voidrun() { 04 for(inti=0;i<100;i++){ 05 while(true){ 06 Integer m=money.get(); 07 if(m>10){ 08 System.out.println("大于10元"); 09 if(money.compareAndSet(m, m-10)){ 10 System.out.println("成功消费10元,余额:"+money.get()); 11 break; 12 } 13 }else{ 14 System.out.println("没有足够的金额"); 15 break; 16 } 17 } 18 try{Thread.sleep(100);} catch (InterruptedException e) {} 19 } 20 } 21 }.start(); 上述代码中,消费者只要贵宾卡里的钱大于10元,就会立即进行一次10元的消费。执行上述程序,得到的输出如下: 余额小于20元,充值成功,余额:39元 大于10元 成功消费10元,余额:29 大于10元 成功消费10元,余额:19 余额小于20元,充值成功,余额:39元 大于10元 成功消费10元,余额:29 大于10元 成功消费10元,余额:39 余额小于20元,充值成功,余额:39元 从这一段输出中,可以看到,这个账户被先后反复多次充值。其原因正是因为账户余额被反复修改,修改后的值等于原有的数值。使得CAS操作无法正确判断当前数据状态。 虽然说这种情况出现的概率不大,但是依然是有可能的出现的。因此,当业务上确实可能出现这种情况时,我们也必须多加防范。体贴的JDK也已经为我们考虑到了这种情况,使用AtomicStampedReference就可以很好的解决这个(ABA)问题。 ABA问题:简单讲就是多线程环境,2次读写中一个线程修改A->B,然后又B->A,另一个线程看到的值未改变,又继续修改成自己的期望值。当然我们如果不关心过程,只关心结果,那么这个就是无所谓的ABA问题。 为了解决ABA问题,伟大的java为我们提供了AtomicMarkableReference和AtomicStampedReference类,为我们解决了问题 AtomicStampedReference是利用版本戳的形式记录了每次改变以后的版本号,这样的话就不会存在ABA问题了,在这里我借鉴一下别人举得例子 举个通俗点的例子,你倒了一杯水放桌子上,干了点别的事,然后同事把你水喝了又给你重新倒了一杯水,你回来看水还在,拿起来就喝,如果你不管水中间被人喝过,只关心水还在,这就是ABA问题。如果你是一个讲卫生讲文明的小伙子,不但关心水在不在,还要在你离开的时候水被人动过没有,因为你是程序员,所以就想起了放了张纸在旁边,写上初始值0,别人喝水前麻烦先做个累加才能喝水。这就是AtomicStampedReference的解决方案。 Synchronized关键字 在Java中,synchronized关键字是用来控制线程同步的,就是在多线程的环境下,控制synchronized代码段不被多个线程同时执行。 1. 修饰方法 Synchronized修饰一个方法很简单,就是在方法的前面加synchronized,synchronized修饰方法和修饰一个代码块类似,只是作用范围不一样,修饰代码块是大括号括起来的范围,而修饰方法范围是整个函数。 public synchronized void method() { // todo } 写法一修饰的是一个方法,锁定了整个方法时的内容。 synchronized关键字不能继承。 虽然可以使用synchronized来定义方法,但synchronized并不属于方法定义的一部分,因此,synchronized关键字不能被继承。如果在父类中的某个方法使用了synchronized关键字,而在子类中覆盖了这个方法,在子类中的这个方法默认情况下并不是同步的,而必须显式地在子类的这个方法中加上synchronized关键字才可以。当然,还可以在子类方法中调用父类中相应的方法,这样虽然子类中的方法不是同步的,但子类调用了父类的同步方法,因此,子类的方法也就相当于同步了。这两种方式的例子代码如下: 在子类方法中加上synchronized关键字 class Parent { public synchronized void method() { } } class Child extends Parent { public synchronized void method() { } } 在子类方法中调用父类的同步方法 class Parent { public synchronized void method() { } } class Child extends Parent { public void method() { super.method(); } } 在定义接口方法时不能使用synchronized关键字。 构造方法不能使用synchronized关键字,但可以使用synchronized代码块来进行同步。 2. 修饰代码块 1) 一个线程访问一个对象中的synchronized(this)同步代码块时,其他试图访问该对象的线程将被阻塞 注意下面两个程序的区别 class SyncThread implements Runnable { private static int count; public SyncThread() { count = 0; } public void run() { synchronized(this) { for (int i = 0; i < 5; i++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } } public int getCount() { return count; } } public class Demo00 { public static void main(String args[]){ //test01 // SyncThread s1 = new SyncThread(); // SyncThread s2 = new SyncThread(); // Thread t1 = new Thread(s1); // Thread t2 = new Thread(s2); //test02 SyncThread s = new SyncThread(); Thread t1 = new Thread(s); Thread t2 = new Thread(s); t1.start(); t2.start(); } } test01的运行结果 test02的运行结果 当两个并发线程(thread1和thread2)访问同一个对象(syncThread)中的synchronized代码块时,在同一时刻只能有一个线程得到执行,另一个线程受阻塞,必须等待当前线程执行完这个代码块以后才能执行该代码块。Thread1和thread2是互斥的,因为在执行synchronized代码块时会锁定当前的对象,只有执行完该代码块才能释放该对象锁,下一个线程才能执行并锁定该对象 为什么上面的例子中thread1和thread2同时在执行。这是因为synchronized只锁定对象,每个对象只有一个锁(lock)与之相关联。 2) 当一个线程访问对象的一个synchronized(this)同步代码块时,另一个线程仍然可以访问该对象中的非synchronized(this)同步代码块。 例: class Counter implements Runnable{ private int count; public Counter() { count = 0; } public void countAdd() { synchronized(this) { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } } //非synchronized代码块,未对count进行读写操作,所以可以不用synchronized public void printCount() { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + " count:" + count); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } public void run() { String threadName = Thread.currentThread().getName(); if (threadName.equals("A")) { countAdd(); } else if (threadName.equals("B")) { printCount(); } } } public class Demo00{ public static void main(String args[]){ Counter counter = new Counter(); Thread thread1 = new Thread(counter, "A"); Thread thread2 = new Thread(counter, "B"); thread1.start(); thread2.start(); } } 运行结果 可以看见B线程的调用是非synchronized,并不影响A线程对synchronized部分的调用。从上面的结果中可以看出一个线程访问一个对象的synchronized代码块时,别的线程可以访问该对象的非synchronized代码块而不受阻塞。 3)指定要给某个对象加锁 /** * 银行账户类 */ class Account { String name; float amount; public Account(String name, float amount) { this.name = name; this.amount = amount; } //存钱 public void deposit(float amt) { amount += amt; try { Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } //取钱 public void withdraw(float amt) { amount -= amt; try { Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } public float getBalance() { return amount; } } /** * 账户操作类 */ class AccountOperator implements Runnable{ private Account account; public AccountOperator(Account account) { this.account = account; } public void run() { synchronized (account) { account.deposit(500); account.withdraw(500); System.out.println(Thread.currentThread().getName() + ":" + account.getBalance()); } } } public class Demo00{ //public static final Object signal = new Object(); // 线程间通信变量 //将account改为Demo00.signal也能实现线程同步 public static void main(String args[]){ Account account = new Account("zhang san", 10000.0f); AccountOperator accountOperator = new AccountOperator(account); final int THREAD_NUM = 5; Thread threads[] = new Thread[THREAD_NUM]; for (int i = 0; i < THREAD_NUM; i ++) { threads[i] = new Thread(accountOperator, "Thread" + i); threads[i].start(); } } } 运行结果 在AccountOperator 类中的run方法里,我们用synchronized 给account对象加了锁。这时,当一个线程访问account对象时,其他试图访问account对象的线程将会阻塞,直到该线程访问account对象结束。也就是说谁拿到那个锁谁就可以运行它所控制的那段代码。 当有一个明确的对象作为锁时,就可以用类似下面这样的方式写程序。 public void method3(SomeObject obj) { //obj 锁定的对象 synchronized(obj) { // todo } } 当没有明确的对象作为锁,只是想让一段代码同步时,可以创建一个特殊的对象来充当锁: class Test implements Runnable { private byte[] lock = new byte[0]; // 特殊的instance变量 public void method() { synchronized(lock) { // todo 同步代码块 } } public void run() { } } 3. 修饰一个静态的方法 Synchronized也可修饰一个静态方法,用法如下: public synchronized static void method() { // todo } 静态方法是属于类的而不属于对象的。同样的,synchronized修饰的静态方法锁定的是这个类的所有对象。 /** * 同步线程 */ class SyncThread implements Runnable { private static int count; public SyncThread() { count = 0; } public synchronized static void method() { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } public synchronized void run() { method(); } } public class Demo00{ public static void main(String args[]){ SyncThread syncThread1 = new SyncThread(); SyncThread syncThread2 = new SyncThread(); Thread thread1 = new Thread(syncThread1, "SyncThread1"); Thread thread2 = new Thread(syncThread2, "SyncThread2"); thread1.start(); thread2.start(); } } syncThread1和syncThread2是SyncThread的两个对象,但在thread1和thread2并发执行时却保持了线程同步。这是因为run中调用了静态方法method,而静态方法是属于类的,所以syncThread1和syncThread2相当于用了同一把锁。 4. 修饰一个类 Synchronized还可作用于一个类,用法如下: class ClassName { public void method() { synchronized(ClassName.class) { // todo } } } /** * 同步线程 */ class SyncThread implements Runnable { private static int count; public SyncThread() { count = 0; } public static void method() { synchronized(SyncThread.class) { for (int i = 0; i < 5; i ++) { try { System.out.println(Thread.currentThread().getName() + ":" + (count++)); Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } } } public synchronized void run() { method(); } } 本例的的给class加锁和上例的给静态方法加锁是一样的,所有对象公用一把锁 总结 A. 无论synchronized关键字加在方法上还是对象上,如果它作用的对象是非静态的,则它取得的锁是对象;如果synchronized作用的对象是一个静态方法或一个类,则它取得的锁是对类,该类所有的对象同一把锁。 B. 每个对象只有一个锁(lock)与之相关联,谁拿到这个锁谁就可以运行它所控制的那段代码。 C. 实现同步是要很大的系统开销作为代价的,甚至可能造成死锁,所以尽量避免无谓的同步控制。 2. 线程可见性 可见性-synchronized 可见性-volatile 内存屏障(memory barrier) 是一个CPU指令。基本上,它是这样一条指令: a) 确保一些特定操作执行的顺序; b) 影响一些数据的可见性(可能是某些指令执行后的结果)。编译器和CPU可以在保证输出结果一样的情况下对指令重排序,使性能得到优化。插入一个内存屏障, 相当于告诉CPU和编译器先于这个命令的必须先执行,后于这个命令的必须后执行。内存屏障另一个作用是强制更新一次不同CPU的缓存。例如,一个写屏障会 把这个屏障前写入的数据刷新到缓存,这样任何试图读取该数据的线程将得到最新值,而不用考虑到底是被哪个cpu核心或者哪颗CPU执行的。 volatile使用场景: volatile很适合用作状态标示量: 有序性 happend-before原则 1.程序次序规则:一个线程内,按照代码顺序,书写在前面的操作先行发生于书写在后面的操作;2.锁定规则:一个unLock操作先行发生于后面对同一个锁额lock操作;3.volatile变量规则:对一个变量的写操作先行发生于后面对这个变量的读操作;4.传递规则:如果操作A先行发生于操作B,而操作B又先行发生于操作C,则可以得出操作A先行发生于操作C;5.线程启动规则:Thread对象的start()方法先行发生于此线程的每个一个动作;6.线程中断规则:对线程interrupt()方法的调用先行发生于被中断线程的代码检测到中断事件的发生;7.线程终结规则:线程中所有的操作都先行发生于线程的终止检测,我们可以通过Thread.join()方法结束、Thread.isAlive()的返回值手段检测到线程已经终止执行;8.对象终结规则:一个对象的初始化完成先行发生于他的finalize()方法的开始;

优秀的个人博客,低调大师

服务器安装笔记

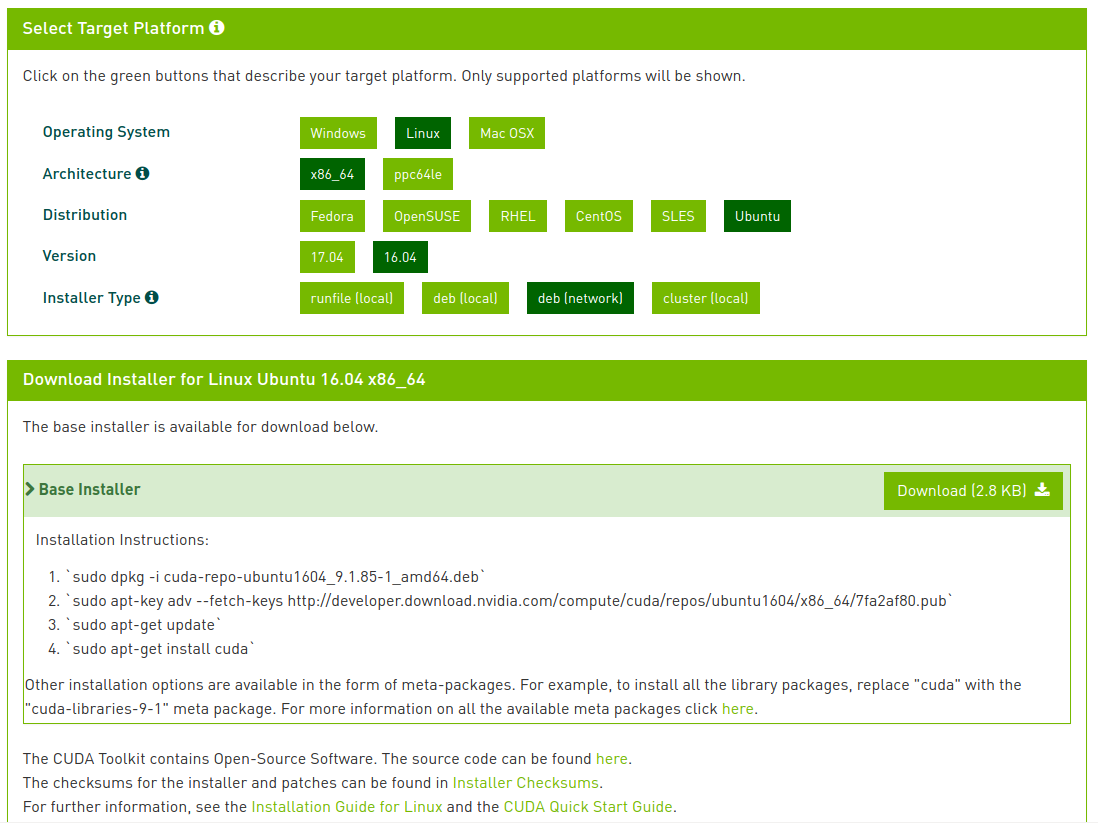
搞了一个月总算申请到了台 NVIDIA 机器, 接下来是安装过程 NVIDIA 驱动及Cuda环境安装 1. 查看系统架构 $ uname -am Linux aisrv 4.4.0-87-generic #110-Ubuntu SMP Tue Jul 18 12:55:35 UTC 2017 x86_64 x86_64 x86_64 GNU/Linux 安装 ubuntu 常用包 $ sudo apt install ubuntu-drivers-common $ ubuntu-drivers devices == /sys/devices/pci0000:00/0000:00:03.0/0000:03:00.0 == vendor : NVIDIA Corporation modalias : pci:v000010DEd00001B06sv00001462sd00003609bc03sc00i00 driver : nvidia-384 - distro non-free driver : nvidia-387 - third-party non-free recommended driver : xserver-xorg-video-nouveau - distro free builtin 安装docker $ sudo apt-get install \ apt-transport-https \ ca-certificates \ curl \ software-properties-common $ curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo apt-key add - $ sudo apt-key fingerprint 0EBFCD88 $ sudo add-apt-repository \ "deb [arch=amd64] https://download.docker.com/linux/ubuntu \ $(lsb_release -cs) \ stable" $ sudo apt-get update $ sudo apt-get install docker-ce # 免sudo 运行 docker # 查看是否存在 docker group $ cat /etc/group | grep docker docker:x:999: # 当前是存在 docker 组, 如不存在,通过 $ sudo groupadd docker 创建 # 添加当前用户到组中 $ sudo usermod -aG docker $(whoami) $ sudo service docker restart # 退出当前登录, 然后重新登录即可 2. 安装 GPU 驱动 安装 NVIDIA 驱动(可跳过) # 自动安装驱动,有可能失败 $ sudo ubuntu-drivers autoinstall # 手动安装, 如上述 ubuntu-drivers devices命令结果来看,安装 $ sudo apt install nvidia-384 $ sudo reboot 安装完成之后简单测试: $ nvidia-smi Sat Jan 6 12:12:43 2018 +-----------------------------------------------------------------------------+ | NVIDIA-SMI 384.90 Driver Version: 384.90 | |-------------------------------+----------------------+----------------------+ | GPU Name Persistence-M| Bus-Id Disp.A | Volatile Uncorr. ECC | | Fan Temp Perf Pwr:Usage/Cap| Memory-Usage | GPU-Util Compute M. | |===============================+======================+======================| | 0 GeForce GTX 108... Off | 00000000:03:00.0 Off | N/A | | 29% 37C P0 53W / 250W | 0MiB / 11171MiB | 3% Default | +-------------------------------+----------------------+----------------------+ +-----------------------------------------------------------------------------+ | Processes: GPU Memory | | GPU PID Type Process name Usage | |=============================================================================| | No running processes found | +-----------------------------------------------------------------------------+ 安装 cuda 包 $ lspci | grep -i nvidia 03:00.0 VGA compatible controller: NVIDIA Corporation Device 1b06 (rev a1) 03:00.1 Audio device: NVIDIA Corporation Device 10ef (rev a1) 进入到 GPU 官网, 按当前服务器配置进行选择,并配置: GPU配置 上述使用的是网络安装的方式进行安装. 安装完成之后需要重启机器 安装 cuDNN 库 caffe , tensorflow等DL专用的深度学习库 $ wget https://developer.nvidia.com/rdp/cudnn-download#a-collapse731-92 以 tensorflow为例: $ export DEVICES=$(\ls /dev/nvidia* | xargs -I{} echo '--device {}:{}') $ docker run -it --rm $DEVICES -v /usr/lib64/nvidia/:/usr/local/nvidia/lib64 tensorflow/tensorflow:latest-gpu bash 3. 安装docker 镜像 通过 tensorflow 官方镜像来构建自己的系统镜像 参见Dockerfile.gpu 4. 挂载 GPU 节点 如上述内容 tensorflow 的例子,相似 在 docker 环境内部安装 cuda 相关的 libraries 之后, 将主机上的设备节点直接映射到 docker 内部使用即可 其他问题 总结 在 docker 中使用宿主机的 GPU 主要是将对应的设备节点直接映射到 docker 内部即可 KVM 中使用 NVIDIA 则是通过虚拟化的方式,详细参见GPU Virtualization with KVM / QEMU 参考 GPU Virtualization with KVM / QEMUcuda – 从docker容器使用GPU?docker cuda - Dockerfiledocker-hub cudainstall-from-a-package

优秀的个人博客,低调大师

SDWebImage学习笔记之NSMapTable

NSDictionary/NSMutableArray浅析 我们在使用NSDictionary/NSMutableArray时,通常会使用NSString对象作为key,因为key必须遵循NSCopying协议,见NSMutableArray中的方法: - (void)setObject:(ObjectType)anObject forKey:(KeyType <NSCopying>)aKey; 在NSDictionary/NSMutableArray对象中,aKey对象被copy一份后存入,anObject对象则被强引用。来看一段代码: NSMutableDictionary *aDictionary = [[NSMutableDictionary alloc] initWithCapacity:0]; { NSString *aKey = @"akey"; NSObject *aObject = [[NSObject alloc] init]; [aDictionary setObject:aObject forKey:aKey]; } NSLog(@"dictionary: %@", aDictionary); 打印日志: dictionary: { akey = "<NSObject: 0x60400001d3b0>"; } 本来作用于结束后,aKey变量指向的NSString对象(简称aKey对象)和aObject变量指向的NSObject对象(简称aObject对象)应该被自动释放,但是aDictionary变量指向的NSMutableDictionary对象(简称aDictionary对象)持有一份aObject对象的强引用,所以打印日志时,aDictionary对象不为空。 现在有一个Teacher类表示班主任信息,包含姓名name属性和年龄age属性,另有一个Student类表示学生信息,也包含姓名name属性和年龄age属性。那么一个班包含一个班主任(Teacher对象)和n个学生(Student数组),为了统计一个班的信息,需要把班主任和学生的信息及对应关系保存下来。 // Teacher.h @interface Teacher : NSObject @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Teacher.m @implementation Teacher @end // Student.h @interface Student : NSObject @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Student.m @implementation Student @end // ViewController.m { NSMutableDictionary *aDictionary = [[NSMutableDictionary alloc] initWithCapacity:0]; Teacher *teacher = [[Teacher alloc] init]; teacher.name = @"teacher"; teacher.age = 30; NSMutableArray *aArray = [[NSMutableArray alloc] initWithCapacity:0]; for (int i = 0; i < 3; i++) { Student *student = [[Student alloc] init]; student.name = [NSString stringWithFormat:@"student%d", i]; student.age = i; [aArray addObject:student]; } [aDictionary setObject:aArray forKey:teacher.name]; NSLog(@"%@", aDictionary); } 打印日志: dictionary:{ teacher = ( "<Student: 0x60000003aa00>", "<Student: 0x60000003a9c0>", "<Student: 0x60000003aa80>" ); } 这里将班主任的姓名作为key,这样会损失其他信息。如果想要将teacher对象作为key,则需要让Teacher类遵循NSCopying协议,而且NSDictionary/NSMutable使用hash表来实现key和value之间的映射和存储,所以作为key值的类型必须重写++- (NSUInteger)hash++和++- (BOOL)isEqual:(id)object++两个方法,其中hash方法计算该对象的hash值,hash值决定该对象在hash表中存储的位置,isEqual方法通过hash值来定位对象在hash表中的位置。具体代码如下: // Teacher.h @interface Teacher : NSObject<NSCopying> @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Teacher.m @implementation Teacher - (id)copyWithZone:(NSZone *)zone { Teacher *teacher = [[Teacher allocWithZone:zone] init]; teacher.name = self.name; teacher.age = self.age; return teacher; } - (BOOL)isEqual:(id)object { // 比较hash值是否相等 return [self hash] == [object hash]; } - (NSUInteger)hash { // 调用父类的hash方法,也可以自定义 return [super hash]; } 打印日志: dictionary:{ "<Teacher: 0x600000027940>" = ( "<Student: 0x60c00022fa20>", "<Student: 0x60c00022fa00>", "<Student: 0x60c00022f960>" ); } NSMapTable浅析 NSMapTable继承自NSObject,自iOS6.0开始使用,NSMapTable是可变的。 NS_CLASS_AVAILABLE(10_5, 6_0) @interface NSMapTable<KeyType, ObjectType> : NSObject <NSCopying, NSCoding, NSFastEnumeration> NSMapTable有两个指定初始化方法和一个便捷初始化方法: // 指定初始化方法 - (instancetype)initWithKeyOptions:(NSPointerFunctionsOptions)keyOptions valueOptions:(NSPointerFunctionsOptions)valueOptions capacity:(NSUInteger)initialCapacity NS_DESIGNATED_INITIALIZER; - (instancetype)initWithKeyPointerFunctions:(NSPointerFunctions *)keyFunctions valuePointerFunctions:(NSPointerFunctions *)valueFunctions capacity:(NSUInteger)initialCapacity NS_DESIGNATED_INITIALIZER; // 便捷初始化方法 + (NSMapTable<KeyType, ObjectType> *)mapTableWithKeyOptions:(NSPointerFunctionsOptions)keyOptions valueOptions:(NSPointerFunctionsOptions)valueOptions; 初始化方法方法中有两个参数keyOptions和valueOptions,都是NSPointerFunctionsOptions类型,NSPointerFunctionsOptions是一个枚举类型, typedef NS_OPTIONS(NSUInteger, NSPointerFunctionsOptions) { // Memory options are mutually exclusive // default is strong NSPointerFunctionsStrongMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (0UL << 0), // use strong write-barrier to backing store; use GC memory on copyIn #if (TARGET_OS_MAC && !(TARGET_OS_EMBEDDED || TARGET_OS_IPHONE)) || TARGET_OS_WIN32 NSPointerFunctionsZeroingWeakMemory NS_ENUM_DEPRECATED_MAC(10_5, 10_8) = (1UL << 0), // deprecated; uses GC weak read and write barriers, and dangling pointer behavior otherwise #endif NSPointerFunctionsOpaqueMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (2UL << 0), NSPointerFunctionsMallocMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (3UL << 0), // free() will be called on removal, calloc on copyIn NSPointerFunctionsMachVirtualMemory API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (4UL << 0), NSPointerFunctionsWeakMemory API_AVAILABLE(macos(10.8), ios(6.0), watchos(2.0), tvos(9.0)) = (5UL << 0), // uses weak read and write barriers appropriate for ARC // Personalities are mutually exclusive // default is object. As a special case, 'strong' memory used for Objects will do retain/release under non-GC NSPointerFunctionsObjectPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (0UL << 8), // use -hash and -isEqual, object description NSPointerFunctionsOpaquePersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (1UL << 8), // use shifted pointer hash and direct equality NSPointerFunctionsObjectPointerPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (2UL << 8), // use shifted pointer hash and direct equality, object description NSPointerFunctionsCStringPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (3UL << 8), // use a string hash and strcmp, description assumes UTF-8 contents; recommended for UTF-8 (or ASCII, which is a subset) only cstrings NSPointerFunctionsStructPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (4UL << 8), // use a memory hash and memcmp (using size function you must set) NSPointerFunctionsIntegerPersonality API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (5UL << 8), // use unshifted value as hash & equality NSPointerFunctionsCopyIn API_AVAILABLE(macos(10.5), ios(6.0), watchos(2.0), tvos(9.0)) = (1UL << 16), // the memory acquire function will be asked to allocate and copy items on input }; 常用的枚举值及对应的含义如下: NSPointerFunctionsStrongMemory: 强引用存储对象 NSPointerFunctionsWeakMemory: 弱引用存储对象 NSPointerFunctionsCopyIn:copy存储对象 就是说,如果NSMapTable的初始化方法为: NSMapTable *aMapTable = [[NSMapTable alloc] initWithKeyOptions:NSPointerFunctionsCopyIn valueOptions:NSPointerFunctionsStrongMemory capacity:0]; 或 NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsCopyIn valueOptions:NSPointerFunctionsStrongMemory]; 那么就等同于NSMutableDictionay的初始化方法: NSMutableDictionary *aDictionary = [[NSMutableDictionary alloc] initWithCapacity:0]; 或 NSMutableDictionary *aDictionary = [NSMutableDictionary dictionary]; 若初始方法修改为 NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsWeakMemory valueOptions:NSPointerFunctionsStrongMemory]; 即对key值进行弱引用,就可以不用让Teacher类遵循NSCopying协议和重新跟hash有关的两个方法,代码如下: // Teacher.h @interface Teacher : NSObject @property (nonatomic, copy) NSString *name; @property (nonatomic, assign) NSInteger age; @end // Teacher.m @implementation Teacher @end // ViewController.m Teacher *teacher = [[Teacher alloc] init]; teacher.name = @"teacher"; teacher.age = 30;NSMutableArray *aArray = [[NSMutableArray alloc] initWithCapacity:0]; for (int i = 0; i < 3; i++) { Student *student = [[Student alloc] init]; student.name = [NSString stringWithFormat:@"student%d", i]; student.age = i; [aArray addObject:student]; } NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsWeakMemory valueOptions:NSPointerFunctionsStrongMemory]; [aMapTable setObject:aArray forKey:teacher]; NSLog(@"%@", aMapTable); 打印日志: NSMapTable { [10] <Teacher: 0x604000038a40> -> ( "<Student: 0x60400003c640>", "<Student: 0x60400003c660>", "<Student: 0x60400003c620>" ) } 这样的方法可以快速的将NSObject对象作为key存入到“字典”中。 由于NSDictionary/NSMutableArray会强引用value,使得value的引用计数+1,加入不希望怎么做,可以用NSMapTable来实现。 NSMapTable *aMapTable = [NSMapTable mapTableWithKeyOptions:NSPointerFunctionsStrongMemory valueOptions:NSPointerFunctionsWeakMemory]; { NSObject *keyObject = [[NSObject alloc] init]; NSObject *valueObject = [[NSObject alloc] init]; [aMapTable setObject:valueObject forKey:keyObject]; NSLog(@"NSMapTable:%@", aMapTable); } NSLog(@"NSMapTable:%@", aMapTable); 打印日志: NSMapTable:NSMapTable { [6] <NSObject: 0x60c00000c690> -> <NSObject: 0x60c00000c730> } NSMapTable:NSMapTable { } 第一个NSLog打印出了key-value值,等到object对象指向的NSObject对象超出作用域,释放该对象,由于aMapTable弱引用object对象,aMapTable的中的key-value值会被安全的删除,第二个NSLog打印出的值为空。 NSMapTable与NSDictionary/NSMutableDictionary对比 NSDcitionary有一个可变类型NSMutableDictionary,NSMapTable没有可变类型,它本身就是可变的; NSDcitionary/NSMutableDictionary中对于key和value的内存管理方法唯一,即对key进行copy,对value进行强引用,而NSMapTable没有限制; NSDcitionary中对key值进行copy,不可改变,通常用字符串作为key值,只是key->object的映射,而NSMapTable的key是可变的对象,既可以实现key->object的映射,又可以实现object->object的映射。 遗留的问题 笔者才疏学浅,对NSMapTable与NSDictionary的内部结构了解不是很深,不清楚key-value是通过怎么样的方式绑定起来的,假如看到这篇文章的朋友有所了解,希望可以指点一二。


优秀的个人博客,低调大师

java并发编程笔记--CopyOnWriteArrayList

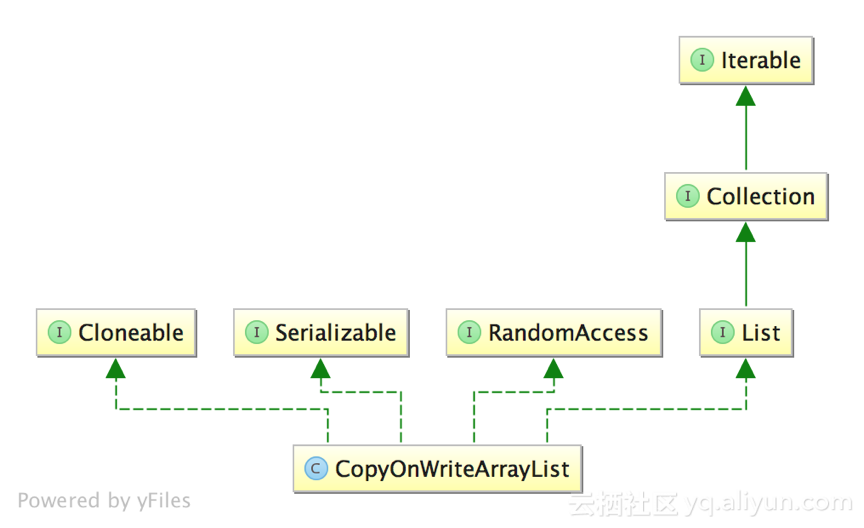
1 描述 1) CopyOnWriteArrayList是List的一种线程安全的实现;2) 其实现原理采用”CopyOnWrite”的思路(不可变元素),即所有写操作,包括:add,remove,set等都会触发底层数组的拷贝,从而在写操作过程中,不会影响读操作;避免了使用synchronized等进行读写操作的线程同步;3) CopyOnWrite对于写操作来说代价很大,故不适合于写操作很多的场景;当遍历操作远远多于写操作的时候,适合使用CopyOnWriteArrayList;4) 迭代器以”快照”方式实现,在迭代器创建时,引用指向List当前状态的底层数组,所以在迭代器使用的整个生命周期中,其内部数据不会被改变;并且集合在遍历过程中进行修改,也不会抛出ConcurrentModificationException;迭代器在遍历过程中,不会感知集合的add,remove,set等操作;5) 因为迭代器指向的是底层数组的”快照”,因此也不支持对迭代器本身的修改操作,包括add,remove,set等操作,如果使用这些操作,将会抛出UnsupportedOperationException;6) 相关Happens-Before规则:一个线程将元素放入集合的操作happens-before于其它线程访问/删除该元素的操作; 2 类图 主要角色:1) Iterable接口:定义创建迭代器操作,赋予实现类创建迭代器的能力;2) Collection接口:定义集合基本操作,所有集合类都需实现该接口;3) List接口:定义列表基本操作,所有列表类都需要实现该接口;4) Serializable接口:标记接口,允许对象序列化;5) Cloneable接口:标记接口,允许对象被克隆,如果类没有实现Cloneable接口,调用类对象的clone方法抛出CloneNotSupportedException;6) RandomAccess接口:标记接口,用来表明其支持快速(通常是固定时间)随机访问(比如:ArrayList支持快速随机访问,所以使用普通遍历方式效率更高;而LinkedList则更适合顺序访问,所以使用迭代器的方式效率更高);JDK中推荐的是对List集合尽量要实现RandomAccess接口;7) COWIterator:CopyOnWriteArrayList对应的迭代器;不支持写操作,当调用写操作时,将抛出UnsupportedOperationException异常;8) COWSubList:调用subList方法时,CopyOnWriteArrayList对应的子列表对象,和CopyOnWriteArrayList共享同一个array对象,使用使用offset和size维护对array的位置偏移;且当CopyOnWriteArrayList调用写操作更新array引用时,COWSubList对应的操作会抛出ConcurrentModificationException;9) COWSubListIterator:COWSubList对应的迭代器,底层通过COWIterator实现,使用offset和size维护对array的位置偏移;不支持写操作,当调用写操作时,将抛出UnsupportedOperationException异常; 3 主要实现 3.1 基本属性定义 /** * 互斥锁,用于保护所有修改操作,通过Unsafe进行初始化 */ final transient ReentrantLock lock = new ReentrantLock(); /** * 存放数据的底层数据结构,只能通过getArray()和setArray()两个方法访问; */ private transient volatile Object[] array; /** * <h2>array属性的getter和setter</h2> * <p>声明为非private类型,以便于CopyOnWriteArraySet访问</p> */ final Object[] getArray() { return array; } final void setArray(Object[] array) { this.array = array; } 1) lock属性:互斥锁,用于控制CopyOnWriteArrayList所有的写操作的同步,以及对应的COWSubList的所有读写操作的同步;2) array属性:Object[]数组,用于存放集合元素的底层数据结构;array只允许CopyOnWriteArrayList定义的getter和setter方法访问;(原因?) 3.2 构造器定义 /** * <h2>初始化array为空数组</h2> */ public CopyOnWriteArrayList() { setArray(new Object[0]); } /** * <h2>将集合参数中的元素作为当前集合对象的元素</h2> */ public CopyOnWriteArrayList(Collection<? extends E> c) { Object[] elements; if (c.getClass() == CopyOnWriteArrayList.class) { elements = ((CopyOnWriteArrayList<?>) c).getArray(); } else { elements = c.toArray(); //注:c.toArray()可能不一定返回Object[] if (elements.getClass() != Object[].class) { elements = Arrays.copyOf(elements, elements.length, Object[].class); } } } /** * <h2>将数组参数中的元素作为当前集合对象的元素</h2> */ public CopyOnWriteArrayList(E[] toCopyIn) { //注:传入数组对象并不是传递引用,而是新建一个数组拷贝原有数组 setArray(Arrays.copyOf(toCopyIn, toCopyIn.length, Object[].class)); } 1) 定义了3个构造函数,第一个构造函数为无参构造函数,默认初始化array为空数组;后两个构造函数分别接收Collection对象和数组对象作为参数,使用参数的元素作为初始化array的元素;2) 使用数组对象作为参数时,需要通过浅拷贝的方式初始化array,而非直接使用数组对象的引用; 3.3 查找元素 @Override public int size() { return getArray().length; } @Override public boolean isEmpty() { return size() == 0; } private static boolean eq(Object o1, Object o2) { return (o1 == null) ? o2 == null : o1.equals(o2); } private static int indexOf(Object o, Object[] elements, int index, int fence) { if (o == null) { for (int i = index; i < fence; i++) { if (elements[i] == null) { return i; } } } else { for (int i = index; i < fence; i++) { if (o.equals(elements[i])) { return i; } } } return -1; } private static int lastIndexOf(Object o, Object[] elements, int index) { if (o == null) { for (int i = index; i >= 0; i--) { if (elements[i] == null) { return i; } } } else { for (int i = index; i >= 0; i--) { if (o.equals(elements[i])) { return i; } } } return -1; } @Override public boolean contains(Object o) { Object[] elements = getArray(); return indexOf(o, elements, 0, elements.length) >= 0; } @Override public int indexOf(Object o) { Object[] elements = getArray(); return indexOf(o, elements, 0, elements.length); } public int indexOf(E e, int index) { Object[] elements = getArray(); return indexOf(e, elements, index, elements.length); } public int lastIndexOf(Object o) { Object[] elements = getArray(); return lastIndexOf(o, elements, elements.length - 1); } public int lastIndexOf(E e, int index) { Object[] elements = getArray(); return lastIndexOf(e, elements, index); } 1) CopyOnWriteArrayList的所有读操作都不需要加锁;2) 单个元素的访问,直接通过索引访问底层数组;3) 查找遍历等涉及多个元素的读操作,都会针对array的快照进行,即每次操作开始前使用名为elements的Object[]局部变量存放array当前的引用。在遍历过程中,array发生变化时,遍历操作遍历的依然是原来的快照,从而保证了读操作不需要加锁,写操作也不会发生ConcurrentModificationException异常; 3.4 新增元素 @Override public boolean add(E e) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); int len = elements.length; Object[] newElements = Arrays.copyOf(elements, len + 1); newElements[len] = e; setArray(newElements); return true; } finally { lock.unlock(); } } 1) 所有的新增元素操作都需要使用lock加互斥锁;2) 新增元素需要考虑添加元素的个数(单个/集合),添加元素的位置(末尾/非末尾); 3.5 更新元素 @Override public E set(int index, E element) { //加锁 final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); E oldValue = get(elements, index); //待更新元素不是原来的元素,才执行copyOnWrite if (oldValue != element) { int len = elements.length; Object[] newElements = Arrays.copyOf(elements, len); newElements[index] = element; setArray(newElements); } else { // 注:再次更新引用,为了触发volatile的语义,通知所有线程 setArray(elements); } return oldValue; } finally { //解锁 lock.unlock(); } } 1) 同添加元素操作一样,更新元素也需要使用lock加互斥锁;2) 需要注意的是,即使待更新元素和集合中元素引用相同,也需要执行setArray()操作,以便触发volatile语义,通知所有线程; 3.6 删除元素 @Override public E remove(int index) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); int len = elements.length; E oldValue = get(elements, index); //计算需要移动的元素个数 int numMoved = len - index - 1; //如果删除元素在数组末尾 if (numMoved == 0) { setArray(Arrays.copyOf(elements, len - 1)); } else { Object[] newElements = new Object[len - 1]; System.arraycopy(elements, 0, newElements, 0, index); System.arraycopy(elements, index + 1, newElements, index, numMoved); setArray(newElements); } return oldValue; } finally { lock.unlock(); } } private boolean remove(Object o, Object[] snapshot, int index) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] current = getArray(); int len = current.length; //如果此时已经进行过写操作 if (snapshot != current) { //校准索引 FINDINDEX: { //在当前代码获取锁时,有可能len已经小于index,故需要取二者中较小的; int prefix = Math.min(index, len); //情形1:[0,index)区间的元素有删除操作,导致index所指元素前移 for (int i = 0; i < prefix; i++) { //如果元素引用已经替换 if (current[i] != snapshot[i] && eq(o, current[i])) { index = i; break FINDINDEX; } } //情形2:当前数组删除元素较多,导致数组长度小于原先index if (index >= len) { return false; } //情形3:[0,index)区间的元素没有删除操作,index所指元素未移动 if (current[index] == o) { break FINDINDEX; } //情形4:[0,index)区间有添加元素操作,导致index所指元素后移,重新定位元素索引 index = indexOf(o, current, index, len); } } Object[] newElements = new Object[len - 1]; System.arraycopy(current, 0, newElements, 0, index); System.arraycopy(current, index + 1, newElements, index, len - index - 1); setArray(newElements); return true; } finally { lock.unlock(); } } @Override public boolean remove(Object o) { Object[] snapshot = getArray(); int index = indexOf(o, snapshot, 0, snapshot.length); return index >= 0 && remove(o, snapshot, index); } 1) 删除元素时,同样需要加互斥锁,但出于效率考虑,在加锁前都检测待删除元素是否存在,如果不存在则不加锁,直接返回false;2) 由于判断元素是否存在的操作时未加锁,不能保证删除方法执行过程中,其它线程进行写操作。故在加锁后,依然需要对索引进行校准,增加了删除操作实现难度; 3.7 迭代器实现 @Override public Iterator<E> iterator() { return new COWIterator<E>(getArray(), 0); } @Override public ListIterator<E> listIterator() { return new COWIterator<E>(getArray(), 0); } @Override public ListIterator<E> listIterator(int index) { Object[] elements = getArray(); int len = elements.length; if (index < 0 || index > len) { throw new IndexOutOfBoundsException("Index: " + index); } return new COWIterator<E>(elements, index); } /** * <h2>Copy-On-Write迭代器定义</h2> * <p>限定为final,表示不可以被继承</p> */ static final class COWIterator<E> implements ListIterator<E> { /** * 限定为final,指定为不可变对象,存放arry快照 */ private final Object[] snapshot; /** * 迭代器索引 */ private int cursor; private COWIterator(Object[] elements, int initialCursor) { cursor = initialCursor; snapshot = elements; } public boolean hasNext() { return cursor < snapshot.length; } public boolean hasPrevious() { return cursor > 0; } @SuppressWarnings("unchecked") public E next() { if (!hasNext()) { throw new NoSuchElementException(); } return (E) snapshot[cursor++]; } @SuppressWarnings("unchecked") public E previous() { if (!hasPrevious()) { throw new NoSuchElementException(); } return (E) snapshot[--cursor]; } public int nextIndex() { return cursor; } public int previousIndex() { return cursor - 1; } /** * Not supported. Always throws UnsupportedOperationException. * * @throws UnsupportedOperationException always; {@code remove} * is not supported by this iterator. */ public void remove() { throw new UnsupportedOperationException(); } /** * Not supported. Always throws UnsupportedOperationException. * * @throws UnsupportedOperationException always; {@code set} * is not supported by this iterator. */ public void set(E e) { throw new UnsupportedOperationException(); } /** * Not supported. Always throws UnsupportedOperationException. * * @throws UnsupportedOperationException always; {@code add} * is not supported by this iterator. */ public void add(E e) { throw new UnsupportedOperationException(); } @Override public void forEachRemaining(Consumer<? super E> action) { Objects.requireNonNull(action); Object[] elements = snapshot; final int size = elements.length; for (int i = cursor; i < size; i++) { @SuppressWarnings("unchecked") E e = (E) elements[i]; action.accept(e); } cursor = size; } } 1) COWIterator迭代器实现是基于快照的,即在调用iterator()方法创建迭代器时,传入array的引用作为快照; 通过一个整型游标记录当前访问到元素的索引;2) 因为迭代器是基于快照的,故所有读操作都无须加锁,且迭代过程中,对CopyOnWriteArrayList集合的修改不会影响到迭代操作,也不会抛出ConcurrentModificationException;3) 注意:因为COWSubList是作为CopyOnWriteArrayList的子列表的,所有操作都依赖于array,所以COWSubList的所有操作都必须检测array是否有改变,并且读写操作都要加锁,以保证写操作替换array的时候,没有读操作同步进行; 4 适用场景 4.1 小数据量,读多写少 数据量较小,读操作尤其是遍历操作远多于写操作时候,适合使用CopyOnWriteArrayList。 5 缺点&权衡点 5.1 写操作耗时更多 不可变对象的每次写操作就要进行一次copy/new操作,带来的性能消耗随着copy的数据量显著增加,包括内存的消耗以及copy/new过程的时间消耗;故不适合copy/new数据量很大,并且写操作很多的场景。 5.2 集合占用内存更多 使用Copy-On-Write,如果短时间有大量读伴随着写,则会有很多”快照”引用得不到释放,占用大量内存。 6 应用案例 7 相关知识点 7.1 迭代器模式 7.2 CopyOnWriteArraySet 8 问题思考 1)CopyOnWriteList如何保证在遍历的过程中修改集合不会触发ConcurrentModificationException?2)为什么CopyOnWriteList的迭代器不支持写操作?3)如下代码为什么不直接使用array,而要通过getArray方法? 4)加锁的代码为什么要按照如下方式写?是要防止锁的引用改变吗? 参考 [Java多线程系列--“JUC集合”02之 CopyOnWriteArrayList]()sun.misc.Unsafe类的使用CopyOnWriteArrayList解读

优秀的个人博客,低调大师

《大型网站技术架构》笔记

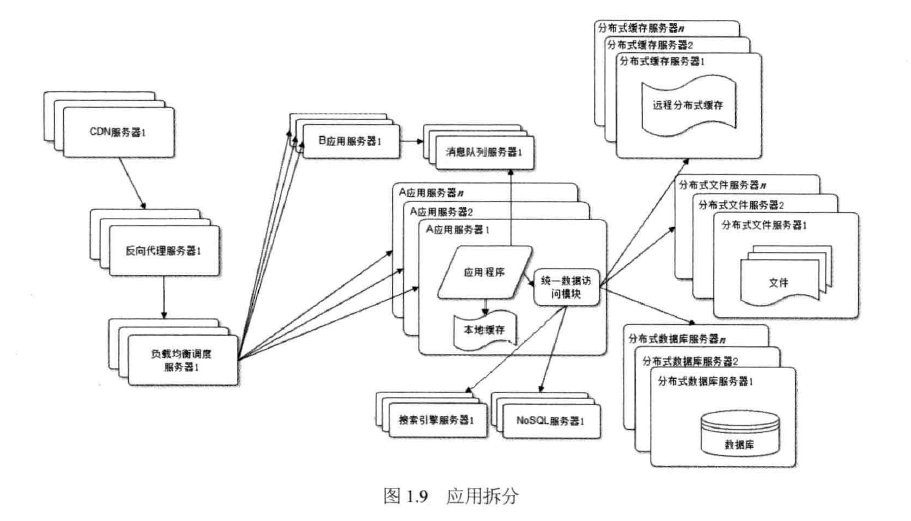
核心原理与案例分析 分为三个部分,应用区、文件区、DB区: 大型网站核心架构要素:性能、可用性、伸缩性、扩展性、安全性 WEB前端性能优化:减少http请求,合并CSS、合并JavaScript、合并图片。使用浏览器缓存。启用压缩。CSS放页面最上面,JS放页面最下面。减少Cookie传输。CDN加速。反向代理。 缓存:将数据存储在相对较高访问速度的存储介质中。缓存的内容为:读写比例高、很少变化的数据。 分布式缓存:memcached 消息队列异步处理 线程数量和CPU内核数成正比 RAID0:并发写入每块磁盘 RAID1:两块磁盘都写同样的 RAID10 RAID5: HDFS取代RAID 预发布服务器:不添加在负载均衡中的完全一样的服务器 灰度发布 几种负载均衡方式:HTTP重定向负载均衡、DNS域名解析负载均衡、反向代理负载均衡、IP负载均衡、直接路由负载均衡(修改MAC,LVS) 负载均衡算法:RR轮询、WRR加权轮询、随机、最少连接、源地址散列 70%的WEB攻击来自XSS攻击和SQL注入攻击 消毒、禁止页面JavaScript访问带有HttpOnly属性的Cookie CSRF:跨站点请求伪造 开源WAF,web应用防火墙:ModSecurity 信息加密技术:单向散列加密、对称加密、非对称加密 单向散列算法:MD5、SHA 对称加密:DES、RC 非对称加密:RSA 贝叶斯分类算法 秒杀系统的应对策略:秒杀系统独立部署、秒杀商品页面静态化、租借秒杀活动网络带宽、动态生成随机下单页面URL 首页不应该访问数据库,首页最好是静态的

优秀的个人博客,低调大师

Java学习笔记--可变参数

可变参数的格式: 数据类型... 变量名 可变参数要 注意的细节: 1. 如果一个函数 的形参使用上了可变参数之后,那么调用该方法的时候可以传递参数也可以不传递参数。 2. 可变参数实际上是一个数组对象。 3. 可变参数必须位于形参中的最后一个参数。 4. 一个函数最多只能有一个可变 参数,因为可变参数要位于形参中最后一个位置上。 public class Demo4 { public static void main(String[] args) { int[] arr = {1,2,3,4}; add(1,2,3,4);//输出10 add(arr);//输出10 add();//输出0 } public static void add(int... arr){ //长度是0 int result = 0; for(int item : arr){ result+=item; } System.out.println("总和:"+ result); } }

优秀的个人博客,低调大师

java学习笔记--增强for循环

什么是增强for循环? 原来的for循环是这样子的: for(int i=0;i<10;i++) 那我们来看一下增强for循环: for(object a:x)//不只是object 数组存储的是什么类型的就填什么类型 x是数组或者集合 里面是Interator迭代器实现的 注意:遍历的时候不能用集合增删元素 只能通过迭代器进行操作 因为迭代器创建的时候会创建一个单链表 如果是通过集合来操作元素数量的话那么 实际的数量是变化了 可是迭代器创建的那个单链表却还是原来的样子 这样子 迭代器往下遍历的时候 就找不到实际的值 重点: 增强for循环的适用范围: 如果是实现了Iterable接口的对象或者是数组对象(包括int)都可以使用增强for循环。 //注意: Map集合没有实现Iterable接口,所以map集合不能直接使用增强for循环,如果需要使用增强for循环需要借助于Collection // 的集合。 HashMap<String, String> map = new HashMap<String, String>(); map.put("001","张三"); map.put("002","李四"); map.put("003","王五"); map.put("004","赵六"); Set<Map.Entry<String, String>> entrys = map.entrySet(); for(Map.Entry<String, String> entry :entrys){ System.out.println("键:"+ entry.getKey()+" 值:"+ entry.getValue()); } 举例: 实现了Iterable接口的对象 package cn.itcast.jdk15; import java.util.Iterator; //自定一个类使用增强for循环 class MyList implements Iterable<String>{ Object[] arr = new Object[10]; int index = 0 ; //当前的指针 public void add(Object o){ arr[index++] = o; // 1 } public int size(){ return index; } @Override public Iterator<String> iterator() { return new Iterator<String>() { int cursor = 0; @Override public boolean hasNext() { return cursor<index; } @Override public String next() { return (String) arr[cursor++]; } @Override public void remove() { } }; } } public class Demo3 { public static void main(String[] args) { MyList list = new MyList(); list.add("张三"); list.add("李四"); list.add("王五"); for(String item :list){ System.out.println(item); } } }

优秀的个人博客,低调大师

Effective C++学习笔记

导读 本书的最佳用途:彻底了解C++如何行为,为什么那样行为,以及如何运用其行为形成优势。 size_t是一个typedef,是某种不带正负号的unsigned类型。 签名(signature):函数的参数和返回值。即std::size_t num(int number) 的签名是 std::size_t ( int ) explicit可组织他被用来隐式转换(implicit type conversions),但他仍可以被进行显示转换(explicit type conversions)。 如图: 拷贝构造---以同型对象初始化自我对象。 拷贝赋值---从另一个同性对象中拷贝其值到自我对象。 1、让自己习惯C++ 条款一:视C++为一个语言联邦 c++是四种语言的联邦 每种语言都有自己的规约。C++高效编程守则视状况而变化,取决于你使用C++的哪一部分。 条款2:尽量以const、enum、inline替换#define 也就是“宁可以编译器替换预处理”。因为define或许不被视为语言的一部分。 class专属常量:为了将常量的作用域(scope)限制于class内,必须让它成为class的一个成员(member);而为了确保此常量最多只有一份实体,必须让它成为static成员。 我们无法用#define创建一个专属常量。 menu hack: 1、menu hack的行为更像#define,而不是const。例如取const地址是合法的,而取menu hack或者#define的地址是不合法的。 2、如果不希望别人活得一个pointer或reference指向你的某个常量,enum可以帮你实现这个约束。 3、enum和#define绝不会导致没必要的内存分配,因为有的编译器会为const对象设定另外的存储空间。 4、enum hack是模板元编程的技术基础。 对于单纯的常量,最好以const对象或enum替换#define;对于形似函数的宏,最好用inline函数替换#define。 条款3:尽可能使用const 令函数的返回值为const,可以降低因客户错误而造成的意外。如下图: class R{.....} const R poerator *(const R& lns, const R& rhs) 两个成员函数如果只是常量性(constness)方面不同,可以被重载,如下图: 上图中non-const operator[]的返回值类型是char &,而不是char,因为如果函数的返回类型是一个内置类型,那么改动函数返回值就不合法(what?我不懂。。。吴老师:这个说法有点令人困惑。关键不是内置类型与否,而是值类型与否。需要修改内容,函数需要返回一个非const的引用。。。还是不太懂。。。) 条款4:确定对象被使用前已先被初始化 int x; c++语言中,上述语句在某些语境下,x被初始化为0,某些情况下x不被初始化。读取未初始化的值会导致不明确的行为。在某些平台上,仅仅只是读取未初始化的值,就可以让你的程序终止运行。 不要混淆赋值和初始化,如下图: c++规定:对象成员变量的初始化动作发生在进入构造函数本体之前。 使用初始列进行初始化的效率更高,因为比起先调用default构造函数然后再调用copy assignment操作符,单只调用一次copy构造函数比较高效,有时甚至高效得多。 (1)在初始化列表中,成员的初始化顺序和成员的声明顺序相同,与初始化列表的位置顺序无关。(2) 初始化列表先于构造函数执行。 (3) 类中可以定义const成员变量,它并非真正意义的常量,而是只读变量,其初始化方式只能依靠初始化列表。 const只读变量虽然不可出现在赋值符号的左边,但是可以通过指针去修改其值的。(what???) 当你想要default构造一个成员变量,你都可以使用初值列,只要指定无物(nothing)作为初始化实参即可。如下图: 规定总是在初值列中列出所有成员变量,以免去记忆哪些成员变量可以无需初值。 如果成员变量是const或references,它就需要初值,而不能被赋值。具体原因详见链接: https://blog.csdn.net/qq_29344757/article/details/76093216 在class中,变量不能直接初始话,需要通过构造函数(或拷贝构造函数)来初始话,如果程序员没有定义构造函数系统会有一个默认构造函数。 除了静态数据成员外,数据成员不能在类体内显式的初始化 不同编译单元内定义之non-local static 对象 条款5:了解C++默默编写并调用哪些函数 当你写一个空类没有声明的时候,编译器会为他声明一个copy构造函数、一个copy assignment函数和一个析构函数。如果你没有声明任何构造函数,编译器会为你声明一个default构造函数。如下图: 当这些函数被调用的时候,编译器才会把他们创建出来。 注意:编译器产生的析构函数是一个non-virtual,除非这个class的base class自身声明有virtual析构函数(不明觉厉,先记下来) 如果类中你声明了一个带实参的构造函数,编译器便不会创建default构造函数,如此,你写的构造函数就不会被创建出来的无实参的default构造函数覆盖掉。 条款6:若不想使用编译器自动生成的函数,就应该明确的拒绝 驳回编译器自动提供的功能,可将相应的成员函数声明为private并且不予实现。或者使用上图所示的手法也可以(上图所示的手法感觉更好一点) 条款7:为多态基类声明virtual析构函数 如果一个类里面不含虚函数,通常意味着他并不意图被用做一个base class(基类)。当类不企图被当做base class,灵其析构函数为virtual往往是个馊主意。C++标准库中很多都是没有虚函数的class,比如string、vector、list等,所以不要把标准库中的类作为基类。 虚指针vptr(virtual table pointer)用于在运行期决定哪一个虚函数被调用。vptr指向一个由函数指针构成的数组,该数组称为虚表vtbl(virtual table):每个带有虚函数的类都有对应的虚表。 纯虚函数导致抽象类(不能被实例化(instantiated)的类) 虚析构函数的作用:为了当用一个基类的指针删除一个派生类的对象时,派生类的析构函数会被调用。(用C++开发的时候,用来做基类的类的析构函数是虚函数。) Class ClxBase { public: ClxBase() {}; //虚虚构函数 virtual ~ClxBase() {}; virtual void DoSomething() { cout << "Do something in class ClxBase!" << endl; }; }; 条款8:别让异常逃离析构函数 析构函数绝对不要吐出异常。如果一个被析构函数调用的函数可能会抛出异常,析构函数应该捕捉任何异常,然后吞下他们(不传播)或结束程序。 如果客户需要对某一操作函数运行期间抛出的异常做出反应,那么class应该提供一个普通函数(而非在析构函数中)执行该操作。 条款9:绝不在构造和析构过程中调用虚函数 class Transation { public: Transation(); virtual void logTransaction() const = 0; ... }; Transation::Transation() { ... logTransaction();//构造函数调用虚函数 } class BuyTransation :public Transation { public: virtual void logTransation() const; ... };上述代码执行: BuyTransation b; 在该调用logTransaction时,调用的虚函数是base class中的,而不是BuyTransaction中的。 因为:base class(基类)构造期间,虚函数不会下降到derived classes(子类)阶层。由于base classes构造函数的执行更早于的derived classes构造函数,当base class 构造函数执行时derived class的成员变量尚未初始化,如果器件调用的virtual函数下降至derived classes阶层,而derived classes的函数机会必然去用local成员变量,而那些成员变量尚未初始化,因此无法调用derived classes中的虚函数,而是调用base class的虚函数。 更根本原因:在derived class对象的base class 构造期间,对象的类型是base class而不是derived class。不止虚函数会被编译器解析至base class,若使用运行期类型信息,也会把对象是为base class。 logTransaction是纯虚函数,除非他被定义,否则程序无法连接,因为连接器找不到必要的Transaction::logTransaction实现代码。 弥补措施:在构造期间,可以藉由“令derived classes将必要的构造信息向上传递至base class构造函数”。 条款10:令operator= 返回一个 reference to *this 赋值采用右结合定律,因此x=y=z=15等价于(x=(y=(z=15)))。为了实现“连锁赋值”,赋值操作符必须返回一个reference指向操作符的左侧实参。 条款11:在operator= 中处理“自我赋值” “自我赋值”发生在对象被赋值给自己时。拷贝构造函数里面应该先判断一下传入的参数是不是自己。 条款12:复制对象时勿忘其每一个成分 如果你自己写拷贝构造函数,而不用编译器默认构造的拷贝构造函数,当你为class添加一个成员变量后,你必须同时修改拷贝构造函数,如果你忘记,编译器也不太可能会提醒你。一旦你给这个class添加了子类,而忘记修改基类的拷贝构造函数,子类就无法对从父类那里继承下来的变量进行赋值。 拷贝构造函数应该确保复制“对象内的所有成员变量”及“所有base class成分”。 不要试图使拷贝赋值函数调用拷贝构造函数,同时也不要试图让拷贝构造函数调用拷贝赋值函数。如果上述两个函数有重复代码,可以在private里面写一个函数供上述两个函数调用,该函数常备命名为init 条款13:对象管理资源

优秀的个人博客,低调大师

Spark 官网阅读笔记

1.spark读取本地文件系统: 则该文件也必须可以在工作节点上的相同路径上访问。所以需要将文件复制到所有work 节点或使用网络安装的共享文件系统。 2.group by key 没有reduceBykey, aggregateBykey高效,(后者是同时分区排序) 3.accumulator 累加器的使用 4.broadcast variables 广播变量的使用 5:DataFrame就是DataSet的一行Dataset[Row] 6.用于隐式转换,如将RDD转换为DataFrames . 需要 import spark.implicits._ 7.全局临时视图与系统保存的数据库绑定global_temp,我们必须使用前面加上限定名称来引用它,例如SELECT * FROM global_temp.view1。(加关键字global_temp) 8.新建session测试spark.newSession().sql("select * from global_temp.people") 9.通过提供一个样例类可以将DataFrames转换为Dataset。映射将通过名称 10:类型推断 peopleDF.createOrReplaceTempView("people") val tdf = spark.sql("select name,age from people were age>=13 and age <= 19) tdf.map(t=> "name: " +t(0)).show() tdf.map(t=> "name: " +t.getAs[String]("name')).show() 11. persist table: 写出时没有指定路径参数(默认存储为管理表,路径为hive-site.xml,指定的位置),表被删除时,数据,路径都会被删掉。指定参数则不会。 For file-based data source, e.g. text, parquet, json, etc. you can specify a custom table path via the path option, e.g. df.write.option("path", "/some/path").saveAsTable("t"). When the table is dropped, the custom table path will not be removed and the table data is still there. If no custom table path is specified, Spark will write data to a default table path under the warehouse directory. When the table is dropped, the default table path will be removed too. 12. the automatic type inference can be configured ,配置是否启用类型推断,确定分区字段。by spark.sql.sources.partitionColumnTypeInference.enabled, which is default to true. When type inference is disabled, string type will be used for the partitioning columns. 13.设置全局的参数实现类型合并: spark.sql.parquet.mergeSchema 14:读取HIVE:前提需要pom文件中有spark-hive 依赖。 val spark = SparkSession 。builder() 。appName (“Spark Hive示例” ) 。config (“spark.sql.warehouse.dir” , warehouseLocation ) 。enableHiveSupport () 。getOrCreate () import spark.implicits._ import spark.sql 15:使用广播表: import org.apache.spark.sql.functions.broadcast broadcast(spark.table("src")).join(spark.table("records"), "key").show() 16:pyArrow: 要在执行这些调用时使用箭头,用户需要首先将Spark配置'spark.sql.execution.arrow.enabled'设置为'true'。这是默认禁用的。 pyspark 使用自定义python相关。 配置spark-env.sh 内容:添加如下 export PYSPARK_PYTHON= /home/lio/anaconda3/env/DL/bin/python3.5 即可 ipython notebook with spark http://blog.cloudera.com/blog/2014/08/how-to-use-ipython-notebook-with-apache-spark/ import numpy as np import pandas as pd # Enable Arrow-based columnar data transfers spark.conf.set("spark.sql.execution.arrow.enabled", "true") # Generate a Pandas DataFrame pdf = pd.DataFrame(np.random.rand(100, 3)) # Create a Spark DataFrame from a Pandas DataFrame using Arrow df = spark.createDataFrame(pdf) # Convert the Spark DataFrame back to a Pandas DataFrame using Arrow result_pdf = df.select("*").toPandas() pip install PyArrow - spark-streaming 17: 要仅停止StreamingContext,请将可选参数stop()调用stopSparkContext为false: * @param stopSparkContext If true, stops the associated SparkContext. The underlying SparkContext will be stopped regardless of whether this StreamingContext has been started. */ def stop( stopSparkContext: Boolean = conf.getBoolean("spark.streaming.stopSparkContextByDefault", true) ): Unit = synchronized { stop(stopSparkContext, false) } 18:DStream由连续的RDD系列表示,这是Spark对不可变的分布式数据集的抽象.DStream中的每个RDD都包含来自特定时间间隔的数据. 19:不在driver端创建数据库连接, 不使用foreachRDD操作创建连接,最好使用foreachPartition 和connectionPool dstream.foreachRDD { rdd => val connection = createNewConnection() // executed at the driver rdd.foreach { record => connection.send(record) // executed at the worker } } 这是不正确的,因为这要求将连接对象序列化并从Driver端发送到worker端。这种连接对象很难在机器间转移。此错误可能表现为序列化错误(连接对象不可序列化),初始化错误(连接对象需要在worker初始化)等。正确的解决方案是在worker上创建连接对象。 但是,这可能会导致另一个常见错误 - 为每条记录创建一个新的连接。例如, dstream.foreachRDD { rdd => rdd.foreach { record => val connection = createNewConnection() connection.send(record) connection.close() } } 通常,创建连接对象会带来时间和资源开销。因此,创建和销毁每个记录的连接对象可能会导致不必要的高开销,并且可能会显着降低系统的整体吞吐量。更好的解决方案是使用 rdd.foreachPartition- 创建单个连接对象并使用该连接发送RDD分区中的所有记录。 dstream.foreachRDD { rdd => rdd.foreachPartition { partitionOfRecords => val connection = createNewConnection() partitionOfRecords.foreach(record => connection.send(record)) connection.close() } } 这会缓解许多记录中的连接创建开销。 最后,通过跨多个RDD /批次重用连接对象,可以进一步优化这一点。可以维护一个静态的连接对象池,因为多个批处理的RDD被推送到外部系统,所以可以重复使用,从而进一步降低了开销。 dstream.foreachRDD { rdd => rdd.foreachPartition { partitionOfRecords => // ConnectionPool is a static, lazily initialized pool of connections val connection = ConnectionPool.getConnection() partitionOfRecords.foreach(record => connection.send(record)) ConnectionPool.returnConnection(connection) // return to the pool for future reuse } } 请注意,池中的连接应按需延迟创建,如果暂时不使用,则超时。这实现了向外部系统发送数据的最高效率。 其他要记住的要点: 输出操作会延迟执行DStream,就像RDD由RDD操作懒洋洋地执行一样。具体来说,DStream输出操作中的RDD操作会强制处理接收到的数据。因此,如果您的应用程序没有任何输出操作,或者dstream.foreachRDD()没有任何RDD操作的输出操作,则不会执行任何操作。系统只会收到数据并丢弃它。 默认情况下,输出操作一次执行一次。并且它们按照它们在应用程序中定义的顺序执行。 20: val words: DStream[String] = ... words.foreachRDD { rdd => // Get the singleton instance of SparkSession val spark = SparkSession.builder.config(rdd.sparkContext.getConf).getOrCreate() 从整个在使用的streamingContext的sparkContext中获取构建sparkSession的配置文件。 import spark.implicits._ // Convert RDD[String] to DataFrame val wordsDataFrame = rdd.toDF("word") // Create a temporary view wordsDataFrame.createOrReplaceTempView("words") // Do word count on DataFrame using SQL and print it val wordCountsDataFrame = spark.sql("select word, count(*) as total from words group by word") wordCountsDataFrame.show() } 21:可以异步的使用sql的查询不同进程中的streamingContext实例。请确保streamingContext设置记住足够多的数据,否则,streamingContext没有感知到任何 查询会删除之前的数据。{您还可以在来自不同线程的流式数据上定义的表上运行SQL查询(即与正在运行的StreamingContext异步)。只要确保您将StreamingContext设置为记住足够数量的流数据,以便查询可以运行。否则,不知道任何异步SQL查询的StreamingContext将在查询完成之前删除旧流数据。例如,如果您想查询最后一批,但查询可能需要5分钟才能运行,请调用streamingContext.remember(Minutes(5))(以Scala或其他语言的等效语言)}如果您想查询最后一批,但查询可能需要5分钟才能运行,请调用streamingContext.remember(Minutes(5)) 22:容错: 对于通过网络接收数据的输入流(例如Kafka,Flume,套接字等),默认持久性级别设置为将数据复制到两个节点以实现容错。 DStream的默认持久性级别使数据在内存中序列化 23:为了减少数据恢复时的lineage过于长所以需要设立checkpoint切断这个链条。 24:配置checkpoint, 失败自启动。 预写日志:spark.streaming.receiver.writeAheadLog.enable来true 24:设置背压,:设置最大接收速率 - 如果群集资源不够大,流式传输应用程序无法像接收数据一样快速处理数据,则可以通过以记录/秒为单位设置最大速率限制来限制接收器速率。查看接收器的配置参数 spark.streaming.receiver.maxRate和spark.streaming.kafka.maxRatePerPartition Direct Kafka方法。在Spark 1.5中,我们引入了一项名为backpressure的功能,无需设置此速率限制,因为Spark Streaming会自动计算出速率限制并在处理条件发生变化时动态调整速率限制。这个背压可以通过设置来启用配置参数 spark.streaming.backpressure.enabled来true。 25:sturctedStreaming:new data in the data stream === new rows append to a unabounded table. 26:写出模式: 完整:整个更新后的结果表将被写入外部存储器。由存储连接器决定如何处理整个表格的写入 追加:只有在结果表中追加的新行才会写入外部存储器。这仅适用于预期不会更改结果表中现有行的查sinks 更新:- 只有自上次触发以来在结果表中更新的行才会写入外部存储器(自Spark 2.1.1起可用)。请注意,这与完整模式不同之处在于,此模式仅输出自上次触发后更改的行。如果查询不包含聚合,则它将模式。 27:容错语义: 提供端到端的一次语义是结构化数据流设计背后的关键目标之一。为此,我们设计了结构化流式源,接收器和执行引擎,以可靠地跟踪处理的确切进程,以便通过重新启动和/或重新处理来处理任何类型的故障。假定每个流源都有偏移量(类似于Kafka偏移量或Kinesis序列号)来跟踪流中的读取位置。该引擎使用checkpoint和WAL来记录每个触发器中正在处理的数据的偏移范围。流式接收器被设计为处理重新处理的幂等。通过使用可重放源和幂等,结构化数据流可以确保端到端完全一次的语义 任何失败 28:类型推断和分区 对于即席查询,您可以通过设置spark.sql.streaming.schemaInference为true启用。 可以/data/year=2016/在/data/year=2015/存在时添加,但更改分区列(即通过创建目录/data/date=2016-04-17/)是无效的。 29:水位线: import spark.implicits._ val words = ... // streaming DataFrame of schema { timestamp: Timestamp, word: String } // Group the data by window and word and compute the count of each group val windowedCounts = words .withWatermark("timestamp", "10 minutes") .groupBy( window($"timestamp", "10 minutes", "5 minutes"), $"word") .count() 在这个例子中,我们正在定义查询的水印“timestamp”列的值,并且还定义了“10分钟”作为允许数据有多迟的阈值。 30:join操作: 流数据和静态数据集之间的join val staticDf = spark.read. ... val streamingDf = spark.readStream. ... streamingDf.join(staticDf, "type") // inner equi-join with a static DF streamingDf.join(staticDf, "type", "right_join") // right outer join with a static DF 流数据和流数据之间的join: 为了在流-流join的时候可以进行状态清理 水位线限制:事件处理逻辑可延时发生的最大时间 事件时间延迟:事件处理逻辑中的事件限制 import org.apache.spark.sql.functions.expr val impressions = spark.readStream. ... val clicks = spark.readStream. ... // Apply watermarks on event-time columns val impressionsWithWatermark = impressions.withWatermark("impressionTime", "2 hours") val clicksWithWatermark = clicks.withWatermark("clickTime", "3 hours") // Join with event-time constraints impressionsWithWatermark.join( clicksWithWatermark, expr(""" clickAdId = impressionAdId AND clickTime >= impressionTime AND clickTime <= impressionTime + interval 1 hour """) ) 2小时”的水印延迟保证引擎不会丢失延迟少于2小时的任何数据。但延迟超过2小时的数据可能会或可能不会得到处理。 31:虽然水印+事件时间约束对于内连接是可选的,但对于左外连接和右外连接,它们必须指定。这是因为为了在外连接中生成NULL结果,引擎必须知道输入行将来何时不会与任何事物匹配。因此,必须指定水印+事件时间约束以生成正确的结果。因此,具有外连接的查询与前面的广告示例非常相似,不同之处在于会有一个附加参数指定它为外连接。 impressionsWithWatermark.join( clicksWithWatermark, expr(""" clickAdId = impressionAdId AND clickTime >= impressionTime AND clickTime <= impressionTime + interval 1 hour """), joinType = "leftOuter" // can be "inner", "leftOuter", "rightOuter" ) 32:外部结果的生成 关于如何生成外部结果,需要注意几个重要特征。 外部NULL结果将生成延迟,这取决于指定的水印延迟和时间范围条件。这是因为引擎必须等待很长时间才能确保没有匹配,并且将来不会再有匹配。 在当前的微批处理引擎中,水印在微批处理结束时被提前,而下一个微批处理使用更新后的水印来清理状态并输出外部结果。由于我们仅在有新数据要处理时触发微量批处理,因此如果流中没有接收到新数据,则可能会延迟生成外部结果。 简而言之,如果连接的两个输入流中的任何一个在一段时间内都没有收到数据,则外部(两种情况下,左侧或右侧)输出可能会延迟。 支持流式查询中的连接矩阵

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册