首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10001篇文章
优秀的个人博客,低调大师

JavaJDBC(快速理解

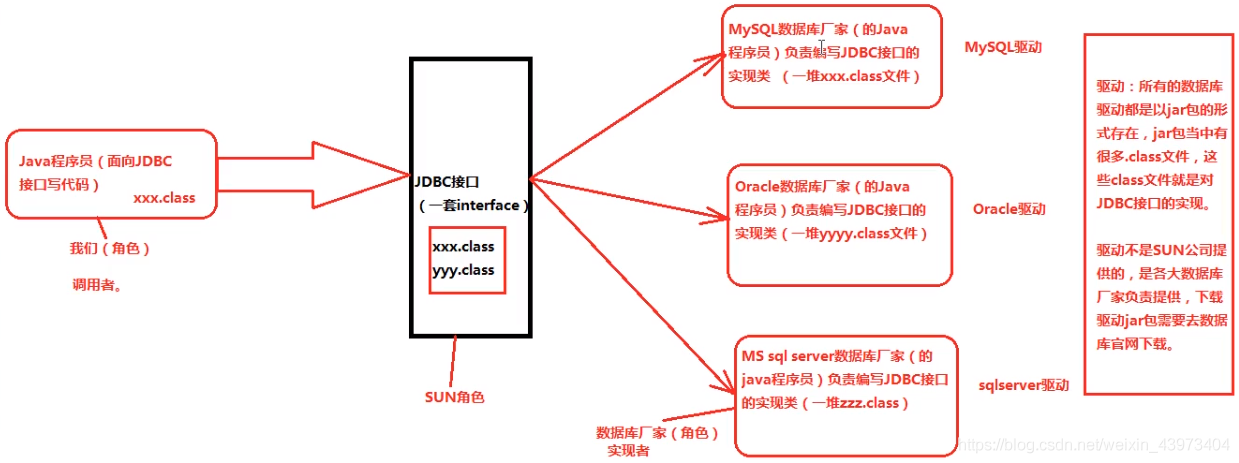
1.JDBC是什么? Java DataBase Connectivity(Java语言连接数据库) 2.JDBC的本质是什么? JDBC是SUN公司制定的一套接口(interface) java.sql.*; (这个软件包下有很多接口。) 3.JDBC开发前的准备工作,先从官网下载对应的驱动jar包,然后将其配置到环境变量classpath当中。 classpath=.;D:\course\06-JDBC\resources\MySql Connector Java 5.1.23\mysql-connector-java-5.1.23-bin.jar 以上的配置是针对于文本编辑器的方式开发,使用IDEA工具的时候,不需要配置以上的环境变量。 IDEA有自己的配置方式。 4.JDBC编程六步(需要背会) 第一步:注册驱动(作用:告诉Java程序,即将要连接的是哪个品牌的数据库) 第二步:获取连接(表示JVM的进程和数据库进程之间的通道打开了,这属于进程之间的通信,重量级的,使用完之后一定要关闭通道。) 第三步:获取数据库操作对象(专门执行sql语句的对象) 第四步:执行SQL语句(DQL DML....) 第五步:处理查询结果集(只有当第四步执行的是select语句的时候,才有这第五步处理查询结果集。) 第六步:释放资源(使用完资源之后一定要关闭资源。Java和数据库属于进程间的通信,开启之后一定要关闭。) import java.sql.Driver; import java.sql.DriverManager; import java.sql.SQLException; import java.sql.Connection; import java.sql.Statement; public class JDBCTest{ public static void main(String[] args) { Connection conn= null; Statement stmt = null; ResultSet rs = null; try{ //1.注册驱动 //第一种方式 Driver driver = new com.mysql.jdbc.Driver(); DriverManager.registerDriver(driver); //第二种方式(一下方法不需要返回值,我们只需要它的类加载动作) class.forName("com.mysql.jdbc.Driver"); //2.获取连接 String url = "jdbc:mysql://127.0.0.1:3306/bjpowernode"; String user = "root"; String password = "333"; conn = DriverManager.getConnection(url,user,password); System.out.println("数据库连接对象:"+conn); //com.mysql.jdbc.JDBC4Connection@34340fab //3.获取数据库操作对象(statement专门执行sql语句) stmt = conn.createStatement(); //4.执行sql String sql = "select empno as a,ename,sal from emp"; rs= stmt.executeQuery(sql); //executeUpdate执行DML语句 executeQuery(sql)执行DQL语句 //5.处理查询结果集 while(rs.next()) { int empno = rs.getInt("a"); String ename = rs.getString("ename"); double sal = rs.getDouble("sal"); System.out.pritnln(empno+","+ename+","+sal); } } catch(SQLException e){ e.printStackTrace(); }finally{ try{ if(stmt !=null){ stmt.close(); } }catch(SQLException e){ e.printStackTrace(); } try{ if(conn !=null){ conn.close(); } }catch(SQLException e){ e.printStackTrace(); } } } } 使用属性配置文件 //jdbc.propertes属性配置文件 driver=com.mysql.jdbc.Driver url=jdbc:mysql://localhost:3306/bjpowernode user=root password=333 import java.sql.Driver; import java.sql.DriverManager; import java.sql.SQLException; import java.sql.Connection; import java.sql.Statement; import java.util.*; public class JDBCTest{ public static void main(String[] args) { //使用资源绑定器绑定属性配置文件 ResourceBundle bundle = ResourceBundle.getBundle("jdbc"); String driver = bundle.getString("driver"); String url = bundle.getString("url"); String user = bundle.getString("user"); String password = bundle.getString("password"); Connection conn= null; Statement stmt = null; try{ //1.注册驱动 class.forName(driver); //2.获取连接 conn = DriverManager.getConnection(url,user,password); System.out.println("数据库连接对象:"+conn); //com.mysql.jdbc.JDBC4Connection@34340fab //3.获取数据库操作对象(statement专门执行sql语句) stmt = conn.createStatement(); //4.执行sql String sql = "insert into dept(deptno,dname,loc) values(50,'人事部','北京')"; int count = stmt.executeUpdate(sql); //执行DML语句 System.out.println(count == 1 ? "保存成功":"保存失败"); //5.处理查询结果集 } catch(Exception e){ e.printStackTrace(); }finally{ try{ if(stmt !=null){ stmt.close(); } }catch(SQLException e){ e.printStackTrace(); } try{ if(conn !=null){ conn.close(); } }catch(SQLException e){ e.printStackTrace(); } } } } 5.登录功能实现(防止SQL注入,PreparedStatement) package com.bjpowernode.jdbc; import java.sql.*; import java.util.HashMap; import java.util.Map; import java.util.Scanner; /*实现功能: 1.需求:模拟用户登录功能的实现。 2.业务描述: 程序运行的时候,提供一个输入的入口,可以让用户输入用户名和密码 合法:显示登录成功。 不合法:显示登录失败。 3.数据准备: 在实际的开发中使用建模工具 4.Sql注入现象(安全隐患): 根本原因 fdsa ''or 将用户名或密码的or 当做了sql语句 解决SQL注入问题: 要想用户信息不参与Sql语句编译,那么必须使用java.sql.PreparedStatement PreparedStatement是属于预编译数据库操作对象,编译一次执行多次。 PreparedStatement ps = null; 其中一个?代表一个占位符,站位符不能用点引号括起来 String sql = "select * from t_user where loginName = ? and loginPwd = ?"; ps = conn.prepareStatement(sql); 给占位符传值 ps.setString(1,loginName); ps.setString(2,loginPwd); */ public class JDBCTest06 { public static void main(String[] args) { //初始一个界面 Map<String,String> userLoginInfo = initUI(); boolean loginSuccess = login(userLoginInfo); System.out.println(loginSuccess? "登录成功!":"登录失败用户名密码错误!"); } private static boolean login(Map<String, String> userLoginInfo) { boolean loginSuccess = false; Connection conn = null; PreparedStatement ps = null;//这里是PreParedStatement(预编译数据库操作对象) ResultSet rs = null; try{ //注册驱动 Class.forName("com.mysql.jdbc.Driver"); //连接语句 conn = DriverManager.getConnection("jdbc:mysql://127.0.0.1:3306/bjpowernode","root","333"); //获取数据库操作对象 String sql = "select * from t_user where loginName = ? and loginPwd = ?"; ps = conn.prepareStatement(sql); //给占位符传值 ps.setString(1,userLoginInfo.get("loginName")); ps.setString(2,userLoginInfo.get("loginPwd")); rs = ps.executeQuery(); if (rs.next()) { loginSuccess = true; } }catch (ClassNotFoundException e){ e.printStackTrace(); }catch (SQLException e) { e.printStackTrace(); }finally { if (rs !=null){ try { rs.close(); }catch (SQLException e) { e.printStackTrace(); } } if (ps !=null){ try { ps.close(); }catch (SQLException e) { e.printStackTrace(); } } if (conn !=null) { try{ conn.close(); }catch (SQLException e) { e.printStackTrace(); } } } return loginSuccess; } /* * 初始化用户页面 * @return 用户输入用户名密码等登录信息 * */ private static Map<String, String> initUI() { Scanner s = new Scanner(System.in); System.out.println("用户名:"); String loginName = s.nextLine(); System.out.println("密码:"); String loginPwd = s.nextLine(); Map<String,String> userLoginInfo = new HashMap<>(); userLoginInfo.put("loginName",loginName); userLoginInfo.put("loginPwd",loginPwd); return userLoginInfo; } } Statement的用处(需要SQL注入) Statement存在SQL注入问题,是编译一次执行一次。PreparedStatement执行效率高。 需要先 用户台输入desc降序,输入asc升序,此时需要使用Sql注入 String keyWords = desc或者asc String sql = "select ename = from emp order by ename " + keyWords; 6.账户转账演示事务 sql脚本 drop table if exists t_act; create table t_act( actno bigint, balance double(7,2) //注意:7表示有效数字,2表示小数位个数 ); insert into t_act(actno,balance) values(111,20000); insert into t_act(actno,balance) values(222,0); commit; select * from t_act; 重点三句: conn.setAutoCommit(false); conn.commit(); conn.rollback(); public class HelloWorld { public static void main(String []args) { Connection conn = null; PreparedStatement ps = null; try{ //注册驱动 Class.forName("com.mysql.jdbc.Driver"); //获取连接 conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/bjpowernode","root","333"); //将自动提交机制改为手动提交 conn.setAutoCommit(false);//开启事务 //获取预编译的数据库操作系统 String sql = "update t_act set balance = ? where actno = ?"; ps = conn.prepareStatement(sql); //给替换符赋值 ps.setDouble(1,10000); ps.setInt(2,111); int count = ps.executeUpdate(); ps.setDouble(1,10000); ps.setInt(2,222); count +=ps.executeUpdate(); //程序到这里表示成功 conn.commit(); //提交事务 Syste.out.println(count == 2 ?"转账成功":"转账成功"); }catch(Exception e) { if(conn != null) { try{ //回滚事务 conn.rollback(); }catch(SQLException e) { e.printStackTrace(); } } e.printStackTrace(); } } } 7.JDBC工具类封装 import java.sql.*; public class DBUtil { private DBUtil() { } //工具类的构造方法是私有的; //因为工具类的方法是静态的,不需要实例化 static { try { Class.forName("com.mysql.jdbc.Driver"); } catch (ClassNotFoundException e) { e.printStackTrace(); } } //获取数据库连接对象 //@return 连接对象 public static PreparedStatement createStatement(String sql) throws SQLException { Connection conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/bjpowernode", "root", "333"); PreparedStatement ps = conn.prepareStatement(sql); return ps; } //关闭资源 //conn 连接对象 //ps 数据库操作对象 //rs 结果集 public static void close(Connection conn, Statement ps, ResultSet rs) { if (rs != null) { try { rs.close(); } catch (SQLException e) { e.printStackTrace(); } } if (ps != null) { try { ps.close(); } catch (SQLException e) { e.printStackTrace(); } } if (conn != null) { try { conn.close(); } catch (SQLException e) { e.printStackTrace(); } } } }

优秀的个人博客,低调大师

ArrayList源码理解

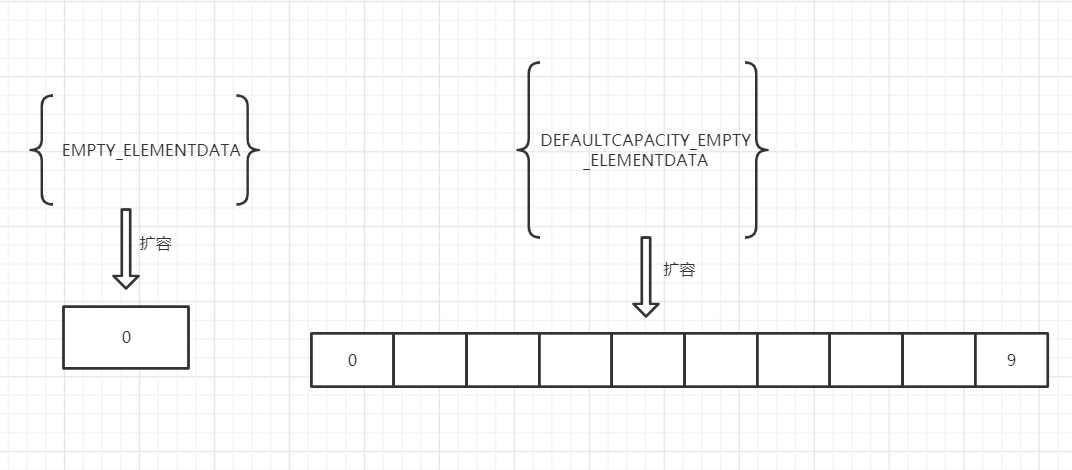
ArrayList是最常见的集合类,顾名思义,ArrayList就是一个以数组形式实现的集合。它拥有List集合的特点: 存取有序 带索引 允许重复元素 它本身的特点是: 查找元素快 顺序插入快 那ArrayList为什么会有这些特性的?其实从源码中我们就能够了解到它是如何实现的。 Resizable-array implementation of the {@code List} interface. Implements all optional list operations, and permits all elements, including {@code null}. In addition to implementing the {@code List} interface,this class provides methods to manipulate the size of the array that is used internally to store the list. 实现了List接口的,一个可调整大小的数组。可以存储所有的元素,包括null,除了实现了List接口的方法外,还提供了一些方法用于操作内部用于存储元素的数组的大小。 public class ArrayList<E> extends AbstractList<E> implements List<E>, RandomAccess, Cloneable, java.io.Serializable RandomAccess标记接口 表示ArrayList支持随机访问。什么是随机访问呢?随机访问是说你可以随意访问该数据结构中的任意一个节点,假设该数据结构有10000个节点,你可以随意访问第1个到第10000个节点。因为ArrayList用数组来存数据,Java中给数组划分内存来存储元素时,划分的是一块连续的内存地址,这些相邻元素是按顺序连续存储的。只要知道起始元素的地址First,直接first+N,便可以得到第N个元素的地址。这就是ArrayList查找快的原因。 Cloneable标记接口 表示ArrayList是可以被克隆的。 java.io.Serializable标记接口 表示ArrayList是可以被序列化的。 主要成员变量: @java.io.Serial private static final long serialVersionUID = 8683452581122892189L; 用于标明序列化时的版本号。 private static final int DEFAULT_CAPACITY = 10; 默认初始化大小。 private static final Object[] EMPTY_ELEMENTDATA = {}; 默认空数组大小。 private static final Object[] DEFAULTCAPACITY_EMPTY_ELEMENTDATA = {}; 默认初始化空数组大小。 看到这可能有人会有疑问,同样是空数组,为什么要有两个引用变量来表示呢?且看后面的扩容机制说明。 transient Object[] elementData; 这就是ArrayList所维护的用于存储数据的数组了,transient标明这个存储数据的数组不会被序列化,而ArrayList却又打上了标记接口java.io.Serializable说明是可序列化的,这不是自相矛盾了吗?暂且按下不表,看看ArrayList的内部机制再回头说明。 private int size; ArrayList的大小(其实也就是其中包含的元素个数)。 构造方法: //传入了初始值的 public ArrayList(int initialCapacity) { if (initialCapacity > 0) { this.elementData = new Object[initialCapacity]; } else if (initialCapacity == 0) { this.elementData = EMPTY_ELEMENTDATA; } else { throw new IllegalArgumentException("Illegal Capacity: "+ initialCapacity); } } //没有传入初始值的 public ArrayList() { this.elementData = DEFAULTCAPACITY_EMPTY_ELEMENTDATA; } //传入一个Collection集合的 public ArrayList(Collection<? extends E> c) { elementData = c.toArray(); if ((size = elementData.length) != 0) { if (elementData.getClass() != Object[].class) elementData = Arrays.copyOf(elementData, size, Object[].class); } else { // replace with empty array. this.elementData = EMPTY_ELEMENTDATA; } } 可以看到,如果传入了初始值initialCapacity,就会按照这个值来初始化数组的大小。如果传入0,则数组等于EMPTY_ELEMENTDATA,如果用了空参构造,则数组等于DEFAULTCAPACITY_EMPTY_ELEMENTDATA。 扩容机制: 我们知道,Java中数组一旦定义则长度是不允许改变的,那么ArrayList如何实现_Resizable-array implementation(可调整大小的数组实现)?_ 答案就在扩容机制上: //传入最小所需要的容量 private Object[] grow(int minCapacity) { //当前容量大小 int oldCapacity = elementData.length; //若当前容量大小大于0且数组创建是不是通过空参构造创建的 if (oldCapacity > 0 || elementData != DEFAULTCAPACITY_EMPTY_ELEMENTDATA) { //定义新的最小所需容量 int newCapacity = ArraysSupport.newLength(oldCapacity, minCapacity - oldCapacity, /* minimum growth */ //右移一位,类似于除以2 oldCapacity >> 1 /* preferred growth */); return elementData = Arrays.copyOf(elementData, newCapacity); } else { return elementData = new Object[Math.max(DEFAULT_CAPACITY, minCapacity)]; } } //传入当前容量,最小需要增加的容量,首选增长的容量 public static int newLength(int oldLength, int minGrowth, int prefGrowth) { // assert oldLength >= 0 // assert minGrowth > 0 //将最小所需要增加的容量与首选增长的容量比较,取较大的与当前容量相加 int newLength = Math.max(minGrowth, prefGrowth) + oldLength; if (newLength - MAX_ARRAY_LENGTH <= 0) { return newLength; } return hugeLength(oldLength, minGrowth); } 我们每次添加元素的时候,都会去确认一下当前ArrayList所维护的数组存储的元素是否已经达到上限(元素个数等于数组长度)?如果是的话,就会触发扩容机制grow()去创建一个新的更大的数组来转移数据。 可以看到,若是我们通过传入参数0来构造ArrayList,grow()就会判断出来这个是一个长度为0的自定义空数组,那么就会按照最小的所需要的容量扩容。 如果没有传入参数,就用默认初始容量10,来创建初始的数组。 而且我们可以看到,扩容的时候会判断所需要的最小容量是不是比当前数组的1.5倍还大?不是就按照当前数组长度的1.5倍来扩容,否则就按传进来的最小所需容量来扩容。 为什么是1.5倍呢? 1.如果一次性扩容扩得太大,必然造成内存空间的浪费。 2.如果一次性扩容扩得不够,那么下一次扩容的操作必然比较快地会到来,这会降低程序运行效率,要知道扩容还是比较耗费性能的一个操作,因为会新建数组移动数据。 所以扩容扩多少,是JDK开发人员在时间、空间上做的一个权衡,提供出来的一个比较合理的数值。 添加元素: //添加单个元素,默认添加到集合尾 public boolean add(E e) { modCount++; add(e, elementData, size); return true; } //实际调用的方法 private void add(E e, Object[] elementData, int s) { if (s == elementData.length) elementData = grow(); elementData[s] = e; size = s + 1; } //添加另一个集合,默认添加到集合尾 public boolean addAll(Collection<? extends E> c) { Object[] a = c.toArray(); modCount++; int numNew = a.length; if (numNew == 0) return false; Object[] elementData; final int s; if (numNew > (elementData = this.elementData).length - (s = size)) elementData = grow(s + numNew); //5个参数的意思分别是:源数组,源数组开始复制的位置,目标数组,目标数组开始接收的位置,接收的长度 System.arraycopy(a, 0, elementData, s, numNew); size = s + numNew; return true; } 基本上很浅显易懂,只要容量够就能直接添加,否则得扩容。 其中modCount是用于快速失败的一种机制,因为基本集合在多线程环境下是不安全的,这个以后再讨论。 删除元素: //按元素删除 public boolean remove(Object o) { final Object[] es = elementData; final int size = this.size; int i = 0; //标签旧方法,用于跳出多个循环 found: { if (o == null) { for (; i < size; i++) if (es[i] == null) break found; } else { for (; i < size; i++) if (o.equals(es[i])) break found; } return false; } fastRemove(es, i); return true; } //按索引删除 public E remove(int index) { Objects.checkIndex(index, size); final Object[] es = elementData; @SuppressWarnings("unchecked") E oldValue = (E) es[index]; fastRemove(es, index); return oldValue; } //实际执行方法 private void fastRemove(Object[] es, int i) { modCount++; final int newSize; if ((newSize = size - 1) > i) System.arraycopy(es, i + 1, es, i, newSize - i); es[size = newSize] = null; } 分两种情况,一种是按照传入的元素去删除,这样得从数组开头遍历过去并且逐一调用equals方法比较,只要找到第一个符合的就将其删除。 第二种是按照传入的索引去删除,这个可以直接定位。另外需要注意的一点是当ArrayList里存储的是Integer包装类的时候,依然是选择索引删除。 删除的意思是将数组此位置的元素的引用设置为null,如果没有另外的引用指向此元素,那么此元素就会被标记为垃圾被回收。 如果删除的元素在最后就不用移动元素了,如果不在就需要移动元素。 插入元素: public void add(int index, E element) { rangeCheckForAdd(index); modCount++; final int s; Object[] elementData; if ((s = size) == (elementData = this.elementData).length) elementData = grow(); System.arraycopy(elementData, index, elementData, index + 1, s - index); elementData[index] = element; size = s + 1; } 先判断容量是否足够,再去将此位置以及后面的元素全部向后移动一位,最后将传入的元素插入此位置。 最后说明: 了解了ArrayList的各种机制,我们就能知道为什么存储元素的elementData用transient修饰了 //序列化 @java.io.Serial private void writeObject(java.io.ObjectOutputStream s) throws java.io.IOException { // Write out element count, and any hidden stuff int expectedModCount = modCount; s.defaultWriteObject(); // Write out size as capacity for behavioral compatibility with clone() s.writeInt(size); // Write out all elements in the proper order. for (int i=0; i<size; i++) { s.writeObject(elementData[i]); } if (modCount != expectedModCount) { throw new ConcurrentModificationException(); } } //反序列化 @java.io.Serial private void readObject(java.io.ObjectInputStream s) throws java.io.IOException, ClassNotFoundException { // Read in size, and any hidden stuff s.defaultReadObject(); // Read in capacity s.readInt(); // ignored if (size > 0) { // like clone(), allocate array based upon size not capacity SharedSecrets.getJavaObjectInputStreamAccess().checkArray(s, Object[].class, size); Object[] elements = new Object[size]; // Read in all elements in the proper order. for (int i = 0; i < size; i++) { elements[i] = s.readObject(); } elementData = elements; } else if (size == 0) { elementData = EMPTY_ELEMENTDATA; } else { throw new java.io.InvalidObjectException("Invalid size: " + size); } } 其实主要是看里边的两个循环的方法,涉及到的是size。我们已经了解了存放元素的数组会动态的改变,因此里边未必就存满了元素。真正有多少个元素是size负责的。所以我们序列化的时候仅仅去遍历size个对象就能完成序列化了。这样就能避免序列化太多不需要的东西,加快序列化速度以及减小文件大小。 总结: 在需要顺序添加数据以及快速访问数组的场景,ArrayList最适合被使用。
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册