首页 文章 精选 留言 我的

精选列表

搜索[子流程],共10000篇文章
优秀的个人博客,低调大师

Cline 接入 GLM-5.2 实战:配置流程、思考模式体验及与 Sonnet 5 的成本差异

Cline 按 token 计费,而且花起来毫不手软。每一轮它都会把你的文件树、打开的缓冲区、还有正在跑的任务日志重新发一遍,所以你选哪个模型,一天之内就会体现在账单上。很多团队为了让这个循环更便宜、又不想换成一个连重构都扛不住的模型,就会选 GLM-5.2。这篇指南大约五分钟把它接进 Cline。 有两个地方最容易踩坑,而且都不是大家一开始担心的那些。第一,GLM-5.2 不是 Claude 模型,所以它不该填进大多数 Cline 教程让你填的那个位置。第二,思考开关的行为跟 Sonnet 5 的不一样。这两点下面都会讲,还有那份成本对比,它决定了 GLM-5.2 到底值不值得取代 Claude Sonnet 5。 ## 配好之后能做什么(以及不能做什么) 配好之后,GLM-5.2 就会作为 agent 驱动 Cline:读文件、给出 diff、执行命令,全程用满 1M token 的上下文。在你花掉这五分钟之前,先说清楚它的真实边界。 | 问题 | 结论 | | --- | --- | | GLM-5.2 能当完整的 Cline agent 吗? | 能,OpenAI Compatible provider 就能用上工具调用。 | | 它走 Anthropic provider 那个位置吗? | 不。那个位置是给 Claude 的。GLM 走 OpenAI Compatible。 | | 能控制推理深度吗? | 部分能。Cline 会发一个 reasoning-effort 提示;但你关不掉 GLM 的思考。 | | 完整的 1M 上下文能用吗? | 能,前提是在 Cline 里把上下文窗口设成 1000000。 | | 比 Claude Sonnet 5 便宜吗? | 按牌价便宜,大约 1.6-1.9x。缓存会拉近差距。 | | 工具调用会像 Claude 那样干净吗? | 不一定。GLM 在 Cline 里有记录在案的工具调用解析怪毛病。 | ## 决策框架:什么时候在 Cline 里用 GLM-5.2(什么时候别用) GLM-5.2 在写代码上是实打实的高性价比选择,不是降级。但它不是闭着眼就该选的那个,在错误的场景里选它,要么多花钱,要么搭进去一上午去调工具调用。 ### 适合用 GLM-5.2 的场景 - 你的 Cline 会话又长又涉及大量文件,决定账单的是 token 用量而不是峰值推理能力,这时更低的输出单价会迅速滚出复利。 - 你想要一个以写代码为先、带真正 1M 窗口的模型来处理大仓库。 - 你本来就用一个 OpenAI 兼容端点路由多种模型,想加一个便宜的默认项,又不想再接一套集成。 ### 不该用它的场景 - 你是 Claude 重度用户,看重原生工具调用、缓存控制和 effort 旋钮。Sonnet 5 走 Cline 的 Anthropic provider 三样全保留,那 ~1.6x 的价差不一定值得你去忍受更粗糙的集成。 - 任务是棘手的跨文件重构,或者一个隐蔽的并发 bug,更强的模型一遍搞定而不是三遍。把升级模型的机会留给这类活儿,剩下 80% 交给 GLM。 - 你需要在琐碎的回合里彻底关掉推理。从 Cline 出发,GLM 默认一直开着思考,而这个你在 UI 里改不了(下面会讲)。 ### 到此为止规则 如果你的目标只是让 Cline 指向一个便宜的写代码模型,那就做完第 1 到第 5 步,设好上下文窗口,就可以收手了。思考模式和成本那两节是给要在花钱和质量之间做权衡的人看的,跟基础接入无关。 ## 环境要求 - **VS Code 加从应用市场装的 Cline 扩展**,用较新的版本。GLM 的工具调用处理在最近几个版本里一直在改进,所以旧版本是常见的麻烦来源。 - **一个 API key**,对应一个提供 GLM-5.2 的后端。本文用的是 ,一个 OpenAI 兼容的网关,所以同一个 key 在你想升级处理难回合时也能触达 Claude、GPT 等其他模型。 - **能连通**你的端点。如果在公司的 TLS 代理后面,先把证书问题解决掉;我们那篇 Claude Code SSL 证书报错指南 里同样的 Node 规则也适用于 Cline。 ## 分步操作:在 Cline 里跑 GLM-5.2 整个配置就是五个字段加一条测试消息。真正需要动脑的只有第 1 步,而且它的答案跟 Claude 正好相反。 ### 第 1 步:选对 provider 位置(不是 Claude 那个) Cline 提供两条接入路径。大多数教程让你用 Anthropic provider,因为大多数教程讲的是 Claude。GLM-5.2 不是 Claude,所以这里选那个位置就错了。 | Provider 位置 | Base URL | 用途 | | --- | --- | --- | | OpenAI Compatible | ` | GLM-5.2 以及任何非 Claude 模型 | | Anthropic | ` | 仅限 Claude 模型 | 选 **OpenAI Compatible**。这个网关确实也一个 Anthropic 协议的端点暴露了 GLM-5.2,如果你是从 Claude Code 里驱动它,那一点很重要,但在 Cline 内部,OpenAI Compatible 这个位置才是行为正常的路径。 ### 第 2 步:打开 Cline 设置并选择 provider 点 VS Code 活动栏里的 Cline 图标,再点面板顶部的齿轮图标。在 **API Provider** 下面选 **OpenAI Compatible**。 ### 第 3 步:填 base URL 和 key 把 base URL 和你的 API key 粘进去。 ``` Base URL: API Key: sk--... ``` 预期结果:字段保存成功,Cline 不再提示缺少 key。 ### 第 4 步:填 Model ID 把 Model ID 填成带命名空间的 id,前缀也要带上: ``` z-ai/glm-5.2 ``` 光写 `glm-5.2` 在网关上会失败,因为目录是按 provider 划分命名空间的。如果你在别处见过 `glm-5.2[1m]`,那个别名是 Claude Code 在 Z.ai 自家编码端点上用来开启 1M 窗口的约定,不是 Cline 的 OpenAI Compatible 字段想要的东西。在这里,model ID 和上下文设置是分开各管一摊的。完整的接入路径清单、以及每个 ID 适用于哪里,都在我们的 GLM-5.2 接入指南 里。 ### 第 5 步:设置上下文窗口并测试 在 OpenAI Compatible 的模型设置里,把上下文窗口设成 `1000000`。GLM-5.2 自带 1M token 窗口;如果你让 Cline 停在更小的默认值上,它会在长任务里悄悄丢掉早先的工具调用步骤,表现出来就像模型在重构中途「跟丢了线索」。 然后在 Cline 聊天框里发一条简短消息,比如「列出这个项目里的文件」。如果 Cline 读了文件树并回复,说明线路已经通了。接着给它派一件小事,比如「给 `parseConfig` 函数加输入校验,再配一个测试」,看它是不是能自己读文件、给出一个待你批准的 diff、并运行测试。如果它只读不写,那是 GLM 已知的行为,不是你配置的问题;报错那一节会讲到。 在把一个项目押在它身上之前,你可以在 GLM-5.2 的 模型页 上确认它当前的 model ID 和每 token 单价。 ## 思考开关:Cline 到底发给 GLM-5.2 什么 这一节最会让从 Claude 配置过来的人意外,所以值得说精确些。 当 Cline 启用思考模式时,会在请求体中附加 `thinking` 参数块,智谱原生端点与 的兼容层对该字段的解析行为存在差异,需在实际请求日志中确认模型是否正确触发了推理链输出。 GLM-5.2 是一个推理模型,思考**默认开启**。Z.ai 的文档明确写着思考是 “activated by default in GLM-5.2 … series”(同一句话也涵盖 GLM-5.1、GLM-5 和 GLM-4.7)。文档里改这个的办法,是在请求上加一个 `thinking` 对象: ``` "thinking": { "type": "disabled" } ``` 问题就在这儿。Cline 的 OpenAI Compatible provider 不会发送那个对象。它的 Model Configuration 里有一个 Reasoning Effort 选择器,默认是 `none`;把它设成 low、medium 或 high,Cline 转而发送一个 `reasoning` 对象(`{enabled: true, effort}`)。这是两个不同的控制项,而 GLM 的开关那个,Cline 从来不碰。 Cline OpenAI Compatible reasoning: {effort} none (default) · low/med/high Gateway / OpenRouter GLM-5.2 thinking: {type: enabled} default, cannot toggle Cline 从不发送 thinking:{type:disabled},所以 GLM 一直在思考。 effort 选择器只调深浅,不是关闭开关。 落到实处是这样: | 控制项 | Cline OpenAI Compatible | GLM-5.2 原生 | | --- | --- | --- | | 开/关思考 | 未暴露 | `thinking: {type: enabled/disabled}`,默认开 | | 调整推理深度 | Reasoning Effort 选择器,默认 `none`(low/medium/high) | 取决于网关的映射(各网关未逐一验证) | | 推理输出 | 以 `reasoning_content` 返回 | 以 `reasoning_content` 返回 | | 发送任何推理提示 | 把选择器从默认的 `none` 拨开 | 默认开启 | 有两条结论值得记牢。第一,只要你想让任何推理提示到达模型,就必须把 Reasoning Effort 选择器从默认的 `none` 拨开;停在 `none` 上,Cline 根本不发送任何推理参数。第二,那个 `reasoning` 对象到底会不会改变 GLM 的行为,取决于网关有没有把它翻译成 GLM 自己的 `thinking` 控制项,而且无论如何它都不会关闭思考。GLM 会思考;这些 token 会按输出计费。为它做预算,而不是想着把它关掉。 ## GLM-5.2 对比 Claude Sonnet 5:算笔成本账 这是决定你怎么配的那份对比。两个模型都能写代码,都带 1M 上下文,在 上又都在同一个 key 后面,所以这是一次真正的选择,而不是一次迁移。 以每百万 token 计价对比时,若等中间层网关调用 GLM-5.2,其输入与输出单价均低于 Claude Sonnet 5 的官方定价,具体差值需参照各平台当前公示费率进行核算。 | 模型 | 输入 | 输出 | 缓存读取 | 上下文 | Model ID | | --- | --- | --- | --- | --- | --- | | GLM-5.2 | $1.4/M | $4.4/M | $0.26/M | 1M | `z-ai/glm-5.2` | | Claude Sonnet 5 | $2/M | $10/M | $0.20/M | 1M | `anthropic/claude-sonnet-5` | 上面 Sonnet 5 的单价是 Anthropic 的引入期定价,按 Anthropic 定价文档,有效期到 August 31, 2026;之后的标准单价是输入 $3/M、输出 $15/M,这会进一步拉大 GLM 的领先。当前的每 token 数字与 模型页一致。 按 2:1 的输入输出比混合一下,这是写代码回合的典型比例:GLM-5.2 落在每百万 token $2.40 附近,Sonnet 5 落在 $4.67 附近。这在牌价上大约是 1.9x 的差距,把 Sonnet 5 更便宜的缓存读取算进去后,还能维持在 1.6x 左右。注意 Sonnet 唯一胜出的地方:它的缓存读取 $0.20/M 实际上比 GLM 的 $0.26/M 更低,所以对于 Cline 每一轮都要重发、依赖的那部分上下文,Sonnet 的缓存按每个缓存 token 算稍微更划算。 给一次会话套上真实数字。假设一次工作会话在很多轮里大约走了 2M 输入和 200K 输出: | 场景 | GLM-5.2 | Claude Sonnet 5 | | --- | --- | --- | | 单次会话,无缓存 | ~$3.68 | ~$6.00 | | 单次会话,约 70% 上下文命中缓存 | ~$2.08 | ~$3.48 | | 团队一个月(5 名开发 x 20 天,含缓存) | ~$208 | ~$348 | 所以 GLM-5.2 是实打实地更便宜,对现实中带缓存的负载来说大约 1.6x,而不是你拿一个性价比模型去比旗舰时看到的那种 5x。这个差距在团队规模下就是真金白银,也正是把 GLM 当默认驱动的全部理由。它也小到这个程度:如果你本来就是 Claude 用户,从 Cline 的 Anthropic provider 那里拿到了原生工具调用和缓存控制,那继续留在 Sonnet 5 上也是站得住脚的选择。想看对其他前沿模型更深入的每 token 拆解,见我们的 GLM-5.2 对比 GPT-5.5 成本分析,想看这套配置在 Claude 那一侧怎么做,见 Claude Sonnet 5 接入 Cline 指南。 ## 配置中的常见报错(及修复) GLM 的开源权重血统意味着它在 Cline 里的集成比 Claude 更粗糙,而大多数摩擦都有详尽记录,并不神秘。 | 症状 | 原因 | 修复 | | --- | --- | --- | | `model not found` | 用了裸 ID,或者把 `glm-5.2[1m]` 别名用在了错误的端点上 | 在 OpenAI Compatible 位置上用 `z-ai/glm-5.2` | | 只读文件,从不编辑 | GLM 反复解析文件却不发出编辑调用(Cline [#7486](https://github.com/cline/cline/issues/7486),GLM-4.6/MiniMax-M2,closed) | 任务拆小、上下文保持 1M;顽固的回合就升级模型 | | 工具标签显示成纯文本,然后卡住 | 思考 token 泄漏进 `content`,Cline 把整段都当成了推理(Cline [#5843](https://github.com/cline/cline/issues/5843),GLM-4.5,closed) | 把 Cline 升级到能解析 GLM `reasoning_content` 的版本 | | 推理提示不起作用 | Reasoning Effort 停在默认的 `none` 上,不会发送任何推理参数(Cline [#6581](https://github.com/cline/cline/issues/6581),gpt-5,closed) | 在模型选项里把 Reasoning Effort 设成 low/medium/high | | 模型在任务中途忘掉早先的步骤 | 上下文窗口停在 Cline 的默认值上 | 把上下文窗口设成 `1000000` | | `401 Unauthorized` | key 对应的是另一个网关,或者是空的 | 粘贴与你 base URL 匹配的 key | 如果一个 model ID 能解析成功,但回复感觉被截断了,检查一下 Cline 的最大输出设置是不是在推理过程和真正的回复都还没放下之前就把答案裁掉了。GLM-5.2 支持最多 128K 输出 token,但 Cline 的默认上限要低得多。 ## 团队 / 多人开发配置 对团队来说,收益在于一个端点、一套模型策略,而不是每个人各自拿着自己的 GLM 订阅去配自己的 key。注册单个网关,你的密钥管理器给每位开发发一个 key,再把 Cline 的 provider 设置标准化,让所有人都同一个 base URL 路由 `z-ai/glm-5.2`。账单归到一处,切换整个团队的默认模型只是改一行共享 Model ID,而不是让一整队人各自重配一遍。 与之配套的习惯是模型分层:把 GLM-5.2 当成大多数回合的便宜默认项,只把真正难的那些升级到更强的模型。因为 用同一个 key 暴露了 GLM、Claude 和其他模型,升级就是换一个 Model ID,而不是接一套新集成。这套路由逻辑跟我们 30 美元 AI 编码栈指南 里的一样,端点的通用机制则在 Cline API 配置指南 里。 ## 备选方案:跑 GLM-5.2 的其他路子 用 Cline 是本文推荐的配置,因为一个 key 就覆盖了 GLM 以及所有你会升级过去的模型。但这不是唯一的路子。 除直连智谱 API 外,也可聚合网关层调用 GLM-5.2,OpenRouter 和 均支持将其作为后端模型,Cline 只需对应填写各平台的 base_url 与 API key 即可完成路由切换。 - **(OpenAI Compatible),推荐。** 在 ` 上用 `z-ai/glm-5.2`,按量付费,同一个 key 在难回合里还能触达 Claude 和 GPT。 - **直连 Z.ai。** Z.ai 自家的 API 和 Coding Plan 原生提供 GLM-5.2,包括编码端点上用来开 1M 窗口的 `glm-5.2[1m]` 别名。如果你只用 GLM、又想要原生的 `thinking` 控制,这条最便宜。GLM-5.2 接入指南 里有完整走法。 - **OpenRouter。** 也在一个 OpenAI 兼容位置后面暴露了 `z-ai/glm-5.2`,如果你本来就把一切都路由过它,这个有用。见 [openrouter.ai/z-ai/glm-5.2](https://openrouter.ai/z-ai/glm-5.2)。 - **自托管开源权重。** 如果你的负载撑得起硬件成本,GLM-5.2 的权重让本地 vLLM 部署成为可能。我们在 在 vLLM 上自托管 GLM-5.2 里算过这笔账,免费档的路径则在 GLM-5.2 免费:$0 路线 里。 ## FAQ **怎么在 Cline 里跑 GLM-5.2?** 打开 Cline 设置,选 OpenAI Compatible provider,把 Base URL 设成 ` key,把 Model ID 设成 `z-ai/glm-5.2`,再把上下文窗口设成 `1000000`。发一条测试消息。 **Cline 用哪个 model ID 跑 GLM-5.2?** 网关用 `z-ai/glm-5.2`,前缀要带上。光写 `glm-5.2` 会失败,而 `glm-5.2[1m]` 别名属于 Z.ai 的编码端点,不属于 Cline 的 OpenAI Compatible 字段。 **GLM-5.2 能用 Cline 的 agent 模式吗?** 能,OpenAI Compatible 它能读文件、写 diff、执行命令。工具调用要经过一层转换,GLM 又有记录在案的解析怪毛病,所以把命令审批保持开着。 **怎么在 Cline 里关掉 GLM-5.2 的思考?** 从 UI 里关不掉。思考默认开启,而关闭开关是 `thinking: {type: disabled}` 参数,Cline 的 OpenAI Compatible 路径不会发送它。Reasoning Effort 选择器(默认 `none`)调的是深浅,不是开/关。 **GLM-5.2 比 Claude Sonnet 5 便宜吗?** 按牌价便宜,大约 1.6-1.9x(在 上是 $1.4/$4.4 对 $2/$10)。Sonnet 5 更便宜的缓存读取加上它在 Cline 里的原生集成,会拉近实际差距。 **为什么 GLM 只读文件却从不编辑?** 同样的行为在更早的 GLM 版本(GLM-4.6)上被记录在 Cline issue #7486 里,现已 closed;它在兼容路径上用 5.2 时仍可能冒出来。任务拆小、上下文保持 1M;如果一直这样,就把这个回合升级模型。 **为什么输出里会看到 `` 标签或原始推理内容?** GLM 的 `reasoning_content` 泄漏进了主输出流,Cline 就在工具调用上卡住了。把 Cline 升级到能解析这个推理字段的版本。 **上下文窗口该设多少?** `1000000`。GLM-5.2 有 1M 窗口、最多 128K 输出;设小了会在长任务里丢掉早先的步骤。 ## 本次更新核对的来源 - [Z.ai 思考模式文档](https://docs.z.ai/guides/capabilities/thinking-mode)。确认 GLM-5.2 默认开启思考、`thinking: {type}` 参数以及 `clear_thinking`(2026-07-28 核对)。 - [Z.ai GLM-5.2 模型参考](https://docs.z.ai/guides/llm/glm-5.2)。1M 上下文、最多 128K 输出、以及 `reasoning_content` 字段的来源。 - [Cline 仓库](https://github.com/cline/cline) 及 issue [#5843](https://github.com/cline/cline/issues/5843)(GLM-4.5)、[#6581](https://github.com/cline/cline/issues/6581)(gpt-5)、[#7486](https://github.com/cline/cline/issues/7486)(GLM-4.6/MiniMax-M2),均为 closed。兼容路径上的 reasoning-effort 处理与 GLM 工具调用行为。 - 模型页 z-ai/glm-5.2 和 anthropic/claude-sonnet-5。每 token 单价 $1.4/$4.4 和 $2/$10,缓存读取 $0.26/M 和 $0.20/M(2026-07-28 核对)。 - [Anthropic 定价文档](https://platform.claude.com/docs/en/about-claude/pricing)。Sonnet 5 引入期窗口(至 August 31, 2026)以及之后标准 $3/$15 单价的来源。 --- **参考来源** - ofox 文档:用量与配额追踪 — https://docs.ofox.io/zh/develop/observability/usage-tracking

优秀的个人博客,低调大师

分析全志Tina打包流程,并在buildroot上来实现打包生成tina镜像,支持PhoenixSuit烧写

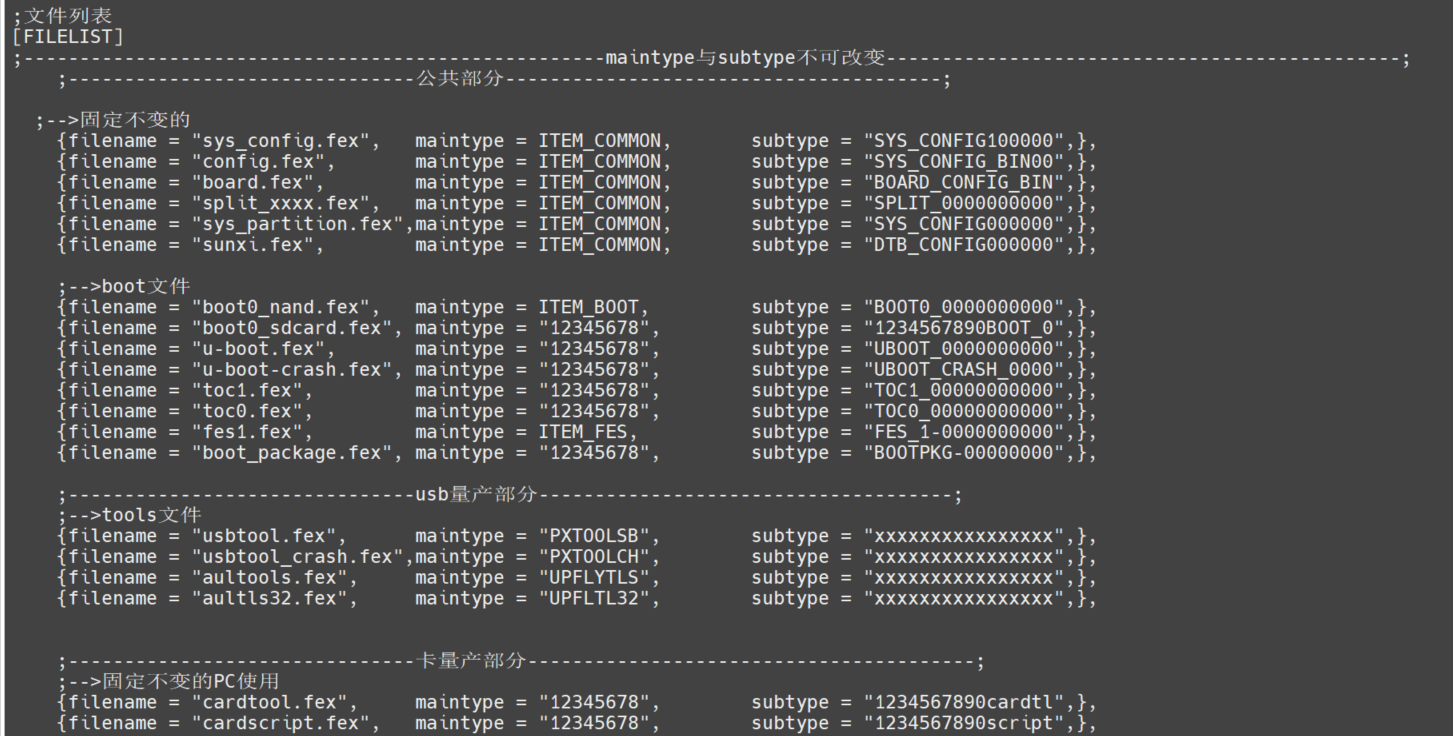
Tina里面所有的 downloadfile文件 都是我们编译出来要烧写的文件。所以只需要把相应的文件放到这个目录下,就可以进行打包操作了。 如果你在不改变 文件大小的前提下,可以直接执行tina-d1-h/tools/pack-bintools/src/dragon image.cfg sys_partition.fex 命令,你会发现它生成了一个 tina_d1-h-nezha_uart0.img,镜像,这个镜像是和使用pack命令打包生成的一样。 那么这里面还有一个 img.cfg文件。这个文件里面包含了很多 fex二进制文件,目前我认为这些文件都是和全志官方的烧写工具绑定死的,所以不用管它,只要制作的时候 当前目录下有这些工具即可。 有了这两个文件以后,就可以直接使用 dragon打包生成可以用 凤凰烧写器 烧写的系统镜像啦。 sys_partiton分析 如果你的系统镜像格式 一直保持大小不变,那么上面这个命令 就可以一直用,但是这个时候 我想自己编译内核 增加 驱动模块,编译文件系统 增加组件 导致系统镜像变大了 这要怎么办? 简单点,直接修改 sys_partition.fex为 文件大小不就可以了吗? 但是你会发现 这样做不行,他会提示错误。 这个时候 我们就要继续分析 log日志输出了,会发现,我们执行 dragon打包 只有下面这些输出信息,没有上面的 GPT/MBR分区信息。 /home/book/D1s-Core/tina-d1-h/tools/pack-bintools/src/ /home/book/D1s-Core/tina-d1-h/out/d1-h-nezha/image Begin Parse sys_partion.fex Add partion boot-resource.fex BOOT-RESOURCE_FEX Add partion very boot-resource.fex BOOT-RESOURCE_FEX FilePath: boot-resource.fex FileLength=2f8c00Add partion env.fex ENV_FEX000000000 Add partion very env.fex ENV_FEX000000000 FilePath: env.fex FileLength=20000Add partion env.fex ENV_FEX000000000 Add partion very env.fex ENV_FEX000000000 FilePath: env.fex FileLength=20000Add partion boot.fex BOOT_FEX00000000 Add partion very boot.fex BOOT_FEX00000000 FilePath: boot.fex FileLength=4f4000Add partion rootfs.fex ROOTFS_FEX000000 Add partion very rootfs.fex ROOTFS_FEX000000 FilePath: rootfs.fex FileLength=5e0000Add partion dsp0.fex DSP0_FEX00000000 Add partion very dsp0.fex DSP0_FEX00000000 FilePath: dsp0.fex FileLength=3e38cBuildImg 0 Dragon execute image.cfg SUCCESS ! 那么这个时候 就需要往回找,这个文件是哪里来的 怎么生成的? 通过 搜索 分析 发现是 来自于 sys_partiton.bin 文件,但是这个文件又是一个 二进制文件,而且也是后面打包生成的,那么还是要继续往回找 sys_partition.bin文件又是怎么生成的。 同样是结合log 加打印 找到了 如下这两个命令。 busybox unix2dos sys_partition.fex script sys_partition.fex 一开始以为这个 script 是ubuntu的某一个包,后来发现也是一个全志自家提供的工具。 既然 工具都找全了 那我们可以修改试试看。 修改 sys_partition.fex 把它的大小 调整为 70824 之后保存退出,从头执行如下命令 来确认猜想是否正确。 book@virtual-machine:~/D1s-Core/tina-d1-h/out/d1-h-nezha/image$ busybox unix2dos sys_partition.fex book@virtual-machine:~/D1s-Core/tina-d1-h/out/d1-h-nezha/image$ ~/D1s-Core/tina-d1-h/tools/pack-bintools/src/script sys_partition.fex argc = 2 input name sys_partition.fex Script 1 source file Path=/home/book/D1s-Core/tina-d1-h/out/d1-h-nezha/image/sys_partition.fex Script 1 bin file Path=/home/book/D1s-Core/tina-d1-h/out/d1-h-nezha/image/sys_partition.bin update_fdt: num 1752 randto1k parser 1 file ok book@virtual-machine:~/D1s-Core/tina-d1-h/out/d1-h-nezha/image$ ~/D1s-Core/tina-d1-h/tools/pack-bintools/src/update_mbr sys_partition.bin 4 mbr count = 4 partitation file Path=/home/book/D1s-Core/tina-d1-h/out/d1-h-nezha/image/sys_partition.bin mbr_name file Path=/home/book/D1s-Core/tina-d1-h/out/d1-h-nezha/image/sunxi_mbr.fex download_name file Path=/home/book/D1s-Core/tina-d1-h/out/d1-h-nezha/image/dlinfo.fex mbr size = 252 mbr magic softw411 disk name=boot-resource disk name=env disk name=env-redund disk name=boot disk name=rootfs disk name=dsp0 disk name=recovery this is not a partition key update_for_part_info 0 crc 0 = ea84dacc crc 1 = 7f398b91 crc 2 = 1a8f7e37 crc 3 = 8f322f6a gpt_head->header_crc32 = 0x53fc3a66 GPT----part num 8--- gpt_entry: 128 gpt_header: 92 GPT:boot-resource: a1f8 c177 GPT:env : c178 c36f GPT:env-redund : c370 c567 GPT:boot : c568 1161f GPT:rootfs : 11620 22ac7 GPT:dsp0 : 22ac8 22eb7 GPT:recovery : 22eb8 29cf7 GPT:UDISK : 29cf8 ffffffde update gpt file ok update mbr file ok book@virtual-machine:~/D1s-Core/tina-d1-h/out/d1-h-nezha/image$ book@virtual-machine:~/D1s-Core/tina-d1-h/out/d1-h-nezha/image$ ~/D1s-Core/tina-d1-h/tools/pack-bintools/src/dragon image.cfg sys_partition.fex /home/book/D1s-Core/tina-d1-h/tools/pack-bintools/src/ /home/book/D1s-Core/tina-d1-h/out/d1-h-nezha/image Begin Parse sys_partion.fex Add partion boot-resource.fex BOOT-RESOURCE_FEX Add partion very boot-resource.fex BOOT-RESOURCE_FEX FilePath: boot-resource.fex FileLength=2f8c00Add partion env.fex ENV_FEX000000000 Add partion very env.fex ENV_FEX000000000 FilePath: env.fex FileLength=20000Add partion env.fex ENV_FEX000000000 Add partion very env.fex ENV_FEX000000000 FilePath: env.fex FileLength=20000Add partion boot.fex BOOT_FEX00000000 Add partion very boot.fex BOOT_FEX00000000 FilePath: boot.fex FileLength=4f4000Add partion rootfs.fex ROOTFS_FEX000000 Add partion very rootfs.fex ROOTFS_FEX000000 FilePath: rootfs.fex FileLength=5e0000Add partion dsp0.fex DSP0_FEX00000000 Add partion very dsp0.fex DSP0_FEX00000000 FilePath: dsp0.fex FileLength=3e38cBuildImg 0 Dragon execute image.cfg SUCCESS ! book@virtual-machine:~/D1s-Core/tina-d1-h/out/d1-h-nezha/image$ 最后在当前目录下 生成了一个 名为 tina_d1-h-nezha_uart0.img 文件,把它用 凤凰烧录 工具烧录进去。 你会发现你可以把你增加过文件的分区 烧进去 并启动啦。 那么这个时候,还存在一个问题,就是D1使用的都是 squashfs 类型的文件系统,这个时候,你也需要分析一下 他们的这个文件系统 生产方式,这个就可以借助 grep 命令了,参考如下。 分析文件系统生成方式 最后得到 这个 rootfs.squashfs -noappend -processors 9 -nopad -noappend -root-owned -comp xz -b 256k -p '''/dev d 755 0 0''' -p '''/dev/console c 600 0 0 5 1''' -processors 4\n' >> /home/book/buildroot_dshannezhastu/buildroot-awol/output/build/buildroot-fs/squashfs/fakeroot 然后 把它 扔进 buildroot 就可以制作出 可以供 D1内核使用的系统, 注意 tina的环境变量里面的 init 进程位置和buildroot 不一样 需要修改。 注意 tina的环境变量里面的 init 进程位置和buildroot 不一样 需要修改。 注意 tina的环境变量里面的 init 进程位置和buildroot 不一样 需要修改。 最后 给大家放上,我们已经支持过 NEZHA D1的buildroot完整系统镜像源码 https://github.com/DongshanPI/buildroot_dshannezhastu clone下来后,需要更新git 子模块 执行如下命令来拉取子模块的源码。 git submodule update --init --recursive git submodule update --recursive --remote git pull --recurse-submodules 之后进入 buildroot-awol 目录下,稍等一会 就可以生成 供spi nand 烧写的flash镜像了。 当然,也可以烧到tf卡启动。。 buildroot_dshannezhastu/buildroot-awol$ make BR2_DL_DIR=../Download BR2_EXTERNAL=../br2nezhastu/ dshannezhastu_spinand_core_defconfig 编译完成后的输出信息。 镜像输出在 output/images/目录下

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册