首页 文章 精选 留言 我的

精选列表

搜索[基础搭建],共10000篇文章
优秀的个人博客,低调大师

Spark2.2.0 分布式离线搭建

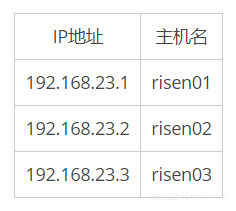
1、Spark简介 Apache Spark 是专为大规模数据处理而设计的快速通用的计算引擎。Spark是UC Berkeley AMP lab (加州大学伯克利分校的AMP实验室)所开源的类Hadoop MapReduce的通用并行框架,Spark,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是——Job中间输出结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的MapReduce的算法。 Spark 是一种与 Hadoop 相似的开源集群计算环境,但是两者之间还存在一些不同之处,这些有用的不同之处使 Spark 在某些工作负载方面表现得更加优越,换句话说,Spark 启用了内存分布数据集,除了能够提供交互式查询外,它还可以优化迭代工作负载。 Spark 是在 Scala 语言中实现的,它将 Scala 用作其应用程序框架。与 Hadoop 不同,Spark 和 Scala 能够紧密集成,其中的 Scala 可以像操作本地集合对象一样轻松地操作分布式数据集。 尽管创建 Spark 是为了支持分布式数据集上的迭代作业,但是实际上它是对 Hadoop 的补充,可以在 Hadoop 文件系统中并行运行。通过名为 Mesos 的第三方集群框架可以支持此行为。Spark 由加州大学伯克利分校 AMP 实验室 (Algorithms, Machines, and People Lab) 开发,可用来构建大型的、低延迟的数据分析应用程序。 2、部署准备 2.1、安装包准备 spark-2.2.0-bin-hadoop2.6.tgz jdk-8u161-linux-x64.tar.gz scala-2.11.0.tgz 2.2、节点配置信息2.3、节点资源配置信息3、集群配置与启动 3.1、安装包上传与解压 操作节点:risen01 操作用户:root 上传安装包spark-2.2.0-bin-hadoop2.6.tgz,scala-2.11.0.tgz,jdk-8u161-linux-x64.tar.gz(如果已经存在则不需要此步骤)到 risen01节点下的~/packages目录下,结果如图所示: 2、解压JDK安装包,Spark安装包Scala安装包和到/usr/local下 操作节点:risen01 操作用户:root 解压JDK命令: tar -zxvf ~/packeages/jdk-8u161-linux-x64.tar.gz -C /usr/local 解压spark命令: tar -zxvf ~/packages/spark-2.2.0-bin-hadoop2.6.tgz -C /usr/local 解压Scala命令: tar -zxvf ~/packages/scala-2.11.0.tgz -C /usr/local 3.2、启动前准备 操作节点:risen01,risen02,risen03 操作用户:root 在/data目录下新建立spark/work目录用来存放spark的任务处理日志 在/log目录下新建立spark目录用来存放spark的启动日志等 3.3、修改配置文件 3.3.1、编辑spark-env.sh文件 操作节点:risen01 操作用户:root 说明:请根据实际集群的规模和硬件条件来配置每一项参数 进入到/usr/local/spark-2.2.0-bin-hadoop2.6/conf目录下执行命令: cp spark-env.sh.template spark-env.sh 编辑spark-env.sh文件,添加以下内容: #设置spark的web访问端口 SPARK_MASTER_WEBUI_PORT=18080 #设置spark的任务处理日志存放目录 SPARK_WORKER_DIR=/data/spark/work #设置spark每个worker上面的核数 SPARK_WORKER_CORES=2 #设置spark每个worker的内存 SPARK_WORKER_MEMORY=1g #设置spark的启动日志等目录 SPARK_LOG_DIR=/log/spark #指定spark需要的JDK目录 export JAVA_HOME=/usr/local/jdk1.8.0_161 #指定spark需要的Scala目录 export SCALA_HOME=/usr/local/scala-2.11.0 #指定Hadoop的安装目录 export HADOOP_HOME=/opt/cloudera/parcels/CDH/lib/hadoop #指定Hadoop的配置目录 export HADOOP_CONF_DIR=/opt/cloudera/parcels/CDH/lib/hadoop/etc/hadoop/ #实现spark-standlone HA(因为我们HA实现的是risen01和risen02之间的切换不涉及risen03,所以这段配置risen03可有可无) export SPARK_DAEMON_JAVA_OPTS="-Dspark.deploy.recoveryMode=ZOOKEEPER -Dspark.deploy.zookeeper.url=risen01:2181,risen02:2181,risen03:2181 -Dspark.deploy.zookeeper.dir=/data/spark" 3.3.2、 编辑spark-defaults.conf文件 操作节点:risen01 操作用户:root 说明:请根据实际集群的规模和硬件条件来配置每一项参数 进入到/usr/local/spark-2.2.0-bin-hadoop2.6/conf目录下执行命令: cp spark-defaults.conf.template spark-defaults.conf 编辑spark-defaults.conf文件,添加以下内容: #设置spark的主节点 spark.master spark://risen01:7077 #开启eventLog spark.eventLog.enabled true #设置eventLog存储目录 spark.eventLog.dir /log/spark/eventLog #设置spark序列化方式 spark.serializer org.apache.spark.serializer.KryoSerializer #设置spark的driver内存 spark.driver.memory 1g #设置spark的心跳检测时间间隔 spark.executor.heartbeatInterval 20s #默认并行数 spark.default.parallelism 20 #最大网络延时 spark.network.timeout 3000s 3.3.3、 编辑slaves文件 操作节点:risen01 操作用户:root 说明:请根据实际集群的规模和硬件条件来配置每一项参数 进入到/usr/local/spark-2.2.0-bin-hadoop2.6/conf目录下执行命令: cp slaves.templete slaves 编辑slaves文件,修改localhost为: risen01 risen02 risen03 3.4、分发其他节点 执行scp命令: 操作节点:risen01 操作用户:root scp -r /usr/local/spark-2.2.0-bin-hadoop2.6 root@risen02:/usr/local scp -r /usr/local/scala-2.11.0 root@risen02:/usr/local scp -r /usr/local/jdk1.8.0_161 root@risen02:/usr/local scp -r /usr/local/spark-2.2.0-bin-hadoop2.6 root@risen03:/usr/local scp -r /usr/local/scala-2.11.0 root@risen03:/usr/local scp -r /usr/local/jdk1.8.0_161 root@risen03:/usr/local 需要提前创建好bigdata用户并实现免密(这里不再赘述,此步骤如果做过可不做) 权限修改 操作节点:risen01,risen02,risen03 操作用户:root 修改/log/spark权限命令: chown -R bigdata.bigdata /log/spark 修改/data/spark权限命令: chown -R bigdata.bigdata /data/spark 修改spark的安装目录命令: chown -R bigdata.bigdata /usr/local/spark-2.2.0-bin-hadoop2.6 修改Scala的安装目录命令: chown -R bigdata.bigdata /usr/local/scala-2.11.0 修改JDK1.8的安装目录命令:(此步骤如果做过可不做) chown -R bigdata.bigdata /usr/local/jdk1.8.0_161 结果如图下所示:3.5、启动集群 操作节点:risen01,risen02 操作用户:bigdata (1) 进入到/usr/local/spark-2.2.0-bin-hadoop2.6/sbin目录下执行./start-all.sh,查看web界面如下图所示: 然后在进入到risen02机器的spark安装目录下/usr/local/spark-2.2.0-bin-hadoop2.6/sbin执行命令./start-master.sh启动spark集群的备用主节点。(记得一定要启动备用主节点的进程,这里我们只用risen02做备用主节点,risen03虽然也配置了有资格,但是暂时我们不需要) (2) 进入到/usr/local/spark-2.2.0-bin-hadoop2.6/bin目录下执行spark-shell,并测试统计词频的测试,结果如下图所示: 截止到此,spark-standlone模式便安装成功了! 推荐阅读:https://www.roncoo.com/course/view/c4e0130ea2354c71a2cb9ba24348746c 文章来源:https://my.oschina.net/blogByRzc/blog/1800450

优秀的个人博客,低调大师

centos 7.4 搭建ftp服务器 vsftpd

在centos 7.3测试也是OK的,其它版本没有实验 # 安装 vsftpd $ yum install vsftpd -y # 启动 $ service vsftpd start && systemctl restart vsftpd.service # 查看 $ netstat -nltp | grep 21 /* 目前 FTP 服务登陆允许匿名登陆,也无法区分用户访问,我们需要配置 FTP 访问权限 vsftpd 的配置目录为 /etc/vsftpd,包含下列的配置文件: vsftpd.conf 为主要配置文件 ftpusers 配置禁止访问 FTP 服务器的用户列表 user_list 配置用户访问控制 */ # 修改权限 $ vi /etc/vsftpd/vsftpd.conf 修改内容如下: # 禁用匿名用户 anonymous_enable=NO # 禁止切换根目录 chroot_local_user=YES # 重启后 pub/目录访问需要登录了 $ service vsftpd restart && systemctl restart vsftpd.service # 创建 FTP 用户 $ useradd dongzhihong # 为用户 dongzhihong 设置密码 $ echo "dongzhihongmima" | passwd dongzhihong --stdin #限制该用户仅能通过 FTP 访问 #限制用户 dongzhihong 只能通过 FTP 访问服务器,而不能直接登录服务器 $ usermod -s /sbin/nologin dongzhihong # 为用户分配主目录 为用户 dongzhihong 创建主目录 并约定:/data/ftp 为主目录, 该目录不可上传文件 #创建 /data/ftp/pub目录 $ mkdir -p /data/ftp/pub #写欢迎文件 /data/ftp/welcome.txt $ echo "Welcome to use FTP service." > /data/ftp/welcome.txt # 设置访问权限 chmod a-w表示不可写(all-write) $ chmod a-w /data/ftp && chmod 777 -R /data/ftp/pub # 设置为用户主目录 $ usermod -d /data/ftp dongzhihong # 重启服务器 $ sudo systemctl restart vsftpd.service # 登录FTP 资源管理器打开 ftp://dongzhihong:dongzhihongmima@IP FTP软件登录 主动,被动都可以 /END

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册