首页 文章 精选 留言 我的

精选列表

搜索[PostgreSQL扩展],共10000篇文章
优秀的个人博客,低调大师

知识扩展--空间转录组(xenium、Atera、CosMx)分析细胞niche的临床意义

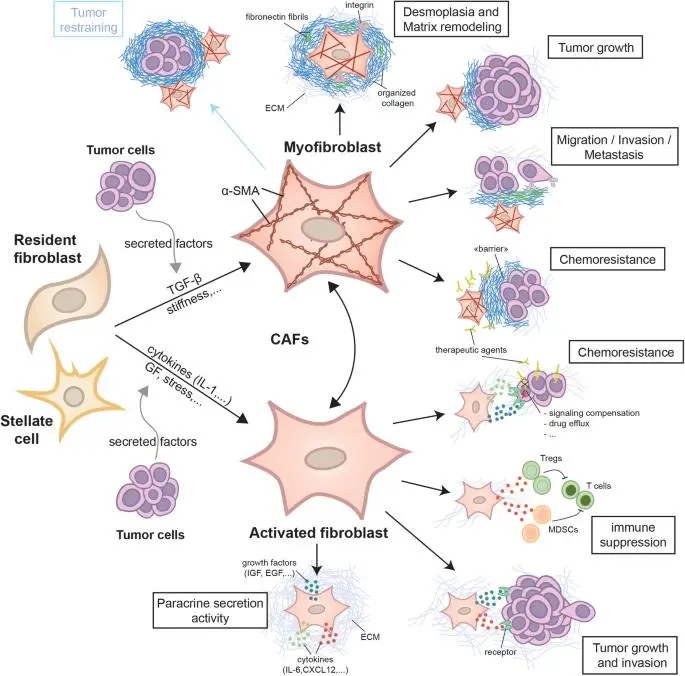
#### 作者,Evil Genius ![](https://developer.qcloudimg.com/http-save/yehe-10067361/df7fe0fd3ce8efaa96c3a4508845a5b2.png) #### 这一篇我们来梳理一下空间转录组(xenium、Atera、CosMx)分析细胞niche的临床意义。 细胞niche真正有价值的地方不是简单回答“**哪里有什么细胞**”,而是进一步回答: > **什么细胞在什么空间位置形成了什么微环境?这个微环境是否改变肿瘤细胞状态、治疗反应和患者预后?** 近期研究已经显示,CAF 与肿瘤细胞、免疫细胞形成的空间组织与免疫排斥、治疗抵抗和临床结局密切相关。比如在人乳腺癌 Xenium 数据中,肌成纤维样 CAF 可以围绕肿瘤核心形成“屏障”,而免疫调节型 CAF 更倾向与免疫细胞共定位。 --- # 一、先把“细胞 niche”理解清楚 例如有一个肺癌组织: ![](https://developer.qcloudimg.com/http-save/yehe-10067361/a8ca2c6906ea58016410db6a91c80e33.png) ![](https://developer.qcloudimg.com/http-save/yehe-10067361/03b1fc14a373db6b53e5d3fb34ea7efa.png) ![](https://developer.qcloudimg.com/http-save/yehe-10067361/1eda094618096f9410f7a5d2b46b2fa0.png) ![](https://developer.qcloudimg.com/http-save/yehe-10067361/d67919676f224610de46c0fb43e5ab52.png) ![](https://developer.qcloudimg.com/http-save/yehe-10067361/d4284a73f19dc02b65b7daf23c51c587.png) 假设空间上发现: ``` CD8 T cell ↓ ───────────────── Fibroblast Fibroblast ↓ ↓ ┌──────────────────┐ │ │ │ Tumor cells │ │ Tumor cells │ │ Tumor cells │ │ │ └──────────────────┘ Fibroblast Fibroblast ``` 这时候普通单细胞 RNA-seq 很难回答: > “这些 fibroblast 是否恰好包围肿瘤细胞?” 因为 scRNA-seq 把组织打散了。 而 Xenium / CosMx 这类技术可以知道: - 每个肿瘤细胞在哪里 - 每个 fibroblast 在哪里 - 每个 T cell 在哪里 - 两种细胞距离多远 - 哪些细胞经常共定位 - 哪些细胞互相排斥 - 某种细胞周围形成了什么细胞组合 于是就可以从: **Cell type → Spatial neighborhood → Niche → Biological function → Clinical outcome** 一路建立起来。 --- # 二、最核心的概念:从“细胞类型”升级到“空间生态位” 例如传统分析: > CAF ↑ 这其实信息量比较有限。 你真正想研究的应该是: > **Tumor + POSTN⁺ CAF + macrophage + hypoxia** 是否形成一种特定空间生态位? 例如: ### Niche 1:Tumor–CAF niche ``` Tumor │ ├── POSTN+ CAF ├── COL1A1+ CAF ├── COL3A1+ CAF └── TGFβ signaling ``` 可能对应: **ECM重塑 → 肿瘤细胞 EMT → 侵袭 → 耐药** --- ### Niche 2:Tumor–CAF–Macrophage niche ``` Tumor ↓ POSTN+ CAF ↓ SPP1+ macrophage ↓ 免疫抑制 ↓ CD8 T-cell exclusion ``` 这就比“CAF多”有意义得多。 近期研究已经发现,POSTN⁺ CAF 与特定巨噬细胞共同定位,可以形成缺氧、纤维化、CD8⁺ T 细胞排斥的空间生态位,并与免疫检查点抑制剂反应较差相关。 --- # 三、为什么这对临床特别重要? 可以临床价值总结成 **5个层次**。 --- ## ① 预测患者预后 这是最直接的。 不是简单计算: > CAF比例 = 30% 而是计算: > **肿瘤细胞周围 50 μm 内 CAF 密度** 或者: > **Tumor–CAF neighborhood score** 然后比较: ``` 高 Tumor-CAF niche ↓ OS ↓ PFS ↓ 复发 ↑ ``` 这比单纯 bulk RNA-seq 的: > COL1A1 ↑ 更具有空间解释能力。 2026年的泛癌空间研究对373个样本、12种癌症识别出13类反复出现的空间 niche,并发现不同 niche 与预后和免疫治疗反应存在显著关联。 --- # 四、② 预测治疗反应——这其实是最有价值的方向 例如: ### 肿瘤患者接受 EGFR-TKI 你可以把患者分成: ``` Responder Tumor ↓ 较少 CAF ↓ CD8 T cells进入 ``` 和: ``` Non-responder Tumor ↓ POSTN+ CAF COL1A1+ CAF TGFβ ↓ ECM barrier ↓ 免疫排斥 / survival signaling ↓ Drug resistance ``` 最终建立: > **CAF-associated resistance niche score** 然后看看这个 score 能不能预测: - ORR - PFS - OS - acquired resistance - response duration --- # 五、“肿瘤细胞外围成纤维细胞导致耐药”做的更加非常深入 比如研究: ## EGFR突变肺癌 假设: ``` EGFR-mutant tumor cells ↓ POSTN+ CAF ↓ TGFβ / ECM ↓ EMT ↓ EGFR-TKI resistance ``` 你可以把肿瘤细胞按照空间环境分成: ### Tumor-A 周围没有 CAF: ``` Tumor Tumor Tumor ↓ CAF density low ``` ### Tumor-B 周围大量 CAF: ``` CAF CAF CAF ↓ ↓ ↓ Tumor Tumor Tumor Tumor ↑ ↑ ↑ CAF CAF CAF ``` 然后比较这两群**肿瘤细胞自身的表达**。 例如: |Tumor状态|CAF-low|CAF-high| | --- | --- | --- | |EGFR signaling|↑|↓| |EMT|↓|↑| |TGFβ|↓|↑| |Hypoxia|↓|↑| |ECM interaction|↓|↑| |Drug resistance|↓|↑| |Cell survival|↓|↑| 这时候就从: > “CAF和肿瘤细胞在一起” 升级成: > **“空间邻近的CAF与肿瘤细胞状态改变相关。”** 这已经非常接近机制研究了。 而且已有肺癌研究利用空间转录组和单细胞数据预测空间药物反应,发现高 fibroblast-density 区域的肿瘤细胞对 lapatinib 的预测敏感性降低,并通过共培养实验进行了验证。 --- # 六、③ 找“耐药细胞”到底藏在哪里 这是单细胞空间技术特别有价值的地方。 传统 scRNA-seq: ``` Tumor cells ├── Cluster 1 ├── Cluster 2 ├── Cluster 3 └── Cluster 4 ``` 发现 Cluster 4: > drug resistance genes ↑ 但是不知道: > **Cluster 4 在哪里?** 空间技术可以继续回答: ``` Tumor resistant cells ↓ 是否集中在 ↓ CAF-rich niche? ↓ Macrophage-rich niche? ↓ Hypoxic niche? ↓ Invasive front? ``` 这样就可以找到: > **Resistance-associated spatial niche** 这比单纯找到一个“耐药 cluster”有意义得多。 近期 Xenium 研究也已经观察到,治疗抵抗的肿瘤区域可以与特定 fibroblast / myeloid programs 相邻;例如直肠癌研究中,残留肿瘤周围的 POSTN⁺ CAF 与化疗放疗抵抗相关。 --- # 七、④ 找潜在治疗靶点 这是空间 niche 最终走向转化医学的关键。 例如发现: ``` Tumor ↕ POSTN+ CAF ↕ SPP1+ macrophage ``` 然后 ligand-receptor: ``` CAF POSTN ↓ receptor Macrophage SPP1 ↓ receptor Tumor TGFβ pathway ↑ ``` 于是可以提出: > **不是单独杀肿瘤细胞,而是破坏这个“耐药生态位”。** 也就是: ``` 原来的治疗 EGFR-TKI ↓ Tumor ↓ ↓ CAF niche保护残存Tumor ↓ 复发 ``` 变成: ``` EGFR-TKI + CAF / TGFβ / ECM pathway inhibitor ↓ Tumor ↓↓↓ ``` 这就是空间组学非常重要的临床价值: > **从“找靶点”升级到“找靶点所在的空间生态系统”。** --- # 八、⑤ 指导联合治疗 例如最终得到: ### Niche A **Tumor + CAF** → TGFβ ↑ 推荐: > TKI + TGFβ pathway inhibition --- ### Niche B **Tumor + CAF + macrophage** → SPP1 / CSF1 / IL-6 ↑ 推荐: > TKI + macrophage-targeting therapy --- ### Niche C **Tumor + CAF + CD8 exclusion** → ECM / collagen ↑ 推荐: > TKI + ECM remodeling strategy --- ### Niche D **Tumor + exhausted T cells** → PD-1 / PD-L1 ↑ 推荐: > TKI + ICB 所以未来空间组学真正临床化的方向,很可能不是: > “这个患者有多少CAF?” 而是: > **“这个患者是什么类型的CAF niche?这个niche通过什么机制造成耐药?应该联合什么药物?”** --- # 九、Xenium、CosMx、Atera在这个问题上分别有什么优势? 如果目标就是: > **细胞 niche + 肿瘤微环境 + 耐药** 那么三者都可以做,但思路略有区别。 |平台|Niche分析价值|主要优势| | --- | --- | --- | |Xenium|⭐⭐⭐⭐⭐|单细胞/亚细胞空间定位,非常适合cell-cell neighborhood| |CosMx|⭐⭐⭐⭐⭐|高plex、单细胞空间转录组,非常适合复杂TME| |Atera|⭐⭐⭐⭐–⭐⭐⭐⭐⭐|更偏向大规模空间数据和细胞生态/空间关系分析| |Visium|⭐⭐⭐|spot级空间关系,适合宏观区域| |Visium HD|⭐⭐⭐⭐|更高空间分辨率,但分析策略与真正cell segmentation仍有区别| 尤其是 Xenium/CosMx 这类平台,可以直接得到: ``` Cell ID Cell type X coordinate Y coordinate Gene expression Cell boundary ``` 因此可以直接计算: ``` Tumor cell ↓ 50 μm ↓ CAF数量 ``` 或者: ``` CAF ↓ 80 μm neighborhood ↓ Tumor / T / B / macrophage / endothelial ``` 实际上已有研究就是采用 **CAF周围80 μm范围内的细胞组成**构建 neighbor vector,再通过 NMF 提取空间 CAF 亚型。 --- # 十、如果真正做科研,建议把分析设计成如下路线 ``` Xenium / CosMx / Atera ↓ Cell segmentation ↓ Cell annotation ↓ Tumor / CAF / T / B / NK / Macrophage ↓ ──────────────────────── ↓ Spatial neighborhood ↓ 50 μm / 80 μm / 100 μm ↓ Neighborhood composition ↓ Niche clustering ↓ ──────────────────────── ↓ Tumor–CAF niche Tumor–Macrophage niche Tumor–T-cell niche CAF–Macrophage niche CAF–T-cell niche ↓ ──────────────────────── ↓ DEG / pathway ↓ Ligand–receptor ↓ Cell state ↓ ──────────────────────── ↓ Drug response PFS / OS Recurrence Treatment response ↓ ──────────────────────── ↓ Resistance-associated niche ↓ Potential therapeutic target ``` --- # 十一、最值得做的其实是“空间条件下的差异表达” 例如: ### 普通差异表达 ``` Tumor cells Responder vs Non-responder ``` 得到: > Gene A ↑ Gene B ↑ Gene C ↑ 但是你不知道为什么。 --- ### 空间条件差异表达 把 tumor cells 分成: ``` Tumor cells near CAF vs Tumor cells far from CAF ``` 然后: ``` DEG ↓ EMT TGFβ Hypoxia PI3K-AKT MAPK DNA repair Drug resistance ``` 这就非常有意思。 进一步: ``` CAF proximity ↓ Tumor transcriptional state ↓ Drug resistance ``` 这已经可以形成一条非常漂亮的科研故事。 --- # 十二、最终可以形成一个非常完整的临床研究模型 例如做: ## “空间CAF niche介导EGFR-TKI耐药” 可以设计成: ``` 患者队列 ↓ 治疗前 Xenium / CosMx ↓ Tumor + CAF空间定位 ↓ 识别 CAF-rich niche ↓ 比较 CAF-rich vs CAF-poor tumor cells ↓ 发现: EMT ↑ TGFβ ↑ PI3K-AKT ↑ Survival signaling ↑ ↓ 建立 CAF-resistance niche score ↓ 预测 ORR / PFS / OS ↓ 多队列验证 ↓ 体外共培养 ↓ CAF + Tumor ↓ 药物处理 ↓ 验证耐药 ↓ CAF/TGFβ/ECM干预 ↓ 恢复药物敏感性 ``` 这就不再是简单的: > **“做了一张漂亮的空间图。”** 而是: > **空间定位 → niche → 肿瘤细胞状态 → 耐药机制 → 临床预测 → 靶向干预** 这才是 Xenium、CosMx、Atera 做 **cell niche analysis** 最有价值的地方。 而且现在这个方向已经越来越明确:CAF的功能并不是由“CAF这个细胞类型”本身决定,而是与**CAF所处的位置、邻居细胞组成以及空间组织结构**密切相关;2025年的 Cancer Cell 研究利用 CosMx/MERSCOPE 分析了超过570万细胞,识别出具有不同邻居组成和空间组织方式的CAF亚型,并在多个平台进行验证。 **所以,如果接下来是想真正做 Xenium / CosMx / Atera 的 niche 分析,建议不要只学“niche clustering”。最值得系统掌握的是:`邻域定义 → niche识别 → spatial interaction → ligand-receptor → niche-specific DEG → 耐药关联 → 临床结局 → 机制验证**` **这一整条链。** #### 生活很好,有你更好。

优秀的个人博客,低调大师

xbatis 与 mybatis-plus 对比,两者均为 mybatis 扩展的 ORM 框架

注:文章由deepseek联网生成 我们把 xbatis 和 MyBatis-Plus (简称 MP) 放在一起,进行一次全方位的对比。两者都是基于 MyBatis 的增强框架,但设计哲学和侧重点有很明显的差异。 为了让你看得更清楚,我把它们的核心区别整理成了一个表格: 对比维度 xbatis (新一代) MyBatis-Plus (MP) 对比解读 设计哲学 重度 ORM,链式 DSL:追求极致的对象化操作,API设计接近自然语言,旨在让写代码像写SQL一样流畅。 增强工具,轻量封装:在MyBatis基础上做增强,提供通用Mapper和CRUD方法,目标是简化开发。 xbatis 更像一个彻底的“重构者”,而 MP 是一个优秀的“助手”。 核心API 链式查询 (QueryChain):所有操作通过链式API完成,非常流畅且一致。例如:QueryChain.of(mapper).eq(Entity::getId,1).paging(pager)。 条件构造器 (Wrapper):通过QueryWrapper或LambdaQueryWrapper构造条件,是独立的参数对象。例如:mapper.selectList(new LambdaQueryWrapper<User>().eq(User::getId, 1))。 xbatis 的链式 API 是方法的主体,而 MP 的 Wrapper 是方法的参数。xbatis 的写法在复杂场景下可能更连贯。 多表关联 原生支持:通过@Fetch注解或join方法,能够非常优雅地解决对象关联查询,并能有效避免 N+1 问题。 支持有限:官方推荐复杂关联查询回退到 XML 手写 SQL。虽然可以通过@Select注解注入 Wrapper 条件,但可读性和维护性较差。 这是 xbatis 一个非常突出的优势,对复杂业务系统很友好。MP 则更专注于单表操作。 分表能力 透明式分表:通过@SplitTable注解和自定义分片策略,业务代码对分表无感,框架自动路由到正确的子表。 不支持:需借助第三方中间件(如 Apache ShardingSphere)实现。 xbatis 在分表支持上更加“开箱即用”。 跨数据库兼容 内置深度兼容:内置的 SQL 构建器深度适配了 13+ 种数据库,同一套代码可以在不同数据库间无缝切换。 基础兼容:分页等基础操作兼容多种数据库,但复杂的函数或特性可能需手动适配。 xbatis 在设计上对跨数据库迁移的考虑更周全。 Mapper 模式 单 Mapper 模式:可以定义一个BasicMapper操作所有实体,无需为每个实体都创建 Mapper 接口。 实体绑定 Mapper:通常每个实体都需要一个继承BaseMapper<T>的接口。 xbatis 的“单 Mapper”模式在项目庞大时能减少大量重复的接口文件。 独特功能 -SQL 模板:兼顾手写 SQL 的灵活性。 -RETURNING子句支持:在更新/删除后直接返回操作结果,实现某些特定业务逻辑时非常便捷。 -代码生成器:非常成熟,可以快速生成 Entity、Mapper、Service、Controller 全套代码。 -活跃的生态:用户多,问题解决方案丰富。 MP 的代码生成器是其杀手锏;xbatis 则在RETURNING支持等细节上体现了其“重度 ORM”的深度。 💡 究竟该怎么选? 基于上面的对比,你可以根据自己项目的具体情况来决定: 选 xbatis,如果: 你的项目中有大量的多表关联查询,希望代码能像操作单表一样简单、优雅。 你的项目未来有分表计划,或者需要在多种数据库之间迁移。 你喜欢链式 API的流畅编程体验,希望代码即文档,逻辑更连贯。 你希望用一个框架解决 90% 的数据库操作问题,包括复杂的对象关系映射。 选 MyBatis-Plus,如果: 你的项目以单表 CRUD为主,复杂查询较少。 你非常依赖代码生成器来快速搭建项目。 你希望拥有更庞大的用户社区,遇到问题更容易在网上找到现成的解决方案。 你的团队已经习惯了Wrapper的使用方式。 xbatis 和 MP 都是非常优秀的框架。xbatis 凭借其链式 API、原生多表关联和分表能力,正在成为复杂业务开发的新选择;而 MP 则凭借其低门槛、强大的代码生成器和成熟的生态,在快速开发领域依然占据着稳固的地位。

优秀的个人博客,低调大师

Coding Plan权益扩展:支持四大编程模型!首月低至8.9元

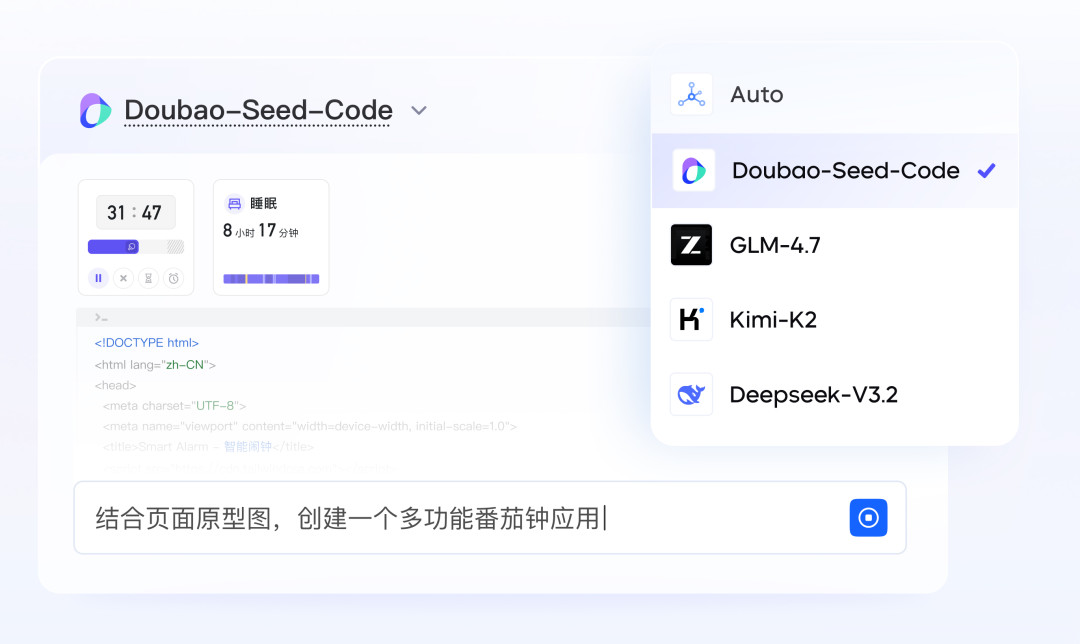
为了给开发者带来更精细化的优质编程体验,今天,火山方舟 Coding Plan 权益迎来新升级。 Coding Plan 订阅套餐,现在集成了 Doubao-Seed-Code、GLM-4.7、DeepSeek-V3.2 和 Kimi-K2-Thinking 多款编程模型,让开发者能够自由切换 AI 引擎,为不同编程任务匹配最适合的模型。 未来,Coding Plan 也会动态加入更多出色的编程模型,第一时间集合更多模型版本,为开发者创新提速。 作为国内首个集合多款模型的订阅套餐,Coding Plan 新权益给开发者带来了灵活高效的编程体验,更延续了一贯的性价比优势:现在下单,首月折扣最低至2.2折,8.9元即可畅享模型自由! 国内首个集合多模型的订阅套餐 火山方舟 Coding Plan 是为广大开发者量身打造的 AI Coding 场景订阅服务。该服务支持最新的 Doubao-Seed-Code 模型与多款主流 AI 编码工具,大幅提升开发者代码编写的效率与质量。 同时,火山方舟 Coding Plan 还提供了 Auto 模式,这一智能调度系统能够基于“效果+速度”双维度智能匹配最合适的模型。 当前,用户以订阅的形式购买套餐,即可自由选择 Doubao-Seed-Code、GLM-4.7、DeepSeek-V3.2和 Kimi-K2-Thinking 国内主流编程模型;也可以使用 Auto 模式,让平台根据用户需求自动匹配更适合当下场景的模型。 使用火山方舟 Coding Plan,在 Claude Code 中尝试小游戏开发 便宜、量大、不降速 火山方舟 Coding Plan 涵盖 Lite 和 Pro 两大套餐,以满足轻量化使用和频繁使用的不同开发场景。其中,Pro 套餐用量是 Lite 套餐的5倍,为高强度开发工作提供充足保障。 Lite 套餐支持每5小时最多约1,200次请求,首购一个月优惠价仅9.9元; Pro 套餐支持每5小时最多约6,000次请求,首购一个月优惠价49.9元。 还有限时福利!推荐好友订阅,好友可享额外9折优惠,被推荐人还能获得订单10%的优惠券!推荐越多,优惠越多,无上限。 以 Lite 套餐为例,叠加推荐优惠券,首月优惠低至2.2折,8.9元即可立刻畅享模型自由,大幅降低尝试门槛。 而且首购一次性下单三个月可享5折。 依托字节跳动的资源保障和工程能力,Coding Plan 在实现更快的模型服务时,也确保了稳定性和可靠性。 在请求高峰期,Coding Plan 也能保持稳定的服务性能,服务不降速,让开发者专注于创造性工作。 火山方舟 Coding Plan 具有广泛的兼容性,支持:Claude Code、Cursor、Cline、Codex CLI、Kilo Code、Roo Code、OpenCode等多种主流编程工具,让开发者能够在熟悉的环境中享受 AI 编程的便利。 配置过程简单直观,只需两大步骤即可完成,大大降低了使用门槛。 步骤一:订阅火山方舟Coding Plan 访问火山方舟 Coding Plan 活动,按需订阅套餐;对比选择适合的套餐,轻量化使用考虑 Lite,频繁使用考虑 Pro。 支付成功后,确认 Coding Plan 已生效:打开火山方舟控制台的开通管理页面,查看套餐开始与结束时间。 在开通管理页面选择或切换目标模型,无需在工具中额外变更模型配置。 支持最新的 Doubao-Seed-Code、DeepSeek-V3.2、GLM-4.7、Kimi-K2模型,也可开启 Auto 模式,火山方舟将根据场景选择最优模型。 步骤二:配置编程工具 Coding Plan 支持 Claude Code、Cursor、Cline、Codex CLI 等编程工具。 下面以 Claude Code 为例介绍如何使用 Coding Plan。接入其他编程工具,请参见活动页 AI 编程工具接入指南。 例如,完成 Claude Code 安装后,配置以下信息。 ANTHROPIC_BASE_URL:https://ark.cn-beijing.volces.com/api/coding ANTHROPIC_AUTH_TOKEN:获取API Key。链接:https://console.volcengine.com/ark/region:ark+cn-beijing/apikey ANTHROPIC_MODEL: ark-code-latest 配置好之后,可以输入/status 确认模型状态。正确情况如下图所示,显示出你选择的模型信息。 注:如果提示如下出错信息,应是由于已登录过 Claude Code,可输入/logout 退出登录,再启动 Claude Code。 在这个 AI 技术日新月异的时代,拥抱先进工具不仅是提高效率的途径,更是保持竞争力的选择。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。


用户登录
用户注册