首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10001篇文章
优秀的个人博客,低调大师

【从入门到放弃-ZooKeeper】ZooKeeper入门

前言 ZooKeeper是一个分布式服务协调框架,可以用来维护分布式配置信息、服务注册中心、实现分布式锁等。在Hbase、Hadoop、kafka等项目中都有广泛的应用。随着分布式、微服务的普及,ZooKeeper已经成为我们日常开发工作中无法绕过的一环,本文将从安装配置到最基础的使用入手,对其进行介绍。 安装部署 下载 在 http://mirror.bit.edu.cn/apache/zookeeper/stable/ 下载推荐的stable版本。可以直接下载编译好的bin文件。目前最新的stable版本是3.5.5 解压 将下载的文件解压至工作目录,我的工作目录是/var/workspace/zookeeper tar -xzvf apache-zookeeper-3.5.5-bin.tar.gz -C /var/workspace/zo

优秀的个人博客,低调大师

es 入门

**注意事项-------使用ealsticsearch要配置java的开发环境JDK(1.8以上) ealsticsearch: 索引(Index) 类型(type) 文档(Document) 字段(Fields) 关系型数据库: 数据库 表 行 列 from elasticsearch import Elasticsearch 默认host为localhost,port为9200.但也可以指定host与port es = Elasticsearch("http://127.0.0.1:9200") 插入数据,index,doc_type名称可以自定义,id可以根据需求赋值,body为内容 es.index(index="my_index",doc_type="test_type",id=0,body={"name":"python","addr":"深圳"})es.index(index="my_index",doc_type="test_type",id=1,body={"name":"java","addr":"北京"}) 同样是插入数据,create() 方法需要我们指定 id 字段来唯一标识该条数据,而 index() 方法则不需要,如果不指定 id,会自动生成一个 id es.create(index="my_index",doc_type="test_type",id=1,body={"name":"python","addr":"深圳"}) 删除指定的index、type、id的文档 es.delete(index='indexName', doc_type='typeName', id=1) 删除index es.indices.delete(index='news', ignore=[400, 404])query = {'query': {'match_all': {}}}# 查找所有文档query1 = {'query': {'match': {'sex': 'famale'}}}# 删除性别为女性的所有文档query2 = {'query': {'range': {'age': {'lt': 11}}}}# 删除年龄小于11的所有文档query3 = {'query': {'term': {'name': 'jack'}}}# 查找名字叫做jack的所有文档 删除所有文档 es.delete_by_query(index="my_index",doc_type="test_type",body=query) get:获取指定index、type、id所对应的文档 es.get(index="my_index",doc_type="test_type",id=1) search:查询满足条件的所有文档,没有id属性,且index,type和body均可为None result = es.search(index="my_index",doc_type="test_type",body=query)print(result'hits'[0])# 返回第一个文档的内容 update:更新指定index、type、id所对应的文档 更新的主要点: 1. 需要指定 id 2. body={"doc": } , 这个doc是必须的 es.update(index="my_index",doc_type="test_type",id=1,body={"doc":{"name":"python1","addr":"深圳1"}}) ---查询所有数据# 搜索所有数据es.search(index="my_index",doc_type="test_type") 或者 body = { "query":{ "match_all":{} }}es.search(index="my_index",doc_type="test_type",body=body) ---term与terms term body = { "query":{ "term":{ "name":"python" } }} 查询name="python"的所有数据 es.search(index="my_index",doc_type="test_type",body=body) terms body = { "query":{ "terms":{ "name":[ "python","android" ] } }} 搜索出name="python"或name="android"的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---match与multi_match match:匹配name包含python关键字的数据 body = { "query":{ "match":{ "name":"python" } }} 查询name包含python关键字的数据 es.search(index="my_index",doc_type="test_type",body=body) multi_match:在name和addr里匹配包含深圳关键字的数据 body = { "query":{ "multi_match":{ "query":"深圳", "fields":["name","addr"] } }} 查询name和addr包含"深圳"关键字的数据 es.search(index="my_index",doc_type="test_type",body=body) ---idsbody = { "query":{ "ids":{ "type":"test_type", "values":[ "1","2" ] } }} 搜索出id为1或2d的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---复合查询boolbody = { "query":{ "bool":{ "must":[ { "term":{ "name":"python" } }, { "term":{ "age":18 } } ] } }} 获取name="python"并且age=18的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---切片式查询body = { "query":{ "match_all":{} } "from":2 # 从第二条数据开始 "size":4 # 获取4条数据} 从第2条数据开始,获取4条数据 es.search(index="my_index",doc_type="test_type",body=body) ---范围查询 body = { "query":{ "range":{ "age":{ "gte":18, # >=18 "lte":30 # <=30 } } }} 查询18<=age<=30的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---前缀查询body = { "query":{ "prefix":{ "name":"p" } }} 查询前缀为"赵"的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---通配符查询 body = { "query":{ "wildcard":{ "name":"*id" } }} 查询name以id为后缀的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---排序body = { "query":{ "match_all":{} } "sort":{ "age":{ # 根据age字段升序排序 "order":"asc" # asc升序,desc降序 } }} ---filter_path响应过滤 只需要获取_id数据,多个条件用逗号隔开 es.search(index="my_index",doc_type="test_type",filter_path=["hits.hits._id"]) 获取所有数据 es.search(index="my_index",doc_type="test_type",filter_path=["hits.hits._*"]) ---count执行查询并获取该查询的匹配数 获取数据量 es.count(index="my_index",doc_type="test_type") ---度量类聚合获取最小值body = { "query":{ "match_all":{} }, "aggs":{ # 聚合查询 "min_age":{ # 最小值的key "min":{ # 最小 "field":"age" # 查询"age"的最小值 } } }} 搜索所有数据,并获取age最小的值 es.search(index="my_index",doc_type="test_type",body=body) ---获取最大值body = { "query":{ "match_all":{} }, "aggs":{ # 聚合查询 "max_age":{ # 最大值的key "max":{ # 最大 "field":"age" # 查询"age"的最大值 } } }} 搜索所有数据,并获取age最大的值 es.search(index="my_index",doc_type="test_type",body=body) ---获取和body = { "query":{ "match_all":{} }, "aggs":{ # 聚合查询 "sum_age":{ # 和的key "sum":{ # 和 "field":"age" # 获取所有age的和 } } }} 搜索所有数据,并获取所有age的和 es.search(index="my_index",doc_type="test_type",body=body) ---获取平均值body = { "query":{ "match_all":{} }, "aggs":{ # 聚合查询 "avg_age":{ # 平均值的key "sum":{ # 平均值 "field":"age" # 获取所有age的平均值 } } }} 搜索所有数据,获取所有age的平均值 es.search(index="my_index",doc_type="test_type",body=body)

优秀的个人博客,低调大师

Matplotlib 入门

最近一直在学习有关机器学习的内容,发现有关可视化的内容无法绕过,在网上搜索了很久,看了一些中英文的资料和书,这里主要是记录下来,主要供自己进一步学习之用。 本文适合零基础,但你需要对Python, Numpy, Pandas 有基本的了解。 首先完成以下的中文翻译资料的学习,原作者的github链接也一并奉上,你可以 clone 下来。学习这个课程的过程中,你需要了解的基本API函数: 完成了这个学习, 使用面向对象界面画图的一般步骤就是 建立一个 Figure 对象 在这个 Figure 里建立一个或n个 Axes 对象 这些 Axes 里分别画图、装饰 我们画完图以后一般要加上标题、图例这些元素。这些功能散布在 Matplotlib API 的各处 加标题可以使用 Axes 对象的 set_title 方法。坐标轴的标签可以使用 Axes 对象的 set_xlabel 和 set_ylabel 方法。图例可以使用 Axes 对象的 legend 方法创建。这 个函数会使用 Line2D 对象的 label 属性。注意 上一节最后的那一段代码,Ax.plot() 这一行我们并没有使用 plot 的返回值,实际上它的返回值正是 Line2D 对象的列表,所以我们可以这样设置 label:Ax.plot(X1, Y1, label="blabla") 也可以这样Lines = Ax.plot(X1, Y1) Lines[0].set_label("blabla") 如果我们在一个 plot 调用里画多条线,同时设 label,这些线都会有相同的 label。设置完这些以后,只需调用 Ax.legend(),图例就会出现在图的右上角。如果我们使用上一节 的那个例子,右上角并不是放图例的好地方,这时我们可以使用 legend 的 loc参数。这个参数可以是一个字符串, 比如"right","lower left" 之类,也可以是一 个整数,具体定义请见 官方文档。这里我们可以简单地使用 0 或者 "best" 让 Matplotlib 自动选择位置,Ax.legend(loc=0) 现在我们的图基本成型,可以插入到文档里了。这时我们可能想调整图的大小, 我们可以修改 Figure 构造函数的调用,Fig = Plt.figure(figsize=(4,3)) 这样图的大小就会是宽 4 高 3,单位传说是英寸。也可以使用 Fig 的 set_figwidth 和 set_figheight 方法。如果你把图的尺寸改得比较小的话,可能会 发生一件非常奇妙的事,就是坐标轴的标签被图的边界遮住了,或者干脆不见了。 解决办法就是调整绘图区域的四个边界在图中的位置,比如下面的代码Fig.subplots_adjust(left=0.15, top=0.9) 把绘图区域的左边界放在图左边 15% 的位置,上边界放在高的 90% 的位置。Matplotlib 中的文本 Matplotlib 有很强的文本功能。它可以处理普通的文本,也可以使用 LaTeX 渲 染数学公式。Matplotlib 还带了一个 LaTeX 引擎,可以在系统里没有 LaTeX 的 时候渲染数学公式。以下代码使用默认字体(貌似是 Verdana)显示 x 轴的标题Ax.set_xlabel("x") 如果你要使用 LaTeX 来排这个标题,只需要使用 Python raw string,并把标 题放在数学模式里,Ax.set_xlabel(r" 𝑥x ") 注意即便是使用 raw string,不在数学模式里的部分仍然不会使用 LaTeX。Matplotlib 的 Axes 类有一个 text 方法,可以 在一个 Axes 对象的任意位置放置一个文本。 Figure 也有一个 figtext 方法用来在 Figure 对象的任意位置放置文本。具体用法请见 官方文档。 Axes 对象还有一个超级强大的 annotate 方法, 可以满足你对标注的最变态需求。要改变文本的默认字体,需要使用 pyplot 模块的 rc 函数,Plt.rc("font", family="Helvetica") 不过如果你指定的字体是 OpenType 的话,貌似不能嵌入到 PDF 里…​ 请参考: 1)github - https://github.com/rougier/matplotlib-tutorial 2) Translation - https://liam.page/2014/09/11/matplotlib-tutorial-zh-cn/ 3) https://www.cnblogs.com/wei-li/archive/2012/05/23/2506940.html4) https://journals.plos.org/ploscompbiol/article?id=10.1371/journal.pcbi.1003833 以下为草稿:http://liyangbit.com/pythonvisualization/matplotlib-top-50-visualizations/

优秀的个人博客,低调大师

Jmeter 入门

Jmeter的初步认识 一、 接口测试 一般的测试包含七步: 新建请求 添加线程组 添加http请求 配置http参数 添加cookie管理、header管理 添加结果树 在点击运行 查看运行结果 参数在前后端分离一般用json格式,也可以选择html(HTMl Source Formatted)或者其他 二、 压力测试 配置线程组 参数说明: -. 线程数:虚拟用户数。一个虚拟用户占用一个进程或线程。多少虚拟用户就设置多少个线程数。 -. Rame-Up Period: 表示线程数多长时间全部启动。即准备时长:如果线程数是15,准备时长为3,,也就是每秒钟启动5个线程。 -. 循环次数:这个设置不会改变并发数,可以延长并发时间。总请求数=线程数*循环次数 -. 调度器:设置压测的启动时间、结束时间、持续时间和启动延迟时间。

优秀的个人博客,低调大师

Prometheus 入门

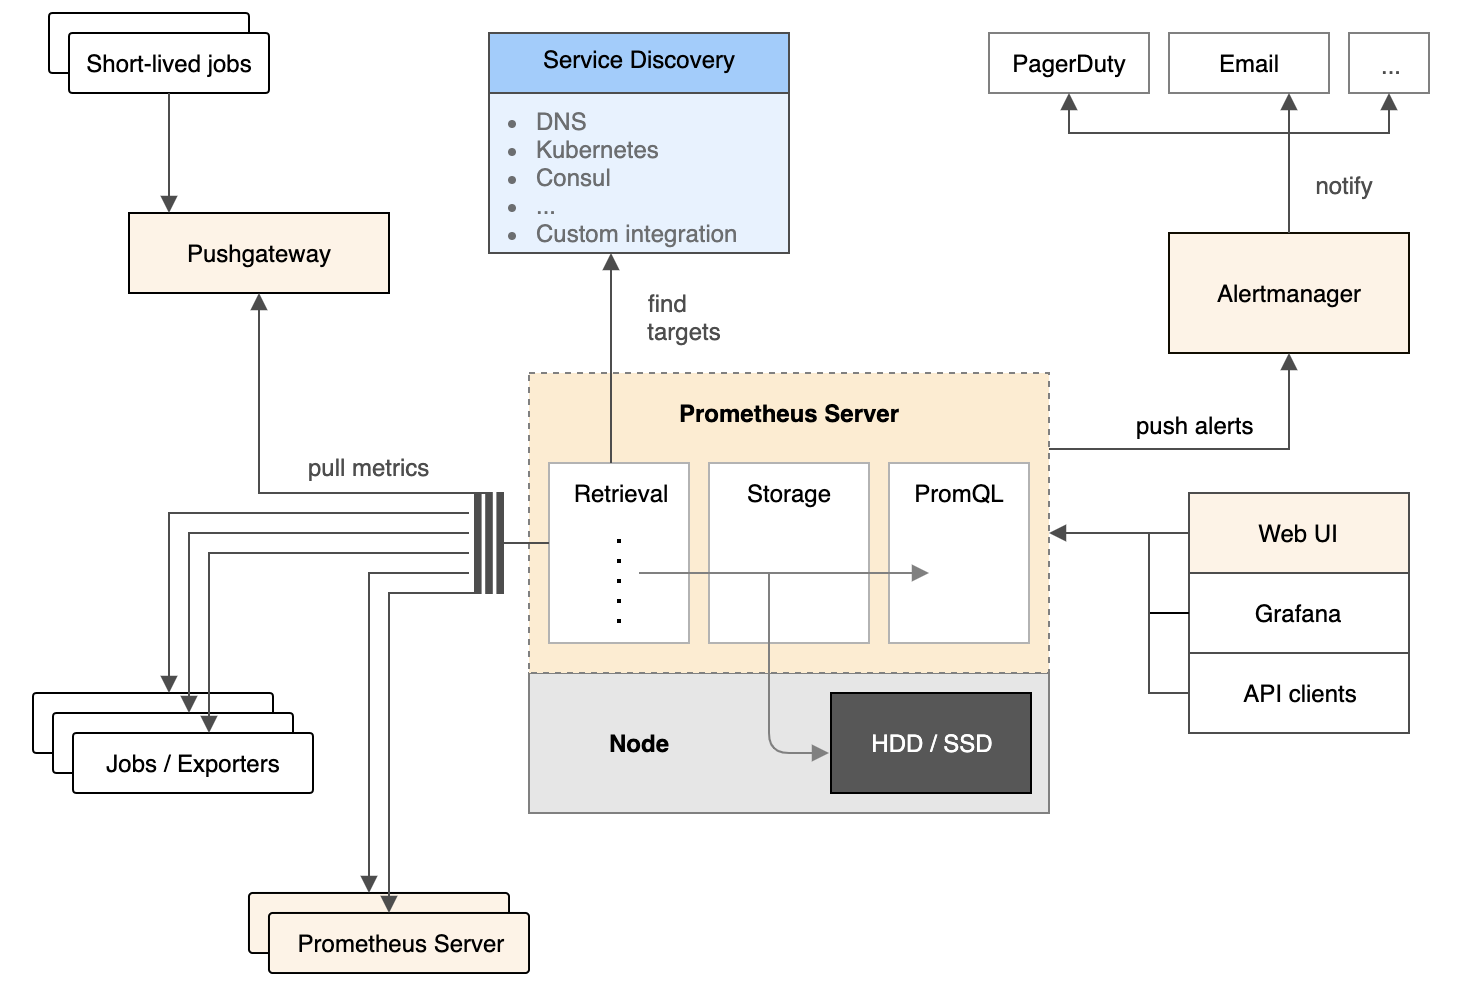
文章首发于公众号《程序员果果》地址 : https://mp.weixin.qq.com/s/BjZyNcWEgflJMnjfceiluw 简介 Prometheus 是一套开源的系统监控报警框架。它启发于 Google 的 borgmon 监控系统,由工作在 SoundCloud 的 google 前员工在 2012 年创建,作为社区开源项目进行开发,并于 2015 年正式发布。 特点 作为新一代的监控框架,Prometheus 具有以下特点: 强大的多维度数据模型: 时间序列数据通过 metric 名和键值对来区分。 所有的 metrics 都可以设置任意的多维标签。 数据模型更随意,不需要刻意设置为以点分隔的字符串。 可以对数据模型进行聚合,切割和切片操作。 支持双精度浮点类型,标签可以设为全 unicode。 灵活而强大的查询语句(PromQL):在同一个查询语句,可以对多个 metrics 进行乘法、加法、连接、取分数位等操作。 易于管理: Prometheus server 是一个单独的二进制文件,可直接在本地工作,不依赖于分布式存储。 高效:平均每个采样点仅占 3.5 bytes,且一个 Prometheus server 可以处理数百万的 metrics。使用 pull 模式采集时间序列数据,这样不仅有利于本机测试而且可以避免有问题的服务器推送坏的 metrics。 可以采用 push gateway 的方式把时间序列数据推送至 Prometheus server 端。 可以通过服务发现或者静态配置去获取监控的 targets。 有多种可视化图形界面。 易于伸缩。 组成及架构 Prometheus 生态圈中包含了多个组件,其中许多组件是可选的: Prometheus Server: 用于收集和存储时间序列数据。 Client Library: 客户端库,为需要监控的服务生成相应的 metrics 并暴露给 Prometheus server。当 Prometheus server 来 pull 时,直接返回实时状态的 metrics。 Push Gateway: 主要用于短期的 jobs。由于这类 jobs 存在时间较短,可能在 Prometheus 来 pull 之前就消失了。为此,这次 jobs 可以直接向 Prometheus server 端推送它们的 metrics。这种方式主要用于服务层面的 metrics,对于机器层面的 metrices,需要使用 node exporter。 Exporters: 用于暴露已有的第三方服务的 metrics 给 Prometheus。 Alertmanager: 从 Prometheus server 端接收到 alerts 后,会进行去除重复数据,分组,并路由到对收的接受方式,发出报警。常见的接收方式有:电子邮件,pagerduty,OpsGenie, webhook 等。 一些其他的工具。 下图为 Prometheus 官方文档中的架构图: 从上图可以看出,Prometheus 的主要模块包括:Prometheus server, exporters, Pushgateway, PromQL, Alertmanager 以及图形界面。 其大概的工作流程是: Prometheus server 定期从配置好的 jobs 或者 exporters 中拉 metrics,或者接收来自Pushgateway 发过来的 metrics,或者从其他的 Prometheus server 中拉 metrics。 Prometheus server 在本地存储收集到的 metrics,并运行已定义好的 alert.rules,记录新的时间序列或者向 Alertmanager 推送警报。 Alertmanager 根据配置文件,对接收到的警报进行处理,发出告警。在图形界面中,可视化采集数据。 相关概念 下面将对 Prometheus 中的数据模型(时间序列),metric 类型,instance 和 jobs等概念进行介绍。 数据模型 Prometheus 中存储的数据为时间序列,是由 metric 的名字和一系列的标签(键值对)唯一标识的,不同的标签则代表不同的时间序列。 metric 名字:该名字应该具有语义,一般用于表示 metric 的功能,例如:http_requests_ total, 表示 http 请求的总数。其中,metric 名字由 ASCII 字符,数字,下划线,以及冒号组成,且必须满足正则表达式 a-zA-Z_:*。 标签:使同一个时间序列有了不同维度的识别。例如 http_requests_total{method="Get"} 表示所有 http 请求中的 Get 请求。当 method="post" 时,则为新的一个 metric。标签中的键由 ASCII 字符,数字,以及下划线组成,且必须满足正则表达式 a-zA-Z_:*。 样本:实际的时间序列,每个序列包括一个 float64 的值和一个毫秒级的时间戳。 格式:{=, …},例如:http_requests_total{method="POST",endpoint="/api/tracks"}。 Metrics种类 Prometheus客户端库提供了四种核心Metrics类型。 Counter(计数器) 说明:Counter是一个累积度量,它表示一个单调递增的 Metrics,其值只能在重启时递增或重置为零 场景:可以使用Counter来表示http的请求数、已完成的任务数或错误数、下单数。 Gauge(测量仪) 说明:当前值的一次快照(snapshot)测量,可增可减。 场景:磁盘使用率,当前同时在线用户数。 Histogram(直方图) 说明:通过区间统计样本分布。 场景:请求延迟时间的统计。例如统计 0~200ms、200ms~400ms、400ms~800ms 区间的请求数有多。 Summary(汇总) 说明:根据样本统计出百分位。 场景:请求延迟时间的统计。例如统计 95%的请求延迟 < xxx ms ,99%的请求延迟 < xxx ms instance 和 jobs 在Prometheus术语中,你可以scrape(刮擦)的端点称为 实例,通常对应于单个进程。一组同种类型的 instances(主要用于保证可扩展性和可靠性),例如:具有四个复制instances(实例)的API服务器job作业: job: api-server instance 1: 1.2.3.4:5670 instance 2: 1.2.3.4:5671 instance 3: 5.6.7.8:5670 instance 4: 5.6.7.8:5671 当Prometheus scrape(刮擦)目标时,它会自动在scrape的时间序列上附加一些标签,用来识别scrape的目标。 job:目标所属的已配置job名称。 instance::已刮擦的目标URL 的一部分。 对于每次实例 scrape(刮取,Prometheus都会在以下时间序列中存储样本: up{job="<job-name>", instance="<instance-id>"}:1如果实例是健康的,即可达,或者0刮擦失败。 scrape_duration_seconds{job="<job-name>", instance="<instance-id>"}:刮擦持续时间。 scrape_samples_post_metric_relabeling{job="<job-name>", instance="<instance-id>"}:应用度量标准重新标记后剩余的样本数。 scrape_samples_scraped{job="<job-name>", instance="<instance-id>"}:目标暴露的样本数。 scrape_series_added{job="<job-name>", instance="<instance-id>"}:该刮擦中新系列的大致数量。v2.10中的新功能。 up时间序列对于实例可用性监视非常有用。 安装和配置 安装 你可以在官网 https://prometheus.io/download/ 下载 安装包,解压后使用。为了方便,我使用docker 镜像的方式 运行Prometheus。 docker run --name prometheus -d -p 9090:9090 prom/prometheus 浏览器输入http://localhost:9090 ,访问 Prometheus 的 Web UI: 点击菜单栏 “Status” 下的 Targets ,界面如下: 可以看大Prometheus 自身 metrics 处于UP状态 ,说明 安装成功。 配置 Prometheus 的配置文件 prometheus.yml 内容如下: # 全局设置,可以被覆盖 global: scrape_interval: 15s evaluation_interval: 15s rule_files: # - "first.rules" # - "second.rules" scrape_configs: - job_name: prometheus static_configs: - targets: ['localhost:9090'] 该global块控制 Prometheus 的全局配置。我们有两种选择。第一个,scrape_interval控制Prometheus 刮擦目标的频率。你可以为单个目标覆盖此值。在这种情况下,全局设置是每15秒刮一次。该evaluation_interval选项控制普罗米修斯评估规则的频率。Prometheus 使用规则创建新的时间序列并生成警报。 该rule_files块指定我们希望 Prometheus 加载的任何规则的位置。现在我们没有规则。 最后一个块scrape_configs控制 Prometheus 监视的资源。由于 Prometheus 还将自己的数据公开为HTTP端点,因此它可以抓取并监控自身的健康状况。在默认配置中有一个名为 prometheus 的job,它抓取 prometheus 服务器 公开的时间序列数据。该作业包含一个静态配置的目标,即端口9090上的本地主机。返回的时间序列数据将详细说明Prometheus服务器的状态和性能。 实验 Prometheus HTTP 度量模拟器 为了演示 Prometheus 的简单使用,这里运行一个 Prometheus HTTP 度量模拟器。模拟一个简单的HTTP微服务,生成Prometheus Metrics,通过 docker 运行。 docker run -p 8080:8080 pierrevincent/prom-http-simulator:0.1 它在/metrics端点下公开以下Prometheus指标: http_requests_total:请求计数器,标签endpoint和status http_request_duration_milliseconds:请求延迟直方图 可以开启流量高峰模式,更改流量高峰模式可以通过以下方式完成: # ON curl -X POST http://127.0.0.1:8080/spike/on # OFF curl -X POST http://127.0.0.1:8080/spike/off # RANDOM curl -X POST http://127.0.0.1:8080/spike/random 错误率默认为1%。它可以更改为0到100之间的数字: # 例如将错误率设置为50% curl -H 'Content-Type: application/json' -X PUT -d '{"error_rate": 50}' http://127.0.0.1:8080/error_rate 修改Prometheus配置 需要将 HTTP 度量模拟器 的 metrics端点 配置到 Prometheus的配置文件 prometheus.yml 中。 创建一个 prometheus.yml 文件 内容如下: global: scrape_interval: 5s evaluation_interval: 5s scrape_timeout: 5s scrape_configs: - job_name: 'prometheus' static_configs: - targets: ['localhost:9090'] - job_name: 'http-simulator' metrics_path: /metrics static_configs: - targets: ['172.16.1.232:8080'] 通过docker up 命令替换 容器中的配置文件: docker cp prometheus.yml prometheus:/etc/prometheus/ 重启容器: docker restart prometheus 访问 http://localhost:9090/targets ,发现已经出现了 target “http-simulator” ,并且为UP状态。 查询 请求率(Request Rate)查询 查询http请求数 http_requests_total{job="http-simulator"} 查询成功login请求数 http_requests_total{job="http-simulator", status="200", endpoint="/login"} 查询成功请求数,以endpoint区分 http_requests_total{job="http-simulator", status="200"} 查询总成功请求数 sum(http_requests_total{job="http-simulator", status="200"}) 查询成功请求率,以endpoint区分 rate(http_requests_total{job="http-simulator", status="200"}[5m]) 查询总成功请求率 sum(rate(http_requests_total{job="http-simulator", status="200"}[5m])) 延迟分布(Latency distribution)查询 查询http-simulator延迟分布 http_request_duration_milliseconds_bucket{job="http-simulator"} 查询成功login延迟分布 http_request_duration_milliseconds_bucket{job="http-simulator", status="200", endpoint="/login"} 不超过200ms延迟的成功login请求占比 sum(http_request_duration_milliseconds_bucket{job="http-simulator", status="200", endpoint="/login", le="200"}) / sum(http_request_duration_milliseconds_count{job="http-simulator", status="200", endpoint="/login"}) 成功login请求延迟的99百分位 histogram_quantile(0.99, rate(http_request_duration_milliseconds_bucket{job="http-simulator", status="200", endpoint="/login"}[5m])) 上面给出的这些查询表达式,在 prometheus 的 查询界面上自行测试下 ,这里就不一一测试了, 总结 本篇对 Prometheus 的组成,架构和基本概念进行了介绍,并实例演示了 Prometheus 的查询表达式的应用。本篇是 Prometheus 系列的第一篇, 后续还会有Prometheus与其他图形界面的集成,与 springboot 应用的集成等 。 参考 https://prometheus.io/docs/introduction/overview/https://www.ibm.com/developerworks/cn/cloud/library/cl-lo-prometheus-getting-started-and-practice/index.html

优秀的个人博客,低调大师

MyCAT入门

MyCAT 1.什么是MyCAT MyCAT是基于阿里的cobar实现的数据库中间件产品。 2.什么是数据库中间件 就是介于数据库和应用之间,进行数据处理与交互的中间服务。有了数据库中间件,应用只需要集中处理业务,大量的通用的数据聚合,事务,数据源切换都由数据库中间件处理。 3.MyCAT的主要作用 1.单纯的读写分离,支持读写分离,主从切换; 2.分表分库,对于超过1000万的表进行分片,最大支持1000亿的单表分片 3.多租户应用,每个应用一个库,但应用程序mycat,实现多租户化 4.报表系统,借助mycat分表能力,处理大规模报表统计 5.替代Hbase,分析大数据 4.MyCAT基本元素 逻辑库 数据库中间件是一个或多个数据库集群构成的逻辑库。他并不是只有一个数据库,而是有多个库的聚集。 逻辑表 1.逻辑表 在分布式数据库系统中,对应用来说,读写数据的表就是逻辑表。逻辑表可以是数据切分后,分布在一个或多个分片库,也可以不做数据切分,不分片,只由一个表构成。 2.分片表 分片表,是指那些原有的很大数据的表,需要切分到多个数据库的表。 3.非分片表 一个数据库中并不是所有的表都很大,某些表可以不用进行切分。非分片表,既是数据量比较小的表 4.ER表 子表的记录与所关联的父表记录存放在同一数据分片上,即字表依赖于父表成为ER表。 5.全局表 一些常常很少会改变的表成为全局表(例如字典表),全局表将在每个数据分片上拷贝一份,且要保证数据相同。此时使用join操作时,将会大大提高效率。 分片节点 数据切分后,一个大表被分到不同分片数据库上面,每个表分片所在的数据库就是分片节点。(dataNode) 节点主机 数据切分后,每个分片节点不一定会都独占一个物理机器,同一物理机器上面可以有多个分片数据库,这样一个或多个分片节点所在的物理机器就是节点主机。为了避免单节点主机并发数量限制,尽量将读写压力高的节点,均匀分布在不同的节点主机。 分片规则 一个大表被分成若干个分片表,就需要一定的规则。这样按照业务将数据分到某个分片的规则就是分片规则。 全局序列号 数据切分后,原有关系数据库中的主键约束在分布式条件下将无法使用,因此需要引入外部机制保证数据唯一性标识,这种保证全局数据唯一标识的机制就是全局序列号 5.MyCAT安装 下载地址:[link](http://dl.mycat.io/1.6.6.1/) ###1.Linux系统 - 到mycat项目主页下载linux安装包。 - 将解压后文件放到usr/local/mycat目录下 - mycat解压后目录如下 bin程序目录 conf配置文件存放目录 lib存放mycat项目依赖包目录 logs存放mycat日志目录 - mycat启动 vi /etc/profile 在系统环境变量文件中增加 MYCAT_HOME=/usr/local/mycat 执行source /etc/profile命令,使环境变量生效 经过以上两个步骤的配置后,就可以到/usr/local/mycat/bin目录下执行:/mycat start启动服务。 ###2.Windows系统 mycat在Windows中部署时,建议将解压后的目录放在根目录中,尽量在路径中不要包含中文路径。如:D:\Mycat-server-1.6-win\ 命令行启动方式: 从cmd命令中将路径切换到bin目录下,执行startup_nowrap.bat即可启动mycat服务。(mycat需要java环境支持,需先要求已有节哀吧、va环境。并且版本必须在1.7以上)。 ###2.基于zk的启动 ...... ...... ......

优秀的个人博客,低调大师

Protobuf 入门

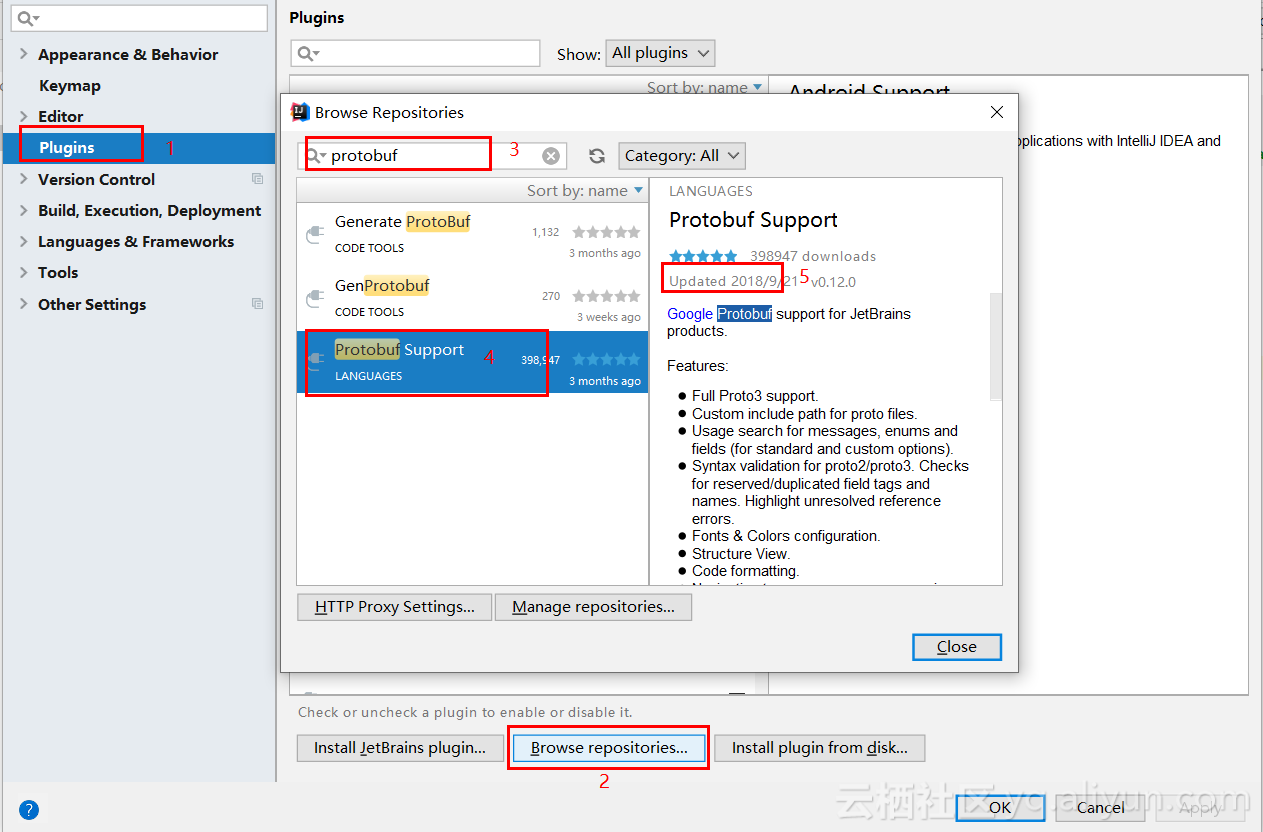
IDEA中的Protobuf的插件的使用 首先File->setting中找到plugins 然后安装插件 安装完成后重启IDEA就可以了 测试: 在src/main/下建立proto文件夹,并在其中建立以proto为后缀文件 然后将如下的proto协议写进去 syntax = "proto3"; message SearchRequest { string query = 1; int32 page_number = 2; int32 result_per_page = 3; } 然后maven中添加 <properties> <grpc.version>1.6.1</grpc.version> <protobuf.version>3.3.0</protobuf.version> </properties> <dependencies> <dependency> <groupId>io.grpc</groupId> <artifactId>grpc-netty</artifactId> <version>${grpc.version}</version> <scope>provided</scope> </dependency> <dependency> <groupId>io.grpc</groupId> <artifactId>grpc-protobuf</artifactId> <version>${grpc.version}</version> <scope>provided</scope> </dependency> <dependency> <groupId>io.grpc</groupId> <artifactId>grpc-stub</artifactId> <version>${grpc.version}</version> <scope>provided</scope> </dependency> <dependency> <groupId>com.google.protobuf</groupId> <artifactId>protobuf-java</artifactId> <version>${protobuf.version}</version> </dependency> </dependencies> <build> <extensions> <extension> <groupId>kr.motd.maven</groupId> <artifactId>os-maven-plugin</artifactId> <version>1.5.0.Final</version> </extension> </extensions> <plugins> <plugin> <groupId>org.xolstice.maven.plugins</groupId> <artifactId>protobuf-maven-plugin</artifactId> <version>0.5.0</version> <configuration> <protocArtifact>com.google.protobuf:protoc:${protobuf.version}:exe:${os.detected.classifier}</protocArtifact> <pluginId>grpc-java</pluginId> <pluginArtifact>io.grpc:protoc-gen-grpc-java:${grpc.version}:exe:${os.detected.classifier}</pluginArtifact> </configuration> <executions> <execution> <goals> <goal>compile</goal> <goal>compile-custom</goal> </goals> </execution> </executions> </plugin> </plugins> </build> 等待下载完成后,然后点击maven中的compile插件,运行完,如果配置正确,在项目的target的目录下就生成了我们需要的类文件了 好了介绍到这里,IDEA中使用protobuf插件就完成了,下面是关于protobuf的简介和一些详细内容 简介 Google Protocol Buffer 简称Protobuf是Google公司内部的开源项目,可用于RPC系统和持续数据存储系统 是一种轻便高效的结构化数据存储格式,可用于结构化数据串行化,或者序列化,非常适合数据存储或RPC数据交换格式,可用于通讯协议,数据存储等领域,并且是平台无关的 定义数据类型 如上在IDEA中运行的protobuf文件,我们拿这个来说 syntax = "proto3"; message SearchRequest { string query = 1; int32 page_number = 2; int32 result_per_page = 3; } syntax 指定protobuf的版本,必须是文件的第一行 message 代表这是一个消息,SearchRequest消息中指定了三个字段,每一个字段对应于要包含在这种类型的消息中的数据,每一个字段都有一个名称和类型,比如上面的int32 page_number = 2;,名称就是page_number,而类型就是int32,注意等号后面的不是默认值,而可以认为他是此page_number字段的身份证,不可重复,这些数字用于以二进制格式标识您的字段,一旦消息类型被使用就不应该被更改,需要注意的是1到15范围内的字段编号需要一个字节来编码,而16到2047范围内的字段编号需要两个字节,所以经常使用的应该为其编码为1到15之间,这些数字的范围是[1, 536870911],其中19000~19999是为协议缓冲区实现而保留的,不可以使用,否则报错 标量值类型 即int32 page_number = 2;中的int32叫做标量值类型 下面是标量值类型以及生成的java中的对应类型 类型 说明 对应类型 double null double float null float int32 使用可变长度编码,编码负数效率低下,如果你的字段可能有负值,请改用sint32 int int64 使用可变长度编码,编码负数效率低下,如果你的字段可能有负值,请改用sint64 long uint32 使用可变长度编码 int uint64 使用可变长度编码 long sint32 使用可变长度编码,符号整型值,这些比常规int32编码负数更有效 int sint64 使用可变长度编码,有符号的int值,这些比常规int64编码负数更有效 long fixed32 总是四字节,如果值经常大于2^28,则比uint32更有效 int fixed64 总是八字节,如果值经常大于2^56,则比uint64更有效 long sfixed32 总是四字节 int sfixed64 总是八字节 long bool null boolean string 字符串必须始终包含UTF8编码或7位ASCII文本 string bytes 可以包含任意字节序列 byteString 如果你使用的是别的语言,那么还有一张对照图,在下面 修饰符 如果一个字段被repeated修饰,则表示它是一个列表类型的字段 如果你现在不确定是否某个值或者变量是否以后会使用的到为了不误写,那么可以保留 message Foo { reserved 2, 15, 9 to 11; reserved "foo", "bar"; string foo = 3 // 编译报错,因为‘foo’已经被标为保留字段 } 缺省值:默认值 string类型的默认值是空字符串 bytes类型的默认值是空字节 bool类型的默认值是false 数字类型的默认值是0 enum类型的默认值是第一个定义的枚举值 message类型(对象,如上文的SearchRequest就是message类型)的默认值与 语言 相关 repeated修饰的字段默认值是空列表,比如repeated string query = 1; = java.util.List<java.lang.String> 如果一个字段的值等于默认值(如bool类型的字段设为false),那么它将不会被序列化,这样的设计是为了节省流量 枚举 之前的都是简单类型,比如int32之类的,那么在message中还可以定义复杂类型 每个枚举值有对应的数值,数值不一定是连续的.第一个枚举值的 数值必须是0且至少有一个枚举值 ,否则编译报错.编译后编译器会为你生成对应语言的枚举类,零值必须为第一个元素,以便与proto 2语义兼容,其中第一个枚举值总是默认的 由于编码原因,出于效率考虑,不推荐使用负数作为枚举值的数值 如下就在之前的基础上添加到了春夏秋冬四个枚举常量值,当然里面的数字标识不用按顺序来 syntax = "proto3"; message SearchRequest { string query = 1; int32 page_number = 2; int32 result_per_page = 3; Groups groups = 4; enum Groups{ SPRING = 0; SUMMER = 1; Autumn = 2; WINTER = 3; } } 如果个别的枚举值的标识是相同的,需要用option allow_alias = true;来声明一下,比如 enum Groups{ option allow_alias = true; SPRING = 0; SUMMER = 2; Autumn = 2; WINTER = 3; } 如果去掉option allow_alias = true;,那么编译会出现错误, 并且注意枚举数常量必须在32位整数的范围内 可以使用messageName.enum的形式,在其他message中引用,比如 message Others { SearchRequest.Groups groups = 1; } 其生成的类中方法定义的返回值就是Mes.SearchRequest.Groups getGroups(); 使用其它的message类型 第一种使用方法如下 syntax = "proto3"; message First { repeated string query = 1; Second second = 2; //引用其他message类型 } message Second { int32 num = 1; } 第二种即import导入使用 syntax = "proto3"; import "second.proto"; //首先导入 message First { repeated string query = 1; Second second = 2; //引用其他message类型 } 上面这种导入如果测试,需要将second.proto移到相同目录下,并且First和Second消息是两个proto文件 嵌套 可以在一个message类型中定义另一个message类型,并且可以一直嵌套下去,类似Java的内部类 message SearchResponse { message Result { string url = 1; string title = 2; repeated string snippets = 3; } repeated Result results = 1; } 可以使用Parent.Type的形式引用嵌套的message message SomeOtherMessage { SearchResponse.Result result = 1; } 更新message 当proto不能满足要求的情况下,那么我们就需要按照要求更新message 不要更改任何已有的字段的数值标识 如果增加新的字段,使用旧格式的字段仍然可以被新产生的代码所解析.相似的,通过新代码产生的消息也可以被旧代码解析:只不过新的字段会被忽视掉.注意:未被识别的字段会在反序列化的过程中丢弃掉,所以如果消息再被传递给新的代码,新的字段依然是不可用的 非required的字段可以移除,只要它们的标识号在新的消息类型中不再使用,但是更好的做法是将此字段重命名,保证其标识号不被其他变量误用 nt32, uint32, int64, uint64,和bool是全部兼容的,如果转换的时候发生不符合的情况,那么会强制类型转换 sint32和sint64是互相兼容的,但是它们与其他整数类型不兼容 string和bytes是兼容的,只要bytes是有效的UTF-8编码 嵌套消息与bytes是兼容的,只要bytes包含该消息的一个编码过的版本 fixed32与sfixed32是兼容的,fixed64与sfixed64是兼容的 枚举类型与int32,uint32,int64和uint64相兼容,,如果转换的时候发生不符合的情况,那么会强制类型转换 Any Any允许包装任意的message类型 ,一个Any类型包括一个可以被序列化bytes类型的任意消息,以及一个URL作为一个全局标识符和解析消息类型.为了使用Any类型,你需要导入import google/protobuf/any.proto import "google/protobuf/any.proto"; message Response { google.protobuf.Any data = 1; } 如上会被解析成private java.util.List<com.google.protobuf.Any> details_; 类型 对于给定的消息类型的默认类型URL是type.googleapis.com/packagename.messagename 不同语言的实现会支持动态库以线程安全的方式去帮助封装或者解封装Any值,例如在java中,Any类型会有特殊的pack()和unpack()访问器 实例 //People.proto syntax = "proto3"; message Get{ string name = 1; } //First.proto syntax = "proto3"; import "google/protobuf/any.proto"; message Response { google.protobuf.Any data = 1; } public class Tests { public static void main(String[] args) throws InvalidProtocolBufferException { People.Get wangziqiang = People.Get.newBuilder().setName("wangziqiang").build(); First.Response build = First.Response.newBuilder().setData(Any.pack(wangziqiang)).build(); System.out.println(build.getData()); System.out.println(build.getData().unpack(People.Get.class).getName()); } /** * 输出结果 * type_url: "type.googleapis.com/Get" * value: "\n\vwangziqiang" * wangziqiang */ } 如上我们就看到了,Any可以包含任何的message,也就是进行pack动作,而unpack是进行解包得到内容,这是我自己的理解 Oneof 用于几个参数只能初始化其中一个的情况,设置其中一个字段会清除其它字段,repeated不可以在其中被使用 syntax = "proto3"; message Name{ oneof set_name{ string first_name = 1; string last_name = 2; } } public class Tests { public static void main(String[] args) { People.Name wangziqiang = People.Name.newBuilder().setFirstName("nn").setLastName("wangziqiang").build(); System.out.println("getFirstName -> " + wangziqiang.getFirstName()); System.out.println("getLastName -> " + wangziqiang.getLastName()); System.out.println(wangziqiang.getFirstName().isEmpty()); System.out.println(wangziqiang.getLastName().isEmpty()); } /** * getFirstName -> wangziqiang * getLastName -> * true * false * 也就可以看出来,只有最后一次设置的字段有值. */ } Map 其实是一种语法糖,如下 message xx{ int32 i = 1; string j = 2; } message ss { xx x = 1; //map<int32,string> = 1 } 需要注意的是key除了floating和bytes的任意标量类型都是可以的,value可以是任意类型 map的顺序不一定 map类型字段不支持repeated 当为.proto文件产生生成文本格式的时候,map会按照key 的顺序排序,数值化的key会按照数值排序 如果有重复的key则后一个key不会被使用 实例 syntax = "proto3"; message Name{ map<int32,string> names = 1; } public class Tests { public static void main(String[] args) throws InvalidProtocolBufferException { People.Name.Builder builder = People.Name.newBuilder(); builder.putNames(1,"one"); builder.putNames(3,"three"); builder.putNames(2,"two"); People.Name name = builder.build(); System.out.println(name); } /** * names { * key: 1 * value: "one" * } * names { * key: 3 * value: "three" * } * names { * key: 2 * value: "two" * } */ } 包 使用方法 syntax = "proto3"; package qidai; message Name{ map<int32,string> names = 1; } 定义服务 如果想要将消息类型用在RPC系统中,可以在.proto文件中定义一个RPC服务接口,protocol buffer编译器将会根据所选择的不同语言生成服务接口代码 syntax = "proto3"; package qidai; message NameRequest{ string name = 1; } message NameResponse{ int32 name_hash = 1; } service rpc_name { rpc getName(NameRequest) returns(NameResponse); } 上面的表示,rpc的参数为NameRequest,而返回值为NameResponse,对于java应用protobuf实现简单的rpc,之后再说 JSON映射 在protobuf中支持使用JSON,那么对于protobuf中的类型和JSON中的类型的对应表如下 proto3 JSON JSON示例 注意 message object {"fBar": v, "g": null, …} 产生JSON对象,消息字段名可以被映射成lowerCamelCase形式,并且成为JSON对象键,null被接受并成为对应字段的默认值 enum string "FOO_BAR" 枚举值的名字在proto文件中被指定 map object {"k": v, …} 所有的键都被转换成string repeated V array [v, …] null被视为空列表 bool true, false true, false string string "Hello World!" bytes base64 string "YWJjMTIzIT8kKiYoKSctPUB+" int32,fixed32,uint32 number 1, -10, 0 JSON值会是一个十进制数,数值型或者string类型都会接受 int64,fixed64,uint64 string "1", "-10" JSON值会是一个十进制数,数值型或者string类型都会接受 float,double number 1.1, -10.0, 0, "NaN", "Infinity" JSON值会是一个数字或者一个指定的字符串如”NaN”,”infinity”或者”-Infinity”,数值型或者字符串都是可接受的,指数符号也可以接受 Any object {"@type": "url", "f": v, … } 如果一个Any保留一个特上述的JSON映射,则它会转换成一个如下形式:{"@type": xxx, "value": yyy}否则,该值会被转换成一个JSON对象,@type字段会被插入所指定的确定的值 Timestamp string "1972-01-01T10:00:20.021Z" 使用RFC 339,其中生成的输出将始终是Z-归一化啊的,并且使用0,3,6或者9位小数 Duration string "1.000340012s", "1s" 生成的输出总是0,3,6或者9位小数,具体依赖于所需要的精度,接受所有可以转换为纳秒级的精度 Struct object { … } 任意的JSON对象,见struct.proto Wrapper types various types 2, "2", "foo", true, "true", null, 0, ... 包装器在JSON中的表示方式类似于基本类型,但是允许nulll,并且在转换的过程中保留null FieldMask string "f.fooBar,h" 见fieldmask.proto ListValue array [foo, bar, …] Value value 任意JSON值 NullValue null JSON null 下面也是对照表 选项 在定义.proto文件时能够标注一系列的options.Options并不改变整个文件声明的含义,但却能够影响特定环境下处理方式.完整的可用选项可以在google/protobuf/descriptor.proto找到,在IDEA中直接搜索descriptor.proto就行 一些选项是文件级别的,意味着它可以作用于最外范围,不包含在任何消息内部、enum或服务定义中.一些选项是消息级别的,意味着它可以用在消息定义的内部.当然有些选项可以作用在域、enum类型、enum值、服务类型及服务方法中 常用的选择 java_package:文件选项,即指定包名,如下,但是自己感觉好像与package com.qidai;一样的作用 syntax = "proto3"; option java_package = "com.qidai"; message NameRequest{ string name = 1; } java_outer_classname:文件选项,即指定外部类类名,如果不指定,那么默认的类名是以proto文件的名字作为类名的 syntax = "proto3"; option java_outer_classname = "Peoples"; //然后编译完成后就是生成的Peoples的类名,而不是以proto文件名作为类名了 message NameRequest{ string name = 1; } optimize_for:文件选项,可以被设置为 SPEED, CODE_SIZE,或者LITE_RUNTIME,这些值将影响代码的生成 SPEED:默认protocol buffer编译器将通过在消息类型上执行序列化、语法分析及其他通用的操作.这种代码是最优的. CODE_SIZE:protocol buffer编译器将会产生最少量的类,通过共享或基于反射的代码来实现序列化、语法分析及各种其它操作.采用该方式产生的代码将比SPEED要少得多, 但是操作要相对慢些,但是生成的代码的访问方式和SPEED是一样的 LITE_RUNTIMEprotocol buffer编译器依赖于运行时核心类库来生成代码(即采用libprotobuf-lite 替代libprotobuf).这种核心类库由于忽略了一 些描述符及反射,要比全类库小得多.这种模式经常在移动手机平台应用多一些 syntax = "proto3"; option optimize_for = SPEED; message NameRequest{ string name = 1; } deprecated:表示废弃了 syntax = "proto3"; message NameRequest{ string name = 1 [deprecated = true]; } 生成访问类 如上我们都是在IDEA插件的帮助下,自动完成编译的,自己接触的是Java,所以在这里列一下Java的生成类的方式,如果你是别的语言,那么请参考给出的参考博文 protoc --proto_path=IMPORT_PATH --java_out=DST_DIR path/to/file.proto IMPORT_PATH声明了一个.proto文件所在的解析import具体目录,如果忽略该值,则使用当前目录,如果有多个目录则可以多次调用--proto_path,-I=IMPORT_PATH是--proto_path的简化形式 --java_out 在目标目录DST_DIR中产生Java代码 作为一个方便的拓展,如果DST_DIR以.zip或者.jar结尾,编译器会将输出写到一个ZIP格式文件或者符合JAR标准的.jar文件中.注意如果输出已经存在则会被覆盖 好了到这就是Protobuf的基本用法,本文参考网上的博文,链接如下,如果本文有什么错误请及时指出 , 谢谢咯 开发学院简书CSDN

优秀的个人博客,低调大师

Lambda入门

Lambda 来源于微积分数学中的 λ,其涵义是声明为了表达一个函数具体需要什么. Table of contents Introduction 使用 Introduction 什么是Lambda? 我们知道,对于一个Java变量,我们可以赋给其一个“值”。 如果你想把“一块代码”赋给一个Java变量,应该怎么做呢? 比如,我想把右边那块代码,赋给一个叫做aBlockOfCode的Java变量: 在Java 8之前,这个是做不到的。但是Java 8问世之后,利用Lambda特性,就可以做到了。 当然,这个并不是一个很简洁的写法。所以,为了使这个赋值操作更加elegant, 我们可以移除一些没用的声明。 这样,我们就成功的非常优雅的把“一块代码”赋给了一个变量。而“这块代码”,或者说“这个被赋给一个变量的函数”,就是一个Lambda表达式。 但是这里仍然有一个问题,就是变量aBlockOfCode的类型应该是什么? 在Java 8里面,所有的Lambda的类型都是一个接口,而Lambda表达式本身,也就是”那段代码“,需要是这个接口的实现。这是我认为理解Lambda的一个关键所在,简而言之就是,Lambda表达式本身就是一个接口的实现。直接这样说可能还是有点让人困扰,我们继续看看例子。我们给上面的aBlockOfCode加上一个类型: 这种只有一个接口函数需要被实现的接口类型,我们叫它”函数式接口“。为了避免后来的人在这个接口中增加接口函数导致其有多个接口函数需要被实现,变成"非函数接口”,我们可以在这个上面加上一个声明@FunctionalInterface, 这样别人就无法在里面添加新的接口函数了: 这样,我们就得到了一个完整的Lambda表达式声明: 使用 Lambda表达式有什么作用? 最直观的作用就是使得代码变得异常简洁。 我们可以对比一下Lambda表达式和传统的Java对同一个接口的实现: 这两种写法本质上是等价的。但是显然,Java 8中的写法更加优雅简洁。并且,由于Lambda可以直接赋值给一个变量,我们就可以直接把Lambda作为参数传给函数, 而传统的Java必须有明确的接口实现的定义,初始化才行: 有些情况下,这个接口实现只需要用到一次。传统的Java 7必须要求你定义一个“污染环境”的接口实现MyInterfaceImpl,而相较之下Java 8的Lambda, 就显得干净很多。 Lambda结合FunctionalInterface Lib, forEach, stream(),method reference等新特性可以使代码变的更加简洁! 直接上例子。 假设Person的定义和List的值都给定。 该注解见lombok 现在需要你打印出guiltyPersons List里面所有LastName以"Z"开头的人的FirstName。 原生态Lambda写法:定义两个函数式接口,定义一个静态函数,调用静态函数并给参数赋值Lambda表达式。 这个代码实际上已经比较简洁了,但是我们还可以更简洁么? 当然可以。在Java 8中有一个函数式接口的包,里面定义了大量可能用到的函数式接口(java.util.function (Java Platform SE 8 ))。所以,我们在这里压根都不需要定义NameChecker和Executor这两个函数式接口,直接用Java 8函数式接口包里的Predicate和Consumer就可以了——因为他们这一对的接口定义和NameChecker/Executor其实是一样的。 第一步简化 - 利用函数式接口包: 静态函数里面的for each循环其实是非常碍眼的。这里可以利用Iterable自带的forEach()来替代。forEach()本身可以接受一个Consumer 参数。 第二步简化 - 用Iterable.forEach()取代foreach loop: 由于静态函数其实只是对List进行了一通操作,这里我们可以甩掉静态函数,直接使用stream()特性来完成。stream()的几个方法都是接受Predicate,Consumer等参数的(java.util.stream (Java Platform SE 8 ))。你理解了上面的内容,stream()这里就非常好理解了,并不需要多做解释。 第三步简化 - 利用stream()替代静态函数: 对比最开始的Lambda写法,这里已经非常非常简洁了。但是如果,我们的要求变一下,变成print这个人的全部信息,及p -> System.out.println(p); 那么还可以利用Method reference来继续简化。所谓Method reference, 就是用已经写好的别的Object/Class的method来代替Lambda expression。格式如下: 第四步简化 - 如果是println(p),则可以利用Method reference代替forEach中的Lambda表达式: 这基本上就是能写的最简洁的版本了 Lambda配合Optional可以使Java对于null的处理变的异常优雅 这里假设我们有一个person object,以及一个person object的Optional wrapper: Optional如果不结合Lambda使用的话,并不能使原来繁琐的null check变的简单。 只有当Optional结合Lambda一起使用的时候,才能发挥出其真正的威力! 我们现在就来对比一下下面四种常见的null处理中,Java 8的Lambda+Optional和传统Java两者之间对于null的处理差异。 情况一 - 存在则开干 情况二 - 存在则返回,无则返回屁 情况三 - 存在则返回,无则由函数产生 情况四 - 夺命连环null检查 由上述四种情况可以清楚地看到,Optional+Lambda可以让我们少写很多ifElse块。尤其是对于情况四那种夺命连环null检查,传统java的写法显得冗长难懂,而新的Optional+Lambda则清新脱俗,清楚简洁 关于Java的Lambda, 还有东西需要讨论和学习。比如如何handle lambda exception,如何利用Lambda的特性来进行parallel processing等。总之,我只是一如既往地介绍个大概,让你大概知道,哦!原来是这样子就OK了。网上关于Lambda有很多相关的教程,多看多练。假以时日,必定有所精益。 转载自知乎用户Sevenvidia,来自Amazon,Lambda 表达式有何用处?如何使用?

优秀的个人博客,低调大师

Druid入门

应用场景 设计一个系统来预估未来一年的广告流量,不是总流量,是任意时间段任何定向(Targeting)条件约束情况下的流量。定向条件有近百种(内容类别,设备平台,用户地域,用户人口属性等),整个时间区间不同组合数(也就是数据行数)是亿级别。目标是秒级的查询响应时间。 一个简单的数据例子如下: 存储系统选择 MySQL不是适合的选择 最容易想到的是用Mysql作为数据存放和查询引擎,由于数据行数太多,Mysql必须通过创建索引或者组合索引来加速查询。 典型的查询包含若干个定向类别,这些定向条件的组合是非常多的(top 80%的查询也会包含几十种组合),故需要创建非常多的组合索引,代价很高。 另外,对于那些没有创建组合索引的查询,查询时间完全不能接受。 为什么没有用Hbase或者Hive Hbase本身是一个经典的基于hdfs的分布式存储系统,通常来说其是行存储的,当创建column families之后,每个column family是列存储的。在这个应用中,可以为每个定向类别(包括日期)创建一个单独的column family,但Hbase本身没有为column family创建bitmap indexing,查询速度应该会受到影响。 另外不用Hbase的一个原因是希望存储系统尽量轻量级,最好不要安装hadoop Hive将查询转化为M/R任务,没法保证查询的快速响应(比如M/R cluster资源竞争很激烈时),而且使用Hive需要以来hadoop cluster,对这个应用来说也略微重量级。 我们需要一个高可用的分布式的列存储系统 核心需求包含2点,一是查询速度快,二是系统的拓展性好,最好是分布式的。 第一点要求意味着最好用column-store而不是row-store,在这个应用中,虽然定向类别有近百种,但是单次查询通常只会涉及几个。对于修改操作较少且查询往往只涉及少数几列的场景使用column-store可以获得快一个量级的查询速度。而且column-store可以通过bitmap indexing,encoding,以及compression来优化查询速度和存储开销 第二点要求一方面是由于我们的数据量较大,并行存储和查询可以减少时间开销,另一方面是数据量每年还在快速上涨,以后可以简单地通过加机器来应对。 对系统的其他要求比较普遍:系统可用性要高,稳定,轻量级,易于上手。 为什么Druid是适合的选择 Druid满足我们上面2点要求,其是一个开源的、分布式的、列存储系统,特别适用于大数据上的(准)实时分析统计。且具有较好的稳定性(Highly Available)。 其相对比较轻量级,文档非常完善,也比较容易上手。 Druid介绍 概念 Segment: Druid中有个重要的数据单位叫segment,其是Druid通过bitmap indexing从raw data生成的(batch or realtime)。 segment保证了查询的速度。可以自己设置每个segment对应的数据粒度,这个应用中广告流量查询的最小粒度是天,所以每天的数据会被创建成一个segment。注意segment是不可修改的,如果需要修改,只能够修改raw data,重新创建segment了 架构 image Druid本身包含5个组成部分:Broker nodes, Historical nodes, Realtime nodes, Coordinator Nodes和indexing services. 分别的作用如下: Broker nodes: 负责响应外部的查询请求,通过查询Zookeeper将请求划分成segments分别转发给Historical和Real-time nodes,最终合并并返回查询结果给外部; Historial nodes: 负责’Historical’ segments的存储和查询。其会从deep storage中load segments,并响应Broder nodes的请求。Historical nodes通常会在本机同步deep storage上的部分segments,所以即使deep storage不可访问了,Historical nodes还是能serve其同步的segments的查询; Real-time nodes: 用于存储和查询热数据,会定期地将数据build成segments移到Historical nodes。一般会使用外部依赖kafka来提高realtime data ingestion的可用性。如果不需要实时ingest数据到cluter中,可以舍弃Real-time nodes,只定时地batch ingestion数据到deep storage; Coordinator nodes: 可以认为是Druid中的master,其通过Zookeeper管理Historical和Real-time nodes,且通过Mysql中的metadata管理Segments Druid中通常还会起一些indexing services用于数据导入,batch data和streaming data都可以通过给indexing services发请求来导入数据。 Druid还包含3个外部依赖 Mysql:存储Druid中的各种metadata(里面的数据都是Druid自身创建和插入的),包含3张表:”druid_config”(通常是空的), “druid_rules”(coordinator nodes使用的一些规则信息,比如哪个segment从哪个node去load)和“druid_segments”(存储每个segment的metadata信息); Deep storage: 存储segments,Druid目前已经支持本地磁盘,NFS挂载磁盘,HDFS,S3等。Deep Storage的数据有2个来源,一个是batch Ingestion, 另一个是real-time nodes; ZooKeeper: 被Druid用于管理当前cluster的状态,比如记录哪些segments从Real-time nodes移到了Historical nodes; 查询 Druid的查询是通过给Broker Nodes发送HTTP POST请求(也可以直接给Historical or Realtime Node),具体可见Druid官方文档。查询条件的描述是json文件,查询的response也是json格式。Druid的查询包含如下4种: Time Boundary Queries: 用于查询全部数据的时间跨度 groupBy Queries: 是Druid的最典型查询方式,非常类似于Mysql的groupBy查询。query body中几个元素可以这么理解: “aggregation”: 对应mysql”select XX from”部分,即你想查哪些列的聚合结果; “dimensions”: 对应mysql”group by XX”,即你想基于哪些列做聚合; “filter”: 对应mysql”where XX”条件,即过滤条件; “granularity”: 数据聚合的粒度; Timeseries queries: 其统计满足filter条件的”rows”上某几列的聚合结果,相比”groupBy Queries”不指定基于哪几列进行聚合,效率更高; TopN queries: 用于查询某一列上按照某种metric排序的最常见的N个values; 本文小结 Druid是一个开源的,分布式的,列存储的,适用于实时数据分析的系统,文档详细,易于上手; Druid在设计时充分考虑到了Highly Available,各种nodes挂掉都不会使得druid停止工作(但是状态会无法更新); Druid中的各个components之间耦合性低,如果不需要streaming data ingestion完全可以忽略realtime node; Druid的数据单位Segment是不可修改的,我们的做法是生成新的segments替换现有的; Druid使用Bitmap indexing加速column-store的查询速度,使用了一个叫做CONCISE的算法来对bitmap indexing进行压缩,使得生成的segments比原始文本文件小很多; 在我们的应用场景下(一共10几台机器,数据大概100列,行数是亿级别),平均查询时间<2秒,是同样机器数目的Mysql cluter的1/100 ~ 1/10; Druid的一些“局限”: Segment的不可修改性简化了Druid的实现,但是如果你有修改数据的需求,必须重新创建segment,而bitmap indexing的过程是比较耗时的; Druid能接受的数据的格式相对简单,比如不能处理嵌套结构的数据

优秀的个人博客,低调大师

Numpy入门

标题中的英文首字母大写比较规范,但在python实际使用中均为小写。 2018年7月23日笔记 0. 学习内容: Python科学计算库:Numpy需要掌握的知识: 1.Numpy简介;2.Numpy程序包;3.简单的Numpy程序;4.为什么使用Numpy; 5.Numpy是什么;6.Numpy数据溢出; 1. Numpy简介 Numpy是python语言中的科学计算库。 下文主要介绍数据科学工具包Numpy的基本用法,内容包括: 1.Numpy的ndarray多维数组创建 2.Numpy的ndarray多维数组索引切片访问 3.Numpy的ndarray多维数组的组合分割 2. Numpy程序包 集成开发环境为Jupyter notebook 语言及其版本为python3.6 安装numpy在cmd中运行命令:pip install numpy,如果电脑安装了最新版的anaconda,则自带jupyter notebook和numpy库。 集成开发环境如下图所示: image_1cj3s95tl1rsg1hlm1fatkhl12bj9.png-24kB 3.简单的Numpy程序 两个一维矩阵做加法 matrix1 = [0,1,4] matrix2 = [0,1,8] matrix3 = [0,2,12] #使用python原有的列表和推导式 matrix1 = [0,1,4] matrix2 = [0,1,8] matrix3 = [a+b for a,b in zip(matrix1,matrix2)] print(matrix3,type(matrix3)) #使用numpy库计算 import numpy matrix1 = numpy.arange(3) ** 2 matrix2 = numpy.arange(3) ** 3 matrix3 = matrix1 + matrix2 print(matrix3,type(matrix3)) 代码及其运行结果如下图所示: image_1cj3sskqr1t6p19dm1so8aodibh13.png-31.5kB 4.为什么使用Numpy 原因有以下3点: 1.对于同样的数值计算任务,由于Numpy能够直接对数组和矩阵进行操作,可以省略很多循环语句使用Numpy要比直接编写Python代码便捷得多; 2.Numpy中数组的存储效率和输入输出性能均远远优于Python中等价的数据结构; 3.Numpy的大部分代码都是用C语言写的,这使得Numpy比纯Python代码高效得多。 5.Numpy是什么 Numpy的全名为Numeric Python,是一个开源的科学计算库,它包括: 1.一个强大的N维数组对象ndarray;2.比较成熟的函数库; 3.用于整合C/C++和Fortran代码的工具包;4.实用的线性代数、傅里叶变换和随机生成函数。 Numpy支持高维度数组计算和矩阵计算,此外也针对了数组提供了大量的科学函数库。 6.Numpy数据溢出 import numpy as np matrix = np.arange(1292) ** 3 print(matrix.dtype) print(matrix[-3:]) print(2 ** 32 - 1291 ** 3) 代码及其运行结果如下图: image_1cj3u1bb713t11jlkjsp1tmjih41t.png-15.8kB 从上面一段代码可以看出:1.np.arange方法产生的一个ndarray对象,对象中的元素默认为int32类型。 2^31 - 1的值为2147483647,如果int32类型超过这个值则算越界,越界后所得值为负数。 越界所得负数的绝对值 + 原本值 = 2 ** 32。 练习 利用Numpy实现两个向量相乘的结果 有两种解答方法:1.利用np.dot方法,需要2个参数,1个参数数据类型为ndarray,长度要相同。 2.利用ndarray对象的dot方法,需要1个参数,参数数据类型为ndarray,长度要相同。 下面代码中有两种解答方法的示例。 import numpy as np matrix1 = np.arange(10) print(matrix1) matrix2 = np.arange(10,20) print(matrix2) print(np.dot(matrix1,matrix2)) print(matrix1.dot(matrix2)) image_1cja6gt6rp7orhr1rq712jff899.png-41.1kB

优秀的个人博客,低调大师

MongoDB入门

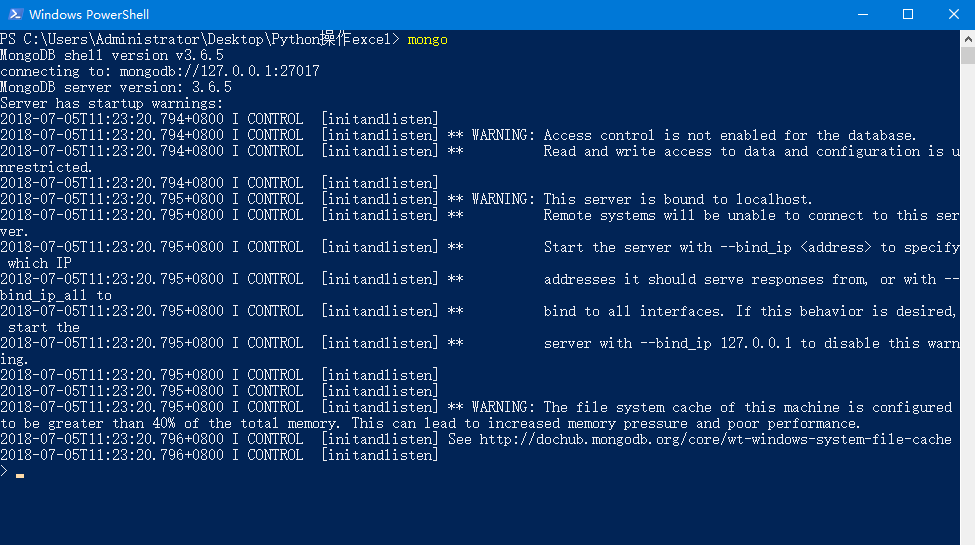
2018年7月5日笔记 1.MongoDB简介 1.1 NoSQL数据库是什么 NoSQL,指的是非关系型的数据库。NoSQL有时也称作Not Only SQL的缩写,是对不同的传统的关系型数据库的数据库管理系统的统称。 NoSQL用于超大规模数据的存储。(例如谷歌或Facebook每天为他们的用户收集万亿比特的数据)。这些类型的数据存储不需要固定的模式,无需多余操作就可以横向扩展。 主要解决: 1.对数据库高并发的需求 2.对海量数据的高效率存储和访问的需求 3.对数据库的高扩展性和高可用性的需求 1.2 什么是MongoDB 取自“humongous”(海量),是由10gen团队2007年10月开发并维护的开源,高性能,可扩展,无模式,面向文档(document-oriented)的数据库。其内存储的一种-like结构化数据。它介于关系数据库和非关系数据库之间,是非关系数据库中最像关系数据库的。是一个基于分布式文件存储的数据库。由C++语言编写。旨在为WEB应用提供可扩展的高性能数据存储方案。 官网:http://www.mongodb.com 最新版本:3.6.3(3/20/2018) 支持操作系统:OSX/linux/Windows 1.3 MongoDB数据库的特点 高性能、易部署、易使用、存储数据数据非常方便。主要功能特性有: 1.面向集合存储,易存储对象类型的数据 2.模式自由(没有行,列,关系等概念) 3.支持完全索引,包含内部对象。 4.支持查询 5.支持复制和故障恢复 6.使用高效的二进制数据存储,包括大型对象 7.自动处理碎片,以支持云计算层次的扩展性 8.支持C#、Python、Ruby、Java、C、Javascript、Perl以及C++语言的驱动程序,社区中也提供了对Erlang以及.NET及平台的扩展程序。 9.文件存储格式为BSON(一种JSON的扩展) 10.可通过网络访问 优点:弱一致性、文档结构的存储方式、内置GridFS(分布式文件系统)缺点:不支持事务、空间占用大 1.4 MongoDB数据库的适用场合 适用场景: 1.网站实时数据处理。它非常适合实时的插入、更新与查询,并具备网站实时数据存储所需的复制及高度伸缩性。 2.缓存。由于性能很高,他适合作为信息基础建设的缓存层。在系统重启之后,由它搭建的数据持久化存储层可以避免下层的数据源过载。 3.高伸缩性的场合。非常适合由数十或者数百台服务器组成的数据库,它的路线图中已经包含对MapReduce引擎的内置支持。不适用场景: 1.类似银行或会计系统这种高事务性的系统。 2.传统的商业智能应用 3.复杂的跨文档级联查询 1.5 MongoDB 视觉中国、大众点评、淘宝、优酷、淘宝 2.MongoDB的基本使用 MongoDB的软件安装教程:Windows 平台安装 MongoDB教程 下面的命令能够正确运行的前提是已经启动MongoDB服务 进入MongoDB的Shell.png-26.3kB 2.1 显示已有的数据库 命令:show dbs 图片.png-1kB 2.2 创建库 使用use runoob就已经创建一个名为runoob的数据库,但必须要往runoob数据库中的一个集合中插入一条数据才能用show dbs命令看到runoob数据库,db.mycoll.insert({name:'runoob'})这一句就是往mycoll这个集合中插入一条name字段值为runoob的数据。 在MongoDB中,数据库和集合不需要提前创建,只要使用就自动创建。 命令: use runoob db.mycoll.insert({name:'runoob'}) show dbs 2.3 删除数据库 命令:db.dropDatabase() 图片.png-3.5kB 2.4 创建集合 命令:db.createCollection(name,options) name参数的数据类型是字符串,意义是要创建的集合名称 options参数的数据类型是json格式的文本,意义是制定有关内存大小和索引选项 options可以是如下参数: 图片.png-16.1kB 从下图中可以看出,一开始使用 show collections显示没有集合,创建第一个简单的集合 mycoll,第二个带参数的集合 mycoll2,创建两个集合后,可以用 show collections可以显示这两个集合的存在。 图片.png-4.5kB 2.5 删除集合 命令:db.{}.drop(),大括号中的要填入的内容是要删除的集合的名称。 图片.png-1.6kB 3.MongoDB进阶 3.1 MongoDB常见数据类型 1.String:这是最常见的数据类型来存储数据,在MongoDB中的字符串必须是有效的UTF-8 2.Integer:这种类型是用来存储一个数值。整数可以是32位或64位,这取决与运行软件的机器。 3.Boolean:用来存储布尔值(true/false) 4.Double:用来存储浮点值 5.Min/Max Keys: 用来对BSON元素的最低和最高值比较 6.Arrays:使用此类型的数组或列表存储到一个键 7.Timestamp:时间戳,这可以方便记录的文件已被修改或添加 8.Object:此类型嵌入式的文件中 9.Null:这种类型是用来存储一个Null的 10.Symbol:用于字符串相同,但它通常是保留给特定符号类型的语言使用。 11.Date:用于存储当前时间或日期的Unix时间格式,可以指定自己的日期和时间。 12.ObjectID:用于存储文档的ID 13.Binary data:用于存储二进制数据 14.Regular expression:用于存储正则表达式 3.2 MongoDB插入文档 命令语法:db.{}.insert({}),第一个大括号填入集合名,第二个大括号填入要插入的文档。 图片.png-7.3kB 3.3 MongoDB更新文档 命令语法:db.{}.update({},{}),第一个大括号填入集合名,第二个大括号填入json格式的文本,第三个括号填入两层json格式文本,第一层的第一个元素的键为$set 图片.png 从上图中可以看到集中mycoll中的第一个文档中的第一个元素title的值从MongoDB overview改为了MongoDB。 3.4 MongoDB Save()方法 命令语法: db.{}.save({}),第一个大括号填入集合名,第二个大括号填入json格式的文本 图片.png 3.5 MongoDB删除文档 命令语法: db.{}.remove({},{}),第一个大括号填入集合名,第二个大括号填入json格式的文本,用于选择被删除的文档,成对大括号内可以为空,第三个括号内为非0整数或true时,删除一条满足判断语句的文档。 图片.png 第三个括号内为0或false或者不填时,删除所有满足判断语句的文档,如下图所示。 图片.png 4.MongoDB查询文档 4.1 find()方法 从MongoDB中查询集合数据,需要使用MongoDB的find()方法。 命令语法:db.{}.find({}),第一个大括号填入集合名,第二个大括号填入json格式的文本 如下图所示,find()函数没有参数时,显示这个集合当中的所有文档;find()函数有参数,但是没有找到满足判断条件的语句时,没有打印结果 图片.png-5.4kB 使用pretty()方法可以使在命令行中的数据打印更整齐。 图片.png-6.4kB 4.2 limit()方法 图片.png-10.4kB 作业 创建数据库 school 用来存放一些班级学生信息; use school db.createCollection("students") 你要为学校下的各个年级、班级建立集合;创建集合可以是显式的,也可以是隐式的;在这路你需要显式地创建“一年级一班的”集合grade_1_1; use school db.createCollection("grades") db.createCollection("classes") db.createCollection("grade_1_1") 隐式创建“一年级二班”:grade_1_2创建的同时为“一年级二班”加入一个学生:"name": 'zhangsan', "age": '7', "sex": "0" use school db.grade_1_2.insert({name:"zhangsan",age:7,sex:0}) 因为一些特殊原因,要解散一年级二班,删除一年级二班的信息 use school school.grade_1_2.drop() 使用循环创建一年级的3个班,并随机添加 10 名学生 for(grade_index in (grade = ['grade_1_1', 'grade_1_2', 'grade_1_3'])) { for (var i = 1; i <= 10; i++) { db[grade[grade_index]].insert({ "name": "zhangsan" + i, "sex": Math.round(Math.random() * 10) % 2, "age": Math.round(Math.random() * 6) + 3, "hobby": [] }); } } 6.查看一年级二班grade_1_2中的所有学生 db.grade_1_2.find() 7.查看一年级二班grade_1_2中所有年龄是 4 岁的学生 db.grade_1_2.find({age:4}) 8.查看一年级二班grade_1_2中所有年龄大于 4 岁的学生 db.grade_1_2.find({age:{$gt:4}}) 9.查看一年级二班grade_1_2中所有年龄大于 4 岁并且小于 7 岁的学生 db.grade_1_2.find({age:{gt:4,lt:7}}) 10.查看一年级二班grade_1_2中所有年龄是 4 岁或 6 岁的学生 db.grade_1_2.find({$or:[{age:4},{age:6}]}) 11.查看一年级二班grade_1_2中所有姓名带zhangsan1的学生 db.grade_1_2.find({name:{$regex:"zhangsan1"}}) 12.查看一年级二班grade_1_2中所有姓名带zhangsan1和zhangsan2的学生 db.grade_1_2.find({$or:[{name:"zhangsan1"},{name:"zhangsan2"}]}) 13.查看一年级二班grade_1_2中所有兴趣爱好有三项的学生 db.grade_1_2.find({hobby:{$size:3}}) 14.查看一年级二班grade_1_2中所有兴趣爱好包括画画的学生 db.grade_1_2.find({hobby:"drawing"}) 15.查看一年级二班grade_1_2中所有兴趣爱好既包括画画又包括跳舞的学生 db.grade_1_2.find({hobby:{$all:{"drawing","dance"}}}) 16.查看一年级二班grade_1_2中所有兴趣爱好有三项的学生的 学生数目 db.grade_1_2.find({hobby:{$size:3}}).count() 17.查看一年级二班的第二位学生 db.grade_1_2.find().limit(1).skip(1) 18.查看一年级二班的学生,按年纪升序 db.grade_1_2.find().sort({age:1}) 19.查看一年级二班的学生,按年纪降序 db.grade_1_2.find().sort({age:-1}) 20.查看一年级二班的学生,年龄值有哪些 db.grade_1_2.distinct('age') 21.查看一年级二班的学生,兴趣覆盖范围有哪些 db.grade_1_2.distinct('hobby') 22.查看一年级二班的学生,男生(sex为 0)年龄值有哪些 db.grade_1_2.distinct('age',{'sex':0}) 23.一年级二班grade_1_2, 删除所有 4 岁的学生 db.grade_1_2.remove({age:4}) 24.一年级二班grade_1_2, 删除第一位 6 岁的学生 db.grade_1_2.remove({age:4},1) 25.一年级二班grade_1_2中,修改名为zhangsan7的学生,年龄为 8 岁,兴趣爱好为 跳舞和画画; db.grade_1_2.update({name:"zhangsan7"},{$set:{age:8,hobby:["dance","drawing"]}}) 26.一年级二班grade_1_2中,追加zhangsan7学生兴趣爱好唱歌; db.grade_1_2.update({name:"zhangsan7"},{$push:{hobby:"sing"}}) 27.一年级二班grade_1_2中,追加zhangsan7学生兴趣爱好吹牛和打篮球; db.grade_1_2.update({"name": "zhangsan7"},{$push: {"hobby": {$each: ["brag","basketball"]}}}) 28.一年级二班grade_1_2中,追加zhangsan7学生兴趣爱好唱歌和打篮球,要保证hobby数组不重复; db.grade_1_2.update({"name": "zhangsan7"},{$addToSet: {"hobby": {$each: ["sing","basketball"]}}}) 29.新学年,给一年级二班所有学生的年龄都增加一岁 db.grade_1_2.update({},{$inc:{"age":1}},{multi:true}) 30.一年级二班grade_1_2中,删除zhangsan7学生的sex属性 db.grade_1_2.update({name:"zhangsan7"},{$unset:{sex:1}}) 31.一年级二班grade_1_2中,删除zhangsan7学生的hobby数组中的头元素 db.grade_1_2.update({name:"zhangsan7"},{$pop:{hobby:-1}}) 32.一年级二班grade_1_2中,删除zhangsan7学生的hobby数组中的尾元素 db.grade_1_2.update({name:"zhangsan7"},{$pop:{hobby:1}}) 33.一年级二班grade_1_2中,删除zhangsan7学生的hobby数组中的sing元素 db.grade_1_2.update({name:"zhangsan7"},{$pull:{hobby:"sing"}})

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册