首页 文章 精选 留言 我的

精选列表

搜索[PWA技术],共10007篇文章
优秀的个人博客,低调大师

Docker技术及其使用

基本概念 Docker镜像(image) Docker 镜像就是一个只读的模板。镜像可以用来创建 Docker 容器。Docker 提供了一个很简单的机制来创建镜像或者更新现有的镜像,用户甚至可以直接从其他人那里下载一个已经做好的镜像来直接使用 Docker容器(container) Docker 利用容器来运行应用。容器是从镜像创建的运行实例。它可以被启动、开始、停止、删除。每个容器都是相互隔离的,保证安全的平台。 Docker仓库(repository) 仓库是集中存放镜像文件的场所。有时候把仓库和仓库注册服务器( Registry )混为一谈,并不严格区分。实际上,仓库注册服务器上往往存放着多个仓库,每个仓库中又包含了多个镜像,每个镜像有不同的标签 (tag) 。仓库分为公开仓库 (Public) 和私有仓库 (Private) 两种形式。最大的公开仓库是 Docker Hub ,存放了数量庞大的镜像供用户下载。国内的公开仓库包括 Docker Pool 等,可以提供大陆用户更稳定快读的访问。当用户创建了自己的镜像之后就可以使用 push 命令将它上传到公有或者私有仓库,这样下载在另外一台机器上使用这个镜像时候,只需需要从仓库上 pull 下来就可以了。额概念。 基本的Docker命令 Docker的安装 sudo apt install docker.io Docker启动及状态查询 sudo service docker start sudo service docker status 查看Docker的版本 sudo docker version 查看本地镜像 sudo docker images 下载镜像文件 sudo docker pull ubuntu 运行Ubuntu镜像 docker run -i -t ubuntu /bin/bash 删除镜像文件 sudo docker rmi -f hello-world 查看已经启动的Docker服务(容器) sudo docker ps –a 停止docker服务 sudo docker stop image-name 登陆Docker sudo docker login https://hub.docker.com/ 保存修改后的Docker容器 docker commit [OPTIONS] CONTAINER [REPOSITORY[:TAG]] OPTIONS说明: -a :提交的镜像作者; -c :使用Dockerfile指令来创建镜像; -m :提交时的说明文字; -p :在commit时,将容器暂停 docker可以支持把一个宿主机上的目录挂载到镜像里 docker run -it -v /home/dock/Downloads:/usr/Downloads ubuntu64 /bin/bash docker run -it -v /home/dock/Downloads:/usr/Downloads ubuntu64 /bin/bash Docker容器的删除 docker rm CONTAINER ID Docker镜像的删除 docker rmi Docker容器启动start/stop/restart docker start/stop/restart docker start命令使用-i选项来开启交互模式 查询镜像和容器的详细信息 docker inspect docker info 连接正在运行的容器 docker attach CONTAINER ID/name 退出容器不关闭 ctrl + d 退出关闭容器, ctrl + p + q 退出容器不关闭 Docker的Ubuntu镜像安装的容器无ifconfig命令和ping命令 解决: apt-get update apt install net-tools # ifconfig apt install iputils-ping # ping docker Ubuntu安装mysql apt-get update apt-get install -y mysql-server mysql-client Docker容器和主机文件拷贝 1)从容器内拷贝文件到主机上 docker cp <containerId>:/file/path/within/container /host/path/target 2)从主机内拷贝文件到容器上 sudo docker cp host_path containerID:container_path 3)问题 FATA[0000] Error: Path not specified Version 1.6.2 doesn't allow copying from host to container, you need to upgrade to at least 1.8 for that support docker版本升级 1)、Docker源安装指定版本: sudo apt-get install apt-transport-https sudo apt-key adv --keyserver hkp://keyserver.ubuntu.com:80 --recv-keys 36A1D7869245C8950F966E92D8576A8BA88D21E9 sudo bash -c "echo deb https://get.docker.io/ubuntu docker main >/etc/apt/sources.list.d/docker.list" sudo apt-get update --更新软件源 sudo apt-cache search docker --查找需要更新的docker版本 sudo apt-get install lxc-docker-1.9.1 2)错误的解决 docker安装完成后执行sudo service docker start,提示错误:Failed to start docker.service: Unit docker.service is masked. 解决方案: systemctl unmask docker.service systemctl unmask docker.socket systemctl start docker.service docker 容器备份 1)生成docker镜像 docker commit -p 30b8f18f20b4 container-backup 2)我们想要在Docker注册中心上传或备份镜像,我们只需要运行 docker login 命令来登录进Docker注册中心,然后推送所需的镜像即可 (1)docker login (2)docker tag a25ddfec4d2a arunpyasi/container-backup:test (3)docker push arunpyasi/container-backup 3)如果我们不想备份到docker注册中心,而是想要将此镜像保存在本地机器中,以供日后使用,那么我们可以将其作为tar包备份。要完成该操作,我们需要运行以下 docker save 命令。 docker save -o ~/container-backup.tar container-backup tar -zcvf ubuntu2-backup.tar.gz container-backup.ta docker 恢复容器 1)在我们成功备份了我们的Docker容器后,我们现在来恢复这些制作了Docker镜像快照的容器。如果我们已经在注册中心推送了这些Docker镜像,那么我们仅仅需要把那个Docker镜像拖回并直接运行即可。 docker pull arunpyasi/container-backup:test 2)如果我们将这些Docker镜像作为tar包文件备份到了本地,那么我们只要使用 docker load 命令,后面加上tar包的备份路径,就可以加载该Docker镜像了。 tar -zxvf ubuntu2-backup.tar.gz docker load -i ~/container-backup.tar 3)使用docker image查看 extc 命令 使用attach命令经常会卡段,可以使用exec命令替代 docker exec -it ubuntu /bin/bash 上面用attach进入的用exit会退出容器必须用ctrl P Q退出才能继续后台运行,exec的 用exit也不会真正退出容器继续后台运行 用name或id都可以 常用命令 docker run --name ubuntu -it ubuntu:16.04 /bin/bash docker exec -it 96740370a5da /bin/bash

优秀的个人博客,低调大师

Python 技术百问

如何让用户保持登录状态https://yq.aliyun.com/ask/495120 如何迭代Pandas Dataframe中的行https://yq.aliyun.com/ask/495119 如何在Python中查找或删除列表中的子串列表https://yq.aliyun.com/ask/495117 无法创建文件notepad txt utf-8https://yq.aliyun.com/ask/495113 在数据框中查找值并在相应列中交叉引用值https://yq.aliyun.com/ask/495109 (Django)我们如何将单选按钮值存储到数据库中https://yq.aliyun.com/ask/495108 Python:如何检查两个字符串的匹配字符数?https://yq.aliyun.com/ask/49510

优秀的个人博客,低调大师

blink测试技术介绍

引言: flink是面向数据流处理和批处理的分布式开源计算框架。2016年阿里巴巴引入flink框架,改造为blink,将其运用到搜索及推荐的离线实时计算中,成功解决了搜索、推荐实时大数据量计算的痛点。2017年5月,集团整合了所有流计算产品,决定以blink引擎为基础,打造一款全球领先的实时计算引擎。2017年的双11,blink支持了20多个事业部/群,同时运行了1100+实时计算job,每秒处理的日志数峰值达到惊人的4.7亿。集团内部Blink用户群已经超过1400+的开发同学。因此blink质量保障变得极其重要,blink测试团队成立一年多的时间,从无到有,逐步建立起完整的blink测试体系,全方位保障blink质量。 Blink测试平台介绍 blink测试团队为blink质量量身打造blink测试平台,内容如下图所示:

优秀的个人博客,低调大师

技术分享连载(十三)

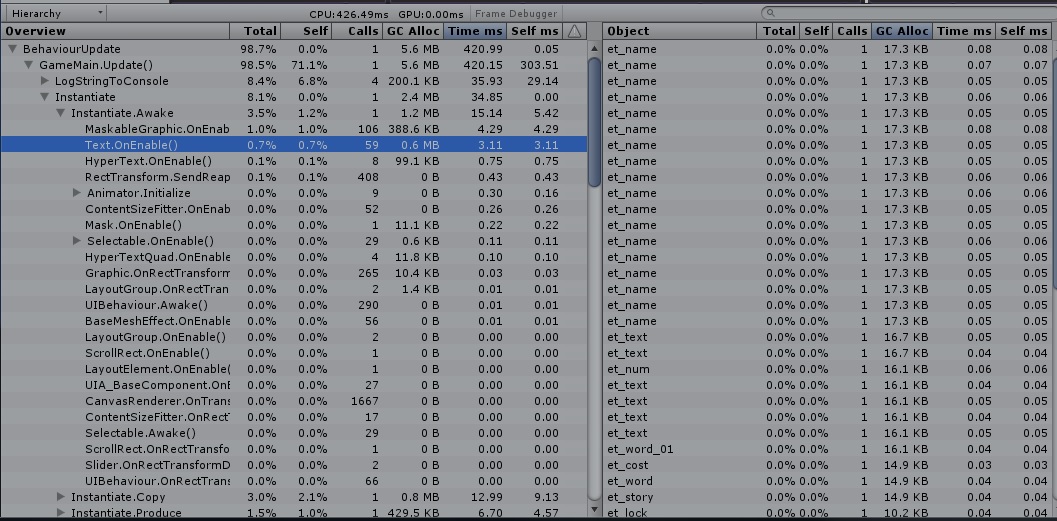
资源管理 Q1: 请问粒子特效的Shader是否不能使用依赖打包? 我们对Shader的模型和特效使用了依赖打包,运行的时候发现模型显示是正常的,但是粒子特效使用的Shader就不能正常运行,特效显示不正常。而在编辑器中,我们看到Material中的Shader是存在的。这时候如果重新手动给这个Material指定同样的Shader,这个粒子特效就能正常显示,请问这是什么原因引起的? 部分 Shader 在打包到 Android 版本的 Assetbundle 之后,会因为平台不兼容而无法正确显示,这是因为打包后的 Shader 代码只保留了目标平台的预编译代码,不一定能够在 Editor 下运行,所以这是正常现象。 但这并不会影响依赖打包,因为在真机上并不会出现类似的问题。 性能优化 Q2:如图,我们在UI打开或者移动到某处的时候经常会观测到CPU上的冲激,经过进一步观察发现是因为Instantiate产生了大量的GC。想请问下Instantiate是否应该产生GC呢?我们能否通过资源制作上的调整来避免这样的GC呢?如下图,因为一次性产生若干MB的GC在直观感受上还是很可观的。 准确的说这些 GC Alloc 并不是由Instantiate 直接引起的,而是因为被实例化出来的组件会进行 OnEnable 操作,而在 OnEnable 操作中产生了 GC,比如以上图中的函数为例: 上图中的 Text.OnEnable 是在实例化一个 UI 界面时,UI 中的文本(即 Text 组件)进行了 OnEnable 操作,其中主要是初始化文本网格的信息(每个文字所在的网格顶点,UV,顶点色等等属性),而这些信息都是储存在数组中(即堆内存中),所以文本越多,堆内存开销越大。但这是不可避免的,只能尽量减少出现次数。 因此,我们不建议通过 Instantiate/Destroy 来处理切换频繁的 UI 界面,而是通过 SetActive(true/false),甚至是直接移动 UI 的方式,以避免反复地造成堆内存开销。 资源管理 Q3: iOS平台需要对图集做RGB和Alpha通道的分离吗?我发现在同样大小的图片(正方形),RGB Compressed PVRTC 4bits和RGBA Compressed PVRTC 4bits两种格式,占用内存是一样的,如果把一张图片分成两张,那么在iOS平台是不是占用内存多一倍?有透明通道的,对于它的图集怎么处理会更好一点? 通常iOS下是不需要做通道分离的,因为 iOS 通用的 PVRTC 格式支持 Alpha 通道。但目前也有团队反馈,在 iOS 上进行通道分离有助于减少失真,可以在一定程度上提高视觉效果,因此也可以尝试做一个对比。 如果发现占用内存是一样的,那么原始图片是RGB的。如果iOS上做通道分离,内存确实会增加一倍。UI的纹理在iOS下可以直接选择默认的 Compress,在打Atlas时会自动处理成 PVRTC,开发团队可以从Sprite packer窗口来看Atlas的压缩格式做个确认。 性能优化 Q4: 关于场景中玩家和NPC名字的DrawCall的问题。我们项目中是使用TextMesh挂到场景单位上,但是这样每个名字就占了一个DrawCall,请问有没有好的办法优化呢? 游戏中的HUD的做法一般有两种,一种是如上的做法,另一种则是通过NGUI/UGUI来制作HUD。第二种的实现方法大致如下: (1)计算屏幕中角色在屏幕中的位置; (2)根据屏幕中的位置来计算各自HUD的位置,并根据HUD的数量分别放置在一个或几个Panel/Canvas下。 第二种方法的优势是尽可能用少的Draw Call数来渲染角色的HUD。开发团队可以就该方法来进行尝试。 性能优化 Q5: 我们能通过Batching来进行效能方面的优化吗?透过粒子发射出来的半透明模型片是无法Saved by Batching ,如果粒子可以使用Dynamic Batching的话,想请教具体的使用规则与方法。 根据Unity 官方的信息,目前粒子系统已经不再进行 Draw Call 的拼合,因为在新版本5.3 中已通过多线程进行更新,暂时无法支持拼合,但性能已经得到提升。 原文出处:侑虎科技 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

优秀的个人博客,低调大师

技术分享连载(五)

UI Q1:能否在NGUI多分辨率适应方面提供一些解决方案或者思路? 多分辨率适应涉及到以下几个方面: 布局。通常可以通过 NGUI 中的 Anchor 组件来实现,能够保证 UI 到屏幕上指定锚点的距离; UI 背景图比例。通常我们建议将背景图的长宽比放大,以适配不同长宽比的屏幕,但要注意两边需要留空,或者保留可被裁掉的元素; UI 的整体缩放。可以通过 UIRoot 组件的 Scaling Style 来统一配置。 需要提醒的是,不同类型的游戏对布局的需求通常也不同,因此还是需要结合实际开发情况来做调整。 图形渲染 Q2:请问Unity引擎中使用什么贴图压缩格式,可以保证在占用内存相对较小的情况下True Color效果和原图相当?同时在iOS和Android平台上图片的压缩格式分别用什么比较合适?有什么需要注意的地方吗? 目前来讲,并不存在一个所有GPU平台都支持硬件解压的压缩格式。 ETC1 和 PVRTC 分别是Android和iOS上我们最推荐的格式。 但对于透明纹理,ETC1不支持,而 PVRTC 则可能有较大失真,因此更推荐使用 RGBA 16。 一般来说建议直接使用 Unity 默认的压缩格式(即选择 Compressed 即可,不需要做特殊设置),Unity 会做如下处理: Android 上不带Alpha通道的图片采用 ETC1,带Alpha通道的图片采用True Color中的RGB16,TrueColor中的 RGBA16 会>比 RGBA32 更节省空间,但图像的显示质量会差一些; iOS 上使用 PVRTC,但PVRTC格式要求纹理的长宽相等,且都是2的幂次(即POT,在ImportSettings中可以将NPOT的纹理自动转换成POT)。 另外,针对Android 上的带Alpha通道的图片,还有一种常见的做法,即把Alpha通道独立出来作为另一张纹理,从而将 RGB 部分和 Alpha 部分分别采用 ETC1来压缩,但渲染时就需要自定义的 Shader来处理。 同时,我们不建议直接使用 RGBA32 格式的纹理,因为它占用了很大的内存。一般建议使用 RGBA16 和 ETC 格式的纹理来进行加载。 如果转换到 RGBA16 格式时出现了类似“色阶”的颜色问题,则建议尽可能避免大量的过渡色使用。 内存管理 Q3:在UWA的帮助下,我们追踪到了一个Reserved GFX的内存占用,并且显示比较高。我们应当如何降低该内存占用呢? 一般来说,Reserved GFX 中的内存,主要是纹理和网格资源,可以尝试对纹理格式进行检测,尽可能使用硬件支持的压缩纹理;而对于网格资源,则可以从减少顶点或者顶点属性入手。 具体信息也可以查看UWA文档。 另外,更重要的是检测纹理和网格资源是否存在冗余(多份一样的资源)或者泄露(比如,主城中的大纹理出现在战斗场景中),这是需要极力避免的。关于资源冗余、内存泄露,开发者可以参考我们之前的文章《 性能优化,进无止境---内存篇(下)》。 资源管理 Q4:请问游戏中特效使用的很多贴图, 一般有什么好的方式去管理吗 ? 不合并图集的话会有上千张小的透明贴图, 合并图集又会有占用内存过多的问题。 可以合并成Atlas,一般将尽可能同时出现频率较高的Texture合成Atlas,这样并不会造成内存过大。在这方面也可以参考我们前不久推荐的插件Mesh Baker。 图形渲染 Q5: 在Unity开发中,大规模使用粒子特效会有什么问题 ?如何去针对性的优化? 普遍来说,会造成Draw call高、渲染开销大、CPU高等问题。下图就是UWA性能诊断系统对粒子系统检测的几个注意点。 原文出处:侑虎科技 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

优秀的个人博客,低调大师

技术分享连载(三)

内存管理 Q1:如图,在Editor中查看Profiler里的内存详细信息,发现Used Total中有个“Unity”,请问是什么意思?为什么会特别大? 在Editor中运行时,“Unity”大是正常的,因为在Editor中运行项目时,引擎包含了所有的资源占用的内存(除了部分纹理和Mesh是在GFX中),同时自身会进行很多的辅助操作来记录各种游戏运行信息。一般来说,在查看游戏运行时的真实消耗内存,我们均是推荐直接在发布游戏上通过Profiler进行查看,在Editor中运行游戏所看到的内存是要大很多的。 内存管理 Q2: 在进行内存优化时,Unity Profiler给出的数据和Android系统(adb dumpsys meminfo,已经考虑memtrack的影响 )的数据差距较大(已经分析了Profiler自身的内存占用),如何分析这部分差异,比如包括对显存消耗进行准确统计,OS消耗的统计等等? 内存差异较大是正常的,一般来说,Profiler统计的内存较为一致,而Android系统通过ADB反馈的PSS、Private Dirty等值则是差别很大。这主要是因为芯片和OS的不同而导致。具体的Android内存,建议直接查看Google Android OS的相关文档。 Unity Profiler反馈的则是引擎的真实物理使用内存,一般我们都建议通过Profiler来查看内存是否存在冗余、泄露等问题。 资源管理 Q3:iOS上PVRTC不支持NPOT的贴图压缩,在Android上可以用ETC2,但在iOS上不能压缩,内存消耗大。请问在iOS上有没有好的处理方案? ETC2仅能在支持OpenGL ES3.0的手机上进行使用,请研发团队在使用前谨慎考察支持ES3.0的手机在国内的覆盖范围。 PVRTC不支持NPOT的贴图压缩,这是Apple规定的,上层应用无权对此更改。我们仅能建议将纹理尽可能做成POT形式,否则只能接受内存较大的开销,没有其他更好的办法。 资源加载 Q4:怎样动态加载Navmesh? 目前Navmesh不支持动态加载,只能随场景一起加载, 因此可以考虑将带有Navmesh的场景打包成AssetBundle,然后使用LoadLevel加载AssetBundle中的场景。 Navmesh的动态加载已经在Unity的Roadmap中。而当前,Navmesh是和场景绑定的,也就是说目前只能通过LoadLevel(不支持LoadLevelAdditive的加载方式)来加载场景的同时,自动加载对应的Navmesh数据。替代方案是:将多个“场景Prefab”的Navmesh 合并到同一个场景中烘焙好(互不重叠),然后再将这些“场景Prefab”分离到各个单独的场景中去;在运行阶段,Navmesh随着第一个场景一次性加载,而对于其他的场景物件,再通过LoadLevelAdditive来加载对应的场景即可。缺点是为了使场景物件对齐Navmesh,在场景制作时就不能出现坐标上的重叠,因此仅供参考。 在Unity 5.x下,Lightmap的动态加载,需要通过脚本将烘焙时每个物件的Lightmapindex和Lightmapscaleoffset记录下,并在运行时动态加载后设置回去的方式来实现。因为目前Lightmapindex和Lightmapscaleoffset信息是和场景绑定在一起,储存在Lightmapsnap.assets 中,发布时也是放在场景信息中,因此不会记录在Prefab 上。 图形渲染 Q5:当关闭预渲染GI时会出现IndirectResolution,这个参数有什么用,为什么调大了以后会大大增加渲染时间,但是烘培出来却没有什么效果。 该值主要控制的是GI的烘焙密度,数值越大,表示每个单位距离内的Texel越多,即烘焙得越精致,自然烘焙的时间也越长。 该值并非越大越好,场景越小建议该值越低。该值为1时,对于多数场景,其烘焙效果已经足够了,升高该值,其效果也不会有明显提升。 原文出处:侑虎科技 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

优秀的个人博客,低调大师

技术分享连载(十五)

图形渲染 Q1:以前端游时代,材质根据Pass不同、光照环境不同可以离线预编译成ShaderCache,运行时并不需要拼材质再实时编译,只要加载二进制代码就好了。那Unity有没有做这件事呢?我们是根据平台和环境预编译的Shader。 对于支持 Binary Shader 加载的设备,在首次编译某个 Shader 的时候是会生成其对应的 Binary Shader Cache ,生成的 Binary 文件位于和 Application.persistantPath 并列的Cache 目录下。 图形渲染 Q2:相同效果前提下,就性能而言,Shader 是用 V&F 还是Surface好? Surface生成的V&F比较庞杂,分支较多,如果不注意 #pragma surface 参数的选择,容易出现不必要的开销。举例来说,如果直接用 Unity 5.x 中默认创建的 Surface Shader (默认参数为 #pragma surface surf Standard fullforwardshadows),那么 Shader 是会做 Physically based Standard Lighting 的,而这在移动端开销非常大,且并非必要。 图形渲染 Q3:Lightmap在Baked GI的等待时间比较长(Realtime GI已关闭),想请教有没有什么建议的参数或是方式,可以缩短等待的时间? 目前就我们的了解,在Unity 5.x比较影响烘焙时间的主要是大面积的面片导致Light Transport 过程过久(Enlighten 的机制所限)。可以尝试拆分面积较大的面片,来提高烘焙的速度(通常,拆分大面积的面片对渲染性能也会有所提升)。 主要原因可参考如下的帖子: http://forum.unity3d.com/threads/light-transport-problem-with-large-objects.310405 资源管理 Q4:Prefab中的GameObject的tag设置为EditorOnly仍然会被打进Resoures包吗?有其它EditorOnly方案吗? EditorOnly理论上只对场景中的 GameObject起效。因此 Project 目录中的 Prefab 打上 EditorOnly 后,放在 Resources 目录下依然会被打进游戏包中。但只要将其放在 Resources 目录以外,则其就会因为没有场景中的物件引用而被排除在外。 内存管理 Q5:对于Handheld.PlayFullScreenMovie 这个Unity播放开场动画的API,会有内存问题吗?比如我的mp4动画有20MB,那么这个动画会撑高mono堆内存吗? Android上PlayFullScreenMovie 的实现实际上是通过Android原生的接口直接播放的,播放过程中Unity也是停止更新的,因此这部分的内存理论上并不会记录在 Unity 中,同样也不影响mono。 原文出处:侑虎科技 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

优秀的个人博客,低调大师

技术分享连载(九十)

内存 Q1:我们发现刚进入游戏,Dalvik Heap的内存很高,导致PSS比较高,切到后台,再切回游戏,Dalvik Heap内存减少非常多。然后我尝试使用网上说的Android调用GC的方式,System.GC,结合runFinalization。调用Runtime.getRuntime().gc(),都无法有效减少,不知道这块是否有办法有效调用一次? 我们查到原因了,是因为我们在Android层写了一个splash,但这个splash是png的,分辨率是1920x1080,我们之前是 int splash_bg = getResources().getIdentifier(bgName, “drawable”, getPackageName()); m_BgView.setBackgroundResource(splash_bg); 这张图片在HideSplash会被处于游离状态,要等Java的GC调用后,才会回收,但实际图片按道理内存也不该涨100MB左右,我们用测试工程只有Splash和SplashVideo,发现内存并不会增长那么多,代码一模一样。后面只能解释,可能JVM后某种内存分配算法造成的,当本来比较低的情况,分配会比较少,当到达一定数量级,再分配,就会分配更大一块内存(对Android底层机制不熟) 后面我们改为先从getResources里获得BITMAP,然后给ImageView,再HideSplash时候,调用Bitmap的手动释放方法。 该问题来自UWA问答社区,感谢题主在解决后将其方法分享公开,如您对该问题仍有疑问,可以转至社区进行进一步交流。 https://answer.uwa4d.com/question/5a2a04c27030070236a983f5 制作 Q2:我有一个MeshRenderer,它拥有两个材质,现在我想给其设置一个不同的MaterialPropertyBlocks,但据我所知,目前还没有能实现这样的办法,因为当我从Renderer中得到MaterialPropertyBlock后,我是不能指定它还能应用于某个材质了是吧?不知道大家有没有好的解决方法呢? 是的,MaterialPropertyBlocks是以MeshRenderer为单位的,而不是以Material为单位的。只能建议题主对Mesh进行拆分,确保每个Renderer上只挂一个Material。 该问题来自UWA问答社区,如您对该问题仍有疑问,可以转至社区进行进一步交流。 https://answer.uwa4d.com/question/5a263f54d99fdb2b3c628873 性能 最近项目从Unity 4 升级到Unity 5或Unity 2017时,在中低端Android机上,帧率降了10多帧,用Adreno Profiler上查了是GPU Bound。 我们游戏对帧率要求比较高, 游戏的时候必须满帧运行, 所以这个问题很明显。经过折腾,最后查出来是Unity 5 之后, 默认开启了Blit, 分辨率越高,GPU压力越大。 尤其在中低端机上,我用的是Adreno 405测试的, Unity 4能满帧, 但Unity 5或者Unity 2017最高才45左右, 简直不能忍。幸运的是,Unity 2017.2,官方终于开放了设置能禁止Blit. 但是Unity 5就没这个运气了, 根据官方的消息,他们暂时还没有计划把这个引入Unity 5.6, 具体帖子可见:https://forum.unity.com/threads/big-performance-issue-with-unity5-on-android.338847 在发现和解决问题的过程中,钱康来同学提供了不少帮助,在此感谢!开这个问题也是让大家知道下,免得像我当初摸石头过河,花太多时间折腾。 该问题来自UWA问答社区,感谢题主的无私分享,建议使用Unity 2017 或者Unity 5 版本的开发者密切注意!如您对该问题仍有疑问,可以转至社区进行进一步交流。 https://answer.uwa4d.com/question/5a282669a670486845f8a03d 内存 Q3:这个[Triggers RebuildInternalState]是隐藏物体就一定会触发的吗?我看Profiler里最后一列都有提示Warning,感觉挺重要的一个错误。这个要怎么去避免呢,是否会导致Animator.Initialize耗时又变得很明显(在之前有做过缓存的情况下) 这个是含有Animation组件的GameObject被Deactive时的引擎Warning,在很多情况下确实会造成较高的CPU耗时。对此,建议题主尝试在GameObject不再需要使用时,直接将其移出屏幕外,并将其挂载的Component进行Disable,而非将其GameObject进行Deactive,这样可以RebuildInternalState的发生。 该问题来自UWA问答社区,如您对该问题仍有疑问,可以转至社区进行进一步交流。 https://answer.uwa4d.com/question/5a2a62cdff95f1253a1b365e Unreal 4 渲染 Q4:你好 我看了UWA关于Unreal全局光照的那篇文章,有几点疑问想问下: 1、Unity的Lightmap烘焙时,为什么不能从Normal map获取Normal信息呢?我看Unreal的Lightmass也是烘焙出两张图,一张方向一张颜色。它的颜色可以受NormalMap的影响吗? 2、Unreal的一个场景多张Lightmap,例如白天到晚上,渐变是怎么融合的呢? 1、Lightmap中的Directional信息是指烘焙光照的方向信息。在Lightmap中一张是记录光照的Intensity,一张是记录Direcitonal,这个Directional是用来参与Shading中方向相关计算的,例如:高光计算、与normal计算等。如果是纯Dffuse材质也不用Normalmap,这个Directional信息可以去掉,减少存储和计算量。通常在材质中看到的Normalmap指的是Mesh的Normal与Lightmap中记录的Directional并不是同一个值。 2、Unreal中的Precomputed Lighting Scenarios是保存了多套Lightmap以及光照设置,只能做到配合光照进行Lightmap切换,融合现在貌似还做不到。 Q5:烘焙的时候光照的Intensity考虑Normal就类似beast那样,Lightmass烘焙的时候可以提供Normalmap吗? 我是这样理解的:Unity烘焙的时候用了辐射度,也就是先把模型分成块,然后计算快与块之间的反射,不会使用Normalmap。Normalmap提供的是细节的信息,全局光照中间接光的计算结果相对比较低频,比较平滑,加入高频的信息不一定会有好的效果。Unreal 4的lightmass可以有一个选项设置Static类型的光源在烘焙的时候使用normal map,其设在project settings->engine rendering->lighting中。 原文出处:侑虎科技 本文作者:admin 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册