首页 文章 精选 留言 我的

精选列表

搜索[自然语言处理],共10009篇文章
优秀的个人博客,低调大师

Jcseg 2.6.2 发布 - Java轻量级开源自然语言处理包

Jcseg是基于mmseg算法的一个轻量级中文分词器,同时集成了关键字提取,关键短语提取,关键句子提取和文章自动摘要等功能,并且提供了一个基于Jetty的web服务器,方便各大语言直接http调用,同时提供了最新版本的lucene,solr和elasticsearch的分词接口! Jcseg 2.6.2版本主要功能都是为Gitee的搜索设计的,体验可以搓:https://search.gitee.com/?skin=rec&type=repository&q=%E5%88%86%E8%AF%8D 2.6.2版本主要更新内容如下: 1,升级到对lucene 8.20,solr 8.2.0和Elasticsearch的7.4.2版本的支持,Gitee搜索目前用的Elasticseach 7.4.2版本。 2,增加solr和elasticsearch索引级别的分词配置,可以不同索引使用不同的分词配置,具体可以参考Gitee搜索资源分享中的mapping:https://gitee.com/oschina/gitee-search-share。 3,部分已有词库的优化,拼音,词性,同义词等。 4,二次切分优化,增加中英混合词的的二次切分支持。 5,增加n-gram切分模式,可以自定义n,实现n-gram的切分,例如:”中文分词“ 1-gram会被切分成”中 文 分 词“,此功能在Gitee的搜索提示中用到了。 6,增加英文词条的切分,大部分的分词器对于英文都只是通过空格或者标点来切分,这个版本jcseg增加了对英文的切分,同时也是通过mmseg算法来去除歧义,例如: 英文组合词条: jcseg~tokenizer:complex>> openarkcompiler 分词结果: open[0,4]/n ark[4,3]/n compiler[7,8]/n Done, total:15, tokens:3, in 0.00000sec 例如Gitee搜索”openark“:https://search.gitee.com/?q=openark&skin=rec&type=repository 拼音组合词条: jcseg~tokenizer:complex>> guanyuwomen 分词结果: guanyu[0,6]/p women[6,5]/n Done, total:11, tokens:2, in 0.00105sec 例如:Gitee搜索"中文huancunxitong":https://search.gitee.com/?q=huancunxitong&skin=rec&type=repository 7,增加英文词库和拼音词库,用于支撑上述的英文切分,这个英文也包括拼音的切分,例如:Gitee搜索的拼音和汉语相互搜索: 搜索”fenci“:https://search.gitee.com/?q=fenci&skin=rec&type=repository 搜索”分词“:https://search.gitee.com/?q=%E5%88%86%E8%AF%8D&skin=rec&type=repository 搜索”中文分词“:https://search.gitee.com/?q=%E4%B8%AD%E6%96%87%E5%88%86%E8%AF%8D&skin=rec&type=repository 搜索”中文fenci“:https://search.gitee.com/?q=%E4%B8%AD%E6%96%87fenci&skin=rec&type=repository 8,同义词优化,同义词词库和offset逻辑无缝对接lucene的increasement设计,便于实现同义词的检索和高亮,例如:Gitee搜索的同义词效果如下: 搜索”中文分词“:https://search.gitee.com/?q=%E4%B8%AD%E6%96%87%E5%88%86%E8%AF%8D&skin=rec&type=repository 搜索”汉语分词“:https://search.gitee.com/?q=%E6%B1%89%E8%AF%AD%E5%88%86%E8%AF%8D&skin=rec&type=repository 搜索”普通话分词“:https://search.gitee.com/?q=%E6%99%AE%E9%80%9A%E8%AF%9D%E5%88%86%E8%AF%8D&skin=rec&type=repository 9,更改了Jcseg的API设计,使用函数接口来代替部分的class查找,使用更方便,API变更为如下: //创建SegmenterConfig分词配置实例,自动查找加载jcseg.properties配置项来初始化 SegmenterConfig config = new SegmenterConfig(true); //创建默认单例词库实现,并且按照config配置加载词库 ADictionary dic = DictionaryFactory.createSingletonDictionary(config); //依据给定的ADictionary和SegmenterConfig来创建ISegment //为了Api往后兼容,建议使用SegmentFactory来创建ISegment对象 ISegment seg = ISegment.COMPLEX.factory.create(config, dic); //备注:以下代码可以反复调用,seg为非线程安全 //设置要被分词的文本 String str = "研究生命起源。"; seg.reset(new StringReader(str)); //获取分词结果 IWord word = null; while ( (word = seg.next()) != null ) { System.out.println(word.getValue()); } 10,BUG修复: 英文切分的offset问题:https://gitee.com/lionsoul/jcseg/issues/I19IQ4 NLP日期实体识别问题:https://gitee.com/lionsoul/jcseg/issues/I17DMS maven仓库(中央仓库同步中...): <dependency> <groupId>org.lionsoul</groupId> <artifactId>jcseg-core</artifactId> <version>2.6.2</version> </dependency> 下载地址: Gitee:https://gitee.com/lionsoul/jcseg/tree/v2.6.2-release Github:https://github.com/lionsoul2014/jcseg/releases/tag/v2.6.2-release
优秀的个人博客,低调大师

Jcseg 2.5.0 发布,Java 轻量级开源自然语言处理包

Jcseg是基于mmseg算法的一个轻量级中文分词器,同时集成了关键字提取,关键短语提取,关键句子提取和文章自动摘要等功能,并且提供了一个基于Jetty的web服务器,方便各大语言直接http调用,同时提供了最新版本的lucene,solr和elasticsearch的分词接口! Jcseg 2.5.0更新如下: 1,修复NLP模式下部分“第xx”实体识别的position错误的bug (Reported by https://gitee.com/lionsoul/jcseg/issues/I10FKC)。 2,修复elasticsearch插件的词库autoload的bug(Reported by https://gitee.com/lionsoul/jcseg/issues/IWT2P)。 3,对于全部的切分模式增加同义词自动词性继承。 4,增加elasticsearch 7.2.0支持和lucene, solr 8.0.0支持 (Reported by https://gitee.com/lionsoul/jcseg/issues/IZ7GS)。 5,lucene,solr,elasticsearch检索同义词解决方案与Jcseg同义词方案结合。 6,修复了lucene以及其扩展产品Elasticsearch, solr等同义词以及派生词 (例如,中文数字转阿拉伯数字)的高亮的bug。 这个问题打Jcseg增加同义词以来一直都有的问题,issue中被提了很多次,感谢以下的issue和信息提供者,已经测试OK了: https://gitee.com/lionsoul/jcseg/issues/IM8GD https://gitee.com/lionsoul/jcseg/issues/IMBLD https://gitee.com/lionsoul/jcseg/issues/IRLA2 https://gitee.com/lionsoul/jcseg/issues/IRLA2 https://gitee.com/lionsoul/jcseg/issues/IXA40 https://gitee.com/lionsoul/jcseg/issues/I11505 https://github.com/lionsoul2014/jcseg/issues/46 7,jccseg-server更改jetty版本号为:9.4.18.v20190429。 8,词条格式调整为:“词条/词性集合/拼音/实体集合/自定义参数”。 9,少量词库优化 。 下载地址: Gitee:https://gitee.com/lionsoul/jcseg/tree/v2.5.0-release Github:https://github.com/lionsoul2014/jcseg/releases/tag/v2.5.0-release Maven仓库地址: <dependency> <groupId>org.lionsoul</groupId> <artifactId>jcseg-core</artifactId> <version>2.5.0</version> </dependency>

优秀的个人博客,低调大师

自然语言处理工具HanLP-基于层叠HMM地名识别

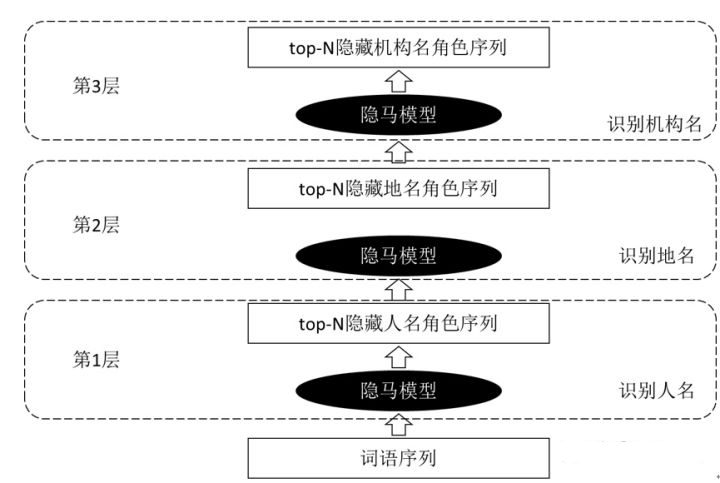
本篇接上一篇内容《HanLP-基于HMM-Viterbi的人名识别原理介绍》介绍一下层叠隐马的原理。首先说一下上一篇介绍的人名识别效果对比: 只有Jieba识别出的人名准确率极低,基本为地名或复杂地名组成部分或复杂机构名组成部分。举例如下: [1] 战乱的阿富汗地区,qiang zhi可随意买卖,AK47价格约500人民币“阿富汗”被识别为人名。[2] 安庆到桂林自驾游如何规划?“桂林”被识别为人名。[3] 2018天津市和平分局招聘社区戒毒、社区康复工作人员成绩查询入口“康复”被识别为人名。 只有HanLP识别出的人名除了特别常用姓氏的名字识别正确,其他的都识别错误。举例如下: [1] 纳溪区副区长李明带队到“花田酒地”景区检查节前安全工作“花田酒”被被识别为人名。[2] 秀英“线上线下”齐发力 助力贫困户“微互动”拓宽农产品销路“齐发力”被识别为人名。[3] 紧急通知:秦报融媒粉团祖山一日游日报名费大调整!“秦报”被识别为人名。 HanLP与Jieba都识别出的人名 非常用姓氏识别出的人名基本错误。[1] 房产高管薪酬大起底 万科郁亮年薪1189.9万仅排第二 [2] 生生不息 南通支云发布汶川地震十周年海报呼吁赛前默哀[3] 为什么伊郎不能有he wu qi,而美国有he wu qi? 名字本身构成词时基本错误。[1] 周口一村庄杨絮着火,对付杨絮用啥方法好呢? [2] 上联: 三国魏蜀吴,如何对下联?[3] 上联:灯火辉煌万家乐。求下联? 如何解决这些badcase呢,要看你的时间了,如果时间充裕的话,可以调整发射概率文件也就是nr.txt文件。如果时间不充裕的话,比如我现在的情况,那就只保留常用姓氏,以及特别需要关注的人名了。上一篇的内容先说到这里,介绍本篇的主题”基于层叠隐马的命名实体识别”我这里主要阅读的是这篇文章《基于层叠隐马尔可夫模型的中文命名实体识别》。层叠就是将模型级联起来的意思,因此系统的结构如下图所示: 如图所示,层叠隐马就是训练三个隐马模型,每个模型标注一种实体,三个模型采用级联形式连接。 不同的实体有不同的角色标注,实际就是特征,这些特征需要有语言学的知识,实际上就是你的阅读量,通过你大量阅读总结经验,比如姓氏可以作为名字的一个特征(张、王、李、赵),常用地名的后缀可以作为一个特征(省、市、区、县),机构名表处所的尾字可以作为一个特征(局、处、所、院)。这里地名的角色标注简表如下所示:

优秀的个人博客,低调大师

Jcseg 2.4.0 发布,Java 轻量级开源自然语言处理包

Jcseg是基于mmseg算法的一个轻量级中文分词器,同时集成了关键字提取,关键短语提取,关键句子提取和文章自动摘要等功能,并且提供了一个基于Jetty的web服务器,方便各大语言直接http调用,同时提供了最新版本的lucene,solr和elasticsearch的分词接口! Jcseg 2.4.0更新如下: 1,修复时间组合实体识别的bug,有时候会出现错误组合的情况。 2,优化NLP模式的时间实体的识别,区分组合时间,例如:"米"实体为"length.m","3米"为"nuc_length.m"。 长度单位/null 米/n/length.m ,/w/null 例如/d/null 这/r/null 根/q/null 线/q/null 长/d/null 3米/q/nuc_length.m 3,依据百度的汉语数据修复词条中的部分拼音错误:https://gitee.com/lionsoul/jcseg/commit/4f08a01ea94828e4c4ac585a744b4755f33c8c4b 4,修复中文数字转阿拉伯数字后词条的offset错误。 5,依据百度的汉语数据修复词条中的部分拼音错误:https://gitee.com/lionsoul/jcseg/commit/3de95015056a7ea683c5955faef891fa68af36b5 6,修改Elasticsearch的资源访问为官网建议的安全资源访问形式,意味着es插件不需要再grant privileges。 7,Elasticsearch插件中增加插件级别的单例词库创建接口并且使用安全方式加载词库。 8,修改jcseg-server中的jetty版本为:9.3.24.v20180605 9,jcseg-server.properties配置文件增加自定义host支持,便于外网访问。 10,修复maven编译中的全部javadoc报错。 11,README中增加了jcseg的使用案例和链接,以及微信和QQ沟通账号。 下载地址: Gitee:https://gitee.com/lionsoul/jcseg/tree/v2.4.0-release Github:https://github.com/lionsoul2014/jcseg/releases/tag/v2.4.0-release maven仓库地址: <dependency> <groupId>org.lionsoul</groupId> <artifactId>jcseg-core</artifactId> <version>2.4.0</version> </dependency> 本文来自云栖社区合作伙伴“开源中国” 本文作者:狮子的魂 原文链接

优秀的个人博客,低调大师

如何利用自然语言处理构建基于内容的电影推荐系统

“empty brown theater chairs” by Tyler Callahan on Unsplash 你是否有过这样的疑惑:为什么Netflix,Amazon,Google总能推荐到你比较感兴趣的产品?我们有时会对互联网上的产品进行评分,以此体现我们对产品的偏好,同时,推荐系统会利用我们分享的数据,生成推荐结果。主流的推荐系统算法大致分为两类:基于用户历史数据的协同过滤算法和基于内容数据的过滤算法。两者的区别其实从名称上便可看出,但接下来我们将以电影推荐为例进一步阐述二者之间的不同。 协同过滤(Collaborative filters) 协同过滤依赖用户的历史评分数据,为用户推荐自己未曾看过,而与自己相似的用户已经观看过的电影。为了确定两个用户之间是否相似,协同过滤会结合用户所看过的电影以及他们对电影的评分。 Colla

优秀的个人博客,低调大师

自然语言处理工具hanlp关键词提取图解TextRank算法

看一个博主(亚当-adam)的关于hanlp关键词提取算法TextRank的文章,还是非常好的一篇实操经验分享,分享一下给各位需要的朋友一起学习一下! TextRank是在Google的PageRank算法启发下,针对文本里的句子设计的权重算法,目标是自动摘要。它利用投票的原理,让每一个单词给它的邻居(术语称窗口)投赞成票,票的权重取决于自己的票数。这是一个“先有鸡还是先有蛋”的悖论,PageRank采用矩阵迭代收敛的方式解决了这个悖论。本博文通过hanlp关键词提取的一个Demo,并通过图解的方式来讲解TextRank的算法。 1//长句子 2String content = "程序员(英文Programmer)是从事程序开发、维护的专业人员。" + 3"一般将程序员分为程序设计人员和程序编码人员," + 4"但两者的界限并不非常清楚,特别是在中国。" + 5"软件从业人员分为初级程序员、高级程序员、系统" + 6"分析员和项目经理四大类。"; 最后提取的关键词是:[程序员, 程序, 分为, 人员, 软件] 下面来分析为什么会提取出这5个关键词 第一步:分词 把content 通过一个的分词算法进行分词,这里采用的是Viterbi算法也就是HMM算法。分词后(当然首先应把停用词、标点、副词之类的去除)的结果是: [程序员, 英文, Programmer, 从事, 程序, 开发, 维护, 专业, 人员, 程序员, 分为, 程序, 设计, 人员, 程序, 编码, 人员, 界限, 并不, 非常, 清楚, 特别是在, 中国, 软件, 从业人员, 分为, 程序员, 高级, 程序员, 系统分析员, 项目经理, 四大] 第二步:构造窗口 hanlp的实现代码如下: Map<String, Set<String>> words = new TreeMap<String, Set<String>>(); Queue<String> que = new LinkedList<String>(); for (String w : wordList) { if (!words.containsKey(w)) { words.put(w, new TreeSet<String>()); } // 复杂度O(n-1) if (que.size() >= 5) { que.poll(); } for (String qWord : que) { if (w.equals(qWord)) { continue; } //既然是邻居,那么关系是相互的,遍历一遍即可 words.get(w).add(qWord); words.get(qWord).add(w); } que.offer(w); } 这个代码的功能是为分个词构造窗口,这个词前后各四个词就是这个词的窗口,如词分词后一个词出现了多次,像[程序员],那就是把每次出现取一次窗口,然后把各次结果合并去重,最后结果是:程序员=[Programmer, 专业, 中国, 人员, 从业人员, 从事, 分为, 四大, 开发, 程序, 系统分析员, 维护, 英文, 设计, 软件, 项目经理, 高级]。最后形成的窗口: 1 Map<String, Set<String>> words = 2 3 {Programmer=[从事, 开发, 程序, 程序员, 维护, 英文], 专业=[人员, 从事, 分为, 开发, 程序, 程序员, 维护], 中国=[从业人员, 分为, 并不, 清楚, 特别是在, 程序员, 软件, 非常], 人员=[专业, 分为, 并不, 开发, 清楚, 界限, 程序, 程序员, 维护, 编码, 设计, 非常], 从业人员=[中国, 分为, 清楚, 特别是在, 程序员, 软件, 高级], 从事=[Programmer, 专业, 开发, 程序, 程序员, 维护, 英文], 分为=[专业, 中国, 人员, 从业人员, 特别是在, 程序, 程序员, 系统分析员, 维护, 设计, 软件, 高级], 四大=[程序员, 系统分析员, 项目经理, 高级], 并不=[中国, 人员, 清楚, 特别是在, 界限, 程序, 编码, 非常], 开发=[Programmer, 专业, 人员, 从事, 程序, 程序员, 维护, 英文], 清楚=[中国, 人员, 从业人员, 并不, 特别是在, 界限, 软件, 非常], 特别是在=[中国, 从业人员, 分为, 并不, 清楚, 界限, 软件, 非常], 界限=[人员, 并不, 清楚, 特别是在, 程序, 编码, 非常], 程序=[Programmer, 专业, 人员, 从事, 分为, 并不, 开发, 界限, 程序员, 维护, 编码, 英文, 设计], 程序员=[Programmer, 专业, 中国, 人员, 从业人员, 从事, 分为, 四大, 开发, 程序, 系统分析员, 维护, 英文, 设计, 软件, 项目经理, 高级], 系统分析员=[分为, 四大, 程序员, 项目经理, 高级], 维护=[Programmer, 专业, 人员, 从事, 分为, 开发, 程序, 程序员], 编码=[人员, 并不, 界限, 程序, 设计, 非常], 英文=[Programmer, 从事, 开发, 程序, 程序员], 设计=[人员, 分为, 程序, 程序员, 编码], 软件=[中国, 从业人员, 分为, 清楚, 特别是在, 程序员, 非常, 高级], 非常=[中国, 人员, 并不, 清楚, 特别是在, 界限, 编码, 软件], 项目经理=[四大, 程序员, 系统分析员, 高级], 高级=[从业人员, 分为, 四大, 程序员, 系统分析员, 软件, 项目经理]} 第三步:迭代投票 每个词最后的投票得分由这个词的窗口进行多次迭代投票决定,迭代的结束条件就是大于最大迭代次数这里是200次,或者两轮之前某个词的权重小于某一值这里是0.001f。看下代码: Map<String, Float> score = new HashMap<String, Float>(); //依据TF来设置初值 for (Map.Entry<String, Set<String>> entry : words.entrySet()){ score.put(entry.getKey(),sigMoid(entry.getValue().size())); } System.out.println(score); for (int i = 0; i < max_iter; ++i) { Map<String, Float> m = new HashMap<String, Float>(); float max_diff = 0; for (Map.Entry<String, Set<String>> entry : words.entrySet()) { String key = entry.getKey(); Set<String> value = entry.getValue(); m.put(key, 1 - d); for (String element : value) { int size = words.get(element).size(); if (key.equals(element) || size == 0) continue; m.put(key, m.get(key) + d / size * (score.get(element) == null ? 0 : score.get(element))); } max_diff = Math.max(max_diff, Math.abs(m.get(key) - (score.get(key) == null ? 0 : score.get(key)))); } score = m; if (max_diff <= min_diff) break; } System.out.println(score); return score; } 投票的原理拿Programmer=[从事, 开发, 程序, 程序员, 维护, 英文],这个词来说明,Programmer最后的得分是由[从事, 开发, 程序, 程序员, 维护, 英文],这6个词依次投票决定的,每个词投出去的分数是和他本身的权重相关的。 1、投票开始前每个词初始化了一个权重,score.put(entry.getKey(),sigMoid(entry.getValue().size())),这个权重是0到1之间,公式是 1 //value是每个词窗口的大小 2public static float sigMoid(float value) { 3return (float)(1d/(1d+Math.exp(-value))); 4} 这个函数的公式和图像如下,因为value一定是大于0的,所以sigMod值属于(0,1) 初始化后的分词是:{特别是在=0.99966466, 程序员=0.99999994, 编码=0.99752736, 四大=0.98201376, 英文=0.9933072, 非常=0.99966466, 界限=0.99908894, 系统分析员=0.9933072, 从业人员=0.99908894, 程序=0.99999774, 专业=0.99908894, 项目经理=0.98201376, 设计=0.9933072, 从事=0.99908894, Programmer=0.99752736, 软件=0.99966466, 人员=0.99999386, 清楚=0.99966466, 中国=0.99966466, 开发=0.99966466, 并不=0.99966466, 高级=0.99908894, 分为=0.99999386, 维护=0.99966466} 进行迭代投票,第一轮投票,[Programmer, 专业, 中国, 人员, 从业人员, 从事, 分为, 四大, 开发, 程序, 系统分析员, 维护, 英文, 设计, 软件, 项目经理, 高级]依给次*程序员*投票,得分如下: [Programmer]给[程序员]投票后,[]程序员]的得分: [专业]给[程序员]投票 这样[Programmer, 专业, 中国, 人员, 从业人员, 从事, 分为, 四大, 开发, 程序, 系统分析员, 维护, 英文, 设计, 软件, 项目经理, 高级]依次给[程序员]投票,投完票后,再给其它的词进行投票,本轮结束后,判断是否达到最大迭代次数200或两轮之间分数差值小于0.001,如果满足则结束,否则继续进行迭代。 最后的投票得分是:{特别是在=1.0015739, 程序员=2.0620303, 编码=0.78676623, 四大=0.6312981, 英文=0.6835063, 非常=1.0018439, 界限=0.88890904, 系统分析员=0.74232763, 从业人员=0.8993066, 程序=1.554001, 专业=0.88107216, 项目经理=0.6312981, 设计=0.6702926, 从事=0.9027207, Programmer=0.7930236, 软件=1.0078223, 人员=1.4288887, 清楚=0.9998723, 中国=0.99726284, 开发=1.0065585, 并不=0.9968608, 高级=0.9673803, 分为=1.4548829, 维护=0.9946941},分数最高的关键词就是要提取的关键词

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册