首页 文章 精选 留言 我的

精选列表

搜索[翻译工具],共10011篇文章
优秀的个人博客,低调大师

[Android]使用MVP解决技术债务(翻译)

以下内容为原创,欢迎转载,转载请注明 来自天天博客:http://www.cnblogs.com/tiantianbyconan/p/5892671.html 使用MVP解决技术债务 原文:https://medium.com/picnic-engineering/tackling-technical-debt-with-mvp-67e805ed5103#.couu0d5i0 免责申明:这篇博客并不是讲关于怎么使用MVP的方式(上帝知道关于这些已经太多了)去写Android代码。而仅仅是我的个人经验,关于怎么转换我们的表现层到MVP架构来帮助我们解决一些累积的技术债务,而且在这个过程中也会帮助我们的app从一个原型转变成一个更具维护性的产品。 任何从事Android工作足够久、项目足够大的开发者最有可能达到一个点,他们面对他们的代码库,觉得应该有更好的实现方案。我们在Picnic也是一样,在Android app开发开始后大约八个月,我们到达了的那一刻,就在我们向公众发布第一个版本的时候。 这一刻正好是在我们app推出的时候这也并不意外。直到那时,我们以一个非常快的速度在前进,不断敲打我们的键盘,从零开始构建一个完整的产品,尝试新的东西,结合用户反馈到我们的app中,在每天的基础上增加和丢弃特性。 为了跟上公司的速度我们砍掉了这里那里的边边角角。这样的工作对我们来说很好,这也是我们能够在这么短的时间内构建这个app的原因之一。但是正如预期那样,最后这些决定的影响开始以技术债务的形式显示出来。幸运的是这些技术债务是在数月之内建立的,在app的性能和稳定性上面并没有任何真正的影响。反而我们是在其它领域开始注意到它: 新功能迭代时间的增加。 新入职的开发者遇到困难 它被证实难以实现自动化测试 整体功能的复杂性在增加 我们已经有了一个很好的想法和一个易于理解的架构,用于网络层、错误处理和app内部模块通信。但是像大多数Android开发者,我们会对把太多的逻辑放进Activity和Fragment中会产生内疚。 旁注:这是Android开发者的共同的问题,而作为开发者需要在黑暗中摸索,因为Google对这个话题保持沉默。我们从它们那里得到的第一个(算是)官方回复是来自Android团队的一个开发者在 Google+ post,说明我们应该把核心的Android API作为一个‘系统框架’,意味着他们会带我们手把手地到达Android核心的组件(Activity, BroadcastReceiver, Service 和 ContentProvider)。之后我们做什么都是看我们自己了。而且就在最近,Google终于提供了一系列的例子用来解决关于怎么构建一个Android app的共同问题,它着重于MVP。尽管只是beta,但是它可以在这里查看:Android Architecture Blueprints。 无论如何,这其实是一件好事,因为这意味着我们可以自由地去实验任何我们喜欢的方式,而不是被强制在一个平台遵循一个特定的模式。 现在讲回我们的故事… 除非你处在Android开发世界的远古时期,你应该会注意到表现层架构是现在的热门。关于最好的方式是什么,每个人甚至连他妈妈似乎都有自己的观点。工作中标准的Android方式(类似MVC),到MVP,到通过data-binding的MVVM,所有的方式都沿用了 Uncle Bob 的 clean architecture。每一种方式围绕赞成或者反对的意见都有一些有趣的讨论,但是有一件事我们要明确知道,那就是我们应该避免喝Kool-Aid(译者注:这里是比喻,表示非常愚昧地接受信奉某种观点或者思想)和期望其中一种是银色子弹(译者注:这里是比喻为具有极端有效性的解决方法)然后永远解决所有问题。 当在考虑怎么去重构我们的表现层时,我们已经有近一年的代码库的积累,我们很清楚我们的缺陷在哪里,然后我们需要使用一个新的实现(以上主要表示一些能够解决我们的技术债务的点)来达到我们的目标。我们在虚拟的项目中试玩了一些,体验了各种方法的不同之处,然后最终决定使用MVP。从它的核心来说,MVP本身仅仅是一个概念,而Android框架,根据设计,并不强制任何模式,我们可以自由地选择实际的实现细节。 在Android团队中,首先我们是不过度工程的信徒,让代码随着时间的推移自然地发展,而不是过早地在试图为自己不可预知的未来做准备的抽象之上增加抽象。正因为这个原因,我们选择另一风味的MVP,使得可以最低限度地保持我们的抽象层次。在代码级别,这意味着有一个单独的接口来表示View。所有其它的组件都是具体的类。你可能会问自己,怎么会只有View使用接口?考虑到我们迫切的需要,这是真正受益于这样的接口的唯一的组件,因为我们实际上有不同的具体的Views来共享相同的接口。所以在我们的案例中,这里的一个接口将被允许我们去重用Presenters。一些MVP实现建议给所有组件(M,V和P)设置接口。尽管这样会工作得很完美,但是我们在较早的阶段并不提倡,因为添加之后的成本是代码可读性和维护性,尤其是当我们考虑到新入职对MVP陌生的初级开发者的时候,好处超过面向接口编程的方式。 相比其他,MVP实现是非常标准的。View(Activity,Fragment或者一个自定义View)负责创造和维护Presenter,而Presenter处理各种业务相关的逻辑(数据获取,存储,格式化等等),然后根据需要通过更新UI回调到View。在我们的案例中,数据层已经是相当模块化了,构造用于表示数据模型的POJOs,以及一个预先存在的控制层用于处理网络通信。 这是一个非常标准的MVP设置,也因为它很简单,我们可以在几周的时间内替换几乎我们的所有的UI代码。因为我们已经存在独立的数据层来处理所有与后端的API交互,所以真正需要重构的只是Views和Presenters的交互。 在重构的过程中,我们也学习了一些可能会派得上用场的东西: 生命周期:因为Presenter是View创建的,我们需要确保完全地理解View的生命周期,特别是因为它将最有可能去处理状态更新和异步数据。举个例子,每一个Presenter应该在View destroyed的情况下有一个取消异步任务的方式,或者应该在用户暂停或者恢复视图事件时重置到原始状态等等。最后但同样重要的是,当View已经被销毁,试图从Presenter去更新View元素,始终需要注意可怕的NPEs。 保持Views尽可能地愚蠢:我们的Views应该不再包含任何业务相关的逻辑。它应该只包含Android框架inflate和设置View的这些最低限度的东西。任何用户交互应该派发到Presenter。根据经验,如果你的views有任何其它方法去更新UI元素或者响应用户触发的事件,那么你可能应该去检查它们的实现。 保持Presenter尽可能地纯粹:这一点,我们的意思时你应该尽可能地避免有Android相关的代码在你的presenters中。为这些组件编写纯粹的单元测试,而不需要使用其它如Robolectric等测试框架,这明显地得到了简化。这明显说起来比做起来容易得多,因为你终归会在某些地方遇到这种情况,举个例子,你将需要有一个Context的引用用来比如数据加载、访问strings文件等等。 结论 那么,说了那么多,最终的结论是什么呢?总的来说,我很高兴使用了MVP。它一定程度上帮我们解决了我们快速开发所累积的技术债务,然后,我们准备了更多来针对第二阶段的开发。 一些值得一提的事情: 测试数:在重构之前,测试的数量用两只手都可以数得过来。这是一个巨大的任务来针对包含了所有逻辑如执行数据解析、格式化、网络请求、错误处理和管理自己的生命周期的Activity编写测试。仅思考如果在这些条件下编写测试就足以让我们去寻找其它的方式了。一旦转换我们的第一份代码到MVP,对此编写测试就变得碎片化了。通过一个清晰的合同明确什么View能够处理,我们可以把自己的代码与Android UI框架隔离开,然后仅仅测试实际调用的是否是正确的方法,并给出每个测试场景。现在实际的业务相关逻辑被放置在Presenters中,因为它们绝大多数都不需要有Android OS相关的认知(或者小部分相关的可以被mocked),我们也可以针对它们编写非常有效率的单元测试,因此,在过去几个月里,我们的测试用例从原来的10增加到900,而且还在增长中。 可预见性:这个是有一点软度量,但是非常强大的一点。针对UI,我们选择并坚持一个通用的模式,我可以在代码库中获得可预见的好处。这意味着,无论是哪种开发者眼里的UI元素(Activity,Dialog,Fragment等等),如果理解其中一个怎么工作,那也就能理解所有怎么工作。打开一个就算不是你写的文件也不再会遇到让你觉得惊喜的东西了。明确规定职责,每一单个的UI组件都遵循相同的明确的模式。让新入职的新开发者从第一天起就是高效的,这是非常宝贵的。 我们别忘记MVP并不只是用于表现层,但是作为前端开发人员,这里花费了我们太多的时间。所以努力去寻找一个解决方案来给我们带来更好的可预见性和在新的开发者加入我们的时候也能让我们快速迭代是值得的。经过全面的考虑,我们可以有把握地说MVP是可以帮助我们达到这个目标的一个重要的里程碑。 P.S. 如果你仍然渴望看到一些源代码,这里有一个我们MVP实现‘忘记密码’用例的剥离下来的版本,展示MVP组件与用户的交互,用户点击‘重置密码’按钮进入他们的邮件地址(为保持代码的简洁,Android模版代码已经移除): // BasePresenter.java (Base class for all our Presenters) public abstract class BasePresenter<V> { private WeakReference<V> mView; public void bindView(@NonNull V view) { mView = new WeakReference<>(view); } public void unbindView() { mView = null; } public V getView() { if (mView == null) { return null; } else { return mView.get(); } } protected final boolean isViewAttached() { return mView != null && mView.get() != null; } } // IForgotPasswordView.java (view interface) public interface IForgotPasswordView { void showLoading(); void hideLoading(); void setEmailText(String email); void showEmailNotValidError(); void showPasswordRequestOk(String message); void showPasswordRequestFail(); } // ForgotPasswordFragment.java (view implementation) public class ForgotPasswordFragment implements IForgotPasswordView, View.OnClickListener { // Triggered by the user clicking a button public void onResetPasswordClick() { String email = mEmailEditText.getText().toString(); // Forward all logic to the Presenter mPresenter.requestPasswordChange(email); } } // ForgotPasswordPresenter.java public class ForgotPasswordPresenter extends BasePresenter<IForgotPasswordView> { public void requestPasswordChange(String email) { if (!Utils.isEmailValid(email)) { // Make sure the view is still alive before trying to access it if(isViewAttached()) { getView().showEmailNotValidError(); } } else { requestPasswordChangeAsync(email); } } private void requestPasswordChangeAsync(String email) { // Update the view's UI elements if(isViewAttached()) { getView().hideKeyboard(); getView().showLoading(); // Call our API (results are posted back on an EventBus) api.forgotPassword(email); } } // Subscription to the event bus @Subscribe public void onEvent(final Event event) { if (isViewAttached()) { // Update the view's UI elements getView().hideLoading(); switch (event.getType()) { case FORGOT_PASSWORD_OK: getView().showPasswordRequestOk((String) event.getData()); break; case FORGOT_PASSWORD_FAILED: getView().showPasswordRequestFail(); break; } } } }

优秀的个人博客,低调大师

[翻译]Hello, wasm-pack - cargo.toml

Cargo.toml cargo.toml是Rust 包管理器 cargo 的清单文件。这个文件包 name、 version 和包的依赖,在 Rust 中,我们一般称之为 crate。 在示例中给出了一系列信息,但是我们主要讨论如下三点: crate-type wasm-bindgen 依赖 [features] 和 wee_alloc、console_error_panic_hook 依赖 1.crate-type [lib] crate-type = ["cdylib", "rlib"] Rust-wasm 包与通常的 crate 有一点不同,作为 WebAssembly 项目, 我们需要在 cargo.toml 中加入该说明。 如果你熟悉其他的 Rust crate,那么你肯定知道,大多的 crate 的类型是 rlib(默认), 或者是二进制形式的 bin(这种形式不需要 crate-type 注解), 并且 [lib] 注解在普通的 Cargo 项目中并不需要指定。 crate-type = ["cdylib"] 指示你的工程将会被编译为动态系统库 [dynamic system library], 但是对于 WebAssembly,他将会编译为一个没有启动函数的 .wasm 文件,在 Linux 平台上,他将会创建.so 文件,在macOS 上将会创建.dylib文件,在 windows 平台上将会创建 *.dylib 文件。 我们通常指定 crate-type = ["rlib"] 来确保我们的库可以用 wasm-pack 来做单元测试(稍后会看到)。如果没有这个配置,我们将不能测试我们的库,因为 cdylib 包类型和 wasm-pack 的单元测试类型相冲突。 你可以使用此链接获取更多关于包类型的知识。 2. wasm-bindgen 依赖 wasm-bindgen 在WebAssembly 中是一个重要的依赖。 这个包允许我们使用 [wasm-bindgen] 为在 JavaScript 和 Rust 生成的 wasm 之间的代码打标签。以使我们使用它的属性可以导入 JS 并且导出 Rust。 wasm-bindgen = "0.2" 当我们讨论 lib.rs 生成什么内容的时候,将会看到更多关于怎么使用这个库。如果你从 JavaScript 技术栈过来,你可能注意到了当我们添加依赖的时候并没有加 ^ 或者 ~ ,看起来像是我们只要 0.2 这个版本。然而,事实并非如此!在 Rust 里, ^ 是默认的,你可使用这个 链接查看更多信息 3. [features] 和 wee_alloc, console_error_panic_hook dependencies 作为我们设计模板的工作的一部分,该模板可帮助人们发现针对特定用例的有用包,该模板包括两个依赖项,这对于开发Rust-wasm包的人们可能非常有用:console_error_panic_hook 和 wee_alloc。 因为这些依赖关系主要在 Rust-wasm 包开发工作流程的特定部分中有用,所以我们还设置了一些粘合代码,使我们既可以将它们都包含为依赖关系,又可以选择将它们包含在内。 [features] default = ["console_error_panic_hook"] [dependencies] wasm-bindgen = "0.2" # The `console_error_panic_hook` crate provides better debugging of panics by # logging them with `console.error`. This is great for development, but requires # all the `std::fmt` and `std::panicking` infrastructure, so isn't great for # code size when deploying. console_error_panic_hook = { version = "0.1.1", optional = true } # `wee_alloc` is a tiny allocator for wasm that is only ~1K in code size # compared to the default allocator's ~10K. It is slower than the default # allocator, however. # # Unfortunately, `wee_alloc` requires nightly Rust when targeting wasm for now. wee_alloc = { version = "0.4.2", optional = true } 在我们的代码中,只有在启用某些 [features] 的情况下,我们才会将代码的某些部分标记为正在运行,特别是 console_error_panic_hook 和 wee_alloc。默认情况下,仅启用 console_error_panic_hook。要禁用或启用任一功能,默认情况下,我们可以在 [features] 下编辑 default 数组。 要了解有关这些功能的更多信息,我们将在 src/lib.rs 和 src/utils.rs 部分中深入讨论它们。 简要地,它们包括: console_error_panic_hook ,用于将奔溃消息记录到开发人员控制台的功能。 wee_alloc,一个使代码量更小而优化的分配器。

优秀的个人博客,低调大师

组复制官方翻译二、Group Replication Background

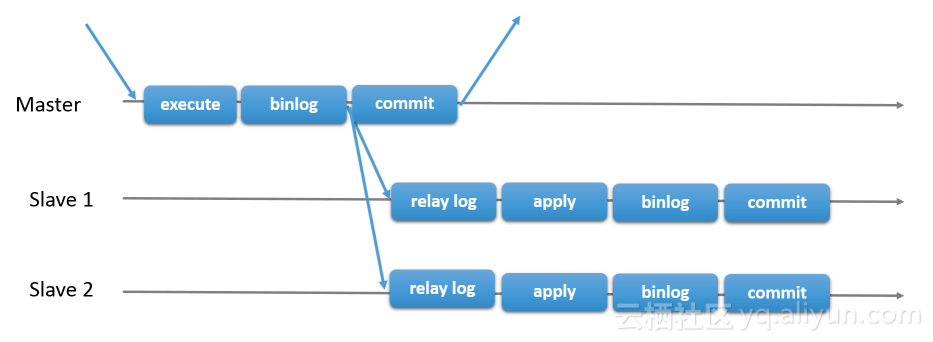
https://dev.mysql.com/doc/refman/8.0/en/group-replication-background.html 这一章主要描述一些组复制的背景 构建一个容错系统最常用的方法就是让组件冗余,换句话说就是组件即便被移除掉,整个系统还是能够正常对外提供服务这无疑在不同层面上提出了更多的挑战需要注意的是,复制结构的数据库系统必须思考的一个事实就是:他们需要维护和管理一堆不同的sever此外,他们还必须解决分布式系统所面临的问题:比如 脑裂、网络分区等等 因此,最大的挑战就是去融合这种逻辑数据库,保证数据复制的一致性换句话说,为了让不同server都同意这个系统的状态,他们每一台server的数据修改都必须验证一致这就意味着他们需要运作的想一个状态机一样(分布式) MySQL Group Replication提供了一套分布式状态机制复制管理方法 对于要提交的事务,这个group采取大部分原则来投票,让事务全局有序决定commit还是拒绝这个事务都是由server自行判断,但是所有servers都会做出一样的决定如果网络产生了分区,脑裂产生导致成员之间无法达成一致投票决定,那么这个系统会停止运行直到这个问题被解决所以,他有一个内置、自动的脑裂包含机制在运行 以上所有的功能都是由Group Communication System (GCS) 协议来保证它有错误检测机制、组成员通信服务、安全可靠的顺序一致消息分发所有这些特性是搭建一个 数据完全一致性的系统 的关键要素在一些非常核心重要的技术点上 罗列了Paxos 算法的实现,它扮演着组复制通信引擎的角色,至关重要 18.1.1 Replication Technologies 在了解MGR内幕之前,这里先主要介绍下相关的背景概念、以及概述这章主要告诉我们,MGR需要什么,以及传统的异步复制和MGR直接的一些区别 18.1.1.1 Primary-Secondary Replication 传统的复制提供了一个简单的主从复制架构(Primary-Secondary)primary就是master,secondary就是slaves,可以有多个slavesmaster执行事务、commit事务,然后异步的将这些事务发送到slaves,让他们re-executed一遍(statement模式)或者 重新applied (ROW模式)它是share-nothing架构,即所有server都有一份完整的数据copy 还有一种传统复制叫:半同步复制它意味着:在commit的之前,master等待,直到slaves给master一个确认接收到事务的ack,master才恢复commit的操作 在上面的两幅图中,你能看到异步传统复制协议的基本架构,箭头代表client消息的流动和转变 18.1.1.2 Group Replication 组复制是一个实现了容错系统的技术组复制集群就是一堆机器,他们之间通过消息进行沟通communication 层:提供了一系列的保障机制,atomic message(原子广播) , total order message delivery(全局序列消息分发机制) MGR在此基础上构建并实现了一个multi-master的复制协议,它可以在任何server上写数据集群的本质就是多server,每个server可以独立的处理事务但是所有的读写(RW)事务都必须经过集群的审核所有的只读(RO)事务不受任何影响换句话说,对于RW事务,group只需要决定它应该commit还是拒绝commit,因此事务操作并不是单方面(origi server)的决定确切的说,当origin server准备进行事务commit的时候,这个server会自动广播这个写集然后,一个全局排序的事务产生了这意味着,所有的server都接收同样顺序的事务集由于是有序的,所有server应用相同顺序,相同数据的写集,因此他们的数据也是一致的 然而,如果是并发写在不同server的场景会遇到冲突因此,对应这种情况需要进行冲突检测,这个过程叫做认证 certification如果两个并发事务在不同server同时执行,并且更新了相同的row,那么他们就是冲突的那么它的解决方案就是,排在前面的事务会被标记commit,排在后面的会被拒绝(这个事务在origin server会回滚,其他server会被丢弃) 最后,MGR也是一种share-nothing架构,每个server都有一份完整的数据copy 18.1.2 Group Replication Use Cases 组复制提供了一个高容错性的系统,即使一些机器宕机,只要不是所有或者大多数机器不可用,那么整个系统还是可用状态总结下来,MGR保证数据库持续可用 18.1.2.1 Examples of Use Case Scenarios 以下就是典型的MGR使用案例 Elastic Replication 可伸缩的复制 Highly Available Shards 高可用的分片 Alternative to Master-Slave replication 可选择master-slave架构 Autonomic Systems 完全自动化的系统 18.1.3 Group Replication Details 18.1.3.1 Failure Detection 它提供一个错误检测机制,可以找到或报告出哪些servers没有回应,哪些server挂了在高一层次来将,错误检测机制就是一个分布式服务,用于提供哪些server挂掉或可能挂掉的情报信息之后,如果组成员通过某种协议认证了这个嫌疑犯(可能挂掉的家伙)已经真的挂了,那么集群就会决定这个嫌疑犯真的的确挂了这意味着,组的其他成员一致决定将这个嫌疑犯踢出集群 当Server A 在指定time-out时间内没有收到来自server B的回应,那么B就会被提升为嫌疑犯如果一个Server被其他group成员隔离,那么它就会怀疑所有其他的成员都挂了由于它不能达成投票的一致性认可(没有达到法定人数的确认),所以它认为的嫌疑犯就不能被确认为failed如果一个Server在这种情况下被隔离,那么他是不能执行local事务的 18.1.3.2 Group Membership MGR依赖组会员服务(Group Membership Service,简称GMS),它是内置的它定义了哪些servers是online并加入了这个group,这些online servers经常被称为view因此,这个组里面的任一online成员都有一个一致的view 如果servers同意让一个新server加入到这个group中来,那么这个group就好重新自动将其配置上,且重新触发形成一个新的view如果一个server非自愿的离开了group,那么错误检测机制就开始识别,也会重新配置上一个新的view上面提到的这些都需要一个协议,并且需要大多数人参与并认可的协议如果这个group没有满足达到这个协议认可的要求,那么自动配置将不会起作用,并且该系统会被阻塞来防止脑裂的产生最后,这意味着管理员需要手动介入来解决这个问题 18.1.3.3 Fault-tolerance MGR 是在Paxos分布式算法构建实现的,以此它需要满足大多数活跃成员进行投票选举的策略。有一个公式:n = 2 x f + 1 , n代表group的成员数,f代表允许挂掉的成员数 ,在这个公式下,整个集群是安全的 如果n=3,那么允许挂掉的server是1,也能满足要求,但是如果再挂一个呢, 其实就问题非常大了 集群成员数量n majority 可允许挂掉的server数量 1 1 0 2 2 0 3 2 1 4 3 1 5 3 2 6 4 2 7 4 3

优秀的个人博客,低调大师

Openstack 安装部署指南翻译系列 之 概况

1.1.1.1.Nova服务安装(Compute) 1.1.1.1.1.计算服务概述 使用OpenStack Compute来托管和管理云计算系统。OpenStack Compute是基础架构即服务(IaaS)系统的主要部分。主要模块是用Python实现的。 OpenStack Compute与OpenStack Identity进行交互以进行身份验证; OpenStack镜像服务用于磁盘和服务器镜像; OpenStack仪表板用于用户和管理界面。镜像访问受到项目和用户的限制;配额对于每个项目是有限的(例如数量)。OpenStack Compute可以在标准硬件上水平扩展,并下载镜像以启动实例。 OpenStack Compute由以下几个服务组成: 2nova-api服务 接受并回复最终用户的计算API调用。该服务支持OpenStack Compute API,Amazon EC2 API和特殊的Admin API,用于特权用户执行管理操作。它执行一些策略并启动大多数业务流程活动,例如运行一个实例。 2nova-api-metadata服务 接受来自实例的元数据请求。nova-api-metadata当您在多主机模式下运行nova-network安装时,通常会使用该服务 。有关详细信息,请参阅 “OpenStack管理员指南”中的元数据服务。 2nova-compute服务 通过虚拟机管理程序API创建和终止虚拟机实例的工作程序守护程序。例如: 适用于XenServer / XCP的XenAPI KVM或QEMU的libvirt 适用于VMware的VMwareAPI 处理相当复杂。基本上,守护程序接受队列中的操作,并执行一系列系统命令,例如启动KVM实例并更新数据库中的状态。 2nova-placement-api服务 跟踪每个提供商的库存和使用情况。有关详细信息,请参阅Placement API。 2nova-scheduler服务 从队列获取虚拟机实例请求,并确定运行哪个计算服务器主机。 2nova-conductor模块 中介nova-compute服务和数据库之间的交互。它消除了对nova-compute服务器所做的云数据库的直接访问。该nova-conductor模块水平缩放。但是,请勿在nova-compute服务运行的节点上部署它 。有关详细信息,请参阅配置参考指南。 2nova-cert模块 服务器守护进程为Nova Cert服务提供X509证书。用于生成证书euca-bundle-image。只需要EC2 API。 2nova-consoleauth守护进程 授权控制台代理提供的用户的令牌。参考nova-novncproxy和nova-xvpvncproxy。此服务必须运行才能使控制台代理工作。您可以在集群配置中针对单个nova-consoleauth服务运行任一类型的代理。有关信息,请参阅关于nova-consoleauth。 2nova-novncproxy守护进程 提供通过VNC连接访问运行实例的代理。支持基于浏览器的novnc客户端。 2nova-spicehtml5proxy守护进程 提供通过SPICE连接访问运行实例的代理。支持基于浏览器的HTML5客户端。 2nova-xvpvncproxy守护进程 提供通过VNC连接访问运行实例的代理。支持OpenStack特定Java客户机。 2队列 在守护进程之间传递消息的中心枢纽。通常用RabbitMQ实现,也可以用另一个AMQP消息队列来实现,如ZeroMQ。 2SQL数据库 存储云基础设施的大部分构建时间和运行时状态,包括: 可用的实例类型 正在使用的实例 可用网络 项目 理论上,OpenStack Compute可以支持SQLAlchemy支持的任何数据库。公共数据库是用于测试和开发工作的SQLite3,MySQL,MariaDB和PostgreSQL。 1.1.1.1.2.安装和配置控制器节点 本节介绍如何在控制器节点上安装和配置代号为Nova的Compute服务。 1.1.1.1.2.1.先决条件 在安装和配置Compute服务之前,必须创建数据库,服务凭据和API端点。 1、要创建数据库,请完成以下步骤: 使用数据库访问客户端作为root用户连接到数据库服务器: $ mysql -u root -p 创建nova_api,nova和nova_cell0数据库: MariaDB [(none)]> CREATE DATABASE nova_api; MariaDB [(none)]> CREATE DATABASE nova; MariaDB [(none)]> CREATE DATABASE nova_cell0; 授予对数据库的正确访问权限: MariaDB [(none)]> GRANT ALL PRIVILEGES ON nova_api.* TO 'nova'@'localhost' \ IDENTIFIED BY 'NOVA_DBPASS'; MariaDB [(none)]> GRANT ALL PRIVILEGES ON nova_api.* TO 'nova'@'%' \ IDENTIFIED BY 'NOVA_DBPASS'; MariaDB [(none)]> GRANT ALL PRIVILEGES ON nova.* TO 'nova'@'localhost' \ IDENTIFIED BY 'NOVA_DBPASS'; MariaDB [(none)]> GRANT ALL PRIVILEGES ON nova.* TO 'nova'@'%' \ IDENTIFIED BY 'NOVA_DBPASS'; MariaDB [(none)]> GRANT ALL PRIVILEGES ON nova_cell0.* TO 'nova'@'localhost' \ IDENTIFIED BY 'NOVA_DBPASS'; MariaDB [(none)]> GRANT ALL PRIVILEGES ON nova_cell0.* TO 'nova'@'%' \ IDENTIFIED BY 'NOVA_DBPASS'; 更换NOVA_DBPASS一个合适的密码。 退出数据库访问客户端。 2、输入admin凭据以访问仅管理CLI命令: $ . admin-openrc 3、创建计算服务凭据: 创建nova用户: $ openstack user create --domain default --password-prompt nova User Password: Repeat User Password: 将admin角色添加到nova用户: $ openstack role add --project service --user nova admin 创建nova服务实体: $ openstack service create --name nova \ --description "OpenStack Compute" compute 4、创建Compute API服务端点: $ openstack endpoint create --region RegionOne \ compute public http://controller:8774/v2.1 $ openstack endpoint create --region RegionOne \ compute internal http://controller:8774/v2.1 $ openstack endpoint create --region RegionOne \ compute admin http://controller:8774/v2.1 5、使用选择的PLACEMENT_PASS创建Placement服务: $ openstack user create --domain default --password-prompt placement User Password: Repeat User Password: 6、将Placement用户添加到具有管理角色的服务项目中: $ openstack role add --project service --user placement admin 7、在服务目录中创建Placement API条目: $ openstack service create --name placement --description "Placement API" placement 8、创建Placement API服务端点: $ openstack endpoint create --region RegionOne placement public http://controller:8778 $ openstack endpoint create --region RegionOne placement internal http://controller:8778 $ openstack endpoint create --region RegionOne placement adminhttp://controller:8778 1.1.1.1.2.2.安装和配置组件 1、安装软件包: # yum install openstack-nova-api openstack-nova-conductor \ openstack-nova-console openstack-nova-novncproxy \ openstack-nova-scheduler openstack-nova-placement-api 2、编辑/etc/nova/nova.conf文件并完成以下操作: 在该[DEFAULT]部分中,仅启用计算和元数据API: [DEFAULT] # ... enabled_apis = osapi_compute,metadata 在[api_database]和[database]部分中配置数据库访问: [api_database] # ... connection = mysql+pymysql://nova:NOVA_DBPASS@controller/nova_api [database] # ... connection = mysql+pymysql://nova:NOVA_DBPASS@controller/nova 替换NOVA_DBPASS为您选择的计算数据库的密码。 在本[DEFAULT]节中,配置RabbitMQ消息队列访问: [DEFAULT] # ... transport_url = rabbit://openstack:RABBIT_PASS@controller 替换RABBIT_PASS为您为该openstack帐户选择的密码RabbitMQ。 在[api]和[keystone_authtoken]部分中,配置身份服务访问: [api] # ... auth_strategy = keystone [keystone_authtoken] # ... auth_uri = http://controller:5000 auth_url = http://controller:35357 memcached_servers = controller:11211 auth_type = password project_domain_name = default user_domain_name = default project_name = service username = nova password = NOVA_PASS 替换NOVA_PASS为nova身份服务中为用户选择的密码 。 在该[DEFAULT]部分中,配置该my_ip选项以使用控制器节点的管理接口IP地址: [DEFAULT] # ... my_ip = 10.0.0.11 在本[DEFAULT]节中,启用对网络服务的支持: [DEFAULT] # ... use_neutron = True firewall_driver = nova.virt.firewall.NoopFirewallDriver 注意:默认情况下,Compute使用内部防火墙驱动程序。由于网络服务包含防火墙驱动程序,因此您必须使用nova.virt.firewall.NoopFirewallDriver防火墙驱动程序禁用Compute防火墙驱动 程序。 在本[vnc]节中,配置VNC代理以使用控制器节点的管理接口IP地址: [vnc] enabled = true # ... vncserver_listen = $my_ip vncserver_proxyclient_address = $my_ip 在该[glance]部分中,配置Image Service API的位置: [glance] # ... api_servers = http://controller:9292 在该[oslo_concurrency]部分中,配置锁定路径: [oslo_concurrency] # ... lock_path = /var/lib/nova/tmp 在本[placement]节中,配置Placement API: [placement] # ... os_region_name = RegionOne project_domain_name = Default project_name = service auth_type = password user_domain_name = Default auth_url = http://controller:35357/v3 username = placement password = PLACEMENT_PASS 替换PLACEMENT_PASS为placement身份服务中为用户选择的密码 。注释[placement]节中的任何其他选项。 启用对Placement API的访问,方法是将以下配置添加到/etc/httpd/conf.d/00-nova-placement-api.conf: <Directory /usr/bin> <IfVersion >= 2.4> Require all granted </IfVersion> <IfVersion < 2.4> Order allow,deny Allow from all </IfVersion> </Directory> 重新启动httpd服务: # systemctl restart httpd 3、填充nova-api数据库: # su -s /bin/sh -c "nova-manage api_db sync" nova 4、注册cell0数据库: # su -s /bin/sh -c "nova-manage cell_v2 map_cell0" nova 5、创建cell1单元格: # su -s /bin/sh -c "nova-manage cell_v2 create_cell --name=cell1 --verbose" nova 6、导入新星数据库: # su -s /bin/sh -c "nova-manage db sync" nova 7、验证nova cell0和cell1是否正确注册: # nova-manage cell_v2 list_cells 1.1.1.1.2.3.完成安装 启动Compute服务并将其配置为在系统启动时启动: # systemctl enable openstack-nova-api.service \ openstack-nova-consoleauth.service openstack-nova-scheduler.service \ openstack-nova-conductor.service openstack-nova-novncproxy.service # systemctl start openstack-nova-api.service \ openstack-nova-consoleauth.service openstack-nova-scheduler.service \ openstack-nova-conductor.service openstack-nova-novncproxy.service 本文转自yuweibing51CTO博客,原文链接:http://blog.51cto.com/yuweibing/1981178,如需转载请自行联系原作者

优秀的个人博客,低调大师

Openstack 安装部署指南翻译系列 之 网络

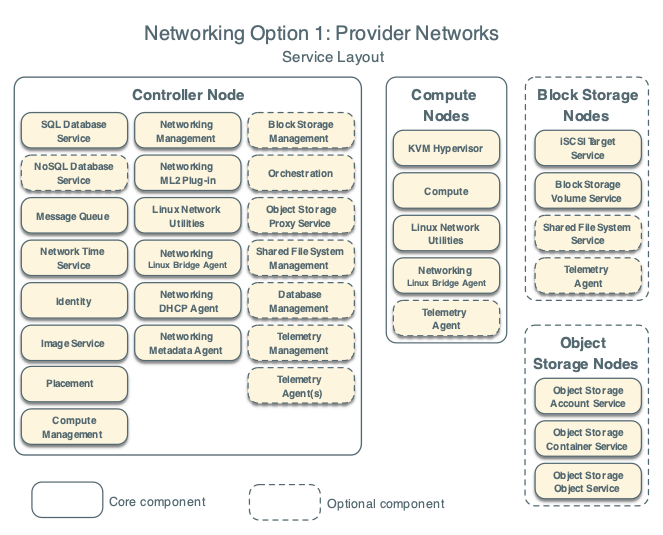
网络包括两种类型,网络选项1:提供商网络(Provider networks)和网络选项2:自助网络(Self-service networks),其中网络选项2:自助网络(Self-service networks)能够实现更加高级的网络功能,能够实现网络选项1的所有功能,因此我们的项目选择网络选项2:自助网络(Self-service networks)。以下是虚拟网络选项的说明: 1.1.1.1.网络选项1:提供商网络(Providernetworks) 提供商网络选项以最简单的方式部署OpenStack网络服务,主要是第2层(桥接/交换)服务和网络的VLAN分段。本质上,它将虚拟网络与物理网络相结合,并依赖物理网络基础设施进行第3层(路由)服务。另外,DHCP服务为实例提供IP地址信息。 OpenStack用户需要有关底层网络基础设施的更多信息来创建一个完全匹配基础架构的虚拟网络。 此选项不支持自助服务(私有)网络,第3层(路由)服务以及高级服务,如 LBaaS和 FWaaS。如果希望这些功能,需要自助服务网络选项(Self-service networks)。 1.1.1.1.网络选项2:自助网络(Self-service networks) 自助服务网络选项通过层次3(路由)服务来提供提供商网络选项,使服务网络能够使用覆盖分段方法(如VXLAN)。基本上,它使用NAT将虚拟网络路由到物理网络。此外,此选项为高级服务(如LBaaS和FWaaS)提供了基础。 OpenStack用户可以创建虚拟网络,而无需了解数据网络上的基础架构。如果相应地配置了第二层插件,这也可以包括VLAN网络。 ' 本文转自yuweibing51CTO博客,原文链接:http://blog.51cto.com/yuweibing/1981168 ,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册