首页 文章 精选 留言 我的

精选列表

搜索[端侧决策],共10011篇文章
优秀的个人博客,低调大师

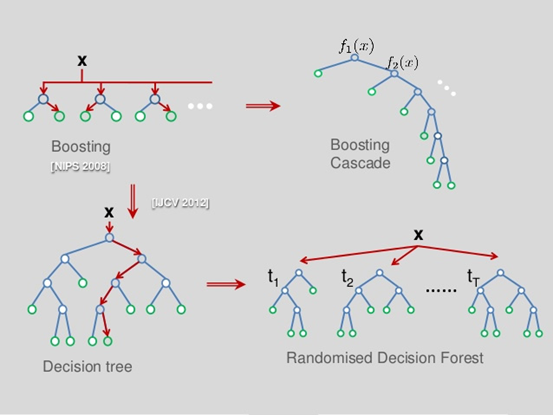
我的spark python 决策树实例

from numpy import array from pyspark.mllib.regression import LabeledPoint from pyspark.mllib.tree import DecisionTree, DecisionTreeModel from pyspark import SparkContext from pyspark.mllib.evaluation import BinaryClassificationMetrics sc = SparkContext(appName="PythonDecisionTreeClassificationExample") data = [ LabeledPoint(0.0, [0.0]), LabeledPoint(1.0, [1.0]), LabeledPoint(0.0, [-2.0]), LabeledPoint(0.0, [-1.0]), LabeledPoint(0.0, [-3.0]), LabeledPoint(1.0, [4.0]), LabeledPoint(1.0, [4.5]), LabeledPoint(1.0, [4.9]), LabeledPoint(1.0, [3.0]) ] all_data = sc.parallelize(data) (trainingData, testData) = all_data.randomSplit([0.8, 0.2]) # model = DecisionTree.trainClassifier(sc.parallelize(data), 2, {}) model = DecisionTree.trainClassifier(trainingData, numClasses=2, categoricalFeaturesInfo={}, impurity='gini', maxDepth=5, maxBins=32) print(model) print(model.toDebugString()) model.predict(array([1.0])) model.predict(array([0.0])) rdd = sc.parallelize([[1.0], [0.0]]) model.predict(rdd).collect() predictions = model.predict(testData.map(lambda x: x.features)) labelsAndPredictions = testData.map(lambda lp: lp.label).zip(predictions) predictionsAndLabels = predictions.zip(testData.map(lambda lp: lp.label)) metrics = BinaryClassificationMetrics(predictionsAndLabels) print "AUC=%f PR=%f" % (metrics.areaUnderROC, metrics.areaUnderPR) testErr = labelsAndPredictions.filter(lambda (v, p): v != p).count() / float(testData.count()) print('Test Error = ' + str(testErr)) print('Learned classification tree model:') print(model.toDebugString()) # Save and load model model.save(sc, "./myDecisionTreeClassificationModel") sameModel = DecisionTreeModel.load(sc, "./myDecisionTreeClassificationModel") 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/7151341.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

数据中心选址需要明智的决策

不久以前,数据中心是平淡无奇的设施。他们的业绩和企业价值是企业高管的一个谜。这同样适用于描述这些设施的语言:例如,能耗,容量,以及性能比较等。 如今,这些抽象的经营理念已经不再默默无闻。他们已经进入企业利益相关者的战略。这种变化部分就是更好地发挥财政资金的作用,在数据中心生命周期投入大量的资金。自20世纪80年代以来,企业在延长这些数据中心设施使用期限已投资数十亿美元。 通常在技术的推动下,数据中心已经转移了CFO和CIO的关注点。在多部门规划过程中,数据中心的长期运营要从财务,运营以及企业社会责任的角度适当的位置开始。 这似乎是显而易见的,数据中心避免建设在恶劣的天气条件或远离电力供应或缺乏能源的地点,但令人惊讶的是,往往这些因素没有足够的考虑。 获得一个很好的协议 从哪里开始?土地资本成本。如果一家企业对于数据中心建设的地点有自己的决定,那么通常避开了那些风险,企业管理者也应该知道出售给数据中心使用的土地溢价往往很高。几年前,微软公司为了其在爱荷华州建设的一个数据中心支付了600万美元,其土地成本其实只有100万美元,是以农业用途售出。而这些成本数字大幅增长,Facebook公司在达拉斯新收购的110英亩建设数据中心花费了更大的成本。 这种支出必须在整个项目的背景下考虑,因为成本是不可恢复的。鉴于微软公司的预算是11亿美元,在这个例子中,土地成本是总体成本的一小部分,但对于规模较小的组织来说,任何错误的决定都可能会破坏数据中心设施的未来盈利能力和商业价值。 在实施任何投资之前,必须考虑环境法规。这意味着进行环境影响评估,以评估和预测数据中心对周围环境的影响。虽然数据中心项目不太可能造成污染或化学风险。而这些法规也包括水资源的评估,这是数据中心设施的冷却系统的重要组成部分。 鉴于现代数据中心对冷却水的依赖,任何建设计划都必须符合节水条例。因此需要对数据中心建设地点的水资源可用性进行研究,考虑水的储存和可持续使用的做法。以苹果公司在内华达州的数据中心为例,该数据中心建在地下,可以更好利用当地的水资源。这种设计还可以使数据中心设施防止自然灾害。 而一些企业也利用了凉爽的气候,有助于降低能源成本,减少了对昂贵的机械冷却系统的依赖。也就是说,“自然冷却”并不总是正确的名称。当使用分析应用程序评估时,一些举措实际上花费最终比预期还要多。 在干旱地区建设数据中心要慎重的另一个原因是,尽管冰岛的气候寒冷,可再生能源丰富,似乎提供了成本效益,但其位置可能太偏僻了。微软公司认为,冰岛离大规模的人口中心太远,可能会有着更高的数据延迟。在决定数据中心的位置的时候,特别是那些跨洲际的数据中心枢纽“着陆区”,如贡希利地球数据中心的网络连接,因此网络的连通性是一个重要的考虑因素。 除了温度的考虑,有关气候和当地条件的风险必须在短期和长期评估。有机会获得历史气候数据,因此,在选址中要了解所在地的温度波动,可再生能源,水资源,以及利用环境的冷却能力对数据中心运行的影响。 提前规划 就数据中心的规划程序而言,错误的决定所带来的损失代价高昂,苹果公司发现,该公司投资9.4亿美元新在爱尔兰新建数据中心计划遭到了延误,当地人提出数据中心可能对环境有影响,并进行了投诉。在苹果公司的案例中,这是由于独立的计划小组负责评估该公司施工延迟的一个上诉案件。因此,企业在投资前需要了解任何潜在的规划异议和适用法规,以避免延误和不必要的成本。 电能将是数据中心设施的最高运营成本之一,而数据中心的位置可能受到能源价格的影响,这取决于是否来自火力发电的电网电力,还是可持续能源,如水电,风能和太阳能。在美国,每个州的能源价格都不尽相同,但与国际能源相价格相比,他们的价格一般都很低。 另一考虑是数据中心的电能情况:如果数据中心是远程的或正在新开发的,电力传输将必须被扩展,这增加了成本,并潜在地导致延误。另外,能源税也应该是分析和计算的一部分,所以确定本地税率和提供的任何激励措施都是至关重要的。能够得知未来税收的增加或减少是财务部门和运营部门一个非常有价值的能力。 这个过程对于数据中心服务提供商是至关重要的。因为数据中心运营利润率正在被挤压,数据中心设施的盈利能力取决于最大化可用空间、电能和容量。如果数据中心设计无法处理其最大可能的工作量,那么投资将永远不会达到它的潜力。任何能源成本的微小变化都会对未来的财务成功和商业治理产生巨大的影响。 能源成本对于数据中心运营来说是一个真正的威胁。毕竟,能源成本总是在不断变化。挪威宣布2016年为在该国建设和运营的数据中心的电力减免一些税费,这凸显了该国赢得更多的数据中心业务的决心。计划为用电量达到5兆瓦以上的数据中心削减96%的电力税费,这意味着在该国投资的数据中心年度电费将有重大改变的潜力。这是一个政策改变的势头,而芬兰的大型数据中心已经受益于其较低的能源税税率,而瑞典政府正在考虑针对数据中心和数据服务提供商实施减税97%的计划。 在美国52个州中,超过一半的州和其他司法管辖区相续推出他们的税收优惠政策,以鼓励数据中心运营商在当地投资。而数据中心运营商了解哪些州提供最好的税收优惠,并衡量他们对其他数据中心的选择标准是很重要的。 尽职调查需要考虑到一个数据中心所有不同的因素。但是,要实现一个称职的和负责任的评估,需要不同的情况下的分析和准确预测成本和/或性能水平的能力。 重要的是,这些模拟不仅要预测目前的状况;他们还必须考虑今后的变化,例如能源成本的增加和税收的减少,这有一个长期的影响。这样做将提供内置建模,模拟和预测数据中心的投资和运营性能的解决方案。 关于作者 理查·詹金斯是Romonet的市场营销和战略合作伙伴关系的高级副总裁。李察的销售和营销的职业生涯,包括从企业系统管理到物联网(IOT)-启用智能鞋类的角色。在离开皇家海军在1990,他曾在英国的IT分销商的发展渠道在EMEA地区,建设和销售一年IT承包商公司并提供给伦敦的银行咨询服务。 理查德·詹金斯是Romonet公司营销和战略合作伙伴关系的高级副总裁。理查德的销售和市场营销的职业生涯中角色,涵盖企业系统管理、物联网(IOT),以及互联网智能等。他曾为一家英国的IT分销商开发整个EMEA渠道,并在2000年IT承包商公司,并提供总部位于伦敦的银行IT咨询服务。 本文转自d1net(转载)

优秀的个人博客,低调大师

spark 针对决策树进行交叉验证

from pyspark import SparkContext, SQLContext from pyspark.ml import Pipeline from pyspark.ml.classification import DecisionTreeClassifier from pyspark.ml.feature import StringIndexer, VectorIndexer from pyspark.ml.evaluation import MulticlassClassificationEvaluator # Load the data stored in LIBSVM format as a DataFrame. data = sqlContext.read.format("libsvm").load("data/mllib/sample_libsvm_data.txt") # Index labels, adding metadata to the label column. # Fit on whole dataset to include all labels in index. labelIndexer = StringIndexer(inputCol="label", outputCol="indexedLabel").fit(data) # Automatically identify categorical features, and index them. # We specify maxCategories so features with > 4 distinct values are treated as continuous. featureIndexer =\ VectorIndexer(inputCol="features", outputCol="indexedFeatures", maxCategories=4).fit(data) # Split the data into training and test sets (30% held out for testing) (trainingData, testData) = data.randomSplit([0.7, 0.3]) # Train a DecisionTree model. dt = DecisionTreeClassifier(labelCol="indexedLabel", featuresCol="indexedFeatures") # Chain indexers and tree in a Pipeline pipeline = Pipeline(stages=[labelIndexer, featureIndexer, dt]) # Train model. This also runs the indexers. model = pipeline.fit(trainingData) # Make predictions. predictions = model.transform(testData) # Select example rows to display. predictions.select("prediction", "indexedLabel", "features").show(5) # Select (prediction, true label) and compute test error evaluator = MulticlassClassificationEvaluator( labelCol="indexedLabel", predictionCol="prediction", metricName="precision") accuracy = evaluator.evaluate(predictions) print("Test Error = %g " % (1.0 - accuracy)) treeModel = model.stages[2] # summary only print(treeModel) ############################# from pyspark.ml.tuning import ParamGridBuilder, CrossValidator # Create ParamGrid for Cross Validation paramGrid = (ParamGridBuilder() .addGrid(lr.regParam, [0.01, 0.5, 2.0]) .addGrid(lr.elasticNetParam, [0.0, 0.5, 1.0]) .addGrid(lr.maxIter, [1, 5, 10]) .build()) Copy to clipboardCopy # Create 5-fold CrossValidator cv = CrossValidator(estimator=lr, estimatorParamMaps=paramGrid, evaluator=evaluator, numFolds=5) # Run cross validations cvModel = cv.fit(trainingData) # this will likely take a fair amount of time because of the amount of models that we're creating and testing # Use test set here so we can measure the accuracy of our model on new data predictions = cvModel.transform(testData) # cvModel uses the best model found from the Cross Validation # Evaluate best model evaluator.evaluate(predictions) #We can also access the model’s feature weights and intercepts easily print 'Model Intercept: ', cvModel.bestModel.intercept ML provides CrossValidator class which can be used to perform cross-validation and parameter search. Assuming your data is already preprocessed you can add cross-validation as follows: import org.apache.spark.ml.Pipeline import org.apache.spark.ml.tuning.{ParamGridBuilder, CrossValidator} import org.apache.spark.ml.classification.RandomForestClassifier import org.apache.spark.ml.evaluation.MulticlassClassificationEvaluator // [label: double, features: vector] trainingData org.apache.spark.sql.DataFrame = ??? val nFolds: Int = ??? val NumTrees: Int = ??? val metric: String = ??? val rf = new RandomForestClassifier() .setLabelCol("label") .setFeaturesCol("features") .setNumTrees(NumTrees) val pipeline = new Pipeline().setStages(Array(rf)) val paramGrid = new ParamGridBuilder().build() // No parameter search val evaluator = new MulticlassClassificationEvaluator() .setLabelCol("label") .setPredictionCol("prediction") // "f1" (default), "weightedPrecision", "weightedRecall", "accuracy" .setMetricName(metric) val cv = new CrossValidator() // ml.Pipeline with ml.classification.RandomForestClassifier .setEstimator(pipeline) // ml.evaluation.MulticlassClassificationEvaluator .setEvaluator(evaluator) .setEstimatorParamMaps(paramGrid) .setNumFolds(nFolds) val model = cv.fit(trainingData) // trainingData: DataFrame Using PySpark: from pyspark.ml import Pipeline from pyspark.ml.classification import RandomForestClassifier from pyspark.ml.tuning import CrossValidator, ParamGridBuilder from pyspark.ml.evaluation import MulticlassClassificationEvaluator trainingData = ... # DataFrame[label: double, features: vector] numFolds = ... # Integer rf = RandomForestClassifier(labelCol="label", featuresCol="features") evaluator = MulticlassClassificationEvaluator() # + other params as in Scala pipeline = Pipeline(stages=[rf]) crossval = CrossValidator( estimator=pipeline, estimatorParamMaps=paramGrid, evaluator=evaluator, numFolds=numFolds) model = crossval.fit(trainingData) 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/7803849.html,如需转载请自行联系原作者

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册