首页 文章 精选 留言 我的

精选列表

搜索[然之],共10000篇文章
优秀的个人博客,低调大师

Linux命令之curl

获取http请求头信息,-I 只打印response header, -i 打印response header和body curl -I "http://www.jouypub.com" curl -i "http://www.jouypub.com" 使用代理 curl -x 1.193.162.91:8000 http://www.jouypub.com curl -x 1.193.162.91:8000 --connect-timeout 3 --max-time 10 http://www.jouypub.com 上传文件curl -F "filename=@/home/test/file.tar.gz" http://localhost/action.php -F参数,curl就会以 multipart/form-data 的方式发送POST请求。-F参数以name=value的方式来指定参数内容,如果值是一个文件,则需要以name=@file的方式来指定。 选项 -d 以post方式请求 -H 请求时添加header,冒号前后不能有空格 curl -H "name=abc" http://www.jouypub.com -o 结果输出到指定文件 curl -o /dev/null http://www.jouypub.com -m/--max-time 指定最大允许时间,单位秒 curl -m 20 http://www.jouypub.com --connect-timeout 连接超时,单位秒 curl --connect-timeout 5 http://www.jouypub.com

优秀的个人博客,低调大师

Java异常之IllegalMonitorStateException

JavaDoc Thrown to indicate that a thread has attempted to wait on an object's monitor or to notify other threads waiting on an object's monitor without owning the specified monitor. 其实意思就是说,也就是当前的线程不是此对象监视器的所有者。也就是要在当前线程锁定对象,才能用锁定的对象此行这些方法,需要用到synchronized ,锁定什么对象就用什么对象来执行 notify(), notifyAll(),wait(), wait(long), wait(long, int)操作,否则就会报IllegalMonitorStateException A thread becomes the owner of the object's monitor in one of three ways: 1. By executing a synchronized instance method of that object. 2. By executing the body of a synchronized statement that synchronizes on the object. 3. For objects of type Class, by executing a synchronized static method of that class. 通过以下三种方法之一,线程可以成为此对象监视器的所有者: 执行此对象的同步 (Sychronized) 实例方法 执行在此对象上进行同步的 synchronized 语句的正文 对于 Class 类型的对象,执行该类的同步静态方法 也就是在说,就是需要在调用wait()或者notify()之前,必须使用synchronized语义绑定住被wait/notify的对象。 解决方法: 通过实现加锁的方式实现线程同步时产生的并发问题 1 锁定方法所属的实例对象 public synchronized void method(){ //然后就可以调用:this.notify()... //或者直接调用notify()... } 2 锁定方法所属的实例的Class public Class Test{ public static synchronized void method(){ //然后调用:Test.class.notify()... } } 3 锁定其他对象 public Class Test{ public Object lock = new Object(); public static void method(){ synchronized (lock) { //需要调用 lock.notify(); } } } 总结 线程操作的wait()、notify()、notifyAll()只能在同步控制方法或同步控制块内调用 如果在非同步控制方法或控制块里调用,程序能通过编译,但运行的时候,将得到 IllegalMonitorStateException 异常,并伴随着一些含糊信息,比如 ‘当前线程不是拥有者’。 其实异常的含义是 调用wait()、notify()、notifyAll()的任务在调用这些方法前必须 ‘拥有’(获取)对象的锁。”

优秀的个人博客,低调大师

Java 基础 之 for 循环

http://www.verejava.com/?id=16992632674123 /** for 循环 定义 : for(初始化变量;判断条件;更新循环变量){} 执行过程: 1. 初始化变量 2. 执行判断条件, 如果true 继续执行,执行完后, 更新循环变量, 再判断条件, 直到 判断条件为 false 退出循环 */ public class ForStatement { public static void main(String[] args) { //打印出0-9 /* 执行过程: 1. 初始化i=0; 2. 执行 i<10 如果为true 执行 System.out.println(i); 执行完后 i++ 再跟 i<10 判断 以此循环直到 i>=10 退出循环 */ for (int i = 0; i < 10; i++) { System.out.println(i); } } } /* while, do while, for 循环的比较 1. while 循环是先判断再循环, do while 是先执行再判断 2. for 循环一般用于下标值访问的情况 问题: 如果我们要在循环的时候中途终止,或退出需要用到 break ,continue */ http://www.verejava.com/?id=16992632674123

优秀的个人博客,低调大师

python之常用模块

模块,用一堆代码实现了某个功能的代码的集合。 类似于函数式编程和面向过程编程,函数式编程则完成一个功能,其他代码用来调用即可,提供了代码的重用性和代码间的耦合。而对于一个复杂的功能来,可能需要多个函数才能完成(函数又可以在不同的.py文件中),n个 .py 文件组成的代码集合就称为模块。 如:os 是系统相关的模块;file是文件操作相关的模块 模块分为三种: 自定义模块 内置标准模块(又称标准库) 开源模块 自定义模块 1.定义模块 情境一: 在主目录下建立.py文件,根据实际需要能完成相应功能的文件 情景二: 在子目录下建立的.py文件 2.导入模块 Python之所以应用越来越广泛,在一定程度上也依赖于其为程序员提供了大量的模块以供使用,如果想要使用模块,则需要导入。导入模块有一下几种方法: 1 import module 2 from module.xx.xx import xx 3 from module.xx.xx import xx as rename 4 from module.xx.xx import * 导入模块其实就是告诉Python解释器去解释那个py文件 导入一个py文件,解释器解释该py文件 导入一个包,解释器解释该包下的 __init__.py 文件 那么问题来了,导入模块时是根据那个路径作为基准来进行的呢?即:sys.path import sys print sys.path 结果: ['/Users/wupeiqi/PycharmProjects/calculator/p1/pp1', '/usr/local/lib/python2.7/site-packages/setuptools-15.2-py2.7.egg', '/usr/local/lib/python2.7/site-packages/distribute-0.6.28-py2.7.egg', '/usr/local/lib/python2.7/site-packages/MySQL_python-1.2.4b4-py2.7-macosx-10.10-x86_64.egg', '/usr/local/lib/python2.7/site-packages/xlutils-1.7.1-py2.7.egg', '/usr/local/lib/python2.7/site-packages/xlwt-1.0.0-py2.7.egg', '/usr/local/lib/python2.7/site-packages/xlrd-0.9.3-py2.7.egg', '/usr/local/lib/python2.7/site-packages/tornado-4.1-py2.7-macosx-10.10-x86_64.egg', '/usr/local/lib/python2.7/site-packages/backports.ssl_match_hostname-3.4.0.2-py2.7.egg', '/usr/local/lib/python2.7/site-packages/certifi-2015.4.28-py2.7.egg', '/usr/local/lib/python2.7/site-packages/pyOpenSSL-0.15.1-py2.7.egg', '/usr/local/lib/python2.7/site-packages/six-1.9.0-py2.7.egg', '/usr/local/lib/python2.7/site-packages/cryptography-0.9.1-py2.7-macosx-10.10-x86_64.egg', '/usr/local/lib/python2.7/site-packages/cffi-1.1.1-py2.7-macosx-10.10-x86_64.egg', '/usr/local/lib/python2.7/site-packages/ipaddress-1.0.7-py2.7.egg', '/usr/local/lib/python2.7/site-packages/enum34-1.0.4-py2.7.egg', '/usr/local/lib/python2.7/site-packages/pyasn1-0.1.7-py2.7.egg', '/usr/local/lib/python2.7/site-packages/idna-2.0-py2.7.egg', '/usr/local/lib/python2.7/site-packages/pycparser-2.13-py2.7.egg', '/usr/local/lib/python2.7/site-packages/Django-1.7.8-py2.7.egg', '/usr/local/lib/python2.7/site-packages/paramiko-1.10.1-py2.7.egg', '/usr/local/lib/python2.7/site-packages/gevent-1.0.2-py2.7-macosx-10.10-x86_64.egg', '/usr/local/lib/python2.7/site-packages/greenlet-0.4.7-py2.7-macosx-10.10-x86_64.egg', '/Users/wupeiqi/PycharmProjects/calculator', '/usr/local/Cellar/python/2.7.9/Frameworks/Python.framework/Versions/2.7/lib/python27.zip', '/usr/local/Cellar/python/2.7.9/Frameworks/Python.framework/Versions/2.7/lib/python2.7', '/usr/local/Cellar/python/2.7.9/Frameworks/Python.framework/Versions/2.7/lib/python2.7/plat-darwin', '/usr/local/Cellar/python/2.7.9/Frameworks/Python.framework/Versions/2.7/lib/python2.7/plat-mac', '/usr/local/Cellar/python/2.7.9/Frameworks/Python.framework/Versions/2.7/lib/python2.7/plat-mac/lib-scriptpackages', '/usr/local/Cellar/python/2.7.9/Frameworks/Python.framework/Versions/2.7/lib/python2.7/lib-tk', '/usr/local/Cellar/python/2.7.9/Frameworks/Python.framework/Versions/2.7/lib/python2.7/lib-old', '/usr/local/Cellar/python/2.7.9/Frameworks/Python.framework/Versions/2.7/lib/python2.7/lib-dynload', '/usr/local/lib/python2.7/site-packages', '/Library/Python/2.7/site-packages'] 如果sys.path路径列表没有你想要的路径,可以通过 sys.path.append('路径') 添加。通过os模块可以获取各种目录,例如: import sys import os pre_path = os.path.abspath('../') sys.path.append(pre_path) View Code 开源模块 一、下载安装 yum pip apt-get ... View Code 下载源码 解压源码 进入目录 编译源码 python setup.py build 安装源码 python setup.py install View Code 注:在使用源码安装时,需要使用到gcc编译和python开发环境,所以,需要先执行: yum install gcc yum install python-devel 或 apt-get python-dev View Code 安装成功后,模块会自动安装到 sys.path 中的某个目录中,如: /usr/lib/python2.7/site-packages/ 二、导入模块 同自定义模块中导入的方式 还有一个模块 paramiko,paramiko是一个用于做远程控制的模块,使用该模块可以对远程服务器进行命令或文件操作,值得一说的是,fabric和ansible内部的远程管理就是使用的paramiko来现实。(不是很了解) 内置模块 一、os 用于提供系统级别的操作 os.getcwd() 获取当前工作目录,即当前python脚本工作的目录路径 os.chdir("dirname") 改变当前脚本工作目录;相当于shell下cd os.curdir 返回当前目录: ('.') os.pardir 获取当前目录的父目录字符串名:('..') os.makedirs('dirname1/dirname2') 可生成多层递归目录 os.removedirs('dirname1') 若目录为空,则删除,并递归到上一级目录,如若也为空,则删除,依此类推 os.mkdir('dirname') 生成单级目录;相当于shell中mkdir dirname os.rmdir('dirname') 删除单级空目录,若目录不为空则无法删除,报错;相当于shell中rmdir dirname os.listdir('dirname') 列出指定目录下的所有文件和子目录,包括隐藏文件,并以列表方式打印 os.remove() 删除一个文件 os.rename("oldname","newname") 重命名文件/目录 os.stat('path/filename') 获取文件/目录信息 os.sep 输出操作系统特定的路径分隔符,win下为"\\",Linux下为"/" os.linesep 输出当前平台使用的行终止符,win下为"\t\n",Linux下为"\n" os.pathsep 输出用于分割文件路径的字符串 os.name 输出字符串指示当前使用平台。win->'nt'; Linux->'posix' os.system("bash command") 运行shell命令,直接显示 os.environ 获取系统环境变量 os.path.abspath(path) 返回path规范化的绝对路径 os.path.split(path) 将path分割成目录和文件名二元组返回 os.path.dirname(path) 返回path的目录。其实就是os.path.split(path)的第一个元素 os.path.basename(path) 返回path最后的文件名。如何path以/或\结尾,那么就会返回空值。即os.path.split(path)的第二个元素 os.path.exists(path) 如果path存在,返回True;如果path不存在,返回False os.path.isabs(path) 如果path是绝对路径,返回True os.path.isfile(path) 如果path是一个存在的文件,返回True。否则返回False os.path.isdir(path) 如果path是一个存在的目录,则返回True。否则返回False os.path.join(path1[, path2[, ...]]) 将多个路径组合后返回,第一个绝对路径之前的参数将被忽略 os.path.getatime(path) 返回path所指向的文件或者目录的最后存取时间 os.path.getmtime(path) 返回path所指向的文件或者目录的最后修改时间 官方源码 二、sys 用于提供对解释器相关的操作 sys.argv 命令行参数List,第一个元素是程序本身路径 sys.exit(n) 退出程序,正常退出时exit(0) sys.version 获取Python解释程序的版本信息 sys.maxint 最大的Int值 sys.path 返回模块的搜索路径,初始化时使用PYTHONPATH环境变量的值 sys.platform 返回操作系统平台名称 sys.stdout.write('please:') val = sys.stdin.readline()[:-1] 官方源码 三、hashlib 用于加密相关的操作,代替了md5模块和sha模块,主要提供SHA1, SHA224, SHA256, SHA384, SHA512 ,MD5 算法 import hashlib # ######## md5 ######## hash = hashlib.md5() hash.update('admin') print hash.hexdigest() # ######## sha1 ######## hash = hashlib.sha1() hash.update('admin') print hash.hexdigest() # ######## sha256 ######## hash = hashlib.sha256() hash.update('admin') print hash.hexdigest() # ######## sha384 ######## hash = hashlib.sha384() hash.update('admin') print hash.hexdigest() # ######## sha512 ######## hash = hashlib.sha512() hash.update('admin') print hash.hexdigest() 以上加密算法虽然依然非常厉害,但时候存在缺陷,即:通过撞库可以反解。所以,有必要对加密算法中添加自定义key再来做加密。 import hashlib # ######## md5 ######## hash = hashlib.md5('898oaFs09f') hash.update('admin') print hash.hexdigest() 更高及的另一种加密方式,python 还有一个 hmac 模块,它内部对我们创建 key 和 内容 再进行处理然后再加密. import hmac h = hmac.new('wueiqi') h.update('hellowo') print h.hexdigest() 四、json 和pickle 可以参考上一篇中的内容https://www.cnblogs.com/Young111/p/9298627.html 五、shutil 高级的 文件、文件夹、压缩包 处理模块 shutil.copyfileobj(fsrc, fdst[, length])将文件内容拷贝到另一个文件中,可以部分内容. def copyfileobj(fsrc, fdst, length=16*1024): """copy data from file-like object fsrc to file-like object fdst""" while 1: buf = fsrc.read(length) if not buf: break fdst.write(buf) View Code shutil.copyfile(src, dst)拷贝文件 def copyfile(src, dst): """Copy data from src to dst""" if _samefile(src, dst): raise Error("`%s` and `%s` are the same file" % (src, dst)) for fn in [src, dst]: try: st = os.stat(fn) except OSError: # File most likely does not exist pass else: # XXX What about other special files? (sockets, devices...) if stat.S_ISFIFO(st.st_mode): raise SpecialFileError("`%s` is a named pipe" % fn) with open(src, 'rb') as fsrc: with open(dst, 'wb') as fdst: copyfileobj(fsrc, fdst) View Code shutil.copymode(src, dst)仅拷贝权限。内容、组、用户均不变 def copymode(src, dst): """Copy mode bits from src to dst""" if hasattr(os, 'chmod'): st = os.stat(src) mode = stat.S_IMODE(st.st_mode) os.chmod(dst, mode) View Code shutil.copystat(src, dst)拷贝状态的信息,包括:mode bits, atime, mtime, flags def copystat(src, dst): """Copy all stat info (mode bits, atime, mtime, flags) from src to dst""" st = os.stat(src) mode = stat.S_IMODE(st.st_mode) if hasattr(os, 'utime'): os.utime(dst, (st.st_atime, st.st_mtime)) if hasattr(os, 'chmod'): os.chmod(dst, mode) if hasattr(os, 'chflags') and hasattr(st, 'st_flags'): try: os.chflags(dst, st.st_flags) except OSError, why: for err in 'EOPNOTSUPP', 'ENOTSUP': if hasattr(errno, err) and why.errno == getattr(errno, err): break else: raise View Code shutil.copy(src, dst)拷贝文件和权限 def copy(src, dst): """Copy data and mode bits ("cp src dst"). The destination may be a directory. """ if os.path.isdir(dst): dst = os.path.join(dst, os.path.basename(src)) copyfile(src, dst) copymode(src, dst) View Code shutil.copy2(src, dst)拷贝文件和状态信息 def copy2(src, dst): """Copy data and all stat info ("cp -p src dst"). The destination may be a directory. """ if os.path.isdir(dst): dst = os.path.join(dst, os.path.basename(src)) copyfile(src, dst) copystat(src, dst) View Code shutil.ignore_patterns(*patterns)shutil.copytree(src, dst, symlinks=False, ignore=None)递归的去拷贝文件 例如:copytree(source, destination, ignore=ignore_patterns('*.pyc', 'tmp*') shutil.rmtree(path[, ignore_errors[, onerror]])递归的去删除文件 shutil.make_archive(base_name, format,...) 创建压缩包并返回文件路径,例如:zip、tar base_name: 压缩包的文件名,也可以是压缩包的路径。只是文件名时,则保存至当前目录,否则保存至指定路径,如:www =>保存至当前路径如:/Users/wupeiqi/www =>保存至/Users/wupeiqi/ format: 压缩包种类,“zip”, “tar”, “bztar”,“gztar” root_dir: 要压缩的文件夹路径(默认当前目录) owner: 用户,默认当前用户 group: 组,默认当前组 logger: 用于记录日志,通常是logging.Logger对象 #将 /Users/young/Downloads/test 下的文件打包放置当前程序目录 import shutil ret = shutil.make_archive("dddddd", 'gztar', root_dir='/Users/young/Downloads/test') #将 /Users/wupeiqi/Downloads/test 下的文件打包放置 /Users/wupeiqi/目录 import shutil ret = shutil.make_archive("/Users/young/dddddd", 'gztar', root_dir='/Users/young/Downloads/test') View Code shutil 对压缩包的处理是调用 ZipFile 和 TarFile 两个模块来进行的,详细: import zipfile # 压缩 z = zipfile.ZipFile('laxi.zip', 'w') z.write('a.log') z.write('data.data') z.close() # 解压 z = zipfile.ZipFile('laxi.zip', 'r') z.extractall() z.close() zipfile压缩解压 import tarfile # 压缩 tar = tarfile.open('your.tar','w') tar.add('/Users/wupeiqi/PycharmProjects/bbs2.zip', arcname='bbs2.zip') tar.add('/Users/wupeiqi/PycharmProjects/cmdb.zip', arcname='cmdb.zip') tar.close() # 解压 tar = tarfile.open('your.tar','r') tar.extractall() # 可设置解压地址 tar.close() tarfile压缩解压 六、shelve shelve模块是一个简单的k,v将内存数据通过文件持久化的模块,可以持久化任何pickle可支持的python数据格式 import shelve d = shelve.open('shelve_test') #打开一个文件 class Test(object): def __init__(self,n): self.n = n t = Test(123) t2 = Test(123334) name = ["young","Jon","test"] d["test"] = name #持久化列表 d["t1"] = t #持久化类 d["t2"] = t2 d.close() View Code 七、xml xml是实现不同语言或程序之间进行数据交换的协议,跟json差不多,但json使用起来更简单,不过,古时候,在json还没诞生的黑暗年代,大家只能选择用xml呀,至今很多传统公司如金融行业的很多系统的接口还主要是xml。 xml的格式如下,就是通过<>节点来区别数据结构的: <?xml version="1.0"?> <data> <country name="Liechtenstein"> <rank updated="yes">2</rank> <year>2008</year> <gdppc>141100</gdppc> <neighbor name="Austria" direction="E"/> <neighbor name="Switzerland" direction="W"/> </country> <country name="Singapore"> <rank updated="yes">5</rank> <year>2011</year> <gdppc>59900</gdppc> <neighbor name="Malaysia" direction="N"/> </country> <country name="Panama"> <rank updated="yes">69</rank> <year>2011</year> <gdppc>13600</gdppc> <neighbor name="Costa Rica" direction="W"/> <neighbor name="Colombia" direction="E"/> </country> </data> View Code xml协议在各个语言里的都 是支持的,在python中可以用以下模块操作xml import xml.etree.ElementTree as ET tree = ET.parse("xmltest.xml") root = tree.getroot() print(root.tag) #遍历xml文档 for child in root: print(child.tag, child.attrib) for i in child: print(i.tag,i.text) #只遍历year 节点 for node in root.iter('year'): print(node.tag,node.text) View Code 修改和删除xml文件 import xml.etree.ElementTree as ET tree = ET.parse("xmltest.xml") root = tree.getroot() #修改 for node in root.iter('year'): new_year = int(node.text) + 1 node.text = str(new_year) node.set("updated","yes") tree.write("xmltest.xml") #删除node for country in root.findall('country'): rank = int(country.find('rank').text) if rank > 50: root.remove(country) tree.write('output.xml') View Code 自己创建xml文档 import xml.etree.ElementTree as ET new_xml = ET.Element("namelist") name = ET.SubElement(new_xml,"name",attrib={"enrolled":"yes"}) age = ET.SubElement(name,"age",attrib={"checked":"no"}) sex = ET.SubElement(name,"sex") sex.text = '33' name2 = ET.SubElement(new_xml,"name",attrib={"enrolled":"no"}) age = ET.SubElement(name2,"age") age.text = '19' et = ET.ElementTree(new_xml) #生成文档对象 et.write("test.xml", encoding="utf-8",xml_declaration=True) ET.dump(new_xml) #打印生成的格式 View Code 八、PyYAML 参考文档:http://pyyaml.org/wiki/PyYAMLDocumentation 九、ConfigParser 用于对特定的配置进行操作,当前模块的名称在 python 3.x 版本中变更为 configparser。 # 注释1 ; 注释2 [section1] k1 = v1 k2:v2 [section2] k1 = v1 import ConfigParser config = ConfigParser.ConfigParser() config.read('i.cfg') # ########## 读 ########## #secs = config.sections() #print secs #options = config.options('group2') #print options #item_list = config.items('group2') #print item_list #val = config.get('group1','key') #val = config.getint('group1','key') # ########## 改写 ########## #sec = config.remove_section('group1') #config.write(open('i.cfg', "w")) #sec = config.has_section('wupeiqi') #sec = config.add_section('wupeiqi') #config.write(open('i.cfg', "w")) #config.set('group2','k1',11111) #config.write(open('i.cfg', "w")) #config.remove_option('group2','age') #config.write(open('i.cfg', "w")) View Code 十、logging 用于便捷记录日志且线程安全的模块,logging的日志可以分为debug(),info(),warning(),error()andcritical()5个级别,下面我们看一下怎么用。 import logging logging.basicConfig(filename='log.log', format='%(asctime)s - %(name)s - %(levelname)s -%(module)s: %(message)s', datefmt='%Y-%m-%d %H:%M:%S %p', level=10) logging.debug('debug') logging.info('info') logging.warning('warning') logging.error('error') logging.critical('critical') logging.log(10,'log') 相应等级: 1 CRITICAL = 50 2 FATAL = CRITICAL 3 ERROR = 40 4 WARNING = 30 5 WARN = WARNING 6 INFO = 20 7 DEBUG = 10 日志格式: %(name)s Logger的名字 %(levelno)s 数字形式的日志级别 %(levelname)s 文本形式的日志级别 %(pathname)s 调用日志输出函数的模块的完整路径名,可能没有 %(filename)s 调用日志输出函数的模块的文件名 %(module)s 调用日志输出函数的模块名 %(funcName)s 调用日志输出函数的函数名 %(lineno)d 调用日志输出函数的语句所在的代码行 %(created)f 当前时间,用UNIX标准的表示时间的浮 点数表示 %(relativeCreated)d 输出日志信息时的,自Logger创建以 来的毫秒数 %(asctime)s 字符串形式的当前时间。默认格式是 “2003-07-08 16:49:45,896”。逗号后面的是毫秒 %(thread)d 线程ID。可能没有 %(threadName)s 线程名。可能没有 %(process)d 进程ID。可能没有 %(message)s 用户输出的消息 如果想同时把log打印在屏幕和文件日志里,就需要了解一点复杂的知识 了 Python 使用logging模块记录日志涉及四个主要类,使用官方文档中的概括最为合适: logger提供了应用程序可以直接使用的接口; handler将(logger创建的)日志记录发送到合适的目的输出; filter提供了细度设备来决定输出哪条日志记录; formatter决定日志记录的最终输出格式。 logger每个程序在输出信息之前都要获得一个Logger。Logger通常对应了程序的模块名,比如聊天工具的图形界面模块可以这样获得它的Logger:LOG=logging.getLogger(”chat.gui”)而核心模块可以这样:LOG=logging.getLogger(”chat.kernel”) Logger.setLevel(lel):指定最低的日志级别,低于lel的级别将被忽略。debug是最低的内置级别,critical为最高Logger.addFilter(filt)、Logger.removeFilter(filt):添加或删除指定的filterLogger.addHandler(hdlr)、Logger.removeHandler(hdlr):增加或删除指定的handlerLogger.debug()、Logger.info()、Logger.warning()、Logger.error()、Logger.critical():可以设置的日志级别 handler handler对象负责发送相关的信息到指定目的地。Python的日志系统有多种Handler可以使用。有些Handler可以把信息输出到控制台,有些Logger可以把信息输出到文件,还有些 Handler可以把信息发送到网络上。如果觉得不够用,还可以编写自己的Handler。可以通过addHandler()方法添加多个多handlerHandler.setLevel(lel):指定被处理的信息级别,低于lel级别的信息将被忽略Handler.setFormatter():给这个handler选择一个格式Handler.addFilter(filt)、Handler.removeFilter(filt):新增或删除一个filter对象 每个Logger可以附加多个Handler。接下来我们就来介绍一些常用的Handler:1) logging.StreamHandler使用这个Handler可以向类似与sys.stdout或者sys.stderr的任何文件对象(file object)输出信息。它的构造函数是:StreamHandler([strm])其中strm参数是一个文件对象。默认是sys.stderr 2) logging.FileHandler和StreamHandler类似,用于向一个文件输出日志信息。不过FileHandler会帮你打开这个文件。它的构造函数是:FileHandler(filename[,mode])filename是文件名,必须指定一个文件名。mode是文件的打开方式。参见Python内置函数open()的用法。默认是’a',即添加到文件末尾。 3) logging.handlers.RotatingFileHandler这个Handler类似于上面的FileHandler,但是它可以管理文件大小。当文件达到一定大小之后,它会自动将当前日志文件改名,然后创建 一个新的同名日志文件继续输出。比如日志文件是chat.log。当chat.log达到指定的大小之后,RotatingFileHandler自动把 文件改名为chat.log.1。不过,如果chat.log.1已经存在,会先把chat.log.1重命名为chat.log.2。。。最后重新创建 chat.log,继续输出日志信息。它的构造函数是:RotatingFileHandler( filename[, mode[, maxBytes[, backupCount]]])其中filename和mode两个参数和FileHandler一样。maxBytes用于指定日志文件的最大文件大小。如果maxBytes为0,意味着日志文件可以无限大,这时上面描述的重命名过程就不会发生。backupCount用于指定保留的备份文件的个数。比如,如果指定为2,当上面描述的重命名过程发生时,原有的chat.log.2并不会被更名,而是被删除。 4) logging.handlers.TimedRotatingFileHandler这个Handler和RotatingFileHandler类似,不过,它没有通过判断文件大小来决定何时重新创建日志文件,而是间隔一定时间就 自动创建新的日志文件。重命名的过程与RotatingFileHandler类似,不过新的文件不是附加数字,而是当前时间。它的构造函数是:TimedRotatingFileHandler( filename [,when [,interval [,backupCount]]])其中filename参数和backupCount参数和RotatingFileHandler具有相同的意义。interval是时间间隔。when参数是一个字符串。表示时间间隔的单位,不区分大小写。它有以下取值:S 秒M 分H 小时D 天W 每星期(interval==0时代表星期一)midnight 每天凌晨 1 import logging 2 3 #create logger 4 logger = logging.getLogger('TEST-LOG') 5 logger.setLevel(logging.DEBUG) 6 7 8 # create console handler and set level to debug 9 ch = logging.StreamHandler() 10 ch.setLevel(logging.DEBUG) 11 12 # create file handler and set level to warning 13 fh = logging.FileHandler("access.log") 14 fh.setLevel(logging.WARNING) 15 # create formatter 16 formatter = logging.Formatter('%(asctime)s - %(name)s - %(levelname)s - %(message)s') 17 18 # add formatter to ch and fh 19 ch.setFormatter(formatter) 20 fh.setFormatter(formatter) 21 22 # add ch and fh to logger 23 logger.addHandler(ch) 24 logger.addHandler(fh) 25 26 # 'application' code 27 logger.debug('debug message') 28 logger.info('info message') 29 logger.warn('warn message') 30 logger.error('error message') 31 logger.critical('critical message') View Code 文件自动截断例子: import logging from logging import handlers logger = logging.getLogger(__name__) log_file = "timelog.log" #fh = handlers.RotatingFileHandler(filename=log_file,maxBytes=10,backupCount=3) fh = handlers.TimedRotatingFileHandler(filename=log_file,when="S",interval=5,backupCount=3) formatter = logging.Formatter('%(asctime)s %(module)s:%(lineno)d %(message)s') fh.setFormatter(formatter) logger.addHandler(fh) logger.warning("test1") logger.warning("test12") logger.warning("test13") logger.warning("test14") View Code 十一、re 常用的正则表达式 1 '.' 默认匹配除\n之外的任意一个字符,若指定flag DOTALL,则匹配任意字符,包括换行 2 '^' 匹配字符开头,若指定flags MULTILINE,这种也可以匹配上(r"^a","\nabc\neee",flags=re.MULTILINE) 3 '$' 匹配字符结尾,或e.search("foo$","bfoo\nsdfsf",flags=re.MULTILINE).group()也可以 4 '*' 匹配*号前的字符0次或多次,re.findall("ab*","cabb3abcbbac") 结果为['abb', 'ab', 'a'] 5 '+' 匹配前一个字符1次或多次,re.findall("ab+","ab+cd+abb+bba") 结果['ab', 'abb'] 6 '?' 匹配前一个字符1次或0次 7 '{m}' 匹配前一个字符m次 8 '{n,m}' 匹配前一个字符n到m次,re.findall("ab{1,3}","abb abc abbcbbb") 结果'abb', 'ab', 'abb'] 9 '|' 匹配|左或|右的字符,re.search("abc|ABC","ABCBabcCD").group() 结果'ABC' 10 '(...)' 分组匹配,re.search("(abc){2}a(123|456)c", "abcabca456c").group() 结果 abcabca456c 11 12 13 '\A' 只从字符开头匹配,re.search("\Aabc","alexabc") 是匹配不到的 14 '\Z' 匹配字符结尾,同$ 15 '\d' 匹配数字0-9 16 '\D' 匹配非数字 17 '\w' 匹配[A-Za-z0-9] 18 '\W' 匹配非[A-Za-z0-9] 19 's' 匹配空白字符、\t、\n、\r , re.search("\s+","ab\tc1\n3").group() 结果 '\t' 20 21 '(?P<name>...)' 分组匹配 re.search("(?P<province>[0-9]{4})(?P<city>[0-9]{2})(?P<birthday>[0-9]{4})","371481199306143242").groupdict("city") 结果{'province': '3714', 'city': '81', 'birthday': '1993'} 最常用的匹配语法 re.match 从头开始匹配 re.search 匹配包含 re.findall 把所有匹配到的字符放到以列表中的元素返回 re.splitall 以匹配到的字符当做列表分隔符 re.sub 匹配字符并替换 仅需轻轻知道的几个匹配模式 re.I(re.IGNORECASE): 忽略大小写(括号内是完整写法,下同) M(MULTILINE): 多行模式,改变'^'和'$'的行为(参见上图) S(DOTALL): 点任意匹配模式,改变'.'的行为 十二、time 时间相关的操作,时间有三种表示方式: 时间戳 1970年1月1日之后的秒,即:time.time() 格式化的字符串 2014-11-11 11:11, 即:time.strftime('%Y-%m-%d') 结构化时间 元组包含了:年、日、星期等... time.struct_time 即:time.localtime() 1 print time.time() 2 print time.mktime(time.localtime()) 3 4 print time.gmtime() #可加时间戳参数 5 print time.localtime() #可加时间戳参数 6 print time.strptime('2014-11-11', '%Y-%m-%d') 7 8 print time.strftime('%Y-%m-%d') #默认当前时间 9 print time.strftime('%Y-%m-%d',time.localtime()) #默认当前时间 10 print time.asctime() 11 print time.asctime(time.localtime()) 12 print time.ctime(time.time()) 13 14 import datetime 15 ''' 16 datetime.date:表示日期的类。常用的属性有year, month, day 17 datetime.time:表示时间的类。常用的属性有hour, minute, second, microsecond 18 datetime.datetime:表示日期时间 19 datetime.timedelta:表示时间间隔,即两个时间点之间的长度 20 timedelta([days[, seconds[, microseconds[, milliseconds[, minutes[, hours[, weeks]]]]]]]) 21 strftime("%Y-%m-%d") 22 ''' 23 import datetime 24 print datetime.datetime.now() 25 print datetime.datetime.now() - datetime.timedelta(days=5) View Code 十三、random 随机数 mport random print random.random() print random.randint(1,2) print random.randrange(1,10) 随机验证码例子: import random checkcode = '' for i in range(4): current = random.randrange(0,4) if current != i: temp = chr(random.randint(65,90)) else: temp = random.randint(0,9) checkcode += str(temp) print checkcode


优秀的个人博客,低调大师

Java 基础 之 常量

http://www.verejava.com/?id=16992564786810 /* java中常量分为以下几种 1. 整型常量 2. 浮点数常量 3. 字符常量 4. 布尔型常量 5. 字符串常量 */ public class FinalVariable { public static void main(String[] args) { //常量的定义:不可以改变的变量 //1. 整型常量 final int UP=0; final int DOWN=1; final int LEFT=2; final int RIGHT=3; System.out.println(UP); System.out.println(DOWN); System.out.println(LEFT); System.out.println(RIGHT); /* 注意: 1. 常量的定义一般用大写 */ //2. 浮点数常量 final float PI=3.14f; System.out.println(PI); //3. 布尔常量 final boolean RUN=true; System.out.println(RUN); //4. 字符常量 final char A='A'; System.out.println(A); System.out.println('\r'); System.out.println('\''); System.out.println('\"'); System.out.println('\\'); //5. 字符串常量 final String CONST="情意地久天长"; System.out.println(CONST); } } /* 总结: 1. 常量的命名规则跟变量一样 2. 常量一般大写 3. 常量前面加 final 关键字 4. 常量不能改变值 */ http://www.verejava.com/?id=16992564786810

优秀的个人博客,低调大师

Java 基础 之 变量

http://www.verejava.com/?id=1699255231918 /* 注意: 1. 变量命名不允许重复 2. 变量的命名规则: 以字符,下划线,$ ,数字组成,并且开始首字母必须为 字符,下滑线或$ 不能是数字 */ public class TestVariable { public static void main(String[] args) { //变量的定义: 系统分配的一块内存区用来存储数据的地方 //String 存储数据的类型 字符串 : 以双引号" " 括起来的字符或汉字等 //bottle 变量名 //等号 = 代表赋值 也就是说将 "矿泉水" 数据存储到 名称为 bottle的内存区域中 String bottle="矿泉水"; //将变量名为bottle内存区域的数据打印输出到控制台上 System.out.println(bottle); //修改变量的值, 将 "果汁" 替换了bottle内存区域的值 bottle="果汁"; System.out.println(bottle); //清空变量, 清空bottle的内存数据 bottle=""; System.out.println(bottle); //删除变量, 赋值给null值删除变量, 这个时候垃圾回收器 GC 如果扫描到 //bottle 变量会自动回收分配的内存空间 bottle=null; System.out.println(bottle); //注意: //1.变量名是不能重复定义的, 否则编译不能通过 //String bottle="牛奶"; //System.out.println(bottle); //变量的命名规则: 以字符,下划线,$ ,数字组成,并且开始首字母必须为 字符,下滑线或$ 不能是数字 //String 1a="a"; //System.out.println(1a); String $b="b"; System.out.println($b); String _c="c"; System.out.println(_c); } } http://www.verejava.com/?id=1699255231918

优秀的个人博客,低调大师

Java之Https请求

import java.io.BufferedReader; import java.io.InputStream; import java.io.InputStreamReader; import java.io.OutputStream; import java.net.URL; import java.security.cert.CertificateException; import java.security.cert.X509Certificate; import javax.net.ssl.HttpsURLConnection; import javax.net.ssl.SSLContext; import javax.net.ssl.SSLSocketFactory; import javax.net.ssl.TrustManager; import javax.net.ssl.X509TrustManager; public class testHttps implements X509TrustManager { public void checkClientTrusted(X509Certificate[] arg0, String arg1) throws CertificateException { // TODO Auto-generated method stub } public void checkServerTrusted(X509Certificate[] arg0, String arg1) throws CertificateException { // TODO Auto-generated method stub } public X509Certificate[] getAcceptedIssuers() { // TODO Auto-generated method stub return null; } public static String httpsRequest(String requestUrl,String requestMethod,String outputStr){ StringBuffer buffer=null; try{ //创建SSLContext SSLContext sslContext=SSLContext.getInstance("SSL"); TrustManager[] tm={new testHttps()}; //初始化 sslContext.init(null, tm, new java.security.SecureRandom());; //获取SSLSocketFactory对象 SSLSocketFactory ssf=sslContext.getSocketFactory(); URL url=new URL(requestUrl); HttpsURLConnection conn=(HttpsURLConnection)url.openConnection(); conn.setDoOutput(true); conn.setDoInput(true); conn.setUseCaches(false); conn.setRequestMethod(requestMethod); //设置当前实例使用的SSLSoctetFactory conn.setSSLSocketFactory(ssf); conn.connect(); //往服务器端写内容 if(null!=outputStr){ OutputStream os=conn.getOutputStream(); os.write(outputStr.getBytes("utf-8")); os.close(); } //读取服务器端返回的内容 InputStream is=conn.getInputStream(); InputStreamReader isr=new InputStreamReader(is,"utf-8"); BufferedReader br=new BufferedReader(isr); buffer=new StringBuffer(); String line=null; while((line=br.readLine())!=null){ buffer.append(line); } }catch(Exception e){ e.printStackTrace(); } return buffer.toString(); } public static void main(String[] args) { String s=httpsRequest("https://www.baidu.com","GET",null); System.out.println(s); } } 上述代码运行main方法后,直接返回百度的html界面 也就是大家常见的如下界面: 关于https请求,以及它和http请求的区别等,可以参考百度百科:https://baike.baidu.com/item/https/285356?fr=aladdin 至于如何https请求不再多说,秘密都在javax.net.ssl这个包及其包下对应的类。 Java同很多例如Ruby,Python等高级语言一样,很多底层的东西基本都是封装好的。作为开发者熟知api,根据业务的需要,导入对应的包,调用对应的方法完成需求。 当然,作为初级程序员而言知道哪些api比较常用,完成工作任务或者学习任务即可,但是作为中级程序员而言,不仅仅要知道api,而且要熟悉理解它的实现原理,当然也要知道在那些情况使用它们,以及它们在项目中是如何运行的,会出现什么问题,作为中级程序员必须要知道,当然,如果作为初级程序员而言,对于原理可以放在一边,当然,能理解是最好。

优秀的个人博客,低调大师

docker 之网络配置

Docker 网络实现 首先,要实现网络通信,机器需要至少一个网络接口(物理接口或虚拟接口)来收发数据包;此外,如果不同子网之间要进行通信,需要路由机制。 Docker 中的网络接口默认都是虚拟的接口。虚拟接口的优势之一是转发效率较高。 Linux 通过在内核中进行数据复制来实现虚拟接口之间的数据转发,发送接口的发送缓存中的数据包被直接复制到接收接口的接收缓存中。对于本地系统和容器内系统看来就像是一个正常的以太网卡,只是它不需要真正同外部网络设备通信,速度要快很多。 Docker 容器网络就利用了这项技术。它在本地主机和容器内分别创建一个虚拟接口,并让它们彼此连通(这样的一对接口叫做 veth pair)。 创建网络参数 Docker 创建一个容器的时候,会执行如下操作: 创建一对虚拟接口,分别放到本地主机和新容器中; 本地主机一端桥接到默认的 docker0 或指定网桥上,并具有一个唯一的名字,如 veth65f9; 容器一端放到新容器中,并修改名字作为 eth0,这个接口只在容器的名字空间可见; 从网桥可用地址段中获取一个空闲地址分配给容器的 eth0,并配置默认路由到桥接网卡 veth65f9。 完成这些之后,容器就可以使用 eth0 虚拟网卡来连接其他容器和其他网络。 可以在 docker run 的时候通过 --net 参数来指定容器的网络配置,有4个可选值: --net=bridge 这个是默认值,连接到默认的网桥。 --net=host 告诉 Docker 不要将容器网络放到隔离的名字空间中,即不要容器化容器内的网络。此时容器使用本地主机的网络,它拥有完全的本地主机接口访问权限。容器进程可以跟主机其 它 root 进程一样可以打开低范围的端口,可以访问本地网络服务比如 D-bus,还可以让容器做一些影响整个主机系统的事情,比如重启主机。因此使用这个选项的时候要非常小心。如果进一步的使用 --privileged=true,容器会被允许直接配置主机的网络堆栈。 --net=container:NAME_or_ID 让 Docker 将新建容器的进程放到一个已存在容器的网络栈中,新容器进程有自己的文件系统、进程列表和资源限制,但会和已存在的容器共享 IP 地址和端口等网络资源,两者进程可以直接通过 lo 环回接口通信。 --net=none 让 Docker 将新容器放到隔离的网络栈中,但是不进行网络配置。之后,用户可以自己进行配置。 四种单节点网络模式 1、bridge 模式 Docker 容器默认使用 bridge 模式的网络。其特点如下: 使用一个 linux bridge,默认为 docker0 使用 veth 对,一头在容器的网络 namespace 中,一头在 docker0 上 该模式下Docker Container不具有一个公有IP,因为宿主机的IP地址与veth pair的 IP地址不在同一个网段内 Docker采用 NAT 方式,将容器内部的服务监听的端口与宿主机的某一个端口port 进行“绑定”,使得宿主机以外的世界可以主动将网络报文发送至容器内部 外界访问容器内的服务时,需要访问宿主机的 IP 以及宿主机的端口 port NAT 模式由于是在三层网络上的实现手段,故肯定会影响网络的传输效率。 容器拥有独立、隔离的网络栈;让容器和宿主机以外的世界通过NAT建立通信 2、Host 模式 定义: Host 模式并没有为容器创建一个隔离的网络环境。而之所以称之为host模式,是因为该模式下的 Docker 容器会和 host 宿主机共享同一个网络 namespace,故 Docker Container可以和宿主机一样,使用宿主机的eth0,实现和外界的通信。换言之,Docker Container的 IP 地址即为宿主机 eth0 的 IP 地址。其特点包括: 这种模式下的容器没有隔离的 network namespace 容器的 IP 地址同 Docker host 的 IP 地址 需要注意容器中服务的端口号不能与 Docker host 上已经使用的端口号相冲突 host 模式能够和其它模式共存 3、container 模式 定义: Container 网络模式是 Docker 中一种较为特别的网络的模式。处于这个模式下的 Docker 容器会共享其他容器的网络环境,因此,至少这两个容器之间不存在网络隔离,而这两个容器又与宿主机以及除此之外其他的容器存在网络隔离。 4、none 模式 定义: 网络模式为 none,即不为 Docker 容器构造任何网络环境。一旦Docker 容器采用了none 网络模式,那么容器内部就只能使用loopback网络设备,不会再有其他的网络资源。Docker Container的none网络模式意味着不给该容器创建任何网络环境,容器只能使用127.0.0.1的本机网络。 实验: rhel7.3 172.25.12.250(物理机) 启动一个容器,不指定时,容器默认使用 bridge 模式 [root@foundation12 ~]# docker run -it --name web ubuntu 查看物理机 物理机桥接情况 设定为none 模式 [root@foundation12 ~]# docker run -it --name vm1 --net none ubuntu 查看PID: [root@foundation12 ~]# docker inspect -f '{{.State.Pid}}' vm1 虚拟化网络都是基于netns 实现,netns 可以创建一个完全隔离的新网络环境,这个环境包括一个独立的网卡空间,路由表,ARP表,ip地址表,iptables等。总之,与网络有关的组件都是独立的。 ip [ OPTIONS ] netns { COMMAND | help }ip netns list - show all of the named network namespaces 列出所有名称空间ip netns add NETNSNAME - create a new named network namespace 创建一个新的名称空间ip netns delete NETNSNAME - delete the name of a network namespace 删除一个名称空间ip netns exec NETNSNAME cmd ... - Run cmd in the named network namespace 在网络名称空间中执行系统命令 eg: [root@foundation12 netns]# ip link add name veth0 type veth peer name veth1 添加网口到namespace(创建端口对) 在当前namespace可以看到veth0和veth1 [root@foundation12 ~]# ip link list 查看端口对 [root@foundation12 netns]# brctl addif docker0 veth0 将veth0加入docker0这个网桥 默认网桥都是down的,置为up状态 [root@foundation12 netns]# ip addr [root@foundation12 netns]# ip link set up veth0 [root@foundation12 netns]# ip link set up veth1 [root@foundation12 netns]# ip link set veth1 netns 4943 增加端口到namespace 查看net namespace 修改名字,添加IP和网关 [root@foundation12 netns]# ip netns exec 4943 ip link set veth1 name eth0 [root@foundation12 netns]# ip netns exec 4943 ip link set up eth0 [root@foundation12 netns]# ip netns exec 4943 ip addr add 172.17.0.100/24 dev eth0 [root@foundation12 netns]# ip netns exec 4943 ip route add default via 172.17.0.1 如下效果,none网络变得可以通信 迎工作一到五年的Java程序员朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

JVM之垃圾回收

JVM是每个JAVA开发都会听说了解过的东西,相关知识有一部分也是需要深入了解的,去年刚好有机会一次团队内部技术分享,就做了这方面的一些准备,简单了解了JVM的垃圾回收机制。 JVM虚拟机架构 上面是JVM架构,简单说说数据区每一部分的作用: Java堆(Heap),是Java虚拟机所管理的内存中最大的一块。Java堆是被所有线程共享的一块内存区域,在虚拟机启动时创建。此内存区域的唯一目的就是存放对象实例,几乎所有的对象实例都在这里分配内存。 方法区(Method Area),与Java堆一样,是各个线程共享的内存区域,它用于存储已被虚拟机加载的类信息、常量、静态变量、即时编译器编译后的代码等数据。 程序计数器(Program Counter Register),程序计数器(Program CounterRegister)是一块较小的内存空间,它的作用可以看做是当前线程所执行的字节码的行号指示器。在虚拟机的概念模型里(仅是概念模型,各种虚拟机可能会通过一些更高效的方式去实现),字节码解释器工作时就是通过改变这个计数器的值来选取下一条需要执行的字节码指令,分支、循环、跳转、异常处理、线程恢复等基础功能都需要依赖这个计数器来完成。 JVM栈(JVM Stacks),与程序计数器一样,Java虚拟机栈(Java Virtual MachineStacks)也是线程私有的,它的生命周期与线程相同。虚拟机栈描述的是Java方法执行的内存模型:每个方法被执行的时候都会同时创建一个栈帧(StackFrame)用于存储局部变量表、操作栈、动态链接、方法出口等信息。每一个方法被调用直至执行完成的过程,就对应着一个栈帧在虚拟机栈中从入栈到出栈的过程。 本地方法栈(Native Method Stacks),本地方法栈(Native Method Stacks)与虚拟机栈所发挥的作用是非常相似的,其区别不过是虚拟机栈为虚拟机执行Java方法(也就是字节码)服务,而本地方法栈则是为虚拟机使用到的Native方法服务。 本篇主要所提及的垃圾回收机制,主要是针对JAVA堆的。 在讨论垃圾回收机制之前,需要先知道JVM会回收哪些对象? 简单来说,会被GC掉的对象是: 不是GC roots并且没有被GC roots引用的对象。 这里不讨论哪些对象、引用可以成为GC roots,如感兴趣可以自行深入了解一下。 GC 算法 标记-清除算法 算法分为“标记”和“清除”两个阶段:标记阶段:找到所有可访问的对象,做个标记 ,清除阶段:遍历堆,把未被标记的对象回收。之所以说它是最基础的收集算法,是因为后续的收集算法都是基于这种思路并对其缺点进行改进而得到的。 标记-清除 它的主要缺点有两个: 一个是效率问题,标记和清除过程的效率都不高; 另外一个是空间问题,标记清除之后会产生大量不连续的内存碎片,空间碎片太多可能会导致,当程序在以后的运行过程中需要分配较大对象时无法找到足够的连续内存而不得不提前触发另一次垃圾收集动作。 复制(Copying)的收集算法 它将可用内存按容量划分为大小相等的两块,每次只使用其中的一块。当这一块的内存用完了,就将还存活着的对象复制到另外一块上面,然后再把已使用过的内存空间一次清理掉。 复制(Copying)的收集算法 该算法使得每次都是对其中的一块进行内存回收,内存分配时也就不用考虑内存碎片等复杂情况,只要移动堆顶指针,按顺序分配内存即可,实现简单,运行高效。只是这种算法的代价是将内存缩小为原来的一半,持续复制长生存期的对象则导致效率降低。并且该算法在对象存活率较高时就要执行较多的复制操作,效率将会变低。更关键的是,如果不想浪费50%的空间,就需要有额外的空间进行分配担保,以应对被使用的内存中所有对象都100%存活的极端情况,所以在老年代一般不能直接选用这种算法。 标记-整理算法 根据老年代的特点,有人提出了另外一种“标记-整理”(Mark-Compact)算法,标记过程仍然与“标记-清除”算法一样,但后续步骤不是直接对可回收对象进行清理,而是让所有存活的对象都向一端移动,然后直接清理掉端边界以外的内存。 标记-整理 “分代收集”(GenerationalCollection)算法 把Java堆分为新生代和老年代,这样就可以根据各个年代的特点采用最适当的收集算法。在新生代中,每次垃圾收集时都发现有大批对象死去,只有少量存活,那就选用复制算法,只需要付出少量存活对象的复制成本就可以完成收集。而老年代中因为对象存活率高、没有额外空间对它进行分配担保,就必须使用“标记-清除”或“标记-整理”算法来进行回收。 GC收集器 Serial收集器是一个新生代收集器,单线程执行,使用复制算法。它在进行垃圾收集时,必须暂停其他所有的工作线程(用户线程)。是Jvm client模式下默认的新生代收集器。对于限定单个CPU的环境来说,Serial收集器由于没有线程交互的开销,专心做垃圾收集自然可以获得最高的单线程收集效率。 ParNew其实就是serial的多线程版本,ParNew在单线程的情况下甚至不如Serial,ParNew是除了serial之外唯一能和CMS配合的。 Parallel Scavenge收集器和ParNew收集器类似,是一个新生代收集器。使用复制算法的并行多线程收集器。 主要适应主要适合在后台运算而不需要太多交互的任务。比如需要与用户交互的程序,良好的响应速度能提升用户的体验;而高吞吐量则可以最高效率地利用CPU时间,尽快地完成程序的运算任务等。 CMS收集过程 CMS算法主要分为四个步骤: a. 暂停所有应用线程(stop-the-word)并且标记能直接从roots节点到达的节点,虽然会造成STW,由于只扫描全局变量、栈等根节点直接到达的对象,这一步会非常快。 b.恢复应用线程,并且开启gc线程从第一个步骤中扫描到的节点开始进行深度遍历并标记,这个过程GC Thread和应用线程是同时进行的,当应用进程改变了某个对象的状态时会把当前对象所在的page标记为dirty,new的object所在的page也标记为dirty,深度遍历完整个对象图。 c.暂停所有应用进程并扫描roots以及标记为dirty page所在的区域,这个步骤也会暂停所有应用,由于只扫描roots以及dirty page,因此暂停时间比较短。 d.恢复应用进程并对内存进行回收。 图中C虽然未被GC roots引用,但依旧被标记出来。是因为不希望在过程中再次造成dirty page。因此C对象会在下次GC时被回收 (此处page如何分页,暂时没有找到相关资料。) 总之CMS将stop-the-world的时间降到最低,能给电商网站用户带来最好的体验。 尽管CMS的GC线程对CPU的占用率会比较高,但在多核的服务器上还是展现了优越的特性,目前也被部署在国内的各大电商网站上。 下面列出七个基本的收集器: Serial(串行GC)标记-复制 Serial Old(MSC)(串行GC)标记-整理 ParNew(并行GC)标记-复制 Parallel Scavenge(并行回收GC)标记-复制 Parallel Old(并行GC)标记-整理 CMS(并发GC)标记-清除 G1(JDK1.7+) (该收集器没有过多了解,性能据说是相对较好的,先留个坑之后填上。 GC收集器组合 有关GC的调优 我没有工程上的具体调优经验,不过了解的是:GC停顿时间缩短是以牺牲吞吐量和新生代空间来换取的:系统把新生代调小一些,收集300MB新生代肯定比收集500MB快吧,这也直接导致垃圾收集发生得更频繁一些,原来10秒收集一次、每次停顿100毫秒,现在变成5秒收集一次、每次停顿70毫秒。停顿时间的确在下降,但吞吐量也降下来了。 最后附上该篇文章大概的脑图

优秀的个人博客,低调大师

linux之awk命令

awk是一个非常棒的数据处理工具。相比于sed常常作用于一整行的处理,awk则比较倾向于将一行分成数个“字段”来处理。因此,awk 相当适合处理小型的数据处理。awk通常运行模式是这样的: [root@www ~]# awk '条件类型1{动作1} 条件类型2{动作2} 。。。' filename awk 后面接两个单引号并加上大括号来设置想要对数据进行的处理动作。awk 可以处理后续接的文件,也可以读取来自签个命令的standardoutput。但如前面所说的,awk主要是处理每一行的字段内的数据,而默认的字段的分隔符为空格键或[tab]键。举例来说,我们用 last 可以将登陆者的数据取出来,但我只想要取出账号与登录者的IP,且账号和IP之间以[tab]隔开 [root@www ~]# last -n 5 | awk '{print $1 "\t" $3}' <==可先用last -n 5 查看登录者数据,再进行操作 root 192.168.1.100 root 192.168.1.100 root 192.168.1.100 dmtsai 192.168.1.100 root Fri 上面是 awk 最常使用的动作。通过print 的功能将字段数据列出来!字段的分隔以空格或[tab] 隔开。第5行数据有点奇怪;这是因为数据格式的问题。所以使用awk的时候,请先确认一下你的数据,如果是连续性的数据,请不要有空格或[tab] 在内,否则就会像上面那样,发生误判。 另外,在每一行的每个字段都是有变量名称的,那就是$1,$2等变量名称。以上面的例子来说,root就是$1,因为它是第一列,至于192.168.1.100 是第三列,所以它就是 $3,后面以次类推。还有个变量$0,$0代表一整行数据的意思。 由此,上面5行当中,整个的awk处理流程是: 1.读入第一行,并将第一行数据填入$0,$1,$2等变量中; 2.依据条件类型的限制,判断是否需要进行后面的动作; 3.做完所有动作与条件类型; 4.若还有后续的“行”的数据,则重复上面1~3 的步骤,直到所有的数据都读完为止。 经过这样的步骤,你会晓得,awk 是以行为一次处理的单位,而以字段为最小的处理单位。那么awk 又怎么知道整个数据到底有几行和几列?这就需要 awk 的内置变量的帮忙了 NF: 每一行($0) 拥有的字段总数 NR: 目前awk 所处理的是 “第几行”数据 FS: 目前的分隔符,默认是空格

优秀的个人博客,低调大师

MyBatis之动态sql

如果使用JDBC或者Hibernate等ORM框架,很多时候你要根据需要去拼接sql,这是一个很麻烦的事情。而MyBatis提供对动态sql的组装能力,而且它只有为数不多的几个基本元素,简单明了,大量的判断可以在MyBatis的映射文件xml进行配置,以达到我们需要编写大量代码才能实现的需求。动态sql减少了很多编写代码量的工作。 这从中又体现了MyBatis的优点,可配置性,灵活性和可维护性。 注意该例子在MyBatis+Hibernate+JDBC分析对比的文章上基础进行的 下面进行对上述表中的例子进行演示: package cn.mybatis; import org.apache.ibatis.annotations.Param; public interface UserMapper { User getUserById(Integer Id); //注意@Param 适用场景针对于参数n<=5的情况下进行,如果参数n大于5以上建议将参数改为JavaBean User getUserByName(@Param("userName") String userName); } if演示示例: <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="cn.mybatis.UserMapper"> <!--如果一部分字段查询比较频繁,建议使用sql标签,将查询过频繁的字段放进去,这样方面管理和修改--> <sql id="user"> id,user_name </sql> <select id="getUserById" parameterType="Integer" resultMap="users"> select <include refid="user"/> from `user` where id=#{Id} </select> <!-- if标签主要适用于多条件查询,例如分页查询,比如博客,比如时间日期,标签类型,时间类型等等 单个条件可以使用下面的例子 如果条件多的话,建议在<if></if>外嵌套<where>标签 --> <select id="getUserByName" parameterType="String" resultMap="users"> select id,user_name from `user` where <if test="userName!=null and userName !=''"> user_name like concat ('%',#{userName},'%') </if> </select> <resultMap type="User" id="users"> <id column="id" property="Id"/> <result column="user_name" property="userName"/> </resultMap> </mapper> choosey演示示例: <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="cn.mybatis.UserMapper"> <!-- Choose相当于Java中的 if(..){ }else if(..){ }else{ } otherwise这里就不做演示了,otherwise相当于否则的意思,可以说就是else 注意 在外层必须嵌套<where>标签,否则会一直显示sql错误 --> <select id="getUserByName" parameterType="Map" resultMap="users"> select * from `user` <where> <choose> <when test="Id!=null and Id!=''"> and id = #{Id} </when> <when test="userName != null and userName != ''"> and user_name = #{userName} </when> </choose> </where> </select> <resultMap type="User" id="users"> <id column="id" property="Id"/> <result column="user_name" property="userName"/> </resultMap> </mapper> 接口类 package cn.mybatis; import java.util.List; import java.util.Map; import org.apache.ibatis.annotations.Param; public interface UserMapper { User getUserByName(Map<String,Object> map); } 测试类 package cn.mybatis; import java.util.HashMap; import java.util.List; import java.util.Map; import org.apache.ibatis.session.SqlSession; public class TestMyBatis { public static void main(String[] args) { SqlSession sqlSession = null; sqlSession = MyBatisExample.getSqlSessionFactory().openSession(); UserMapper userMapper = sqlSession.getMapper(UserMapper.class); User users = new User(); users.setId(1); users.setUserName(null); Map<String,Object> map = new HashMap<String,Object>(); map.put("user", users); User user = userMapper.getUserByName(map); System.out.println(user.getUserName()); } } trim演示示例: <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="cn.mybatis.UserMapper"> <!-- trim意味着去掉一些特殊字符 trim prefix表示前缀 通常加上where的话,表示已经将where写进前缀,这时就不用写where了 prefixOverrides 表示将第一個and或者or去掉 --> <select id="getUserByName" parameterType="String" resultMap="users"> select id,user_name from `user` <trim prefix="where" prefixOverrides="and|or"> <if test="userName!=null"> and user_name = #{userName} </if> </trim> </select> <resultMap type="User" id="users"> <id column="id" property="Id"/> <result column="user_name" property="userName"/> </resultMap> </mapper> 接口类: package cn.mybatis; import org.apache.ibatis.annotations.Param; public interface UserMapper { User getUserByName(@Param ("userName") String userName); } 测试类: package cn.mybatis; import java.util.HashMap; import java.util.List; import java.util.Map; import org.apache.ibatis.session.SqlSession; public class TestMyBatis { public static void main(String[] args) { SqlSession sqlSession = null; sqlSession = MyBatisExample.getSqlSessionFactory().openSession(); UserMapper userMapper = sqlSession.getMapper(UserMapper.class); User user = userMapper.getUserByName("张飞"); System.out.println(user.getUserName()); } } set <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="cn.mybatis.UserMapper"> <!-- set 当满足条件时继续下一个,否则报错,这里也相当于做一个判断验证 --> <!-- <update id="updateUserInfo" parameterType="User"> update `user` <set> <if test="userName != null and userName !='' "> user_name = #{userName} </if> </set> where id = #{Id} </update> --> <!--trim在这里也可以应用--> <update id="updateUserInfo" parameterType="User"> update `user` <trim prefix="set" prefixOverrides=","> <if test="userName !=null and userName !=''"> user_name = #{userName} </if> </trim> where id= #{Id} </update> <resultMap type="User" id="users"> <id column="id" property="Id"/> <result column="user_name" property="userName"/> </resultMap> </mapper> 接口类: package cn.mybatis; import java.util.List; import java.util.Map; import org.apache.ibatis.annotations.Param; public interface UserMapper { int updateUserInfo(User user); } 测试类: package cn.mybatis; import java.util.HashMap; import java.util.List; import java.util.Map; import org.apache.ibatis.session.SqlSession; public class TestMyBatis { public static void main(String[] args) { SqlSession sqlSession = null; sqlSession = MyBatisExample.getSqlSessionFactory().openSession(true); UserMapper userMapper = sqlSession.getMapper(UserMapper.class); User user = new User(); user.setId(1); user.setUserName("张好s"); int lines =userMapper.updateUserInfo(user); if(lines==1) { System.out.println("Yes"); }else { System.out.println("No"); } } } foreach这里就不演示了,参照我的博文批量更新,那里写的比较详细 当然接下来还有bind,不过这个不常用,以上说的包括没说的foreach是开发过程中常用的动态sql。

优秀的个人博客,低调大师

SpringCloud学习之SpringCloudBus

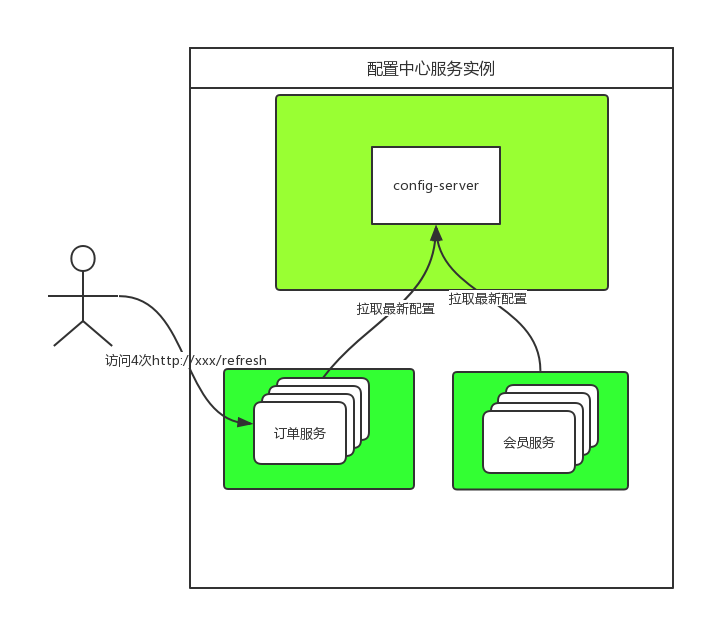
一。spring-cloud-bus是什么? 回答这个问题之前,我们先回顾先前的分布式配置,当配置中心发生变化后,我们需要利用spring-boot-actuator里的refresh端点进行手动刷新: 根据上述示例情况:我们每次要获取最新配置时,要一个一个的通过refresh刷新服务节点,这种方式是不是非常low而且非常麻烦,那该怎么办呢? 大家还记得zookeeper中watch是做什么用的吗?当监控的节点数据发生变化了,那么是不是所有订阅到该节点的客户端都会触发一个订阅回调呢?这其实也类似于我们的消息总线。在微服务架构的系统中,我们通常会使用轻量级的消息代理来构建一个公有的消息主题让系统中所有微服务实例都连接上来,由于该主题中产生的消息会被所有实例监听和消费,所以我们称它为消息总线。 那么在分布式配置中,我们的所有服务都订阅消息总线的话,当配置改变时,配置中心通知消息总线,然后所有的服务节点接收到订阅消息后,在从配置中心获取最新的配置,是不是一个一劳永逸的过程?那么可以得到如下结构图: 二、实现分布式配置的消息总线 我先贴出:项目结构图 我们统一把配置放在config目录下 1、在对应的服务添加对应的依赖 首先我们先配置config-server。gradle配置文件: dependencies { // testCompile group: 'junit', name: 'junit', version: '4.12' compile('org.springframework.cloud:spring-cloud-config-server') compile('org.springframework.kafka:spring-kafka') compile('org.springframework.cloud:spring-cloud-starter-bus-kafka') compile('org.springframework.cloud:spring-cloud-starter-eureka-server') } View Code 注意我们使用kafka作为消息总线的中间件 然后我们依次在所需的服务中添加对应的依赖 dependencies { // testCompile group: 'junit', name: 'junit', version: '4.12' compile('org.springframework.cloud:spring-cloud-starter-config') compile('org.springframework.kafka:spring-kafka') compile('org.springframework.cloud:spring-cloud-starter-bus-kafka') compile('org.springframework.cloud:spring-cloud-starter-eureka-server') } View Code 2、配置对应的application.yml config-server的yml文件: spring: application: name: config-server cloud: config: server: git: uri: file://${user.home}/IdeaProjects/spring-cloud repos: local: pattern: '**/local' uri: file://${user.home}/IdeaProjects/spring-cloud searchPaths: config search-paths: config label: master kafka: bootstrap-servers: localhost:9092 server: port: 8888 endpoints: refresh: sensitive: false bus: sensitive: false View Code 这里面注意要把端点先开放出来,然后进行kafka的相关配置,其余服务的配置文件也进行这样的操作,使其能与消息总线通讯。 3、依次启动服务 当服务启动成功时,SpringBootActuator给我们提供一个/bus/refresh端点,同时我们可以在kafka主题里面找到相应的topics,其名字为springCloudBus: 4、访问Config-Server的/bus/refesh 我们先使用kafka的消费端来监听一下消息内容。运行: ./kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic springCloudBus 紧接着我们在访问http://localhost:8888/bus/refresh 刷新config-server的配置 然后我们可以发现消费端,订阅到如下消息: 其中:type为消息的事件类型 timestamp 为消息的时间戳 orginService:消息的来源服务实例 destinationService:消息的目标服务实例,**代表了总线上的所有服务实例 在本例子中,我们可以看到每个服务的ackId都来自于 type为RefreshRemoteApplicationEvent的服务ID 5、运行服务 我们先通过gradle的build任务进行打包会得到如下文件:xxxx.jar与xxx.jar.orginal 那么进入到对应目录下 启动两个服务并注册到注册中心 命令如下: java -Dserver.port=8300 -Dspring.profiles.active=local -jar xxxx.jar java -Dserver.port=8200 -Dspring.profiles.active=local -jar xxxx.jar 注意一定不要在application.yml配置如上参数,否则通过(-Dxxx=xxx)系统变量设置的值将不会生效 此时我们更改config对应的配置并commit后,在运行步骤4,就可以拿到最新的结果了,再次附上相关代码: StudentConfig: package com.hzgj.lyrk.order.config; import org.springframework.boot.context.properties.ConfigurationProperties; import org.springframework.context.annotation.Configuration; @ConfigurationProperties(prefix = "student") @Configuration public class StudentConfig { private String name; private String age; public String getName() { return name; } public void setName(String name) { this.name = name; } public String getAge() { return age; } public void setAge(String age) { this.age = age; } @Override public String toString() { return "StudentConfig{" + "name='" + name + '\'' + ", age='" + age + '\'' + '}'; } } View Code order-server-local: student: name: student_local age: 17 View Code

优秀的个人博客,低调大师

Python之CVXOPT模块

Python中支持Convex Optimization(凸规划)的模块为CVXOPT,其安装方式为: 卸载原Pyhon中的Numpy 安装CVXOPT的whl文件,链接为:https://www.lfd.uci.edu/~gohlke/pythonlibs/ 安装Numpy+mkl的whl文件,链接为:https://www.lfd.uci.edu/~gohlke/pythonlibs/ 之所以选择这种安装方式,是因为Python的whl和pip直接install的不兼容性。 CVXOPT的官方说明文档网址为:http://cvxopt.org/index.html, 现最新版本为1.1.9,由Martin Andersen, Joachim Dahl 和Lieven Vandenberghe共同开发完成,能够解决线性规划和二次型规划问题,其应用场景如机器学习中的SVM算法中的Hard Margin SVM情形. CVXOPT使用举例如下: 线性规划问题 例1: Python程序代码: import numpy as np from cvxopt import matrix, solvers A = matrix([[-1.0, -1.0, 0.0, 1.0], [1.0, -1.0, -1.0, -2.0]]) b = matrix([1.0, -2.0, 0.0, 4.0]) c = matrix([2.0, 1.0]) sol = solvers.lp(c,A,b) print(sol['x']) print(np.dot(sol['x'].T, c)) print(sol['primal objective']) 输出结果: pcost dcost gap pres dres k/t 0: 2.6471e+00 -7.0588e-01 2e+01 8e-01 2e+00 1e+00 1: 3.0726e+00 2.8437e+00 1e+00 1e-01 2e-01 3e-01 2: 2.4891e+00 2.4808e+00 1e-01 1e-02 2e-02 5e-02 3: 2.4999e+00 2.4998e+00 1e-03 1e-04 2e-04 5e-04 4: 2.5000e+00 2.5000e+00 1e-05 1e-06 2e-06 5e-06 5: 2.5000e+00 2.5000e+00 1e-07 1e-08 2e-08 5e-08 Optimal solution found. {'primal objective': 2.4999999895543072, 's': <4x1 matrix, tc='d'>, 'dual infeasibility': 2.257878974569382e-08, 'primal slack': 2.0388399547464153e-08, 'dual objective': 2.4999999817312535, 'residual as dual infeasibility certificate': None, 'dual slack': 3.529915972607509e-09, 'x': <2x1 matrix, tc='d'>, 'iterations': 5, 'gap': 1.3974945737723005e-07, 'residual as primal infeasibility certificate': None, 'z': <4x1 matrix, tc='d'>, 'y': <0x1 matrix, tc='d'>, 'status': 'optimal', 'primal infeasibility': 1.1368786228004961e-08, 'relative gap': 5.5899783359379607e-08} [ 5.00e-01] [ 1.50e+00] [[ 2.49999999]] 例2 Python程序代码 import numpy as np from cvxopt import matrix, solvers A = matrix([[1.0, 0.0, -1.0], [0.0, 1.0, -1.0]]) b = matrix([2.0, 2.0, -2.0]) c = matrix([1.0, 2.0]) d = matrix([-1.0, -2.0]) sol1 = solvers.lp(c,A,b) min = np.dot(sol1['x'].T, c) sol2 = solvers.lp(d,A,b) max = -np.dot(sol2['x'].T, d) print('min=%s,max=%s'%(min[0][0], max[0][0])) 输出结果: pcost dcost gap pres dres k/t 0: 4.0000e+00 -0.0000e+00 4e+00 0e+00 0e+00 1e+00 1: 2.7942e+00 1.9800e+00 8e-01 9e-17 7e-16 2e-01 2: 2.0095e+00 1.9875e+00 2e-02 4e-16 2e-16 7e-03 3: 2.0001e+00 1.9999e+00 2e-04 2e-16 6e-16 7e-05 4: 2.0000e+00 2.0000e+00 2e-06 6e-17 5e-16 7e-07 5: 2.0000e+00 2.0000e+00 2e-08 3e-16 7e-16 7e-09 Optimal solution found. pcost dcost gap pres dres k/t 0: -4.0000e+00 -8.0000e+00 4e+00 0e+00 1e-16 1e+00 1: -5.2058e+00 -6.0200e+00 8e-01 1e-16 7e-16 2e-01 2: -5.9905e+00 -6.0125e+00 2e-02 1e-16 0e+00 7e-03 3: -5.9999e+00 -6.0001e+00 2e-04 1e-16 2e-16 7e-05 4: -6.0000e+00 -6.0000e+00 2e-06 1e-16 2e-16 7e-07 Optimal solution found. min=2.00000000952,max=5.99999904803 二次型规划问题 其中P,q,G,h,A,b为输入矩阵,该问题求解采用QP算法。 例1: Python程序代码: from cvxopt import matrix, solvers Q = 2*matrix([[2, .5], [.5, 1]]) p = matrix([1.0, 1.0]) G = matrix([[-1.0,0.0],[0.0,-1.0]]) h = matrix([0.0,0.0]) A = matrix([1.0, 1.0], (1,2)) b = matrix(1.0) sol=solvers.qp(Q, p, G, h, A, b) print(sol['x']) print(sol['primal objective']) 输出结果: pcost dcost gap pres dres 0: 1.8889e+00 7.7778e-01 1e+00 2e-16 2e+00 1: 1.8769e+00 1.8320e+00 4e-02 0e+00 6e-02 2: 1.8750e+00 1.8739e+00 1e-03 1e-16 5e-04 3: 1.8750e+00 1.8750e+00 1e-05 6e-17 5e-06 4: 1.8750e+00 1.8750e+00 1e-07 2e-16 5e-08 Optimal solution found. [ 2.50e-01] [ 7.50e-01] 例2: Python程序代码: from cvxopt import matrix, solvers P = matrix([[1.0, 0.0], [0.0, 0.0]]) q = matrix([3.0, 4.0]) G = matrix([[-1.0, 0.0, -1.0, 2.0, 3.0], [0.0, -1.0, -3.0, 5.0, 4.0]]) h = matrix([0.0, 0.0, -15.0, 100.0, 80.0]) sol=solvers.qp(P, q, G, h) print(sol['x']) print(sol['primal objective']) 输出结果 pcost dcost gap pres dres 0: 1.0780e+02 -7.6366e+02 9e+02 0e+00 4e+01 1: 9.3245e+01 9.7637e+00 8e+01 6e-17 3e+00 2: 6.7311e+01 3.2553e+01 3e+01 6e-17 1e+00 3: 2.6071e+01 1.5068e+01 1e+01 2e-17 7e-01 4: 3.7092e+01 2.3152e+01 1e+01 5e-18 4e-01 5: 2.5352e+01 1.8652e+01 7e+00 7e-17 3e-16 6: 2.0062e+01 1.9974e+01 9e-02 2e-16 3e-16 7: 2.0001e+01 2.0000e+01 9e-04 8e-17 5e-16 8: 2.0000e+01 2.0000e+01 9e-06 1e-16 2e-16 Optimal solution found. [ 7.13e-07] [ 5.00e+00] 20.00000617311241

优秀的个人博客,低调大师

iOS开发之UIWebView

UIWebView是iOS sdk中一个最常用的控件。是内置的浏览器控件,我们可以用它来浏览网页、打开文档等等。这篇文章我将使用这个控件,做一个简易的浏览器。如下图: 我们创建一个Window-based Application程序命名为:UIWebViewDemo UIWebView的loadRequest可以用来加载一个url地址,它需要一个NSURLRequest参数。我们定义一个方法用来加载url。在UIWebViewDemoViewController中定义下面方法: - (void)loadWebPageWithString:(NSString*)urlString { NSURL *url =[NSURL URLWithString:urlString]; NSLog(urlString); NSURLRequest *request =[NSURLRequest requestWithURL:url]; [webView loadRequest:request]; } 在界面上放置3个控件,一个textfield、一个button、一个uiwebview,布局如下: 在代码中定义相关的控件:webView用于展示网页、textField用于地址栏、activityIndicatorView用于加载的动画、buttonPress用于按钮的点击事件。 @interface UIWebViewDemoViewController :UIViewController<UIWebViewDelegate> { IBOutlet UIWebView *webView; IBOutlet UITextField *textField; UIActivityIndicatorView *activityIndicatorView; } - ( IBAction )buttonPress:( id ) sender; - ( void )loadWebPageWithString:( NSString *)urlString; @end 使用IB关联他们。 设置UIWebView,初始化UIActivityIndicatorView: - (void)viewDidLoad { [super viewDidLoad]; webView.scalesPageToFit =YES; webView.delegate=self; activityIndicatorView = [[UIActivityIndicatorView alloc] initWithFrame : CGRectMake(0.0f, 0.0f, 32.0f, 32.0f)] ; [activityIndicatorView setCenter: self.view.center] ; [activityIndicatorView setActivityIndicatorViewStyle: UIActivityIndicatorViewStyleWhite] ; [self.view addSubview : activityIndicatorView] ; [self buttonPress:nil];// Do any additional setup after loading the view from its nib.} UIWebView主要有下面几个委托方法: 1、- (void)webViewDidStartLoad:(UIWebView *)webView;开始加载的时候执行该方法。 2、- (void)webViewDidFinishLoad:(UIWebView *)webView;加载完成的时候执行该方法。 3、- (void)webView:(UIWebView *)webView didFailLoadWithError:(NSError *)error;加载出错的时候执行该方法。 我们可以将activityIndicatorView放置到前面两个委托方法中。 - (void)webViewDidStartLoad:(UIWebView *)webView { [activityIndicatorView startAnimating] ; }- (void)webViewDidFinishLoad:(UIWebView *)webView { [activityIndicatorView stopAnimating]; } buttonPress方法很简单,调用我们开始定义好的loadWebPageWithString方法就行了: - ( IBAction )buttonPress:( id ) sender { [textField resignFirstResponder]; [ self loadWebPageWithString:textField.text]; } 当请求页面出现错误的时候,我们给予提示: - ( void )webView:(UIWebView *)webView didFailLoadWithError:( NSError *)error { UIAlertView *alterview = [[UIAlertView alloc] initWithTitle:@ "" message:[error localizedDescription] delegate: nil cancelButtonTitle: nil otherButtonTitles:@ "OK" , nil ]; [alterview show]; [alterview release]; } 总结:本文通过实现一个简单的浏览器,说明了uiwebview的方法和属性,相信通过这个例子,应该明白uiwebview的使用了。 代码:UIWebViewDemo.zip 本文转自麒麟博客园博客,原文链接:http://www.cnblogs.com/zhuqil/archive/2011/07/28/2119923.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

11 - JavaSE之GUI

GUI(念法 gu yi) AWT AWT(Abstract Window Toolkit 抽象窗口开发包,在C# 或者 linux窗口开发类之上又封装一层,达到跨平台的目的)包括了很多类和接口,用于GUI 的编程。 GUI 的各种元素(如:窗口,按钮, 文本框等)由 Java 类来实现。 使用 AWT 所涉及的类一般在 java.awt 包及其子包中。 Container(容器) 和 Component(组件)是 AWT 的两个核心类。 AWT 是java比较旧的开发包,新的开发包叫 javax.Swing。 Component 和 Container Java 的图形用户界面的最基本组成部分是 Component,Component 类及其子类的对象用来描述以图形化的方式显示在屏幕上并能与用户进行交互的 GUI 元素,例如,一个按钮,一个标签等。 一般的 Component 对象不能独立的显示出来,必须将其放在某一 Container 对象才可以显示出来。 Container 是 Component 的子类,Container 子类对象可以容纳别的 Component 对象。 Container 对象可以使用方法 add(...) 向其中添加 Component 对象。 Container 是 Component 的子类,因此 Container 对象也可以被当做 Component 对象添加到其他 Container 对象中。 两种常用的 Container。Window:其对象表示自由停泊的顶级窗口。Panel:其对象可以容纳其他 Component 对象,但是不能独立存在,必须被添加到其他 Container 中(如 Window)。 Frame Frame 是 Window 的子类,由 Frame 或其子类创建的对象为一个窗体。 Frame 的常用构造方法:Frame(); Frame(String s) // 创建标题栏为字符串 s 的窗口。 成员函数略。(注意 Frame还继承了父类 Window 的成员方法,一些常用的方法在 Window 里面。) 示例1: import java.awt.*; public class TestFrame { public static void main( String args[]) { Frame f = new Frame("My First Test"); f.setLocation(300, 300); f.setSize( 170,100); f.setBackground( Color.blue); f.setResizable(false); f.setVisible( true); } } 示例2:(推荐) import java.awt.*; public class Test { public static void main(String args[]) { MyFrame f1 = new MyFrame(100,100,200,200,Color.BLUE); MyFrame f2 = new MyFrame(300,100,200,200,Color.YELLOW); MyFrame f3 = new MyFrame(100,300,200,200,Color.GREEN); MyFrame f4 = new MyFrame(300,300,200,200,Color.MAGENTA); } } class MyFrame extends Frame{ static int id = 0; MyFrame(int x,int y,int w,int h,Color color){ super("MyFrame " + (++id)); setBackground(color); setLayout(null); setBounds(x,y,w,h); setVisible(true); } } Panel Panel 对象可以看成可以容纳 Component 的空间 Panel 对象可以拥有自己的布局管理器 Panel 的构造方法。Panel() // 使用默认的布局管理器初始化。 Panle(LayoutManager layout) // 使用指定的布局管理器初始化。 Panel 类拥有从其父继承来的一些常用成员方法。 示例1: import java.awt.*; public class Test { public static void main(String args[]) { Frame f = new Frame("Java Frame with Panel"); Panel p = new Panel(null); f.setLayout(null); // 少了此句话,将不显示Frame的背景,全部由Panel覆盖 f.setBounds(300,300,500,500); f.setBackground(new Color(102,95,51)); p.setBounds(50,50,400,400); p.setBackground(new Color(204,204,255)); f.add(p); f.setVisible(true); } } 示例2: import java.awt.*; public class Test { public static void main(String args[]) { new MyFrame("MyFrameWithPanel",300,300,400,300); } } class MyFrame extends Frame{ private Panel p1,p2,p3,p4; MyFrame2(String s,int x,int y,int w,int h){ super(s); setLayout(null); p1 = new Panel(null); p2 = new Panel(null); p3 = new Panel(null); p4 = new Panel(null); p1.setBounds(0,0,w/2,h/2); p2.setBounds(0,h/2,w/2,h/2); p3.setBounds(w/2,0,w/2,h/2); p4.setBounds(w/2,h/2,w/2,h/2); p1.setBackground(Color.BLUE); p2.setBackground(Color.GREEN); p3.setBackground(Color.YELLOW); p4.setBackground(Color.MAGENTA); add(p1);add(p2);add(p3);add(p4); setBounds(x,y,w,h); setVisible(true); } } PS: Panel 的 setBounds 方法中设置的位置大小是相对于相对装入的 Frame 窗口位置和大小的。 布局管理器 Java 语言中,提供了布局管理器类的对象可以管理 Component 在 Container 中的布局,不必直接设置 Component 位置和大小。 每个 Container 都有一个布局管理器对象,当容器需要对某个组件进行定位或判断其大小尺寸时,就会调用其对应的布局管理器,调用 Container 的 setLayout 方法改变其布局管理器对象。 AWT 提供了至少 5 种布局管理器类: FlowLayout BorderLayout GridLayout CardLayout GridBagLayout FlowLayout FlowLayout 是 Panel 类的默认布局管理器。 FlowLayout 布局管理器对组件逐行定位,行内从左到右,一行排满后换行。 不改变组件的大小,按组件原有尺寸显示组件,可以设置不同的组件间距,行距以及对齐方式。 FlowLayout 默认的对齐方式是居中。 FlowLayout 的构造方法: new FlowLayout(FlowLayout.RIGHT, 20, 40); // 右对齐,组件之间水平间隔20像素,垂直间隔40像素。 new FlowLayout(FlowLayout.RIGHT); // 右对齐,组件之间水平和垂直间隔为缺省值(5像素)。 new FlowLayout(); // 缺省为居中对齐,组件之间水平和垂直间隔为缺省值(5像素)。 示例1: import java.awt.*; public class Test { public static void main(String args[]) { Frame f = new Frame("Flow Layout"); Button button1 = new Button("Ok"); Button button2 = new Button("Open"); Button button3 = new Button("Close"); f.setLayout(new FlowLayout(FlowLayout.CENTER)); f.add(button1); f.add(button2); f.add(button3); //f.setSize(100,100); f.pack(); // pack打包,刚好包住 f 里面的组件,自适应。 f.setVisible(true); } } 示例2: import java.awt.*; public class Test { public static void main(String args[]) { Frame f = new Frame("Java Frame"); FlowLayout l = new FlowLayout(FlowLayout.CENTER, 20, 40); f.setLayout(l); f.setLocation(300,400); f.setSize(300,200); f.setBackground(new Color(204,204,255)); for(int i = 1; i<=7; i++){ f.add(new Button("BUTTON")); } f.setVisible(true); } } BorderLayout BorderLayout 是 Frame 类的默认布局管理器。 BorderLayout 将整个容器的布局划分成: 东(EAST) 西(WEST) 南(SOUTH) 北(NORTH) 中(CENTER) 五个区域,组件只能被添加到指定的区域。 如果不指定组件的加入位置,则默认加入到 CENTER 区。 每个区域只能加入一个组件,如果加入多个,则先前的加入的组件会被覆盖。 示例: import java.awt.*; public class Test { public static void main(String args[]) { Frame f; f = new Frame("Border Layout"); Button bn = new Button("BN"); Button bs = new Button("BS"); Button bw = new Button("BW"); Button be = new Button("BE"); Button bc = new Button("BC"); f.add(bn, BorderLayout.NORTH); f.add(bs, BorderLayout.SOUTH); f.add(bw, BorderLayout.WEST); f.add(be, BorderLayout.EAST); f.add(bc, BorderLayout.CENTER); f.setSize(200,200); f.setVisible(true); } } GridLayout GridLayout 布局管理器将空间划分成规则的矩形网格,每个单元格区域大小相等。组件被添加到每个单元格中,先从左到右填满一行后换行,再从上到下。 在 GridLayout 构造方法中指定分割的行数和列数。(如:GridLayout(3, 4); // 整个空间分为3行4列。) 示例: import java.awt.*; public class Test { public static void main(String args[]) { Frame f = new Frame("GridLayout Example"); Button b1 = new Button("b1"); Button b2 = new Button("b2"); Button b3 = new Button("b3"); Button b4 = new Button("b4"); Button b5 = new Button("b5"); Button b6 = new Button("b6"); f.setLayout (new GridLayout(3,2)); f.add(b1); f.add(b2); f.add(b3); f.add(b4); f.add(b5); //f.add(b6); f.pack(); f.setVisible(true); } } 问题:请使用 Container 的嵌套实现下面布局? 代码:(实现原理:Panel 嵌套 Panel) import java.awt.*; public class Test { public static void main(String args[]) { Frame f = new Frame("Frame"); f.setLayout(new GridLayout(2,1)); f.setBounds(400,200, 500, 300); Panel p1 = new Panel(new BorderLayout()); Panel p2 = new Panel(new BorderLayout()); Panel p11 = new Panel(new GridLayout(2,1)); Panel p22 = new Panel(new GridLayout(2,2)); p11.add(new Button("BUTTON")); p11.add(new Button("BUTTON")); p1.add(p11, BorderLayout.CENTER); p1.add(new Button("BUTTON"), BorderLayout.WEST); p1.add(new Button("BUTTON"), BorderLayout.EAST); for(int i=0; i<4; i++) { p22.add(new Button("BUTTON")); } p2.add(p22, BorderLayout.CENTER); p2.add(new Button("BUTTON"), BorderLayout.WEST); p2.add(new Button("BUTTON"), BorderLayout.EAST); f.add(p1); f.add(p2); f.setVisible(true); } } 布局管理器总结 Frame 是一个顶级窗口,Frame 的缺省布局管理器为 BorderLayout Panel 无法单独显示,必须添加到某个容器中,Panel 的缺省布局管理器为 FlowLayout. 当把 Panel 作为一个组件添加到某个容器后,该 Panel 仍然可以有自己的布局管理器。 使用布局管理器时,布局管理器负责各个组件的大小和位置,因此用户无法在这种情况下设置组件的大小和位置属性,如果试图使用 Java 提供的 setLocation(), setSize(), setBounds() 等方法,则都会被布局管理器覆盖。 如果用户确实需要亲自设置组件大小和位置,则应取消该容器的布局管理器,方法为:setLayout(null); 事件监听 Button 事件监听 创建自己的类 MyMonitor 实现 ActionListener 接口 向 Button 对象中注册 MyMonitor 对象。 在 Button 对象有 ActionEvent 事件对象产生的时候,自动调用 MyMonitor对象中实现 ActionListener 接口的函数actionPerformed 方法 示例: import java.awt.*; import java.awt.event.*; public class Test { public static void main(String args[]) { Frame f = new Frame("Test"); Button b = new Button("Press Me!"); Monitor bh = new Monitor(); b.addActionListener(bh); f.add(b,BorderLayout.CENTER); f.pack(); f.setVisible(true); } } class Monitor implements ActionListener { public void actionPerformed(ActionEvent e) { System.out.println("a button has been pressed"); } } TextField 类 java.awt.TextField 类用来创建文本框对象。 TextField 常用方法: // 构造方法 TextField () TextField (int columns) // 文本框长度 TextField (String text) TextField (String text, int columns) // 方法 public void setText(String t) public String getText() public void setEchoChar(char c) // 设置回显字符 public void setEditable(noolean b) public boolean isEditable() public void setBackground(Color c) public void select(int selectionStart, int selectionEnd) public void selectAll() // 不知怎么用? public void addActionListener(ActionListener e) // 添加动作监听器 TextField 事件监听 TextField 对象可能发生 Action(光标在文本框内敲回车)事件,该事件对应的事件类是 java.awt.event.ActionEvent. 用来处理 ActionEvent 事件是实现了 java.awt.event.ActionListener 接口的类的对象。 ActionListener 接口定义有方法: public void actionPerformed(ActionEvent e); 实现该接口的类要在该方法中添加处理该事件(Action)的语句。 使用 addActionListener(ActionListener l) 方法为 TextField 对象注册一个 ActionListener 对象,当 TextField 对象发生 Action 事件时,会生成一个 ActionEvent 对象,该对象作为参数传递给 ActionListener 对象的 actionPerformed 方法 在方法中可以获取该对象的信息,并作出相应的处理。 示例1: import java.awt.*; import java.awt.event.*; public class Test { public static void main(String[] args) { new TFFrame(); } } class TFFrame extends Frame { TFFrame() { TextField tf = new TextField(); add(tf); tf.addActionListener(new TFActionListener()); // tf.setEchoChar('*'); pack(); setVisible(true); } } class TFActionListener implements ActionListener { @Override public void actionPerformed(ActionEvent e) { TextField tf = (TextField)e.getSource(); System.out.println(tf.getText()); tf.setText(""); } } 示例2: import java.awt.*; import java.awt.event.*; public class Test { public static void main(String[] args) { new TFFrame(); } } class TFFrame extends Frame { TextField tf1, tf2, tfsum; Label lb = null; Button btn = null; TFFrame() { tf1 = new TextField(10); tf2 = new TextField(10); tfsum = new TextField(15); lb = new Label("+"); btn = new Button("="); btn.addActionListener(new TFActionListener(this)); setLayout(new FlowLayout()); add(tf1); add(lb); add(tf2); add(btn); add(tfsum); pack(); setVisible(true); } } class TFActionListener implements ActionListener { private TFFrame tf; TFActionListener(TFFrame tf) { this.tf = tf; } @Override public void actionPerformed(ActionEvent e) { int t1 = Integer.parseInt(tf.tf1.getText()); int t2 = Integer.parseInt(tf.tf2.getText()); tf.tfsum.setText("" + (t1 + t2)); } } private TFFrame tf; TFActionListener(TFFrame tf) { this.tf = tf;} 当我们需要获取其他的对象的时候,传递的不是另一个对象的成员变量,而是将整个对象的引用传递过来,这种编程模式叫做 “门面模式” 。网上有详细解释。 内部类 好处 可以方便的访问包装类的成员。 可以清楚的组织逻辑,防止不应该被其他类访问的类访问。 何时使用 该类不允许或者不需要其他类进行访问时。(比如:各种事件的监听器) 示例: import java.awt.*; import java.awt.event.*; public class Test { public static void main(String[] args) { new TFFrame("Frame of sum"); } } class TFFrame extends Frame { TextField tf1, tf2, tfsum; Label lb = null; Button btn = null; TFFrame(String s) { super(s); tf1 = new TextField(10); tf2 = new TextField(10); tfsum = new TextField(15); lb = new Label("+"); btn = new Button("="); btn.addActionListener(new TFActionListener()); setLayout(new FlowLayout()); add(tf1); add(lb); add(tf2); add(btn); add(tfsum); pack(); setVisible(true); } class TFActionListener implements ActionListener { @Override public void actionPerformed(ActionEvent e) { int t1 = Integer.parseInt(tf1.getText()); int t2 = Integer.parseInt(tf2.getText()); tfsum.setText("" + (t1 + t2)); } } } 内部类:将 class TFActionListener implements ActionListener 放到了 TFFrame 类的内部。 Graphics 类 paint 方法 每个 Component 都有一个 paint(Graphics g) 方法,用于实现绘图目的,每次重画该 Component 的时候,都会自动调用 paint 方法。 什么叫重画该 Component 的时候? 打比方说 Component 是一个窗口,那么改变窗口大小的时候,最小化最大化窗口的时候,切换到其他界面再切回来的时候都会重画窗口,都会导致 paint 方法自动被调用。 paint 时 Container 接口的方法,需要重写。 示例: import java.awt.*; public class Test { public static void main(String[] args) { new PaintFrame().launchFrame(); } } class PaintFrame extends Frame { public void launchFrame() { setBounds(200,200,640,480); setVisible(true); } public void paint(Graphics g) { Color c = g.getColor(); // 作用为保护现场 g.setColor(Color.red); g.fillOval(50, 50, 30, 30); g.setColor(Color.green); g.fillRect(80,80,40,40); g.setColor(c); // 作用为恢复现场 } } 鼠标事件适配器 抽象类 java.awt.event.MouseAdapter 实现了 MouseListener 接口,可以使用其子类作为 MouseEvent 的监听器,只要重写其相应的方法即可。 MouseAdapter 存在的意义(就是为了不全部写出接口方法的实现,MouseAdapter 以空方法实现了MouseListener 接口,我们可以继承 MouseAdapter ,然后只重写我们想要重写的方法即可,不需要全部写出接口中的方法。) 不止有 MouseAdapter 还有 xxxAdapter 示例: import java.awt.*; import java.awt.event.*; import java.util.*; public class Test{ public static void main(String args[]) { new MyFrame("Draw Point"); } } class MyFrame extends Frame { ArrayList points = null; MyFrame(String s) { super(s); points = new ArrayList(); setLayout(null); setBounds(300,300,400,300); this.setBackground(new Color(204,204,255)); setVisible(true); this.addMouseListener(new Monitor()); } @Override public void paint(Graphics g) { Iterator i = points.iterator(); while(i.hasNext()){ Point p = (Point)i.next(); g.setColor(Color.RED); g.fillOval(p.x,p.y,10,10); } } public void addPoint(Point p){ points.add(p); } } class Monitor extends MouseAdapter { public void mousePressed(MouseEvent e) { MyFrame f = (MyFrame)e.getSource(); f.addPoint(new Point(e.getX(),e.getY())); f.repaint(); // 当有鼠标点击时重绘,保证在界面未重画的时候,强制重画界面 } } repaint() 方法调用了 -- update() 调用了 --paint() 方法。基本上所有的 GUI 图形绘制都是采用这样的方法。 Window 事件 和 匿名类 Window 事件所对应的事件类为 WindowEvent,所对应的事件监听接口为 WindowListener。 WindowListener 定义的方法: void windowActivated(WindowEvent e) // 窗口激活时 void windowClosed(WindowEvent e) // 窗口已经关闭时 void windowClosing(WindowEvent e) // 窗口正在关闭时 void windowDeactivated(WindowEvent e) // 窗口未激活时 void windowDeiconified(WindowEvent e) //当窗口从最小化更改为正常状态时调用。 void windowIconified(WindowEvent e) //当窗口从正常状态更改为最小化状态时调用。 void windowOpened(WindowEvent e) // 第一次调用窗口可见。 与 WindowListener 对应的适配器为 WindowAdapter。 示例: import java.awt.*; import java.awt.event.*; public class Test { public static void main(String args[]) { new MyFrame55("MyFrame"); } } class MyFrame55 extends Frame { MyFrame55(String s) { super(s); setLayout(null); setBounds(300, 300, 400, 300); this.setBackground(new Color(204, 204, 255)); setVisible(true); //this.addWindowListener(new MyWindowMonitor()); this.addWindowListener( new WindowAdapter() { public void windowClosing(WindowEvent e) { setVisible(false); System.exit(0); } }); } /* class MyWindowMonitor extends WindowAdapter { public void windowClosing(WindowEvent e) { setVisible(false); System.exit(-1); } } */ } 其中: this.addWindowListener( new WindowAdapter() { public void windowClosing(WindowEvent e) { setVisible(false); System.exit(0); } }); /* class MyWindowMonitor extends WindowAdapter { public void windowClosing(WindowEvent e) { setVisible(false); System.exit(-1); } } */ 为匿名类。 在实际的项目中看到一个很奇怪的现象,Java可以直接new一个接口,然后在new里面粗暴的加入实现代码。就像下面这样。那么问题来了,new出来的对象没有实际的类作为载体,这不是很奇怪吗? 思考以下代码的输出是什么? Runnable x = new Runnable() { @Override public void run() { System.out.println(this.getClass()); } }; x.run(); 实际答案是出现xxxx$1这样一个类名,它是编译器给定的名称。 键盘事件的测试程序 import java.awt.*; import java.awt.event.*; public class Test { public static void main(String args[]) { new MyFrame("Key Frame"); } } class MyFrame extends Frame { MyFrame(String s) { super(s); setBounds(300, 200, 200, 200); addKeyListener(new MyKeyListener()); addWindowListener(new MyWindowListener()); setVisible(true); } class MyKeyListener extends KeyAdapter { @Override public void keyPressed(KeyEvent e) { if(e.getKeyCode() == KeyEvent.VK_UP) { System.out.println("UP!"); } } } class MyWindowListener extends WindowAdapter { @Override public void windowClosing(WindowEvent e) { System.exit(0); } } }

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册