首页 文章 精选 留言 我的

精选列表

搜索[入门],共9562篇文章
优秀的个人博客,低调大师

Tensorflow CNN入门

一、概论 以图像识别来举例,比如我们让计算机如何识别一张猫的图片识别出猫呢? 老式的计算机视觉是如何做的呢? 比如OpenCV: 首先理解很多算法,比如如何检测线条(Edge Detection) 如何做形态学变化等 根据我们的知识, 经验, 脑洞来设计很多特征; 用这些特征去比对一张图像是不是猫。 这样做存在的问题呢? 每一种不同的物件,我们都得去设计特征。 这样的人工智能主要是人工,而不是只能。 老式的流程: 原始数据 ——> 人工特征提取 ——> 算法 ——> 结果 卷积要解决的问题就是自动的特征提取(Feature Extraction) 卷积神经网络: 原始数据 ——> 卷积网络 ——> 算法 ——> 结果 #其中 卷积网络 + 算法 称为 深度学习

优秀的个人博客,低调大师

lvs简单入门

只解决c10k问题是不够的,单台主机的处理能力是有限的,一台主机同时处理500个动态网页请求已经是极限了。这里有两种方法提升处理性能,一,定制高性能的计算机,众所周知计算机硬件设计成本极其高,性能每提高10%成本就要增加一倍,这也是intel被称为挤牙膏公司的原因,不是其研发能力不行而是计算机硬件性能提升的难度太大,这个方法貌似不可行。二,使用两台主机处理业务,这就会引来一个问题怎么把请求分发到两个主机,这里我们引入了负载均衡器。 # 目录 负载均衡 lvs工作方式和调度方法 ipvsadm的使用 lvs-nat lvs-dr 多端口绑定和持久连接 # 负载均衡 使用负载均衡有两个方法,一是采用商用负载均衡硬件的,这个方法是最好的方法,能上硬件一定不要使用软件,又是硬件同样的问题也是价格,只要是涉及到基础设施的服务一定要使用。一方面是硬件的稳定性,比软件好很多,虽然软件可维护性和拓展性比较好,但是对于一些金融公司,他们玩的就是公信力和大众信心,每个故障都是竞争对手拆台的理由,一旦故障硬件背锅,理赔。常用的硬件F5的Big-IP,Citrix的Netscaler,A10的A10 另一种是采用软件负载均衡,只要考虑成本使用负载均衡软件就对了,它的性能比硬件也不会差别太大,并且灵活。常用的有lvs,nginx,haproxy,ats。。。 在做负载均衡的时候,我们在7层模型的哪一层做负载均衡,ip层基于主机做负载均衡粒度太大可用性太差基本不使用,更低的层基本上没有价值了,tcp层的话我们就可以把不同服务的请求采取不同的方式负载均衡,应用层的话我们可以根据具体协议拆包分析后负载均衡,既然涉及到拆开数据包,那处理的数据量就会大大增加,那么对计算机性能要求也越高,性能就越差,并且负载均衡器的通用性也越差。 传输层:lvs,nginx:(stream),haproxy:(mode tcp) 应用层: http:nginx, httpd, haproxy(mode http) fastcgi:nginx, httpd mysql:mysql-proxy # lvs工作方式和调度方法 ### lvs的工作方式 有四种lvs-nat,lvs-dr,lvs-tun,lvs-fullnat lvs集群类型中的术语: vs:Virtual Server, Director, Dispatcher, Balancer rs:Real Server, upstream server, backend server CIP:Client IP, VIP: Virtual serve IP, RIP: Real server IP, DIP: Director IP * lvs-nat 它的工作机制类似iptables的dnat功能,但是它工作于input链上。一次请求过程如下图 当客户端向director发送数据,数据在input链上目的地址vip换为rip后,被转发到postrouting链上过滤后发送到real server,real server处理完后把数据发送到director,director把这个数据的源地址rip更改为vip,当然lvs-nat不仅仅是更改ip也可以更改端口,所以支持端口映射,由以上可以总结nat的特点,rip和dip必须在同一网络中,rs的网关需要指向dip,因为所以的数据必须经过director更改ip。 这种工作方式director很容成为网络瓶颈,因为所以的数据都要经过director,director网卡的吞吐量就代表整个网站的流量吞吐量,当今世界的慢慢走向5G,director是完全不能满足需求的,需要借助其它网络设备帮助director分担流量,这就引入了lvs-dr模型。 * lvs-dr 如图,lvs-dr也是在input链上更改数据,但是它更改的不是ip地址而是mac地址,它把目的mac地址vmac更改为rmac,这里就要求vip,rip,dip必须在广播域内,但是地址不一定要在一个网段,因为他们间的通信需要使用mac直接通信。realserver处理请求后直接把数据返回给客户端。 等等,不对啊!realserver是怎么给客户端发送数据包的,realserver服务器上只有rip怎么用vip给客户端通信,这里需要我们给realserver配置vip。但是有一个问题,在网络中多个主机拥有同一个ip会产生冲突的,我们的解决方案是只让一个主机发送arp广播并且响应arp请求,选谁毋庸置疑只能选择director。 控制arp广播arp-ignore,0广播,1不广播;控制响应arp-announce,0响应所有接口信息,1尽量只响应当前网卡的信息,2只响应当前网卡的信息 lvs-dr的使用方法有两种,一种是每个realserver都有与公网交互的公网ip,另一种是只有内网ip,之后演示。 * lvs-tun 它是在原本的报文外部继续封装一个ip头,有可能造成超级帧 * lvs-fullnat 它是把源ip和目的ip都更改,相当于director请求realserver,realserver响应回来数据再把两个ip地址更改,这样这个数据包就可以跨越路由通信了,nat本来就会造成director网络瓶颈,它的使用场景主要应用于请求数据量不大但后服务器数量很多的场景。 ### 调度方法 调用方法可以分为两类,一类是静态调度算法,一类是动态调用算法 * 静态算法 rr #以轮询的方法,把请求转发到后端的主机 wrr #加权轮询,把请求按照一定的比例转发后端主机 sh #源地址哈希,把源地址做hash运算后,把realserver也hash,每个realserver只处理自己hash和上一realserver的hash之间的源地址的请求如图 dh #目标地址哈希,这样realserver可以开启缓存了 * 动态算法 lc #最少连接,根据realserver的正在处理请求的数量进行调度,Overhead=activeconns*256+inactiveconns wlc #加权最少连接,Overhead=(activeconns*256+inactiveconns)/weight nq #在lc的基础上改进的,意思是不许有realserver主机空闲 sed #最短等等时间,Overhead=(activeconns+1)*256/weight lblc #动态的DH算法;基于地址的最小连接数调度(locality-based least-connection):将来自同一个目的地址的请求分配给同一台RS,此时这台服务器是尚未满负荷的。否则就将这个请求分配给连接数最小的RS,并以它作为下一次分配的首先考虑 lblcr #带复制功能的lblc # ipvsadm的使用 管理集群服务:增、改、删; 增、改: ipvsadm -A|E -t|u|f service-address [-s scheduler] [-p [timeout]] 删: ipvsadm -D -t|u|f service-address [-s scheduler]:指定集群的调度算法,默认为wlc service-address: -t|u|f: -t: TCP协议的端口,VIP:TCP_PORT -u: TCP协议的端口,VIP:UDP_PORT -f:firewall MARK,是一个数字; 管理集群上的RS:增、改、删; 增、改: ipvsadm -a|e -t|u|f service-address -r server-address [-g|i|m] [-w weight] 删: ipvsadm -d -t|u|f service-address -r server-address server-address: rip[:port] # lvs-nat nat实验拓扑图 这个使用我采用的是虚拟机,主机ip做cip,director的vip采用的桥接网络,dip和rip采用的是仅主机模式 realserver1执行的命令 yuminstallhttpd-y#安装httpd echors1>/var/www/html/index.html#提供网页文件 realserver2执行的命令 yuminstallhttpd-y echors2>/var/www/html/index.html director执行的命令 yuminstallipvsadm-y ipvsadm-A-t172.16.29.4:80-swrr ipvsadm-a-t172.16.29.4:80-r192.168.95.2-m-w1 ipvsadm-a-t172.16.29.4:80-r192.168.95.3-m-w2 # lvs-dr ### 都采用公网ip的方案 所有网卡都采用桥接 director执行的命令 ifconfigeno16777736:0172.16.29.4netmask255.255.255.255broadcast172.16.29.4up#若在directer和realserver在同一个网段里一定要使用这一行 ipvsadm-A-t172.16.29.4:80-swrr ipvsadm-a-t172.16.29.4:80-r172.16.29.10-g-w1 ipvsadm-a-t172.16.29.4:80-r172.16.29.20-g-w2 realserver执行的命令 echo1>/proc/sys/net/ipv4/conf/all/arp_ignore echo1>/proc/sys/net/ipv4/conf/lo/arp_ignore echo2>/proc/sys/net/ipv4/conf/lo/arp_announce echo2>/proc/sys/net/ipv4/conf/all/arp_announce ifconfiglo:0172.16.29.4netmask255.255.255.255broadcast172.16.29.4up routeadd-host172.16.29.4devlo:0 ### 只要一个公网ip的解决方案 全部接口采用的仅主机模式,并且每个主机只有一个网卡,每个网卡都先配置一个ip,后期再添加需要的ip director要执行的命令 ifconfigeno16777736:0192.168.95.20netmask255.255.255.0broadcast192.168.95.20 ipvsadm-A-t192.168.95.20:80-swrr ipvsadm-a-t192.168.95.20:80-r10.0.0.10-g-w2 ipvsadm-a-t192.168.95.20:80-r10.0.0.20-g-w2 realserver需要执行的命令 echo1>/proc/sys/net/ipv4/conf/all/arp_ignore echo1>/proc/sys/net/ipv4/conf/lo/arp_ignore echo2>/proc/sys/net/ipv4/conf/lo/arp_announce echo2>/proc/sys/net/ipv4/conf/all/arp_announce ifconfiglo:0192.168.95.20netmask255.255.255.255broadcast192.168.95.20up routeadd-host192.168.95.20devlo:0 routeadddefaultgw10.0.0.1 路由设备需要执行的命令 echo 1 > /pro/sys/net/ipv4/ip_forward #开启转发功能 # 多端口绑定和持久连接 ### FWM:FireWall Mark 借助于防火墙标记来分类报文,而后基于标记定义集群服务;可将多个不同的应用使用同一个集群服务进行调度; 打标记方法(在Director主机): # iptables -t mangle -A PREROUTING -d $vip -p $proto --dport $port -j MARK --set-mark NUMBER 基于标记定义集群服务: # ipvsadm -A -f NUMBER [options] ### lvs persistence:持久连接 持久连接模板:实现无论使用任何算法,在一段时间内,实现将来自同一个地址的请求始终发往同一个RS; ipvsadm -A|E -t|u|f service-address [-s scheduler] [-p [timeout]] port Affinity: 每端口持久:每集群服务单独定义,并定义其持久性; 每防火墙标记持久:基于防火墙标记定义持久的集群服务;可实现将多个端口上的应用统一调度,即所谓的port Affinity; 每客户端持久:基于0端口定义集群服务,即将客户端对所有应用的请求统统调度至后端主机,而且可使用持久连接进行绑定; # 总结 lvs是负载均衡器中最基本的,理解了它的原理和使用方法,基本上掌握了大多数的负载均衡器的原理。其中dr模型是必须掌握的,真正使用的话我感觉会使用dr,net的功能很有可能被7层代理的服务器替代了。多端口绑定功能也很常用比如80和443端口绑定统一调度;持久连接虽然破坏调度效果,但是在没有session缓存服务器的话还是很高效的。

优秀的个人博客,低调大师

Docker入门简介

Docker的概念 什么是Docker? Docker是一个开源平台,包含:容器引擎和Docker Hub注册服务器 Docker容器引擎:可以将开发者打包他们的应用和依赖包到一个可一直的容器中,然后将其发布到任何流行的Linux机器上。 Docker Hub 注册服务器:用户可以该注册服务器上创建自己的镜像库来存储、管理和分享镜像。利用Docker,可以实现软件一次配置,处处运行 RedHat从RHEL6.5开始集成对Docker的支持。 容器与虚拟机 Docker是容器的一种,容器是一种轻量级的虚拟技术,重量级的则是虚拟机,例如VMware,VirtualBox等 容器与虚拟机的对比 容器 虚拟机 相同点 都可以在不同的主机之间迁移 都具备root权限 都可以远程控制 都有备份,回滚操作 操作系统 在性能上有优势,能够轻易的同时运行多个操作系统 可以安装任何操作系统,性能不急容器 优点 更为高效,集中。一个硬件节点可以运行数以百计的容器,非常节省资源。Qos会尽量满足,但不保证一定满足,内核由提供者升级,服务由服务器提供者管理 对操作系统具有绝对的权限,对系统版本和升级具有完全管理权限。具有一整套的资源:CPU,RAM和磁盘,QoS是具有保证的。每一个操作虚拟机像一个真实的物理机一样,可以实现不同的操作系统同时运行在同一个物理节点上。 资源管理 弹性的资源分配:资源可以在没有关闭容器的情况下添加,数据卷也无需重新分配大小(有些服务的容器需要重启) 虚拟机需要重启,虚拟机里的操作系统需要处理新加入的资源,例如添加一块磁盘,则需要重新分区等 远程管理 根据操作系统的不同,会通过shell或者远程桌面进行,前提是容器内的操作系统已经启动 远程控制由虚拟化平台提供,可以在虚拟机启动之前连接。所以可以安装系统 缺点 对内核没有控制权限,只有容器的提供者具备升级权限。只有一个内核运行在物理节点上,几乎不能实现不同的操作系统混合。容器提供者一般仅提供少数的几款操作系统 每一台虚拟机具有更大的负载,耗费更多的资源,用于需要全权维护和管理。一台物理机上能够运行的虚拟机也非常有限 配置 快速,秒级即可准备好,由容器提供者处理 配置时间长,从几分钟到几小时,具体取决于操作系统,需要自行安装操作系统 启动时间 秒级 分钟级 硬盘使用 MB GB 性能 接近原生态 若于原生态 系统支持量 单机支持上千个容器 一般不多于几十个 Docker的应用场景 Docker几种典型的应用场景 加速本地开发,通过Docker能够快速搭建好开发和运行环境,并且该环境可以直接传递给测试和产品部署 自动打包和部署应用 创建轻量、私有的PaaS环境 自动化测试和持续集成/部署 部署并扩展Web应用、数据库和后端服务器 创建安全沙盒子 轻量级桌面虚拟化 Docker的组件 Docker采用的是C/S架构 Docker客户端,即Docker可执行程序,可以通过命令和API的形式与Docker守护程序进行通信,Docker守护程序提供Docker服务 Docker包含三大核心组件:镜像、容器和库 镜像:一个只读的静态模板。保存着容器需要的环境和应用的执行代码,可以把镜像看成容器的代码。当代码运行起来后就成了容器。镜像采用分层机制,每个镜像都是只读的,但是可以将写数据的层通过联合文件系统附加在原有镜像之上,这种增量式修改使得镜像非常容易存储、传输和更新。 容器:是一个运行时环境,它是一个镜像的运行状态,相对于静态的镜像而言。容器是镜像执行时的动态表现。 库:Docker采用注册服务器来存储和共享用户的镜像,库是某个特定用户存储镜像的目录。 AUFS Docker利用AUFS来实现对容器的快速更新。 AUFS是一种支持将不同目录挂载到同一个虚拟文件系统下的文件系统,支持对每个目录的读写权限管理。另外,AUFS具有层的概念,每一次修改都是在已有的只写层进行增量修改,修改内容将形成新的文件层,而不影响原有层。 Docker的安装 安装环境: 内核版本 [root@docker ~]# uname -r 2.6.32-573.el6.x86_64 [root@docker ~]# 系统版本 [root@docker ~]# cat /etc/redhat-release CentOS release 6.7 (Final) [root@docker ~]# 注意:如果使用RedHat linux或者Centos linux ,需要时6.5以上的版本以及内核版本在2.6.32-431以上 安装EPEL的命令 rpm -Uvh http://mirror.math.princeton.edu/pub/epel/6/x86_64/epel-release-6-8.noarch.rpm 安装Docker yum install docker-io –y 启动Docker后台 ./etc/init.d/docker start 确认Doocker安装成功 [root@docker ~]# docker info Containers: 0 Images: 0 Storage Driver: devicemapper Pool Name: docker-8:3-3016327-pool Pool Blocksize: 65.54 kB Backing Filesystem: extfs Data file: /dev/loop0 Metadata file: /dev/loop1 Data Space Used: 305.7 MB Data Space Total: 107.4 GB Data Space Available: 78.07 GB Metadata Space Used: 729.1 kB Metadata Space Total: 2.147 GB Metadata Space Available: 2.147 GB Udev Sync Supported: true Deferred Removal Enabled: false Data loop file: /var/lib/docker/devicemapper/devicemapper/data Metadata loop file: /var/lib/docker/devicemapper/devicemapper/metadata Library Version: 1.02.95-RHEL6 (2015-04-15) Execution Driver: native-0.2 Logging Driver: json-file Kernel Version: 2.6.32-573.el6.x86_64 Operating System: <unknown> CPUs: 1 Total Memory: 1.826 GiB Name: docker ID: ZRF4:2E26:P3LZ:TK37:5HJG:5VP3:HUVQ:NSMR:J6BG:WMWO:YEDJ:MDGZ 所有的努力都值得期许,每一份梦想都应该灌溉!

优秀的个人博客,低调大师

docker快速入门

1、docker简介 docker通过内核虚拟化技术(namespace及cgroups等)来提供容器的资源隔离与安全保障等,由于docker通过操作系统层的虚拟化实现隔离,所以docker容器在运行时,不需要类似虚拟机额外的操作系统开销,提供资源利用率 2、docker vs kvm 3、docker组件 镜像、容器、仓库 4、docker安装 [root@docker~]#tee/etc/yum.repos.d/docker.repo<<-'EOF' [dockerrepo] name=DockerRepository baseurl=https://yum.dockerproject.org/repo/main/centos/7/ enabled=1 gpgcheck=1 gpgkey=https://yum.dockerproject.org/gpg EOF [root@docker~]#yuminstalldocker-engine-y 5、docker基础操作 [root@docker~]#systemctlenabledocker.service Createdsymlinkfrom/etc/systemd/system/multi-user.target.wants/docker.serviceto/usr/lib/systemd/system/docker.service. [root@docker~]#systemctlstartdocker.service [root@docker~]# [root@docker~]#dockerpullcentos#拉取镜像 [root@docker~]#dockerpulldaocloud.io/library/nginx 有时候拉取速度很慢,采用国内源加速 root@docker~]#vim/usr/lib/systemd/system/docker.service增加下面这行 EnvironmentFile=/etc/sysconfig/docker 新建配置文件[root@docker~]#vim/etc/sysconfig/docker 在https://dashboard.daocloud.io/注册,然后点击加速器生成加速链接 OPTIONS=--registry-mirror=curl-sSLhttps://get.daocloud.io/daotools/set_mirror.sh|sh-s [root@docker~]#dockersearchnginx#搜索镜像 [root@docker~]#dockerp_w_picpaths REPOSITORYTAGIMAGEIDCREATEDSIZE centoslatest0584b3d2cf6d2weeksago196.5MB 导出镜像 [root@docker~]#dockersave-onginx.tardaocloud.io/library/nginx [root@docker~]#dockersave-ocnetos.tarcentos 导入镜像 [root@docker~]#dockerload--inputcnetos.tar或者[root@docker~]#dockerload<cnetos.tar 删除镜像 [root@docker~]#dockerrmi0584b3d2cf6d(镜像ID) [root@docker~]#dockerruncentos/bin/echo"Helloworld" Helloworld [root@docker~]#dockerps-a CONTAINERIDIMAGECOMMANDCREATEDSTATUSPORTSNAMES 5e381e68a385centos"/bin/echo'Hellowor"6secondsagoExited(0)5secondsagoclever_lamarr [root@docker~]#dockerrun--namemydocker-t-icentos/bin/bash [root@1a67f4c92b6e/]# [root@1a67f4c92b6e/]#ps-ef UIDPIDPPIDCSTIMETTYTIMECMD root10018:56?00:00:00/bin/bash root141018:56?00:00:00ps-ef [root@1a67f4c92b6e/]#exit exit [root@docker~]#dockerps-a CONTAINERIDIMAGECOMMANDCREATEDSTATUSPORTSNAMES 1a67f4c92b6ecentos"/bin/bash"12minutesagoExited(0)6secondsagomydocker 5e381e68a385centos"/bin/echo'Hellowor"16minutesagoExited(0)16minutesagoclever_lamarr [root@docker~]#dockerrun--namedocker-demo-dcentos/bin/bash-d代表放入后台执行 6c5a777467b9552714f9cd3322e677750e2b8b5b0bd2d81e79094ad560828a5e [root@docker~]#dockerps-a CONTAINERIDIMAGECOMMANDCREATEDSTATUSPORTSNAMES 6c5a777467b9centos"/bin/bash"11secondsagoExited(0)11secondsagodocker-demo 1a67f4c92b6ecentos"/bin/bash"17minutesagoExited(0)4minutesagomydocker 5e381e68a385centos"/bin/echo'Hellowor"21minutesagoExited(0)21minutesagoclever_lamarr [root@docker~]#dockerstopmydocker停止容器 [root@docker~]#dockerstart1a67f4c92b6e启动容器 [root@docker~]#dockerrun-d--namemynginxdaocloud.io/library/nginx 225a9b0459630c62dcf2199d6244b16a74ad9412471abf0be03755768df3ae63 [root@docker~]# [root@docker~]#dockerps CONTAINERIDIMAGECOMMANDCREATEDSTATUSPORTSNAMES 225a9b045963daocloud.io/library/nginx"nginx-g'daemonoff"6secondsago Up5seconds80/tcp,443/tcpmynginx 进入容器脚步 [root@docker~]#catdocker_in.sh #!/bin/bash docker_in(){ NAME_ID=$1 PID=$(dockerinspect--format"{{.State.Pid}}"$NAME_ID) nsenter-t$PID-m-u-i-n-p } docker_in$1 6、docker网络 root@docker~]#dockerrun-d-P--namenginx-test1daocloud.io/library/nginx 9b1d36d40127fe2c84bbe7750802e435a817a15b4159b24fc49bfb1107a2cb74 [root@docker~]#dockerps-l CONTAINERIDIMAGECOMMANDCREATEDSTATUSPORTSNAMES 9b1d36d40127daocloud.io/library/nginx"nginx-g'daemonoff"2minutesagoUp2minutes0.0.0.0:32769->80/tcp,0.0.0.0:32768->443/tcpnginx-test1 [root@docker~]#netstat-lntup|grep32768 tcp600:::32768:::*LISTEN11213/docker-proxy [root@docker~]#curl-Ihttp://172.16.80.132:32769 HTTP/1.1200OK Server:nginx/1.11.5 Date:Thu,24Nov201605:58:47GMT Content-Type:text/html Content-Length:612 Last-Modified:Tue,11Oct201615:03:01GMT Connection:keep-alive ETag:"57fcff25-264" Accept-Ranges:bytes 转换前 [root@docker~]#iptables-L-n ChainINPUT(policyACCEPT) targetprotoptsourcedestination ACCEPTall--0.0.0.0/00.0.0.0/0stateRELATED,ESTABLISHED ACCEPTicmp--0.0.0.0/00.0.0.0/0 ACCEPTall--0.0.0.0/00.0.0.0/0 ACCEPTtcp--0.0.0.0/00.0.0.0/0stateNEWtcpdpt:22 REJECTall--0.0.0.0/00.0.0.0/0reject-withicmp-host-prohibited ChainFORWARD(policyACCEPT) targetprotoptsourcedestination DOCKER-ISOLATIONall--0.0.0.0/00.0.0.0/0 DOCKERall--0.0.0.0/00.0.0.0/0 ACCEPTall--0.0.0.0/00.0.0.0/0ctstateRELATED,ESTABLISHED ACCEPTall--0.0.0.0/00.0.0.0/0 ACCEPTall--0.0.0.0/00.0.0.0/0 REJECTall--0.0.0.0/00.0.0.0/0reject-withicmp-host-prohibited ChainOUTPUT(policyACCEPT) targetprotoptsourcedestination ChainDOCKER(1references) targetprotoptsourcedestination ChainDOCKER-ISOLATION(1references) targetprotoptsourcedestination RETURNall--0.0.0.0/00.0.0.0/0 转换后 [root@docker~]#dockerrun-d-P--namenginx-test1daocloud.io/library/nginx 42783cf5053639383004f82b9e72fe0223c7c028d2754b2d0f74429824715f05 [root@docker~]#dockerps-l CONTAINERIDIMAGECOMMANDCREATEDSTATUSPORTSNAMES 42783cf50536daocloud.io/library/nginx"nginx-g'daemonoff"9secondsagoUp7seconds0.0.0.0:32769->80/tcp,0.0.0.0:32768->443/tcpnginx-test1 [root@docker~]#iptables-L-n ChainINPUT(policyACCEPT) targetprotoptsourcedestination ACCEPTall--0.0.0.0/00.0.0.0/0stateRELATED,ESTABLISHED ACCEPTicmp--0.0.0.0/00.0.0.0/0 ACCEPTall--0.0.0.0/00.0.0.0/0 ACCEPTtcp--0.0.0.0/00.0.0.0/0stateNEWtcpdpt:22 REJECTall--0.0.0.0/00.0.0.0/0reject-withicmp-host-prohibited ChainFORWARD(policyACCEPT) targetprotoptsourcedestination DOCKER-ISOLATIONall--0.0.0.0/00.0.0.0/0 DOCKERall--0.0.0.0/00.0.0.0/0 ACCEPTall--0.0.0.0/00.0.0.0/0ctstateRELATED,ESTABLISHED ACCEPTall--0.0.0.0/00.0.0.0/0 ACCEPTall--0.0.0.0/00.0.0.0/0 REJECTall--0.0.0.0/00.0.0.0/0reject-withicmp-host-prohibited ChainOUTPUT(policyACCEPT) targetprotoptsourcedestination ChainDOCKER(1references) targetprotoptsourcedestination ACCEPTtcp--0.0.0.0/0172.17.0.2tcpdpt:443 ACCEPTtcp--0.0.0.0/0172.17.0.2tcpdpt:80 ChainDOCKER-ISOLATION(1references) targetprotoptsourcedestination RETURNall--0.0.0.0/00.0.0.0/0 [root@docker~]#shdocker_in.shnginx-test1 root@42783cf50536:/# root@42783cf50536:/# root@42783cf50536:/#ipaddr 1:lo:<LOOPBACK,UP,LOWER_UP>mtu65536qdiscnoqueuestateUNKNOWNgroupdefault link/loopback00:00:00:00:00:00brd00:00:00:00:00:00 inet127.0.0.1/8scopehostlo valid_lftforeverpreferred_lftforever inet6::1/128scopehost valid_lftforeverpreferred_lftforever 4:eth0:<BROADCAST,MULTICAST,UP,LOWER_UP>mtu1500qdiscnoqueuestateUPgroupdefault link/ether02:42:ac:11:00:02brdff:ff:ff:ff:ff:ff inet172.17.0.2/16scopeglobaleth0 valid_lftforeverpreferred_lftforever inet6fe80::42:acff:fe11:2/64scopelink valid_lftforeverpreferred_lftforever 7、docker数据存储 [root@docker~]#dockerrun-d--namenginx-volume-test1-v/datadaocloud.io/library/nginx 88b24d79a4f3b021325592ceac20e86291166d675b213d60db017548c4d9d960 [root@docker~]#shdocker_in.shnginx-volume-test1 root@88b24d79a4f3:/#cd/data/ root@88b24d79a4f3:/data#ls root@88b24d79a4f3:/data#touchhehe root@88b24d79a4f3:/data#ls-l total0 -rw-r--r--1rootroot0Nov2406:30hehe [root@docker~]#cd/var/lib/docker/ [root@dockerdocker]#ll total32 drwx------6rootroot4096Nov2414:28containers drwx------5rootroot4096Nov2402:05devicemapper drwx------3rootroot4096Nov2401:20p_w_picpath drwxr-x---3rootroot4096Nov2401:20network drwx------2rootroot4096Nov2401:20swarm drwx------2rootroot4096Nov2410:09tmp drwx------2rootroot4096Nov2401:20trust drwx------3rootroot4096Nov2414:28volumes [root@dockerdocker]#cdvolumes/ [root@dockervolumes]#ls 4c60775f938a840e5484aee9088bc612977c25a01f5bd164690d94c962e66e60metadata.db [root@dockervolumes]#cd4c60775f938a840e5484aee9088bc612977c25a01f5bd164690d94c962e66e60/ [root@docker4c60775f938a840e5484aee9088bc612977c25a01f5bd164690d94c962e66e60]#ls _data [root@docker4c60775f938a840e5484aee9088bc612977c25a01f5bd164690d94c962e66e60]#cd_data/容器内的文件实际在物理机上面的的保存目录 [root@docker_data]#ls hehe [root@docker~]#dockerrun-d--namenginx-volume-test2-v/data/mysql:/mysqldaocloud.io/library/nginx f7278ce9bd88c26a0c5aaefcb2b39f1f9df0066bc94edb7a530213815e166f5e #-v/data/mysql:/mysql表示把物理机的/data/mysql目录挂载到容器内的/mysql目录下面 [root@docker~]#dockerrun-d--namenginx-volumes-v/data/mysql:/mysqldaocloud.io/library/nginx 28c616e44352fc4eafeb2f87dbbb7b6eb9df447235afe027034efa96df1c5071 [root@docker~]# [root@docker~]#dockerrun-d--nameweb-node1--volumes-fromnginx-volumesdaocloud.io/library/nginx 0f022ce56e8b800cb1a4ac76bb8a326d42e198093146e8661ad3ac8925ad317d [root@docker~]# [root@docker~]#dockerrun-d--nameweb-node2--volumes-fromnginx-volumesdaocloud.io/library/nginx 03d5e88c15f6604eeee2b8af500b8f356ba69adc34710f3c19b813530f19dc3d

优秀的个人博客,低调大师

《Java从入门到放弃》JavaSE入门篇:程序结构

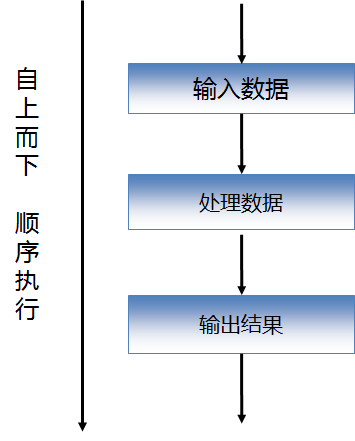
程序的结构一般分为三种: 顺序结构。 选择结构。 循环结构。 一、顺序结构:这个不用多说吧,跟我们平时写文章的顺序一样,从上往下。 二、选择结构:从名字就能看出,要选择嘛,到底是要漂亮滴妹子,还是要有钱滴妹子呢!当然,如果是个吊丝码农滴话,那你就不要多想了,还是老老实实码代码吧··· 三、循环结构:循环啊,就是一直转啊转啊转啊,转到出意外为止。 接下来还是老规矩,通过小示例来学习语法吧。 顺序结构: 一、输入姓名和年龄,输出自我介绍。 publicstaticvoidmain(String[]args){ //创建输入数据的对象,具体什么叫对象···,先不用管吧 Scannerinput=newScanner(System.in); Stringname;//姓名 intage;//年龄 System.out.print("请输入姓名:"); name=input.next(); System.out.print("请输入年龄:"); age=input.nextInt(); System.out.println("大家好,我叫"+name+",今年"+age+"岁,请多关照。"); } 注意: 这就是一个标准的顺序结构,代码会从上往下执行,如果你把int age;这句话放到最后,那就会在age = input.nextInt();这一行报语法错误了。 结果: 选择结构: 选择结构的语法有四种,我们通过下面的案例来了解。 一、输入你的存款,如果大于5000则加上“壕”的头衔。 publicstaticvoidmain(String[]args){ //创建输入数据的对象,具体什么叫对象···,先不用管吧 Scannerinput=newScanner(System.in); Stringname;//姓名 intdeposit;//存款 System.out.print("请输入姓名:"); name=input.next(); System.out.print("请输入存款:"); deposit=input.nextInt(); System.out.print("大家好,我叫"+name); if(deposit>5000){ System.out.print("(壕)"); } System.out.println("。"); } 语法: if( 条件 ){ 要执行的代码 } 注意: 条件成立时会执行{}中的所有代码。 结果: 二、输入你的存款,如果大于5000则加上“壕”的头衔,否则加上“穷13”的头衔。 if(deposit>5000){ System.out.print("(壕)"); } else{ System.out.print("(穷13)"); } 注意:别的代码不用动,只需要在if(){}结构上加上else{}就OK了,else{}表示条件不成立时的执行代码。 结果: 三、输入你的存款,如果大于50000,则加上“神壕”的头衔,否则如果大于30000,则加上“金壕”的头衔,否则如果大于10000,则加上“壕”的头衔,否则加上“穷13”的头衔。 if(deposit>50000){ System.out.print("(神壕)"); } elseif(deposit>30000){ System.out.print("(金壕)"); } elseif(deposit>10000){ System.out.print("(壕)"); } else{ System.out.print("(穷13)"); } 注意:这种语法叫多分支选择结构(一般用于选择情况大于2的场合,比如演唱会门票的级别、你的女神的胸肌是A还是BCDEF等)。 结果就不展示了。 四、查询余额请按1,套餐更改请按2,宽带业务请按3,企业业务请按4,人工服务请按5,其它业务请瞎按. publicstaticvoidmain(String[]args){ //创建输入数据的对象,具体什么叫对象···,先不用管吧 Scannerinput=newScanner(System.in); intnum; System.out.print("1.查询余额请按1," +"\n2.套餐更改请按2" +"\n3.宽带业务请按3" +"\n4.企业业务请按4" +"\n5.人工服务请按5" +"\n6.其它业务请瞎按" +"\n请选择:"); num=input.nextInt(); switch(num){ case1: System.out.println("您的余额为0。");break; case2: System.out.println("改完了,请回吧。");break; case3: System.out.println("宽带装好了,请交钱1998¥。");break; case4: System.out.println("请上传企业注册资料。");break; case5: System.out.println("我们正在招聘服务人员,请稍等...");break; default: System.out.println("乱按好玩吧...");break; } } 注意: switch语法一般用于数值类型和布尔类型等值判断的场合,最新版的JDK支持String类型了。小伙伴们可以自己试试。 每个case后的语句执行完后都有个小尾巴(break;),表示从这儿退出switch结构,大家可以把这个小尾巴去掉看看结果有什么不一样。 结果: 循环结构: 循环结构常用的有四种:while、do...while、for、foreach(后面讲集合时再介绍)。 对应的语法都很简单,我们通过求100以内的奇数和来了解一下,后面再来分析一个经典案例。 publicstaticvoidmain(String[]args){ //求100以内的奇数和 //1.while循环 inti=1;//循环的初值 ints=0;//保存和 while(i<=100){//循环的条件 s+=i;//循环的内容 i+=2;//循环的步长(也就是循环变量的值如何变化) } System.out.println("while循环结果:"+s); //变量值还原 i=1; s=0; //2.do...while循环 do{ s+=i; i+=2; }while(i<=100); System.out.println("do...while循环结果:"+s); //变量值还原 s=0; //3.for循环 for(i=1;i<=100;i+=2){ s+=i; } System.out.println("for循环结果:"+s); } 执行结果: 从上面的语法应该可以看出,循环主要有四个点:初值、条件、步长、循环体(内容)。那么这三种循环的语法有什么区别呢? while循环:侧重于不确定循环次数的场合,先判断,如果条件成立则进入循环。 do...while循环:侧重于不确定循环次数的场合,先执行一次,之后如果条件成立则时入循环。 for循环:侧重于确定循环次数的场合。 与循环配合使用的还有两个关键字:continue和break; 他们的作用,看代码和结果吧: publicstaticvoidmain(String[]args){ for(inti=0;i<10;i++){ if(i==5){ continue; } System.out.print(i+","); } System.out.println("\n======================="); for(inti=0;i<10;i++){ if(i==5){ break; } System.out.print(i+","); } } 结果: 注意到两个的区别了吧 运行continue后,就不再执行循环里面continue后面的代码,直接运行i++去了。 而运行break后,则直接跳出了循环,后面的都不执行了。 经典案例:登录功能,如果账号密码输入正确则登录成功,否则请再次输入密码。 分析: 登录时要输入几次账号密码?很明显不知道啊!!!所以for循环被排除了。 然后再判断,是要先输入账号密码后判断,还是先判断后再输入账号密码呢? 这也很明显,要先输入了才需要判断啊!!!所以while循环也被排除了。 最后就剩下do...while循环了。代码如下: publicstaticvoidmain(String[]args){ //模拟登录功能 //分析过程: //1.定义保存账号和密码的变量 Scannerinput=newScanner(System.in); StringinLoginID; StringinLoginPWD; //2.因为还没学习数据库,所以定义两个变量保存正确的账号和密码 StringloginID="liergou"; StringloginPWD="haha250"; //3.输入账号和密码 do{ System.out.print("请输入账号:"); inLoginID=input.next(); System.out.print("请输入密码:"); inLoginPWD=input.next(); //4.判断输入的账号和密码与正确的是否相同(判断字符串是否相等使用equals方法), //如果相同等提示登录成功,循环结束,否则提示重新输入 if(inLoginID.equals(loginID)&&inLoginPWD.equals(loginPWD)){ System.out.println("登录成功!"); break; } else{ System.out.println("账号和密码不匹配,请重新输入!"); } }while(true); } 如果你非要使用while和for,那··············当然也是可以滴,只不过代码复杂度会上升,特别是使用for来写的话会很奇怪,大伙可以看看: 这是使用while的写法 publicstaticvoidmain(String[]args){ //模拟登录功能 //分析过程: //1.定义保存账号和密码的变量 Scannerinput=newScanner(System.in); StringinLoginID; StringinLoginPWD; //2.因为还没学习数据库,所以定义两个变量保存正确的账号和密码 StringloginID="liergou"; StringloginPWD="haha250"; //3.输入账号和密码 System.out.print("请输入账号:"); inLoginID=input.next(); System.out.print("请输入密码:"); inLoginPWD=input.next(); while(true){ //4.判断输入的账号和密码与正确的是否相同(判断字符串是否相等使用equals方法), //如果相同等提示登录成功,循环结束,否则提示重新输入 if(inLoginID.equals(loginID)&&inLoginPWD.equals(loginPWD)){ System.out.println("登录成功!"); break; } else{ System.out.println("账号和密码不匹配,请重新输入!"); //下面的代码重复了 System.out.print("请输入账号:"); inLoginID=input.next(); System.out.print("请输入密码:"); inLoginPWD=input.next(); } } } 下面是使用for的写法 for(;true;){ //4.判断输入的账号和密码与正确的是否相同(判断字符串是否相等使用equals方法), //如果相同等提示登录成功,循环结束,否则提示重新输入 if(inLoginID.equals(loginID)&&inLoginPWD.equals(loginPWD)){ System.out.println("登录成功!"); break; } else{ System.out.println("账号和密码不匹配,请重新输入!"); //下面的代码重复了 System.out.print("请输入账号:"); inLoginID=input.next(); System.out.print("请输入密码:"); inLoginPWD=input.next(); } } 最后,再布置几个练习,各位看官自己分析并练习练习吧,看具体使用哪种循环最好。 1.打印出所有的"水仙花数",所谓"水仙花数"是指一个三位数,其各位数字立方和等于该数本身。例如:153是一个"水仙花数",因为153=1的三次方+5的三次方+3的三次方。 2.将一个正整数分解质因数。例如:输入90,打印出90=2*3*3*5。 3. 球从100M高度自由落下,每次落地后反跳回原高度的一半,再落下,求它在第10次落地时,共经过多少M?第10次反弹多高? 4. 任意输入一个整数(小于6位),求它的位数询问 5. “我爱你,嫁给我吧?”,选择“你喜欢我吗?(y/n):",如果输入为y则打印”我们形影不离“,若输入为n,则继续询问 如果有不确定答案的练习,就在评论里讨论吧··· “软件思维”博客地址:51CTO感兴趣的小伙伴可以去看相关的其它博文。

优秀的个人博客,低调大师

了解TiDB基础入门

由于目前的项目把mysql换成了TiDb,所以特意来了解下tidb。其实也不能说换,由于tidb和mysql几乎完全兼容,所以我们的程序没有任何改动就完成了数据库从mysql到TiDb的转换,TiDB 是一个分布式 NewSQL SQL 、 NoSQL 和 NewSQL 的优缺点比较 数据库。它支持水平弹性扩展、ACID 事务、标准 SQL、MySQL 语法和 MySQL 协议,具有数据强一致的高可用特性,是一个不仅适合 OLTP 场景还适合 OLAP 场景的混合数据库。下面是对有关资料的整理还有一些扩展内容以链接的方式展示,有兴趣可以点击了解一下。

优秀的个人博客,低调大师

Jupyter Notebook入门指南

作者:京东科技隐私计算产品部 孙晓军 1. Jupyter Notebook介绍 图1 Jupter项目整体架构 [https://docs.jupyter.org/en/latest/projects/architecture/content-architecture.html] Jupyter Notebook是一套基于web的交互式开发环境。用户可以在线开发和分享包含代码和输出的交互式文档,支持实时代码,数学方程,可视化和 markdown等。用途包括:数据清理和转换,数值模拟,统计建模,机器学习等等。 Jupyter Notebook内部通过内核维护状态并运行代码片段,浏览器显示代码片段和其执行的结果。Jupyter Notebook提供了一个用户交互式的开发环境,用户可以通过执行一部分代码片段,并观察执行结果。这种交互式设计,使得Jupyter Notebook非常适合数据科学和机器学习的开发工作。 注意本文的代码和脚本,均基于Jupyter Notebook v6.5.2稳定版本。 2. Jupyter的工作方式 图2 Jupter Notebook工作方式 [https://docs.jupyter.org/en/latest/projects/architecture/content-architecture.html] Jupyter的主要工作单元是Jupyter Server和Kernel。其中Jupyter Server用来提供基于Web的界面和API服务,Kernel用来执行代码片段。浏览器通过Http和Websockets的方式和Jupyter Server进行交互,Jupyter Server和kernel之间,通过ZeroMQ进行数据通信。 Jupyter Server采用经典的MVC模式,使用了tornado作为web服务器,用来提供地址映射和控制器逻辑,使用jinja2来提供模板视图功能。 Jupyter Notebook(v6.5.2)项目的主要模块结构如下: 模块 说明 notebook Notebook功能模块。 terminal 终端模块。为Jupyter提供控制台交互能力。 view 文件可视化模块。比如pdf文件的显示。 tree 工作区目录树 nbconvert 格式转换模块,可以把Jupyter Notebook转换成html,pdf等格式 kernel Jupyter Notebook 内核 services Jupyter Notebook REST API模块 i18n Jupyter Notebook多语言资源 3. 安装Jupyter Notebook 前置条件 Python和pip 不同的Jupyter Notebook对Python有不同的版本要求。我们安装的最新的稳定版本v6.5.2的Jupyter Notebook,要求Python的最低版本为3.6。注意这个Python的版本,不同于内核的Python版本。对于Jupyter内核来说,支持的Python版本和Jupyter Notebook依赖的Python版本没有关系。 在Linux系统下安装Jupyter Notebook 使用pip安装Jupyter notebook非常简单。如果服务器同时拥有Python2和Python3的pip,注意需要使用pip3来替换命令中的pip。 # 更新pip pip install --upgrade pip # 安装jupyter pip install jupyter # 检查安装的jupyter jupyter --version //输出 notebook : 6.5.2 4. 配置和启动Jupyter Jupyter提供了大量的启动参数,用来配置Jupyter Server。我们可以在启动Jupyter服务时,通过命令行参数的方式配置当前启动的服务,但更普遍的方式是使用Jupyter的配置文件。 # 生成配置文件 jupyter notebook --generate-config // 默认生成的配置文件位置: /root/.jupyter/jupyter_notebook_config.py # 修改Jupyter配置文件... # 启动jupyter jupyter notebook Jupyter直接使用一个Python文件来配置Jupyter服务,所有的配置项均通过Python代码来完成。常用的配置项及其说明如下: 名称 默认值 说明 c.NotebookApp.allow_root False 为了安全,Jupyter默认不允许使用root用户启动。如果需要以root用户的身份启动Jupyter,需要开启此设定 c.NotebookApp.allow_origin '' 当需要Jupyter内嵌到iframe时,可以设置为“*“来避免跨origin的限制 c.NotebookApp.ip localhost 当需要通过外网地址来访问Jupyter服务时,需要设置一个有效的服务器IP地址。 c.NotebookApp.port 8888 Jupyter server对外服务端口 c.NotebookApp.notebook_dir / Jupyter的工作空间,默认可以访问服务器上当前用户的所有文件系统 c.NotebookApp.open_browser True 启动服务后是否立即通过浏览器打开服务地址 c.NotebookApp.default_url /tree Jupyter服务的默认地址 c.NotebookApp.extra_static_paths [] 扩展静态文件目录 c.NotebookApp.extra_template_paths [] 扩展模板文件目录 c.KernelSpecManager.allowed_kernelspecs set() 默认允许使用所有的kernel c.NotebookApp.nbserver_extensions {} 允许加载的Jupyter Server扩展 5. 使用Jupyter 5.1. 创建Notebook 启动Jupyter 后,在浏览器内输入 http://服务器地址:端口/,Jupyter会默认重定向到.default_url指定的工作区目录树地址,默认是工作区目录树的界面。 如果在访问的过程中,使用了默认的token作为其认证方式,那么在首次打开时,需要输入Jupyter Notebook的token值,这个值可以在启动Jupyter时的控制台输出中找到,或者使用Jupyter命令来查询 # 查询运行的jupyter notebook jupyter notebook list //返回结果中包含了http://x.x.x.x:8899?token=ABC 的信息,其中的ABC就是我们需要的token 图3 Jupter Notebook的默认工作区目录树页面 Jupyter Notebook通过Jupyter Server提供基于Web的平台无关的工作方式,这使得跨平台开发和协作,代码分享等能力变得比传统IDE更加容易。 在Jupyter 工作区管理界面,用户可以灵活地以类似文件系统的方式管理工作区的数据。可以创建文件和文件夹,编辑文件和文件夹,可以上传和下载文件。通过选择一个Jupyter内核,可以创建一个Notebook文件。 图4 通过Jupyter内核创建一个Notebook 5.2. 使用Notebook 使用Python3内核创建一个Notebook后,我们得到一个xxx.ipynb(IPython Notebook)文件。这个文件是一个json格式的文本文件,其中包含了我们在Notebook中编写的代码和文本内容,也包含了界面上没有显示的元数据信息。通过在工作区目录界面选择一个notebook文件,点击编辑,我们可以查看到ipynb文件的原始内容。 图5 ipynb文件的原始内容 我们可以像使用其它IDE类似的方式来使用Notebook,在使用Notebook上,我们主要关注下Jupyter内核和单元格。 内核是执行单元格代码的核心进程,不同的内核,决定了我们在单元格中能够编写哪些语言的代码,以及对应了指定的编程语言的哪个版本等信息。 单元格是整个Notebook的核心组成部分,我们编写的代码和文本,通过一些列Notebook单元格来组成。Notebook提供了Code,Markdown, Raw NBConvert, Heading四种类型的单元格。 •Code单元格。用来编写内核指定语言的程序代码 •Markdown单元格。使用Markdown编辑器的语法来编辑富文本 •Raw NBConvert单元格。原始的文本,不会被当作代码或markdown被解释执行 •Heading单元格。Heading是Mardown的一个子集,对应了Markdown中的标题编写语法 Jupyter Notebook使用了机器学习中检查点的概念,在我们修改Notebook的过程中,Jupyter会自动保存我们的修改,我们也可以通过【文件】->【保存】来手动保存检查点。检查点文件包含了我们编写的Notebook内容,以及执行代码单元格之后的输出。我们可以在工作空间的“.ipynb_checkpoints”文件夹下,找到这些检查点文件。 图6 使用Jupyter单元格来编写交互式代码 5.3. 分享Notebook 相较于使用传统的IDE编写的代码,基于Web服务的Jupyter Notebook在代码分享上拥有着天然的优势。 在Jupyter Notebook中,我们可以通过两种不同的方式分享我们创作的nootbook。 交互式Notebook文档 传统的技术文档或者说明书,通过静态的文本,配合图片和视频,来描述和讲解特定的技术或功能。有了Jupyter Notebook后,我们仍然可以使用Notebook来编写类似传统的技术文档。在此基础上,我们可以加入更生动的代码交互单元格,用户通过查看文档说明,并与文档中提供的代码进行互动,可以更生动地介绍产品中的功能和技术。每个Jupyter Notebook的ipynb文件,都对应了一个独立的访问地址: http://x.x.x.x:8899/notebooks/my_notebook.ipynb ,通过分享此文件的地址,其他用户可以方便地使用包含了富文本和可执行的代码的交互式Notebook文档。 离线Notebook文档 我们通过逐步执行文档中的所有单元格,得到一个包含了我们编写的说明和代码,以及代码执行的输出结果的完整文档。之后点击【文件】-> 【另存为】,选择一种合适的文件格式。我们可以把文档导出为一份静态文件,通过共享此静态文件,我们实现了Notebook文档的离线分享。 5.4. 魔法函数 Jupyter Notebook提供了一些列魔法函数来增强Jupyter Code单元格的功能,通过魔法函数,我们能够执行javascript脚本,html代码,运行另一个可执行程序等许多额外的功能。 我们可以在Jupyter代码单元格中使用 %lsmagic命令来查看所有的魔法函数,如果要阅读详细的魔法函数的使用说明,可以参考: https://ipython.readthedocs.io/en/stable/interactive/magics.html 魔法函数分为行魔法函数,单元格魔法函数和会话魔法函数。顾名思义,行魔法函数只对当前行起作用,而单元格魔法函数则作用于整个单元格,会话魔法函数则作用于整个会话期间。 一些常用的魔法函数: 指令 说明 %matplotlib 设置matplot绘图的显示模式 %%javascript 单元格内的代码被识别为javascript代码 %%html 单元格内的代码被识别为html代码 %run 执行外部脚本文件 %pwd 获取当前工作的目录位置(非工作空间目录位置) %writefile 以文件形式保存当前单元格代码 %timeit 获取本行代码的执行时间 %debug 激活调试模式 6. 管理Jupyter 6.1. 多语言 Jupyter Notebook使用i18n目录下的资源来进行多语言翻译。在Jupyter Notebook启动时,会加载i18n目录下的多语言资源。之后根据http请求指定的语言,为响应数据提供对应的多语言翻译。如果没有对应的翻译,则保留原始的多语言标签值(英文)。如果调整了多语言翻译,需要重新启动Jupyter Notebook才能使用新的语言包。 Jupyter Notebook的翻译资源主要分布在三个po文件中: •nbjs.po - js文件中的多语言数据 •nbui.po - UI界面中的多语言数据 •notebook.po - notebook中的多语言数据 原始的po文件,需要通过pybabel工具,把po文件编译成mo文件,之后部署在$notebook/i18n/${LANG}/LC_MESSAGES/目录下($notebook是notebook的安装目录),才能在Jupyter Notebook中作为多语言的资源包来使用。 # 使用pybabel编译多语言po文件 pybabel compile -D notebook -f -l ${LANG} -i ${LANG}/LC_MESSAGES/notebook.po -o ${LANG}/LC_MESSAGES/notebook.mo pybabel compile -D nbui -f -l ${LANG} -i ${LANG}/LC_MESSAGES/nbui.po -o ${LANG}/LC_MESSAGES/nbui.mo pybabel compile -D nbjs -f -l ${LANG} -i ${LANG}/LC_MESSAGES/nbjs.po -o ${LANG}/LC_MESSAGES/nbjs.mo 图7 使用了中文语言包后的中文Notebook界面 6.2. 内核管理 内核(kernel)是独立于jupyter服务和界面之外的用来运行Jupyter代码单元格的进程,Jupyter默认提供了ipykernel内核来支持Python开发语言。Jupyter社区提供了jupyterC, IJava,xeus-cling, xeus-sql等众多其它编程语言的内核,用来支持C/C++, Java, SQL等编程语言。 ipykernel默认使用系统环境下的Python来提供服务。我们可以使用ipykernel安装多个Python kernel来提供Python2.x, Python3.x等多个Python内核环境。 安装kernel后,kernel的信息被保存在kernel.json文件中,我们可以在 /usr/local/share/jupyter/kernels 目录,找到Jupyter安装的所有kernel以及对应的kernel.json文件。 kernel可以直接继承自安装kernel的Python指令,也可以使用Python虚拟环境。 # 1.直接继承自Python指令的kernel安装 # 安装ipykernel pip install ipykernel # 安装kernel python -m ipykernel install --name tensorflow2 --display-name "tensorflow2" # 2. 在Python虚拟环境下的kernel安装 # 激活虚拟环境 source activate myenv # 安装ipykernel pip install ipykernel # 安装kernel python -m ipykernel install --name myenv --display-name "Python3 (myenv)" 如果需要查看当前的kernel列表,以及删除已经安装的kernel,可以使用如下的Jupyter命令: # 查看已经安装的kernel列表 jupyter kernelspec list # 删除列表中指定的kernel jupyter kernelspec remove kernelname 6.3. REST API Jupyter提供了REST API接口来和Jupyter server进行交互。借助REST API的能力,我们可以以编程的方式和Jupyter Server进行交互,灵活地管理Jupyter Server。另外REST API为现代化的软件开发提供了一个优秀的能力:自动化。 借助Jupyter Notebook REST API,可以实现文件的上传和下载,检查点管理,会话管理,内核管理,终端管理等一些列管理能力。完整的Jupyter REST API接口列表可以参考: https://jupyter-server.readthedocs.io/en/latest/developers/rest-api.html 要使用REST API,需要在请求中携带认证信息。Jupyter支持直接把token作为query string的方式来认证,也可以使用标准的Http Authorization头信息来完成认证。使用Authorization头来认证的格式如下: Authrozation: token 527a9f1430ccfed995ebcf15517583a2547c2469bc3c47a6 图8 使用Postman来调用Jupyter REST API接口 6.4. 安全管理与多人协作 Jupyter提供了灵活强大的能力,用以支持在线的交互式文档和代码的编写。但Jupyter项目自身没有提供精细化的安全管理体系,用以支持多用户下灵活地使用Jupyter Notebook的功能。对于文件安全,Jupyter依赖于启动服务的linux用户,合理地配置启动Jupyter的用户的权限,才能保证使用Jupyter的用户,不会对系统或项目造成破坏。Jupyter工作空间的设定,仅起到了方便Jupyter使用者管理必要文件的易用性,不能阻挡用户访问和管理工作空间外的文件系统。另外,配合使用Python虚拟环境,可以防止Jupyter Notebook提供的 pip install ,pip uninstall功能,对现有项目环境造成破坏。 在多人协作方面,JupyterHub项目提供了多人协作Jupyter Notebook和Jupyter lab开发的能力。使用JupyterHub,不同职能的用户可以在自己独立的空间内进行Notebook的编写工作,不同用户间也可以方便地分享各自的Notebook。 7. 扩展Jupyter 7.1. 前端扩展 Jupyter Notebook前端扩展(front end extension)是使用Javascript语言编写的异步模块,可以用来绘制Jupyter界面的仪表盘,Notebook,工具栏等,。定义一个前端扩展必须要实现一个load_ipython_extension方法,当前端控件被加载时,Jupyter client会调用load_ipython_extension方法。 Jupyter Notebook前端扩展能力目前还不是一个稳定的版本,不保证代码能够向后兼容。Jupyter的JS API目前也没有官方的文档,需要通过源代码或者实际加载的JS来查看Jupyter前端脚本的成员和方法。 我们实现一个简单的前端扩展脚本,在jupyter前端的工具条中,添加一个自定义工具,当点击自定义工具时,弹出提示信息。 define([ 'base/js/namespace' ], function( Jupyter ) { function load_ipython_extension() { var handler = function () { alert('欢迎使用前端扩展!'); }; var action = { icon: 'fa-comment-o', help : '前端扩展', help_index : 'zz', handler : handler }; var prefix = 'my_extension'; var action_name = 'show-alert'; var full_action_name = Jupyter.actions.register(action, action_name, prefix); // returns 'my_extension:show-alert' Jupyter.toolbar.add_buttons_group([full_action_name]); } return { load_ipython_extension: load_ipython_extension }; }); 完前端扩展代码后,我们把脚本保存到main.js文件,放置在/opt/my_extension目录下。接下来我们使用jupyter nbextension工具来安装和启用前端扩展 # 安装前端扩展 jupyter nbextension install /opt/my_extension # 启用前端扩展 jupyter nbextension enable my_extension/main # 禁用前端扩展 jupyter nbextension disable my_extension/main # 查看前端扩展列表 jupyter nbextension list # 卸载前端扩展 jupyter nbextension uninstall my_extension 图9 在Notebook工具条中加入的前端扩展 7.2. 服务端扩展 Jupyter服务端扩展(server extension)是使用Python语言编写的模块,可以用来处理发送到Jupyter Server的Http请求。使用Jupyter服务端扩展,可以更改现有Jupyter请求的数据和行为,也可以为jupyter Server定义新的服务处理程序。 定义一个服务端扩展模块要实现一个load_jupyter_server_extension方法,其中包含一个类型为notebook.notebookapp.NotebookApp的参数serverapp,serverapp的详细属性和方法可以通过Jupyter Notebook源代码中的notebookapp.py文件来查看。当服务端扩展被加载时,Jupyter Server会调用load_jupyter_server_extension方法。在load_jupyter_server_extension方法中,我们可以通过调用serverapp的web_app属性的add_handlers方法来注册处理程序,用来处理特定的服务端请求。处理程序类需要继承自Jupyter的IPythonHandler类。在处理程序的方法中,可以使用Jupyter提供的@web.authenticated装饰器来为方法增加身份认证保护。 通过服务端扩展,还可以与前端扩展联动,实现一个功能丰富的Jupyter Notebook前端控件。 # 定义一个处理程序 from tornado import ( gen, web, ) from notebook.base.handlers import IPythonHandler class HelloWorldHandler(IPythonHandler): @web.authenticated @gen.coroutine def get(self): self.finish(f'Hello, world!') # 实现load_jupyter_server_extension方法并注册处理程序 def load_jupyter_server_extension(serverapp): handlers = [ ('/myextension/hello', HelloWorldHandler) ] serverapp.web_app.add_handlers('.*$', handlers) 完成服务端扩展代码后,我们把代码保存为__init__.py文件,要在Jupyter Notebook中使用处理程序,我们还需要进行服务端扩展的安装和启用。不同于前端扩展,服务端扩展不能直接使用指令来安装,需要我们手动编写安装程序。此外,Jupyter提供了自动启用服务端扩展和前端扩展的方法,需要我们在脚本的根目录提供启用扩展的配置文件。 jupyter-config/ ├── jupyter_notebook_config.d/ │ └── my_server_extension.json └── nbconfig/ └── notebook.d/ └── my_front_extension.json setup.py 加入了自动启用扩展的配置,我们的服务端扩展目录结构如下: hello-extension/ ├── __init__.py jupyter-config/ ├── jupyter_notebook_config.d/ └── hello_extension.json hello_extension.json文件的内容为: { "ServerApp": { "jpserver_extensions": { "hello_extension": true } } } 接下来我们通过安装程序,安装服务端扩展的信息保存在/root/.jupyter/jupyter_notebook_config.json文件中。在安装完成后,我们可以通过jupyter serverextesion工具来股那里服务端扩展 # 启用服务端扩展 jupyter serverextension enable hello_extension # 禁用服务端扩展 jupyter serverextension disable hello_extension # 服务端扩展直接卸载的方法,需要我们通过pip uninstall 卸载安装程序, # 再通过手工修改/root/.jupyter/jupyter_notebook_config.json文件删除扩展信息来完成卸载 图10 在浏览器中测试安装的服务端扩展程序 7.3. 界面定制 Jupyter没有提供标准的界面定制的能力,但我们可以手工调整jupyter生成的模板视图文件和样式文件,达到整条调整jupyter notebook的界面的能力。 Jupyter Notebook模板文件的位置为:$notebook/templates,样式和脚本定制推荐的方案是使用~/.jupyter/custom/custom.css和~/.jupyter/custom/custom.js文件。我们可以直接在此基础上对文件进行修改,还可以通过extra_template_paths和extra_static_paths来引入其它位置的模板和其它静态文件。 图11 通过直接调整模板文件加入的界面定制按钮 7.4. 小部件 小部件(Widgets)是Jupyter交互式可视化数据呈现部件。Jupyter Widgets同时包含了访问后端数据和前端呈现的能力,可以用于在Jupyter Notebook上生动地展示服务端的数据和数据变化。 在v6.5.2稳定版本上,我们目前只能使用系统提供的小部件,还不能开发自定义小部件。在Jupyter notebook7.x版本中,开始提供了小部件的自定义开发能力。 # 确保安装了ipywidgets和traitlets pip install --upgrade traitlets pip install --upgrade ipywidgets # 安装和启用小部件 jupyter nbextension install --py widgetsnbextension jupyter nbextension enable --py widgetsnbextension 在安装和启用了小部件后,我们可以在notebook中直接使用系统提供的小部件。 图12 在Notebook中使用小部件 完整的小部件列表和使用方式可以参考: https://ipywidgets.readthedocs.io/en/7.x/examples/Widget List.html 8. 总结 Jupyter Notebook以其丰富的功能,简单易用,强大的交互能力和扩展能力,成为数据科学和机器学习开发中的神器。目前,Jupyter Notebook支持超过40种编程语言,被应用于Google Colab, Kubeflow, 华为云,kaggle等多个知名项目中,大量机器学习和数据科学的论文中使用到了Jupyter。Jupyter在数据可视化,提升工作效率,改善用户体验和丰富文档功能方面显现了巨大的威力。除此之外,Jupyter还提供的灵活强大的扩展能力,更是为Jupyter的深层次使用提供了更广阔的想象空间。如果你还没有开始接触Jupyter,那么就从现在开始吧。


资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册