首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

TiDB原理解析系列(一)---Why Do We Use it?

TiDB是PingCAP公司设计的开源分布式NewSQL数据库。由于它兼容MySQL协议,并支持绝大多数SQL功能(比如joins,subqueries, transaction等)。业务能够直接通过MySQL connector去使用它来替换MySQL。TiDB适合场景: 数据量大,MySQL复杂查询很慢。Online DDL影响业务的使用。 MySQL单机容量或者性能达到瓶颈,不想分库分表或者使用数据库中间件等对业务侵入性较大、对业务有约束的Sharding方案。 有高并发实时写入、实时查询、实时统计分析的需求。 有分布式事务、多数据中心的数据100%强一致性、auto-failover的高可用的需求。 TiDB与MySQL相比,有什么优势,让它更适合上述场景?接下来将从以下六个方面进行对比。 1.TiDB实现分布式的SQL引擎和存储 MySQL水平扩展一般是主从复制,典型的就是一主多从模式。但这种只适合读多写少的业务。碰到大写入量的业务,这种模式反而会成为瓶颈。那么就必须寻求其他的分布式方案,有以下两种思路: 基于修改MySQL的分布式方案。通过MySQL的Server把InnoDB变成分布式数据库,但由于MySQL生成的执行计划是单机的,这不是一个分布式的Plan。不了解底层分布式存储,是无法选择一个最高效率的执行计划。 基于中间件方式的分布式方案,比如ProxySQL。做一款中间件需要考虑很多,比如通过解析SQL解析出ShardKey,然后根据ShardKey分发请求,再合并结果。另外在中间件这层还需要维护Session并保存缓存结果。大多数方案并不支持分布式Transaction,不支持跨节点Join,无法处理复杂Plan,也不会处理Subqueries。同时业务需要维护ShardKey,不支持ORM导致业务开发效率降低。 以上MySQL的问题是由传统架构模式本身带来的,而TiDB的模式是不一样的。它在TiDB Server层实现了分布式的SQL引擎,依赖TiKV来提供分布式存储和分布式事务支持,分布式的设计也方便做水平扩展。以上MySQL分布式方案带来的问题,TiDB都能做很好的解决,这是架构本身带来的优势。 如上图所示,TiDB集群主要分为以下三个组件: TiDB ServerTiDB Server负责接收SQL请求,处理SQL相关的逻辑,并通过PD找到存储计算所需数据的TiKV地址,与TiKV交互获取数据,最终返回结果。TiDB Server本身并不存储数据,只负责计算,可以无限水平扩展。通过负载均衡组件(如LVS、HAProxy或F5)对外提供统一的接入地址。 PD ServerPlacement Driver(简称PD)是整个集群的管理模块。其主要工作有三个:一是存储集群的元信息(某个Key存储在哪个 TiKV节点);二是对TiKV集群进行调度和负载均衡(如数据的迁移、Raft group leader成员变更等);三是分配全局唯一且递增的事务ID(支持分布式事务)。 TiKV Server TiKV Server负责存储数据,从外部看TiKV是一个分布式的提供事务的Key-Value存储引擎。存储数据的基本单位是 Region,每个Region负责存储一个Key Range(从StartKey到EndKey的左闭右开区间)的数据,每个TiKV节点会负责多个Region。TiKV使用Raft协议做复制,保持数据的一致性和容灾。副本以Region为单位进行管理,不同节点上的多个Region构成一个Raft Group。数据在多个TiKV之间的负载均衡由PD调度,是以Region为单位进行调度。 2.TiDB金融级的高可用 MySQL的复制方式是半同步或者是异步,半同步也可以降级成异步。也就是说任何时候数据出了问题是不敢切换的,因为有可能是异步复制,有一部分数据还没有同步过来,这时候切换数据就不一致了。多数据中心的复制和数据中心的容灾,MySQL在这上面是做不好的。而TiDB/TiKV/PD的三个组件都能容忍部分实例失效,并且不影响整个集群的可用性,支持跨中心部署。下面分别说明这三个组件的单个实例失效后的服务状态,以及如何进行恢复。 TiDB ServerTiDB Server是无状态的,推荐至少部署两个实例。当单个实例失效时,会影响正在这个实例上进行的服务,从应用的角度看,会出现单次请求失败的情况,重新连接成功后即可继续获得服务。单个实例失效后,可以重启这个实例或者部署一个新的实例。 PD ServerPD是一个集群,通过Raft协议保持数据的一致性,单个实例失效时,如果这个实例不是Raft的leader,那么服务完全不受影响;如果这个实例是Raft的leader,会重新选出新的Raft leader,自动恢复服务。PD在选举的过程中无法对外提供服务,这个时间大约是3秒钟。推荐至少部署三个PD实例,单个实例失效后,重启这个实例或者添加新的实例。 TiKV ServerTiKV是一个集群,通过Raft协议保持数据的一致性(副本数量可配置,默认保存三副本),并通过PD做负载均衡调度。单个节点失效时,会影响这个节点上存储的所有Region。对于Region中的Leader结点,会中断服务,等待重新选举;对于 Region中的Follower节点,不会影响服务。当某个TiKV节点失效,并且在一段时间内(默认10分钟)无法恢复,PD会将其上的数据迁移到其他的TiKV节点上。 3.TiDB存储引擎RocksDB MySQL默认存储引擎从2010年起就一直是InnoDB,InnoDB使用B+树数据结构,这与传统的商业数据库相似。TiDB使用RocksDB作为TiKV的存储引擎。读写性能的测试对比: RocksDB读性能只有InnoDB-Compress性能的70%。但在高并发下,RocksDB平均响应时间表现要比InnoDB-Compress好。但与未压缩的InnoDB还是差不少。 RocksDB写性能表现优异,QPS大概是InnoDB-Compress的10倍。 RocksDB优势是在于处理大型数据集,因为它可以更有效地压缩数据并且插入数据性能优秀。6亿4千万数据导入MySQL,InnoDB未经压缩大小为160GB,InnoDB-Compress为86GB,RocksDB为62GB。TiDB更加适合大规模数据场景。数据条数少于5000w的场景下通常用不到TiDB,单机MySQL能满足的场景也不需要用到TiDB。 4.TiDB更好的解决了Online DDL问题 业务发展迅速,应用模式频繁更改是常态。相应地,数据库访问模式和Schema也随之变化。DDL是SQL的一类,主要作用是创建和更改数据的Schema信息,最常见的操作包括:加减列、更改列类型、加减索引等。5.6版本以后,MySQL内部开始支持Online DDL。但MySQL的Online DDL方案始终没有解决下面问题:MySQL主备副本之间通过Binlog同步,主的Schema变更成功后,才会写BinLog同步给备库,然后备库才开始做DDL。假设一个DDL变更需要一个小时,那么备库最多可能会延迟两倍的变更时间。若变更期间,主库发生故障,备库数据还未追平,则无法提供服务的。TiDB使用Google F1论文介绍的协议实现在线DDL。Tikv基本不感知DDL操作。对于Tikv来说,所有的操作都是PUT/GET/DELETE,所以副本间的变更也与普通DML没有差异。任何时候,只要底层raft协议能正常work,三副本高可用和强一致就能得到保证。这个方案虽然Schema变更比较麻烦,但对于Tikv存储层特别友好,不用感知DDL,共用一套机制保证高可用和强一致。不会出现类似MySQL主备延迟和主备Schema不一致问题。DDL更改也被分解成更小的转换阶段,这样它们可以防止数据损坏场景,并且系统允许单个节点一次最多支持一个DDL版本。 5.TiDB提供一站式HTAP解决方案 MySQL团队把注意力放在优化联机事务处理(OLTP)查询的性能上。也就是说,MySQL团队花费更多的时间使简单查询执行得更好,而不是使所有或复杂查询执行得更好。这种方法没有错,因为许多应用程序只使用简单的查询。TiDB设计目标在处理混合事务/分析处理(HTAP)的性能上。对于那些希望对数据进行实时分析的应用来说,这是一个主要的卖点,因为它消除了在MySQL数据库和分析数据库之间进行的批量加载。一份存储同时处理OLTP & OLAP,无需传统繁琐的ETL 过程。 6.TiDB可视化监控与告警 这一点对运维非常友好。MySQL将关键监控指标放在内存表中,获取它需要通过SQL查询,可视化与告警部分都需要额外开发。而TiDB提供Metrics接口,使用 Prometheus记录组件中各种操作的详细信息,使用Grafana进行可视化展示。无须其他开发额外,根据需要,即可配置定制化自己的监控图表和报警。 总结 在替代MySQL的场景中,TiDB与MySQL相比更加适合大数量的场景;同时也补充了MySQL的不足,比如处理Online DDL问题;在MySQL不适合的场景中,比如HTAP场景中也能发挥很好的优势。如果你想更多了解TiDB作者的初衷,参阅How do we build TiDB,Meet TiDB: An open source NewSQL database。

优秀的个人博客,低调大师

【Kubernetes系列】第9篇 网络原理解析(上篇)

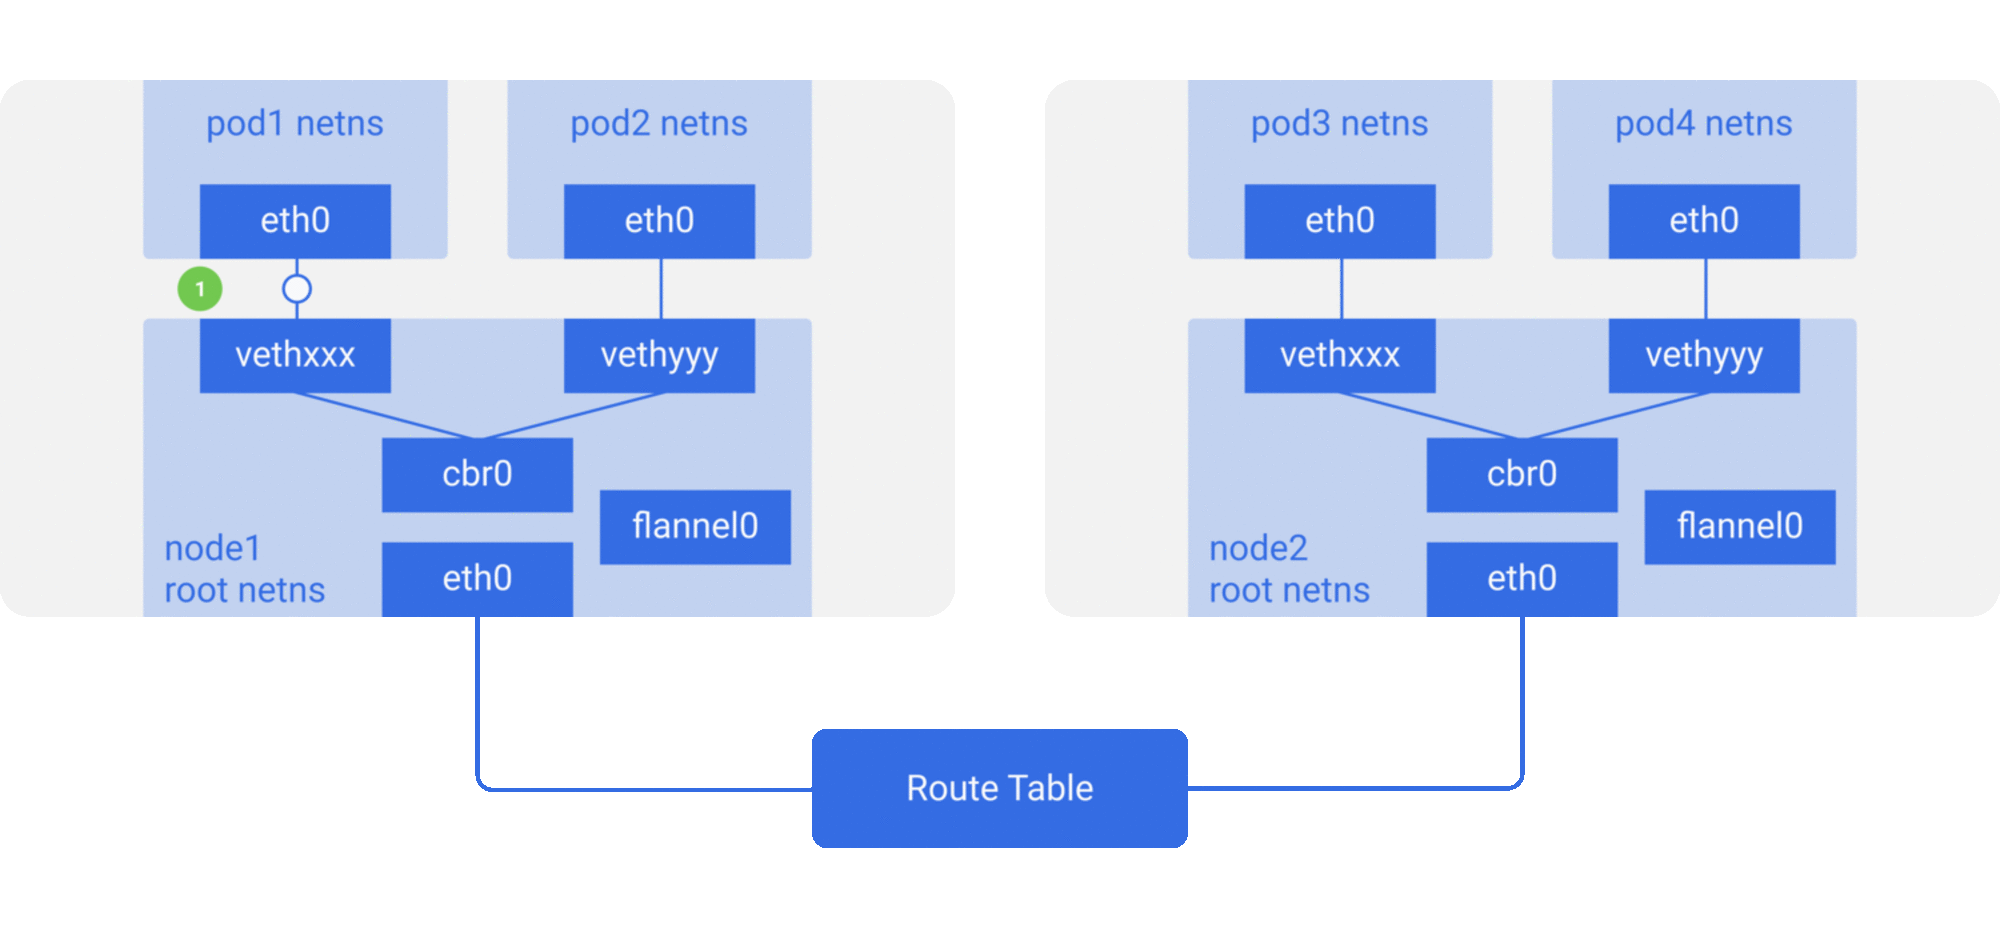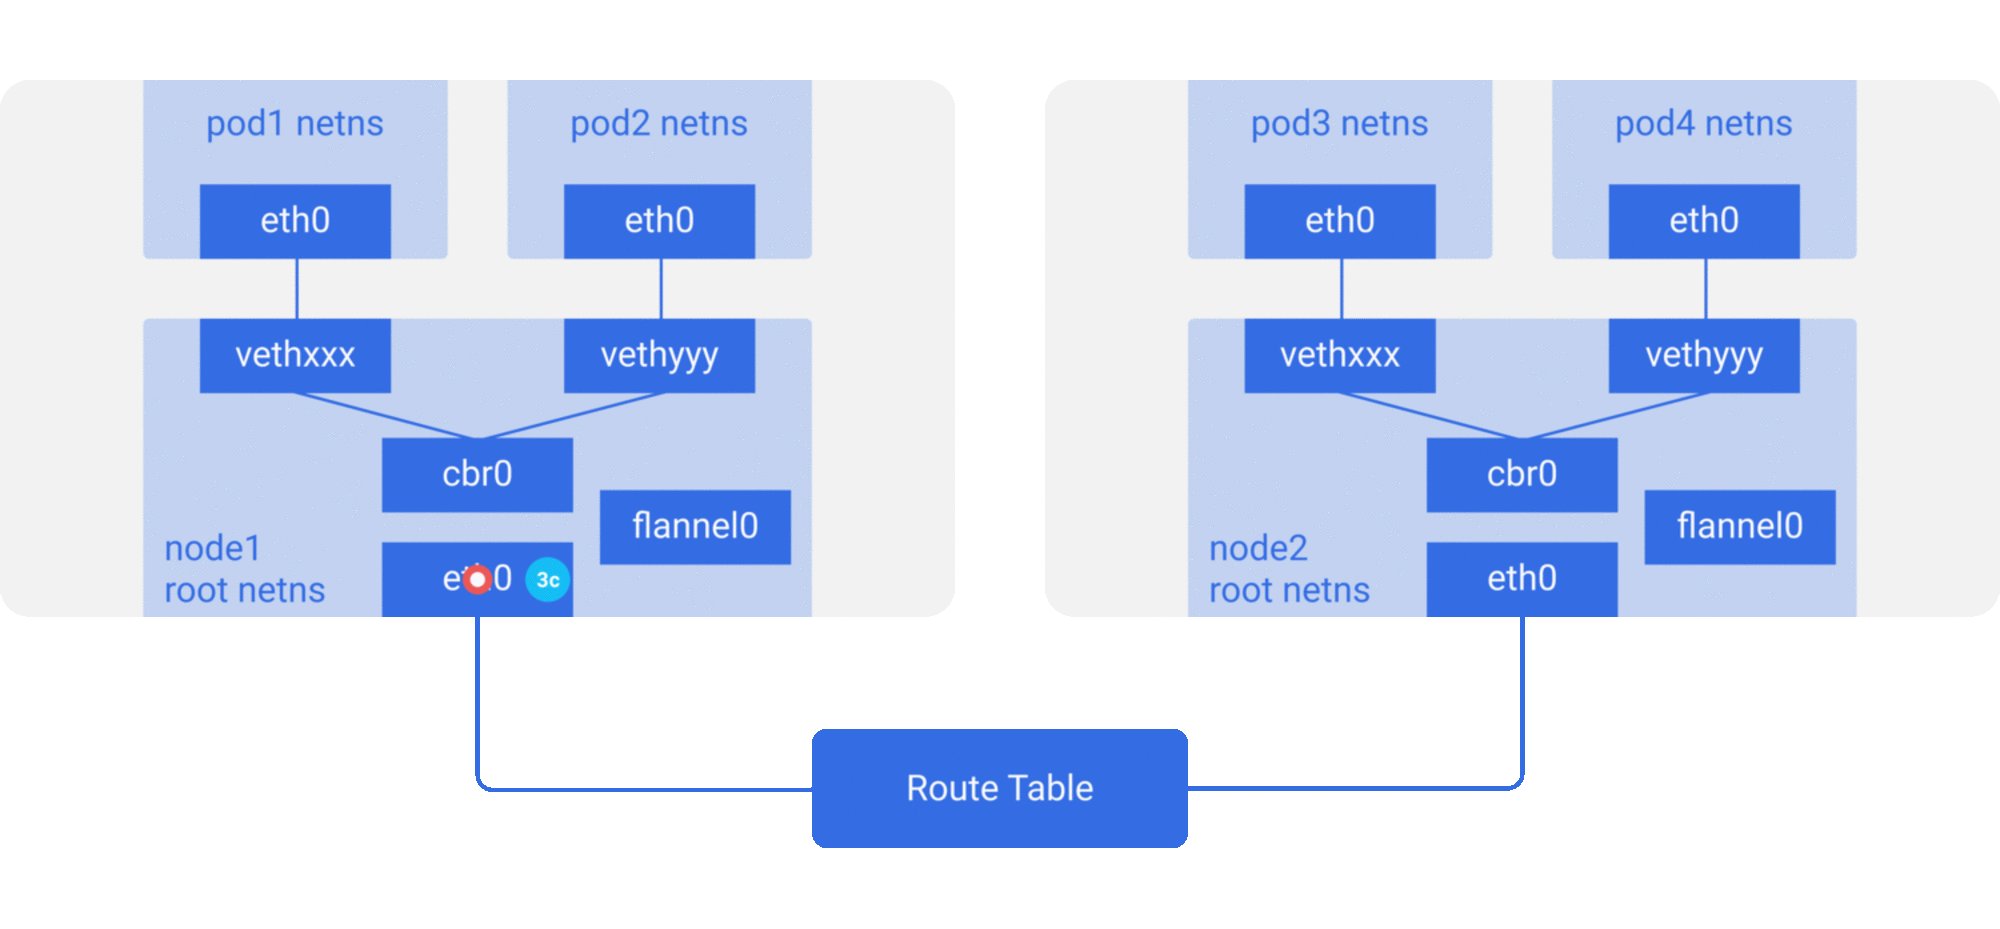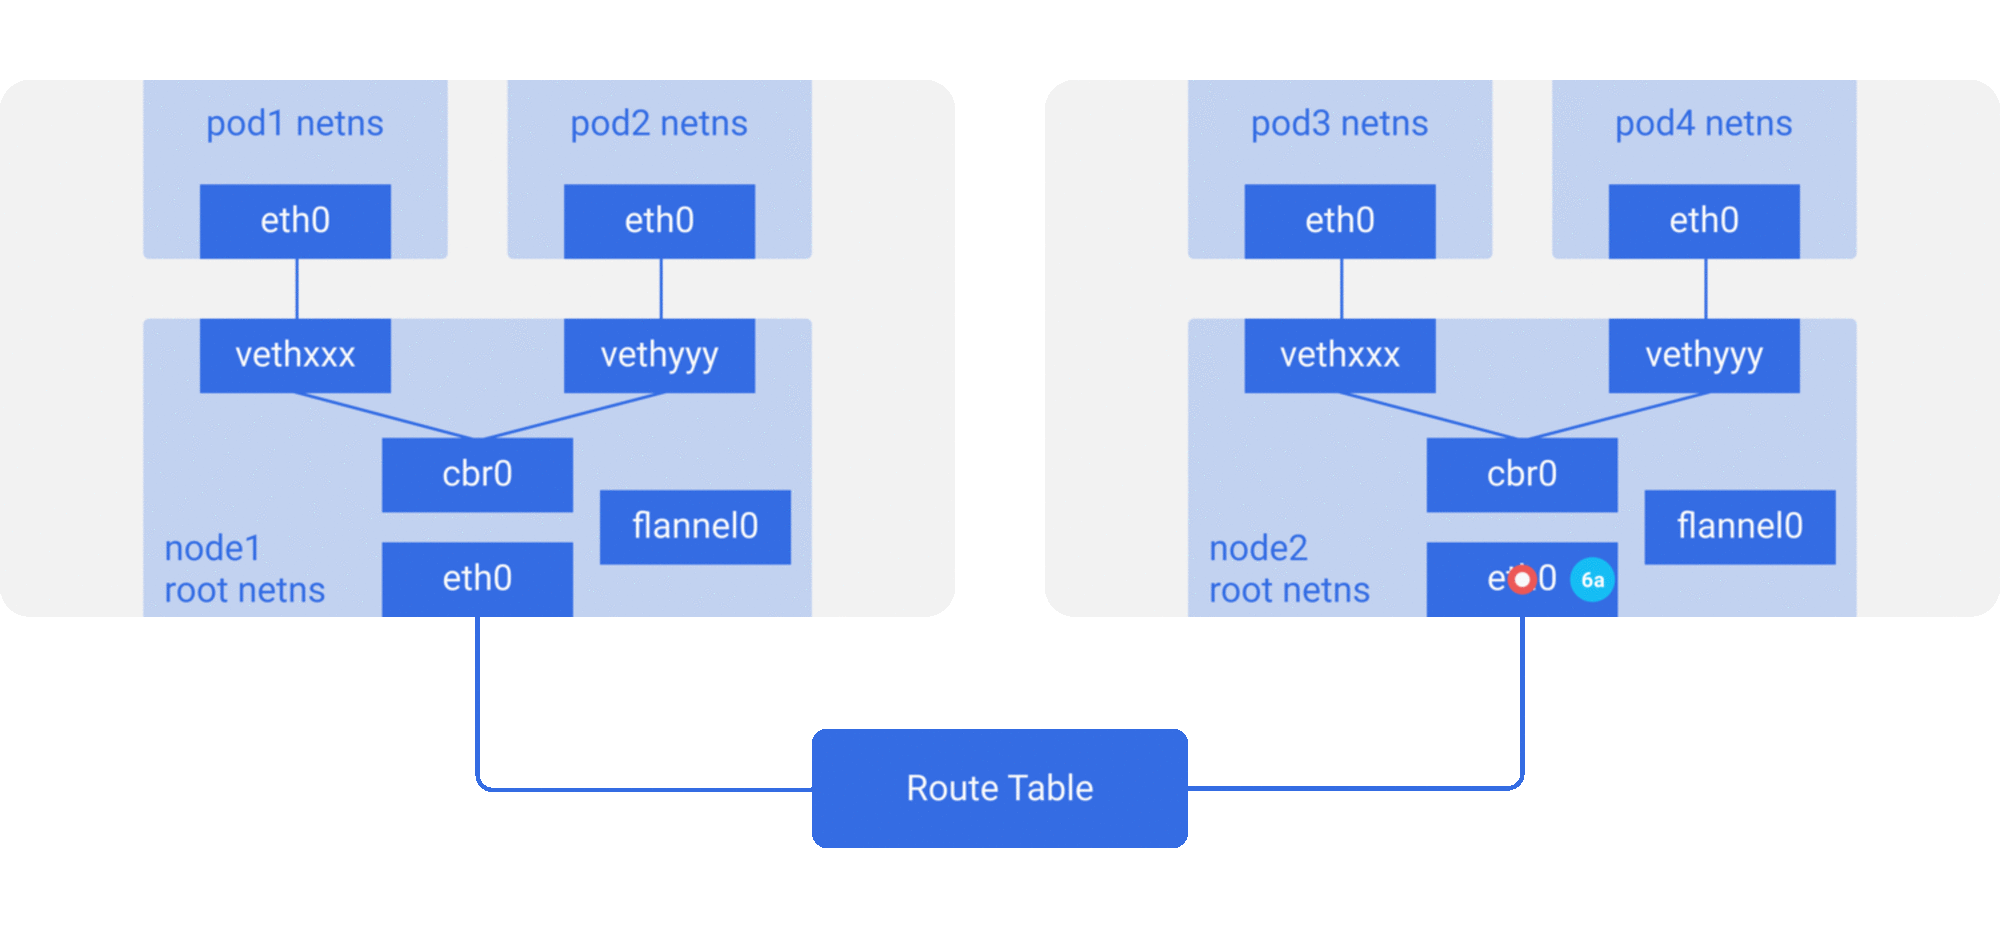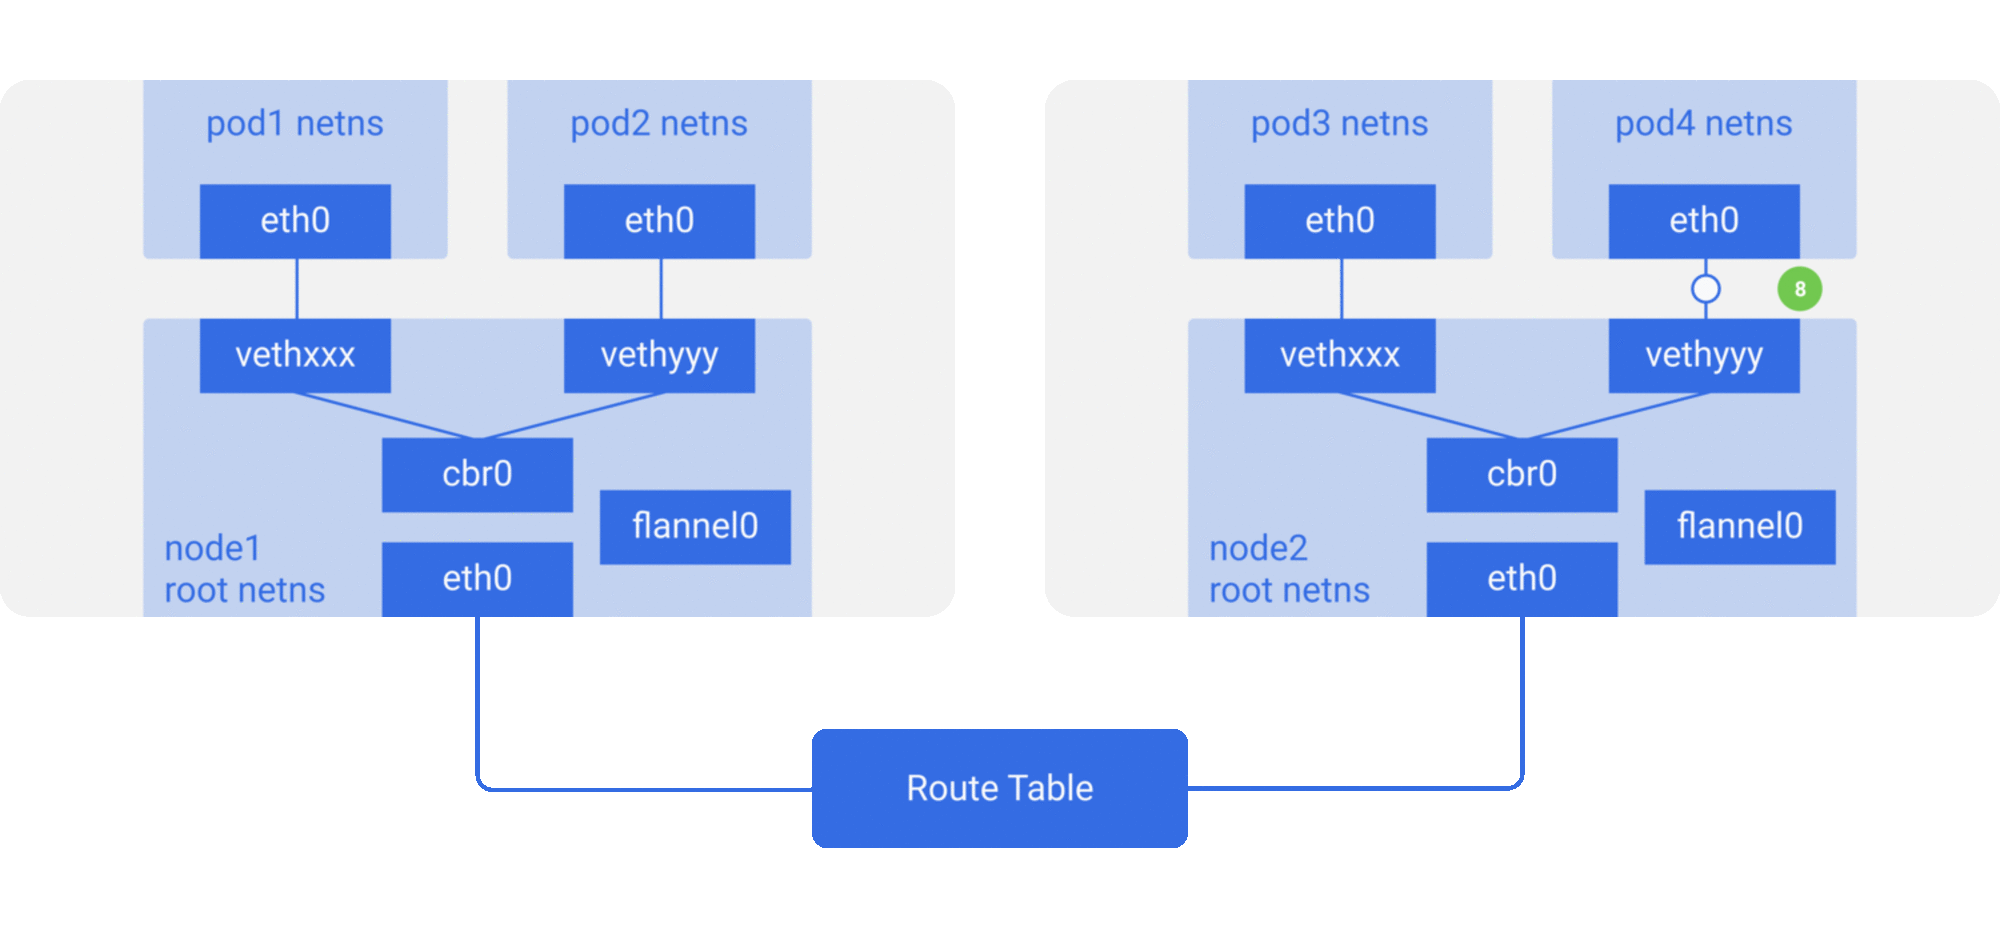
1. Linux网络基础 1.1 名词解释 Network Namespace(网络命名空间):Linux在网络栈中引入网络命名空间,将独立的网络协议栈隔离到不同的命令空间中,彼此间无法通信;docker利用这一特性,实现不容器间的网络隔离。 Iptables/Netfilter:Netfilter负责在内核中执行各种挂接的规则(过滤、修改、丢弃等),运行在内核模式中;Iptables模式是在用户模式下运行的进程,负责协助维护内核中Netfilter的各种规则表;通过分析进入主机的网络封包,将封包的表头数据提取出来进行分析,以决定该联机为放行或抵挡的机制。 由于这种方式可以直接分析封包表头数据,所以包括硬件地址(MAC), 软件地址 (IP), TCP, UDP, ICMP 等封包的信息都可以进行过滤分析。 Veth设备对:Veth设备对的引入是为了实现在不同网络命名空间的通信。 Bridge(网桥):网桥是一个二层网络设备,是最简单的CNI网络插件,它首先在Host创建一个网桥,然后再通过veth pair连接该网桥到container netns。另外,Bridge模式下,多主机网络通信需要额外配置主机路由 Route(路由):Linux系统包含一个完整的路由功能,当IP层在处理数据发送或转发的时候会使用路由表来决定发往哪里。 Container Network Interface (CNI) 最早是由CoreOS发起的容器网络规范,是 Kubernetes网络插件的基础。其基本思想为:Container Runtime在创建容器时,先创建好network namespace,然后调用CNI插件为这个netns配置网络,其后再启动容器内的进程 2. Kubernetes 网络模型 Kubernetes网络有一个重要的基本设计原则: 每个Pod拥有唯一的IP 这个Pod IP被该Pod内的所有容器共享,并且其它所有Pod都可以路由到该Pod。你可曾注意到,你的Kubernetes节点上运行着一些"pause"容器?它们被称作“沙盒容器(sandbox containers)",其唯一任务是保留并持有一个网络命名空间(netns),该命名空间被Pod内所有容器共享。通过这种方式,即使一个容器死掉,新的容器创建出来代替这个容器,Pod IP也不会改变。这种IP-per-pod模型的巨大优势是,Pod和底层主机不会有IP或者端口冲突。我们不用担心应用使用了什么端口。 这点满足后,Kubernetes唯一的要求是,这些Pod IP可被其它所有Pod访问,不管那些Pod在哪个节点。 2.1 节点内通信 第一步是确保同一节点上的Pod可以相互通信,然后可以扩展到跨节点通信、internet上的通信,等等。 Kubernetes Node(root network namespace) 在每个Kubernetes节点(本场景指的是Linux机器)上,都有一个根(root)命名空间(root是作为基准,而不是超级用户)-- root netns(root network namespace)。 主要的网络接口 eth0 就是在这个root netns下。 Kubernetes Node(pod network namespace) 类似的,每个Pod都有其自身的netns(network namespace),通过一个虚拟的以太网对连接到root netns。这基本上就是一个管道对,一端在root netns内,另一端在Pod的netns内。 我们把Pod端的网络接口叫 eth0,这样Pod就不需要知道底层主机,它认为它拥有自己的根网络设备。另一端命名成比如 vethxxx。你可以用 ifconfig 或者 ip a 命令列出你的节点上的所有这些接口。 Kubernetes Node(linux network bridge) 节点上的所有Pod都会完成这个过程。这些Pod要相互通信,就要用到linux的以太网桥 cbr0 了。Docker使用了类似的网桥,称为docker0。你可以用 brctl show 命令列出所有网桥。 Kubernetes Node(same node pod-to-pod communication) 假设一个网络数据包要由pod1到pod2 它由pod1中netns的eth0网口离开,通过vethxxx进入root netns。 然后被传到cbr0,cbr0使用ARP请求,说“谁拥有这个IP”,从而发现目标地址。 vethyyy说它有这个IP,因此网桥就知道了往哪里转发这个包。 数据包到达vethyyy,跨过管道对,到达pod2的netns。 这就是同一节点内容器间通信的流程。当然也可以用其它方式,但是无疑这是最简单的方式,同时也是Docker采用的方式。 2.2 不同节点间通信 正如我前面提到,Pod也需要跨节点可达。Kubernetes不关心如何实现。我们可以使用L2(ARP跨节点),L3(IP路由跨节点,就像云提供商的路由表),Overlay网络,或者甚至信鸽。无所谓,只要流量能到达另一个节点的期望Pod就好。每个节点都为Pod IPs分配了唯一的CIDR块(一段IP地址范围),因此每个Pod都拥有唯一的IP,不会和其它节点上的Pod冲突。 大多数情况下,特别是在云环境上,云提供商的路由表就能确保数据包到达正确的目的地。我们在每个节点上建立正确的路由也能达到同样的目的。许多其它的网络插件通过自己的方式达到这个目的。 这里我们有两个节点,与之前看到的类似。每个节点有不同的网络命名空间、网络接口以及网桥。 Kubernetes Nodes with route table(cross node pod-to-pod communication) 假设一个数据包要从pod1到达pod4(在不同的节点上) 它由pod1中netns的eth0网口离开,通过vethxxx进入root netns。 然后被传到cbr0,cbr0通过发送ARP请求来找到目标地址。 本节点上没有Pod拥有pod4的IP地址,根据路由判断数据包由cbr0 传到主网络接口 eth0. 数据包的源地址为pod1,目标地址为pod4,它以这种方式离开node1进入电缆。 路由表有每个节点的CIDR块的路由设定,它把数据包路由到CIDR块包含pod4的IP的节点。 因此数据包到达了node2的主网络接口eth0。现在即使pod4不是eth0的IP,数据包也仍然能转发到cbr0,因为节点配置了IP forwarding enabled。节点的路由表寻找任意能匹配pod4 IP的路由。它发现了 cbr0 是这个节点的CIDR块的目标地址。你可以用route -n命令列出该节点的路由表,它会显示cbr0的路由,类型如下: 网桥接收了数据包,发送ARP请求,发现目标IP属于vethyyy。 数据包跨过管道对到达pod4。 这就是Kubernetes网络的基础。下次你碰到问题,务必先检查这些网桥、iptables规则表和路由表。

优秀的个人博客,低调大师

深入理解 Java 中的 final 关键字

final 是 Java 中重要关键字之一,可以应用于类、方法以及变量上。这篇文章中将讲解什么是 final 关键字?将变量、方法和类声明为 final 代表了什么?使用 final 的好处是什么? final 关键字是什么? final 在 Java 中是一个保留的关键字,可以声明成员变量、方法、类以及本地变量。一旦你将引用声明作 final,你将不能改变这个引用了,编译器会检查代码,如果试图将变量再次初始化的话,编译器会报编译错误。 final 变量 凡是对成员变量或者本地变量(在方法中的或者代码块中的变量称为本地变量)声明为 final 的都叫作 final 变量。final 变量经常和 static 关键字一起使用,作为常量。下面是 final 变量的例子: public static final String NAME = "wupx"; NAME = new String("wupx"); //invalid compilation error final 变量是只读的。 final 方法 final 也可以声明方法,Java 里用 final 修饰符去修饰一个方法的唯一正确用途就是表达:这个方法原本是一个虚方法,现在通过 final 来声明这个方法不允许在派生类中进一步被覆写(override)。 Java 中非私有的成员方法默认都是虚方法,而虚方法就可以在派生类中被覆写。为了保证某个类上的某个虚方法不在派生类中被进一步覆写,就需要使用 final 修饰符来声明,让编译器(例如 javac)与 JVM 共同检查并保证这个限制总是成立。 下面引用 R 大 在知乎上的回答来打破“用 final 修饰方法可以让对这个方法的调用变快”的流言: 曾经有一种广为流传的说法是用final修饰方法可以让对这个方法的调用变快。这种说法在现代主流的优化JVM上都是不成立的(例如Oracle JDK / OpenJDK HotSpot VM、IBM J9 VM、Azul Systems Zing VM等)。这是因为:能用final修饰的虚方法,其派生类中必然不可能存在对其覆写的版本,于是可以判定这个虚方法只有一个可能的调用目标;而如果此时把这个final修饰符去掉,这些先进的JVM都可以通过“类层次分析”(Class Hierarchy Analysis,CHA)来发现这个方法在派生类中没有进一步覆写的版本,于是同样可以判定这个虚方法只有一个可能的调用目标。然后两者的优化程度会一模一样,无论是从“不需要通过虚分派而可以直接调用目标”(称为“去虚化”,devirtualization)还是从“便于内联”的角度看,这两种情况都是一样的。 而如果某个类层次结构中原本某个虚方法就存在多个覆写版本的话,那么本来也不可能对这个虚方法加上final修饰,所以就算这种情况下去虚化变得困难,锅也不能让“因为没用final修饰”来背。 使用final关键字在现代主流的优化JVM上不会提升性能。 下面是 final 方法的例子: class User{ public final String getName(){ return "user:wupx"; } } class Reader extends User{ @Override public final String getName(){ return "reader wupx"; //compilation error: overridden method is final } } final 类 使用 final 来修饰的类叫作 final 类,final类通常功能是完整的,它们不能被继承,Java 中有许多类是 final 的,比如 String, Interger 以及其他包装类。下面是 final 类的实例: final class User{ } class Reader extends User{ //compilation error: cannot inherit from final class } 内存模型中的 final 对于 final 变量,编译器和处理器都要遵守两个重排序规则: 构造函数内,对一个 final 变量的写入,与随后把这个被构造对象的引用赋值给一个变量,这两个操作之间不可重排序 首次读一个包含 final 变量的对象,与随后首次读这个 final 变量,这两个操作之间不可以重排序 实际上这两个规则也正是针对 final 变量的写与读。写的重排序规则可以保证,在对象引用对任意线程可见之前,对象的 final 变量已经正确初始化了,而普通变量则不具有这个保障;读的重排序规则可以保证,在读一个对象的 final 变量之前,一定会先读这个对象的引用。如果读取到的引用不为空,根据上面的写规则,说明对象的 final 变量一定以及初始化完毕,从而可以读到正确的变量值。 如果 final 变量的类型是引用型,那么构造函数内,对一个 final 引用的对象的成员域的写入,与随后在构造函数外把这个被构造对象的引用赋值给一个引用变量,这两个操作之间不能重排序。 实际上这也是为了保证 final 变量在对其他线程可见之前,能够正确的初始化完成。 final 关键字的好处 下面为使用 final 关键字的一些好处: final 关键字提高了性能,JVM 和 Java 应用都会缓存 final 变量 final 变量可以安全的在多线程环境下进行共享,而不需要额外的同步开销 总结 final 关键字可以用于成员变量、本地变量、方法以及类 final 成员变量必须在声明的时候初始化或者在构造器中初始化,否则就汇报编译错误 不能够对 final 变量再次赋值 本地变量必须在声明时赋值 在匿名类中所有变量都必须是 final 变量 final 方法不能被重写 final 类不能被继承 接口中声明的所有变量本身是 final 的 final 和 abstract 这两个关键字是反相关的,final 类就不可能是 abstract 的 没有在声明时初始化 final 变量的称为空白 final 变量(blank final variable),它们必须在构造器中初始化,或者调用 this() 初始化,不这么做的话,编译器会报错final变量(变量名)需要进行初始化 按照 Java 代码惯例,final 变量就是常量,而且通常常量名要大写 对于集合对象声明为 final 指的是引用不能被更改 参考 《Java编程思想》 https://www.zhihu.com/question/66083114

优秀的个人博客,低调大师

从源码角度理解Java设计模式——装饰者模式

一、饰器者模式介绍 装饰者模式定义:在不改变原有对象的基础上附加功能,相比生成子类更灵活。 适用场景:动态的给一个对象添加或者撤销功能。 优点:可以不改变原有对象的情况下动态扩展功能,可以使扩展的多个功能按想要的顺序执行,以实现不同效果。 缺点:更多的类,使程序复杂 类型:结构型。 类图: 源码分析中的典型应用 Java I/O 中的装饰者模式 Spring Session 中的装饰者模式 Mybatis 缓存中的装饰者模式 二、给系统添加日志,安全、限流示例 一般系统的安全、日志、限流等业务无关代码可以抽离出来,在Controller前后用切面改造,模板方法模式可以部分解决这个问题: public abstract class BaseAspect { Logger logger = LoggerFactory.getLogger(BaseCommand.class); public void execute(){ //记录日志 logger.debug("..start.."); //过滤跨站脚本攻击 paramXssAspect(); //限制速率 doRateLimit(); doBusiness(); logger.debug("..end.."); } public abstract void doBusiness(); } class PlaceOrderAspect extends BaseAspect { @Override public void doBusiness() { //下单操作 } } class PayOrderAspect extends BaseAspect { @Override public void doBusiness() { //支付操作 } } 在父类中已经把”乱七八糟“的非业务代码写好了,只留了一个抽象方法等子类去实现,子类变的很清爽,只需关注业务逻辑就可以了。 这种方式最大的缺陷就是父类会定义一切:要执行那些非业务代码,以什么顺序执行等等,子类只能无条件接受。如果有一个子类,不限制速率,那么它也没有办法把它去掉。 利用装饰者模式,针对上面的问题,可以变的很灵活。 //最高层抽象组件 interface IAspect { String doHandlerAspect(); } //基本被装饰类 class AspectImpl implements IAspect{ @Override public String doHandlerAspect() { return "裸跑代码."; } } abstract class AbstractDecorator implements IAspect{ //很重要,组合抽象构件到自己的类中 private IAspect aspect; public AbstractDecorator(IAspect aspect) {//通过IAspect构造自己 this.aspect = aspect; } @Override public String doHandlerAspect() { return this.aspect.doHandlerAspect(); } } 附加记录日志,安全,限流功能: class LoggerAspect extends AbstractDecorator{ public LoggerAspect(IAspect aspect){ super(aspect); } @Override public String doHandlerAspect() { return super.doHandlerAspect()+"+记录日志."; } } class ParamXssAspect extends AbstractDecorator{ public ParamXssAspect(IAspect aspect){ super(aspect); } @Override public String doHandlerAspect() { return super.doHandlerAspect()+"+过滤危险字符."; } } class LimitAspect extends AbstractDecorator{ public LimitAspect(IAspect aspect){ super(aspect); } @Override public String doHandlerAspect() { return super.doHandlerAspect()+"+限流."; } } 测试一下: public class Test { public static void main(String[] args) { IAspect aspect = new LimitAspect(new ParamXssAspect(new LoggerAspect(new AspectImpl()))); System.out.println(aspect.doHandlerAspect()); } } 运行结果: ------ 裸跑代码.+记录日志.+过滤危险字符.+限流. ------ 通过上面可以看出,装饰者模式可以任意次序组装功能,是不是很灵活?另外,也可以把上述三个功能封装成注解@Log、@ParamXss、@AccessLimit,实现可拔插。如果读者想看注解功能完整实现,可以参考我的这个项目:SpringBoot+JWT+Shiro+MybatisPlus实现Restful快速开发后端脚手架 三、源码中的装饰者模式 3.1、Java IO中是体现最明显的装饰者模式。 它基于字符流(InputStream/OutputStream) 和 字节流(Reader/Writer)作为基类,下面画出InputStream、Reader的部分类图: 这里总结几种常用流的应用场景: 流名称 应用场景 ByteArrayInputStream 访问数组,把内存中的一个缓冲区作为 InputStream 使用,CPU从缓存区读取数据比从存储介质的速率快10倍以上 StringBufferInputStream 把一个 String 对象作为。InputStream。不建议使用,在转换字符的问题上有缺陷 FileInputStream 访问文件,把一个文件作为 InputStream ,实现对文件的读取操作 PipedInputStream 访问管道,主要在线程中使用,一个线程通过管道输出流发送数据,而另一个线程通过管道输入流读取数据,这样可实现两个线程间的通讯 SequenceInputStream 把多个 InputStream 合并为一个 InputStream . “序列输入流”类允许应用程序把几个输入流连续地合并起来 DataInputStream 特殊流,读各种基本类型数据,如byte、int、String的功能 ObjectInputStream 对象流,读对象的功能 PushBackInputStream 推回输入流,可以把读取进来的某些数据重新回退到输入流的缓冲区之中 BufferedInputStream 缓冲流,增加了缓冲功能 3.2、Spring Session中的ServletRequestWrapper(Response也一样)的装饰者模式。 public class ServletRequestWrapper implements ServletRequest { private ServletRequest request;//组合抽象接口到自己的类中 public ServletRequestWrapper(ServletRequest request) {//可以构造自己 if(request == null) { throw new IllegalArgumentException("Request cannot be null"); } else { this.request = request; } } public ServletRequest getRequest() { return this.request; } public void setRequest(ServletRequest request) { if(request == null) { throw new IllegalArgumentException("Request cannot be null"); } else { this.request = request; } } //省略... } 3.3、Spring Cache中的TransactionAwareCacheDecorator的装饰者模式。 其实从类名就可以看出。 public class TransactionAwareCacheDecorator implements Cache { private final Cache targetCache;//把Cache组合到自己类中 public TransactionAwareCacheDecorator(Cache targetCache) {//通过Cache构造自己 Assert.notNull(targetCache, "Target Cache must not be null"); this.targetCache = targetCache; } public <T> T get(Object key, Class<T> type) { return this.targetCache.get(key, type); } public void put(final Object key, final Object value) { // 判断是否开启了事务 if (TransactionSynchronizationManager.isSynchronizationActive()) { // 将操作注册到 afterCommit 阶段 TransactionSynchronizationManager.registerSynchronization(new TransactionSynchronizationAdapter() { public void afterCommit() { TransactionAwareCacheDecorator.this.targetCache.put(key, value); } }); } else { this.targetCache.put(key, value); } } // ...省略... } 3.4、Mybatis中的装饰者。 Cache为抽象构件类,PerpetualCache为具体构件类,decorators包下的类为装饰类,这里没有抽象装饰类。 参考: 设计模式 | 装饰者模式及典型应用 《码农翻身》刘欣

优秀的个人博客,低调大师

深入理解Java中的volatile关键字

本文就围绕volatile展开,主要介绍volatile的用法、volatile的原理,以及volatile是如何提供可见性和有序性保障的等。 volatile这个关键字,不仅仅在Java语言中有,在很多语言中都有的,而且其用法和语义也都是不尽相同的。尤其在C语言、C++以及Java中,都有volatile关键字。都可以用来声明变量或者对象。下面简单来介绍一下Java语言中的volatile关键字。 volatile的用法 volatile通常被比喻成"轻量级的synchronized",也是Java并发编程中比较重要的一个关键字。和synchronized不同,volatile是一个变量修饰符,只能用来修饰变量。无法修饰方法及代码块等。 volatile的用法比较简单,只需要在声明一个可能被多线程同时访问的变量时,使用volatile修饰就可以了。 publicclassSingleton{ privatevolatilestaticSingletonsingleton; privateSingleton(){} publicstaticSingletongetSingleton(){ if(singleton==null){ synchronized(Singleton.class){ if(singleton==null){ singleton=newSingleton(); } } } returnsingleton; } } 如以上代码,是一个比较典型的使用双重锁校验的形式实现单例的,其中使用volatile关键字修饰可能被多个线程同时访问到的singleton。 volatile的原理 在再有人问你Java内存模型是什么,就把这篇文章发给他中我们曾经介绍过,为了提高处理器的执行速度,在处理器和内存之间增加了多级缓存来提升。但是由于引入了多级缓存,就存在缓存数据不一致问题。 但是,对于volatile变量,当对volatile变量进行写操作的时候,JVM会向处理器发送一条lock前缀的指令,将这个缓存中的变量回写到系统主存中。 但是就算写回到内存,如果其他处理器缓存的值还是旧的,再执行计算操作就会有问题,所以在多处理器下,为了保证各个处理器的缓存是一致的,就会实现缓存一致性协议 缓存一致性协议:每个处理器通过嗅探在总线上传播的数据来检查自己缓存的值是不是过期了,当处理器发现自己缓存行对应的内存地址被修改,就会将当前处理器的缓存行设置成无效状态,当处理器要对这个数据进行修改操作的时候,会强制重新从系统内存里把数据读到处理器缓存里。 所以,如果一个变量被volatile所修饰的话,在每次数据变化之后,其值都会被强制刷入主存。而其他处理器的缓存由于遵守了缓存一致性协议,也会把这个变量的值从主存加载到自己的缓存中。这就保证了一个volatile在并发编程中,其值在多个缓存中是可见的。 volatile与可见性 可见性是指当多个线程访问同一个变量时,一个线程修改了这个变量的值,其他线程能够立即看得到修改的值。 我们在再有人问你Java内存模型是什么,就把这篇文章发给他中分析过:Java内存模型规定了所有的变量都存储在主内存中,每条线程还有自己的工作内存,线程的工作内存中保存了该线程中是用到的变量的主内存副本拷贝,线程对变量的所有操作都必须在工作内存中进行,而不能直接读写主内存。不同的线程之间也无法直接访问对方工作内存中的变量,线程间变量的传递均需要自己的工作内存和主存之间进行数据同步进行。所以,就可能出现线程1改了某个变量的值,但是线程2不可见的情况。 前面的关于volatile的原理中介绍过了,Java中的volatile关键字提供了一个功能,那就是被其修饰的变量在被修改后可以立即同步到主内存,被其修饰的变量在每次是用之前都从主内存刷新。因此,可以使用volatile来保证多线程操作时变量的可见性。 volatile与有序性 有序性即程序执行的顺序按照代码的先后顺序执行。 我们在再有人问你Java内存模型是什么,就把这篇文章发给他中分析过:除了引入了时间片以外,由于处理器优化和指令重排等,CPU还可能对输入代码进行乱序执行,比如load->add->save 有可能被优化成load->save->add 。这就是可能存在有序性问题。 而volatile除了可以保证数据的可见性之外,还有一个强大的功能,那就是他可以禁止指令重排优化等。 普通的变量仅仅会保证在该方法的执行过程中所依赖的赋值结果的地方都能获得正确的结果,而不能保证变量的赋值操作的顺序与程序代码中的执行顺序一致。 volatile可以禁止指令重排,这就保证了代码的程序会严格按照代码的先后顺序执行。这就保证了有序性。被volatile修饰的变量的操作,会严格按照代码顺序执行,load->add->save 的执行顺序就是:load、add、save。 volatile与原子性 原子性是指一个操作是不可中断的,要全部执行完成,要不就都不执行。 我们在Java的并发编程中的多线程问题到底是怎么回事儿?中分析过:线程是CPU调度的基本单位。CPU有时间片的概念,会根据不同的调度算法进行线程调度。当一个线程获得时间片之后开始执行,在时间片耗尽之后,就会失去CPU使用权。所以在多线程场景下,由于时间片在线程间轮换,就会发生原子性问题。 在上一篇文章中,我们介绍synchronized的时候,提到过,为了保证原子性,需要通过字节码指令monitorenter和monitorexit,但是volatile和这两个指令之间是没有任何关系的。 所以,volatile是不能保证原子性的。 在以下两个场景中可以使用volatile来代替synchronized: 1、运算结果并不依赖变量的当前值,或者能够确保只有单一的线程会修改变量的值。 2、变量不需要与其他状态变量共同参与不变约束。 除以上场景外,都需要使用其他方式来保证原子性,如synchronized或者concurrent包。 我们来看一下volatile和原子性的例子: publicclassTest{ publicvolatileintinc=0; publicvoidincrease(){ inc++; } publicstaticvoidmain(String[]args){ finalTesttest=newTest(); for(inti=0;i<10;i++){ newThread(){ publicvoidrun(){ for(intj=0;j<1000;j++) test.increase(); }; }.start(); } while(Thread.activeCount()>1)//保证前面的线程都执行完 Thread.yield(); System.out.println(test.inc); } } 以上代码比较简单,就是创建10个线程,然后分别执行1000次i++操作。正常情况下,程序的输出结果应该是10000,但是,多次执行的结果都小于10000。这其实就是volatile无法满足原子性的原因。 为什么会出现这种情况呢,那就是因为虽然volatile可以保证inc在多个线程之间的可见性。但是无法inc++的原子性。 总结与思考 我们介绍过了volatile关键字和synchronized关键字。现在我们知道,synchronized可以保证原子性、有序性和可见性。而volatile却只能保证有序性和可见性。 那么,我们再来看一下双重校验锁实现的单例,已经使用了synchronized,为什么还需要volatile? publicclassSingleton{ privatevolatilestaticSingletonsingleton; privateSingleton(){} publicstaticSingletongetSingleton(){ if(singleton==null){ synchronized(Singleton.class){ if(singleton==null){ singleton=newSingleton(); } } } returnsingleton; } } 原文发布时间为:2018-10-26 本文来自云栖社区合作伙伴“Android开发中文站”,了解相关信息可以关注“Android开发中文站”。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册