首页 文章 精选 留言 我的

精选列表

搜索[智能推荐],共10000篇文章
优秀的个人博客,低调大师

请推荐一门能精确控制大量并发并行的编程语言或解决方案

需求是短时间内发送大量 GET 和 POST 请求,支持并行,要有极致的效率,慢一毫秒都无法接受的那种。 我现在已经用 Python 的异步方式实现了一个小 Demo,用到了 Trio 和 HTTPX 这两个包。但是速度并不满意。虽然能够并发,但是随着并行数量越来越多,提升硬件和带宽并不能提升效率。毕竟异步仍然是单核单线程。 我也搜了相关的内容,比如用 Go 语言试试。但是时间有限,比较着急,希望熟悉的大佬能指点一下,谢谢。

优秀的个人博客,低调大师

推荐一个非常好用的以多tab标签方式打开windows CMD的工具

最近我在做基于nodejs的微服务开发,需要在windows命令行里启动很多微服务。我的windows 10任务栏是这样子的: 我想找一款能像下图Chrome标签页这样打开windows 10 CMD窗口的工具,在网上找了一圈后,发现了这个名叫console2的工具: 网址:https://sourceforge.net/projects/console/ 下载下来压缩包只有1点几兆,解压即用。可以像Chrome那样任意新建tab: 可以在多个tab间方便切换: 本文来自云栖社区合作伙伴“汪子熙”,了解相关信息可以关注微信公众号"汪子熙"。

优秀的个人博客,低调大师

Java专家推荐之资深讲师徐雷,.NET转Java需要先了解Java的哪些框架?

社区将持续介绍优秀的Java专家,本期请到了阿里云大学讲师,资深架构师徐雷,在线为开发者解决问题,向徐雷提问请点击:https://yq.aliyun.com/promotion/755 徐雷,资深架构师 徐雷,花名:徐雷frank;资深架构师,MongoDB中文社区联席主席,吉林大学计算机学士,上海交通大学硕士。从事了 10年+开发工作,专注于分布式架构,Java Spring Boot、Spring Cloud、MongoDB、Redis。 喜欢专研技术问题,擅长讲课,《MongoDB实战》第2版、《24种云计算架构设计模式》译者,2018年5月受邀成为《阿里巴巴Java和MongoDB技术认证》讲师,2018年8月与阿里巴巴资深专家P9叶翔直播《阿里巴巴MongoDB高级实战课程》 徐雷在社区发布的视频: Java Spri

优秀的个人博客,低调大师

遇见一款很受用的一个工具,推荐给各位程序员

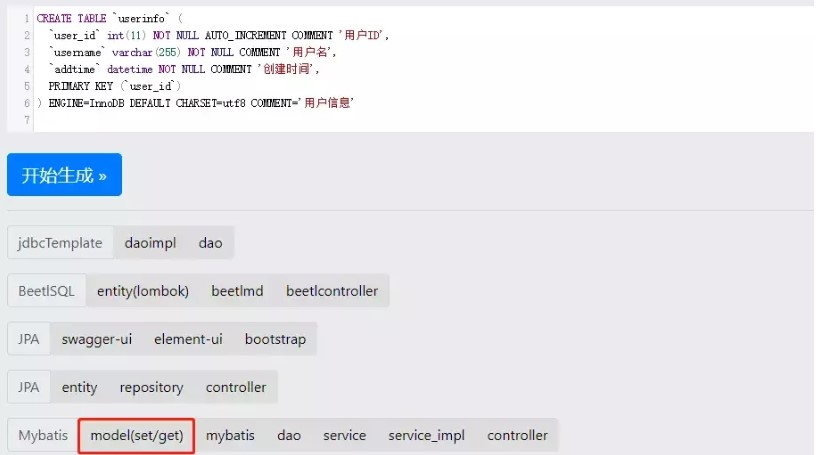
最近我在做一个电商项目,在设计数据库表的时候遇到过这样一个场景,商品表中的字段特别多,设置完后产品经理又说改一下,然后改了一下,但是我代码中的实体却有点问题,一直报字段不对应,这里大家就暂且不说什么我为什么不使用逆向工程之类的了。 就因为这个问题30多个字段我改了好几次,确实挺费事的,在上周我发现一个很好用的工具,它不仅可以将我们的数据表直接转换为实体类,还可以生成DAO,甚至还可以把我们的json格式的数据直接转换实体类,这里不多说了,给大家简单演示一下这些功能。 数据库表转JavaBean: 我们直接将我们的表结构字段赋值进去点击开始生成,那么它就会给我们生成下面的这些数据,我们先来看下生成的JavaBean importjava.io.Serializable; importjava.util.Date; importjava.util.List; /** * 用户信息 * @author 大狼狗 2018-10-28 */ publicclassUserinfoimplementsSerializable{ privatestaticfinallongserialVersionUID =1L; /** * 用户id */ privateintuserId; /** * 用户名 */ privateString username; /** * 创建时间 */ privateDate addtime; publicintgetUserId(){ returnuserId; } publicvoidsetUserId(intuserId){ this.userId = userId; } publicStringgetUsername(){ returnusername; } publicvoidsetUsername(String username){ this.username = username; } publicDategetAddtime(){ returnaddtime; } publicvoidsetAddtime(Date addtime){ this.addtime = addtime; } } 我们再来看下它给我们生成的其他东西: 这就是给我们生成的一些基本的sql语句: <?xml version="1.0"encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mappernamespace="com.softdev.system.dao.UserinfoDao"> <resultMapid="Userinfo"type="com.softdev.system.entity.Userinfo"> <resultcolumn="user_id"property="userId"/> <resultcolumn="username"property="username"/> <resultcolumn="addtime"property="addtime"/> </resultMap> <sqlid="Base_Column_List"> `user_id`, `username`, `addtime` </sql> <insertid="insert"parameterType="java.util.Map"> INSERT INTO userinfo ( `user_id`, `username`, `addtime` ) VALUES( #{userinfo.userId}, #{userinfo.username}, NOW() ) </insert> <deleteid="delete"parameterType="java.util.Map"> DELETE FROM userinfo WHERE `id` = #{id} </delete> <updateid="update"parameterType="java.util.Map"> UPDATE userinfo SET user_id = #{userinfo.userId}, username = #{userinfo.username}, addtime = #{userinfo.addtime}, UpdateTime = NOW() WHERE `id` = #{userinfo.id} </update> <selectid="load"parameterType="java.util.Map"resultMap="Userinfo"> SELECT<includerefid="Base_Column_List"/> FROM userinfo WHERE `id` = #{id} </select> <selectid="pageList"parameterType="java.util.Map"resultMap="Userinfo"> SELECT<includerefid="Base_Column_List"/> FROM userinfo LIMIT #{offset}, #{pagesize} </select> <selectid="pageListCount"parameterType="java.util.Map"resultType="int"> SELECT count(1) FROM userinfo </select> </mapper> 我们可以通过下面看到,从JavaBean到Controller这个工具都可以帮我们直接生成,是不是感觉好用很多啊! 还有一个我感觉比较好用的功能,我上一个项目做的是公安相关的,里面要和好几个平台进行对接,有时候数据结构很复杂,你要好好分析他们返回的json然后定义对应的实体类,这个工具也可以根据json帮助我们生成对应的JavaBean,还有很多好用的功能我这里就不一一列举了。 我这里直接把链接放在这里,有兴趣的朋友可以看看。 网址:http://www.bejson.com/


优秀的个人博客,低调大师

案例推荐《中汇技术:打造银行间市场本外币交易背后的共享服务平台》

随着银行间市场新业务的开展,为了快速响应业务需求,更好的服务行业机构和会员单位,中汇系统逐步升级至分布式、服务化、高可用的技术架构。 中汇公司自主设计规划的企业架构资产库,包含丰富的技术平台、框架,中间件、构件库和基础设施,结合领域驱动的先进理念,实施建设交易中心各类应用系统,包括银行间外汇交易系统、本币交易系统、交易后处理系统和中国货币网等,打造银行间市场基础设施环境,构建技术生态圈。

优秀的个人博客,低调大师

使用 IntelliJ IDEA 导入 Spark 最新源码及编译 Spark 源代码(博主强烈推荐)

前言 其实啊,无论你是初学者还是具备了有一定spark编程经验,都需要对spark源码足够重视起来。 本人,肺腑之己见,想要成为大数据的大牛和顶尖专家,多结合源码和操练编程。 准备工作 1、scala 2.10.4(本地的安装) Scala的安装(本地) 2、Jdk1.7+ 或 jdk1.8+ (本地的安装) Jdk 1.7*安装并配置 Jdk 1.8*安装并配置 JDK的windows和Linux版本之下载 3、IntelliJ IDEA IntelliJ IDEA(Community版本)的下载、安装和WordCount的初步使用(本地模式和集群模式) IntelliJ IDEA(Ultimate版本)的下载、安装和WordCount的初步使用(本地模式和集群模式) Spark源码的编译过程详细解读(各版本) 另外,最后还是建议大家开始先使用 pre-built 的 Spark,对 Spark 的运行、使用方法有所了解,编写了一些 Spark 应用程序后再展开源代码的阅读,并尝试修改源码,进行手动编译。 总体流程 1、从 Github 导入 Spark 工程 打开IntelliJ IDEA 后,在菜单栏中选择VCS→Check out from Version Control→Git,之后在 Git Repository URL 中填入 Spark 项目的地址,并指定好本地路径,如下图所示。 https://github.com/apache/spark.git 或者,我们可以直接先下载好, 比如我这里,已经下载好了 解压, 提前,先准备好 对于spark源码的目录结构 1、编译相关 : sbt 、assembly、project 2、spark核心 :core 3、Spark Lib : streaming 、 sql 、graphx 、mllib 4、运行脚本和配置 : bin 、sbin 、conf 5、虚拟化 : ec2 、docker 、dev 6、式例 : examples 、data 7、部署相关: yarn 8、python支持 : python 9、repl : repl 10、 3pp : externals 现在,我开始,进入spark源码导入工作。 先来关闭,已有的工程。 File -> Close Project 得到,如下 选择,Import Project 这里,为了日后的spark源码阅读环境的方便和开发 安装之后的几个常用设置: 1、界面字体大小的设置 可见,界面字体的效果 2、代码字体的设置 3、因我们平常,用习惯了eclipse,快捷键,设置为我们平常,eclipse的风格。 完成 简单,带领,如何巧看spark源码? 这里,为了避免一个不利的阅读, 放到D盘的根目录下, 设置行号 其他的源码,首先,Ctrl + Shift + R,然后,自行去阅读。 建议,在理解概念,真的,可以拿源码来帮助理解! 总结 所以啊,源码 + 官网 ,是黄金组合。 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5881893.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册