首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

C++标准编程:虚函数与内联

我们曾经在讨论C++的时候,经常会问到:“虚函数能被声明为内联吗?”现在,我们几乎听不到这个问题了。现在听到的是:“你不应该使print成为内联的。声明一个虚函数为内联是错误的!” 这种说法的两个主要的原因是(1)虚函数是在运行期决议而内联是一个编译期动作,所以,我们将虚函数声明为内联并得不到什么效果;(2)声明一个虚函数为内联导致了函数的多分拷贝,而且我们为一个不应该在任何时候内联的函数白白花费了存储空间。这样做很没脑子。 不过,事实并不是这样。我们先来看看第一个:许多情况下,虚拟函数都被静态地决议了——比如在派生类虚拟函数中调用基类的虚拟函数的时候。为什么这样做呢?封装。一个比较明显的例子就是派生类析构函数调用链。所有的虚析构函数,除了最初触发这个析构链的虚析构函数,都被静态的决议了。如果不将基类的虚析构函数内联,我们无法从中获利[a]。这和不内联一个虚拟析构函数有什么不同吗?如果继承体系层次比较深并且有许多这样的类的实例要被销毁的话,答案是肯定的。 再来看另外一个不用析构函数的例子,想象一下设计一个图书馆类。我们将MaterialLocation作为抽象类LibraryMaterial的一个成员。将它的print成员函数声明为一个纯虚函数,并且提供函数定义:它输出MaterialLocation。 class LibraryMaterial { private: MaterialLocation _loc;// shared data // … public: // declares pure virtual function inline virtual void print(ostream& = cout) = 0; }; // we actually want to encapsulate the handling of the // location of the material within a base class // LibraryMaterial print() method - we just don’t want it // invoked through the virtual interface. That is, it is // only to be invoked within a derived class print() method inline void LibraryMaterial:: print(ostream &os) { os <<_loc; } 接着,我们引入一个Book类,它的print函数输出Title, Author等等。在这之前,它调用基类的print函数(LibraryMaterial::print())来显示书本位置(MaterialLocation)。如下: inline void Book:: print(ostream &os) { // ok, this is resolved statically, // and therefore is inline expanded … LibraryMaterial::print(); os << "title:" << _title << "author" << _author<< endl; } AudioBook类,派生于Book类,并加入附加信息,比如旁述,音频格式等等。这些东西都用它的print函数输出。再这之前,我们需要调用Book::print()来显示前面的信息。 inline void AudioBook:: print(ostream &os) { // ok, this is resolved statically, // and therefore is inline expanded … Book::print(); os <<"narrator:"<< _narrator <<endl; } 这和虚析构函数调用链的例子一样,都只是最初调用的虚函数没有被静态决议,其它的都被原地展开。This unnamed hierarchical design pattern is significantly less effective if we never declare a virtual function to be inline. 那么对于第二个原因中代码膨胀的问题呢?我们来分析一下,如果我们写下: LibraryMaterial *p = new AudioBook("Mason & Dixon", "Thomas Pynchon", "Johnny Depp"); // … p->print(); 这个print实例是内联的吗?不,当然不是。这样不得不通过虚拟机制在运行期决议。这让print实例放弃了对它的内联声明了吗?也不是。这个调用转换为下面的形式(伪代码): // Pseudo C++ Code // Possible transformation of p->print() (*p->_vptr[ 2 ])(p); where 2 represents the location of print within the associated virtual function table.因为调用print是通过函数指针_vptr[2]进行的,所以,编译器不能静态的决定这个调用地址,并且,这个函数也不能内联。 当然,虚函数print的内联实体(definition)也必须在某个地方表现出来。 即是说,至少有一个函数实体是在virtual table调用的地址原地展开的。编译器是如何决定在何时展开这个函数实体呢?其中一个编译(implementaion)策略是当virtual table生成的同时,生成这个函数实体。这就是说对于每一个派生类的virtual table都会生成一个函数实体。 在一个可应用的类[b]中有多少vitrual table会被生成呢?呵呵,这是一个好问题。C++标准中对虚函数行为进行了规定,但是没有对函数实现进行规定。由于virtual table没有在C++标准中进行规定,很明显,究竟这个virtual table怎样生成,和究竟要生成多少个vitrual table也没有规定。多少个?当然,我们只要一个。Stroustrup的cfront编译器,很巧妙的处理了这些情况。( Stan and Andy Koenig described the algorithm in the March 1990 C++ Report article, "Optimizing Virtual Tables in C++ Release 2.0.") Moreover, the C++ Standard now requires that inline functions behave as though only one definition for an inline function exists in the program even though the function may be defined in different files。新的规则要求编译器只展开一个内联虚函数。如果一点被广泛采用的话,虚函数的内联导致的代码膨胀问题就会消失。
优秀的个人博客,低调大师

Java并发编程笔记4-线程池

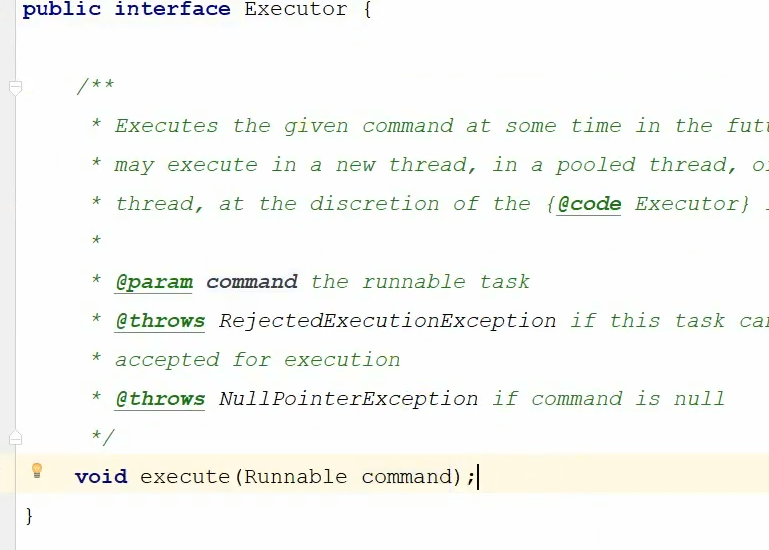
我们使用线程的时候就去创建一个线程,但是就会有一个问题: 如果并发的线程数量非常多,而且每个线程都是执行一个时间很短的任务就结束了,这样频繁创建线程就会导致大大降低系统的效率,因为频繁创建线程和销毁线程需要时间。 那么有没有一种办法使得线程可以复用,就是执行完一个任务,并不被销毁,而是可以继续执行其他的任务? 线程池正好能解决这样的问题。正如名称所称的那样,线程池管理一个工作者线程的同构池。线程池是与工作队列紧密绑定的。所谓工作队列,其作用是持有所有等待执行的任务。 工作者线程的生活从此轻松起来:它从工作队列中获取下一个任务,执行它,然后回来等待另外一个线程。 这类似于企业应用程序中事务监听器(transaction monitor)的角色:它将课运行事务的数量控制在一个合理的水平中,不会因过渡滥用事务而耗尽有限资源。 线程池中执行任务线程,这方法有很多“每任务每线程”无法笔记的优势。重用存在的线程,而不是创建新的线程,这可以在处理多请求时抵消线程创建,消亡产生的开销。还有一个好处就是,在请求到达时,工作者线程通常已经存在 ,用于创建线程的等待时间并不会延迟任务的执行,因此提高响应性。通过适当地调整线程池的大小,你可以得到足够多的线程以保持处理器忙碌,同时可以还防止过多的线程互相竞争资源,导致应用程序耗尽内存或者失败。 每任务每线程例子如下: public class ThreadPool { public static void main(String[] args) throws IOException { ServerSocket serverSocket = new ServerSocket(80); while (true){ final Socket socket = serverSocket.accept(); Runnable task = new Runnable() { public void run() { handleRequest(socket); } }; new Thread(task).start(); } } private static void handleRequest(Socket socket) { } } 可以看到这个例子是一个粗制滥造的并发服务端,来一个用户就创建一个线程,你根本就不知道有多少用户来,要创建多少个线程。这样频繁创建线程就会导致大大降低系统的效率,因为频繁创建线程和销毁线程需要时间, 过渡滥创建线程而耗尽有限资源。 由于这原因,java中给我们提供Executor框架。通过Executors中的某个静态工厂方法来创建一个线程池: 1.newFixedThreadPool 创建一个定长的线程池,每当提交一个任务就创建一个线程,知道达到池的最大长度,这时线程池会保持长度不再变化(如果一个线程由于非预期的Exception而结束,线程池会补充一个新的线程)。 下面用newFixedThreadPool 创建一个定长的线程池来改造上面的例子,如下: public class ThreadPool { public static void main(String[] args) throws IOException { //newFixedThreadPool参数为线程池的大小 Executor executor = Executors.newFixedThreadPool(100); ServerSocket serverSocket = new ServerSocket(80); while (true){ final Socket socket = serverSocket.accept(); Runnable task = new Runnable() { public void run() { handleRequest(socket); } }; //直接将任务丢进线程池来执行任务 executor.execute(task); } } private static void handleRequest(Socket socket) { } } 这样就不会发生过渡滥创建线程而耗尽有限资源。 2.newSingleThreadExecutor创建一个单线程化的executor,他只创建唯一的工作者线程来执行任务,如果这个线程异常结束,会有另一个取代它。executor会保证任务依照任务队列所规定的顺序(FIFO,LIFO,优先级)执行。 3.newCachedThreadPool创建一个可缓存的线程池,如果当前线程的长度超过了处理的需要,它可以灵活的回收空闲的线程,当需求增加时,它可以灵活的增加新的线程,并不会对池的长度做任何限制。但是认为改线程池的长度没有任何限制,有可能会把资源耗尽, 这需要自己很好的把控了。 4.newScheduledThreadPool创建一个定长的线程池,而且支持定时的以及周期性的任务执行,类似于Timer。 Executor的生命周期: Executor实现通常知识为执行任务而创建线程。但是JVM会在所有(非后台的,nondaemon)线程全部终止后才退出。因此,如果无法正确关闭Executor,将会阻止JVM的结束。 因为Executor是异步地执行任务,所以在任何时间里,所有之前提交的任务状态都不能立即可见。这些任务中,有些可能已经完成,有些可能正在运行,其他的还可能在队列中等待执行。关闭应用程序时,程序会出现很多中情况:从平缓关闭 到最突然的关闭,以及介于这两种阶段情况之间的各种可能。Executor是为应用服务提供服务的,他们理应可以关闭,无论是平缓还是突然。 注意:关闭操作还会影响到记录应用程序任务状态的反馈信息。 Executor就是一个接口,源码如下图: 我们可以进入Executors这个类的源码,如下: 可以看到newFixedThreadPool 创建一个定长的线程池,返回的是一个ExecutorService,但是我们上面例子接收的是Executor,为什么Executor也可以接收呢?我们继续进入ExecutorService源码如下: 可以看到原来ExecutorService继承了Executor。ExecutorService扩展了Executor,并且添加了一些用于声明周期管理的方法。 源码如下: ExecutorService暗示了生命周期有3种状态:运行、关闭、终止。ExecutorService最初创建后的初始状态是运行状态。 shutdown方法会启动一个平缓的关闭过程:停止接受新的任务,同时等待已经提交的任务完成,包括尚未开始执行的任务。 shutdownNow方法会启动要给强制的关闭过程:尝试取消所有运行中的任务和排在队列中尚未开始执行的任务is。 isShutdown方法:判断线程池(即ExecutorService)是否关闭。 isTerminated方法:是线程池(即ExecutorService)是否进入终止状态。 在关闭后提交到ExecutorService中的任务,会被拒绝执行处理器(rejected execution handler)处理。拒绝执行处理器是ExecutorService的一种实现,ThreadPoolExecutor提供的,ExecutorService接口中的方法并不提供拒绝执行处理器。拒绝执行处理器可能只是 简单的放弃任务,也可能会引起execute抛出一个未检查的RejectedExecutionException。一旦所有任务全部完成后,ExecutorService会转入终止状态。 awaitTermination方法:等待ExecutorService到达终止状态。 通常shutdown会紧随awaitTermination之后,这样可以产生同步地关闭ExecutorService的效果。 上面的Executor的例子的程序是没办法关闭线程池,会一直跑下去,那么我们如何写一个支持关闭的webserver呢? 明显我们现在要用ExecutorService来改造上面的Executor的例子。伪代码如下: public class ThreadPool { private static ExecutorService executorService = Executors.newCachedThreadPool(); public static void main(String[] args) throws IOException { //newFixedThreadPool参数为线程池的大小 ServerSocket serverSocket = new ServerSocket(80); //这里就不再像上面的例子一样无限的接受任务了,要根据我的线程池是否处于关闭状态来决定 while (!executorService.isShutdown()){ final Socket socket = serverSocket.accept(); try{ executorService.execute(new Runnable() { public void run() { handleRequest(socket); } }); }catch (RejectedExecutionException e){ //如果拒绝服务不是因为我线程池关闭导致的,我们要在这里打印一下日志 if (!executorService.isShutdown()){ System.out.println("接受任务被拒绝"); throw e; } } } } //用一个公共的方法去关闭线程池 public void stop(){ executorService.shutdown(); } private static void handleRequest(Socket socket) { //获取请求 Request req = readRequest(socket); //如果请求已经关闭 if (isShutdownRequest(req)){ //关闭线程池 stop(); }else { //请求转发 dispatchRequest(req); } } } 经过改造,这服务端变的优雅多了。 延时的,并具有周期性的任务 在newScheduledThreadPool出来之前我们一般会用Timer和TimerTask来做。Timer在JDK里面,是很早的一个API了。 但是Timer存在一些缺陷,Timer只创建唯一的线程来执行所有Timer任务。如果一个timer任务的执行很耗时,会导致其他TimerTask的时效准确性出问题。例如一个TimerTask每10秒执行一次, 而另外一个TimerTask每40ms执行一次,重复出现的任务会在后市的任务完成后快速连续的被调用4次,要么完全“丢失”4次调用。 Timer的另外一个问题在于,如果TimerTask抛出未检查的异常会终止timer线程。这种情况下,Timer也不会重新回复线程的执行了;它错误的认为整个Timer都被取消了。此时 已经被安排但尚未执行的TimerTask永远不会再执行了,新的任务也不能被调度了。 现在我们看一下Timer的例子,如下: public class Shedule { private static long start; public static void main(String[] args) { TimerTask task = new TimerTask() { public void run() { System.out.println(System.currentTimeMillis()-start); try{ Thread.sleep(3000); }catch (InterruptedException e){ e.printStackTrace(); } } }; TimerTask task1 = new TimerTask() { @Override public void run() { System.out.println(System.currentTimeMillis()-start); } }; Timer timer = new Timer(); start = System.currentTimeMillis(); //启动一个调度任务,1S钟后执行 timer.schedule(task,1000); //启动一个调度任务,3S钟后执行 timer.schedule(task1,3000); } } 上面程序我们预想是第一个任务执行后,第二个任务3S后执行的,即输出一个1000,一个3000. 实际运行结果如下: 实际运行结果并不如我们所愿。世界结果,是过了4S后才输出第二个任务,即4001约等于4秒。那部分时间时间到哪里去了呢?那个时间是被我们第一个任务的sleep所占用了。 现在我们在第一个任务中去掉Thread.sleep();这一行代码,运行是否正确了呢?如下: public class Shedule { private static long start; public static void main(String[] args) { TimerTask task = new TimerTask() { public void run() { System.out.println(System.currentTimeMillis()-start); } }; TimerTask task1 = new TimerTask() { @Override public void run() { System.out.println(System.currentTimeMillis()-start); } }; Timer timer = new Timer(); start = System.currentTimeMillis(); //启动一个调度任务,1S钟后执行 timer.schedule(task,1000); //启动一个调度任务,3S钟后执行 timer.schedule(task1,3000); } } 运行结果如下: 可以看到确实是第一个任务过了1S后执行,第二个任务在第一个任务执行完后过3S执行了。 这就说明了Timer只创建唯一的线程来执行所有Timer任务。如果一个timer任务的执行很耗时,会导致其他TimerTask的时效准确性出问题。 Timer存在一些缺陷,因此你应该考虑使用ScheduledThreadPoolExecutor作为替代品。你可以通过构造函数或者通过newScheduledThreadPool工厂方法创建一个ScheduledThreadPoolExecutor。 如下: public class Shedule { private static long start; private static ScheduledExecutorService executorService = Executors.newScheduledThreadPool(2); public static void main(String[] args) { TimerTask task = new TimerTask() { public void run() { System.out.println(System.currentTimeMillis()-start); try{ Thread.sleep(3000); }catch (InterruptedException e){ e.printStackTrace(); } } }; TimerTask task1 = new TimerTask() { @Override public void run() { System.out.println(System.currentTimeMillis()-start); } }; Timer timer = new Timer(); start = System.currentTimeMillis(); //TimeUnit.MILLISECONDS指定毫秒为单位 executorService.schedule(task,1000, TimeUnit.MILLISECONDS); executorService.schedule(task1,3000, TimeUnit.MILLISECONDS); } } 运行结果如下: 可以看到运行结果符合预期。 可以看到如果一个timer任务的执行很耗时(例如Thread.sleep),ScheduledThreadPoolExecutor并不会导致其他TimerTask的时效准确性出问题。 还可以看到,这两个TimerTask互不干扰。 互相干扰还有一个反面: 如果TimerTask抛出未检查的异常会终止timer线程。这种情况下,Timer也不会重新回复线程的执行了;它错误的认为整个Timer都被取消了。此时 已经被安排但尚未执行的TimerTask永远不会再执行了,新的任务也不能被调度了。 例子如下: public class Shedule { private static long start; private static ScheduledExecutorService executorService = Executors.newScheduledThreadPool(2); public static void main(String[] args) { TimerTask task = new TimerTask() { public void run() { System.out.println(System.currentTimeMillis()-start); throw new RuntimeException(); } }; TimerTask task1 = new TimerTask() { @Override public void run() { System.out.println(System.currentTimeMillis()-start); } }; Timer timer = new Timer(); start = System.currentTimeMillis(); timer.schedule(task,1000); timer.schedule(task1,3000); } } 如果第一TimerTask出现未知异常,第二个TimerTask还能运行起来吗? 结果如下: 明显第一TimerTask出现未知异常,第二个TimerTask不能运行起来了。这就说明 如果TimerTask抛出未检查的异常会终止timer线程。这种情况下,Timer也不会重新回复线程的执行了;它错误的认为整个Timer都被取消了。此时 已经被安排但尚未执行的TimerTask永远不会再执行了,新的任务也不能被调度了。 ScheduledThreadPoolExecutor可以解决此问题,例子如下: public class Shedule { private static long start; private static ScheduledExecutorService executorService = Executors.newScheduledThreadPool(2); public static void main(String[] args) { TimerTask task = new TimerTask() { public void run() {throw new RuntimeException(); } }; TimerTask task1 = new TimerTask() { @Override public void run() { System.out.println(System.currentTimeMillis()-start); } }; Timer timer = new Timer(); start = System.currentTimeMillis(); //TimeUnit.MILLISECONDS指定毫秒为单位 executorService.schedule(task,1000, TimeUnit.MILLISECONDS); executorService.schedule(task1,3000, TimeUnit.MILLISECONDS); } } 运行结果如下: 可以看到第一个线程挂了,第二个线程并没有受到影响。这就说明了ScheduledThreadPoolExecutor可以解决了 如果TimerTask抛出未检查的异常会终止timer线程。这种情况下,Timer也不会重新回复线程的执行了;它错误的认为整个Timer都被取消了。此时 已经被安排但尚未执行的TimerTask永远不会再执行了,新的任务也不能被调度了的问题 还要注意一点,Timer是和系统时间挂钩的,如果当前服务器的时间一改,Timer就不那么靠谱了。 还要注意的是ThreadPoolExecutor。 源码如下图: 可以看到new一个FixedThreadPool/newSingleThreadExecutor/newCachedThreadPool/newScheduledThreadPool实际上返回的都是是new ThreadPoolExecutor()。 我们再看一下ThreadPoolExecutor源码如下: 可以看到ThreadPoolExecutor配置的非常灵活,如果我们用普通的一个FixedThreadPool/newSingleThreadExecutor/newCachedThreadPool/newScheduledThreadPool没办法满足你的需求了,你可以用 ThreadPoolExecutor灵活的指定参数来完成你的需求。这适合精确的任务执行。还不如说我们的任务被拒绝(RejecedExecutionHandler)后,我们可以用ThreadPoolExecutor灵活处理

优秀的个人博客,低调大师

python函数式编程之装饰器(二)

以前用装饰器,都是定义好了装饰器后,使用@装饰器名的方法写入被装饰函数的正上方 在这里,定义的装饰器都是没有参数的 在定义装饰器的函数的时候,没有在括号里定义参数,这就叫做无参装饰器 既然有无参装饰器,那么当然也就会有有参装饰器 有参装饰器的定义和使用 定义一个普通的装饰器 db_path = "db.txt" login_dic = { "user": None, "status": None, } def auth(func): def wrapper(*args, **kwargs): if login_dic['user'] and login_dic['status']: res = func(*args, **kwargs) return res name = input("your name:").strip() password = input("your password:").strip() with open(db_path, "r", encoding="utf-8") as f: user_dic = eval(f.read()) if name in user_dic and password == user_dic[name]: print("login ok") login_dic['user'] = name login_dic['status'] = True res = func(*args, **kwargs) return res else: print("login error") return wrapper @auth def index(): print("welcome to index page") @auth def home(name): print("welcome to %s home page" % name) index() home() 上面的例子是一个典型的基于文件的认证方式的装饰器 在生产环境中,用户的认证方式可能有很多种,比如还有LDAP和数据库的认证方式 如果想把上面的代码修改,添加基于不同认证方式的用户认证 db_path = "db.txt" login_dic = { "user": None, "status": None, } def deco(auth_type): def auth(func): def wrapper(*args, **kwargs): if auth_type == "file": if login_dic['user'] and login_dic['status']: res = func(*args, **kwargs) return res name = input("your name:").strip() password = input("your password:").strip() with open(db_path, "r", encoding="utf-8") as f: user_dic = eval(f.read()) if name in user_dic and password == user_dic[name]: print("login ok") login_dic['user'] = name login_dic['status'] = True res = func(*args, **kwargs) return res else: print("login error") elif auth_type == 'ldap': print("ldap认证方式") elif auth_type == "sql": print("数据库的认证方式") else: print("不知道的认证方式") return wrapper return auth 有参装饰器的调用 @deco(auth_type="file") def index(): print("welcome to index page") @deco(auth_type="abc") def home(name): print("welcome to %s home page" % name) index() home() 在上面的例子里,deco(auth_type="file")这个函数的执行以后就得到了auth函数,但是现在得到的auth函数跟以前的auth函数是不一样的,现在的auth函数内部添加了认证方式这样一个参数, 这样添加auth_type参数后的结果就相当于加在index函数和home函数正上方的是auth函数,这样就为最开始时的auth函数添加了一个参数 函数中的路由功能 先定义3个函数,现在想做的是只需要用户输入字符串,就执行对应的函数 可以通过为每个函数添加装饰器的功能,把普通函数添加到函数字典中,然后到函数字典中找到输入字符串对应的函数地址,加括号就可以运行了 类似于 func_dic = {"f1": f1, "f2": f2, "f3": f3} def f1(): print("f1 func") def f2(): print("f2 func") def f3(): print("f3 func") 这里就要使用到有参装饰器 定义有参装饰器 def make_func_dic(key): def deco(func): func_dic[key] = func return deco 用装饰器make_func_dic装饰函数 func_dic = {} def make_func_dic(key): def deco(func): func_dic[key] = func return deco @make_func_dic("f1") # 等同于deco(f1) def f1(): print("f1 func") @make_func_dic("f2") # 等同于deco(f2) def f2(): print("f2 func") @make_func_dic("f3") # 等同于deco(f3) def f3(): print("f3 func") 打印func_dic,得到结果 {'f1': <function f1 at 0x0000000002D2A510>, 'f2': <function f2 at 0x0000000002D2A598>, 'f3': <function f3 at 0x0000000002D2A620>} 可以看到func_dic字典中,每个字符串对应的是相应字符串的函数的内存地址 这样想运行f1函数,只需要把func_dic中的"f1"的值加括号运行就可以了 然后使用户输入字符串,运行字符串对应的函数 while True: cmd=input(">>: ").strip() if cmd in func_dic: func_dic[cmd]() 这样就可以得到想要的结果了 这样做的好处:只需要输入对应的字符串,就可以执行对应的函数,不需要使用if和elif对输入的字符串进行一条一条的判断了 这就是使用装饰器在代码级别达到函数的路由功能

优秀的个人博客,低调大师

java并发编程笔记--Executor相关API整理

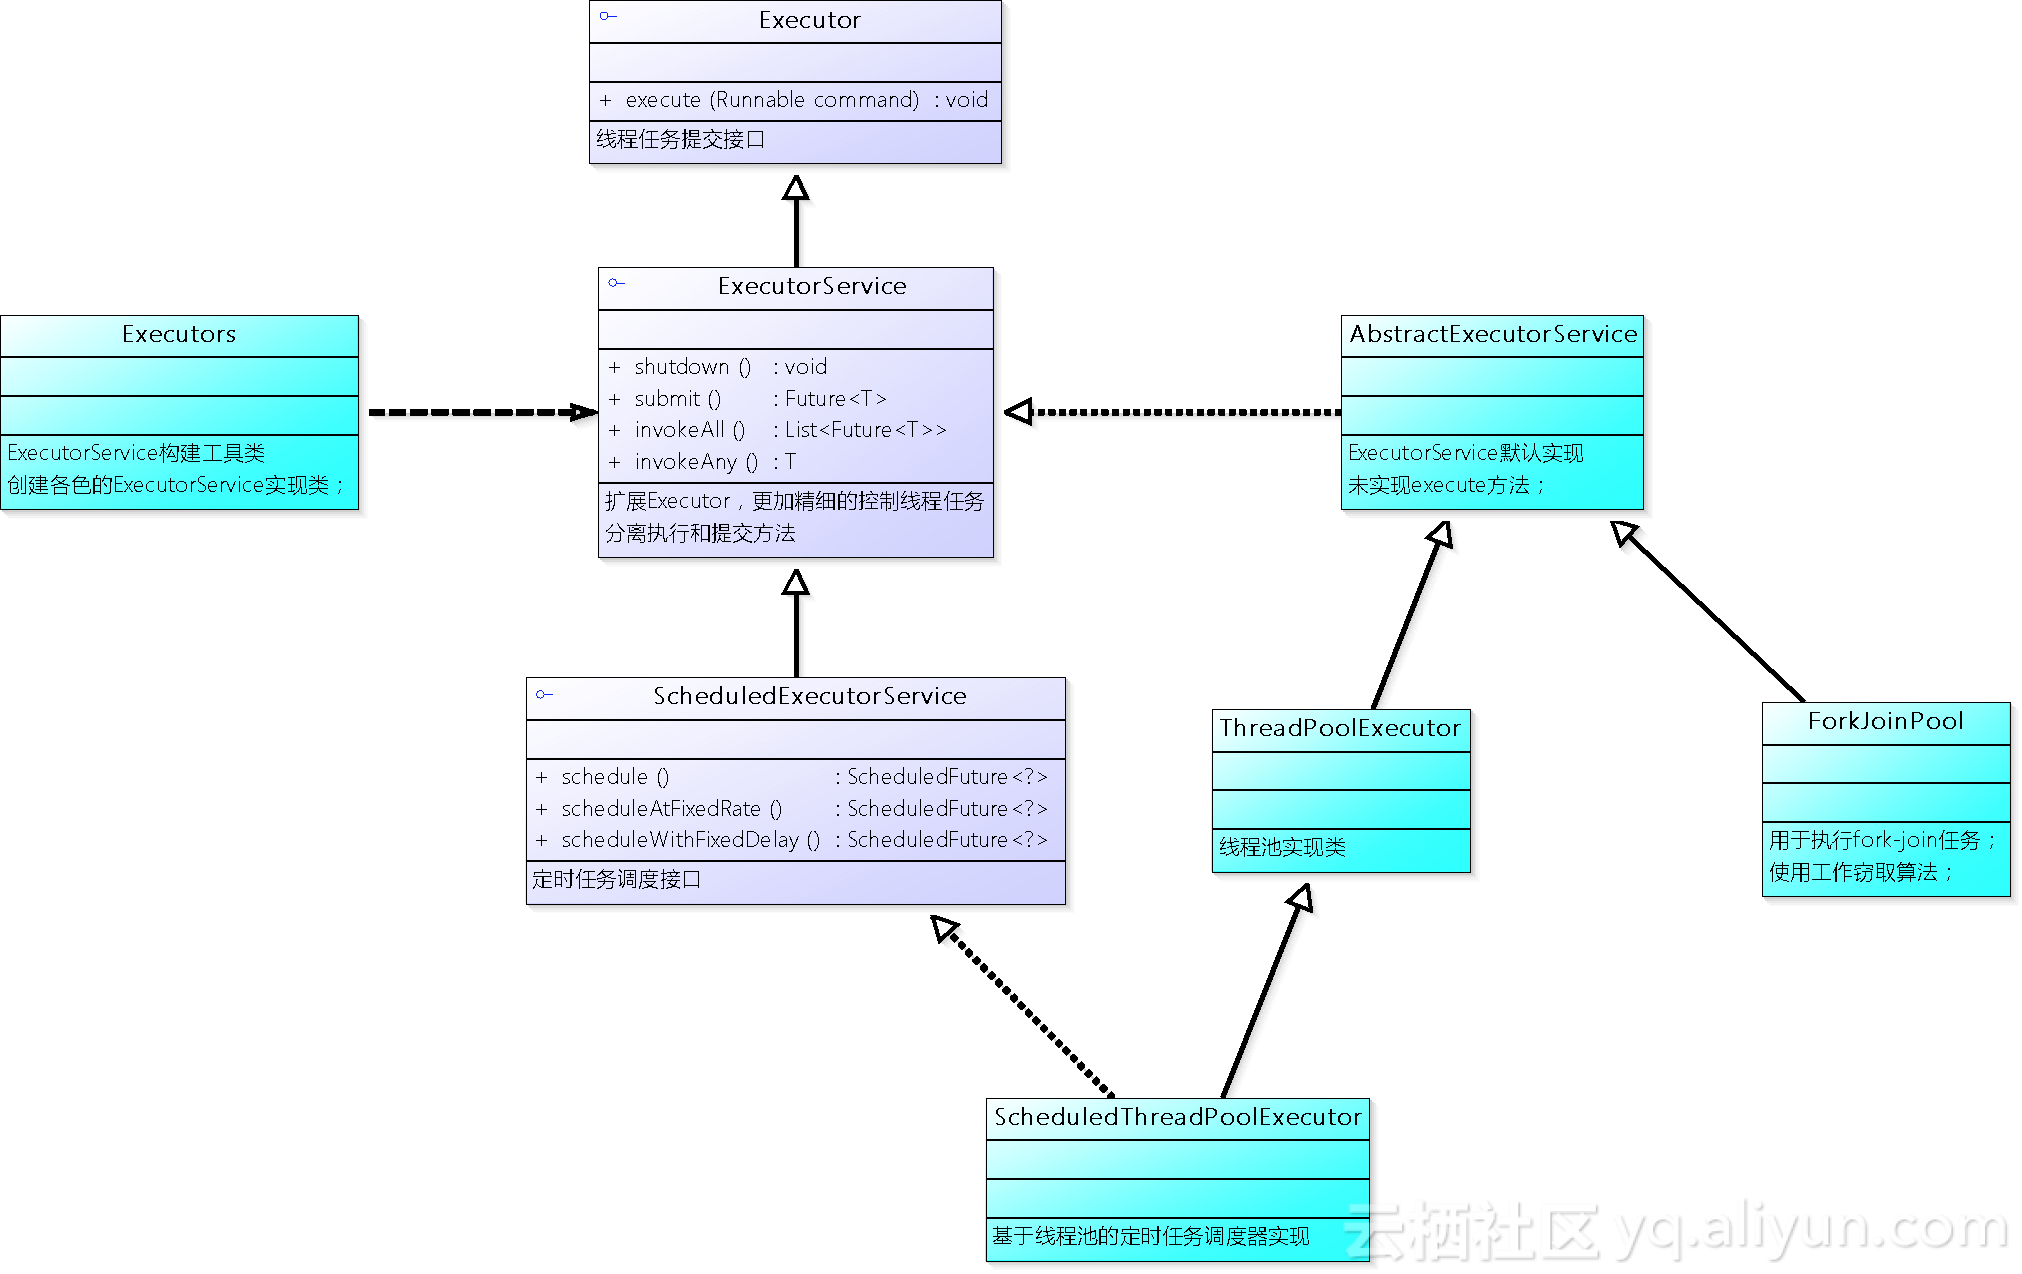
Executor框架是concurrent包提供的用于执行线程任务的框架,它基于生产者-消费者模式实现,将提交任务的线程和执行任务的线程解耦。提交任务的线程视作生产者,执行任务的线程视作消费者。任务的执行策略可以通过定制不同的消费者实现,比如:任务可以同步执行,也可以异步执行;任务可以按照编排优先级,高优先级的任务可以优先执行;任务可以延迟执行或者按周期执行...这些实现对于生产者而言透明,生产者无需关注消费者的具体实现,仅需要按照业务需求提交任务即可。 类图 Executor接口定义了concurrent包线程任务执行的入口,其扩展接口和实现类形成了一套满足线程任务执行的通用框架。 Executor接口 一个线程任务的执行入口,包含一个execute方法,接收Runnable参数,用于解耦线程任务的提交和执行。execute方法依赖于具体的实现,即可以在提交任务的线程中执行线程任务,也可以启动新的线程异步执行,或者将提交的任务进行编排按照一定规则执行。 ExecutorService接口 作为Executor的扩展,分离了任务的执行(execute)和提交方法(submit/invoke*)。包含3种状态: 运行(running):ExecutorService创建后的状态,表示执行器处于正常状态,可以接受任务; 关闭(shutdown):执行shutdown/shutdownNow后的状态,此时不再接受新任务,且等待ExecutorService中的工作线程终止; 终止(terminated):ExecutorService中的所有工作线程终止运行,可通过isTerminated判断是否终止;通过awaitTermination同步等待终止; ExecutorService定义了多个方法实现对线程任务状态更加精细的控制,扩展方法包括: void shutdown():触发Executor关闭操作,Executor在关闭前会等待已经提交的任务执行完成后才关闭。shutdown方法触发关闭操作后即刻返回,并不会等待任务执行完成才返回; List shutdownNow():触发Executor关闭操作,停止所有正在执行的任务,并返回所有等待执行的任务列表; boolean isShutdown():是否已经触发Executor的关闭操作,当执行shutdown/shutdownNow方法后,该方法返回true; boolean isTerminated():是否已经结束关闭操作;当关闭操作触发时,Executor并不一定立即关闭,可能需要等待已经提交任务执行完成后才关闭,因此只有当Executor真正执行完关闭操作后,该方法返回true; boolean awaitTermination(long timeout, TimeUnit unit):调用该方法的线程会阻塞等待,直到Executor执行完关闭操作;阻塞期间可能因超时(返回false)或者被中断(抛出InterruptedException异常)返回; Future submit(Callable task):提交一个线程任务,返回一个Futrue对象,以便接收和处理线程执行结果; Future submit(Runnable task, T result):同上,因为Runnable的run方法没有返回值,故单独用一个参数存放执行结果; Future<?> submit(Runnable task):同上; List> invokeAll(Collection<? extends Callable> tasks):批量提交任务,同步等待全部任务执行完并返回Future对象集合存放每个任务的执行结果; List> invokeAll(Collection<? extends Callable> tasks, long timeout, TimeUnit unit):同上,允许设置超时时间; T invokeAny(Collection<? extends Callable> tasks):执行所提交的任务,同步等待第一个已经执行完成的任务并返回结果,其余未完成任务将被取消执行; T invokeAny(Collection<? extends Callable> tasks, long timeout, TimeUnit unit):同上,允许设置超时时间; 面试问题:Runnable接口和Callable接口有何异同?相同点:均被设计用来抽象线程任务的执行,将任务的提交和任务的执行解耦,使得任务的提交和执行可以放在不同的线程中执行;不同点:Callable接口允许返回计算结果,也可以抛出异常,在任务执行过程中可以异步的捕获异常,也可以获取线程执行结果;而Runnable接口不允许这样做,通常异常处理需要放在接口内实现,计算结果也无法直接返回,需要借助消息队列等其它数据结构和组件实现; 注意:是用execute方法和submit方法提交任务在异常处理上存在区别:execute提交的任务在执行时如果抛出未捕获异常,则可以由java.lang.Thread.UncaughtExceptionHandler捕获处理。而submit提交的任务执行过程中如果抛出未捕获异常,将被视为任务执行结果的一部分,异常通过返回Future.get封装在ExecutionException中抛出。 ScheduledExecutorService接口 定时任务执行入口,允许延迟或者周期性调度线程任务,类似java.util.Timer的调度功能。 面试问题:java.util.Timer和ScheduledExecutorService接口的实现有何异同? 提交任务参数不同:Timer的任务参数必须是TimerTask类型;而ScheduledExecutorService参数相对灵活,可以是Runnable也可以是Callable类型; 调度线程不同:一个Timer对象包含一个TimerThread和一个TaskQueue对象,TimerThread线程用于调度所有的TimerTask任务,TaskQueue负责存放当前Timer对象等待调度的所有任务。TaskQueue是一个优先队列,基于堆实现,调度效率为log(n),任务通过下一次执行时间进行排序,以便保证最近的任务最先被调度执行。在创建Timer之后,TimerThread即已创建并且调用start方法启动,Timer调度任务是逐个调度,如果队列中的任务执行时间过长,将会导致整个任务序列执行时间的延迟。ScheduledExecutorService的实现类对执行任务的线程控制更加灵活,如ScheduledThreadPoolExecutor使用线程池来调度任务,可以同时调度多个任务,减少了因为任务排队执行而造成的延迟;当ScheduledThreadPoolExecutor指定的线程池大小为1时,效果等同于使用Timer; 时间单位不同:ScheduledExecutorService使用TimeUnit指定时间,更加灵活; 调度时间基准不同:Timer基于绝对时间调度,因而对操作系统的时钟变化敏感,一旦操作系统调整时钟,可能导致任务执行时间变化;ScheduledThreadPoolExecutor基于相对时间调度,因而对于系统时钟变化不敏感,具有更好的兼容性; Timer存在线程泄漏问题:Timer对于执行任务抛出的异常不作捕获处理,一旦任务抛出异常,将导致整个Timer不可用,累及其它待执行任务;而ScheduledThreadPoolExecutor可以正确处理任务抛出的异常; ScheduledExecutorService接口方法包括: ScheduledFuture<?> schedule(Runnable command, long delay, TimeUnit unit):以给定延迟调度一个一次性的任务,当任务执行完成后,ScheduledFuture<?>的get方法返回null; ScheduledFuture schedule(Callable callable, long delay, TimeUnit unit):同上,在任务执行完后,返回Callable执行结果; ScheduledFuture<?> scheduleAtFixedRate(Runnable command, long initialDelay, long period, TimeUnit unit):周期性的执行给定任务。任务第一次执行时延迟initialDelay时长,然后按照( initialDelay + period*( n - 1 ) ,n表示任务执行次数)固定周期执行;如果单次任务执行时间超过period,则下一次执行将会等待当次执行完成后立即执行,而不会并行执行; ScheduledFuture<?> scheduleWithFixedDelay(Runnable command, long initialDelay, long delay, TimeUnit unit):周期性的执行给定任务。任务第一次执行时延迟initialDelay时长,然后按照( 上一次结束时间 + period )周期性执行,因而该方法执行任务的周期并不固定,会根据任务执行时间的长短变化;上一次任务结束到下一次任务执行开始,总是相隔period时长; 面试问题:ScheduledExecutorService接口的scheduleAtFixedRate与scheduleWithFixedDelay区别? 解释如上 AbstractExecutorService抽象类 作为ScheduledExecutorService的默认实现,实现了提交任务submit/invoke*方法,使用RunnableFuture作为返回结果(FutureTask作为默认实现类);未实现execute方法,等待子类实现; ThreadPoolExecutor类 基于线程池的ExecutorService的实现,底层通过线程池并发执行任务,从而提高执行效率,ThreadPoolExecutor本身即为一个线程池的实现,线程池中用于执行任务的线程称为工作线程。根据不同的场景,线程池的执行策略可能不同,需要通过一些列参数进行控制,包括:corePoolSize(核心工作线程数),maximumPoolSize(最大工作线程数),keepAliveTime,workQueue(任务队列),threadFactory(线程创建类),handler(提交任务被拒绝后的处理策略)。为了简化操作,concurrent包的Executors类提供了几种常用线程池的创建方法,用来简化操作。 corePoolSize与maximumPoolSize参数 1)当poolSize < corePoolSize(poolSize为线程池当前的大小,通过getPoolSize方法获取),线程池会新建一个core线程用来执行新来的任务,即便此时线程池中有空闲的线程;2)当corePoolSize <= poolSize <= maximumPoolSize,且任务队列未满,线程池将会优先将新来的任务放入workQueue中等待core线程执行;3)当corePoolSize <= poolSize < maximumPoolSize,且任务队列已满,线程池新建一个线程执行新到任务;4)当corePoolSize和maximumPoolSize设置相同时,则线程池大小固定;5)corePoolSize和maximumPoolSize可以被设置为整型的上限Integer.MAX_VALUE,然而线程池大小的设置依赖于业务需要,同时也受限于所在物理设备的资源(CPU个数、内存大小、文件句柄数等),因此一般情况下,线程池大小不应该设置过大。如果需要处理海量的并发任务,则考虑使用分布式方法来处理;6)corePoolSize和maximumPoolSize可以通过构造函数设置,也可以通过setter方法设置; prestartCoreThread / prestartAllCoreThreads方法 当线程池大小poolSize threadFactory参数 创建线程时可以指定线程名称,所属的ThreadGroup,线程的优先级,是否是守护线程等。有时创建线程时,我们希望这些参数都能够遵守一定规则,比如:创建的线程都归属于同一个ThreadGroup、线程名称以相同的前缀开始...ThreadFactory接口的定义就是为了创建某一类线程,通过不同的实现类实现对不同类型线程测创建。ThreadPoolExecutor默认使用DefaultThreadFactory作为线程创建的工厂类,该类创建的线程都归属于同一个ThreadGroup,线程名以统一的前缀开始,优先级都是Thread.NORM_PRIORITY,非守护线程。可以在构造函数中通过threadFactory参数进行定制。 注意:当ThreadFactory创建线程返回null时,ThreadPoolExecutor将继续运行,但是可能无法正常执行任务。 keepAliveTime参数 如果线程池的poolSize>corePoolSize,并且有空闲的非core线程,则当非core线程空闲时间达到keepAliveTime时,将会被回收,以便减少资源消耗。该参数可以通过构造函数指定,也可以通过setter方法动态指定。当设置为Long.MAX_VALUE时,表示线程永久保留。当keepAliveTime不为0,且同时设置allowCoreThreadTimeOut为true时,将会对core线程也执行相同的回收策略。 注:allowCoreThreadTimeOut设置为true还有一项额外的作用,即可以确保当ThreadPoolExecutor需要被terminate时,所有的工作线程均被shutdown。 workQueue参数 ThreadPoolExecutor中的workQueue用于暂存等待执行的任务。workQueue可以是任意BlockingQueue类型。workQueue的使用同poolSize相关。1)当poolSize < corePoolSize时,线程池将会通过新增core线程的方式处理新来的任务,而不会放入workQueue中;2)当corePoolSize <= poolSize <= maximumPoolSize时,且workQueue未满时,线程池将会优先将新来的任务放入workQueue中等待core线程执行;3)当corePoolSize <= poolSize < maximumPoolSize,且workQueue已满,线程池会新建非core线程处理新来的任务; workQueue常用的3种策略: 直接传递任务:使用SynchronousQueue,SynchronousQueue可以理解为一个size为0的阻塞队列,每一个任务提交都必须等待有对应的任务获取操作,省去了中间的存储和查找操作。如果当前池中没有线程接收正在提交的任务,则会新建一个线程,直到工作线程数达到maximumPoolSizes后开始驳回任务。为了避免任务驳回,通常需要设置maximumPoolSizes为不限制。当提交任务的速率大于处理任务的速率时,将会导致线程数的无限制增加。 无界队列:使用LinkedBlockingQueue等无界队列,当poolSize达到corePoolSize,并且没有core线程空闲时,新任务将会进入队列等待,由于队列长度没有限制,因而线程池中最多只会有corePoolSize个线程,此时maximumPoolSizes参数无效。该策略适合于任务之前没有依赖的情况,以确保任务执行不会相互影响,比如处理http请求时,即可使用该策略。当提交任务的速率大于处理任务的速率时,将会导致任务队列中任务的积压。 有界队列:使用ArrayBlockingQueue等有界队列,可以避免大量创建线程或者任务积压造成资源耗尽。但是,需要权衡queueSize和maximumPoolSizes设置。比如:I/O密集型任务可以设置较小的queueSize和较大的maximumPoolSizes,以便CPU资源被充分利用,避免因为等待I/O操作造成CPU资源不能够被充分利用。 注:只要是BlockingQueue的实现类可以被ThreadPoolExecutor使用,因而可以根据各种BlockingQueue的子类特性影响任务执行的顺序,比如:使用PriorityBlockingQueue能够将任务按照优先级排序,使得高优先级的任务能够被优先执行。使用DelayQueue则适合于执行延迟任务,队列中的任务会按照延迟时间排序,仅当任务超过延迟时间后,才可以执行take操作; ThreadPoolExecutor提供了对workQueue元素操作的外部方法,如getQueue()允许直接获取workQueue的引用,方便监控和调试;remove和purge方法允许删除workQueue中的元素。 RejectedExecutionHandler参数 RejectedExecutionHandler接口定义了当任务被线程池驳回时,需要执行的处理策略。任务驳回包括2种情况: 线程池已经shutdown; 线程池能够处理的任务已经达到饱和,如:poolSize达到maximumPoolSizes,且workQueue已满,此时新来的任务将会被驳回; concurrent包提供4种处理策略,用户也可以通过实现RejectedExecutionHandler接口自定义处理策略: AbortPolicy:中止策略,直接抛出RejectedExecutionException异常; CallerRunsPolicy:直接在调用execute方法的线程中执行被驳回的任务;该策略由于占用了任务提交线程,因而会降低任务提交的速率。等同于任务提交线程直接执行任务; DiscardPolicy:丢弃策略,将会丢弃被驳回的任务; DiscardOldestPolicy:丢弃最老任务策略,将会删除workQueue头部的任务,然后重新提交被驳回任务;如果任务一直被驳回,该策略将会一直重复执行; 注意:使用CallerRunsPolicy策略可能引起线程安全问题场景:假设任务访问了某种非线程安全的资源,为了保证线程安全,使用poolSize为1的线程池串行处理任务,如果任务被驳回,触发驳回策略使用外部线程重新执行,则可能和工作线程同时访问非线程安全的资源,引发线程安全问题。 回调方法 ThreadPoolExecutor提供了beforeExecute,afterExecute,terminated等回调用法,用于根据线程池的反馈执行相关操作。这些方法可以通过子类重写。 beforeExecute/afterExecute方法,会在每个任务执行前/后被调用,可以用作重置执行参数、打印日志、统计执行数据等; terminated方法,在ThreadPoolExecutor被termniate之后调用,可用于执行资源清理等操作; 线程池大小&工作队列大小设置的考量 很难精确的给出线程池应该设置的大小,需要根据业务运行的情况不断调整。但是我们也可以根据一些经验给出大概的大小。 CPU密集型:较小的poolSize和较大的workQueue;因为CPU密集型任务,资源的瓶颈主要在CPU,较小的poolSize可以保障cpu资源充分被用于任务执行,而非进行上下文切换;设置较大的workQueue可以确保充分接收更多的任务,提高吞吐。poolSize通常设置Ncpu+1个线程比较合适; I/O密集型:设置较大的poolSize和较小的workQueue;I/O密集型任务的瓶颈主要在I/O的等待,任务的I/O等待降低了工作线程处理速率,可能会导致后续任务的延迟,因此提高任务处理的并发度,能够有效减少I/O等待,故设置一个较大的poolSize。同时,为了保障任务不因为I/O等待而过多积压,造成时延增加,故设置一个较小的workQueue。 经验公式:Nthread = Ncpu Ucpu ( 1 + W/C )Nthread,计算得出的poolSize大小;Ncpu,可使用的cpu个数/核数;Ucpu,期望最高的cpu使用率,考虑需要限制CPU使用率的场景,不能够总是将CPU使用率估计为100%,因而使用此参数;W,线程的等待时间,需要自己统计求平均值;C,线程的运行时间,需要自己统计求平均值; 注:决定线程池数量上限的因素还包括一些内存、文件句柄、socket句柄、数据库连接等资源的限制,在设置时也应该考虑; ForkJoinPool类 主要用于执行ForkJoinTask任务,同时支持非ForkJoinTask类型的任务。ForkJoinPool的优点在于实现了『工作窃取算法』:池中的工作线程不仅可以执行外部的线程任务,同时也可以执行其它运行中的任务所产生的子任务。这种策略适合于处理任务产生大量子任务的场景,也适合于处理由外部提交的大量细小的任务; 静态方法commonPool返回一个通用的ForkJoinPool,可用来执行那些没有明确指定线程池的任务; 线程池支持的最大线程数为32767; ScheduledThreadPoolExecutor类 基于线程池的ScheduledExecutorService的实现,底层通过线程池并发调度任务,该类继承ThreadPoolExecutor,使用无界队列策略,即使用corePoolSize个线程和无界的workQueue; 不推荐将corePoolSize设置为0,或者allowCoreThreadTimeOut设置为true,因为当任务执行周期较长超过keepAliveTime时,可能导致任务执行时,池中的线程都被回收的情况; 当任务在执行前被cancel后,将不会被执行,任务不会从队列中立即删除,而是等到超过delay时间后,才会从队列中删除。通过setRemoveOnCancelPolicy(true)可以设置cancel后立即删除任务; 当一个任务同时被scheduleAtFixedRate和scheduleAtFixedRate调度,可能会在不同的线程中执行,但不会产生重叠执行的情况,因为前一次执行happens-before后一次执行; Executors类 Executors类的主要功能包括如下: 提供ExecutorService的创建方法,并使用DelegatedExecutorService包装,仅暴露接口方法,防止外部修改操作; 提供ScheduledExecutorService的创建方法,并使用DelegatedScheduledExecutorService包装,仅暴露接口方法,防止外部修改操作; 提供ThreadFactory的创建方法; 提供Callable类型转换方法; ExecutorService线程池相关工具方法 ExecutorService newSingleThreadExecutor() 无界队列策略,创建只有一个线程的线程池,因为使用了包装器,可以防止外部修改; ExecutorService newFixedThreadPool(int nThreads) 无界队列策略,创建固定大小的线程池,使用无界队列;keepAliveTime为0; ExecutorService newCachedThreadPool() 直接传递任务策略,使用SynchronousQueue作为workQueue; ExecutorService newCachedThreadPool(ThreadFactory threadFactory) ScheduledExecutorService newSingleThreadScheduledExecutor() 创建单线程的任务调度; ScheduledExecutorService newScheduledThreadPool(int corePoolSize) 创建指定线程池大小的任务调度; ExecutorService newWorkStealingPool(int parallelism) 创建一个ForkJoinPool,使用parallelism指定并发度; ExecutorService newWorkStealingPool() 创建ForkJoinPool,使用处理器个数作为并发度;

优秀的个人博客,低调大师

面向对象高级编程:使用枚举类

当我们需要定义常量时,一个办法是用大写变量通过整数来定义,例如月份: JAN = 1 FEB = 2 MAR = 3 ... NOV = 11 DEC = 12 好处是简单,缺点是类型是int,并且仍然是变量。 更好的方法是为这样的枚举类型定义一个class类型,然后,每个常量都是class的一个唯一实例。Python提供了Enum类来实现这个功能: from enum import Enum Month = Enum('Month', ('Jan', 'Feb', 'Mar', 'Apr', 'May', 'Jun', 'Jul', 'Aug', 'Sep', 'Oct', 'Nov', 'Dec')) 这样我们就获得了Month类型的枚举类,可以直接使用Month.Jan来引用一个常量,或者枚举它的所有成员: for name, member in Month.__members__.items(): print(name, '=>', member, ',', member.value) value属性则是自动赋给成员的int常量,默认从1开始计数。 如果需要更精确地控制枚举类型,可以从Enum派生出自定义类: from enum import Enum, unique @unique class Weekday(Enum): Sun = 0 # Sun的value被设定为0 Mon = 1 Tue = 2 Wed = 3 Thu = 4 Fri = 5 Sat = 6 @unique装饰器可以帮助我们检查保证没有重复值。 访问这些枚举类型可以有若干种方法: >>> day1 = Weekday.Mon >>> print(day1) Weekday.Mon >>> print(Weekday.Tue) Weekday.Tue >>> print(Weekday['Tue']) Weekday.Tue >>> print(Weekday.Tue.value) 2 >>> print(day1 == Weekday.Mon) True >>> print(day1 == Weekday.Tue) False >>> print(Weekday(1)) Weekday.Mon >>> print(day1 == Weekday(1)) True >>> Weekday(7) Traceback (most recent call last): ... ValueError: 7 is not a valid Weekday >>> for name, member in Weekday.__members__.items(): ... print(name, '=>', member) ... Sun => Weekday.Sun Mon => Weekday.Mon Tue => Weekday.Tue Wed => Weekday.Wed Thu => Weekday.Thu Fri => Weekday.Fri Sat => Weekday.Sat 可见,既可以用成员名称引用枚举常量,又可以直接根据value的值获得枚举常量。 练习 把Student的gender属性改造为枚举类型,可以避免使用字符串: # -*- coding: utf-8 -*- from enum import Enum, unique # 测试: bart = Student('Bart', Gender.Male) if bart.gender == Gender.Male: print('测试通过!') else: print('测试失败!') Run 小结 Enum可以把一组相关常量定义在一个class中,且class不可变,而且成员可以直接比较。 转载。原文:https://www.liaoxuefeng.com/wiki/0014316089557264a6b348958f449949df42a6d3a2e542c000/00143191235886950998592cd3e426e91687cdae696e64b000

优秀的个人博客,低调大师

面向对象高级编程:使用元类

type() 动态语言和静态语言最大的不同,就是函数和类的定义,不是编译时定义的,而是运行时动态创建的。 比方说我们要定义一个Hello的class,就写一个hello.py模块: class Hello(object): def hello(self, name='world'): print('Hello, %s.' % name) 当Python解释器载入hello模块时,就会依次执行该模块的所有语句,执行结果就是动态创建出一个Hello的class对象,测试如下: >>> from hello import Hello >>> h = Hello() >>> h.hello() Hello, world. >>> print(type(Hello)) <class 'type'> >>> print(type(h)) <class 'hello.Hello'> type()函数可以查看一个类型或变量的类型,Hello是一个class,它的类型就是type,而h是一个实例,它的类型就是class Hello。 我们说class的定义是运行时动态创建的,而创建class的方法就是使用type()函数。 type()函数既可以返回一个对象的类型,又可以创建出新的类型,比如,我们可以通过type()函数创建出Hello类,而无需通过class Hello(object)...的定义: >>> def fn(self, name='world'): # 先定义函数 ... print('Hello, %s.' % name) ... >>> Hello = type('Hello', (object,), dict(hello=fn)) # 创建Hello class >>> h = Hello() >>> h.hello() Hello, world. >>> print(type(Hello)) <class 'type'> >>> print(type(h)) <class '__main__.Hello'> 要创建一个class对象,type()函数依次传入3个参数: class的名称; 继承的父类集合,注意Python支持多重继承,如果只有一个父类,别忘了tuple的单元素写法; class的方法名称与函数绑定,这里我们把函数fn绑定到方法名hello上。 通过type()函数创建的类和直接写class是完全一样的,因为Python解释器遇到class定义时,仅仅是扫描一下class定义的语法,然后调用type()函数创建出class。 正常情况下,我们都用class Xxx...来定义类,但是,type()函数也允许我们动态创建出类来,也就是说,动态语言本身支持运行期动态创建类,这和静态语言有非常大的不同,要在静态语言运行期创建类,必须构造源代码字符串再调用编译器,或者借助一些工具生成字节码实现,本质上都是动态编译,会非常复杂。 metaclass 除了使用type()动态创建类以外,要控制类的创建行为,还可以使用metaclass。 metaclass,直译为元类,简单的解释就是: 当我们定义了类以后,就可以根据这个类创建出实例,所以:先定义类,然后创建实例。 但是如果我们想创建出类呢?那就必须根据metaclass创建出类,所以:先定义metaclass,然后创建类。 连接起来就是:先定义metaclass,就可以创建类,最后创建实例。 所以,metaclass允许你创建类或者修改类。换句话说,你可以把类看成是metaclass创建出来的“实例”。 metaclass是Python面向对象里最难理解,也是最难使用的魔术代码。正常情况下,你不会碰到需要使用metaclass的情况,所以,以下内容看不懂也没关系,因为基本上你不会用到。 我们先看一个简单的例子,这个metaclass可以给我们自定义的MyList增加一个add方法: 定义ListMetaclass,按照默认习惯,metaclass的类名总是以Metaclass结尾,以便清楚地表示这是一个metaclass: # metaclass是类的模板,所以必须从`type`类型派生: class ListMetaclass(type): def __new__(cls, name, bases, attrs): attrs['add'] = lambda self, value: self.append(value) return type.__new__(cls, name, bases, attrs) 有了ListMetaclass,我们在定义类的时候还要指示使用ListMetaclass来定制类,传入关键字参数metaclass: class MyList(list, metaclass=ListMetaclass): pass 当我们传入关键字参数metaclass时,魔术就生效了,它指示Python解释器在创建MyList时,要通过ListMetaclass.__new__()来创建,在此,我们可以修改类的定义,比如,加上新的方法,然后,返回修改后的定义。 __new__()方法接收到的参数依次是: 当前准备创建的类的对象; 类的名字; 类继承的父类集合; 类的方法集合。 测试一下MyList是否可以调用add()方法: >>> L = MyList() >>> L.add(1) >> L [1] 而普通的list没有add()方法: >>> L2 = list() >>> L2.add(1) Traceback (most recent call last): File "<stdin>", line 1, in <module> AttributeError: 'list' object has no attribute 'add' 动态修改有什么意义?直接在MyList定义中写上add()方法不是更简单吗?正常情况下,确实应该直接写,通过metaclass修改纯属变态。 但是,总会遇到需要通过metaclass修改类定义的。ORM就是一个典型的例子。 ORM全称“Object Relational Mapping”,即对象-关系映射,就是把关系数据库的一行映射为一个对象,也就是一个类对应一个表,这样,写代码更简单,不用直接操作SQL语句。 要编写一个ORM框架,所有的类都只能动态定义,因为只有使用者才能根据表的结构定义出对应的类来。 让我们来尝试编写一个ORM框架。 编写底层模块的第一步,就是先把调用接口写出来。比如,使用者如果使用这个ORM框架,想定义一个User类来操作对应的数据库表User,我们期待他写出这样的代码: class User(Model): # 定义类的属性到列的映射: id = IntegerField('id') name = StringField('username') email = StringField('email') password = StringField('password') # 创建一个实例: u = User(id=12345, name='Michael', email='test@orm.org', password='my-pwd') # 保存到数据库: u.save() 其中,父类Model和属性类型StringField、IntegerField是由ORM框架提供的,剩下的魔术方法比如save()全部由metaclass自动完成。虽然metaclass的编写会比较复杂,但ORM的使用者用起来却异常简单。 现在,我们就按上面的接口来实现该ORM。 首先来定义Field类,它负责保存数据库表的字段名和字段类型: class Field(object): def __init__(self, name, column_type): self.name = name self.column_type = column_type def __str__(self): return '<%s:%s>' % (self.__class__.__name__, self.name) 在Field的基础上,进一步定义各种类型的Field,比如StringField,IntegerField等等: class StringField(Field): def __init__(self, name): super(StringField, self).__init__(name, 'varchar(100)') class IntegerField(Field): def __init__(self, name): super(IntegerField, self).__init__(name, 'bigint') 下一步,就是编写最复杂的ModelMetaclass了: class ModelMetaclass(type): def __new__(cls, name, bases, attrs): if name=='Model': return type.__new__(cls, name, bases, attrs) print('Found model: %s' % name) mappings = dict() for k, v in attrs.items(): if isinstance(v, Field): print('Found mapping: %s ==> %s' % (k, v)) mappings[k] = v for k in mappings.keys(): attrs.pop(k) attrs['__mappings__'] = mappings # 保存属性和列的映射关系 attrs['__table__'] = name # 假设表名和类名一致 return type.__new__(cls, name, bases, attrs) 以及基类Model: class Model(dict, metaclass=ModelMetaclass): def __init__(self, **kw): super(Model, self).__init__(**kw) def __getattr__(self, key): try: return self[key] except KeyError: raise AttributeError(r"'Model' object has no attribute '%s'" % key) def __setattr__(self, key, value): self[key] = value def save(self): fields = [] params = [] args = [] for k, v in self.__mappings__.items(): fields.append(v.name) params.append('?') args.append(getattr(self, k, None)) sql = 'insert into %s (%s) values (%s)' % (self.__table__, ','.join(fields), ','.join(params)) print('SQL: %s' % sql) print('ARGS: %s' % str(args)) 当用户定义一个class User(Model)时,Python解释器首先在当前类User的定义中查找metaclass,如果没有找到,就继续在父类Model中查找metaclass,找到了,就使用Model中定义的metaclass的ModelMetaclass来创建User类,也就是说,metaclass可以隐式地继承到子类,但子类自己却感觉不到。 在ModelMetaclass中,一共做了几件事情: 排除掉对Model类的修改; 在当前类(比如User)中查找定义的类的所有属性,如果找到一个Field属性,就把它保存到一个__mappings__的dict中,同时从类属性中删除该Field属性,否则,容易造成运行时错误(实例的属性会遮盖类的同名属性); 把表名保存到__table__中,这里简化为表名默认为类名。 在Model类中,就可以定义各种操作数据库的方法,比如save(),delete(),find(),update等等。 我们实现了save()方法,把一个实例保存到数据库中。因为有表名,属性到字段的映射和属性值的集合,就可以构造出INSERT语句。 编写代码试试: u = User(id=12345, name='Michael', email='test@orm.org', password='my-pwd') u.save() 输出如下: Found model: User Found mapping: email ==> <StringField:email> Found mapping: password ==> <StringField:password> Found mapping: id ==> <IntegerField:uid> Found mapping: name ==> <StringField:username> SQL: insert into User (password,email,username,id) values (?,?,?,?) ARGS: ['my-pwd', 'test@orm.org', 'Michael', 12345] 可以看到,save()方法已经打印出了可执行的SQL语句,以及参数列表,只需要真正连接到数据库,执行该SQL语句,就可以完成真正的功能。 不到100行代码,我们就通过metaclass实现了一个精简的ORM框架,是不是非常简单? 小结 metaclass是Python中非常具有魔术性的对象,它可以改变类创建时的行为。这种强大的功能使用起来务必小心。 转载。原文:https://www.liaoxuefeng.com/wiki/0014316089557264a6b348958f449949df42a6d3a2e542c000/0014319106919344c4ef8b1e04c48778bb45796e0335839000

优秀的个人博客,低调大师

面向对象高级编程:使用__slots__

正常情况下,当我们定义了一个class,创建了一个class的实例后,我们可以给该实例绑定任何属性和方法,这就是动态语言的灵活性。先定义class: class Student(object): pass 然后,尝试给实例绑定一个属性: >>> s = Student() >>> s.name = 'Michael' # 动态给实例绑定一个属性 >>> print(s.name) Michael 还可以尝试给实例绑定一个方法: >>> def set_age(self, age): # 定义一个函数作为实例方法 ... self.age = age ... >>> from types import MethodType >>> s.set_age = MethodType(set_age, s) # 给实例绑定一个方法 >>> s.set_age(25) # 调用实例方法 >>> s.age # 测试结果 25 但是,给一个实例绑定的方法,对另一个实例是不起作用的: >>> s2 = Student() # 创建新的实例 >>> s2.set_age(25) # 尝试调用方法 Traceback (most recent call last): File "<stdin>", line 1, in <module> AttributeError: 'Student' object has no attribute 'set_age' 为了给所有实例都绑定方法,可以给class绑定方法: >>> def set_score(self, score): ... self.score = score ... >>> Student.set_score = set_score 给class绑定方法后,所有实例均可调用: >>> s.set_score(100) >>> s.score 100 >>> s2.set_score(99) >>> s2.score 99 通常情况下,上面的set_score方法可以直接定义在class中,但动态绑定允许我们在程序运行的过程中动态给class加上功能,这在静态语言中很难实现。 使用__slots__ 但是,如果我们想要限制实例的属性怎么办?比如,只允许对Student实例添加name和age属性。 为了达到限制的目的,Python允许在定义class的时候,定义一个特殊的__slots__变量,来限制该class实例能添加的属性: class Student(object): __slots__ = ('name', 'age') # 用tuple定义允许绑定的属性名称 然后,我们试试: >>> s = Student() # 创建新的实例 >>> s.name = 'Michael' # 绑定属性'name' >>> s.age = 25 # 绑定属性'age' >>> s.score = 99 # 绑定属性'score' Traceback (most recent call last): File "<stdin>", line 1, in <module> AttributeError: 'Student' object has no attribute 'score' 由于'score'没有被放到__slots__中,所以不能绑定score属性,试图绑定score将得到AttributeError的错误。 使用__slots__要注意,__slots__定义的属性仅对当前类实例起作用,对继承的子类是不起作用的: >>> class GraduateStudent(Student): ... pass ... >>> g = GraduateStudent() >>> g.score = 9999 除非在子类中也定义__slots__,这样,子类实例允许定义的属性就是自身的__slots__加上父类的__slots__。 转载。原文:https://www.liaoxuefeng.com/wiki/0014316089557264a6b348958f449949df42a6d3a2e542c000/00143186739713011a09b63dcbd42cc87f907a778b3ac73000

优秀的个人博客,低调大师

详解JAVA实现支付宝接口编程

//实现java支付宝很简单,只要从支付宝官方下载 http://help.alipay.com/support/index_sh.htm下载程序,配置一下参数就OK了; 1.先到http://help.alipay.com/support/index_sh.htm下接口程序,右下角有个“接口资料下载”点击下载进入下载页面http://club.alipay.com/read.php?tid=9976972选择你要下载支付宝的接口类型;我是选择“支付宝即时到账收款接口” 2.解压以后,可以看到很多种版本语言的支付宝例子,选择你要的语言类型;这里我是选择的是“alipaydirect\alipaydirect\支付宝即时到帐接口\java\create_direct_pay_by_user_jsp_utf8”是UTR-8的程序; 3.将项目导入到你的开发平台上,也就是myeclipse平台上,就可以看到项目的结构了。然后配置支付宝,作为测试的话这里只要修改一个文件就可以了,其他文件都不需要修改的,这个文件就是“AlipayConfig.java”里面的// ↓↓↓↓↓↓↓↓↓↓请在这里配置您的基本信息↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓ // 合作身份者ID,以2088开头由16位纯数字组成的字符串 public static String partner = ""; // 交易安全检验码,由数字和字母组成的32位字符串 public static String key = ""; // 签约支付宝账号或卖家收款支付宝帐户 public static String seller_email = ""; // 支付宝服务器通知的页面 要用 http://格式的完整路径,不允许加?id=123这类自定义参数 // 必须保证其地址能够在互联网中访问的到 public static String notify_url = "http://www.xxx.cn/create_direct_pay_by_user_jsp_utf8/notify_url.jsp"; // 当前页面跳转后的页面 要用 http://格式的完整路径,不允许加?id=123这类自定义参数 // 域名不能写成http://localhost/create_direct_pay_by_user_jsp_utf8/return_url.jsp ,否则会导致return_url执行无效 public static String return_url = "http://127.0.0.1:8080/create_direct_pay_by_user_jsp_utf8/return_url.jsp"; //↑↑↑↑↑↑↑↑↑↑请在这里配置您的基本信息↑↑↑↑↑↑↑↑↑↑↑↑↑↑↑ 4.然后开启服务器,运行index.jsp页面就可以看到效果了; 5.若需要了解具体得信息,在下载的文件里面有一个帮助文档PDF文件“支付宝即时到账接口集成教程.pdf”和“即时到账交易接口(create_direct_pay_by_user).pdf”; 在这个“alipaydirect\alipaydirect\支付宝即时到帐接口\java\create_direct_pay_by_user_jsp_utf8\”还有一个“readme.txt”帮助文件;仔细看一下帮助文档就可以明白的! 接下来用一点实例更加详细的解释一下: 1:拥有自己的支付宝企业账号。去产品商店选择适合自己的方案。并签约合同。 2:选择合适的商家收款产品并去签约。填写相应的信息 3:在商家服务会有PID和KEY是关键的东西。 4:选择自己签约的产品类型,下载对应的接口api与测试代码 即时到账收款 --alipaydirect 网银支付 --alipaydirect_bankpay_single 担保交易收款 --alipaytescow 双功能收款 --alipaydualfun 快捷支付(无线) --WS_SECURE_PAY_SDK 手机网站支付 --WS_WAP_PAYWAP 扫码即时到账 --alipaymobileqrcode 扫码担保交易--alipaymobileqrcode 批量付款到支付宝账户 --alipaytranspay 快捷登录 --alipayfastlogin 5:alipaydirect_bankpay_single 测试 在核心代码alipayconfig需要更改自己的partner和key 6:网银银行简码 网银银行简码 BOCB2C 中国银行 ICBCB2C 中国工商银行 ICBCBTB 中国工商银行(B2B) CMB 招商银行 CCB 中国建设银行 CCBBTB 中国建设银行(B2B) ABC 中国农业银行 ABCBTB 中国农业银行(B2B) SPDB 上海浦东发展银行 SPDBB2B 上海浦东发展银行(B2B) CIB 兴业银行 GDB 广东发展银行 SDB 深圳发展银行 CMBC 中国民生银行 COMM 交通银行 CITIC 中信银行 CEBBANK 光大银行 NBBANK 宁波银行 HZCBB2C 杭州银行 SHBANK 上海银行 SPABANK 平安银行 BJRCB 北京农村商业银行 fdb101 富滇银行 PSBC-DEBIT 中国邮政储蓄银行 BJBANK 北京银行 7:错误代码错误说明 误代码 说明 EXPARTNER_INFO_UNCORRECT 传入外部商户接口信息不正确 TRADE_BUYER_NOT_MATCH 买家账户与交易中不一致 TRADE_SELLER_NOT_MATCH 卖家账户与交易中不一致 TRADE_DATA_NOT_MATCH 请求数据与交易中不一致 SELLER_NOT_IN_SPECIFIED_SELLERS 卖家不在指定的商户限制卖家中 ILLEGAL_SIGN 签名验证出错 ILLEGAL_ARGUMENT 输入参数有错误 HASH_NO_PRIVILEGE 没有权限访问该服务 ILLEGAL_SERVICE service参数不正确 ILLEGAL_PARTNER 合作身份者ID不正确 HAS_NO_PUBLICKEY 没有上传公钥 USER_NOT_EXIST 会员不存在 OUT_TRADE_NO_EXIST 外部交易号已经存在 TRADE_NOT_EXIST 交易不存在 ILLEGAL_PAYMENT_TYPE 无效支付类型 BUYER_NOT_EXIST 买家不存在 SELLER_NOT_EXIST 卖家不存在 BUYER_SELLER_EQUAL 买家、卖家是同一帐户 ILLEGAL_SIGN_TYPE 签名类型不正确 COMMISION_ID_NOT_EXIST 佣金收取帐户不存在 COMMISION_SELLER_DUPLICATE 收取佣金帐户和卖家是同一帐户 出现的错误代码为ILLEGAL_PARTNER_EXTERFACE 1、没有签约这个接口的合同。 2、签约了相应的接口合同,但没有生效。 3、签约了相应的接口合同,但由于违规违法等原因被审核部门强制关闭。 8:页面需要修改的东西alipayapi.jsp 9:跳转页面第6步有截图。卖家账号收款的账号。不是付款的账号哦。 如果调试登录了收款的支付宝账号。会出错的哦。错误截图如下 错误代码:BUYER_SELLER_EQUAL 如果调试登录了收款的支付宝账号。而且页面填写的卖家账号非卖家账号(收款账号)会出现如下错误 错误代码:SELLER_NOT_IN_SPECIFIED_SELLERS 如果没有错误。则会直接跳转付款页面。输入买家账号即可。 10:成功付款的页面。付款页面需要输入购买用户的支付宝账号和支付密码 11:使用springMVC封装写符合自己网站需求的代码。以下代码仅参考 这个是ALIPAYAPI代码要获取数据的 [java] view plain copy <codeclass="hljsjavascript"style=""><spanclass="hljs-built_in"style="">Date</span>date=<spanclass="hljs-keyword"style="">new</span><spanclass="hljs-built_in"style="">Date</span>(); <spanclass="hljs-comment"style="">//支付类型必填不必修改</span> <spanclass="hljs-built_in"style="">String</span>payment_type=<spanclass="hljs-string"style="">"1"</span>; <spanclass="hljs-comment"style="">//服务器异步通知页面路径</span> <spanclass="hljs-comment"style="">//需http://格式的完整路径,不能加?id=123这类自定义参数</span> <spanclass="hljs-built_in"style="">String</span>notify_url=<spanclass="hljs-string"style="">"http://localhost:8080/alipay/async"</span>; <spanclass="hljs-comment"style="">//页面跳转同步通知页面路径</span> <spanclass="hljs-comment"style="">//需http://格式的完整路径,不能加?id=123这类自定义参数,不能写成http://localhost/</span> <spanclass="hljs-built_in"style="">String</span>return_url=<spanclass="hljs-string"style="">"http://192.168.0.222:8080/alipay/return_url"</span>; <spanclass="hljs-comment"style="">//订单名称</span> <spanclass="hljs-comment"style="">//必填</span> <spanclass="hljs-comment"style="">//Stringsubject=newString(request.getParameter("WIDsubject").getBytes("ISO-8859-1"),"UTF-8");</span> <spanclass="hljs-built_in"style="">String</span>subject=<spanclass="hljs-keyword"style="">new</span><spanclass="hljs-built_in"style="">String</span>(<spanclass="hljs-string"style="">"测试商品"</span>.getBytes(<spanclass="hljs-string"style="">"ISO-8859-1"</span>),<spanclass="hljs-string"style="">"UTF-8"</span>); <spanclass="hljs-comment"style="">//付款金额</span> <spanclass="hljs-comment"style="">//必填</span> <spanclass="hljs-comment"style="">//Stringtotal_fee=newString(request.getParameter("WIDtotal_fee").getBytes("ISO-8859-1"),"UTF-8");</span> <spanclass="hljs-built_in"style="">String</span>total_fee=<spanclass="hljs-string"style="">"0.01"</span>; <spanclass="hljs-built_in"style="">Map</span><<spanclass="hljs-built_in"style="">String</span>,<spanclass="hljs-built_in"style="">String</span>>sParaTemp=<spanclass="hljs-keyword"style="">new</span>HashMap<<spanclass="hljs-built_in"style="">String</span>,<spanclass="hljs-built_in"style="">String</span>>(); sParaTemp.put(<spanclass="hljs-string"style="">"service"</span>,<spanclass="hljs-string"style="">"create_direct_pay_by_user"</span>);<spanclass="hljs-comment"style="">//接口服务----即时到账</span> sParaTemp.put(<spanclass="hljs-string"style="">"partner"</span>,AlipayConfig.partner);<spanclass="hljs-comment"style="">//支付宝PID</span> sParaTemp.put(<spanclass="hljs-string"style="">"_input_charset"</span>,AlipayConfig.input_charset);<spanclass="hljs-comment"style="">//统一编码</span> sParaTemp.put(<spanclass="hljs-string"style="">"payment_type"</span>,payment_type);<spanclass="hljs-comment"style="">//支付类型</span> sParaTemp.put(<spanclass="hljs-string"style="">"notify_url"</span>,notify_url);<spanclass="hljs-comment"style="">//异步通知页面</span> sParaTemp.put(<spanclass="hljs-string"style="">"return_url"</span>,return_url);<spanclass="hljs-comment"style="">//页面跳转同步通知页面</span> sParaTemp.put(<spanclass="hljs-string"style="">"seller_email"</span>,Constants.SELLER_EMAIL);<spanclass="hljs-comment"style="">//卖家支付宝账号</span> sParaTemp.put(<spanclass="hljs-string"style="">"out_trade_no"</span>,date.getTime()+payment_type);<spanclass="hljs-comment"style="">//商品订单编号</span> sParaTemp.put(<spanclass="hljs-string"style="">"subject"</span>,subject);<spanclass="hljs-comment"style="">//商品名称</span> sParaTemp.put(<spanclass="hljs-string"style="">"total_fee"</span>,total_fee);<spanclass="hljs-comment"style="">//价格</span> <spanclass="hljs-comment"style="">//建立请求</span> <spanclass="hljs-built_in"style="">String</span>sHtmlText=AlipaySubmit.buildRequest(sParaTemp,<spanclass="hljs-string"style="">"get"</span>,<spanclass="hljs-string"style="">"立即付款"</span>); request.setAttribute(<spanclass="hljs-string"style="">"sHtmlText"</span>,sHtmlText); <spanclass="hljs-keyword"style="">return</span><spanclass="hljs-literal"style="">null</span>;</code> 付款是否成功的代码 [java] view plain copy <codeclass="hljsjavascript"style=""><spanclass="hljs-built_in"style="">Map</span><<spanclass="hljs-built_in"style="">String</span>,<spanclass="hljs-built_in"style="">String</span>>params=<spanclass="hljs-keyword"style="">new</span>HashMap<<spanclass="hljs-built_in"style="">String</span>,<spanclass="hljs-built_in"style="">String</span>>(); <spanclass="hljs-built_in"style="">Map</span>requestParams=request.getParameterMap(); <spanclass="hljs-keyword"style="">for</span>(Iteratoriter=requestParams.keySet().iterator();iter.hasNext();){ <spanclass="hljs-built_in"style="">String</span>name=(<spanclass="hljs-built_in"style="">String</span>)iter.next(); <spanclass="hljs-built_in"style="">String</span>[]values=(<spanclass="hljs-built_in"style="">String</span>[])requestParams.get(name); <spanclass="hljs-built_in"style="">String</span>valueStr=<spanclass="hljs-string"style="">""</span>; <spanclass="hljs-keyword"style="">for</span>(inti=<spanclass="hljs-number"style="">0</span>;i<values.length;i++){ valueStr=(i==values.length-<spanclass="hljs-number"style="">1</span>)?valueStr+values[i]:valueStr+values[i]+<spanclass="hljs-string"style="">","</span>; } params.put(name,valueStr); } <spanclass="hljs-built_in"style="">String</span>tradeNo=request.getParameter(<spanclass="hljs-string"style="">"out_trade_no"</span>); <spanclass="hljs-built_in"style="">String</span>tradeStatus=request.getParameter(<spanclass="hljs-string"style="">"trade_status"</span>); <spanclass="hljs-keyword"style="">if</span>(AlipayNotify.verify(params)){ <spanclass="hljs-keyword"style="">if</span>(tradeStatus.equals(<spanclass="hljs-string"style="">"TRADE_FINISHED"</span>)||tradeStatus.equals(<spanclass="hljs-string"style="">"TRADE_SUCCESS"</span>)){ System.out.println(<spanclass="hljs-string"style="">"ok!>>>>>>>>"</span>+tradeNo); } <spanclass="hljs-keyword"style="">return</span><spanclass="hljs-string"style="">"success"</span>; }<spanclass="hljs-keyword"style="">else</span>{ <spanclass="hljs-keyword"style="">return</span><spanclass="hljs-string"style="">"fail"</span>; } }</code> 12:使用springMVC封装写符合自己网站需求的代码。以下代码仅参考 全部都写在一个Controller里面 [java] view plain copy <codeclass="hljstypescript"style=""><spanclass="hljs-comment"style="">/** *支付宝Controller *@author宗潇帅 *@修改日期2014-9-25下午1:29:53 */</span> @Controller @RequestMapping(value=<spanclass="hljs-string"style="">"/aliapi"</span>) <spanclass="hljs-keyword"style="">public</span><spanclass="hljs-keyword"style="">class</span>AlipayApiController{ <spanclass="hljs-keyword"style="">private</span><spanclass="hljs-keyword"style="">static</span>Loglog=LogFactory.getLog(AlipayApiController.class); @RequestMapping(value=<spanclass="hljs-string"style="">"/index"</span>) <spanclass="hljs-keyword"style="">public</span><spanclass="hljs-built_in"style="">String</span>index(HttpServletRequestrequest, HttpServletResponseresponse){ <spanclass="hljs-keyword"style="">return</span><spanclass="hljs-string"style="">"web/pay/fund"</span>;<spanclass="hljs-comment"style="">//付款的页面。本页面是为了测试而使用的</span> } @RequestMapping(value=<spanclass="hljs-string"style="">"/deposit"</span>,method=RequestMethod.POST,produces=<spanclass="hljs-string"style="">"application/json"</span>) <spanclass="hljs-keyword"style="">public</span><spanclass="hljs-built_in"style="">String</span>deposit(HttpServletRequestrequest,HttpServletResponseresponse,Modelmodel)throwsException{ <spanclass="hljs-comment"style="">//PrintWriterout=response.getWriter();</span> <spanclass="hljs-built_in"style="">String</span>result=<spanclass="hljs-string"style="">""</span>; <spanclass="hljs-built_in"style="">Date</span>date=<spanclass="hljs-keyword"style="">new</span><spanclass="hljs-built_in"style="">Date</span>(); <spanclass="hljs-comment"style="">//支付类型</span> <spanclass="hljs-comment"style="">//必填,不能修改</span> <spanclass="hljs-built_in"style="">String</span>payment_type=<spanclass="hljs-string"style="">"1"</span>; <spanclass="hljs-comment"style="">//服务器异步通知页面路径</span> <spanclass="hljs-comment"style="">//需http://格式的完整路径,不能加?id=123这类自定义参数</span> <spanclass="hljs-built_in"style="">String</span>notify_url=<spanclass="hljs-string"style="">"http://192.168.0.222:8080/live/aliapi/async"</span>; <spanclass="hljs-comment"style="">//页面跳转同步通知页面路径</span> <spanclass="hljs-comment"style="">//需http://格式的完整路径,不能加?id=123这类自定义参数,不能写成http://localhost/</span> <spanclass="hljs-built_in"style="">String</span>return_url=<spanclass="hljs-string"style="">"http://192.168.0.222:8080/live/aliapi/return_url"</span>; <spanclass="hljs-comment"style="">//商户订单号.</span> <spanclass="hljs-comment"style="">//商户网站订单系统中唯一订单号,必填</span> <spanclass="hljs-comment"style="">//Stringout_trade_no=date.getTime()+"";</span> <spanclass="hljs-comment"style="">//订单名称</span> <spanclass="hljs-comment"style="">//必填</span> <spanclass="hljs-built_in"style="">String</span>subject=<spanclass="hljs-string"style="">"充值测试"</span>; <spanclass="hljs-comment"style="">//防钓鱼时间戳</span> <spanclass="hljs-comment"style="">//若要使用请调用类文件submit中的query_timestamp函数</span> <spanclass="hljs-built_in"style="">String</span>anti_phishing_key=<spanclass="hljs-string"style="">""</span>; <spanclass="hljs-comment"style="">//客户端的IP地址</span> <spanclass="hljs-comment"style="">//非局域网的外网IP地址,如:221.0.0.1</span> <spanclass="hljs-built_in"style="">String</span>exter_invoke_ip=<spanclass="hljs-string"style="">""</span>; <spanclass="hljs-built_in"style="">String</span>total_fee=ServletRequestUtils.getStringParameter(request,<spanclass="hljs-string"style="">"amount"</span>,<spanclass="hljs-string"style="">""</span>); <spanclass="hljs-built_in"style="">String</span>body=ServletRequestUtils.getStringParameter(request,<spanclass="hljs-string"style="">"body"</span>,<spanclass="hljs-string"style="">"test"</span>); <spanclass="hljs-comment"style="">//商品展示地址</span> <spanclass="hljs-built_in"style="">String</span>show_url=ServletRequestUtils.getStringParameter(request,<spanclass="hljs-string"style="">"show_url"</span>,<spanclass="hljs-string"style="">"http://www.elve.cn"</span>); <spanclass="hljs-comment"style="">//需以http://开头的完整路径,例如:http://www.xxx.com/myorder.html</span> Map<<spanclass="hljs-built_in"style="">String</span>,<spanclass="hljs-built_in"style="">String</span>>sParaTemp=<spanclass="hljs-keyword"style="">new</span>HashMap<<spanclass="hljs-built_in"style="">String</span>,<spanclass="hljs-built_in"style="">String</span>>(); sParaTemp.put(<spanclass="hljs-string"style="">"service"</span>,<spanclass="hljs-string"style="">"create_direct_pay_by_user"</span>);<spanclass="hljs-comment"style="">//接口服务----即时到账</span> sParaTemp.put(<spanclass="hljs-string"style="">"partner"</span>,AlipayConfig.partner);<spanclass="hljs-comment"style="">//支付宝PID</span> sParaTemp.put(<spanclass="hljs-string"style="">"_input_charset"</span>,AlipayConfig.input_charset);<spanclass="hljs-comment"style="">//统一编码</span> sParaTemp.put(<spanclass="hljs-string"style="">"payment_type"</span>,payment_type);<spanclass="hljs-comment"style="">//支付类型</span> sParaTemp.put(<spanclass="hljs-string"style="">"notify_url"</span>,notify_url);<spanclass="hljs-comment"style="">//异步通知页面</span> sParaTemp.put(<spanclass="hljs-string"style="">"return_url"</span>,return_url);<spanclass="hljs-comment"style="">//页面跳转同步通知页面</span> sParaTemp.put(<spanclass="hljs-string"style="">"seller_email"</span>,Constants.SELLER_EMAIL);<spanclass="hljs-comment"style="">//卖家支付宝账号</span> sParaTemp.put(<spanclass="hljs-string"style="">"out_trade_no"</span>,date.getTime()+payment_type);<spanclass="hljs-comment"style="">//商品订单编号</span> sParaTemp.put(<spanclass="hljs-string"style="">"subject"</span>,subject);<spanclass="hljs-comment"style="">//商品名称</span> sParaTemp.put(<spanclass="hljs-string"style="">"total_fee"</span>,total_fee);<spanclass="hljs-comment"style="">//价格</span> sParaTemp.put(<spanclass="hljs-string"style="">"body"</span>,body); sParaTemp.put(<spanclass="hljs-string"style="">"show_url"</span>,show_url); sParaTemp.put(<spanclass="hljs-string"style="">"anti_phishing_key"</span>,anti_phishing_key); sParaTemp.put(<spanclass="hljs-string"style="">"exter_invoke_ip"</span>,exter_invoke_ip); <spanclass="hljs-comment"style="">//建立请求</span> <spanclass="hljs-keyword"style="">try</span>{ <spanclass="hljs-built_in"style="">String</span>sHtmlText=AlipaySubmit.buildRequest(sParaTemp,<spanclass="hljs-string"style="">"post"</span>,<spanclass="hljs-string"style="">"确认"</span>); Gsongson=<spanclass="hljs-keyword"style="">new</span>GsonBuilder().setDateFormat(<spanclass="hljs-string"style="">"yyyy-MM-ddHH:mm:ss"</span>).create(); <spanclass="hljs-built_in"style="">String</span>s=gson.toJson(sHtmlText); model.addAttribute(<spanclass="hljs-string"style="">"sHtmlText"</span>,s); request.setAttribute(<spanclass="hljs-string"style="">"sHtmlText"</span>,s); result=<spanclass="hljs-string"style="">"{\"success\":true,\"msg\":\"跳转成功\"}"</span>; StringUtil.writeToWeb(sHtmlText,<spanclass="hljs-string"style="">"html"</span>,response); <spanclass="hljs-keyword"style="">return</span><spanclass="hljs-literal"style="">null</span>; }<spanclass="hljs-keyword"style="">catch</span>(Exceptione){ <spanclass="hljs-keyword"style="">if</span>(log.isErrorEnabled()){ log.error(<spanclass="hljs-string"style="">"ddddddddddddddddddddd"</span>); } result=<spanclass="hljs-string"style="">"{\"success\":false,\"msg\":\"跳转失败,请稍候再试!\"}"</span>; StringUtil.writeToWeb(result,<spanclass="hljs-string"style="">"html"</span>,response); <spanclass="hljs-keyword"style="">return</span><spanclass="hljs-literal"style="">null</span>; } } <spanclass="hljs-comment"style="">/** *同步通知的页面的Controller *@paramrequest *@paramresponse *@return *@author宗潇帅 */</span> @RequestMapping(value=<spanclass="hljs-string"style="">"/return_url"</span>) <spanclass="hljs-keyword"style="">public</span><spanclass="hljs-built_in"style="">String</span>Return_url(HttpServletRequestrequest,HttpServletResponseresponse){ <spanclass="hljs-keyword"style="">return</span><spanclass="hljs-string"style="">"web/pay/success"</span>; } <spanclass="hljs-comment"style="">/** *异步通知付款状态的Controller *@paramrequest *@paramresponse *@return *@author宗潇帅 */</span> @SuppressWarnings(<spanclass="hljs-string"style="">"rawtypes"</span>) @RequestMapping(value=<spanclass="hljs-string"style="">"/async"</span>,method=RequestMethod.GET) <spanclass="hljs-keyword"style="">public</span><spanclass="hljs-built_in"style="">String</span>async(HttpServletRequestrequest, HttpServletResponseresponse){ Map<<spanclass="hljs-built_in"style="">String</span>,<spanclass="hljs-built_in"style="">String</span>>params=<spanclass="hljs-keyword"style="">new</span>HashMap<<spanclass="hljs-built_in"style="">String</span>,<spanclass="hljs-built_in"style="">String</span>>(); MaprequestParams=request.getParameterMap(); <spanclass="hljs-keyword"style="">for</span>(Iteratoriter=requestParams.keySet().iterator();iter.hasNext();){ <spanclass="hljs-built_in"style="">String</span>name=(<spanclass="hljs-built_in"style="">String</span>)iter.next(); <spanclass="hljs-built_in"style="">String</span>[]values=(<spanclass="hljs-built_in"style="">String</span>[])requestParams.get(name); <spanclass="hljs-built_in"style="">String</span>valueStr=<spanclass="hljs-string"style="">""</span>; <spanclass="hljs-keyword"style="">for</span>(inti=<spanclass="hljs-number"style="">0</span>;i<values.length;i++){ valueStr=(i==values.length-<spanclass="hljs-number"style="">1</span>)?valueStr+values[i]:valueStr+values[i]+<spanclass="hljs-string"style="">","</span>; } params.put(name,valueStr); } <spanclass="hljs-built_in"style="">String</span>tradeNo=request.getParameter(<spanclass="hljs-string"style="">"out_trade_no"</span>); <spanclass="hljs-built_in"style="">String</span>tradeStatus=request.getParameter(<spanclass="hljs-string"style="">"trade_status"</span>); <spanclass="hljs-comment"style="">//StringnotifyId=request.getParameter("notify_id");</span> <spanclass="hljs-keyword"style="">if</span>(AlipayNotify.verify(params)){<spanclass="hljs-comment"style="">//验证成功</span> <spanclass="hljs-keyword"style="">if</span>(tradeStatus.equals(<spanclass="hljs-string"style="">"TRADE_FINISHED"</span>)||tradeStatus.equals(<spanclass="hljs-string"style="">"TRADE_SUCCESS"</span>)){ <spanclass="hljs-comment"style="">//要写的逻辑。自己按自己的要求写</span> log.error(<spanclass="hljs-string"style="">"ok......."</span>); System.out.println(<spanclass="hljs-string"style="">">>>>>充值成功"</span>+tradeNo); } <spanclass="hljs-keyword"style="">return</span><spanclass="hljs-string"style="">"web/pay/success"</span>; }<spanclass="hljs-keyword"style="">else</span>{<spanclass="hljs-comment"style="">//验证失败</span> <spanclass="hljs-keyword"style="">return</span><spanclass="hljs-string"style="">"web/pay/fail"</span>; } } }</code> 13:JSP付款页面表单提交数据并弹出付款页面 <%@pagecontentType="text/html;charset=UTF-8"%><!DOCTYPEhtml><htmlxmlns="http://www.w3.org/1999/xhtml"><head><metahttp-equiv="Content-Type"content="text/html;charset=utf-8"/><%@includefile="/common/webMeta.jsp"%><title>www.elve.cn</title><metacontent="www.elve.cn"name="keywords"/><metacontent="www.elve.cn"name="description"/></head><scripttype="text/javascript">$(function(){$("#amount").focus();$("#doSubmit").click(function(){form1.submit();});});</script><body><formid="form1"action="${ctx}/aliapi/deposit"method="post"target="_blank"><tablecellpadding="10"><tr><td>充值测试</td><tdclass="balance"id="userBalance"></td></tr><tr><td><iclass="zfb"></i></td><tdstyle="padding-bottom:0px;">亲爱的<spanclass="suppliment_user"id="suppliment_user"></span>,您可以使用支付宝充值积善分,请填写以下信息</td></tr><tr><td></td><td>金额<inputtype="text"name="amount"id="amount"></td></tr><tr><td></td><td><ahref="javascript:void(0);"id="doSubmit"class="blank_btn">确认</a></td></tr></table></form></body></html> 如果以上还是有问题,那就直接去看支付宝接口文档吧! 原文地址http://www.bieryun.com/603.html

优秀的个人博客,低调大师

[IOS]陀螺仪和加速仪编程

如何实现iPhone的重力感应还有旋转感应,也就是术语上的陀螺仪和加速器?下面我们来用一个简单的Demo入门一下吧! 由于模拟器上不能运行这个,所以只能贴出代码,没有截图。 ViewController.h: #import <UIKit/UIKit.h> @interface BIDViewController : UIViewController<UIAccelerometerDelegate> @property (weak, nonatomic) IBOutlet UILabel *accelerometerLabel; @property (weak, nonatomic) IBOutlet UILabel *gyroscopeLabel; @end ViewController.m: #import "BIDViewController.h" #import <CoreMotion/CoreMotion.h> @interface BIDViewController () @property (strong, nonatomic) CMMotionManager *motionManager; @property (strong, nonatomic) NSOperationQueue *queue; @end @implementation BIDViewController - (NSUInteger)supportedInterfaceOrientations { return UIInterfaceOrientationMaskPortrait; } - (void)viewDidLoad { [super viewDidLoad]; // Do any additional setup after loading the view, typically from a nib. self.motionManager = [[CMMotionManager alloc] init]; self.queue = [[NSOperationQueue alloc] init]; if (self.motionManager.accelerometerAvailable) { self.motionManager.accelerometerUpdateInterval = 1.0 / 10.0; [self.motionManager startAccelerometerUpdatesToQueue:self.queue withHandler: ^(CMAccelerometerData *accelerometerData, NSError *error) { NSString *labelText; labelText = [NSString stringWithFormat: @"Accelerometer\n-----------\nx: %+.2f\ny: %+.2f\nz: %+.2f", accelerometerData.acceleration.x, accelerometerData.acceleration.y, accelerometerData.acceleration.z]; NSLog(@"%@",labelText); }]; } else { self.accelerometerLabel.text = @"This device has no accelerometer."; } if (self.motionManager.gyroAvailable) { self.motionManager.gyroUpdateInterval = 1.0 / 10.0; [self.motionManager startGyroUpdatesToQueue:self.queue withHandler: ^(CMGyroData *gyroData, NSError *error) { NSString *labelText; labelText = [NSString stringWithFormat: @"Gyroscope\n--------\nx: %+.2f\ny: %+.2f\nz: %+.2f", gyroData.rotationRate.x, gyroData.rotationRate.y, gyroData.rotationRate.z]; NSLog(@"%@",labelText); }]; } else { self.gyroscopeLabel.text = @"This device has no gyroscope"; } } @end 切记要导入CoreMotion.framework框架 本文转蓬莱仙羽51CTO博客,原文链接:http://blog.51cto.com/dingxiaowei/1366411,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android教程之android数据库编程

由于android内置了SQLite数据库! SQLite本身就是一个很小型的数据库! 数据库存储的位置在data/data/<项目文件夹>/databases/ 1:创建数据库Context.createDatabase(String name,int version ,int mode,CursorFactory factory) 如果创建不成功则抛出FileNotFoundException异常 SQLiteDatabaseDataBase=this.openOrCreateDatabase("DataBase.db", MODE_PRIVATE, newCursorFactory(){ //创建新的数据库,名称Database,模式MODE_PRIVATE publicCursornewCursor(SQLiteDatabasedb, SQLiteCursorDrivermasterQuery, StringeditTable, SQLiteQueryquery){ returnnull; } }); 2:打开已经存在的数据库Context.openDatabase(String file,CursorFactory factory); 如果我们要实现打开不存在的数据库就创建它,代码如下: //创建一个名为:DataBase的数据库,后缀为.db SQLiteDatabaseDataBase=this.openOrCreateDatabase("DateBase.db", MODE_PRIVATE, null); //也可以这样写 try { //打开已经存在的数据库 db=this.openDatabase("DateBase.db",null); } catch(FileNotFoundExceptione) { try { //建立新的数据库 } catch(FileNotFoundExceptione) { db=null; } } 3:关闭数据库 //千万不要忘记关闭数据库哦 DataBase.close(); 4:删除指定数据库 this.deleteDatabase("Database.db"); 5:执行SQL命令使用:SQLiteDatabase.execSQL(String sql); 其他东西后面有时间的时候在补充! 本文转自 yarin 51CTO博客,原文链接:http://blog.51cto.com/yarin/379993,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册