首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

Java并发编程笔记之PriorityBlockingQueue源码分析

JDK 中无界优先级队列PriorityBlockingQueue 内部使用堆算法保证每次出队都是优先级最高的元素,元素入队时候是如何建堆的,元素出队后如何调整堆的平衡的? PriorityBlockingQueue是带优先级的无界阻塞队列,每次出队都返回优先级最好或者最低的元素,内部是平衡二叉树堆的实现。 首先看一下PriorityBlockingQueue类图结构,如下: 可以看到PriorityBlockingQueue内部有个数组queue用来存放队列元素,size用来存放队列元素个数,allocationSpinLock 是个自旋锁,用CAS操作来保证只有一个线程可以扩容队列, 状态为0 或者1,其中0标示当前没有在进行扩容,1标示当前正在扩容。 我们首先看看PriorityBlockingQueue的构造函数,源码如下: private static final int DEFAULT_INITIAL_CAPACITY = 11; public PriorityBlockingQueue() { this(DEFAULT_INITIAL_CAPACITY, null); } public PriorityBlockingQueue(int initialCapacity) { this(initialCapacity, null); } public PriorityBlockingQueue(int initialCapacity, Comparator<? super E> comparator) { if (initialCapacity < 1) throw new IllegalArgumentException(); this.lock = new ReentrantLock(); this.notEmpty = lock.newCondition(); this.comparator = comparator; this.queue = new Object[initialCapacity]; } 如上构造函数,默认队列容量为11,默认比较器为null,也就是使用元素的compareTo方法进行比较来确定元素的优先级,这意味着队列元素必须实现Comparable接口。 接下来我们主要看PriorityBlockingQueue的几个操作的源码,如下: 1.offer 操作,offer操作的作用是在队列插入一个元素,由于是无界队列,所以一直返回true,源码如下: public boolean offer(E e) { if (e == null) throw new NullPointerException(); //获取独占锁 final ReentrantLock lock = this.lock; lock.lock(); int n, cap; Object[] array; //如果当前元素个数>=队列容量,则扩容(1) while ((n = size) >= (cap = (array = queue).length)) tryGrow(array, cap); try { Comparator<? super E> cmp = comparator; //默认比较器为null (2) if (cmp == null) siftUpComparable(n, e, array); else //自定义比较器 (3) siftUpUsingComparator(n, e, array, cmp); //队列元素增加1,并且激活notEmpty的条件队列里面的一个阻塞线程(9) size = n + 1; notEmpty.signal();//激活调用take()方法被阻塞的线程 } finally { //释放独占锁 lock.unlock(); } return true; } 可以看到上面代码,offer操作主流程比较简单,接下来主要关注PriorityBlockingQueue是如何进行扩容的和内部如何建立堆的,首先看扩容源码如下: private void tryGrow(Object[] array, int oldCap) { lock.unlock(); //释放获取的锁 Object[] newArray = null; //cas成功则扩容(4) if (allocationSpinLock == 0 && UNSAFE.compareAndSwapInt(this, allocationSpinLockOffset, 0, 1)) { try { //oldGap<64则扩容新增oldcap+2,否者扩容50%,并且最大为MAX_ARRAY_SIZE int newCap = oldCap + ((oldCap < 64) ? (oldCap + 2) : // 如果一开始容量很小,则扩容宽度变大 (oldCap >> 1)); if (newCap - MAX_ARRAY_SIZE > 0) { // 可能溢出 int minCap = oldCap + 1; if (minCap < 0 || minCap > MAX_ARRAY_SIZE) throw new OutOfMemoryError(); newCap = MAX_ARRAY_SIZE; } if (newCap > oldCap && queue == array) newArray = new Object[newCap]; } finally { allocationSpinLock = 0; } } //第一个线程cas成功后,第二个线程会进入这个地方,然后第二个线程让出cpu, //尽量让第一个线程执行下面点获取锁,但是这得不到肯定的保证。(5) if (newArray == null) // 如果两外一个线程正在分配,则让出 Thread.yield(); lock.lock();//(6) if (newArray != null && queue == array) { queue = newArray; System.arraycopy(array, 0, newArray, 0, oldCap); } } tryGrow 目的是扩容,这里要思考下为啥在扩容前要先释放锁,然后使用 cas 控制只有一个线程可以扩容成功呢? 其实这里不先释放锁也是可以的,也就是在整个扩容期间一直持有锁,但是扩容是需要花时间的,如果扩容的时候还占用锁,那么其他线程在这个时候是不能进行出队和入队操作的, 这大大降低了并发性。所以为了提高性能,使用CAS控制只有一个线程可以进行扩容,并且在扩容前释放了锁,让其他线程可以进行入队和出队操作。 spinlock锁使用CAS控制只有一个线程可以进行扩容,CAS失败的线程会调用Thread.yield() 让出 cpu,目的是为了让扩容线程扩容后优先调用lock.lock 重新获取锁, 但是这得不到一定的保证。有可能yield的线程在扩容线程扩容完成前已经退出,并执行了代码(6)获取到了锁。如果当前数组扩容还没完毕,当前线程会再次调用tryGrow方法, 然后释放锁,这又给扩容线程获取锁提供了机会,如果这时候扩容线程还没扩容完毕,则当前线程释放锁后又调用yield方法让出CPU。可知当扩容线程进行扩容期间, 其他线程是原地自旋通过代码(1)检查当前扩容是否完毕,等扩容完毕后才退出代码(1)的循环。 当扩容线程扩容完毕后会重置自旋锁变量allocationSpinLock 为 0,这里并没有使用UNSAFE方法的CAS进行设置是因为同时只可能有一个线程获取了该锁,并且 allocationSpinLock 被修饰为了 volatile。 当扩容线程扩容完毕后会执行代码 (6) 获取锁,获取锁后复制当前 queue 里面的元素到新数组。 接下来我们看看建堆算法,源码如下: private static <T> void siftUpComparable(int k, T x, Object[] array) { Comparable<? super T> key = (Comparable<? super T>) x; //队列元素个数>0则判断插入位置,否者直接入队(7) while (k > 0) { int parent = (k - 1) >>> 1; Object e = array[parent]; if (key.compareTo((T) e) >= 0) break; array[k] = e; k = parent; } array[k] = key;(8) } 接下来用图来解释上面的算法过程,假设队列初始化容量为2,创建的优先级队列的泛型参数为Integer。 首先调用队列offer(2)方法,希望插入元素2到队列,插入前队列状态如下图所示: 首先执行代码(1),从上图变量值可以知道判断值为false,所以紧接着执行代码(2),由于 k=n=size=0 所以代码(7)判断结果为 false,所以会执行代码(8)直接把元素 2 入队,最后执行代码(9)设置 size 的值加 1,这时候队列的状态如下图: 然后调用队列的 offer(4) 时候,首先执行代码(1),从上图变量值可知判断为 false,所以执行代码(2),由于 k=1, 所以进入 while 循环,由于 parent=0;e=2;key=4; 默认元素比较器是使用元素的 compareTo 方法, 可知 key>e 所以执行 break 退出 siftUpComparable 中的循环; 然后把元素存到数组下标为 1 的地方,最后执行代码(9)设置 size 的值加 1,这时候队列状态为: 然后调用队列的offer(6) 时候,首先执行代码(1),从上图变量值知道这时候判断值为true,所以嗲用tryGrow进行数组扩容,由于2 < 64 所以newCap=2 + (2+2)=6; 然后创建新数组并拷贝, 然后调用siftUpComparable 方法,由于 k=2>0 进入 while 循环,由于 parent=0;e=2;key=6;key>e 所以 break 后退出 while 循环; 并把元素 6 放入数组下标为 2 的地方,最后设置 size 的值加 1,现在队列状态: 然后调用队列的 offer(1) 时候,首先执行代码(1),从上图变量值知道这次判断值为 false,所以执行代码(2),由于k=3, 所以进入 while 循环,由于parent=0;e=4;key=1; key<e,所以把元素 4 复制到数组下标为 3 的地方, 然后 k=0 退出 while 循环;然后把元素 1 存放到下标为 0 地方,现在状态: 此时此刻的二叉树堆的树形图如下: 可知堆的根元素是 1,也就是这是一个最小堆,那么当调用这个优先级队列的 poll 方法时候,会一次返回堆里面值最小的元素。 2.poll操作,poll 操作作用是获取队列内部堆树的根节点元素,如果队列为空,则返回 null。源码如下: public E poll() { final ReentrantLock lock = this.lock; lock.lock();//获取独占锁 try { return dequeue(); } finally { lock.unlock();//释放独占锁 } } 如上代码可以知道在进行出队操作过程中要先加锁,这意味着,当前线程进行出队操作的时候,其他线程不能再进行入队和出队操作,但是从前面介绍offer函数的时候,知道这时候可以有其他线程进行扩容, 接下来,我们要看一下出队操作的dequeue方法的源码如下: private E dequeue() { //队列为空,则返回null int n = size - 1; if (n < 0) return null; else { //获取队头元素(1) Object[] array = queue; E result = (E) array[0]; //获取队尾元素,并值null(2) E x = (E) array[n]; array[n] = null; Comparator<? super E> cmp = comparator; if (cmp == null)//(3) siftDownComparable(0, x, array, n); else siftDownUsingComparator(0, x, array, n, cmp); size = n;//(4) return result; } } 如上代码,如果队列为空则直接返回 null,否者执行代码(1)获取数组第一个元素作为返回值存放到变量 Result,这里要注意一下数组里面第一个元素是优先级最小或者最大的元素,出队操作就是返回这个元素。 然后代码(2)获取队列尾部元素存放到变量X,并且置空尾部节点,然后执行代码(3)插入变量X 到数组下标为 0 的位置后,重新调整堆为最大或者最小堆,然后返回。 这里重要的是看如何去掉堆的根节点后,使用剩下的节点重新调整为一个最大或者最小堆。 接下来我们看看siftDownComparable 的源码,如下: private static <T> void siftDownComparable(int k, T x, Object[] array, int n) { if (n > 0) { Comparable<? super T> key = (Comparable<? super T>)x; int half = n >>> 1; // loop while a non-leaf while (k < half) { int child = (k << 1) + 1; // 假设左边子树最小 Object c = array[child];(5) int right = child + 1;(6) if (right < n && ((Comparable<? super T>) c).compareTo((T) array[right]) > 0)(7) c = array[child = right]; if (key.compareTo((T) c) <= 0)(8) break; array[k] = c; k = child; } array[k] = key;(9) } } 下面我们结合图来模拟上面调整堆的算法过程,接着上节队列的状态继续讲解,上节队列元素序列为 1,2,6,4: 第一次调用队列的 poll() 方法时候,首先执行代码(1)(2),这时候变量 size =4;n=3;result=1;x=4; 这时候队列状态图如下: 然后执行代码(3),调整堆后队列状态图,如下: 第二次调用队列的 poll() 方法时候,首先执行代码(1)(2),这时候变量 size =3;n=2;result=2;x=6; 这时候队列状态图,如下: 然后执行代码(3)调整堆后队列状态图,如下: 第三次调用队列的 poll() 方法时候,首先执行代码(1)(2),这时候变量 size =2;n=1;result=4;x=6; 这时候队列状态图,如下: 然后执行代码(3)调整堆后队列状态图,如下: 第四次直接返回元素 6. 接下来重点说说 siftDownComparable 这个调整堆的算法: 首先说下堆调整的思路,由于队列数组第 0 个元素为树根,出队时候要被移除,这时候数组就不在是最小堆了,所以需要调整堆, 具体是要从被移除的树根的左右子树中找一个最小的值来当树根,左右子树又会看自己作为树根节点的树的左右子树里面哪个是最小值,这是一个递归的过程,直到树叶节点结束递归, 如果不明白,下面结合图形来说明,假如当前队列内容如下: 对应的二叉堆树如下: 这时候如果调用了 poll(); 那么 result=2;x=11;队列末尾的元素设置为 null 后,剩下的元素调整堆的步骤如下图: 如上图(1)树根的 leftChildVal = 4;rightChildVal = 6; 4<6; 所以 c=4; 然后 11>4 也就是 key>c;所以使用元素 4 覆盖树根节点的值,现在堆对应的树如图(2)。 然后树根的左子树树根的左右孩子节点中 leftChildVal = 8;rightChildVal = 10; 8<10; 所以 c=8; 然后发现 11>8 也就是 key>c;所以元素 8 作为树根左子树的根节点,现在树的形状如图(3), 这时候判断 k<half 为 false 就会退出循环,然后把 x=11 设置到数组下标为 3 的地方,这时候堆树如图(4),至此调整堆完毕,siftDownComparable 返回 result=2,poll 方法也返回了。 3.put操作,put 操作内部调用的 offer, 由于是无界队列,所以不需要阻塞,源码如下: public void put(E e) { offer(e); // never need to block } 4.take 操作,take 操作作用是获取队列内部堆树的根节点元素,如果队列为空则阻塞,源码如下: public E take() throws InterruptedException { //获取锁,可被中断 final ReentrantLock lock = this.lock; lock.lockInterruptibly(); E result; try { //如果队列为空,则阻塞,把当前线程放入notEmpty的条件队列 while ( (result = dequeue()) == null) notEmpty.await();//阻塞当前线程 } finally { lock.unlock();//释放锁 } return result; } 如上代码,首先通过 lock.lockInterruptibly() 获取独占锁,这个方式获取的锁是对中断进行响应的。然后调用 dequeue 方法返回堆树根节点元素,如果队列为空,则返回 false, 然后当前线程调用 notEmpty.await() 阻塞挂起当前线程,直到有线程调用了 offer()方法(offer 方法内在添加元素成功后调用了 notEmpty.signal 方法会激活一个阻塞在 notEmpty 的条件队列里面的一个线程)。 另外这里使用 while 而不是 if 是为了避免虚假唤醒。 5.size操作,获取队列元个数,如下代码,在返回 size 前加了锁,保证在调用 size() 方法时候不会有其它线程进行入队和出队操作,另外由于 size 变量没有被修饰为 volatie,这里加锁也保证了多线程下 size 变量的内存可见性。源码如下: public int size() { final ReentrantLock lock = this.lock; lock.lock(); try { return size; } finally { lock.unlock(); } } 总结:PriorityBlockingQueue 队列内部使用二叉树堆维护元素优先级,内部使用数组作为元素存储的数据结构,这个数组是可以扩容的,当前元素个数 >= 最大容量的时候会通过算法扩容, 出队的时候始终保证出队的元素是堆树的根节点,而不是在队列里面停留时间最长的元素,默认元素优先级比较规则是使用元素的compareTo方法来做,用户可以自定义优先级的比较优先级。
优秀的个人博客,低调大师

Java并发编程笔记之ArrayBlockingQueue源码分析

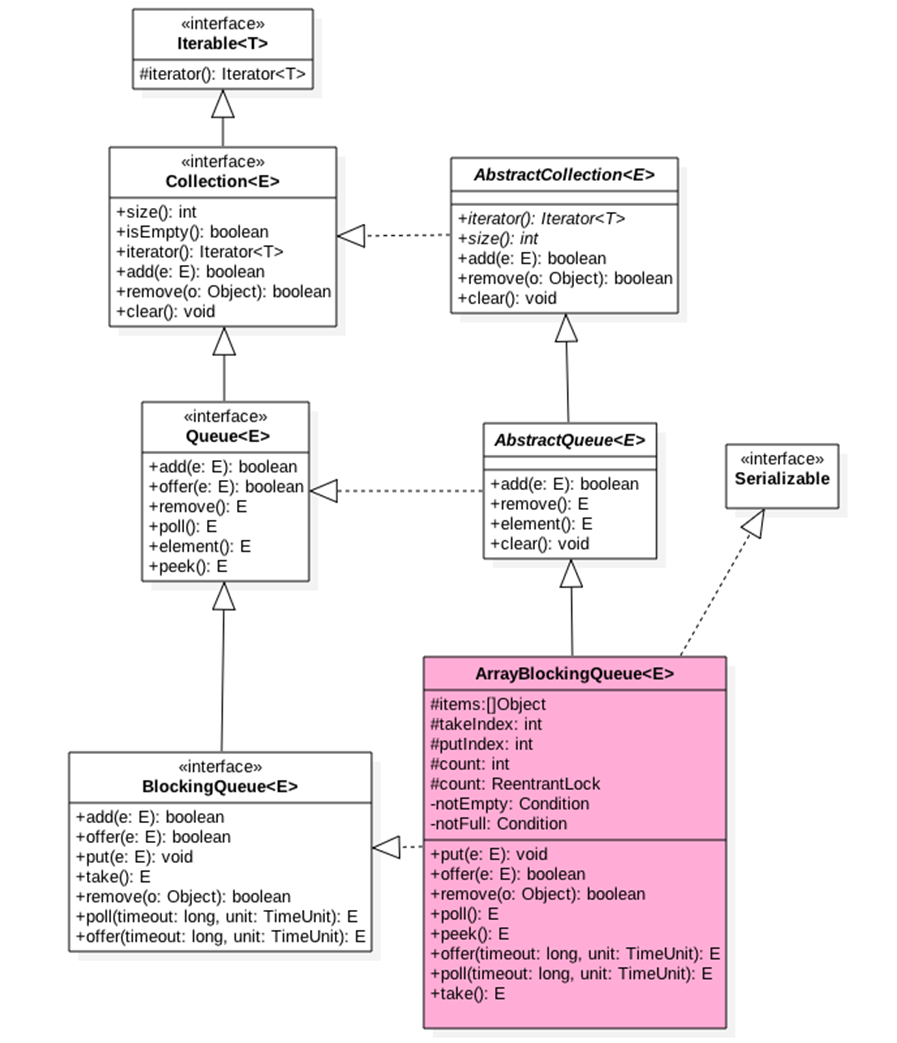
一.JDK 中基于数组的阻塞队列 ArrayBlockingQueue 原理剖析,ArrayBlockingQueue 内部如何基于一把独占锁以及对应的两个条件变量实现出入队操作的线程安全? 首先我们先大概的浏览一下ArrayBlockingQueue 的内部构造,如下类图: 如类图所示,可以看到ArrayBlockingQueue 内部有个数组items 用来存放队列元素,putIndex变量标示入队元素的下标,takeIndex是出队的下标,count是用来统计队列元素个数, 从定义可以知道,这些属性并没有使用valatile修饰,这是因为访问这些变量的使用都是在锁块内被用。而加锁了,就足以保证了锁块内变量的内存可见性。 另外还有个独占锁lock 用来保证出队入队操作的原子性,这保证了同时只有一个线程可以进行入队出队操作,另外notEmpty,notFull条件变量用来进行出队入队的同步。 由于ArrayBlockingQueue 是有界队列,所以构造函数必须传入队列大小的参数。 接下来我们进入ArrayBlockingQueue的源码看,如下: public ArrayBlockingQueue(int capacity) { this(capacity, false); } public ArrayBlockingQueue(int capacity, boolean fair) { if (capacity <= 0) throw new IllegalArgumentException(); this.items = new Object[capacity]; lock = new ReentrantLock(fair); notEmpty = lock.newCondition(); notFull = lock.newCondition(); } 如上面代码所示,默认情况下使用的是ReentrantLock提供的非公平独占锁进行入队出队操作的加锁。 接下来主要看看ArrayBlockingQueue的主要的几个操作的源码,如下: 1.offer 操作,向队列尾部插入一个元素,如果队列有空闲容量,则插入成功后返回true,如果队列已满则丢弃当前元素,然后返回false, 如果e元素为null,则抛出NullPointerException 异常,另外该方法是不阻塞的。源码如下: public boolean offer(E e) { //(1)e为null,则抛出NullPointerException异常 checkNotNull(e); //(2)获取独占锁 final ReentrantLock lock = this.lock; lock.lock(); try { //(3)如果队列满则返回false if (count == items.length) return false; else { //(4)否者插入元素 enqueue(e); return true; } } finally { lock.unlock(); } } 代码(2)获取独占锁,当前线程获取到该锁后,其他入队和出队操作的线程都会被阻塞挂起后放入lock锁的AQS阻塞队列。 代码(3)如果队列满则直接返回false,否则调用enqueue方法后返回true,enqueue的源码如下: private void enqueue(E x) { //(6)元素入队 final Object[] items = this.items; items[putIndex] = x; //(7)计算下一个元素应该存放的下标 if (++putIndex == items.length) putIndex = 0; count++; //(8) notEmpty.signal(); } 可以看到上面代码首先把当前元素放入items数组,然后计算下一个元素应该存放的下标,然后递增元素个数计数器,最后激活 notEmpty 的条件队列中因为调用 poll 或者 take 操作而被阻塞的的一个线程。 这里由于在操作共享变量,比如count前加了锁,所以不存在内存不可见问题,加过锁后获取的共享变量都是从主存获取的,而不是在CPU缓存获取寄存器里面的值。 代码(5)释放锁,释放锁后会把修改的共享变量值,比如Count的值刷新回主内存中,这样其他线程通过加锁再次读取这些共享变量后就可以看到最新的值。 2.put操作,向队列尾部插入一个元素,如果队列有空闲则插入后直接返回true,如果队列已满则阻塞当前线程直到队列有空闲插入成功后返回true, 如果在阻塞的时候被其他线程设置了中断标志,则被阻塞线程会抛出InterruptedException 异常而返回,另外如果 e 元素为 null 则抛出 NullPointerException 异常。源码如下: public void put(E e) throws InterruptedException { //(1) checkNotNull(e); final ReentrantLock lock = this.lock; //(2)获取锁(可被中断) lock.lockInterruptibly(); try { //(3)如果队列满,则把当前线程放入notFull管理的条件队列 while (count == items.length) notFull.await(); //(4)插入元素 enqueue(e); } finally { //(5) lock.unlock(); } } 代码(2)在获取锁的过程中当前线程被其它线程中断了,则当前线程会抛出 InterruptedException 异常而退出。 代码(3)判断如果当前队列满了,则把当前线程阻塞挂起后放入到 notFull 的条件队列,注意这里是使用了 while 而不是 if。为什么需要while呢? 这是因为考虑到当前线程被虚假唤醒的问题,也就是其它线程没有调用 notFull 的 singal 方法时候,notFull.await() 在某种情况下会自动返回。 如果使用if语句简单判断一下,那么虚假唤醒后会执行代码(4),元素入队,并且递增计数器,而这时候队列已经是满了的,导致队列元素个数大于了队列设置的容量,导致程序出错。 而使用使用 while 循环假如 notFull.await() 被虚假唤醒了,那么循环在检查一下当前队列是否是满的,如果是则再次进行等待。 代码(4)如果队列不满则插入当前元素。 3.poll操作,从队列头部获取并移除一个元素,如果队列为空则返回 null,该方法是不阻塞的。源码如下: public E poll() { //(1)获取锁 final ReentrantLock lock = this.lock; lock.lock(); try { //(2)当前队列为空则返回null,否者调用dequeue()获取 return (count == 0) ? null : dequeue(); } finally { //(3)释放锁 lock.unlock(); } } 代码(1)获取独占锁 代码(2)如果队列为空则返回 null,否者调用 dequeue() 方法,dequeue 源码如下: private E dequeue() { final Object[] items = this.items; //(4)获取元素值 @SuppressWarnings("unchecked") E x = (E) items[takeIndex]; //(5)数组中值值为null; items[takeIndex] = null; //(6)队头指针计算,队列元素个数减一 if (++takeIndex == items.length) takeIndex = 0; count--; //(7)发送信号激活notFull条件队列里面的一个线程 notFull.signal(); return x; } 如上代码,可以看到首先获取当前队头元素保存到局部变量,然后重置队头元素为null,并重新设置队头下标,元素计数器递减,最后发送信号激活notFull 的条件队列里面一个因为调用 put 或者 offer 而被阻塞的线程。 4.take 操作,获取当前队列头部元素,并从队列里面移除,如果队列为空则阻塞调用线程。如果队列为空则阻塞当前线程知道队列不为空,然后返回元素, 如果如果在阻塞的时候被其它线程设置了中断标志,则被阻塞线程会抛出 InterruptedException 异常而返回。源码如下: public E take() throws InterruptedException { //(1)获取锁 final ReentrantLock lock = this.lock; lock.lockInterruptibly(); try { //(2)队列为空,则等待,直到队列有元素 while (count == 0) notEmpty.await(); //(3)获取队头元素 return dequeue(); } finally { //(4) 释放锁 lock.unlock(); } } 可以看到take操作的代码也比较简单,与poll相比,只是步骤(2)如果队列为空,则把当前线程挂起后放入到notEmpty的条件队列,等其他线程调用notEmpty.signal() 方法后在返回, 需要注意的是这里也是使用 while 循环进行检测并等待而不是使用 if。之所以这样做,道理都是一样。这里就不在解释了。 5.peek 操作获取队列头部元素但是不从队列里面移除,如果队列为空则返回 null,该方法是不阻塞的。源码如下: public E peek() { //(1)获取锁 final ReentrantLock lock = this.lock; lock.lock(); try { //(2) return itemAt(takeIndex); } finally { //(3) lock.unlock(); } } @SuppressWarnings("unchecked") final E itemAt(int i) { return (E) items[i]; } peek的实现更加简单,首先获取独占锁,然后从数组items 中获取当前队头下标的值并返回,在返回之前释放了获取的锁。 6.size 操作,获取当前队列元素个数。源码如下: public int size() { final ReentrantLock lock = this.lock; lock.lock(); try { return count; } finally { lock.unlock(); } } size 操作是简单的,获取锁后直接返回 count,并在返回前释放锁。也许你会有疑问这里有没有修改Count的值,只是简单的获取下,为何要加锁呢? 答案很简单,如果count声明为volatile,这里就不需要加锁了,因为因为 volatile 类型变量保证了内存的可见性,而 ArrayBlockingQueue 的设计中 count 并没有声明为 volatile, 这是因为count的操作都是在获取锁后进行的,而获取锁的语义之一就是获取锁后访问的变量都是从主内存获取的,这就保证了变量的内存可见性。 最后用一张图来加深对ArrayBlockingQueue的理解,如下图: 总结:ArrayBlockingQueue 通过使用全局独占锁实现同时只能有一个线程进行入队或者出队操作,这个锁的粒度比较大,有点类似在方法上添加 synchronized 的意味。ArrayBlockingQueue 的 size 操作的结果是精确的,因为计算前加了全局锁。 二、Logback 框架中异步日志打印中 ArrayBlockingQueue 的使用 在高并发并且响应时间要求比较小的系统中同步打日志已经满足不了需求了,这是因为打日志本身是需要同步写磁盘的,会造成 响应时间 增加,如下图同步日志打印模型为: 异步模型是业务线程把要打印的日志任务写入一个队列后直接返回,然后使用一个线程专门负责从队列中获取日志任务写入磁盘,其模型具体如下图: 如图可知其实 logback 的异步日志模型是一个多生产者单消费者模型,通过使用队列把同步日志打印转换为了异步,业务线程调用异步 appender 只需要把日志任务放入日志队列,日志线程则负责使用同步的 appender 进行具体的日志打印到磁盘。 接下来看看异步日志打印具体实现,要把同步日志打印改为异步需要修改 logback 的 xml 配置文件如下: <appender name="PROJECT" class="ch.qos.logback.core.FileAppender"> <file>project.log</file> <encoding>UTF-8</encoding> <append>true</append> <rollingPolicy class="ch.qos.logback.core.rolling.TimeBasedRollingPolicy"> <!-- daily rollover --> <fileNamePattern>project.log.%d{yyyy-MM-dd}</fileNamePattern> <!-- keep 7 days' worth of history --> <maxHistory>7</maxHistory> </rollingPolicy> <layout class="ch.qos.logback.classic.PatternLayout"> <pattern> <![CDATA[%n%-4r [%d{yyyy-MM-dd HH:mm:ss}] %X{productionMode} - %X{method} %X{requestURIWithQueryString} [ip=%X{remoteAddr}, ref=%X{referrer}, ua=%X{userAgent}, sid=%X{cookie.JSESSIONID}]%n %-5level %logger{35} - %m%n]]> </pattern> </layout> </appender> <appender name="asyncProject" class="ch.qos.logback.classic.AsyncAppender"> <discardingThreshold>0</discardingThreshold> <queueSize>1024</queueSize> <neverBlock>true</neverBlock> <appender-ref ref="PROJECT" /> </appender> <logger name="PROJECT_LOGGER" additivity="false"> <level value="WARN" /> <appender-ref ref="asyncProject" /> </logger> 可知 AsyncAppender 是实现异步日志的关键,下节主要讲这个的内部实现。 异步原理实现 首先从 AsyncAppender 的类图结构来从全局了解下 AsyncAppender 中组件构成,类图如下所示: 从上面的类图我们可以知道如下两点: 1.如上图可知 AsyncAppender 继承自 AsyncAppenderBase,其中后者具体实现了异步日志模型的主要功能,前者只是重写了其中的一些方法。另外从上类图可知 logback 中的异步日志队列是一个阻塞队列, 后面会知道其实是一个有界阻塞队列 ArrayBlockingQueue, 其中 queueSize 是有界队列的元素个数默认为 256。 2.worker 是个线程,也就是异步日志打印模型中的单消费者线程,aai 是一个 appender 的装饰器里面存放同步日志的 appender, 其中 appenderCount 记录 aai 里面附加的同步 appender 的个数;neverBlock 是当日志队列满了的时候是否阻塞打日志的线程的一个开关;discardingThreshold 是一个阈值,当日志队列里面空闲个数小于该值时候新来的某些级别的日志会被直接丢弃,下面会具体讲到。 首先我们来看下何时创建的日志队列以及何时启动的消费线程,这需要看下 AsyncAppenderBase 的 start 方法,该方法是在解析完毕配置 AsyncAppenderBase 的 xml 的节点元素后被调用,源码如下: public void start() { ... //(1)日志队列为有界阻塞队列 blockingQueue = new ArrayBlockingQueue<E>(queueSize); //(2)如果没设置discardingThreshold则设置为队列大小的1/5 if (discardingThreshold == UNDEFINED) discardingThreshold = queueSize / 5; //(3)设置消费线程为守护线程,并设置日志名称 worker.setDaemon(true); worker.setName("AsyncAppender-Worker-" + worker.getName()); //(4)设置启动消费线程 super.start(); worker.start(); } 从上代码可知如下两点: 1. logback 使用的队列是有界队列 ArrayBlockingQueue,之所以使用有界队列是考虑到内存溢出问题,在高并发下写日志的 qps 会很高如果设置为无界队列队列本身会占用很大内存,很可能会造成 内存溢出。 2.这里消费日志队列的 worker 线程被设置为了守护线程,意味着当主线程运行结束并且当前没有用户线程时候该 worker 线程会随着 JVM 的退出而终止,而不管日志队列里面是否还有日志任务未被处理。另外这里设置了线程的名称是个很好的习惯,因为这在查找问题的时候很有帮助,根据线程名字就可以定位到是哪个线程。 既然是有界队列那么肯定需要考虑如果队列满了,该如何处置,是丢弃老的日志任务,还是阻塞日志打印线程直到队列有空余元素那? 要回答这个问题,我们需要看看具体进行日志打印的AsyncAppenderBase 的 append 方法,源码如下: protected void append(E eventObject) { //(5)调用AsyncAppender重写的isDiscardable if (isQueueBelowDiscardingThreshold() && isDiscardable(eventObject)) { return; } ... //(6)放入日志任务到队列 put(eventObject); } private boolean isQueueBelowDiscardingThreshold() { return (blockingQueue.remainingCapacity() < discardingThreshold); } 其中 (5) 调用了 AsyncAppender 重写的 isDiscardable,源码如下: //(7) protected boolean isDiscardable(ILoggingEvent event) { Level level = event.getLevel(); return level.toInt() <= Level.INFO_INT; } 结合 代码(5)和代码(7) 可知如果当前日志的级别小于 INFO_INT 级别并且当前队列的剩余容量小于 discardingThreshold 时候会直接丢弃这些日志任务。 接下来看具体步骤 (6) 的 put 方法,源码如下: private void put(E eventObject) { //(8) if (neverBlock) { blockingQueue.offer(eventObject); } else { try {//(9) blockingQueue.put(eventObject); } catch (InterruptedException e) { // Interruption of current thread when in doAppend method should not be consumed // by AsyncAppender Thread.currentThread().interrupt(); } } } 可知如果 neverBlock 设置为了 false(默认为 false)则会调用阻塞队列的 put 方法,而 put 是阻塞的,也就是说如果当前队列满了,如果在企图调用 put 方法向队列放入一个元素则调用线程会被阻塞直到队列有空余空间。这里有必要提下其中第 (9) 步当日志队列满了的时候 put 方法会调用 await() 方法阻塞当前线程,如果其它线程中断了该线程,那么该线程会抛出 InterruptedException 异常,那么当前的日志任务就会被丢弃了。如果 neverBlock 设置为了 true 则会调用阻塞队列的 offer 方法,而该方法是非阻塞的,如果当前队列满了,则会直接返回,也就是丢弃当前日志任务。 最后看下 addAppender 方法内是什么的,源码如下: public void addAppender(Appender<E> newAppender) { if (appenderCount == 0) { appenderCount++; ... aai.addAppender(newAppender); } else { addWarn("One and only one appender may be attached to AsyncAppender."); addWarn("Ignoring additional appender named [" + newAppender.getName() + "]"); } } 如上代码可知一个异步 appender 只能绑定一个同步 appender, 这个 appender 会被放到 AppenderAttachableImpl 的 appenderList 列表里面。 到这里我们已经分析完了日志生产线程放入日志任务到日志队列的实现,下面一起来看下消费线程是如何从队列里面消费日志任务并写入磁盘的,由于消费线程是一个线程,那就从 worker 的 run 方法看起,源码如下所示: class Worker extends Thread { public void run() { AsyncAppenderBase<E> parent = AsyncAppenderBase.this; AppenderAttachableImpl<E> aai = parent.aai; //(10)一直循环直到该线程被中断 while (parent.isStarted()) { try {//(11)从阻塞队列获取元素 E e = parent.blockingQueue.take(); aai.appendLoopOnAppenders(e); } catch (InterruptedException ie) { break; } } //(12)到这里说明该线程被中断,则吧队列里面的剩余日志任务 //刷新到磁盘 for (E e : parent.blockingQueue) { aai.appendLoopOnAppenders(e); parent.blockingQueue.remove(e); } ... .. } } 其中(11)从日志队列使用 take 方法获取一个日志任务,如果当前队列为空则当前线程会阻塞到 take 方法直到队列不为空才返回,获取到日志任务后会调用 AppenderAttachableImpl 的 aai.appendLoopOnAppenders 方法,该方法会循环调用通过 addAppender 注入的同步日志 appener 具体实现日志打印到磁盘的任务。

优秀的个人博客,低调大师

Java并发编程笔记之LinkedBlockingQueue源码探究

LinkedBlockingQueue的实现是使用独占锁实现的阻塞队列。首先看一下LinkedBlockingQueue的类图结构,如下图所示: 如类图所示:LinkedBlockingQueue是使用单向链表实现,有两个Node分别来存放首尾节点,并且里面有个初始值为0 的原子变量count,它用来记录队列元素个数。 另外里面有两个ReentrantLock的实例,分别用来控制元素入队和出队的原子性,其中takeLock用来控制同时只有一个线程可以从队列获取元素,其他线程必须等待, putLock控制同时只能有一个线程可以获取锁去添加元素,其他线程必须等待。另外notEmpty 和 notFull 是信号量,内部分别有一个条件队列用来存放进队和出队的时候被阻塞的线程, 说白了,这其实就是一个生产者 - 消费者模型。 我们首先看一下独占锁的源码,如下所示: /** 执行take, poll等操作时候需要获取该锁 */ private final ReentrantLock takeLock = new ReentrantLock(); /** 当队列为空时候执行出队操作(比如take)的线程会被放入这个条件队列进行等待 */ private final Condition notEmpty = takeLock.newCondition(); /** 执行put, offer等操作时候需要获取该锁*/ private final ReentrantLock putLock = new ReentrantLock(); /**当队列满时候执行进队操作(比如put)的线程会被放入这个条件队列进行等待 */ private final Condition notFull = putLock.newCondition(); /** 当前队列元素个数 */ private final AtomicInteger count = new AtomicInteger(0); 接着我们要进入LinkedBlockingQueue 无参构造函数,源码如下: public static final int MAX_VALUE = 0x7fffffff; public LinkedBlockingQueue() { this(Integer.MAX_VALUE); } public LinkedBlockingQueue(int capacity) { if (capacity <= 0) throw new IllegalArgumentException(); this.capacity = capacity; //初始化首尾节点,指向哨兵节点 last = head = new Node<E>(null); } 从源码中可以看到,默认队列的容量为0x7fffffff; 用户也可以自己指定容量,所以一定程度上 LinkedBlockingQueue 可以说是有界阻塞队列。 接下来我们主要看LinkedBlockingQueue 的几个主要方法的源码,如下: 1.offer操作,向队列尾部插入一个元素,如果队列有空闲容量则插入成功后返回true,如果队列已满则丢弃当前元素然后返回false,如果 e元素为null,则抛出空指针异常(NullPointerException),还有一点就是,该方法是非阻塞的。源码如下: public boolean offer(E e) { //(1)空元素抛空指针异常 if (e == null) throw new NullPointerException(); //(2) 如果当前队列满了则丢弃将要放入的元素,然后返回false final AtomicInteger count = this.count; if (count.get() == capacity) return false; //(3) 构造新节点,获取putLock独占锁 int c = -1; Node<E> node = new Node<E>(e); final ReentrantLock putLock = this.putLock; putLock.lock(); try { //(4)如果队列不满则进队列,并递增元素计数 if (count.get() < capacity) { enqueue(node); c = count.getAndIncrement(); //(5) if (c + 1 < capacity) notFull.signal(); } } finally { //(6)释放锁 putLock.unlock(); } //(7) if (c == 0) signalNotEmpty(); //(8) return c >= 0; } private void enqueue(Node<E> node) { last = last.next = node; } 代码(2)判断的是如果当前队列已满则丢弃当前元素并返回false。 代码(3)获取到putLock锁,当前线程获取到该锁后,则其他调用put 和 offer 的线程将会被阻塞(阻塞的线程被放到 putLock 锁的 AQS 阻塞队列)。 代码(4)这里又重新判断了一下当前队列是否满了,这是因为在执行代码(2)和获取到putLock锁期间,有可能其他线程通过put 或者 offer方法想队列里面添加了新的元素。重新判断队列确实不满则新元素入队,并递增计数器。 代码(5)判断的是如果新元素入队后还有空闲空间,则唤醒notFull的条件队列里面因为调用了notFull 的 await 操作(比如执行put方法而队列满了的时候)而被阻塞的一个线程,因为队列现在有空闲,所以这里可以提前唤醒一个入队线程。 代码(6)则释放获取的putLock锁,这里要注意锁的释放一定要在finally里面做,因为即使try块抛出异常了,finally也是会被执行到的。另外释放锁后其他因为调用put和offer而被阻塞的线程将会有一个获取到改锁。 代码(7)c == 0说明在执行代码(6)释放锁的时候队列里面至少有一个元素,队列里面有元素则执行signalNotEmpty,signalNotEmpty的源码如下: private void signalNotEmpty() { final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { notEmpty.signal(); } finally { takeLock.unlock(); } } 通过上面代码可以看到其作用是激活notEmpty 的条件队列中因为调用notEmpty的await方法(比如调用 take 方法并且队列为空的时候)而被阻塞的一个线程,这里也说明了调用条件变量的方法前,要首先获取对应的锁。 offer的总结:offer方法中通过使用putLock锁保证了在队尾新增元素的原子性和队列元素个数的比较和递增操作的原子性。 2.put操作,向队列尾部插入一个元素,如果队列有空闲则插入后直接返回true,如果队列已经满则阻塞当前线程知道队列有空闲插入成功后返回true,如果在阻塞的时候被其他线程设置了中断标志, 则被阻塞线程会抛出InterruptedException 异常而返回,另外如果 e 元素为 null 则抛出 NullPointerException 异常。源码如下: public void put(E e) throws InterruptedException { //(1)空元素抛空指针异常 if (e == null) throw new NullPointerException(); //(2) 构建新节点,并获取独占锁putLock int c = -1; Node<E> node = new Node<E>(e); final ReentrantLock putLock = this.putLock; final AtomicInteger count = this.count; putLock.lockInterruptibly(); try { //(3)如果队列满则等待 while (count.get() == capacity) { notFull.await(); } //(4)进队列并递增计数 enqueue(node); c = count.getAndIncrement(); //(5) if (c + 1 < capacity) notFull.signal(); } finally { //(6) putLock.unlock(); } //(7) if (c == 0) signalNotEmpty(); } 代码(2)中使用 putLock.lockInterruptibly() 获取独占锁,相比 offer 方法中这个获取独占锁方法意味着可以被中断,具体说是当前线程在获取锁的过程中,如果被其它线程设置了中断标志则当前线程会抛出 InterruptedException 异常, 所以put操作在获取 锁过程中是可被中断的。 代码(3)如果当前队列已经满,则notFull 的 await() 把当前线程放入 notFull 的条件队列,当前线程被阻塞挂起并释放获取到的 putLock 锁,由于putLock锁被释放了,所以现在其他线程就有机会获取到putLock锁了。 代码(3)判断队列是否为空为何使用 while 循环而不是 if 语句呢? 这是因为考虑到当前线程被虚假唤醒的问题,也就是其它线程没有调用 notFull 的 singal 方法时候,notFull.await() 在某种情况下会自动返回。 如果使用if语句简单判断一下,那么虚假唤醒后会执行代码(4),元素入队,并且递增计数器,而这时候队列已经是满了的,导致队列元素个数大于了队列设置的容量,导致程序出错。 而使用使用 while 循环假如 notFull.await() 被虚假唤醒了,那么循环在检查一下当前队列是否是满的,如果是则再次进行等待。 3.poll操作,从队列头部获取并移除一个元素,如果队列为空则返回 null,该方法是不阻塞的。源码如下: public E poll() { //(1)队列为空则返回null final AtomicInteger count = this.count; if (count.get() == 0) return null; //(2)获取独占锁 E x = null; int c = -1; final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { //(3)队列不空则出队并递减计数 if (count.get() > 0) {//3.1 x = dequeue();//3.2 c = count.getAndDecrement();//3.3 //(4) if (c > 1) notEmpty.signal(); } } finally { //(5) takeLock.unlock(); } //(6) if (c == capacity) signalNotFull(); //(7)返回 return x; } private E dequeue() { Node<E> h = head; Node<E> first = h.next; h.next = h; // help GC head = first; E x = first.item; first.item = null; return x; } 代码(1) 如果当前队列为空,则直接返回 null。 代码(2)获取独占锁 takeLock,当前线程获取该锁后,其它线程在调用 poll 或者 take 方法会被阻塞挂起。 代码 (3) 如果当前队列不为空则进行出队操作,然后递减计数器。 代码(4)如果 c>1 则说明当前线程移除掉队列里面的一个元素后队列不为空(c 是删除元素前队列元素个数),那么这时候就可以激活因为调用 poll 或者 take 方法而被阻塞到notEmpty 的条件队列里面的一个线程。 代码(5)释放锁,一定要在finally里面释放锁。 代码(6)说明当前线程移除队头元素前当前队列是满的,移除队头元素后队列当前至少有一个空闲位置,那么这时候就可以调用signalNotFull激活因为调用put 或者 offer 而被阻塞放到 notFull 的条件队列里的一个线程,signalNotFull源码如下: private void signalNotFull() { final ReentrantLock putLock = this.putLock; putLock.lock(); try { notFull.signal(); } finally { putLock.unlock(); } } poll 代码逻辑比较简单,值得注意的是获取元素时候只操作了队列的头节点。 4.peek 操作,获取队列头部元素但是不从队列里面移除,如果队列为空则返回 null,该方法是不阻塞的。源码如下: public E peek() { //(1) if (count.get() == 0) return null; //(2) final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { Node<E> first = head.next; //(3) if (first == null) return null; else //(4) return first.item; } finally { //(5) takeLock.unlock(); } } 可以看到代码(3)这里还是需要判断下 first 是否为 null 的,不能直接执行代码(4)。 正常情况下执行到代码(2)说明队列不为空,但是代码(1)和(2)不是原子性操作,也就是在执行代码(1)判断队列不为空后, 在代码(2)获取到锁前,有可能其他线程执行了poll 或者 take 操作导致队列变为了空,然后当前线程获取锁后,直接执行 first.item 会抛出空指针异常。 5.take 操作,获取当前队列头部元素并从队列里面移除,如果队列为空则阻塞调用线程。如果队列为空则阻塞当前线程知道队列不为空,然后返回元素,如果在阻塞的时候被其他线程设置了中断标志,则被阻塞线程会抛出InterruptedException 异常而返回。源码如下: public E take() throws InterruptedException { E x; int c = -1; final AtomicInteger count = this.count; //(1)获取锁 final ReentrantLock takeLock = this.takeLock; takeLock.lockInterruptibly(); try { //(2)当前队列为空则阻塞挂起 while (count.get() == 0) { notEmpty.await(); } //(3)出队并递减计数 x = dequeue(); c = count.getAndDecrement(); //(4) if (c > 1) notEmpty.signal(); } finally { //(5) takeLock.unlock(); } //(6) if (c == capacity) signalNotFull(); //(7) return x; } 代码(1)当前线程获取到独占锁,其他调用take 或者 poll的线程将会被阻塞挂起。 代码(2)如果队列为空则阻塞挂起当前线程,并把当前线程放入notEmpty 的条件队列。 代码(3)进行出队操作并递减计数。 代码(4)如果 c > 1 说明当前队列不为空,则唤醒notEmpty 的条件队列的条件队列里面的一个因为调用 take 或者 poll 而被阻塞的线程。 代码(5)释放锁。 代码(6)如果 c == capacity 则说明当前队列至少有一个空闲位置,则激活条件变量 notFull 的条件队列里面的一个因为调用 put 或者 offer 而被阻塞的线程。 6.remove操作,删除队列里面指定元素,有则删除返回 true,没有则返回 false,源码如下: public boolean remove(Object o) { if (o == null) return false; //(1)双重加锁 fullyLock(); try { //(2)遍历队列找则删除返回true for (Node<E> trail = head, p = trail.next; p != null; trail = p, p = p.next) { //(3) if (o.equals(p.item)) { unlink(p, trail); return true; } } //(4)找不到返回false return false; } finally { //(5)解锁 fullyUnlock(); } } 代码(1)通过fullyLock获取双重锁,当前线程获取后,其他线程进行入队或者出队的操作就会被阻塞挂起。双重锁方法fullyLock的源码如下: void fullyLock() { putLock.lock(); takeLock.lock(); } 代码(2)遍历队列寻找要删除的元素,找不到则直接返回false,找到则执行unlink操作,unlink的源码如下: void unlink(Node<E> p, Node<E> trail) { p.item = null; trail.next = p.next; if (last == p) last = trail; 如果当前队列满,删除后,也不忘记唤醒等待的线程 if (count.getAndDecrement() == capacity) notFull.signal(); } 可以看到删除元素后,如果发现当前队列有空闲空间,则唤醒 notFull 的条件队列中一个因为调 用 put 或者 offer 方法而被阻塞的线程。 代码(5)调用 fullyUnlock 方法使用与加锁顺序相反的顺序释放双重锁,源码如下: void fullyUnlock() { takeLock.unlock(); putLock.unlock(); } 7.size操作,获取当前队列元素个数。源码如下: public int size() { return count.get(); } 总结:由于在操作出队入队的时候操作Count的时候加了锁,因此相比ConcurrentLinkedQueue 的size方法比较准确。 最后用一张图来加深LinkedBlockingQueue的理解,如下图: 因此我们要思考一个问题:为何 ConcurrentLinkedQueue 中需要遍历链表来获取 size 而不适用一个原子变量呢? 这是因为使用原子变量保存队列元素个数需要保证入队出队操作和操作原子变量是原子操作,而ConcurrentLinkedQueue 是使用 CAS 无锁算法的,所以无法做到这个。

优秀的个人博客,低调大师

Java并发编程笔记之ConcurrentLinkedQueue源码探究

JDK 中基于链表的非阻塞无界队列 ConcurrentLinkedQueue 原理剖析,ConcurrentLinkedQueue 内部是如何使用 CAS 非阻塞算法来保证多线程下入队出队操作的线程安全? ConcurrentLinkedQueue是线程安全的无界非阻塞队列,其底层数据结构是使用单向链表实现,入队和出队操作是使用我们经常提到的CAS来保证线程安全的。 我们首先看一下ConcurrentLinkedQueue的类图结构先,好有一个内部逻辑有一个大概的印象,如下图所示: 可以清楚的看到ConcurrentLinkedQueue内部的队列是使用单向链表方式实现,类中两个volatile 类型的Node 节点分别用来存放队列的首位节点。 首先我们先来看一下ConcurrentLinkedQueue的构造函数,如下: public ConcurrentLinkedQueue() { head = tail = new Node<E>(null); } 通过无参构造函数可知默认头尾节点都是指向 item 为 null 的哨兵节点。 Node节点内部则维护一个volatile 修饰的变量item 用来存放节点的值,next用来存放链表的下一个节点,从而链接为一个单向无界链表,这就是单向无界的根本原因。如下图: 接下来看ConcurrentLinkedQueue 主要关注入队,出队,获取队列元素的方法的源码,如下所示: 1.首先看入队方法offer,offer 操作是在队列末尾添加一个元素,如果传递的参数是 null 则抛出 NPE 异常,否者由于 ConcurrentLinkedQueue 是无界队列该方法一直会返回 true。另外由于使用 CAS 无阻塞算法,该方法不会阻塞调用线程,其源码如下: public boolean offer(E e) { //(1)e为null则抛出空指针异常 checkNotNull(e); //(2)构造Node节点 final Node<E> newNode = new Node<E>(e); //(3)从尾节点进行插入 for (Node<E> t = tail, p = t;;) { Node<E> q = p.next; //(4)如果q==null说明p是尾节点,则执行插入 if (q == null) { //(5)使用CAS设置p节点的next节点 if (p.casNext(null, newNode)) { //(6)cas成功,则说明新增节点已经被放入链表,然后设置当前尾节点 if (p != t) casTail(t, newNode); // Failure is OK. return true; } } else if (p == q)//(7) //多线程操作时候,由于poll操作移除元素后有可能会把head变为自引用,然后head的next变为新head,所以这里需要 //重新找新的head,因为新的head后面的节点才是正常的节点。 p = (t != (t = tail)) ? t : head; else //(8) 寻找尾节点 p = (p != t && t != (t = tail)) ? t : q; } } 类图结构时候谈到构造队列时候参构造函数创建了一个 item 为 null 的哨兵节点,并且 head 和 tail 都是指向这个节点,下面通过图形结合来讲解下 offer 操作的代码实现。 1.首先看一下,当一个线程调用offer(item)时候情况:首先代码(1)对传参判断空检查,如果为null 则抛出空指针异常,然后代码(2)则使用item作为构造函数参数创建一个新的节点, 代码(3)从队列尾部节点开始循环,目的是从队列尾部添加元素。如下图: 上图是执行代码(4)时候队列的情况,这时候节点 p , t ,head ,tail 同时指向了item为null的哨兵节点,由于哨兵节点的next节点为null,所以这里q指向也是null。 代码(4)发现q==null 则执行代码(5),通过CAS原子操作判断p 节点的next节点是否为null,如果为null 则使用节点newNode替换p 的next节点, 然后执行代码(6),由于 p == t ,所以没有设置尾部节点,然后退出offer方法,这时候队列的状态图如下: 上面讲解的是一个线程调用offer方法的情况下,如果多个线程同时调用,就会存在多个线程同时执行到代码(5),假设线程A调用offer(item1), 线程B调用offer(item2),线程 A 和线程B同时到 p.casNext(null,newNode)。而CAS的比较并设置操作是原子性的,假设线程A先执行了比较设置操作, 则发现当前P的next节点确实是null ,则会原子性更新next节点为newNode,这时候线程B 也会判断p 的next节点是否为null,结果发现不是null,(因为线程 A 已经设置了 p 的 next 为 newNode)则会跳到代码(3), 然后执行到代码(4)的时候的队列分布图如下: 根据这个状态图可知线程B会执行代码(8),然后q 赋值给了p,这个时候状态图为: 然后线程B再次跳转到代码(3)执行,当执行到代码(4)时候队列状态图为: 由于这时候q == null ,所以线程B 会执行步骤(5),通过CAS操作判断 当前p的next 节点是否为null ,不是则再次循环后尝试,是则使用newNode替换,假设CAS成功了,那么执行步骤(6), 由于 p != t 所以设置tail节点为newNode ,然后退出offer方法。这时候队列的状态图为: 到现在为止,offer代码在执行路径现在就差步骤(7)还没有执行过,其实这个要在执行poll操作才会出现的,这里先看一下执行poll操作后可能会存在的一种情况,如下图所示: 下面分析下当队列处于这种状态调用offer添加元素代码执行到代码(4)的时候的队列状态图,如下: 由于q节点不为空并且p==q 所以执行代码(7),因为 t == tail所以p 被赋值为head ,然后进入循环,循环后执行到代码(4)的时候的队列状态图,如下: 由于 q ==null,所以执行代码(5),进行CAS操作,如果当前没有其他线程执行offer操作,则CAS操作会成功,p的next节点被设置为新增节点,然后执行代码(6), 由于p != t 所以设置新节点为队列尾节点,现在队列状态图,如下: 在这里的自引用的节点会被垃圾回收掉,可见offer操作里面关键步骤是代码(5)通过原子CAS操作来进行控制同时只有一个线程可以追加元素到队列末尾,进行cas竞争失败的线程, 则会通过循环一次次尝试进行cas操作,知道cas成功才会返回,也就是通过使用无限循环里面不断进行CAS尝试方式来替代阻塞算法挂起调用线程,相比阻塞算法,这是使用CPU资源换取阻塞带来的开销。 2.poll操作,poll 操作是在队列头部获取并且移除一个元素,如果队列为空则返回 null,我们首先看改方法的源码,如下: public E poll() { //(1) goto标记 restartFromHead: //(2)无限循环 for (;;) { for (Node<E> h = head, p = h, q;;) { //(3)保存当前节点值 E item = p.item; //(4)当前节点有值则cas变为null if (item != null && p.casItem(item, null)) { //(5)cas成功标志当前节点以及从链表中移除 if (p != h) updateHead(h, ((q = p.next) != null) ? q : p); return item; } //(6)当前队列为空则返回null else if ((q = p.next) == null) { updateHead(h, p); return null; } //(7)自引用了,则重新找新的队列头节点 else if (p == q) continue restartFromHead; else//(8) p = q; } } } final void updateHead(Node<E> h, Node<E> p) { if (h != p && casHead(h, p)) h.lazySetNext(h); } poll操作是从队头获取元素,所以代码(2)内层循环是从head节点开始迭代,代码(3)获取当前队头的节点,当队列一开始为空的时候队列状态为: 由于head 节点指向的item 为null 的哨兵节点,所以会执行到代码(6),假设这个过程没有线程调用offer,则此时q等于null ,如下图: 所以执行updateHead方法,由于h 等于 p所以没有设置头节点,poll方法直接返回null。 假设执行到代码(6)的时候已经有其他线程调用了offer 方法成功添加了一个元素到队列,这时候q执行的是新增元素的节点,这时候队列状态图为: 所以代码(6)判断结果为false,然后会转向代码(7)执行,而此时p不等于q,所以转向代码(8)执行,执行结果是p指向了节点q,此时的队列状态如下: 然后程序转向代码(3)执行,p现在指向的元素值不为null,则执行p.casItem(item, null)通过 CAS 操作尝试设置 p 的 item 值为 null, 如果此时没有其他线程进行poll操作,CAS成功则执行代码(5),由于此时 p != h ,所以设置头节点为p,poll然后返回被从队列移除的节点值item。此时队列状态为: 这个状态就是前面提到offer操作的时候,offer代码的执行路径(7)执行的前提状态。 假如现在一个线程调用了poll操作,则在执行代码(4)的时候的队列状态为: 可以看到这时候执行代码(6)返回null。 现在poll的代码还有个分支(7)还没有被执行过,那么什么时候会执行呢?假设线程A执行poll操作的时候,当前的队列状态,如下: 那么执行p.casItem(item, null)通过 CAS 操作尝试设置 p 的 item 值为 null。 假设 CAS 设置成功则标示该节点从队列中移除了,此时队列状态为: 然后由于p != h,所以会执行updateHead 方法,假如线程A执行updateHead前,另外一个线程B开始poll操作,这时候线程B的p指向head节点, 但是还没有执行到代码(6),这时候队列状态为: 然后线程A执行updateHead 操作,执行完毕后线程 A 退出,这时候队列状态为: 然后线程B继续执行代码(6)q=p.next由于该节点是自引用节点所以p==q,所以会执行代码(7)跳到外层循环restartFromHead,重新获取当前队列队头 head, 现在状态为: 总结:poll元素移除一个 元素的时候,只是简单的使用CAS操作把当前节点的item值设置为null,然后通过重新设置头节点让该元素从队列里面摘除, 被摘除的节点就成了孤立节点,这个节点会被在GC的时候会被回收掉。另外,执行分支中如果发现头节点被修改了要跳到外层循环重新获取新的头节点。 3.peek操作,peek 操作是获取队列头部一个元素(只不获取不移除),如果队列为空则返回 null,其源码如下: public E peek() { //(1) restartFromHead: for (;;) { for (Node<E> h = head, p = h, q;;) { //(2) E item = p.item; //(3) if (item != null || (q = p.next) == null) { updateHead(h, p); return item; } //(4) else if (p == q) continue restartFromHead; else //(5) p = q; } } } 代码结构与poll操作类似,不同于代码(3)的使用只是少了castItem 操作,其实这很正常,因为peek只是获取队列头元素值,并不清空其值, 根据前面我们知道第一次执行 offer 后 head 指向的是哨兵节点(也就是 item 为 null 的节点),那么第一次peek的时候,代码(3)中会发现item==null, 然后会执行 q = p.next, 这时候 q 节点指向的才是队列里面第一个真正的元素或者如果队列为 null 则 q 指向 null。 当队列为空的时候,队列状态图,如下: 这时候执行updateHead 由于 h 节点等于 p 节点所以不进行任何操作,然后 peek 操作会返回 null。 当队列中至少有一个元素的时候(假如只有一个),这时候队列状态为: 这时候执行代码(5)这时候 p 指向了 q 节点,然后执行代码(3)这时候队列状态为: 执行代码(3)发现 item 不为 null,则执行 updateHead 方法,由于 h!=p, 所以设置头结点,设置后队列状态为: 可以看到其实就是剔除了哨兵节点。 总结:peek操作代码与poll操作类似,只是前者只获取队列头元素,但是并不从队列里面删除,而后者获取后需要从队列里面删除,另外,在第一次调用peek操作的时候, 会删除哨兵节点,并让队列的head节点指向队列里面第一个元素或者null。 4.size方法,获取当前队列元素个数,在并发环境下不是很有用,因为 CAS 没有加锁所以从调用 size 函数到返回结果期间有可能增删元素,导致统计的元素个数不精确。源码如下: public int size() { int count = 0; for (Node<E> p = first(); p != null; p = succ(p)) if (p.item != null) // 最大返回Integer.MAX_VALUE if (++count == Integer.MAX_VALUE) break; return count; } //获取第一个队列元素(哨兵元素不算),没有则为null Node<E> first() { restartFromHead: for (;;) { for (Node<E> h = head, p = h, q;;) { boolean hasItem = (p.item != null); if (hasItem || (q = p.next) == null) { updateHead(h, p); return hasItem ? p : null; } else if (p == q) continue restartFromHead; else p = q; } } } //获取当前节点的next元素,如果是自引入节点则返回真正头节点 final Node<E> succ(Node<E> p) { Node<E> next = p.next; return (p == next) ? head : next; } 5.remove方法,如果队列里面存在该元素则删除给元素,如果存在多个则删除第一个,并返回 true,否者返回 false。源码如下: public boolean remove(Object o) { //查找元素为空,直接返回false if (o == null) return false; Node<E> pred = null; for (Node<E> p = first(); p != null; p = succ(p)) { E item = p.item; //相等则使用cas值null,同时一个线程成功,失败的线程循环查找队列中其它元素是否有匹配的。 if (item != null && o.equals(item) && p.casItem(item, null)) { //获取next元素 Node<E> next = succ(p); //如果有前驱节点,并且next不为空则链接前驱节点到next, if (pred != null && next != null) pred.casNext(p, next); return true; } pred = p; } return false; } ConcurrentLinkedQueue 底层使用单向链表数据结构来保存队列元素,每个元素被包装为了一个 Node 节点,队列是靠头尾节点来维护的,创建队列时候头尾节点指向一个 item 为 null 的哨兵节点, 第一次 peek 或者 first 时候会把 head 指向第一个真正的队列元素。由于使用非阻塞 CAS 算法,没有加锁,所以获取 size 的时候有可能进行了 offer,poll 或者 remove 操作,导致获取的元素个数不精确,所以在并发情况下 size 函数不是很有用。

优秀的个人博客,低调大师

Java并发编程笔记之ReentrantLock源码分析

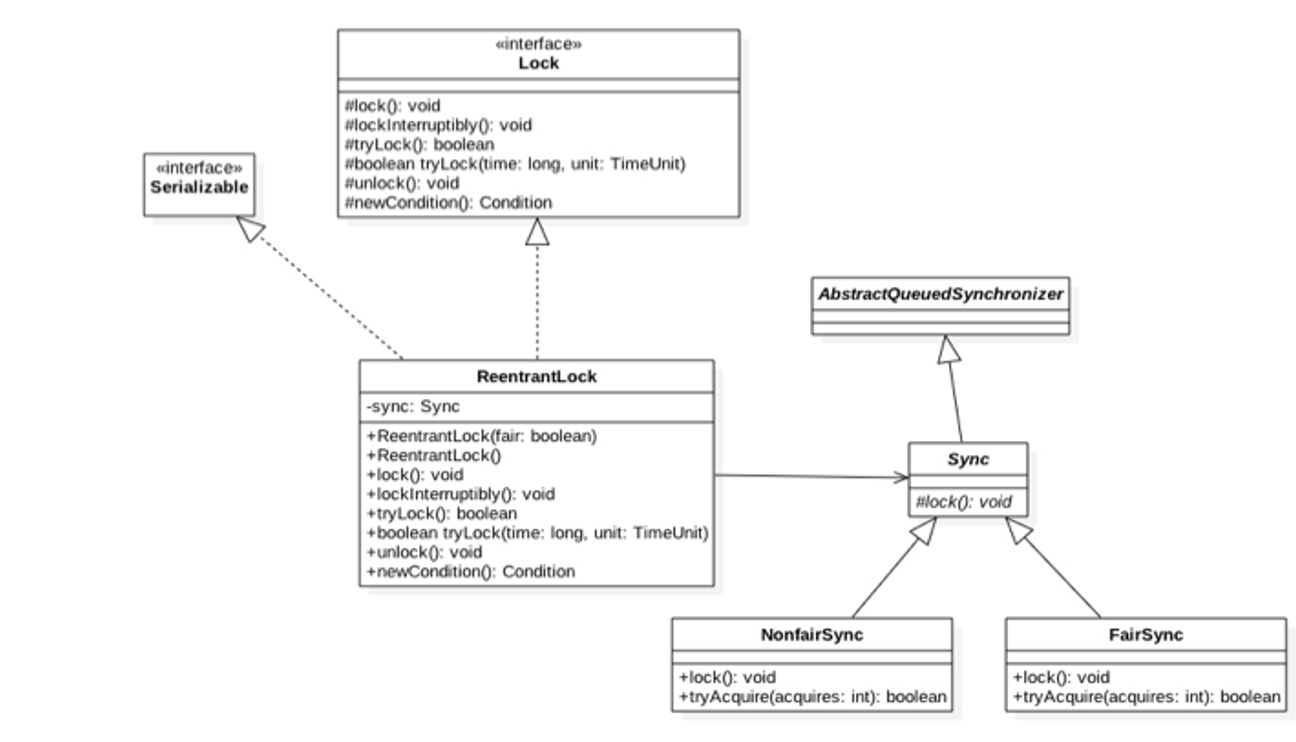
ReentrantLock是可重入的独占锁,同时只能有一个线程可以获取该锁,其他获取该锁的线程会被阻塞后放入该锁的AQS阻塞队列里面。 首先我们先看一下ReentrantLock的类图结构,如下图所示: 从类图可以知道,ReentrantLock最终还是使用AQS来实现,并且根据参数决定内部是公平锁还是非公平锁,默认是非公平锁。 首先我们先看ReentrantLock源码,看到其构造函数及其参数,这是决定内部是公平锁还是非公平锁,如下源码所示: public ReentrantLock() { sync = new NonfairSync(); } public ReentrantLock(boolean fair) { sync = fair ? new FairSync() : new NonfairSync(); } 其中类Sync直接继承自AQS,它的子类NonfairSync和FairSync分别实现了获取锁的公平和非公平策略。 在这里AQS的状态值state代表线程获取该锁的可重入次数,默认情况下state的值为0,标示当前锁没有被任何线程持有,当一个线程第一次获取该锁的时候会尝试使用CAS设置state的值为1,如果CAS成功则当前线程获取了该锁,然后记录该锁的持有者为当前线程, 在该线程没有释放锁,第二次获取该锁后,状态值会加1,被设置为2,这就是可重入次数,在该线程释放该锁的时候,会尝试使用CAS让状态值减1,如果减1 后状态值为0 则当前线程释放该锁。 接下来我们看一下ReentrantLock是如何获取锁的,如下: 1.void lock() 当一个线程调用该方法,说明该线程希望获取该锁,如果锁当前没有被其它线程占用并且当前线程之前没有获取该锁,则当前线程会获取到该锁,然后设置当前锁的拥有者为当前线程,并设置 AQS 的状态值为 1 后直接返回。 如果当前线程之前已经获取过该锁,则这次只是简单的把 AQS 的状态值 status 加 1 后返回。 如果该锁已经被其它线程持有,则调用该方法的线程会被放入 AQS 队列后阻塞挂起。源码如下: public void lock() { sync.lock(); } 如上面代码所示,ReentrantLock的lock()是委托给sync类,根据创建ReentrantLock的时候,构造函数选择sync的实现是NonfairSync或者FairSync,这里先看sync的子类NonfairSync的情况,也就是非公平锁的时候,源码如下: final void lock() { //(1)CAS设置状态值 if (compareAndSetState(0, 1)) setExclusiveOwnerThread(Thread.currentThread()); else //(2)调用AQS的acquire方法 acquire(1); } 如上面代码所示,代码(1)因为默认AQS的状态值为0,所以第一个调用Lock的线程会通过CAS设置状态值为1,CAS成功则代表当前线程获取到了锁,然后setExclusiveOwnerThread 设置了该锁持有者是当前线程。 如果这时候有其他线程调用lock方法企图获取该锁,执行代码(1)CAS会失败,然后会调用AQS的acquire方法,这里注意传递参数为1,接下来我们看AQS的acquire的核心代码,如下: public final void acquire(int arg) { //(3)调用ReentrantLock重写的tryAcquire方法 if (!tryAcquire(arg) && // tryAcquiref返回false会把当前线程放入AQS阻塞队列 acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) selfInterrupt(); } 之前说过 AQS 并没有提供可用的 tryAcquire 方法,tryAcquire 方法需要子类自己定制化,所以这里代码(3)会调用 ReentrantLock 重写的 tryAcquire 方法代码。 这里先看下非公平锁的源码代码如下: protected final boolean tryAcquire(int acquires) { return nonfairTryAcquire(acquires); } final boolean nonfairTryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); //(4)当前AQS状态值为0 if (c == 0) { if (compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } }//(5)当前线程是该锁持有者 else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) // overflow throw new Error("Maximum lock count exceeded"); setState(nextc); return true; }//(6) return false; } 正如上面代码(4)会看当前锁的状态值是否为0,为0则说明当前该锁空闲,那么就尝试CAS获取该锁(尝试将 AQS 的状态值从 0 设置为 1),并设置当前锁的持有者为当前线程返回返回 true。 如果当前状态值不为0 则说明该锁已经被某个县城持有,所以代码(5)看当前线程是否是该锁的持有者,如果当前线程是该锁持有者,状态值增加1,然后返回true。 如果当前线程不是锁的持有者则返回 false, 然后会被放入 AQS 阻塞队列。 到目前为止,介绍完了非公平锁的实现代码,回过头看看非公平锁在这里是怎么体现的,首先非公平是说:先尝试获取锁的线程并不一定比后尝试获取锁的线程优先获取锁。 这里假设线程 A 调用 lock()方法时候执行到了 nonfairTryAcquire 的代码(4)发现当前状态值不为 0,所以执行代码(5)发现当前线程不是线程持有者,则执行代码(6)返回 false,然后当前线程会被放入了 AQS 阻塞队列。 这时候线程 B 也调用了 lock() 方法执行到 nonfairTryAcquire 的代码(4)时候发现当前状态值为 0 了(假设占有该锁的其它线程释放了该锁)所以通过 CAS 设置获取到了该锁。而明明是线程 A 先请求获取的该锁那,这就是非公平锁的实现, 这里线程 B 在获取锁前并没有看当前 AQS 队列里面是否有比自己请求该锁更早的线程,而是使用了抢夺策略。 好了,知道非公平锁的实现了,那么我们接下来看一下公平锁是如何实现的呢? 公平锁的实现只需要看FairSync重写的tryAcquire方法,源码如下: protected final boolean tryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); //(7)当前AQS状态值为0 if (c == 0) { //(8)公平性策略 if (!hasQueuedPredecessors() && compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } //(9)当前线程是该锁持有者 else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) throw new Error("Maximum lock count exceeded"); setState(nextc); return true; }//(10) return false; } } 如上代码公平性的tryAcquire策略与非公平锁的类似,不同在于代码(8)处设置CAS前添加了hasQueuedPredecessors 方法,该方法是实现公平性的核心代码,源代码如下: public final boolean hasQueuedPredecessors() { Node t = tail; // Read fields in reverse initialization order Node h = head; Node s; return h != t &&((s = h.next) == null || s.thread != Thread.currentThread()); } 如上代码所示,如果当前线程节点有前驱节点则返回true,否则如果当前AQS队列为空或者当前线程节点是AQS的第一个节点则返回false。 其中如果h == t 则说明当前队列为空则直接返回false,如果h != t 并且 (s = h.next) ==null 说明有一个元素将要作为AQS的第一个节点入队列,那么返回true, 如果h != t 并且 (s = h.next) !=null 并且 s.thread !=Thread.currentThread() 则说明队列里面的第一个元素不是当前线程则返回 true。 2.void lockInterruptibly() 与 lock() 方法类似,不同在于该方法对中断响应,就是当前线程在调用该方式时候,如果其它线程调用了当前线程线程的 interrupt()方法,当前线程会抛出 InterruptedException 异常然后返回,源代码如下: public void lockInterruptibly() throws InterruptedException { sync.acquireInterruptibly(1); } public final void acquireInterruptibly(int arg)throws InterruptedException { //当前线程被中断则直接抛出异常 if (Thread.interrupted()) throw new InterruptedException(); //尝试获取资源 if (!tryAcquire(arg)) //调用AQS可被状态的方法 doAcquireInterruptibly(arg); } 3.boolean tryLock() 尝试获取锁,如果当前该锁没有被其它线程持有则当前线程获取该锁并返回 true, 否者返回 false,注意该方法不会引起当前线程阻塞。源码如下所示: public boolean tryLock() { return sync.nonfairTryAcquire(1); } final boolean nonfairTryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); if (c == 0) { if (compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) // overflow throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 如上代码与非公平锁的 tryAcquire() 方法类似,所以 tryLock() 使用的是非公平策略。 4.boolean tryLock(long timeout, TimeUnit unit) 尝试获取锁与 tryLock()不同在于设置了超时时间,如果超时没有获取该锁则返回 false。源代码如下: public boolean tryLock(long timeout, TimeUnit unit)throws InterruptedException { //调用AQS的tryAcquireNanos方法。 return sync.tryAcquireNanos(1, unit.toNanos(timeout)); } 接下来我们要看一下,ReentrantLock是如何释放锁的。 1.void unlock() 尝试释放锁,如果当前线程持有该锁,调用该方法会让该线程对该线程持有的 AQS 状态值减一,如果减去 1 后当前状态值为 0 则当前线程会释放对该锁的持有,否者仅仅减一而已。 如果当前线程没有持有该锁调用了该方法则会抛出 IllegalMonitorStateException 异常 ,源代码如下: public void unlock() { sync.release(1); } protected final boolean tryRelease(int releases) { //(11)如果不是锁持有者调用UNlock则抛出异常。 int c = getState() - releases; if (Thread.currentThread() != getExclusiveOwnerThread()) throw new IllegalMonitorStateException(); boolean free = false; //(12)如果当前可重入次数为0,则清空锁持有线程 if (c == 0) { free = true; setExclusiveOwnerThread(null); } //(13)设置可重入次数为原始值-1 setState(c); return free; } 如上代码所示(11)如果当前线程不是该锁持有者则直接抛异常,否则,看状态值剩余值是否为0,为0 则说明当前线程要释放对该锁的持有权,则执行代码(12)把当前锁持有者设置为null。 如果剩余值不为0,则仅仅让当前线程对该锁的可重入次数减1。 到目前基本了解了ReentrantLock的原理,那么接下来我们是否可以用ReentrantLock来实现一个简单的线程安全的list呢? 例子如下: import java.util.ArrayList; import java.util.concurrent.locks.ReentrantLock; /** * Created by cong on 2018/6/12. */ public class ReentrantLockList { //线程不安全的list private ArrayList<String> array = new ArrayList<String>(); //独占锁 private volatile ReentrantLock lock = new ReentrantLock(); //添加元素 public void add(String e) { lock.lock(); try { array.add(e); } finally { lock.unlock(); } } //删元素 public void remove(String e) { lock.lock(); try { array.remove(e); } finally { lock.unlock(); } } //获取数据 public String get(int index) { lock.lock(); try { return array.get(index); } finally { lock.unlock(); } } } 如上代码通过在操作 array 元素前进行加锁保证同时只有一个线程可以对 array 数组进行修改,但是同时也只能有一个线程对 array 元素进行访问。 最后几个图加深前面所学的内容,如下图所示: 如上图,假如线程 Thread1,Thread2,Thread3 同时尝试获取独占锁 ReentrantLock,假设 Thread1 获取到了,则 Thread2 和 Thread3 就会被转换为 Node 节点后放入 ReentrantLock 对应的 AQS 阻塞队列后阻塞挂起。 如上图,假设 Thread1 获取锁后调用了对应的锁创建的条件变量 1,那么 Thread1 就会释放获取到的锁,然后当前线程就会被转换为 Node 节点后插入到条件变量 1 的条件队列,由于 Thread1 释放了锁, 所以阻塞到 AQS 队列里面 Thread2 和 Thread3 就有机会获取到该锁,假如使用的公平策略,那么这时候 Thread2 会获取到该锁,会从 AQS 队列里面移除 Thread2 对应的 Node 节点。

优秀的个人博客,低调大师

Java并发编程笔记之AbstractQueuedSynchronizer源码分析

为什么要说AbstractQueuedSynchronizer呢? 因为AbstractQueuedSynchronizer是JUC并发包中锁的底层支持,AbstractQueuedSynchronizer是抽象同步队列,简称AQS,是实现同步器的基础组件,并发包中锁的实现底层就是使用AQS实现,另外大多数人可能不会直接用到AQS, 但是知道其原理对于架构设计还是很有帮助的。 首先我们看一下AQS的类图结构,如下图: 从类图的关系可以看到AQS是一个FIFO的双向队列,内部通过节点head 和 tail 记录队首和队尾元素,队列元素类型为Node。其中Node中Thread变量用来存放进入AQS队列里面的线程;Node 节点内部SHARED用来标记该线程是获取共享资源时候被阻塞挂起来后放入AQS队列, EXCLUSIVE标记线程是获取独占资源时候被挂起后放入AQS队列;waitStatus记录当前线程等待状态,分别为CANCELLED(线程被取消了),SIGNAL(线程需要被唤醒),CONDITION(线程在条件队列里面等待),PROPAGATE(释放共享资源时候需要通知其他节点); pre记录当前节点的前驱节点,next记录当前节点后继节点。 AQS中维持了一个单一的状态信息state,可以通过getState,setState,compareAndSetState 函数修改其值;对于ReentrantLock 的实现来说,state 可以用来表示当前线程获取锁的可重入次数; 对应读写锁ReentrantReadWriteLock 来说state 的高16位表示读状态,也就是获取该读锁的次数,低 16位 表示获取到写锁的线程的可重入次数;对于FuterTask 来说,state用来表示任务状态(例如,还没开始,运行,完成,取消); 对应CountDownlatch 和CyclicBarrie 来说,state用来表示计数器当前的值。 AQS有个内部类ConditionObject 是用来结合锁实现线程同步,ConditionObject可以直接访问AQS对象内部的变量,比如 state 状态值 和AQS队列; ConditionObject是条件变量,每个条件变量对应一个条件队列(单向链表队列),用来存放调用条件变量的await()方法后被阻塞的线程,如上类图所示,这个条件队列的头尾元素分别为firstWaiter 和 lastWaiter。 对于AQS 来说,线程同步的关键是对状态值state进行操作,根据state是否属于一个线程,操作state的方式分为独占模式和共享模式。 独占模式下获取和释放资源使用方法的源码如下: void acquire(int arg) void acquireInterruptibly(int arg) boolean release(int arg) 共享模式下获取和释放资源方法的源码如下: void acquireShared(int arg) void acquireSharedInterruptibly(int arg) boolean releaseShared(int arg) 对于独占锁方式获取的资源是与具体线程绑定的,也就是说如果一个线程获取到了资源,就会标记是那个线程获取到的,其他线程尝试操作state获取资源时候发现当前该资源不是自己持有,就会获取失败后被阻塞; 比如独占锁ReentrantLock的实现,当一个线程获取了ReentrantLock的锁后,AQS内部会首先使用CAS操作把state状态从0 变成 1,然后设置当前锁的持有者为当前线程,当该线程再次获取锁的时候,发现当前线程就是锁的持有者,则会把state状态值从1变成2, 也就是设置可重入次数,当另外一个线程获取锁的时候发现自己并不是该锁的持有者就会被放入AQS阻塞队列后挂起。 对于共享操作方式资源是与具体线程不相关的,多个线程去请求资源时候是通过CAS方式竞争获取资源,当一个线程获取到了资源后,另外一个线程再次获取时候,如果 当前资源还能满足它的需要,则当前线程只需要使用CAS方式进行获取即可, 共享模式下并不需要记录哪个线程获取了资源;比如 Semaphore 信号量,当一个线程通过acquire()方法获取一个信号量时候,会首先看当前信号两个数是否满足需要,不满足则把当前线程放入阻塞队列,如果满足则通过自旋CAS获取信号量。 那么我们接下来首先看独占模式的获取和释放资源的流程,如下: 1.当一个线程调用acquire(int arg)方法获取独占资源的时候,会首先使用tryAcquire 尝试获取资源,具体是设置状态变量state的值,成功则直接返回。失败则将当前线程封装为类型Node.EXCLUSIVE 的Node节点后插入到AQS阻塞队列尾部, 并调用LockSupport.part(this)挂起当前线程。 public final void acquire(int arg) { if (!tryAcquire(arg) && acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) selfInterrupt(); } 2.当一个线程调用release(int arg)的时候会尝试使用tryRelease 操作释放资源,这里是设置状态变量state的值,然后调用LockSupport.unpark(thread)激活AQS队列里面最早被阻塞的线程(thread)。 被激活的线程则会使用tryAcquire尝试看当前状态变量state的值是否满足自己的需要,满足则该线程被激活,然后继续向下运行,否则还是会被放入AQS队列并被挂起。 public final boolean release(int arg) { if (tryRelease(arg)) { Node h = head; if (h != null && h.waitStatus != 0) unparkSuccessor(h); return true; } return false; } 这里需要注意的是AQS类并没有提供可用的tryAcquire 和 tryRelease,正如AQS是锁阻塞和同步容器的基础框架,是抽象类,tryAcquire和 tryRelease 需要有具体的子类来实现的。 子类在实现tryAcquire 和 tryRelease 时候要根据具体场景使用CAS算法尝试修改该状态值state,成功则返回true,否则返回false。子类还需要定义在调用acquire 和 release 方法时候 state 状态值的增减代表什么含义。 比如继承自AQS实现的独占锁ReentrantLock,定义当status为0的时候标示锁空闲,为1 的时候标示锁已经被占用,在重写tryAcquire的时候,内部需要使用CAS算法看当前status是否为0,如果为0 则使用CAS设置为1, 并设置当前线程持有者为当前线程,并返回true,如果CAS失败则返回false。继承自 AQS 实现的独占锁实现 tryRelease 时候,内部需要使用CAS算法把当前status值从1 修改为0,并设置当前锁的持有者为null,然后返回true,如果CAS失败则返回false。 接下来我们看一下共享资模式的获取与释放流程,如下: 1.当前线程调用acquireShared(int arg) 获取共享资源时候,会首先使用tryAcquireShared尝试获取资源,具体是设置状态变量state的值,成功则直接返回。失败则将当前线程封装为类型Node.SHARED 的 Node 节点后插入到 AQS 阻塞队列尾部,并使用 LockSupport.park(this) 挂起当前线程。 public final void acquireShared(int arg) { if (tryAcquireShared(arg) < 0) doAcquireShared(arg); } 2.当一个线程调用 releaseShared(int arg) 时候会尝试使用, tryReleaseShared 操作释放资源,这里是设置状态变量 state 的值,然后使用 LockSupport.unpark(thread)激活 AQS 队列里面最早被阻塞的线程 (thread)。被激活的线程则使用 tryReleaseShared 尝试看当前状态变量 state 的值是否能满足自己的需要, 满足则该线程被激活然后继续向下运行,否者还是会被放入 AQS 队列并被挂起。 public final boolean releaseShared(int arg) { if (tryReleaseShared(arg)) { doReleaseShared(); return true; } return false; } 同理需要注意的 AQS 类并没有提供可用的 tryAcquireShared 和 tryReleaseShared,正如 AQS 是锁阻塞和同步器的基础框架,tryAcquireShared 和 tryReleaseShared 需要有具体的子类来实现。 子类在实现 tryAcquireShared 和 tryReleaseShared 时候要根据具体场景使用 CAS 算法尝试修改状态值 state, 成功则返回 true,否者返回 false。 比如继承自 AQS 实现的读写锁 ReentrantReadWriteLock 里面的读锁在重写 tryAcquireShared 时候,首先看写锁是否被其它线程持有,如果是则直接返回 false,否者使用 CAS 递增 status 的高 16 位,在 ReentrantReadWriteLock 中 status 的高 16 为获取读锁的次数。 继承自 AQS 实现的读写锁 ReentrantReadWriteLock 里面的读锁在重写 tryReleaseShared 时候,内部需要使用 CAS 算法把当前 status 值的高 16 位减一,然后返回 true, 如果 cas 失败则返回 false。 基于 AQS 实现的锁除了需要重写上面介绍的方法,还需要重写 isHeldExclusively 方法用来判断锁是被当前线程独占还是被共享。 接下来我们再看看独占模式和共享模式下获取资源的带有 Interruptibly 关键字的函数 独占模式下的: void acquire(int arg) void acquireInterruptibly(int arg) 共享模式下的: void acquireShared(int arg) void acquireSharedInterruptibly(int arg) 这两套函数都有一个带有Interruptibly 关键字的函数,那么带有这个关键字的和不带有什么区别呢? 其实不带Interruptibly关键字的方法是不对中断进行响应,也就是线程在调用不带Interruptibly关键字的方法在获取资源的时候或者获取资源失败被挂起的时候,其他线程中断了该线程,那么改线程不会因为被中断而抛出异常, 还是继续获取资源或者不被挂起,也就是不对中断进行响应,忽略中断。 带Interruptibly关键字的方法是对中断进行响应,也就是说线程在调用带Interruptibly关键字的方法在获取资源的时候或者获取资源失败被挂起的时候,其他线程中断了该线程,那么该线程会抛出InterruptedException 异常而返回。 那么我要思考一下,AQS提供的队列是如何维护的呢? 我们主要看入队操作:当一个线程获取锁失败后,该线程会被转换为Node节点,然后就会使用enq(final Node node)方法插入该节点到AQS的阻塞队列,源码如下: private Node enq(final Node node) { for (;;) { Node t = tail;//(1) if (t == null) { // Must initialize if (compareAndSetHead(new Node()))//(2) tail = head; } else { node.prev = t;//(3) if (compareAndSetTail(t, node)) {//(4) t.next = node; return t; } } } } 源码程序逻辑的节点图如下: 结合上图和上面的源码,如上代码,第一次循环当要在AQS 队列尾部插入元素时候,AQS队列状态为图(default),也就是队列头尾节点都指向null; 当执行代码(1)后,节点 t 指向了尾部节点,这时候队列如图(1)。 可知这时候 t 为 null,则执行代码(2)使用 CAS 算法设置一个哨兵节点为头结点,如果 CAS 设置成功,然后让尾部节点也指向哨兵节点,这时候队列状态如图(II)。 到现在只是插入了一个哨兵节点,还需要插入的 node 节点,所以第二次循环后执行到步骤(1),这时候队列状态如图(III); 然后执行代码(3)设置 node 的前驱节点为尾部节点,这时候队列状态图如图(IV);然后通过 CAS 算法设置 node 节点为尾部节点,CAS 成功后队列状态图为(V); CAS 成功后在设置原来的尾部节点的后驱节点为 node, 这时候就完成了双向链表的插入了,这时候队列状态为图(VI)。 AQS —— 条件变量的支持 notify 和 wait 是配合 synchronized 内置锁实现线程间同步基础设施,条件变量的 signal 和 await 方法是用来配合锁(使用 AQS 实现的锁)实现线程间同步的基础设施。 调用共享变量的 notify 和 wait 方法前必须先获取该共享变量的内置锁,同理在调用条件变量的 signal 和 await 方法前必须先获取条件变量对应的锁。 那么什么是条件变量呢?如何使用呢?下面看一个例子,代码如下: ReentrantLock lock = new ReentrantLock();//(1) Condition condition = lock.newCondition();//(2) lock.lock();//(3) try { System.out.println("begin wait"); condition.await();//(4) System.out.println("end wait"); } catch (Exception e) { e.printStackTrace(); } finally { lock.unlock();//(5) }lock.lock();//(6) try { System.out.println("begin signal"); condition.signal();//(7) System.out.println("end signal"); } catch (Exception e) { e.printStackTrace(); } finally { lock.unlock();//(8) } 代码(1)创建了一个独占锁 ReentrantLock 的对象,ReentrantLock 是基于 AQS 实现的锁。 代码(2)使用创建的 lock 对象的 newCondition()方法创建了一个 ConditionObject 变量,这个变量就是 lock 锁对应的一个条件变量。需要注意的是一个 Lock 对象可以创建多个条件变量。 代码(3)首先获取了独占锁,代码(4) 则调用了条件变量的 await()方法阻塞挂起了当前线程,当其它线程调用了条件变量的 signal 方法时候,被阻塞的线程才会从 await 处返回,需要注意的是和调用 Object 的 wait 方法一样, 如果在没有获取到锁前调用了条件变量的 await 方法会抛出 java.lang.IllegalMonitorStateException 异常。 代码(5) 则释放了获取的锁。 其实这里的lock对象等价于synchronized 加上共享变量,当调用lock.lock()方法就相当于进入了 synchronized 块(获取了共享变量的内置锁),当调用 lock.unLock() 方法时候就相当于退出了 synchronized 块。 当调用条件变量的 await() 方法时候就相当于调用了共享变量的 wait() 方法,当调用了条件变量的 signal 方法时候就相当于调用了共享变量的 notify() 方法。当调用了条件变量的 signalAll()方法时候就相当于调用了共享变量的 notifyAll() 方法。 到这里对条件变量有了一定的认识了,上面通过lock.newCondition() 作用其实是new 了一个AQS内部声明的ConditionObject对象,如一开始所看到的类图,ConditionObject 是AQS的内部类,可以访问到AQS内部的变量(例如状态变量 status 变量)和方法。 对应每个条件变量的内部维护了一个条件队列,用来存放当调用条件变量的await()方法被阻塞的线程。注意这个条件队列和AQS队列不是一回事。 如下代码,当线程调用了条件变量的await()方法时候(事先必须先调用了锁的 lock() 方法获取锁),内部会构造一个类型为Node.CONDITION 的 node 节点,然后插入该节点到条件队列末尾,然后当前线程会释放获取的锁(也就是会操作锁对应的 status 变量的值),并被阻塞挂起。 这时候如果有其他线程调用了lock.lock() 尝试获取锁时候,就会有一个线程获取到锁,如果获取到锁的线程有调用了条件变量的await()方法,则该线程也会被放入条件变量的阻塞队列,然后释放获取到的锁,阻塞到await()方法处。 源码如下: public final void await() throws InterruptedException { if (Thread.interrupted()) throw new InterruptedException(); //创建新的node,并插入到条件队列末尾(9) Node node = addConditionWaiter(); //释放当前线程获取的锁(10) int savedState = fullyRelease(node); int interruptMode = 0; //调用park方法阻塞挂起当前线程(11) while (!isOnSyncQueue(node)) { LockSupport.park(this); if ((interruptMode = checkInterruptWhileWaiting(node)) != 0) break; } ... } 如下代码,当另外一个线程调用了条件变量的signal方法的时候(事先必须先调用了锁的 lock() 方法获取锁),内部会把条件队列里面队头的一个线程节点从条件队列里面移除后放入到AQS的阻塞队列里面,然后激活该线程。 public final void signal() { if (!isHeldExclusively())throw new IllegalMonitorStateException(); Node first = firstWaiter; if (first != null) //移动条件队列队头元素到AQS队列 doSignal(first); } 需要注意的是AQS只提供了ConditionObject 的实现,并没有提供 newCondition 函数来 new 一个 ConditionObject 对象,需要由 AQS 的子类来提供 newCondition 函数。 接下来我们要看一下当一个线程调用条件变量的 await() 方法被阻塞后,如何放入的条件队列。源码如下:‘ private Node addConditionWaiter() { Node t = lastWaiter; ... //(1) Node node = new Node(Thread.currentThread(), Node.CONDITION); //(2) if (t == null) firstWaiter = node; else t.nextWaiter = node;//(3) lastWaiter = node;//(4) return node; } 如上代码(1)首先根据当前线程创建了一个类型为Node.CONDITION 的节点,然后通过步骤(2)(3)(4)在单向条件队列尾部插入一个元素。 最后注意如下几点: 1.当多个线程同时调用 lock.lock() 获取锁的时候,同时只有一个线程获取到了该锁,其他线程会被转换为 Node 节点插入到 lock 锁对应的 AQS 阻塞队列里面,并做自旋 CAS 尝试获取锁; 2.如果获取到锁的线程又调用了对应的条件变量的 await() 方法,则该线程会释放获取到的锁,并被转换为 Node 节点插入到条件变量对应的条件队列里面; 3.这时候因为调用 lock.lock() 方法被阻塞到 AQS 队列里面的一个线程会获取到被释放的锁,如果该线程也调用了条件变量的 await()方法则该线程也会被放入条件变量的条件队列。 4.当另外一个线程调用了条件变量的 signal() 或者 signalAll() 方法时候,会把条件队列里面的一个或者全部 Node 节点移动到 AQS 的阻塞队列里面,等待时机获取锁。 如下图: 如上图可以看到,一个锁对应有一个 AQS 阻塞队列,对应多个条件变量,每个条件变量有自己的一个条件队列。

优秀的个人博客,低调大师

Java并发编程笔记之CopyOnWriteArrayList源码分析

并发包中并发List只有CopyOnWriteArrayList这一个,CopyOnWriteArrayList是一个线程安全的ArrayList,对其进行修改操作和元素迭代操作都是在底层创建一个拷贝数组(快照)上进行的,也就是写时拷贝策略。 我们首先看一下CopyOnWriteArrayList的类图有哪些属性和方法,如下图所示: 如上,CopyOnWriteArrayList的类图,每个CopyOnWriteArrayList对象里面有一个array数组对象用来存放具体元素,ReentrantLock独占锁对象用来保证同时只有一个线程对array进行修改,这里只要记得ReentrantLock是独占锁,同时只有一个线程可以获取就可以了。 那么问题来了,如果让我们自己去做一个写时拷贝的线程安全的List,我们会怎么做,要考虑哪些要点? 1.list何时初始化,初始化list元素个数为多少,list是有限大小? 2.如何保证线程安全,比如多个线程进行读写时候,如果保证是线程安全的? 3.如何使用迭代器遍历list时候的数据一致性? 那么我们就进入CopyOnWriteArrayList源码去看,看看设计者是如何处理的。 CopyOnWriteArrayList源码分离如下: 1.初始化,首先看一下CopyOnWriteArrayList的无参构造函数,如下代码内部创建了一个大小为0的Object数据作为array的初始值。源码如下: public CopyOnWriteArrayList() { setArray(new Object[0]); } 接下来再看看CopyOnWriteArrayList的有参构造函数,源码如下: //创建一个list,其内部元素是入参toCopyIn的拷贝 public CopyOnWriteArrayList(E[] toCopyIn) { setArray(Arrays.copyOf(toCopyIn, toCopyIn.length, Object[].class)); } //入参为集合,拷贝集合里面元素到本list public CopyOnWriteArrayList(Collection<? extends E> c) { Object[] elements; if (c.getClass() == CopyOnWriteArrayList.class) elements = ((CopyOnWriteArrayList<?>)c).getArray(); else { elements = c.toArray(); // c.toArray might (incorrectly) not return Object[] (see 6260652) if (elements.getClass() != Object[].class) elements = Arrays.copyOf(elements, elements.length, Object[].class); } setArray(elements); } 2.添加元素,CopyOnWriteArrayList中添加元素函数有add(E e),add(int index , E element),addIfAbsent(E e),addAllAbsent(Collection<? extends E> c)等操作,原理一致, 接下来就以add(E e)进行讲解。源码如下: public boolean add(E e) { //加独占锁(1) final ReentrantLock lock = this.lock; lock.lock(); try { //获取array(2) Object[] elements = getArray(); //拷贝array到新数组,添加元素到新数组(3) int len = elements.length; Object[] newElements = Arrays.copyOf(elements, len + 1); newElements[len] = e; //使用新数组替换添加前的数组(4) setArray(newElements); return true; } finally { //释放独占锁(5) lock.unlock(); } } 如上代码,调用add方法的线程会首先执行代码(1)去获取独占锁,如果多个线程都调用add则只有一个线程会获取该锁,其他线程会被阻塞挂起知道锁被释放。所以一个线程获取到锁后,就保证了在该线程添加元素过程中,其他线程不会对array进行修改。 线程获取锁后执行代码(2)获取array,然后执行代码(3)拷贝array到一个新数组(从这里可以知道新数组的大小是原来数组大小加增加1,所以CopyOnWriteArrayList是无界List),并把要新增的元素添加到新数组。 然后执行到代码(4)把新数组替换原数组,然后返回前要释放锁,由于加了锁,所以整个add过程是个原子操作,需要注意的是添加元素时候首先是拷贝了一个快照,然后在快照上进行的添加,而不是直接在源来的数组上进行。 3.获取指定位置元素,E get(int index)获取下标为index的元素,如果元素不存在会抛出IndexOutOfBoundsException 异常,源码如下: public E get(int index) { return get(getArray(), index); } final Object[] getArray() { return array; } private E get(Object[] a, int index) { return (E) a[index]; } } 如上代码,获取指定位置的元素分为两步,首先获取到当前list里面的array数组,这里称为步骤1,然后通过随机访问的下标方式访问指定位置的元素,这里称为步骤2。 从代码中可以看到整个过程并没有加锁,这就可能会导致当执行完步骤1后执行步骤2前,另外一个线程C进行了修改操作,比如remove操作,就会进行写时拷贝删除当前get方法要访问的元素,并且修改当前list的array为新数组。 而这之后步骤2 可能才开始执行,步骤2操作的是线程C删除元素前的一个快照数组(因为步骤1让array指向的是原来的数组),所以虽然线程C已经删除了index处的元素,但是步骤2还是返回index处的元素,这其实就是写时拷贝策略带来弱一致性。 4.修改指定元素,修改 list 中指定元素的值,如果指定位置的元素不存在则抛出 IndexOutOfBoundsException 异常,源码码如下: public E set(int index, E element) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); E oldValue = get(elements, index); if (oldValue != element) { int len = elements.length; Object[] newElements = Arrays.copyOf(elements, len); newElements[index] = element; setArray(newElements); } else { // Not quite a no-op; ensures volatile write semantics setArray(elements); } return oldValue; } finally { lock.unlock(); } } 如上代码,首先获取了独占锁控制了其他线程对array数组的修改,然后获取当前数组,并调用get方法获取指定位置元素。 如果指定的位置元素与新值不一致则创建新数组并拷贝元素,在新数组上修改指定位置元素值并设置新数组到array。 如果指定位置元素与新值一样,则为了保障volatile语义,还是需要重新设置下array,虽然array内容并没有改变(为了保证 volatile 语义是考虑到 set 方法本身应该提供 volatile 的语义). 5.删除元素,删除list里面指定的元素,主要的方法有如下方法: E remove(int index) boolean remove(Object o) boolean remove(Object o, Object[] snapshot, int index) 等方法,原理一致,这里讲解下 remove(int index) 方法,源码如下: public E remove(int index) { //获取独占锁 final ReentrantLock lock = this.lock; lock.lock(); try { //获取数组 Object[] elements = getArray(); int len = elements.length; //获取指定元素 E oldValue = get(elements, index); int numMoved = len - index - 1; //如果要删除的是最后一个元素 if (numMoved == 0) setArray(Arrays.copyOf(elements, len - 1)); else { //分两次拷贝除删除后的元素到新数组 Object[] newElements = new Object[len - 1]; System.arraycopy(elements, 0, newElements, 0, index); System.arraycopy(elements, index + 1, newElements, index, numMoved); //使用新数组代替老的 setArray(newElements); } return oldValue; } finally { //释放锁 lock.unlock(); } } 正如上面代码所示,其实和新增元素时候是类似的,首先是获取独占锁保证删除数组期间,其他线程不能对array进行修改,然后获取数组中要给删除的元素,并把剩余的原始拷贝到新数组后,把新数组替换原来的数组,最后在返回前释放锁。 6.接下来要讲解一下弱一致性的迭代器。 遍历列表元素可以使用迭代器进行迭代操作,讲解什么是迭代器的弱一致性前先上一个例子说明下迭代器的使用。代码如下: import java.util.concurrent.CopyOnWriteArrayList; /** * Created by cong on 2018/6/9. */ public class CopyOnWriteArrayListTest { public static void main( String[] args ) { CopyOnWriteArrayList<String> arrayList = new CopyOnWriteArrayList<>(); arrayList.add("hello"); arrayList.add("java"); Iterator<String> itr = arrayList.iterator(); while(itr.hasNext()){ System.out.println(itr.next()); } } } 运行结果如下: 其中迭代器的hasNext方法用来判断是否还有元素,next方法则是具体返回元素。那么接下来看CopyOnWriteArrayList中迭代器是弱一致性,所谓弱一致性是指返回迭代器后,其他线程对list的增删改对迭代器不可见,无感知的,那么下面就看看是如何做到的。源码如下: public Iterator<E> iterator() { return new COWIterator<E>(getArray(), 0); } static final class COWIterator<E> implements ListIterator<E> { //array的快照版本 private final Object[] snapshot; //数组下标 private int cursor; //构造函数 private COWIterator(Object[] elements, int initialCursor) { cursor = initialCursor; snapshot = elements; } //是否遍历结束 public boolean hasNext() { return cursor < snapshot.length; } //获取元素 public E next() { if (! hasNext()) throw new NoSuchElementException(); return (E) snapshot[cursor++]; } } 如上代码当调用iterator()方法获取迭代器时候实际是返回一个COWIterator对象,COWIterator的snapshot变量保存了当前list的内容,cursor是遍历list数据的下标。 这里为什么说snapshot是list的快照呢?明明是指针传递的引用,而不是拷贝。如果在该线程使用返回的迭代器遍历元素的过程中,其他线程没有对list进行增删改,那么snapshot本身就是list的array,因为它们是引用关系。 但是如果遍历期间,有其他线程对该list进行了增删改,那么snapshot就是快照了,因为增删改后list里面的数组被新数组替换了,这时候老数组只有被snapshot索引用,所以这也就说明获取迭代器后,使用改迭代器进行变量元素时候,其它线程对该list进行的增删改是不可见的, 因为它们操作的是两个不同的数组,这也就是弱一致性的达成。 下面通过一个例子来演示多线程下,迭代器的弱一致性的效果:代码如下: import java.util.Iterator; import java.util.concurrent.CopyOnWriteArrayList; /** * Created by cong on 2018/6/9. */ public class CopyOnWriteArrayListTest { private static volatile CopyOnWriteArrayList<String> arrayList = new CopyOnWriteArrayList<>(); public static void main( String[] args ) throws InterruptedException { arrayList.add("hello"); arrayList.add("Java"); arrayList.add("welcome"); arrayList.add("to"); arrayList.add("hangzhou"); Thread threadOne = new Thread(new Runnable() { @Override public void run() { //修改list中下标为1的元素为JavaSe arrayList.set(1, "JavaSe"); //删除元素 arrayList.remove(2); arrayList.remove(3); } }); //保证在修改线程启动前获取迭代器 Iterator<String> itr = arrayList.iterator(); //启动线程 threadOne.start(); //等在子线程执行完毕 threadOne.join(); //迭代元素 while(itr.hasNext()){ System.out.println(itr.next()); } } } 运行结果如下: 如上代码main函数首先初始化了arrayList,然后在启动线程前获取到了arrayList迭代器,子线程ThreadOne启动后首先修改了arrayList第一个元素的值,然后删除了arrayList中坐标为2,3 的元素。 主线程等待子线程执行完毕后使用获取的迭代器遍历数组元素,从打印的结果来看,子线程里面进行的操纵是一个都没有生效,这就是迭代器的弱一致性的效果,需要注意的是获取迭代器必须在子线程操作之前进行。 注意:CopyOnWriteArrayList使用写时拷贝的策略来保证list的一致性,而获取-拷贝-写入 三步并不是原子性的,所以在修改增删改的过程中都是用了独占锁,并保证了同时只有一个线程才能对list数组进行修改。 另外CopyOnWriteArrayList提供了弱一致性的迭代器,保证在获取迭代器后,其他线程对list的修改该不可见,迭代器遍历时候的数组是获取迭代器时候的一个快照,另外并发包中CopyOnWriteArraySet 底层就是使用它进行实现,感兴趣的可以去翻翻看。

优秀的个人博客,低调大师

Java并发编程笔记之ThreadLocalRandom源码分析

JDK 并发包中 ThreadLocalRandom 类原理剖析,经常使用的随机数生成器 Random 类的原理是什么?及其局限性是什么?ThreadLocalRandom 是如何利用 ThreadLocal 的原理来解决 Random 的局限性? 我们首先看Random 类及其局限性,如下: 在 JDK7 之前包括现在,java.util.Random 应该是使用比较广泛的随机数生成工具类,另外 java.lang.Math 中的随机数生成也是使用的 java.util.Random 的实例。下面先看看 java.util.Random 的使用例子如下: /** * Created by cong on 2018/6/4. */ public class RandomTest { public static void main(String[] args) { //(1)创建一个默认种子的随机数生成器 Random random = new Random(); //(2)输出10个在0-5(包含0,不包含5)之间的随机数 for (int i = 0; i < 10; ++i) { System.out.println(random.nextInt(5)); } } } 代码(1)创建一个默认随机数生成器,使用默认的种子。 代码(2)输出输出10个在0-5(包含0,不包含5)之间的随机数。 运行结果如下: 这里提下随机数的生成需要一个默认的种子,这个种子实际上就是是一个 long 类型的数字,这个种子要么在 Random 的时候通过构造函数指定,那么默认构造函数内部会生成一个默认的值,问题来了,有了默认的种子后,如何生成随机数呢? 我们进入Radom类里面去看nextInt方法的源码,如下: public int nextInt(int var1) { //(3)参数校验 if(var1 <= 0) { throw new IllegalArgumentException("bound must be positive"); } else { //(4)根据老的种子生成心的种子 int var2 = this.next(31); //(5)以下根据新的种子计算随机数 int var3 = var1 - 1; if((var1 & var3) == 0) { var2 = (int)((long)var1 * (long)var2 >> 31); } else { for(int var4 = var2; var4 - (var2 = var4 % var1) + var3 < 0; var4 = this.next(31)) { ; } } return var2; } } 可以看到上面代码可知新的随机数的生成需要两个步骤: 1.首先需要根据老的种子生成新的种子。 2.然后根据新的种子来计算新的随机数。 其中步骤(4)我们可以抽象为 seed=f(seed),其中 f 是一个固定的函数,比如seed= f(seed)=a*seed+b;, 步骤(5)也可以抽象为 g(seed,bound),其中 g 是一个固定的函数,比如g(seed,bound)=(int)((bound * (long)seed) >> 31);。在单线程情况下每次调用 nextInt 都是根据老的种子计算出来新的种子,这是可以保证随机数产生的随机性的。 但是在多线程下多个线程可能都拿同一个老的种子去执行步骤(4)计算新的种子,这会导致多个线程产生的新种子是一样的,由于步骤(5)算法是固定的,所以会导致多个线程产生相同的随机值,这并不是我们想要的。 所以需要保证步骤(4)的原子性,也就是说多个线程在根据同一个老种子计算新种子时候,第一个线程的新种子计算出来后,第二个线程要丢弃自己老的种子,要使用第一个线程的新种子来计算自己的新种子,依次类推,只有保证了这个,才能保证多线程下产生的随机数是随机的。 Random 函数使用一个原子变量达到了这个效果,在创建 Random 对象时候初始化的种子就保存到了种子原子变量里面,下面看下 next() 的源码: protected int next(int bits) { long oldseed, nextseed; AtomicLong seed = this.seed; do { //(6) oldseed = seed.get(); //(7) nextseed = (oldseed * multiplier + addend) & mask; //(8) } while (!seed.compareAndSet(oldseed, nextseed)); //(9) return (int)(nextseed >>> (48 - bits)); } 代码(6)获取当前原子变量种子的值; 代码(7)根据当前种子值计算新的种子; 代码(8)使用 CAS 操作,使用新的种子去更新老的种子,多线程下可能多个线程都同时执行到了代码(6),那么可能多个线程都拿到的当前种子的值是同一个,然后执行步骤(7)计算的新种子也都是一样的,但是步骤(8)的 CAS 操作会保证只有一个线程可以更新老的种子为新的, 失败的线程会通过循环重新获取更新后的种子作为当前种子去计算老的种子,可见这里解决了上面提到的问题,也就保证了随机数的随机性。 代码(9)则使用固定算法根据新的种子计算随机数。 因此,每个 Random 实例里面有一个原子性的种子变量用来记录当前的种子的值,当要生成新的随机数时候要根据当前种子计算新的种子并更新回原子变量。多线程下使用单个 Random 实例生成随机数时候,多个线程同时计算新的种子时候会竞争同一个原子变量的更新操作,、 由于原子变量的更新是 CAS 操作,同时只有一个线程会成功,所以会造成大量线程进行自旋重试,这是会降低并发性能的,所以 ThreadLocalRandom 应运而生。 为了解决多线程高并发下 Random 的缺陷,JUC 包下新增了 ThreadLocalRandom 类。我首先先看ThreadLocalRandom的原理,如下图: 接着我们再看一下ThreadLocalRandom 的类图结构,如下图: 可知 ThreadLocalRandom 继承了 Random 并重写了 nextInt 方法,ThreadLocalRandom 中并没有使用继承自 Random 的原子性种子变量。 ThreadLocalRandom 中并没有具体存放种子,具体的种子是存放到具体的调用线程的 threadLocalRandomSeed 变量里面的,ThreadLocalRandom 类似于 ThreadLocal类 就是个工具类。 当线程调用 ThreadLocalRandom 的 current 方法时候 ThreadLocalRandom 负责初始化调用线程的 threadLocalRandomSeed 变量,也就是初始化种子。 当调用 ThreadLocalRandom 的 nextInt 方法时候,实际上是获取当前线程的 threadLocalRandomSeed 变量作为当前种子来计算新的种子,然后更新新的种子到当前线程的 threadLocalRandomSeed 变量,然后在根据新种子和具体算法计算随机数。 这里需要注意的是 threadLocalRandomSeed 变量就是 Thread 类里面的一个普通 long 变量,并不是原子性变量,其实道理很简单,因为这个变量是线程级别的,根本不需要使用原子性变量,如果还是不理解可以思考下 ThreadLocal 的原理。 其中变量 seeder 和 probeGenerator 是两个原子性变量,在初始化调用线程的种子和探针变量时候用到,每个线程只会使用一次。 另外变量 instance 是个 ThreadLocalRandom 的一个实例,该变量是 static 的,当多线程通过 ThreadLocalRandom 的 current 方法获取 ThreadLocalRandom 的实例时候其实获取的是同一个,但是由于具体的种子是存放到线程里面的, 所以 ThreadLocalRandom 的实例里面只是与线程无关的通用算法,所以是线程安全的。 接下来进入ThreadLocalRandom 的主要代码实现逻辑,如下: 首先是Unsafe机制的使用,具体以后再讲。如下源码: private static final sun.misc.Unsafe UNSAFE; private static final long SEED; private static final long PROBE; private static final long SECONDARY; static { try { //获取unsafe实例 UNSAFE = sun.misc.Unsafe.getUnsafe(); Class<?> tk = Thread.class; //获取Thread类里面threadLocalRandomSeed变量在Thread实例里面偏移量 SEED = UNSAFE.objectFieldOffset (tk.getDeclaredField("threadLocalRandomSeed")); //获取Thread类里面threadLocalRandomProbe变量在Thread实例里面偏移量 PROBE = UNSAFE.objectFieldOffset (tk.getDeclaredField("threadLocalRandomProbe")); //获取Thread类里面threadLocalRandomProbe变量在Thread实例里面偏移量,这个值在后面讲解的LongAdder里面会用到 SECONDARY = UNSAFE.objectFieldOffset (tk.getDeclaredField("threadLocalRandomSecondarySeed")); } catch (Exception e) { throw new Error(e); } } ThreadLocalRandom current() 方法:该方法获取 ThreadLocalRandom 实例,并初始化调用线程中 threadLocalRandomSeed 和 threadLocalRandomProbe 变量。源码如下: static final ThreadLocalRandom instance = new ThreadLocalRandom(); public static ThreadLocalRandom current() { //(12) if (UNSAFE.getInt(Thread.currentThread(), PROBE) == 0) //(13) localInit(); //(14) return instance; } static final void localInit() { int p = probeGenerator.addAndGet(PROBE_INCREMENT); int probe = (p == 0) ? 1 : p; // skip 0 long seed = mix64(seeder.getAndAdd(SEEDER_INCREMENT)); Thread t = Thread.currentThread(); UNSAFE.putLong(t, SEED, seed); UNSAFE.putInt(t, PROBE, probe); } 代码(12)如果当前线程中 threadLocalRandomProbe 变量值为0(默认情况下线程的这个变量为0),说明当前线程第一次调用 ThreadLocalRandom 的 current 方法,那么就需要调用 localInit 方法计算当前线程的初始化种子变量。这里设计为了延迟初始化, 不需要使用随机数功能时候 Thread 类中的种子变量就不需要被初始化,这是一种优化。 代码(13)首先计算根据 probeGenerator 计算当前线程中 threadLocalRandomProbe 的初始化值,然后根据 seeder 计算当前线程的初始化种子,然后把这两个变量设置到当前线程。 代码(14)返回 ThreadLocalRandom 的实例,需要注意的是这个方法是静态方法,多个线程返回的是同一个 ThreadLocalRandom 实例。 int nextInt(int bound) 方法:计算当前线程的下一个随机数。源码如下图所示: public int nextInt(int bound) { //(15)参数校验 if (bound <= 0) throw new IllegalArgumentException(BadBound); //(16) 根据当前线程中种子计算新种子 int r = mix32(nextSeed()); //(17)根据新种子和bound计算随机数 int m = bound - 1; if ((bound & m) == 0) // power of two r &= m; else { // reject over-represented candidates for (int u = r >>> 1; u + m - (r = u % bound) < 0; u = mix32(nextSeed()) >>> 1) ; } return r; } 可以看到上面代码逻辑步骤与 Random 相似,我们重点看下 nextSeed() 方法: final long nextSeed() { Thread t; long r; // UNSAFE.putLong(t = Thread.currentThread(), SEED,r = UNSAFE.getLong(t, SEED) + GAMMA); return r; } 如上代码首先使用 r = UNSAFE.getLong(t, SEED) 获取当前线程中 threadLocalRandomSeed 变量的值,然后在种子的基础上累加 GAMMA 值作为新种子,然后使用 UNSAFE 的 putLong 方法把新种子放入当前线程的 threadLocalRandomSeed 变量。 理论知道了,那么现在用一个例子来讲解ThreadLocalRandom如何使用,例子如下: public class RandomTest { public static void main(String[] args) { //(10)获取一个随机数生成器 ThreadLocalRandom random = ThreadLocalRandom.current(); //(11)输出10个在0-5(包含0,不包含5)之间的随机数 for (int i = 0; i < 10; ++i) { System.out.println(random.nextInt(5)); } } } 运行结果如下: 如上代码(10)调用 ThreadLocalRandom.current() 来获取当前线程的随机数生成器。 ThreadLocal 的出现就是为了解决多线程下变量的隔离问题,让每一个线程拷贝一份变量,每个线程对变量进行操作时候实际是操作自己本地内存里面的拷贝。 实际上 ThreadLocalRandom 的实现也是这个原理,Random 的缺点是多个线程会使用原子性种子变量,会导致对原子变量更新的竞争,如下图: 如果每个线程维护自己的一个种子变量,每个线程生成随机数时候根据自己老的种子计算新的种子,并使用新种子更新老的种子,然后根据新种子计算随机数,就不会存在竞争问题,这会大大提高并发性能。这就是ThreadLocalRandom使用ThreadLocal的原理的独到之处。 到目前为止,我们知道了 Random 的实现原理以及介绍了 Random 在多线程下存在竞争种子原子变量更新操作失败后自旋等待的缺点,从而引出 ThreadLocalRandom 类,ThreadLocalRandom 使用 ThreadLocal 的原理,让每个线程内持有一个本地的种子变量, 该种子变量只有在使用随机数时候才会被初始化,多线程下计算新种子时候是根据自己线程内维护的种子变量进行更新,从而避免了竞争。

优秀的个人博客,低调大师

Java并发编程笔记之ThreadLocal源码分析

多线程的线程安全问题是微妙而且出乎意料的,因为在没有进行适当同步的情况下多线程中各个操作的顺序是不可预期的,多线程访问同一个共享变量特别容易出现并发问题,特别是多个线程需要对一个共享变量进行写入时候,为了保证线程安全, 一般需要使用者在访问共享变量的时候进行适当的同步,如下图所示: 可以看到同步的措施一般是加锁,这就需要使用者对锁也要有一定了解,这显然加重了使用者的负担。那么有没有一种方式当创建一个变量的时候,每个线程对其进行访问的时候访问的是自己线程的变量呢?其实ThreaLocal就可以做这个事情,注意一下,ThreadLocal的出现并不是为了解决上面的问题而出现的。 ThreadLocal是在JDK包里面提供的,它提供了线程本地变量,也就是如果你创建了一个ThreadLocal变量,那么访问这个变量的每个线程都会有这个变量的本地拷贝,多个线程操作这个变量的时候,实际是操作自己本地内存里面的变量,从而避免了线程安全问题,创建一个ThreadLocal变量后, 每个线程会拷贝一个变量到自己的本地内存,如下图: 好了,现在我们思考一个问题:ThreadLocal的实现原理,ThreadLocal作为变量的线程隔离方式,其内部又是如何实现的呢? 首先我们要看ThreadLocal的类图结构,如下图所示: 如上类图可见,Thread类中有一个threadLocals和inheritableThreadLocals 都是ThreadLocalMap类型的变量,而ThreadLocalMap是一个定制化的Hashmap,默认每个线程中这两个变量都为null,只有当线程第一次调用了ThreadLocal的set或者get方法的时候才会创建。 其实每个线程的本地变量不是存到ThreadLocal实例里面的,而是存放到调用线程的threadLocals变量里面。也就是说ThreadLocal类型的本地变量是存放到具体线程内存空间的。 ThreadLocal其实就是一个外壳,它通过set方法把value值放入调用线程threadLocals里面存放起来,当调用线程调用它的get方法的时候再从当前线程的threadLocals变量里面拿出来使用。如果调用线程如果一直不终止的话,那么这个本地变量会一直存放到调用线程的threadLocals变量里面, 因此,当不需要使用本地变量时候可以通过调用ThreadLocal变量的remove方法,从当前线程的threadLocals变量里面删除该本地变量。可能还有人会问threadLocals为什么设计为Map结构呢?很明显是因为每个线程里面可以关联多个ThreadLocal变量。 接下来我们可以进入到ThreadLocal中的源码如看看,如下代码所示: 主要看set,get,remove这三个方法的实现逻辑,如下: 先看set(T var1)方法 public void set(T var1) { //(1)获取当前线程 Thread var2 = Thread.currentThread(); //(2) 当前线程作为key,去查找对应的线程变量,找到则设置 ThreadLocal.ThreadLocalMap var3 = this.getMap(var2); if(var3 != null) { var3.set(this, var1); } else { //(3) 第一次调用则创建当前线程对应的Hashmap this.createMap(var2, var1); } } 如上代码(1)首先获取调用线程,然后使用当前线程作为参数调用了 getMap(var2) 方法,getMap(Thread var2) 代码如下: ThreadLocal.ThreadLocalMap getMap(Thread var1) { return var1.threadLocals; } 可知getMap(var2) 所作的就是获取线程自己的变量threadLocals,threadlocal变量是绑定到了线程的成员变量里面。 如果getMap(var2) 返回不为空,则把 value 值设置进入到 threadLocals,也就是把当前变量值放入了当前线程的内存变量 threadLocals,threadLocals 是个 HashMap 结构,其中 key 就是当前 ThreadLocal 的实例对象引用,value 是通过 set 方法传递的值。 如果 getMap(var2) 返回空那说明是第一次调用 set 方法,则创建当前线程的 threadLocals 变量,下面看 createMap(var2, var1) 里面做了啥呢? void createMap(Thread var1, T var2) { var1.threadLocals = new ThreadLocal.ThreadLocalMap(this, var2); } 可以看到的就是创建当前线程的threadLocals变量。 接下来我们再看get()方法,代码如下: public T get() { //(4)获取当前线程 Thread var1 = Thread.currentThread(); //(5)获取当前线程的threadLocals变量 ThreadLocal.ThreadLocalMap var2 = this.getMap(var1); //(6)如果threadLocals不为null,则返回对应本地变量值 if(var2 != null) { ThreadLocal.ThreadLocalMap.Entry var3 = var2.getEntry(this); if(var3 != null) { Object var4 = var3.value; return var4; } } //(7)threadLocals为空则初始化当前线程的threadLocals成员变量。 return this.setInitialValue(); } 代码(4)首先获取当前线程实例,如果当前线程的threadLocals变量不为null则直接返回当前线程的本地变量。否则执行代码(7)进行初始化,setInitialValue()的代码如下: private T setInitialValue() { //(8)初始化为null Object var1 = this.initialValue(); Thread var2 = Thread.currentThread(); ThreadLocal.ThreadLocalMap var3 = this.getMap(var2); //(9)如果当前线程变量的threadLocals变量不为空 if(var3 != null) { var3.set(this, var1); //(10)如果当前线程的threadLocals变量为空 } else { this.createMap(var2, var1); } return var1; } 如上代码如果当前线程的 threadLocals 变量不为空,则设置当前线程的本地变量值为 null,否者调用 createMap 创建当前线程的 createMap 变量。 接着我们在看看void remove()方法,代码如下: public void remove() { ThreadLocal.ThreadLocalMap var1 = this.getMap(Thread.currentThread()); if(var1 != null) { var1.remove(this); } } 如上代码,如果当前线程的 threadLocals 变量不为空,则删除当前线程中指定 ThreadLocal 实例的本地变量。 接下来我们看看具体演示demo,代码如下: /** * Created by cong on 2018/6/3. */ public class ThreadLocalTest { //(1)打印函数 static void print(String str) { //1.1 打印当前线程本地内存中localVariable变量的值 System.out.println(str + ":" + localVariable.get()); //1.2 清除当前线程本地内存中localVariable变量 //localVariable.remove(); } //(2) 创建ThreadLocal变量 static ThreadLocal<String> localVariable = new ThreadLocal<>(); public static void main(String[] args) { //(3) 创建线程one Thread threadOne = new Thread(new Runnable() { public void run() { //3.1 设置线程one中本地变量localVariable的值 localVariable.set("线程1的本地变量"); //3.2 调用打印函数 print("线程1----->"); //3.3打印本地变量值 System.out.println("移除线程1本地变量后的结果" + ":" + localVariable.get()); } }); //(4) 创建线程two Thread threadTwo = new Thread(new Runnable() { public void run() { //4.1 设置线程one中本地变量localVariable的值 localVariable.set("线程2的本地变量"); //4.2 调用打印函数 print("线程2----->"); //4.3打印本地变量值 System.out.println("移除线程2本地变量后的结果" + ":" + localVariable.get()); } }); //(5)启动线程 threadOne.start(); threadTwo.start(); } } 代码(2)创建了一个 ThreadLocal 变量; 代码(3)、(4)分别创建了线程 1和 2; 代码(5)启动了两个线程; 线程 1 中代码 3.1 通过 set 方法设置了 localVariable 的值,这个设置的其实是线程 1 本地内存中的一个拷贝,这个拷贝线程 2 是访问不了的。然后代码 3.2 调用了 print 函数,代码 1.1 通过 get 函数获取了当前线程(线程 1)本地内存中 localVariable 的值; 线程 2 执行类似线程 1。 运行结果如下: 这里要注意一下ThreadLocal的内存泄漏问题 每个线程内部都有一个名字为 threadLocals 的成员变量,该变量类型为 HashMap,其中 key 为我们定义的 ThreadLocal 变量的 this 引用,value 则为我们 set 时候的值,每个线程的本地变量是存到线程自己的内存变量 threadLocals 里面的,如果当前线程一直不消失那么这些本地变量会一直存到, 所以可能会造成内存泄露,所以使用完毕后要记得调用 ThreadLocal 的 remove 方法删除对应线程的 threadLocals 中的本地变量。 解开代码1.2的注释后,再次运行,运行结果如下: 我们有没有想过这样的一个问题:子线程中是否获取到父线程中设置的 ThreadLocal 变量的值呢?InheritableThreadLocal 的实现原理,InheritableThreadLocal 是如何弥补 ThreadLocal 不支持继承的特性? 这里可以告诉大家,在子线程中是获取不到父线程中设置的 ThreadLocal 变量的值的。那么有办法让子线程访问到父线程中的值吗?为了解决该问题 InheritableThreadLocal 应运而生,InheritableThreadLocal 继承自 ThreadLocal,提供了一个特性,就是子线程可以访问到父线程中设置的本地变量。 首先我们先进入InheritableThreadLocal这个类的源码去看,如下: public class InheritableThreadLocal<T> extends ThreadLocal<T> { public InheritableThreadLocal() { } //(1) protected T childValue(T var1) { return var1; } //(2) ThreadLocalMap getMap(Thread var1) { return var1.inheritableThreadLocals; } //(3) void createMap(Thread var1, T var2) { var1.inheritableThreadLocals = new ThreadLocalMap(this, var2); } } 可以看到InheritableThreadlocal继承ThreadLocal,并重写了三个方法,在上面的代码已经标出了。代码(3)可知InheritableThreadLocal重写createMap方法,那么可以知道现在当第一次调用set方法时候创建的是当前线程的inhertableThreadLocals变量的实例,而不再是threadLocals。 代码(2)可以知道当调用get方法获取当前线程的内部map变量时候,获取的是inheritableThreadLocals,而不再是threadLocals。 关键地方来了,重写的代码(1)是何时被执行的,以及如何实现子线程可以访问父线程本地变量的。这个要从Thread创建的代码看起,Thread的默认构造函数以及Thread.java类的构造函数如下: /** * Created by cong on 2018/6/3. */ public Thread(Runnable target) { init(null, target, "Thread-" + nextThreadNum(), 0); } private void init(ThreadGroup g, Runnable target, String name, long stackSize, AccessControlContext acc) { //... //(4)获取当前线程 Thread parent = currentThread(); //... //(5)如果父线程的inheritableThreadLocals变量不为null if (parent.inheritableThreadLocals != null) //(6)设置子线程中的inheritableThreadLocals变量 this.inheritableThreadLocals =ThreadLocal.createInheritedMap(parent.inheritableThreadLocals); this.stackSize = stackSize; tid = nextThreadID(); } 创建线程时候在构造函数里面会调用init方法,前面讲到了inheritableThreadLocal类get,set方法操作的是变量inheritableThreadLocals,所以这里inheritableThreadLocal变量就不为null,所以会执行代码(6),下面看createInheritedMap方法源码,如下: static ThreadLocalMap createInheritedMap(ThreadLocalMap parentMap) { return new ThreadLocalMap(parentMap); } 可以看到createInheritedMap内部使用父线程的inheritableThreadLocals变量作为构造函数创建了一个新的ThreadLocalMap变量,然后赋值给了子线程的inheritableThreadLocals变量,那么接着进入到ThreadLocalMap的构造函数里面做了什么,源码如下: private ThreadLocalMap(ThreadLocalMap parentMap) { Entry[] parentTable = parentMap.table; int len = parentTable.length; setThreshold(len); table = new Entry[len]; for (int j = 0; j < len; j++) { Entry e = parentTable[j]; if (e != null) { @SuppressWarnings("unchecked") ThreadLocal<Object> key = (ThreadLocal<Object>) e.get(); if (key != null) { //(7)调用重写的方法 Object value = key.childValue(e.value);//返回e.value Entry c = new Entry(key, value); int h = key.threadLocalHashCode & (len - 1); while (table[h] != null) h = nextIndex(h, len); table[h] = c; size++; } } } } 如上代码所做的事情就是把父线程的inhertableThreadLocals成员变量的值复制到新的ThreadLocalMap对象,其中代码(7)InheritableThreadLocal类重写的代码(1)也映入眼帘了。 总的来说:InheritableThreadLocal类通过重写代码(2)和(3)让本地变量保存到了具体线程的inheritableThreadLocals变量里面,线程通过InheritableThreadLocal类实例的set 或者 get方法设置变量时候就会创建当前线程的inheritableThreadLocals变量。当父线程创建子线程时候, 构造函数里面就会把父线程中inheritableThreadLocals变量里面的本地变量拷贝一份复制到子线程的inheritableThreadLocals变量里面。 好了原理了解到位了,接下来进行一个例子来验证上面所了解的东西,如下: package com.hjc; /** * Created by cong on 2018/6/3. */ public class InheritableThreadLocalTest { //(1) 创建线程变量 public static ThreadLocal<String> threadLocal = new ThreadLocal<String>(); public static void main(String[] args) { //(2) 设置线程变量 threadLocal.set("hello Java"); //(3) 启动子线程 Thread thread = new Thread(new Runnable() { public void run() { //(4)子线程输出线程变量的值 System.out.println("子线程:" + threadLocal.get()); } }); thread.start(); //(5)主线程输出线程变量值 System.out.println("父线程:" + threadLocal.get()); } } 运行结果如下: 也就是说同一个 ThreadLocal 变量在父线程中设置值后,在子线程中是获取不到的。根据上节的介绍,这个应该是正常现象,因为子线程调用 get 方法时候当前线程为子线程,而调用 set 方法设置线程变量是 main 线程,两者是不同的线程,自然子线程访问时候返回 null。 那么有办法让子线程访问到父线程中的值吗?答案是有,就用我们上面原理分析的InheritableThreadLocal。 将上面例子的代码(1)修改为: //(1) 创建线程变量 public static ThreadLocal<String> threadLocal = new InheritableThreadLocal<String>(); 运行结果如下: 可知现在可以从子线程中正常的获取到线程变量值了。那么什么情况下需要子线程可以获取到父线程的 threadlocal 变量呢? 情况还是蛮多的,比如存放用户登录信息的 threadlocal 变量,很有可能子线程中也需要使用用户登录信息,再比如一些中间件需要用统一的追踪 ID 把整个调用链路记录下来的情景。 Spring Request Scope 作用域 Bean 中 ThreadLocal 的使用 我们知道 Spring 中在 XML 里面配置 Bean 的时候可以指定 scope 属性来配置该 Bean 的作用域为 singleton、prototype、request、session 等,其中作用域为 request 的实现原理就是使用 ThreadLocal 实现的。如果你想让你 Spring 容器里的某个 Bean 拥有 Web 的某种作用域, 则除了需要 Bean 级上配置相应的 scope 属性,还必须在 web.xml 里面配置如下: <listener> <listener-class>org.springframework.web.context.request.RequestContextListener</listener-class> </listener> 这里主要看RequestContextListener的两个方法: public void requestInitialized(ServletRequestEvent requestEvent) 和 public void requestDestroyed(ServletRequestEvent requestEvent) 当一个web请求过来时候会执行requestInitialized方法: public void requestInitialized(ServletRequestEvent requestEvent) { .......省略 HttpServletRequest request = (HttpServletRequest) requestEvent.getServletRequest(); ServletRequestAttributes attributes = new ServletRequestAttributes(request); request.setAttribute(REQUEST_ATTRIBUTES_ATTRIBUTE, attributes); LocaleContextHolder.setLocale(request.getLocale()); //设置属性到threadlocal变量 RequestContextHolder.setRequestAttributes(attributes); } public static void setRequestAttributes(RequestAttributes attributes) { setRequestAttributes(attributes, false); } public static void setRequestAttributes(RequestAttributes attributes, boolean inheritable) { if (attributes == null) { resetRequestAttributes(); } else { //默认inheritable=false if (inheritable) { inheritableRequestAttributesHolder.set(attributes); requestAttributesHolder.remove(); } else { requestAttributesHolder.set(attributes); inheritableRequestAttributesHolder.remove(); } } } 可以看到上面源码,由于默认inheritable 为FALSE,我们的属性值都放到了requestAttributesHoder里面,而它的定义是: private static final ThreadLocal<RequestAttributes> requestAttributesHolder =new NamedThreadLocal<RequestAttributes>("Request attributes"); private static final ThreadLocal<RequestAttributes> inheritableRequestAttributesHolder =new NamedInheritableThreadLocal<RequestAttributes>("Request context"); 其中NamedThreadLocal<T> extends ThreadLocal<T>,所以不具有继承性。 其中NamedThreadLocal<T> extends ThreadLocal<T>,所以不具有继承性。 NameInheritableThreadLocal<T> extends InheritableThreadLocal<T>,所以具有继承性,所以默认放入到RequestContextHolder里面的属性值在子线程中获取不到。 当请求结束时候调用requestDestroyed方法,源码如下: public void requestDestroyed(ServletRequestEvent requestEvent) { ServletRequestAttributes attributes = (ServletRequestAttributes) requestEvent.getServletRequest().getAttribute(REQUEST_ATTRIBUTES_ATTRIBUTE); ServletRequestAttributes threadAttributes = (ServletRequestAttributes) RequestContextHolder.getRequestAttributes(); if (threadAttributes != null) { // 我们很有可能在最初的请求线程中 if (attributes == null) { attributes = threadAttributes; } //请求结束则清除当前线程的线程变量。 LocaleContextHolder.resetLocaleContext(); RequestContextHolder.resetRequestAttributes(); } if (attributes != null) { attributes.requestCompleted(); } } 接下来从时序图看一下 Web请求调用逻辑如何: 也就是说每次发起一个Web请求在Tomcat中context(具体应用)处理前,host匹配后会设置下RequestContextHolder属性,让requestAttributesHolder不为空,在请求结束时会清除。 因此,默认情况下放入RequestContextHolder里面的属性子线程访问不到,Spring 的request作用域的bean是使用threadlocal实现的。 接下来进行一个例子模拟请求,代码如下: web.xml配置如下: 因为是 request 作用域,所以必须是 Web 项目,并且需要配置 RequestContextListener 到 web.xml。 <listener> <listener-class>org.springframework.web.context.request.RequestContextListener</listener-class> </listener> 接着注入一个 request 作用域 bean 到 IOC 容器。代码如下: <bean id="requestBean" class="hjc.test.RequestBean" scope="request"> <property name="name" value="hjc" /> <aop:scoped-proxy /> </bean> 测试代码如下: @WebResource("/testService") public class TestRpc { @Autowired private RequestBean requestInfo; @ResourceMapping("test") public ActionResult test(ErrorContext context) { ActionResult result = new ActionResult(); pvgInfo.setName("hjc"); String name = requestInfo.getName(); result.setValue(name); return result; } } 如上首先配置 RequestContextListener 到 web.xml 里面,然后注入了 Request 作用域的 RequestBean 的实例到 IOC 容器,最后 TestRpc 内注入了 RequestBean 的实例,方法 test 首先调用了 requestInfo 的方法 setName 设置 name 属性,然后获取 name 属性并返回。 这里如果 requestInfo 对象是单例的,那么多个线程同时调用 test 方法后,每个线程都是设置-获取的操作,这个操作不是原子性的,会导致线程安全问题。而这里声明的作用域为 request 级别,也是每个线程都有一个 requestInfo 的本地变量。 上面例子方法请求的时序图如下: 我们要着重关注调用test时候发生了什么: 其实前面创建的 requestInfo 是被经过 CGliB 代理后的(感兴趣的可以研究下 ScopedProxyFactoryBean 这类),所以这里调用 setName 或者 getName 时候会被 DynamicAdvisedInterceptor 拦截的,拦击器里面最终会调用到 RequestScope 的 get 方法获取当前线程持有的本地变量。 关键来了,我们要看一下RequestScope的get方法的源码如下: public Object get(String name, ObjectFactory objectFactory) { RequestAttributes attributes = RequestContextHolder.currentRequestAttributes();//(1) Object scopedObject = attributes.getAttribute(name, getScope()); if (scopedObject == null) { scopedObject = objectFactory.getObject();//(2) attributes.setAttribute(name, scopedObject, getScope());//(3) } return scopedObject; } 可知当发起一个请求时候,首先会通过 RequestContextListener.requestInitialized 里面调用 RequestContextHolder.setRequestAttributess 设置 requestAttributesHolder。 然后请求被路由到 TestRpc 的 test 方法后,test 方法内第一次调用 setName 方法时候,最终会调用 RequestScope.get()方法,get 方法内代码(1)获取通过 RequestContextListener.requestInitialized 设置的线程本地变量 requestAttributesHolder 保存的属性集的值。 接着看该属性集里面是否有名字为 requestInfo 的属性,由于是第一次调用,所以不存在,所以会执行代码(2)让 Spring 创建一个 RequestInfo 对象,然后设置到属性集 attributes,也就是保存到了当前请求线程的本地内存里面了。然后返回创建的对象,调用创建对象的 setName。 最后test 方法内紧接着调用了 getName 方法,最终会调用 RequestScope.get() 方法,get 方法内代码(1)获取通过 RequestContextListener.requestInitialized 设置的线程本地变量 RequestAttributes,然后看该属性集里面是否有名字为 requestInfo 的属性, 由于是第一次调用 setName 时候已经设置名字为 requestInfo 的 bean 到 ThreadLocal 变量里面了,并且调用 setName 和 getName 的是同一个线程,所以这里直接返回了调用 setName 时候创建的 RequestInfo 对象,然后调用它的 getName 方法。 到目前为止我们了解ThreadLocal 的实现原理,并指出 ThreadLocal 不支持继承性;然后紧接着讲解了 InheritableThreadLocal 是如何补偿了 ThreadLocal 不支持继承的特性;最后简单的介绍了 Spring 框架中如何使用 ThreadLocal 实现了 Reqeust Scope 的 Bean。

优秀的个人博客,低调大师

Java并发编程-队列同步器(AbstractQueuedSynchronizer)

章节目录 Lock接口与Synchronized的区别及特性 队列同步器的接口与自定义锁示例 队列同步器的实现分析 1.Lock接口与Synchronized的区别及特性 特性 描述 尝试非阻塞性的获取锁 当前线程尝试获取锁(自旋获取锁),如果这一时刻锁没有被其他线程获取到,则成功获取并持有锁 能被中断的获取锁 已获取锁的线程可以响应中断,当获取到锁的线程被中断时,可以抛出中断异常,同时锁会被释放 超时获取锁 在指定的截止时间之前获取锁,如果截止时间到了仍然没有获取到锁,则返回 注意:Lock接口的实现基本上都是通过聚合了一个同步器的子类来完成线程访问控制的 队里同步器的接口与定义锁示例 队列同步器定义: 队列同步器,是用来构建锁与其它同步组件的基础框架,基本数据结构与内容是: 1、int state -> state 标示同步状态; 2、内置的FIFO来完成获取同步状态的线程的排队工作。 队列同步器使用方式 1、子类通过继承同步器并实现它的抽象方法来管理同步状态; 2、实现过程中对同步状态的更改,通过 setState()、 setState(int newState)、 compareAndSetState(int expect,int newUpdateValue) 来进行操作,保证状态改变时原子性的、安全的; 3、实现同步器的子类被推荐为自定义同步组件的静态内部类; 4、同步器可以支持独占式的获取同步状态(ReentrantLock)、也可以支持共享 式的获取同步状态(ReentrantReadWriteLock) 对于同步器与锁的关系可以这样理解: 在锁的实现中聚合同步器,利用同步器实现锁的语义。 锁面向使用者,它定义了使用者与锁的交互接口,隐藏了实现细节。 同步器面向的是锁的实现者,它简化了锁的实现方式,屏蔽了同步器状态管理、线程排队、等待与唤醒等底层操作。 2.队列同步器的接口与自定义锁示例 2.1 模板方法模式 同步器的设置是基于**模版方法模式**,使用者需要继承同步器并重写指定的方 法,随后将同步器组合在自定义同步组件的实现中,并调用同步器提供的模板 方法,而这些模板方法将会调用使用者重写的方法。 2.2 重写同步器指定的方法 getState():获取当前同步状态 setState(int newState):设置当前同步状态 compareAndSetState(int expect,int update): 使用CAS设置当前的状态,该方 法保证状态设置的原子性 2.3 同步器可重写的方法 方法名称 描述 protected boolean tryAcquire(int arg) 独占式获取同步状态,实现该方法需要查询当前状态并判断同步状态是否符合预期,然后再进行CAS设置同步状态 protected boolean tryRelease(int arg) 独占式释放同步状态,等待获取同步状态的线程将有机会获取同步状态(公平性获取锁) protected int tryAcquireShared(int arg) 共享式获取同步状态,返回>=0的值,标示获取成功,反之获取失败 protected boolean tryReleaseShared(int arg) 共享式释放同步状态 protected boolean isHeldExclusively() 当前同步器是否在独占模式下被线程占用,一般该方法表示是否被当前线程所独占 2.4 独占锁示例 package org.seckill.lock; import java.util.concurrent.TimeUnit; import java.util.concurrent.locks.AbstractQueuedSynchronizer; import java.util.concurrent.locks.Condition; import java.util.concurrent.locks.Lock; /** * 利用了模板方法模式 */ public class Mutex implements Lock { private static class Sync extends AbstractQueuedSynchronizer { //是否处于占用状态 @Override protected boolean isHeldExclusively() { return getState() == 1; } //当状态为0时获取锁 @Override protected boolean tryAcquire(int arg) { if (compareAndSetState(0, 1)) { setExclusiveOwnerThread(Thread.currentThread()); return true; } return false; } //释放锁,将当前状态设置为0 @Override protected boolean tryRelease(int arg) { if (getState() == 0) { throw new IllegalMonitorStateException(); } setExclusiveOwnerThread(null); setState(0); return true; } //返回一个condition,每个condition中都包含了一个condition队列 Condition newCondition() { return new ConditionObject(); } } //仅需要将操作代理到Sync上即可 private Sync sync = new Sync(); public void lock() { sync.acquire(1);//调用tryAccquire } //当前已获取锁的线程响应中断,释放锁,抛出异常,并返回 public void lockInterruptibly() throws InterruptedException { sync.acquireInterruptibly(1); } public boolean tryLock() { return sync.tryAcquire(1);//尝试立即获取锁 } public boolean tryLock(long timeout, TimeUnit unit) throws InterruptedException { return sync.tryAcquireNanos(1, unit.toNanos(timeout));//尝试超时获取锁 } public void unlock() { sync.release(1);//释放锁 } public Condition newCondition() { return sync.newCondition(); } } 总结-实现同步组件的方法 1. 独占锁Mutex 是一个自定义同步组件,它允许同一时刻只允许同一个线程占有锁。 2.Mutex中定义了一个私有静态内部类,该类继承了同步器并实现了独占式获取和释放同步状态。 3.在tryAcquire(int acquires)方法中,经过CAS设置成功(同步状态设置为1),则 代表获取了同步状态,而在tryRelease(int releases) 方法中只是将同步状态重 置为0。 3 队列同步器的实现分析 3.1 同步队列数据结构 同步器依赖内部的同步队列,即一个FIFO的队列,这个队列由双向链表实现。节点数据从 队列尾部插入,头部删除。 node 数据结构 struct node { node prev; //节点前驱节点 node next; //节点后继节点 Thread thread; //获取同步状态的线程 int waitStatus; //等待状态 Node nextWaiter; //等待队列中的后继节点 } 等待队列 后续篇章介绍到condition会有相关记录。 同步队列基本结构 3.2 无法获取到同步状态的线程节点被加入到同步队列的尾部 本质上是采用 compareAndSetTail(Node expect,Node update),当一个线程成功的获取了同步状态 (或者锁),其他线程将无法获取到同步状态,转而被构造成为节点并加入到同步队列中,而这个加入队列的过程 必须要保证线程安全。所以采用了基于CAS的方式来设置尾节点的方法。 ,需要传递当前节点认为的尾节点和当前节点,只有设置成功后,当前节点才正式与之前的尾节点建立关联。 3.3 成功获取同步状态 同步队列遵循FIFO,首节点是获取同步状态成功的节点,首节点的线程在释放 同步状态时,会唤醒后继节点,而后继节点将会在获取同步状态成功时,将自己设置为首节点。 3.4 独占式同步状态获取与释放 前驱节点为头节点且能够获取同步状态的判断条件和线程进入同步队列 来获 取同步状态是自旋的过程。 设置首节点是通过获取同步状态成功的线程来完成的acquireQueued(node,args)完成的 独占式获取同步状态的流程图 独占式同步状态(锁)获取流程

优秀的个人博客,低调大师

Java并发编程的艺术(十二)——线程安全

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80289238 1. 什么是『线程安全』? 如果一个对象构造完成后,调用者无需额外的操作,就可以在多线程环境下随意地使用,并且不发生错误,那么这个对象就是线程安全的。 2. 线程安全的几种程度 线程安全性的前提:对『线程安全性』的讨论必须建立在对象内部存在共享变量这一前提,若对象在多条线程间没有共享数据,那这个对象一定是线程安全的! 2.1. 绝对的线程安全 上述线程安全性的定义即为绝对线程安全的情况,即:一个对象在构造完之后,调用者无需任何额外的操作,就可以在多线程环境下随意使用。绝对的线程安全是一种理想的状态,若要达到这一状态,往往需要付出巨大的代价。通常并不需要达到绝对的线程安全。 2.2. 相对的线程安全 我们通常所说的『线程安全』即为『相对的线程安全』,JDK中标注为线程安全的类通常就是『相对的线程安全』,如:Vector、HashTable、Collections.synchronizedXXX。对于相对线程安全的类,使用它们时一般不需要使用额外的保障措施,但对于一些特定的使用场景,仍然需要额外的操作来保证线程安全,如: // 读线程 Thread t1 = new Thread( new Runnable(){ public void run(){ for(int i=0; i<vector.size(); i++){ System.out.println( vector.get(i) ); } } }).start(); // 写线程 Thread t2 = new Thread( new Runnable(){ public void run(){ for(int i=0; i<vector.size(); i++){ vector.remove(i); } } }).start(); 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 vector是一个线程安全的容器,它所提供的方法均为同步方法,但上述代码仍然会出现线程安全性问题:若线程1读了一半的元素后暂停,线程2开始执行,并删除了所有的元素,然后线程1继续执行,此时发生角标越界异常!修改方案:加上额外的同步 // 读线程 Thread t1 = new Thread( new Runnable(){ public void run(){ synchronized( vector ){ for(int i=0; i<vector.size(); i++){ System.out.println( vector.get(i) ); } } } }).start(); // 写线程 Thread t2 = new Thread( new Runnable(){ public void run(){ synchronized( vector ){ for(int i=0; i<vector.size(); i++){ vector.remove(i); } } } }).start(); 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 2.3. 线程对立 线程对立指的是:不论调用者采用何种同步措施,都无法达到线程安全的目的。如Thread类的suspend、resume方法就是线程对立的方法。suspend方法会暂停线程,但它不会释放资源,若resume需要请求到该资源才会被运行的话,系统就会进入死锁状态。 3. 实现线程安全的方法 3.1. 互斥同步 同步指的是同一时刻,只有一条线程操作『共享变量』。 实现同步的方式有很多:互斥访问、CAS操作。互斥会引起阻塞,当一条线程请求一个已经被另一线程使用的锁时,就会进入阻塞态;而进入阻塞态会涉及上下文切换。因此,使用互斥来实现同步的开销是很大的。 互斥同步(阻塞式同步)是一种『悲观锁』,即它认为总是存在多条线程竞争资源的情况,因此它不管当前是不是真的有多条线程在竞争共享资源,它总是先上锁,然后再处理。 Java中有两种实现互斥同步的方式:synchronized和ReentrantLock。 synchronized 编译器会在synchronized同步块的开始和结束位置加上monitorenter和monitorexit指令; 这两个指令需要一个reference类型的参数来指名要锁定和解锁的对象; 若同步块没有明确指定锁对象,那么就使用当前对象或当前类的Class对象; 它是一把可重入的锁,即:当前线程在已经获得锁的情况下,可以再次获取该锁,因此不会出现当前线程把自己锁死的情况; ReentrantLock它也是一把可重入的锁,但比synchronized多如下功能: 等待可中断:若一条线程长时间占用锁不释放,那被阻塞的线程可以选择放弃等待,而去做别的事;这对于要处理长时间的同步块时是很有帮助的。 可实现公平锁:synchronized是一种非公平锁,即:被阻塞的线程竞争锁是随机的;而公平锁是根据被阻塞线程先来后到的顺序给予锁。ReentrantLock默认是非公平锁,可以通过构造函数构造公平锁。 可以绑定多个条件:synchronized可使用wait/notify来实现等待/通知机制,但一个synchronized同步块只能使用一次,若要使用多次,就需要嵌套同步块;但ReentrantLock可以通过newCondition创建多个条件。 synchronized和ReentrantLock如何选择?优先选择synchronized!JDK1.6已经对synchronized做了很多优化,性能与ReentrantLock相差不大。在条件允许的请况下应优先选择synchronized。 3.2. 非阻塞同步 它是一种『乐观锁』,即它总是认为当前没有线程使用共享资源,因此它不管当前的状态,直接操作共享资源,若发现产生了冲突,那么再采取补偿措施(如:CAS的补偿措施就是不断尝试,直到不发生冲突为止),这种方式线程无需进入阻塞态(挂起态),因此称为『非阻塞同步』。 JUC中各种整形原子类的自增、自减等操作就使用了CAS。 CAS操作过程:CAS操作存在3个值:共享变量V、预期的旧值A、新值B,若V与A相同,则将V更新成B,否则就不更新,继续循环比较,直到更新完成为止。 CAS操作可能引发的问题:ABA问题。若V一开始的值为A,但在准备赋新值的过程中A变成了B,又变成了A,而CAS操作误认为V没有被改过。 无同步方案 『阻塞式同步』和『非阻塞式同步』都是同一时刻只让一条线程处理共享数据,而下面的方案使得多条线程之间不存在共享数据,从而无需同步。 可重入代码如果一块代码段只要输入的值一样其结果就一样的话,这段代码就叫『可重入代码』。这一类代码天生具有线程安全性,线程随意切换结果都一样。 线程封闭线程封闭:把所有涉及共享变量操作的任务都放在一个线程中运行。这样就不存在多条线程同时处理共享变量了,从而达到了线程安全目的。 WEB服务器采用的就是这种方式,它把每个请求封装在一条线程中处理,从而不存在线程安全性问题。 不可变对象如果是共享的基本数据类型变量,只要被final修饰,它就是不可变的;如果是共享的对象,那就要确保它内部的共享成员变量不会被它的行为所改变。PS:保证对象内部共享变量不会被改变的方法有很多,最简单粗暴的方式就是将所有共享变量用final修饰。 不可变对象一定是线程安全的。

优秀的个人博客,低调大师

Java并发编程的艺术(十三)——锁优化

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80289271 自旋锁 背景:互斥同步对性能最大的影响是阻塞,挂起和恢复线程都需要转入内核态中完成;并且通常情况下,共享数据的锁定状态只持续很短的一段时间,为了这很短的一段时间进行上下文切换并不值得。 原理:当一条线程需要请求一把已经被占用的锁时,并不会进入阻塞状态,而是继续持有CPU执行权等待一段时间,该过程称为『自旋』。 优点:由于自旋等待锁的过程线程并不会引起上下文切换,因此比较高效; 缺点:自旋等待过程线程一直占用CPU执行权但不处理任何任务,因此若该过程过长,那就会造成CPU资源的浪费。 自适应自旋:自适应自旋可以根据以往自旋等待时间的经验,计算出一个较为合理的本次自旋等待时间。 锁清除 编译器会清除一些使用了同步,但同步块中没有涉及共享数据的锁,从而减少多余的同步。 锁粗化 若有一系列操作,反复地对同一把锁进行上锁和解锁操作,编译器会扩大这部分代码的同步块的边界,从而只使用一次上锁和解锁操作。 轻量级锁 本质:使用CAS取代互斥同步。 背景:『轻量级锁』是相对于『重量级锁』而言的,而重量级锁就是传统的锁。 轻量级锁与重量级锁的比较: 重量级锁是一种悲观锁,它认为总是有多条线程要竞争锁,所以它每次处理共享数据时,不管当前系统中是否真的有线程在竞争锁,它都会使用互斥同步来保证线程的安全; 而轻量级锁是一种乐观锁,它认为锁存在竞争的概率比较小,所以它不使用互斥同步,而是使用CAS操作来获得锁,这样能减少互斥同步所使用的『互斥量』带来的性能开销。 实现原理: 对象头称为『Mark Word』,虚拟机为了节约对象的存储空间,对象处于不同的状态下,Mark Word中存储的信息也所有不同。 Mark Word中有个标志位用来表示当前对象所处的状态。 当线程请求锁时,若该锁对象的Mark Word中标志位为01(未锁定状态),则在该线程的栈帧中创建一块名为『锁记录』的空间,然后将锁对象的Mark Word拷贝至该空间;最后通过CAS操作将锁对象的Mark Word指向该锁记录; 若CAS操作成功,则轻量级锁的上锁过程成功; 若CAS操作失败,再判断当前线程是否已经持有了该轻量级锁;若已经持有,则直接进入同步块;若尚未持有,则表示该锁已经被其他线程占用,此时轻量级锁就要膨胀成重量级锁。 前提:轻量级锁比重量级锁性能更高的前提是,在轻量级锁被占用的整个同步周期内,不存在其他线程的竞争。若在该过程中一旦有其他线程竞争,那么就会膨胀成重量级锁,从而除了使用互斥量以外,还额外发生了CAS操作,因此更慢! 偏向锁 作用:偏向锁是为了消除无竞争情况下的同步原语,进一步提升程序性能。 与轻量级锁的区别:轻量级锁是在无竞争的情况下使用CAS操作来代替互斥量的使用,从而实现同步;而偏向锁是在无竞争的情况下完全取消同步。 与轻量级锁的相同点:它们都是乐观锁,都认为同步期间不会有其他线程竞争锁。 原理:当线程请求到锁对象后,将锁对象的状态标志位改为01,即偏向模式。然后使用CAS操作将线程的ID记录在锁对象的Mark Word中。以后该线程可以直接进入同步块,连CAS操作都不需要。但是,一旦有第二条线程需要竞争锁,那么偏向模式立即结束,进入轻量级锁的状态。 优点:偏向锁可以提高有同步但没有竞争的程序性能。但是如果锁对象时常被多条线程竞争,那偏向锁就是多余的。 偏向锁可以通过虚拟机的参数来控制它是否开启。

优秀的个人博客,低调大师

python函数式编程之生成器

在前面的学习过程中,我们知道,迭代器有两个好处: 一是不依赖索引的统一的迭代方法 二是惰性计算,节省内存 但是迭代器也有自己的显著的缺点,那就是 不如按照索引取值方便 一次性,只能向后取值,不能向前取值 所以我们还需要学习另外一种对象,那已经生成器 1.什么是生成器 如果一个函数体内部包含yield关键字,该函数就是生成器函数,执行该函数就得到一个生成器对象 2.得到生成器 先来看下面的代码 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() print(g) 根据上面生成器的定义:函数体内部包含yield关键字,则该函数就是生成器函数,则上面的函数执行结果就是一个生成器对象 执行上面的代码,查看程序执行结果 <generator object foo at 0x0000000001DF2BF8> 可以看出:上面的函数执行的结果g就是一个生成器对象,上面的函数foo就是一个生成器函数 3.生成器的内置方法 修改上面的代码,调用dir方法查看生成器中包含的方法 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() print(dir(g)) 打印生成器内部的方法,可以看到打印的结果 ['__class__', '__del__', '__delattr__', '__dir__', '__doc__', '__eq__', '__format__', '__ge__', '__getattribute__', '__gt__', '__hash__', '__init__', '__init_subclass__', '__iter__', '__le__', '__lt__', '__name__', '__ne__', '__new__', '__next__', '__qualname__', '__reduce__', '__reduce_ex__', '__repr__', '__setattr__', '__sizeof__', '__str__', '__subclasshook__', 'close', 'gi_code', 'gi_frame', 'gi_running', 'gi_yieldfrom', 'send', 'throw'] 在这些结果中,可以看到有__iter__方法和__next__方法,由此可以判断出生成器的本质就是迭代器 ,生成器是迭代器的一种 4.判断生成器是否是迭代器 修改上面的代码 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() from collections import Iterable print(isinstance(g,Iterable)) 查看打印结果 True 上面的两个例子都可以证明:生成器的本质是迭代器,生成器就是迭代器的一种 5.生成器的 __iter__方法和__next__方法 既然生成器的本质是迭代器,那么调用生成器的 __iter__方法和__next__方法,得到的结果会是什么呢 修改上面的代码 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() print(g) print(g.__iter__()) g.__next__() 程序执行结果 <generator object foo at 0x0000000001DF2BF8> <generator object foo at 0x0000000001DF2BF8> first... 从上面的程序的执行结果可以看出:直接打印生成器g和调用生成器g.__iter__方法,得到的结果都是生成器对象g 在内存中的地址 调用g.__next__方法,实际上就是从生成器g中取出一个值,执行一次g.__next__方法,触发一次生成器的取值操作,这个过程在上面的代码中表现为foo函数的向下执行过程 从上面的程序的执行结果中可以看到,只执行了foo函数的第一个print函数,并没有执行第二个和第三个print函数。 通常对函数来说,函数开始执行以后直到return语句,函数才会停止执行 在这里执行一次g.__next__方法,foo函数中执行了一行代码,遇到yield就停止了,在这里yield好像起到了return的作用。 实际上,yield关键字的功能之一就是起到返回的作用 上面的程序执行遇到yield,本次g.__next__方法执行完毕。 在函数的执行过程中,如果函数的return语句有返回值,则函数的执行完成就得到return语句的返回值, 如果return没有定义返回值或者函数中没有定义return语句,则函数的执行结果默认为None 修改上面的代码,打印__next__方法的执行结果 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() print(g.__next__()) 程序执行结果 first... None 可以看到,调用__next__方法时,yield后没接任何参数时,yield默认的返回值也是None 6.yield后面接返回值 那如果在yield关键字后接一个返回值,程序执行结果会是怎么样的呢 修改上面的代码,在yield关键字后接一个返回值,看程序的执行结果 def foo(): print("first...") yield 1 print("second...") yield 2 print("third...") g=foo() print(g.__next__()) 程序执行结果 first... 1 从上面的程序的执行结果可以看出,yield会把其后面接的数返回,作为__next__方法的执行结果 7.yield与return的不同点 在函数中,不管一个函数中定义了多少个return语句,函数在执行到第一个return语句的时候就会中止,其后面的语句将不会被继续执行 而对于yield来说,每调用一次__next__方法,程序会从开始向下执行,直到遇到yield语句,程序暂停,等到第二次调用__next__方法,程序会从上次暂停的地方继续向下执行,直到遇到下一个yield或者程序执行完成 在上面的例子里,是使用yield把函数foo变成一个生成器,执行foo函数时,并不会立即执行foo函数,而是先得到生成器g,当调用一次`g.__next__`方法时,函数foo开始向下执行,遇到yield时,程序暂停,当下一次调用`g.__next__`方法时,函数foo继续从上一次暂停的地方开始向下执行,直到遇到yield暂停 8.生成器的StopIteration 修改程序,多次调用__next__方法,查看程序的执行结果 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() print(g) print(g.__iter__()) g.__next__() print('*'*30) g.__next__() print('#'*30) g.__next__() 程序执行结果 <generator object foo at 0x0000000001DF2BF8> <generator object foo at 0x0000000001DF2BF8> first... ****************************** second... ############################## third... Traceback (most recent call last): File "E:/py_code/test.py", line 28, in <module> g.__next__() StopIteration 从上面程序的执行结果可以看出,每调用一次生成器的__next__方法,会得到一个返回值,就相当于从迭代器中取一个值。 如果程序在执行过程中,没有得到返回值,这就说明迭代器的最后一个值已经被遍历完成了,所以此时再调用__next__方法,程序就会抛出异常 9.生成器的for循环遍历 在前面的学习中已经知道,生成器本质上就是一个迭代器。既然是迭代器,那么当然可以使用for循环来遍历生成器 修改上面的例子,使用for循环来遍历生成器 def foo(): print("first...") yield 1 print("second...") yield 2 print("third...") g=foo() for i in g: print(i) print("*"*30) 查看程序的执行结果 first... 1 ****************************** second... 2 ****************************** third... 在上面的例子里,每执行一次for循环,就相当于是执行一次g.__next__方法,yield会返回其后所接的数字,所以for循环前两次的执行结果都是print函数和yield后接的数字 for循环执行到第三次的时候,执行完print函数,程序会抛出StopIteration异常,但是StopIteration的异常会被for循环捕捉到,所以for循环执行第三次只执行了print语句 10.总结: yield关键字的功能: 与return的功能类似,都可以返回值,但不一样的地方在于一个函数中可以多次调用yield来返回值 为函数封装好了`__iter__方法`和`__next__方法`,把函数的执行结果变成了迭代器 `遵循迭代器的取值方式(obj.__next__())`,触发的函数的执行,函数暂停与再继续都由yield保存 11.示例:使用yield模拟linux中的命令:tail -f | grep 'error' | grep '404' 代码如下: import time def tail(file_path, encoding='utf-8'): with open(file_path, encoding=encoding) as f: f.seek(0, 2) while True: line = f.readline() if line: yield line else: time.sleep(0.5) def grep(lines, pattern): for line in lines: if pattern in line: yield line g1 = tail('a.txt') g2 = grep(g1, 'error') g3 = grep(g2, '404') for i in g3: print(i)

优秀的个人博客,低调大师

Java并发编程的艺术(二)——重排序

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/79612475 当我们写一个单线程程序时,总以为计算机会一行行地运行代码,然而事实并非如此。 什么是重排序? 重排序指的是编译器、处理器在不改变程序执行结果的前提下,重新排列指令的执行顺序,以达到最佳的运行效率。 重排序分类 重排序分为:编译器重排序 和 处理器重排序。 数据依赖 编译器和处理器并不会随意的改变指令的执行顺序,因为有些指令之间是有依赖关系的,若改变了他们的执行顺序,就会出现错误的结果。因此,编译器和处理器只会对没有依赖关系的指令进行重排序。 数据依赖:若相邻的两条指令访问同一个变量,并且其中有一条指令执行写操作,那么这样的两条指令之间存在数据依赖。对于有数据依赖关系的指令,不会发生重排序。 数据依赖关系总结一下为以下三种情况: 指令 示例 读后写 a=b;b=1; 写后写 a=1;a=2; 写后读 a=1;b=a; as-if-serial 在单线程开发中,程序员不需要知道指令是如何重排序的,只要简单地认为指令是按照顺序依次执行的即可。这就是as-if-serial的语义,即:貌似是串行的。

优秀的个人博客,低调大师

java面试-Java并发编程(二)——重排序

当我们写一个单线程程序时,总以为计算机会一行行地运行代码,然而事实并非如此。 什么是重排序? 重排序指的是编译器、处理器在不改变程序执行结果的前提下,重新排列指令的执行顺序,以达到最佳的运行效率。 重排序分类 重排序分为:编译器重排序 和 处理器重排序。 数据依赖 编译器和处理器并不会随意的改变指令的执行顺序,因为有些指令之间是有依赖关系的,若改变了他们的执行顺序,就会出现错误的结果。因此,编译器和处理器只会对没有依赖关系的指令进行重排序。 数据依赖:若相邻的两条指令访问同一个变量,并且其中有一条指令执行写操作,那么这样的两条指令之间存在数据依赖。对于有数据依赖关系的指令,不会发生重排序。 数据依赖关系总结一下为以下三种情况: 指令 示例 读后写 a=b;b=1; 写后写 a=1;a=2; 写后读 a=1;b=a; as-if-serial 在单线程开发中,程序员不需要知道指令是如何重排序的,只要简单地认为指令是按照顺序依次执行的即可。这就是as-if-serial的语义,即:貌似是串行的。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册