首页 文章 精选 留言 我的

精选列表

搜索[算力],共10000篇文章
优秀的个人博客,低调大师

产学研聚力智能操作系统,openKylin 分享 AI OS 的发展探索与开源实践

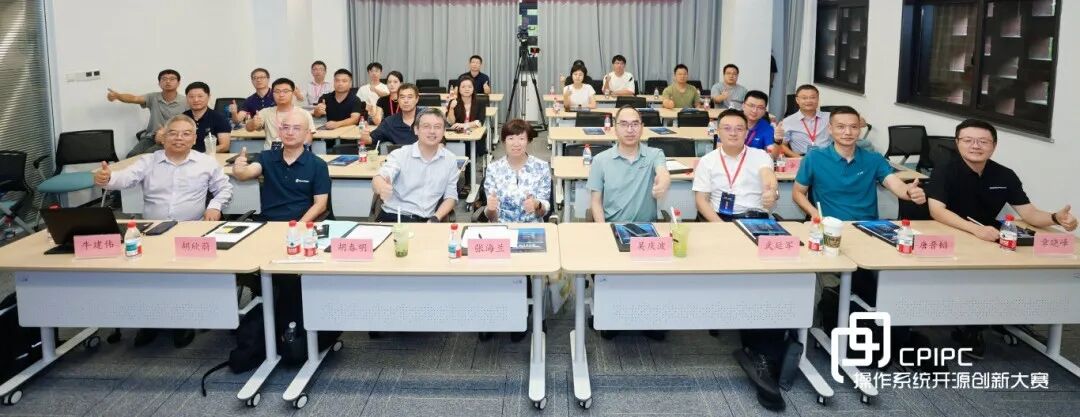
9月28日,依托中国研究生操作系统创新大赛所搭建的平台,北京航空航天大学软件学院牵头组织了“智能时代的开源操作系统”专题研讨会。本次研讨会旨在汇聚产业界、学术界与研究界的力量,共同探讨智能时代操作系统发展的现状、面临的机遇与挑战。 openKylin社区技术委员会主任吴庆波受邀出席,并作了题为《AI OS的思考与探索》的主题分享。报告中首先介绍了OS在PC、移动互联网和智能时代等阶段的发展历程,并举例介绍了各自的发展特点和AI时代下新的创新与尝试,总结和分析了AI OS发展广泛关注的研究热点。 基于我国现有硬件和AI底层软件栈的基础和现状,探讨了以开源RISC-V指令集架构为基础,发展软硬协同、端云融合和开源生态发展的AI OS相关技术路线,以及基于openKylin开源操作系统的探索与尝试;最后,对AI OS未米的发展和多场景智能化应用进行了展望。 随后,中国科学院软件研究所副所长武延军、北京航空航天大学计算机学院教授牛建伟、开源鸿蒙项目群工作委员会执行主席章晓峰、openEuler社区技术委员会主席胡欣蔚等专家也分享了人工智能时代开源操作系统发展前景,面临的挑战以及各自在技术前沿的宝贵探索与深刻思考。 openKylin 以“为世界提供与人工智能技术深度融合的开源操作系统”为愿景,积极推动开源操作系统与人工智能技术的深度融合,致力于聚合产业及开发者力量共同打造全球领先的智能桌面开源操作系统根社区。一方面致力于构建原生支持AI的基础环境,为AI应用提供稳定、高效的系统级支撑;另一方面,积极探索面向端侧设备的智能体验创新,以提升系统在交互智能与服务精准推送等方面的能力。同时,openKylin持续加强与RISC-V等国产芯片架构的软硬协同优化,并构建开放的开发者生态,旨在共同打造面向未来、创新演进的AI OS开源基石。

优秀的个人博客,低调大师

告别提示词工程,「上下文工程」才是 AI Agent 的核心竞争力

编者按: 什么样的技能才能真正决定 AI 智能体的成败?是更复杂的算法,还是更精妙的提示词?我们今天为大家带来的文章,作者的观点是:构建强大 AI 智能体的关键已从"提示词工程"转向"上下文工程"。 文章从"上下文"的广义定义出发,详细拆解了影响 AI 决策的七大关键要素,包括系统指令、用户输入、历史对话、长期记忆、外部检索信息、可用工具及输出结构。通过对比"廉价演示项目"与"神奇智能体"的案例,作者生动展现了上下文质量如何决定 AI 的表现 ------ 真正的差距不在于模型本身,而在于是否提供了恰当的上下文支持。作者进一步提出,上下文工程是一套动态流程,需跨领域协作,以结构化的方式整合业务需求与技术实现,确保 LLM 在正确的时间获得正确的信息与工具。 作者 | Philipp Schmid 编译 | 岳扬 上下文工程(Context Engineering)是一个在人工智能领域逐渐走红的新术语。行业内讨论的焦点正从"提示词工程"(prompt engineering)转向一个更广泛、更强大的概念:上下文工程(Context Engineering)。托比·卢克(Tobi Lutke)[1]将其描述为"为任务提供完整的上下文背景,使大语言模型能够合理解决问题的一门艺术",他说得很到位。 随着 Agents 的兴起,将哪些信息输入"有限的工作记忆(limited working memory)"中变得越来越重要。我们观察到,决定一个 Agent 成败的关键因素,通常就在于你提供给它的上下文质量。大多数 Agent 的失败早已不是模型本身的问题,而恰恰是上下文供给的失败。 01 什么是上下文(Context)? 要理解上下文工程(Context Engineering),我们首先必须扩展对"上下文"的定义。它不仅指你发送给 LLM 的单一提示词(prompt)。应该将其视为模型在生成响应前所看到的一切信息。 指令 / 系统提示词(Instructions / System Prompt) : 用于定义模型在对话期间行为的初始指令集,可以/应该包含示例、规则等。 用户提示词(User Prompt) : 来自用户的即时任务或问题。 状态 / 历史(短期记忆)[State / History (short-term Memory] : 当前的对话内容,包括导致此刻结果的"用户与模型的历史回复"。 长期记忆(Long-Term Memory) : 在之前的多次对话中收集的持久性知识库,包含学习到的用户偏好、过往对话摘要、或被明确告知需要记忆以备后续使用的信息。 检索信息(RAG)[Retrieved Information (RAG)] : 外部的、最新的知识,来自文档、数据库或 API 的相关信息,用于回答特定问题。 可用工具(Available Tools) : 所有可调用函数或内置工具的标准化描述(如输入参数、输出格式、功能说明)(例如 check_inventory, send_email)。 结构化输出(Structured Output) : 对模型响应格式的定义,例如一个 JSON 对象。 02 为什么重要?从「廉价的演示项目」到「神奇的智能体产品」 构建真正高效的 AI 智能体的秘诀,与你编写代码的复杂程度关系不大,而与你提供上下文的质量息息相关。 构建智能体,与你编写的代码或使用的框架关系不大。 一个廉价的演示项目和"神奇的智能体"之间的区别,就在于你所提供上下文的质量。假设让一个 AI 助手根据一封简单的邮件来安排会议: Hey, just checking if you're around for a quick sync tomorrow. 嘿,想问一问明天方不方便,我们快速碰个头? "廉价的智能体演示项目"的上下文质量很差。它只看到用户的请求,其他什么都看不到。它的代码可能功能完善,它会调用 LLM 并获得响应,但输出的内容却毫无帮助,且充满机械感: Thank you for your message. Tomorrow works for me. May I ask what time you had in mind? 感谢来信!明天我有空。你想约在几点? "神奇的智能体"则由丰富的上下文驱动。其代码的主要任务并非琢磨如何回应,而是收集 LLM 所需的信息,以便更好地响应用户需求。在调用 LLM 之前,你可以扩展上下文,使其包含: 你的日历信息(显示你日程已满)。 你与此人的过往邮件(用于确定合适的非正式语气)。 你的联系人列表(用于识别 ta 为关键的合作伙伴)。 send_invite 或 send_email 工具。 然后便能生成回应: Hey Jim! Tomorrow's packed on my end, back-to-back all day. Thursday AM free if that works for you? Sent an invite, lmk if it works. 嗨 Jim!明天我这边日程全排满了,从早到晚连轴转。周四上午有空,你看行不?邀请已发,确认下是否合适~ 这种神奇的效果并非源于更聪明的模型或更精巧的算法,而在于为正确的任务提供了恰当的上下文。这就是为什么上下文工程(Context Engineering)非常重要。智能体的失败并非仅仅是模型的失败,本质上是上下文的缺失。 03 从提示词工程到上下文工程 什么是上下文工程?如果说"提示词工程(prompt engineering)"侧重于在单个文本字符串中精心设计一套完美的指令,那么上下文工程(context engineering)的范畴则宽广得多。简而言之: 上下文工程是一门设计和构建动态系统的学科,它能以正确的格式、在正确的时间提供正确的信息与工具,赋予 LLM 完成任务所需的一切资源。 上下文工程是 一套流程,而非某些字符串:上下文不仅是一个静态的提示词模板。它是主 LLM 调用前系统运行所产生的输出。 动态构建的:随任务即时生成,适配用户当下的需求。对某个请求,其上下文可能是日历数据,对另一请求,上下文则可能是邮件记录或网页搜索结果。 在正确的时间提供正确的信息和工具:其核心职责是确保模型不遗漏关键细节(Garbage In, Garbage Out)。这意味着只有在必需且有帮助时才提供知识(信息)与能力(工具)。 注重呈现格式:如何呈现信息很重要。简明扼要的摘要胜过原始数据的堆砌,清晰的工具架构胜过模糊的指令。 04 Summary 构建强大且可靠的 AI 智能体,已经不再需要寻找神奇的提示词或更新模型版本。其核心在于上下文工程,即以正确的格式、在正确的时间提供正确的信息与工具。这是一项跨领域协作的挑战,需要理解业务场景、定义预期输出,并结构化组织所有必要的信息,使 LLM 能够真正"完成任务"。 05 致谢 本综述的完成得益于深度研究(deep research)与人工校验(manual research),并从以下优质资源中汲取了灵感与信息: Tobi Lutke tweet[1] Karpathy tweet[2] The rise of "context engineering"[3] Own your context window[4] Context Engineering by Simon Willison[5] Context Engineering for Agents[6] END 本期互动内容 🍻 ❓你是否有过动态构建上下文的经验?能否分享一个你认为特别成功的案例? 文中链接 [1]https://x.com/tobi/status/1935533422589399127 [2]https://x.com/karpathy/status/1937902205765607626 [3]https://blog.langchain.com/the-rise-of-context-engineering/ [4]https://github.com/humanlayer/12-factor-agents/blob/main/content/factor-03-own-your-context-window.md [5]https://simonwillison.net/2025/Jun/27/context-engineering/ [6]https://rlancemartin.github.io/2025/06/23/context_engineering/ 本文经原作者授权,由 Baihai IDP 编译。如需转载译文,请联系获取授权。 原文链接: https://www.philschmid.de/context-engineering

优秀的个人博客,低调大师

探索 Zadig 自测模式,一套环境多人协同,释开发者创造力!

在日常开发中,研发工程师经常遇到环境不足、环境管理混乱以及互相抢占环境的问题,这种情况不仅使得研发工程在等待环境准备和切换中花费大量宝贵的工作时间,无法充分发挥创造性,还直接影响了项目的进度和质量。对于业务架构简单、服务数量较少的情况,往往会选择扩展出一套完整的新环境来满足不同研发同时自测联调的诉求,减少不必要的等待时间。而面对复杂的业务场景,一套测试环境中可能包含成千上百个服务,额外搭建这样一套完整的环境成本极高,甚至由于一些服务的基础架构的原因,复制多套环境几乎不可能。 为了应对上述痛点问题,Zadig 提出了一种低成本搭建子环境的解决方案。在 Zadig 自测模式的子环境中,只需部署少量服务,并与基准服务进行交互,实现了更为高效的开发和联调流程。 在本文中,我们将深入探讨 Zadig 自测模式的基本原理、应用场景、管理员操作细节和工程师在日常使用中的实际操作等。 基本原理 自测模式是 Zadig 为降低环境管理复杂度和部署成本而推出的一种面向开发者的功能模块。当开启了环境的自测模式后,该环境则成为基准环境,该环境拥有完整的服务调用链。没有灰度标的请求会在基准环境中进行调用,调用链路为A -> B -> C。 当开发者需要进行开发、联调时,比如涉及到到 A 和 C 两个服务的变更,可以基于基准环境新建 dev1 子环境,该子环境中仅部署变更后的 A 和 C 服务,即 A' 和 C'。联调时请求加上灰度标,如在 http header 中设定x-env=dev1的灰度标,此时请求会按照A' -> B -> C'进行。 同理,当开发、联调时仅涉及到 B 和 C 两个服务的变更时,可以基于基准环境新建 dev2 子环境,该子环境仅部署变更后的 B 和 C 服务,即 B'' 和 C''。联调时加上灰度标x-env=dev2,这样请求按照A -> B'' -> C''进行。 应用场景 Zadig 的自测模式支持用较低成本快速拉起包括部分服务的子环境,在子环境中开发、变更目标服务,并和包括全量服务的基准环境交互来实现自测联调,企业可使用自测模式解决的问题包括但不限于: 1. 开发频率快,业务验证需求旺盛,亟需小快跑的方式迭代业务,但缺乏相关工程底座建设。 2. 微服务的数量大,业务复杂度高,导致建设一套完整的环境成本高,代价大。 3. 部分微服务因基础技术架构等原因,无法完整地复制出多套完整环境,导致多个团队绑定在一个环境中,环境稳定性难保障。 4. ...... 如何使用 下面以simple-service为例来说明如何配置和使用 Zadig 自测模式。项目背景以及自测联调需求说明如下: 1. 项目中共包括 3 个微服务 a、b、c,服务调用链路:a -> b -> c 2.dev环境为日常完整稳定的测试环境,包括全部微服务 a、b、c 3. 日常会对 a 服务进行高频改动,希望能对 a 服务进行充分自测,确保其变更可交付 管理员:配置自测模式 步骤1:开启自测模式 访问dev环境 > 更多 > 点击开启自测模式 这时会对自测模式的依赖条件做检查: 1. 业务架构实现全链路数据透传能力或者使用 Tracing 组件。系统无法自动检查,需要管理员自行确保,此处支持较为广泛应用的 SkyWalking、Zipkin、Jaeger 等。 2. 系统会对 Istio 是否安装做自动检查,如果没有请在环境所在集群进行安装 3. 服务调用链自动检查,主要依据是有 K8s Service 类型的资源和服务 a、b、c 对应 当开启自测模式后,dev环境即成为基准环境。 步骤2:配置入口服务 若需要在子环境中添加并联调入口服务,即本项目中a服务,则需要在基准环境中,配置入口服务的 Istio 网关。并将配置的访问地址解析到集群 istio-ingressgateway service 的外网访问地址上,如下图所示。 工程师:日常自测联调 创建子环境 在 dev 基准环境中通过点击创建子环境,选择 a 服务可创建包含 a 服务的子环境dev-subenv1。 请求验证 当需要请求服务 a 时,在请求头部加入x-env=dev-subenv1即可将请求流量转发到子环境dev-subenv1中,实现子环境和dev环境的自测联调。测试效果如下所示: 1. 增加x-env=dev-subenv1请求头访问服务 a,子环境中的服务 a 会接收到请求并给出响应,对于请求链路上的 b 和 c 服务,dev环境中的服务会给出正常响应。 子环境 dev-subenv1 中a服务的日志: 2. 执行不带任何头部信息的请求,直接请求服务 a,dev环境中的服务 a、b、c 会处理请求,子环境中无请求流量输入。 基准环境 dev 中a服务的日志: Zadig 的自测模式是为开发者量身定制的解决方案,适用于多人协同开发、业务规模大、服务相互关联、日常变更频繁的场景。传统测试环境所带来的有限资源、高成本、复杂性等问题,在 Zadig 的自测模式下迎刃而解。 通过低成本搭建子环境、灵活部署少量服务,Zadig 的自测模式使开发者能够在独立的测试环境中进行高效工作,摆脱了对同一测试环境的争夺,提升了开发流程的质量和效率。 欢迎大家下载试用,体验更高效的开发方式! 立即体验 Zadig V2.0 新架构,开启高效交付之旅!🚀 Zadig 开放,链接,专业 阅读原文/Zadig 在 Github/Zadig 在 Gitee 推荐阅读 :只有大厂才可以有 DevOps 平台?/Zadig vs. Jenkins 详细比对:时代的选择与开发者之选/基于 Istio + Zadig,零负担实现云原生全链路灰度发布/阿里云 MSE + Zadig,面向开发者的全链路灰度发布解决方案/ZADIG 专家版倾情上线:一键高效发布,119元/人月起,社区老友享年终福利!

优秀的个人博客,低调大师

有多大约束力?法官发布临时禁令 要求黑客不得发布窃取的数据

知名商业律师事务所 4 New Square Chambers 在 6 月 12 日遭到网络攻击,不少私人数据因此被泄露。援引外媒 The Register 报道,近日该公司赢得了一项法庭禁令,阻止黑客公布这些窃取的数据。 在遭到勒索软件攻击之后,黑客威胁如果不支付赎金就公开所有窃取的信息。为此,女法官 Steyn 授权发布了一项临时禁令,禁止网络犯罪分子使用、公布或向任何一方传达有关被盗数据或其部分内容。 虽然禁令的有效期只到本周五,不过在暗网黑客论坛上似乎还没有黑客泄露任何相关的数据。而这种禁令此前从未发生过,虽然可能性很小,但每个人都很好奇黑客是否会在赎金要求上退缩,避免泄露被盗数据。 我们无法预测这一法院命令的影响,因为网络犯罪分子已经开始无视美国和欧盟在这一问题上的努力,并谋划对西方国家发动更大规模的攻击。而且从勒索攻击来看,越来越多的大公司愿意为数据妥协而支付赎金。

优秀的个人博客,低调大师

刘烈宏:“十四五”期间我国将从5方面发力大数据

在5月26日举办的“2021中国国际大数据产业博览会”上,工业和信息化部党组成员、副部长刘烈宏出席开幕式并致辞。 刘烈宏表示,在党中央、国务院的坚强领导下,工信部扎实推进国家大数据战略,加快信息通信网络建设,加强技术和产业支撑,深入开展行业示范应用,打造产业集群,取得了积极进展。“十三五”时期,我国大数据产业年均复合增长率超过30%,2020年产业规模超过1万亿元。 “十四五”时期,我国大数据产业将步入集成创新、快速发展、深度应用、结构优化的新阶段。刘烈宏指出,下一步,要立足新发展阶段,贯彻新发展理念,构建新发展格局,重点做好5方面工作。 一是持续提升网络供给能力。推进以5G和光纤网络为代表的“双千兆”网络协同发展。 二是大力营造智能生态体系。加强数据中心与智能计算、人工智能等技术协同,更好地推动大数据赋能千行百业。 三是把握服务实体经济方向。构建新型工业网络基础设施,支持企业开展“5G+工业互联网”融合应用创新,建立完善数据安全管理机制。 四是积极引导企业数字化转型。支持互联网企业以数据流动带动跨界融合,推动企业上云、用云,加快数字产业化发展。 五是加快完善数字治理体系。推进全国一体化政务数据中心建设,扩大基础公共数据安全有序开放,鼓励企业开展公共数据挖掘利用,赋能数字经济、数字社会发展。

优秀的个人博客,低调大师

莫唱衰:5G开局很快,但原力呈现才刚刚开始

中国的5G发牌才一年时间,正式商用也不过半年,但是,现在三家运营商建设的基站数量已经超过40万,年度将达到80万。几天前,中国移动宣布,目前已经完成全年5G基站建设任务,接下来的半年都是超额。 在2020年,中国人购买的手机中,5G手机已经占据相当的比重,用户换机主要动力就是5G。只是,现在最令人遗憾的是,我们还没有专属的杀手级5G应用。 在一些人看来,既然5G专属应用还没有出现,4G网络还堪当大任,那么5G网络的建设就应该缓行,至少是应该节奏慢下来等一等终端普及和应用开发。从运营商的现实利益出发,甚至从某些跟不上5G节奏的终端厂商或者应用开发者角度,5G网络建设慢一点都是合理的,但是,网络建设的缓慢一定会压住终端与应用进展,也就会进一步拉低5G网络建设速度,从而形成恶性循环。那时候,5G就会变得遥遥无期。 既然网络建设这样快,5G的社会应用也一定会加速推进。在信息产业中,网络始终是一切的基础,只有有了网络,终端的销售才会变得具有价值,而只有当终端与网络都超过了规模临界值,相应的应用才会真的诞生并影响社会。 以现在的数据来看,运营商的5G套餐用户数已经超过1亿,连接上5G网络的智能手机也超过了6600多万部,一个规模化的5G场景搭建即将完成。我们有理由相信,5G改变社会的好应用正在登场。以历史的经验模型来看,13%是一个新兴网络实现质的蜕变的节点,现在的中国手机用户大概在16亿,那么,5G用户数达到2亿的时刻很可能就是5G爆发的时间点。 在3G时代,很多人就认为网络建设意义不大,还不如好好把GPRS做好,可是,当3G网络与手机起步后不久,微博就改变了社会媒体方式,淘宝开始能手机购物,微信开始拿到移动互联的船票。到了4G初期,中国移动抢跑建设的4G网络,很快就让人们感受到了手机导航带来的出行革命,手机支付宝、滴滴、抖音都改变了我们的生活方式。 我们相信,5G拥有更快的网络速度、更低的网络时延和更广泛的物联网支持,也更安全更节能,任何拿出一个特性都会带来质变,何况是三个或者多个效能同时出现?5G可以让很多在4G时代能做也开始做的事情变得更得心应手,还一定会诞生出4G无法支撑的业务应用。 简单分析,在4G时代,我们已经可以直播购物,也可以远程办公和在线学习,还可以在工业互联方面有所建树。有了5G支撑以后,直播购物将更加变得丰富多彩,与历史上的电视购物的差别越来越大,让商业呈现更有效率更有价值,改变整个商业逻辑。有了5G,远程办公和学习将拥有VR/3D还有更多人工智能,不再是简单的在线看视频,而是如朕亲临“”。至于工业互联,显然是只有5G才会带来魔力。 即便现在的5G网络刚刚建设,布局也不完善,信号覆盖也不全面,但已经体现出来了相当的价值。借助5G技术,远程的会诊和手术帮助了疫情控制更加快捷,煤矿的安检也更加安全,视频的会议在移动场景下也畅快无阻。我们更有期待,在5G更为普及之后,防疫健康码将有望补齐一切短板,不能成为抗疫神器,更有可能创造5G应用传奇。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册