首页 文章 精选 留言 我的

精选列表

搜索[学习],共10000篇文章
优秀的个人博客,低调大师

Python Flask学习知识点(七)

timg (11).jpg 静态文件访问原理 app文件夹下新建文件夹static,放入一张图片demo.jpg,然后访问服务器启动默认地址127.0.0.1:81/static/demo.jpg就可以访问到这张图片。 问:为什么Flask可以在任何代码不编写的情况下自动读取到static目录下的图片文件? 答:因为Flask对于静态文件是有默认值设置的,默认情况下,Flask认为静态文件夹的名字就叫ststic,并且位于应用程序的根目录下的,也就是app文件夹目录下。 image.png 问:为什么应用程序根目录是app目录而不是app上边的flaskDemo目录? 答:因为在实例化Flask核心对象是传入了一个参数,如下代码: def create_app(): app = Flask(__name__) app.config.from_object('app.secure') app.config.from_object('app.setting') register_blueprint(app) db.init_app(app) db.create_all(app=app) return app __name__这个参数决定了我们应用程序的根目录是app目录。 如果不想使用默认的static作为静态文件存储路径,可以通过更改配置来访问, app = Flask(__name__, static_folder='web/img') 更改成为这个路径,就要这样访问:127.0.0.1:81/img/demo.jpg, 还可以这么改: app = Flask(__name__, static_folder='web/img', static_path='') 但是我们一般还是使用Flask默认设置即可,如果确实有需求,具体使用详情请查阅官方文档。 静态文件放到蓝图中 之前说过,Flask里有两个层级: Flask核心对象:应用程序级别 蓝图 对于静态文件,也有两个级别: 应用程序static 蓝图static 如果你认为你的静态文件是针对你的蓝图的话,那么你其实是可以把静态文件注册到蓝图上边,而不是注册到应用程序上边。 image.png 蓝图的相关方法其实几乎就是复制了Flask核心对象的api,基本参数都是一致的。 蓝图注册静态文件夹: from flask import Blueprint # 蓝图 web = Blueprint("web", __name__, static_folder='', static_url_path='') 模板文件 模板就是html,但是和普通html不同,模板是没有数据的,它等待填充数据。 app文件夹下新建文件夹templates,新建html文件:test.html: image.png 同上边提到的static文件夹一样,我们可以自定义templates文件夹的位置,通过更改template_folder=参数来自定义templates文件夹的位置,例如,把templates文件夹移动到web文件夹下后需改动: 两种更改方法: Flask核心对象上更改:app = Flask(__name__, template_folder='web/templates') 在蓝图对象上更改:web = Blueprint("web", __name__, template_folder='templates') 现在要把视图函数中返回的数据填充到模板test.html中,使用Flask内置的方法:render_template() from flask import render_template @web.route('/test') def test(): r = { "name": "allen", 'age': 24 } r1 = { "name": "zhao", "age": 12 } return render_template('test.html', data=r, data1=r1) 模板语言 Jinja2 如何在模板中组织、解析相关数据 编辑test.html: <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>Title</title> </head> <body> <h1>demo</h1> {{data.age}} {{data1.age}} </body> </html> 运行代码,浏览器输入127.0.0.1:8000/test image.png 可以看到,之前我们写在视图函数中的数据已经展示到页面了。 Flask为了让我们很好的在模板解析和展示数据,它引入了一个模板引擎,叫做Jinja2。 Jinja2有自己的语法,例如注释代码:{#hello word#},这里就把hello word注释掉了。 我们的pycharm默认是不会像写python代码一样智能提示Jinja2的语法,但是,更改设置即可: image.png Jinja2也叫做模板语言, Flask官方推荐我们使用Jinja2,大家也可以自己使用其他的模板语言。

优秀的个人博客,低调大师

机器学习笔记——特征标准化

数据标准化是在特征处理环节必不可少的重要步骤。 数据标准化是为了消除不同指标量纲的影响,方便指标之间的可比性,量纲差异会影响某些模型中距离计算的结果。 常见标准化方法主要有归一化、正态化。 数据归一化也即0-1标准化,又称最大值-最小值标准化,核心要义是将原始指标缩放到0~1之间的区间内。相当于对原变量做了一次线性变化。 其公式为 EX = (x- min)/(max - min) 另一种常用的标准化方法是z-score标准化,将原始指标标准化为均值为0,标准化为1的正态分布。 EX = (x - mean)/σ R语言中的特征标准化: library("caTools") library("scales") data(iris) split = sample.split(iris$Species,SplitRatio = .8) train_data = subset(iris,split == TRUE) test_data = subset(iris,split == FALSE) train_data[,-5] = apply(train_data[,-5],2,rescale,to = c(0,1)) test_data[,-5] = apply(test_data[,-5],2,rescale,to = c(0,1)) 以上scales包中的rescale函数可以自动完成指标中0-1标准化的任务,事实上,它可以将原始指标线性变化到任何一个数字区间内。 我们可以来验证结果是否是可信的。 range(train_data[,1]) range(apply(train_data[,-5],2,rescale,to = c(0,1))[,1]) [1] 4.3 7.7 [1] 0 1 当然你也可以自己写一个叫简单的0-1标准化函数 scale1 = function(x){ (x - min(x))/(max(x) - min(x)) } range(apply(train_data[,-5],2,scale1)[,1]) [1] 0 1 z-score标准化 z-score标准化可以通过scale函数快速实现。 train_data[,-5] = scale(train_data[,-5]) mean(train_data[,1]);sd(train_data[,1]) [1] 5.869167 [1] 0.8259241 mean(scale(train_data[,-5])[,1]);sd(scale(train_data[,-5])[,1]) [1] 0 [1] 1 #自定义一个z-score标准化函数 z_norm = function(x){ (x - mean(x))/sd(x) } mean(apply(train_data[,-5],2,z_norm)[,1]);sd(apply(train_data[,-5],2,z_norm)[,1]) [1] 0 [1] 1 Python中sk-learn库中有专门用于处理以上两种标准化的函数。 from sklearn import preprocessing from sklearn.model_selection import train_test_split from sklearn.datasets import load_iris import pandas as pdimport numpy as np iris = load_iris() data = iris['data'] iris_data = pd.DataFrame( data = data, columns = ['sepal_length','sepal_width','petal_length','petal_width'] ) iris_data["Species"] = iris[ 'target'] iris_data["Species"] = iris_data["Species"].map({0:"setosa",1:"versicolor",2:"virginica"}) x,y = iris_data.iloc[:,0:-1],iris_data.iloc[:,-1] train_data,_data,train_target,test_target = train_test_split(x,y,test_size = 0.2,stratify = y) Python中的0-1标准化 min_max_scaler = preprocessing.MinMaxScaler() #实例化0-1标准化方法 X_train_minmax = min_max_scaler.fit_transform(test_data.iloc[:,0:4].values) X_test_minmax = min_max_scaler.transform(test_data.iloc[:,0:4].values) X_train_minmax[:,0].max() - X_train_minmax[:,0].min()1.0 Python中的z-score标准化 训练集第一列的均值和方差如下 train_data.iloc[:,0].mean();train_data.iloc[:,0].std() 5.86166666666666 40.8416853174847874 sc_X = preprocessing.StandardScaler() #实例化z-score标准化方法 X_train = sc_X.fit_transform(train_data.iloc[:,0:4].values) X_test = sc_X.transform(test_data.iloc[:,0:4].values) 标准化后第一列的均值和方差 X_train[:,0].mean();X_train[:,0].std() -2.2907601741432396e-151.0 以上仅介绍了最常用的两种标准化特征的方法及其实现,标准化的方法还有很多,对于什么的模型需要使用标准化以及适用什么方法的标准化,需要视具体场景和数据量级差异而定,小编也在摸索中。 标准化一方面可以防止原始特征中量纲差异影响距离运算(比如欧氏距离的运算)。 另一方面标准化也可以在一定程度上提升算法求解的效率。 原文发布时间为:2018-09-23 本文作者:杜雨 本文来自云栖社区合作伙伴“数据小魔方”,了解相关信息可以关注“数据小魔方”。

优秀的个人博客,低调大师

Python 学习之进程与线程 「 上 」

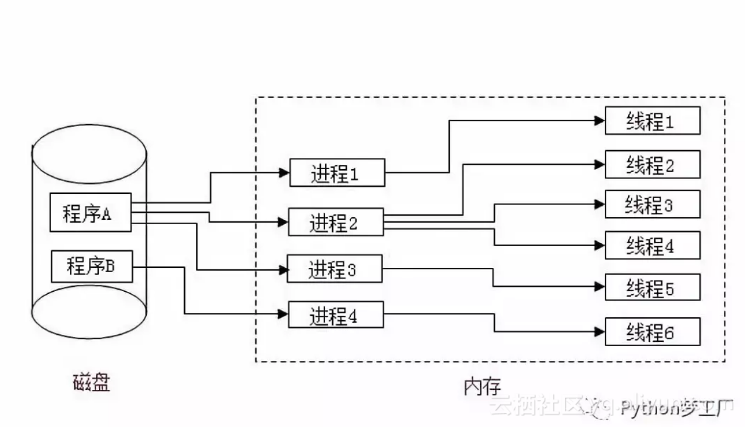
进程与线程 进程:对于操作系统来说,一个任务就是一个进程(Process),比如打开一个浏览器(任务)就是启动一个浏览器进程。进程是系统中程序执行和资源分配的基本单位,每个进程都有自己的数据段、代码段和堆栈段。 线程:有些进程不止同时干一件事情,比如Word,它可以同时进行打字、拼写检查、打印等事情。在一个进程内部,要同时干多件事情,就需要同时运行多个“子任务”,我们把进程内的这些“子任务”称为线程(Thread),线程是最小的执行单元。 实现多任务原理 现代操作系统比如 Mac OS X,UNIX,Linux,Windows 等,都支持“多任务”。多任务指的是操作系统可以同时运行多个任务,比如同时在聊 QQ,听音乐,码字… 单核CPU实现多任务原理:CPU执行代码都是顺序执行的,操作系统轮流让各个任务交替执行,QQ 执行 2us 秒,切换到听音乐,听音乐执行 2us 秒,再切换到 word,执行 2us 秒…每个任务都是交替执行的,但是由于CPU的调度执行速度实在是太快了,我们感觉就像所有任务都在同时执行一样。 多核CPU实现多任务原理:真正的并行执行多任务只能在多核CPU上实现,但是,由于任务数量远远多于CPU的核心数量,所以,操作系统也会自动把很多任务轮流调度到每个核心上执行。 并行与并发 并发:看上去同时执行,任务数多于核心数并行:真正同时执行,任务数小于等于核心数 多任务的实现方式: 多进程模式 多线程模式 协程模式 多进程+多线程模式 单进程(任务)现象 代码块 fromtimeimportsleepdefrun(): while1: print("执行子进程") sleep(1)if__name__=="__main__": while1: print("执行父进程")#父进程不结束,子进程无法开始 sleep(1) run()#不会执行到run方法,只有上面的while循环结束才可以执行 运行结果 多进程(任务)现象 1.任务间互不干扰 启动进程执行多任务,各个任务间互不干扰。multiprocessing库,跨平台版本的多进程模块,提供了一个Process类来代表一个进程对象 代码块 frommultiprocessingimportProcessfromtimeimportsleepimportosdefrun1(num): while1: #getpid()获取当前进程id号,getppid()获取当前进程的父进程id号 print("执行子进程-%s"%num,os.getpid(),os.getppid()) sleep(2)defrun2(num): while1: print("执行子进程-%s"%num) sleep(3)if__name__=="__main__": while1: print("启动父(主)进程",os.getpid()) #创建子进程target:进程执行的任务,args为元组类型 p1=Process(target=run1,args=("01",)) p1.start()#启动进程 p2=Process(target=run2,args=("02",)) p2.start()#启动进程 whileTrue: print("执行主进程") sleep(1) 运行结果 2. 任务间相互干扰 事实上同时执行的各个任务之间并不是没有关联的,而是需要相互通信和协调,有时,任务1必须暂停等待任务 2 完成后才能继续执行,有时,任务 3 和任务 4 又不能同时执行。所以,多进程和多线程的程序的复杂度要远远高于我们前面写的单进程、单线程的程序。 代码块 frommultiprocessingimportProcessfromtimeimportsleepdefrun(num): print("子进程启动") sleep(2) print("子进程结束")if__name__=="__main__": print("父进程启动") #创建多个子进程,此处以一个为例 p=Process(target=run,args=("1",)) p.start() #未加入join()方法时,父进程的结束不影响子进程。为了让父进程等待所有的子进程结束后再继续执行父进程,需要添加一个join()方法,通常用于进程间的同步 p.join() print("父进程结束") 运行结果 3.启动大量子进程 以进程池的方式来批量创建多个子进程,体现多任务的并发执行 代码块 frommultiprocessingimportPoolimporttime,os,randomdefrun(num): print("子进程%d启动--%s"%(num,os.getpid())) start=time.time() time.sleep(random.choice([1,2,3])) end=time.time() print("子进程%d结束--%s--耗时%.2f"%(num,os.getpid(),end-start))if__name__=="__main__": print("父进程启动") #以进程池来创建多个进程,Pool默认大小是CPU核心数,表示可以同时执行的进程数量 p=Pool() foriinrange(10): #创建进程,放入进程池统一管理 p.apply_async(run,args=(i,)) #在调用join()之前必须先调用close(),调用close()之后就不能再继续添加新的进程了 p.close() #进程池对象调用join(),会等待进程池中所有的子进程结束完再去执行父进程 p.join() print("父进程结束") 运行结果 4.1文件拷贝(单进程) 当拷贝的文件量很少时,单进程的方式比较快,因为多进程需要先创建进程花费时间;当拷贝的文件量很大很多时,多进程的优势就体现出来了。例子中拷贝的是大小为 446 M 的多张图片,多进程花费的时间较少。 代码块 importos,time#实现文件的拷贝,此处文件大小为446MdefcopyFile(rPath,wPath): fr=open(rPath,"rb") fw=open(wPath,"wb") content=fr.read() fw.write(content) fr.close() fw.close() path=r"C:\Users\Mark\Pictures\pic1\12" toPath=r"C:\Users\Mark\Pictures\pic1\14"#读取path下的所有文件 filesList=os.listdir(path)#启动for循环处理每一个文件 start=time.time()forfileNameinfilesList: copyFile(os.path.join(path,fileName),os.path.join(toPath,fileName)) end=time.time() print("总耗时:%0.2f"%(end-start))#总耗时:19.03 4.2文件拷贝(多进程) 代码块 importos,timefrommultiprocessingimportPool#实现文件的拷贝defcopyFile(rPath,wPath): fr=open(rPath,"rb") fw=open(wPath,"wb") content=fr.read() fw.write(content) fr.close() fw.close() path=r"C:\Users\Mark\Pictures\pic1\12" toPath=r"C:\Users\Mark\Pictures\pic1\14"if__name__=="__main__": #读取path下的所有文件 filesList=os.listdir(path) #启动for循环处理每一个文件 start=time.time() p=Pool() forfileNameinfilesList: p.apply_async(copyFile,args=(os.path.join(path,fileName),os.path.join(toPath,fileName))) p.close() p.join() end=time.time() print("总耗时:%0.2f"%(end-start))#总耗时:15.76 5.封装进程对象 一般而言,父进程主要是负责调度子进程的执行,不具体负责某项任务,所以需要进行封装进程对象。将实现各个功能、任务的子线程封装起来,父线程只需负责调用,提高了代码的逻辑与整洁性。 代码块 父进程调用代码 fromchildProcessimportchildProcessif__name__=="__main__": print("父进程启动") #创建子进程 p=childProcess("01") #自动调用p进程对象的run方法 p.start() p.join() print("父进程结束") 子进程实现功能代码 frommultiprocessingimportProcessimportos,timeclasschildProcess(Process): def__init__(self,num): Process.__init__(self) self.num=num defrun(self): print("子进程(%s--%s)启动"%(self.num,os.getpid())) #子进程的功能 time.sleep(3) print("子进程(%s--%s)结束"%(self.num,os.getpid())) 运行结果 原文发布时间为:2018-08-06 本文作者:Python 梦工厂 本文来自云栖社区合作伙伴“Python梦工厂”,了解相关信息可以关注“Python梦工厂”。

优秀的个人博客,低调大师

6.Swift学习之逻辑分支

一. 分支的介绍 分支语句即 if/switch/三目运算符等判断语句 通过分支语句可以控制程序的执行流程 二. if分支语句 和OC中if语句有一定的区别 判断句可以不加() 判断之后的执行语句必须用{}阔起来 在判断句中必须有明确的真假 不再有非0即真 必须有明确的Bool值 案例一 let a = 10 // 错误写法: //if a { // print("a") //} // 正确写法 if a > 9 { print(a) } 案例二 let score = 87 if score < 60 { print("不及格") } else if score <= 70 { print("及格") } else if score <= 80 { print("良好") } else if score <= 90 { print("优秀") } else { print("完美") } 案例三: // 这个是可选类型,因为只有声明成可选类型后,才可以判断是否为空 // 可选类型会在后续讲解,可先了解即可 let view : UIView? = UIView() // 判断如果view有值,则设置背景 // 错误写法 //if view { // view.backgroundColor = UIColor.red //} if view != nil { view!.backgroundColor = UIColor.red } 三. 三目运算符 Swift 中的 三目 运算保持了和 OC 一致的风格 var a = 10 var b = 50 var result = a > b ? a : b print(result) 四.guard的使用 guard是Swift2.0新增的语法,目的是提高程序的可读性 它与if语句非常类似,但不同的是当条件为false的时候执行 guard语句必须带有else语句,它的语法如下: 当条件表达式为true时候跳过else语句中的内容,执行后面的语句组 条件表达式为false时候执行else语句中的内容,跳转语句一般是return、break、continue和throw guard 条件表达式 else { // 条换语句 break } 语句组 例子 var age = 18 func online(age : Int) -> Void { guard age >= 18 else { print("回家去") return } print("可以上网") } online(age) 四.switch分支 switch的介绍 Switch作为选择结构中必不可少的语句也被加入到了Swift中 苹果对Switch进行了大大的增强,使其拥有其他语言中没有的特性 switch的简单使用 基本用法和OC用法一致 不同之处: switch后可以不跟() case后可以不跟break(默认会有break) case后多行语句可以不加() 例子 let sex = 0 switch sex { case 0 : print("男") case 1 : print("女") default : print("其他") } 补充一: 一个case判断中,可以判断多个值 多个值以,隔开 let sex = 0 switch sex { case 0, 1: print("正常人") default: print("其他") } 补充二: 如果希望出现之前的case穿透,则可以使用关键字fallthrough let sex = 0 switch sex { case 0: fallthrough case 1: print("正常人") default: print("其他") } Switch支持多种数据类型 浮点型的switch判断 let f = 3.14 switch f { case 3.14: print("π") default: print("not π") } 支持字符串类型(后面会讲字符串) let m = 5 let n = 10 var result = 0 let opration = "+" switch opration { case "+": result = m + n case "-": result = m - n case "*": result = m * n case "/": result = m / n default: result = 0 } print(result) switch支持区间判断 什么是区间? 数学中区间(0,10)、(0,10]、[0,10)、[0,10] swift中的区间常见有两种 半开半闭区间:0..<10 表示:0~9,不包括10 闭区间:0...10 表示:0~10 let score = 88 switch score { case 0..<60: print("不及格") case 60..<80: print("几个") case 80..<90: print("良好") case 90..<100: print("优秀") default: print("满分") }

优秀的个人博客,低调大师

Python Flask学习知识点(六)

timg (10).jpg image.png Flask多线程机制 发送请求和服务器处理请求的线程之间的关系? 客户端发送十个请求,Flask开启多少个线程处理请求?其实是由web服务器开启的多线程。 如果要上生产线,一般不会用Flask自带的web server。 对于一个web网站而言,必须有承受并发的能力。 单线程: 如果是单线程,只有当一个请求处理完成之后,才会处理下一个请求,所以这时候看起来就像是要排队一样 单线程下,当一个请求进来之后,Flask会实例化一个Request对象,用这个对象来装载请求信息,这时候只有一个实例化的request,当第一个请求结束后,Flask会再实例化一个Request对象来装载第二个请求,然后request变量又指向当前请求,那么这样众多用户就不会混乱。 多线程: werkzeug库下local模块下的Local对象,Flask就是用Local来做线程隔离的。 Local对象的本质就是用线程的id号作为字典的键这种基本原理实现的。 Flask中线程隔离栈LocalStack LocalStack 是实现线程隔离的栈结构,把Local封装了。 LocalStack需要使用push方法 LocalStack: Local特性 Stack特性:栈结构,只能取栈顶元素,先进后出 使用线程隔离的意义在于:使当前线程能够正确引用到他自己做创建的对象,而不是引用到其他线程做创建的对象 线程隔离对象 LocalStack 问:Flask使用LocalStack为了隔离哪个对象? 答:被线程隔离对象 RequestContext AppContext Flask核心对象全局只有一个。 看一段测试代码,测试下LocalStack线程隔离: import threading from werkzeug.local import LocalStack stack = LocalStack() stack.push('a') print('主线程top:', stack.top) def child(): print("子线程:", stack.top) stack.push('b') print('子线程:', stack.top) t = threading.Thread(target=child, name='demo') t.start() print('主线程top:', stack.top) 打印结果: 主线程top: a 子线程: None 子线程: b 主线程top: a 还有哪些是被线程隔离的对象? image.png 以上都是被线程隔离的对象。 ViewModel的基本概念 很多时候,我们的数据在提交给页面的时候需要做一些处理或者裁剪,这时就需要ViewModel层来做这件事,如图: image.png viewModel作用 裁剪 修饰 合并 app文件夹下新建文件夹view_models,这里就可以处理数据的裁剪、修饰、合并。 单页面与网站的区别 一个网站页面由哪几部分构成? JS CSS(静态文件) HTML模板 数据 网站 一般来讲,服务器端把数据返回到HTML模板中,称之为服务器渲染,然后返回到浏览器给用户,此时,客户端浏览器网页中的JS CSS起作用再一次发起请求渲染页面,这是一个完整的页面就处理完了。 image.png 单页面 浏览器去请求一个静态的html,html返回到客户端浏览器后,html里边的js css 发起请求,来填充数据。 image.png 单页面和普通网站有什么区别: 区别的第一种说法: 对于多页面普通网站而言,大多数情况下它的数据渲染或者说模板填充都是在服务器端进行的, 而对于单页面来说,他数据的渲染是在客户端进行的。 区别的第二种说法: 单页面业务逻辑也就是说数据运算主要集中在客户端用js去操作,而普通网站而言,绝大多数业务逻辑是在服务器,也就是视图函数中去进行的。

优秀的个人博客,低调大师

微服务学习之thrift介绍安装

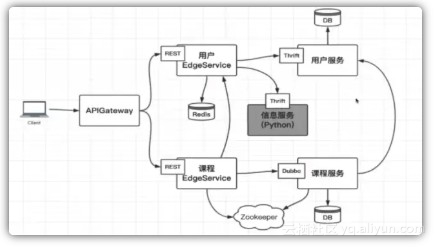
最近在做一个docker+Kubernetes微服务容器化实战项目,项目中用到了很多不熟悉的组件,也遇到了挺多的问题。项目结构是这样的: 在做信息服务的时候需要安装thrift组件,遇到了点儿问题,特此记录下过程。 首先来说一下thrift: 什么是thrift? 简单来说,是Facebook公布的一款开源跨语言的RPC框架. 什么是RPC框架? RPC全称为Remote Procedure Call,意为远程过程调用,常用的rpc框架有thrift、dubbo、grpc、motan等。 假设有两台服务器A,B。A服务器上部署着一个应用a,B服务器上部署着一个应用b,现在a希望能够调用b应用的某个函数(方法),但是二者不在同一个进程内,不能直接调用,就需要通过网络传输,在AB服务器之间建一条网络传输通道,a把参数传过去,b接收到参数调用自己的方法,得到结果,再通过网络传回给a,简单讲就是A通过网络来调用B的过程.这个过程要涉及的东西很多,比如多线程,Socket,序列化反序列化,网络I/O,很复杂,于是牛掰的程序员把这些封装起来做成一套框架,供大家使用,就是RPC框架。 thrift的跨语言特型 thrift通过一个中间语言IDL(接口定义语言)来定义RPC的数据类型和接口,这些内容写在以.thrift结尾的文件中,然后通过特殊的编译器来生成不同语言的代码,以满足不同需要的开发者,比如java开发者,就可以生成java代码,c++开发者可以生成c++代码,生成的代码中不但包含目标语言的接口定义,方法,数据类型,还包含有RPC协议层和传输层的实现代码. thrift的协议栈结构 thrift是一种c/s的架构体系.在最上层是用户自行实现的业务逻辑代码.第二层是由thrift编译器自动生成的代码,主要用于结构化数据的解析,发送和接收。TServer主要任务是高效的接受客户端请求,并将请求转发给Processor处理。Processor负责对客户端的请求做出响应,包括RPC请求转发,调用参数解析和用户逻辑调用,返回值写回等处理。从TProtocol以下部分是thirft的传输协议和底层I/O通信。TProtocol是用于数据类型解析的,将结构化数据转化为字节流给TTransport进行传输。TTransport是与底层数据传输密切相关的传输层,负责以字节流方式接收和发送消息体,不关注是什么数据类型。底层IO负责实际的数据传输,包括socket、文件和压缩数据流等。 下面介在Centos7.2上安装thrift: Thirft下载安装: 这里安装源码包,即后缀是tar.gz 或者.tgz包: wget http://mirrors.tuna.tsinghua.edu.cn/apache/thrift/0.11.0/thrift-0.11.0.tar.gz 查看README和INSTALL文件,根据README和INSTALL文件,查看thrift安装说明以及thrift依赖的软件包,然后解压源码包: tar -zxf thrift-0.11.0.tar.gz 源码包第一步需要先执行以下命令,tarball(即后缀是.tar的包)不需要: ./bootstrap.sh 然后直接运行软件根目录下的configure脚本 ./configure 查看回显,显示java和python、go编译yes,其他的no编译。 因为我只需要编译java和python、go,其他的可以忽略不管。 这里需要提前安装go的环境,可以参考:https://www.jianshu.com/p/b2222fc04f47 这里有一点需要注意,本来已经安装了jdk,用java -version看到的版本1.8的jdk。 但是./configure执行完java还是no。然后查看configure文件里有如下的代码: 大概意思是thrift编译java需要jdk和ant,然后再执行ant -version发现确实没有安装ant。那就安装ant呗: 安装ant: 这里顺便安了一下maven。 wget http://repos.fedorapeople.org/repos/dchen/apache-maven/epel-apache-maven.repo -O /etc/yum.repos.d/epel-apache-maven.repo yum -y install apache-maven yum -y install ant ant安装好了: 如果你也遇到./configure执行完java后面是no的情况,你就得首先检查jdk和ant了。 下面继续执行安装thrift的步骤: #使用make命令进行编译 make #使用make install命令进行安装 make install 最后验证: 输入thrift -version命令,查看输出信息判断thrift是否安装成功 $ thrift -version Thrift version 0.11.0 如上回显,说明thrift安装成功,至此,你可以利用thrift进行开发实现。 windows安装请参考: https://www.jianshu.com/p/42e4b5919434 原文发布时间为:2018-09-19 本文作者:小碗汤 本文来自云栖社区合作伙伴“我的小碗汤”,了解相关信息可以关注“我的小碗汤”。

优秀的个人博客,低调大师

Python Flask学习知识点(四)

timg (8).jpg 上节讲到,视图函数可以以接受参数的形式来获取传入后台的参数,但是往往我们需要对参数进行校验,比如说请求一个10条数据,那么page=10,但是如果某些比较皮的小盆友传入一个page=10000,那服务器也要去数据库查询10000条记录返回吗?显然不能那么做,所以这就涉及到在Flask中做参数检查的工作。 WTForms参数验证 首先,安装这个第三方的插件wtformspip install wtforms 我们都知道,在web应用中,分层这个概念非常重要,MVC模式其实可以理解为就是分层,这里我们引入验证层这个概念。无论写任何的web应用,验证层都是非常重要的概念。 所以我们所有的参数校验工作,都不会直接写到视图函数中,而是都会放到验证层去做。 在app文件夹下新建forms文件夹,并新建book.py文件: image.png 编写book.py: from wtforms.validators import Length, NumberRange, DataRequired() from wtforms import Form, StringField, IntegerField class SearchForm(Form): q = StringField(validators=[DataRequired(), Length(min=1, max=30)]) page = IntegerField(validators=[NumberRange(min=1, max=99)], default=1) 解释这段代码: 使用wtforms提供的StringField对象来定义参数q的类变量 使用wtforms提供的IntegerField对象来定义参数page的类变量 wtforms内置了很多的验证对象来帮助我们快速的完成对参数的验证,而不需要手动编写验证函数。当然了,我们也可以自定义验证对象。 为了验证q参数,可以使用内置的验证对象:Length,验证q参数的长度,validators接受一个list,可以传入多个验证对象,这里我们验证q参数传入Length验证对象。 同样,验证page参数也是同样的原理,这里使用的三个内置的验证对象(NumberRange,Length,DataRequired),可以查阅文档了解详细的用法。 编写完验证层代码,在视图函数中调用,更改web文件夹下book.py: from flask import jsonify, request from flaskDemo.app.forms.book import SearchForm from . import web @web.route('/hello') def search(): form = SearchForm(request.args) if form.validate(): q = form.q.data page = form.page.data result = {"name": q, "valus": page} return jsonify(result) return jsonify({"error": 0}) 解释代码: 首先导入SearchForm并实例化为form对象,并且传入参数request.args,通过form.validate()的返回值判断是否符合验证器规定的结果。 这里讲一点,使用page = form.q.data这种方式获取q和page的值,而不直接使用q,是因为我们之前在验证层SearchForm中定义了page参数如果为空,使用1为默认值,所以我们要从form.q.data 这种拿到page参数。 看下效果,运行run.py启动,在浏览器中输入符合规则的urlhttp://127.0.0.1:8000/hello?q=demo&page=1 再输入不符合规则的urlhttp://127.0.0.1:8000/hello?q=demo&page=100 返回结果: image.png image.png 一个是成功,一个是失败。 因为之前我们在验证层中定义了page的最大值为99,所以如果输入100,就会返回错误。 再试一下不输入page参数:http://127.0.0.1:8000/hello?q=demo image.png 还是可以返回默认值。 继续,看下图: image.png debug调试过程中,看下form实例中的一个errors,这个errors就是当验证不通过时,wtforms给我们的一个错误提示,在一般情况下,如果参数验证不通过时是会抛出一个异常的,但是使用wtforms,它会把错误提示放到errors属性中而不抛出异常。 更改代码: def search(): form = SearchForm(request.args) if form.validate(): q = form.q.data page = form.page.data result = {"name": q, "valus": page} return jsonify(result) return jsonify({"error": form.errors}) 这里改为return jsonify({"error": form.errors})。 再运行代码输入URLhttp://127.0.0.1:8000/hello?q=demo&page=100得到如下: image.png 可见wtforms告诉我们为什么验证不通过。 这里也可以在SearchForm自定义返回的错误信息,只需更改为: class SearchForm(Form): q = StringField(validators=[DataRequired(), Length(min=1, max=30)]) page = IntegerField(validators=[NumberRange(min=1, max=99, message="传入的参数不符合要求")], default=1) 再运行代码: image.png 拆分配置文件 之前我们一直是把配置参数全部放到config.py中,但是这样的话会有一个问题,那就是如果我们把比较私密的配置(例如数据库地址以及密码)和普通的参数放在一起,势必会有安全风险,比如把代码传到了git上,所以最好把配置文件拆分为两种不同级别的,这里我们把config.py拆分为secure.py和setting.py,并且全部放到app文件夹下。 secure.py 用来存放数据库密码、账号还有我们后边提到的flask app key ,这样比较机密的信息,单独放配置文件中,还有就是开发环境和生产环境中的不同设置,比如 debug=True。 setting.py 用来存放不涉及到机密的,生产和开发环境一样的配置。 更改之前的代码,app文件夹下的__init__.py: def create_app(): app = Flask(__name__) app.config.from_object("app.setting") app.config.from_object("app.secure") register_blueprint(app) return app current_app 在Flask中,如果要在运行中读取配置文件中的参数,需要使用Flask核心对象app来查找,但是之前讲过,如果反复导入app,或造成循环导入,那么解决方法就是使用current_app,current_app其实就是指代的app, 例如,读取配置文件中的PER_PAGE变量: 因为之前我们做了这个操作: def create_app(): app = Flask(__name__) app.config.from_object("app.setting") app.config.from_object("app.secure") register_blueprint(app) return app 把setting.py和secure.py中的配置加到了Flask内置config对象中,所以要这样读取配置文件中的变量: current_app.config['PER_PAGE'] 欲知后事如何,请看下回分解,记得点个赞~感谢

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册