首页 文章 精选 留言 我的

精选列表

搜索[学习],共10000篇文章
优秀的个人博客,低调大师

Python高级知识点学习(九)

并发、并行,同步、异步,阻塞、非阻塞 并发、并行 并发是在一个时间段内,有几个程序在同一个cpu上运行,但是任意时刻只有一个程序在cpu上运行。 并行是任意时刻点上,有多个程序同时运行在多个cpu上。 同步、异步 同步是指代码调用IO操作时,必须等待IO操作完成才返回的调用方式。 异步是指代码调用IO操作时,不必等待IO操作完成就返回的调用方式。 阻塞、非阻塞 阻塞是指调用函数时候当前线程被挂起。 非阻塞是指调用函数时候当前线程不会被挂起,而是立即返回。 阻塞和非阻塞的概念和同步异步感觉很像,但是其实它们之间是有区别的。 区别: 同步和异步实际上是消息通信的一种机制,可以把IO操作看做一个消息,调用IO操作时,相当于发一个消息给另外一个线程(或者说另外一个协程),让它去执行某些操作,在提交数据之后立刻得到future,后边就可以通过future拿到结果,实际上是消息之间的通信机制。 阻塞和非阻塞是不同于同步异步的,它是函数调的一种机制。 IO 多路复用 (select、poll 和 epoll) unix中五种I/O模型 阻塞式I/O 非阻塞式I/O I/O复用 信号驱动式I/O (用的比较少) 异步I/O (POSIX的aio_系列函数) 以上五种是递进式的发展。 I/O多路复用: select方法也是阻塞的方法,select本身是阻塞式的,select可以监听多个文件句柄和socket,select在某一个文件句柄或者socket准备好的话就会返回,这时候立刻可以做业务逻辑处理。 I/O多路复用带来的好处是: 比如现在同时发起了100个非阻塞式的请求,这时候直接使用select去监听这100个socket,这样的话一旦有一个发生状态变化,我们就可以立马处理它。 I/O多路复用中,将数据从内核复制到用户空间这段时间消耗还是省不了。 异步IO: 这里的异步IO是真正意义上的异步IO(aio),我们现在接触到很多高并发框架实际上都没有使用异步IO,实际上在很大程度上使用的都是io多路复用技术,IO多路复用很成熟很稳定,异步IO对于IO多路复用性能提升并没有达到很明显的程度,但是编码难度有很大提升,所以当前情况下IO多路复用用的比较多。 异步IO节省掉了数据从内核拷贝到用户空间这一步骤。 select、poll、epoll: select、poll、epoll都是I/O多路复用的机制。 I/O多路复用就是通过一种机制,一个进程可以监视多个描述符,一旦某个描述符就绪(一般就是读就绪或写就绪),能够通知程序进行相应的读写操作。 但select、poll、epoll本质上都是同步I/O,因为它们都需要在读写事件就绪后自己负责进行读写(数据从内核拷贝到用户区),也就是说这个读写过程是阻塞的,而异步I/O则无需自己负责进行读写,异步I/O的实现会负责把数据从内核拷贝到用户空间。 select是什么? select 函数监视的文件描述符分三类,分别是writefds、readfds、exceptfds。调用select后会阻塞,直到有描述符就绪(有数据可读、可写、或者有except),或者超时(timeout指定等待时间,如果立即返回设为null即可),函数返回。当select函数返回后,可以通过遍历fdset来找到就绪的描述符。 select目前几乎在所有的平台上支持,其良好的跨平台也是它的一个优点。select的一个缺点在于单个进程监视的文件描述符的数量有最大限制,在linux上一般为1024,可以通过修改宏定义甚至重新编译内核的方式提升这一性质,但是这样也会造成效率的降低。 poll是什么? 不同于select使用三个位图来表示三个fdset的方式,poll使用一个pollfd的指针实现。pollfd结构包含了要监视的event和发生的event,不再使用select "参数-值" 传递的方式。同时,pollfd并没有最大数量限制(但是数量过大性能也会下降)。和select函数一样,poll返回后,需要轮询pollfd来获取就绪的描述符。 从上面看,select和poll都需要在返回后,通过遍历文件描述符来获取已经就绪的socket。事实上,同时连接的大量客户端在一时刻可能只有很少的处于就绪的状态,因此随着监视的描述符数量的增长,其效率也会线性下降。 epoll是什么? epoll是在2.6内核中提出的,epoll是之前的select和poll的增强版本。相对于select和poll来讲,epoll更加灵活,没有描述符限制。epoll使用一个文件描述符管理多个描述符,将用户关系的文件描述符的事件存放到内核的一个事件表中,这样在用户空间和内核空间的copy只需要一次。 epoll它的查询使用了数据结构中性能很高的一个:红黑树。 nginx就是使用了epoll。 epoll并不代表一定比select好: 在并发高的情况下,连接活跃度不是很高, epoll比select。 并发性不高,同时连接很活跃, select比epoll好。 非阻塞I/O实现http请求 上示例代码: import socket from urllib.parse import urlparse def get_url(url): # 通过socket请求html url = urlparse(url) host = url.netloc path = url.path if path == "": path = "/" # 建立socket连接 client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) # 这里会导致后边抛异常,但是连接请求已经发出去了 client.setblocking(False) # 捕获异常 try: client.connect((host, 80)) # 阻塞不会消耗cpu except BlockingIOError as e: pass # 不停的询问连接是否建立好, 需要while循环不停的去检查状态 # 做计算任务或者再次发起其他的连接请求 while True: try: client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(path, host).encode("utf8")) break except OSError as e: pass data = b"" while True: # 这里还会抛异常,读不到就继续读 try: d = client.recv(1024) except BlockingIOError as e: continue if d: data += d else: break data = data.decode("utf8") html_data = data.split("\r\n\r\n")[1] #打印返回的数据 print(html_data) client.close() if __name__ == "__main__": get_url("http://www.baidu.com") 非阻塞I/O整个过程依赖前后的监测,整个过程不停的做while循环检测状态,但是返回时间没有变,所以并没有提高并发。 select+回调+事件循环实现http请求 目前开源的高性能框架,一般都是使用这种方式实现并发。 使用select + 回调 + 事件循环实现下载网页,并发性高且是单线程。 select方法本尊是在import select这个包里边,但是有另外一个包把select基础上进行了封装,用起来更简单:from selectors import DefaultSelector,DefaultSelector一般使用DefaultSelector这个比较多。 看代码示例: import socket import time from urllib.parse import urlparse from selectors import DefaultSelector, EVENT_READ, EVENT_WRITE selector = DefaultSelector() urls = [] stop = False class Fetcher: def connected(self, key): selector.unregister(key.fd) self.client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(self.path, self.host).encode("utf8") selector.register(self.client.fileno(), EVENT_READ, self.readable) # 当socket可读时,读数据,全部都是cpu操作 def readable(self, key): d = self.client.recv(1024) if d: self.data += d else: # 数据读完为空 selector.unregister(key.fd) data = self.data.decode("utf8") html_data = data.split("\r\n\r\n")[1] print(html_data[:30]) self.client.close() urls.remove(self.spider_url) if not urls: global stop stop = True def get_url(self, url): self.spider_url = url url = urlparse(url) self.host = url.netloc self.path = url.path self.data = b"" if self.path == "": self.path = "/" # 建立 socket 连接 self.client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) self.client.setblocking(False) try: self.client.connect((self.host, 80)) # 阻塞不会消耗cpu except BlockingIOError as e: pass selector.register(self.client.fileno(), EVENT_WRITE, self.connected) # 驱动整个事件循环 def loop(): while not stop: ready = selector.select() for key, mask in ready: call_back = key.data call_back(key) if __name__ == "__main__": # 计时开始 start_time = time.time() for url in range(60): url = "http://www.baidu.com" urls.append(url) fetcher = Fetcher() fetcher.get_url(url) loop() print(time.time()-start_time) 上边代码中,Fetcher类包含三个方法,get_url简历socket连接,connected和readable是两个回调函数。 loop函数负责驱动整个事件循环。 回调的缺点 可读性差 共享状态异常处理 异常处理困难

优秀的个人博客,低调大师

Python高级知识点学习(八)

线程同步 - condition介绍 多线程中的另外一个重要点就是condition:条件变量。 condition是python多线程编程中用于复杂线程间通信的一个锁 叫做条件变量。 cond = threading.Condition() with self.cond: cond.notify() cond.wait() condition有两层锁, 一把底层锁会在线程调用了wait方法的时候释放, 上面的锁会在每次调用wait的时候分配一把并放入到cond的等待队列中,等到notify方法的唤醒。 有关condition的详情请查阅资料。(这里作者自己暂时还没理清楚原理,见谅) 线程同步 - Semaphore 介绍 信号量,Semaphore。 Semaphore 是用于控制进入数量的锁,控制进入某段代码的线程数。 文件, 读、写, 写一般只是用于一个线程写,读可以允许有多个。 ThreadPoolExecutor线程池 多线程和多进程对比 运算,耗cpu的操作,用多进程编程 对于io操作来说, 使用多线程编程 由于进程切换代价要高于线程,所以能使用线程就不用进程。 耗费cpu的操作: def fib(n): if n<=2: return 1 return fib(n-1)+fib(n-2) if __name__ == "__main__": with ThreadPoolExecutor(3) as executor: all_task = [executor.submit(fib, (num)) for num in range(1, 10)] start_time = time.time() for future in as_completed(all_task): data = future.result() print("exe result: {}".format(data)) print("last time is: {}".format(time.time()-start_time)) 模拟IO操作: def random_sleep(n): time.sleep(n) return n if __name__ == "__main__": with ProcessPoolExecutor(3) as executor: all_task = [executor.submit(random_sleep, (num)) for num in [2]*30] start_time = time.time() for future in as_completed(all_task): data = future.result() print("exe result: {}".format(data)) print("last time is: {}".format(time.time()-start_time)) multiprocessing 多进程 使用os.fork创建子进程,fork只能用于linux/unix中。 import os import time # fork新建子进程 fork只能用于linux/unix中 pid = os.fork() print("a") if pid == 0: print('子进程id:{} ,父进程id是: {}.' .format(os.getpid(), os.getppid())) else: print('我是父进程, 我fork出的子进程id是:{}.'.format(pid)) time.sleep(2) 运行结果: a 我是父进程, 我fork出的子进程id是:3093. a 子进程id:3093 ,父进程id是: 3092. 运行结果中,可以看到打印了两次a,因为在执行完pid = os.fork()这行代码后,就创建了一个子进程,且子进程把父进程中的数据原样拷贝了一份到自己的进程中,所以父进程中打印一次,子进程中又打印一次。 多进程编程: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": progress = multiprocessing.Process(target=get_html, args=(2,)) print(progress.pid) progress.start() print(progress.pid) progress.join() print("main progress end") 使用进程池: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": # 使用进程池 pool = multiprocessing.Pool(multiprocessing.cpu_count()) result = pool.apply_async(get_html, args=(3,)) # 等待所有任务完成 pool.close() pool.join() print(result.get()) 进程池另一种方法: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": # 使用进程池 pool = multiprocessing.Pool(multiprocessing.cpu_count()) for result in pool.imap_unordered(get_html, [1, 5, 3]): print("{} sleep success".format(result)) 进程间通信 Queue、Pipe,Manager 共享全局变量不能适用于多进程编程,可以适用于多线程。 进程间通信和线程间通信有相同也有不同,不同点是之前在多线程中用的线程间通信的类和线程间同步的锁在多进程中是不能用的。 使用multiprocessing中的Queue实现进程通信 import time from multiprocessing import Process, Queue, Pool, Manager, Pipe def producer(queue): queue.put("a") time.sleep(2) def consumer(queue): time.sleep(2) data = queue.get() print(data) if __name__ == "__main__": queue = Queue(10) my_producer = Process(target=producer, args=(queue,)) my_consumer = Process(target=consumer, args=(queue,)) my_producer.start() my_consumer.start() my_producer.join() my_consumer.join() 一定要使用multiprocessing中的Queue,如果使用import queue这个queue是不行的。 pool中的进程间通信需要使用manager中的queue multiprocessing中的queue不能用于pool进程池。 pool中的进程间通信需要使用manager中的queue def producer(queue): queue.put("a") time.sleep(2) def consumer(queue): time.sleep(2) data = queue.get() print(data) if __name__ == "__main__": queue = Manager().Queue(10) pool = Pool(2) pool.apply_async(producer, args=(queue,)) pool.apply_async(consumer, args=(queue,)) pool.close() pool.join() 使用Manager,多进程修改同一变量: def add_data(p_dict, key, value): p_dict[key] = value if __name__ == "__main__": progress_dict = Manager().dict() from queue import PriorityQueue first_progress = Process(target=add_data, args=(progress_dict, "a", 22)) second_progress = Process(target=add_data, args=(progress_dict, "b", 23)) first_progress.start() second_progress.start() first_progress.join() second_progress.join() print(progress_dict) 可以看到两个进程对一个dict变量做值得填充,最终主进程中打印出了最终的dict。 通过pipe实现进程间通信: pipe的性能高于queue。 pipe只能适用于两个进程。 def producer(pipe): pipe.send("a") def consumer(pipe): print(pipe.recv()) if __name__ == "__main__": recevie_pipe, send_pipe = Pipe() #pipe只能适用于两个进程 my_producer = Process(target=producer, args=(send_pipe, )) my_consumer = Process(target=consumer, args=(recevie_pipe,)) my_producer.start() my_consumer.start() my_producer.join() my_consumer.join() my_producer进程给my_consumer进程发送的a变量可以正常打印。

优秀的个人博客,低调大师

Python高级知识点学习(七)

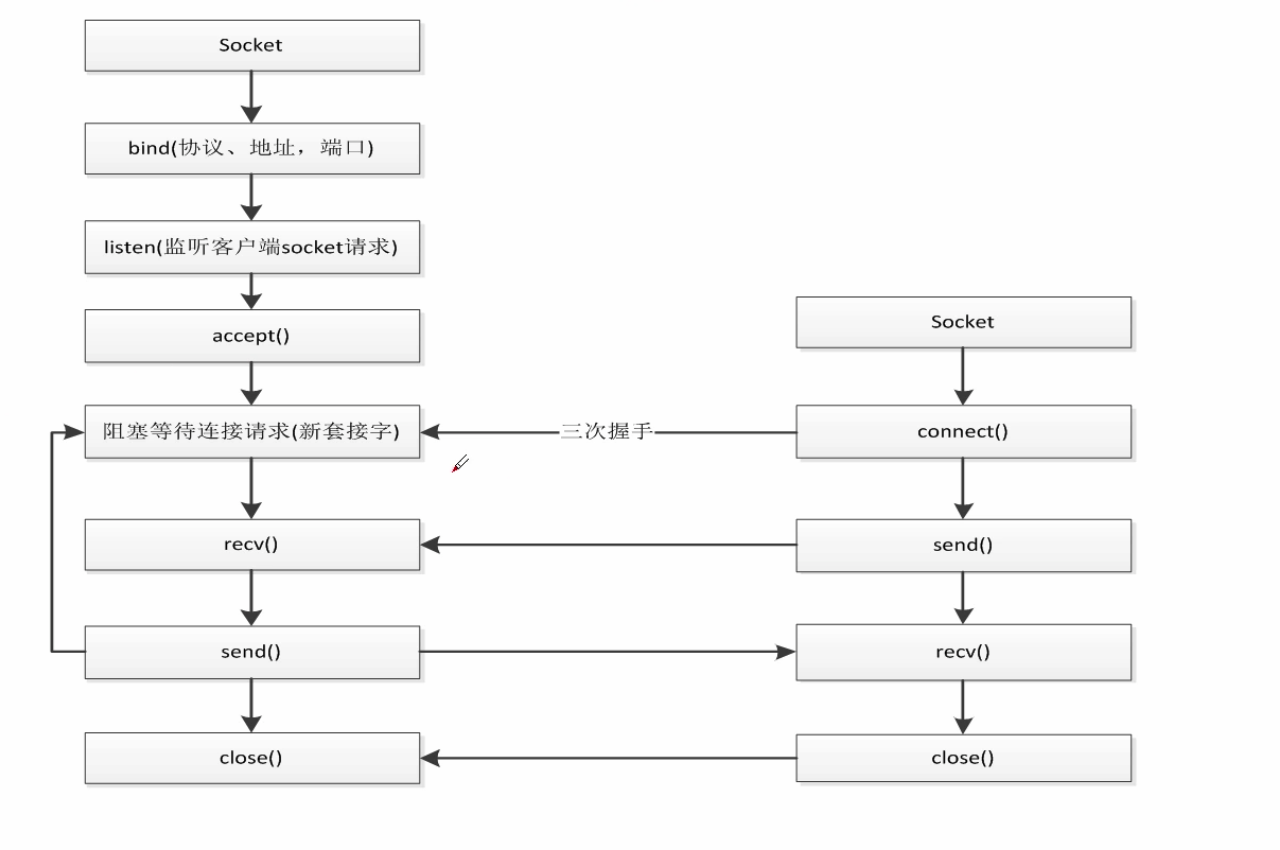
HTTP、Socket、TCP概念 socket属于常用的http协议之下的让我们可以使用tcp/ip协议的一个接口。 socket编程 image.png socket编程的模式其实是非常固定的。 上图: 左侧server端 右侧client端 server必须是随时处于一个监听的状态和服务的状态,因为不知道客户端什么时候会发送来请求。 绑定协议、地址、端口。 每一个应用程序只能占用一个端口,服务器a到服务器b发数据时,数据是不知道是由哪个应用程序接受的,这时候就需要端口机制,每一个应用程序提供一个端口。 socket连接后,只要不关闭连接,服务端可以一直给客户端发送请求,但是在http中,只完成一次发送数据就停止了。 编写测试代码: 新建文件sever.py import socket server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) # 绑定ip 端口 server.bind(('0.0.0.0', 8000)) # 监听 server.listen() sock, addr = server.accept() # 接受client端发来的数据 data = sock.recv(1024) # 打印数据 print(data.decode('utf8')) # 给client发数据 sock.send("hello".encode("utf8")) # 关闭 server.close() sock.close() 新建文件client.py import socket client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect(('127.0.0.1', 8000)) # 给server端发数据 client.send("allen".encode("utf-8")) # 接受server端发来的数据 data = client.recv(1024) # 打印数据 print(data.decode('utf8')) # 关闭 client.close() 首先运行server.py,再运行client.py,观察打印结果,可以看到,数据发送接收已经是实现。 socket实现简单聊天 要实现双向交流,肯定不能做close操作,改为一直while循环, 代码: 修改srever.py import socket server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) server.bind(("0.0.0.0", 8000)) server.listen() sock, addr = server.accept() while True: # 接受client端发来的数据 data = sock.recv(1024) # 打印数据 print(data.decode('utf8')) re_data = input() # 给client发数据 sock.send(re_data.encode("utf8")) 修改client.py: import socket client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect(('127.0.0.1', 8000)) while True: # 输入消息 re_data = input() client.send(re_data.encode("utf8")) # 接受client端发来的数据 data = client.recv(1024) # 打印数据 print(data.decode('utf8')) 运行server.py ,再运行client.py,在client.py中输入要发送的文字,在server.py中观察接收到的文字,再在server.py中发送文字,在client.py中查看。 以上就是实现了最初级的基本聊天过程。 如果要在网页上做一个聊天模块,一般都是需要用web socket来实现。 socket多用户聊天 所谓多用户聊天,其实平时我们也经常遇到。 假如你是一位线上客服人员,你需要接待的人员可能同时有多位,当你和A用户聊天时,并不妨碍和B用户C用户给你发消息,而你回消息,回给A用户的消息只有A用户可以看到,B用户是看不到的,接着看如何实现这种功能。 首先client.py的代码不用改动,只需修改server.py: import socket import threading server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) server.bind(('0.0.0.0', 8000)) server.listen() def handle_sock(sock, addr): while True: data = sock.recv(1024) print(data.decode("utf8")) re_data = input() sock.send(re_data.encode("utf8")) while True: sock, addr = server.accept() #用线程去处理新接收的连接(用户) client_thread = threading.Thread(target=handle_sock, args=(sock, addr)) client_thread.start() 上边代码把接受处理逻辑放到了线程中,每一个线程存放一个不同的socket,主线程来查看有哪些线程进入。 运行server.py,再运行多个client.py,client.py给server发消息,测试可发现可实现上边的客服功能。 注:真正客服系统要比这个复杂得多,以上代码仅供测试。 socket模拟http请求 我们平常所用到的requests包,是基于 urllib,urllib实际上是基于socket上来完成的。 requests - urlib - socket 如何通过socket去完成类似urllib中http请求呢? http请求无非就是在tcp协议之上加了一些协议,只要按照这个协议发,就会返回数据。 看代码: import socket from urllib.parse import urlparse def request_demo(url): # url拆分 url = urlparse(url) host = url.netloc path = url.path if path == "": path = "/" # 建立socket连接 client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect((host, 80)) client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(path, host).encode("utf8")) data = b"" # 每次读取1024大小,循环知道读取完毕 while True: d = client.recv(1024) if d: data += d else: break data = data.decode("utf8") print(data) client.close() if __name__ == "__main__": url = 'http://www.baidu.com' request_demo(url) 运行结果包含两部分: 第一部分request header 第二部分html源码 建立连接的过程是比较费时的,一般在使用socket编程都是为了解决长连接的问题,而不是说每发送一个请求数据返回就把它关掉。 很多时候我们需要一个交互的过程,这时候socket就派上用场了,有了socket后我们的代码灵活性高,它完全可以让我们将整个过程变得可以操控。

优秀的个人博客,低调大师

Python高级知识点学习(六)

围棋少年 Python中的迭代协议 迭代协议有两个概念: 可迭代类型(Iterable) 迭代器(Iterator) 迭代器:迭代器是访问集合内元素的一种方式, 一般用来遍历数据。 迭代器和以下标的访问方式不一样, 迭代器是不能返回的, 迭代器提供了一种惰性方式数据的方式。 可迭代对象(Iterable) 和 迭代器(Iterator) 是不同的。 可迭代对象: 实现__iter__这个魔法函数 迭代器: 实现__next__这个魔法函数 实现__iter__这个魔法函数 from collections.abc import Iterable, Iterator a = [1, 2] print(isinstance(a, Iterable)) print(isinstance(a, Iterator)) 打印结果: True False 上边代码,因为a是一个list,而list是一个可迭代对象并不是迭代器,因为list对象中没有__next__方法。 生成器 生成器函数:函数里只要有yield关键字,它就是生成器对象。 生成器对象在python编译字节码的时候就产生了。 生成器对象也是实现了迭代器协议的,所以可以使用for循环遍历到它的值。 def gen_func(): yield 1 gen = gen_func() for value in gen: print(value) 打印结果: 1 Python 中的GIL GIL:global interpreter lock (cpython) GIL:全局解释器锁。 python中一个线程对应于c语言中的一个线程。 GIL使得同一个时刻只有一个线程在一个cpu上执行字节码, 也就意味着无法将多个线程映射到多个cpu上执行。 GIL锁分配给某一线程后,并不是说这个线程执行完了之后它才会释放把它交给另外一个线程,它不是整个过程完全占有,它实际上是会在适当的时刻释放的,是结合了字节码执行的行数比如他执行了1000行字节码之后,它会释放,然后另外一个线程就可以得到运行。 GIL释放: 会根据执行的字节码行数以及时间片释放gil。 gil在遇到io的操作时候主动释放。 total = 0 def add(): global total for i in range(1000000): total += 1 def desc(): global total for i in range(1000000): total -= 1 thread1 = threading.Thread(target=add) thread2 = threading.Thread(target=desc) thread1.start() thread2.start() thread1.join() thread2.join() print(total) 上边代码两个线程分别执行两个函数,两个函数对同一变量做加减操作,本来应该先加到1000000再减1000000最终打印出0,但事实上是不会打印0的。 多线程编程 IO密集型时,适合多线程。 CPU密集型时,适合多进程。 多线程编程是我们几乎所有编程语言中都会遇到的问题。 操作系统能够切换和调度的最小单元是线程。 在最开始的时候,操作系统能够调度的最小单元是进程,但是由于进程对系统资源消耗非常大,所以后期就演变出了线程。 第一种方式:通过Thread类实例化 def get_detail_html(url): print("get detail html started") time.sleep(2) print("get detail html end") def get_detail_url(url): print("get detail url started") time.sleep(4) print("get detail url end") if __name__ == "__main__": thread1 = threading.Thread(target=get_detail_html, args=("",)) thread2 = threading.Thread(target=get_detail_url, args=("",)) # 设置为守护线程,随着主线程退出,子线程也退出 #thread1.setDaemon(True) #thread2.setDaemon(True) start_time = time.time() thread1.start() thread2.start() # 等待线程1,2执行完成 再执行完主线程; thread1.join() thread2.join() print(time.time() - start_time) 上边代码中,两个线程分别执行两个函数,主线程下有两个子线程。 thread1.setDaemon(True)这个操作是把thread1设置为守护线程,随着主线程退出,thread1也退出。thread1.join()这个操作是把主线程等待thread1执行完再执行完主线程。 第二种方式:通过重载Thread来实现多线程 def get_detail_html(url): print("get detail html started") time.sleep(2) print("get detail html end") def get_detail_url(url): print("get detail url started") time.sleep(4) print("get detail url end") class GetDetailHtml(threading.Thread): def __init__(self, name): super().__init__(name=name) def run(self): print("get detail html started") time.sleep(2) print("get detail html end") class GetDetailUrl(threading.Thread): def __init__(self, name): super().__init__(name=name) def run(self): print("get detail url started") time.sleep(4) print("get detail url end") if __name__ == "__main__": thread1 = GetDetailHtml("get_detail_html") thread2 = GetDetailUrl("get_detail_url") start_time = time.time() thread1.start() thread2.start() thread1.join() thread2.join() print("last time: {}".format(time.time()-start_time)) 上边代码继承threading.Thread必须重载run方法。 线程同步Lock、RLock 为什么要线程同步? 现有两个函数,分别是对全局变脸a进行加减操作,两个函数使用两个线程来运行,一个线程负责把a加一,另一个负责把a减一,上代码: a = 0 def add(a): a += 1 def desc(a): a-=1 首先使用内置方法dis()看一下两个函数字节码是什么样子的: import dis def add(a): a += 1 def desc(a): a-=1 print(dis.dis(add)) print(dis.dis(desc)) 打印结果: 63 0 LOAD_FAST 0 (a) 2 LOAD_CONST 1 (1) 4 INPLACE_ADD 6 STORE_FAST 0 (a) 8 LOAD_CONST 0 (None) 10 RETURN_VALUE None 66 0 LOAD_FAST 0 (a) 2 LOAD_CONST 1 (1) 4 INPLACE_SUBTRACT 6 STORE_FAST 0 (a) 8 LOAD_CONST 0 (None) 10 RETURN_VALUE None 上边代码打印结果: 看下add的里边字节码: LOAD_FAST:首先把 a LOAD 到内存中 LOAD_CONST :再把1 LOAD 到内存中 INPLACE_ADD:执行加的操作 STORE_FAST:将加完的值赋值给 a desc里边也是一样的,分四步,不同的是desc里执行的是减法。 如果同时执行add字节码和desc字节码时,之前笔记中提过,执行以上四个步骤时随时都可能释放gil锁,因为字节码的数量已经满了,以上四步任何一步骤都可能释放gil锁切换到另外一个线程,所以有可能造成一个结果,就是a要么等于1,要么等于-1,但是我们期望的是a 等于0,这时候就需要线程同步来解决问题。 我们希望在执行add函数的代码段时,另一个线程中的desc代码段是停止的,这就是线程同步机制。 python给我们提供了一个机制,叫做锁:from threading import Lock 在运行一个代码段时,加一把锁,等运行完了,再释放锁。 from threading import Lock total = 0 # 声明一把锁 lock = RLock() def add(): global lock global total for i in range(1000000): # 获得锁 lock.acquire() total += 1 # 释放锁 lock.release() def desc(): global total global lock for i in range(1000000): lock.acquire() total -= 1 lock.release() import threading thread1 = threading.Thread(target=add) thread2 = threading.Thread(target=desc) thread1.start() thread2.start() thread1.join() thread2.join() print(total) 打印结果: 0 上边代码不管累加多少次最终结果都是0。 如果没有释放锁,会导致死锁。 使用锁会影响性能。 RLock: 在同一个线程里面,可以连续调用多次acquire, 一定要注意acquire的次数要和release的次数相等。 在同一个线程中,可以使用RLock。

优秀的个人博客,低调大师

Python高级知识点学习(五)

dict的子类 首先,不建议自己编写代码继承dict和list这种原生使用c语言编写的,因为有时候,用c语言写的dict不会调用python写的覆盖的方法。 如果确实有继承dict来写代码的需求,可以使用UserDict,继承这个UserDict。 UserDict这个内部使用了python语言实现了c语言写的逻辑。 from collections import UserDict class Mydict(UserDict): def __setitem__(self, key, value): super().__setitem__(key, value*2) my_dict = Mydict(one=1) print (my_dict) 打印结果: {'one': 2} set和fronzenset set集合: 无序 不重复 set 接受一个可迭代对象 frozenset集合: 一旦设置好就无法修改。 frozenset为不可变类型。 相对于可变类型来说的好处,可以作为dict的key。 set的初始化方法: set([a, b, c]) a = {a, b, c} 两种都可以初始化 dict、set实现原理 当我们了解了背后的实现原理,就可以判断什么情况下使用dict以及为什么要使用dict。 dict查找的性能远远大于list。 在list中随着list数据的增大 查找时间会增大。 在dict中查找元素不会随着dict的增大而增大。 dict原理实际上就是利用hash算法。 数组和链表相比来说最大的优势,就是它可以做到任何一个位置直接存取而不需要从头到尾遍历,因为数组是一段连续的空间,数组取数据的时间复杂度是O(1)。 dict的key或者set的值,都必须是可以hash的。不可变对象都是可hash的, str, fronzenset, tuple。 自己实现的类重载__hash__这个魔法函数,让它可以变为可哈希对象。 dict的内存花销大,但是查询速度快, 自定义的对象或者python内部的对象都是用dict包装的。 dict的存储顺序和元素添加顺序有关,添加数据有可能改变已有数据的顺序。 Python中的变量是什么 python和java中的变量本质不一样,python的变量实质上是一个指针。我们可以理解变量就是一个便利贴, 例如:a = 1 先成对象,然后贴便利贴,把a贴在1上面。 a = [1, 2, 3] b = a print(id(a), id(b)) 打印结果: a和b的地址值一样。 is 和 == 的区别 is是判断对象的id是否相同,但是注意看下边例子: a = [1, 2, 3, 4] b = [1, 2, 3, 4] print (id(a), id(b)) print (a is b) 输出结果: 4446597320 4446597640 False 上边这种用法得到的结果很正常,再看下边代码: a = 1 b = 1 print (id(a), id(b)) print (a is b) 运行结果: 4325627840 4325627840 True 这种情况下,a和b指向的是同一个。这是由于Python内部机制决定的,将小正数建立一个全局唯一的对象,小段字符串也是一样的。 a = [1, 2, 3] b = [1, 2, 3] print(a==b) 返回True 因为: list里边实现了一个魔法函数 __eq__,当我们调用a==b这种模式的时候,会调用__eq__这个魔法函数,从而来判断值是否相等。 它们的值是相等的,只是不是同一个对象而已,所有a==b是True。 垃圾回收和del语句 cpython中垃圾回收的算法是采用 引用计数 a = 1 b = a 此时,1这个对象上就又有一个计数器,a = 1 时会在计数器上加1,b如果指向的还是1,1上边的计数器会再加1,当不使用时,执行del a,他就会将引用计数器减1,当引用计数器减到0时,python解释器会将对象回收。 对象只有在计数器减到0时,才会被回收,del只是减计数器的功能。 a = object() b = a del a print(b) print(a) 打印结果: <object object at 0x104a86100> NameError: name 'a' is not defined 可以看到,执行del后,只是把a销毁了,b还在。 __del__魔法函数: 可以在__del__魔法函数中实现自己的逻辑,当python解释器回收对象的时候,会调用对象的__del__魔法函数,它可以帮我们在回收对象时做一些事。 @property的用法 我们在读源码时,往往会看到这这种方法: @property def hello(self): pass @property 这个装饰器会把函数变为属性描述符,怎么说? 看代码: class Allen(object): def word(self): return 'word' @property def hello(self): return 'hello' a = Allen() print(a.hello) print(a.word()) 运行结果: hello word 可以发现,@property这个装饰器把取方法的模式变为取属性。 魔法函数__getattr__、__getattribute__介绍 魔法函数是python解释器内部需要用的方法,它是整个python动态特性的最根本原因。 __getattr__:就是在查找不到属性的时候调用。 例1: class User: def __init__(self, info): self.info = info def __getattr__(self, item): return '2' if __name__ == "__main__": user = User('allen') print(user.info) print(user.age) 运行结果: allen 2 例2: class User: def __init__(self, info={}): self.info = info def __getattr__(self, item): return self.info[item] if __name__ == "__main__": user = User(info={"name": "allen", "age": "3"}) print(user.name) 打印结果: allen __getattribute__ : 比__getattr__更高级,只要查找属性,就会首先进入__getattribute__这个魔法函数,强制进入,无条件的。 __getattribute__这个魔法函数尽量不要去重写,因为如果一旦写不好,整个类的属性访问就会崩溃掉,一般写框架时会用到这个魔法函数。 class User: def __init__(self,info={}): self.info = info def __getattr__(self, item): return self.info[item] def __getattribute__(self, item): return "10" if __name__ == "__main__": user = User(info={"name":"allen"}) print(user.name) print(user.test) 打印结果: 10 10 属性描述符和属性查找过程 一个类只需要实现__get__、__set__、__delete__这三个中的任意一个方法,它就算是属性描述符。 通过属性描述符,可以控制在赋值的时候它的行为,在属性设置的时候参数检查。 属性描述符有两种: 数据属性描述符:实现__get__ 和 __set__就是数据属性描述符。 非数据属性描述符:只实现一个__get__方法就是非数据属性描述符。 数据属性描述符 和 非数据属性描述符 它们的属性查找过程是不一样的。 前边提到的属性查找过程,先查找实例中的属性,然后查找类中的属性,实际上它有更加详细的查找过程。 魔法函数__new__ 和 __init__ 区别 __new__ 魔法函数在python新式类才会有 python2.2之前没有这个。 class User: def __new__(cls, *args, **kwargs): print(" in new ") return super().__new__(cls) def __init__(self): print(" in init") pass if __name__ == "__main__": user = User() 打印结果: in new in init __new__魔法函数允许在生成对象之前加逻辑,自定义对象生成过程,传递进来的是类。 __init__方法传递进去的是对象。 __new__ 在 __init__ 之前调用。 __new__中必须return super().__new__(cls)才会调用__init__方法。 def __new__(cls, *args, **kwargs):这个中的*args,和**kwargs,代表的是传入的参数。

优秀的个人博客,低调大师

Python高级知识点学习(三)

mro算法 类属性和实例属性的查找顺序 何为类属性:定义在类内部的的一些变量或者方法,都统称为类属性 何为实例属性:定义在对象内部的的一些变量或者方法,都统称为实例属性 对象也就是实例的意思。 class A: aa = 1 def __init__(self, x, y): self.x = x self.y = y a = A(2, 3) 类也是对象,看上边代码,实际上有两个空间,A 和 a 两个不同的空间。单继承时,属性查找方式,向上查找,首先查找对象里,再查找类中 在多继承时,会很复杂 python2.2之前,python里的类叫经典类,经典类继承方式如果不显式继承object,实际上是不会自动继承object,Python3中,经典类已经不存在了,都叫做新式类。经典类中,深度优先查找 。 Python2.3之后,广度优先也没有了,至今都采用C3算法Python3多重继承C3算法: #新式类 class D: pass class E: pass class C(E): pass class B(D): pass class A(B, C): pass print(A.__mro__) 打印结果:(<class '__main__.A'>, <class '__main__.B'>, <class '__main__.D'>, <class '__main__.C'>, <class '__main__.E'>, <class 'object'>)可以看到继承顺序是 A - B - D - C - E - object 类方法静态方法和实例方法 实例方法:实例方法很常见,通常我们在类里定义的都是实例方法, 只是针对于实例进行操作,实例方法中第一个参数:self,self代表的就是实例本身 静待方法: 带@staticmethod装饰器的方法叫静态方法,静态方法不需要接受cls或self,和普通的函数用法一样 类方法: 带@classmethod装饰器的方法叫做类方法,类方法第一个参数是cls,代表的是类本身,(这里的cls可以修改为任意形式的代表) def a(self): pass @staticmethod def b(): pass @classmethod def c(cls): pass Python中的私有属性 双下划綫开头表示私有属性,私有属性的访问,只能在类中的公共方法中访问,类外部防问不到,无法通过实例访问。 私有属性不仅仅是变量 还可以是函数。 class User: def __init__(self, birthday): self.__birthday = birthday user = User(2000) print(user.birthday) 运行结果: AttributeError: 'User' object has no attribute 'birthday' 以上代码块结果就是访问不到私有属性。 但是,私有不是绝对的,只是加了一个小技巧,Python中将私有属性的访问变形成这种: class User: def __init__(self, birthday): self.__birthday = birthday user = User(2000) print(user._User__birthday) 运行结果: 2000 可以看到,通过变量_User__birthday这个就可以访问到私有属性。 Java中的反射机制也是无法做到绝对安全的,从语言层面讲,没有绝对的私有属性,Python简单一些 Java麻烦一些。 Python自省 Python对象自省何为自省?自省是通过一定的机制查询到对象的内部结构使用__dict__魔法函数,dict是用C语言写的 性能高,做了很多优化,推荐使用。 也可以使用dir() ,dir()会列出类中所有属性,推荐使用。 class Student(): def __init__(self, scool_name): self.scool_name = scool_name if __name__ == "__main__": user = Student("zhao") #通过__dict__查询属性 print(user.__dict__) 打印结果: {'scool_name': 'zhao'} class Student(): def __init__(self, name): self.name = name if __name__ == "__main__": user = Student("zhao") user.__dict__["school_addr"] = "北京市" print(user.school_addr) print(user.name) a = [1, 2] print(dir(a)) print(dir(user)) 打印结果: ['__class__', '__delattr__', '__dict__', '__dir__', '__doc__', '__eq__', '__format__', '__ge__', '__getattribute__', '__gt__', '__hash__', '__init__', '__init_subclass__', '__le__', '__lt__', '__module__', '__ne__', '__new__', '__reduce__', '__reduce_ex__', '__repr__', '__setattr__', '__sizeof__', '__str__', '__subclasshook__', '__weakref__', 'name', 'school_addr', 'scool_name'] ['__add__', '__class__', '__contains__', '__delattr__', '__delitem__', '__dir__', '__doc__', '__eq__', '__format__', '__ge__', '__getattribute__', '__getitem__', '__gt__', '__hash__', '__iadd__', '__imul__', '__init__', '__init_subclass__', '__iter__', '__le__', '__len__', '__lt__', '__mul__', '__ne__', '__new__', '__reduce__', '__reduce_ex__', '__repr__', '__reversed__', '__rmul__', '__setattr__', '__setitem__', '__sizeof__', '__str__', '__subclasshook__', 'append', 'clear', 'copy', 'count', 'extend', 'index', 'insert', 'pop', 'remove', 'reverse', 'sort'] Python中super()函数 super()就是调用父类。 class A: def __init__(self): print('is A') class B(A): def __init__(self): print('is B') # 在某些情况下,我们希望在运行完以上代码调用父类的init方法,一般在Python3中使用下面这种方法调用 super().__init__() if __name__ == "__main__": b = B() 打印结果: is B is A super()就是调用父类,其实这样讲并不准确,super()函数调用其实是按照mro查找的顺序调用的。 class A: def __init__(self): print("A") class B(A): def __init__(self): print("B") super().__init__() class C(A): def __init__(self): print("C") super().__init__() class D(B, C): def __init__(self): print("D") super().__init__() if __name__ == "__main__": print(D.__mro__) d = D() 打印结果: (<class '__main__.D'>, <class '__main__.B'>, <class '__main__.C'>, <class '__main__.A'>, <class 'object'>) D B C A 既然我们重写子类的构造函数, 为什么还要去调用super再次调用父类构造函数?有些时候,为了使用父类中的一些已经写好的方法,所以会有使用super的情况。 上下文管理器 首先介绍下这种用法: try: print("code started") raise KeyError return 1 except KeyError as e: print ("key error") return 2 else: print("other error") return 3 finally: print ("finally") return 4 result = exe_try() print (result) 运行结果: code started key error finally 4 在finally语句块中的代码,不管上边代码是否发生异常都会执行finally中的代码,优先finally中的return,其次return上边的。 上下文管理器,也就是with语句,实质上就是为了解放try finally这种写法而诞生的。 上下文管理器是如何完成的呢?python是基于协议进行编程的,上下文管理器就是一种协议:上下文管理器协议。 上下文管理器协议可以使用是因为实现了两个魔法函数:__enter__和__exit__ class Sample: def __enter__(self): print("enter") # 获取资源 return self def __exit__(self, exc_type, exc_val, exc_tb): # 释放资源 print("exit") def do_something(self): print("doing something") with Sample() as sample: sample.do_something() 运行结果: enter doing something exit 还有一种方法,可以简便的实现上下文管理器的功能:@contextlib.contextmanager 可以将一个函数变为上下文管理器 import contextlib @contextlib.contextmanager def file_open(file_name): print ("file open") yield {} print ("file end") with file_open("a.txt") as f_opened: print("file processing") 运行结果: file open file processing file end @contextlib.contextmanager内部会做一些逻辑,其实是利用了生成器的特性。

优秀的个人博客,低调大师

Python高级知识点学习(二)

深入类和对象 鸭子类型问:什么是鸭子类型?答:当看到一只鸟走起路来像鸭子,游泳像鸭子,叫起来也像鸭子,那么这只鸟就可以被看做鸭子。(所有的类或对象,都实现了共同的方法,方法名要一样,这样的话这些类就归为一种类型,在调用时同时调用同样的方法) 在java中,要实现多态,所有子类必须继承父类并重写父类的方法;在python中,python中对象和java不同,变量是动态的可以指向任何一个类型。 class Cat(): def say(): pass class Dog(): def say(): pass class Duck(): def say(): pass 三个类共同实现同一个方法且方法名相同,就实现了多态。Python多态比Java简单正是因为python是动态语言。 抽象基类abc模块 何为抽象基类?继续用java做比较,Python这里抽象基类可以当做java中的接口,java中是无法实现多继承的,java只能继承一个类,但是可以继承多个接口,接口是不能用来实例化的;所以Python里边抽象基类也是不能实例化的。 python是动态语言,动态语言是没有变量类型的,Python中变量只是个符号而已,它可以指向任何类型的对象。 所以在Python中也就不存在多态这种概念,我们可以赋值任何类型数据给Python中的变量,而且它是可以修改的,所以说它就不需要像java中一样去实现多态,因为本身从语言层面讲就是支持多态的语言。 动态语言和静态语言非常大的区别之一就是静态语言不需要我们指明变量类型,所以动态语言中也就少了编译时检查错误的环节,python中写错了代码只能在运行中发现错误。 不同魔法函数就赋予了类不同特性,和java非常大的区别就是不需要去继承某一个指定的类。 鸭子类型和魔法函数构成了Python语言的基础,也就是Python中的协议。我们只需要去实现指定的魔法函数,类就可以是某种类型的对象,不同魔法函数具有的特性不同,这种使用魔法函数事先约定好的做法我们都可以称之为一种协议。 抽象基类用途: 我们在某些情况之下希望判定某个对象的类型 我们需要强制某个子类必须实现某些方法 抽象基类用法: 在基础类中,我们去设定好一些方法,所有继承这个基类的类都必须覆盖抽象基类的方法, 抽象基类是无法实例化的 所有的抽象基类继承的必须是metaclass=ABCMeta 在做框架编程时,往往我们需要使用框架者在使用类时必须实现类中的一些方法,这时候可以使用抽象基类,举了例子: class CacheBase(metaclass=abc.ABCMeta): @abc.abstractmethod def get(self, key): pass @abc.abstractmethod def set(self, key, value): pass class RedisCache(CacheBase): pass redis_cache = RedisCache() 运行结果:TypeError: Can't instantiate abstract class RedisCache with abstract methods get, set在实例化RedisCache()这个时,就开始报错了,错误提示让我们必须实现get set方法。 补全这两个方法后运行就不报错了 class RedisCache(CacheBase): def set(self, key, value): pass def get(self, key): pass redis_cache = RedisCache() type和isinstance区别 尽量使用isinstance判断类型,避免使用type产生误差is 和 == 符号 区别: is用法判断id是否相同 ==用法判断值是否相等 类变量和实例变量(对象变量) 先看代码: class A: # 类变量 aa = 1 def __init__(self, x, y): # self是类的实例 # 实例变量 self.x = x self.y = y # 上边赋值后 x y 都属于实例了 不再属于类了 a是实例 A是类 aa是类变量 类变量在所有实例中是共享的 a = A(2, 3) A.aa = 11 a.aa = 100 # a实例新建一个属性 把aa放到a实例中 a.aa和A.aa是独立的 print(a.x, a.y, a.aa) print(A.aa) b = A(3, 5) print(b.aa) 运行结果: 2 3 100 11 11 解释代码: 新建了一个名为A的类,类中新建类属性aa = 1类中新建构造函数,绑定两个变量x y。 属性查找方式,向上查找,首先查找对象里有没有,再查找类中有没有类变量和实例变量是独立的存在 类变量在所有实例中是共享的 a.aa = 100:a实例新建一个属性 把aa放到a实例中 a.aa和A.aa是独立的。 建议以上代码反复测试加以记忆。

优秀的个人博客,低调大师

Python高级知识点学习(四)

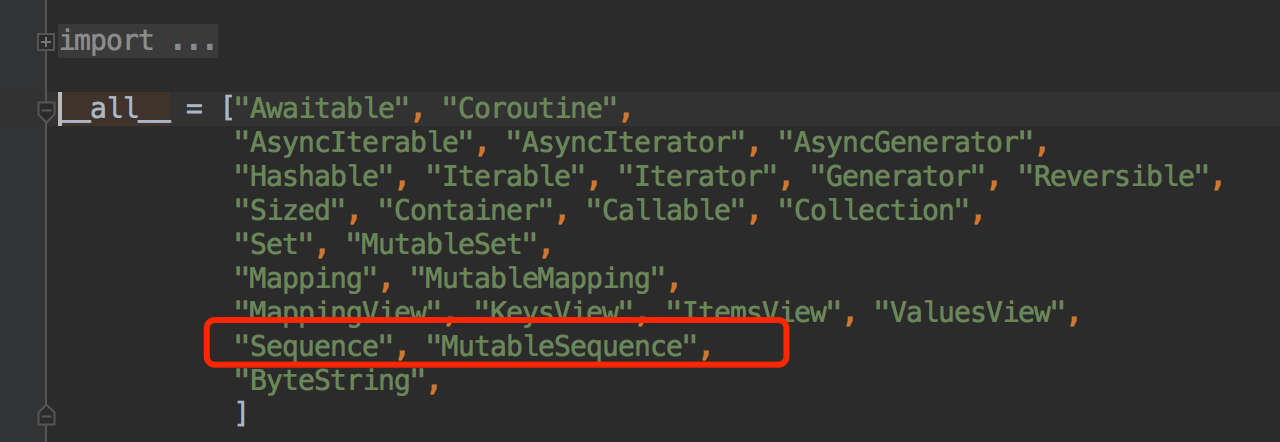
序列类型 Python中的序列类型,序列类型可以使用for循环遍历。 序列类,序列是python中非常重要的协议,如何通过实现这个协议,将类变为序列类。 Python中的序列分类两个维度区分: 容器序列:可以放置任意类型的数据。 可变序列、不可变序列。 序列类型的一些协议 from collections import abc 跟容器相关的数据结构的抽象基类都是放到abc里的,可以查看源码看下继承关系: image.png image.png list中的extend方法、+、 +=、以及append区别: a = [1, 2] # 新对象上+ [3, 4] c = a + [3, 4] #就地加, 还是a对象上边操作 a += (3, 4) a.extend(range(3)) a.append((1, 2)) print(a) 打印结果: [1, 2, 3, 4, 0, 1, 2, (1, 2)] 可切片对象 列表的切片:模式[start:end:step] start:从哪开始 end:从哪结束 step:步长 例如:a = [1, 2, 3, 4, 5, 6, 7, 8, 9, 0]a[::] 切片操作返回的是一个新的列表,不会改变原列表。 实现可切片对象,最关键的是要实现一个魔法函数:__getitem__ 什么时候不使用列表List 某些情况最好选择Python中其他内置的数据结构:array和deque。 array 和 List 重要区别: array只能存放指定的数据类型,List不同 array性能比List高 列表推导式、生成器表达式、字典推导式 列表推导式:又名列表生成式,通过一行代码来生成列表。 列表生成式性能高于列表操作, 第一:能用尽量用, 因为效率高 第二:如果逻辑过于复杂,建议不要使用,会失去高可读性 生成器表达式:改为小括号即可:(i for i in range(21) if i % 2 == 1) 转换为lsit ,list((i for i in range(21) if i % 2 == 1)) 字典推导式: 一行代码生成 dict。 dict的abc继承关系 from collections.abc import Mapping, MutableMapping dict属于 mapping 类型 from collections.abc import Mapping, MutableMapping # dict属于 mapping 类型 a = {} print(type(a)) print(isinstance(a, MutableMapping)) 打印结果: <class 'dict'> True 上边代码中,a 并不是继承了MutableMapping,只是实现了MutableMapping中的一些魔法函数。 dict常用方法: clear方法:清空dict copy方法:返回浅拷贝 浅拷贝的时候会互相影响: one = { "a": {"name": "zhao"}, "b": {"age": "20"} } two = one.copy() two['a']['name'] = 'wang' print(two) print(one) 打印结果: {'a': {'name': 'wang'}, 'b': {'age': '20'}} {'a': {'name': 'wang'}, 'b': {'age': '20'}} 深拷贝: import copy one = { "a": {"name": "zhao"}, "b": {"age": "20"} } two = copy.deepcopy(one) two['a']['name'] = 'wang' print(two) print(one) 打印结果: {'a': {'name': 'wang'}, 'b': {'age': '20'}} {'a': {'name': 'zhao'}, 'b': {'age': '20'}} fromkeys方法:快速生成以list元素为key的dict,fromkeys参数接受可迭代对象。 new_list = ["a", "b"] new_dict = dict.fromkeys(new_list, {"age": "18"}) 运行结果: {'a': {'age': '18'}, 'b': {'age': '18'}} get方法: new_dict = {"a": "a", "b": "b"} print(new_dict.get('c', 'c')) 打印结果: c setdefault方法:去dict中取值,如果没有值,则设置完默认值后再取值,如果有值,则只取值。 # dict没有值: a = {"a": "a", "b": "b"} b = a.setdefault("c", "c") print(b) print(a) 打印结果: c {'a': 'a', 'b': 'b', 'c': 'c'} # dict有值 a = {"a": "a", "b": "b", "c": "2"} b = a.setdefault("c", "c") print(b) print(a) 打印结果: 2 {'a': 'a', 'b': 'b', 'c': '2'} update方法:合并两个dict qrcode_for_gh_60369a20e6f5_258.jpg 可以关注我的微信公众号,会更新Python知识点,也会有其他语言和软件开发中的各种坑,都会记录在公众号。

优秀的个人博客,低调大师

SQL数据库学习之路(四)

要求:通过SQL语句创建以下基本表: 教师关系 T(T#, TNAME,TITLE) 课程关系 C(C#,CNAME,T#) 学生关系 S(S#,SNAME,AGE,SEX) 选课关系SC(S#,C#,SCORE) 班级关系CLASS(CLASSID,CLASSNAME) 其中红色粗体为主键,带下划线的属性为外键。 通过SQL语句在CLASS表的CLASSID列上创建聚集索引IDX_CLASSID 通过SQL语句创建在S#和C#两个列上创建索引IDX_S#_C#,并指定索引按S#降序,C#升序有序。 通过SQL语句实现以下操作: 撤销索引IDX_CLASSID及IDX_S#_C# 在学生关系中增加班级号属性列CLASSID 撤销学生关系中的班级号属性列CLASSID 撤销班级关系CLASS 方法: 1.打开SQL Server Mangement Studio, 连接到本地数据库。在对象资源管理 器中,点击数据库,然后选择新建查询。输入创建数据库的代码,点击执行,在消息窗口出现命令已成功完成。在存放的文件夹中产生mdf主数据文件和ldf日志文件。在对象资源管理器中右键数据库,选择刷新,将会出现work数据库。 createdatabasework onprimary( name='work',--主数据文件的逻辑名称 filename='F:\SQL\work1\work.mdf',--主数据文件的物理名称 size=10mb, --主数据文件的初始大小 filegrowth=10mb --主数据文件的增长率 ) logon( name='work_log',--日志文件的逻辑名称 filename='F:\SQL\work1\work_log.ldf',--日志文件的物理名称 size=5mb, --日志文件的初始大小 filegrowth=10% --日志文件的增长率 ) 2.输入创建各个表的代码,选择这些代码点击执行,刷新work数据库,会出现创建的表。 createtableT --创建表教师关系T (T# char(4)notnull, TNAME char(8)notnull, TITLE char(10), PRIMARYKEY(T#) --设置主键为T# ); createtableC --创建表课程关系T (C# char(4), CNAME char(10)notnull, T# char(4), PRIMARYKEY(C#),--设置主键为C# FOREIGNKEY(T#)REFERENCEST(T#) --设置外键为T# ); createtableS --创建表学生关系S (S# char(4)notnull, SNAME char(8)notnull, AEG char(1), PRIMARYKEY(S#) --设置主键为S# ); createtableSC --创建表选课关系SC (S# char(4), C# char(4), SCORE SMALLINT, PRIMARYKEY(S#,C#),--设置主键为S#,C# FOREIGNKEY(S#)REFERENCESS(S#),----设置外键为S# FOREIGNKEY(C#)REFERENCESC(C#)----设置外键为C# ); createtableclass --创建表班级关系class ( CLASSID char(4), CLASSNAME char(8) ); 3.输入代码,右键class表,点击设计。出现表class,然后右键CLASSID,选择索引。SC表统一操作。 createuniqueindexIDX_CLASSID onclass(CLASSID);--在CLASS表的CLASSID列上创建聚集索引IDX_CLASSID createuniqueindexIDX_S#_C# onSC(S# DESC,C# ASC);--创建在S#和C#两个列上创建索引IDX_S#_C#,并指定索引按S#降序,C#升序有序 4.撤销索引IDX_CLASSID及IDX_S#_C#。代码为: DROPINDEXIDX_CLASSID onclass;--撤销索引IDX_CLASSID DROPINDEXIDX_S#_C# onSC; --撤销索引IDX_S#_C# 在学生关系中增加班级号属性列CLASSID。代码为: altertableS addCLASSID char(4);--在学生关系中增加班级号属性列CLASSID 撤销学生关系中的班级号属性列CLASSID,代码为: altertableS dropcolumnCLASSID; --撤销学生关系中的班级号属性列CLASSID 撤销班级关系CLASS,代码为: droptableclass ; --撤销班级关系CLASS

优秀的个人博客,低调大师

16.Swift学习之结构体

结构体的介绍 概念介绍 结构体(struct)是由一系列具有相同类型或不同类型的数据构成的数据集合 结构体是值类型 结构体既可以定义属性又可以定义方法 定义语法 struct 结构体名称 { // 属性和方法 } 举例 struct Person { var name = "Zhangsan" var age = 10 var sex = "man" func say(){ print("人会说话") } } 解读 定义了一个名叫 Person的结构体 这个结构体拥有两个存储属性 name、 age和 sex 这个结构体拥有一个方法say 结构体实例 实例化结构体最简单的是在结构体名字后面写上(),任何属性都被初始化为它们的默认值 var p1 = Person() 所有的结构体都有一个自动生成的成员构造函数来实例化结构体,可以使用它来初始化所有的成员属性 var p2= Person(name: "Lisi", age: 20, sex: "woman") 访问属性和方法 可以用.来访问一个结构体实例的属性和方法 访问时如果使用了赋值语句就是设置属性 //访问 p2.age //设置 p2.age = 30 //通过.调用结构体中的属性和方法 p1.name p1.age p1.sex p1.say() 结构体是值类型 值类型是一种当它被赋值给一个常量或者变量,或者被传递给函数时会被拷贝的类型 Swift 中的结构体(包括枚举)是值类型,它在代码传递中总是会被拷贝 //值类型拷贝 var p3 = p2 //此时改变p3并不会改变p2的值 p3.name = "Wangwu" p3.age = 30 p2.age //20 p2.name //Lisi p3.age //30 p3.name //Wangwu 常用的结构体 CGRect /* Rectangles. */ public struct CGRect { public var origin: CGPoint public var size: CGSize public init() public init(origin: CGPoint, size: CGSize) } CGSize /* Sizes. */ public struct CGSize { public var width: CGFloat public var height: CGFloat public init() public init(width: CGFloat, height: CGFloat) } CGPoint /* Points. */ public struct CGPoint { public var x: CGFloat public var y: CGFloat public init() public init(x: CGFloat, y: CGFloat) } 字符串,数组和字典的赋值与拷贝行为 Swift 中的 String , Array 和 Dictionary类型是作为结构体来实现的,这意味着String , Array 和 Dictionary在它们被赋值到一个新的常量或者变量,或它们本身被传递到一个函数或方法中的时候,其实是传递了拷贝。 OC中的 NSString, NSArray和 NSDictionary,它们是作为类来实现的,所以NSString , NSArray 和 NSDictionary实例总是作为一个引用而不是拷贝来赋值和传递。

优秀的个人博客,低调大师

【学习笔记】hive 之行拆列explode

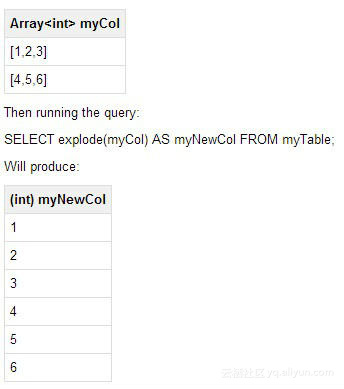
1、explode explode(ARRAY) 列表中的每个元素生成一行explode(MAP) map中每个key-value对,生成一行,key为一列,value为一列限制:1、No other expressions are allowed in SELECT SELECT pageid, explode(adid_list) AS myCol... is not supported 2、UDTF's can't be nested SELECT explode(explode(adid_list)) AS myCol... is not supported 3、GROUP BY / CLUSTER BY / DISTRIBUTE BY / SORT BY is not supported SELECT explode(adid_list) AS myCol ... GROUP BY myCol is not supported 2、lateral view 可使用lateral view解除以上限制,语法: lateralView: LATERAL VIEW explode(expression) tableAlias AS columnAlias (',' columnAlias)*fromClause: FROM baseTable (lateralView)* 案例: table名称为pageAds SELECT pageid, adid FROM pageAds LATERAL VIEW explode(adid_list) adTable AS adid; 输出结果: 3、多个lateral view from语句后面可以带多个lateral view语句 案例: 表名:baseTable from后只有一个lateral view: SELECT myCol1, col2 FROM baseTable LATERAL VIEW explode(col1) myTable1 AS myCol1; 结果: 多个lateral view: SELECT myCol1, myCol2 FROM baseTable LATERAL VIEW explode(col1) myTable1 AS myCol1 LATERAL VIEW explode(col2) myTable2 AS myCol2; 结果: 4、Outer Lateral Views 如果array类型的字段为空,但依然需返回记录,可使用outer关键词。 比如:select * from src LATERAL VIEW explode(array()) C AS a limit 10; 这条语句中的array字段是个空列表,这条语句不管src表中是否有记录,结果都是空的。 而:select * from src LATERAL VIEW OUTER explode(array()) C AS a limit 10; 结果中的记录数为src表的记录数,只是a字段为NULL。 比如: 238 val_238 NULL86 val_86 NULL311 val_311 NULL27 val_27 NULL165 val_165 NULL409 val_409 NULL255 val_255 NULL278 val_278 NULL98 val_98 NULL 官方文档: https://cwiki.apache.org/confluence/display/Hive/LanguageManual+LateralView https://cwiki.apache.org/confluence/display/Hive/LanguageManual+UDF#LanguageManualUDF-explode

优秀的个人博客,低调大师

Python高级知识点学习(一)

image.png Python中一切皆对象 和Java相比,Python的面向对象更加彻底。 函数和类也是对象,是python的一等公民。 代码和模块也可以称之为对象。 python中的类也是对象,类可以理解为模板,根据这个模板去生成我们的对象,可以动态修改类的属性。 何为一等公民? 可以赋值给一个变量 可以添加到集合对象中 可以作为参数传递给函数 可以当做函数的返回值 (生成器应用) type、object、class之间的关系 类是由type来生成的一个对象,object是所有类都要继承的最顶层的一个基础类,type也是一个类,同时也是一个对象。 看代码片段一: a = 1 b = "abc" print(type(1)) print(type(int)) print(type(b)) print(type(str)) 打印出的结果: <class 'int'> <class 'type'> <class 'str'> <class 'type'> 代码片段二: class Student: pass class MyStudent(Student): pass stu = Student() print(type(stu)) print(type(Student)) print(int.__bases__) print(str.__bases__) print(Student.__bases__)# 打印Student基类 print(MyStudent.__bases__)# 打印Student基类 print(type.__bases__) print(object.__bases__) # 最顶层的类的基类为空 print(type(object)) 打印出的结果: <class '__main__.Student'> <class 'type'> (<class 'object'>,) (<class 'object'>,) (<class 'object'>,) (<class '__main__.Student'>,) (<class 'object'>,) () <class 'type'> 可以看到,类是由type来生成的一个对象。 上述代码建议反复阅读练习。 Python中常见的内置类型 首先说明对象的三个特征: 身份:也就是地址,通过id()函数查看地址 类型:int、str等 值:每个对象都有自己的值 常见内置类型: None(全局只有一个),Python解释器在启动时会用None生成一个None对象。 a = None b = None print(id(a) == id(b)) 打印结果: Ture 可以看到a,b是指向同一个对象(id相同)。 数值类型:int float complex(复数) bool。 迭代类型:可用for进行遍历 序列类型:list、bytes、range、tuple、str、array 等 映射类型:dict 集合类型:set、frozenset 上下文管理器:with语句 其他:class、实例 等等等。 Python中的魔法函数 问:什么是魔法函数? 答:双下划线开头,双下划线结尾的这些函数,通常称之为魔法函数。 例如: image.png 一般魔法函数不要自定义,使用 Python 提供的即可。 使用 Python 提供的魔法函数,为了增强类的特性。 代码:使用魔法函数之前 class Company(object): def __init__(self, employee_list): self.employee = employee_list company = Company(["tom", "bob", "jane"]) for i in company.employee: print(i) 打印结果: a b c 代码:使用魔法函数之后 class Company(object): def __init__(self, employee_list): self.employee = employee_list def __getitem__(self, item): return self.employee[item] company = Company(["a", "b", "c"]) 打印结果: a b c 可以看到__getitem__()这个魔法函数的功能。 定义了这个魔法函数后,实例化后的对象就隐含的变为可迭代对象(iterable)。 for循环其实是要拿到一个对象的迭代器,迭代器是需要实现__iter__这个方法才会有迭代器特性,Python语法会做一些优化,如果拿不到迭代器,就会尝试去对象中找__getitem__这个方法,如果有的话就会调用这个方法,一次一次直到将数据取完。这是python语言本身解释器会完成的功能。 魔法函数调用不需要显示调用,解释器会隐式调用。 Python的数据模型 魔法函数是Python数据模型的一个概念而已,因为网络上大家喜欢称之为魔法函数。 Python数据模型会增强对象的特性。 class Company(object): def __init__(self, employee_list): self.employee = employee_list def __getitem__(self, item): return self.employee[item] def __len__(self): return len(self.employee) company = Company(["a", "b", "c"]) print(len(company)) 结果: 3 __len__魔法函数增强了company对象的特性。 因为魔法函数很多,类似的魔法函数请大家自行去网上查找,并查看用法。

优秀的个人博客,低调大师

14.Swift学习之闭包

闭包引入 计算1个数的平方 函数写法 func square(param:Int) -> Int{ return param * param } square(param:3) 闭包写法 let squareCloure = { (param:Int) -> Int in return param * param } squareCloure(3) 闭包含义 闭包是可以被传递和引用的一个独立模块 闭包能够捕获和存储定义在其上下文中的任何常量和变量,即闭合并包裹那些常量和变量,因此被称为“闭包” 闭包符合如下三种形式中的一种: 全局函数是一个有名字但不会捕获任何值的闭包 内嵌函数是一个有名字且能从其上层函数捕获值的闭包(函数中的嵌套函数知识点) 闭包表达式是一个轻量级语法,可以捕获其上下文中常量或变量值的没有名字的闭包 闭包和函数一样也是引用类型 简单案例 案例一 let demo= { print("Swift 闭包实例。") } demo() 案例二 let divide = {(val1: Int, val2: Int) -> Int in return val1 / val2 } let result = divide(200, 20) print (result) 闭包表达式 闭包表达式语法有如下的一般形式: { (parameters) -> (return type) in statements } 闭包表达式由一对{}开始与结束 由in关键字将闭包分割成两部分:参数与返回值、闭包体 闭包参数与函数参数的区别 形式参数不能提供默认值,其他和函数一样 闭包主要知识点 参数名称缩写 Swift 提供了参数名称的缩写功能,直接通过 $0,$1,$2来顺序调用闭包的参数 在闭包表达式中使用参数名称缩写,可以在闭包参数列表中省略对其定义 参数类型可以通过函数类型进行推断 在单行闭包的时候,return 关键字可以省略 参数名称省略以后,in 关键字也可以被省略 //从数组中筛选指出合适的数据组成新的数组 func getList(score:[Int], con:(Int)->Bool) -> [Int]{ var newScore:[Int] = [Int]() for item in score { if con(item) { newScore.append(item) } } return newScore } let newAarray = getList(score: [75,60,95,45,85], con:{(s:Int)->Bool in return s>80}) print(newAarray) 第一种简写: 省略 ->与返回类型(根据后面表达式可以推断返回值是一个Bool) let newAarray = getList(score: [75,60,95,45,85], con:{(s:Int) in return s>80}) 第二种简写:省略参数类型和括号(根据函数的参数可推断传进来的必然是Int) let newAarray = getList(score: [75,60,95,45,85], con:{s in return s>80}) 第三种简写:省略return关键字 let newAarray = getList(score: [75,60,95,45,85], con:{s in s>80}) 第四种简写:参数名称缩写,省略参数声明和in,改为$0 let newAarray = getList(score: [75,60,95,45,85], con:{$0>80}) 捕获 闭包可以从上下文环境中捕获常量、变量,并在自己的作用域内使用 Swift最简单的闭包形式是嵌套函数,也就是定义在其他函数的函数体内的函数,嵌套函数可以捕获其外部函数所有的参数以及定义的常量和变量。 func makeIncrementor(forIncrement amount: Int) -> () -> Int { var runningTotal = 0 func incrementor() -> Int { runningTotal += amount return runningTotal } return incrementor } let incrementByTen = makeIncrementor(forIncrement: 10) // 返回的值为10 print(incrementByTen()) // 返回的值为20 print(incrementByTen()) // 返回的值为30 print(incrementByTen()) 尾随闭包 尾随闭包是一个书写在函数括号之后的闭包表达式,函数支持将其作为最后一个参数调用 闭包是函数的最后一个参数 调用时,函数的 ) 可以前置到倒数第二个参数末尾,后面的参数直接使用 { // 执行代码 },形式参数标签也随之省略 将一个很长的闭包表达式作为最后一个参数传递给函数,可以使用尾随闭包来增强函数的可读性 //尾随闭包 func doSomething(info:String, clousre:(String)->Void){ clousre(info) } //不使用尾随闭包进行函数调用 doSomething(info: "Hello", clousre: { s in print(s) }) //使用尾随闭包进行函数调用 doSomething(info: "World") { s in print(s) } 逃逸闭包 闭包作为一个参数传递给一个函数 传入函数的闭包如果在函数执行结束之后才会被调用,那么这个闭包就叫做逃逸闭包 声明一个接受闭包作为形式参数的函数时,可以在形式参数的类型之前写上@escaping 来明确闭包是允许逃逸的 逃逸闭包会在函数结束后才执行 举例 //逃逸闭包:闭包可以超出函数的范围来调用 //存放没有参数、没有返回值的闭包 var closureArray :[()->Void] = [()->Void]() //定义一个函数,接收一个非逃逸闭包为参数 func nonEscapeClosure(closure:()->Void){ closure() } //定义一个函数,接收一个逃逸闭包为参数,将闭包并存储到一个数组里面去,并没有调用 func escapeClosure(closure: @escaping ()->Void){ print("函数开始") closureArray.append(closure) print("函数结束") } var x = 10 //打印10 print(x) nonEscapeClosure { x = 100 } //打印100 因为闭包在函数里面执行了 print(x) escapeClosure { x = 200 } //打印100 因为闭包逃逸了 没有在函数里面执行 print(x) closureArray.first?() //打印200 在函数外面调用了闭包 print(x) //尾随闭包常用于异步回调 自动闭包 一种自动创建的闭包,用于包装函数参数的表达式 不接受任何参数,被调用时会返回被包装在其中的表达式的值 在形式参数的类型之前加上@autoclosure关键字标识这是一个逃逸闭包 //自动闭包 func printIfTrue(predicate:@autoclosure ()->Bool){ if predicate() { print("is true") } else{ print("is false") } } //直接进行调用了,Swift 将会把 2 > 1 这个表达式自动转换为 () -> Bool。这样我们就得到了一个写法简单、表意清楚的表达式。 printIfTrue(predicate: 2>1) printIfTrue(predicate: 2<1) 闭包的循环引用 class NetworkTools: NSObject { /// 完成回调属性 var finishedCallBack: (()->())? /// 加载数据 /// - parameter finished: 完成回调 func loadData(finished: () -> ()) { self.finishedCallBack = finished working() } func working() { finishedCallBack?() } deinit { print("网络工具 88") } class ViewController: UIViewController { var tools: NetworkTools? override func viewDidLoad() { super.viewDidLoad() tools = NetworkTools() tools?.loadData() { print("加载数据完成,更新界面:", NSThread.currentThread()) weakSelf!.view.backgroundColor = UIColor.redColor() } } /// 与 OC 中的 dealloc 类似,注意此函数没有() deinit { print("控制器 88") } } Swift中解决循环引用的方式 方案一: 使用weak,对当前控制器使用弱引用 但是因为self可能有值也可能没有值,因此weakSelf是一个可选类型,在真正使用时可以对其强制解包(该处强制解包没有问题,因为控制器一定存在,否则无法调用所在函数) // 解决方案一: weak var weakSelf = self tools.loadData { print("加载数据完成,更新界面:", NSThread.currentThread()) weakSelf!.view.backgroundColor = UIColor.redColor() } 方案二: 和方案一类型,只是书写方式更加简单 可以写在闭包中,并且在闭包中用到的self都是弱引用 tools.loadData {[weak self] () -> () in print("加载数据完成,更新界面:", NSThread.currentThread()) self!.view.backgroundColor = UIColor.redColor() } 方案三: 使用关键字unowned 从行为上来说 unowned 更像OC中的 unsafe_unretained unowned 表示:即使它原来引用的对象被释放了,仍然会保持对被已经释放了的对象的一个 "无效的" 引用,它不能是 Optional 值,也不会被指向 nil tools.loadData {[unowned self] () -> () in print("加载数据完成,更新界面:", NSThread.currentThread()) self.view.backgroundColor = UIColor.redColor() }

优秀的个人博客,低调大师

leetcode算法题学习Java版(2)

283.Move Zeros(移动零) 给定一个数组 nums,编写一个函数将所有 0 移动到数组的末尾,同时保持非零元素的相对顺序。 示例: 输入: [0,1,0,3,12] 输出: [1,3,12,0,0] 说明: 必须在原数组上操作,不能拷贝额外的数组。 尽量减少操作次数。 class Solution { public void moveZeroes(int[] nums) { int k = 0; for(int i = 0;i<nums.length;i++){ if(nums[i]!=0){ if(i!=k){ int temp = nums[k]; nums[k] = nums[i]; nums[i] = temp; } k++; } } } } 75.Sort Colors(颜色分类) 给定一个包含红色、白色和蓝色,一共 n 个元素的数组,原地**对它们进行排序,使得相同颜色的元素相邻,并按照红色、白色、蓝色顺序排列。 此题中,我们使用整数 0、 1 和 2 分别表示红色、白色和蓝色。 注意: 不能使用代码库中的排序函数来解决这道题。 示例:输入: [2,0,2,1,1,0]输出: [0,0,1,1,2,2]进阶: 一个直观的解决方案是使用计数排序的两趟扫描算法。 首先,迭代计算出0、1 和 2 元素的个数,然后按照0、1、2的排序,重写当前数组。 你能想出一个仅使用常数空间的一趟扫描算法吗? 解题思路,本题共三个元素,非常适合三路快排的方法,并且仅需扫描数组一遍即可完成排序 class Solution { public void sortColors(int[] nums) { int zero = -1; // nums[0...zero]==0 int two = nums.length; //nums[two...n-1]==2 for (int i = 0; i < two;) { if(nums[i]==0){ int temp = nums[++zero]; nums[zero] = nums[i]; nums[i++] = temp; }else if(nums[i]==1){ i++; }else{ assert nums[i]==2; int temp = nums[--two]; nums[two] = nums[i]; nums[i] = temp; } } } } 88.Merged sorted Array(合并有序数组) 给定两个有序整数数组 nums1 和 nums2,将 nums2 合并到 nums1 中,使得 num1 成为一个有序数组。 说明: 初始化 nums1 和 nums2 的元素数量分别为 m 和 n。 你可以假设 nums1 有足够的空间(空间大小大于或等于 m + n)来保存 nums2 中的元素。 示例: 输入: nums1 = [1,2,3,0,0,0], m = 3 nums2 = [2,5,6], n = 3 输出: [1,2,2,3,5,6] 解题思路:这道题解决很简单,但是最大效率的算法却也比较难想,很巧妙,暴力解法就是把两个数组合并,然后快排。但是参照了leetcode上别人的代码,效率更高,思路就是不断比较二者的最大值,把最大值放在nums1数组的最后,知道排序成功。 class Solution { public void merge(int[] nums1, int m, int[] nums2, int n) { int count = m + n - 1; m--; n--; while (m != -1 && n != -1) { nums1[count--] = nums1[m] > nums2[n] ? nums1[m--] : nums2[n--]; } while (n != -1) { nums1[count--] = nums2[n--]; } } } 215.Kth Largest Element in an Array(数组中第K个最大的元素) 在未排序的数组中找到第 k 个最大的元素。请注意,你需要找的是数组排序后的第 k 个最大的元素,而不是第 k 个不同的元素。 示例 1: 输入: [3,2,1,5,6,4] 和 k = 2 输出: 5 示例 2: 输入: [3,2,3,1,2,4,5,5,6] 和 k = 4 输出: 4 说明: 你可以假设 k 总是有效的,且 1 ≤ k ≤ 数组的长度。 这道题很有趣,他的解法非常多,我也是在这道题感受到了自己与大佬之间的差距,就算用同一种解法,别人的代码也比我写的优雅的多。令人哭笑不得的是,自己写了半天的算法,其实运行下来比别人两行代码(Array.sort,调用jdk内置的函数)就搞定了还慢了很多倍。 解题思路:这道题用简单暴力的解法是非常容易的,同样是先对数组进行排序,最简单的办法是用jdk内置的Array.sort进行排序,然后从后往前取第k个元素,这种解法既简单,又由于jdk内置的快排效率非常高,在leetcode上这种解法只用了4ms,排名第二。当然更聪明的解法很多,例如,使用快排(分治算法),在快排的每一趟排完后,如果要找的k较大,则只对对应的一半继续进行快排,直到找到结果。还有使用堆的办法。 class Solution { public int findKthLargest(int[] nums, int k) { Queue<Integer> queue = new PriorityQueue<Integer>(); for (int i = 0; i < nums.length; i++) { if (i < k) { queue.add(nums[i]); } else if (queue.peek() < nums[i]) { queue.remove(); queue.add(nums[i]); } } return queue.peek(); } } class Solution { public int findKthLargest(int[] nums, int k) { int left = 0, right = nums.length - 1; while (true){ int pos = partition(nums, left, right); if(k - 1 == pos) return nums[pos]; else if(pos > k - 1) right = pos - 1; else left = pos + 1; } } public int partition(int[] nums, int left, int right){ int pivot = nums[left], l = left +1, r = right; while (l <= r){ if(nums[l] < pivot && nums[r] > pivot) swap(nums, l, r); if (nums[r] <= pivot) r--; if (nums[l] >= pivot) l++; } swap(nums, left, r); return r; } public void swap(int nums[], int left, int right){ int temp = nums[left]; nums[left] = nums[right]; nums[right] = temp; } } Two Sum II(两数之和) 给定一个已按照升序排列 的有序数组,找到两个数使得它们相加之和等于目标数。 函数应该返回这两个下标值 index1 和 index2,其中 index1 必须小于 index2。 说明: 返回的下标值(index1 和 index2)不是从零开始的。 你可以假设每个输入只对应唯一的答案,而且你不可以重复使用相同的元素。 示例: 输入: numbers = [2, 7, 11, 15], target = 9 输出: [1,2] 解释: 2 与 7 之和等于目标数 9 。因此 index1 = 1, index2 = 2 。 解题思路:这道题同样有多种思路,暴力解法是两次遍历该数组,找到相加等于target的索引,这种解法的时间复杂度是O(n^2)。利用二分法的思想来解这道题,时间复杂度是O(nlogn)。而利用对撞指针来解这道题,时间复杂度只有O(n),以下是对撞指针的解法。 class Solution { public int[] twoSum(int[] numbers, int target) { int i = 0,j = numbers.length-1; while(i<j){ if(numbers[i]+numbers[j]==target){ break; } if(numbers[i]+numbers[j]>target){ j--; } if(numbers[i]+numbers[j]<target){ i++; } } return new int[]{++i,++j}; } } 209.Minimum Size Subarray Sum(最小子数组) 给定一个含有 n 个正整数的数组和一个正整数 s ,找出该数组中满足其和 ≥ s 的长度最小的连续子数组。如果不存在符合条件的连续子数组,返回 0。 示例: 输入: s = 7, nums = [2,3,1,2,4,3] 输出: 2 解释: 子数组 [4,3] 是该条件下的长度最小的连续子数组。 进阶: 如果你已经完成了O(n) 时间复杂度的解法, 请尝试 O(n log n) 时间复杂度的解法。 解题思路:该题使用滑动窗口法解决只需要O(n)的时间复杂度 public class MSSubarraySum { public int minSubArrayLen(int s, int[] nums) { int i = 0, j = -1; int sum = 0; int result = nums.length+1; while(i<nums.length){ if(j<nums.length-1&&sum<s){ sum+=nums[++j]; }else{ sum-=nums[i++]; } if(sum>=s) result = Math.min(result,j-i+1); } if(result == nums.length+1){ result = 0; } return result; } } 3.Longest Substring Without Repeating Characters(无重复字符的最小子串) 给定一个字符串,找出不含有重复字符的最长子串的长度。 示例 1: 输入: "abcabcbb" 输出: 3 解释: 无重复字符的最长子串是 "abc",其长度为 3。 示例 2: 输入: "bbbbb" 输出: 1 解释: 无重复字符的最长子串是 "b",其长度为 1。 示例 3: 输入: "pwwkew" 输出: 3 解释: 无重复字符的最长子串是 "wke",其长度为 3。 请注意,答案必须是一个子串,"pwke" 是一个子序列 而不是子串。 解题思路:这道题同样是使用滑动窗口的思想去解是最佳的。该题需要记录每个字符出现的频率,因此初始化一个长度为256的freq数组,根据字符的ASCII码来每个字符出现的频率。根据频率来进行窗口的滑动。 class Solution { public int lengthOfLongestSubstring(String s) { int[] freq = new int[256]; for (int f = 0; f < freq.length; f++) { freq[f] = 0; } int i = 0, j = -1; int result = 0; while (i < s.length()) { if (j < s.length() - 1 && freq[s.charAt(j + 1)] == 0) { freq[s.charAt(++j)]++; }else{ freq[s.charAt(i++)]--; } result = Math.max(result, j - i + 1); } return result; } } Minimum Window Substring(最小覆盖子串) 给定一个字符串 S 和一个字符串 T,请在 S 中找出包含 T 所有字母的最小子串。 示例: 输入: S = "ADOBECODEBANC", T = "ABC" 输出: "BANC" 说明: 如果 S 中不存这样的子串,则返回空字符串 ""。 如果 S 中存在这样的子串,我们保证它是唯一的答案。 解题思路:这道题我依然是使用滑动窗口的思想去解的,时间复杂度为O(2st),解题耗时较长,主要原因是每次都要遍历一遍结果集去判断结果是否正确,可以去参考leetcode 该题更好的解法。 class Solution { public String minWindow(String s, String t) { HashMap<Integer,Integer> target = new HashMap<>(); for(int i =0;i<t.length();i++){ if(target.get((int)t.charAt(i))==null){ target.put((int) t.charAt(i),1); }else{ int temp = target.get((int)t.charAt(i)); target.put((int) t.charAt(i),temp+1); } } int freq[] = new int[256]; for (int i = 0; i < freq.length; i++) freq[i] = 0; int i = 0, j = -1; int length = Integer.MAX_VALUE; String result = ""; while(i<s.length()){ if(j<s.length()-1&&!hasFound(freq,target)){ freq[s.charAt(++j)]++; }else{ freq[s.charAt(i++)]--; } if(hasFound(freq,target)){ if(length>j-i+1){ length = j-i+1; result = s.substring(i,j+1); } } } return result; } public static boolean hasFound(int[] arr1,HashMap<Integer,Integer> arr2){ // for(int i =0;i<arr2.length;i++){ // if(arr1[arr2[i]]<1) // return false; // } Iterator iter = arr2.entrySet().iterator(); while(iter.hasNext()){ Map.Entry<Integer,Integer> entry = (Map.Entry) iter.next(); if(arr1[entry.getKey()]<entry.getValue()){ return false; } } return true; } } 451.Sort Characters By Frequency(根据字符出现频率排序) 示例 1: 输入: "tree" 输出: "eert" 解释: 'e'出现两次,'r'和't'都只出现一次。 因此'e'必须出现在'r'和't'之前。此外,"eetr"也是一个有效的答案。 解题思路:这里我是用HashMap来解的,不过最后用了比较笨的办法来按顺序拼凑字符串。是通过类似选择排序的办法,每次比较map里的所有value值,将最大的值拿出来放在最前面。Leetcode上有更好的方法可以借鉴。 class Solution { public String frequencySort(String s) { Map<Character,Integer> map = new HashMap<>(); for(int i =0;i<s.length();i++){ map.put(s.charAt(i),map.getOrDefault(s.charAt(i),0)+1); } StringBuffer result = new StringBuffer(); int temp = -1; char tempKey=' '; int i = 0; while(i<s.length()){ for (Map.Entry<Character,Integer> entry:map.entrySet()) { if(temp<entry.getValue()){ tempKey = entry.getKey(); temp = entry.getValue(); } } map.remove(tempKey); while(temp>0){ result.append(tempKey); i++; temp--; } } return result.toString(); } } 15.3Sum(三数之和) 给定一个包含 n 个整数的数组 nums,判断 nums 中是否存在三个元素 a,b,c ,使得 a + b + c = 0 ?找出所有满足条件且不重复的三元组。 注意:答案中不可以包含重复的三元组。 例如, 给定数组 nums = [-1, 0, 1, 2, -1, -4], 满足要求的三元组集合为: [ [-1, 0, 1], [-1, -1, 2] ] 解题思路:我用的是对撞指针的方式,遍历数组的过程中,对当前遍历的索引之后的数,采用对撞指针的方式,找到和等于0-nums【i】的两个数。我的代码略有瑕疵导致速度较慢,以下为leetcode上解题思路与我相同,但是做了细节优化的代码 class Solution { public List<List<Integer>> threeSum(int[] nums) { int len=nums.length; Arrays.sort(nums); List<List<Integer>> res = new ArrayList<>(); for(int i=0;i<len;i++){ if(nums[i]>0)break; //简化,如果>0则说明该三数之和不可能为0 if(i>0&&nums[i]==nums[i-1])continue; //去重 int target=0-nums[i]; int l=i+1,r=len-1; //此处必须对i后面的数字进行筛选,不能重复 while(l<r){ List<Integer> list=new ArrayList(); if(nums[l]+nums[r]==target){ list.add(nums[i]); list.add(nums[l]); list.add(nums[r]); res.add(list); while(r>l&&nums[l+1]==nums[l])l++; //这个地方改成l-1只会出现一个结果了 while(r>l&&nums[r]==nums[r-1])r--; l++;r--; }else if(nums[l]+nums[r]>target)r--; else l++; } } return res; } } 454.4SumII(四数相加II) 给定四个包含整数的数组列表 A , B , C , D ,计算有多少个元组 (i, j, k, l) ,使得 A[i] + B[j] + C[k] + D[l] = 0。 为了使问题简单化,所有的 A, B, C, D 具有相同的长度 N,且 0 ≤ N ≤ 500 。所有整数的范围在 -228 到 228 - 1 之间,最终结果不会超过 231 - 1 。 例如: 输入: A = [ 1, 2] B = [-2,-1] C = [-1, 2] D = [ 0, 2] 输出: 2 解释: 两个元组如下: (0, 0, 0, 1) -> A[0] + B[0] + C[0] + D[1] = 1 + (-2) + (-1) + 2 = 0 (1, 1, 0, 0) -> A[1] + B[1] + C[0] + D[0] = 2 + (-1) + (-1) + 0 = 0 解题思路:暴力解法为遍历四个数组所有情况,时间复杂度为O(n^4 )。本题我使用了查找表的方法,将数组A和B的所有和的情况置入查找表中,遍历C和数组D即可得到结果,时间复杂度为O(n^2) public int fourSumCount(int[] A, int[] B, int[] C, int[] D) { int result = 0; Map<Integer,Integer> map = new HashMap<>(); for(int i = 0;i<A.length;i++){ for(int j = 0;j<B.length;j++){ map.put(A[i]+B[j],map.getOrDefault(A[i]+B[j],0)+1); } } for(int i = 0;i<C.length;i++){ for(int j = 0;j<D.length;j++){ if(map.containsKey(0-C[i]-D[j])){ result+=map.get(0-C[i]-D[j]); } } } return result; } 206. Reverse Linked List 反转链表 反转一个单链表。 示例: 输入: 1->2->3->4->5->NULL 输出: 5->4->3->2->1->NULL 进阶: 你可以迭代或递归地反转链表。你能否用两种方法解决这道题? 解题思路:对于链表题来说,一般不能直接操作链表节点的值,而是通过操作指针来改变链表。例如,扫描一遍链表,将值压入栈中,再第二次扫描链表,将值从栈中弹出,这种方式一般在面试的算法题中是不被允许的。因此,这道题我用了三个临时指针,只改变listNode的next指针的方向来改变链表。 public class ReverseLinkedList { public ListNode reverseList(ListNode head) { if(head == null) return head; ListNode pre = null, cur = head, next = head.next; while (cur != null){ cur.next = pre; pre = cur; cur = next; if(next!=null){ next = next.next; } } return pre; } } 92. Reverse Linked List II 反转链表 II 反转从位置 m 到 n 的链表。请使用一趟扫描完成反转。 说明: 1 ≤ m ≤ n ≤ 链表长度。 示例: 输入: 1->2->3->4->5->NULL, m = 2, n = 4 输出: 1->4->3->2->5->NULL 这道题个人感觉还是挺难的,因为要处理的特殊情况较多,又不能直接更改节点的值,而是要通过指针来实现反转链表。这里还是以leetcode上大神写的更优美的代码为例吧 public ListNode reverseBetween_1(ListNode head, int m, int n) { if (head == null || m < 1 || m > n) return null; ListNode head1 = head; ListNode preTail = null;//需要逆置节点的前驱节点 //第一步:前进至第m节点,即行走m-1步;注意考虑m为1的情况,此时preTail=null int i = 1; while(head1 != null && i++ < m){ preTail = head1; head1 = head1.next; } //第二步:反转m->n节点 if(head1 == null) return head;//head1为null,不需要后翻转了 ListNode preNode = null; ListNode reverseListPreHead = head1; ListNode nextNode; while (head1 != null && m++ <= n) { nextNode = head1.next; head1.next = preNode; preNode = head1; head1 = nextNode; } //第三步:反转链表的头尾处理 reverseListPreHead.next = head1;//处理尾巴 if (preTail != null) {//处理头部 preTail.next = preNode; return head; }else{ return preNode;//若preTail为null,返回翻转链表段的最后一个节点 } } Remove Duplicates from Sorted List 删除排序链表中的重复元素 给定一个排序链表,删除所有重复的元素,使得每个元素只出现一次。 示例 1: 输入: 1->1->2 输出: 1->2 示例 2: 输入: 1->1->2->3->3 输出: 1->2->3 解题思路:这道题题意我理解错了,不知道是不是题目表达的问题,让我误以为要删除所有的不管是否相邻的具有重复值的节点。但看了leetcode上其他人的代码,都只是删除相邻的重复的节点。 if(head ==null) return null; if(head.next == null) return head; Set<Integer> set = new HashSet<>(); ListNode temp = new ListNode(-1); temp.next = head; while (temp!=null&&temp.next!=null){ ListNode next = temp.next; if(set.contains(next.val)) temp.next = temp.next.next; else{ set.add(next.val); temp = temp.next; } } return head; 86.Partition List 分隔链表 给定一个链表和一个特定值 x,对链表进行分隔,使得所有小于 x 的节点都在大于或等于 x 的节点之前。 你应当保留两个分区中每个节点的初始相对位置。 示例: 输入: head = 1->4->3->2->5->2, x = 3 输出: 1->2->2->4->3->5 解题思路:感觉链表的题都好难啊……但是看了别人的解法有感觉很简单,这道题的思路就是把小的和大的分别依次链起来,最后整合。 public ListNode partition(ListNode head, int x){ ListNode head1 = new ListNode(0); ListNode head2 = new ListNode(0); ListNode phead1 = head1; ListNode phead2 = head2; ListNode temp = head; while (temp!=null){ if(temp.val<x){ phead1.next = temp; temp = temp.next; phead1 = phead1.next; phead1.next = null; }else{ phead2.next = temp; temp = temp.next; phead2 = phead2.next; phead2.next = null; } } phead1.next = head2.next; head = head1.next; return head; } 328. Odd Even Linked List 奇偶链表 给定一个单链表,把所有的奇数节点和偶数节点分别排在一起。请注意,这里的奇数节点和偶数节点指的是节点编号的奇偶性,而不是节点的值的奇偶性。 请尝试使用原地算法完成。你的算法的空间复杂度应为 O(1),时间复杂度应为 O(nodes),nodes 为节点总数。 示例 1: 输入: 1->2->3->4->5->NULL 输出: 1->3->5->2->4->NULL 示例 2: 输入: 2->1->3->5->6->4->7->NULL 输出: 2->3->6->7->1->5->4->NULL 说明: 应当保持奇数节点和偶数节点的相对顺序。 链表的第一个节点视为奇数节点,第二个节点视为偶数节点,以此类推。 解题思路:这道题和上一道题的解题思路基本一致。将奇偶数节点分别链起来,最后再整合即可。需要注意的是需要记录奇偶节点的首节点的位置,方便整合。 public ListNode oddEvenList(ListNode head) { ListNode temp = head; ListNode evenNode = new ListNode(-1); ListNode oddNode = new ListNode(-1); ListNode pEvenNode = evenNode; ListNode pfirOddNode = oddNode; int i = 1; while (temp != null){ if(i%2==0){ evenNode.next = temp; evenNode = evenNode.next; temp = temp.next; evenNode.next = null; }else { oddNode.next = temp; oddNode = oddNode.next; temp = temp.next; oddNode.next = null; } i++; } oddNode.next = pEvenNode.next; head = pfirOddNode.next; return head; } 2.Add Two Numbers 两数相加 给定两个非空链表来表示两个非负整数。位数按照逆序方式存储,它们的每个节点只存储单个数字。将两数相加返回一个新的链表。 你可以假设除了数字 0 之外,这两个数字都不会以零开头。 示例: 输入:(2 -> 4 -> 3) + (5 -> 6 -> 4) 输出:7 -> 0 -> 8 原因:342 + 465 = 807 解题思路:不得不说看别人的代码都赏心悦目,相比之下自己的代码不知道是哪个弱智写的。这道题同样不难,两两相加,遇到某个数字位数不够了补0就可以了。这里还是以leetcode上大佬写的代码为例 public ListNode addTwoNumbers(ListNode l1, ListNode l2) { ListNode next = new ListNode(0); ListNode result = next; int add = 0; while (l1 != null || l2 != null) { int l1val = (l1 != null) ? l1.val : 0; int l2val = (l2 != null) ? l2.val : 0; int value = l1val + l2val + add; add = value / 10; next.next = new ListNode(value % 10); next = next.next; l1 = (l1 != null) ? l1.next : null; l2 = (l2 != null) ? l2.next : null; } if (add > 0) { next.next = new ListNode(add); } return result.next; } 203. Remove Linked List Elements 移除链表元素 删除链表中等于给定值 val 的所有节点。 示例: 输入: 1->2->6->3->4->5->6, val = 6 输出: 1->2->3->4->5 解题思路: 利用虚拟头结点,删除所有重复元素即可。我的代码有些小瑕疵,应该释放删除掉节点的内存空间。 public ListNode removeElements(ListNode head, int val) { ListNode dummyNode = new ListNode(0); dummyNode.next = head; ListNode cur = dummyNode; while (cur.next!=null){ if(cur.next.val==val) cur.next = cur.next.next; else cur = cur.next; } return dummyNode.next; } 82. Remove Duplicates from Sorted List II 删除排序链表中的重复元素 II 给定一个排序链表,删除所有含有重复数字的节点,只保留原始链表中 没有重复出现 的数字。 示例 1: 输入: 1->2->3->3->4->4->5 输出: 1->2->5 示例 2: 输入: 1->1->1->2->3 输出: 2->3 解题思路:总感觉链表题都挺有难度的,可能是平常用的少的原因吧。这道题其实思路也很简单,就是遇到相同节点,就循环往下找下一个不同的节点,并链接。 public ListNode deleteDuplicates(ListNode head) { ListNode dummyHead = new ListNode(0); dummyHead.next = head; ListNode prev = dummyHead; while (prev.next != null) { ListNode cur = prev.next; if (cur.next == null || cur.val != cur.next.val) { prev = prev.next; continue; } while (cur.next != null && cur.next.val == cur.val) { cur.next = cur.next.next; } prev.next = cur.next; } return dummyHead.next; }

优秀的个人博客,低调大师

leetcode算法题学习Java版(1)

队列和广度优先搜索 岛屿的个数 给定一个由 '1'(陆地)和 '0'(水)组成的的二维网格,计算岛屿的数量。一个岛被水包围,并且它是通过水平方向或垂直方向上相邻的陆地连接而成的。你可以假设网格的四个边均被水包围。 https://leetcode-cn.com/explore/learn/card/queue-stack/217/queue-and-bfs/872/ 解题思路:广度优先,从某个为1的点开始,广度优先搜索他附近所有为1的点,将这些点的值改为2防止重复。计算有多少次将相邻的1改为2的次数,即为岛屿的次数。 class Solution { public int numIslands(char[][] grid) { if (grid == null || grid.length == 0 || grid[0].length == 0) return 0 ; int row = grid.length;//行数 int column = grid[0].length;//列数 int count = 0; for (int i = 0; i < row; i++) { for (int j = 0; j < column; j++) { if (grid[i][j] == '1'){ count ++; combine(grid,i,j); } } } return count; } public static void combine(char[][] grid, int x, int y){ grid[x][y] = '2'; if (x > grid.length-1 && y > grid[0].length-1 ) { return; } if (x < grid.length-1 && grid[x+1][y] == '1') { //向下 combine(grid,x+1,y); } if (y < grid[0].length-1 && grid[x][y+1] == '1'){ //向右 combine(grid,x,y+1); } if (x > 0 && grid[x-1][y] == '1' ){ //向上 combine(grid,x-1,y); } if (y > 0 && grid[x][y-1] == '1') { //向左 combine(grid,x,y-1); } } } 打开转盘锁 你有一个带有四个圆形拨轮的转盘锁。每个拨轮都有10个数字: '0', '1', '2', '3', '4', '5', '6', '7', '8', '9' 。每个拨轮可以自由旋转:例如把 '9' 变为 '0','0' 变为 '9' 。每次旋转都只能旋转一个拨轮的一位数字。 锁的初始数字为 '0000' ,一个代表四个拨轮的数字的字符串。 列表 deadends 包含了一组死亡数字,一旦拨轮的数字和列表里的任何一个元素相同,这个锁将会被永久锁定,无法再被旋转。 字符串 target 代表可以解锁的数字,你需要给出最小的旋转次数,如果无论如何不能解锁,返回 -1。 https://leetcode-cn.com/explore/learn/card/queue-stack/217/queue-and-bfs/873/ 解题思路:将这道题看作是一道迷宫题,每次找一个数字当前能一步到的其他所有邻居数字,次数加1,所有邻居数字再找邻居数字的邻居数字,直到找到一个正确路径。 package com.ice.leetcode; import java.util.*; public class Solution { public static void main(String[] args) { String[] deadends = {"8887","8889","8878","8898","8788","8988","7888","9888"}; String target = "8888"; int count = openLock(deadends, target); System.out.println(count); } public static int openLock(String[] deadends, String target) { String start = "0000"; List<String> visited = new ArrayList<String>(); visited.add(start); Queue<String> queue = new LinkedList<String>(); int count = 0; queue.offer(start); while (!queue.isEmpty()) { int len = queue.size(); for (int i = 0; i < len; i++) { String top = queue.peek(); queue.poll(); List<String> neibors = findNeibors(top); for (String neibor:neibors) { if (target.equals(neibor)) { count++; return count; } if (findString(visited, neibor)) { continue; } if (!findString(Arrays.asList(deadends), neibor)) { visited.add(neibor); queue.offer(neibor); } } } count++; } return -1; } public static List<String> findNeibors(String s) { String temp = s; List<String> result = new ArrayList<>(); for (int i = 0; i < s.length(); i++) { char[] charTemp = temp.toCharArray(); charTemp[i] = String.valueOf((Integer.parseInt(String.valueOf(charTemp[i])) + 1) % 10).toCharArray()[0]; // charTemp[i] = (char) ((Integer.parseInt(String.valueOf(charTemp[i])) + 1) % 10); result.add(String.valueOf(charTemp)); charTemp[i] = String.valueOf((Integer.parseInt(String.valueOf(charTemp[i])) + 8) % 10).toCharArray()[0]; result.add(String.valueOf(charTemp)); } return result; } public static boolean findString(List<String> tofind, String s) { for (String temp : tofind) { if (s.equals(temp)) { return true; } } return false; } } 完全平方数 给定正整数 n,找到若干个完全平方数(比如 1, 4, 9, 16, ...)使得它们的和等于 n。你需要让组成和的完全平方数的个数最少。 示例 1: 输入: n = 12 输出: 3 解释: 12 = 4 + 4 + 4. 示例 2: 输入: n = 13 输出: 2 解释: 13 = 4 + 9. https://leetcode-cn.com/explore/learn/card/queue-stack/217/queue-and-bfs/874/ 解题思路:这道题和上一道打开转盘锁思路基本一样,同样是使用广度优先,每遍历一层将count++。不同点在于,本题每层将一个数拆成一个完全平方数和另一个数之和,每次将另一个数加入队列,判断另一个数是否为完全平方数,否则,广度搜索他的下一层。 import static java.lang.Math.sqrt; class Solution { public int numSquares(int n) { int count = 0; Queue<Integer> queue = new LinkedList<>(); if(isSquare(n)){ return 1; } queue.offer(n); while(!queue.isEmpty()){ int len = queue.size(); for (int z=0;z<len;z++){ int top = queue.peek(); queue.poll(); for(int i=0;i<=sqrt(top);i++){ int m = top-i*i; if(isSquare(m)){ count +=2; return count; } if(m==top){ continue; } queue.offer(m); } } count++; } return count; } public static boolean isSquare(int n){ double temp = sqrt(n); int m = (int) temp; return m*m==n; } } 栈和深度优先搜索 有效的括号 给定一个只包括 '(',')','{','}','[',']' 的字符串,判断字符串是否有效。 有效字符串需满足: 左括号必须用相同类型的右括号闭合。 左括号必须以正确的顺序闭合。 注意空字符串可被认为是有效字符串。 解题思路:本题较简单,利用堆栈,遇到右括号即一直出栈,判断括号是否匹配 class Solution { public boolean isValid(String s){ Stack<String> stack = new Stack<String>(); for(int i =0;i<s.length();i++){ String temp = s.substring(i,i+1); if(temp.equals("}")||temp.equals("]")||temp.equals(")")){ if(stack.empty()){ return false; } while (!stack.empty()){ String top = stack.peek(); stack.pop(); if((top.equals("{")||top.equals("[")||top.equals("("))){ if(!matchBrackets(top,temp)){ return false; }else { break; } } } }else { stack.push(temp); } } if(stack.isEmpty()){ return true; } return false; } public static boolean matchBrackets(String a,String b){ if( (a.equals("{")&&b.equals("}")) || (a.equals("[")&&b.equals("]")) || (a.equals("(")&&b.equals(")")) ){ return true; } return false; } } 每日温度 根据每日 气温 列表,请重新生成一个列表,对应位置的输入是你需要再等待多久温度才会升高的天数。如果之后都不会升高,请输入 0 来代替。 例如,给定一个列表 temperatures = [73, 74, 75, 71, 69, 72, 76, 73],你的输出应该是 [1, 1, 4, 2, 1, 1, 0, 0]。 提示:气温 列表长度的范围是 [1, 30000]。每个气温的值的都是 [30, 100] 范围内的整数。 https://leetcode-cn.com/explore/learn/card/queue-stack/218/stack-last-in-first-out-data-structure/879/ 解题思路:本题利用栈,将气温不断入栈,判断下一个气温是否比栈顶的气温高,如果高,则不断出栈直到不比栈顶的温度高,如果,并逐个计算每个出栈元素与这个比他们高的气温的差值天数,最后将这个气温入栈,寻找下一个比他高的气温。直到栈空。 class Solution { public int[] dailyTemperatures(int[] temperatures) { Stack<Entry> stack = new Stack<Entry>(); int[] res = new int[temperatures.length]; for (int i = 0; i < temperatures.length; i ++) { if (stack.isEmpty()) { stack.push(new Entry(temperatures[i], i)); continue; } if (temperatures[i] <= stack.peek().val) stack.push(new Entry(temperatures[i], i)); else { int j = 1; while (!stack.isEmpty() && temperatures[i] > stack.peek().val) { Entry tmp = stack.pop(); res[tmp.index] = i - tmp.index; } stack.push(new Entry(temperatures[i], i)); } } return res; } private class Entry { public int val; public int index; public Entry(int val, int index) { this.val = val; this.index = index; } } } 逆波兰表达式求值 根据逆波兰表示法,求表达式的值。 有效的运算符包括 +, -, *, / 。每个运算对象可以是整数,也可以是另一个逆波兰表达式。 说明: 整数除法只保留整数部分。 给定逆波兰表达式总是有效的。换句话说,表达式总会得出有效数值且不存在除数为 0 的情况。 https://leetcode-cn.com/explore/learn/card/queue-stack/218/stack-last-in-first-out-data-structure/880/ 解题思路:本题很简单,不断入栈,遇到运算符就出栈前两位进行运算即可 class Solution { public int evalRPN(String[] tokens){ Stack<String> stack = new Stack<>(); for(int i =0;i<tokens.length;i++){ if(isSimbol(tokens[i])){ int temp1 = Integer.parseInt(stack.pop()); int temp2 = Integer.parseInt(stack.pop()); if(tokens[i].equals("+")){ stack.push(String.valueOf(temp1+temp2)); } if(tokens[i].equals("-")){ stack.push(String.valueOf(temp2-temp1)); } if(tokens[i].equals("*")){ stack.push(String.valueOf(temp1*temp2)); } if(tokens[i].equals("/")){ stack.push(String.valueOf(temp2/temp1)); } }else { stack.push(tokens[i]); } } return Integer.parseInt(stack.pop()); } public static boolean isSimbol(String s){ if(s.equals("+")||s.equals("-")||s.equals("*")||s.equals("/")){ return true; } return false; } }

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册