首页 文章 精选 留言 我的

精选列表

搜索[学习],共10000篇文章
优秀的个人博客,低调大师

Java学习:反射的应用,依赖加载

使用反射实现从配置文件加载类以及根据配置文件解决特定依赖关系。 配置文件reflect.properties: 1AdminDao=reflect.AdminDao 1GuestDao=reflect.GuestDao 1Manager=reflect.Manager 2Manager:AdminDao 2Manager:GuestDao 对应类文件AdminDao: package reflect; public class AdminDao { public AdminDao(){ System.out.println("成功实例化AdminDao"); } } 对应类文件GuestDao: package reflect; public class GuestDao { public GuestDao(){ System.out.println("成功实例化GuestDao"); } } 对应类文件Manager: package reflect; public class Manager { private AdminDao adminDao = null; private GuestDao guestDao = null; public Manager() { System.out.println("Manage实例化成功"); } public void setAdminDao (Object o) { this.adminDao = (AdminDao)o; System.out.println("解决adminDao依赖"); } public void setGuestDao (Object o) { this.guestDao = (GuestDao)o; System.out.println("解决guestDao依赖"); } } 反射测试工厂类: package reflect; import java.io.BufferedReader; import java.io.FileReader; import java.io.IOException; import java.lang.reflect.Method; import java.util.HashMap; import java.util.Map; import java.util.Set; public class ObjectFactory { public static Map<String,Object> map = new HashMap<String,Object>(); static { BufferedReader br = null; try { br = new BufferedReader(new FileReader("src/reflect.properties")); String str = br.readLine(); while(str != null) { char c = str.charAt(0); switch (c) { case '1': String[] arr = str.substring(1).split("="); Object o = Class.forName(arr[1]).newInstance(); map.put(arr[0].trim().toLowerCase(), o); break; case '2': String[] arr2 = str.substring(1).split(":"); Object obj = map.get(arr2[0].trim().toLowerCase()); Object fieldObj = map.get(arr2[1].trim().toLowerCase()); String methodName = "set"+arr2[1].substring(0, 1).toUpperCase()+arr2[1].substring(1); Method method = obj.getClass().getDeclaredMethod(methodName, Object.class); method.invoke(obj, fieldObj); break; } str = br.readLine(); } } catch (Exception e) { e.printStackTrace(); } finally { try { br.close(); } catch (IOException e) { e.printStackTrace(); } } } public static void main(String[] args) { Set<String> set = map.keySet(); for (String string:set) { System.out.println(string+"--"+map.get(string)); } } } 跑起来结果: 成功实例化AdminDao 成功实例化GuestDao Manage实例化成功 解决adminDao依赖 解决guestDao依赖 admindao--reflect.AdminDao@10d1f30 manager--reflect.Manager@7aacc1 guestdao--reflect.GuestDao@1e3cabd

优秀的个人博客,低调大师

ElasticSearch学习笔记1-修改文档

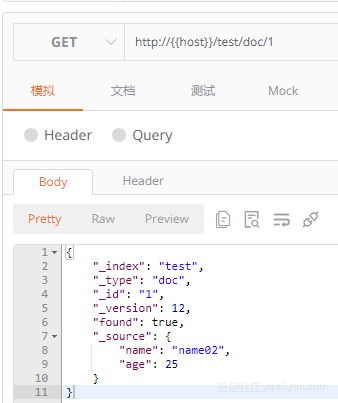
本文中所有用[]括起来的和xxx都是变量 基本操作:1、根据id修改文档,使用POST请求 POST /[index]/[type]/[id]/_update { "doc": {"[XXX]":"[xxxxx]"} } 举例: 上面这个图片中index为test,type为doc,id为1,我们将里面的name改为“name03” age改为20,请求如下: POST /test/doc/_update { "doc": { "name": "name03", "age": 20 } } 返回结果为: { "_index": "test", "_type": "doc", "_id": "1", "_version": 13, "result": "updated", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 13, "_primary_term": 1 } 对该id再进行一次查询,结果如图所示: 2、使用脚本修改 POST /[index]/[type]/[id]/_update { "script" : "ctx._source.[xxx] = [xxx]" } 继续使用上面的文档 POST /test/doc/1/_update { "script":"ctx._source.age+=5;ctx._source.name=\"name04\"" } 查询结果:修改成功。3、删除 DELETE /[index]/[type]/[id] 比较简单,不做举例4、批量创建批量创建和批量修改的请求都是一样的, 传的参数不一样请求: POST /[index]/[type]/_bulk 批量创建参数:{"index":{"_id":"xxx"}}{"xxx": "xxx" }{"index":{"_id":"xxx"}}{"xxx": "xxx" } 举例: POST /test01/doc01/_bulk {"index":{"_id":"1"}} {"name": "name01" } {"index":{"_id":"2"}} {"name": "name02","age":20 } {"index":{"_id":"3"}} {"name": "name03","age":20 } --------------1 这里有一点要注意:在图中1的位置,后面一定要换行,否则会报错,提示需要新的一行作为结束的标识,报错信息如下 { "error": { "root_cause": [ { "type": "illegal_argument_exception", "reason": "The bulk request must be terminated by a newline [\n]" } ], "type": "illegal_argument_exception", "reason": "The bulk request must be terminated by a newline [\n]" }, "status": 400 } 注意上面两张图片中最左边序号的不同,下面是正确的json数据,体会什么叫以新的一行作为结束的标识。 这种操作实际上是id存在就更新,不存在就创建,返回结果如下: { "took": 162, "errors": false, "items": [ { "index": { "_index": "test01", "_type": "doc01", "_id": "1", "_version": 6, "result": "updated", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 5, "_primary_term": 1, "status": 200 } }, { "index": { "_index": "test01", "_type": "doc01", "_id": "2", "_version": 2, "result": "updated", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 1, "_primary_term": 1, "status": 200 } }, { "index": { "_index": "test01", "_type": "doc01", "_id": "3", "_version": 1, "result": "created", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 0, "_primary_term": 1, "status": 201 } } ] } 查看下这三个id的具体内容: 5、批量修改参数: {"update":{"_id":"xxx"}} {"doc": { "XXX": "xxx" } } {"delete":{"_id":"xxx"}} 现在对上面创建的三条记录做批量修改: POST /test01/doc01/_bulk {"update":{"_id":"1"}} {"doc": { "name": "name011"}} {"delete":{"_id":"2"}} {"update":{"_id":"3"}} {"script": "ctx._source.age+=5;ctx._source.name=\"name033\""} -----------1 和批量创建一样,最后一行需要换行。查询索引test01的数据如下:数据全部修改成功!

优秀的个人博客,低调大师

"深度"学习让照片动起来

Facebook最近推出了“3D照片”功能,让普通的照片能有3D显示效果:可以随着手机姿态的变化显示照片的不同视角,打开链接即可体验 https://www.facebook.com/applealmondblog/posts/1922679287846447 (手机上陀螺仪控制,PC上鼠标控制) 可以看到虽然视角变化被限制在较小的范围,但是确实有3D的感觉,其实这样结合陀螺仪的简单3D效果也挺常见的,比如王者荣耀的启动界面: 晃动手机,前后景会随着手机姿态位移变化;一些H5页面也有这种效果,实现就更简单了,前后景两张或多张图片层叠,根据陀螺仪数据改变图片相对位置即可 可以看出,产生3D效果的关键在于z轴,即深度(depth),当图层或像素的深度有差别时,就可以在不同视角下计算出图层或像素新的位置,渲染出当前视角对应的图像。我们把每个像

优秀的个人博客,低调大师

java8学习:CompletableFuture方法使用

下面是自己总结的一部分的api的使用,当然下面有些方法后面加上Async就会变为异步的 /** * 变换:参数为Function接口 * thenApply:将上一个结果当做这次thenApply的参数传入,加以处理后,返回一个值 * 可以传入T返回T也可以传入T返回U */ public void thenApply() { CompletableFuture<String> future = CompletableFuture.supplyAsync(()-> 1).thenApply(i -> String.valueOf(i)); String i = future.join(); System.out.println(i); //1 } /** * 消费 * 参数为Consumer接口 * thenAccept:将上一个的结果当做这次的参数传入,但是无返回值 */ public void thenAccept() { CompletableFuture<Void> future = CompletableFuture.supplyAsync(() -> 1).thenAccept((integer -> System.out.println(integer))); future.join(); //1 } public void thenCompose() { CompletableFuture<Integer> future = CompletableFuture.supplyAsync(() -> 1) //提供第一个CompletableFuture结果值 .thenCompose((i) -> //将上一个结果值传入下一个CompletableFuture CompletableFuture.supplyAsync(() -> i + 2)); //对传入的结果值进行处理 Integer join = future.join(); System.out.println(join); } /** * 结合两个结果得到一个最终值 * 逻辑处理需要的是BiFunction接口 * 需要两个CompletableFuture结果,并且需要有处理两个结果的逻辑 * 两个CompletableFuture返回的结果不需要一致 */ public void thenCombine() { CompletableFuture<String> future = CompletableFuture.supplyAsync(() -> "Hello ") //第一个CompletableFuture返回结果 .thenCombine(CompletableFuture.supplyAsync(() -> 1), //第二个CompletableFuture返回结果 (future1, future2) -> future1 + future2); //处理两个结果的逻辑 String join = future.join(); System.out.println(join); //Hello World } /** * 跟上面的差不多,只不过这里处理逻辑需要的是一个BiConsumer接口,无返回值而已 */ public void thenAcceptBoth() { CompletableFuture<Void> both = CompletableFuture.supplyAsync(() -> "Hello ") //第一个CompletableFuture返回结果 .thenAcceptBoth(CompletableFuture.supplyAsync(() -> "World"), //第二个CompletableFuture返回结果 (future1, future2) -> System.out.println(future1 + future2));//处理两个结果的逻辑 both.join(); //Hello World } /** * 两个CompletableFuture一起执行,哪个先执行完就用哪个CompletableFuture的结果 * 处理逻辑需要的参数是一个Function接口 * 下面整体代码的逻辑是返回1的睡眠一秒,返回2的睡眠0.3秒,所以返回2的肯定比1要快,所以结果为2,然后应用到处理逻辑上 * 最终结果就是为 2 done * 两个CompletableFuture返回的参数需要一致 * 这适用于两种渠道完成同一个事情,就可以调用这个方法,找一个最快的结果进行处理,最终有返回值。 */ public void applyToEither() { CompletableFuture<String> apply = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } return "1"; }).applyToEither( CompletableFuture.supplyAsync(() -> { try { Thread.sleep(300); } catch (InterruptedException e) { e.printStackTrace(); } return "2"; }), (future) -> future + " done" //对于首先完成的CompletableFuture任务之后执行的逻辑 ); String join = apply.join(); System.out.println(join);//2 done } /** * 与上面使用方法一致,只是多加了一个选项 * 结果为3 three */ public void applyToEithers() { CompletableFuture<String> apply = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } return "1"; }).applyToEither( CompletableFuture.supplyAsync(() -> { try { Thread.sleep(800); } catch (InterruptedException e) { e.printStackTrace(); } return "2"; }),(future) -> future + " done" //对于首先完成的CompletableFuture任务之后执行的逻辑 ).applyToEither( CompletableFuture.supplyAsync(() -> { try { Thread.sleep(300); } catch (InterruptedException e) { e.printStackTrace(); } return "3"; }),(future -> future + " three") ); String join = apply.join(); System.out.println(join);//2 done } /** * 对于出错的处理过程进行补偿,即如果future出错,会运行exceptionally里的Function函数 * 当然没有错就不会运行后面指定的函数 */ @Test public void exceptionally() { CompletableFuture<String> exceptionally = CompletableFuture.supplyAsync(() -> { int i = 1 / 0 ; return "1"; }).exceptionally(ex -> { ex.printStackTrace(); return "error"; }); String join = exceptionally.join(); System.out.println(join); } /** * 输出 * error * java.util.concurrent.CompletionException: java.lang.ArithmeticException: / by zero * at java.util.concurrent.CompletableFuture.encodeThrowable(CompletableFuture.java:273) * at java.util.concurrent.CompletableFuture.completeThrowable(CompletableFuture.java:280) * at java.util.concurrent.CompletableFuture$AsyncSupply.run(CompletableFuture.java:1592) * at java.util.concurrent.CompletableFuture$AsyncSupply.exec(CompletableFuture.java:1582) * at java.util.concurrent.ForkJoinTask.doExec(ForkJoinTask.java:289) * at java.util.concurrent.ForkJoinPool$WorkQueue.runTask(ForkJoinPool.java:1056) * at java.util.concurrent.ForkJoinPool.runWorker(ForkJoinPool.java:1692) * at java.util.concurrent.ForkJoinWorkerThread.run(ForkJoinWorkerThread.java:157) * Caused by: java.lang.ArithmeticException: / by zero * at com.qidai.demotest.MyTestx.lambda$exceptionally$18(MyTestx.java:125) * at java.util.concurrent.CompletableFuture$AsyncSupply.run(CompletableFuture.java:1590) * ... 5 more */ /** * 与上面的thenAccept相比较,这个方法并不需要输入参数,相同点是都是无返回值 */ public void thenRun() { CompletableFuture<Void> runnable = CompletableFuture.supplyAsync(() -> "1").thenRun(() -> System.out.println("runnable")); runnable.join(); }

优秀的个人博客,低调大师

java8学习:使用流(1)

内容来自《 java8实战 》,本篇文章内容均为非盈利,旨为方便自己查询、总结备份、开源分享。如有侵权请告知,马上删除。书籍购买地址:java8实战 筛选和切片 filter方法 //取出是素菜的菜单 menu.stream() .filter(Dish::isVegetarian) //代表是否是素食,这里条件并不一定是方法调用,只要的你条件能够返回boolean就可以 .collect(Collectors.toList()); limit方法 //取出菜单的前三个 menu.stream().limit(3) //跟sql中limit一样,不过这个是短路limit,也就是说,它取出了三个后就不再遍历后面的元素了,直接返回 .collect(Collectors.toList()); distinct方法:去重 menu.stream() .distinct() //去重操作,根据元素的hashCode和equals方法判断是否相等 .collect(Collectors.toList()); skip方法:跳过指定数量的元素 //取菜单中第三个到第五个 menu.stream() .skip(2) //跳过开头两个元素 .limit(3) //然后截取第三个到第五个 .forEach(System.out::println); //如上可以看出skip和limit是互补的,因为limit没有这样的形式:limit(start,end) 映射 提到这个概念,就是把你stream里的每个元素都应用到自己指定的表达式之上然后返回,就比如 List<String> list = Arrays.asList("1","2","3"); list.stream() .映射方法(str -> str + "dada") .forEach(System.out::println); //以上为伪代码 //说明的意思就是list中的每个元素:1,2,3都会应用到表达式:str + "dada" //并返回表达式的值 //所以结果就是1dada,2dada,3dada map方法 //这里提到的map方法,完全可以替换上面的伪代码:映射方法,上面代码是传入A类型返回A类型的演示 //也就是传入字符串1,2,3返回的也是字符串 //map当然可以传入A类型返回B类型,比如 List<String> list = Arrays.asList("1","2","3"); list.stream() .map(Integer::parseInt) .forEach(System.out::println); //上面就是传入String,返回的是int //当然也可以是返回字符串的长度 考虑一个场景,把n个单词的里面的字母去重然后输出 就比如["abc","bce"],里面的字母就是["a","b","c","b","c","e"],去重后是:["a","b","c","e"],现在来实现它 List<String> list = Arrays.asList("abc","bce"); List<String[]> collect = list.stream() .map(str -> str.split("")) .distinct() .collect(Collectors.toList()); collect.forEach(System.out::println); 上面的感觉是对的,拆分,然后去重,但是一点需要注意,当lambda把第一个元素"abc"进行映射操作的时候,split方法返回的是一个String数组对象,这也就能解释为什么List的泛型是String数组了,数组跟数组distinct那肯定是去重不成功的。 流的过程是这样的["abc","bce"] -> [{"a","b","c"},{"b","c","e"}],然后拿{"a","b","c"}和{"b","c","e"}去重肯定行不通 现在遇到的问题就是:我们希望把abc和bce切分然后合并成一个流,然后进行去重,我们接着实验 Array::stream Array::stream可以接受一个数组并产生一个流,如下 String[] str = {"abc","bce"}; Stream<String> stream = Arrays.stream(str); stream.forEach(System.out::println); //abc //bce 我们在上面的split方法返回的就是数组,我们尝试将split返回的数组映射到此方法上,看看能不能合并成一条流 List<String> list = Arrays.asList("abc","bce"); List<Stream<String>> collect = list.stream() .map(str -> str.split("")) .map(Arrays::stream) .distinct() .collect(Collectors.toList()); //java.util.stream.ReferencePipeline$Head@2aae9190 //java.util.stream.ReferencePipeline$Head@2f333739 但是并不尽如人意,因为他返回的泛型是Stream,也就是说,Array::stream方法只是把一个数组转换为一个流,流中的元素是String所以这个流就是这样的Stream,这种情况类似上面遇到的返回的是两个数组,现在返回的List中装入的并不是String,而是两条流,流跟流做去重也是行不通的 解决方案 现在遇到的问题就是:他们都是将一个list元素单独转化为一条流或者一个数组,我们需要的是转换为流或者数组之后,再将这些返回的数组或者流接为一个流或者数组,就像接水管一样,让他们连起来 尝试方法:flatmap List<String> list = Arrays.asList("abc","bce"); List<String> collect = list.stream() .map(str -> str.split("")) .flatMap(Arrays::stream) .distinct() .collect(Collectors.toList()); collect.forEach(System.out::println); //a b c e 如上的代码终于是返回了一个LIst,所以结果也是我们期待的达到了去重的效果,那么它的流的处理过程是怎么样的呢?如下 传入"abc"->切分为["a","b","c"] --->flatMap合并["a","b","c","b","c","e"]->去重->ok 传入"bce"->切分为["b","c","e"] 上面能看懂吗...懒得画图了,第一行和第三行是flatMap前面的split过程,然后是第二行存入flatMap进行合并流 flatMap也就是把n个流合并为一个流 小实战 要求两个list:["123"],["456"],然后组成元组:(1,4),(1,5),(1,6),(2,4),(2,5)... List<String> first = Arrays.asList("123"); List<String> second = Arrays.asList("456"); first.stream() .map(str -> str.split("")) .forEach(strs -> { Arrays.stream(strs).forEach(f -> { second.stream() .map(sec -> sec.split("")) .forEach(secs -> Arrays.stream(secs).forEach(s -> System.out.println("("+f+","+s+")"))); }); }); //上面代码是直接输出的,那么下面的就是将元组组合成一个LIst返回了 List<String> first = Arrays.asList("123"); List<String> second = Arrays.asList("456"); List<String> collect = first.stream() .map(str -> str.split("")) .flatMap(strs -> //将strs后的表达式返回的stream都合并为一个 Arrays.stream(strs).flatMap(f -> second.stream() .map(sec -> sec.split("")) .flatMap(secs -> Arrays.stream(secs).map(s -> "(" + f + "," + s + ")"))) ).collect(Collectors.toList()); collect.forEach(System.out::println); //耐心看..... 查找和匹配 anyMatch:至少匹配一个 List<String> list = Arrays.asList("1","2","3","4"); boolean b = list.stream().anyMatch(s -> s.equals("1")); //true allMatch:全部匹配 List<String> list = Arrays.asList("1","2","3","4"); boolean b = list.stream().allMatch(s -> Integer.parseInt(s) < 5); //true noneMatch:全部不匹配 List<String> list = Arrays.asList("1","2","3","4"); boolean b = list.stream().noneMatch(s -> Integer.parseInt(s) > 5); //true 如上的方法都具有短路效果,意思就是主要遇到一个不匹配条件的元素就立刻返回true或者false findAny:找任意一个 List<String> list = Arrays.asList("1","2","3","4"); Optional<String> any = list.stream().findAny(); System.out.println(any.get()); //虽然书上说是任意一个,但是我一直返回的是1 //自己测试的将元素添加到十个,stream依旧是1,但是使用并行流parallelStream,将随机返回,但是依然是区间比较小 Option以后的帖子会说到的,你可以看一下我相关的帖子,只要记住Option是一个值的容器,因为findAny找的可能是个空列表,所以他可能会返回null,然后将返回的这个值包装在Option中,然后调用get方法就会出现返回的值,如果Option中没有值还get那么就会报错,现在只要知道这点就可以了 findFirst:找到第一个 List<String> list = Arrays.asList("1","2","3","4"); Optional<String> any = list.stream().findFirst(); System.out.println(any.get()); //1 归约reduce 上面的映射和这词提到的归约可以一起使用,类似hadoop中的mr模型 元素求和 int[] is = {1,2,3,4,5,6,7,8,9}; Arrays.stream(is).reduce(0,Integer::sum);//45 //以0为起始值,所以如果数组内没有元素,也不至于null,然后依次相加 //0+1=1 //1+2=3 //3+3=6 //6+4=10 .... int[] is = {1,2,3,4,5,6,7,8,9}; OptionalInt reduce = Arrays.stream(is).reduce(Integer::sum); System.out.println("reduce = " + reduce.getAsInt());//45 //OptionalInt的出现就是因为它没有初始值进行累加,所以如果数组为空,那么将返回null //OptionalInt使用方法和Optional一样,只是方法名变了一下,目前只知道这些就好了 元素最大值和最小值 //max int[] is = {1,2,3,4,5,6,7,8,9}; OptionalInt reduce = Arrays.stream(is).reduce(Integer::max); System.out.println("reduce = " + reduce.getAsInt()); //9 //求最小改为min方法即可,也可以自己实现 OptionalInt reduce = Arrays.stream(is).reduce((a,b) -> a > b ? a : b ); 归约方法的优势和并行化 求和方法:定义一个int变量,然后迭代去加。相比之下reduce将其转换为了内部迭代。而且迭代要去求和并且更新我们的一个int共享变量,这对于并行化来说并不容易实现,如果加入了同步,可能线程切换的开销就已经抵消了并行带来的性能提升。(可变的变量累计器对于并行来说并不好),如上的代码为了实现并行只需要把stream方法改为parallelStream()即可 int[] is = {1,2,3,4,5,6,7,8,9}; int sum = 0; //int共享变量 //这只是单线程的,如果是多线程的话,为了保证sum的正确肯定要sync。 //所以这就是说的共享变量并不适合于并行化 for (int i : is) { sum += i; //更新共享变量 } 流操作的有状态和无状态 如果你购买了书可以先去看看书的定义,下面是我自己的理解 int[] is = {1,2,3,4,5,6,7,8,9}; Arrays.stream(is) .filter(i -> i > 3) //无状态 .map(i -> i + 1) //无状态 .distinct() //有状态 .max(); //有状态 对于上面来说,filter和map只是接收一个元素然后过滤映射一个元素,这个元素处理完就交给下面的方法处理了,自己并不保留这个元素,这样的叫做无状态 那distinct和max来说,他不能接收一个处理一个然后再交给下面的方法处理,因为它需要拿到整个元素来去重和去最大值,如果拿到部分他肯定是不能做这些操作的,元素就暂时的保留在了方法中,所以这样的叫做有状态 接下来的东西下一篇讲
优秀的个人博客,低调大师

SQL数据库学习之路(八)

数据库介绍: 在网页上的主程序中进行注册操作,然后把数据发送给人,人传递这些数据到数据库当中。 为什么学ADO.NET:之前我们所学的只能在查询分析器中查看数据,操作数据。我们不能让一个普通用户使用SQL去操作,所以我们搭建一个界面(Web Winform)让用户方便地去使用数据库中的数据。 什么是ADO.NET:ADO.NET就是一组类库,这组类库可以让我们通过程序去访问数据库,就像System.IO下的类用类操作文件一样,System.Data这组类是用来操作数据库,它提供了统一的编程接口。 数据提供程序(常用类): 1.connection :用来连接数据库 2.command :用来执行SQL语句 3.datareader :只读、只进的结果集,一条一条读取数据。 4dataadapter :一个封装了上面三个对象的对象。 数据集(DataSet):临时数据库,断开式数据操作 VS中连接数据库 1.打开VS2015,在左上角文件中选择新建项目。选择C#中的控制台应用程序,自己定义命名,点击确定,出现如下界面。 2.打开服务器资源管理器,或者视图,服务器资源管器 。 右键数据连接,创建新连接后如图所示 。 .服务器名是你要连接的服务器名,可以是你自己的服务器也可以是别人的服务器,点击下拉框按钮会出现在局域网中所有的服务器。身份验证当你连接你自己的服务器可以是Windows身份验证,如果连接局域网的服务器必须是SQL server 验证,需提供登录名和密码。连接到数据库就是你自己想用的服务器的数据库。 3.点击在数据连接中出现的数据库,右键选择属性,在属性中复制连接字符串的内容。 Data Source=****;(这是指服务器的名字)Initial Catalog=Text;(这是要连接的数据库)Integrated Security=True(以Windows身份登录的) 4.在调用类时增加这一句using System.Data.SqlClient; main()函数代码: int r=0; //连接字符串 string str = "Data Source=********;Initial Catalog=Text;Integrated Security=True"; using (SqlConnection con=new SqlConnection(str)) //连接数据库 { string sql = " ";//输入需要使用的SQL语句 using (SqlCommand cmd =new SqlCommand(sql,con))//要执行的SQL语句 { con.Open(); //打开数据库 //增删改 r = cmd.ExecuteNonQuery(); } Console.WriteLine(r > 0 ? "操作成功" : "操作失败"); //如果r>0控制台显示操作成功,r<0控制台显示操作失败 Console.ReadKey(); }

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册