首页 文章 精选 留言 我的

精选列表

搜索[腾讯技术创作特训营S8],共10000篇文章
优秀的个人博客,低调大师

别再纠结线程池池大小、线程数量了,哪有什么固定公式 | 京东云技术团队

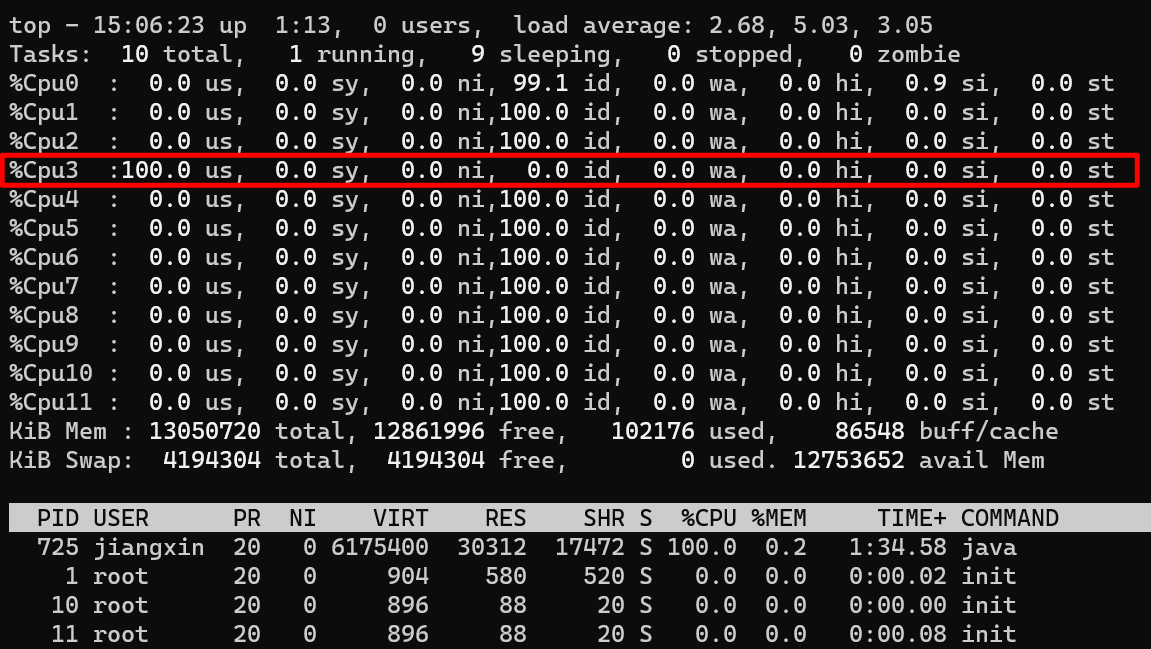
可能很多人都看到过一个线程数设置的理论: CPU 密集型的程序 - 核心数 + 1 I/O 密集型的程序 - 核心数 * 2 不会吧,不会吧,真的有人按照这个理论规划线程数? 线程数和CPU利用率的小测试 抛开一些操作系统,计算机原理不谈,说一个基本的理论(不用纠结是否严谨,只为好理解):一个CPU核心,单位时间内只能执行一个线程的指令 那么理论上,我一个线程只需要不停的执行指令,就可以跑满一个核心的利用率。 来写个死循环空跑的例子验证一下: 测试环境:AMD Ryzen 5 3600, 6 - Core, 12 - Threads public class CPUUtilizationTest { public static void main(String[] args) { //死循环,什么都不做 while (true){ } } } 运行这个例子后,来看看现在CPU的利用率: 从图上可以看到,我的3号核心利用率已经被跑满了 那基于上面的理论,我多开几个线程试试呢? public class CPUUtilizationTest { public static void main(String[] args) { for (int j = 0; j < 6; j++) { new Thread(new Runnable() { @Override public void run() { while (true){ } } }).start(); } } } 此时再看CPU利用率,1/2/5/7/9/11 几个核心的利用率已经被跑满: 那如果开12个线程呢,是不是会把所有核心的利用率都跑满?答案一定是会的 如果此时我把上面例子的线程数继续增加到24个线程,会出现什么结果呢? 从上图可以看到,CPU利用率和上一步一样,还是所有核心100%,不过此时负载已经从11.x增加到了22.x(load average解释参考https://scoutapm.com/blog/understanding-load-averages),说明此时CPU更繁忙,线程的任务无法及时执行。 现代CPU基本都是多核心的,比如我这里测试用的AMD 3600,6核心12线程(超线程),我们可以简单的认为它就是12核心CPU。那么我这个CPU就可以同时做12件事,互不打扰。 如果要执行的线程大于核心数,那么就需要通过操作系统的调度了。操作系统给每个线程分配CPU时间片资源,然后不停的切换,从而实现“并行”执行的效果。 但是这样真的更快吗?从上面的例子可以看出,一个线程就可以把一个核心的利用率跑满。如果每个线程都很“霸道”,不停的执行指令,不给CPU空闲的时间,并且同时执行的线程数大于CPU的核心数,就会导致操作系统更频繁的执行切换线程执行,以确保每个线程都可以得到执行。 不过切换是有代价的,每次切换会伴随着寄存器数据更新,内存页表更新等操作。虽然一次切换的代价和I/O操作比起来微不足道,但如果线程过多,线程切换的过于频繁,甚至在单位时间内切换的耗时已经大于程序执行的时间,就会导致CPU资源过多的浪费在上下文切换上,而不是在执行程序,得不偿失。 上面死循环空跑的例子,有点过于极端了,正常情况下不太可能有这种程序。 大多程序在运行时都会有一些 I/O操作,可能是读写文件,网络收发报文等,这些 I/O 操作在进行时时需要等待反馈的。比如网络读写时,需要等待报文发送或者接收到,在这个等待过程中,线程是等待状态,CPU没有工作。此时操作系统就会调度CPU去执行其他线程的指令,这样就完美利用了CPU这段空闲期,提高了CPU的利用率。 上面的例子中,程序不停的循环什么都不做,CPU要不停的执行指令,几乎没有啥空闲的时间。如果插入一段I/O操作呢,I/O 操作期间 CPU是空闲状态,CPU的利用率会怎么样呢?先看看单线程下的结果: public class CPUUtilizationTest { public static void main(String[] args) throws InterruptedException { for (int n = 0; n < 1; n++) { new Thread(new Runnable() { @Override public void run() { while (true){ //每次空循环 1亿 次后,sleep 50ms,模拟 I/O等待、切换 for (int i = 0; i < 100_000_000l; i++) { } try { Thread.sleep(50); } catch (InterruptedException e) { e.printStackTrace(); } } } }).start(); } } } 哇,唯一有利用率的9号核心,利用率也才50%,和前面没有sleep的100%相比,已经低了一半了。现在把线程数调整到12个看看: 单个核心的利用率60左右,和刚才的单线程结果差距不大,还没有把CPU利用率跑满,现在将线程数增加到18: 此时单核心利用率,已经接近100%了。由此可见,当线程中有 I/O 等操作不占用CPU资源时,操作系统可以调度CPU可以同时执行更多的线程。 现在将I/O事件的频率调高看看呢,把循环次数减到一半,50_000_000,同样是18个线程: 此时每个核心的利用率,大概只有70%左右了。 线程数和CPU利用率的小总结 上面的例子,只是辅助,为了更好的理解线程数/程序行为/CPU状态的关系,来简单总结一下: 一个极端的线程(不停执行“计算”型操作时),就可以把单个核心的利用率跑满,多核心CPU最多只能同时执行等于核心数的“极端”线程数 如果每个线程都这么“极端”,且同时执行的线程数超过核心数,会导致不必要的切换,造成负载过高,只会让执行更慢 I/O 等暂停类操作时,CPU处于空闲状态,操作系统调度CPU执行其他线程,可以提高CPU利用率,同时执行更多的线程 I/O 事件的频率频率越高,或者等待/暂停时间越长,CPU的空闲时间也就更长,利用率越低,操作系统可以调度CPU执行更多的线程 线程数规划的公式 前面的铺垫,都是为了帮助理解,现在来看看书本上的定义。《Java 并发编程实战》介绍了一个线程数计算的公式: 如果希望程序跑到CPU的目标利用率,需要的线程数公式为: 公式很清晰,现在来带入上面的例子试试看: 如果我期望目标利用率为90%(多核90),那么需要的线程数为: 核心数12 * 利用率0.9 * (1 + 50(sleep时间)/50(循环50_000_000耗时)) ≈ 22 现在把线程数调到22,看看结果: 现在CPU利用率大概80+,和预期比较接近了,由于线程数过多,还有些上下文切换的开销,再加上测试用例不够严谨,所以实际利用率低一些也正常。 把公式变个形,还可以通过线程数来计算CPU利用率: 线程数22 / (核心数12 * (1 + 50(sleep时间)/50(循环50_000_000耗时))) ≈ 0.9 虽然公式很好,但在真实的程序中,一般很难获得准确的等待时间和计算时间,因为程序很复杂,不只是“计算”。一段代码中会有很多的内存读写,计算,I/O 等复合操作,精确的获取这两个指标很难,所以光靠公式计算线程数过于理想化。 真实程序中的线程数 那么在实际的程序中,或者说一些Java的业务系统中,线程数(线程池大小)规划多少合适呢? 先说结论:没有固定答案,先设定预期,比如我期望的CPU利用率在多少,负载在多少,GC频率多少之类的指标后,再通过测试不断的调整到一个合理的线程数 比如一个普通的,SpringBoot 为基础的业务系统,默认Tomcat容器+HikariCP连接池+G1回收器,如果此时项目中也需要一个业务场景的多线程(或者线程池)来异步/并行执行业务流程。 此时我按照上面的公式来规划线程数的话,误差一定会很大。因为此时这台主机上,已经有很多运行中的线程了,Tomcat有自己的线程池,HikariCP也有自己的后台线程,JVM也有一些编译的线程,连G1都有自己的后台线程。这些线程也是运行在当前进程、当前主机上的,也会占用CPU的资源。 所以受环境干扰下,单靠公式很难准确的规划线程数,一定要通过测试来验证。 流程一般是这样: 分析当前主机上,有没有其他进程干扰 分析当前JVM进程上,有没有其他运行中或可能运行的线程 设定目标 目标CPU利用率 - 我最高能容忍我的CPU飙到多少? 目标GC频率/暂停时间 - 多线程执行后,GC频率会增高,最大能容忍到什么频率,每次暂停时间多少? 执行效率 - 比如批处理时,我单位时间内要开多少线程才能及时处理完毕 …… 梳理链路关键点,是否有卡脖子的点,因为如果线程数过多,链路上某些节点资源有限可能会导致大量的线程在等待资源(比如三方接口限流,连接池数量有限,中间件压力过大无法支撑等) 不断的增加/减少线程数来测试,按最高的要求去测试,最终获得一个“满足要求”的线程数** 而且而且而且!不同场景下的线程数理念也有所不同: Tomcat中的maxThreads,在Blocking I/O和No-Blocking I/O下就不一样 Dubbo 默认还是单连接呢,也有I/O线程(池)和业务线程(池)的区分,I/O线程一般不是瓶颈,所以不必太多,但业务线程很容易称为瓶颈 Redis 6.0以后也是多线程了,不过它只是I/O 多线程,“业务”处理还是单线程 所以,不要纠结设置多少线程了。没有标准答案,一定要结合场景,带着目标,通过测试去找到一个最合适的线程数。 可能还有同学可能会有疑问:“我们系统也没啥压力,不需要那么合适的线程数,只是一个简单的异步场景,不影响系统其他功能就可以” 很正常,很多的内部业务系统,并不需要啥性能,稳定好用符合需求就可以了。那么我的推荐的线程数是:CPU核心数 附录 Java 获取CPU核心数 Runtime.getRuntime().availableProcessors()//获取逻辑核心数,如6核心12线程,那么返回的是12 Linux 获取CPU核心数 # 总核数 = 物理CPU个数 X 每颗物理CPU的核数 # 总逻辑CPU数 = 物理CPU个数 X 每颗物理CPU的核数 X 超线程数 # 查看物理CPU个数 cat /proc/cpuinfo| grep "physical id"| sort| uniq| wc -l # 查看每个物理CPU中core的个数(即核数) cat /proc/cpuinfo| grep "cpu cores"| uniq # 查看逻辑CPU的个数 cat /proc/cpuinfo| grep "processor"| wc -l 如果我的文章对您有帮助,请点赞/收藏/关注鼓励支持一下吧❤❤❤❤❤❤ 作者:京东保险 蒋信 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

iOS16新特性:实时活动-在锁屏界面实时更新APP消息 | 京东云技术团队

简介 之前在 《iOS16新特性:灵动岛适配开发与到家业务场景结合的探索实践》 里介绍了iOS16新的特性:实时更新(Live Activity)中灵动岛的适配流程,但其实除了灵动岛的展示样式,Live Activity还有一种非常实用的应用场景,那就是锁屏界面实时状态更新: 上图是部分已经做出适配的APP,锁屏实时活动的展示。可以看到,相比于灵动岛的样式,锁屏更新的展示区域更大,能够显示更多信息,并且是在锁屏界面上进行展示,结合苹果在iPhone14之后推出的“全天候显示”功能,能够让用户在不解锁手机,甚至不拿起手机的情况下就能够获取到APP内最新的消息更新,在某些应用场景下非常实用。 这篇文章主要就介绍Live Activity中锁屏实时活动样式的适配流程,再结合实际开发过程中的遇到的问题进行实际详解: 限制条件 在进行开发之前,需要先了解一下锁屏实时活动的一些限制条件: 1.实时活动显示在通知区域且有更自由的视图定制和刷新方法,但是跟Widget小组件一样,它也限制了视图上的动画开发,所有的动画效果仅能由系统处理。 2.锁屏通知区域内的实时活动在8小时之内可以刷新数据展示,超过8小时不再支持刷新,,超过12小时强制消失 3.实时活动视图本体不支持发起网络请求,所有的动态数据都要经由通知下发,或者后台活动数据刷新,且每次更新的数据不能超过4KB。 4.实时活动可以通过推送下发更新数据,但是推送的类型不同于传统“基于证书”的推送,而是“基于token”的推送类型。 实际开发 1.建立锁屏实时活动扩展项目 这部分建立的过程与灵动岛的适配流程完全一致,请参见 iOS16新特性:灵动岛适配开发与到家业务场景结合的探索实践 中相关的流程描述,如果之前建立过灵动岛项目,则可以直接开始开发: 2.UI开发 Live Activity的全部样式开发均完全采用SwiftUI,锁屏实时活动也不例外,以下是我开发的UI部分代码,大家可以一参考一下: struct LockScreenLiveActivityView: View { let context: ActivityViewContext<DJDynamicIslandAttributes> var body: some View { VStack { Spacer(minLength: 10) LockScreenLiveActivityStoreHeaderView(imageURL: context.state.logo, title: context.state.title, subTitle: context.state.subTitle) Spacer(minLength: 0) LockScreenLiveActivityProgressView(progress: context.state.progress) Spacer(minLength: 10) } } } struct LockScreenLiveActivityStoreHeaderView: View { let imageURL: String let title: String let subTitle: String var body: some View { HStack(spacing: 10) { NetworkImage(imageUrl: imageURL) .frame(width: 50, height: 50) VStack(alignment: .leading, spacing: 4) { HStack { Text(title) .font(.system(size: 16, weight: .bold)) .foregroundColor(Color(hex: 0x333333, alpha: 1)) } Text(subTitle) .font(.system(size: 13)) .foregroundColor(Color(hex: 0x666666, alpha: 1)) .padding(EdgeInsets(top: 5, leading: 0, bottom: 0, trailing: 0)) } Spacer() // 填充剩余空间 } .padding(8) } } struct LockScreenLiveActivityProgressView: View { var progress: CGFloat let borderOffset = 20.0 var body: some View { VStack { ZStack(alignment: .bottom) { HStack(alignment: .bottom) { Spacer() NetworkImage(imageUrl: "", placeholdImage: "store") .frame(width: 50, height: 50) Spacer() } HStack(alignment: .bottom) { NetworkImage(imageUrl: "", placeholdImage: "knight") .frame(width: 40, height: 40) .offset(x: progress * UIScreen.main.bounds.width - 25) Spacer() } HStack(alignment: .bottom) { Spacer() NetworkImage(imageUrl: "", placeholdImage: "pin") .frame(width: 18, height: 25) .offset(x: -borderOffset) } } .frame(height: 50) Spacer(minLength: 0) ZStack(alignment: .leading) { RoundedRectangle(cornerRadius: 5) .foregroundColor(Color.gray) .frame(height: 10) RoundedRectangle(cornerRadius: 5) .foregroundColor(Color.yellow) .frame(width: (UIScreen.main.bounds.width - borderOffset * 3) * progress, height: 10) } .frame(height: 15) .padding(.horizontal, borderOffset) } } } 运行起来以后大概长这个样子: 坑1: 由于实时活动不允许加载网络请求,所以网络图片的URL也无法加载,可以通过: 1.直接通推送通知过下发图片的Data,再转成img,但是要注意数据大小,不要超过4Kb 2.本地图片 来解决 3.Live Activity的生命周期 Live Activity的生命周期由ActivityKit管理,其中,数据部分的模型类为ActivityAttributes,自定义数据模型需要继承自ActivityAttributes,静态数据变量直接生命在结构体内,动态数据变量需要声明在ActivityAttributes的ContentState中,这部分变量在接收到推送更新数据时,会自动根据json数据的key值进行解析并更新: struct DJDynamicIslandAttributes: ActivityAttributes { public typealias DJDynamicIslandStatus = ContentState public struct ContentState: Codable, Hashable { // 动态数据 var logo: String = "" var title: String = "" var subTitle: String = "" var progress: Double = 0 } // 静态数据 var totalAmount: String var orderId: String } Live Activity的生命周期分为: 创建(start) 利用Activity的request方法创建 func startActivity() throws { let attributes = DJDynamicIslandAttributes( // 静态数据 ) let initialContentState = DJDynamicIslandAttributes.ContentState( // 动态数据 ) let activity = try Activity.request( attributes: attributes, content: .init(state: initialContentState, staleDate: nil), pushType: .token) } 更新(update) 利用Activity的update方法更新,传入的参数即为ActivityAttributes的ContentState,也就是动态数据部分 func updateActivity(){ Task{ let updatedStatus = DJDynamicIslandAttributes.ContentState( // 动态数据 ) for activity in Activity<DJDynamicIslandAttributes>.activities{ await activity.update(using: updatedStatus) print("已更新灵动岛显示 Value值已更新 请展开灵动岛查看") } } } 结束(end) 利用Activity的end方法结束,并从锁屏通知界面上移除 func endActivity(){ Task{ for activity in Activity<DJDynamicIslandAttributes>.activities{ await activity.end(dismissalPolicy: .immediate) print("已关闭灵动岛显示") } } } 4.数据同步 通过 ActivityConfiguration(for: DJDynamicIslandAttributes.self) { context in } 方法创建实时活动视图的时候,回调的参数context类型是ActivityViewContext<ActivityAttributes>,可以通过context.state取到动态化数据的属性: struct LockScreenLiveActivityView: View { let context: ActivityViewContext<DJDynamicIslandAttributes> var body: some View { VStack { Spacer(minLength: 10) LockScreenLiveActivityStoreHeaderView(imageURL: context.state.logo, title: context.state.title, subTitle: context.state.subTitle) Spacer(minLength: 0) LockScreenLiveActivityProgressView(progress: context.state.progress) Spacer(minLength: 10) } } } 利用这些属性刷新视图 使用推送通知更新实时活动 前面已经介绍过,实时活动可以通过推送通知来更新数据展示,下面来介绍具体做法以及开发过程中遇到的坑 ActivityKit 提供了从应用程序启动、更新和结束实时活动的功能。我们可以使用Token通过从服务器发送到 Apple 推送通知服务 (APNs) 的 ActivityKit 推送通知来更新实时活动, 苹果WWDC:《Update Live Activities with push notifications》教程视频 要使用 ActivityKit 推送通知更新实时活动: 1.获取APP的推送Token 使用 ActivityKit ,在启动实时活动时获取实时活动的唯一推送Token。 func startActivity(orderId:String) throws { let attributes = DJDynamicIslandAttributes( // 静态数据 ) let initialContentState = DJDynamicIslandAttributes.ContentState( // 动态数据 ) let activity = try Activity.request( attributes: attributes, content: .init(state: initialContentState, staleDate: nil), pushType: .token) Task { // 获取实时活动的唯一推送Token for await data in activity.pushTokenUpdates { let token = data.map { String(format: "%02x", $0) }.joined() } } } 使用Activity.request方法时注意传入pushType参数为.token,指定实时活动更新方式为“基于token”的推送更新,这个token就标识了是哪部手机的哪个实时活动来接受推送通知。拿到token后,前端要把它发送给后端服务器,由后端处理发给苹果进行推送 坑2: Activity.request方法后,token不会立刻生成,而是会异步生成,过一段时间才能取到,所以要建一个Task使用for await方式来获取 坑3: 只有真机调试才能获取token,模拟器无法生成token(苹果APNs不会为模拟器下发推送通知) 2.为APP开启推送通知能力 在苹果开发者中心developer.apple.com 申请一个用于通知的key 之后可以获得: 一个10个字符的Key ID,后续的推送中会用到 一个authentication token signing key,是一个.p8类型的文件,后续的推送中需要传入它的存储路径。 3.将要推送的数据进行封装,准备进行通知推送 "aps": { "timestamp":'$(date +%s)', "event":"update", "content-state":{ "logo": "https://img.duoziwang.com/2016/12/17/16485364877.jpg", "title": "订单已经开始配送", "subTitle": "快递员正在加急配送", "progress": 0.6 } } aps内的数据就是推送通知内容,timestamp是时间戳;event是通知类型,分为update和end两种;content-state就是上文中定义的ActivityAttributes动态数据属性部分,这里的key要与属性名对应,接到通知后就可以自动解析并更新数据 坑4: 所有的属性,在content-state里都要有对应的key-value,就算是空的也要写上,不然会解析失败 4.编写服务器脚本 上面封装好的数据,要由后端服务器负责发送给苹果推送服务器(APNs),这个过程就要用到之前几步拿到的信息。这里我把推送脚本的模版提供给大家,大家可以在这个基础上进行修改: #!/bin/bash # Set and export your shell variables export TEAM_ID="苹果开发者账号的teamID" export TOKEN_KEY_FILE_NAME="第二步拿到的.p8文件存储路径" export AUTH_KEY_ID="第二步拿到的Key ID" export TOPIC="app的BundleIdentifier.push-type.liveactivity" export ACTIVITY_PUSH_TOKEN="第一步拿到的token" export APNS_HOST_NAME="api.sandbox.push.apple.com" # Calculate JWT components export JWT_ISSUE_TIME=$(date +%s) export JWT_HEADER=$(printf '{ "alg": "ES256", "kid": "%s" }' "${AUTH_KEY_ID}" | openssl base64 -e -A | tr -- '+/' '-_' | tr -d =) export JWT_CLAIMS=$(printf '{ "iss": "%s", "iat": %d }' "${TEAM_ID}" "${JWT_ISSUE_TIME}" | openssl base64 -e -A | tr -- '+/' '-_' | tr -d =) export JWT_HEADER_CLAIMS="${JWT_HEADER}.${JWT_CLAIMS}" export JWT_SIGNED_HEADER_CLAIMS=$(printf "${JWT_HEADER_CLAIMS}" | openssl dgst -binary -sha256 -sign "${TOKEN_KEY_FILE_NAME}" | openssl base64 -e -A | tr -- '+/' '-_' | tr -d =) export AUTHENTICATION_TOKEN="${JWT_HEADER}.${JWT_CLAIMS}.${JWT_SIGNED_HEADER_CLAIMS}" # Send APNs request curl -v --header "apns-topic: $TOPIC" \ --header "apns-push-type: liveactivity" \ --header "apns-priority: 10" \ --header "authorization: bearer $AUTHENTICATION_TOKEN" \ --data '{ "aps": { "timestamp":'$(date +%s)', "event":"update", "content-state":{ #动态数据 } } }' \ --http2 "https://${APNS_HOST_NAME}/3/device/${ACTIVITY_PUSH_TOKEN}" 此部分请求头部信息格式来源: Establishing a token-based connection to APNs Sending push notifications using command-line tools Updating Live Activities with ActivityKit push notifications 运行成功后控制台显示“HTTP/2 200”代表成功了! 更新视图: 作者:京东零售 姜海 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

从一些常见的错误聊聊mysql服务端的关键配置 | 京东云技术团队

背景 每一年都进行大促前压测,每一次都需要再次关注到一些基础资源的使用问题,订单中心这边数据库比较多,最近频繁报数据库异常,所以对数据库一些配置问题也进行了研究,本文给出一些常见的数据库配置,说明这些配置对我们数据库使用的影响。目前,MySQL服务端配置对使用方来说是不可更改的,需要联系DBA进行操作。这些配置操作对我们来说是一个黑盒,但是了解核心配置可以帮助我们快速定位数据库问题原因。 问题汇总 问题一、too many connections 数据库服务端配置:max_connections 这个问题我们这边线上遇到过,对于同一个数据库,有多个系统都连接了数据库,导致连接数据库的机器比较多,在数据库qps比较大时,创建的连接数比较大,导致连接的总数超过了数据库服务端连接的限制阈值,从而报了这个错误。 举个栗子:如果max_connections设置为1000,我们这边有200台机器,每台机器最大连接数为20,在连接比较大时,可能大致连接的总数为200 * 20 = 4000 > 1000,超过数据库的限制。 下面让我们在本地演示一下这种错误: 首先查询当前服务端最大连接数: 如果这个参数太大,不好演示的话,可以通过如下参数,将这个数值改小些 下面通过客户端尝试连接数据库,可以看到,直接报错了 对于这种问题有两种解决办法: 第一种:联系DBA将max_connections设置的大一些,DBA之前反馈max_connections这个参数有自动增长的逻辑; 第二种方法:如果数据库操作qps并不是很大,可以将每台机器的数据库连接最大值设置小一些,如果设置了初始化连接大小,要考虑机器数的增长,随着机器数的增长,连接的总数肯定会递增的。 问题二、慢日志长时间执行导致服务不可用 数据库库服务端配置:max_execution_time 之前写了一篇文章聊了一下如何在客户端配置参数解决慢日志长时间执行问题,这个在本地验证是没有问题的,但是由于我们线上环境使用的是JED,JED的架构多了中间代理层,在客户端执行KILL QUERY CONNECTION_ID会提示失败,导致没法停止慢sql(这个好坑,据说JED后期会优化这个问题)。 既然目前客户端没法控制慢sql停止,从官网上看了一下mysql服务端的配置参数,发现有一个参数能够控制服务端主动超时停止sql,参数变量:max_execution_time,本地环境验证如下: 首先将sql执行超时时间设置为2s: 然后执行一个sleep函数,让执行时间达到10s,可以看出来执行直接中断了,因为超过了2s的最大超时时间: 问题三、服务端连接都断开了,但是客户端还用无效连接发送请求 数据库库服务端配置:wait_timeout 之前线上用的是mysql,通过mysql驱动包直连数据库,数据库服务端默认连接空闲时间是8小时,后来响应公司号召,将传统的mysql切到了jed(底层也是mysql), jed由于网关层的存在,客户端是通过mysql驱动包跟网关层进行直连,网关这一层数据库空闲连接超时时间仅仅10分钟,当时在客户端进行空闲连接探活时间超过10分钟,导致数据库报错频繁。现在已经找不到历史的数据库异常日志了,本地模拟了一下,验证如下: 先将本地空闲连接超时设置为10s 验证源码如下,让两条sql执行时间超过10s,可以发现第二次执行sql时执行报错了 所以,如果换了数据源,需要确认下服务端的空闲连接超时时间设置,免得配置的值和客户端检测空闲连接健康性检测间隔不匹配,出现意料不到的结果。 注:我们这边使用的是DBCP数据源连接池,配置如下: <bean id="abstractParallelProductWriteDataSource" class="org.apache.commons.dbcp.BasicDataSource" abstract="true" destroy-method="close" init-method="createDataSource"> <property name="driverClassName" value="com.mysql.jdbc.Driver" /> <property name="username" value="${db.online.write.username}" /> <property name="password" value="${db.online.write.password}" /> <property name="initialSize" value="3" /> <property name="minIdle" value="3" /><!--最小链接数 --> <property name="maxIdle" value="3" /><!--最大链接数 --> <property name="maxActive" value="8" /><!--最大活跃链接数 --> <property name="maxWait" value="200" /> <property name="validationQuery" value="select 1" /> <property name="testOnBorrow" value="false" /> <property name="removeAbandonedTimeout" value="10" /> <property name="removeAbandoned" value="true" /> <!-- 池中的连接空闲10分钟后被回收,默认值就是30分钟 --> <property name="minEvictableIdleTimeMillis" value="600000" /> <!-- 每5分钟运行一次空闲连接回收器 --> <property name="timeBetweenEvictionRunsMillis" value="300000" /> <!--指明连接是否被空闲连接回收器(如果有)进行检验.如果检测失败,则连接将被从池中去除 --> <property name="testWhileIdle" value="true"/> <!--在每次空闲连接回收器线程(如果有)运行时检查的连接数量,默认值是3 --> <property name="numTestsPerEvictionRun" value="5"/> </bean> timeBetweenEvictionRunsMillis这个参数配置的是检测空闲连接的间隔时间,如果服务端空闲连接10分钟就断开了,这个时间需要小于10分钟。minEvictableIdleTimeMillis这个时间是判断当前连接已经空闲了多久了,目前配置的是10分钟。 其他关键配置汇总 thread_handling 配置了服务端的线程处理模型,主要的值有no-threads、one-thread-per-connection、loaded-dynamically。其中no-threads表示同一时刻只能有一个连接被一个线程处理。one-thread-per-connection表示对于每一个连接请求都有一个线程来处理。loaded-dynamically是mysql的线程池模式,目前默认的是one-thread-per-connection,所以连接太多的话,也会导致创建的线程快速增加,消耗系统的资源。 slow_query_log 用来控制是否打印慢日志,如果需要分析系统性能情况,可以打开这个开关,进行慢日志分析。 profiling 是否启用sql查询性能分析,类似于debug日志,线上环境需要关闭,比较耗性能,这个参数后面mysql版本会废弃掉,现在还是可以先使用着,新的使用方式可以参考:https://dev.mysql.com/doc/refman/8.0/en/performance-schema-query-profiling.html。 由于这个参数线上是关闭着,只能让DBA临时帮忙查询下分析结果,平常也没咋用,感觉还是一个不错的工具,分析结果类似下面截图: 总结 mysql服务端配置太多,目前工作中主要接触了上述这些配置,感觉还不错的,在平常分析数据库问题上能够给予一定的帮助,大家也可以去多了解一下,更多的配置可以参考官方文档:mysql服务端配置官网 作者:京东零售 姜昌伟 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

spring多数据源动态切换的实现原理及读写分离的应用 | 京东云技术团队

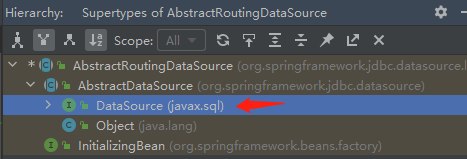
简介 AbstractRoutingDataSource是Spring框架中的一个抽象类,可以实现多数据源的动态切换和路由,以满足复杂的业务需求和提高系统的性能、可扩展性、灵活性。 应用场景 多租户支持:对于多租户的应用,根据当前租户来选择其对应的数据源,实现租户级别的隔离和数据存储。 分库分表:为了提高性能和扩展性,将数据分散到多个数据库或表中,根据分片规则来选择正确的数据源,实现分库分表。 读写分离:为了提高数据库的读写性能,可能会采用读写分离的方式,根据读写操作的类型来选择合适的数据源,实现读写分离。 数据源负载均衡:根据负载均衡策略来选择合适的数据源,将请求均匀地分配到不同的数据源上,提高系统的整体性能和可伸缩性。 多数据库支持:在一些场景下,可能需要同时连接多个不同类型的数据库,如关系型数据库、NoSQL数据库等。根据业务需求选择不同类型的数据源,实现对多数据库的支持。 实现原理 1.AbstractRoutingDataSource实现了DataSource接口,作为一个数据源的封装类,负责路由数据库请求到不同的目标数据源 2.该类中定义了一个determineTargetDataSource方法,会获取当前的目标数据源标识符,进而返回真正的数据源; 值得注意的是:其中determineCurrentLookupKey为抽象方法,明显是要让用户自定义实现获取数据源标识的业务逻辑。 3.当系统执行数据库操作之前,会先获取数据源链接,即调用getConnection方法,该类重写的getConnection方法,会获取到真正的目标数据源,进而将数据库操作委托给目标数据源进行处理。 读写分离实现V1版 yml中配置主从数据库连接信息 spring: datasource: business-master: url: jdbc:mysql://ip1:3306/xxx username: c_username password: p1 business-slaver: url: jdbc:mysql://ip2:3306/xxx username: c_username password: p2 2.读取yml中的主从数据源配置 @Data @ConfigurationProperties(prefix = "spring.datasource") @Component public class DataSourcePropertiesConfig { /** * 主库配置 */ DruidDataSource businessMaster; /** * 从库配置 */ DruidDataSource businessSlaver; } 3.自定义动态数据源类DynamicRoutingDataSource,继承AbstractRoutingDataSource类,并重写determineCurrentLookupKey方法,定义获取目标数据源标识的逻辑。 此处的逻辑为:定义一个DataSourceHolder类,将数据源标识放到ThreadLocal中,当需要时从ThreadLocal中获取。 public class DynamicRoutingDataSource extends AbstractRoutingDataSource { /** * 获取目标数据源标识 */ @Override protected Object determineCurrentLookupKey() { return DataSourceHolder.getDbName(); } } public class DataSourceHolder { /** * 当前线程使用的 数据源名称 */ private static final ThreadLocal<String> THREAD_LOCAL_DB_NAME = new ThreadLocal<>(); /** * 设置数据源名称 */ public static void setDbName(String dbName) { THREAD_LOCAL_DB_NAME.set(dbName); } /** * 获取数据源名称,为空的话默认切主库 */ public static String getDbName() { String dbName = THREAD_LOCAL_DB_NAME.get(); if (StringUtils.isBlank(dbName)) { dbName = DbNameConstant.MASTER; } return dbName; } /** * 清除当前数据源名称 */ public static void clearDb() { THREAD_LOCAL_DB_NAME.remove(); } } 4.创建动态数据源DynamicRoutingDataSource对象,并注入到容器中。这里创建了主从两个数据源,并进行了初始化,分别为其设置了数据源标识并放到了DynamicRoutingDataSource对象中,以便后面使用。 若为多个数据源,可参考此处进行批量定义。 @Configuration public class DataSourceConfig { @Autowired private DataSourcePropertiesConfig dataSourcePropertiesConfig; /** * 主库数据源 */ public DataSource masterDataSource() throws SQLException { DruidDataSource businessDataSource = dataSourcePropertiesConfig.getBusinessMaster(); businessDataSource.init(); return businessDataSource; } /** * 从库数据源 */ public DataSource slaverDataSource() throws SQLException { DruidDataSource businessDataSource = dataSourcePropertiesConfig.getBusinessSlaver(); businessDataSource.init(); return businessDataSource; } /** * 动态数据源 */ @Bean public DynamicRoutingDataSource dynamicRoutingDataSource() throws SQLException { DynamicRoutingDataSource dynamicRoutingDataSource = new DynamicRoutingDataSource(); Map<Object, Object> targetDataSources = new HashMap<>(2); targetDataSources.put("master", masterDataSource()); targetDataSources.put("slaver", slaverDataSource()); dynamicRoutingDataSource.setDefaultTargetDataSource(masterDS); dynamicRoutingDataSource.setTargetDataSources(targetDataSources); dynamicRoutingDataSource.afterPropertiesSet(); return dynamicRoutingDataSource; } } 5.自定义一个注解,指定数据库。 可以将一些常用的查询接口自动路由到读库,以减轻主库压力。 @Documented @Inherited @Target({ElementType.METHOD}) @Retention(RetentionPolicy.RUNTIME) public @interface DataSourceSwitch { /** * 数据源名称,默认主库 */ String dbName() default "master"; } 6.定义一个切面,拦截所有Controller接口,使用DataSourceSwitchRead注解的方法,将统一路由到读库查询 @Aspect @Component @Slf4j public class DataSourceAspect { /** * 切库,若为多个从库,可在这里添加负载均衡策略 */ @Before(value = "execution ( * com.jd.gyh.controller.*.*(..))") public void changeDb(JoinPoint joinPoint) { Method m = ((MethodSignature) joinPoint.getSignature()).getMethod(); DataSourceSwitch dataSourceSwitch = m.getAnnotation(DataSourceSwitch.class); if (dataSourceSwitch == null) { DataSourceHolder.setDbName(DbNameConstant.MASTER); log.info("switch db dbName = master"); } else { String dbName = dataSourceSwitch.dbName(); log.info("switch db dbName = {}", dbName); DataSourceHolder.setDbName(dbName); } } } 作者:京东科技 郭艳红 来源:京东云开发者社区

优秀的个人博客,低调大师

源码解析Collections.sort ——从一个逃过单测的 bug 说起 | 京东云技术团队

本文从一个小明写的bug 开始,讲bug的发现、排查定位,并由此展开对涉及的算法进行图解分析和源码分析。 事情挺曲折的,因为小明的代码是有单测的,让小明更加笃定自己写的没问题。所以在排查的时候,也经历了前世的500年,去排查排序后的list改动(主要是小明和同事互相怀疑对方的代码,不多说了)。 本文从问题定位之后开始讲: 前言 小明写了一个自定义排序的代码,简化后如下。聪明的你快来帮小明review一下吧。 代码 背景:有一批休息室,status是状态,其中1表示空闲,8表示使用中,2表示在维修。需要按照1空闲<8使用中<2在维修的顺序进行排序。 例如:输入:[1,8, 2, 2, 8, 1, 8],期望输出:[1, 1, 8, 8, 8, 2, 2]。list不为空,数量小于100。 环境:JDK 8 小明的代码如下: /** * 排序 */ private static int compare(Integer status1, Integer status2) { // 1<8<2 ,按照这样的规则排序 if (status2 != null && status1 != null) { // 2-维修中, 维修中排到最后面 if (status2.equals(2)) { return -1; } else { // 8-使用中, 排在倒数第二,仅在维修中之前 if (status2.equals(8) && !status1.equals(2)) { return -1; } } } return 0; } //Test public static void main(String[] args) { List<Integer> list = Lists.newArrayList(1, 8, 2, 2, 8, 1, 8); System.out.println("排序前:"+list); list.sort(Test::compare); System.out.println("排序后:"+list); } 看上面的代码有问题么?别急,咱们先给个入参试一下。 测试 [ 1, 8, 2, 2, 8, 1, 8 ] public static void main(String[] args) { List<Integer> list = Lists.newArrayList(1, 8, 2, 2, 8, 1, 8); System.out.println("排序前:"+list); list.sort(Test::compare); System.out.println("排序后:"+list); } 输出: 排序前:[1, 8, 2, 2, 8, 1, 8] 排序后:[1, 1, 8, 8, 8, 2, 2] 结论:结果是对的,符合预期 。 ( 按照1空闲<8使用中<2维修中的顺序进行排序) 。 嗯,看起来排序是对的。但确实是有问题呢? (小明OS :哪里有问题?不可能有问题!我本地是好的!) 那我们看看情景复现👉🏻 情景复现 那有什么问题呢?我们再给几个入参试一下 。 case1 : 随机入参 [2, 8, 1, 2, 8, 8, 8, 2, 1] 输出: 排序前:[2, 8, 1, 2, 8, 8, 8, 2, 1] 排序后:[1, 1, 8, 8, 8, 8, 2, 2, 2] 期望是:[1, 1, 8, 8, 8, 8, 2, 2, 2] 结论:结果对,符合预期 ✅。 case2 : 多增加一些数 [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 2, 2, 2, 2, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 8, 2, 2] 输出: 排序前:[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 2, 2, 2, 2, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 8, 2, 2] 排序后:[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 2, 2, 2, 2, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 8, 2, 2] 期望是:[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 8, 2, 2, 2, 2, 2, 2, 2] 结论:结果不对了,不符合预期 ❌。 case3 : 换几个数 [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 8, 8, 8, 8, 8, 2, 2, 2, 2, 2, 8, 8, 8, 8, 2, 2] 输出: 排序前:[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 8, 8, 8, 8, 8, 2, 2, 2, 2, 2, 8, 8, 8, 8, 2, 2] 排序后:[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 8, 8, 8, 8, 8, 8, 8, 8, 8, 2, 2, 2, 2, 2, 2, 2] 期望是:[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 8, 8, 8, 8, 8, 8, 8, 8, 8, 2, 2, 2, 2, 2, 2, 2] 结论:结果又对了?? 这是什么情况?! 小明有些慌了,越想越觉得奇怪,目前看起来有这样几个看起来些许离谱的结论: 1、可能是和数据量有关系(因为用32位以下的数据,多次Test 也没发现问题), 2、一定和数据数值有关系。(32位以上,有的数据样本没问题,有的有问题)。 3、有问题都在中间部分,而两边是有序的,猜测像排序归并导致的问题。 定位 想查这个问题,小明有三个思路。 一是:代码的逻辑比较,是有一些不完整的。那可以先试着改改代码,通过这几个失败用例,然后在找深层原因。 二是:查查用的排序类,有没有坑。用法有没有特殊注意的,有没有类似的案例。 三是:从源码上,理清排序底层的逻辑,找到哪一个环节排序出了问题。 顺着这三个思路,小明发现写的代码里缺少返回为1的场景。虽然小明不知道有没有影响,但是试了试,发现好使。。但为啥呢? private static int compare(Integer status1, Integer status2) { // 1<8<2 ,按照这样的规则排序 if (status2 != null && status1 != null) { // 2-维修中, 维修中排到最后面 if (status2.equals(2)) { return -1; } else { // 8-使用中, 排在倒数第二,仅在维修中之前 if (status2.equals(8) && !status1.equals(2)) { return -1; }else{ return 1; } } } return 0; } } 然后小明看 Collections.sort 的坑,没有看到和这个相关的。 接下来,还是要来调试代码。最终定位是因为原来的compare 自定义代码里,对 compaer(2,1) 这种应该返回1的情况 ,默认返回了0。导致在底层两组数据归并排序过程,误以为1和2相等了。 [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 2, 2, 2, 2, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 8, 2, 2] 见Debug部分:(具体分析内容在后边源码部分) 解决方案 发现问题,就好解决了。方案是,要么补充完善逻辑,要么换用一种权重映射的排序方式。 1 优化代码 /** * 按照1<8<2排序 **/ private static int compare(Integer status1, Integer status2) { // 2大于8 大于1 ,按照这样的规则排序 if (status2 != null && status1 != null) { // 2-维修中, 维修中排到最后面 if (status2.equals(2)) { return -1; } else { // 8-使用中, 排在倒数第二,仅在维修中之前 if (status2.equals(8) && !status1.equals(2)) { return -1; }else{ return 1; } } } return 0; } 2 改为权重等方式排序 当然,还有对于一些容易理解出错的排序,也可以通过设置权重映射的方式进行排序。 **小明忽然想起来,无论底层排序算法是什么, 排序逻辑还是要完整。这一点也开发规约也是有的呀。**👉🏻 【注意】在JDK7版本及以上,为了让Arrays.sort、Collections.sort正常工作,Comparator必须满足以下三个条件,否则会抛出IllegalArgumentException异常。 1)比较x和y的结果应该与比较y和x的结果相反。 2)如果x>y,y>z,则x>z。 3)如果x=y,则比较x和z的结果应该与比较y和z的结果相同。 好了问题解决了,那我们接下来慢慢聊聊这里Collections.sort 底层用的TimSort排序原理。以及为什么32位及以上才有问题,为什么正好是归并过程有问题 ? 源码解读 JAVA 7 中集合类中的sort 开始,默认用TimSort排序方法 。Tim Sort,里的Tim 也没什么特别的含义。Tim是这个算法的创始人Tim Peters 的名字。该算法首先在Python中应用,之后在 java 中应用。 TimSort :一种稳定的、自适应的、迭代的归并排序,在部分排序数组上运行时需要的比较远远少于nlg (n)次,而在随机数组上运行时提供与传统归并排序相当的性能。像所有合适的归并排序一样,这种排序是稳定的,运行时间为O(n log n)(最坏情况)。在最坏的情况下,这种排序需要n/2个对象引用的临时存储空间;在最好的情况下,它只需要少量的常量空间。这个实现改编自Tim Peters的Python列表排序 图解 TimSort 排序原理 如果数组的长度小于32,直接采用二分法插入排序。(略) 如果数组的长度大于32,找到单调上升段(或下降段,进行反转),然后基于这个单调片段,通过插入排序的方式进行合并。如此反复归并相邻片段。 到这一步的时候,小明恍然大悟,怪不得32位数以下,没有出现过问题呢。 这个算法里有一个重要的概念,也可以理解为分段( 算法里 run )。每个分段都是连续上升或下降的子串 然后对下降的分段进行反转,使其变为一个递增的子串。这样就可以得到若干的分段,使得每个分段都单调递增,后续就可以对这些分段进行合并。 👉🏻 当然算法里会计算出一个最小的分段长度(Java里16-32之间),来控制分段的数量以保证效率。对那些不满足最小长度的分区,会采用二分插入的方法,使其满足最的长度。比如我们假设最小的长度是3,那此时由于第二段36 不符合最小长度3,会利用二分插入法,将8插入到第二段。即 368 就是第二段了。 分段划分之后,下一步就是如何进行合并。 合并时,会将分区进行压栈,并判断是否需要和之前的分段做合并。当然还有一些更详细的优化点,具体可看下文源码部分。重点说一下,两个分段如何进行合并。 假设以下内容: 第一个段包含元素:[1, 2, 3, 5, 6, 8, 9] 第二个段包含元素:[4, 6, 7, 8, 10, 11, 12] 第一个段在数组中出现在第二个段之前。请注意,实际段落长度不会这么短。如前所述,段落长度应介于16到32之间。此处只是提供示例以说明问题。 gallopRight():查找第二个段的第一个元素在第一个段中的位置。例如,在此示例中,位置为2。这意味着前两个元素不需要参与合并,它们的位置不需要改变。 gallopLeft():查找第一个段的最后一个元素在第二个段中的位置。在此处,发现第二个段中的第四个元素为10。因此,第二个段中的10、11、12不需要参与合并,它们的位置也不需要改变。 最终参与合并的段为: 第一段:[5,6,8,9] 第二段:[4, 6, 7, 8] 这样参与合并的段的长度就大大减小了。 这里就是我们上边问题出现的地方。在gallopLeft 方法里, [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 2, 2, 2,2] [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 8, 2, 2] 查找第一个段的最后一个元素【2】在第二个段中的位置时,比较【2】和【1】时,得出了相等的结果。这有什么影响呢?因为数组分段是单调递增的,也就是说第一组里最后一个(最大的)数据2,和第二组里第一个(最小的)数据1 相等。那也就是说,第一个数组直接在第二个数组之前。即: [**1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 2, 2, 2, 2,**1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 8, 2, 2] 源码解读:Collections.sort 排序原理 入口 list.sort(Test::compare); 进入list sort public void sort(Comparator<? super E> c) { final int expectedModCount = modCount; // 当前 modCount 的值 Arrays.sort((E[]) elementData, 0, size, c); // 使用 Arrays.sort 对 elementData 数组进行排序 if (modCount != expectedModCount) { // 检查排序过程中是否发生了并发修改 throw new ConcurrentModificationException(); } modCount++; // 增加 modCount 的值,表示进行了一次修改 } Arrays.sort() 进入Arrays.sort()方法 public static <T> void sort(T[] a, int fromIndex, int toIndex, Comparator<? super T> c) { if (c == null) { sort(a, fromIndex, toIndex); // 如果比较器为 null,调用默认的排序方法 } else { rangeCheck(a.length, fromIndex, toIndex); // 检查 fromIndex 和 toIndex 的范围是否合法 if (LegacyMergeSort.userRequested) legacyMergeSort(a, fromIndex, toIndex, c); // 如果指定使用传统的归并排序,则调用该方法 else TimSort.sort(a, fromIndex, toIndex, c, null, 0, 0); // 否则,调用 TimSort 进行排序 } } TimSort.sort 我们重点看 TimSort.sort /** * Sorts the given range, using the given workspace array slice * for temp storage when possible. This method is designed to be * invoked from public methods (in class Arrays) after performing * any necessary array bounds checks and expanding parameters into * the required forms. * * @param a the array to be sorted * @param lo the index of the first element, inclusive, to be sorted * @param hi the index of the last element, exclusive, to be sorted * @param c the comparator to use * @param work a workspace array (slice) * @param workBase origin of usable space in work array * @param workLen usable size of work array * @since 1.8 */ static <T> void sort(T[] a, int lo, int hi, Comparator<? super T> c, T[] work, int workBase, int workLen) { assert c != null && a != null && lo >= 0 && lo <= hi && hi <= a.length; int nRemaining = hi - lo; if (nRemaining < 2) return; // 数组长度为 0 或 1 时,无需排序 // 如果数组长度较小,执行“迷你的 TimSort”而不进行合并操作 if (nRemaining < MIN_MERGE) { int initRunLen = countRunAndMakeAscending(a, lo, hi, c); binarySort(a, lo, hi, lo + initRunLen, c); return; } /** * 从左到右遍历数组一次,找到自然的 run, * 将短的自然 run 扩展到 minRun 的长度,并合并 run 以保持栈的不变性。 */ TimSort<T> ts = new TimSort<>(a, c, work, workBase, workLen); int minRun = minRunLength(nRemaining); do { // 确定下一个 run int runLen = countRunAndMakeAscending(a, lo, hi, c); // 如果 run 很短,则扩展到 min(minRun, nRemaining) 的长度 if (runLen < minRun) { int force = nRemaining <= minRun ? nRemaining : minRun; binarySort(a, lo, lo + force, lo + runLen, c); runLen = force; } // 将 run 推入待处理 run 栈,并可能进行合并 ts.pushRun(lo, runLen); ts.mergeCollapse(); // 前进以找到下一个 run lo += runLen; nRemaining -= runLen; } while (nRemaining != 0); // 合并所有剩余的 run 以完成排序 assert lo == hi; ts.mergeForceCollapse(); assert ts.stackSize == 1; } countRunAndMakeAscending : 找到数组中的一段有序数字 countRunAndMakeAscending:方法的主要作用就是找到数组中的一段有序数字,并告诉我们它们的长度。如果这段数字是倒序的,它还会将它们反转成正序。 private static <T> int countRunAndMakeAscending(T[] a, int lo, int hi, Comparator<? super T> c) { assert lo < hi; int runHi = lo + 1; if (runHi == hi) return 1; // 找到 run 的结束位置,并在降序情况下反转范围 if (c.compare(a[runHi++], a[lo]) < 0) { // 降序 while (runHi < hi && c.compare(a[runHi], a[runHi - 1]) < 0) runHi++; reverseRange(a, lo, runHi); } else { // 升序 while (runHi < hi && c.compare(a[runHi], a[runHi - 1]) >= 0) runHi++; } return runHi - lo; } mergeCollapse : 将连续的有序小段合并成更大的有序段 mergeCollapse的主要作用就是在排序过程中,将连续的有序小段合并成更大的有序段,以便更高效地进行排序。 /** * Examines the stack of runs waiting to be merged and merges adjacent runs * until the stack invariants are reestablished: * 检查等待合并的运行堆栈,并合并相邻的运行,直到满足堆栈条件: * 1. runLen[i - 3] > runLen[i - 2] + runLen[i - 1] * 2. runLen[i - 2] > runLen[i - 1] * * This method is called each time a new run is pushed onto the stack, * so the invariants are guaranteed to hold for i < stackSize upon * entry to the method. * 每次将新的运行推入堆栈时,都会调用此方法,因此在进入方法时,对于 i < stackSize,满足堆栈条件。 */ private void mergeCollapse() { while (stackSize > 1) { int n = stackSize - 2; if (n > 0 && runLen[n-1] <= runLen[n] + runLen[n+1]) { if (runLen[n - 1] < runLen[n + 1]) n--; // 在位置 n 处合并相邻的运行 mergeAt(n); } else if (runLen[n] <= runLen[n + 1]) { // 在位置 n 处合并相邻的运行 mergeAt(n); } else { // 堆栈条件已满足,退出循环 break; } } } mergeAt(n) : 把两个有序的小段合并成一个更大的有序段 mergeAt(n):它帮助我们把两个有序的小段合并成一个更大的有序段,以便在排序过程中保持正确的顺序。 /** * Merges the two runs at stack indices i and i+1. Run i must be * the penultimate or antepenultimate run on the stack. In other words, * i must be equal to stackSize-2 or stackSize-3. * * @param i stack index of the first of the two runs to merge */ private void mergeAt(int i) { assert stackSize >= 2; assert i >= 0; assert i == stackSize - 2 || i == stackSize - 3; int base1 = runBase[i]; int len1 = runLen[i]; int base2 = runBase[i + 1]; int len2 = runLen[i + 1]; assert len1 > 0 && len2 > 0; assert base1 + len1 == base2; // 记录合并后的 run 长度;如果 i 是倒数第三个 run,也要滑动最后一个 run(不参与本次合并) runLen[i] = len1 + len2; if (i == stackSize - 3) { runBase[i + 1] = runBase[i + 2]; runLen[i + 1] = runLen[i + 2]; } stackSize--; // 找到 run2 中第一个元素在 run1 中的插入位置 int k = gallopRight(a[base2], a, base1, len1, 0, c); assert k >= 0; base1 += k; len1 -= k; if (len1 == 0) return; // 找到 run1 中最后一个元素在 run2 中的插入位置 len2 = gallopLeft(a[base1 + len1 - 1], a, base2, len2, len2 - 1, c); assert len2 >= 0; if (len2 == 0) return; // 使用临时数组(长度为 min(len1, len2))合并剩余的 run if (len1 <= len2) mergeLo(base1, len1, base2, len2); else mergeHi(base1, len1, base2, len2); } gallopRigth && gallopLeft :在有序数组中快速查找目标元素的可能位置,便于合并 其中两个主要的方法就是gallopRigth()和gallopLeft() 。这里就是上面所说的 找元素的部分。 主要作用就是在有序数组中快速查找目标元素的可能位置,它采用一种跳跃式的查找策略,通过快速定位可能的位置,提高查找速度。 也就是上文中这一部分: 假设以下内容: 第一个段包含元素:[1,2,3,5,6,8,9] 第二个段包含元素:[4,6,7,8,10,11,12] 第一个段在数组中出现在第二个段之前。请注意,实际段落长度不会这么短。如前所述,段落长度应介于16到32之间。此处只是提供示例以说明问题。 gallopRight():查找第二个段的第一个元素在第一个段中的位置。例如,在此示例中,位置为2。这意味着前两个元素不需要参与合并,它们的位置不需要改变。 gallopLeft():查找第一个段的最后一个元素在第二个段中的位置。在此处,发现第二个段中的第四个元素为10。因此,第二个段中的10、11、12不需要参与合并,它们的位置也不需要改变。 这样参与合并的段的长度就大大减小,时间相应的就变短了(算法的优化点之一)。gallopLeft 代码如下: **gallopLeft**方法用于在有序数组的指定范围内进行快速查找,定位将指定键插入的位置或最左边相等元素的索引。它使用跳跃式的查找策略,根据键与范围内元素的比较结果,通过不断调整步长进行左跳或右跳,直到找到合适的插入位置。最后,使用二分查找在找到的范围内确定确切的插入位置,并返回结果。这个方法的目标是提高查找效率。 /** * Locates the position at which to insert the specified key into the * specified sorted range; if the range contains an element equal to key, * returns the index of the leftmost equal element. * * @param key 要搜索插入位置的键 * @param a 要搜索的数组 * @param base 范围内第一个元素的索引 * @param len 范围的长度;必须大于 0 * @param hint 开始搜索的索引,0 <= hint < n。hint 越接近结果,该方法的执行速度越快。 * @param c 用于对范围进行排序和搜索的比较器 * @return 整数 k,0 <= k <= n,满足 a[b + k - 1] < key <= a[b + k], * 假设 a[b - 1] 是负无穷大,a[b + n] 是正无穷大。 * 换句话说,键属于索引 b + k 处;或者换句话说, * 数组 a 的前 k 个元素应该在键之前,后面的 n - k 个元素应该在键之后。 */ private static <T> int gallopLeft(T key, T[] a, int base, int len, int hint, Comparator<? super T> c) { assert len > 0 && hint >= 0 && hint < len; int lastOfs = 0; int ofs = 1; if (c.compare(key, a[base + hint]) > 0) { // 向右跳跃,直到 a[base+hint+lastOfs] < key <= a[base+hint+ofs] int maxOfs = len - hint; while (ofs < maxOfs && c.compare(key, a[base + hint + ofs]) > 0) { lastOfs = ofs; ofs = (ofs << 1) + 1; if (ofs <= 0) // 检查 int 溢出 ofs = maxOfs; } if (ofs > maxOfs) ofs = maxOfs; // 将偏移量相对于基准位置进行调整 lastOfs += hint; ofs += hint; } else { // key <= a[base + hint] // 向左跳跃,直到 a[base+hint-ofs] < key <= a[base+hint-lastOfs] final int maxOfs = hint + 1; while (ofs < maxOfs && c.compare(key, a[base + hint - ofs]) <= 0) { lastOfs = ofs; ofs = (ofs << 1) + 1; if (ofs <= 0) // 检查 int 溢出 ofs = maxOfs; } if (ofs > maxOfs) ofs = maxOfs; // 将偏移量相对于基准位置进行调整 int tmp = lastOfs; lastOfs = hint - ofs; ofs = hint - tmp; } assert -1 <= lastOfs && lastOfs < ofs && ofs <= len; /* * 现在 a[base+lastOfs] < key <= a[base+ofs], * 因此键位于 lastOfs 的右侧,但不超过 ofs 的位置。 * 使用二分查找,在不变式 a[base + lastOfs - 1] < key <= a[base + ofs] 的条件下进行。 */ lastOfs++; while (lastOfs < ofs) { int m = lastOfs + ((ofs - lastOfs) >>> 1); if (c.compare(key, a[base + m]) > 0) lastOfs = m + 1; // a[base + m] < key else ofs = m; // key <= a[base + m] } assert lastOfs == ofs; // 所以 a[base + ofs - 1] < key <= a[base + ofs] return ofs; } TimSort 算法的优缺点 优点 稳定性:TimSort 是一种稳定的排序算法,即相等元素的相对顺序在排序后保持不变。 高效的处理小规模或部分有序数组:TimSort 在处理小规模数组时具有良好的性能,可以利用插入排序的优势。此外,对于部分有序的数组,TimSort 也能快速识别并进行优化处理。 最坏情况下的时间复杂度是 O(n log n):在最坏情况下,TimSort 的时间复杂度与其他基于比较的排序算法(如快速排序和归并排序)相同,都是 O(n log n)。 适用于大多数实际数据:TimSort 是一种自适应的排序算法,它能够根据输入数据的特性进行优化,适应不同的数据分布和大小。 缺点 需要额外的空间:TimSort 在合并阶段需要额外的辅助空间,用于暂存部分数组。这可能导致空间复杂度较高,特别是对于大规模数据排序时。 对于某些特殊情况效率较低:在处理某些特殊情况下,例如完全逆序的数组。 最后: 通过查看 TimSort 的源码,可以深入了解该算法的工作原理、核心步骤和关键逻辑。这有助于我们对排查问题时快速定位问题,也有助于对算法的理解和知识的扩展。 另外 TimSort 是一种经过优化的排序算法,它采用了多种技巧来提高性能和效率。通过研究源码,我们可以学习到一些优化技巧,例如插入、二分查找的优化、自适应调整等。这些技巧或许可以用在我们日后的开发场景中。当然,最重要的还是去逐渐体会、借鉴其实现方式和设计优化思想。 最后的最后,谢谢小明。 小明: 参考: 排序算法——Timsort java8中List中sort方法解析 作者:京东零售马丹妹 来源:京东云开发者社区
优秀的个人博客,低调大师

一份保姆级的Stable Diffusion部署教程,开启你的炼丹之路 | 京东云技术团队

市面上有很多可以被用于AI绘画的应用,例如DALL-E、Midjourney、NovelAI等,他们的大部分都依托云端服务器运行,一部分还需要支付会员费用来购买更多出图的额度。在2022年8月,一款叫做Stable Diffusion的应用,通过算法迭代将AI绘画的精细度提上了一个新的台阶,并能在以秒计数的时间内完成产出,还可以在一台有“民用级”显卡的电脑上运行。 通过Stable Diffusion,可以绘制出各种风格的作品,比如动漫风、插画立绘、国风水墨、3D建模,甚至是照片级的拟真图像,而借助诸如LoRa、ControlNet等衍生功能,还可以做到精准控制美术风格、角色细节、姿势、动作、构图等。更更重要的是,他是全面开源的,这意味着你可以在自己的电脑上部署整个程序,使用它出图、作画是完全免费而且不限量的!市面上大多数商业级的AI绘画应用,都是基于SD去开发的。 尽管Stable Diffusion非常亲民,但他还是有一定的配置要求的,它需要一张性能足够强大的独立显卡提供算力进行绘制。实际上,“跑得动”和“玩得爽”是两种不同的体验,算力上的差异会极大的影响AI绘画时的出图效率,也正是因为此,有很多同学因为个人电脑捉急的配置而错失了深入体验Stable Diffusion的机会。等一下,你知道京东云吗?京东云GPU云主机是提供GPU算力的弹性计算服务,具有超强的并行计算能力,正在深度学习、科学计算、图形图像处理、视频编解码等场景广泛使用,为您提供触手可得的算力,有效缓解计算压力,提升您的业务效率,并可弹性扩展,助您快速构建异构的计算应用。 在经历了一系列的探索后,我为你总结出了一套零基础的、非常好上手的借助京东云GPU云主机部署安装Stable Diffusion WebUI以及相关工具和插件的保姆集教程,请查收。 一、创建GPU主机实例 1.1 创建GPU云主机 京东云GPU云主机的标准型的配置包含Tesla P40 24G显卡、12核48G,跑Stable Diffusion体验非常好,配置推荐如下: 配置 推荐 说明 系统 Ubuntu 20.04 64位 规格 GPU 标准型 p.n - p.n1p40.3xlarge 12核 48G Nvidia Tesla P40 24G显存 系统盘 100G 系统盘建议100G 带宽 5M 建议5M 1.2 创建安全组并绑定 首先在左侧菜单【安全组】创建一个安全组,在【入站规则】和【出站规则】中分别添加并开放7860、7861、8080、8888端口。其中 然后在实例详情中,点击【安全组】-【绑定安全组】绑定刚刚创建的安全组。 二、环境安装 2.1 安装GPU驱动 在英伟达官网根据显卡型号、操作系统、CUDA等查询驱动版本。官网查询链接https://www.nvidia.com/Download/index.aspx?lang=en-us 注意这里的CUDA版本,如未安装CUDA可以先选择一个版本,稍后再安装CUDA. 点击Search 如上图,查询到合适的版本为510. 然后可以使用apt安装对应驱动版本,使用apt安装更方便一些。 # 安装510版本驱动 apt install nvidia-driver-510 # 查看驱动信息 nvidia-smi 如安装成功,则可以展示如下提示信息。 2.2 安装CUDA 访问英伟达开发者网站先选择CUDA版本(版本要对应2.1中GPU驱动支持的CUDA版本),再根据操作系统选择对应CUDA安装命令,访问链接https://developer.nvidia.com/cuda-toolkit-archive 如上面安装确定所选择驱动对应的CUDA版本为11.6,根据安装命令安装, 以下命令适用Ubuntu 20.04 x86_64, GPU驱动510版本 wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2004/x86_64/cuda-ubuntu2004.pin sudo mv cuda-ubuntu2004.pin /etc/apt/preferences.d/cuda-repository-pin-600 wget https://developer.download.nvidia.com/compute/cuda/11.6.2/local_installers/cuda-repo-ubuntu2004-11-6-local_11.6.2-510.47.03-1_amd64.deb sudo dpkg -i cuda-repo-ubuntu2004-11-6-local_11.6.2-510.47.03-1_amd64.deb sudo apt-key add /var/cuda-repo-ubuntu2004-11-6-local/7fa2af80.pub sudo apt-get update sudo apt-get -y install cuda 2.3 安装Python 3.10 Stable Diffusion WebUI目前最低支持Python 3.10,所以直接安装3.10版本,安装命令: apt install software-properties-common add-apt-repository ppa:deadsnakes/ppa apt update apt install python3.10 python3.10 --verison PIP设置国内源,由于默认源在国外,所以安装可能经常会出现timeout等问题,使用国内源可以很大程度避免下载包timeout的情况。将如下内容复制到文件~/.pip/pip.conf当中,如没有该文件,先创建touch ~/.pip/pip.conf。 [global] index-url = https://pypi.tuna.tsinghua.edu.cn/simple [install] trusted-host = https://pypi.tuna.tsinghua.edu.cn 2.4 安装Anaconda 非常推荐使用Anaconda。Anaconda可以便捷获取包且对包能够进行管理,同时对Python环境可以统一管理的发行版本。安装命令也很简单: wget https://repo.anaconda.com/archive/Anaconda3-2023.03-1-Linux-x86_64.sh bash ./Anaconda3-2023.03-1-Linux-x86_64.sh 创建Python3.10.9环境,并使用该环境 conda create -n python3.10.9 python==3.10.9 conda activate python3.10.9 2.5 安装PyTorch 首先在PyTorch官网查询对应CUDA版本的Torch,如上述章节2.2中CUDA 11.6需要安装pytorch1.13.1 # 使用conda安装,两种安装方式二选一 conda install pytorch==1.13.1 torchvision==0.14.1 torchaudio==0.13.1 pytorch-cuda=11.6 -c pytorch -c nvidia # 使用pip安装,两种安装方式二选一 pip install torch==1.13.1+cu116 torchvision==0.14.1+cu116 torchaudio==0.13.1 --extra-index-url https://download.pytorch.org/whl/cu116 三、部署Stable Diffusion WebUI 3.1 下载stable-diffusion-webui 注意首先激活Python3.10环境: conda activate python3.10.9 然后下载stable-diffusion-webui git clone https://github.com/AUTOMATIC1111/stable-diffusion-webui.git 3.2 安装依赖 cd到stable-diffusion-webui目录安装相应的依赖,如有访问网络超时、失败等,注意按照章节2.3中设置国内源,如果再次失败,重试几次一般都可完成安装。 cd stable-diffusion-webui pip install -r requirements_versions.txt pip install -r requirements.txt 3.3 启动stable-diffusion-webui 安装完成后,执行如下启动命令: python launch.py --listen --enable-insecure-extension-access 这一步骤会下载一些常用模型,如果遇到下载失败,根据报错提示在huggingface.co下载模型放到对应目录,如下载stable-diffusion-v1-5模型,搜索找到https://huggingface.co/runwayml/stable-diffusion-v1-5/tree/main 点击图中下载按钮,下载v1-5-pruned-emaonly.safetensors到stable-diffusion-webui/models/Stable-diffusion目录,其他模型同理。 模型下载完成,再次执行启动命令,提示已启动到7860端口,则可以通过IP+7860端口访问: 公网建议设置访问密码,注意替换下面命令当中的username:password为用户名、密码。 python launch.py --listen --enable-insecure-extension-access --gradio-auth username:password 上述命令非后台运行,如需后台运行可以使用nohup、tmux等方法实现。 3.4 使用stable-diffusions生成图片 下载一个模型到/stable-diffusion-webui/models/Stable-diffusion目录,模型可以在https://civitai.com/查找,如下图所用majicMIX realistic模型。下载完成后点击左上角刷新按钮,然后选择刚下载的模型,输入Promot和参数即可生成图片。 附上图所用Promot和参数 Prompt 1 girl a 24 y o woman, blonde, dark theme, soothing tones, muted colors, high contrast, look at at viewer, contrasty , vibrant , intense, stunning, captured in the late afternoon sunlight, using a Canon EOS R6 and a 16-35mm to capture every detail and angle, with emphasis on the lighting and shadows, late afternoon sunlight, 8K Negative prompt (deformed, distorted, disfigured, doll:1.3), poorly drawn, bad anatomy, wrong anatomy, extra limb, missing limb, floating limbs, (mutated hands and fingers:1.4), disconnected limbs, mutation, mutated, ugly, disgusting, blurry, amputation, 3d, illustration, cartoon, flat , dull , soft, (deformed, distorted, disfigured:1.3), poorly drawn, bad anatomy, wrong anatomy, extra limb, missing limb, floating limbs, 其他参数 四、常用相关工具与插件 4.1 安装LoRa插件Additional Networks 使用Lora必不可少的插件,Additional Networks可以用来控制checkpoint+LoRa或者多个LoRa模型生成混合风格的图像,并且可以设置Lora模型的Weight。安装方式如下: 打开stable-diffusion-webui,点击【Extensions】- 【Install from URL】输入https://ghproxy.com/https://github.com/kohya-ss/sd-webui-additional-networks.git 然后点击【Install】等待安装,直到在【Installed】中显示,然后直接用命令重启stable-diffusion-webui(不是reload webui),强烈推荐所有插件安装完成都命令重启stable-diffusion-webui,可以免去很多麻烦。 最后点击【Setting】-【Additional Networks】输入LoRa文件夹的绝对路径,如/root/stable-diffusion-webui/models/Lora(示例,请填写你的系统路径),然后【Reload UI】等待重启完成。 然后可以在【txt2img】或【img2img】中选择Lora模型并设置权重使用。 4.2 安装ControlNet 作为Stable Diffusion必装插件,ControlNet 允许用户对生成的图像进行精细的控制,以获得更好的视觉效果,ControlNet让AI绘画的可控性有了质的突变,让AGIC真正的可以投入生产使用。 打开stable-diffusion-webui,点击【Extensions】- 【Install from URL】输入https://ghproxy.com/https://github.com/Mikubill/sd-webui-controlnet.git 然后点击【Install】等待安装,直到在【Installed】中显示,然后直接用命令重启stable-diffusion-webui(不是reload webui)。 由于controlNet会使用很多模型,所以在重启的时候会默认下载,如果下载失败或超时,需要手动下载到controlnet目录。 访问huggingface.co找到controlnet的地址:https://huggingface.co/lllyasviel/ControlNet-v1-1/tree/main 手动下载上面模型文件到stable-diffusion-webui/extensions/sd-webui-controlnet/models目录,查看已下载controlnet模型: 下载完成,重启stable-diffusion-webui即可在【txt2img】或【img2img】使用。 4.3 Jupyter Notebook Jupyter Notebook是一个基于网页的交互环境,可以用来编辑、运行Python代码,可视化看到运行结果。同时提供了基础的文件树操作功能等。 如已在章节2.4中安装了Anaconda,直接使用以下命令运行notebook jupyter notebook --allow-root --NotebookApp.token='设置你的token' 访问IP+8888端口,可以开始使用notebook 4.4 模型训练工具Kohya_ss Kohya_ss是公认推荐训练Stable Diffusion模型的可视化工具,尤其在windows平台支持比较好,经过尝试在linux直接使用会遇到各种环境原因的问题,为了避免这些问题,十分推荐使用docker安装。 先按照docker官方文档安装好docker,Ubuntu安装docker文档:https://docs.docker.com/engine/install/ubuntu/ 由于在docker容器中需要使用GPU资源,所以还需要先安装NVIDIA Container Toolkit sudo apt-get update \ && sudo apt-get install -y nvidia-container-toolkit-base # 查看是否安装成功 nvidia-ctk --version 然后下载kohya_ss: git clone https://github.com/bmaltais/kohya_ss.git 如下图,修改kohya_ss/docker-compose.yaml文件端口为0.0.0.0:7861:7860(将kohya_ss的7860端口映射到宿主机的7861端口,因为7860会被Stable Diffusion WebUI占用), 启动参数设置为"--username xxxx --password xxxx --headless",注意替换xxxx为需要设置的账号密码 然后执行 docker compose build # 首次执行需要build docker compose run --service-ports kohya-ss-gui 过程中会从huggingface.co下载模型文件,如果下载失败,可以尝试手动下载到目录kohya_ss/.cache/user/huggingface/hub/models--openai--clip-vit-large-patch14/snapshots/8d052a0f05efbaefbc9e8786ba291cfdf93e5bff,最后的hash值注意改成对应的版本。 下载地址https://huggingface.co/openai/clip-vit-large-patch14/tree/main,注意下载全部文件 下载完成,然后访问端口+7861端口,可以开始使用Kohya_ss训练模型了。 五、总结 安装完Stable Diffusion及上面的推荐插件,你的Stable Diffuion已经具备强大的生产力。后续我会继续同大家一起探索和分享更多的使用经验,敬请期待系列文章下一集。 现在购买京东云GPU云主机新人即享99元7天的一折体验价(合0.59元/小时),即刻开启炼丹之旅。 作者:京东科技 王雷 来源:京东云开发者社区

优秀的个人博客,低调大师

Jmeter压测实战:Jmeter二次开发之自定义函数 | 京东云技术团队

1 前言 Jmeter是Apache基金会下的一款应用场景非常广的压力测试工具,具备轻量、高扩展性、分布式等特性。Jmeter已支持实现随机数、计数器、时间戳、大小写转换、属性校验等多种函数,方便使用人员使用。如果在使用过程中存在和业务强耦合的常用功能函数,在Jmeter不支持的情况下,那就需要单独开发自定义函数实现特定功能。 本文介绍如何开发Jmeter自定义函数实现快速生成京东宙斯下单标准sign,同时深刻理解Jmeter的插件化机制及高扩展性特性。 2 开发准备 Java基础开发 Maven基本使用 开发依赖版本 JDK 1.8.0Maven 3.6.3Jmeter 5.4.3 3 自定义函数核心实现 3.1 新建项目 新建maven项目,这里项目名为:JSF_Sampler 因为是基于Jmeter的扩展,需要依赖包Jmeter两个核心包,分别是: ApacheJMeter_core ApacheJMeter_java ApacehJMeter_functions pom.xml文件核心配置如下 <groupId>com.jd.jmeter.jsf</groupId> <artifactId>JSF_Sampler</artifactId> <version>1.0-SNAPSHOT</version> <properties> <maven.compiler.source>8</maven.compiler.source> <maven.compiler.target>8</maven.compiler.target> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <jmeter-version>5.4.3</jmeter-version> </properties> <dependencies> <dependency> <groupId>org.apache.jmeter</groupId> <artifactId>ApacheJMeter_core</artifactId> <version>${jmeter-version}</version> </dependency> <dependency> <groupId>org.apache.jmeter</groupId> <artifactId>ApacheJMeter_java</artifactId> <version>${jmeter-version}</version> </dependency> <dependency> <groupId>org.apache.jmeter</groupId> <artifactId>ApacheJMeter_functions</artifactId> <version>${jmeter-version}</version> </dependency> </dependencies> 3.2 继承实现AbstractFunction类 实现类依次实现以下几个步骤 1)新建实现类并继承 AbstractFunction 注意:实现类的包名必须包含xxx.functions.xxx,Jmeter使用命名规则实现实现类的加载。 2)重写以下方法,每个方法的用途见下方代码注释 execute() setParameters() getReferenceKey() getArgumentDesc() /** * 京东宙斯 下单标准字段常量 */ private static final String APP_KEY = "app_key"; private static final String APP_SECRET = "app_secret"; private static final String ACCESS_TOKEN = "access_token"; private static final String TIMESTAMP = "timestamp"; private static final String V = "v"; private static final String METHOD = "method"; private static final String BUY_PARAM_JSON = "360buy_param_json"; /** * Jmeter中自定义的函数名,在Jmeter的函数助手中可以看到 */ private static final String FUNC_NAME = "__GenSignFunction"; /** * 自定义函数的描述,入参,出参,方便使用人员参考使用 */ private static final List<String> desc = new ArrayList<>(); static { desc.add("This function is used to generate the JD's JOS sign value"); } /** * 此为自定义函数核心实现类,其中,入参SampleResult为上次运行的结果,Sampler为当前的采集器; * 返回值为该函数的返回值 * @param sampleResult * @param sampler * @return * @throws InvalidVariableException */ @Override public String execute(SampleResult sampleResult, Sampler sampler) throws InvalidVariableException { // 入参处理 String param = String.valueOf((CompoundVariable)paramValues[0]); String signResult = paramHandler(param); return signResult; } /** * 按京东宙斯sign加密规则生成标准sign * @param param * @return */ public String paramHandler(String param){ Map<String,String> valueMap = new HashMap(); // 按&符号分割 String[] paramArray = param.split("&"); for (int i = 0; i < paramArray.length-1; i++) { String key = paramArray[i].split("=")[0]; String value = paramArray[i].split("=")[1]; valueMap.put(key,value); }; // 京东宙斯标准sign String josGign = EncryptUtil.getSignature(valueMap.get("app_secret")+BUY_PARAM_JSON+valueMap.get("360buy_param_json") +ACCESS_TOKEN+valueMap.get("access_token") +APP_KEY+valueMap.get("app_key") +METHOD+valueMap.get("method") +TIMESTAMP+valueMap.get("timestamp") +V+valueMap.get("v") +valueMap.get("app_secret")); return josGign; } /** * 配置入参,jmeter函数助手入参 */ @Override public void setParameters(Collection<CompoundVariable> collection) throws InvalidVariableException { paramValues = collection.toArray(); } /** * 此方法返回自定义的函数名称 */ @Override public String getReferenceKey() { return FUNC_NAME; } /** * 此方法返回函数描述信息 */ @Override public List<String> getArgumentDesc() { return desc; } 3.3 最终项目结构 4 Jmeter加载扩展包 以上开发完成,打包此项目,注意这里的打包要包含依赖包。 4.1 maven构建配置 <build> <finalName>${project.artifactId}</finalName> <defaultGoal>install</defaultGoal> <plugins> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-compiler-plugin</artifactId> <configuration> <source>1.8</source> <target>1.8</target> </configuration> </plugin> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-assembly-plugin</artifactId> <configuration> <descriptorRefs> <descriptorRef>jar-with-dependencies</descriptorRef> </descriptorRefs> </configuration> <executions> <execution> <id>assemble-all</id> <phase>package</phase> <goals> <goal>single</goal> </goals> </execution> </executions> </plugin> </plugins> </build> 4.2 项目打包 打包指令如下 mvn package -Dmaven.test.skip=true 4.3 Jmeter加载扩展包 将打包后的扩展包放置到Jmeter的ext目录:apache-jmeter-5.4.3/lib/ext/ 启动Jmeter后,Jmeter会自动加载ext目录中的扩展包 打开Jmeter函数助手后,可以看到本次实现类中打印的相关日志 5 自定义函数调用调试 5.1 打开Jmeter函数助手,选择自定义函数 5.2 京东宙斯接口验证 这里使用京东快递获取预制运单号接口,输入GET请求后,直接点击运行函数【Generate & Copy to clipboard】,出参返回32位sign值。 GET请求入参 method=jingdong.etms.waybillcode.get&app_key=349559FAE87E66826499890862E40A44&access_token=c8c2bdc8d1684630bb771a503d5b5a7fkyzh×tamp=2022-01-28 15:10:00&360buy_param_json={"preNum":"1","customerCode":"10K43816","orderType":"0"}&v=2.0&sign=EBB52C6CEDA34703ADE72D4AA4D8F316&app_secret=29959e4cadc14ff4998d4fc26d1e5063 6 总结 本文通过自定义函数实现了京东宙斯下单标准sign的生成,希望通过本项目大家可以学习到: 如何二次开发Jmeter,实现自己特有的自定义函数。 理解为何官方介绍Jmeter是插件化的,高扩展性特性。 更好的理解Jmeter内部处理机制。 作者:京东物流 苗浩冲 来源:京东云开发者社区

优秀的个人博客,低调大师

记一次618军演压测TPS上不去排查及优化 | 京东云技术团队

本文内容主要介绍,618医药供应链质量组一次军演压测发现的问题及排查优化过程。旨在给大家借鉴参考。 背景 本次军演压测背景是,2B业务线及多个业务侧共同和B中台联合军演。 现象 当压测商品卡片接口的时候,cpu达到10%,TPS只有240不满足预期指标,但是TP99已经达到了1422ms。 排查 对于这种TPS不满足预期目标,但是TP99又超高,其实它的原因有很多中可能,通过之前写过的文章对性能瓶颈的一个分析方式《性能测试监控指标及分析调优》,我们可以采用自下而上的策略去进行排查: 首先是操作系统层面的CPU、内存、网络带宽等,对于集团内部的压测,机器的配置、网络带宽,这些因素运维人员已经配置到最优的程度了,无需我们再关心是否是因为硬件资源系统层面导致的因素。 接下来从代码层面和JVM层面进行排查,可能是项目代码中出现了线程阻塞,导致线程出现等待,响应时间变长,请求不能及时打到被测服务器上。对于这种猜测,我们可以在压测过程中打线程dump文件,从dump文件中找到哪个线程一致处于等待状态,从而找到对应的代码,查看是否可以进行优化。这块同开发一同分析整个接口的调用链路,商品卡片接口调用运营端的优惠券的可领可用接口,通过查看此接口的ump监控那个,发现调用量其实并不高。接下来通过查看运营端机器的日志发现,调用可领可用优惠券接口已经超时了,并且机器CPU已经偏高,使用率平均在80%以上。是什么原因导致调用可领可用接口大量超时,成为了问题的关键点。 首先我们代码层面分析,这个可领可用优惠券接口还会调用一个过滤器进行过滤,于是猜测是不是这个过滤器接口把CPU打满了,但是通过监控过滤器接口的ump中可以看到它的TP99并不是很高,说明它的调用量没有上去,这种猜测可能不成立。还好当时代码这设置了一个开关是否使用过滤器,我们把过滤器的开关关闭后。再次进行压测商品卡片接口,发现还是没有解决问题,TPS仍然不高,并且TP99还是很高。说明这个猜测真是不成立的。 接下来我们转换思路,查看JVM日志,是否从中寻找到一些蛛丝马迹,果然从JVM的GC日志中可看到Ygc和Fgc的时间占用比较长,其中Fullgc的时间占用时间达到了7165ms,并且从中可以查看jvm的参数配置,发现Xms 和Xmx配置的值都是1024,只有1个G。问题的原因找到了,这台被压测的机器JVM参数配置的Xms 和Xmx值太小了,如果-Xmx指定偏小,应用可能会导致java.lang.OutOfMemory错误 对于JVM的介绍这部分比较庞大涉及到类加载方式、JVM内存模型、垃圾回收算法、垃圾收集器类型、GC日志,在这就不做详细说明了,想要了解详细内容可以看看《深入理解 JAVA 虚拟机》这本书。 此处简单说明下什么是Ygc和Fgc,以及Xms、Xmx的含义。 JVM内存模型中,分为新生代、老年代和元空间,新生代又分为eden区、Survivor0、Survivor1区。对象优先在Eden区分配,当Eden区没有足够空间时会进行一次Minor GC,执行完第一次MGC之后,存活的对象会被移动到Survivor(from)分区,当Survivor区存储满了之后会进行一次Ygc,但是Ygc一般不会影响应用。当老年代内存不足的时候,会进行一次Full GC,也就是Stop the world,系统将停止运行,清理整个内存堆(包括新生代和老年代) ,FullGC频率过大和时间过长,会严重影响系统的运行。 Xms,JVM初始分配的堆内存 Xmx,JVM最大分配的堆内存 一般情况这两个参数配置的值是相等的,以避免在每次GC 后堆内存重新进行分配。 优化 最后修改机器的JVM数配置 查看JVM配置参数 重启后再次进行压测,我们的TPS指标上来了,并且TP99的值也下去了。达到了预期的一个目标。 总结 其实对于一个性能瓶颈问题的分析排查定位,犹如医生看病,需要望闻问切,通过表面现象逐层的去排除一种种的可能性,最终找到其根本原因,对症下药解决问题。本文介绍的也只是性能瓶颈问题中的一个小小的部分,其实在压测过程中还会遇到各种各样的问题,但是我们掌握了方法论,其实都可以按照相同的思路去排查,最终找到根源。 作者:京东健康 牛金亮 来源:京东云开发者社区

优秀的个人博客,低调大师

Flutter调优--深入探究MediaQuery引起界面Rebuild的原因及解决办法 | 京东云技术团队

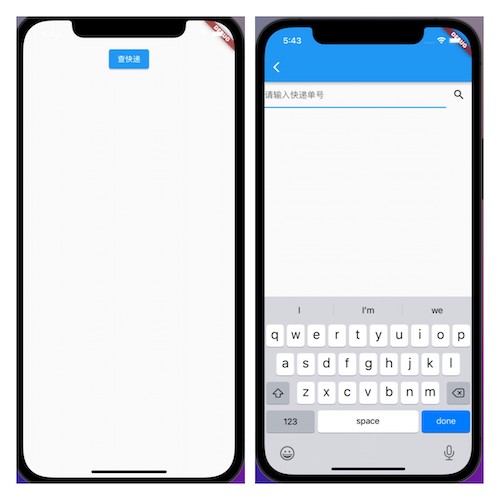
前言 我们可以通过MediaQuery.of(context)方法获取到一些设备和系统的相关信息,比如状态栏的高度、当前是否是黑暗模式等等,使用起来相当方便,但是也要注意可能引起的页面rebuild问题。本文会介绍一个典型的例子,并深入源码来探讨引起rebuild的原因,最后介绍避免rebuild的几个办法。 典型例子 以快递App中的查快递场景举例,首页用MediaQuery.of(context).padding.top获取了状态栏高度,用户点击“查快递”按钮会跳转到查快递界面,在查快递界面,用户输入单号可进行查询操作。 当首页的build方法被调用时,会输出我们提前加好的日志。我们发现,当查快递界面的键盘弹出时,首页的build方法被调用了多次: 主界面的build代码如下: 源码探究 既然是因为主界面在build方法里使用了MediaQuery.of(context),从而导致当键盘弹出/隐藏时进行rebuild操作,那么就先来看下MediaQuery类。 MediaQuery 其继承自InheritedWidget,自身并没有重写createElement方法,从flutter三棵树的角度讲,对应的Element即为InheritedElement。有两个属性,data和child,我们可以从data中获取一些设备/系统相关的属性。 另外还有两个比较重要的方法: fromWindow(key : Key, child : Widget) 此方法直接返回_MediaQueryFromWindow对象,后面会详细介绍。 of(context : BuildContext) 方法里调用了dependOnInheritedWidgetOfExactType,接下来我们详细分析下背后的调用流程。 MediaQuery.of(context) 调用流程 入参是context,本例中的主界面是StatelessWidget,那么这里的context便是StatelessElement。整体调用流程如下: dependOnInheritedWidgetOfExactType 从_inheritedWidgets列表中查询是否有MediaQuery类型的InheritedElement,从三棵树的角度讲,就是从当前节点一直向上查找,找到最近的MediaQuery控件。如果找到,则调用dependOnInheritedElement方法(一般情况下是一定能找到的,下面再详细介绍)。 dependOnInheritedElement 此方法负责将找到的InheritedElement(也就是MediaQuery对应的Element)存起来,并且调用InheritedElement#updateDependencies方法。 updateDependencies setDependencies 最后两个方法很简单,其作用是将主页对应的StatelessElement存储到了MediaQuery对应的InheritedElement#_dependents中。 研究完MediaQuery.of(context)背后的原理,我们可以知道:通过调用of方法,主界面对应的Element和MediaQuery建立了绑定关系,MediaQuery对应的InheritedElement存储了主界面Element的引用。 Rebuild起点 当介绍dependOnInheritedWidgetOfExactType方法时,我们提道:从当前节点往父节点寻找,一般情况下是一定能找到的MediaQuery控件的。这是因为在WidgetsApp里会自动给我们创建一个根MediaQuery。 在main方法里,无论使用CupertinoApp还是MaterialApp,最后都会在内部创建WidgetsApp。我们直接看_WidgetsAppState#build方法里的一个代码片段: 会首先检查widget.useInheritedMediaQuery,这个属性默认为false。如果你创建MaterialApp/CupertinoApp时,没有设置useInheritedMediaQuery属性,或者设置了这个属性为null,但找不到MediaQueryData,那么这里就会调用MediaQuery.fromWindow方法。 上面介绍MediaQuery#fromWindow时,我们知道它会创建_MediaQueryFromWindow控件。 _MediaQueryFromWindow的代码不是很多,把和本文相关的代码全部贴出来了,大家可以自己看下,代码如上图所示。 build方法里创建了MediaQuery控件,并实现了didChangeMetrics方法,当手机发生旋转、键盘弹出/隐藏时就会调用此方法,didChangeMetrics内部又调用了setSate,从而导致build方法被重新调用。 通过flutter三颗树的原理我们可以知道,上述所说的“build方法被重新调用”涉及到MediaQueryFromWindow对应的Element的updateChild方法,简单看下updateChild的内部处理规则: 对MediaQueryFromWindow而言,每次都会创建新的MediaQuery Widget,根据Element#updateChild源码(不是本文讨论重点,不再详细分析其源码)得知,最终会调用MediaQuery对应的Element的update方法。 经过一系列的跳转过后,最终会调用到下面的两个核心方法: 上面介绍的MediaQuery.of(context)方法最终会把入参Context放到_dependents变量里,而这里会遍历这个map,调用每一个Context的didChangeDependecies方法,didChangeDependecies会将此Context置为dirty状态,下一帧来临时会被重新绘制,并调用此Context的build方法。 所以,破案了,当键盘弹起/隐藏时快递主页会被rebuild的原因找到了! 整体的rebuild调用流程如下,感兴趣的可以结合这个调用流程图去看源码: 避免rebuild的办法 研究过源码后,解决方案就变的很简单。 自定义useInheritedMediaQuery属性为true,并在最外面包一层MediaQuery,让WidgetsApp创建时使用MediaQuery,而不去使用监听了application尺寸变化的_MediaQueryFromWindow控件。 避免在页面中使用MediaQuery.of(context)方法,可以使用对应的替代方法,比如本例可以采用下面的代码进行替代,注意单位的转换。 如果必须要使用MediaQuery.of(context)方法,可以使用Builder控件包裹下,of方法的入参传入此Builder的context即可,这样被rebuild仅是Builder控件包裹下的widget子树。 总结 app界面逐渐复杂时,我们不得不考虑去优化界面性能。本文中介绍的例子在开发中是很常见的,如果不了解MediaQuery.of的机制,可能会引起大量使用此方法的界面发生重绘操作,造成页面卡顿、帧率下降。我们详细分析了背后的源码逻辑,介绍了解决办法,希望能给大家的调优工作提供些许帮助。 作者:京东物流 沈明亮 来源:京东云开发者社区

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册