利用ELK分析Nginx日志生产实战
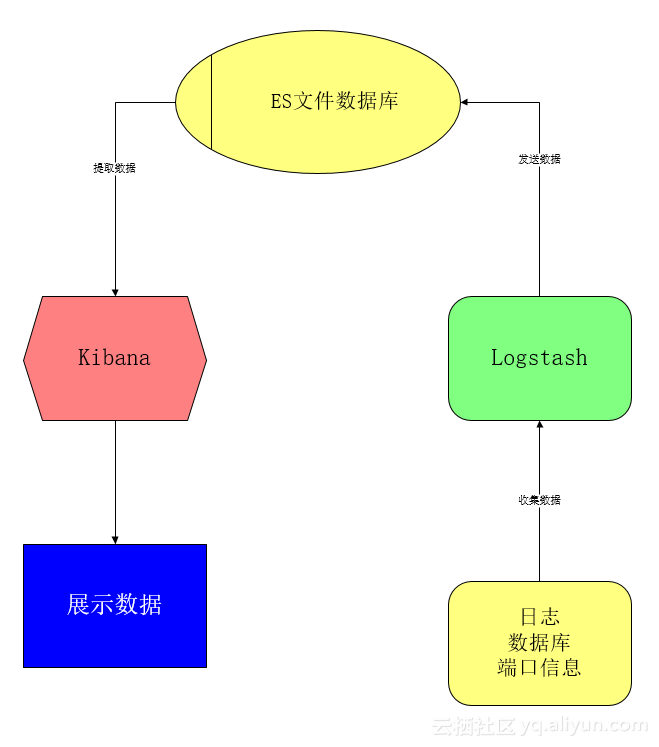
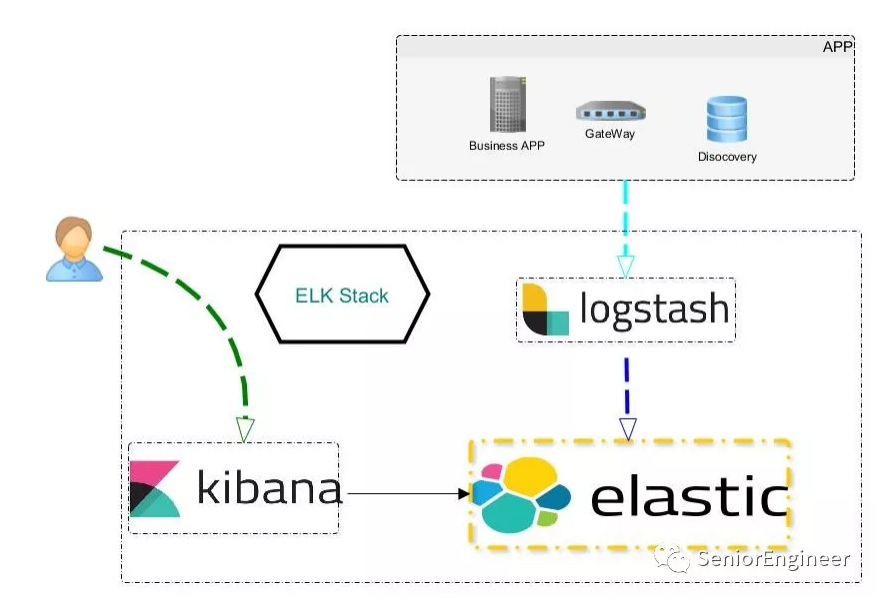
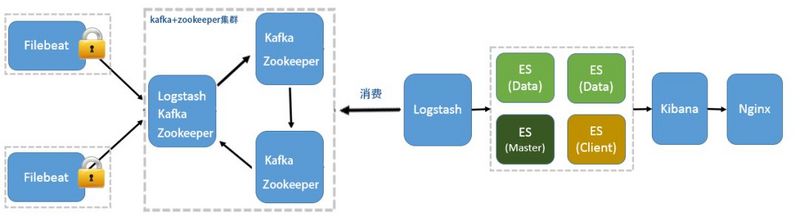
本文以api.mingongge.com.cn域名为测试对象进行统计,日志为crm.mingongge.com.cn和risk.mingongge.com.cn请求之和(此二者域名不具生产换环境统计意义),生产环境请根据具体需要统计的域名进行统计。由于涉及生产线上服务器,故本文部分服务器IP做了打码处理。一、服务介绍1.1、ELKELK是三个开源软件的缩写,分别表示:Elasticsearch , Logstash, Kibana , 它们都是开源软件。新增了一个FileBeat,它是一个轻量级的日志收集处理工具(Agent),Filebeat占用资源少,适合于在各个服务器上搜集日志后传输给Logstash,官方也推荐此工具。Elasticsearch是个开源分布式搜索引擎,提供搜集、分析、存储数据三大功能。它的特点有:分布式,零配置,自动发现,索引自动分片,索引副本机制,restful风格接口,多数据源,自动搜索负载等。Logstash 主要是用来日志的搜集、分析、过滤日志的工具,支持大量的数据获取方式。一般工作方式为c/s架构,client端安装在需要收集日志的主机上,server端负责将收到的各节点日志进行过滤、修改等操作在一并发往elasticsearch上去。Kibana 也是一个开源和免费的工具,Kibana可以为 Logstash 和ElasticSearch 提供的日志分析友好的 Web 界面,可以帮助汇总、分析和搜索重要数据日志。1.2、NginxNginx("engine x") 是一个高性能的HTTP和反向代理服务器,也是一个IMAP/POP3/SMTP代理服务器。 Nginx 是由 Igor Sysoev 为俄罗斯访问量第二的 Rambler.ru 站点开发的,第一个公开版本0.1.0发布于2004年10月4日。其将源代码以类BSD许可证的形式发布,因它的稳定性、丰富的功能集、示例配置文件和低系统资源的消耗而闻名。Nginx是一款轻量级的Web服务器/反向代理服务器及电子邮件(IMAP/POP3)代理服务器,并在一个BSD-like 协议下发行。由俄罗斯的程序设计师Igor Sysoev所开发,供俄国大型的入口网站及搜索引擎Rambler(俄文:Рамблер)使用。其特点是占有内存少,并发能力强,事实上nginx的并发能力确实在同类型的网页服务器中表现较好,中国大陆使用nginx网站用户有:新浪、网易、腾讯等。本文中前端使用了nginx的反向代理功能,并使用了nginx的HTTP功能。1.3、KafkaKafka是由Apache软件基金会开发的一个开源流处理平台,由Scala和Java编写。Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者规模的网站中的所有动作流数据。这种动作(网页浏览,搜索和其他用户的行动)是在现代网络上的许多社会功能的一个关键因素。 这些数据通常是由于吞吐量的要求而通过处理日志和日志聚合来解决。 对于像Hadoop一样的日志数据和离线分析系统,但又要求实时处理的限制,这是一个可行的解决方案。Kafka的目的是通过Hadoop的并行加载机制来统一线上和离线的消息处理,也是为了通过集群来提供实时的消息。二、架构要求2.1、架构描述使用filebeat收集nginx日志,输出到kafka;logstash从kafka中消费日志,通过grok进行数据格式化,输出到elasticsearch中,kibana从elasticsearch中获取日志,进行过滤出图. 2.2、系统版本 CentOS Linux release 7.2.1511 (Core)3.10.0-514.26.2.el7.x86_64 2.3、软件版本 jdk1.8.0_144nginx-1.12.2filebeat-6.3.2awurstmeister/kafka(docker image)logstash- 6.5.4elasticsearch-6.4.0kibana-6.4.0 三、linux系统环境配置与优化 #查看服务器硬件信息dmidecode|grep "Product Name"#查看CPU型号grep name /proc/cpuinfo#查看CPU个数 grep "physical id" /proc/cpuinfo#查看内存大小grep MemTotal /proc/meminfo 四、系统初始化4.1、关闭防火墙 systemctl stop filewalld 4.2、关闭selinux setenforce 0sed -i 's#SELINUX=enforcing#SELINUX=disabled#g' /etc/selinux/config 4.3、添加普通账户 useradd elsearchecho "******"|passwd --stdin elsearch 4.4、配置yum源 cat /etc/yum.repos.d/CentOS- Base.repo[base]name=CentOS-$releaseverenabled=1failovermethod=prioritybaseurl=http://mirrors. cloud.aliyuncs.com/centos/$releasever/os/$basearch/gpgcheck=1gpgkey=http://mirrors.cloud. aliyuncs.com/centos/RPM-GPG-KEY-CentOS- 7[updates]name=CentOS-$releaseverenabled=1failovermethod=prioritybaseurl=http://mirrors.cloud. aliyuncs.com/centos/$releasever/updates/$basearch/gpgcheck=1gpgkey=http://mirrors.cloud.aliyuncs. com/centos/RPM-GPG-KEY-CentOS- 7[extras]name=CentOS-$releaseverenabled=1failovermethod=prioritybaseurl=http://mirrors.cloud. aliyuncs.com/centos/$releasever/extras/$basearch/gpgcheck=1gpgkey=http://mirrors.cloud.aliyuncs. com/centos/RPM-GPG-KEY-CentOS-7 4.5、清理开机自启动服务 for i in `chkconfig --list|grep 3:on |awk '{print $1}'`;do chkconfig$i off;donefor i in crond network rsyslog sshd;do chkconfig --level 3 $ion;donechkconfig --list|grep 3:on 4.6、服务器时间同步 echo '*/5 * * * * /usr/sbin/ntpdate time.windows.com > /dev/null2>&1' >>/var/spool/cron/root 4.7、加大文件描述符 echo '* - nofile 65535' >> /etc/security/limits.conftail -1 /etc/security/limits.conf#重新登陆 后生效(无需重启)ulimit -n(重新登陆后查看) 4.8、内核参数调优(可不操作) \cp /etc/sysctl.conf /etc/sysctl.conf.bakcat>>/etc/sysctl.conf<<EOFnet.ipv4.tcp_timestamps = 0net.ipv4.tcp_synack_retries = 2net.ipv4.tcp_syn_retries = 2net.ipv4.tcp_mem = 94500000 915000000 927000000net.ipv4.tcp_max_orphans = 3276800net.core.wmem_default = 8388608net.core.rmem_default = 8388608net.core.rmem_max = 16777216net.core.wmem_max = 16777216net.ipv4.tcp_rmem=4096 87380 16777216net.ipv4.tcp_wmem=4096 65536 16777216net.core. netdev_max_backlog = 32768net.core.somaxconn = 32768net.ipv4.tcp_syncookies=1net.ipv4.tcp_tw_reuse = 1net.ipv4.tcp_tw_recycle = 1net.ipv4.tcp_fin_timeout=1net.ipv4.tcp_keepalive_time=1200net.ipv4.tcp_max_syn_backlog = 65536net.ipv4.ip_local_port_range = 1024 65535EOF/sbin/sysctl -p 五、部署开始5.1、更改nginx日志输出格式5.1.1、定义日志格式 cat /etc/nginx/nginx.conflog_format main '$remote_addr - $remote_user [$time_local]"$request" ''$status$body_bytes_sent "$http_referer" ''"$http_user_agent" "$http_x_forwarded_for"'; 5.1.2、加载日志格式到对应域名配置中 cat /etc/nginx/conf.d/vhost/api.mingongge.com.cn.confserver {listen 80;server_name newtest- msp-api.mingongge.com.cn;access_log /var/log/nginx/api.mingongge.com.cn.log main;} 5.1.3、reload生效 nginx -s reload 5.1.4、清空原输出文件,并查看输出的日志格式 :> /var/log/nginx/api.mingongge.com.cn.logtailf /var/log/nginx/api.mingongger.com.cn.log1xx.2xx.72.175 - - [18/Mar/2019:13:51:17 +0800] "GET/user/fund/113 HTTP/1.1" 200 673 "-" "Mozilla/5.0 (WindowsNT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) sun/1.5.6 Chrome/69.0.3497.106Electron/4.0.3 Safari/537.36" "-" 5.2、配置kafka测试环境使用docker起的kafka,kafka部署掠过,以下任选一种5.2.1、方法一 创建kafka topic ./kafka-topics.sh --create --topic nginxlog --replication-factor 1--partitions 1 --zookeeper localhost:2181 5.2.2、方法二 auto.create.topics.enable=true 开启kafka自动创建topic配置5.2.3、filebeat部署完成后确认kafka topic中有数据 ./kafka-console-consumer.sh --bootstrap-server 192.168.0.53:9091--from-beginning --topic nginxlog 输出如下 {"@timestamp":"2019-03-14T07:16:50.140Z","@metadata": {"beat":"filebeat","type":"doc","version":"6.3.2","topic":"nginxlog"},"fields": {"log_topics":"nginxlog"},"beat":{"version":"6.3.2","name":"test-kafka-web","hostname":"test- kafka-web"},"host":{"name":"test-kafka-web"},"source":"/var/log/nginx/newtest-msp- api.mingongge.com.cn-80.log","offset":114942,"message":"116.226.72.175- - [14/Mar/2019:15:16:49 +0800] newtest-msp-api.mingongge.com.cn POST\"/upstream/page\" \"-\" 200 6314\"http://newtest-msp-crm.mingongge.com.cn/\" 200 192.168.0.49:60070.024 0.024 \"Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36(KHTML, like Gecko) Chrome/70.0.3538.67 Safari/537.36\"\"-\""}Processed a total of 7516 messages 测试环境中kafka地址为 192.168.0.53:9091 5.3、配置filebeat收集nginx日志5.3.1、安装filebeat cd /opt/ && wget http://download.mingongge.com.cn/download/software/filebeat-6.3.2- x86_64.rpmyum localinstall filebeat-6.3.2-x86_64.rpm -y 5.3.2、编辑配置文件 cat /etc/filebeat/filebeat.ymlfilebeat.prospectors:- input_type: logenabled: truepaths:- /var/log/nginx/api.mingongge.com.cn.log#收集日志路径fields:log_topics: nginxlog #kafka中topic 名称json.keys_under_root: truejson.overwrite_keys: trueoutput.kafka:enabled: truehosts: ["192.168.0.53:9091"] #kafka地址topic:'%{[fields][log_topics]}' #kafka中topic名称 partition.round_robin:reachable_only: falsecompression: gzipmax_message_bytes: 1000000required_acks: 1 5.3.3、启动filebeat& 开机启动 systemctl start filebeatsystemctl enable filebeat 5.4、配置logstash5.4.1 编辑配置 cat /usr/local/logstash/config/nginx.confinput {kafka {type =>"nginxlog"topics => ["nginxlog"]bootstrap_servers=> ["192.168.0.53:9091"]group_id =>"nginxlog"auto_offset_reset=> latestcodec =>"json"}}filter {if [type] == "nginxlog"{grok {match => {"message" => "% {COMBINEDAPACHELOG}" }remove_field =>"message"}date {match => ["timestamp" , "dd/MMM/YYYY:HH:mm:ss Z" ]}geoip {source =>"clientip"target =>"geoip"database =>"/usr/local/logstash/config/GeoLite2-City.mmdb"add_field => ["[geoip][coordinates]", "% {[geoip][longitude]}" ] #添加字段coordinates,值为经度add_field => ["[geoip][coordinates]", "% {[geoip][latitude]}" ] #添加字段coordinates,值为纬度}mutate {convert => ["[geoip] [coordinates]", "float"]}useragent {source =>"agent"target =>"userAgent"}}}output {if [type] == 'nginxlog' {elasticsearch {hosts =>["http://192.168.0.48:9200"]index =>"logstash-nginxlog- %{+YYYY.MM.dd}"}stdout {codec =>rubydebug}}} 5.4.2、使用配置文件启动logstash服务,观察输出 /usr/local/logstash/bin/logstash -f nginx.conf{"httpversion"=> "1.1","verb" =>"GET","auth"=> "-","@timestamp"=> 2019-03- 18T06:41:27.000Z,"type"=> "nginxlog","json"=> {},"source"=> "/var/log/nginx/newtest-msp- api.mingongge.com.cn-80.log","fields" =>{"log_topics"=> "nginxlog"},"response"=> "200","offset"=> 957434,"host"=> {"name" =>"test- kafka-web"},"beat"=> {"hostname"=> "test-kafka-web","version"=> "6.3.2","name"=> "test-kafka- web"},"bytes"=> "673","request"=> "/user/fund/113","timestamp"=> "18/Mar/2019:14:41:27 +0800","referrer"=> "\"-\"","userAgent"=> {"os"=> "Windows","major" => "4","patch"=> "3","build"=> "","minor"=> "0","os_name"=> "Windows", "device"=> "Other","name"=> "Electron"},"geoip"=> {"ip" => "1xx.2xx.72.175","country_name" => "China","coordinates" => [[0] 121.4012, [1] 31.0449],"region_name" => "Shanghai","location" => {"lat"=> 31.0449,"lon"=> 121.4012},"continent_code" => "AS","timezone" => "Asia/Shanghai", "longitude" => 121.4012,"city_name" => "Shanghai","country_code2" => "CN","region_code" => "SH", "latitude" => 31.0449,"country_code3" => "CN"},"@version"=> "1","clientip"=> "1xx.2xx.72. 175","ident"=> "-","agent"=> "\"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36(KHTML, like Gecko) sun/1.5.6 Chrome/69.0.3497.106 Electron/4.0.3Safari/537.36\""} 5.4.3、后台启动logstash确认出现以上输出后,将logstash分离出当前shell,并放在后台运行 nohup /usr/local/logstash/bin/logstash -f nginx.conf &>/dev/null & 5.5、kibana配置5.5.1、修改kibana配置 /usr/local/kibana-6.5.4-linux-x86_64/config/kibana.yml #增加高德地图 tilemap.url:'http://webrd02.is.autonavi.com/appmaptile?lang=zh_cn&size=1&scale=1&style=7&x= {x}&y={y}&z={z}' 5.5.2、创建Index Pattern 5.5.3、IP访问TOP5选择柱形图 添加X轴,以geoip.ip为order by字段 5.5.4 、PV 选择metric 默认统计总日志条数,即为PV数 5.5.5、全球访问地图 选择map Field选择geoip.location 选择添加高德地图 5.5.6、实时流量 选择线条图 5.5.7、操作系统 选择饼图 5.5.8、登陆次数 过滤login关键字,并做count统计 5.5.9、访问地区 5.5.10、Dashboard展示IP访问Top5:每日客户端IP请求数最多的前五个(可分析出攻击者IP)PV:每日页面访问量全球访问图:直观的展示用户来自哪个国家哪个地区实时流量:根据@timestamp字段来展示单位时间的请求数(可根据异常峰值判断是否遭遇攻击)操作系统:展示客户端所用设备所占比重登陆次数:通过过滤request中login的访问记录,粗略估算出进行过登陆的次数访问地区:展示访问量最多的国家或地区 需展示其他指标,可进行自由发挥 扩展阅读:https://www.roncoo.com/view/1123532441674326017