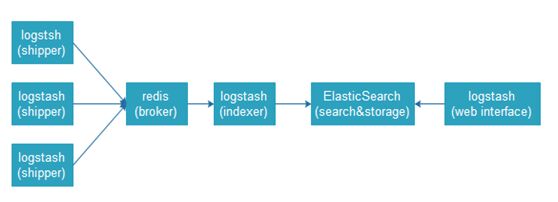
ELK 之 ElasticSearch
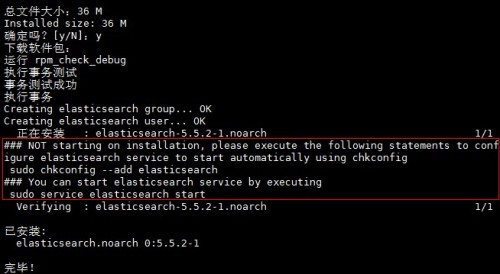
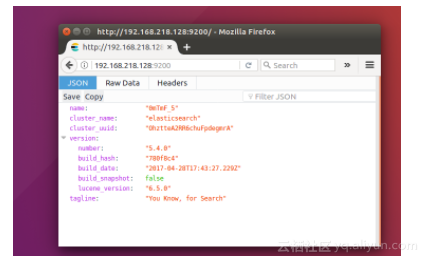
一、概述 1、简介 ElasticSearch是一个基于Lucene实现的开源、分布式、Restful的全文本搜索引擎;此外,它还是一个分布式实时文档存储,其中每个文档的每个field均是被索引的数据,且可被搜索;也是一个带实时分析功能的分布式搜索引擎,能够扩展至数以百计的节点实时处理PB级的数据。 应用场景:当我们建立一个网站或应用程序,并要添加搜索功能,但是想要完成搜索工作的创建是非常困难的。我们希望搜索解决方案要运行速度快、能有一个零配置和一个完全免费的搜索模式、能够简单地使用JSON通过HTTP来索引数据、搜索服务器始终可用、一台开始并扩展到数百台,并且实时搜索,我们要简单的多租户,我们希望建立一个云的解决方案。因此我们利用Elasticsearch来解决所有这些问题以及可能出现的更多其它问题。 设计用途:用于分布式全文检索 技术支持:通过HTTP使用JSON进行数据索引 主要目的:解决对于搜索的众多需求 2、基本组件 索引(index):文档容器,换句话说,索引是具有类似属性的文档的集合。类似于表。索引名必须使用小写字母; 类型(type):类型是索引内部的逻辑分区,其意义完全取决于用户需求。一个索引内部可定义一个或多个类型。一般来说,类型就是拥有相同的域的文档的预定义。 文档(document):文档是Lucene索引和搜索的原子单位,它包含了一个或多个域。是域的容器;基于JSON格式表示。每个域的组成部分:一个名字,一个或多个值;拥有多个值的域,通常称为多值域; 映射(mapping):原始内容存储为文档之前需要事先进行分析,例如切词、过滤掉某些词等;映射用于定义此分析机制该如何实现;除此之外,ES还为映射提供了诸如将域中的内容排序等功能。 4、ES的集群组件 Cluster:ES的集群标识为集群名称;默认为"elasticsearch"。节点就是靠此名字来决定加入到哪个集群中。一个节点只能属性于一个集群。 Node:运行了单个ES实例的主机即为节点。用于存储数据、参与集群索引及搜索操作。节点的标识靠节点名。 Shard:将索引切割成为的物理存储组件;但每一个shard都是一个独立且完整的索引;创建索引时,ES默认将其分割为5个shard,用户也可以按需自定义,创建完成之后不可修改。 shard有两种类型:primary shard和replica。Replica用于数据冗余及查询时的负载均衡。每个主shard的副本数量可自定义,且可动态修改。 5、ES Cluster工作过程 启动时,通过多播(默认)或单播方式在9300/tcp查找同一集群中的其它节点,并与之建立通信。 集群中的所有节点会选举出一个主节点负责管理整个集群状态,以及在集群范围内决定各shards的分布方式。站在用户角度而言,每个均可接收并响应用户的各类请求。 集群有状态:green, red, yellow 6、其他 ES的默认端口: 参与集群的事务:9300/tcp transport.tcp.port 接收请求:9200/tcp http.port 二、安装配置ElasticSearch 1、系统环境 操作系统:一台CentOS release 6.9(主节点),两台CentOS release 6.7(其他节点) ElasticSearch版本:elasticsearch-5.5.2.rpm JDK版本:java-1.8.0-openjdk 注:由于ElasticSearch依赖Java环境,所以必须安装JDK。而且JDK版本必须在1.7以上。 2、安装并配置java环境 1 yum install java-1.8.0-openjdk-1.8.0.102-4.b14.el7.x86_64.rpm 1 vim /etc/profile .d /java .sh 添加: 1 export JAVA_HOME= /usr/bin/java 注:我的java在/usr/bin下,可以通过which命令查找下确切位置。 3、安装ElasticSearch 1 yum install elasticsearch-5.5.2.rpm 注:安装完成后有以下提示信息 简单编辑配置elasticsearch文件: 1 vim /etc/elasticsearch/elasticsearch .ym 主节点添加cluster以及node名称: 其他节点添加cluster以及node名称(cluster命名一样,node分别命名): 另一台: 启动elasticsearch服务: 1 serviceelasticsearchstart 查看监听端口: 通过CURL访问Elasticsearch进行检测是否正常: 1 curl-XGET 'http://127.0.0.1:9200/?pretty' Curl访问Elasticsearch格式: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 curl-X<VERB> '<PROTOCOL>://HOST:PORT/<PATH>?<QUERY_STRING>' -d '<BODY>' VERB:GET,PUT,DELETE等; PROTOCOL:http,https QUERY_STRING:查询参数,例如?pretty表示用易读的JSON格式输出; BODY:请求的主体; 例: curl-XGET‘http: //127 .0.0.1:9200/?help’通过“?help”获取帮助 [root@CentOS~] #curl-XGEThttp://127.0.0.1:9200/_cat/nodes?h=name,ip,port,uptime,heap,current Centos127.0.0.1930033.6m 查看集群监控状况(health): curl-XGET 'http://127.0.0.1:9200/_cluster/health?pretty' 查看集群状态(state): curl-XGET 'http://127.0.0.1:9200/_cluster/state/?pretty' 查看集群节点状态(stats): curl-XGET 'http://127.0.0.1:9200/_nodes/stats?pretty' 问题: 1.在启动elasticsearch的时候,内存占用过大: 由于安装的elasticsearch为5.5版本,此版本默认heap设置为2G. 可以编辑jvm.options配置文件进行设置。 2.不能访问elasticsearch9200端口: 可以修改elasticsearch.yml配置文件, 1 2 network.host:192.168.137.100 http.port:9200 4、Elasticsearch的插件(Plugins) Elasticsearch扩展性很强,可以通过安装插件实现功能的扩展。通过插件扩展ES功能如添加自定义的映射类型、自定义分析器、本地脚本、自定义发现方式。 Plugins的安装: 安装方式有两种: 1)直接将插件放置于/usr/share/elasticsearch/plugins目录中; 2)使用/usr/share/elasticsearch/bin/elasticsearch-plugins脚本进行安装(可以通过加参数"-h"获取帮助信息); 例:安装x-pack 1 /usr/share/elasticsearch/bin/elasticsearch-plugin install x-pack X-Pack是一个Elastic Stack的扩展,将安全,警报,监视,报告和图形功能包含在一个易于安装的软件包中。 在Elasticsearch 5.0.0之前,您必须安装单独的Shield,Watcher和Marvel插件才能获得在X-Pack中所有的功能。 站点插件访问格式: 1 http: //HOST :9200 /_plugin/ {plugin_name} 三、ElasticSearch的使用 1、Elasticsearch CRUD操作相关的API 1)创建文档: 1 2 3 4 5 6 7 curl-XPUT 'localhost:9200/students/class1/1?pretty' -d' >{ > "first_name" : "fan" , > "gender" : "male" , > "age" :23, > "courses" : "it" >}' 或 1 curl-XPUT 'localhost:9200/students/class1/1' -d '{"first_name":"fan","age":25,"sex":"male"}' 2)获取文档: 1 2 3 4 5 6 7 8 9 10 11 12 13 curl-XGET 'localhost:9200/students/class1/1?pretty' { "_index" : "students" , "_type" : "class1" , "_id" : "1" , #插入时指定的id=1,xxx/class1/1(id)?pretty "_version" :1, "found" : true , "_source" :{ "first_name" : "fan" , "age" :25, "sex" : "male" } } 3)更新文档(两种方法) 1.PUT方法(会覆盖原有文档) 2.如果只更新部分内容,可以使用_update API 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 curl-XPOST 'localhost:9200/students/class1/1/_update?pretty' -d' >{ > "doc" :{ "age" :23} >}' { "_index" : "students" , "_type" : "class1" , "_id" : "1" , "_version" :2, "result" : "updated" , "_shards" :{ "total" :2, "successful" :1, "failed" :0 } } 4)删除文档 删除文档指定id就可以。(删除id为3的内容) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 curl-XDELETE 'localhost:9200/students/class1/3?pretty' { "found" : true , "_index" : "students" , "_type" : "class1" , "_id" : "3" , "_version" :4, "result" : "deleted" , "_shards" :{ "total" :2, "successful" :1, "failed" :0 } } 在重新查找id为3的文档,结果已经删除。 5)删除索引 查看索引:(使用_cat API) 1 curl-XGET 'localhost:9200/_cat/indices?v' 删除索引:(指定索引节点即可) 1 2 curl-XDELETE 'localhost:9200/students' { "acknowledged" : true } 再次查看索引:(已经删除) 2、查询数据 查询数据我们需要使用elasticsearch的"Query" API,“Query”API是elasticsearch最重要的一部分。主要用于实现搜索功能。 "Query"API通过Query DSL(JSON based language for building complex queries)来实现,Query DSL可以实现 诸多类型的查询操作,如simple term query,phrase,range boolean,fuzzy等。 ES的查询操作执行分为两个阶段:1)分散阶段 2)合并阶段: 查询方式: 向ES发起查询请求的方式有两种: 1、通过Restful request API查询,也称为query string; 2、通过发送REST request body进行;(可以查询更为复杂的查询) 例方法一查询:查询student索引下所有文档(查询较小数据文档) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 [root@Centos6~] #curl-XGET'localhost:9200/students/_search?pretty' { "took" :1063, "timed_out" : false , "_shards" :{ "total" :5, "successful" :5, "failed" :0 }, "hits" :{ "total" :2, "max_score" :1.0, "hits" :[ { "_index" : "students" , "_type" : "class1" , "_id" : "2" , "_score" :1.0, "_source" :{ "third_name" : "jing" , "age" :25, "sex" : "female" } }, { "_index" : "students" , "_type" : "class1" , "_id" : "1" , "_score" :1.0, "_source" :{ "third_name" : "fan" , "age" :23, "sex" : "male" } } ] } } 例方法二查询: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 [root@Centos6~] #curl-XGET'localhost:9200/students/_search?pretty'-d' >{ > "query" :{ "match_all" :{}} >}' { "took" :11, "timed_out" : false , "_shards" :{ "total" :5, "successful" :5, "failed" :0 }, "hits" :{ "total" :2, "max_score" :1.0, "hits" :[ { "_index" : "students" , "_type" : "class1" , "_id" : "2" , "_score" :1.0, "_source" :{ "third_name" : "jing" , "age" :25, "sex" : "female" } }, { "_index" : "students" , "_type" : "class1" , "_id" : "1" , "_score" :1.0, "_source" :{ "third_name" : "fan" , "age" :23, "sex" : "male" } } ] } } 多索引、多类型查询: /_search:所有索引; /INDEX_NAME/_search:单索引; /INDEX1,INDEX2/_search:多索引; /s*,t*/_search: /students/class1/_search:单类型搜索 /students/class1,class2/_search:多类型搜索 Mapping和Analysis: 什么是Mapping? 映射 为了能够把日期字段处理成日期,把数字字段处理成数字,把字符串字段处理成全文本(Full-text )或精确的字符串值,Elasticsearch需要知道每个字段里面都包含了什么类型。这些类型和字段的 信息存储(包含)在映射(mapping)中。 正如《数据吞吐》一节所说,索引中每个文档都有一个类型(type)。 每个类型拥有自己的映射 (mapping)或者模式定义(schema definition)。一个映射定义了字段类型,每个字段的数据类型,以 及字段被Elasticsearch处理的方式。映射还用于设置关联到类型上的元数据。 这里只是入门。 例如,可以使用映射来定义: 字符串字段是否作为全文本搜索字段 哪些字段包含数字,日期或地理信息 文档中所有字段的值是否应该被索引到_all字段 日期值的格式 自定义规则来控制动态添加的字段的映射 映射类型与type:即一个索引中有多个type,从逻辑上对文档进行划分、每个索引有一个或多个映射 类型,类型是对Document划分的逻辑组,索引中每个文档都有一个类型(type),每个类型拥有自己的 映射或者模式定义(schema definition) 。每个映射类型包括: 1.关联到类型上的元数据,比如:_index, _type, _id, and _source 2.字段或属性的定义,比如:字段类型,每个字段的数据类型,以及字段被ES处理的方式。 数据类型大致分类: 简单类型,比如:string, date, long, double, boolean 或 ip等 嵌套对象 特殊类型,比如:geo_point, geo_shape, 或completion等 简单来讲mapping在Elasticsearch中的作用就是约束。 Elasticsearch对每一个文档,会取得其所有域的所有值,生成一个名为“_all”的域;执行查询时,如果在query_string未指定查询的域,则在_all域上执行查询操作; 1 2 3 4 GET... /_search ?q= 'Xianglong' GET... /_search ?q= 'Xianglong%20Shiba%20Zhang' GET... /_search ?q=courses: 'Xianglong%20Shiba%20Zhang' GET... /_search ?q=courses: 'Xianglong' 前两个:表示在_all域搜索; 后两个:在指定的域上搜索; 例子: 查看指定类型的mapping示例: 1 curl 'localhost:9200/students/_mapping/class1?pretty' 什么是Analysis? 分析和分析器 分析(analysis)是这样一个过程: 首先,标记化一个文本块为适用于倒排索引单独的词(term) 然后标准化这些词为标准形式,提高它们的“可搜索性”或“查全率” 这个工作是分析器(analyzer)完成的。一个分析器(analyzer)只是一个包装用于将三个功能放到一个 包里: 功能1:字符过滤器 首先字符串经过字符过滤器(character filter),它们的工作是在标记化前处理字符串。字符过滤器 能够去除HTML标记,或者转换"&"为"and"。 功能2:分词器 下一步,分词器(tokenizer)被标记化成独立的词。一个简单的分词器(tokenizer)可以根据空格或逗 号将单词分开(译者注:这个在中文中不适用)。 功能3:标记过滤 最后,每个词都通过所有标记过滤(token filters),它可以修改词(例如将"Quick"转为小写),去 掉词(例如停用词像"a"、"and"、"the"等等),或者增加词(例如同义词像"jump"和"leap") Elasticsearch提供很多开箱即用的字符过滤器,分词器和标记过滤器。这些可以组合来创建自定义 的分析器以应对不同的需求。 内建的分析器 不过,Elasticsearch还附带了一些预装的分析器,你可以直接使用它们。下面我们列出了最重要的 几个分析器,来演示这个字符串分词后的表现差异: "Set the shape to semi-transparent by calling set_trans(5)" Elasticsearch内置的分析器:Standard analyzer;Simple analyzer;Whitespace analyzer;Language analyzer 标准分析器(Standard analyzer) 标准分析器是Elasticsearch默认使用的分析器。对于文本分析,它对于任何语言都是最佳选择(译 者注:就是没啥特殊需求,对于任何一个国家的语言,这个分析器就够用了)。它根据Unicode Consortium的定义的单词边界(word boundaries)来切分文本,然后去掉大部分标点符号。最后,把 所有词转为小写。产生的结果为: set, the, shape, to, semi, transparent, by, calling, set_trans, 5 简单分析器(Simple analyzer) 简单分析器将非单个字母的文本切分,然后把每个词转为小写。产生的结果为: set, the, shape, to, semi, transparent, by, calling, set, trans 空格分析器(Whitespace analyze) 空格分析器依据空格切分文本。它不转换小写。产生结果为: Set, the, shape, to, semi-transparent, by, calling, set_trans(5) 语言分析器(Language analyzer) 特定语言分析器适用于很多语言。它们能够考虑到特定语言的特性。例如,english分析器自带一套 英语停用词库——像and或the这些与语义无关的通用词。这些词被移除后,因为语法规则的存在,英 语单词的主体含义依旧能被理解(译者注:stem English words这句不知道该如何翻译,查了字典, 我理解的大概意思应该是将英语语句比作一株植物,去掉无用的枝叶,主干依旧存在,停用词好比枝 叶,存在与否并不影响对这句话的理解。)。 english分析器将会产生以下结果: set, shape, semi, transpar, call, set_tran, 5 注意"transparent"、"calling"和"set_trans"是如何转为词干的。 分析器不仅在创建索引时用到;在构建查询时也会用到. ElasticSearch查询语法(Query DSL) Elasticsearch查询分为两类: query 查询:执行full-text查询时,基于相关度来评判其匹配结果;查询执行过程复杂,且不会被缓存; filter 查询(过滤查询):执行exact查询时,基于其结果为“yes”或“no”进行评判;速度快,且结果缓存; 查询语句的结构: 全文查询: 1 2 3 4 5 6 { QUERY_NAME:{ AGGUMENT:VALUE, ARGUMENT:VALUE,... } } 某个字段上查询: 1 2 3 4 5 6 7 { QUERY_NAME:{ FIELD_NAME:{ ARGUMENT:VALUE,... } } } filter 查询: termfilter:精确匹配包含指定term的文档;{ "term": {"name": "Guo"} } 1 2 3 4 5 6 7 8 [root@CentOS~] #curl-XGET'localhost:9200/students/_search?pretty'-d' >{ > "query" :{ > "term" :{ > "name" : "fan" >} >} >}' 结果: termsfilter:用于多值精确匹配;{ "terms": { "name": ["Guo", "Rong"] }} 1 2 3 4 5 6 7 8 [root@CentOS~] #curl-XGET'localhost:9200/students/_search?pretty'-d' { "query" :{ "terms" :{ "name" :[ "fan" , "jing" ] } } }' 结果: rangefilters:用于在指定的范围内查找数值或时间; 1 2 3 4 5 6 { "range" : "age" :{ "gte" :15, "lte" :25 } } 范围比较字符:gt(大于), lt(小于), gte(大于等于), lte(小于等于) existsandmissingfilters:存在或者不存在; 1 2 3 4 5 { "exists" :{ "age" :25 } } booleanfilter: 基于boolean的逻辑来合并多个filter子句; must:其内部所有的子句条件必须同时匹配,即and; 1 2 3 4 must:{ "term" :{ "age" :25} "term" :{ "gender" : "Female" } } must_not:其所有子句必须不匹配,即not 1 2 3 must_not:{ "term" :{ "age" :25} } should:至少有一个子句匹配,即or 1 2 3 4 should:{ "term" :{ "age" :25} "term" :{ "gender" : "Female" } } QUERY 查询: match_allQuery:用于匹配所有文档,没有指定任何query,默认即为match_all query. 1 { "match_all" :{}} matchQuery:在几乎任何域上执行full-text或exact-value查询; 如果执行full-text查询:首先对查询时的语句做分析; 1 { "match" :{ "students" : "Guo" }} 如果执行exact-value查询:搜索精确值;此时,建议使用过滤,而非查询; 1 { "match" :{ "name" : "Guo" }} multi_matchQuery:用于在多个域上执行相同的查询; 1 <span style= "font-family:'微软雅黑', 'Microsoft YaHei';font-size:14px;" >{<br> "multi_match" :<br> "query" : full-text search<br> "field" : { 'field1' , 'field2' }<br>}<br>{<br> "multi_match" :<br> "query" : {<br> "students" : "Guo" <br>}<br> "field" :<br>{<br> "name" ,<br> "description" <br>}<br>}< /span ><br> bool query: 基于boolean逻辑合并多个查询语句;与bool filter不同的是,查询子句不是返回"yes"或"no",而是其计算出的匹配度分值。因此,boolean Query会为各子句合并其score; 关键词:must: must_not: should: 合并filter和query查询语句(组合查询): 一般来讲可以filter语句嵌套到query语句用来过滤,但很少把query语句嵌套到filter语句上。 1 <span style= "font-family:'微软雅黑', 'Microsoft YaHei';font-size:14px;" >{<br> "filterd" : {<br>query: { "match" : { "gender" : "Female" } }<br>filter: { "term" : { "age" : 25}}<br>}<br>}< /span ><br> 查询语句语法检查: 1 2 3 4 GET /INDEX/_validate/query ?pretty { #查询语句 } 例子: 1 curl-XGET 'localhost:9200/students/_validate/query?pretty' -d '{"query":{"term":{"name":"fan"}}}' 如果想获取详细信息,可以使用以下格式: 1 2 3 4 GET /INDEX/_validate/query ?explain&pretty { #查询语句 } 例子: 1 curl-XGET 'localhost:9200/students/_validate/query?explain&pretty' -d '{"query":{"term":{"name":"fan"}}}' 本文转自 SoulMio 51CTO博客,原文链接:http://blog.51cto.com/bovin/1963980,如需转载请自行联系原作者