首页 文章 精选 留言 我的

精选列表

搜索[融合分析],共10007篇文章
优秀的个人博客,低调大师

京东app后台多端融合架构代码重构实战

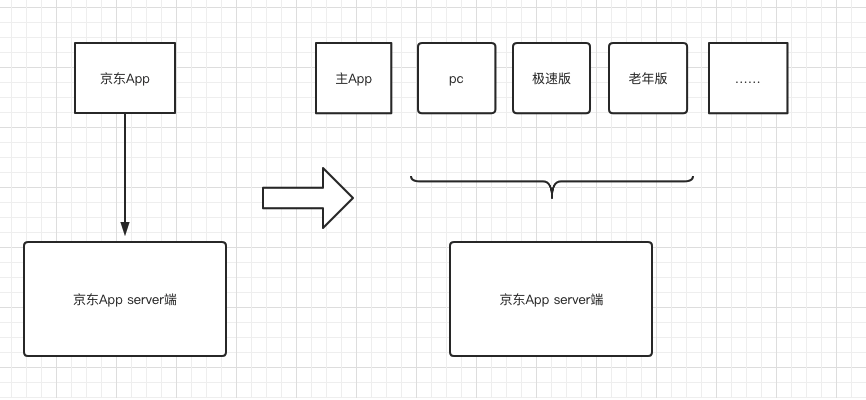
一 简介 重构是一个非常常见且古老的课题,涉及重构的文章、书更是不可胜数。 但其实做程序做久了就会知道,想把一个复杂的系统做好,尤其是参与人数较多的中大型项目,靠看几本设计模式的书,去试图寻找设计模式的奥秘,其实是不够的。很多时候,看书时觉得很有道理,例子也能理解,但到实际开发时,却无从下手,不知道怎么灵活套用。 很多项目,在持续的版本迭代中,还伴随着人员的更替过程,往往为了解决眼前的需求,最常见的就是直接复制类似的逻辑,或者就是在末尾追加逻辑。同时,受限于对老版本的需求理解,很容易出现新需求覆盖老需求的参数值,无意识的更改老版本结果等。那么倘若系统的隔离性做的不好,则极易产生A功能的改动,影响BCD等一大堆功能的正确性。 以京东App的后台为例,就是一个典型的复杂系统,涉及开发人员众多,模块巨多,迭代时间很长,很多业务逻辑已无从考证,开发人员也已经换了好几轮,那么对于这样的系统,如何让开发人员做的需求、功能隔离开,互不影响,各小模块又能各自健壮、系统又具备相当的扩展性、配置化率又高(仅通过配置即可完成功能的变更),就成了一个不得不深入考虑的问题。 本篇主要是我在实际工作中,对一个复杂系统做了一些改造,并从中总结的一些经验,做的分享。 二 案例 近期京东App后台核心模块发生了较大的逻辑改动,主要原因是新增了一些接入来源,从之前的独苗京东App,到后来的京东PC站、京东极速版、老年版、小程序等等,都接入了原App后台。通过完成统一接入,避免了多个后台共存,重复开发的问题。 而这些不同的来源,逻辑就有较多不同。 有的来源需要执行逻辑ABC,有的来源需要执行BCD,有的只需要执行BC,并且不同的来源返回值也有所不同,这就对之前的单一来源的系统架构产生了较大的冲击,如果处理不当,则不可避免地出现大量的if-else逻辑,以及扩展上的混乱。 那么针对这种情况,以及对提高系统整体配置化率的诉求,我们对后台架构做了一次重构。本文就是对重构内容做的一个浓缩后的抽象讲解,线上实战性质,非单纯设计模式类的demo。 如下图,我尽可能简化了细节,和小模块内的逻辑,仅保留了最外层的大模块。 我们来看背景,之前只有主App客户端来源的请求,譬如refer=1,该请求到达后,需要触发"运费"、"优惠券"等数十个上游rpc调用,之后聚合各上游系统结果,返回给客户端对应结果。 现在新增的接入方,譬如"老年版",refer=5,就删减了组件层一些复杂的促销逻辑、凑单、白条之类,结果层也有相应删改。我们该如何支撑这种可能随时增删改模块和来源的业务架构呢? 三 原始问题点——复杂的排列组合 当多个层级均出现了多个变量时,这个系统的逻辑就变成了一个复杂的排列组合问题。 我们假如用户的入参是User对象,里面有一个字段refer表明了来源。 在重构前,代码进入主流程后,如下图,就是简单地根据refer来决定是否走哪些模块、返回哪些参数。 图中仅作为示例,实际情况,每个 fetch模块都有数千数万行代码,逻辑之复杂,各种if、else运用之嵌套,各种与或非使用之犀利,实属鲁班再世,也要夸赞几句鬼斧神工的。 大家都能看出来的问题,就是业务模块与入参变量的强耦合,如果入参refer=1,则执行业务模块A、B、C,不执行E、F、G,且返回值包含X、Y、Z,不包含U、V、W。 这样的设计不可避免带来了极大的维护的麻烦与混乱,到处都在判断是否是它,是他还是她? 那么该如何隔离层级,解耦模块与来源、来源与返回值之间的关联呢。 四 简化判断,让职责单一 上面提到了最大的问题,我们用通俗的话来讲就是:如果是A,我就做A1、A2、A3;如果是B,我就做A2,A3,A4。 那么问题就是这个主逻辑器做了太多的事情,日后被修改的概率极大,每个逻辑变动,都会导致主逻辑器的改动。 我们主要优化的点就是将这个逻辑给去掉,让主逻辑器职责单一,每个业务单元也职责单一。将上面的逻辑变成如果是A1,则来源是A时我工作,是B时我不工作,如果是A2,则来源A、B我都工作,如果是A4,则来源A我不工作,来源B我工作。 可以看到,做的事情就是当有一堆条件判断,要决定执行N个逻辑中的M个时,调用者不应该关心调用逻辑,而应由这N个逻辑自行判断自己要不要执行。 从代码实现来看,就是调用者不关心有多少个逻辑块,也不必关心日后的增减,从而实现调用的解耦。那么代码该如何写呢? 原来的是在一个方法里,fetchStock,fetchDiscount等等,首先我们要把这些实现全部去除,并统一为对接口的遍历。 改造后的代码是这样 代码很简单,注入一个接口的集合,并遍历这个集合,根据实现类返回的true、false决定是否要执行这个实现类的业务逻辑。 接口定义如下 单个逻辑单元代码如下 以上主流程的逻辑很清晰,后续随着各模块的扩展或缩减,都不需要动主逻辑,而只需要各个子模块根据自己的情况返回是否要执行自己即可。 五 动态配置,避免硬编码 通过以上的改造,我们已经完成了模块间的隔离,当有新增、删减模块时,可以做到不影响主流程,且将代码修改、影响范围控制在一个类里。 但是需求的变化总是很频繁,仅仅做到互不影响还不满足需求,我们还需要做到能够动态的控制各个模块的启用和关闭。 譬如『如果是A,我就做A1、A2、A3;如果是B,我就做A2,A3,A4』。希望能做到随时仅通过修改配置,不改代码不重新发布而做到『如果是A,我就做A1、A2;如果是B,我就做A3,A4』,完成对模块的启停。 动态配置该如何实现呢? 其实很简单,我们只需要修改execute方法,将refer==1这种规则存放于配置中心,将execute方法里的硬编码判断变成根据配置中心的配置进行判断即可。如下图: 那么ConfigCenter就是配置中心工具类,里面提供了根据key获取value的方法。配置中心大抵如注释所描述的,在应用启动时,全量从zk、etcd等拉取配置并保存在本地内存,并开启监听,当配置中心内容有变化时,更新到本地内存里。 通过观察各个模块的execute类,可以进一步发现,倘若配置中心里我们将类名作为key,模块所支持的refer集合为value时,各模块的execute方法就是完全一样的代码。那么整个方法又可以进一步抽成一个抽象类,由该抽象类来完成这个判断逻辑,如图: 当有了统一完成"开关"的父类后,则各个模块的逻辑单元就更加简单了,只需要关注自己的业务逻辑即可。 至此,最小业务单元职责则回归到纯粹的业务逻辑,不再参与流程控制的逻辑判断。同理,主流程也不再参与对各个子业务单元的判断和控制,只关注于对接口的遍历,各模块也不再产生相互影响。 六 结果层字段隔离控制 以上我们完成了业务逻辑单元的隔离,那么对于结果层该如果控制呢? 原始代码是这样的,在主流程中对各个变量进行判断,然后设置结果的值。从原始代码可以看到,即便只有一个变量refer就已经让代码可维护性变的很差,更别提真实场景下变量可能有多个时,要维护不同变量场景下返回不同的参数该多少困难。 通过对上面业务层控制的实现,我们同样可以采用类似的方式来处理结果层。 定义一个接口如下,定义boolean型方法,让各字段决定自己要不要返回。定义key、value,用来存放字段名和value。 修改主流程如下,当需要返回时,才能待返回字段的key、value存起来。 实现类如下: 以上方式展示了对结果层进行精细化控制的简单方案,实际场景中,可能涉及结果层数据结构并不是单层、对key、value的判断需要额外的属性等,其实思路都是一样的。 如果要增加入参的判断,在接口的needOut里追加要参加逻辑判断的入参即可。如果返回的结构不是单层的key-value,则在复合结构的实现类里再嵌套一层新定义的接口的遍历也可。 七 长逻辑相关处理 长逻辑这种最常见,也是最好处理的。我们经常在写一处逻辑时,刚开始很简单,几行就解决了,后来随着业务越来越膨胀,这个方法也是越来越长。终于有一天,代码长到显示器装不下它了,后面的逻辑开始出现对前面的逻辑产生影响了,这个方法就开始变的有"坏味道"。 这种相信大家都不少见,尤其在老系统中,从1千到8千行的我都见过,编辑器右边的滚动条都要看不到了。当然仅仅是长倒还好说,主要的问题是相互影响,前面赋的值,后面就被覆盖了,这种问题往往还比较隐蔽,极其影响系统的健康。 解决这种长逻辑,其实很简单,做好两件事即可,1-将方法的顺序执行变成接口遍历,2-封装。 1 如何将方法的顺序执行变成遍历呢? 这个其实在上面已经讲了,是类似的做法。将一大堆在同一个大方法里的小方法全部变成某个接口的实现类,从而将方法的顺序执行,变成对接口集合的遍历执行。后续增加或删减方法时,只操作对应的类即可,而不需要对这个大流程做修改。 一个单独的实现类就是这样的: 可能有人会问,我的各个方法是有先后顺序的,你用了接口集合,该怎么控制顺序呢,从上图的Order注解可以看到,这个就是控制在接口实现类的顺序的,值越小,在List里越靠前。 2 如何理解封装呢? 这个更简单,之前不是说代码长了易出现值被后面的逻辑覆盖,那么就以某个最小参数为一个类,所有对他的增删改都控制在一个类,完成对某参数、对象的封装控制。而不要散落各地去修改一个参数的值。 八 带中断的长逻辑处理 最后一个问题,如果带有流程中断的情况。如图,一个长逻辑,在某些条件被中断了,中断后后面的逻辑自然是走不到了。那么之前的对接口集合遍历方式还能用吗? 自然是可以用的,不过就要稍加改造,让实现类的方法返回一个boolean值,当false时,中断这个循环流程即可,这样后面的逻辑就走不到了。 如果不是要中断,而是某条件下执行自己,某条件下跳过自己,这个就往上看看文章的第4段。 最后 本文通过一些例子,描述了一些场景下对系统的改造方式,由于京东APP后台逻辑复杂,以上场景仅覆盖了部分典型场景,未全部写出改造点,当然还有一部分是特有的非典型问题,可能大部分用户碰不到的场景,也未写出。 如果有遇到类似场景,可参考文中的一些方式进行处理。如果有问题,或有建议,亦可联系作者wuweifeng10@jd.com。

优秀的个人博客,低调大师

区块链技术融合成云计算未来趋势

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 区块链的众多优势使其可以很好地解决现有一些技术所面临的瓶颈问题,利用这些优势和传统云计算技术相结合,将促进基于区块链的分布式云计算领域的一些突破和应用,为大规模的应用打下基础。 最近几年,区块链作为新兴的技术引起了广泛的关注。区块链可以应用的领域非常广,包含支付、身份识别、云计算、物品溯源、游戏、投票、医疗等。众多传统的技术也可以和区块链技术相结合发挥更大的作用,比如在传统的云计算领域,将云计算和区块链结合起来可以实现更高效、更经济、更安全可信的分布式云计算。 云计算及所面临的问题 云计算是一种基于互联网的计算方式。通过这种方式,共享软硬件资源和信息,可以按需求提供给计算机各种终端和其他设备。云计算是继上世纪80年代大型计算机到客户端—服务器的大转变之后的又一巨变。用户不再需要了解“云”中基础设施的细节,不必具有相应的专业知识,也无需直接进行控制。云计算描述了一种基于互联网的新IT服务增加、使用和交付模式,通常涉及通过互联网来提高动态易拓展且经常虚拟化的资源。 然而,云计算技术的发展也存在不少痛点。 现有云计算市场极度中心化,市场份额由少数几家科技巨头依靠自身高度集中化的服务器资源垄断了整个云计算市场,借助市场力量享受高额利润,进而导致算力服务价格居高不下。BOINC(伯克利开放式网络计算平台)是目前最为主流的分布式计算平台,为众多的数学、物理等学科类别的项目所使用,但是由于这是基于分布在世界各地的志愿者的计算资源而形成的分布式计算平台,缺乏足够的志愿者来贡献算力。 分布式云计算的良好平台 桌面网格的思想是收集互联网上未充分利用的计算机资源,在一个分布式虚拟的超级计算机上,以极小成本执行大规模并行及分布式应用程序。 桌面网格计算技术有三个功能使其成为完全分布式云计算的良好平台:***是韧性,如果某些节点出现故障,计算仍能继续在其他工作节点上运行;第二是效率,即使计算节点多种多样,应用程序仍可以获得***性能;第三是易于部署,无需特定配置即可使用任意节点,甚至包括那些位于网络边缘的节点。这使得包括传统的高性能计算集群、云基础设施及个人电脑等计算资源的桌面网格成为组合混合基础设施的***解决方案。 然而,桌面网格仍然存在一些重要的问题,比如难以计算各个节点对网络作出的贡献,从而缺少激励机制,难以撮合需求与计算资源的匹配等。 区块链技术的出现,可以很好地解决这些问题,比如通过贡献证明协议提供可证明的共识、可追溯性和信用机制。 基于区块链的分布式云计算 基于区块链的分布式云计算基础设施将允许按需、安全和低成本地访问***竞争力的计算基础设施。而分布式应用程序DApps则可以通过分布式云计算平台自动检索、查找、提供、使用、释放所需的所有计算资源,如应用程序、数据和服务器。通过简化访问服务器的方式,分布式云计算大大降低了数据中心的热能损耗,同时使得数据供应商和消费者更容易获得所需计算资源。 传统区块链,如比特币和以太坊依赖于工作量证明机制(PoW),以确保区块链上参与者之间发生的代币交易被大量节点采用的加密挑战所验证。而基于区块链的分布式云计算则可以采用贡献证明协议,即通过链外行为,如实时提供数据集、传输文件、执行计算、提供专业服务等活动引发参与者之间的代币交易。 因此,需要一个新的协议来证明贡献已经准确无误地发生,且相应的代币交易可以在区块链上进行。我们称这种共识机制为贡献证明机制。有几个采用相似协议的平台如GridCoin、FatCom、FileCoin,它们允许在区块链和链外资源之间建立共识。例如,GridCoin提出了研究证明来奖励那些捐赠了部分计算机时间给生物医学研究,以及探索宇宙等伟大科学计算的志愿者。相比较而言,贡献证明将更加通用,允许验证更多的行为。 在分布式系统中可以使用一种匹配算法,通过相关描述将一个资源请求和一个资源供应进行匹配。在设计分布式云平台时,匹配算法是资源配置中的一个基本构建块。它基本上解决了“我可以在这台机器上运行这个任务吗”的问题。我们通过iEx.ec区块链存储智能合约来描述计算资源的特征,如内存容量、CPU类型、磁盘空间等。有些合约描述的是运行一个任务或部署一个虚拟机实例的要求(如最小磁盘空间、内存、GPU运行的要求、预计管理程序等)。匹配描述语言已经在一些学术论文中得到详述,并在软件中得到了应用。 在分布式系统中,调度算法会分配一些任务在相关计算资源上执行。调度程序是分布式计算系统的一个重要组成部分,应用程序执行的性能主要取决于它的有效性。调度程序面临的一个特别挑战是设计多标准调度,即一个算法中有多个策略来选择计算资源和调度任务。 基于区块链的分布式云计算的技术不仅仅存在于理论中,众多采用这些技术的应用项目如Golem、iExe、cSONM等已取得一些进展。Golem希望建立在以太坊上的去中心化的GPU计算资源租赁平台;cSONM正在打造通用的去中心超级计算机;法国区块链技术公司iExec为所有计算资源相关的供应商(计算服务商、数据供应商、应用程序供应商)提供了一个资源共享交易的可信平台。融入了独有的贡献证明共识协议和英特尔***的安全可信技术(Intel SGX)来确保平台的可信度和平台上数据的安全性,支持从高性能计算到物联网在内的多个领域的应用程序。 区块链的众多优势使其可以很好地解决现有一些技术所面临的瓶颈问题,利用这些优势和传统云计算技术相结合,将促进基于区块链的分布式云计算领域的一些突破和应用,为大规模的应用打下基础。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册