首页 文章 精选 留言 我的

精选列表

搜索[学习笔记],共10005篇文章
优秀的个人博客,低调大师

MongoDB学习笔记(一)--基础

Insert MongoDB在执行插入时,首先会将插入的数据转换成BSON格式。然后MongoDB数据库会对BSON进行解剖,并检查是否存在_id建。 >doc = { "_id" : 1, "author" : "yyd", "title" : "MongoDB Test", "text" : "this is a test", "tags" : [ "love", "test" ], "comments" : [ { "author" : "yyd_guest", "comment" : "yes" }, { "author" : "yyd_admin", "comment" : "no" } ] } > db.yyd.insert(doc); Query 全部查找 返回除了 tags 字段外的所有字段 返回 tags = test 除了 comments 的所有列 返回 id=1 的 title 字段 <, <=, >, >= 大于 $gt、小于 $lt、大于等于 $gte、小于等于 $lte $all $all 操作类似$in 操作,但是不同的是,$all 操作要求数组里面的值全部被包含在返回的记录里面。 $exists $exists 操作检查一个字段是否存在。 $exists:true代表返回存在这个键的值。 $exists:false代表返回不存在这个键的值。 $mod > db.user.find("this._id%2==1"); > db.user.find({_id:{$mod:[2,1]}}); 两句话一样的效果。 $ne $ne 意思是 not equal,不等于。 $in $in 操作类似于传统关系数据库中的 IN。 $nin $nin 跟$in 操作相反。 $or $nor $nor 跟$or 相反。 $size $size 操作将会查询数组长度等于输入参数的数组。 skip 跳过前 2 条记录。 limit 每页返回 3 条记录 sort() sort()方法对返回记录集按照指定字段进行排序返回,1 表示升序,-1 表示降序。 count() count()方法返回查询记录的总数目。 Remove Update update() db.collection.update( criteria, objNew, upsert, multi ) 参数说明: Criteria:用于设置查询条件的对象 Objnew:用于设置更新内容的对象 Upsert:如果记录已经存在,更新它,否则新增一个记录 Multi:如果有多个符合条件的记录,全部更新 注意:默认情况下,只会更新第一个符合条件的记录 save() 如果存在更新它,如果不存在,新增记录。 $inc 增加1,对int等有效。 对一个_id=3 的 user 的年龄进行加 1,两种方法。 $set { $set : { field : value } } 把 field 的值设置成 value,当 field 不存在时,增加一个字段,类似 SQL 的 set 操作,value 支持所有类型。 $unset { $unset : { field : 1} } 删除给定的字段 field。 $push { $push : { field : value } } 如果 filed 是一个已经存在的数组,那么把 value 追加给 field; 如果 field 原来不存在,那么新增 field 字段,把 value 的值赋给 field; 如果 field 存在,但是不是一个数组,将会出错。 $pushAll { $pushAll : { field : value_array } } 功能同$push,只是这里的 value 是数组,相当于对数组里的每一个值进行$push操作。 $addToSet { $addToSet : { field : value } } 如果 filed 是一个已经存在的数组,并且 value 不在其中,那么把 value 加入到数组; 如果 filed 不存在,那么把 value 当成一个数组形式赋给 field;$pop 如果 field 是一个已经存在的非数组类型,那么将会报错。 $pop { $pop : { field : 1 } } 删除数组中最后一个元素 { $pop : { field : -1 } } 删除数组中第一个元素 $pull { $pull : { field : _value } } 如果 field 是一个数组,那么删除符合_value 检索条件的记录; 如果 field 是一个已经存在的非数组,那么会报错。 $pullAll { $pullAll : { field : value_array } } $rename { $rename : { old_field_name : new_field_name } 重命名指定的字段名称。 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3557414.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

网络及Web学习笔记

IT人一提到说到网络,必定且首先就要提到的就是TCP/IP协议了。这是基本的网络通信层的协议。而这个协议,是网路平台七层网络协议中的一个点。网路协议定义了从用户数据和请求的处理打包/解包的TCP,UDP协议,到分包发送数据的IP协议,再到物理层的实现。一大堆的概念,一本本大砖头般的书,就是学这方面的人都受不了,更不用说只是想了解下网络过程的一般用户了。而更为人熟知的,该是伯纳斯李及其万维网了。万维网乃是现在最大的网络了,而一开始,网络是一点点连接起来的。 那么网络到底是什么呢?计算机刚兴起时,其主要工作就是用来做大规模计算的。其服务方式也是由大型服务机To客户机的形式。客户端进行数据请求,服务机响应处理然后再由客户机显示结果。后来,才有了机器与机器之间需要数据共享的问题。如果就那么几台机器,那么拷贝一份数据也没什么。但是当一个集群的机器需要共享数据,特别是涉及到实时数据时,显然,用拷贝的方式不能满足需求了。所以才有了计算机之间的通信。 而在一开始,不同硬件厂商——IBM, HP, SUN都定义了自己的通信协议和实现。同一个硬件厂商的硬件通信没问题,但是不同厂商的硬件却不能通信。所以才有了后来的标准化的通信协议。而万维网的兴起是在个人计算机兴起后,伯纳斯李的创造性发明。由此,计算机不再是一个个单独的存在,而是通过网络互通互联在一起的一个网络了。 首次接触到通信协议这种东西,往往茫然不知其所谓。记得我第一次了解到这些协议的时候就总是想不通,通过这些协议性的规定就可以实现数据的传输了吗?这是莫名其妙。后来才理解了,传输数据是由物理层的介质——光纤、无线网络——来实现的。而协议是通信双方约定好的,数据传输的格式。以约定好的格式来传输,双方都方便。数据发送方按照协议规定格式进行数据打包然后发送,而接收方就可以按照这个格式进行快速解包了。或者,可以这么去理解,协议就是一个双方都知道的其格式的空表格,发送方往表格空白处填充数据,而接收方,从表格中取出数据。由于双方都知道表格的格式,所以,要发什么数据,要取什么数据,直接去找所需的栏目就可以了。 现在的网络,是一个去中心化的网络。网络中的一个个节点通过IP地址定位。主要通信则发生在服务器与普通网络入口(pc机,手机)之间。所谓网络应用程序就是客户端(Client)软件与服务器端(Server)的通信了。这就是所谓的CS架构模型。而当下大热的Web,提倡用浏览器(Browser)代替客户端(Client)的新模型——BS架构模型。其中,最主要的通信就是浏览器与服务器程序的通信。也就是HTTP通信协议。这些整个过程中,HTTP协议负责对请求和响应的打包与解包。TCP协议负责的是机器与机器之间的通信连接,即用户端机器与服务器端机器的连接。而IP协议负责了用户机器与客户端机器见通信路径的选择,数据的分包发送等。TCP协议是建立在IP协议的基础上的。 作者:何妍 来源:51CTO

优秀的个人博客,低调大师

MySQL Group Replication 学习笔记

作者简介 刘伟 云和开创高级顾问 题记:group replication作为mysql官方,在5.7版本阶段开发的,innodb的分布式数据库架构,从发布开始就有很多关注,下文是我对目前为止的材料以及实验的一些总结。 主要资料来源是官方blog:http://mysqlhighavailability.com/ group replication架构 group replication(后文简称GR)实现的分布式数据库架构,底层的分布式基础是Paxos(出于行文限制,此处不单独交代Paxos)。通过Paxos来保证分布式数据库系统中,事务的提交顺序。 每次一个事务在一个节点提交的时候,就会发送所修改的数据到所有节点,检查期间是否有修改冲突(比如修改了别的节点已经修改并提交成功的事务的数据),如果发现冲突,本事务回滚。如果没有冲突,则可以直接提交成功。 对于非执行事务的远程节点,如果事务判断为执行成功,远程发送过来的数据,会被保存在本地的一个relay log里面(注意,与常规主从同步使用的relay log不是同一组),之后由从库的applier线程采用正常主从同步(目前已经支持LOGICAL_CLOCK并行执行)的方式执行掉对应的relay log。 这里有一个临界点,如果一个事务刚刚被写入relay log,还没有来得及执行掉,这时候有一个事务的执行涉及了相关的数据,那么后来的这个事务在执行阶段可以执行成功,但是必定会在提交阶段失败的。 使用建议 根据目前的状况看,GR使用的时候,应该做到以下几点以对性能优化以及减少分布式冲突。 节点分区 虽然是分布式,但并非采用纯粹的随机或者轮询来对节点访问,而是采用一些分区算法,保证指定的主键必定发生指定的实例上。 这点主要目的是避免出现事务在分布式系统中的冲突,导致不可控的事务回滚。 建议的分区算法是一致性哈希,方便节点的添加删除,以及负载均衡。 控制单次事务操作数据量 即控制事务所涉及修改(增,删,改)的数据,主要原因有两点: 一是,多节点之间的冲突检验需要传输相关的数据,如果单次事务量过大,会导致单次事务的检查时间增长,由于分布式事务的全局序列性,单个慢事务会导致全局的低速。 二是,由于最终多节点的同步,还是通过每个节点自己的relay线程来执行的,如果有大事务,会导致relay线程执行不到后面的事务,导致事务延迟,并导致可能会产生的分布式事务回滚。 周边功能介绍 主要组件简介 capture 追踪当前正在执行的事务的上下文 applier 执行远程事务传输到本地的日志到本地数据库 recovery 负责分布式环境下的节点恢复,以及相关的数据回追,失败处理等 失败节点检测 只有认为无法连接的节点才会从集群中自动踢走。 机制如下: 不可用本身的发觉,是依赖消息通讯的超时决定的。即如果节点对另外的节点的消息发送超时,则认为远程节点不可用。 对于正常节点,如果认为一个其他节点不可用了,首先会标记为不可用,之后与其他节点沟通,如果确认这个节点确实其他节点都认为不可用,则实际设置为不可用节点。 如果一个节点发现自生连接不到其他所有的实例(认为其他节点全部死亡),则这个节点本身之后的事务执行,就不会采用分布式算法而是退回传统的单节点事务模式。 另外,如果同时失败节点数过多(超过一半),为了避免脑裂,分布式算法会拒绝运行,需要人工介入恢复,这也是需要注意的一点。 节点状态 ONLINE 节点状态正常,可以正常执行事务 RECOVERING 正在接收种子节点的日志 OFFLINE 节点之前注册了,但并不属于当前集群(可能节点已经失败) ERROR 恢复阶段,阶段1或者阶段2失败 UNREACHABLE 节点不可达,一般出现在通讯超时的情况 失败恢复 这里说的,主要把一个节点,加入到已有集群的过程,而非单实例的崩溃恢复。 -->阶段1 第一阶段,新实例选择集群中的一个实例作为种子实例,这个种子实例会发送所有新实例到加入集群为止缺失的日志数据到新实例,这个的执行,是通过简单的主从同步日志的方式做的。 执行阶段1的期间,新实例还会一直持续接收当前正在活跃(实例加入集群后)的事务的日志,补全从种子实例没有传输的增量日志。 当种子实例传输日志完成之后,第一阶段就完毕了。 这一阶段,如果种子实例出现问题崩溃或者失败了,新实例会自动选取实例里面别的实例替代。 -->阶段2 这一阶段,新实例合并之前的活跃事务到当前数据库,当残余的事务量接近0(新事务一直在别的实例发生,只能非常接近0而很难完全追上)的时候,实例在集群中的状态,就会被修改为ONLINE了。 流量控制 mysql的GR,全局所有的实例都拥有所有的数据,也实际上需要运行所有的写入流量,如果有某一个实例相对较慢,如果时间持续下去,这个节点可能出现延迟,极端情况下,可能越追越远。 流量控制试图做到的事情是,保障整个集群节点之间,最快的节点和最慢的节点之间的事务差距不要太大。 实际需要控制的,有两个队列,一个是事务提交时候的冲突检查队列,一个是事务实际执行的relay日志队列 DDL执行 DDL先天上并不支持事务化,也就是多节点执行的时候,如果有几个节点失败,并不会导致已经执行成功的节点回滚DDL,对于DDL的执行结果需要单独验证,以避免多节点表不一致。 IP白名单 这个主要是安全方面的考虑,之允许指定来源的ip作为复制节点与集群通讯。 一些限制 使用group replication有以下一些限制。 所有涉及的数据都必须发生在InnoDB存储引擎的表内。 所有的表必须有明确的主键定义。 网络地址只支持IPv4。 需要低延迟,高带宽的网络。 目前集群限制最多允许9个节点。 必须启用binlog。 binlog 格式必须是row格式。 必须打开gtid模式。 复制相关信息必须使用表存储。 事务写集合(Transaction write set extraction)必须打开。(这个目前与savepoint冲突,这也是导致mysqldump无法备份GR实例的原因) log slave updates必须打开。 binlog的checksum目前不支持。 由于事务写集合的干扰,无法使用savepoint。 SERIALIZABLE 隔离级别目前不支持。 对同一个对象,在集群中不同的实例上,并行地执行DDL(哪怕是相互冲突的DDL)是可行的,但会导致数据一致性等方面的错误,目前阶段不支持在多节点同时执行同一对象的DDL。 外键的级联约束操作目前的实现并不完全支持,不推荐使用。 几个名词 Donor:用于节点恢复时候,传输历史binlog的节点。Group Configuration:集群里已经配置的实例列表。Group Membership Service:维护一致性view变更的服务,作用于节点的新增,退出,以及当前视图的维护工作。Joiner:将要加入到集群但状态尚未恢复到ONLINE的新节点。Seed:负责触发新节点加入集群动作的实例。View:当前集群活跃实例的列表。 本文出自数据和云公众号,原文链接

优秀的个人博客,低调大师

Android Drawable绘图学习笔记

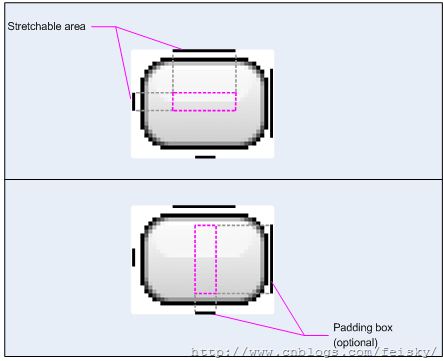
如何获取 res 中的资源 数据包package:android.content.res 主要类:Resources Android SDK中的简介:Class for accessing an application’s resources.Class for accessing an application’s resources. This sits on top of the asset manager of the application (accessible through getAssets()) and provides a higher-level API for getting typed data from the assets. 其主要接口按照功能,划分为以下三部分: getXXXX() 例如: int getColor(int id) Drawable getDrawable(int id) String getString(int id) 直接获取res中存放的资源 InputStream openRawResource(int id) 获取资源的数据流,读取资源数据 void parseBundleExtras(XmlResourceParser parser, Bundle outBundle) 从XML文件中获取数据 Resource为每种资源提供了相应的接口来获取这种资源,除了可以直接获取资源外,还额外提供了以数据流的方式获取资源,这在以后的应用程序开发中会经常使用,那么如何获取Resources了,如下:Resources r = this.getContext().getResources(); 如何获取资源中的画图对象 数据包package:android.graphics.drawable 主要类:Drawable Android SDK中的简介:A Drawable is a general abstraction for “something that can be drawn.” Most often you will deal with Drawable as the type of resource retrieved for drawing things to the screen; the Drawable class provides a generic API for dealing with an underlying visual resource that may take a variety of forms. 看了以上简介,发现Drawable是个virtual class,具体如何画图,需要具体分析Drawable的子类,例如:BitmapDrawable Android SDK中的简介:A Drawable that wraps a bitmap and can be tiled, stretched, or aligned. You can create a BitmapDrawable from a file path, an input stream, through XML inflation, or from a Bitmap object. It can be defined in an XML file with the<bitmap>element. 其主要接口如下: BitmapDrawable() BitmapDrawable(Bitmap bitmap) BitmapDrawable(String filepath) BitmapDrawable(InputStream is) void draw(Canvas canvas) Draw in its bounds (set via setBounds) respecting optional effects such as alpha (set via setAlpha) and color filter (set via setColorFilter). final Bitmap getBitmap() final Paint getPaint() Drawable是个抽象类,在BitmapDrawable中我们就看到位图的具体操作,在仔细看下BitmapDrawable的构造函数,我们就会发现与Resource中的openRawResource()接口是相对应的,就可以通过以下方法来获取位图: Resources r = this.getContext().getResources(); Inputstream is = r.openRawResource(R.drawable.my_background_image); BitmapDrawable bmpDraw = new BitmapDrawable(is); Bitmap bmp = bmpDraw.getBitmap(); Paint 数据包package:android.graphics Android SDK中的简介:The Paint class holds the style and color information about how to draw geometries, text and bitmaps. 主要就是定义:画刷的样式,画笔的大小/颜色等。 Typeface 数据包 package:android.graphics Android SDK中的简介:The Typeface class specifies the typeface and intrinsic style of a font. 主要就是定义:字体。 核心类显示资源 数据包package:android.graphics 主要类:Canvas Android SDK中的简介:The Canvas class holds the “draw” calls. To draw something, you need 4 basic components: A Bitmap to hold the pixels, a Canvas to host the draw calls (writing into the bitmap), a drawing primitive (e.g. Rect, Path, text, Bitmap), and a paint (to describe the colors and styles for the drawing). 按照结构的功能,将主要接口分为以下3部分: boolean clipXXXX() Region区域操作:DIFFERENCE INTERSECT REPLACE REVERSE_DIFFERENCE UNION XOR void drawXXXX()画图函数 void rotate() void scale() void skew() void translate() 画布操作函数 Region在这里需要特殊说明下:Region就是一个区域,也就是画布(Canvas)中的有效区域,在无效区域上draw,对画布没有任何改变。 Drawable类 Drawable是一个通用的抽象类,它的目的是告诉你什么东西是可以画的。你会发现基于Drawable类扩展出各种绘图的类,见下面的表格,当然你可以继承它来创建你自己的绘图类. Interfaces Animatable Interface that drawables suporting animations should implement. Drawable.Callback Implement this interface if you want to create an animated drawable that extendsDrawable. Classes AnimationDrawable An object used to create frame-by-frame animations, defined by a series of Drawable objects, which can be used as a View object's background. BitmapDrawable A Drawable that wraps a bitmap and can be tiled, stretched, or aligned. ClipDrawable A Drawable that clips another Drawable based on this Drawable's current level value. ColorDrawable A specialized Drawable that fills the Canvas with a specified color, with respect to the clip region. Drawable A Drawable is a general abstraction for "something that can be drawn." Most often you will deal with Drawable as the type of resource retrieved for drawing things to the screen; the Drawable class provides a generic API for dealing with an underlying visual resource that may take a variety of forms. Drawable.ConstantState DrawableContainer DrawableContainer.DrawableContainerState GradientDrawable A Drawable with a color gradient for buttons, backgrounds, etc. InsetDrawable A Drawable that insets another Drawable by a specified distance. LayerDrawable A Drawable that manages an array of other Drawables. LevelListDrawable A resource that manages a number of alternate Drawables, each assigned a maximum numerical value. NinePatchDrawable A resizeable bitmap, with stretchable areas that you define. PaintDrawable Drawable that draws its bounds in the given paint, with optional rounded corners. PictureDrawable Drawable subclass that wraps a Picture, allowing the picture to be used whereever a Drawable is supported. RotateDrawable A Drawable that can rotate another Drawable based on the current level value. ScaleDrawable A Drawable that changes the size of another Drawable based on its current level value. ShapeDrawable A Drawable object that draws primitive shapes. ShapeDrawable.ShaderFactory Base class defines a factory object that is called each time the drawable is resized (has a new width or height). StateListDrawable Lets you assign a number of graphic images to a single Drawable and swap out the visible item by a string ID value. TransitionDrawable An extension of LayerDrawables that is intended to cross-fade between the first and second layer. 有三种方法可以定义和实例化一个Drawable:保存一个图片到你工程资源中,使用XML文件来描述Drawable属性或者用一个正常的类去构造。下面我们将讨论两种技术(对一个有开发经验的开发者来说构造并不是最新的技术)。 从资源图像文件中创建 一个比较简单的方法是添加一个图片到你的程序中,然后通过资源文件引用这个文件,支持的文件类型有PNG(首选的) JPG(可接受的)GIF(不建议),显然这种对于显示应用程序的图标跟来说是首选的方法,也可以用来显示LOGO,其余的图片可以用在例如游戏中。 把一个图片资源,添加你的文件到你工程中res/drawable/目录中去,从这里,你就可以引用它到你的代码或你的XML布局中,也就是说,引用它也可以用资源编号,比如你选择一个文件只要去掉后缀就可以了(例如:my_image.png 引用它是就是my_image)。 注意:SDK指出,为了缩小图片的存储空间,在Build的时候又可能对图片进行压缩,如果不想被压缩,可以将图片放在res/raw/目录中。 SDK给出的例子: LinearLayout mLinearLayout; protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); // Create a LinearLayout in which to add the ImageView mLinearLayout = new LinearLayout(this); // Instantiate an ImageView and define its properties ImageView i = new ImageView(this); i.setImageResource(R.drawable.my_image); i.setAdjustViewBounds(true); // set the ImageView bounds to match the Drawable's dimensions i.setLayoutParams(new Gallery.LayoutParams(LayoutParams.WRAP_CONTENT, LayoutParams.WRAP_CONTENT)); // Add the ImageView to the layout and set the layout as the content view mLinearLayout.addView(i); setContentView(mLinearLayout); } 获取Drawable对象: Resources res = mContext.getResources(); Drawable myImage = res.getDrawable(R.drawable.my_image); 注意:保持每个资源类型的一至,可以保证你项目状态的一致性,就不用担心有许多不同类型的对象来实例化它。例如:如果使用相同的图像资源来实例化两个Drawable对象。然后修改一个Drawables的属性(例如alpha),然后不幸得是这个效果也会出现在另一个对象上去。所以当处理同一个资源的多个实例对象时,不是直接转换为Drawable,而是应该执行tween animation 如何添加资源到ImageView: <ImageView android:layout_width="wrap_content" android:layout_height="wrap_content" android:tint="#55ff0000" android:src="@drawable/my_image"/> 从XML文件中创建 到如今,你应该比较熟悉按Android的原则去开发一个用户接口,因此,你也应该理解了定义一个XML文件对于对象的作用与灵活的重要性。这个理念无数次用于Drawables. 如果你想创建一个Drawable对象,而这个对象并不依赖于变量或用户的交换,把它定义到XML中去应该是一个不错的方法。即使你期望在你的应用程序中改变其属性来增加用户体验。你应该考虑把对象放入XML中,因为你可以随时修改其属性。 当你在你的XML中定义了一个Drawable,保存这个XML文件到你工程目录下res/drawable目录中,然后通过调用Resource.getDrawable()来检索并实例化,传递给它XML文件中的资源ID号。任何Drawable的子类都支持inflate这个方法,这个方法会通过XML来实例化你的程序。任何Drawable都支持XML的扩展来利用特殊的XML属性来帮助定义对象的属性,可以查看任何Drawable子类文档来看如何定义XML文件。 如下定义了一个TransitionDrawable:An extension of LayerDrawables that is intended to cross-fade between the first and second layer. It can be defined in an XML file with the<transition>element. Each Drawable in the transition is defined in a nested<item>. 有关TransitionDrawable的详细信息查看http://androidappdocs.appspot.com/reference/android/graphics/drawable/TransitionDrawable.html。 将其定义在res/drawable/expand_collapse.xml: <?xml version="1.0" encoding="utf-8"?> <transition xmlns:android="http://schemas.android.com/apk/res/android"> <item android:drawable="@drawable/pic1"/> <item android:drawable="@drawable/pic2"/> </transition> 下面实例化并处理: public class MainActivity extends Activity { /** Called when the activity is first created. */ @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.main); Resources res=getResources(); TransitionDrawable trans=(TransitionDrawable )res.getDrawable(R.drawable.expand_collapse); ImageView image = (ImageView)findViewById(R.id.ImageView01); image.setImageDrawable(trans); trans.startTransition(3000); } } ShapeDrawable 当你想去画一些动态的二维图片,一个ShapeDrawable对象可能会对你有很大的帮助。通过ShapeDrawable,你可以通过编程画出任何你想到的图像与样式。 ShapeDrawable继承了Drawable, 所以你可以调用Drawable里有的函数,比如视图的背景,通过setBackgroundDrawable()设置。当然,你可以在自定义的视图布局中画你的图形,因为ShapeDrawable有自己的draw()方法。你可以在View.OnDraw()方法期间创建一个视图的子类去画ShapeDrawable。 ShapeDrawable类(像很多其他Drawable类型在android.graphics.drawable包)允许你定义drawable公共方法的各种属性。有些属性你可以需要调整,包括透明度,颜色过滤,不透明度,颜色。 例子: public class CustomDrawableView extends View { private ShapeDrawable mDrawable; public CustomDrawableView(Context context) { super(context); int x = 10; int y = 10; int width = 300; int height = 50; mDrawable = new ShapeDrawable(new OvalShape()); mDrawable.getPaint().setColor(0xff74AC23); mDrawable.setBounds(x, y, x + width, y + height); } protected void onDraw(Canvas canvas) { mDrawable.draw(canvas); } 显示: CustomDrawableView mCustomDrawableView;protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); mCustomDrawableView = new CustomDrawableView(this); setContentView(mCustomDrawableView);} 在XML中定义方法:如果你想用XML文件配置来取代原有布局来画自定义的drawable,于是你自定义的Drawable类必须重载view (Context, AttributeSet) 构造函数。 <com.example.shapedrawable.CustomDrawableView android:layout_width="fill_parent" android:layout_height="wrap_content" /> NinePatchDrawable NinePatchDrawable 绘画的是一个可以伸缩的位图图像,Android会自动调整大小来容纳显示的内容。一个例子就是NinePatch为背景,使用标准的Android按钮,按钮必须伸缩来容纳长度变化的字符 NinePatchDrawable是一个标准的PNG图像,它包括额外的1个像素的边界,你必须保存它后缀为.9.png,并且保持到工程的res/drawable目录中。 这个边界是用来确定图像的可伸缩和静态区域。你可以在左边和上边的线上画一个或多个黑色的1个像素指出可伸缩的部分(你可以需要很多可伸缩部分),它的相对位置在可伸缩部分相同,所以大的部分总是很大的。 你还有可以在图像的右边和下边画一条可选的drawable区域(有效的,内边距线)。如果你的视图对象设置NinePath为背景然后指定特殊的视图字体,它将自行伸缩使所有的文本来适应根据右线与底部线设计好的区域(如果有的话),当然内边距线不包括其中,Android可以使用左边的线与上面的线来定义一个drawable区域。 我们来澄清一下这两条不同的线,左边跟顶部的线来定义哪些图像的像素允许在伸缩时被复制。底部与右边的线用来定义一个相对位置内的图像,视图的内容就放入其中。 使用方法: <Button id="@+id/tiny" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_alignParentTop="true" android:layout_centerInParent="true" android:text="Tiny" android:textSize="8sp" android:background="@drawable/my_button_background"/><Button id="@+id/big" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_alignParentBottom="true" android:layout_centerInParent="true" android:text="Biiiiiiig text!" android:textSize="30sp" android:background="@drawable/my_button_background"/> 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/01/08/1642567.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

虚拟化技术学习笔记

ECS 用的KVM。 任何计算机的问题都可以通过另一层的重定向解决。 虚拟技术:Xen, KVM, Hyper-V, Vmware ESX Server, VMware workstation, VirtualBox Binary Translation: 因为一开始X86不支持虚拟化, 实现复杂,性能损失 硬件辅助虚拟化:2004年 Intel和AMD 发布新的CPU规范,支持虚拟化。 问题: 1,ECS主要就是用的虚拟化技术吧,ECS产品本身和盘古有什么关系呢?这张图感觉有点需要推敲。 2,一个特定的ECS在阿里云里面,如果相应的物理机发生故障,如何切换?

优秀的个人博客,低调大师

Learning ELK stack 学习笔记

不错的入门书Learning ELK stack 第三章: Logstash插件类型分为四类: Input Filter Output Codec Logstash input类的file插件维护了一个sincedb文件追踪监控操作文件的当前位置。默认写入$HOME/.sincedb*,游标及读取频率可以通过配置修改。 file的两个配置属性:sincedb_path,sincedb_write_interval(默认15秒读取一次文件) 这里还涉及另一个配置 start_position => "beginning" 或"end"(默认),使用beginning,如果移除了.sincedb,将重新读取历史数据,造成数据重复。 lumberjack和logstash forwarder(轻量化的logstash)使用lumberjack协议打包日志 redis经常做为logstash forwarder 与logstash的中间人角色,在高负载系统上提供获取日志的服务。 Logstash outpu类型插件: 重点是elasticsearch,email,kafka,lumberjack,redis, Logstash filter类型插件: date,drop,grok解析非结构化的日志转换成结构化,mutate重命名,移除,替换,修改字段,转换字段类型,合并字段等 Logstash codec类型插件:编码解码日志 json,mutliline 第五章节: elasticsearch > indices > documents(json) > fields(_type,mapping) pattern=>"logstash-%{+YYYY.MM.dd}"(默认index) shard:index的物理存储位置,支持Primary shard and replica shard, 默认每个document使用5个shard replica shard分布在各个节点上,可以failover与平均负载 cluster > nodes :三种角色 =>data node =>master node =>routing node & load banlancer node elasticsearch api $curl -X '://://?'d '' VERB:GET, POST, PUT,DELETE, HEAD PROTOCAL:http,https PATH:/index/type/id OPERATION_NAME:_search, _count, and so on QUERY_STRING:?pretty for pretty print of JSON documents BODY:This makes a request for body text. 查看指定index的document thinkt@linux-pw37:~> curl -XGET 'http://192.168.56.101:9200/logstash-2016.09.09/_search?pretty' { "took" : 107, "timed_out" : false, "_shards" : { "total" : 5, "successful" : 5, "failed" : 0 }, "hits" : { "total" : 1, "max_score" : 1.0, "hits" : [ { "_index" : "logstash-2016.09.09", "_type" : "logs", "_id" : "AVf3tVjYndkMLGPlmtnx", "_score" : 1.0, "_source" : { "message" : "2016-09-09,770.099976,773.244995,759.659973,759.659973,1812200,759.659973", "@version" : "1", "@timestamp" : "2016-09-09T00:00:00.000Z", "path" : "/home/vagrant/table.csv", "host" : "localhost.localdomain", "Date" : "2016-09-09", "Open" : 770.099976, "High" : 773.244995, "Low" : 759.659973, "Close" : 759.659973, "Volume" : 1812200, "Adj_close" : 759.659973 } } ] } } 查看所有index thinkt@linux-pw37:~> curl -XGET 'http://192.168.56.101:9200/_cat/indices?v' health status index pri rep docs.count docs.deleted store.size pri.store.size yellow open logstash-2016.03.18 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.03.17 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.03.16 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.03.15 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.07 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.08 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.09 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.08.31 5 1 1 0 8kb 8kb yellow open logstash-2016.09.01 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.08.30 5 1 1 0 8kb 8kb yellow open logstash-2016.03.21 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.14 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.09.08 5 1 1 0 8kb 8kb yellow open logstash-2016.06.15 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.09.09 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.16 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.09.06 5 1 1 0 7.9kb 7.9kb 查看集群中所有nodes thinkt@linux-pw37:~> curl -XGET 'http://192.168.56.101:9200/_cat/nodes?v' host ip heap.percent ram.percent load node.role master name 10.0.2.15 10.0.2.15 13 56 0.00 d * node-1 logstash 的elasticsearch 插件会自动创建index kibana4特性: 搜索关键字高亮 聚合类型:桶,度量 可脚本化的字段 动态展示 kibana的主项: discover,visualize,dashboard,settings discover的search box搜索记录默认最多显示500条index documents time filter支持quick,absolute,relative三种时间过滤方式,并支持定义自动刷新间隔,也可以使用histogram直方图拖动选择时间。 查询语法使用lucene语法 Lucene n. Lucene是一个非常优秀的开源的全文搜索引擎; 我们可以在它的上面开发出各种全文搜索的应用来。Lucene在国外有很高的知名度; 现在已经是Apache的顶级项目; 在国内; 搜索方式:search box 文本查询,field查询 visualize,dashboard 阻止数据丢失 logs > borker(redis,rabbit mq,amqp,zeroMQ) > logstash > elasticsearch > kibana > nginx 加固数据访问 elasticsearch,kibana使用SSL认证访问elasticsearch browser-(ssl_key_file,ssl_cert_file)->kibana->elasticsearch Elasticsearch shield(收费) Search guard(free) 系统伸缩性 horizontally scalable fast,quick,realtime inexpensive便宜的 flexable弹性灵活的 用户量及支持力度 开源的 数据保留策略 elasticsearch curator管理indeices

优秀的个人博客,低调大师

hadoop学习笔记--集群搭建

注:大家常说的ssh其实就是一个免密码访问的东西,为了简化操作的,不用每次访问其他节点重新输入密码。但是要想配置如下: 1.在每台机器上执行 ssh-keygen -t rsa,连敲三次回车键(即设置空密码) 2.然后在每台机器上都执行cd ~/.ssh,并分别把id_rsa.pub复制到authorized_keys中, 即执行 cp id_rsa.pub authorized_keys 3.然后分别把slave0,slave1的authorized_keys都复制到master主节点的authorized_keys中, 即分别在两个从节点slave0和slave1中执行 ssh-copy-id -i master 4.再分别复制到slave0,slave1中(即每一个节点的authorized_keys中都有这三个节点的密钥) 即在主节点master上执行 scp -r ~/.ssh/authorized_keys slave0:~/.ssh/ scp -r ~/.ssh/authorized_keys slave1:~/.ssh/ 此时成功。 简单测试:比如说在master上执行ssh slave0,这时候发现不需要输入密码即可转 到slave0从节点上,这时成功 hadoop-0.20.2的配置文件 hadoop-0.20.0的配置文件: core-site.xml <property> <name>fs.default.name</name> <value>hdfs://cMaster:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/home/joe/cloudData</value> </property> hdfs-site.xml <property> <name>dfs.name.dir</name> <value>/home/joe/hdfs/name</value> </property> <property> <name>dfs.data.dir</name> <value>/home/joe/hdfs/data</value> </property> <property> <name>dfs.replication</name> <value>1</value> </property> mapred-site.xml <property> <name>mapred.job.tracker</name> <value>cMaster:9001</value> </property> hadoop-0.20.2集群操作命令: hadoop-0.20.2的集群操作命令 上传本地文件至hdfs:[rio@cMaster hadoop-0.20.2]#bin/hadoop dfs -put /home/rio/input/* /in 用WordCount计算数据:[rio@cMaster hadoop-2.2.0]#bin/hadoop jar hadoop-0.20.2-examples.jar wordcount /in /out/wc-01 hadoop-2.2.0的配置文件: hadoop-2.2.0的配置文件: core-site.xml <property> <name>fs.defaultFS</name> <value>hdfs://cMaster:8020</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/home/joe/cloudData</value> </property> yarn-site.xml <property> <name>yarn.resourcemanager.hostname</name> <value>cMaster</value> </property> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> mapred-site.xml(注:将mapred-site.xml.template重命名为mapred-site.xml) <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> hadoop-2.2.0进程启动命令: 启动(或关闭)全部服务:[rio@cMaster hadoop-2.2.0]#sbin/start-all.sh [rio@cMaster hadoop-2.2.0]#sbin/stop-all.sh 格式化主节点:[rio@cMaster hadoop-2.2.0]#bin/hdfs namenode -format(注:仅格式化一次) 启动主节点上的namenode:[rio@cMaster hadoop-2.2.0]#sbin/hadoop-daemon.sh start namenode 启动主节点上的resourcemanager:[rio@cMaster hadoop-2.2.0]#sbin/yarn-daemon.sh start resourcemanager 启动从节点上的datanode:[rio@cMaster hadoop-2.2.0]#sbin/hadoop-daemon.sh start datanode 启动从节点上的nodemanager:[rio@cMaster hadoop-2.2.0]#sbin/yarn-daemon.sh start nodemanager 启动日志历史查询:[rio@cMaster hadoop-2.2.0]#sbin/mr-jobhistory-daemon.sh start historyserver 查看服务是否启动:[rio@cMaster hadoop-2.2.0]#/usr/java/jdk1.8.0_71/bin/jps hadoop-2.2.0集群操作命令: 创建目录:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -mkidr /in 删除文件及目录:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -rmr /out/input 上传本地文件至hdfs:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -put /home/rio/input/* /in 查看hdfs里的文件:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -cat /in/* [rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -cat /out/wc-01/* 用WordCount计算数据:[rio@cMaster hadoop-2.2.0]#bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-example-2.2.0.jar wordcount /in /out/wc-01 当神已无能为力,那便是魔渡众生

优秀的个人博客,低调大师

Hadoop学习笔记(四):HBase

HBase是在一个HDFS上开发的面向列的分布式数据库。HBase不是关系型数据库,不支持SQL。 HTable一些基本概念 Row key 行主键, HBase不支持条件查询和Order by等查询,读取记录只能按Row key(及其range)或全表扫描,因此Row key需要根据业务来设计以利用其存储排序特性(Table按Row key字典序排序如1,10,100,11,2)提高性能。 Column Family(列族) 在表创建时声明,每个Column Family为一个存储单元。在上例中设计了一个HBase表blog,该表有两个列族:article和author。 Column(列) HBase的每个列都属于一个列族,以列族名为前缀,如列article:title和article:content属于article列族,author:name和author:nickname属于author列族。Column不用创建表时定义即可以动态新增,同一Column Family的Columns会群聚在一个存储单元上,并依Column key排序,因此设计时应将具有相同I/O特性的Column设计在一个Column Family上以提高性能。 Timestamp HBase通过row和column确定一份数据,这份数据的值可能有多个版本,不同版本的值按照时间倒序排序,即最新的数据排在最前面,查询时默认返回最新版本。如上例中row key=1的author:nickname值有两个版本,分别为1317180070811对应的“一叶渡江”和1317180718830对应的“yedu”(对应到实际业务可以理解为在某时刻修改了nickname为yedu,但旧值仍然存在)。Timestamp默认为系统当前时间(精确到毫秒),也可以在写入数据时指定该值。 Value 每个值通过4个键唯一索引,tableName+RowKey+ColumnKey+Timestamp=>value,例如上例中{tableName=’blog’,RowKey=’1’,ColumnName=’author:nickname’,Timestamp=’ 1317180718830’}索引到的唯一值是“yedu”。 存储类型 TableName 是字符串RowKey 和 ColumnName 是二进制值(Java 类型 byte[])Timestamp 是一个 64 位整数(Java 类型 long)value 是一个字节数组(Java类型 byte[])。 SHELL操作 HBase提供了丰富的访问接口,其中HBase Shell是常用的便捷方式。 • HBase Shell • Java clietn API • Jython、Groovy DSL、Scala • REST • Thrift(Ruby、Python、Perl、C++…) • MapReduce • Hive/Pig 创建表> create 'test','data1','data2' Column Family是schema的一部分,而Column不是。这里的data1和data2是Column Family。 增加记录>put 'test','1','data1:name','luc'>put 'test','1','data1:age','24'>put 'test','1','data2:height','170cm'>put 'test','1','data2:weight','65kg'>put 'test','1','data1:nickname','vichao'Column完全动态扩展,每行可以有不同的Columns。(ps:好像有点胖啊,要减肥~~) 根据RowKey查询> get 'test','1' HTable按RowKey字典序(1,10,100,11,2)自动排序,每行包含任意数量的Columns,Columns按ColumnKey(data1:age,data1:name,data1:nickname,data2:height,data2:weight)自动排序。 更新操作 查询值: >get 'test','1','data1:nickname' 更新nickname为'vic': >put 'test','1','data1:nickname','vic' 查询更新后的结果:(返回的将是vic) > get ‘blog’,’1’,’data1:nickname’ 知识点回顾:查询默认返回最近的值。 查询nickname的多个(本示例为2个)版本值 > get 'test','1',{COLUMN => 'data1:nickname',VERSIONS => 2}知识点回顾:每个Column可以有任意数量的Values,按Timestamp倒序自动排序。 如何只查询到以前的旧版本呢,需要借助Timestamp >get 'test','1',{COLUMN=>'data1:nickname',TIMESTAMP=>1373707746997} 知识点回顾:TabelName+RowKey+Column+Timestamp=>Value 删除记录 delete只能删除一个column >delete 'test','1','data1:nickname' 删除RowKey的所有column用deleteall >deleteall 'test','1' 删除表练习完毕,把练习表删了吧,删除之前需要先disable>disable 'test'>drop 'test' JAVA API操作 javaAPI操作还是比较简单的,各种api类和api函数,直接上代码了 import java.io.IOException; import org.apache.hadoop.hbase.HBaseConfiguration; import org.apache.hadoop.hbase.HColumnDescriptor; import org.apache.hadoop.hbase.HTableDescriptor; import org.apache.hadoop.hbase.client.Get; import org.apache.hadoop.hbase.client.HBaseAdmin; import org.apache.hadoop.hbase.client.HTable; import org.apache.hadoop.hbase.client.Put; import org.apache.hadoop.hbase.client.Result; import org.apache.hadoop.hbase.client.ResultScanner; import org.apache.hadoop.hbase.client.Scan; import org.apache.hadoop.hbase.util.Bytes; import org.apache.hadoop.conf.Configuration; public class ExampleClient { public static void main(String[] args) throws IOException { Configuration conf = HBaseConfiguration.create(); // Create table HBaseAdmin admin = new HBaseAdmin(conf); HTableDescriptor htd = new HTableDescriptor("test"); HColumnDescriptor hcd = new HColumnDescriptor("data"); htd.addFamily(hcd); admin.createTable(htd); byte[] tablename = htd.getName(); HTableDescriptor[] tables = admin.listTables(); if (tables.length != 1 && Bytes.equals(tablename, tables[0].getName())) { throw new IOException("Failed create of table!"); } // Run some operations HTable table = new HTable(conf, tablename); byte[] row1 = Bytes.toBytes("row1"); Put p1 = new Put(row1); byte[] databytes = Bytes.toBytes("data"); p1.add(databytes, Bytes.toBytes("1"), Bytes.toBytes("value1")); table.put(p1); Get g = new Get(row1); Result result = table.get(g); System.out.println("GET:" + result); Scan scan = new Scan(); ResultScanner scanner = table.getScanner(scan); try { for (Result scannerResult : scanner) { System.out.println("Scan:" + scannerResult); } } catch (Exception e) { e.printStackTrace(); } finally { scanner.close(); } // Drop the table admin.disableTable(tablename); admin.deleteTable(tablename); } } 这里要注意的一点是连接到HBase需要将将HBase环境的hbase-site.xml文件引入到工程中,就像jdbc的数据库连接一样,不然是连不上hbase滴。 Configuration conf = HBaseConfiguration.create();//这行代码会从hbase-site.xml中读取配置信息 HBase MapReduce操作 直接上代码了: import java.io.IOException; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.hbase.HBaseConfiguration; import org.apache.hadoop.hbase.KeyValue; import org.apache.hadoop.hbase.client.Put; import org.apache.hadoop.hbase.client.Result; import org.apache.hadoop.hbase.client.Scan; import org.apache.hadoop.hbase.io.ImmutableBytesWritable; import org.apache.hadoop.hbase.mapreduce.TableMapReduceUtil; import org.apache.hadoop.hbase.mapreduce.TableMapper; import org.apache.hadoop.hbase.mapreduce.TableReducer; import org.apache.hadoop.hbase.util.Bytes; import org.apache.hadoop.mapreduce.Job; public class testHBaseMR { public static class Mapper extends TableMapper<ImmutableBytesWritable, ImmutableBytesWritable> { public Mapper() { } @Override public void map(ImmutableBytesWritable row, Result values, Context context) throws IOException { ImmutableBytesWritable value = null; String[] tags = null; for (KeyValue kv : values.list()) { if ("author".equals(Bytes.toString(kv.getFamily())) && "nickname".equals(Bytes.toString(kv.getQualifier()))) { value = new ImmutableBytesWritable(kv.getValue()); } if ("article".equals(Bytes.toString(kv.getFamily())) && "tags".equals(Bytes.toString(kv.getQualifier()))) { tags = Bytes.toString(kv.getValue()).split(","); } } for (int i = 0; i < tags.length; i++) { ImmutableBytesWritable key = new ImmutableBytesWritable( Bytes.toBytes(tags[i].toLowerCase())); try { context.write(key, value); } catch (InterruptedException e) { throw new IOException(e); } } } } public static class Reducer extends TableReducer<ImmutableBytesWritable, ImmutableBytesWritable, ImmutableBytesWritable> { @Override public void reduce(ImmutableBytesWritable key, Iterable values, Context context) throws IOException, InterruptedException { String friends = ""; for (ImmutableBytesWritable val : values) { friends += (friends.length() > 0 ? "," : "") + Bytes.toString(val.get()); } Put put = new Put(key.get()); put.add(Bytes.toBytes("person"), Bytes.toBytes("nicknames"), Bytes.toBytes(friends)); context.write(key, put); } } public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); conf = HBaseConfiguration.create(conf); Job job = new Job(conf, "HBase_FindFriend"); job.setJarByClass(testHBaseMR.class); Scan scan = new Scan(); scan.addColumn(Bytes.toBytes("author"), Bytes.toBytes("nickname")); scan.addColumn(Bytes.toBytes("article"), Bytes.toBytes("tags")); TableMapReduceUtil .initTableMapperJob("blog", scan, Mapper.class, ImmutableBytesWritable.class, ImmutableBytesWritable.class, job); TableMapReduceUtil .initTableReducerJob("tag_friend", Reducer.class, job); System.exit(job.waitForCompletion(true) ? 0 : 1); } } TableMapReduceUtil.initTableMapperJob;TableMapReduceUtil.initTableReducerJob 用来指定map和reduce。相当于hbase的MR操作工具类吧~ 优化 针对行的键按数据排列的次序进行随机处理; 每个任务只实例化一个HTable对象; HTable.put(put)执行put操作时不使用任何缓冲。可以通过使用HTable.setAutoFlush(false),设置禁用自动刷入,并设置写缓冲大小,同时在任务的最后设置HTable.flushCommits()或者HTable.close(),以确保缓冲中最后没有剩下的未刷入的数据; 设计行键的时候要多加考虑,可以使用复合键,如果键是整数,则应该使用二进制形式以节省存储空间; HBase和RDBMS的比较 HBase: HBase是一个分布式的面向列的数据存储系统; HBase表可以很高和很宽(数十亿行,数百万列); 水平分区并在数千个商用机节点上自动复制; 表的模式是物理存储的直接反映; 不支持SQL; 不需要强一致性和参照完整性; 不支持索引;行是顺序存储的,每行中的列也是,不存在索引膨胀的问题,插入性能和表的大小无关 事务好像仅仅支持针对某一行的一系列Put/Delete操作。不同行、不同表间的操作是无法放在一个事务中的; HBase不支持条件查询和Order by等查询,读取记录只能按Row key(及其range)或全表扫描; 没有内置对连接操作的支持,但是由于表的宽度可以很大,一个宽行可以容下一个主键相关的所有数据,并不需要使用连接; RDBMS: 支持SQL; 需要强一致性和参照完整性; 支持事务,索引等; HBase的特性 没有索引,行是顺序存储的,每行中的列也是,不存在索引膨胀的问题,插入性能和表的大小无关; 自动分区,在表增长的时候,表会自动分裂成区域,并分布到可用的节点上; 线性扩展和对于新节点的自动处理,增加一个节点,把它指向现有的集群,并运行Regionserver,区域会自动重新进行平衡,负载会均匀分布; 普通商用硬件支持; 容错,大量节点意味着每个节点的重要性并不突出,不用担心单个节点失效; 批处理,支持MapReduce操作,可以用全并行的分布式作业来处理数据;

优秀的个人博客,低调大师

Elasticsearch-7.x学习笔记

本文转载自:阅读原文 文章目录 1. 单节点安装 2. ES安装head插件 3. Elasticsearch Rest基本操作 REST介绍 CURL创建索引库 查询索引-GET DSL查询 MGET查询 HEAD的使用 ES更新索引 ES删除索引 ES批量操作-bulk ES版本控制 4. Elasticsearch 核心概念 Cluster Shards Replicas Recovery Gateway Discovery.zen Transport Create Index Mapping 5. Elasticsearch Java 客户端 Java High Level REST Client Java高级客户端 Document APIs Index API Get API Exists API Update API Delete API Bulk API Multi-Get API SearchType Query Then Fetch Dfs, Query Then Fetch 查询-Query 聚合-Aggregations 分页 多索引和多类型查询 极速查询 ElasticSearch索引模块 索引模块组成部分 集成IK中文分词插件 自定义IK词库 热更新IK词库 ES集群安装部署 ES集群规划 ES集群安装 X-Pack安装 Kibana安装 ES优化 集群脑裂优化设置 增大系统打开文件数 合理设置JVM内存 锁定物理内存 合理设置分片 合理设置副本数 合并索引 关闭索引 清除删除文档 合理数据导入 设置索引_all 设置索引_source 版本一致 软件版本 jdk-8u192-linux-x64.tar.gz elasticsearch-7.1.0-linux-x86_64.tar.gz 1. 单节点安装 下载: wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-7.1.0-linux-x86_64.tar.gz 解压 # tar -zxvf elasticsearch-7.1.0-linux-x86_64.tar.gz -C /opt/tools/elk/ # tar -zxvf jdk-8u192-linux-x64.tar.gz -C /opt/tools/ 配置环境变量(root用户下)# vi /etc/profile # set jdk path export JAVA_HOME=/opt/tools/jdk1.8.0 #set es path export ES_HOME=/opt/tools/elk/elasticsearch-7.1.0 export PATH=$PATH:$JAVA_HOME/bin:$ES_HOME/bin 使配置文件生效 # source /etc/profile 查看 # echo $JAVA_HOME /opt/tools/jdk1.8.0 # echo $ES_HOME /opt/tools/elk/elasticsearch-7.1.0 修改配置文件$ES_HOME/config/elasticsearch.yml network.host: 192.168.93.252 #设置当前主机ip 启动 # bin/elasticsearch # bin/elasticsearch -d (后台启动) 报错 问题一 [o.e.b.ElasticsearchUncaughtExceptionHandler] [bigdatademo] uncaught exception in thread [main]org.elasticsearch.bootstrap.StartupException: java.lang.RuntimeException: can not run elast icsearch as root 原因:elasticsearch不能以root账户启动 解决方案:新建一个普通用户 # useradd yskang # passwd yskang Changing password for user yskang. New password: BAD PASSWORD: it is too simplistic/systematic BAD PASSWORD: is too simple Retype new password: passwd: all authentication tokens updated successfully. 授权:# chown -R yskang:yskang /opt/* 然后切换到yskang用户,重新启动elasticsearch 使普通用户具有root用户权限,sudo命令权限(通过which查看命令所在) root用户通过vi sudo去修改 # visudo 添加以下内容: ## Allow root to run any commands anywhere root ALL=(ALL) ALL yskang ALL=(ALL) NOPASSWD: ALL ALL 说明:用户名 IP或者网段=(身份)也可以不写,默认是root 可执行的命令 使用方法$ sudo service iptables status 问题二 java.lang.UnsupportedOperationException: seccomp unavailable: requires kernel 3.5+ with CON FIG_SECCOMP and CONFIG_SECCOMP_FILTER compiled in at org.elasticsearch.bootstrap.SystemCallFilter 原因:报了一大串错误,不必惊慌,其实只是一个警告,主要是因为Linux的版本过低造成的 解决方案:(1)重新安装新版本的Linux系统;(2)警告不影响使用,可以忽略 问题三 ERROR: bootstrap checks failed [1]: max file descriptors [4096] for elasticsearch process is too low, increase to at least [65535] 原因:无法创建本地文件问题,用户最大可创建文件数太小 解决方案: 切换到root用户下,编辑 /etc/security/limits.conf,追加以下内容; # vi /etc/security/limits.conf * soft nofile 65536 * hard nofile 262144 * soft nproc 32000 * hard nproc 32000 问题四 [2]: max number of threads [1024] for user [yskang] is too low, increase to at least [4096] 1 原因:无法创建本地线程问题,用户最大可创建线程数太小 解决方案:切换到root用户下,编辑 /etc/security/limits.d/90-nproc.conf # vi /etc/security/limits.d/90-nproc.conf 找到 * soft nproc 1024 修改为: * soft nproc 4096 1 2 3 4 5 问题五 [3]: max virtual memory areas vm.max_map_count [65530] is too low, increase to at least [262144] 1 原因:最大虚拟内存太小 解决方案:切换到root用户下,编辑 /etc/sysctl.conf,追加以下内容: vm.max_map_count=655360 1 保存后,执行命令(使配置生效),然后重新启动 # sysctl -p 1 问题六 [4]: system call filters failed to install; check the logs and fix your configuration or di sable system call filters at your own risk 1 2 原因: 因为Centos6不支持SecComp,而ES默认bootstrap.system_call_filter为true进行检测,所以导致检测失败,失败后直接导致ES不能解决方案:修改elasticsearch.yml 添加以下内容 $ vi elasticsearch.yml bootstrap.memory_lock: false #设置ES节点允许内存交换 bootstrap.system_call_filter: false #禁用系统调用过滤器 1 2 3 问题七 [5]: the default discovery settings are unsuitable for production use; at least one of [dis covery.seed_hosts, discovery.seed_providers, cluster.initial_master_nodes] must be configured 1 2 原因:默认发现设置不适合生产使用;必须至少配置[dis covery.seed_hosts,discovery.seed_providers,cluster.initial_master_nodes]中的一个 解决方案:修改elasticsearch.yml文件 $ vi elasticsearch.yml 将 #cluster.initial_master_nodes: ["node-1", "node-2"] 去掉注释#并修改为 cluster.initial_master_nodes: ["bigdatademo"] 说明:bigdatademo:当前节点主机名,记得保存。 1 2 3 4 5 启动完成后,验证服务是否开启成功 $ curl http://192.168.93.252:9200 { "name" : "bigdatademo", "cluster_name" : "elasticsearch", "cluster_uuid" : "_na_", "version" : { "number" : "7.1.0", "build_flavor" : "default", "build_type" : "tar", "build_hash" : "606a173", "build_date" : "2019-05-16T00:43:15.323135Z", "build_snapshot" : false, "lucene_version" : "8.0.0", "minimum_wire_compatibility_version" : "6.8.0", "minimum_index_compatibility_version" : "6.0.0-beta1" }, "tagline" : "You Know, for Search" } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 2. ES安装head插件 安装nodejs npm # yum -y install nodejs npm 直接yum install -y nodejs会提示找不到nodejs这个模块 安装nodesource后再执行yum install -y nodejs $ curl --silent --location https://rpm.nodesource.com/setup_10.x | sudo bash - 然后 $ sudo yum -y install nodejs 会将npm一起安装的 查看版本信息 $ node -v v10.16.0 $ npm -v 6.9.0 安装git $ sudo yum -y install git 下载head $ git clone git://github.com/mobz/elasticsearch-head.git $ cd elasticsearch-head $ npm install 报错:node npm install Error:CERT_UNTRUSTED ssl验证问题:使用下面命令取消ssl验证即可解决 npm config set strict-ssl false 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 配置head插件 修改Gruntfile.js配置,增加hostname: '*'配置 $ vi Gruntfile.js connect: { server: { options: { port: 9100, base: '.', keepalive: true, hostname: '*' } } } 1 2 3 4 5 6 7 8 9 10 11 12 修改head/_site/app.js文件 修改head连接es的地址(修改localhost为本机的ip地址) $ vi app.js this.base_uri = this.config.base_uri || this.prefs.get("app-base_uri") || "http://192.168.93.252:9200"; 1 2 ES 配置 修改elasticsearch.yml ,增加跨域的配置(需要重启es才能生效) $ vi config/elasticsearch.yml http.cors.enabled: true http.cors.allow-origin: "*" 1 2 3 启动head插件 $ cd elasticsearch-head/node_modules/grunt/ $ bin/grunt server & 查看进程 $ netstat -ntlp 1 2 3 4 head 查看es集群状态http://192.168.93.252:9100 3. Elasticsearch Rest基本操作 REST介绍 REST定义 REST即表述性状态传递(英文:Representational State Transfer,简称REST)是Roy Fielding博士在2000年他的博士论文中提出来的一种软件架构风格。 它是一种针对网络应用的设计和开发方式,可以降低开发的复杂性,提高系统的可伸缩性。 REST指的是一组架构约束条件和原则。满足这些约束条件和原则的应用程序或设计就是RESTful Web应用程序最重要的REST原则是:客户端和服务器之间的交互在请求之间是无状态的。从客户端到服务器的每个请求都必须包含理解请求所必需的信息。如果服务器在请求之间的任何时间点重启,客户端不会得到通知。此外,无状态请求可以由任何可用服务器回答,这十分适合云计算之类的环境。客户端可以缓存数据以改进性能。 在服务器端,应用程序状态和功能可以分为各种资源。每个资源都是要URI(Universal Resource Identifier)得到一个唯一的地址。所有资源都共享统一的界面,以便在客户端和服务器之间传输状态。使用的是标准的HTTP方法,比如:GET、PUT、POST和DELETE。 REST资源 资源 GET PUT POST DELETE 一组资源的URL 如: http://example.com/products/ 列出URL列表 使用给定的一组资源替换当前组资源 在本资源组中创建或者追加一个新的资源 删除整组资源 单个资源的URL 如: http://example.com/products/1234 获取指定资源的详细信息 替换或者创建指定资源 在资源组下创建或者追加一个新的元素 删除指定的元素 REST基本操作 方法 作用 GET 获取对象的当前状态 PUT 改变对象的状态 POST 创建对象 DELETE 删除对象 HEAD 获取头信息 ES内置的常用REST接口 URL 说明 /index/_search 搜索指定索引下的数据 /_aliases 获取或者操作索引下的别名 /index/ 查看指定索引下的详细信息 /index/type/ 创建或者操作类型 /index/mapping 创建或者操作mapping /index/settings 创建或者操作settings /index/_open 打开指定索引 /index/_close 关闭指定索引 /index/_refresh 刷新索引(使新增加内容对搜索可见,不保证数据被写入磁盘) /index/_flush 刷新索引(会触发Lucene提交数据) CURL命令 简单认为是可以在命令行下访问url的一个工具 curl是利用URL语法在命令行方式下工作的开源文件传输工具,使用curl可以简单实现常见的get/post请求 CURL的使用 -X 指定http请求的方法,GET POST PUT DELETE -d 指定要传输的参数 1 2 CURL创建索引库 示例: 如:索引库名称:test $ curl -XPUT 'http://192.168.93.252:9200/test/' PUT/POST都可以 显示以下内容表示创建索引库成功 {"acknowledged":true,"shards_acknowledged":true,"index":"test"} 创建数据 $ curl -XPOST http://192.168.93.252:9200/test/user/1 -d'{"name":"jack","age":26}' {"error":"Content-Type header [application/x-www-form-urlencoded] is not supported","status":406} 高版本的ES需要指定头文件信息,否则会报错,低版本可以不用指定 $ curl -H "Content-Type: application/json" -XPOST http://192.168.93.252:9200/test/user/1 -d'{ "name":"jack","age":26}' {"_index":"test","_type":"user","_id":"1","_version":1,"result":"created","_shards":{"total":2,"successful":1,"failed":0},"_seq_no":0 ,"_primary_term":1} 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 PUT和POST的用法区别 PUT是幂等方法,二POST不是。所以PUT用于更新操作、POST用于新增操作比较合适 PUT、DELETE操作是幂等的。所谓幂等是指不管进行多少次操作,结果都一样。 POST操作不是幂等的,因此会出现POST重复加载的问题,比如,当多次发出同样的POST请求之后,结果会创建若干的资源 创建操作可以使用POST,也可以使用PUT,区别在于POST是作用在一个集合资源之上的(/articles),而PUT是作用在一个具体资源之上的(/articles/123),比如很多资源使用数据库自增主键作为标识信息,而创建的资源标识信息到底是什么只能由服务端提供,这个时候就必须使用POST 创建索引库的注意事项 索引库名称必须要全部小写,不能以下划线开头,也不能包含逗号 如果没有明确指定索引数据的ID,那么ES会自动生成一个随机的ID,需要使用POST参数 $ curl -H "Content-Type: application/json" -XPOST http://192.168.93.252:9200/test/user/ -d'{ "name":"john","age":18}' 1 2 创建全新内容的两种方式 (1)使用自增ID(post) $ curl -H "Content-Type: application/json" -XPOST http://192.168.93.252:9200/test/user/ -d'{ "name":"john","age":18}' 1 2 (2)在url后面添加参数 $ curl -H "Content-Type: application/json" -XPUT http://192.168.93.252:9200/test/user/2?op_type=create -d'{ "name":"lucy","age":15}' $ curl -H "Content-Type: application/json" -XPUT http://192.168.93.252:9200/test/user/3/_create -d'{ "name":"alan","age":58}' 1 2 3 4 5 查询索引-GET (1)根据id查询 $ curl -XGET http://192.168.93.252:9200/test/user/1 {"_index":"test","_type":"user","_id":"1","_version":1,"_seq_no":0,"_primary_term":1,"found":true,"_source":{"name":"jack","age":26}} 1 2 3 (2)在任意的查询字符串中添加pretty参数,ES可以得到易于识别的json结果 (1) 检索文档中的一部分,如果只需要显示指定字段 $ curl -XGET 'http://192.168.93.252:9200/test/user/1?_source=name&pretty' { "_index" : "test", "_type" : "user", "_id" : "1", "_version" : 1, "_seq_no" : 0, "_primary_term" : 1, "found" : true, "_source" : { "name" : "jack" } } (2) 查询指定索引库指定类型所有数据 $ curl -XGET http://192.168.93.252:9200/test/user/_search?pretty { "took" : 80, "timed_out" : false, "_shards" : { "total" : 1, "successful" : 1, "skipped" : 0, "failed" : 0 }, "hits" : { "total" : { "value" : 4, "relation" : "eq" }, "max_score" : 1.0, "hits" : [ { "_index" : "test", "_type" : "user", "_id" : "1", "_score" : 1.0, "_source" : { "name" : "jack", "age" : 26 } }, { "_index" : "test", "_type" : "user", "_id" : "zeQEIWsBWJbm70w3S4EC", "_score" : 1.0, "_source" : { "name" : "john", "age" : 18 } }, { "_index" : "test", "_type" : "user", "_id" : "2", "_score" : 1.0, "_source" : { "name" : "lucy", "age" : 15 } }, { "_index" : "test", "_type" : "user", "_id" : "3", "_score" : 1.0, "_source" : { "name" : "alan", "age" : 58 } } ] } } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 (3)根据条件进行查询 $ curl -XGET 'http://192.168.93.252:9200/test/user/_search?q=name:john&pretty=true' 或者 $ curl -XGET 'http://192.168.93.252:9200/test/user/_search?q=name:john&pretty' { "took" : 5, "timed_out" : false, "_shards" : { "total" : 1, "successful" : 1, "skipped" : 0, "failed" : 0 }, "hits" : { "total" : { "value" : 1, "relation" : "eq" }, "max_score" : 1.2039728, "hits" : [ { "_index" : "test", "_type" : "user", "_id" : "zeQEIWsBWJbm70w3S4EC", "_score" : 1.2039728, "_source" : { "name" : "john", "age" : 18 } } ] } } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 DSL查询 DSL(Domain Specific Language)领域特定语言 新添加一个文档 $ curl -H "Content-Type: application/json" -XPUT http://192.168.93.252:9200/test/user/4/_create -d'{"name":"zhangsan","age":18}' {"_index":"test","_type":"user","_id":"4","_version":1,"result":"created","_shards":{"total":2,"successful":1,"failed":0},"_seq_no":4 ,"_primary_term":1} $ curl -H "Content-Type: application/json" -XGET http://192.168.93.252:9200/test/user/_search -d'{"query":{"match":{"name":"zhangsan"}}}' {"took":2,"timed_out":false,"_shards":{"total":1,"successful":1,"skipped":0,"failed":0},"hits":{"total":{"value":1,"relation":"eq"}," max_score":1.3862944,"hits":[{"_index":"test","_type":"user","_id":"4","_score":1.3862944,"_source":{"name":"zhangsan","age":18}}]}} 1 2 3 4 5 6 7 MGET查询 使用mget API 获取多个文档 先新建一个索引库test2 $ curl -XPUT 'http://192.168.93.252:9200/test2/' $ curl -H "Content-Type: application/json" -XPOST http://192.168.93.252:9200/test2/user/1 -d'{"name":"marry","age":16}' $ curl -H "Content-Type: application/json" -XGET http://192.168.93.252:9200/_mget?pretty -d'{"docs":[{"_index":"test","_type":"user","_id":2,"_source":"name"},{"_index":"test2","_type":"user","_id":1}]}' { "docs" : [ { "_index" : "test", "_type" : "user", "_id" : "2", "_version" : 1, "_seq_no" : 2, "_primary_term" : 1, "found" : true, "_source" : { "name" : "lucy" } }, { "_index" : "test2", "_type" : "user", "_id" : "1", "_version" : 1, "_seq_no" : 0, "_primary_term" : 1, "found" : true, "_source" : { "name" : "marry", "age" : 16 } } ] } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 如果需要的文档在同一个_index或者同一个_type中,你就可以在URL中指定一个默认的/_index或者/_index/_type $ curl -H "Content-Type: application/json" -XGET http://192.168.93.252:9200/test/user/_mget?pretty -d'{ "docs":[{"_id":1},{"_id":2}]}' { "docs" : [ { "_index" : "test", "_type" : "user", "_id" : "2", "_version" : 1, "_seq_no" : 2, "_primary_term" : 1, "found" : true, "_source" : { "name" : "lucy", "age" : 15 } }, { "_index" : "test", "_type" : "user", "_id" : "1", "_version" : 1, "_seq_no" : 0, "_primary_term" : 1, "found" : true, "_source" : { "name" : "jack", "age" : 26 } } ] } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 如果所有的文档拥有相同的_index以及_type中,直接在请求中添加ids的数组即可 $ curl -H "Content-Type: application/json" -XGET http://192.168.93.252:9200/test/user/_mget?pretty -d'{ "ids":["1","2"]}' { "docs" : [ { "_index" : "test", "_type" : "user", "_id" : "1", "_version" : 1, "_seq_no" : 0, "_primary_term" : 1, "found" : true, "_source" : { "name" : "jack", "age" : 26 } }, { "_index" : "test", "_type" : "user", "_id" : "2", "_version" : 1, "_seq_no" : 2, "_primary_term" : 1, "found" : true, "_source" : { "name" : "lucy", "age" : 15 } } ] } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 HEAD的使用 如果只想检查一下文档是否存在,你可以使用HEAD来替代GET方法,这样就只会返回HTTP头文件 $ curl -i -XHEAD http://192.168.93.252:9200/test/user/1 HTTP/1.1 200 OK Warning: 299 Elasticsearch-7.1.0-606a173 "[types removal] Specifying types in document get requests is deprecated, use the /{index}/_ doc/{id} endpoint instead."content-type: application/json; charset=UTF-8 content-length: 133 $ curl -i -XHEAD http://192.168.93.252:9200/test/user/5 HTTP/1.1 404 Not Found Warning: 299 Elasticsearch-7.1.0-606a173 "[types removal] Specifying types in document get requests is deprecated, use the /{index}/_ doc/{id} endpoint instead."content-type: application/json; charset=UTF-8 content-length: 56 1 2 3 4 5 6 7 8 9 10 11 ES更新索引 ES可以使用PUT或者POST对文档进行更新(全部更新)操作,如果指定ID的文档已经存在,则执行更新操作 注意:ES在执行更新操作的时候,首先会将旧的文档标记为删除状态,然后添加新的文档,旧的文档不会立即消失,但是你也无法访问,ES会在你继续添加更多数据的时候在后台清理已经标记为删除状态的文档 局部更新,可以添加新字段或者更新已有字段(必须使用POST) $ curl -H "Content-Type: application/json" -XPOST http://192.168.93.252:9200/test/user/1/_update -d'{"doc":{"name":"baby","age":18}}' {"_index":"test","_type":"user","_id":"1","_version":2,"result":"updated","_shards":{"total":2,"successful":1,"failed":0},"_seq_no":5 ,"_primary_term":1} $ curl -XGET http://192.168.93.252:9200/test/user/1?pretty { "_index" : "test", "_type" : "user", "_id" : "1", "_version" : 2, "_seq_no" : 5, "_primary_term" : 1, "found" : true, "_source" : { "name" : "baby", "age" : 18 } } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 ES删除索引 ES可以使用DELETE对文档进行删除操作 $ curl -XDELETE http://192.168.93.252:9200/test/user/1 {"_index":"test","_type":"user","_id":"1","_version":3,"result":"deleted","_shards":{"total":2,"successful":1,"failed":0},"_seq_no":6 ,"_primary_term":1} 说明:如果文档存在,result属性值为deleted,_version属性的值+1 $ curl -XDELETE http://192.168.93.252:9200/test/user/1 {"_index":"test","_type":"user","_id":"1","_version":4,"result":"not_found","_shards":{"total":2,"successful":1,"failed":0},"_seq_no" :11,"_primary_term":1} 说明:如果文档不存在,result属性值为not_found,但是_version属性的值依然会+1,这个就是内部管理的一部分,它保证了我们在多个节点间的不同操作的顺序都被正确的标记了 $ curl -XGET http://192.168.93.252:9200/test/user/1 {"_index":"test","_type":"user","_id":"1","found":false} 1 2 3 4 5 6 7 8 9 10 11 12 注意:ES在执行删除操作时也不会立即生效,它只是被标记成已删除。ES将会在你之后添加更多索引的时候才会在后台进行删除内容的清理 ES批量操作-bulk bulk API可以帮助我们同时执行多个请求 格式: action: index/create/update/delete metadata: _index,_type,_id request body: _source(删除操作不需要) {action:{metadata}} {request body} {action:{metadata}} {request body} 1 2 3 4 5 6 7 create和index的区别 如果数据存在,使用create操作失败,会提示文档已经存在,使用index则可以成功执行 使用文件的方式 新建一个requests文件 $ vi requests {"index":{"_index":"test","_type":"user","_id":"6"}} {"name":"mayun","age":51} {"update":{"_index":"test","_type":"user","_id":"6"}} {"doc":{"age":52}} 1 2 3 4 5 执行批量操作 $ curl -H "Content-Type: application/json" -XPOST http://192.168.93.252:9200/_bulk --data-binary @requests {"took":31,"errors":false,"items":[{"index":{"_index":"test","_type":"user","_id":"6","_version":1,"result":"created","_shards":{"tot al":2,"successful":1,"failed":0},"_seq_no":12,"_primary_term":1,"status":201}},{"update":{"_index":"test","_type":"user","_id":"6","_version":2,"result":"updated","_shards":{"total":2,"successful":1,"failed":0},"_seq_no":13,"_primary_term":1,"status":200}}]} $ curl -XGET http://192.168.93.252:9200/test/user/6?pretty { "_index" : "test", "_type" : "user", "_id" : "6", "_version" : 2, "_seq_no" : 13, "_primary_term" : 1, "found" : true, "_source" : { "name" : "mayun", "age" : 52 } } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 bulk请求可以在URL中声明/_index 或者 /_index/_type bulk一次最大处理多少数据量 (1) bulk会把将要处理的数据载入内存中,所以数据量是有限的 (2) 最佳的数据量不是一个确定的数值,它取决于你的硬件,你的文档大小以及复杂性,你的索引以及搜索的负载 (3) 一般建议是1000-5000个文档,如果你的文档很大,可以适当减少队列,大小建议是5-15MB,默认不能超过100MB,可以在ES的配置文件中修改这个值 http.max_content_length: 100mb http.max_content_length :The max content of an HTTP request. Defaults to 100mb. (4) 官网说明:https://www.elastic.co/guide/en/elasticsearch/reference/current/modules-http.html ES版本控制 (1)普通关系型数据库使用的是(悲观并发控制(PCC)) 当我们在修改一个数据前先锁定这一行,然后确保只有读取到数据的这个线程可以修改这一行数据 (2)ES使用的是(乐观并发控制(OCC)) ES不会阻止某一数据的访问,然而,如果基础数据在我们读取和写入的间隔中发生了变化,更新就会失败,这时候就由程序来决定如何处理这个冲突。它可以重新读取新数据来进行更新,又或者将这一情况直接反馈给客户 (3)ES如何实现版本控制(使用ES内部版本号) 首先得到需要修改的文档,获取版本号(_version) $ curl -XGET http://192.168.93.252:9200/test/user/2 {"_index":"test","_type":"user","_id":"2","_version":1,"_seq_no":2,"_primary_term":1,"found":true,"_source":{ "name":"lucy","age":15}} 1 2 3 在执行更新操作的时候把版本号传过去 $ curl -H "Content-Type: application/json" -XPOST http://192.168.93.252:9200/test/user/2/_update?version=1 -d'{"doc":{"age":30}}' {"_index":"test","_type":"user","_id":"2","_version":2,"result":"updated","_shards":{"total":2,"successful":1,"failed":0},"_seq_no":1 4,"_primary_term":1} $ curl -H "Content-Type: application/json" -XPUT http://192.168.93.252:9200/test/user/2?version=2 -d'{"name":"joy","age":20}' 1 2 3 4 5 如果传递的版本号和待更新的文档的版本号不一致,则会更新失败 4. Elasticsearch 核心概念 Cluster (1)代表一个集群,集群中有多个节点,其中有一个为主节点,这个主节点是可以通过 选举产生的,主从节点是对于集群内部来说的。ES的一个概念就是去中心化。 (2)主节点的职责是负责管理集群状态,包括管理分片的状态和副本的状态,以及节点的发现和删除。 (3)注意:主节点不负责对数据的增删改查请求进行处理,只负责维护集群的相关状态信息。 集群状态查看:http://192.168.93.252:9200/_cluster/health?pretty { cluster_name: "elasticsearch", status: "yellow", timed_out: false, number_of_nodes: 1, number_of_data_nodes: 1, active_primary_shards: 2, active_shards: 2, relocating_shards: 0, initializing_shards: 0, unassigned_shards: 2, delayed_unassigned_shards: 0, number_of_pending_tasks: 0, number_of_in_flight_fetch: 0, task_max_waiting_in_queue_millis: 0, active_shards_percent_as_number: 50 } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 Shards (1)代表索引分片,ES可以把一个完整的索引分成多个分片,好处是可以把一个大的索引水平拆分成多个, 分布到不同的节点上,构成分布式搜索,提高性能和吞吐量 (2)分片的数量只能在创建索引库时指定,索引库创建后不能更改。 curl -H "Content-Type:application/json" -XPUT 'http://192.168.93.252:9200/test3/' -d'{"settings":{"number_of_shards":3}}' 1 默认一个索引库有5个分片(7.0之前),本版本7.1.0默认只有一个分片和一个副本 每个分片中最多存储2,147,483,519条数据 官网地址:https://www.elastic.co/guide/en/elasticsearch/reference/current/getting-started-concepts.html To summarize, each index can be split into multiple shards. An index can also be replicated zero (meaning no replicas) or more times. Once replicated, each index will have primary shards (the original shards that were replicated from) and replica shards (the copies of the primary shards). 总而言之,每个索引可以拆分为多个分片。索引也可以复制为零(表示没有副本)或更多次。复制后,每个索引都将具有主分片(从中复制的原始分片)和副本分片(主分片的副本)。 The number of shards and replicas can be defined per index at the time the index is created. After the index is created, you may also change the number of replicas dynamically anytime. You can change the number of shards for an existing index using the _shrink and _split APIs, however this is not a trivial task and pre-planning for the correct number of shards is the optimal approach. 可以在创建索引时为每个索引定义分片和副本的数量。创建索引后,您还可以随时动态更改副本数。您可以使用_shrink和_split API更改现有索引的分片数,但这不是一项简单的任务,并且预先计划正确数量的分片是最佳方法。 By default, each index in Elasticsearch is allocated one primary shard and one replica which means that if you have at least two nodes in your cluster, your index will have one primary shard and another replica shard (one complete replica) for a total of two shards per index. 默认情况下,Elasticsearch中的每个索引都分配了一个主分片和一个副本,这意味着如果群集中至少有两个节点,则索引将具有一个主分片和另一个副本分片(一个完整副本),总共两个每个索引的分片。 Each Elasticsearch shard is a Lucene index. There is a maximum number of documents you can have in a single Lucene index. As of LUCENE-5843, the limit is 2,147,483,519 (= Integer.MAX_VALUE - 128) documents. You can monitor shard sizes using the _cat/shards API. 每个Elasticsearch分片都是Lucene索引。单个Lucene索引中可以包含最多文档数。截至LUCENE-5843,限制为2,147,483,519(= Integer.MAX_VALUE - 128)个文件。您可以使用_cat / shards API监视分片大小。 1 2 3 4 5 6 7 8 9 10 11 Replicas 代表索引副本,ES可以给索引分片设置副本 副本的作用: 一是提高系统的容错性,当某个节点某个分片损坏或丢失时可以从副本中恢复 二是提高ES的查询效率,ES会自动对搜索请求进行负载均衡 副本的数量可以随时修改,可以在创建索引库的时候指定 curl -H "Content-Type:application/json" -XPUT 'http://192.168.93.252:9200/test3/' -d'{"settings":{"number_of_replicas":3}}' 1 默认是一个分片有1个副本 -> index.number_of_replicas: 1 注意:主分片和副本不会存在一个节点中 Recovery 代表数据的恢复或叫数据重新分布,ES在有节点加入或退出时会根据机器的负载对索引分片进行重新分配,挂掉的节点重新启动时也会进行数据恢复 Gateway 代表ES索引的持久化存储方式,ES默认是先把索引存放到内存中,当内存满了时再持久化到硬盘。当这个ES集群关闭再重新启动时就会从Gateway中读取索引数据。 ES支持多种类型的Gateway: 本地文件系统(默认) 分布式文件系统 Hadoop的HDFS和Amazon的S3云存储服务 Discovery.zen 代表ES的自动发现节点机制,ES是一个基于p2p的系统,它先通过广播寻找存在的节点,再通过多播协议来进行节点之间的通信,同时也支持点对点的交互 如果是不同网段的节点如何组成ES集群? 禁用自动发现机制 discovery.zen.ping.multicast.enabled: false 设置新节点被启动时能够发现的主节点列表 discovery.zen.ping.unicast.hosts: [“192.168.93.252”,“192.168.93.251”,“192.168.93.250”] Transport 代表ES内部节点或集群与客户端的交互方式,默认内部是使用tcp协议进行交互,同时它支持http协议(json格式)、thrift、servlet、memcached、zeroMQ等其他的传输协议(通过插件方式集成) Create Index 官网地址:https://www.elastic.co/guide/en/elasticsearch/reference/current/indices-create-index.html Create Index API用于在Elasticsearch中手动创建索引。Elasticsearch中的所有文档都存储在一个索引或另一个索引中。 最基本的命令如下: PUT twitter 1 这将创建一个名为twitter的索引,其默认设置为all 索引命名限制 (1)仅限小写 (2)不能包括\,/,*,?,“,<,>,|,``(空格字符),逗号,# (3)7.0版本之前的索引可能包含冒号(:),但已被弃用,7.0+不支持 (4)不能以- ,_,+开头 (5)不能是.或者.. (6)不能超过255个字节(注意它是字节,因此多字节字符将更快地计入255个限制) Index Settings 创建的每个索引都可以具有与其关联的特定设置,如: PUT twitter { "settings" : { "index" : { "number_of_shards" : 3, "number_of_replicas" : 2 } } } 1 2 3 4 5 6 7 8 9 分片数:number_of_shards默认值为1 副本数:number_of_replicas默认值为1 也可以简化 PUT twitter { "settings" : { "number_of_shards" : 3, "number_of_replicas" : 2 } } 1 2 3 4 5 6 7 注意:您不必在settings部分中明确指定索引部分 查看索引库的settings信息 curl -XGET http://192.168.93.252:9200/test/_settings?pretty 1 操作不存在的索引(创建) curl -H "Content-Type:application/json" -XPUT 'http://192.168.93.252:9200/test4/' -d'{"settings":{"number_of_shards":3,"number_of_replicas":2}}' 1 操作已存在索引(修改) curl -H "Content-Type:application/json" -XPUT 'http://192.168.93.252:9200/test4/_settings' -d'{"index":{"number_of_replicas":2}}' 1 Mapping 官网地址:https://www.elastic.co/guide/en/elasticsearch/reference/current/mapping.html Mapping是定义文档及其包含的字段的存储和索引方式的过程。例如,使用Mapping来定义: (1)应将哪些字符串字段视为全文字段。 (2)哪些字段包含数字,日期或地理位置。 (3)日期值的格式。 (4)用于控制动态添加字段的映射的自定义规则。 Mapping Type 每个索引都有一种映射类型,用于确定文档的索引方式。 映射类型具有: (1)Meta-fields(元字段) 元字段用于自定义文档的元数据关联的处理方式。元字段的示例包括文档的_index,_type,_id和_source字段。 (2)Fields or properties(字段或属性) 映射类型包含与文档相关的字段(fields )或属性(properties )列表。 每个字段都有一个数据类型,可以是: (1)一个简单的类型,如text,keyword,date,long,double,boolean或ip。 (2)支持JSON的分层特性的类型,如对象或嵌套 (3) 或者像geo_point,geo_shape或completion这样的特殊类型。 创建索引时可以指定映射,如下所示: PUT my_index { "mappings": { "properties": { "title": { "type": "text" }, "name": { "type": "text" }, "age": { "type": "integer" }, "created": { "type": "date", "format": "strict_date_optional_time||epoch_millis" } } } } 说明: 创建一个名为my_index的索引 指定映射中的字段或属性 指定标题字段包含文本值 指定名称字段包含文本值 指定age字段包含整数值 指定创建的字段包含两种可能格式的日期值 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 查询索引库的mapping信息 curl -XGET http://192.168.93.252:9200/test/user/_mapping?pretty 1 操作不存在的索引(创建) curl -H "Content-Type:application/json" -XPUT 'http://192.168.93.252:9200/test5/' -d'{"mappings": {"user": {"properties": { "name": { "type": "text"},"age": { "type": "integer" }}}}}' 1 操作已存在索引(修改) curl -H "Content-Type:application/json" -XPUT 'http://192.168.93.252:9200/test5/user/_mapping' -d'{"properties": { "name": { "type": "text"},"age": { "type": "integer" }}}' 1 5. Elasticsearch Java 客户端 Java High Level REST Client Java高级客户端 Java API:7.1 官网地址https://www.elastic.co/guide/en/elasticsearch/client/java-api/current/index.html 添加maven依赖 <!-- junit5 --> <dependency> <groupId>org.junit.jupiter</groupId> <artifactId>junit-jupiter-api</artifactId> <version>5.4.2</version> <scope>test</scope> </dependency> <!-- elasticsearch-rest-high-level-client --> <dependency> <groupId>org.elasticsearch.client</groupId> <artifactId>elasticsearch-rest-high-level-client</artifactId> <version>7.1.0</version> </dependency> 1 2 3 4 5 6 7 8 9 10 11 12 13 14 端口 ES启动监听两个端口:9300 和 9200 ES 9200端口 与 9300端口的区别? 9300是TCP协议端口:通过tcp协议通讯,ES集群之间是通过9300进行通讯,Java客户端(TransportClient)的方式也是以tcp协议在9300端口上与集群进行通信 9200是Http协议端口:主要用于外部通讯,外部使用RESTful接口进行访问 官网介绍:https://www.elastic.co/guide/en/elasticsearch/client/java-rest/7.1/java-rest-high.html Java高级REST客户端,内部仍然是基于低级客户端,它提供了更多的API,接受请求对象作为参数并返回响应对象,由客户端自己处理编码和解码。 每个API都可以同步或异步调用,同步方法返回一个响应对象,而异步方法的名称以async后缀结尾,需要一个监听器参数,一旦收到响应或错误, 就会被通知(在由低级客户端管理的线程池上)。 Java高级REST客户端依赖于Elasticsearch Core项目。它接受与TransportClient相同的请求参数,并返回相同的响应对象。 官网介绍:https://www.elastic.co/guide/en/elasticsearch/client/java-rest/7.1/java-rest-high-compatibility.html 兼容性 Java高级REST客户端需要Java 1.8并依赖于Elasticsearch核心项目。客户端版本与客户端开发的Elasticsearch版本相同。它接受与TransportClient相同的请求参数,并返回相同的响应对象。 高级客户端保证能够与运行在相同主要版本和更大或相同次要版本上的任何Elasticsearch节点进行通信。它不需要与它与之通信的Elasticsearch节点处于相同的次要版本,因为它是向前兼容的,这意味着它支持与Elasticsearch的更高版本进行通信,而不是与其开发的版本进行通信。 初始化 官网介绍:https://www.elastic.co/guide/en/elasticsearch/client/java-rest/7.1/java-rest-high-getting-started-initialization.html 连接到ES集群 RestHighLevelClient实例需要低级客户端构建器来构建,如下所示: RestHighLevelClient client = new RestHighLevelClient( RestClient.builder( new HttpHost("localhost", 9200, "http"), new HttpHost("localhost", 9201, "http"))); 1 2 3 4 高级客户端将在内部创建用于根据提供的构建器执行请求的低级客户端,并管理其生命周期 该低级客户端维护一个连接池并启动一些线程,因此当您需要关闭高级客户端时,它将关闭内部低级客户端以释放这些资源。这可以通过close()方法来完成:client.close(); 测试 /** * 测试:使用RestHighLevelClient连接ElasticSearch集群 * @throws IOException */ @Test public void test() throws IOException { RestHighLevelClient client = new RestHighLevelClient( RestClient.builder( new HttpHost("192.168.93.252", 9200, "http"))); GetRequest getRequest = new GetRequest("test", "5"); boolean exists = client.exists(getRequest, RequestOptions.DEFAULT); if (exists) { System.out.println("文档存在"); } else { System.out.println("文档不存在"); } client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 Document APIs Index API 官网介绍:https://www.elastic.co/guide/en/elasticsearch/client/java-rest/7.1/java-rest-high-document-index.html 索引index API:(json、map、XContentBuilder 、object) public class ESDocumentAPIsTest { public RestHighLevelClient client; /** * 测试:使用RestHighLevelClient连接ElasticSearch集群 * @throws IOException */ @BeforeEach public void test() throws IOException { client = new RestHighLevelClient( RestClient.builder( new HttpHost("192.168.93.252", 9200, "http"))); } /** * index API : json格式 * @throws IOException */ @Test public void testIndexforJson() throws IOException { IndexRequest request = new IndexRequest("posts"); //索引 request.id("1"); //请求的文档ID String jsonString = "{" + "\"user\":\"kimchy\"," + "\"postDate\":\"2019-06-10\"," + "\"message\":\"trying out Elasticsearch\"" + "}"; request.source(jsonString, XContentType.JSON); //文档源以字符串形式提供 //执行 IndexResponse indexResponse = client.index(request, RequestOptions.DEFAULT); System.out.println(indexResponse.getId()); client.close(); } /** * index API :map格式 * @throws IOException */ @Test public void testIndexforMap() throws IOException { Map<String, Object> jsonMap = new HashMap<>(); jsonMap.put("user", "kimchy"); jsonMap.put("postDate", new Date()); jsonMap.put("message", "trying out Elasticsearch"); //文档源作为Map提供,自动转换为JSON格式 IndexRequest request = new IndexRequest("posts").id("2").source(jsonMap); //执行 IndexResponse indexResponse = client.index(request, RequestOptions.DEFAULT); System.out.println(indexResponse.getId()); client.close(); } /** * index API :XContentBuilder 格式 * @throws IOException */ @Test public void testIndexforXContentBuilder() throws IOException { XContentBuilder builder = XContentFactory.jsonBuilder(); builder.startObject(); { builder.field("user", "kimchy"); builder.timeField("postDate", new Date()); builder.field("message", "trying out Elasticsearch"); } builder.endObject(); //文档源作为XContentBuilder对象提供,Elasticsearch内置助手生成JSON内容 IndexRequest request = new IndexRequest("posts").id("3").source(builder); //执行 IndexResponse indexResponse = client.index(request, RequestOptions.DEFAULT); System.out.println(indexResponse.getId()); client.close(); } /** * index API :Object 格式 * @throws IOException */ @Test public void testIndexforObject() throws IOException { //文档源作为Object键对提供,转换为JSON格式 IndexRequest request = new IndexRequest("posts") .id("4") .source("user", "kimchy", "postDate", new Date(), "message", "trying out Elasticsearch"); //执行 IndexResponse indexResponse = client.index(request, RequestOptions.DEFAULT); System.out.println(indexResponse.getId()); client.close(); } } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 Get API 官网介绍:https://www.elastic.co/guide/en/elasticsearch/client/java-rest/7.1/java-rest-high-document-get.html 查询get API /** * get API * @throws IOException */ @Test public void testGetforSynchronous() throws IOException { GetRequest getRequest = new GetRequest("posts", "1"); //同步执行 GetResponse getResponse = client.get(getRequest, RequestOptions.DEFAULT); System.out.println(getResponse.getSource()); //结果:{postDate=2019-06-10, message=trying out Elasticsearch, user=kimchy} client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 Exists API 官网介绍:https://www.elastic.co/guide/en/elasticsearch/client/java-rest/7.1/java-rest-high-document-exists.html 判断exists API /** * exist API * @throws IOException */ @Test public void testExists() throws IOException { GetRequest getRequest = new GetRequest("posts", "5"); getRequest.fetchSourceContext(new FetchSourceContext(false)); getRequest.storedFields("_none_"); //同步执行 boolean exists = client.exists(getRequest, RequestOptions.DEFAULT); if (exists) { System.out.println("存在"); } else { System.out.println("不存在"); } client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 Update API 官网介绍:https://www.elastic.co/guide/en/elasticsearch/client/java-rest/7.1/java-rest-high-document-update.html 更新update API:(json、map、XContentBuilder 、object) /** * Update API json * @throws IOException */ @Test public void testUpdateforJson() throws IOException { UpdateRequest request = new UpdateRequest("posts", "1"); String jsonString = "{" + "\"updated\":\"2019-06-09\"," + "\"reason\":\"daily update\"" + "}"; request.doc(jsonString, XContentType.JSON); //同步执行 UpdateResponse updateResponse = client.update(request, RequestOptions.DEFAULT); System.out.println(updateResponse.getResult()); client.close(); } /** * Update API map * @throws IOException */ @Test public void testUpdateforMap() throws IOException { Map<String, Object> jsonMap = new HashMap<>(); jsonMap.put("updated", new Date()); jsonMap.put("reason", "daily update"); UpdateRequest request = new UpdateRequest("posts", "1").doc(jsonMap); //同步执行 UpdateResponse updateResponse = client.update( request, RequestOptions.DEFAULT); System.out.println(updateResponse.getResult()); client.close(); } /** * Update API XContentBuilder * @throws IOException */ @Test public void testUpdateforXContentBuilder() throws IOException { XContentBuilder builder = XContentFactory.jsonBuilder(); builder.startObject(); { builder.timeField("updated", new Date()); builder.field("reason", "daily update"); } builder.endObject(); UpdateRequest request = new UpdateRequest("posts", "1").doc(builder); //同步执行 UpdateResponse updateResponse = client.update( request, RequestOptions.DEFAULT); System.out.println(updateResponse.getResult()); client.close(); } /** * Update API Object * @throws IOException */ @Test public void testUpdateforObject() throws IOException { UpdateRequest request = new UpdateRequest("posts", "1") .doc("updated", new Date(), "reason", "daily update"); //同步执行 UpdateResponse updateResponse = client.update(request, RequestOptions.DEFAULT); System.out.println(updateResponse.getResult()); client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 Delete API 官网介绍:https://www.elastic.co/guide/en/elasticsearch/client/java-rest/7.1/java-rest-high-document-delete.html 删除delete API /** * Delete API * @throws IOException */ @Test public void testDelete() throws IOException { DeleteRequest request = new DeleteRequest("posts","1"); //同步执行 DeleteResponse deleteResponse = client.delete( request, RequestOptions.DEFAULT); client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 Bulk API 官网介绍:https://www.elastic.co/guide/en/elasticsearch/client/java-rest/7.1/java-rest-high-document-bulk.html 批量操作bulk API /** * Bulk API 批量操作 * @throws IOException */ @Test public void testBulk() throws IOException { BulkRequest request = new BulkRequest(); request.add(new IndexRequest("posts").id("5") .source(XContentType.JSON,"field", "foo")); request.add(new IndexRequest("posts").id("6") .source(XContentType.JSON,"field", "bar")); request.add(new IndexRequest("posts").id("7") .source(XContentType.JSON,"field", "baz")); //可以将不同的操作类型添加到同一BulkRequest中 /* request.add(new DeleteRequest("posts", "3")); request.add(new UpdateRequest("posts", "2") .doc(XContentType.JSON,"other", "test")); request.add(new IndexRequest("posts").id("4") .source(XContentType.JSON,"field", "baz")); */ //同步执行 BulkResponse bulkResponse = client.bulk(request, RequestOptions.DEFAULT); for (BulkItemResponse bulkItemResponse : bulkResponse) { if (bulkItemResponse.isFailed()) { BulkItemResponse.Failure failure = bulkItemResponse.getFailure(); System.out.println(failure.getMessage()); } } client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 Multi-Get API 官网介绍:https://www.elastic.co/guide/en/elasticsearch/client/java-rest/7.1/java-rest-high-document-multi-get.html 多条数据查询Multi-Get API multiGet API并行地在单个http请求中执行多个get请求 /** * Multi-Get API 多条数据查询 * @throws IOException */ @Test public void testMultiGet() throws IOException { MultiGetRequest request = new MultiGetRequest(); request.add(new MultiGetRequest.Item("test","2")); request.add(new MultiGetRequest.Item("test", "3")); request.add(new MultiGetRequest.Item("test", "4")); //同步执行 MultiGetResponse responses = client.mget(request, RequestOptions.DEFAULT); for (MultiGetItemResponse itemResponse : responses) { GetResponse response = itemResponse.getResponse(); if (response.isExists()) { String json = response.getSourceAsString(); //System.out.println(json); Map<String, Object> sourceAsMap = response.getSourceAsMap(); System.out.println(sourceAsMap); } } client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 SearchType 官网介绍:https://www.elastic.co/guide/en/elasticsearch/reference/current/search-request-search-type.html ES搜索存在的问题 (1)返回数据数量问题 如果数据分散在默认的5个分片上,ES会向5个分片同时发出请求,每个分片同时发出请求,每个分片都返回10条数据,最终会返回总数据为:5*10=50条数据,远远大于用户请求。 解决思路: 第一步:先从每个分片汇总查询的数据id,进行排名,取前10条数据 第二步:根据这10条数据id,到不同分片获取数据 (2)返回数据排名问题 每个分片计算符合条件的前10条数据都是基于自己分片的数据进行打分计算的。计算分值(score)使用的词频和文档频率等信息都是基于自己分片的数据进行的,而ES进行整体排名是基于每个分片计算后的分值进行排序的(打分依据就不一致,最终对这些数据统一排名的时间就不准确了)。 解决思路:将各个分片打分标准统一 SearchType类型1:query and fetch fetch:获取 实现原理: 向索引的所有分片(shard)都发出查询请求,各分片返回的时候把元素文档(document)和计算后的排名信息一起返回。 优点: 这种搜索方式是最快的,因为相比后面的几种搜索方式,这种查询方法只需要去shard查询一次。 缺点: 各个shard返回的结果的数量之和可能是用户要求的size的n倍。 Query Then Fetch SearchType类型2:query then fetch 实现原理: 第一步:先向所有的shard发出请求,各分片只返回文档id(注意:不包括文档document)和排名相关的信息(也就是文档对应的分值) 第二步:然后按照各分片返回的文档的分数进行重新排序和排名,取前size个文档。 优点: 返回的数据量是准确的。 缺点: 数据排名不准确且性能一般。 SearchType类型3:Dfs, query and fetch 这种方式比第一种类型多了一个DFS步骤,它可以更精确控制搜索打分和排名。 实现原理: 第一步:先对所有分片发送请求,把所有分片中的词频和文档频率等打分依据全部汇总到一块。 第二步:然后再执行后面的操作 优点: 数据排名准确 缺点: 搜索性能一般,且返回的数据量不准确,可能返回(N*分片数量)的数据。 Dfs, Query Then Fetch SearchType类型4:Dfs, query then fetch 这种方式比第二种类型多了一个DFS步骤。 实现原理: 第一步:先对所有分片发送请求,把所有分片中的词频和文档频率等打分依据全部汇总到一块。 第二步:然后再执行后面的操作 优点: 返回的数据量是准确的,数据排名也是准确的 缺点: 性能最差(这个最差只是表示在这四种查询方式中性能最慢,也不至于不能忍受,如果对查询性能要求不是非常高,而对查询准确度要求比较高的时候可以考虑这个)。 总结: (1)从性能考虑来说:query_and_fetch是最快的,dfs_query_then_fetch是最慢的。 (2)从搜索的准确度来说:DFS要比非DFS的准确度更高。 (3)ES6.x以后进行了优化,只保留了第2和第4两种类型(即query then fetch和dfs,query then fetch) SearchType示例操作 官网介绍:https://www.elastic.co/guide/en/elasticsearch/client/java-rest/7.1/java-rest-high-search.html @Test public void testSearch() throws IOException { SearchRequest searchRequest = new SearchRequest(); SearchSourceBuilder sourceBuilder = new SearchSourceBuilder(); sourceBuilder.query(QueryBuilders.termQuery("user", "kimchy")); searchRequest.indices("posts"); searchRequest.source(sourceBuilder); searchRequest.searchType(SearchType.DFS_QUERY_THEN_FETCH); SearchResponse searchResponse = client.search(searchRequest, RequestOptions.DEFAULT); SearchHits hits = searchResponse.getHits(); System.out.println(hits.getTotalHits()); client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 查询-Query 分页:from/size 排序:sort 过滤:filter 按查询匹配度排序:explain 测试数据 curl -XPUT 'http://192.168.93.252:9200/test6/' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/1 -d'{"name":"tom","age":18,"info":"tom"}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/2 -d'{"name":"jack","age":29,"info":"jack"}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/3 -d'{"name":"jessica","age":18,"info":"jessica"}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/4 -d'{"name":"dave","age":19,"info":"dave"}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/5 -d'{"name":"lilei","age":18,"info":"lilei"}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/6 -d'{"name":"lili","age":18,"info":"lili"}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/7 -d'{"name":"tom","age":29,"info":"tom"}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/8 -d'{"name":"tom1","age":16,"info":"tom1"}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/9 -d'{"name":"tom2","age":38,"info":"tom2"}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/10 -d'{"name":"tom3","age":28,"info":"tom3"}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/11 -d'{"name":"tom4","age":35,"info":"tom4"}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test6/user/12 -d'{"name":"tom5","age":24,"info":"tom5"}' 1 2 3 4 5 6 7 8 9 10 11 12 13 14 测试代码 @Test public void testQuery() throws IOException { SearchRequest searchRequest = new SearchRequest(); SearchSourceBuilder sourceBuilder = new SearchSourceBuilder(); sourceBuilder //.query(QueryBuilders.matchQuery("info", "marry and john")) //.query(QueryBuilders.matchAllQuery()) //.query(QueryBuilders.multiMatchQuery("john", "name","info"))//多字段匹配 //.query(QueryBuilders.queryStringQuery("name:tom*"))//模糊(正则)匹配 .query(QueryBuilders.termQuery("name","tom"))//精准匹配 .from(0)//分页 .size(2) .sort("age", SortOrder.ASC)//排序 .postFilter(QueryBuilders.rangeQuery("age").from(20).to(40))//过滤 .explain(true)//按查询匹配度排序 ; searchRequest.indices("test6"); searchRequest.source(sourceBuilder); searchRequest.searchType(SearchType.DFS_QUERY_THEN_FETCH); SearchResponse searchResponse = client.search(searchRequest, RequestOptions.DEFAULT); SearchHits hits = searchResponse.getHits(); SearchHit[] hitsArray = hits.getHits(); for (SearchHit searchHit : hitsArray) { System.out.println(searchHit.getSourceAsString()); } client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 聚合-Aggregations 根据字段进行分组统计 根据字段分组,统计其他字段的值 aggregations统计实例一 统计相同年龄的学员个数 姓名 年龄 tom 18 jack 29 jessica 18 dave 19 lilei 18 lili 29 测试代码 @Test public void test1() throws IOException { SearchRequest searchRequest = new SearchRequest(); SearchSourceBuilder sourceBuilder = new SearchSourceBuilder(); //按年龄分组聚合统计 TermsAggregationBuilder aggregationBuilder = AggregationBuilders.terms("by_age").field("age"); sourceBuilder .query(QueryBuilders.matchAllQuery()) .aggregation(aggregationBuilder); searchRequest.indices("test6");//添加索引 searchRequest.source(sourceBuilder); searchRequest.searchType(SearchType.DFS_QUERY_THEN_FETCH); SearchResponse searchResponse = client.search(searchRequest, RequestOptions.DEFAULT); //获取分组聚合后信息 Terms terms = searchResponse.getAggregations().get("by_age"); for (Terms.Bucket tmp : terms.getBuckets()) { Object key = tmp.getKey(); long docCount = tmp.getDocCount(); System.out.println(key+" @ "+docCount); } client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 aggregations统计实例二 统计每个学员的总成绩 姓名 科目 分数 tom 语文 59 tom 数学 89 jack 语文 78 jack 数学 85 jessica 语文 97 jessica 数学 68 测试数据 curl -XPUT 'http://192.168.93.252:9200/test7/' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test7/class/1 -d'{"name":"tom","type":"chinese","score":59}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test7/class/2 -d'{"name":"tom","type":"math","score":89}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test7/class/3 -d'{"name":"tom","type":"english","score":90}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test7/class/4 -d'{"name":"jack","type":"chinese","score":78}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test7/class/5 -d'{"name":"jack","type":"math","score":85}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test7/class/6 -d'{"name":"jack","type":"english","score":80}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test7/class/7 -d'{"name":"jessica","type":"chinese","score":97}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test7/class/8 -d'{"name":"jessica","type":"math","score":68}' curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test7/class/9 -d'{"name":"jessica","type":"english","score":85}' 1 2 3 4 5 6 7 8 9 10 11 测试代码 @Test public void test2() throws IOException { SearchRequest searchRequest = new SearchRequest(); SearchSourceBuilder sourceBuilder = new SearchSourceBuilder(); //按年龄分组聚合统计 TermsAggregationBuilder nameAggregation = AggregationBuilders.terms("by_name").field("name.keyword"); SumAggregationBuilder scoreAggregation = AggregationBuilders.sum("by_score").field("score"); //聚合 nameAggregation.subAggregation(scoreAggregation); sourceBuilder .query(QueryBuilders.matchAllQuery()) .aggregation(nameAggregation); searchRequest.indices("test7");//添加索引 searchRequest.source(sourceBuilder); searchRequest.searchType(SearchType.DFS_QUERY_THEN_FETCH); SearchResponse searchResponse = client.search(searchRequest, RequestOptions.DEFAULT); //获取分组聚合后信息 Terms terms = searchResponse.getAggregations().get("by_name"); for (Terms.Bucket tmp : terms.getBuckets()) { Object key = tmp.getKey(); Sum sum = tmp.getAggregations().get("by_score"); System.out.println(key+" : "+sum.getValue()); } client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 报错 ElasticsearchStatusException[Elasticsearch exception [type=search_phase_execution_exception, reason=all shards failed]]; nested: ElasticsearchException[Elasticsearch exception [type=illegal_argument_exception, reason=Fielddata is disabled on text fields by default. Set fielddata=true on [name] in order to load fielddata in memory by uninverting the inverted index. Note that this can however use significant memory. Alternatively use a keyword field instead.]]; 1 2 3 4 原因 默认情况下,在文本字段上禁用Fielddata 因为Fielddata可能会消耗大量的堆空间,尤其是在加载高基数文本字段时。一旦fielddata已加载到堆中,它将在该段的生命周期内保留。此外,加载fielddata是一个昂贵的过程,可能会导致用户遇到延迟命中。这就是默认情况下禁用fielddata的原因。 官网参考地址:https://www.elastic.co/guide/en/elasticsearch/reference/current/fielddata.html 解决办法 在[name]上设置fielddata = true,以便通过反转索引来加载内存中的fielddata。请注意,这可能会占用大量内存。或者,也可以使用关键字字段 如: curl -H "Content-Type:application/json" -XPOST 'http://192.168.93.252:9200/test7/class/_mapping' -d'{"properties":{"name":{"type":"text","fields":{"keyword":{"type":"keyword"}}}}}' 或者 curl -H "Content-Type:application/json" -XPOST http://192.168.93.252:9200/test7/class/_mapping -d'{"properties": {"name": { "type": "text","fielddata": true}}}' 1 2 3 4 5 分页 SQL语句分页:limit m,n(m:从哪条结果开始 n:size,每次返回多少个结果) ES中使用的是from和size两个参数 from:从哪条结果开始,默认值为0 size:每次返回多少个结果,默认值为10 如:假设每页显示5条数据,那么1至3页的请求就是: GET /_search?size=5 GET /_search?size=5&from=5 GET /_search?size=5&from=10 1 2 3 注意: 不要一次请求过多或者页码过大的结果,这样会对服务器造成很大的压力。因为它们会在返回前排序。一个请求会经过多个分片,每个分片都会生成自己的排序结果。然后再进行集中整理,以确保最终结果的正确性。 多索引和多类型查询 案例 /** * 支持多索引、多类型查询 * @throws IOException */ @Test public void test3() throws IOException { SearchRequest searchRequest = new SearchRequest(); SearchSourceBuilder sourceBuilder = new SearchSourceBuilder(); sourceBuilder.query(QueryBuilders.matchAllQuery()) .from(0) .size(100); //searchRequest.indices("test");//单个索引 //searchRequest.indices("test","test2","posts"); searchRequest.indices("test*");//通配符匹配 searchRequest.source(sourceBuilder); searchRequest.searchType(SearchType.DFS_QUERY_THEN_FETCH); SearchResponse searchResponse = client.search(searchRequest, RequestOptions.DEFAULT); SearchHits hits = searchResponse.getHits(); SearchHit[] hitsArray = hits.getHits(); for (SearchHit searchHit : hitsArray) { System.out.println(searchHit.getSourceAsString()); } client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 极速查询 ES将数据存储在不同的分片中,根据文档id通过内部算法得出要将文档存储在哪个分片上,所以在查询时只要指定在对应的分片上进行查询就可以实现基于ES的极速查询。 知道数据在哪个分片上,是解决问题的关键 实现方式:可以通过路由参数来设置数据存储在同一个分片中,setRouting("") org.elasticsearch.cluster.routing--------------OperationRouting-------------indexShards 批量插入测试数据 /** * 极速查询,批量插入测试数据 * @throws IOException */ @Test public void test4() throws IOException { Map<String, Object> jsonMap = new HashMap<>(); jsonMap.put("phone", "13322225555"); jsonMap.put("name", "zhangsan"); jsonMap.put("sex", "M"); jsonMap.put("age", "20"); Map<String, Object> jsonMap2 = new HashMap<>(); jsonMap2.put("phone", "13410252356"); jsonMap2.put("name", "lisi"); jsonMap2.put("sex", "M"); jsonMap2.put("age", "28"); Map<String, Object> jsonMap3 = new HashMap<>(); jsonMap3.put("phone", "18844662587"); jsonMap3.put("name", "wangwu"); jsonMap3.put("sex", "F"); jsonMap3.put("age", "18"); Map<String, Object> jsonMap4 = new HashMap<>(); jsonMap4.put("phone", "16655882345"); jsonMap4.put("name", "zhaoliu"); jsonMap4.put("sex", "F"); jsonMap4.put("age", "24"); Map<String, Object> jsonMap5 = new HashMap<>(); jsonMap5.put("phone", "18563248923"); jsonMap5.put("name", "tianqi"); jsonMap5.put("sex", "F"); jsonMap5.put("age", "22"); Map<String, Object> jsonMap6 = new HashMap<>(); jsonMap6.put("phone", "18325684532"); jsonMap6.put("name", "qiba"); jsonMap6.put("sex", "M"); jsonMap6.put("age", "26"); //批量插入 BulkRequest bulkRequest = new BulkRequest(); bulkRequest.add(new IndexRequest("test8").routing(jsonMap.get("phone").toString().substring(0, 3)).source(jsonMap)) .add(new IndexRequest("test8").routing(jsonMap2.get("phone").toString().substring(0, 3)).source(jsonMap2)) .add(new IndexRequest("test8").routing(jsonMap3.get("phone").toString().substring(0, 3)).source(jsonMap3)) .add(new IndexRequest("test8").routing(jsonMap4.get("phone").toString().substring(0, 3)).source(jsonMap4)) .add(new IndexRequest("test8").routing(jsonMap5.get("phone").toString().substring(0, 3)).source(jsonMap5)) .add(new IndexRequest("test8").routing(jsonMap6.get("phone").toString().substring(0, 3)).source(jsonMap6)); //同步执行 BulkResponse bulkResponse = client.bulk(bulkRequest, RequestOptions.DEFAULT); for (BulkItemResponse bulkItemResponse : bulkResponse) { if (bulkItemResponse.isFailed()) { BulkItemResponse.Failure failure = bulkItemResponse.getFailure(); System.out.println(failure.getMessage()); } } client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 通过路由极速查询 /** * 通过路由极速查询,实现 代码 * @throws IOException */ @Test public void test5() throws IOException { SearchRequest searchRequest = new SearchRequest(); SearchSourceBuilder sourceBuilder = new SearchSourceBuilder(); sourceBuilder.query(QueryBuilders.matchAllQuery()) .from(0) .size(10); searchRequest.indices("test8"); searchRequest.source(sourceBuilder); searchRequest.searchType(SearchType.DFS_QUERY_THEN_FETCH); searchRequest.routing("18325684532".substring(0, 3)); SearchResponse searchResponse = client.search(searchRequest, RequestOptions.DEFAULT); SearchHits hits = searchResponse.getHits(); SearchHit[] hitsArray = hits.getHits(); for (SearchHit searchHit : hitsArray) { System.out.println(searchHit.getSourceAsString()); } client.close(); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 ElasticSearch索引模块 索引模块组成部分 官网说明:https://www.elastic.co/guide/en/elasticsearch/reference/current/analysis.html (1)索引分析模块-Analysis 分析器 - 包含:字符过滤器,标记器和令牌过滤器。 字符过滤器-Character Filters 一个analyzer(分析器)可以具有零个或多个字符过滤器,这些过滤器按顺序应用。 分解器-Tokenizers 一个analyzer(分析器)必须只有一个标记器。 词元过滤器-Token Filters 一个analyzer(分析器)可以具有零个或多个令牌过滤器,这些过滤器按顺序应用。 (2)索引建立模块-Indexer 在建立索引过程中,分析处理的文档将被加入到索引列表。 集成IK中文分词插件 下载ES的IK插件https://github.com/medcl/elasticsearch-analysis-ik 使用maven进行源码编译(可以在Windows上进行编译) mvn clean package 上传并解压releases下的文件到ES插件目录 cp /opt/tools/elk/es-ik-7.1.0/target/releases/elasticsearch-analysis-ik-7.1.0.zip ES_HOME/plugins/ik unzip elasticsearch-analysis-ik-7.1.0.zip 重启ES服务 自定义IK词库 测试新词: curl -H "Content-Type: application/json" -XGET http://192.168.93.252:9200/_analyze?pretty -d'{"analyzer":"ik_max_word","text":"蓝瘦香菇"}' { "tokens" : [ { "token" : "蓝", "start_offset" : 0, "end_offset" : 1, "type" : "CN_CHAR", "position" : 0 }, { "token" : "瘦", "start_offset" : 1, "end_offset" : 2, "type" : "CN_CHAR", "position" : 1 }, { "token" : "香菇", "start_offset" : 2, "end_offset" : 4, "type" : "CN_WORD" 文章目录 1. 单节点安装 2. ES安装head插件 3. Elasticsearch Rest基本操作 REST介绍 CURL创建索引库 查询索引-GET DSL查询 MGET查询 HEAD的使用 ES更新索引 ES删除索引 ES批量操作-bulk ES版本控制 4. Elasticsearch 核心概念 Cluster Shards Replicas Recovery Gateway Discovery.zen Transport Create Index Mapping 5. Elasticsearch Java 客户端 Java High Level REST Client Java高级客户端 Document APIs Index API Get API Exists API Update API Delete API Bulk API Multi-Get API SearchType Query Then Fetch Dfs, Query Then Fetch 查询-Query 聚合-Aggregations 分页 多索引和多类型查询 极速查询 ElasticSearch索引模块 索引模块组成部分 集成IK中文分词插件 自定义IK词库 热更新IK词库 ES集群安装部署 ES集群规划 ES集群安装 X-Pack安装 Kibana安装 ES优化 集群脑裂优化设置 增大系统打开文件数 合理设置JVM内存 锁定物理内存 合理设置分片 合理设置副本数 合并索引 关闭索引 清除删除文档 合理数据导入 设置索引_all 设置索引_source 版本一致 软件版本 jdk-8u192-linux-x64.tar.gz elasticsearch-7.1.0-linux-x86_64.tar.gz

优秀的个人博客,低调大师

Golang学习笔记--slice使用总结

切片对数组进行包装,为数据序列提供了更通用、更强大和更方便的接口。Go中的大多数数组编程都是用切片而不是简单的数组来完成的 slice(切片)代表变长的序列,序列中每个元素都有相同的类型。一个slice类型一般写作[]T,其中T代表slice中元素的类型。 1.slice创建 直接通过初始化参数创建 slice0 := []int{1,3,7,5,2,3,4} fmt.Println(slice0,len(slice0),cap(slice0)) // [1 3 7 5 2 3 4] 7 7 使用内置函数make创建。使用默认值进行初始化 slice1 := make([]int,5,10) fmt.Println(slice1,len(slice1),cap(slice1)) // [0 0 0 0 0] 5 10 从指定下标创建。没指定的将使用默认值进行初始化,比如int类型是0值,string类型是空串。 slice2 := [...]int{1:1,12:12} fmt.Println(slice2) // [0 1 0 0 0 0 0 0 0 0 0 0 12] fmt.Println(slice2[0],len(slice2),cap(slice2)) // 0 13 13 2.slice的操作 下标索引操作 slice3 := []int{1,3,7,5,2,3,4} fmt.Println(slice3[1]) // 3 fmt.Println(slice3[10]) // 运行时报panic: runtime error: index out of range [10] with length 7 for循环操作 slice3 := []int{1,3,7,5,2,3,4} for _,val := range slice3{ fmt.Println(val) } 切片操作。跟python里面切片一样 slice3 := []int{1,3,7,5,2,3,4} fmt.Println(slice3[2:4]) // [7 5] 两个slice不能直接使用 ==进行比较。slice唯一合法的比较操作是和nil比较 slice4 := []int{1,3,7,5,2,3,4} slice5 := slice4[2:4] fmt.Println(slice4 == slice5) // 提示:Invalid operation: slice4 == slice5 (operator == is not defined on []int) fmt.Println(slice4 != nil) // true 内置函数的len和cap函数分别返回slice的长度和容量 内置函数append进行添加操作 slice6 := []int{1,3,7,5,2,3,4} slice7 := append(slice6,0) slice8 := append(slice7,9,8) fmt.Println(slice7) // [1 3 7 5 2 3 4 0] fmt.Println(slice8) // [1 3 7 5 2 3 4 0 9 8] fmt.Println(append(slice6,slice7...)) // 两个slice进行添加 // [1 3 7 5 2 3 4 1 3 7 5 2 3 4 0] 内置函数copy进行拷贝操作 slice10 := []int{1,3,7,5,2,3,4} var slice9 = make([]int,len(slice10)) fmt.Println(slice9,len(slice9),cap(slice9)) // [0 0 0 0 0 0 0] 7 7 copy(slice9,slice10) fmt.Println(slice9,len(slice9),cap(slice9)) // [1 3 7 5 2 3 4] 7 7 3.slice的使用注意点 切片保存对底层数组的引用,如果将一个切片分配给另一个切片,则两个切片都引用同一个数组。修改切片的值,会同时影响到源切片的数据 slice11 := []int{1,3,7,5,2,3,4} slice12 := slice11[2:5] slice12[1] = 10 fmt.Println(slice11) // [1 3 7 10 2 3 4] fmt.Println(slice12) // [7 10 2] 如果函数接受slice参数,则调用者可以看到它对slice元素所做的更改,类似于传递指向底层数组的指针。 slice13 := []int{1,3,7,5,2,3,4} reverse(slice13) fmt.Println(slice13) // [4 3 2 5 7 3 1] func reverse(input_slice []int){ slice_len := len(input_slice) for i := 0 ; i < slice_len / 2; i++ { input_slice[i], input_slice[slice_len - i - 1] = input_slice[slice_len - i -1], input_slice[i] } } slice没有提供直接删除的切片某个元素的内置函数,可以自己组合切片来实现 slice13 := []int{1,3,7,5,2,3,4} slice14 := append(slice13[:2],slice13[4:len(slice13)]...) fmt.Println(slice14) // [4 3 7 3 1] 删除下标为3的元素 在边界处拷贝 Slices 和 Maps(uber_go_guide) 接收 Slices的时候注意拷贝。当 map 或 slice 作为函数参数传入时,如果您存储了对它们的引用,则用户可以对其进行修改。 func (d *Driver) SetTrips(trips []Trip) { d.trips = make([]Trip, len(trips)) copy(d.trips, trips) } trips := ... d1.SetTrips(trips) // 这里我们修改 trips[0],但不会影响到 d1.trips trips[0] = ... 返回 slices的时候注意拷贝。同样,请注意用户对暴露内部状态的 map 或 slice 的修改。 type Stats struct { mu sync.Mutex counters map[string]int } func (s *Stats) Snapshot() map[string]int { s.mu.Lock() defer s.mu.Unlock() result := make(map[string]int, len(s.counters)) for k, v := range s.counters { result[k] = v } return result } // snapshot 现在是一个拷贝 snapshot := stats.Snapshot() 4.slice的runtime的部分实现 // slice.go package runtime // slice的底层的实现结构 type slice struct { array unsafe.Pointer // 一个数组的指针 len int cap int } ... // slice的创建 func makeslice(et *_type, len, cap int) unsafe.Pointer { mem, overflow := math.MulUintptr(et.size, uintptr(cap)) // uintptr的type的大小 * cap大小的uint指针类型 if overflow || mem > maxAlloc || len < 0 || len > cap { // 计算有没有溢出 mem, overflow := math.MulUintptr(et.size, uintptr(len)) if overflow || mem > maxAlloc || len < 0 { panicmakeslicelen() } panicmakeslicecap() } return mallocgc(mem, et, true)// 使用mallockgc进行内存分配, 并返回unsafe.Pointer指针,指向数组 } // append超过容量的时候,进行容量扩展 func growslice(et *_type, old slice, cap int) slice { if raceenabled { callerpc := getcallerpc() racereadrangepc(old.array, uintptr(old.len*int(et.size)), callerpc, funcPC(growslice)) } if msanenabled { msanread(old.array, uintptr(old.len*int(et.size))) } if cap < old.cap { panic(errorString("growslice: cap out of range")) } if et.size == 0 { // append不应该创建一个带有nil指针但有非零len的切片 return slice{unsafe.Pointer(&zerobase), old.len, cap} } // 计算容量扩容后新的容量 newcap := old.cap doublecap := newcap + newcap if cap > doublecap { // 新建的容量大于旧容量的两倍,直接使用当前的容量 newcap = cap } else { if old.len < 1024 { // 如果就长度小于1024,直接使用旧的2倍容量 newcap = doublecap } else { // 如果旧的容量小于当前容量,则按25%的幅度循环进行增长,直到大于当前容量 for 0 < newcap && newcap < cap { newcap += newcap / 4 } if newcap <= 0 { newcap = cap } } } var overflow bool var lenmem, newlenmem, capmem uintptr switch { case et.size == 1: lenmem = uintptr(old.len) newlenmem = uintptr(cap) capmem = roundupsize(uintptr(newcap)) overflow = uintptr(newcap) > maxAlloc newcap = int(capmem) case et.size == sys.PtrSize: lenmem = uintptr(old.len) * sys.PtrSize newlenmem = uintptr(cap) * sys.PtrSize capmem = roundupsize(uintptr(newcap) * sys.PtrSize) overflow = uintptr(newcap) > maxAlloc/sys.PtrSize newcap = int(capmem / sys.PtrSize) case isPowerOfTwo(et.size): var shift uintptr if sys.PtrSize == 8 { // Mask shift for better code generation. shift = uintptr(sys.Ctz64(uint64(et.size))) & 63 } else { shift = uintptr(sys.Ctz32(uint32(et.size))) & 31 } lenmem = uintptr(old.len) << shift newlenmem = uintptr(cap) << shift capmem = roundupsize(uintptr(newcap) << shift) overflow = uintptr(newcap) > (maxAlloc >> shift) newcap = int(capmem >> shift) default: lenmem = uintptr(old.len) * et.size newlenmem = uintptr(cap) * et.size capmem, overflow = math.MulUintptr(et.size, uintptr(newcap)) capmem = roundupsize(capmem) newcap = int(capmem / et.size) } if overflow || capmem > maxAlloc { panic(errorString("growslice: cap out of range")) } // 创建新的slice的数组 var p unsafe.Pointer if et.ptrdata == 0 { p = mallocgc(capmem, nil, false) memclrNoHeapPointers(add(p, newlenmem), capmem-newlenmem) } else { p = mallocgc(capmem, et, true) if lenmem > 0 && writeBarrier.enabled { bulkBarrierPreWriteSrcOnly(uintptr(p), uintptr(old.array), lenmem-et.size+et.ptrdata) } } // 将旧的数组复制到新的数组 memmove(p, old.array, lenmem) // 返回新的slice结构 return slice{p, old.len, newcap} } // slice的copy操作 func slicecopy(toPtr unsafe.Pointer, toLen int, fmPtr unsafe.Pointer, fmLen int, width uintptr) int { if fmLen == 0 || toLen == 0 { return 0 } n := fmLen if toLen < n { n = toLen } if width == 0 { return n } if raceenabled { callerpc := getcallerpc() pc := funcPC(slicecopy) racereadrangepc(fmPtr, uintptr(n*int(width)), callerpc, pc) racewriterangepc(toPtr, uintptr(n*int(width)), callerpc, pc) } if msanenabled { msanread(fmPtr, uintptr(n*int(width))) msanwrite(toPtr, uintptr(n*int(width))) } size := uintptr(n) * width if size == 1 { // common case worth about 2x to do here // 长度为1表示只是一个字节,直接进行赋值 *(*byte)(toPtr) = *(*byte)(fmPtr) } else { // 否则使用内存内存拷贝,将源地址数据拷贝到新的数组 memmove(toPtr, fmPtr, size) } return n }

优秀的个人博客,低调大师

Spring学习笔记(六):MyBatis集成

1 概述 MyBaits是一个著名的持久层框架,本文首先介绍了MyBatis的简单使用,接着与Spring进行整合,最后简单地使用了Generator去自动生成代码。 2 MyBatis简介 MyBatis本来是Apache的一个开源项目——iBatis,2010年由Apaceh Software Foundation迁移到了Google Code,并改名为MyBatis。 MyBatis是一个基于Java的持久层框架,提供的持久层框架包括SQL Maps和Data Access Objects,使用简单的XML或者注解用于配置映射,将接口和POJO映射成数据库中的记录,是一个小巧、方便、高效、简单、直接、半自动化的持久层框架。 3 工作原理 上图: 读取配置文件:mybatis-config.xml是全局MyBatis配置文件,配置了MyBatis运行环境信息 加载映射文件:也就是SQL映射文件,配置了操作数据库的SQL语句 构造会话工厂:通过配置文件构造会话工厂SqlSessionFactory 创建会话对象:由上一步的会话工厂创建会话对象SqlSession 获取MapperStatement:通过用户调用的api的Statement ID获取MapperStatement对象 输入参数映射:通过Executor对MapperStatement进行解析,将各种Java基本类型转化为SQL操作语句中的类型 输出结果映射:JDBC执行SQL后,借助MapperStatement的映射关系将返回结果转化为Java基本类型并返回 4 MyBatis示例 首先先来看一下纯MyBaits的示例,没有整合Spring,一个简单的Maven工程,项目结构如下: 4.1 依赖 <dependency> <groupId>org.mybatis</groupId> <artifactId>mybatis</artifactId> <version>3.5.5</version> </dependency> <dependency> <groupId>org.projectlombok</groupId> <artifactId>lombok</artifactId> <version>1.18.12</version> </dependency> <!--驱动用的是MySQL,版本请自行修改--> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>8.0.21</version> </dependency> Gradle: compile group: 'org.mybatis', name: 'mybatis', version: '3.5.5' compile group: 'mysql', name: 'mysql-connector-java', version: '8.0.21' 4.2 实体类 @Setter @Getter @Builder public class User { private Integer id; private String name; @Override public String toString() { return "id:"+id+"\tname:"+name; } } 4.3 映射文件 新建一个叫UserMapper.xml的映射文件: <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="UserMapper"> <select id="selectById" parameterType="Integer" resultType="pers.entity.User"> select * from user where id=#{id} </select> <select id="selectAll" resultType="pers.entity.User"> select * from user </select> <insert id="insert" parameterType="pers.entity.User"> INSERT INTO `user` (`id`,`name`) VALUES (#{id},#{name}) </insert> <update id="update" parameterType="pers.entity.User"> UPDATE `user` set `name`=#{name} where id=#{id} </update> <delete id="delete" parameterType="Integer"> DELETE FROM `user` WHERE `id` = #{id} </delete> </mapper> 映射文件是一个XML文件,根元素为<mapper>,需要注意其中的namespace属性,调用的时候通过该namespace调用。其中的子元素表示SQL语句: <select>:查询,id指定了这条语句的id号,调用时通过namespace.id的方式调用,比如该条select需要通过UserMapper.selectById调用,parameterType指定参数类型,这里是一个Integer的参数,resultType指定返回类型,实体类 <insert>/<update>/<delete>:对应的插入/修改/删除语句 关于占位符:#{}表示是占位符,相当于传统JDBC中的?,#{id}表示该占位符等待接收的参数名称为id 4.4 配置文件 MyBatis的配置文件,叫mybatis-config.xml: <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE configuration PUBLIC "-//mybatis.org//DTD Config 3.0//EN" "http://mybatis.org/dtd/mybatis-3-config.dtd"> <configuration> <environments default="development"> <environment id="development"> <transactionManager type="JDBC" /> <dataSource type="POOLED"> <property name="driver" value="com.mysql.cj.jdbc.Driver"/> <property name="url" value="jdbc:mysql://localhost:3306/test"/> <property name="username" value="test"/> <property name="password" value="test"/> </dataSource> </environment> </environments> <mappers> <mapper resource="mapper/UserMapper.xml" /> </mappers> </configuration> 指定了数据库的一些连接属性还有mapper的位置。 4.5 测试 public class Main { public static void main(String[] args) { try { InputStream inputStream = Resources.getResourceAsStream("config/mybatis-config.xml"); SqlSessionFactory factory = new SqlSessionFactoryBuilder().build(inputStream); SqlSession session = factory.openSession(); User user = session.selectOne("UserMapper.selectById",1); System.out.println(user); User user1 = User.builder().name("test").build(); session.insert("UserMapper.insert",user1); user1.setName("222"); session.update("UserMapper.update",user1); List<User> list = session.selectList("UserMapper.selectAll"); list.forEach(System.out::println); session.delete("UserMapper.delete",1); session.commit(); session.close(); } catch (Exception e) { e.printStackTrace(); } } } 主要流程如下: 读取配置文件:根据org.apache.ibatis.io.Resources读取配置文件mybatis-config.xml,请注意配置文件的位置正确,这里的配置文件都放在resources下,mybatis-config.xml放在其中的config下 构建Session:根据配置文件构建SqlSessionFactory后,通过openSession创建Session 业务操作:通过session的selectOne/insert/update等进行业务操作,这类操作带两个参数,第一个参数是String,表示配置文件中的SQL语句,采用namespace.id的形式,比如这里的UserMapper.xml中声明namespace为UserMapper,其中带有一条id为selectById的select语句,因此调用时使用UserMapper.selectById的形式,第二个参数是一个Object,表示要传递的参数,也就是绑定到配置文件中对应占位符的值 提交与关闭:业务操作完成后提交事务并关闭session 示例测试结果: 5 Spring整合示例 上面的例子只是为了演示MyBatis的基本使用,没有整合Spring,这里的例子是把Spring整合进来,流程也大概差不多,项目结构如下: 5.1 依赖 分为5类JAR: MyBatis需要的JAR Spring需要的JAR MyBatis与Spring整合的中间JAR 数据库驱动JAR 数据源JAR 完整依赖如下: <dependency> <groupId>org.springframework</groupId> <artifactId>spring-context</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-core</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-beans</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-web</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.projectlombok</groupId> <artifactId>lombok</artifactId> <version>1.18.12</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-jdbc</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>8.0.21</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-tx</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.mybatis</groupId> <artifactId>mybatis</artifactId> <version>3.5.5</version> </dependency> <dependency> <groupId>org.mybatis</groupId> <artifactId>mybatis-spring</artifactId> <version>2.0.5</version> </dependency> <dependency> <groupId>org.apache.commons</groupId> <artifactId>commons-dbcp2</artifactId> <version>2.8.0</version> </dependency> Gradle: compile group: 'org.springframework', name: 'spring-beans', version: '5.2.9.RELEASE' compile group: 'org.springframework', name: 'spring-context', version: '5.2.9.RELEASE' compile group: 'org.springframework', name: 'spring-core', version: '5.2.9.RELEASE' compile group: 'org.springframework', name: 'spring-tx', version: '5.2.9.RELEASE' compile group: 'org.springframework', name: 'spring-jdbc', version: '5.2.9.RELEASE' compile group: 'mysql', name: 'mysql-connector-java', version: '8.0.21' compile group: 'org.apache.commons', name: 'commons-dbcp2', version: '2.8.0' compile group: 'org.mybatis', name: 'mybatis', version: '3.5.5' compile group: 'org.mybatis', name: 'mybatis-spring', version: '2.0.5' 5.2 配置文件 配置文件分为三类: MyBatis映射文件:编写mapper的地方,也就是业务需要的SQL语句 MyBatis全局配置文件:由于整合了Spring,数据源的配置放在了Spring的配置文件中,而只需要保留mapper的查找位置 Spring配置文件:配置数据源+事务管理+MyBaits的sqlSssionFactory+组件扫描 5.2.1 MyBatis映射文件 与上面的例子差不多,只是修改了namespace为包名.类名的形式: <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="pers.dao.UserDao"> <select id="selectById" parameterType="Integer" resultType="pers.entity.User"> select * from user where id=#{id} </select> <select id="selectAll" resultType="pers.entity.User"> select * from user </select> <insert id="insert" parameterType="pers.entity.User"> INSERT INTO `user` (`id`,`name`) VALUES (#{id},#{name}) </insert> <update id="update" parameterType="pers.entity.User"> UPDATE `user` set `name`=#{name} where id=#{id} </update> <delete id="delete" parameterType="Integer"> DELETE FROM `user` WHERE `id` = #{id} </delete> </mapper> namespace需要与对应包名的带有@Mapper的类配置一致。 5.2.2 MyBatis配置文件 <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE configuration PUBLIC "-//mybatis.org//DTD Config 3.0//EN" "http://mybatis.org/dtd/mybatis-3-config.dtd"> <configuration> <mappers> <mapper resource="mapper/UserMapper.xml" /> </mappers> </configuration> 5.2.3 Spring配置文件 <?xml version="1.0" encoding="utf-8" ?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xmlns:tx="http://www.springframework.org/schema/tx" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/tx http://www.springframework.org/schema/tx/spring-tx.xsd http://www.springframework.org/schema/context https://www.springframework.org/schema/context/spring-context.xsd" > <context:component-scan base-package="pers.dao"/> <context:component-scan base-package="pers.service"/> <!--数据源--> <bean id="dataSource" class="org.apache.commons.dbcp2.BasicDataSource"> <property name="driverClassName" value="com.mysql.cj.jdbc.Driver"/> <property name="url" value="jdbc:mysql://localhost:3306/test"/> <property name="username" value="test"/> <property name="password" value="test"/> <!--最大连接数+最大空闲数+初始连接数--> <property name="maxTotal" value="30"/> <property name="maxIdle" value="10"/> <property name="initialSize" value="5"/> </bean> <!--事务管理--> <bean id="txManager" class="org.springframework.jdbc.datasource.DataSourceTransactionManager"> <property name="dataSource" ref="dataSource"/> </bean> <!--开启事务注解--> <tx:annotation-driven transaction-manager="txManager" /> <!--创建SqlSessionFactory Bean--> <bean id="sqlSessionFactory" class="org.mybatis.spring.SqlSessionFactoryBean"> <property name="dataSource" ref="dataSource"/> <property name="configLocation" value="classpath:config/mybatis-config.xml"/> </bean> <!--注解扫描,主要用于@Mapper,会扫描basePackge下的@Mapper注解的接口并自动装配为MyBatis的映射接口--> <bean class="org.mybatis.spring.mapper.MapperScannerConfigurer"> <property name="basePackage" value="pers.dao"/> <property name="sqlSessionFactoryBeanName" value="sqlSessionFactory"/> </bean> </beans> 5.3 持久层 需要加上@Mapper注解,表示自动装配为MyBatis的映射接口,注意: 映射文件中的namespace需要与包名.类名对应,比如这里的包为pers.dao,类名为UserDao,那么映射文件中的namespace为pers.dao.UserDao id需要与方法名对应,比如映射文件中的有一条select语句的id为selectById,那么方法就需要命名为selectById,且参数类型需要对应一致 @Repository @Mapper public interface UserDao { User selectById(Integer id); List<User> selectAll(); int insert(User user); int update(User user); int delete(Integer id); } 5.4 业务层 @Service @Transactional @RequiredArgsConstructor(onConstructor = @__(@Autowired)) public class MyBatisService { private final UserDao dao; public void test(){ User user = dao.selectById(13); System.out.println(user); dao.insert(User.builder().name("333").build()); dao.update(User.builder().name("88888").id(13).build()); dao.selectAll().forEach(System.out::println); dao.delete(12); dao.selectAll().forEach(System.out::println); } } 注入UserDao后进行简单的测试,结果如下: 6 自动生成代码 相信很多程序员也讨厌写又长又麻烦的XML配置文件,因此,MyBatis也提供了一个生成器插件,可以直接从表中生成实体类、dao接口以及映射文件,可以省去很多操作。 步骤如下: 导入依赖 编写Generator配置文件 生成代码 6.1 依赖 其实就是加入一个插件: <build> <plugins> <plugin> <groupId>org.mybatis.generator</groupId> <artifactId>mybatis-generator-maven-plugin</artifactId> <version>1.4.0</version> <configuration> <!-- 在控制台打印执行日志 --> <verbose>true</verbose> <!-- 重复生成时会覆盖之前的文件--> <overwrite>true</overwrite> <configurationFile>src/main/resources/generatorConfig.xml</configurationFile> </configuration> <dependencies> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>8.0.21</version> </dependency> </dependencies> </plugin> </plugins> </build> 数据库驱动请对应修改。 至于Gradle版请看Kotlin版源码。 6.2 配置文件 这里是参考别人的配置文件,修改数据库连接、表名、包名即可: <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE generatorConfiguration PUBLIC "-//mybatis.org//DTD MyBatis Generator Configuration 1.0//EN" "http://mybatis.org/dtd/mybatis-generator-config_1_0.dtd"> <generatorConfiguration> <!-- context 是逆向工程的主要配置信息 --> <!-- id:起个名字 --> <!-- targetRuntime:设置生成的文件适用于那个 mybatis 版本 --> <context id="default" targetRuntime="MyBatis3"> <!--optional,指在创建class时,对注释进行控制--> <commentGenerator> <property name="suppressDate" value="true"/> <!-- 是否去除自动生成的注释 true:是 : false:否 --> <property name="suppressAllComments" value="true"/> </commentGenerator> <!--jdbc的数据库连接 wg_insert 为数据库名字--> <jdbcConnection driverClass="com.mysql.cj.jdbc.Driver" connectionURL="jdbc:mysql://localhost:3306/test" userId="test" password="test" /> <!--非必须,类型处理器,在数据库类型和java类型之间的转换控制--> <javaTypeResolver> <!-- 默认情况下数据库中的 decimal,bigInt 在 Java 对应是 sql 下的 BigDecimal 类 --> <!-- 不是 double 和 long 类型 --> <!-- 使用常用的基本类型代替 sql 包下的引用类型 --> <property name="forceBigDecimals" value="false"/> </javaTypeResolver> <!-- targetPackage:生成的实体类所在的包 --> <!-- targetProject:生成的实体类所在的硬盘位置 --> <javaModelGenerator targetPackage="pers.entity" targetProject="src/main/java"> <!-- 是否允许子包 --> <property name="enableSubPackages" value="false"/> <!-- 是否对modal添加构造函数 --> <property name="constructorBased" value="true"/> <!-- 是否清理从数据库中查询出的字符串左右两边的空白字符 --> <property name="trimStrings" value="true"/> <!-- 建立modal对象是否不可改变 即生成的modal对象不会有setter方法,只有构造方法 --> <property name="immutable" value="false"/> </javaModelGenerator> <!-- targetPackage 和 targetProject:生成的 mapper 文件的包和位置 --> <sqlMapGenerator targetPackage="mapper" targetProject="src/main/resources"> <!-- 针对数据库的一个配置,是否把 schema 作为字包名 --> <property name="enableSubPackages" value="false"/> </sqlMapGenerator> <!-- targetPackage 和 targetProject:生成的 interface 文件的包和位置 --> <javaClientGenerator type="XMLMAPPER" targetPackage="pers.dao" targetProject="src/main/java"> </javaClientGenerator> <!-- tableName是数据库中的表名,domainObjectName是生成的JAVA模型名,后面的参数不用改,要生成更多的表就在下面继续加table标签 --> <table tableName="user" domainObjectName="User" enableCountByExample="false" enableUpdateByExample="false" enableDeleteByExample="false" enableSelectByExample="false" selectByExampleQueryId="false" /> </context> </generatorConfiguration> 6.3 生成代码 双击生成即可: 生成了实体类、dao接口以及mapper文件。 7 参考源码 Java版: Github 码云 CODE.CHINA Kotlin版: Github 码云 CODE.CHINA 8 参考链接 简书-IDEA使用mybatis-generator Github-mybatis-generator-plugin

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册