首页 文章 精选 留言 我的

精选列表

搜索[失败归因],共10006篇文章
优秀的个人博客,低调大师

微软修复 Windows 11 导致复制、保存失败的 bug

Microsoft 解决了在 Windows 11 22H2 设备上保存和复制文件时出现间歇性故障的 bug(尤其是在使用网络共享时)。 这个反复出现的问题只会影响使用 CopyFile API ,且也是大地址感知(large address aware)的 Windows 应用程序。Microsoft Office 应用程序(如 Word 和 Excel)的用户也可能会遇到复制和保存问题,但仅限于使用 32 位版本时。在这种情况下,受影响的用户将看到“文档未保存”错误消息。 微软表示,在使用利用扩展文件属性的特定商业或企业安全软件时,Windows 设备受此特定问题影响的风险更高。在个人或非托管商业环境中使用 Windows 设备的用户则不太可能遇到这个问题。 目前微软已经通过最新发布的 KB5027231 Windows 11 累积更新解决了这个 bug,该修补已通过已知问题回滚 (KIR) 同时修复了 Windows 10 的相同 BUG。

优秀的个人博客,低调大师

Spark1.4启动spark-shell时initializing失败

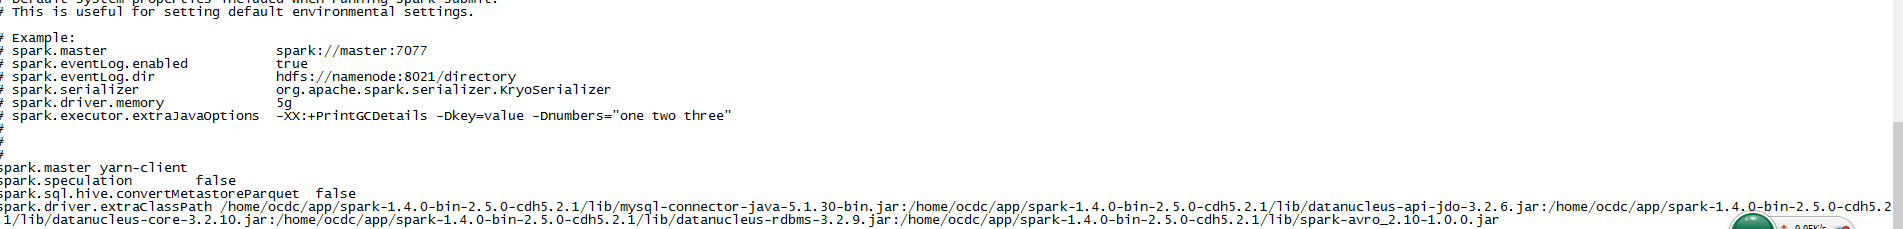
错误信息如下: 5/11/03 16:48:15 INFO spark.SparkContext: Running Spark version 1.4.1 15/11/03 16:48:15 WARN spark.SparkConf: In Spark 1.0 and later spark.local.dir will be overridden by the value set by the cluster manager (via SPARK_LOCAL_DIRS in mesos/standalone and LOCAL_DIRS in YARN). 15/11/03 16:48:15 WARN spark.SparkConf: SPARK_JAVA_OPTS was detected (set to '-verbose:gc -XX:-UseGCOverheadLimit -XX:+UseCompressedOops -XX:-PrintGCDetails -XX:+PrintGCTimeStamps -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/home/xujingwen/ocdc/spark-1.4.1-bin-hadoop2.6/1103164805.hprof'). This is deprecated in Spark 1.0+. Please instead use: - ./spark-submit with conf/spark-defaults.conf to set defaults for an application - ./spark-submit with --driver-java-options to set -X options for a driver - spark.executor.extraJavaOptions to set -X options for executors - SPARK_DAEMON_JAVA_OPTS to set java options for standalone daemons (master or worker) 15/11/03 16:48:15 WARN spark.SparkConf: Setting 'spark.executor.extraJavaOptions' to '-verbose:gc -XX:-UseGCOverheadLimit -XX:+UseCompressedOops -XX:-PrintGCDetails -XX:+PrintGCTimeStamps -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/home/xujingwen/ocdc/spark-1.4.1-bin-hadoop2.6/1103164805.hprof' as a work-around. 15/11/03 16:48:15 WARN spark.SparkConf: Setting 'spark.driver.extraJavaOptions' to '-verbose:gc -XX:-UseGCOverheadLimit -XX:+UseCompressedOops -XX:-PrintGCDetails -XX:+PrintGCTimeStamps -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/home/xujingwen/ocdc/spark-1.4.1-bin-hadoop2.6/1103164805.hprof' as a work-around. 15/11/03 16:48:15 WARN spark.SparkConf: SPARK_CLASSPATH was detected (set to ':ls $SPARK_HOME/lib/*.jar'). This is deprecated in Spark 1.0+. Please instead use: - ./spark-submit with --driver-class-path to augment the driver classpath - spark.executor.extraClassPath to augment the executor classpath 15/11/03 16:48:15 WARN spark.SparkConf: Setting 'spark.executor.extraClassPath' to ':ls $SPARK_HOME/lib/*.jar' as a work-around. 15/11/03 16:48:15 ERROR spark.SparkContext: Error initializing SparkContext. org.apache.spark.SparkException: Found both spark.driver.extraClassPath and SPARK_CLASSPATH. Use only the former. at org.apache.spark.SparkConf$$anonfun$validateSettings$6$$anonfun$apply$8.apply(SparkConf.scala:444) at org.apache.spark.SparkConf$$anonfun$validateSettings$6$$anonfun$apply$8.apply(SparkConf.scala:442) at scala.collection.immutable.List.foreach(List.scala:318) at org.apache.spark.SparkConf$$anonfun$validateSettings$6.apply(SparkConf.scala:442) at org.apache.spark.SparkConf$$anonfun$validateSettings$6.apply(SparkConf.scala:430) at scala.Option.foreach(Option.scala:236) at org.apache.spark.SparkConf.validateSettings(SparkConf.scala:430) at org.apache.spark.SparkContext.<init>(SparkContext.scala:365) at org.apache.spark.repl.SparkILoop.createSparkContext(SparkILoop.scala:1017) at $line3.$read$$iwC$$iwC.<init>(<console>:9) at $line3.$read$$iwC.<init>(<console>:18) at $line3.$read.<init>(<console>:20) at $line3.$read$.<init>(<console>:24) at $line3.$read$.<clinit>(<console>) at $line3.$eval$.<init>(<console>:7) at $line3.$eval$.<clinit>(<console>) 查看spark-env.sh 和spark-default.conf中的配置发现两边都写的有classpath //spark-default.conf # Default system properties included when running spark-submit. # This is useful for setting default environmental settings. # Example: # spark.master spark://master:7077 # spark.eventLog.enabled true # spark.eventLog.dir hdfs://namenode:8021/directory # spark.serializer org.apache.spark.serializer.KryoSerializer # spark.driver.memory 5g # spark.executor.extraJavaOptions -XX:+PrintGCDetails -Dkey=value -Dnumbers="one two three" # # spark.serializer org.apache.spark.serializer.KryoSerializer spark.local.dir /home/xujingwen/data/pseudo-dist/spark/local,/home/xujingwen/data/pseudo-dist/spark/local spark.io.compression.codec snappy spark.speculation false spark.yarn.executor.memoryOverhead 512 #spark.storage.memoryFraction 0.4 spark.eventLog.enabled true spark.eventLog.dir hdfs://cdh5cluster/eventLog spark.eventLog.compress true spark.driver.extraClassPath /home/xujingwen/ocdc/spark-1.4.1-bin-2.6.0-cdh5.4.4/lib/mysql-connector-java-5.1.30-bin.jar:/home/xujingwen/ocdc/spark-1.4.1-bin-2.6.0-cdh5. 4.4/lib/datanucleus-api-jdo-3.2.6.jar:/home/xujingwen/ocdc/spark-1.4.1-bin-2.6.0-cdh5.4.4/lib/datanucleus-core-3.2.10.jar:/home/xujingwen/ocdc/spark-1.4.1-bin-2.6.0-cdh 5.4.4/lib/datanucleus-rdbms-3.2.9.jar //spark-env.sh # Generic options for the daemons used in the standalone deploy mode # - SPARK_CONF_DIR Alternate conf dir. (Default: ${SPARK_HOME}/conf) # - SPARK_LOG_DIR Where log files are stored. (Default: ${SPARK_HOME}/logs) # - SPARK_PID_DIR Where the pid file is stored. (Default: /tmp) # - SPARK_IDENT_STRING A string representing this instance of spark. (Default: $USER) # - SPARK_NICENESS The scheduling priority for daemons. (Default: 0) MASTER=yarn-client SPARK_HOME=/home/xujingwen/ocdc/spark-1.4.1-bin-2.6.0-cdh5.4.4 SCALA_HOME=/home/xujingwen/ocdc/scala JAVA_HOME=/home/xujingwen/ocdc/jdk1.7.0_21 HADOOP_HOME=/home/xujingwen/ocdc/hadoop-2.6.0-cdh5.4.4 export SPARK_MASTER_IP=192.168.0.4 HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop SPARK_EXECUTOR_INSTANCES=50 SPARK_EXECUTOR_CORES=2 SPARK_EXECUTOR_MEMORY=4G SPARK_DRIVER_MEMORY=3G SPARK_YARN_APP_NAME="Spark-1.1.0" #export SPARK_YARN_QUEUE="default" SPARK_SUBMIT_LIBRARY_PATH=$SPARK_LIBRARY_PATH:$HADOOP_HOME/lib/native SPARK_JAVA_OPTS="-verbose:gc -XX:-UseGCOverheadLimit -XX:+UseCompressedOops -XX:-PrintGCDetails -XX:+PrintGCTimeStamps $SPARK_JAVA_OPTS -XX:+HeapDumpOnOutOfMemoryEr ror -XX:HeapDumpPath=/home/xujingwen/ocdc/spark-1.4.1-bin-hadoop2.6/`date +%m%d%H%M%S`.hprof" export SPARK_HISTORY_OPTS="-Dspark.history.ui.port=18080 -Dspark.history.retainedApplications=1000 -Dspark.history.retainedApplications=1000 -Dspark.history.fs.logD irectory=hdfs://cdh5cluster/eventLog" #export SPARK_CLASSPATH=$SPARK_CLASSPATH:/home/xujingwen/ocdc/apache-hive-1.2.1-bin/lib/mysql-connector-java-5.1.30-bin.jar for libjar in 'ls $SPARK_HOME/lib/*.jar' do SPARK_CLASSPATH=$SPARK_CLASSPATH:$libjar done spark1.4版本以后 应统一将classpath配置到spark-default.conf文件中 如下:

优秀的个人博客,低调大师

供应链逆向物流系统 | 逆向物流数据分析:退货率归因分析与改进建议

当逆向物流系统跑起来之后,数据开始沉淀——退货原因、质检分级、维修记录、再销售价格、报废处置……这些散落在各个环节的数据,如果只用来"事后查账",那就太浪费了。真正的数据价值在于向前反哺业务:为什么这个月的退货率突然飙升?是某个供应商的批次问题,还是某个运营活动的描述误导了消费者?哪类商品的维修翻新后仍然复检不通过?哪些 SKU 从退货到再销售的全程成本已经超过了商品本身的价值——也就是说,退回来修好再卖,其实是在亏钱?

优秀的个人博客,低调大师

AI 文本水印是一场注定失败的战争

从 2026 年 8 月起,欧盟 AI 法案开始对新系统生效。法案第 50 条要求 AI 提供者让输出内容「可被检测为人工生成」。换句话说,LLM 必须在输出中嵌入水印。 开发者 Sean Goedecke 写了一篇分析文章,结论很直接:文本水印永远可以被轻松移除。 不是图片水印,是文本隐写 Goedecke 首先澄清了一个常见误解。图片水印可以在噪声中隐藏签名而不被人眼察觉,但文本是「一种高度压缩的媒介」——几乎任何改动都会被人注意到。 简单方案直接出局。如果你让模型「每五个字母必须是一个 e」,输出会充满明显的拼写错误。即使模型能学会在约束下生成可读内容,这个约束也会消耗推理能力,降低输出质量。 能否让模型自行决定是否使用水印?强大的 AI 模型如果足够智能,可以处理这种需求,但这仍然会消耗推理时间,而这些时间本可以更好地用于解决用户的问题,并且会让模型听起来比实际能力差很多。 另外一个问题,是否真的需要水印来检测 AI 生成内容吗? 如果你是 Anthropico 公司,需要验证模型是否生成了特定的文本块,难道不能直接把一段可疑文本喂给所有可能的模型,看哪个模型预测的 token 序列和文本一致——这会产生大量误报,而且对免费验证服务来说成本太高。 SynthID:Google 的方案 目前最成熟的文本水印方案是 Google 的 SynthID。它在 token 采样阶段做手脚。 模型每生成一个 token,都会给词汇表中约 10 万个候选词打出概率分数。SynthID 额外给每个候选词打一个「水印分数」——基于前文 token 计算,用随机种子混合以避免偏差。采样器从高分候选中优先选择水印分数高的 token。 检测时,计算一段文本的聚合水印分数。如果异常高,大概率是 AI 生成的。检测成本很低,因为评分函数在数学上很简单。 Goedecke 指出一个关键限制:temperature 为零时无法施加水印,除非覆盖用户偏好。 Unicode 同形字:更隐蔽的方案 作者怀疑 OpenAI 和 Anthropic 在用的是一种更简单的方法:同形字替换。 把标准空格(U+0020)替换成视觉上无法区分的 Unicode 变体——三分之一 em 空格(U+2004)或中日韩表意空格(U+3000)。通过替换模式编码信息,检测成本极低。 他举了两个证据。Claude Code 已经记录了用同形字隐写来标记中国用户的请求。另外,把 ChatGPT 输出粘贴到 VSCode 时,有时会显示异常的 Unicode 空格——OpenAI 对此的官方说法是「模型特性」。 为什么这些水印都可以被移除 同形字水印的破解方法:把所有同形字替换回标准字符。 SynthID 水印的破解方法:用任何不带水印的 LLM(哪怕是本地小模型)把原文改写一遍。因为水印绑定在「微妙的词汇选择」上,改写就断了。人工改写同理。 更根本的问题是,欧盟 AI 法案的互操作性要求会迫使提供者公开水印方法,消灭任何基于安全性的模糊。 C2PA 不是替代方案 有人可能想到 C2PA 内容凭证——数字签名的元数据。但它只适用于能附加元数据的文件格式:「音频、图片、视频或容器化的文本」。聊天输出和 AI agent 输出是纯文本,没有文件来签名。法案要求的是水印,在元数据签名之外。 社区讨论:这是犯罪吗? 社区最大的争议点是法律层面。有人指出,在欧盟 AI 法案下,移除水印本身可能构成违法行为。 Goedecke 的回应很尖锐:他把这比作「在自己财产上贴贴纸遮住 logo」——既然这是我的输出,我为什么不能去掉标记? 但也有评论者提出了更务实的观点:水印不是为了阻止技术用户,而是为了阻止普通人。大多数用户不会费心去改写 AI 输出来逃避检测。就像 DRM 一样——专业人士总能破解,但它阻止了普通人的随意复制。 另一个讨论线是技术可行性的根本质疑。评论者指出,即使 SynthID 有效,它也需要模型层面的集成。开源模型社区不太可能统一采用任何水印方案——而一旦有无水印的模型可用,整个系统的漏洞就打开了。 预测:水印会成为标配,但没人当真 Goedecke 的预测是:AI 提供者会全面部署 SynthID 风格的 token 采样器(可能只针对欧盟用户,也可能不做区分)。他们会提供免费的水印检测网页。在互操作性压力下,可能最终统一到一个 SynthID 标准、一个欧盟托管的验证页面。 技术用户会轻易去除水印,面向非技术用户的去水印工具会大量出现。 结果是:法律合规了,但目的没达到。 参考来源: Text AI watermarks will always be trivial to remove — Sean Goedecke HN 讨论

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册