首页 文章 精选 留言 我的

精选列表

搜索[垂直整合],共10009篇文章
优秀的个人博客,低调大师

RBAC模型整合数据权限

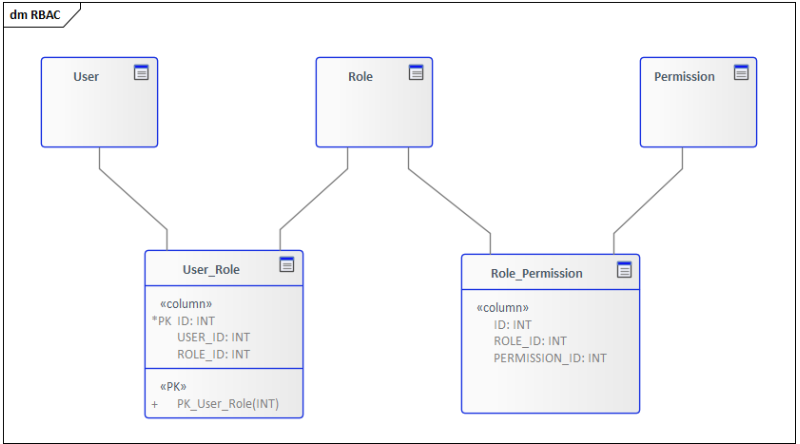
在项目实际开发中我们不光要控制一个用户能访问哪些资源,还需要控制用户只能访问资源中的某部分数据。 控制一个用户能访问哪些资源我们有很成熟的权限管理模型即RBAC,但是控制用户只能访问某部分资源(即我们常说的数据权限)使用RBAC模型是不够的,本文我们尝试在RBAC模型的基础上融入数据权限的管理控制。 首先让我们先看下RBAC模型。 RBAC模型 RBAC是Role-BasedAccess Control的英文缩写,意思是基于角色的访问控制。 RBAC事先会在系统中定义出不同的角色,不同的角色拥有不同的权限,一个角色实际上就是一组权限的集合。而系统的所有用户都会被分配到不同的角色中,一个用户可能拥有多个角色。使用RBAC可以极大地简化权限的管理。 RBAC模型还可以细分为RBAC0,RBAC1,RBAC2,RBAC3。这里我们不讨论他们之间的差异,感兴趣的同学可以自行研究,我们主要聚焦于常见的RBAC0模型上。 如下图就是一个经典RBAC0模型的数据库设计。 RBAC0 在RBAC模型下,系统只会验证用户A是否属于角色RoleX,而不会判断用户A是否能访问只属于用户B的数据DataB。这种问题我们称之为“水平权限管理问题”。 数据权限 列表数据权限,主要通过数据权限控制行数据,让不同的人有不同的查看数据规则;要实现数据权限,最重要的是需要抽象出数据规则。 数据规则 比如我们系统的商机数据,需要从下面几个维度来控制数据访问权限。 销售人员只能看自己的数据; 各大区的销售经理只能看各区域的数据(安徽大区的销售经理看安徽区域的商机数据),同理也适用于某BG分管领导只能看所在BG的商机数据; 财务人员只能看金额小于一万的数据。 上面的这些维度就是数据规则。 这样数据规则的几个重点要素我们也明晰了,就是规则字段,规则表达式,规则值,上面三个场景对应的规则分别如下: 规则字段:创建人,规则表达式:= ,规则值:当前登录人 规则字段:所属大区,规则表达式:= ,规则值:安徽大区 规则字段:销售金额,规则表达式:< ,规则值:10000 数据规则 规则字段配置说明:条件表达式:大于/大于等于/小于/小于等于/等于/包含/模糊/不等于规则值:指定值(固定值/系统上下文变量) 关联资源、用户 光有数据规则是不够的,我们还需要把数据规则跟资源和用户进行绑定。 数据规则与资源的绑定很简单,我们只需要建立一个中间表即可,如下图所示: 这样资源就可以关联上了数据规则。 在应用设计上我们需要一个单独的数据规则管理功能,方便我们录入数据规则,然后在资源管理页面(比如商机列表)上就可以选择内置的数据规则进行资源与规则的绑定。 「那么如何让不同的用户拥有不同的数据规则呢?」 在RBAC模型中,用户是通过授予不同的角色来进行资源的管理,同理我们可以让角色在授予权限的时候关联上数据规则,这样最终在系统上就体现为不同的用户拥有不同的数据规则。 有点拗口,我们还是按上面的例子来说。 销售人员、大区销售经理、财务人员属于不同的角色,他们都拥有商机列表这个资源权限,但是在给这些角色绑定商机列表资源权限时我们可以勾选对应的数据规则(上面已经实现资源与数据规则的绑定)。体现在数据库设计中我们可以在角色资源对应关系表 Role_Permission中添加一个字段用于存储关联的数据规则,如果有多个数据规则可以使用分隔符分割。 最终RBAC模型演变成如下所示的模型: 按照上面的设计我们需要区分各个大区管理的数据权限则需要建立不同的大区角色,如安徽大区销售经理、上海大区销售经理,然后分别给角色勾选对应的数据规则。这里就类似于RBAC1中的角色继承的概念了。 这样我们就基本实现了RBAC与数据规则的绑定,但是我们还有个问题就是如何在系统中落地。 这里我们就要借助大名鼎鼎的AOP来实现了,这篇文章只讲原理不讲实现,所以我们只顺带提一下实现方案。 自定义一个数据权限的注解,比如叫 PermissionData 在对应的资源请求方法,比如商机列表上添加自定义注解 @PermissionData 利用AOP抓取到用户对应角色的所有数据规则并进行SQL拼接,最终在SQL层面实现数据过滤。 继续优化 在上面的设计中我们通过给不同角色绑定不同数据规则实现了数据权限,但是考虑下面一种场景:某角色需要看到的数据范围为 “所属大区为安徽大区且事业部为消费者事业部的商机数据”,在这种场景里按照我们之前的设计需要建立两个数据规则: 所属大区 = 安徽大区 所属事业部 = 消费者事业部 然后再建立2个不同的角色,分别授予不同的数据规则,如果这样的场景比较多的话很容易出现角色爆炸的情况,所有我们这里再抽取出 数据规则组的概念。 一个数据规则组有多个数据规则,数据规则之间通过 AND进行连接,放一张应用设计图: 体现在数据库设计中就变成了如下所示: 小结 通过上面8张表的设计我们实现了RBAC模型与数据权限的结合,当然这里还有继续优化的空间。比如这里的规则字段和规则值我们可以抽取出对应的字典表,让数据规则表去关联这些字典字段,这样在应用层配置数据规则的时候就不需要管理员手动填写而是从字典项中去选择了,减少了数据规则配置出错的概率。 数据权限是一个实现相对比较复杂的功能,这里我们选择的是在RBAC模型基础上进行扩展,如果你有更好的解决方案欢迎留言告诉我。 End 干货分享 这里为大家准备了一份小小的礼物,关注公众号,输入如下代码,即可获得百度网盘地址,无套路领取!001:《程序员必读书籍》002:《从无到有搭建中小型互联网公司后台服务架构与运维架构》003:《互联网企业高并发解决方案》004:《互联网架构教学视频》006:《SpringBoot实现点餐系统》007:《SpringSecurity实战视频》008:《Hadoop实战教学视频》009:《腾讯2019Techo开发者大会PPT》 010:微信交流群 近期热文top 1、关于JWT Token 自动续期的解决方案 2、SpringBoot开发秘籍-事件异步处理 3、架构师之路-服务器硬件扫盲 4、基于Prometheus和Grafana的监控平台 - 环境搭建 5、RocketMQ进阶-事务消息 我就知道你“在看” 本文分享自微信公众号 - JAVA日知录(javadaily)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

使用IOTA整合物联网硬件

本教程面向iota初学者,我们将学习如何开发基于指定IOTA地址的余额来闭合或断开一个连接到树莓派上的继电器,点亮或熄灭LED。教程虽然简单,但足以展示IOTA的强大能力。 我们将使用一个联网的树莓派作为物联网设备,使用Python来检查IOTA tangle上的余额,并使用树莓派的内部GIO管脚来切换所连接的继电器的闭合与断开。然后我们会将继电器连接到一个电池供电的简单LED电路,用来表示我们项目中的物理设备。 要快速掌握区块链和数字货币应用开发,推荐汇智网的区块链开发系列在线教程。 内容涵盖比特币、以太坊、EOS、超级账本、Tendermint等多种主流区块链 平台,同时支持Java、C#、Python、PHP、JavaScript、Dart等多种开发 语言。 元器件 先让我们看一下项目需要的元器件。你应当可以在大多数电子元器件商店或者淘宝上卖到这些元器件,不会超过350元。 树莓派 项目的大脑是树莓派。树莓派将运行用来监视IOTA地址的余额并处理树莓派的通用输入输出(GIO)管脚上的信号: 继电器 继电器用来切换电路以及设备(我们这里就是LED)的开关。为了简化电路我们将使用一个继电器模块,它包含了所有必须的元器件、管脚和接插件。注意你也可以购买多通道继电器模块,只要每个通道可以单独开关即可。 面包板 面包板用来进行电路的连接而无需进行焊接,这使得装配过程更加简单。 发光二极管 当供电时LED会点亮,我们用它来表示项目中的物理设备(比如冰箱)。 300欧电阻 电阻用来限制通过LED的电流。没有电阻的话,LED和树莓派可能会因为电流过大而损坏。要使用的电阻取决于你的LED以及电路电压。在我的演示中,使用了9V电池,因此330欧姆的电阻应当就可以了。 电池 电池为电路提供能力。我的演示中使用的是9v电池。 连接线 我们当然也需要一些电线将各个部件连接起来: 二维码 如果你希望使用手机IOTA钱包来支付使用LED(冰箱、洗衣机....)的费用,那么一个打印好的IOTA收款地址二维码会很方便。当使用IOTA钱包生成地址时,你会找到一个二维码。或者在THETANGLE网站查询已有地址的二维码。 组装电路 现在我们看下组装好的电路: 树莓派的管脚如下: 参考以下说明连接管脚: 树莓派的pin 2(5v)连接到继电器模块的VCC管脚 树莓派的pin 6(地)连接到继电器模块的GND管脚 树莓派的pin 12(GPIO18)连接到继电器模块的IN管脚 继电器模块的COM端子连接到电池的正极 继电器模块的NO端子通过电阻连接到LED的正极 电池的负极连接到LED的负极 需要的软件和库 在我们开始编写Python代码之前,需要先确认已经在树莓派上安装了所需要的软件和库。 首先,我们需要在树莓派上安装一个操作系统。任何树莓派支持的LInux发行版应该都可以。在我的演示中,使用的是Raspbian发行版,因为它已经预置了Python和几个Python编辑器。Raspbian发行版的安装指令可以在这里找到: https://www.raspberrypi.org/downloads/raspbian/。 如果你要单独安装Python,可以参考这里: https://www.python.org/downloads/。 最后,我们需要安装PyIOTA API库,利用它我们就可以使用Python来访问IOTA tangle了。PyIOTA API库及安装指令参见: ttps://github.com/iotaledger/iota.lib.py。 Python代码 现在开始写代码: # Imports some Python Date/Time functions import time import datetime # Imports GPIO library import RPi.GPIO as GPIO # Imports the PyOTA library from iota import Iota from iota import Address # Setup O/I PIN's LEDPIN=18 GPIO.setmode(GPIO.BCM) GPIO.setwarnings(False) GPIO.setup(LEDPIN,GPIO.OUT) GPIO.output(LEDPIN,GPIO.LOW) # Function for checking address balance on the IOTA tangle. def checkbalance(): print("Checking balance") gb_result = api.get_balances(address) balance = gb_result['balances'] return (balance[0]) # URL to IOTA fullnode used when checking balance iotaNode = "https://nodes.thetangle.org:443" # Create an IOTA object api = Iota(iotaNode, "") # IOTA address to be checked for new light funds # IOTA addresses can be created using the IOTA Wallet address = [Address(b'GTZUHQSPRAQCTSQBZEEMLZPQUPAA9LPLGWCKFNEVKBINXEXZRACVKKKCYPWPKH9AWLGJHPLOZZOYTALAWOVSIJIYVZ')] # Get current address balance at startup and use as baseline for measuring new funds being added. currentbalance = checkbalance() lastbalance = currentbalance # Define some variables lightbalance = 0 balcheckcount = 0 lightstatus = False # Main loop that executes every 1 second while True: # Check for new funds and add to lightbalance when found. if balcheckcount == 10: currentbalance = checkbalance() if currentbalance > lastbalance: lightbalance = lightbalance + (currentbalance - lastbalance) lastbalance = currentbalance balcheckcount = 0 # Manage light balance and light ON/OFF if lightbalance > 0: if lightstatus == False: print("light ON") GPIO.output(LEDPIN,GPIO.HIGH) lightstatus=True lightbalance = lightbalance -1 else: if lightstatus == True: print("light OFF") GPIO.output(LEDPIN,GPIO.LOW) lightstatus=False # Print remaining light balance print(datetime.timedelta(seconds=lightbalance)) # Increase balance check counter balcheckcount = balcheckcount +1 # Pause for 1 sec. time.sleep(1) 运行代码 要运行上面的代码,我们需要先在树莓派上保存到文件中,例如let_there_be_light.py。然后使用如下命令: python let_there_be_light.py 现在你应当可以在终端窗口中看到代码在执行了,显示当前的余额,并且每隔10秒钟检查一次LED对应的IOTA地址的余额。 支付LED的使用费 要点亮LED,你只需要使用喜欢的IOTA钱包向LED的IOTA地址转一些IOTA币。只要转账交易被IOTA tangle确认,LED应该就会点亮并直到消耗完余额。在我的演示当中,我设置的收费标准是1秒钟1个IOTA。 原文链接:iota物联网硬件集成新手教程 - 汇智网

优秀的个人博客,低调大师

spring-cloud-stream整合kafka

1.在项目的pom中引入 <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-stream-binder-kafka</artifactId> </dependency> 2.配置消息通道 public interface Demo { /** * 发消息的通道名称 */ String DEMO_OUTPUT = "demo_output"; /** * 消息的订阅通道名称 */ String DEMO_INPUT = "demo_input"; /** * 发消息的通道 * * @return */ @Output(DEMO_OUTPUT) MessageChannel sendDemoMessage(); /** * 收消息的通道 * * @return */ @Input(DEMO_INPUT) SubscribableChannel recieveDemoMessage(); } 使带注释组件的结合Input和Output根据作为值给注释传递接口的列表到代理 @EnableBinding(value = {Demo.class}) 4.链接kafka配置 spring.cloud.stream.bindings.demo_input.destination=demo spring.cloud.stream.bindings.demo_input.group=demo spring.cloud.stream.bindings.demo_output.destination=demo spring.cloud.stream.bindings.demo_output.group=demo spring.cloud.stream.default-binder=kafka spring.kafka.bootstrap-servers=127.0.0.1:9092 spring.kafka.consumer.enable-auto-commit=true spring.kafka.producer.key-serializer=org.apache.kafka.common.serialization.ByteArraySerializer spring.kafka.producer.value-serializer=org.apache.kafka.common.serialization.ByteArraySerializer 5.发送消息 @Resource(name = Demo.DEMO_OUTPUT) private MessageChannel sendDemoMessageChannel; @Test public void Demo() { boolean isSendSuccess = sendDemoMessageChannel. send(MessageBuilder.withPayload("OK").build()); System.out.println(isSendSuccess); } 6.接收消息 @StreamListener(Demo. DEMO_INPUT) public void insertQuotationK(Message<String> message) { if (StringUtils.isEmpty(message.getPayload())) { System.out.println("receiver data is empty !"); System.out.println(400 + "failed"); } System.out.println("kafka收到"+message.getPayload()); } 7.结束咯,如果出现异常,请留言。

优秀的个人博客,低调大师

关于网络爬虫的资料整合

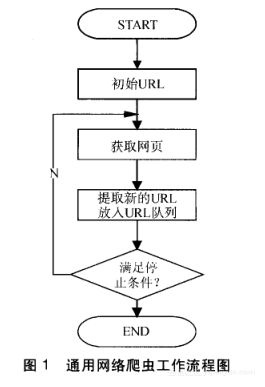
关于通用爬虫的介绍 前言:我们生活在一个充满数据的时代。每天,来自商业、社会以及我们的日常生活所产生「图像、音频、视频、文本、定位信息」等各种各样的海量数据,注入到我们的万维网(WWW)、计算机和各种数据存储设备,其中万维网则是最大的信息载体。数据的爆炸式增长、规模庞大和广泛可用的数据,使得我们真正进入到了“大数据(Big Data)时代”。我们急需功能强大的数据处理技术(Data Technology),从这些海量数据中发现有价值的信息。网络爬虫(Web Crawler)技术,则成为了当下万维网数据(Web Data)收集中,最为高效灵活的解决方案。什么是网络爬虫?网络爬虫 获取数据方式主要有哪些? 1:企业产生的数据:百度搜索指数、腾讯公司业绩数据、阿里巴巴集团财务及运营数据、新浪微博微指数等.... 大型互联网公司拥有海量用户,有天然的数据积累优势,还有一些有数据意识的中小型企业,也开始积累自己的数据。2:数据平台购买数据:数据堂、国云数据市场、贵阳大数据交易所 等... 在各个数据交易平台上购买各行各业各种类型的数据,根据数据信息、获取难易程度的不同,价格也会有所不同。3:政府/机构公开的数据:中华人民共和国国家统计局数据、中国人民银行调查统计、世界银行公开数据、联合国数据、纳斯达克、新浪财经美股实时行情 等... 通常都是各地征服统计上报,或者是行业内专业的网站、机构等提供。4:数据管理咨询公司:麦肯锡、埃森哲、尼尔森、中国互联网络信息中心、艾瑞咨询 等... 通常这样的公司有很庞大的数据团队,一般通过市场调研、问卷调查、固定的样本检测、与各行各业的其他公司合作、专家对话来获取数据,并根据客户需求制定商业解决方案。5:爬虫爬取网络数据: 如果数据市场上没有需要的数据,或者价格太高不愿意购买,那么可以利用爬虫技术,抓取网站上的数据。 通用爬虫:通用网络爬虫 就是 捜索引擎抓取系统,目的是将互联网上的所有的网页下载到本地,形成一个互联网内容的镜像备份。 它决定着整个搜索引擎内容的丰富性和时效性,因此它的性能优劣直接影响着搜索引擎的效果。通用搜索引擎(Search Engine)工作原理第一步:抓取网页搜索引擎网络爬虫的基本工作流程如下: 首先选取一部分的初始URL,将这些URL放入 待抓取URL队列 ; 取出待抓取URL,解析DNS得到主机的IP,并将URL对应的网页下载下来,存储进已下载网页库中,并且将这些URL放进 已抓取URL队列 。 分析网页中包含的其他URL,并且将URL放入 待抓取URL队列,从而进入下一个循环.... PS : 搜索引擎如何获取一个新网站的URL: 新网站向搜索引擎主动提交网址:(如百度http://zhanzhang.baidu.com/linksubmit/url) 在其他网站上设置新网站外链(尽可能处于搜索引擎爬虫爬取范围) 搜索引擎和DNS解析服务商(如DNSPod等)合作,新网站域名将被迅速抓取。 网站的Robots协议 搜索引擎蜘蛛跟进URL抓取时,它需要遵从一些命令或文件的内容,如标注为nofollow的链接,或者是网站的Robots协议。 Robots协议(也叫爬虫协议、机器人协议等),全称是“网络爬虫排除标准”(Robots Exclusion Protocol),网站通过Robots协议告诉搜索引擎哪些页面可以抓取,哪些页面不能抓取,例如: 淘宝网:https://www.taobao.com/robots.txt 腾讯网: http://www.qq.com/robots.txt 第二步:数据存储 搜索引擎爬虫爬取到的网页,将存入原始页面数据库,页面和用户浏览器得到的HTML是完全一样的。 搜索引擎爬虫在抓取页面时,也做一定的重复内容检测,一旦遇到访问权重很低的网站上有大量抄袭、采集或者复制的内容,很可能就不再爬行。第三步:预处理 搜索引擎将爬虫抓取回来的页面,进行各种步骤的预处理。 提取文字 中文分词 消除噪音(比如版权声明文字、导航条、广告等……) 索引处理 特殊文件处理除了HTML文件外,搜索引擎通常还能抓取和索引以文字为基础的多种文件类型,如 PDF、Word、WPS、XLS、PPT、TXT 文件等。我们在搜索结果中也经常会看到这些文件类型。 但搜索引擎还不能处理图片、视频、Flash 这类非文字内容,也不能执行脚本和程序。 第四步:提供检索服务,网站排名 搜索引擎在对信息进行组织和处理后,为用户提供关键字检索服务,将用户检索相关的信息展示给用户。 同时会根据页面的PageRank值(链接的访问量排名)来进行网站排名,这样Rank值高的网站在搜索结果中会排名较前,当然也可以直接使用 Money 购买搜索引擎网站排名,简单粗暴。 完整流程图:但是,这些通用性搜索引擎也存在着一定的局限性: 通用搜索引擎所返回的结果都是网页,而大多情况下,网页里90%的内容对用户来说都是无用的。 不同领域、不同背景的用户往往具有不同的检索目的和需求,搜索引擎无法提供针对具体某个用户的搜索结果。 万维网数据形式的丰富和网络技术的不断发展,图片、数据库、音频、视频多媒体等不同数据大量出现,通用搜索引擎对这些文件无能为力,不能很好地发现和获取。 通用搜索引擎大多提供基于关键字的检索,难以支持根据语义信息提出的查询,无法准确理解用户的具体需求。 本文最终解释权归本文作者所有,未经允许不得私自转载

优秀的个人博客,低调大师

springboot整合druid连接池

依赖 //mysql 驱动 compile group: 'mysql', name: 'mysql-connector-java', version: '5.1.21' //druid compile group: 'com.alibaba', name: 'druid', version: '1.1.10' 1. 新建druid配置信息类DruidConfiguration.java package com.futao.springmvcdemo.foundation.configuration; import com.alibaba.druid.pool.DruidDataSource; import org.springframework.boot.context.properties.ConfigurationProperties; import org.springframework.context.annotation.Bean; import org.springframework.stereotype.Component; import javax.sql.DataSource; import java.sql.SQLException; /** * @author futao * Created on 2018/10/11. * ConfigurationProperties(prefix = "spring.datasource")使用规则,注入的字段如果为private,则必须具有setter方法 */ @Component @ConfigurationProperties(prefix = "spring.datasource") public class DruidConfiguration { /** * 数据库地址 */ private String url; /** * 用户名 */ private String userName; /** * 密码 */ private String password; /** * 初始化连接数量 */ private int initialSize; /** * 最小闲置连接 */ private int minIdle; /** * 最大存活连接 */ private int maxActive; /** * 配置获取连接等待超时的时间 */ private long maxWait; /** * 配置间隔多久才进行一次检测,检测需要关闭的空闲连接,单位是毫秒 */ private long timeBetweenEvictionRunsMillis; /** * 配置一个连接在池中最小生存的时间,单位是毫秒 */ private long minEvictableIdleTimeMillis; /** * 配置一个连接在池中最大生存的时间,单位是毫秒 */ private long maxEvictableIdleTimeMillis; /** * */ private boolean testWhileIdle; /** * */ private boolean testOnBorrow; /** * */ private boolean testOnReturn; /** * */ private boolean poolPreparedStatements; /** * */ private int maxOpenPreparedStatements; /** * */ private boolean asyncInit; @Bean public DataSource druidDataSource() throws SQLException { DruidDataSource druidDataSource = new DruidDataSource(); druidDataSource.setUrl(url); druidDataSource.setUsername(userName); druidDataSource.setPassword(password); druidDataSource.setMaxActive(maxActive); druidDataSource.setInitialSize(initialSize); druidDataSource.setMaxWait(maxWait); druidDataSource.setMinIdle(minIdle); druidDataSource.setTimeBetweenEvictionRunsMillis(timeBetweenEvictionRunsMillis); druidDataSource.setMinEvictableIdleTimeMillis(minEvictableIdleTimeMillis); druidDataSource.setMaxEvictableIdleTimeMillis(maxEvictableIdleTimeMillis); druidDataSource.setTestWhileIdle(testWhileIdle); druidDataSource.setTestOnBorrow(testOnBorrow); druidDataSource.setTestOnReturn(testOnReturn); druidDataSource.setPoolPreparedStatements(poolPreparedStatements); druidDataSource.setMaxOpenPreparedStatements(maxOpenPreparedStatements); druidDataSource.setAsyncInit(asyncInit); return druidDataSource; } public String getUrl() { return url; } public void setUrl(String url) { this.url = url; } public String getUserName() { return userName; } public void setUserName(String userName) { this.userName = userName; } public String getPassword() { return password; } public void setPassword(String password) { this.password = password; } public int getInitialSize() { return initialSize; } public void setInitialSize(int initialSize) { this.initialSize = initialSize; } public int getMinIdle() { return minIdle; } public void setMinIdle(int minIdle) { this.minIdle = minIdle; } public int getMaxActive() { return maxActive; } public void setMaxActive(int maxActive) { this.maxActive = maxActive; } public long getMaxWait() { return maxWait; } public void setMaxWait(long maxWait) { this.maxWait = maxWait; } public long getTimeBetweenEvictionRunsMillis() { return timeBetweenEvictionRunsMillis; } public void setTimeBetweenEvictionRunsMillis(long timeBetweenEvictionRunsMillis) { this.timeBetweenEvictionRunsMillis = timeBetweenEvictionRunsMillis; } public long getMinEvictableIdleTimeMillis() { return minEvictableIdleTimeMillis; } public void setMinEvictableIdleTimeMillis(long minEvictableIdleTimeMillis) { this.minEvictableIdleTimeMillis = minEvictableIdleTimeMillis; } public long getMaxEvictableIdleTimeMillis() { return maxEvictableIdleTimeMillis; } public void setMaxEvictableIdleTimeMillis(long maxEvictableIdleTimeMillis) { this.maxEvictableIdleTimeMillis = maxEvictableIdleTimeMillis; } public boolean isTestWhileIdle() { return testWhileIdle; } public void setTestWhileIdle(boolean testWhileIdle) { this.testWhileIdle = testWhileIdle; } public boolean isTestOnBorrow() { return testOnBorrow; } public void setTestOnBorrow(boolean testOnBorrow) { this.testOnBorrow = testOnBorrow; } public boolean isTestOnReturn() { return testOnReturn; } public void setTestOnReturn(boolean testOnReturn) { this.testOnReturn = testOnReturn; } public boolean isPoolPreparedStatements() { return poolPreparedStatements; } public void setPoolPreparedStatements(boolean poolPreparedStatements) { this.poolPreparedStatements = poolPreparedStatements; } public int getMaxOpenPreparedStatements() { return maxOpenPreparedStatements; } public void setMaxOpenPreparedStatements(int maxOpenPreparedStatements) { this.maxOpenPreparedStatements = maxOpenPreparedStatements; } public boolean isAsyncInit() { return asyncInit; } public void setAsyncInit(boolean asyncInit) { this.asyncInit = asyncInit; } } 2. 在application.yml中配置配置信息 spring: # 数据源 datasource: url: jdbc:mysql://localhost:3306/springboot?useUnicode=true&characterEncoding=utf8 username: root password: 123456 driver-class-name: com.mysql.jdbc.Driver type: com.alibaba.druid.pool.DruidDataSource platform: mysql initialSize: 5 minIdle: 10 maxActive: 20 maxWait: 60000 timeBetweenEvictionRunsMillis: 2000 minEvictableIdleTimeMillis: 600000 maxEvictableIdleTimeMillis: 900000 testWhileIdle: true testOnBorrow: false testOnReturn: false poolPreparedStatements: true maxOpenPreparedStatements: 20 asyncInit: true filters: stat,wall,log4j logSlowSql: true 3. 添加过滤器DruidFilter.java druid除了数据连接池,还集成了对站点的URL进行统计的功能,利用filter忽略druid对某些资源的统计 package com.futao.springmvcdemo.controller; import com.alibaba.druid.support.http.WebStatFilter; import javax.servlet.annotation.WebFilter; import javax.servlet.annotation.WebInitParam; /** * @author futao * Created on 2018/10/11. */ @WebFilter(filterName = "DruidFilter", urlPatterns = "/*", initParams = { @WebInitParam(name = "exclusions", value = "*.js,*.gif,*.jpg,*.bmp,*.png,*.css,*.ico,/druid/*")// 忽略资源 }) public class DruidFilter extends WebStatFilter { } 4. 定义DruidServlet.java显示druid管理页面 package com.futao.springmvcdemo.controller; import com.alibaba.druid.support.http.StatViewServlet; import javax.servlet.annotation.WebInitParam; import javax.servlet.annotation.WebServlet; /** * @author futao * Created on 2018/10/11. */ @WebServlet(urlPatterns = "/druid/*", initParams = { @WebInitParam(name = "allow", value = "127.0.0.1"),// IP白名单 (没有配置或者为空,则允许所有访问) @WebInitParam(name = "deny", value = "192.168.16.111"),// IP黑名单 (存在共同时,deny优先于allow) @WebInitParam(name = "loginUsername", value = "admin"),// 用户名 @WebInitParam(name = "loginPassword", value = "admin"),// 密码 @WebInitParam(name = "resetEnable", value = "false")// 禁用HTML页面上的“Reset All”功能 }) public class DruidServlet extends StatViewServlet { private static final long serialVersionUID = -6085007333934055609L; } 5. 对于基于注解的Filter和Servlet需要在SpringBoot的启动类上打上自动扫描注解@@ServletComponentScan package com.futao.springmvcdemo; import org.mybatis.spring.annotation.MapperScan; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; import org.springframework.boot.web.servlet.ServletComponentScan; /** * @author futao * ServletComponentScan 开启servlet和filter */ @SpringBootApplication @ServletComponentScan @MapperScan("com.futao.springmvcdemo.dao") //@EnableAspectJAutoProxy public class SpringmvcdemoApplication { public static void main(String[] args) { SpringApplication.run(SpringmvcdemoApplication.class, args); } } 截一波运行图

优秀的个人博客,低调大师

关于SpringMVC整合freemarker报错问题

错误信息: org.springframework.beans.factory.BeanCreationException: Error creating bean with name 'FreeMarkerConfigurer' defined in class path resource [spring-mvc.xml]: Invocation of init method failed; nested exception is java.lang.NoSuchMethodError: freemarker.template.Configuration.<init>(Lfreemarker/template/Version;)V 报错原因:freemarker版本问题 通常情况下将其换为2.3.23 如下所示: <dependency> <groupId>org.freemarker</groupId> <artifactId>freemarker</artifactId> <version>2.3.23</version> </dependency> 即可解决该问题

优秀的个人博客,低调大师

idea整合 spring boot jsp mybatis

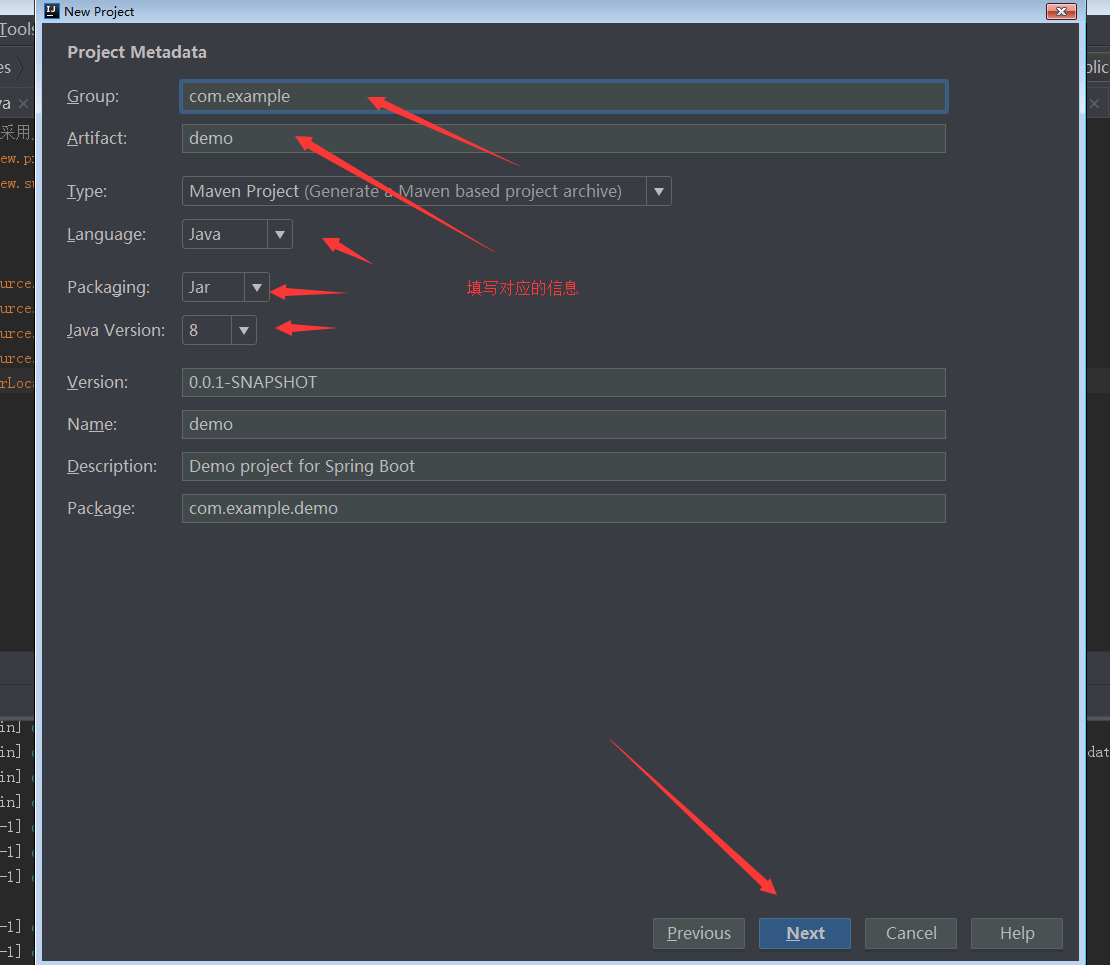
spring boot 开发起来确实要简单许多 ,spring boot 包含了 spring mvc ;内置tomcat ;启动只需要主方法即可 1.使用idea新建一个spring boot项目 file----new 一个project 选择 Spring Initializr 然后next 最下面是pom.xml <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.example</groupId> <artifactId>demo</artifactId> <version>0.0.1-SNAPSHOT</version> <packaging>jar</packaging> <name>demo</name> <description>Demo project for Spring Boot</description> <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>2.0.3.RELEASE</version> <relativePath/> <!-- lookup parent from repository --> </parent> <properties> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding> <java.version>1.8</java.version> </properties> <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> <!-- tomcat 的支持.--> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-tomcat</artifactId> <scope>provided</scope> </dependency> <dependency> <groupId>org.apache.tomcat.embed</groupId> <artifactId>tomcat-embed-jasper</artifactId> <scope>provided</scope> </dependency> <!-- MySql驱动 --> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>5.1.21</version> </dependency> <dependency> <groupId>com.alibaba</groupId> <artifactId>druid</artifactId> <version>1.1.9</version> </dependency> <dependency> <groupId>org.mybatis.spring.boot</groupId> <artifactId>mybatis-spring-boot-starter</artifactId> <version>1.3.2</version> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> </plugin> </plugins> </build> </project>

优秀的个人博客,低调大师

SpringBoot 整合(五)Swagger2

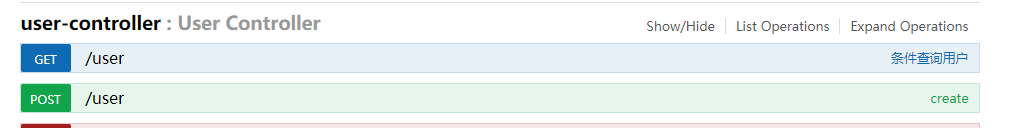
日常我们开发完后端接口,如果是返回restful,写API文档是免不了的,Swagger可以帮我们解决大多数问题(自动生成API文档)。 他会帮我们生成一个html页面,大概就是这个样子。 好了,开始正文,如果你觉得有需要的话,往下看。 1. 添加依赖 <dependency> <groupId>io.springfox</groupId> <artifactId>springfox-swagger2</artifactId> <version>2.6.1</version> </dependency> <dependency> <groupId>io.springfox</groupId> <artifactId>springfox-swagger-ui</artifactId> <version>2.6.1</version> </dependency> 2. 修改启动项 添加注解 @EnableSwagger2 //开启swagger文档生成 3. 给Controller或者字段添加注释 3.1 给Controller方法添加注释。 @ApiOperation(value = "条件查询用户") @GetMapping("/user") @JsonView(User.UserSimpleView.class) public List query(UserQueryCondition condition, @PageableDefault(page = 2,size = 7,sort = "username,asc")Pageable pageable){ System.out.println(ReflectionToStringBuilder.toString(condition, ToStringStyle.DEFAULT_STYLE)); List<User> users = new ArrayList<>(); users.add(new User()); users.add(new User()); users.add(new User()); return users; } 然后访问http://127.0.0.1:8080/swagger-ui.html 3.2 给方法中的字段添加注释 方法一: @RequestMapping("/user/{id:\\d+}") @ApiImplicitParam(name = "id",value = "用户id") public User getInfo( @PathVariable String id){ User user = new User(); user.setUsername("FantJ"); return user; } 方法二: @RequestMapping("/user/{id:\\d+}") public User getInfo(@ApiParam("用户id") @PathVariable String id){ User user = new User(); user.setUsername("FantJ"); return user; } 方法一是再方法上面加注解,方法二是再参数位加注解。 3.3 给实体类的属性添加注释 @ApiModelProperty("用户名") private String username; 最后所有注解的总结 @Api:修饰整个类,描述Controller的作用 @ApiOperation:描述一个类的一个方法,或者说一个接口 @ApiParam:单个参数描述 @ApiModel:用对象来接收参数 @ApiProperty:用对象接收参数时,描述对象的一个字段 @ApiResponse:HTTP响应其中1个描述 @ApiResponses:HTTP响应整体描述 @ApiIgnore:使用该注解忽略这个API @ApiError :发生错误返回的信息 @ApiImplicitParam:一个请求参数 @ApiImplicitParams:多个请求参数 生产中遇到的问题集锦 1. url是127.0.0.1,但是服务在云主机上。 那如何来配置这个url呢?我们添加一个配置类 package com.tyut.web.config; import io.swagger.annotations.Contact; import org.springframework.context.annotation.Bean; import org.springframework.context.annotation.Configuration; import springfox.documentation.builders.ApiInfoBuilder; import springfox.documentation.builders.RequestHandlerSelectors; import springfox.documentation.service.ApiInfo; import springfox.documentation.spi.DocumentationType; import springfox.documentation.spring.web.plugins.Docket; import springfox.documentation.swagger2.annotations.EnableSwagger2; /** * Created by Fant.J. * 2018/4/30 17:20 */ @Configuration @EnableSwagger2 public class SwaggerConfig { public static final String SWAGGER_SCAN_BASE_PACKAGE = "com.tyut.web.controller"; public static final String VERSION = "1.0.0"; ApiInfo apiInfo() { return new ApiInfoBuilder() .title("Swagger API") .description("This is to show api description") .license("Apache 2.0") .licenseUrl("http://www.apache.org/licenses/LICENSE-2.0.html") .termsOfServiceUrl("") .version(VERSION) // .contact(new Contact("","", "844072586@qq.com")) 联系方式 .build(); } @Bean public Docket customImplementation(){ return new Docket(DocumentationType.SWAGGER_2) .select() .apis(RequestHandlerSelectors.basePackage(SWAGGER_SCAN_BASE_PACKAGE)) .build() .host("47.xxx.xxx.96") .directModelSubstitute(org.joda.time.LocalDate.class, java.sql.Date.class) .directModelSubstitute(org.joda.time.DateTime.class, java.util.Date.class) .apiInfo(apiInfo()); } } 2. 修改controller描述 在controller上加注解@Api(description = "公告API") 介绍下我的所有文集: 流行框架 SpringCloudspringbootnginxredis 底层实现原理: Java NIO教程Java reflection 反射详解Java并发学习笔录Java Servlet教程jdbc组件详解Java NIO教程Java语言/版本 研究

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册