2026AI面试题-Temperature 和 top_p 参数有什么作用?
### 题目分类 Prompt 工程与 Context Engineering / 生成参数、概率采样与解码策略 ### 考察点 - 能否说明模型先输出 Logits,Temperature 和 top_p 改变的是下一 Token 的采样分布,而不是模型知识或能力 - 能否用 `softmax(logit / T)` 解释 Temperature 如何改变概率分布的尖锐程度 - 能否讲清 top_p 选择累计概率达到阈值的最小动态候选集,并与固定数量的 top_k 区分 - 能否说明 Temperature 通常先作用于概率分布,top_p 再截断候选,二者同时调整会产生耦合 - 能否按结构化任务、事实问答、自然对话和创意生成给出合理起点,同时强调模型与 Provider 差异 - 能否通过重复采样、任务成功率、格式合法率、多样性、事实指标、延迟和成本验证参数选择 ### 通俗讲解 大模型每生成一个 Token,都会先给词表中的候选算分数。例如下一步可能是: ```text “北京” 60% “上海” 25% “中国” 10% “天气” 5% ``` `temperature` 像调节概率分布的“对比度”。温度低时,原本领先的候选更突出,模型更常选择“北京”;温度高时,概率会变平,“上海”“中国”等候选更有机会被选中。 `top_p` 像划定“允许抽签的候选圈”。如果 `top_p=0.9`,系统按概率从高到低累加,只保留累计概率达到至少 90% 的最小候选集合,再重新归一化并采样。这个集合每一步都可能不同:分布很尖时可能只留一个 Token,分布很平时可能保留很多 Token。 因此,Temperature 改的是分布形状,top_p 改的是候选边界。稳定任务通常降低随机性,创意任务可以适当放开;但它们不是准确率开关,也没有跨模型通用的“黄金值”。 ### 知识讲解 #### 1. Token 生成与采样链路 语言模型根据当前上下文输出整个词表的 Logits。Logit 是未归一化分数,经过 Softmax 后才变成概率。若启用采样,推理引擎会对概率做 Temperature、top_p、top_k、重复惩罚等处理,然后从最终分布随机选择下一个 Token。 一个常见的概念链路是: ```text Context -> Model Logits -> Temperature -> top_p/top_k -> Renormalize -> Sample ``` 具体 Provider 的处理顺序、默认值、边界值和支持参数可能不同,必须以目标模型文档和实测为准。若关闭采样并使用 Greedy Decoding,系统直接选择最高概率 Token,Temperature 与 top_p 可能不再按普通采样语义工作。 #### 2. Temperature 如何改变概率 给定 Logit `z_i` 和温度 `T > 0`,常见变换为: ```text p_i = exp(z_i / T) / sum_j exp(z_j / T) ``` - `T 1`:压缩 Logit 差异,分布更平,低概率 Token 获得更多机会 `T` 趋近 0 时会接近选择最大 Logit,但公式本身不能直接除以 0。API 中的 `temperature=0` 通常被实现为 Greedy 或近似最低随机模式,是服务端约定,不是数学上的 `softmax(z/0)`。 低温会降低输出波动,但不保证事实更正确。如果最高概率路径本来就基于错误知识、错误检索或含糊 Prompt,低温只会更稳定地重复错误。 图解 1:下面这张图展示同一组 Logits 在不同 Temperature 下如何变尖或变平,以及 top_p 如何形成动态 Nucleus。 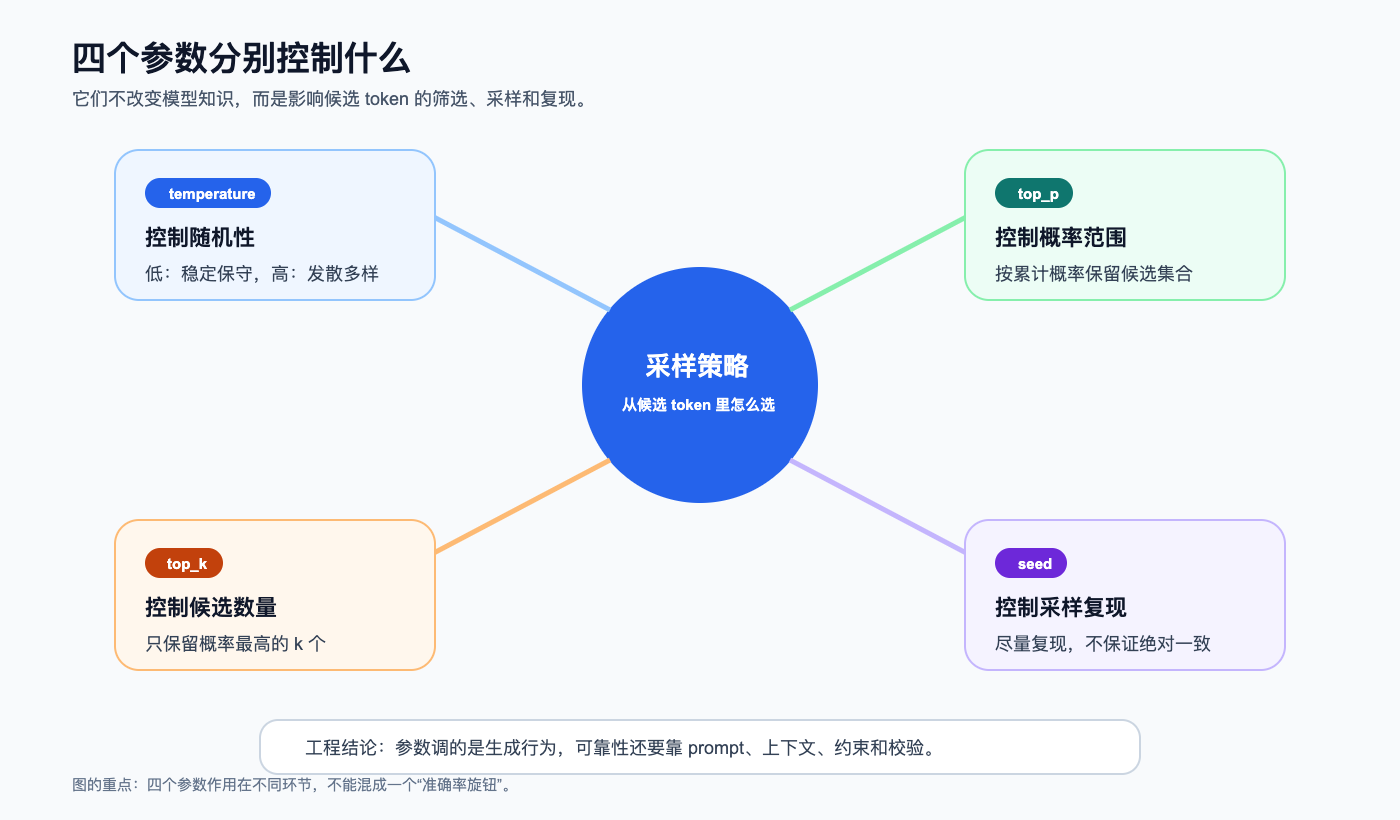 #### 3. top_p 如何选择动态候选集 top_p 也叫 Nucleus Sampling。算法先按概率从高到低排序,再选择累计概率达到 `p` 或更高的最小前缀集合,丢弃长尾候选,最后对保留概率重新归一化并采样。 例如排序后的概率是 `[0.55, 0.25, 0.12, 0.05, 0.03]`: - `top_p=0.7`:前两个 Token 累计 0.80,保留 2 个 - `top_p=0.9`:前三个 Token 累计 0.92,保留 3 个 - `top_p=1.0`:通常不做 Nucleus 截断,保留完整分布 它与 top_k 不同。top_k 永远保留概率最高的固定 `k` 个候选;top_p 保留的数量随当前分布动态变化。分布很确定时 Nucleus 很小,分布不确定时 Nucleus 会扩大。 #### 4. Temperature 与 top_p 如何联动 Temperature 改变概率后,累计概率也会变化,因此会直接影响 top_p 最终保留多少 Token。低 Temperature 让头部更集中,同一个 top_p 往往得到更小的候选集;高 Temperature 让分布变平,同一个 top_p 可能保留更多候选。 若同时大幅降低 Temperature 和 top_p,输出可能过于保守、重复或退化;同时大幅提高二者,则可能扩大长尾噪声、增加跑题和格式失败。更重要的是,同时变化后难以判断质量改变来自哪个参数。 工程上通常选择一个主旋钮:固定 `top_p` 在默认或较宽范围,主要调 Temperature;或者固定 Temperature,主要调 top_p。OpenAI API 文档也建议一般调整二者之一,而不是同时调整两者。 #### 5. 如何按任务选择起始值 下面是用于实验的起点,不是跨模型标准答案: - 分类、抽取、JSON、工具参数:使用模型支持的最低或较低 Temperature,例如 `0~0.2`,top_p 保持默认或较宽;可靠性主要靠 Schema、校验和重试 - RAG 问答、事实总结:可从 `0~0.3` 开始,top_p 取 `0.8~1.0`,重点验证 Groundedness、引用和拒答 - 客服表达、普通对话:可从 `0.4~0.8` 开始,top_p 取 `0.8~0.95`,平衡自然度与一致性 - 头脑风暴、创意文案:可从 `0.8~1.2` 开始,top_p 取 `0.9~1.0`,再用主题、禁区和人工偏好控制质量 图解 2:下面这张图给出不同任务的调参起点、主要指标和失败时的调整方向。 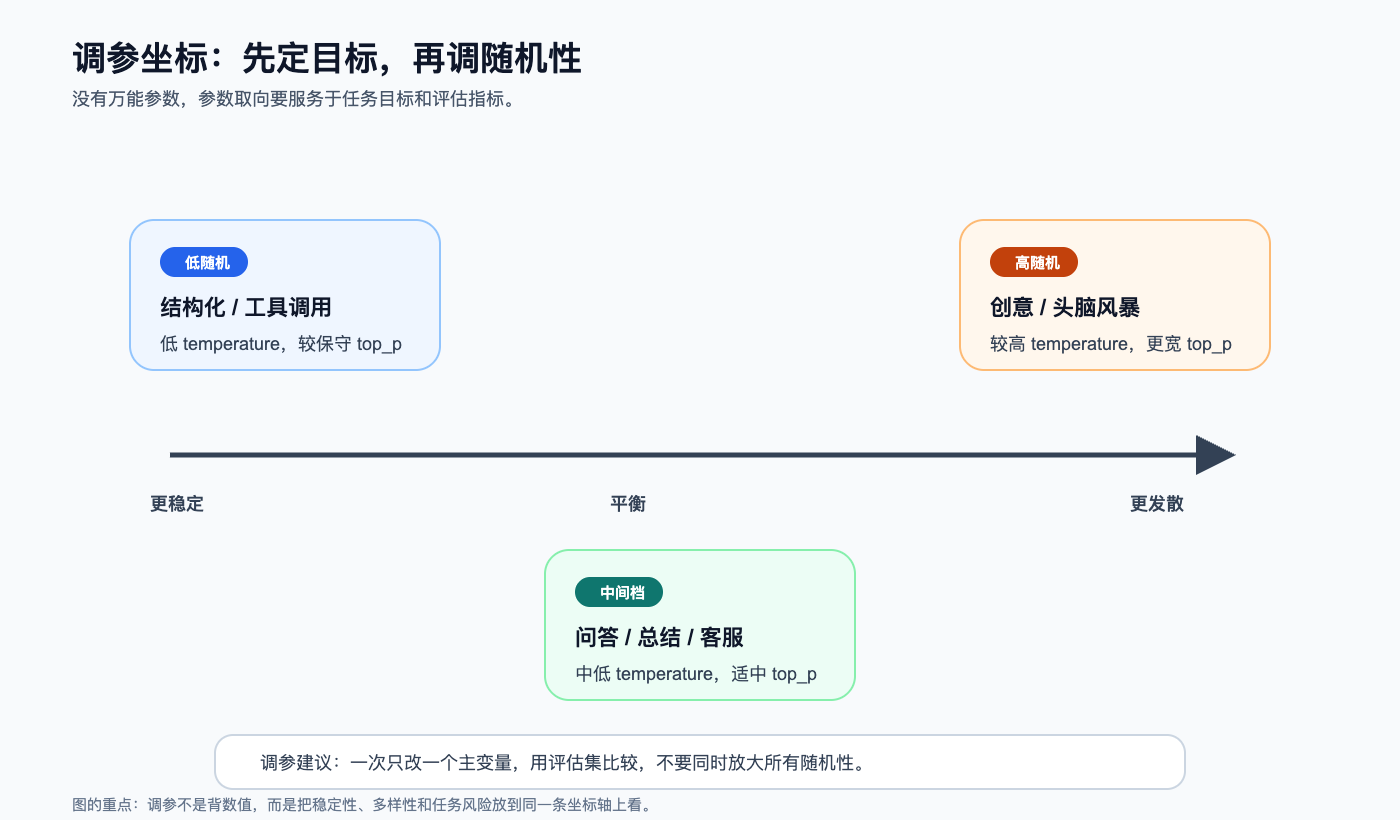 参数范围还受到模型训练方式和 API 限制影响。有些模型只允许特定范围,有些推理或结构化模式不支持这些参数,有些模型在相同数值下表现完全不同。上线前必须针对具体模型版本做评估。 #### 6. 选择参数要用评估集而不是感觉 先固定 Model、Prompt、上下文、输出长度、工具和后处理,只改变一个采样参数。对同一个用例重复运行多次,因为随机采样的一次结果无法代表分布质量。 稳定任务重点看 Task Success、Exact Match、JSON/Schema 通过率、工具参数合法率、引用正确率和输出方差。创意任务还要看 Distinct-n、语义多样性、重复率、人工偏好、主题一致性和安全违规率。 参数网格不宜过大。可以先比较低、中、高三个档位,找到可接受区域后再局部细化。每个配置记录模型快照、Prompt 版本、Temperature、top_p、Seed、样本次数、延迟、Token 和成本,才能重放和归因。 #### 7. 生产边界与常见误区 第一,低 Temperature 不等于确定性。并行计算、模型更新、后端实现和浮点差异都可能导致结果变化。即使支持 Seed,也只能提高可复现性,不能替代完整运行快照。 第二,低 Temperature 不等于低幻觉。事实可靠性主要来自正确数据、RAG、工具、引用校验、拒答和业务规则;采样参数只能影响输出路径的发散程度。 第三,参数不能修复 Prompt 冲突、上下文截断、模型能力不足或错误 Tool Schema。出现问题时要先分层定位,不能把所有 Bad Case 都归因于“温度太高”。 第四,不同阶段可以使用不同参数。规划、工具调用和结构化决策偏保守;候选创意生成可以更发散;最终汇总再回到较稳设置。但高风险业务不应靠多次随机采样决定真实副作用。 ### 代码示例 下面用纯 Python 演示 Temperature 如何改变概率,以及 top_p 如何选择最小累计概率候选集。 ```python from math import exp def temperature_softmax(logits: list[float], temperature: float) -> list[float]: if temperature list[tuple[int, float]]: if not 0 = top_p: break selected_total = sum(probability for _, probability in selected) return [ (token_id, probability / selected_total) for token_id, probability in selected ] logits = [4.0, 3.0, 2.0, 1.0] for temperature in (0.5, 1.0, 1.5): probabilities = temperature_softmax(logits, temperature) candidates = nucleus(probabilities, top_p=0.9) print(temperature, [round(value, 3) for value in probabilities], candidates) ``` ### 代码讲解 `temperature_softmax` 先将 Logit 除以 Temperature。减去最大值是数值稳定技巧,避免 `exp` 溢出;它不会改变最终 Softmax 比例。 `nucleus` 按概率降序累加,一旦达到 `top_p` 就停止,因此返回候选数是动态的。最后重新归一化,使保留候选的概率和重新变为 1,才能继续抽样。 对示例 Logits,`T=0.5` 时第一个 Token 占据绝大多数概率,`top_p=0.9` 只需要很少候选;`T=1.5` 时分布更平,同一个 top_p 会保留更多候选。这说明 Temperature 与 top_p 不是相互独立的两个开关。 代码没有实现 `temperature=0`,因为数学公式不允许除以 0。真实 API 若接受 0,会按照该 Provider 的特殊规则走 Greedy 或近似确定性解码,接入时应通过文档和 Contract Test 验证。 ### 工程深挖 第一,Sampling 与 Greedy/Beam Search 要区分。若 `do_sample=false`,模型通常走 Greedy 或 Beam Search,Temperature/top_p 可能被忽略。调参前先确认实际解码策略和最终有效请求。 第二,处理顺序会改变结果。常见实现先应用 Temperature,再做 top_k/top_p 截断和归一化,但还可能插入 Presence/Frequency/Repetition Penalty、Logit Bias、Min Tokens 和 Stop 条件。不同引擎必须做契约测试。 第三,参数效果随生成位置变化。每一步的概率分布都不同,top_p 候选数也动态变化;不能只查看第一个 Token 的 Logprobs 就推断整段文本的多样性。 第四,结构化输出的首选控制不是低温,而是原生 Structured Output、JSON Schema、有限枚举和服务端校验。低温只能降低部分波动,无法保证括号闭合、字段齐全或业务合法。 第五,创意多样性不能只看 Temperature。过高温度可能增加语法和事实错误;更稳的方法是生成多个有边界的候选,再用独立 Judge、规则或人工选择,并监控重复率与安全指标。 第六,线上回放要记录完整快照,包括模型与 Provider 版本、Prompt、上下文、采样参数、Seed、工具/RAG 结果、响应 ID 和后处理。只记录 Temperature 和 top_p 无法解释漂移。 第七,参数配置应按任务路由。不要让创意文案、RAG 问答和支付 Tool Call 共用一套默认值;配置要版本化、可灰度、可回滚,并在模型升级后重新校准。 ### 面试回答 Temperature 和 top_p 都作用于大模型生成下一个 Token 时的采样分布,但控制方式不同。模型先输出 Logits,Temperature 通常通过 `softmax(logit / T)` 调整分布形状:低于 1 会让头部概率更集中,输出更稳定;高于 1 会让分布更平,低概率候选更容易被采样。 top_p 是 Nucleus Sampling。它按概率从高到低排序,只保留累计概率达到 `p` 的最小候选集合,再重新归一化采样。因此它的候选数量是动态的;top_k 则固定保留概率最高的 k 个 Token。 两者会联动,因为 Temperature 改变概率后,top_p 的累计集合也会变化。实践中我通常固定一个、只调另一个主变量,而不是同时大幅调整,这样更容易归因。`temperature=0` 是 API 的特殊实现,不是把公式里的 T 真设成 0;具体是否走 Greedy 要看 Provider。 选择时没有万能值。分类、抽取、JSON 和 Tool Call 从最低或较低 Temperature 开始;RAG 与事实总结偏低;普通对话用中等随机性;创意任务再适当提高 Temperature 或 top_p。具体范围只是实验起点,模型更换后必须重测。 最后我会固定 Prompt 和上下文,对每个配置重复采样,用任务成功率、格式通过率、Groundedness、引用正确率、多样性、重复率、P95 和成本选择参数。低 Temperature 只能减少波动,不能修复错误知识、差检索或含糊 Prompt。 ### 面试官追问 1. 为什么 Temperature 越低,概率分布越尖? - 回答方向:Logit 除以小于 1 的 T 会放大差异,Softmax 后高 Logit Token 获得更大概率优势。 2. top_p 和 top_k 有什么区别? - 回答方向:top_p 按累计概率保留动态数量候选;top_k 固定保留最高概率的 k 个候选。 3. 为什么不建议同时大幅调整 Temperature 和 top_p? - 回答方向:Temperature 会改变 top_p 的候选集合,二者耦合;同时变化难以归因,也可能过度收缩或放大分布。 4. `temperature=0` 能保证完全一致吗? - 回答方向:不能;它通常是 Provider 的 Greedy/低随机特例,后端、模型版本和浮点计算仍可能造成差异。 5. 降低 Temperature 能解决幻觉吗? - 回答方向:不能,只能减少随机波动;事实可靠性需要证据、RAG、工具、引用校验和拒答。 6. 如何为新模型重新选择参数? - 回答方向:固定其他变量,按任务分桶重复采样,比较质量、多样性、格式、安全、延迟和成本,再灰度上线。 ### 高分回答要点 - 能从 Logits、Softmax 和 Token Sampling 链路解释参数,而不只背“随机性” - 写出 `softmax(logit / T)` 并说明低温变尖、高温变平 - 准确定义 top_p 的最小累计概率候选集和重新归一化 - 主动说明 Temperature 影响 top_p 候选集,通常只调一个主变量 - 给出分任务实验起点,同时强调模型、Provider 和解码策略差异 - 用重复采样与质量、格式、多样性、安全、延迟成本指标做选择 ### 常见扣分回答 - 把 Temperature 当作准确率或幻觉开关,认为越低一定越正确 - 说 top_p 是“保留概率大于 p 的 Token”,没有累计概率概念 - 混淆 top_p 与 top_k,认为候选数量都是固定的 - 直接把 `temperature=0` 代入 Softmax 公式,不说明 API 特殊处理 - 给所有模型和任务一个固定万能值,不做重复采样和评估 - 同时修改 Prompt、模型、Temperature、top_p 和后处理,导致结果无法归因 ### 项目结合话术 我会把生成参数按任务类型版本化,而不是全系统共用默认值。结构化抽取和 Tool Call 从最低随机配置开始,并依赖 Schema 与业务校验;RAG 问答重点测 Groundedness、引用和拒答;创意任务才扩大采样空间并生成多个候选。每次调参会固定模型、Prompt、上下文和后处理,对黄金集重复采样,比较任务成功率、格式通过率、多样性、P95 与单位成功成本,再通过灰度和回放决定是否上线。 ### 一句话总结 Temperature 调整概率分布的尖锐程度,top_p 截取累计概率覆盖的动态候选集;选值要按具体模型和任务做单变量、重复采样评估,而不能把参数当成准确率或幻觉的万能开关。 ### 参考来源 - [同义题源:temperature 和 top_p 参数有什么作用?如何选择合适的值?](https://www.mianshiya.com/bank/1906189461556076546/question/1991796947287056385) - [Hugging Face Transformers:Generation](https://huggingface.co/docs/transformers/main_classes/text_generation) - [Hugging Face Transformers:Generation Strategies](https://huggingface.co/docs/transformers/generation_strategies) - [Holtzman et al.:The Curious Case of Neural Text Degeneration](https://arxiv.org/abs/1904.09751) - [OpenAI API Reference:Create a model response](https://developers.openai.com/api/reference/resources/responses/methods/create)