首页 文章 精选 留言 我的

精选列表

搜索[桌面应用开发],共10000篇文章
优秀的个人博客,低调大师

hadoop实战–搭建eclipse开发环境及编写Hello World

1、在eclise中安装hadoop的插件并配置 在上篇文章《编译hadoop eclipse的插件(hadoop1.0)》,已经介绍过怎样编译基于hadoop1.0的eclipse插件 将jar包放在eclipse安装目录下的plugins文件夹下。然后启动eclipse 进入后,在菜单window->Rreferences下打开设置: 点击“Ant” 出现: 点击browse选择hadoop的源码下的build目录,然后点OK 打开Window->Show View->Other 选择Map/Reduce Tools,单击Map/Reduce Locations,会打开一个View: 添加Hadoop Loacation,其中Host和Port的内容这里的host和port对应mapred-site.xml中mapred.job.tracker的值,UserName 是用户名,我配置的是localhost和9001 但是出现如下问题,eclipse的左侧看不到project explorer,更看不到其中的dfs 解决办法: 应该在菜单栏 选择:Window->Open pespective-><Map/Reduce>。然后就能看到HDFS文件系统已经所创建得一些项目。 添加Hadoop Loacation,其中Host和Port的内容跟据conf/hadoop-site.xml的配置填写,UserName 是用户名,如下图 成功添加Hadoop Loacation后还可能出现如下错误: 解决办法: 这时候,需要对namenode进行格式化:bin/hadoop namenode -format 执行命令:bin/start-all.sh 如果test下面的文件夹显示(1)而不是(2)也是正常的,如果要显示(2),运行《安装并运行hadoop》一文中最后的那几个命令。 在配置完后,在Project Explorer中就可以浏览到DFS中的文件,一级级展开,可以看到之前我们上传的in文件夹,以及当是存放的2个txt文件,同时看到一个在计算完后的out文件夹。 现在我们要准备自己写个Hadoop 程序了,所以我们要把这个out文件夹删除,有两种方式,一是可以在这树上,执行右健删除。 二是可以用命令行: $ bin/hadoop fs -rmr out 用$bin/hadoop fs -ls 查看 2、编写HelloWorld 环境搭建好了,之前运行Hadoop时,直接用了examples中的示例程序跑了下,现在可以自己来写这个HelloWorld了。在eclipse菜单下 new Project 可以看到,里面增加了Map/Reduce选项: 选中,点下一步: 输入项目名称后,继续(next), 再点Finish 然后在Project Explorer中就可以看到该项目了,展开,src发现里面啥也没有,于是右健菜单,新建类(new->new class): 然后点击Finish,就可以看到创建了一个java类了: 然后在这个类中填入下面代码: public static class TokenizerMapper extends Mapper<Object, Text, Text, IntWritable>{ private final static IntWritable one = new IntWritable(1); private Text word = new Text(); public void map(Object key, Text value, Context context ) throws IOException, InterruptedException { StringTokenizer itr = new StringTokenizer(value.toString()); while (itr.hasMoreTokens()) { word.set(itr.nextToken()); context.write(word, one); } } } public static class IntSumReducer extends Reducer<Text,IntWritable,Text,IntWritable> { private IntWritable result = new IntWritable(); public void reduce(Text key, Iterable<IntWritable> values, Context context ) throws IOException, InterruptedException { int sum = 0; for (IntWritable val : values) { sum += val.get(); } result.set(sum); context.write(key, result); } } public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); String[] otherArgs = new GenericOptionsParser(conf, args).getRemainingArgs(); if (otherArgs.length != 2) { System.err.println("Usage: wordcount <in> <out>"); System.exit(2); } Job job = new Job(conf, "word count"); job.setJarByClass(wordCount.class); job.setMapperClass(TokenizerMapper.class); job.setCombinerClass(IntSumReducer.class); job.setReducerClass(IntSumReducer.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(IntWritable.class); FileInputFormat.addInputPath(job, new Path(otherArgs[0])); FileOutputFormat.setOutputPath(job, new Path(otherArgs[1])); System.exit(job.waitForCompletion(true) ? 0 : 1); } 填入代码后,会看到一些错误,没关系,点击边上的红叉,然后选择里面的import即可: import java.io.IOException; import java.util.StringTokenizer; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import org.apache.hadoop.util.GenericOptionsParser; 这里,如果直接用源码来操作,可能会GenericOptionsParser这个类找不到定义,还是红叉,添加commons-cli- 1.2.jar这个jar包,在build/ivy/lib/Hadoop/Common下,右健Project Explorer中的MyHelloWorld工程,选择Build Path->Config Build Path 在Liberaries Tab页下,点击Add External JARs 在弹出窗口中,跟据前面说的目录,找到这个jar包,点确定后,回到工程,可以看到红叉消失,说明编译都通过了。 在确保整个工程没有错误后,点击上面的小绿箭头,然后在弹出的小窗口上,选择Run On Hadoop: 点OK后,会弹出小窗口: 然手中选择Choose an existing server from the list below。然后找到之前配置的地址项,选中后,点Finish,然后系统不会Run起来,在控制台(双击可最大化)中可以看到运行结果: 运行完后,可以看到多了一个out文件夹,双击打开out文件可以看到单词的统计结果来 3、可能出现的问题: 问题1: 运行后,如果Console里只输出Usage :wordcount<in> <out>, 则需要修改下参数,在运行菜单边上小箭头,下拉,点击Run Configuration,: 左边选中 JavaApplication中的 WordCount,右边,在Arguments中输入 in out。然后再点Run 就可以看到结果了。 左边选中 JavaApplication中的 WordCount,右边,在Arguments中输入 in out。然后再点Run 就可以看到结果了。 问题2: 第二次运行会报错,仔细看提示,可以看到报错的是out目录已经存在,所以需要手动来删除一下。 更进一步 上面我们写了一个MapReduce的HelloWorld程序,现在,我们就也学一学HDFS程序的编写。HDFS是什么,它是一个分布式文件存 储系统。一般常用操作有哪些? 当然我们可以从编程角度来:创建、读、写一个文件,列出文件夹中的文件及文件夹列表,删除文件夹,删除目录,移动文件或文件夹,重命名文件或文件夹。 启动eclipse,新建Hadoop项目,名称MyHDFSTest,新建类HDFSTest,点击确定,然后同样工程属性Configure BuildPath中把 build/ivy/lib/Hadoop下的所有jar包都引用进来(不详细说明了,可参考上面的步骤) 在类中,添加main函数: public static void main(String[] args) { } 或者也可以在添加类时,勾选上创建main,则会自动添加上。 在mian函数中添加以下内容: try { Configuration conf = new Configuration(); conf.set("fs.default.name", "hdfs://localhost:9000"); FileSystem hdfs = FileSystem.get(conf); Path path = new Path("in/test3.txt"); FSDataOutputStream outputStream = hdfs.create(path); byte[] buffer = "Hello".getBytes(); outputStream.write(buffer, 0, buffer.length); outputStream.flush(); outputStream.close(); System.out.println("Create OK"); } catch (IOException e) { e.printStackTrace(); } 直接添加进来会报错,然后需要添加一些引用才行: import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.FSDataOutputStream; import org.apache.hadoop.fs.FileSystem; import org.apache.hadoop.fs.Path; 在没有错误后,点击工具条上的运行, 但这次跟前次不一样,选择Run as Java Application。然后,就可以在输出框中看到Create OK的字样了,表明程序运行成功。 这段代码的意思是在in文件夹下,创建test3.txt,里面的内容是”Hello”。 在运行完后,我们可以到eclipse的Project Explorer中查看是否有这文件以及内容。同样也可以用命令行查看$bin/hadoop fs -ls in。 ok,第一个操作HDFS的程序跑起来了,那其它功能只要套上相应的处理类就可以了。为了方便查找操作,我们列举了张表: 操作说明 操作本地文件 操作DFS文件 主要命名空间 java.io.File java.io.FileInputStream java.io.FileOutputStream org.apache.hadoop.conf.Configuration org.apache.hadoop.fs.FileSystem org.apache.hadoop.fs.Path org.apache.hadoop.fs.FSDataInputStream; org.apache.hadoop.fs.FSDataOutputStream 初使化对象 new File(路径); Configuration FileSystem hdfs 创建文件 File.createNewFile(); FSDataOutputStream = hdfs.create(path) FSDataOutputStream.write( buffer, 0, buffer.length); 创建文件夹 File.mkdir() hdfs.mkdirs(Path); 读文件 new FileInputStream(); FileInputStream.read(buffer) FSDataInputStream = hdfs.open(path); FSDataInputStream.read(buffer); 写文件 FileOutputStream.write( buffer, 0, buffer.length); FSDataOutputStream = hdfs.append(path) FSDataOutputStream.write( buffer, 0, buffer.length); 删除文件(夹) File.delete() FileSystem.delete(Path) 列出文件夹内容 File.list(); FileSystem.listStatus() 重命令文件(夹) File.renameTo(File) FileSystem.rename(Path, Path) 有了这张表,以后在需要的时候就可以方便查询了。

优秀的个人博客,低调大师

iOS开发- 以图搜图功能实现 (源码+解析)

以图搜图这个功能相当实用, 之前在实现这个功能的时候, 有一些笔记, 今天就整合成博文, 分享给大家。 这个demo主要实现的功能包括: 自定义拍照界面 图像识别 以图搜图 信息获取(通过识别出的图像, 获取对应信息) 下面是一个简单的演示, 如下: 那么如何实现这样的功能呢? 如果自己去完成图像识别, 显然不现实。 最早我研究的是谷歌API, 不过谷歌在天朝, 大家都懂得... 然后是百度了,尝试了下, 效果还不错。 另外, 百度也有自己“以图搜图”对应的App。不过我们只是为了学会如何实现怎样的功能, 管他呢。 所以,在以图搜图功能上, 我选择了使用百度API,不过百度这个API只提供给他们的“百度轻拍”APP, 不对外开放,我也是通过轻拍抓到的API,然后进行分析。 好了, 接下去就是分析过程了。 demo之后会提供。 1. UIImage 转 NSString 之后我们会采用 post方式, 获取对应的json数据,但是这个请求里面,要传入base64Encoding 编码的NSString (这里放的是图片信息) (不要问我为什么, 百度就是这样设计的 ) [objc] view plain copy UIImage*pic=[UIImageimageNamed:@"test_1.png"]; NSData*pictureData=UIImagePNGRepresentation(pic); NSString*pictureDataString=[pictureDatabase64Encoding]; 2. POST请求 这里, 我抓到的URL是这样的:http://qingpai.baidu.com/api/irs/rex?reqid=196423494211296782&ak=eyJjdCI6IjIwIn0%3D&encoding=base64 如果感兴趣如何获取的, 可以留言, 如果真有疑惑, 我之后会专门再写一篇文章。 这里不是本次的主题, 就不涉及这部分内容了 简单分析下这个API。 qingpai.baidu.com/api/ 很明显, 它是为 ”百度轻拍“提供的 reqid, ak这个是绑定设备的。 这里固定使用这个就可以 encoding=base64 表示传入数据的编码方式。 上面那个API是固定的, 需要改变的是我们post时候传入的数据 具体如下: [objc] view plain copy UIImage*pic=[UIImageimageNamed:@"test_1.png"]; NSData*pictureData=UIImagePNGRepresentation(pic); NSString*pictureDataString=[pictureDatabase64Encoding]; //Post请求 NSString*post=[NSStringstringWithFormat:@"%@",pictureDataString]; NSData*bodyData=[[poststringByAddingPercentEscapesUsingEncoding:NSUTF8StringEncoding]dataUsingEncoding:NSUTF8StringEncoding];//把bodyString转换为NSData数据 NSURL*serverUrl=[NSURLURLWithString:@"http://qingpai.baidu.com/api/irs/rex?reqid=196423494211296782&ak=eyJjdCI6IjIwIn0%3D&encoding=base64"];//获取到服务器的url地址 NSMutableURLRequest*request=[NSMutableURLRequestrequestWithURL:serverUrl cachePolicy:NSURLRequestReloadIgnoringCacheData timeoutInterval:10];//请求这个地址,timeoutInterval:10设置为10s超时:请求时间超过10s会被认为连接不上,连接超时 [requestsetHTTPMethod:@"POST"];//POST请求 [requestsetHTTPBody:bodyData];//body数据 [requestsetValue:@"application/x-www-form-urlencoded"forHTTPHeaderField:@"content-type"];//请求头 NSData*returnData=[NSURLConnectionsendSynchronousRequest:requestreturningResponse:nilerror:nil]; NSString*result=[[NSStringalloc]initWithData:returnDataencoding:NSUTF8StringEncoding]; NSMutableDictionary*addressDic=[resultobjectFromJSONString]; //异步发送request,成功后会得到服务器返回的数据 //返回的数据根据系统的不同会返回不同编码的数据,比如windows为GBK,Ubuntu为UTF8.。。 //注意转换编码格式 NSLog(@"%@",addressDic); 看一下打印的信息, 是json数据, 我拆分完以后, 大体长这样: 返回的数据很多, 大家感兴趣可以自己逐一分析。 简单的介绍下. facesatar 表示 识别出来相似的明星人脸。 [objc] view plain copy "name":"\u90ac\u9756\u9756", "nameid":"1931", "simi":"0.904725", "pid":"1932\/64.jpg", "width":"440", "height":"440", "face_left":"143", "face_top":"107", "face_width":"193", "face_height":"193" 这里是一项的数据. 我们需要的主要是 “name” 和 “simi”属性,分别标示 明星姓名, 相似度。 其他的熟悉包括图片的大小, 人脸的位置, 如果需要也可以使用。 另外, name 这里的编码是Unicode,所以如果一起输出可能不明白什么意思。(缩小到name, 单个输出, 在终端可以看到中文)不过我们获取到这个“name”值后,是可以直接显示,会显示中文的。 另外. 提供一个好用的网站,便于测试 中文转Unicode Unicode转中文 http://javawind.net/tools/native2ascii.jsp?action=transform 再有,similar列表这里列举出了相似的图片及其来源。 具体大家可以自己分析。 三。获取详细信息 我们可以通过json数据里面, 获取到相似度最高的那个人物姓名(也可以是景点名字, 这个API比较强大) 然后调用如下API,就可以显示显示详细信息了。百度都为“轻拍”封装好了。 比如, 人物姓名是 “邬靖靖” , 调用如下URL: http://qingpai.baidu.com/api/proxy/search?word=邬靖靖&pn=1 我这里直接用Safari打开, 就可以看到如下效果: 这样一个封装好的WAP界面, 我们可以直接在UIWebView中, 利用URL打开, 效果就很好了。 将到这里, 主要就是分享一些可供我们直接使用的API。 当然, 这个API在别处肯定是找不到的。 另外, 图片搜索我们还可以拓展出好多知识, 比如 人脸识别,光学字符识别, 图像文字识别.... 以上提到的那3部分, 之前都有写过相关demo。 不过最近忙着考试, 等以后有时间了再逐一分享。 希望以上内容对你有所帮助。

优秀的个人博客,低调大师

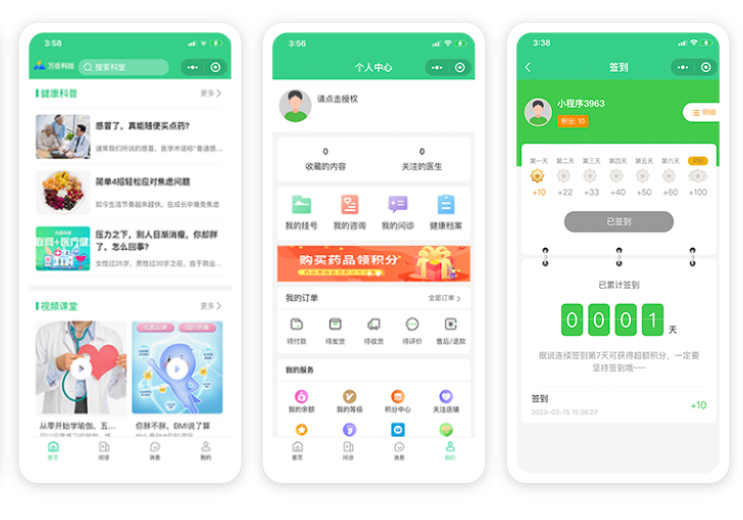
互联网医院系统开发解决方案:AI问诊、在线医疗、患者管理一体化平台开发详解

随着互联网技术与人工智能技术的快速发展,医疗服务模式正在发生深刻变化。从过去“患者到医院找医生”,逐渐转变为“医生通过数字化平台连接患者”。互联网医院系统作为智慧医疗的重要组成部分,正在帮助医疗机构、医生团队以及健康服务企业实现线上诊疗、患者管理、医疗服务数字化升级。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册