首页 文章 精选 留言 我的

精选列表

搜索[AI原生解析],共10000篇文章
优秀的个人博客,低调大师

Serverless 的 AI 写诗,程序员浪漫起来谁能顶得住啊!

古诗词是中国文化殿堂的瑰宝,记得曾经在韩国做 Exchange Student 的时候,看到他们学习我们的古诗词,有中文的还有翻译版的,自己发自内心的骄傲,甚至也会在某些时候背起一些耳熟能详的诗词。 本文将会通过深度学习为我们生成一些古诗词,并将模型部署到 Serverless 架构上,实现基于 Serverless 的古诗词生成 API。 项目构建 古诗词生成实际上是文本生成,或者说是生成式文本。关于基于深度学习的文本生成,最入门级的读物包括 Andrej Karpathy 的博客。他使用例子生动讲解了 Char-RNN (Character based Recurrent Neural Network) 如何用于从文本数据集里学习,然后自动生成像模像样的文本。 上图直观展示了 Char-RNN 的原理。以要让模型学习写出「hello」为例,Char-RNN 的输入输出层都是以字符为单位。输入「h」,应该输出「e」;输入「e」,则应该输出后续的「l」。 输入层我们可以用只有一个元素为1的向量来编码不同的字符,例如,「h」被编码为「1000」、「e」被编码为「0100」,而「l」被编码为「0010」。使用 RNN 的学习目标是,可以让生成的下一个字符尽量与训练样本里的目标输出一致。在图一的例子中,根据前两个字符产生的状态和第三个输入「l」预测出的下一个字符的向量为 <0.1, 0.5, 1.9, -1.1>,最大的一维是第三维,对应的字符则为「0010」,正好是「l」。这就是一个正确的预测。但从第一个「h」得到的输出向量是第四维最大,对应的并不是「e」,这样就产生代价。 学习的过程就是不断降低这个代价。学习到的模型,对任何输入字符可以很好地不断预测下一个字符,如此一来就能生成句子或段落。 本文项目构建参考了 Github 已有项目:https://github.com/norybaby/poet 通过 Clone 代码,并且安装相关依赖: pip3 install tensorflow==1.14 word2vec numpy 通过训练: python3 train.py 可以看到训练结果: 此时会生成多个模型在 output_poem 文件夹下,我们只需要保留最好的即可,例如我的训练之后生成的 json 文件: { "best_model": "output_poem/best_model/model-20390", "best_valid_ppl": 21.441762924194336, "latest_model": "output_poem/save_model/model-20390", "params": { "batch_size": 16, "cell_type": "lstm", "dropout": 0.0, "embedding_size": 128, "hidden_size": 128, "input_dropout": 0.0, "learning_rate": 0.005, "max_grad_norm": 5.0, "num_layers": 2, "num_unrollings": 64 }, "test_ppl": 25.83984375 } 此时,我只需要保存 output_poem/best_model/model-20390 模型即可。 部署上线 在项目目录下,安装必要依赖: pip3 install word2vec numpy -t ./ 由于 Tensorflow 等是腾讯云云函数内置的package,所以这里无需安装,另外 numpy 这个 package 需要在 CentOS+Python3.6 环境下打包。也可以通过之前制作的小工具打包:https://www.serverlesschina.com/35.html 完成之后,编写函数入口文件: import uuid, json from write_poem import WritePoem, start_model writer = start_model() def return_msg(error, msg): return_data = { "uuid": str(uuid.uuid1()), "error": error, "message": msg } print(return_data) return return_data def main_handler(event, context): # 类型 # 1: 自由 # 2: 押韵 # 3: 藏头押韵 # 4: 藏字押韵 style = json.loads(event["body"])["style"] content = json.loads(event["body"]).get("content", None) if style in '34' and not content: return return_msg(True, "请输入content参数") if style == '1': return return_msg(False, writer.free_verse()) elif style == '2': return return_msg(False, writer.rhyme_verse()) elif style == '3': return return_msg(False, writer.cangtou(content)) elif style == '4': return return_msg(False, writer.hide_words(content)) else: return return_msg(True, "请输入正确的style参数") 同时需要准备好 Yaml 文件: getUserIp: component: "@serverless/tencent-scf" inputs: name: autoPoem codeUri: ./ exclude: - .gitignore - .git/** - .serverless - .env handler: index.main_handler runtime: Python3.6 region: ap-beijing description: 自动古诗词撰写 namespace: serverless_tools memorySize: 512 timeout: 10 events: - apigw: name: serverless parameters: serviceId: service-8d3fi753 protocols: - http - https environment: release endpoints: - path: /auto/poem description: 自动古诗词撰写 method: POST enableCORS: true 此时,我们就可以通过 Serverless Framework CLI 部署项目。部署完成之后,我们可以通过 PostMan 测试我们的接口: 总结 本文通过已有的深度学习项目,在本地进行训练,保存模型,然后将项目部署在腾讯云云函数上,通过与 API 网关的联动,实现了一个基于深度学习的古诗词撰写的 API。 One More Thing 3 秒你能做什么?喝一口水,看一封邮件,还是 —— 部署一个完整的 Serverless 应用? 复制链接至 PC 浏览器访问:https://serverless.cloud.tencent.com/deploy/express 3 秒极速部署,立即体验史上最快的 Serverless HTTP 实战开发! 传送门: GitHub: github.com/serverless 官网:serverless.com 欢迎访问:Serverless 中文网,您可以在 最佳实践 里体验更多关于 Serverless 应用的开发! 推荐阅读:《Serverless 架构:从原理、设计到项目实战》


优秀的个人博客,低调大师

5G、AI发挥关键作用

即将开播:4月29日,民生银行郭庆谈商业银行金融科技赋能的探索与实践 随着国内防控形势趋于基本稳定,各地相继开始部署大中小学的“复课”。目前,中小学校大多已经恢复开学,大学的开学时间也都相继公布。在此之前,为了实现“停课不停教”、“停课不停学”,国家以及各地政府都在努力发挥智慧教育体系优势,在社会力量的参与下,一起推动线上学习的开展。 正是在这场特殊危机下,以“云教学”、“云学习”为代表的智慧教育得到了迅速发展,市场渗透度快速提升。不过需要指出的是,智慧教育绝不仅仅是各类教育资源“上云”,还包括了人工智能、5G等前沿技术,以及机器人、VR/AR等智能设备的应用。 解决教育资源不平衡难题 随着国家经济的发展、城市化的推进,国内教育水平实现了极大提升。总体而言,在东部沿海省份及中西部部分重点城市,教育资源相对比较丰富,优质资源集中度也较高,在教育水准上已经达到了国际先进水平。不过,这样的情况也导致教育资源分布不均的问题日益突出。 目前,东部地区与中西部地区在教育资源,尤其是优质教育资源上的分布不平衡已经是个较为严峻的难题。在很多偏远地区,不仅缺少优秀的教师,而且有些连基本的教师配置都成问题。另外,在硬件设施方面,这些偏远地区也存在着很大的不足。要想破解这一困境,必须积极利用科技的力量,智慧教育发挥的价值就在于此。 一方面,通过发展智慧教育,能够逐步释放大中城市的优质、庞大教师资源,使得一部分教师资源可以解放出来,向其他地区倾斜。这样,中小城市及偏远地区的学生可以用远程学习的方式,得到更好地教育;本地的教师也能够得到更好地培训,并腾出一部分资源来进行重点教育。 另一方面,通过发展智慧教育,可以用一系列智能化教育设备来提高乡村学校的教育环境和水平,提升本地教师的教育能力和效率,让学生可以借助这些设备获得更多新的知识、技能,从而打破客观环境给教育、学习施加的桎梏。 在这一过程中,不管是具备高速度、低时延等优势的5G网络,还是可以进行逼真现实教学的全息投影技术,又或是能够让学习体验更多学习乐趣和成果的VR/AR设备,以及帮助教师解放双手和精力的人工智能技术与智能机器人,都在发挥着关键作用。 推动智慧教育发展该怎么做? 智慧教育的落实,牵涉到方方面面,自然是离不开各级政府以及主管部门的支持。因此,在推动智慧教育发展的过程中,政策支撑所起到的作用是不可忽视的。眼下,我国多地已经出台了关于发展智慧教育的相关政策,在这些举措快速落地的情况下,将为智慧教育发展带来实实在在的利好。 与此同时,发展智慧教育也需要把“智慧”落到实处。一是要加大资金投入力度,对大中小学进行智慧化升级,建设智慧课堂、智慧教室等,并积极引入相关前沿技术及设备加以应用;二是要强化对教师的培养、培训,使得教师能够跟上智慧教育发展的步伐,更好地“传道授业解惑”。 如果说无人车、无人机解决了物流配送的“最后一公里”,共享单车解决了出行的“最后一公里”,那么智慧教育就是解决了教育资源最大化利用的“最后一公里”。在当今时代,无论是哪个领域、哪个行业,都应当积极拥抱科技的力量,主动推进智能化、数字化、网联化升级,这样才能紧跟时代步伐,解决既往难题,对于教育领域来说,也是如此。

优秀的个人博客,低调大师

每日一博 | AI 怎么将人绑定到高德地图上?

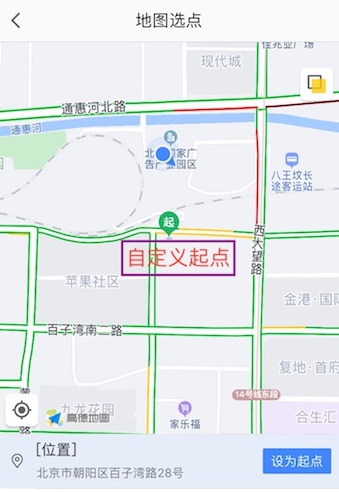
导读:高德地图作为中国领先的出行领域解决方案提供商,导航是其核心用户场景。路线规划作为导航的前提,是根据起点、终点以及路径策略设置,为用户量身定制出行方案。 起点抓路,作为路线规划的初始必备环节,其准确率对于路线规划质量及用户体验至关重要。本文将介绍高德地图针对起点抓路准确率的提升,尤其是在引入机器学习算法模型方面所进行的一些探索与实践。 什么是起点抓路 首先,我们来简单介绍一下什么是起点抓路。起点抓路是指针对用户发起的路线规划请求,通过获取到的用户定位信息,将其起点位置绑定至实际所在的道路。 从高德地图App可以看到,用户进行路线规划时选择起点的方式有以下三种: 1.手动选点(用户在地图上手动标注所处位置)。 2.POI选点(Point of Interest,兴趣点,在地理信息系统中可以是商铺、小区、公交站等地理位置标注信息)。 3.自动定位(通过GPS、基站或WiFi等方式自动定位所在位置)。 三种方式中,用户手动选点及POI选点这两种方式的位置信息相对准确,起点抓路准确率相对较高。 而自动定位起点的方式,由于受GPS、基站、网络定位精度影响,定位坐标易发生漂移,定位设备抓取的位置与用户实际所处道路可能相差几米、几十米甚至几百米。如何在有限信息下,将用户准确定位到真实所在道路,就是我们所要解决的主要问题。 为什么要引入机器学习 引入机器学习之前,起点抓路对候选道路的排序采用了人工规则。核心思路是:以距离为主要特征,结合角度、速度等特征,加权计算得分,进而影响排序,人工规则中所涉及到的权重及阈值等是经综合实战经验人工拍定而成。 随着高德地图业务的不断增长,规划请求数量及场景的增多,人工规则的局限性越来越明显,具体表现在以下方面: 即使包含了众多经验在内,人工设定的阈值、权重仍不够完善,易发生偏移或存在盲区是不可改变的事实。 策略维护方面,面对上游数据的更新,新特征无法用最快速度加入到策略中。 人工规则拍定对经验要求较高,对于人员的更迭,很难做出最敏捷的响应。 在大数据和人工智能时代,利用数据的力量代替部分人力工作,实现流程的自动化,提高工作效率是必然趋势。 因此,基于起点抓路人工规则的现状及问题,我们引入了机器学习模型,自动学习特征与抓路结果之间的关系。一方面,拥有大量规划及实走数据,对于机器学习模型的训练数据获取,高德有天然优势;另一方面,机器学习模型有更强的表达力,能够学习到特征之间的复杂关系,提高抓路准确率。 如何实现机器学习化 回归机器学习本身,下面来介绍我们如何建立起点抓路机器学习模型。一般来讲,运用机器学习方法解决实际问题分为以下几个方面: 目标问题的定义 数据获取与特征工程 模型选择 模型训练及效果评估 1.目标问题定义 在引入机器学习模型之前,需要将待解决问题进行数学抽象。 分析起点抓路问题,如上图所示,我们可以看到当用户在A点发起路线规划请求时,其定位位置A所对应的周边道路是一个独立的集合B,而用户所在的实际道路是这个集合中的唯一一个元素C。 这样,起点抓路问题转化为在定位点周边道路集合中选出一条最有可能是用户实际所在的道路。 整个过程类似搜索排序,因此,我们在制定建模方案时也采用了搜索排序的方式。 提取用户路线规划请求中的定位信息A。 对定位点周边一定范围内的道路进行召回,组成备选集合B。 对备选道路进行排序,最终排在首条的备选道路为模型输出结果,即用户实际所在道路C。 最终,我们将起点抓路定义为一个有监督的搜索排序问题。明确了需要达到的目标,我们开始考虑数据获取及特征工程问题。 2.数据获取与特征工程 业界常言,数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限。可见对于项目最终效果,数据和特征至关重要。 训练起点抓路机器学习模型,我们需要从原始数据中获取两类数据: 真值数据,即用户发送路线规划请求时实际所处道路信息。 机器学习应用于起点抓路项目,第一个问题就是真值数据的获取。用户在某个位置A发起路线规划请求,由于定位精度限制,我们无法确认其实际所在位置,但如果用户在发起规划请求附近有实走信息,可以将实走信息匹配到路网生成一条运动轨迹,通过这条轨迹我们就可以获取到请求定位点所处的实际道路。 我们针对高德地图的导航请求数据进行相关挖掘,将用户实走与路线规划信息相结合,得到了请求与真值一一映射的数据集。 特征数据 在起点抓路模型中,我们提取了三大类特征用于构建样本集,分别是定位点相关特征、道路自身特征以及定位点与道路之间的组合特征。 特征处理是特征工程的核心部分,不同项目在进行特征预处理时会有不同,需要根据实际业务场景进行特殊化处理,往往依赖于专业领域经验。起点抓路项目中,我们针对定位特征进行了样本去重、异常值处理、错误值修正及映射等数据清洗工作。 3.模型选择 在目标问题定义中,我们将起点抓路剖析为搜索排序问题,而机器学习的ranking技术,主要包括point-wise、pair-wise、list-wise三大类。 根据起点抓路业务特点,我们采用了list-wise,其learning to rank框架具有以下特征: 输入信息是同一路线规划请求对应的所有道路构成的多特征向量(即一个query)。 输出信息是对应请求(即同一query)特征向量的打分序列。 对于打分函数,我们采用了树模型。 我们选择NDCG(Normalized Discounted Cumulative Gain归一化累积折算信息增益值)作为模型评价指标,NDCG是一种综合考虑模型排序结果和真实序列之间关系的指标,也是常用的衡量排序结果的指标。 4.模型训练及效果评估 我们抽取了一定时间段内的请求信息,按照步骤2中描述的方式获取到对应真值及特征数据,打标构建了样本集,将其划分为训练集与测试集,训练模型并查看结果是否符合预期。 评估模型效果,我们将测试集的请求分别用人工规则及机器学习模型进行抓路,并分别与真值进行对比,统计准确率。 对比结果,针对随机抽取的请求,模型与人工规则抓路结果差异率为10%,这10%的差异群体中,模型抓路准确率比人工规则提升40%,效果显著。 写在最后 以上我们介绍了大数据和机器学习在起点抓路方面的一些应用,项目的成功上线也验证了机器学习在提升准确率、优化流程等方面可以发挥重要作用。 未来,我们希望能够将现有模型场景继续细化,寻找新的收益点,从数据和模型两个角度共同探索,持续优化机器学习抓路效果。 关注高德技术,找到更多出行技术领域专业内容

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册