首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

小红书悄悄做了个AI大模型,去数学奥赛拿了个满分,666个人类天才才7个满分

![](https://developer.qcloudimg.com/operation/attachment/12085877/20260724-5bf41510.png) AI做数学题的历史,比你想的短 2024年,Google DeepMind的AlphaProof和AlphaGeometry 2第一次参加IMO,拿了28分,银牌水平。但那时候还需要专家先把题目翻译成专门的数学语言,AI才能做。算不上真正的「自己做题」。 2025年,Google的Gemini Deep Think拿到了35分,金牌水平。这一次,AI终于能直接读自然语言的题目了,不用人工翻译。但35分离满分还差7分,那年有5个人类选手比它强。 ![](https://developer.qcloudimg.com/operation/attachment/12085877/20260724-93067670.png) **2026年,小红书的dots-note-3.0,42分,满分。** 两年时间,从银牌到满分。AI在数学上的进步速度,比人类快了不知道多少倍。 而且不只是小红书和华为。Menlo Ventures的合伙人Deedy Das用今年的IMO题目测了四个最前沿的AI模型,Anthropic的Claude Fable拿了42分,OpenAI的GPT-5.6 Sol也拿了42分,Kimi K3同样42分。 ![](https://developer.qcloudimg.com/operation/attachment/12085877/20260724-247ec229.png) ![AI数学能力进化](https://developer.qcloudimg.com/http-save/yehe-6457908/63f0dc7e706336fd61b3267d4757cb81.png) 从银牌到满分,AI只用了两年 但满分和满分不一样 表面上看,四个模型都拿了42分,好像打平了。但Deedy Das把每次尝试的细节全公开了,差异很有意思。 ![](https://developer.qcloudimg.com/operation/attachment/12085877/20260724-f8e1d6c6.png) Axiom Math更有意思,它不仅做对了,还用Lean(一种数学编程语言)把每道题的证明过程全写出来了。它不是「算出来答案是对的」,它是**「我证明给你看为什么是对的」。** ![](https://developer.qcloudimg.com/operation/attachment/12085877/20260724-73ae87b9.png) 这件事真正值得想的是什么 满分本身不是重点。重点是,IMO这些题考的不是计算,**是推理。** 每道题都需要多步逻辑推理、构造性证明、找到非显而易见的解题路径。这不是背公式能背出来的,不是算力堆出来就能碾压的。AI能做到,说明它的推理能力到了一个新阶段。 但另一方面,我得说实话。AI做数学题跟人类做数学题,不是同一件事。 人类做IMO题,是在两天的考试时间里,用纸笔和脑子。AI做IMO题,是在几个小时里,用上万张GPU生成几百万个token,反复试错。Claude Fable一次就对了,K3试了多次才全对。人类选手没有「试错」这个选项,考试就一次。 ![](https://developer.qcloudimg.com/operation/attachment/12085877/20260724-0d2926fa.png) 他说的这个区别很关键。AI能做到满分,说明它的推理能力够强。但它真的「理解」数学了吗?还是只是学会了极度高效的模式匹配?这个问题,现在没人能回答。 更让我担心的是另一件事 Hechinger Report前几天发了一篇研究,追踪了几百万学生用数学学习平台的数据。ChatGPT出来之后,高中生做数学文字题的时间下降了31%。在无人监督的练习里正确率上升了,但到了正式考试,正确率从80%暴跌到60%。 ![](https://developer.qcloudimg.com/operation/attachment/12085877/20260724-2996b71d.png) 学生用AI做练习更快了,但学到的东西更少了。 AI能在IMO拿满分,跟高中生用AI做作业学得更少,这两件事同时发生。这才是真正值得关注的矛盾。 ![](https://developer.qcloudimg.com/operation/attachment/12085877/20260724-73577ebe.png) 这跟计算器普及后的情况很像。计算器出来之后,没人手算开方了,也没人觉得这是问题。但数学不只是计算,数学是训练思维的体操。你让AI替你做思维体操,**你的思维就萎缩了。** 最后说一点 小红书做AI拿满分这件事,最大的信息不是「AI多厉害」。是**「做AI的门槛正在快速降低」。** 小红书不是AI公司,它是一个社交平台。华为不是AI公司,它是一个通信和硬件公司。它们都能做出数学奥赛满分的模型,说明底层技术已经足够成熟,不需要你是AI实验室也能做出顶级模型。 去年只有Google和OpenAI能到金牌水平。今年,四个模型都能满分,而且有两个来自中国公司,其中一个还是做社交的。 **AI的推理能力过了IMO这个坎之后,下一个会是什么?** 没人知道。但按这两年的速度,可能比我们想的快得多。 觉得不错,随手点个**赞**、**在看**、**转发**三连吧 谢谢你看我的文章,我们,下次再见 ✨

优秀的个人博客,低调大师

每日一博 | 前端 monorepo 大仓权限设计的思考与实现

一、背景 前端 monorepo 在试行大仓研发流程过程中,已经包含了多个业务域的应用、共享组件库、工具函数等多种静态资源,在实现包括代码共享、依赖管理的便捷性以及更好的团队协作的时候,也面临大仓代码文件权限的问题。如何让不同业务域的研发能够顺畅的在大仓模式下开发,离不开有效的权限管理方法。好的权限管理方法能够确保研发同学轻松找到和理解项目的不同部分,而不受混乱或不必要的复杂性的影响,并且也应该允许研发同学合作并同时工作,同时也要确保代码合并的更改经过代码审查,以维护代码的质量和稳定性。本文通过实践过程中遇到的一些问题以及逐步沉淀下来的最佳实践,来阐述下前端大仓 monorepo 在权限这块是如何思考以及设计的。 二、前期调研 在做大仓权限设计的时候,前期做了很多的调研,也参考了国内和国外的一些技术文章,总结起来主要是基于以下三点的设计思路去实现: 文件系统的自研,能够做到文件读写权限的完全控制:对于文件系统的自研,国外的最佳实践不外乎是 Google 和 Meta,他们都是大仓实践的典范。对于文件系统的权限控制,有一套自研的文件系统,能够对核心代码和配置文件做到读写权限控制。在 Google 发表的一篇论文《Why Google stores billions of lines of code in a single repository》中也有提到: Since Google’s source code is one of the company’s most important assets, security features are a key consideration in Piper’s design. Piper supports file-level access control lists. Most of the repository is visible to all Piper users;d however, important configuration files or files including businesscritical algorithms can be more tightly controlled. In addition, read and write access to files in Piper is logged. If sensitive data is accidentally committed to Piper, the file in question can be purged. The read logs allow administrators to determine if anyone accessed the problematic file before it was removed. 大致的意思是 Google 内部自研了 Piper,能够支持基于文件级别的访问控制列表,大多数仓库对所有 Piper 用户可见,但是重要的配置文件或包含业务关键算法的文件可以进行更严格的控制,并且对 Piper 中的文件的读写访问都会被记录。 基于 Git 提供的钩子函数,能做到文件写权限的控制:Git 本身是一个分布式文件系统,其提供了代码研发流程中的各种钩子函数,在不同的钩子函数里面对文件的修改做校验,可以做到代码文件写权限的控制,但是做不到代码文件的读权限控制; 基于 Gitlab 的能力,对文件目录权限做控制:Gitlab开始引入了“Protected Environments”的概念,即允许为具体的文件或目录设置权限,并指定哪些用户或用户组拥有文件的“Maintainer”权限,以便管理文件的更改和合并请求,可以用于更细粒度的文件级别权限控制。当然此种方法也只能做到代码文件写权限的控制,做不到代码文件的读权限控制。 从上面的三种调研实现来看,如果要完全做到文件系统的读写权限控制,势必需要自研一套适合研发流程及业务体系的文件系统,这种实现成本会很大,且基于实际的应用场景去考虑,也不是很有必要。所以本文主要围绕基于 Git 提供的钩子函数和基于 Gitlab 的能力来阐述过程中是如何实践的。 三、设计实现 在前端 monorepo 实践过程中,对于权限模块的设计如果考虑不好的话,会带来很不好的研发体验,同时权限的实现不仅仅是代码逻辑层面,需要考虑很多方面。在实践过程中,具体考虑了分支模型的定义、角色权限的分配、文件目录权限以及研发流程的权限控制四个方面。 分支模型的定义 分支模型的定义即不同业务域在大仓下文件目录的定义,清晰的目录结构和文件命名规范是非常重要的,研发可以很快速的检索到所需的文件。前端大仓的分支模型定义如下: Apps:各业务域的目录结 _Share:业务域下通用依赖目录 Abroad-Crm-Micro:具体应用名 ...:后续新增的应用都在业务域目录下 Components:业务域下通用组件目录(初始化固定目录) ...:可以自定义扩展目录 Global:国际业务域应用目录 ...:后续新增的业务域目录都在 App 目录下 Packages:前端平台通用组件、工具函数、配置文件、Hooks 依赖 Components:平台通用组件目录(初始化固定目录) Hooks:平台通用 Hooks 目录(初始化固定目录) ...:可以自定义扩展目录 通过使用语义化的文件和目录命名,减少了混淆和错误,使得分支模型的定义更加的清晰,研发成员也可以很清楚的知道自己所关注的业务应用在哪个目录下,同时如果需要看其他业务域的代码,也很容易检索到。 上面只是大仓 B 端应用的分支模型定义,目前融合了 C 端 H5 应用以及 Node 服务应用之后,大仓目录的划分会相对比较复杂的多,这里不再具体赘述。 角色权限的分配 在大仓模式下,角色权限没有另辟蹊径,还是沿用 Gitlab 已有的权限配置:Owner、Maintainer 和 Developer。 Owner:即代码仓库的所有者,所有者是拥有最高权限的角色,可以对项目进行完全控制。他们可以添加和删除项目成员,修改项目设置,包括访问级别、分支保护规则和集成设置等。只有项目的所有者才能转让或删除项目;权限配置角色为 TL。 Maintainer:即代码仓库的维护者,可以管理项目的代码、问题、合并请求等。可以创建和管理分支,添加和删除文件,创建和关闭问题,合并和推送分支等。维护者不能更改项目的访问级别或添加新的维护者;权限配置角色为 TL/PM。 Developer:即代码仓库的开发者,是项目的一般成员,具有对代码进行修改和提交的权限。他们可以创建和分配问题、合并请求,查看代码、提交变更以及推送和拉取分支等。权限配置角色为研发人员。 这里需要考虑的是只要开发者具备 Developer 权限,那么他就可以修改大仓任何目录下的代码,并且本地可以提交,这样会导致本地源码依赖出现很大的风险:会出现本地代码构建和生产环境构建不一致的情况,在研发流程意识不强的情况下很容易引发线上问题。本着对代码共享的原则,对于代码文件读权限不做控制,也允许研发修改代码,但是对修改的代码的发布会做流程上的强管控。这里就会涉及到 Gitlab 的分支保护机制以及文件 Owner 权限配置。 文件目录权限配置 在 GitLab 未支持文件目录权限设置之前,对于文件目录权限的控制主要依赖 Git 的钩子函数,在代码提交的时候,对暂存区的变更文件进行识别并做文件权限校验,流程设计也不怎么复杂,只需要额外再开发文件目录和研发的权限映射配置平台即可。在 GitLab 开始支持文件目录权限设置,可以用于更细粒度的文件级别的权限控制,内部就支持文件目录和研发的权限映射关系,其配置页面如下: 当有对应的文件或者目录路径下的文件变更的时候,在 CodeReview 过程中必须由对应的 Owner 成员确认无误之后,才可以 MR 代码。比如: .husky/ 表示 .husky 目录下的文件变更,必须由具体的文件 Owner评审通过才可以 MR; Apps/XXX/crm/ 表示 Apps/XXX/crm 目录下的文件变更,必须由对应的文件 Owner其中之一审批通过才可以 MR。 通过 GitLab 提供的文件目录权限配置,即使研发可以修改任意目录下的文件代码,但是最终在 CodeReview 的流程中,需要对应的文件 Owner 进行确认评审,这样就避免了研发在不注意的情况下,提交了原本不该变更的文件的代码,同时也避免了线上问题的发生。 研发流程的权限控制 前面提到的分支模型的定义、角色权限的分配以及文件目录权限的配置都是需要约定俗成的,但是在真实的研发过程中,需要考虑的场景会复杂的多。比如研发可以绕开 MR 的流程,直接本地合并代码到发布分支。对于这类场景,对大仓下的分支做了规范约束以及 MR&CodeReview 流程中的强管控。 保护分支 在大仓研发模式下,主要有四类分支,其命名规范如下: Dev 分支命名规范:feature-[应用标识]-版本号-自定义 测试分支命名规范:test-[应用标识]-版本号 发布分支命名规范:release-[应用标识]-版本号 热修复分支命名规范:hotfix-[应用标识]-版本号 其中 Feature 分支为开发分支,由 Developer 创建和维护;Release 和 Hotfix 分支为保护分支,Developer 和 Maintainer 都可以创建,但是 Developer 角色没有权限直接将 Feature 分支合入 Release 或者 Hotfix 分支,只能由 Maintainer 角色来维护。基于目前不同业务域会经常创建 test 分支用于不同测试环境的部署,这里 test 分支并未设置为保护分支。当然 Matser 分支也是保护分支,只有 Owner 角色才有权限直接将分支代码合并到主干分支。 通过对不同类型的分支的定义,基于 GitLab 提供的保护分支能力,避免了研发本地合并代码的情况,使得 Feature 分支的代码必须走研发流程的 MR&CodeReview 流程,才能最终合入代码。 钩子函数 通过保护分支的约束,避免了本地直接合发布分支带来的风险,但是在本地代码提交的过程中,如果不做权限的校验,就会在 CodeReview 流程中出现文件 Owner 权限不足的情况,为了在代码提交阶段就能识别到非变更文件的提交,这里基于 Git 的钩子函数,做了权限校验,其流程如下: 通过 Git Hooks 提供的 Pre-Commit 和 Pre-Push 两个节点做权限校验,防止出错。Pre-Commit 不是必须的,如果影响代码提交的效率,可以跳过这个步骤,Pre-Push 是必须的,不允许非 Owner 做本地发布。 当然这里也会带来一个问题:当迭代的 Release 分支落后于 Master 分支,此时基于 Master 分支创建的 Feature 分支就会和 Release 分支代码不一致,导致出现很多非必要的变更文件,此时研发会很疑惑为什么会出现没有修改过的变更文件。这个问题在大仓研发模式下是无法避免的,通过分析之后,在本地提交阶段,过滤了 Apps 目录的校验,只保留了大仓顶层部分核心文件的权限校验,因为大部分的变更都在业务域下的应用里面,顶层的文件很少会去修改。 MR&CodeReview 通过保护分支的约束以及钩子函数对部分核心文件的校验,减少了很多在 MR&CodeReview 中本该遇到的问题。基于文件 Owner 权限的 MR 和 CodeReview 流程:Commit 阶段 -> Push 阶段 -> 创建 MR -> CodeReview -> 执行 MR,每个阶段的流程如下: Commit 阶段通过对核心文件的 Owner 校验,避免核心文件被乱改的情况; CodeReview 阶段通过文件 Owner 权限的校验,确保非本身业务域被修改之后被其他业务域的 Owner 知悉。 这里会带来一个问题:当 Release 分支回合 Master 代码的时候,会创建临时 MR,这个过程也会有文件 Owner 权限的校验(比如客服同学同步代码的时候,也会将商家和供应链的代码一起同步过来),就需要其他业务域的文件 Owner CR 通过才行,但 Master 的代码实际已经是 CR 过的,没有必要重复 CR,并且同步频繁的时候,会经常 CR 确认,导致回合代码的效率非常低。这里给效率技术那边提了需求,在 Release 分支回合 Master 代码的时候,不做文件 Owner 的校验。 通过上面对研发流程中的权限控制,避免了出现本地代码构建和生产环境构建不一致的情况,确保了提交代码的质量和稳定性。 四、扩展思路 通过以上的设计实现,基本上大仓下的权限设计能满足现有的研发模式了。为了弥补文件读权限控制的缺陷,过程中,也考虑了访问控制列表以及文件访问日志的实现,但是最终觉得不是很有必要,就没有在大仓里面应用起来。这里可以分享下访问控制列表以及文件访问日志实现的几种思路。 访问控制列表 访问控制列表即大仓下对文件目录的访问控制,以便更精确地控制对敏感信息或关键代码的访问。之前有提到 Google 和 Meta 都是通过自研的文件系统实现,但是如果不是自研,是不是就一定实现不了了呢,其实未必见得。 VSCode设置文件隐藏 通过在大仓目录下的 .vscode/settings.json 文件配置 files.exclude 属性可以实现文件的显隐,如下: { "files.exclude": { "**/scripts": true } } 上面的配置表示大仓目录下的 scripts 目录是不可见的。 存在的问题: 如果懂 .vscode/settings.json 配置的研发,可以直接本地将 True 改为 False,这里配置就失效了。还有并不是所有研发都是用的 VSCode IDE,还有不少研发用其他的 IDE,每个人的研发习惯不一样,很难做到强约束。 MAC下隐藏文件 MAC 下可以通过 shell 命令设置文件的显隐,如下: chflags hidden **/scripts 上面的 shell 命令表示隐藏大仓下的 scripts 目录。结合大仓研发模式下提供的代码按需拉取能力,可以在代码拉取的最后环节执行如上的命令,就可以隐藏对应的文件。 存在的问题:如果懂 MAC 下文件显隐的设置,可以在 shell 终端上执行 chflags nohidden **/scripts ,这样 scripts 就会变为可见了,达不到最终的效果。 对于访问权限列表的控制,实际上是可以通过一些其他的方式实现,但其实现思路基本都是治根不治本,起不了多大的作用,所以最后都没有在大仓的研发流程里面体现。 文件访问日志 文件访问日志即当研发打开文件的时候,发送一条日志到服务端并保存下来,这样可以对包含敏感信息的配置文件进行监听, 设置审计日志和监控,以便跟踪谁做了什么操作,并在出现异常情况时能够快速识别和应对问题。通过 VSCode 插件是可以实现的,VSCode 启动之后,提供了对应文件目录路径的打开事件 onDidOpenTextDocument,当研发打开任何文件的时候,都可以触发监听事件,那么我们就能在监听事件里面去做日志发送相关的逻辑,实现文件访问日志记录的功能,大致的实现如下: export function monitorPermissionOfTargetFile(targetFilePath: string, repoRootPath: string) { const targetFileFullPath = repoRootPath + targetFilePath; // 打开项目目录下任意文件的回调函数 vscode.workspace.onDidOpenTextDocument(textDocument => { // 获取被打开的文件路径 const filePath = textDocument.uri.fsPath; if (filePath === targetFileFullPath) { // 添加日志发送逻辑 } }); } 存在的问题:该功能强依赖 VSCode IDE,只有在 VSCode 里面才能实现,并非所有的研发都在用 VSCode,并且实时监听文件的点击事件也会带来一定的系统开销成本。现在本来打开多个 VSCode IDE,电脑运行就比较慢了,再加上该功能,性能损耗估计会更多。 上面只是提供了大仓权限实践过程中未落地的两个扩展思路,如果还有其他更好的思路能实现文件的读权限控制,欢迎随时沟通交流。 五、总结 前端 monorepo 大仓的权限设计在实现的过程中,遇到了很多的问题,有些时候想的很好,但是实际在研发流程中会因不同的业务域场景存在不一样的问题。比如基于 Master 新建 Feature 分支还是基于 Release 新建 Feature 分支这个问题就尤其突出,起初基于 Master 新建的 Feature 分支,带来的问题是研发在合 Release 分支的时候,有很多非变更文件,导致 CR 都不清楚具体要看哪些文件;然后改成基于 Release 新建的 Feature 分支,带来的问题是会遗漏部分已发版的 Release 分支代码;最后综合考虑还是基于 Master 新建的 Feature 分支。大仓的权限设计也离不开参与研发流程改造的小伙伴以及效能技术的小伙伴,过程中为了适配大仓的权限,做了很多研发流程的改造以及 GitLab 能力的扩展,希望本文能给读者带来一定的帮助。 *文/Bill 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | DDD 落地实践 - 架构师眼中的餐厅

本文以餐厅场景为叙事主线,以领域驱动为核心思想,结合架构设计与功能设计方法论。是从领域分析到落地的全过程案例,内容偏重于落地,因此不乏一些探讨,欢迎指正。 文章较长、全程干货、耐心读完、必有收获。 本文不针对餐厅的实现细节,重在探讨设计思想和方法。 1、领域设计 让我们抛开技术人员的本能技术视角、站在纯业务视角来分析领域问题。 领域设计的核心是分而治之,目的是实现业务领域的自治性。 就像你平时不会将枕头和被子放在厨房或卫生间一样,你的床上不会放着大米白面,否则你想睡觉是一件很复杂的事情,软件系统也是如此,这就是我们要解决的问题。 1.1 宏观流程 假如我要设计一个餐厅,由于分而治之的需要,我会首先从宏观流程去分析,可以帮我们迅速找到重要的区域。  因此会得到几个明确的行为区域,我将餐厅划分为“菜品域”,“订单域”,“厨房域”,“用餐域”,这是业务级别的领域划分,后续应该针对每个区域单独分析。 产出物是:宏观流程和参与角色 1.2 统一语言 语言贯穿于整个开发过程,从需求分析到设计、从设计到编码,因此好的语言非常重要,好的语言体现了清晰的业务概念。 在这个阶段,我们需要通过梳理,找到业务中都有哪些实体与行为,对其做一些归纳。我们的核心问题是:“谁”通过什么“行为”影响了“谁”,其中的三个要素分别是:角色、行为、实体。我的建议是先找到 “角色”、“实体”、“行为”,并对其归类,我常常关注角色以及具体身份、实体以及实体实例,功能以及包含的重要步骤。 角色:是施事主语、是名词,是主动发起行为的一类实体。 行为:是动词、是做了什么事情,是行为本身。 实体:是名词,是除“角色”之外的其他实体。 推荐使用脑图画出来,我认为归纳后的脑图有助于我们识别根本要素,有利于抽象。 产出物是:名词、概念定义、相关脑图。  1.3 用例分析 在这一步、我们使用相对宏观的分析,不需要进入用例的细节分析,掌握角色与行为之间的关系,理清谁在做什么,角色的职责差异是什么。 产出物:用例图 以做菜为例,如图 1.4 领域划分 我们在分析宏观流程时,划分了几个行为区域,但那是业务级别的。在那基础之上,我们需要拉进某个区域的视角,再结合之前的用例分析,按照“功能相关性”、“角色相关性”进一步划分领域。 功能相关性:是用例与领域之间的关系,任何业务的领域都是由一套用例组成的,所以领域划分以功能相关性为主,例如与做菜相关的用例都应该归属于厨房,所以我们确认了厨房域,确认了厨房域包含的用例,这是很自然的事。 角色相关性:其次是角色,常用于划分子域,某个区域涉及多个角色参与,可以按照角色的分工,拆分为多个子域,从而满足不同角色的个性化需要。例如厨房的采购人员负责买菜、刀工负责切菜、大厨负责烹饪。我们就会考虑将厨房划分为“采购域”、“加工域”、“烹饪域”。 通常来说,子域不具备独立的问题空间,不会作为独立的领域存在。 产出物:领域、子域 以厨房域为例,如图  1.5 领域建模 这是大家比较熟知的阶段,重点分析实体与领域之间关系(领域聚合),实体与实体的关系(OO聚合)。 领域模型是实现功能的基石、需要有对功能的本质理解,才能找到最核心的实体,实体之间的OO聚合关系决定了功能的扩展性,OO聚合是最重要的核心点。  组合、聚合 聚合(aggregation):聚合关系是一种弱的关系,整体和部分可以相互独立。 组合(composition):组合关系是一种强的整体和部分的关系,整体和部分具有相同的生命周期。 可以使用如下案例,既能表达领域聚合,又能表达OO聚合的关系。   产出物:聚合、实体、值对象、实体的属性 (领域服务和事件在后续的功能设计中提供) 1.6 领域上下游 领域上下游关系,不是领域的依赖关系,依赖关系指的是能力的依赖,是共用了某些能力,依赖关系是固定的。领域上下游关系,也不是调用关系,调用关系是与用例相关的,并非描述领域处境的。 领域上下游关系指的是影响力的关系,上游影响下游,影响力分为“逻辑影响”和“数据影响”,一般说来我们更应该关注“数据影响”,所以领域上下游关系是一种数据流向的限定,是业务发生的顺序限定,用于规定该领域所使用的数据,是下游领域依赖上游领域“准备就绪”的体现。合理的上下游限定,有助于减少领域之间的不必要依赖,有利于数据的复用并减少重复计算。 领域上下游是与场景相关的,并不是一成不变的,不同的场景存在不同的上下游,各场景应该独立说明。 产出物:各场景的上下游说明 例:在【菜品管理】场景下 如果厨房的某些食材不足了,或者某个厨师休假了,就会影响到菜品的展示,从而影响到客户的订单。 例:在【客户消费】场景下  客户的订单、影响厨房生产的菜,从而影响刀工的行为,也影响到了采购。 请对比下面两个图,用于理解领域的上下游  实际上,厨师不应该依赖采购人员的采购功能,也不依赖刀工的切菜功能,他只是依赖“初加工食材”而已,而“初加工食材”就是被处理好的数据,厨师在做饭时,“初加工食材”就已经被处理好了,上面的图例只是为了说明一个关于领域上下游的问题,这是业务发生顺序以及数据来源的问题。 我们常常使用领域事件串联业务流程,在使用领域事件时,不止要关注点对点的解耦,更应该使业务流程符合领域上下游限定,让各个领域独立运行,减少领域之间的功能依赖,降低领域之间的耦合,减少业务变化带来的影响。 2、架构设计 架构设计是为了解决软件系统复杂度带来的问题,找到系统中的元素并搞清楚他们之间关系。 架构的目标是用于管理复杂性、易变性和不确定性,以确保在长期的系统演化过程中,一部分架构的变化不会对其它部分产生不必要的负面影响。这样做可以确保业务和研发效率的敏捷,让应用的易变部分能够频繁地变化,对应用的其它部分的影响尽可能地小。 架构设计三原则:合适原则、简单原则、演化原则 2.1 分层架构 我们需要按照 接口层、领域层(领域用例层、领域模型层)、依赖层、基础层 构建架构模型。 接口层:为外部提供服务的入口,是适配层的北向网关。不实现任何业务逻辑,也不处理事务,是跨领域的,是流程编排层,是门面服务。 领域用例层:是领域服务层,是领域用例的实现层、隶属于某个领域、是业务逻辑层,是事务层,业务逻辑应该在这层完整体现,不要分散到其他层级。 领域模型层:是领域模型(实体、值对象、聚合)的所在位置,专注于领域模型自身的能力,不包含业务功能,可以处理事务,是原子化的能力,是领域对象的自我实现。 依赖层:是连接外部服务的出口,是适配层的南向网关。包括仓储,端点、RPC等,主要作用是领域和外部解耦,用于保持领域的独立性,是跨领域的。 基础层:与业务无关的,与领域无关的,通用的技术能力,技术组件等。 2.2 架构映射 架构的视角,从大到小依次是:系统->应用(微服务)->模块(包)->子模块 这样的从大到小的层级。 业务领域映射:我们将划分好的领域,按照对应的视角映射为对应的元素,领域模型映射到架构模型时,应该是视角对等的,如果餐厅是系统、那么厨房就是应用,如果餐厅是应用、那么厨房就是模块。也应该层级匹配的,将用例的实现映射到用例层,将领域模型的实现映射到领域模型层。 技术和抽象问题:有时候、业务领域分析不能体现那些共性的技术问题,所以需要适当结合技术视角,可能需要对领域模型微调。同时、我们需要找到共同需要的基础能力,例如“水”、“电”、“煤气”等等,将这些作为额外的考虑因素,要做到业务问题与技术问题解耦,不要将技术问题和业务逻辑揉成一团。 领域设计,类似餐厅设计师,他设计餐厅有几个区域,区域的用途是什么。 架构设计,类似建筑设计师,他设计如何走水电煤气、如何施工等。 产出物:分层架构图 以厨房为视角,其架构如下  以餐厅为视角,其架构如下  分层架构图,体现逻辑上的层级分布,而不是代表组件的具体含义,组件是应用还是模块、需要结合实际情况而定。 2.3 必要的约束 1、分层架构越往下层就越是稳定的:下层是被上层依赖的,下层不可以反向依赖上层(扩展点除外)。因为分层架构的核心原则是将容易变化的逻辑上浮,将共性的、原子化的、通用的逻辑下沉,被依赖的下层应该是稳定的,这要求上层承接更多业务变化。下层离开上层应该是可以独立存在的,例如在接口层定义的DTO不可以在下层被使用,但领域层定义的实体可以被上层使用。 2、在使用充血模型时,应该符合面向对象编程原则:不要随意的将一些能力都充到领域实体模型中。以“菜”为例,重量和规格是“菜”的自身的属性,激发味蕾是“菜”的能力,“菜”可以维护自身的持久化状态。但是、请注意、“菜”不可以“炒菜”,因为“炒菜”的时候,“菜”还没有出现呢,“菜”不是自己的上帝,“菜”需要被做出来,所以“菜”被做出来之前是没有“菜”的,这是个时间上的概念,不要错把“炒菜”的能力放在“菜”的身上。“炒菜”用到的“水+电+气+食材+调料+厨具”不应该是“菜”的属性范围,这些元素都在“厨房”的范围中,不要让领域的模型包含不属于自身的元素,领域的实体模型只是领域的一部分,只用于实现通用的模型能力。 3、接口层和依赖层是与领域无关的:他们是与技术相关的层级,不属于任何领域,这两层不能包含业务逻辑。有时候我们可以把接口层拆为两层(接口层+应用层),也可以把依赖层拆分为两个(模型依赖、服务依赖)。 4、领域层是与环境无关的:无论某个领域是应用还是模块,都应该具备独立的用例层和独立的模型层,即使多个领域在同一个应用当中,也要按照他们是分别独立去看待,无论某个领域是应用还是模块,领域对外部的交互,不可以绕过依赖层和接口层。 5、领域应该是最小完备的:把一个领域拆分为子域、子子域、子子子...... 无限拆分,拆分到一定程度之后,某个子域就不完整了,不完整的子域是不可以独立存在的。拆分不不够或者过度拆分,都是不符合低耦合高内聚原则的。当一个领域的内部子域不具备独立性时,他们之间不必严格解耦,不需要通过依赖层访问本领域的其他子域,他们之间可以直接调用。 6、领域服务层就是领域用例层:他们俩是同一回事儿,都是用于实现领域内的用例的。不要将领域服务与领域用例视为两个独立的层,也不要将领域服务与领域模型视为同一层,否则会导致逻辑的分散(一部分在领域服务层、一部分在领域模型层、还有一部分可能在用例层),也会导致每个层的职责不明确,容易搞乱。如果将业务逻辑写在领域模型中,会导致业务逻辑进一步下沉,业务逻辑的不确定性太大,是不适合下沉的,是违反分层架构原则的。领域模型对应的是实体、领域服务对应的是用例。 7、领域用例层只能承接符合自身领域的用例:我们划分出领域的目的,就是为了区分每个领域的职责所在,因此他们必须严格按照职责办事,我们在之前已明确了用例和领域之间的关系,需要严格遵守。 8、领域模型层遵循最小依赖原则:只可以依赖必要的资源,必要资源指的是领域模型实现自身能力需要的资源,不包括实现业务逻辑包含的资源。例如领域模型需要依赖DB完成持久化,可以依赖数据访问资源,但不应该依赖其他领域资源、不可以依赖RPC资源等。 2.4 微服务划分 服务划分以领域划分为参考,主要看我们要拆分到什么粒度,这 应该符合低耦合高内聚原则,不破坏领域实体的聚合关系。 产出物:微服务 例如餐厅:是有必要拆分的,餐厅的“菜品域”,“订单域”,“厨房域”有独立的问题空间。 例如厨房:是没有必要拆分的,厨师与刀工的耦合非常高,他们都在做饭,分开之后是不完整的,分开就是没有必要的。 所以餐厅被拆分为:厨房(Kitchen)、菜品(Category)、订单(Order)三个微服务。 基于此、我们单独拿出餐厅门面服务作为接口层应用,再单独拿出餐厅基础服务作为水电煤气的应用。 一般情况下,依赖层不会作为单独的服务提供,会被以组件的形式嵌入到其他服务中。 3、功能设计(用例实现) 如果说领域设计是餐厅的设计师、架构设计是餐厅的建筑师、那么功能设计就是餐厅的厨师或服务员。 任何设计都要落地到功能设计,如果厨师不守规则,偏偏要去洗手间洗菜,最后的结果依然是一团乱,最终会导致设计无法落地。 功能设计是实现 “面向扩展开放、面向修改关闭” 的途径,是指导研发落地必备环节。 3.1 功能的概念 功能迭代时,功能会发生一些变化,所以他的含义是可能变化的,所以我们需要再次审视功能的概念,及时加以调整。 例如、我们实现了一个“做蛋炒饭”的功能,后来又实现了一个“做辣椒炒蛋”的功能,那么我们应该将功能升级为“炒菜”,甚至是“制作菜品”等。 明确功能的概念,是功能设计的前提。 产出物:更新语言库,更新脑图 3.2 用例的位置 我们在领域分析章节,已明确了用例与角色的关系,用例与领域的关系。 然而一个新功能的加入,我们仍然要再次评估,以确保他处于正确的位置。 产出物:更新用例图 3.3 事件风暴 我们需要深入功能的细节,首推的方法是事件风暴,适用于解构复杂功能。 事件风暴的作用并不限于功能分析,只是我觉得很适用于功能分析,事件风暴的一张图包含很多内容,正好是功能设计所需要的。 将功能拆分为多个子功能(步骤)。(在后续使用) 确认参与该步骤的角色和领域。(在后续的3.6章节落地) 确认步骤的串联流程和领域事件。(在后续的3.6章节落地) 确认参与该步骤的领域实体。(在后续的3.7章节落地) 产出物:事件风暴模型 3.4 用例分析 我们暂且收回思路,首先要关注共性和差异问题,以确保功能的扩展性。 确认用例的泛化+差异点,实现功能的扩展。 寻找共同包含的步骤,实现逻辑的复用。 产出物:用例分析图 例:制作菜品(做大拌菜、做铁锅炖、做炒鸡蛋、做蒸米饭、做炒米饭) 3.5 用例实现类(领域服务类)结构图 专注于用例层的类设计,实现“面相修改关闭,面相扩展开放”。 用例的类结构图是用例分析图的一种映射。 出物:用例层的类结构图  3.6 用例流程图 我们接回思路,更进一步,将事件风暴模型落实到代码层面。 我们将步骤分配到实现类中、步骤就是该类的一个方法,进一步明确由哪个类和方法来实现该步骤,从而就规定了步骤所在的领域。 我们将步骤和领域事件串联起来,规定了业务实现流程。推荐使用泳道图表达上述内容。泳道的纵向组件是用例的实现类。 这是真实业务流程的映射。 产出物:用例流程图 以炒鸡蛋为例,其用例流程图如下  3.7 活动图(时序图) 我们进一步将事件风暴模型落实到代码层面,我们使用时序图,体现依赖和调用关系,规定了步骤与领域实体模型的关系,进一步说明用例是如何实现的。 这时候,为了简便、我们可以收起领域服务类(用例层)的泳道。 产出物:时序图、活动图  试想一下、假如把业务逻辑放在领域模型当中(例如聚合),如何实现“面相扩展开放、面相修改关闭”呢? 4、编码实现 编码实现...... 我决定还是...... 偷个懒吧...... 哈哈哈。 但是我们回顾一下之前的内容,是否足够了?不同的研发人员依照设计去编码,是否会写出不一样的代码? 最后、我们的目标是“解决软件复杂度带来的问题”,而实现这个目标的途径是“设计指导研发落地”。 本文分享自微信公众号 - 京东云开发者(JDT_Developers)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 前端 JS 安全对抗原理与实践

作者:vivo 互联网安全团队- Luo Bingsong 前端代码都是公开的,为了提高代码的破解成本、保证JS代码里的一些重要逻辑不被居心叵测的人利用,需要使用一些加密和混淆的防护手段。 一、概念解析 1.1 什么是接口加密 如今这个时代,数据已经变得越来越重要,网页和APP是主流的数据载体,如果获取数据的接口没有设置任何的保护措施的话,数据就会被轻易地窃取或篡改。 除了数据泄露外,一些重要功能的接口如果没有做好保护措施也会被恶意调用造成DDoS、条件竞争等攻击效果,比如如下几个场景: 一些营销活动类的Web页面,领红包、领券、投票、抽奖等活动方式很常见。此类活动对于普通用户来说应该是“拼手气”,而对于非正常用户来说,可以通过直接刷活动API接口的这种“作弊”方式来提升“手气”。这样对普通用户来说就很不公平。 所以对重要接口都会采用加密验签的方式进行保护,而验签的加密逻辑大多数都通过JS代码实现,所以保护JS代码不被攻击者窃取尤为重要。 1.2 为什么要保护JS代码 JavaScript代码运行于客户端 JavaScript代码是公开透明的 由于这两个原因,致使JavaScript代码是不安全的,任何人都可以读、分析、复制、盗用甚至篡改。 1.3 应用场景 以下场景就通过特定的防护措施提高了攻击成本: 某些网站会在页面中使用JavaScript对数据进行加密,以保护数据的安全性和隐私性,在爬取时需要通过解密JavaScript代码才能获取到数据。 某些网站的URL会有某个参数带有一些看不太懂的长串加密参数,攻击者要爬取的话就必须要知道这些参数是怎么构造的,否则无法正确地访问该URL。 翻看网站的JavaScript源代码,可以发现很多压缩了或者看不太懂的字符,比如JavaScript文件名被编码,JavaScript的文件内容都压缩成几行,JavaScript变量也被修改成单个字符或者一些十六进制的字符,所以我们不能轻易地根据JavaScript找出某些接口的加密逻辑。 1.4 涉及的技术 这些场景都是网站为了保护数据不被轻易抓取采取的措施,运用的技术主要有: 接口加密技术 JavaScript压缩、混淆和加密技术 二、技术原理 2.1 接口加密技术 数据和功能一般是通过服务器提供的接口来实现,为了提升接口的安全性,客户端会和服务端约定一种接口检验方式,通常是各种加密和编码算法,如Base64、Hex、MD5、AES、DES、RSA等。 常用的数据接口都会携带一个sign参数用于权限管控: ① 客户端和服务端约定一种接口校验逻辑,客户端在每次请求服务端接口的时候附带一个sign参数。 ② sign参数的逻辑自定义,可以由当前时间戳信息、设备ID、日期、双方约定好的秘钥经过一些加密算法构造而成。 ③ 客户端根据约定的加密算法构造sign,每次请求服务器的时候附带上sign数。 ④ 服务端根据约定的加密算法和请求的数据对sign进行校验,如果检验通过,才返回数据,否则拒绝响应。 这就是一个比较简单的接口参数加密的实现,如果有人想要调用这个接口的话,必须要破解sign的生成逻辑,否则是无法正常调用接口的。 当然上面的实现思路比较简单,还可以增加一些时间戳信息和访问频次来增加时效性判断,或使用非对称加密提高加密的复杂程度。 实现接口参数加密需要用到一些加密算法,客户端和服务器都有对应的SDK来实现这些加密算法,如JavaScript的crypto-js、Python的hashlib、Crypto等等。如果是网页且客户端的加密逻辑是用JavaScript来实现的话,其源代码对用户是完全可见的,所以我们需要用压缩、混淆、加密的方式来对JavaScript代码进行一定程度的保护。 2.2 什么是压缩 去除JavaScript代码中不必要的空格、换行等内容,使源码都压缩为几行内容,降低代码可读性,同时可提高网站的加载速度。 如果仅仅是去除空格换行这样的压缩方式,几乎没有任何防护作用,这种压缩方式仅仅是降低了代码的直接可读性,可以用IDE、在线工具或Chrome轻松将JavaScript代码变得易读。 所以JavaScript压缩技术只能在很小的程度上起到防护作用,想提高防护的效果还得依靠JavaScript混淆和加密技术。 2.3 什么是混淆 使用变量混淆、字符串混淆、属性加密、控制流平坦化、调试保护、多态变异等手段,使代码变得难以阅读和分析,同时不影响代码原有功能,是一种理想且实用的JS保护方案。 变量混淆:将变量名、方法名、常量名随机变为无意义的乱码字符串,降低代码可读性,如转成单个字符或十六进制字符串。 字符串混淆:将字符串阵列化集中放置,并进行MD5或Base64编码存储,使代码中不出现明文字符串,可以避免使用全局搜索字符串的方式定位到入口点。 属性加密:针对JavaScript对象的属性进行加密转化,隐藏代码之间的调用关系,把key-value的映射关系混淆掉。 控制流平坦化:打乱函数原有代码执行流程及函数调用关系,使代码逻辑变得混乱无序。 调试保护:基于调试器特性,加入一些强制调试debug语句,无限debug、定时debug、debug关键字,使其在调试模式下难以顺利执行JavaScript代码。 多态变异:JavaScript代码每次被调用时,代码自身立刻自动发生变异,变化为与之前完全不同的代码,避免代码被动态分析调试。 2.4 什么是加密 JavaScript加密是对JavaScript混淆技术防护的进一步升级,基本思路是将一些核心逻辑用C/C++语言来编写,并通过JavaScript调用执行,从而起到二进制级别的防护作用,加密的方式主要有Emscripten和WebAssembly等。 1. Emscripten Emscripten编译器可以将C/C++代码编译成asm.js的JavaScript变体,再由JavaScript调用执行,因此某些JavaScript的核心功能可以使用C/C++语言实现。 2.WebAssembly WebAssembly也能将C/C++代码转成JavaScript引擎可以运行的代码,但转出来的代码是二进制字节码,而asm.js是文本,因此运行速度更快、体积更小,得到的字节码具有和JavaScript相同的功能,在语法上完全脱离JavaScript,同时具有沙盒化的执行环境,利用WebAssembly技术,可以将一些核心的功能用C/C++语言实现,形成浏览器字节码的形式,然后在JavaScript中通过类似如下的方式调用: 这种加密方式更加安全,想要逆向或破解需要逆向WebAssembly,难度极大。 2.5 工具介绍 2.5.1 压缩混淆工具 Uglifyjs(开源): 用NodeJS编写的JavaScript压缩工具,是目前最流行的JS压缩工具,JQuery就是使用此工具压缩,UglifyJS压缩率高,压缩选项多,并且具有优化代码,格式化代码功能。 jshaman: jshaman是一个商业级工具,看了很多社区的评论,这个目前是最好的,可以在线免费使用,也可以购买商业版。 jsfuck: 开源的js混淆工具,原理比较简单,通过特定的字符串加上下标定位字符,再由这些字符替换源代码,从而实现混淆。 YUI Compressor: 业界巨头yahoo提供的一个前端压缩工具,通过java库编译css或js文件进行压缩 2.5.2 反混淆工具 jsbeautifier: jsbeautifier是一个为前端开发人员制作的Chrome扩展,能够直接查看经过压缩的Javascript代码。 UnuglifyJS: 压缩工具uglify对应的解混淆工具。 jspacker: 用PHP编写的压缩工具,可以混淆代码保护知识产权,产生的代码兼容IE、FireFox等常用浏览器,国内大部分在线工具网站都采用这种算法压缩。 三、前端安全对抗 3.1 前端调试手法 3.1.1 Elements Elements 面板会显示目前网页中的 DOM、CSS 状态,且可以修改页面上的 DOM 和 CSS,即时看到结果,省去了在编辑器修改、储存、浏览器查看结果的流程。 有时候一些dom节点会嵌套很深,导致我们很难利用Element面板html代码来找到对应的节点。inspect(dom元素)可以让我们快速跳转到对应的dom节点的html代码上。 3.1.2 Console Console对象提供了浏览器控制台调试的接口,Console是一个对象,上面有很多方便的方法。 console.log( ):最常用的语句,可以将变量输出到浏览器的控制台中,方便开发者调用JS代码 console.table( ):可用于打印obj/arr成表格 console.trace( ):可用于debugger堆栈调试,方便查看代码的执行逻辑,看一些库的源码 console.count( ):打印标签被执行了几次,预设值是default,可用在快速计数 console.countReset( ):用来重置,可用在计算单次行为的触发的计数 console.group( )/console.groupEnd( ): 为了方便一眼看到自己的log,可以用console.group自定义message group标签,还可以多层嵌套,并用console.groupEnd来关闭Group。 3.1.3 JS断点调试 JS断点调试,即在浏览器开发者工具中为JS代码添加断点,让JS执行到某一特定位置停住,方便开发者对该处代码段进行分析与逻辑处理。 Sources面板 ① 普通断点(breakpoint) 给一段代码添加断点的流程是:"F12(Ctrl + Shift + I)打开开发工具"->"点击Sources菜单"->"左侧树中找到相应文件"→"点击行号列"即完成在当前行添加/删除断点操作。当断点添加完毕后,刷新页面JS执行到断点位置停住,在Sources界面会看到当前作用域中所有变量和值。 恢复(Resume):恢复按钮(第一个按钮),继续执行,快捷键 F8,继续执行,如果没有其他的断点,那么程序就会继续执行,并且调试器不会再控制程序。 跨步(Step over):运行下一条指令,但不会进入到一个函数中,快捷键 F10。 步入(Step into):快捷键 F11,和“下一步(Step)”类似,但在异步函数调用情况下表现不同,步入会进入到代码中并等待异步函数执行。 步出(Step out):继续执行到当前函数的末尾,快捷键 Shift+F11,继续执行代码并停止在当前函数的最后一行,当我们使用偶然地进入到一个嵌套调用,但是我们又对这个函数不感兴趣时,我们想要尽可能的继续执行到最后的时候是非常方便的。 下一步(Step):运行下一条语句,快捷键 F9,一次接一次地点击此按钮,整个脚本的所有语句会被逐个执行,下一步命令会忽略异步行为。 启用/禁用所有的断点:这个按钮不会影响程序的执行。只是一个批量操作断点的开/关。 察看(Watch):显示任意表达式的当前值 调用栈(Call Stack):显示嵌套的调用链 作用域(Scope):显示当前的变量 Local:显示当前函数中的变量 Global:显示全局变量 ② 条件断点(Conditional breakpoint) 给断点添加条件,只有符合条件时,才会触发断点,条件断点的颜色是橙色。 ③ 日志断点(logpoint) 当代码执行到这里时,会在控制台输出你的表达式,不会暂停代码执行,日志断点式粉红色。 debugger命令 通过在代码中添加"debugger;"语句,当代码执行到该语句的时候就会自动断点,之后的操作和在Sources面板添加断点调试,唯一的区别在于调试完后需要删除该语句。 在开发中偶尔会遇到异步加载html片段(包含内嵌JS代码)的情况,而这部分JS代码在Sources树中无法找到,因此无法直接在开发工具中直接添加断点,那么如果想给异步加载的脚本添加断点,此时"debugger;"就发挥作用了。 3.2 反调试手段 3.2.1 禁用开发者工具 监听是否打开开发者工具,若打开,则直接调用JavaScript的window.close( )方法关闭网页 ① 监听F12按键、监听Ctrl+Shift+I(Windows系统)组合键、监听右键菜单,监听Ctrl+s禁止保存至本地,避免被Overrides。 <script> //监听F12、Ctrl+Shift+i、Ctrl+s document.onkeydown = function (event) { if (event.key === "F12") { window.close(); window.location = "about:blank"; } else if (event.ctrlKey && event.shiftKey && event.key === "I") {//此处I必须大写 window.close(); window.location = "about:blank"; } else if (event.ctrlKey && event.key === "s") {//此处s必须小写 event.preventDefault(); window.close(); window.location = "about:blank"; } }; //监听右键菜单 document.oncontextmenu = function () { window.close(); window.location = "about:blank"; };</script> ② 监听窗口大小变化 <script> var h = window.innerHeight, w = window.innerWidth; window.onresize = function () { if (h !== window.innerHeight || w !== window.innerWidth) { window.close(); window.location = "about:blank"; } }</script> ③ 利用Console.log <script> //控制台打开的时候回调方法 function consoleOpenCallback(){ window.close(); window.location = "about:blank"; return ""; } //立即运行函数,用来检测控制台是否打开 !function () { // 创建一个对象 let foo = /./; // 将其打印到控制台上,实际上是一个指针 console.log(foo); // 要在第一次打印完之后再重写toString方法 foo.toString = consoleOpenCallback; }()</script> 3.2.2 无限debugger反调试 ① constructor <script> function consoleOpenCallback() { window.close(); window.location = "about:blank"; } setInterval(function () { const before = new Date(); (function(){}).constructor("debugger")(); // debugger; const after = new Date(); const cost = after.getTime() - before.getTime(); if (cost > 100) { consoleOpenCallback(); } }, 1000);</script> ② Function <script> setInterval(function () { const before = new Date(); (function (a) { return (function (a) { return (Function('Function(arguments[0]+"' + a + '")()')) })(a) })('bugger')('de'); // Function('debugger')(); // debugger; const after = new Date(); const cost = after.getTime() - before.getTime(); if (cost > 100) { consoleOpenCallback2(); } }, 1000);</script> 有大佬写了一个库专门用来判断是否打开了开发者工具,可供参考使用:>" linktype="text" imgurl="" tab="outerlink" data-linktype="2">点击查看>> 3.3 反反调试手段 3.3.1 禁用开发者工具 针对判断是否打开开发者工具的破解方式很简单,只需两步就可以搞定。 ① 将开发者工具以独立窗口形式打开 ② 打开开发者工具后再打开网址 3.3.2 无限debugger 针对无限debugger反调试,有以下破解方法 ① 直接使用dubbger指令的,可以在Chrome找到对应行(格式化后),右键行号,选择Never pause here即可。 ② 使用了constructor构造debugger的,只需在console中输入以下代码后,点击F8(Resume script execution)回复js代码执行即可(直接点击小的蓝色放行按钮即可)。 Function.prototype.constructor=function(){} ③ 使用了Function构造debugger的,只需在console中输入以下代码。 Function = function () {} 3.4 总结 JavaScript混淆加密使得代码更难以被反编译和分析,从而提高了代码的安全性,攻击者需要花费更多的时间和精力才能理解和分析代码,从而降低了攻击者入侵的成功率,但它并不能完全保护代码不被反编译和分析,如果攻击者有足够的时间和资源,他们仍然可以理解代码并找到其中的漏洞,道高一尺,魔高一丈,任何客户端加密混淆都会被破解,只要用心都能解决,我们能做的就是拖延被破解的时间,所以尽量避免在前端代码中嵌入敏感信息或业务逻辑。 END 猜你喜欢 Hudi 在 vivo 湖仓一体的落地实践 RocksDB在vivo消息推送系统中的实践 线上ES集群参数配置引起的业务异常案例分析 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 视觉 BEV 基本原理和方案解析

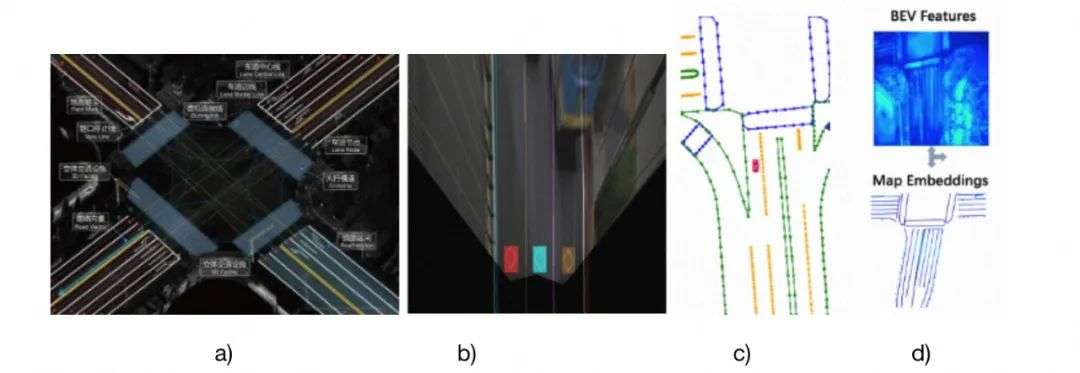
BEV(Bird’s-Eye-View)是一种鸟瞰视图的传感器数据表示方法,它的相关技术在自动驾驶领域已经成了“标配”,纷纷在新能源汽车、芯片设计等行业相继量产落地。BEV同样在高德多个业务场景使用,例如:高精地图地面要素识别、车道线拓扑构建、车端融合定位中都扮演了重要角色。如图1‑1所示: 图1‑1 BEV在高德应用场景(仅列举部分)a)高精底图 b)地面要素识别 c)车道线拓扑构建[1] d)车端融合定位(BEV特征和底图匹配)[2] 本文分享的内容主要包括两个部分:视觉BEV基本原理、方案解析。 1.BEV基础 1.1.引言 如图1‑2所示,BEV具有如下优势: 1) BEV视图尺度变化小。在PV空间(即透视图,类似通常行车记录仪所采集的车辆前视图)中,物体近大远小,物体的大小和类别、远近都有关,而在BEV空间中,物体的大小只和类别有关; 2) BEV空间是决策友好空间。BEV空间更接近3D真实空间的平面空间,而PV空间是真实物理世界在透视投影下的视图,以图1‑2的车道线举例,在真实世界中平行的两条车道线,在BEV空间下还是平行的,在PV空间却是相交的。相比之下,BEV空间下的信息能更方便地被下游规控模块理解和使用。 本章将介绍BEV基础知识。首先介绍BEV的核心**“视角转换模块”的基本原理**,包括2D->3D和3D->2D两种路线,然后介绍BEV使用的魔法“可形变模块”,最后介绍BEV方案中常用的损失函数。 图1‑2 BEV空间和PV空间的图像可视化,a) BEV空间 b) PV空间 1.2.视角转换 如1.1所述,在BEV空间下进行数据处理和操作具有尺度变化小、决策友好的优势,但原始的图像数据是在PV空间下的,如何将PV空间的数据转换到BEV空间或者是3D空间(有3D空间下的数据,将其拍扁就能转到BEV空间)呢?这就是视角转换模块要干的事。 1.2.1. 2D->3D转换模块 2D->3D转换模块基本思想是从2D像素或者特征出发去找3D空间下的对应表示,类似深度估计。下面介绍主流的2D->3D转换方法。 LSS(Lift-Splat-and-Shot)[3]是主流的2D->3D转换方法,如图1‑3所示,Lift指对各相机的图像显式地估计特征点的深度分布,得到包含图像特征的视锥(点云);Splat——结合相机内外参把所有相机的视锥(点云)分配到BEV空间的网格中,对每个格子中的多个视锥点进行pooling计算,形成BEV特征图;Shoot——用task head处理BEV特征图,输出感知结果。最后将C维的特征和D维的深度分布做外积,得到每个深度下的特征,深度概率越大,对应特征响应就越强。 图1‑3 LSS示意,每个特征点生成系列离散深度点,再为深度点生成特征[3] Pseudo-LiDAR是另一种2D->3D转换方法,如图1‑4所示,相比LSS为特征点预测一系列离散深度,Pseudo-LiDAR直接预测深度图,每个像素都有且仅有一个深度。 图1‑4 Pseudo-LiDAR示意,预测深度图,根据原始图像和深度图映射至3D空间[4] 1.2.2. 3D->2D转换模块 3D->2D转换模块基本思想是根据3D点查找对应的2D特征,类似3D空间投影到PV空间。下面介绍主流的3D->2D转换方法。 如图1‑5所示,将3D参考点根据成像原理投影到PV空间获取对应图像特征的方式可以认为是显式映射,这里的参考点可以使用预设的BEV空间的参考点,也可以使用网络生成。 图1‑5 显式映射[5] 相比显式映射,隐式映射不再通过投影映射,而是让网络自己学特征和3D坐标的映射。如图1‑6所示,它先生成视锥空间下的一系列点,再转换到3D空间下,然后将提取的图像特征和3D点传入encoder,encoder处理后输出的就是带有3D坐标信息的特征。 图1‑6 隐式映射[6] 1.3. 可形变模块 要介绍的可形变模块有两种,可形变卷积和可形变注意力,可形变模块的作用更容易通过可形变卷积理解,所以先介绍可形变卷积。 可形变卷积是在卷积的基础上添加offset得到的,如图1‑7最左边的a) 所示,普通卷积通过人工设计的pattern整合pattern内采样点的信息,其pattern设计好后就是固定的,可形变卷积,如图1‑7 b) 所示,可以计算出每个采样点的offset,采样点+offset才是真实的采样点,使得卷积的pattern形式更加灵活,且一定程度上可学习。 图1‑7 可形变卷积示意,a) 普通卷积 b) 可形变卷积[7] 如图1‑8所示,注意力机制需要通过Q (query) 找到K (key),获得K的信息,这个过程也存在可变形的操作空间,让网络自己学习参考点的偏移量。 图1‑8 可变形注意力示意[8] 1.4. 损失函数 损失函数大部分与任务相关,且大同小异,这里集中介绍下后续方案解析需要用到的一些共性的损失函数。 Box Loss (包围盒损失函数) 是目标检测常用的几何损失函数,常采用L1 Loss的形式: Focal Loss是交叉熵损失函数的拓展,常用于分类问题。普通交叉熵损失函数在正负样本不均衡时表现不佳,因此引入平衡交叉熵。另外普通交叉熵损失函数对于难例无法重点学习,因此引入难例聚焦。最终形式为: 2. 视觉BEV方案解析 2.1. 引言 第一章的内容为第二章的方案解析打下知识基础,接下来第二章主要解析具有代表性的视觉BEV方案,主要根据视角转换模块的类型对方案进行分类,首先介绍2D->3D的代表性方案,然后介绍3D->2D的代表性方案。 2.2. 2D->3D代表性方案解析 2D->3D的代表性BEV方案有BEVDet和BEVDepth,下面我们逐一介绍。 2.2.1. BEVDet 3D目标检测跟踪由基于PV空间的方法主导,BEV语义分割跟踪由基于BEV空间的方法主导,那么PV空间和BEV空间哪个更适合做自动驾驶感知呢?是否可以在同一的框架下做这些任务?作者为了回答这两个问题,提出了如图2‑1所示的基于BEV空间的3D目标检测框架,BEVDet。BEVDet主要由四个部分组成,分别为图像特征编码器,视角转换模块,BEV特征编码器,检测头。 图2‑1 BEVDet框架[9] 图像特征编码器(Image-view Encoder)使用2D Backbone网络,如ResNet、SwinTransformer等,对输入的多视角图像做多尺度特征提取,得到多尺度特征。 视角转换模块(View Transformer)对输入的多视角图像特征使用LSS进行离散深度分布预测,获得3D视锥特征。 3D视锥特征经过pooling操作拍扁到BEV空间,BEV特征编码器(BEV Encoder)对BEV空间下的特征做多尺度特征提取,得到BEV特征。 最后送入检测头进行3D目标检测,分类监督使用的损失函数为Focal loss,包围盒监督使用的损失函数为L1 loss。 2.2.2. BEVDepth 作者实验发现LSS估计的深度替换成随机值影响不大,而采用真值深度对指标提升很大,因此得出LSS估计深度不准的结论,如图2‑2所示,在没有明确的深度监督的情况下,很难输出准确,泛化性强的深度感知结果,要想获得更好的检测结果,需要更准的深度,因此引入深度监督训练深度子网络。 图2‑2 LSS的深度预测结果和BEVDepth的深度预测结果的对比[10] 图2‑3是BEVDepth的框架,也能大致分为图像特征编码器,视角转换模块,BEV特征编码器,检测头四个部分。图像特征编码模块大同小异,后续不再展开说明。 图2‑3 BEVDepth框架[10] 视角转换模块的核心是深度估计,深度估计网络DepthNet的框架如图2‑4所示,首先使用MLP对相机内参进行特征化,然后用SE (Squeeze-and-Extraction) 对图像特征进行通道加权,然后经过3个残差块以及可形变卷积,得到深度。深度再与图像特征进行外积,得到3D视锥特征。 图2‑4 深度估计网络框架[10] 相机和用于监督的点云之间的外参可能不准,内参也可能不准,都会导致深度估计有偏,因此BEV特征编码器引入深度修正对3D视锥特征的深度进行修正,然后进行高效体素池化获得BEV特征。 检测头所使用的损失函数和BEVDet是一致的,不做赘述。深度监督使用的损失函数为二分类交叉熵。 2.3. 3D->2D代表性方案解析 前面介绍的2D->3D的方案始终绕不过深度估计,深度估计难免会引入误差,换个思路,先有3D点,再根据3D点找2D特征的方式无需进行深度估计,避免了这部分误差。3D->2D的代表性方案有Detr3D、BEVFormer和PETR。 2.3.1. Detr3D 如图2‑5所示,Detr3D是Detr在3D目标检测的扩展,也是使用query进行特征获取,然后进行检测。Detr3D的图像特征编码器大同小异,不再赘述。 图2‑5 Detr3D框架[5] 特征转换模块首先使用object query生成3D参考点,将参考点投影到PV空间获取图像特征,获取到的图像特征能进一步优化物体的3D表征,得到物体的3D特征。 将特征送入检测头进行目标检测,可以得到一系列的检测结果。普遍地,大家会用NMS等后处理方式获得最终用于Loss计算的检测结果,如图2‑6所示,Detr3D继承了Detr的做法,采用双边图匹配获得与真值一一对应的检测结果。损失函数与前面所述并未本质差异,不做赘述了。 图2‑6 双边图匹配获得与真值一一对应的检测结果[11] 2.3.2. BEVFormer 行车过程有天然的时序特点,当前帧看到的车道线,在后续几帧大概率也是存在且可见的,如何利用这个时序特点是前述方案没有考虑的。BEVFormer引入时序信息进一步增强BEV的检测能力。BEVFormer的图像特征编码模块和前述大同小异,不做赘述。 BEVFormer的核心是中间的BEV特征编码模块,BEV特征编码模块的核心是时序自注意力(Temporal Self-Attention)和空间交叉注意力(Spatial Cross-Attention),时序注意力是为了利用历史帧BEV特征增强当前帧BEV特征,空间交叉注意力则是为了从图像特征获取信息。 图2‑7 BEVFormer框架[12] 具体地,BEVFormer的时序自注意力首先利用车辆运动信息将当前帧BEV特征和历史帧BEV特征进行对齐,然后再使用自注意力融合两者信息,由于车辆运动信息可能不准,不同时刻周围的可利用信息分布也不一致,所以具体使用的是图2‑8所示的可变形注意力机制。 图2‑8 时序可变形自注意力[12] BEVFormer的空间交叉注意力首先为每个格子在Z方向上采样4个值,得到一个格子上的4个参考点,然后与图像特征进行交叉注意力,获得图像特征。如图2‑9所示,这里的交叉注意力也采用可变形注意力机制。 图2‑9 空间可变形交叉注意力[12] 损失函数的计算和Detr3D一致,不再赘述。 2.3.3. PETR 3D->2D的方案一般都需要将参考点投影到PV空间,再取图像特征,PETR避免了复杂的3D->2D转换及特征采样,直接让网络自己学习2D-3D的映射。PETR的框架如图2‑10所示,包括图像特征编码器、3D坐标生成器、3D特征编码器(3D Position Encoder)、3D特征解码器和检测头。图像特征编码器大同小异,不再赘述。 图2‑10 PETR框架[6] 3D坐标生成器生成视锥空间的一系列3D点,具体地,首先将相机视锥空间离散成大小为的网格,网格中的每一点用表示。3D空间中一个点用表示。通过相机内外参可以将相机视锥空间转换到3D空间中。最后再进行归一化。 2D图像特征和3D坐标一起送入到3D特征编码器中,2D特征进行卷积通道降维,3D坐标进行位置编码,然后将处理后的2D特征和3D坐标编码整合,最后特征展平。 图2‑11 3D特征编码器[6] 3D特征解码器先在3D空间生成一系列随机点,再通过MLP生成可学习的query,query在3D特征中取特征,最后使用检测头进行检测。损失函数与Detr3D大同小异,不再赘述。 3. 总结展望 本文从BEV的基础出发,介绍了视觉BEV具有代表性的方案。视觉BEV已经展现出强大的场景理解能力。但是还存在很多值得探索且有挑战的方向[13]: 深度估计是BEV的核心,LSS、Pseudo-LiDAR、激光蒸馏、立体视觉或运动恢复结构等都是有前景的方向。 如何融合传感器的信息也是至关重要的,使用Transformer的自注意力、交叉注意力融合不同模态的特征已经被证明是个可行的方向。多模态中CLIP的文本-图像对也是个很有启发的思路。 泛化性是深度学习亘古不变的话题和努力的方向,在一个设备(数据)上训练好的模型在另一个设备(数据)表现是否一样好。每个设备都要付出训练成本是让人难以接受的。如何将模型和设备解耦在未来一段时间都将是重要的研究方向。 大模型或者基础模型已经在不同领域上取得令人印象深刻的结果,并一举成为SOTA。在BEV感知中如何利用大模型中丰富的知识,在更多的任务上取得更好的效果,这将会逐步引起人们的重视。 4. 参考文献 [1] Bencheng Liao, Shaoyu Chen, Xinggang Wang, et al. Maptr: Structured modeling and learning for online vectorized hd map construction[J]. arXiv preprint arXiv:2208.14437,2022, [2] Yuzhe He, Shuang Liang, Xiaofei Rui, et al. EgoVM: Achieving Precise Ego-Localization using Lightweight Vectorized Maps[J]. arXiv preprint arXiv:2307.08991,2023, [3] Jonah Philion and Sanja Fidler. Lift, splat, shoot: Encoding images from arbitrary camera rigs by implicitly unprojecting to 3d[A]. Springer: 194-210 [4] Yan Wang, Wei-Lun Chao, Divyansh Garg, et al. Pseudo-lidar from visual depth estimation: Bridging the gap in 3d object detection for autonomous driving[A]. 8445-8453 [5] Yue Wang, Vitor Campagnolo Guizilini, Tianyuan Zhang, et al. Detr3d: 3d object detection from multi-view images via 3d-to-2d queries[A]. PMLR: 180-191 [6] Yingfei Liu, Tiancai Wang, Xiangyu Zhang, et al. Petr: Position embedding transformation for multi-view 3d object detection[A]. Springer: 531-548 [7] Jifeng Dai, Haozhi Qi, Yuwen Xiong, et al. Deformable convolutional networks[A]. 764-773 [8] Xizhou Zhu, Weijie Su, Lewei Lu, et al. Deformable detr: Deformable transformers for end-to-end object detection[J]. arXiv preprint arXiv:2010.04159,2020, [9] Junjie Huang, Guan Huang, Zheng Zhu, et al. Bevdet: High-performance multi-camera 3d object detection in bird-eye-view[J]. arXiv preprint arXiv:2112.11790,2021, [10] Yinhao Li, Zheng Ge, Guanyi Yu, et al. BEVDepth: Acquisition of Reliable Depth for Multi-View 3D Object Detection[J]. Proceedings of the AAAI Conference on Artificial Intelligence,2023,37(2): 1477-1485 [11] Nicolas Carion, Francisco Massa, Gabriel Synnaeve, et al. End-to-end object detection with transformers[A].Springer: 213-229 [12] Zhiqi Li, Wenhai Wang, Hongyang Li, et al. Bevformer: Learning bird’s-eye-view representation from multi-camera images via spatiotemporal transformers[A].Springer: 1-18 [13] Hongyang Li, Chonghao Sima, Jifeng Dai, et al. Delving into the Devils of Bird's-eye-view Perception: A Review, Evaluation and Recipe[J]. arXiv preprint arXiv:2209.05324,2022,

优秀的个人博客,低调大师

每日一博 | 十行代码让日志存储降低 80%

前言 履约管理是一个面向物流商家的OMS工作台,自从初代目把架子搭起来之后,就没有继续投入了,后来一直是合作伙伴同学在负责日常维护和需求支撑。经过几年的野蛮生长,系统已经杂草丛生,乱象百出。再后来,甚至一度成为一块无主之地,走行业共建的方式来支持。对于一个不支持行业隔离的系统,行业共建意味这个系统将快速腐化。两年前我开始接管履约管理,来到这片广阔的蛮荒之地,正如所有那些渴望造物乐趣并且手里刚好有锤子镰刀的人,我就像一匹脱缰的野马,脑子里经常会产生很多大胆且新奇的想法,希望借此把履约管理打造成一个完美的系统。只可惜真正能够付诸实践的少之又少,本篇就是为数不多得以落地,并且有相当实用价值idea中的一个,整理出来分享给有需要的同学做参考。 日志乱象 日志是日常开发中最有可能被忽视,最容易被滥用的一个模块。被忽视是因为打日志实在是一个再简单不过的事,前人设计好了一个logback.xml,后面只需要依样画葫芦定义一个logger,随手一个info调用就搞定,他甚至不确定这条日志能不能打出来,也不知道会打在哪个文件,反正先跑一次试试,不行就换error。被滥用是因为不同场景日志的格式内容千差万别,或者说日志打法太灵活,太随意了,风格太多样化了,以至于几乎每个人一言不合就要自己写一个LogUtil,我见过最夸张的,一个系统中用于打日志的工具类,有二三十个之多,后人纠结该用哪个工具可能就要做半个小时的思想斗争,完美诠释了什么叫破窗效应。最好的学习方式就是通过反面教材吸取教训,下面我们列举一些最常见的日志设计开发过程中的问题。 分类之乱 一般来说,一个系统必然需要设计多个日志文件以区分不同业务或场景,不可能所有的日志都打到一个文件里。但是怎么进行分类,没人告诉我们,于是就有了各种各样的分类。按系统模块分。这种分类应该是最基础的一种分类,也是最有层次感的分类。比如履约服务中枢的系统分层。基本上每一层对应一个日志文件。 按租户身份分。一般中台系统都会支持多个租户(行业),每一个租户单独对应一个日志文件。这种分类一般不会单独使用,除非你要做完全意义上的租户隔离。意识流分类法。不符合MECE法则,没有清晰统一的分类逻辑,按业务分,按系统模块分,按接口能力分,按新老链路分,各种分法的影子都能看到,结果就是分出来几十个文件,打日志的人根本就不知道这一行的日志会打进哪个文件。以上说的各种分类方式,都不是绝对纯粹的,因为无论哪一种,无论一开始设计的多么边界清晰,随着时间的推进,最后都会演变为一个大杂烩。 某人希望单独监控某个类产生的日志,新增日志文件; 新增了一个业务,比如一盘货,想单独监控,新增日志文件; 发起了一场服务化战役,针对服务化链路单独监控,新增日志文件; 某个业务想采集用户行为,又不想全接日志消息,新增日志文件; 资损敞口的场景,需要特别关注,新增日志文件; 特殊时期内产生的日志,比如大促,新增日志文件; 凡此种种,不一而足。发现没有,总有那么一瞬间能让人产生新增日志文件的神经冲动,他们的诉求和场景也不可谓不合理,尽管这些日志的维度完全不相关,然而没有什么能阻止这种冲动。最开始的那一套日志设计,就像一个濒临死亡的大象,不断地被不同的利益方从身上扯下一块分去。 格式之乱 对于日志需要有一定的格式这点相信没有人会有异议,格式的乱象主要体现在两个方面,一个是格式的设计上,有些系统设计了非常复杂的格式,用多种分隔符组合,支持日志内容的分组,用关键词定位的方式代替固定位置的格式,同时支持格式扩展,这对人脑和计算机去解析都是一种负担。第二个是同一个日志文件,还能出现不同格式的内容,堆栈和正常业务日志混杂。来看一个例子,我不给任何提示,你能在大脑里很快分析出这个日志的结构吗? requestParam$&trace@2150435916867358634668899ebccf&scene@test&logTime@2023-06-14 17:44:23&+skuPromiseInfo$&itemId@1234567:1&skuId@8888:1&buyerId@777:1&itemTags@,123:1,2049:1,249:1,&sellerId@6294:1&toCode@371621:1&toTownCode@371621003:1&skuBizCode@TMALL_TAOBAO:1&skuSubBizCode@TMALL_DEFAULT:1&fromCode@DZ_001:1+orderCommonInfo$&orderId@4a04c79734652f6bd7a8876379399777&orderBizCode@TMALL_TAOBAO&orderSubBizCode@TMALL_DEFAULT&toCode@371621&toTownCode@371621003&+ 工具之乱 有时候甚至会出现,同一个类,同一个方法中,两行不同的日志埋点,打出来的日志格式不一样,落的日志文件也不一样。为什么会出现这种情况?就是因为用了不同的日志工具。要究其根源,我们需要分析一下不同的工具究竟是在做什么。可以发现,很多工具之间的差别就是支持的参数类型不一样,有些是打印订单对象的,有些是打印消息的,有些是打印调度日志的。还有一些差别是面向不同业务场景的,比如一盘货专用工具,负卖专用工具。还有一些差异是面向不同的异常封装的,有些是打印ExceptionA,有些是打印ExceptionB的。人间离奇事,莫过于此,或许只能用存在即合理去解释了。 日志分层 我一直信奉极简的设计原则,简单意味着牢不可破。上面提到,一套日志系统最终的结局一定是走向混乱,既然这种趋势无法避免,那么我们在最初设计的时候就只能确保一件事,保证原始的分类尽量简单,且不重叠。其实通用的分类方式无非就两种,一种按职能水平拆分,一种按业务垂直拆分。一般来说,一级分类,应该采用水平拆分。因为业务的边界一般是很难划清的,边界相对模糊,职能的边界就相对清晰稳定很多,职能其实反映的是工作流,工作流一经形成,基本不会产生太大的结构性变化。基于这种思路,我设计了如下的日志分层。 从层次上来看,其实只有三层,入口,内核,出口。入口日志只负责打印流量入口的出入参,比如HSF,controller。出口日志负责打印所有第三方服务调用的出入参。内核日志,负责打印所有中间执行过程中的业务日志。就三层足矣,足够简单,不重不漏。另外把堆栈日志单独拎出来,堆栈相比业务日志有很大的特殊性,本文标题所指出的日志存储降低优化,也只是针对堆栈日志做的优化,这个后面再讲。 格式设计 日志的格式设计也有一些讲究。首先日志的设计是面向人可读的,这个无需多言。另外也非常重要的一个点,要面向可监控的设计,这是容易被很多人忽视的一个点。基于这两个原则,说一下我在格式设计上的一些思路。首先要做维度抽象。既然是面向监控,监控一般需要支持多个维护,比如行业维度,服务维度,商家维度等等,那么我们就需要把所有的维度因子抽出来。那么这些维度实际打印的时候怎么传给logger呢?建议是把他们存到ThreadLocal中,打的时候从上下文中取。这样做还有一个好处是,日志打印工具设计的时候就会很优雅,只需要传很少的参数。格式尽量简单,采用约定大于配置的原则,每一个维度占据一个固定的位置,用逗号分割。切忌设计一个大而全的模型,然后直接整个的序列化为一个JSON字符串。也不要被所谓的扩展性给诱惑,给使用方轻易开出一个能够自定义格式的口子,即便你能轻而易举的提供这种能力。根据我的经验,这种扩展性一定会被滥用,到最后连设计者也不知道实际的格式究竟是怎样的。当然这个需要设计者有较高的视野和远见,不过这不是难点,难的还是克制自己炫技的欲望。在内容上,尽量打印可以自解释的文本,做到见名知义。举个例子,我们要打印退款标,退款标原本是用1, 2, 4, 8这种二进制位存储的,打印的时候不要直接打印存储值,翻译成一个能描述它含义的英文code。格式示例 timeStamp|threadName logLevel loggerName|sourceAppName,flowId,traceId,sceneCode,identityCode,loginUserId,scpCode,rpcId,isYace,ip||businessCode,isSuccess||parameters||returnResult|| 内容示例 2023-08-14 14:37:12.919|http-nio-7001-exec-10 INFO c.a.u.m.s.a.LogAspect|default,c04e4b7ccc2a421995308b3b33503dda,0bb6d59616183822328322237e84cc,queryOrderStatus,XIAODIAN,5000000000014,123456,0.1.1.8,null,255.255.255.255||queryOrderStatus,success||{"@type":"com.alibaba.common.model.queryorder.req.QueryOrderListReq","currentUserDTO":{"bizGroup":888,"shopIdList":[123456],"supplierIdList":[1234,100000000001,100000000002,100000000004]},"extendFields":{"@type":"java.util.HashMap"},"invokeInfoDTO":{"appName":"uop-portal","operatorId":"1110","operatorName":"account_ANXRKY8NfqFjXvQ"},"orderQueryDTO":{"extendFields":{"@type":"java.util.HashMap"},"logisTypeList":[0,1],"pageSize":20,"pageStart":1},"routeRuleParam":{"@type":"java.util.HashMap","bizGroup":199000},"rule":{"$ref":"$.routeRuleParam"}}||{"@type":"com.alibaba.common.model.ResultDTO","idempotent":false,"needRetry":false,"result":{"@type":"com.alibaba.common.model.queryorderstatus.QueryOrderStatusResp","extendFields":{"@type":"java.util.HashMap"}},"success":true}|| 堆栈倒打 本文的重点来啦,这个设计就是开头提到的奇思妙想。堆栈倒打源于我在排查另一个系统问题过程中感受到的几个痛点,首先来看一个堆栈示例。 这么长的堆栈,这密密麻麻的字母,即使是天天跟它打交道的开发,相信第一眼看上去也会头皮发麻。回想一下我们看堆栈,真正想得到的是什么信息。所以我感受到的痛点核心有两个。第一个是,SLS(阿里云日志产品系统)上搜出来的日志,默认是折叠的。对于堆栈,我们应该都知道,传统异常堆栈的特征是,最顶层的异常,是最接近流量入口的异常,这种异常我们一般情况下不太关心。最底层的异常,才是引起系列错误的源头,我们日常排查问题的时候,往往最关心的是错误源头。所以对于堆栈日志,我们无法通过摘要一眼看出问题出在哪行代码,必须点开,拉到最下面,看最后一个堆栈才能确定源头。我写了一个错误示例来说明这个问题。常规的堆栈结构其实分两部分,我称之为,异常原因栈,和错误堆栈。 如上,一个堆栈包含有三组异常,每一个RuntimeException是一个异常,这三个异常连起来,我们称为一个异常原因栈。每一个RuntimeException内部的堆栈,我们称为错误堆栈。说明一下,这两个名词是我杜撰的,没有看到有人对二者做区分,我们一般都统称为堆栈。读者能理解我想表达的就行,不用太纠结名词。第二个痛点是,这种堆栈存储成本太高,有效信息承载率很低。老实说这一点可能大多数一线开发并没有太强烈的体感,但在这个降本增效的大环境下,我们每个人应该把这点作为自己的OKR去践行,变被动为主动,否则在机器成本和人力成本之间,公司只好做选择题了。现在目标很明确了,那我们就开始对症下药。核心思路有两个。针对堆栈折叠的问题,采用堆栈倒打。倒打之后,最底层的异常放在了最上面,甚至不用点开,瞟一眼就能知道原因。 同时我们也支持异常原因栈层数配置化,以及错误堆栈的层数配置化。解这个问题,本质上就是这样一个简单的算法题:倒序打印堆栈的最后N个元素。核心代码如下。 /** * 递归逆向打印堆栈及cause(即从最底层的异常开始往上打) * @param t 原始异常 * @param causeDepth 需要递归打印的cause的最大深度 * @param counter 当前打印的cause的深度计数器(这里必须用引用类型,如果用基本数据类型,你对计数器的修改只能对当前栈帧可见,但是这个计数器,又必须在所有栈帧中可见,所以只能用引用类型) * @param stackDepth 每一个异常栈的打印深度 * @param sb 字符串构造器 */ public static void recursiveReversePrintStackCause(Throwable t, int causeDepth, ForwardCounter counter, int stackDepth, StringBuilder sb){ if(t == null){ return; } if (t.getCause() != null){ recursiveReversePrintStackCause(t.getCause(), causeDepth, counter, stackDepth, sb); } if(counter.i++ < causeDepth){ doPrintStack(t, stackDepth, sb); } } 要降低存储成本,同时也要确保信息不失真,我们考虑对堆栈行下手,把全限定类名简化为类名全打,包路径只打第一个字母,行号保留。如:c.a.u.m.s.LogAspect#log:88。核心代码如下。 public static void doPrintStack(Throwable t, int stackDepth, StringBuilder sb){ StackTraceElement[] stackTraceElements = t.getStackTrace(); if(sb.lastIndexOf("\t") > -1){ sb.deleteCharAt(sb.length()-1); sb.append("Caused: "); } sb.append(t.getClass().getName()).append(": ").append(t.getMessage()).append("\n\t"); for(int i=0; i < stackDepth; ++i){ if(i >= stackTraceElements.length){ break; } StackTraceElement element = stackTraceElements[i]; sb.append(reduceClassName(element.getClassName())) .append("#") .append(element.getMethodName()) .append(":") .append(element.getLineNumber()) .append("\n\t"); } } 最终的效果大概长这样。我们随机挑了一个堆栈做对比,统计字符数量,在同等信息量的情况下,压缩比达到88%。 思维拓展 很多文章喜欢鼓吹所谓的最佳实践,在笔者看来最佳实践是个伪命题。当你在谈最佳实践的时候,你需要指明这个"最"是跟谁比出来的,你的适用范围是哪些,我相信没有任何一个人敢大言不惭自己的框架或方案是放之四海而皆准的。本文所提出的日志设计实践方案,是在一个典型的中台应用中落地的,三段的日志分层方案虽然足够简单,足够通用,但是最近解触了一些富客户端应用,这个方案要想迁移,可能就得做一些本土化的改造了。他们的特点是依赖的三方服务少,大量的采用缓存设计,这种设计的底层逻辑是,尽量使得所有逻辑能在本地客户端执行以降低分布式带来的风险和成本,这意味着,可能99%的日志都是内部执行逻辑打的,那我们就得考虑从另一些维度去做拆分。另外对于日志降本,本文探讨的也只是降堆栈的存储,一个系统不可能所有日志都是堆栈,所以实际整体的日志存储成本,可能降幅不会有这么多。谈这么多,归根结底还是一句话,不要迷信银弹,减肥药一类的东西,所有的技术也好,思想也好,都要量体裁衣,量力而行。 作者|伏难 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

每日一博 | 一次网络不通 “争吵” 引发的思考

为啥争吵,吵什么? "你到底在说什么啊,我K8s的ecs节点要访问clb的地址不通和本地网卡有什么关系..." 气愤语气都从电话那头传了过来,这时电话两端都沉默了。过了好一会传来地铁小姐姐甜美的播报声打断了刚刚的沉寂「乘坐地铁必须全程佩戴口罩,下一站西湖文化广场...」。 pod需要访问clb的443的监听, 但是如果是集群内(集群内后面都指的K8s的节点或者POD)访问就会出现如下报错Connection refused: 所以就捋了一下客户链路如下: 具体现象是什么 无论是节点node还是pod里访问192.168.1.200:443都是不通的,但是访问192.168.1.200:80却是正常的。同时集群外的ECS192.168.3.100访问192.168.1.200:443和192.168.1.200:80都是正常的。 进一步分析看看 CLB1的IP192.168.1.200被绑定到了K8s的node节点的kube-ipvs0网卡上,这个是一张dummy 网卡,参考dummy interface。由于 SVC1 是LoadBalancer类型的,同时复用了这个CLB1,关联endpoint是POD1192.168.1.101:80,那么就可以解释为何访问192.168.1.200:80是正常,是由于kube-proxy根据SVC1的配置创建ipvs规则同时挂载了可被访问的后端服务。而集群里访问192.168.1.200:443都是不通的,因为IP被绑定到dummy网卡后,就不会再出节点去访问到CLB1,同时没有443对应ipvs规则,所以直接是拒绝的。 这个时候如果节点里没有ipvs规则(ipvs优先于监听)但是又能访问通的话, 可以检查一下是否本地有监听0.0.0.0:443的服务,那么这个时候所有网卡IP+443都能通,但是访问的是本地服务,而不是真正的CLB后端的服务。 是否有办法解决呢 最建议的方式 最好的方式拆分, 集群内和集群外的服务分开两个CLB使用。 阿里云svc注解的方式 SVC1使用这个注解http://service.beta.kubernetes.io/alibaba-cloud-loadbalancer-hostname,进行占位,这样就不会绑定CLB的IP到kube-ipvs0的网卡上,集群内访问CLB的IP就会出集群访问CLB,但是需要注意如果监听协议为TCP或UDP,集群内访问CLB IP时将会存在回环访问问题。详细信息,请参见客户端无法访问负载均衡CLB[1]。 需要CCM版本在 v2.3.0及以上版本才支持这个注解, 具体参考:通过Annotation配置传统型负载均衡CLB [2] demo: apiVersion: v1 kind: Service metadata: annotations: service.beta.kubernetes.io/alibaba-cloud-loadbalancer-hostname: "${your_service_hostname}" name: nginx-svc namespace: default spec: ports: - name: http port: 80 protocol: TCP targetPort: 80 selector: app: nginx type: LoadBalancer 集群内访问 ExternalTrafficPolicy 策略有影响吗? 我们都知道K8s的nodeport和loadbalancer模式是可以调整外部流量策略的,那么图中的「外部策略为Local/Cluster,所有集群节点创建IPVS规则是有区别的」该如何解释呢, 以及集群内访问nodePort/CLBIP的时候会发生什么。 以下都是针对svc的internalTrafficPolicy都是Cluster或者缺省的情况,这个ServiceInternalTrafficPolicy特性在1.22的K8s中默认开启,具体参考service-traffic-policy [3] 此处我们只讨论ipvs TrafficPolicy Local在Kubernetes 从1.22升级到1.24的行为变化。 Kubernetes 1.24 IPVS的变化 以下均以kube-proxy的IPVS模式为例: 当externalTrafficPolicy为Cluster模式或缺省的时候,ipvs规则里的nodePort/CLBIP后端会挂载所有的Endpoint的IP,这时候集群内访问会丢失源IP,因为节点会做一层SNAT。 当externalTrafficPolicy是Local的时候 当节点上有对应service的Endpoint的时候,ipvs规则里的nodePort/CLBIP后端只挂载自己节点的Endpoint的IP,集群内访问会保留源IP。 当节点上没有对应service的Endpoint的时候 在1.24之前的版本是会挂空的后端的,集群内访问会拒绝。 在1.24之后的K8s集群里,当节点上没有对应service的Endpoint的时候,ipvs规则里的nodePort/CLB IP后端会挂载所有的Endpoint的IP,这时候集群内访问会丢失源IP,因为节点会做一层SNAT。社区调整了Local策略后端服务的规则挂载策略,具体参考社区PR[4]。 https://github.com/kubernetes/kubernetes/pull/97081/commits/61085a75899a820b5eebfa71801e17423c1ca4da 集群外访问SLB 集群外访问SLB的话,CCM只会挂载Local类型的节点,情况跟1.24 kubernetes前一样,这里不做过多阐述,请见上面连接。 集群外访问NodePort 1.24 Kubernetes之前版本 访问有Endpoint的节点的NodePort,可以通,可以保留源IP Nginx分布在cn-hongkong.10.0.4.174和cn-hongkong.10.0.2.84节点。 从外部10.0.3.72节点访问有后端pod所在节点的cn-hongkong.10.0.2.84的30479端口,可以访问。 cn-hongkong.10.0.0.140节点上是有相关的IPVS的规则的,但是只有该节点上后端Pod IP。 通过conntrack表可以到,这是由于在cn-hongkong.10.0.0.140节点上,相关的链路被dnat,最后是由pod cn-hongkong.10.0.2.84节点上的 的nginx-7d6877d777-tzbf7 10.0.2.87返回源,所有的相关转化都在该节点上,所以TCP四层建连可以成功。 访问没有Endpoint的节点的NodePort,不能通,因为节点上没有相关的ipvs转发规则 从外部10.0.3.72节点访问无后端pod所在节点的cn-hongkong.10.0.0.140的30479端口,不可以访问。 查看该cn-hongkong.10.0.0.140节点,并没有相关的ipvs转发规则,所以无法进行dnat,访问会失败。 1.24 Kubernetes版本之后(含) 访问有Endpoint节点的NodePort,可以通,可以保留源IP 访问没有Endpoint节点的NodePort: terway ENIIP or host网络:不通 Nginx分布在cn-hongkong.10.0.2.77和cn-hongkong.10.0.0.171 节点。 从外部10.0.3.72节点访问无后端pod所在节点的cn-hongkong.10.0.5.168的30745端口,可以看到,访问失败。 cn-hongkong.10.0.5.168节点上是有相关的IPVS的规则的,并且会把所有的后端Pod IP加到IPVS规则中。 通过conntrack表可以到,这是由于在cn-hongkong.10.0.5.168节点上,相关的链路被dnat,最后是由pod cn-hongkong.10.0.2.77节点上的nginx-79fc6bc6d-8vctc 10.0.2.78返回源,源在接受这个链路后,会发现和自己的五元组不匹配,直接丢弃,三次握手必然失败,所以建连失败。 flannel网络:可以通,但是保留不了源IP Nginx分布在cn-hongkong.10.0.2.86。 从外部访问cn-hongkong.10.0.4.176的31218端口,可以访问成功。 cn-hongkong.10.0.4.176记录了src是10.0.3.72,并做了dnat为172.16.160.135,期望它返回给10.0.4.176的58825端口。 后端ep所在节点cn-hongkong.10.0.2.86,conntrack表记录了src是10.0.4.176,sport是58825。所以可以看到应用pod是记录的源IP是10.0.4.176,丢失了源IP。 集群内访问SLB或者NodePort 1.24 Kubernetes之前版本 有Endpoint的节点上访问,可以通,可以保留源IP Nginx分布在ap-southeast-1.192.168.100.209和ap-southeast-1.192.168.100.208节点,ap-southeast-1.192.168.100.210节点没有Nginx pod。 从集群任意节点(本例就在209节点)访问有后端pod所在节点的ap-southeast-1.192.168.100.209的NodePort 31565端口,可以访问。 从有后端pod所在节点ap-southeast-1.192.168.100.209访问SLB 8.222.252.252 的80端口,可以访问。 ap-southeast-1.192.168.100.209节点上是有NodePort 和SLB 的IPVS的规则的,但是只有该节点上后端Pod IP。 通过conntrack表可以到,这是由于在ap-southeast-1.192.168.100.209 节点上,相关的链路被dnat,最后是由pod 在ap-southeast-1.192.168.100.209 节点上的 的nginx-7d6877d777-2wh4s 192.168.100.222返回源,所有的相关转化都在该节点上,所以TCP四层建连可以成功。 没有Endpoint的节点上访问,不能通,因为节点上没有相关的ipvs转发规则 从集群任意节点(本例就在210节点)访问没有后端pod所在节点的ap-southeast-1.192.168.100.210 的NodePort 31565端口或者SLB,不可以访问。 也进一步证实,集群内访问关联svc的SLB不出节点,即使SLB有其他监听端口,访问SLB其他端口也会拒绝。 查看该ap-southeast-1.192.168.100.210 节点,并没有相关的ipvs转发规则,所以无法进行dnat,访问会失败。 1.24 Kubernetes版本之后(含) 有Endpoint节点上访问,可以通,可以保留源IP 与上文的1.24 Kubernetes之前版本集群内访问一致,可以参考上文描述。 没有Endpoint节点上访问: Nginx分布在cn-hongkong.10.0.2.77和cn-hongkong.10.0.0.171节点,所以在没有Nginx的cn-hongkong.10.0.4.141节点上测试。 分别有以下几种情况: terway或后端为hostNetwork 节点访问的通 NodePort(源 IP 是 ECS IP,不需要做 SNAT),无法保留源IP 可以看到没有Endpoint的节点的NodePort 110.0.4.141:30745 的IPVS 的规则添加的Nginx的所有后端POD nginx-79fc6bc6d-8vctc 10.0.2.78 和 nginx-79fc6bc6d-j587w 10.0.0.172。 集群内节点自身访问没有后端pod所在节点的cn-hongkong.10.0.4.141 的NodePort 30745/TCP端口,可以访问。 通过conntrack表可以到,在cn-hongkong.10.0.4.141节点上,相关的链路被dnat,最后是由后盾Nginx pod nginx-79fc6bc6d-8vctc 10.0.2.78返回源。 而在nginx-79fc6bc6d-8vctc 10.0.2.78 所在的节点cn-hongkong.10.0.2.77上的conntrack表记录的是10.04.141访问10.0.2.78,并期望10.0.2.78直接返回10.0.4.141的的39530端口。 集群内有endpoint 节点访问没有后端pod所在节点的ap-southeast-1.192.168.100.131 的NodePort 32292端口,不可以访问,与上文1.24 Kubernetes版本之后(含) 集群外访问一致,可以参考上文描述。 节点访问不通 SLB IP(源 IP 是 SLB IP,没有人做 SNAT) 可以看到没有Endpoint的节点的SLB IP 的IPVS 的规则添加的Nginx的所有后端POD nginx-79fc6bc6d-8vctc 10.0.2.78 和 nginx-79fc6bc6d-j587w 10.0.0.172。 没有Endpoint的节点上访问 SLB 47.243.247.219,访问确是超时。 通过conntrack表可以到,在没有ep的节点访问SLB的IP,可以看到期望的是后端pod返回给SLB IP。而SLB IP 在节点上已经被kube-ipvs虚拟占位了,所以没有做snat,造成无法访问。 flannel并且后端为普通pod,可以访问通,但是保留不了源IP Nginx分布在cn-hongkong.10.0.2.86。 在cn-hongkong.10.0.4.176访问SLB 47.242.86.39 是可以访问成功的。 cn-hongkong.10.0.4.176节点的conntrack表可以看到是src和dst都是47.242.86.39,但是期望的是 nginx pod172.16.160.135 返回给 10.0.4.176 的54988端口,47.242.86.39 snat成10.0.4.176。 后端ep所在节点cn-hongkong.10.0.2.86,conntrack表记录了src是10.0.4.176,sport是54988。所以可以看到应用pod是记录的源IP是10.0.4.176,丢失了源IP。 相关链接: [1] 客户端无法访问负载均衡CLB https://help.aliyun.com/document_detail/55206.htm [2] 通过Annotation配置传统型负载均衡CLB https://www.yuque.com/r/goto?url=https%3A%2F%2Fhelp.aliyun.com%2Fzh%2Fack%2Fack-managed-and-ack-dedicated%2Fuser-guide%2Fadd-annotations-to-the-yaml-file-of-a-service-to-configure-clb-instances [3] service-traffic-policy https://kubernetes.io/zh-cn/docs/concepts/services-networking/service-traffic-policy/ [4] 社区PR https://github.com/kubernetes/kubernetes/pull/97081/commits/61085a75899a820b5eebfa71801e17423c1ca4da 作者: 郑明泉、余凯 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册