DeepLearning.ai学习笔记(五)序列模型 -- week2 自然语言处理与词嵌入
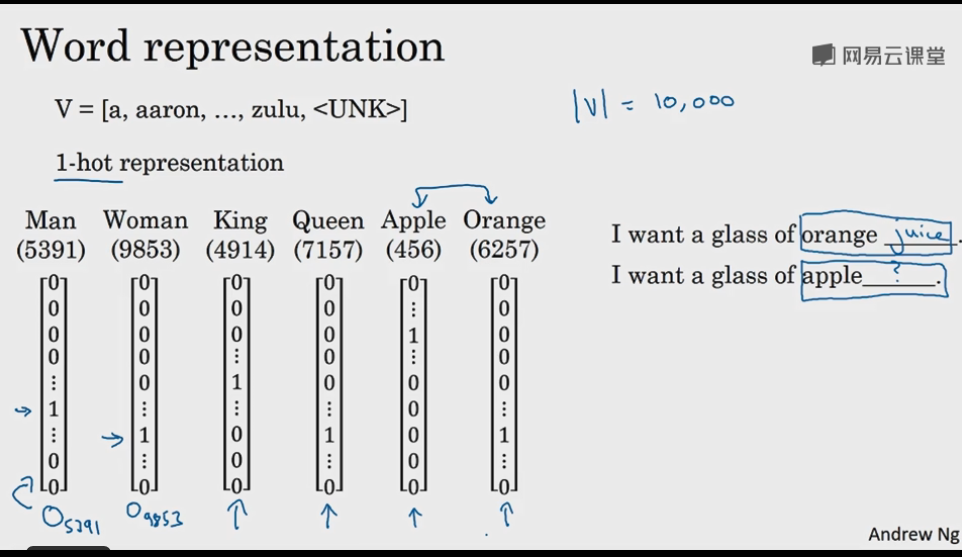
一、词汇表征 首先回顾一下之前介绍的单词表示方法,即one hot表示法。 如下图示,“Man”这个单词可以用 \(O_{5391}\) 表示,其中O表示One_hot。其他单词同理。 但是这样的表示方法有一个缺点,看是看下图中右侧给出的例子,比如给出这么一句不完整的话: **I want a glass of orange __** 假设通过LSTM算法学到了空白处应该填“juice”.但是如果将orange改成apple,即 **I want a glass of apple __** 那么是否也需要从头开始学习“apple juice”吗?能否通过构建“apple” 与 “orange” 的联系让它不需要重学就能进行判断呢?所以下面给出了一种改进的表示方法,称之为“词嵌入(Word Embedding)” 我们知道单词与单词之间是有很多共性的,或在某一特性上相近,比如“苹果”和“橙子”都是水果;或者在某一特性上相反: 比如“父亲”在性别上是男性,“母亲”在性别上是女性,通过构建他们其中的联系可以将在一个单词学习到的内容应用到其他的单词上来提高模型的学习的效率,下面是一个简化的表格用以说明: 原版 汉化版 (上面两个表格分别是课堂上吴大大的讲义和由大数据文摘整理得到的) 简单介绍一下上面的表格的意思: 以“性别(Gender)”这一特征为例,若以-1表示男性,1表示女性,那么显然“Man”在该特征上的值为-1,其他同理,不再赘述。 此时对于单词“orange”和“apple”来说他们会共享很多的特性,比如都是水果,都是圆形,都可以吃,也有些不同的特性比如颜色不同,味道不同,但因为这些特性让RNN模型理解了他们的关系,也就增加了通过学习一个单词去预测另一个的可能性。 假设所用的特征有300个,那么每一个单词就是由这300个特征值组成,因为这个维度是很高的了,所以可以使用$ t-SNE$算法将它们映射到二维空间之后进行可视化聚类,可以得到如下的效果图: 上图通过聚类将词性相类似的单词在二维空间聚为一类,所以这也就可以理解为什么这叫做"词嵌入(Word Embedding)"了,即把原来由多维的特征空间表示单词嵌入到二维空间中去了。 二、使用词嵌入 下面介绍词嵌入的实用场景。 以下图为例,该图表示的是输入一段话,判断出人名。通过学习判断可以知道orange farmer指的应该是人,所以其对应的主语Sally Johnson就应该是人名了,所以其对应位置输出为1。 那如果把orange换成apple呢?通过词嵌入算法可以知道二者词性类似,而且后面跟着farmer,所以也能确认Robert Lin是人名。 我们继续替换,我们将apple farmer替换成不太常见的durian cultivator(榴莲繁殖员)。此时词嵌入中可能并没有durian这个词,cultivator也是不常用的词汇。这个时候怎么办呢?我们可以用到迁移学习。 词嵌入迁移学习步骤如下: 1.学习含有大量文本语料库的词嵌入(一般含有10亿到1000亿单词),或者下载预训练好的词嵌入 2.将学到的词嵌入迁移到相对较小规模的训练集(例如10万词汇),这个时候就能体现出相比于使> 用one hot表示法,使用词嵌入的优势了。如果是使用one hot,那么每个单词是1*100000表> 示,而用词嵌入后,假设特征维度是300,那么只需要使用1*300的向量表示即可。 3.(可选) 这一步骤就是对新的数据进行fine-tune。 词嵌入其实与之前卷积神经网络人脸识别课程中介绍的Siamese网络有类似的地方。 即二者都是使用相同的评价模型对不同对象进行距离运算,距离越近则越相似 例如Siamese网络是将两张人脸图像分别送到相同的CNN模型中计算出特征值并求出差值,来进行判断二者的相似度。词嵌入则是使用两个单词的特征维度进行相似度计算。 但是二者也有差别,以Siamese网络为例,无论输入的人脸图像是什么,其总能计算出二者的相似度。而词嵌入不同,因为有的单词并不出现在某一个词嵌入数据集中,所以此时则无法计算相似度。 三、词嵌入的特性 我们小时候都做过反义词或者近义词的题目吧,那假如告诉机器“Man”↔“Woman”,那么能否退出“King”所对应的单词呢? 这个问题被称作词汇的类比问题(或推理),通过研究词嵌入的特征就可以解决这种问题。 如下图示,我们用\(e_{Man}\)来表示“Man”这个单词,其向量为[-1,0.01,0.03,0.09]。“Woman”同理,二者的差异向量为\(e_{Man}-e_{Woman}=[-2,0,0,0]\)(为方便理解,结果做了简化)。 我们可以很容易知道“King”和“Queen”是相对应的,并且它们之间的差异向量也是[-2,0,0,0]。 大部分时候对于人而言,是很容易找到一对相近的单词的,那么计算机如何找呢?其实按照上面的计算方法已经告诉我们了,即只要满足如下关系式的即可: 已知单词A和单词B是对应的,求与单词C相对应的单词D,则有如下等式: \(e_A - e_B \, \approx \, e_C-e_D\) 其中\(D\)满足\(argmax_w \;\, Similarity(e_D, e_A-e_B+e_C)\) 注意上面的相似度函数为余弦公式,即: \[Similarity(u,v)=\frac{u^Tv}{||u||_2||v||_2}\] 当然也可以用其他距离公式。 如下图用几何方式能够更容易理解,即只要找到与向量\(\vec{AB}\)最接近平行的向量\(\vec{CD}\)即可。 四、嵌入矩阵 如下图示,左边是词嵌入矩阵,每一列表示该单词的特征向量,每一行表示所有单词在某一特征上的值的大小,这个矩阵用\(E\)表示,假设其维度是(300,10000)。 右边矩阵是某一列单词的One hot向量,这里以orange为例,其Onehot向量为\(O_{6257}=[0,…,1,…,0]\)。 那么已知词嵌入矩阵和某一个单词的Onehot向量,那么该单词的特征向量则满足如下等式: \[E*O_j=e_j\] * 表示矩阵乘法 这种获取某个单词特征向量的方法涉及太多运算,所以一般在实际操作中是直接对词嵌入矩阵做列选择即可得到所需单词的特征向量的。 说一下这一小节的感受,虽然最后吴大大也说了在实际操作中只需要做列选择就可以了,但是不明白他为什么还要介绍前面所谓的矩阵相乘运算。。。。 五、学习词嵌入 下图展示了预测单词的方法,即给出缺少一个单词的句子: “**I want a glass of orange ___**” 计算方法是将已知单词的特征向量都作为输入数据送到神经网络中去,然后经过一系列计算到达 Softmax分类层,在该例中输出节点数为10000个。经过计算juice概率最高,所以预测为 “I want a glass of orange juice” 在这个训练模式中,是通过全部的单词去预测最后一个单词然后反向传播更新词嵌表E 假设要预测的单词为W,词嵌表仍然为E,需要注意的是训练词嵌表和预测W是两个不同的任务。 如果任务是预测W,最佳方案是使用W前面n个单词构建语境。 如果任务是训练E,除了使用W前全部单词还可以通过:前后各4个单词、前面单独的一个词、前面语境中随机的一个词(这个方式也叫做 SkipGram 算法),这些方法都能提供很好的结果。 六、Word2Vec 视频中一直没有给 Word2Vec 下一个明确的定义,我们再次下一个非正式定义便于理解: “word2vec” 是指将词语word 变成向量vector 的过程,这一过程通常通过浅层的神经网络完成,例如CBOW或者skip gram,这一过程同样可以视为构建词嵌表E的过程”。 1.Skip-grams 下图详细的展示了Skip-grams。即先假设Context(上下文)是orange,而Target(预测词)则是通过设置窗口值得到的,例如设置为紧邻的后一个单词,此时Target则为juice,设置其他窗口值可以得到其他预测词。 注意这个过程是用来构建词嵌表的,而不是为了真正的去预测,所以如果预测效果不好并不用担心。 2.Skip-grams公式 Skip-grams模型可用如下表达式表示: \[O_{c}\rightarrow E \rightarrow e_{c} \rightarrow \underset{Softmax}{Output} \rightarrow \hat{y}\] Softmax公式为(假设输出节点数为10000): \[p(t|c)=\frac{e^{θ_t^Te_c}}{\sum_{j=1}^{10000}e^{θ_j^Te_c}}\] \(θ_t\) 表示与t有关的参数。 损失函数: \[l(\hat{y},y)=\sum_{i=1}^{10000}y_ilog\hat{y_i}\] 3.解决计算量大的问题 上面在使用Softmax的时候有一个很明显的问题,那就是计算量过于繁琐,所以为了解决计算量大的问题,提出了如下图所示的方法,即Hierachical Softmax(分层的Softmax) 简单的来说就是通过使用二叉树的形式来减少运算量。 例如一些常见的单词,如the、of等就可以在很浅的层次得到,而像durian这种少用的单词则在较深的层次得到。 七、负采样 对于skip gram model而言,还要解决的一个问题是如何取样(选择)有效的随机词 c 和目标词 t 呢?如果真的按照自然随机分布的方式去选择,可能会大量重复的选择到出现次数频率很高的单词比如说“the, of, a, it, I, ...” 重复的训练这样的单词没有特别大的意义。 如何有效的去训练选定的词如 orange 呢?在设置训练集时可以通过“负取样”的方法, 下表中第一行是通过和上面一 样的窗口法得到的“正”(1)结果,其他三行是从字典中随机得到的词语,结果为“负”(0)。通过这样的负取样法 可以更有效地去训练skip gram model. Context Word Target orange juice 1 orange king 0 orange book 0 orange the 0 orange of 0 负取样的个数k由数据量的大小而定,上述例子中为4. 实际中数据量大则 k = 2 ~ 5,数据量小则可以相对大一些k = 5 ~ 20 通过负取样,我们的神经网络训练从softmax预测每个词出现的频率变成了经典binary logistic regression问题,概率公式用 sigmoid 代替 softmax从而大大提高了速度。 \(x_1=(orange, juice) \rightarrow y_1=1\) \(x_2=(orange, king) \rightarrow y_2=0\) \(...\) \(P(y=1|c,t)=\sigma(\theta_t^Te_c)\) 最后我们通过一个并没有被理论验证但是实际效果很好的方式来确定每个被负选样选中的概率为: \(P(w_i)=\frac{f(w_i^{\frac{3}{4}})} {\sum_{j=1}^{10000}f(w_j^{\frac{3}{4}})}\) 八、GloVe词向量 GloVe(Global vectors for word representation)虽然不想Word2Vec模型那样流行,但是它也有自身的优点,即简单。 下面先介绍该算法定义的变量的含义: 如下图示,\(X_{ij}\)表示单词i在语境j中出现的次数,i就相当于前面内容中提到的t(target),j相当于之前的c(context)。 该算法的主要方法是最小化如下公式(假设共有10000个单词): \[\sum_{i=1}^{10000}\sum_{j=1}^{10000}f(x_{ij})(\theta_i^Te_j+b_i+b_j'-logx_{ij})^2\] 当\(x_{ij}=0\)时,\(f(x_{ij})=0\),并且定义\(0log0=0\)。 所以\(f(x_{ij})\)这么一个加权项就可以避免当\(x_{ij}=0\)时上面的式子是无穷大了。 同时对于像“the、of、a”等这些常用的词,加权项可以给与适当的权重。而对于像“durian”这类不常用到的单词,也可以给到更大但不至于过分的权重。 九、情绪分类 平时上淘宝我们都会对买的东西给出文字评价和对应的星级评价,如下图示。 商家可以通过对这些数据来构建一个情绪分类器,从而可以在一些社交平台上如微博、QQ等大家的文字评论然后对应输出相应的星级等级,这样就可以更容易知道自家店是蒸蒸日上还是日落西山了,2333。 下图展示了情绪分类器的模型。 可以看到下图中的模型先将评语中各个单词通过 词嵌表(数据量一般比较大,例如有100Billion的单词数) 转化成对应的特征向量,然后对所有的单词向量做求和或者做平均,然后构建Softmax分类器,最后输出星级评级。 但是上面的模型存在一个问题,一般而言如果评语中有像"good、excellent"这样的单词,一般都是星级评分较高的评语,但是该模型对下面这句评语就显得无能为力了: “Completely lacking in good taste, good service, and good ambience.” 该评语中出现大量的good,如果直接做求和或者平均运算,经过分类器得到的输出很大概率上是高星级评分的,但这显然与该评语的本意不符。 之所以上面的模型存在那样的缺点,就是因为它没有把单词的时序考虑进去,所以我们可以使用RNN构建模型来解决这种问题。RNN模型如下图示: 另外使用RNN模型还有另一个好处,假设测试集中的评语是这样的 “Completely absent of good taste, good service, and good ambience.” 该评语只是将lacking in替换成了absent of,而且我们即使假设absent并没有出现在训练集中,但是因为词嵌表很庞大,所以词嵌表中包含absent,所以算法依旧可以知道absent和lacking有相似之处,最后输出的结果也依然可以保持正确。 十、词嵌入除偏 现如今机器学习已经被用到了很多领域,例如银行贷款决策,简历筛选。但是因为机器是向人们学习,所以好的坏的都会学到,例如他也会学到一些偏见或者歧视。 如下图示 当说到Man:程序员的时候,算法得出Woman:家庭主妇,这显然存在偏见。 又如Man:Doctor,算法认为Woman:Nurse。这显然也存在其实和偏见。 上面提到的例子都是性别上的歧视,词嵌入也会反映出年龄歧视、性取向歧视以及种族歧视等等。 人类在这方面已经做的不对了,所以机器应当做出相应的调整来减少歧视。 下面将主要从性别歧视上来举例说明如何让机器学习消除偏见。 下图展示了一些单词,你可以在心里先想想你看到这些单词的第一时间认为他们所对应的性别是什么吧~~~ 下面正式介绍算法步骤: 1.识别偏见方向 因为该例子是以消除性别歧视为目的,所以我们需要计算出图中这些单词之间的距离的平均值,进而作为偏见方向(bias direction) \(e_{he}-e_{she}\) \(e_{boy}-e_{girl}\) \(e_{grandmother}-e_{grandfather}\) 将上面所求做平均运算,得到的向量方向即为偏见方向。 为方便理解,已在图中画出偏见方向,其余299D(除gender以外的其他单词特征)向量与偏见方向正交,也在下图中画出。 2.词性中和 像“boy,girl”这类词在性别词性上是很明确的,而且不存在歧视,所以无需中和(Neutralize)。 而图中的babysister、doctor则需要中和,具体方法就是将该词像非偏见方向投影得到一个新的坐标。 3.单词对等距离化 如下图示,虽然babysister中和化,但是它还是离grandmother更近,所以依旧带有偏见 所以我们还需要将grandmother、grandfather这类与性别有关的对应词等距分布在非偏见方向的两侧(红色剪头表示移动方向,红色点表示移动后的新坐标),如下图示。 MARSGGBO原创 2018-3-24