首页 文章 精选 留言 我的

精选列表

搜索[Vite构建],共10000篇文章
优秀的个人博客,低调大师

docker:快速构建容器监控系统cAdvisor+InfluxDB+Grafana

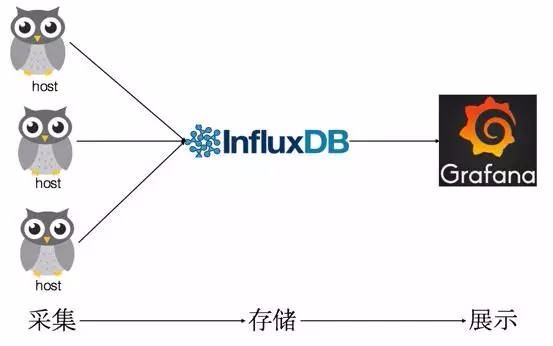
容器监控的方案有很多,有docker自身的docker stats命令、有Scout、有Data Dog等等,本文主要和大家分享一下比较经典的容器开源监控方案组合:cAdvisor+InfluxDB+Grafan。 1.概念 cAdvisor:用于数据采集 InfluxDB:用于数据存储 Grafana: 用于数据展示 1.1 cAdvisor 它是Google用来监测单节点的资源信息的监控工具。Cadvisor提供了一目了然的单节点多容器的资源监控功能。Google的Kubernetes中也缺省地将其作为单节点的资源监控工具,各个节点缺省会被安装上Cadvisor。总结起来主要两点: 展示 Host 和容器两个层次的监控数据。 展示历史变化数据。 由于 cAdvisor 提供的操作界面略显简陋,而且需要在不同页面之间跳转,并且只能监控一个 host,这不免会让人质疑它的实用性。但 cAdvisor 的一个亮点是它可以将监控到的数据导出给第三方工具,由这些工具进一步加工处理。 我们可以把 cAdvisor 定位为一个监控数据收集器,收集和导出数据是它的强项,而非展示数据。 1.2 InfluxDB InfluxDB 是用Go语言编写的一个开源分布式时序、事件和指标数据库,无需外部依赖。类似的数据库有Elasticsearch、Graphite等。 InfluxDB主要特色功能 基于时间序列,支持与时间有关的相关函数(如最大,最小,求和等); 可度量性:你可以实时对大量数据进行计算; 基于事件:它支持任意的事件数据; InfluxDB主要特点 无结构(无模式):可以是任意数量的列; 可拓展的; 支持min, max, sum, count, mean, median 等一系列函数,方便统计; 原生的HTTP支持,内置HTTP API; 强大的类SQL语法; 自带管理界面,方便使用; 1.3 Grafana Grafana是一个可视化面板(Dashboard),有着非常漂亮的图表和布局展示,功能齐全的度量仪表盘和图形编辑器,支持Graphite、zabbix、InfluxDB、Prometheus和OpenTSDB作为数据源。Grafana主要特性:灵活丰富的图形化选项;可以混合多种风格;支持白天和夜间模式;多个数据源。 2.部署过程 创建自定义网络monitor(自定义网络名称),用于后期容器加入此网络中,当然你也可以忽略此步; 创建Influxdb容器,创建数据用户、数据库; 创建cAdvisor容器; 创建Grafana容器,配置grafana; 3.开始部署 3.1 创建自定义网络 前面也说过了,你可以不用创建自定网络,作者只是为了把后期创建的cAdvisor+InfluxDB+Grafana这三个容器都加入自己定义的网络便于理解和管理,所以才新建一个自定义网络: [root@ganbing ~]# docker network create monitor cc193568263604e3bc3e7a5d78f18d07af99810e1d5c19bac99fccfa045f48f5 查看创建的网络: 3.2 创建influxdb容器 启动容器,tutum/influxdb这里没有指定版本,默认会pull最新版本的influxdb: [root@ganbing ~]# docker run -d --name influxdb --net monitor -p 8083:8083 -p 8086:8086 tutum/influxdb 参数说明:-d :后台运行此容器;--name :启运容器分配名字influxdb;--net : 把容器加入到新的网络monitor;-p :映射端口,8083端口为infuxdb后台控制端口,8086端口是infuxdb的数据端口;tutum/influxdb:通过这个容器来运行的,默认会在docker官方仓库pull下来; 查看influxdb容器是否启动: [root@ganbing ~]# docker ps -l CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 30b9789e680d tutum/influxdb "/run.sh" 22 seconds ago Up 21 seconds 0.0.0.0:8083->8083/tcp, 0.0.0.0:8086->8086/tcp influxdb 访问influxdb控制台,ip+8083端口访问: 从上图可以看到,在Query Templates选项中提供了常用的操作模板,可根据这些模版来管理influxdb,下面我们就来创建数据库和数据库用户。 创建cadvisor数据库cadvisor、用户root,用户和数据库大家可以自行随意定义,不一定要跟我一样,只是用于后期grafana的配置: CREATE USER "root" WITH PASSWORD '123456' WITH ALL PRIVILEGES CREATE DATABASE "cadvisor" 3.3 创建cadvisor容器 运行cadvisor容器: $docker run -d \ --name=cadvisor \ --net monitor \ -p 8080:8080 \ --mount type=bind,src=/,dst=/rootfs,ro \ --mount type=bind,src=/var/run,dst=/var/run \ --mount type=bind,src=/sys,dst=/sys,ro \ --mount type=bind,src=/var/lib/docker/,dst=/var/lib/docker,ro \ google/cadvisor \ -storage_driver=influxdb \ -storage_driver_db=cadvisor \ -storage_driver_host=influxdb:8086 参数说明:-d :后台运行此容器;--name :启运容器分配名字cadvisor;--net : 把容器加入到新的网络monitor;-p :映射端口8080;--mout:把宿主机的相文目录绑定到容器中,这些目录都是cadvisor需要采集的目录文件和监控内容;-storage_driver:需要指定cadvisor的存储驱动、数据库主机、数据库名;google/cadvisor:通过cadvisor这个镜像来运行容器,默认会在docker官方仓库把镜像pull下来; 查看cadvisor容器: [root@ganbing ~]# docker ps -l CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 90871ba5be7e google/cadvisor "/usr/bin/cadvisor -…" 51 seconds ago Up 50 seconds 0.0.0.0:8080->8080/tcp cadvisor 通过ip+8080端口访问测试一下,第一次访问这个页面有点慢:从上图可以看到,其实cadvisor也有基础的图形展示功能,我们这里主要用它来做数据采集。 3.4 创建granafa容器 运行granafa容器: [root@ganbing ~]# docker run -d --name grafana --net monitor -p 3000:3000 grafana/grafana 这里的参数比较简单,跟上面都差不多,不做详细解释。 查看运行结果: [root@ganbing ~]# docker ps -l CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES a90e03e2017a grafana/grafana "/run.sh" 17 seconds ago Up 16 seconds 0.0.0.0:3000->3000/tcp grafana 访问granfa,通过ip+3000端口的方式访问,默认账户密码(admin/admin): 添加数据源Add data source,如下图: 新建New dashboard,如下图: 新建了一个监控项之后,回来HOME,可以发现刚才创建的项目: 到这里cAdvisor+InfluxDB+Grafana容器监控系统就部署完成了,至于其它grafana的监控项配置不是本文的重点,就不在这里一一介绍其它监控项怎么玩了,大家如果感兴趣可以参考一些官方资料或者百度一些资料参阅,都是图形化的界面操作,多点、多玩、多测两个就搞明白了。 4.总结 监控没有最好、最优的监控方案,需要根据企业环境的自身特点结合每个监控产品的优势来达到监控的目的。一个企业完整的监控体系包括以下几个组成部分: 监控数据采集的时效与精确 监控数据采集存储与归档 监控数据的图形化展示 监控数据的自动化分析与联动处理 监控的告警及自动化处理 监控工具自身的安全控制 监控告警的响应及跟踪 喜欢我的文章,请点击最上方右角处的《关注》支持一下!

优秀的个人博客,低调大师

Coreseek + Sphinx + Mysql + PHP构建中文检索引擎

首先明确几个概念 Sphinx是开源的搜索引擎,它支持英文的全文检索。所以如果单独搭建Sphinx,你就已经可以使用全文索引了。但是往往我们要求的是中文索引,怎么做呢?国人提供了一个可供企业使用的,基于Sphinx的中文全文检索引擎。也就是说Coreseek实际上的内核还是Sphinx。那么他们的版本对应呢? Coreseek发布了3.2.14版本和4.1版本,其中的3.2.14版本是2010年发布的,它是基于Sphinx0.9.9搜索引擎的。而4.1版本是2011年发布的,它是基于Sphinx2.0.2的。Sphinx从0.9.9到2.0.2还是有改变了很多的,有很多功能,比如sql_attr_string等是在0.9.9上面不能使用的。所以在安装之前请判断清楚你需要安装的是哪个版本,在google问题的时候也要弄清楚这个问题的问题和答案是针对哪个版本的。我个人强烈建议使用4.1版本。 网上有一篇文章说的是Sphinx和Coreseek是怎么安装的,其中它的coreseek安装这部分使用coreseek-4.1来替换就可以使用了。 详细步骤看上面篇文章就理解了,这里说一下我在安装过程中遇到的几个问题: 安装mmseg的时候,./configure出现错误:config.status: error: cannot find input file: src/Makefile.in 这个时候需要先运行下automake 结果我运行的时候竟然提示automake的版本不对 所以这个时候,你可能需要去官网下个对应的版本(有可能是需要老版本)再来运行 在安装csrf的时候,文档提示需要指定mysql,但是我的mysql是yum安装的,找不到安装路径 1 2 3 4 5 ./configure --prefix=/usr/local/coreseek --with-mysql=/usr/local/mysql --with-mmseg=/usr/local/mmseg --with-mmseg-includes=/usr/local/mmseg/ include /mmseg/ --with-mmseg-libs=/usr/local/mmseg/lib/ yum安装的mysql的include和libs文件夹一般是安装在/usr/include/mysql和/usr/lib64/mysql下面 所以这里的--with-mysql可以使用--with-mysql-includes和--with-mysql-libs来进行替换。 1 2 3 4 5 ./configure --prefix=/usr/local/coreseek --with-mysql-includes=/usr/includes/mysql --with-mysql-libs=/usr/lib64/mysql/ --with-mmseg=/usr/local/mmseg --with-mmseg-includes=/usr/local/mmseg/ include /mmseg/ --with-mmseg-libs=/usr/local/mmseg/lib/ 配置文件提示unknown key: sql_attr_string 如上文,就需要检查下自己的sphinx版本了 如何安装php的sphinx扩展 可以在这里(http://pecl.php.net/package/sphinx)找到sphinx的php扩展源码 注意,使用phpize,configure的时候可能会要求要安装libsphinxclient,它在coreseek-4.1-beta/csft-4.1/api/libsphinxclient/里面能找到,编译安装它以后就可以configure,make,生成动态so文件了。 如何配置sphinx.conf配置文件 最复杂的部分就是sphinx.conf配置文件的配置了,里面的注释代码非常多,我建议使用的时候把注释代码去掉,我贴出自己使用的最简单的一个成功的配置文件: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 source src1 { type = mysql sql_host = localhost sql_user = yejianfeng sql_pass = test sql_db = mysite sql_port = 3306 # optional, default is 3306 sql_query_pre = SET NAMES utf8 sql_query_pre = SET SESSION query_cache_type=OFF sql_query = select id, id AS id_new,name, name AS name_query,descr, descr AS descr_query,city FROM account sql_attr_string = name sql_attr_string = descr sql_query_info = SELECT * FROM account WHERE id= $id } source src1throttled : src1 { sql_ranged_throttle = 100 } index test1 { source = src1 path = /home/yejianfeng/instance/coreseek/ var /data/test1 docinfo = extern mlock = 0 morphology = none min_word_len = 1 charset_type = zh_cn.utf-8 charset_dictpath = /home/yejianfeng/instance/mmseg/etc/ html_strip = 0 } indexer { mem_limit = 256M } searchd { listen = 9312 listen = 9306:mysql41 log = /home/yejianfeng/instance/coreseek/ var /log/searchd.log query_log = /home/yejianfeng/instance/coreseek/ var /log/query.log read_timeout = 5 client_timeout = 300 max_children = 30 pid_file = /home/yejianfeng/instance/coreseek/ var /log/searchd.pid max_matches = 1000 seamless_rotate = 1 preopen_indexes = 1 unlink_old = 1 mva_updates_pool = 1M max_packet_size = 8M max_filters = 256 max_filter_values = 4096 } php调用SphinxClient的例子如下: 首先要确保已经启动了searchd 1 2 3 [yejianfeng@AY130416142121702aac etc]$ ps aux|grep searchd 501 30897 0.0 0.0 60824 1396 pts/2 S 17:19 0:00 /home/yejianfeng/instance/coreseek/bin/searchd -c /home/yejianfeng/instance/coreseek/etc/sphinx.conf 501 30999 0.0 0.0 103232 856 pts/2 S+ 18:10 0:00 grep searchd php提供的调用SphinxClient的接口 1 2 3 4 5 6 7 8 9 <?php $s = new SphinxClient; $s ->setServer( "localhost" , 9312); $s ->setArrayResult(true); $s ->setSelect(); $s ->setMatchMode(SPH_MATCH_ALL); $result = $s ->query( '美女' , 'test1' ); print_r( $result ); 本文转自轩脉刃博客园博客,原文链接:http://www.cnblogs.com/yjf512/p/3581869.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

使用 ES decorators 构建一致性 API

![pic] 重用和一致性是程序设计中经久不衰的两个课题。在最新的 ES Proposal 中,「decorators 语法」为此带来了一定的便利,并且,很适合应用于大型的类库中。 装饰模式 提到 decorator 大家都不会陌生,即「装饰模式」—— 我们可以在「不侵入原有代码」的情况下,为代码增加一些「额外的功能」。 所谓「额外的功能」一般都比较独立,不和原有逻辑耦合,只是做一层包装。你也可以把它看成「包装模式」。形如: // 旧方法 function func() {} // 包装后的新方法 function funcWrapped() { // 有的没的 doSomethingBefore(); // 旧方法的过程本身并不变化 func(); // 这啊那的 doSomethingAfter

优秀的个人博客,低调大师

构建NTP时间服务器(以centos为例)

首先介绍一下NTP服务器的用途和基本知识。(来源于百度百科)NTP是网络时间协议(Network Time Protocol),它是用来同步网络中各个计算机的时间的协议。 在计算机的世界里,时间非常地重要,例如对于火箭发射这种科研活动,对时间的统一性和准确性要求就非常地高,是按照A这台计算机的时间,还是按照B这台计算机的时间?NTP就是用来解决这个问题的,NTP(Network Time Protocol,网络时间协议)是用来使网络中的各个计算机时间同步的一种协议。它的用途是把计算机的时钟同步到世界协调时UTC,其精度在局域网内可达0.1ms,在互联网上绝大多数的地方其精度可以达到1-50ms。 它可以使计算机对其服务器或时钟源(如石英钟,GPS等等)进行时间同步,它可以提供高精准度的时间校正,而且可以使用加密确认的方式来防止恶毒的协议攻击。 在NTP中,定义了时间按照服务器的等级传播,按照离外部UTC源远近将所有的服务器归入不同的Stratum(层)中,例如把通过GPS(Global Positioning System,全球定位系统)取得发送标准时间的服务器叫Stratum-1的NTP服务器,而Stratum-2则从Stratum-1获取时间,Stratum-3从Stratum-2获取时间,以此类推,但Stratum层的总数限制在15以内。所有这些服务器在逻辑上形成阶梯式的架构相互连接,而Stratum-1的时间服务器是整个系统的基础,这种阶梯式的架构示意图如图1所示。 好了(我想你一定时略过基础知识,直接看配置了吧),废话不多说,下面时详细的配置步骤: 实验环境:CentOS6.7虚拟机两台 服务端IP:192.168.1.3 客户端IP:192.168.1.4 注:红色字体标示配置命令或特别注意,蓝色标示理论解释。特别注意:请关掉服务端的防火墙或者开启远程客户端访问的123端口。操作为:编辑 vi/etc/sysconfig/iptables 加上下面这行 -A INPUT -m state --state NEW -m udp -p tcp --dport 123 -j ACCEPT —强烈建议做实验时直接关掉防火墙,不然你会烦死。 步骤1.服务端安装ntp ntpdate.可用命令yum -y install ntp ntpdate(使用Yum时请确定虚拟机能连上网,虚拟机工作在桥接模式或者NAT模式下),客户端安装ntpdate,同样的命令yum -y install ntpdate。 步骤2.修改服务端的配置文件。文件目录/etc/ntp.conf。为了确保配置出错无法拯救,先备份文件。 cp /etc/ntp.conf /etc/ntp.conf.bak 下面修改配置文件 vi /etc/ntp.conf (该文件只需要配置主要的两部分:权限、连接远程服务器。添加允许访问你ntp服务器的网路或者主机。) 增加:restrict 192.168.0.0 mask 255.255.0.0 nomodify notrap restrict 192.168.1.0 mask 255.255.255.0 nomodify notrap(restrict格式:restrict [ip] mask [mask_number] [parameter]其中parameter如下:ignore:拒绝所有类型的ntp连接,nomodify:不允许客户端修改服务器的时间参数,但是允许客户端透过这部主机进行时间校验。noquery:不允许客户端进行时间校验。notrap:不提供trap时间登录。notrust:拒绝没有认证的客户端;然后设置server段,设置上层ntp服务器。具体格式:server [IP or HOSTNAME] [PREFER]国内经常用到的ntp服务器有如下: ntp.sjtu.edu.cn s1a.time.edu.cn s1b.time.edu.cn s1c.time.edu.cn s1d.time.edu.cn s1e.time.edu.cn s2a.time.edu.cn s2b.time.edu.cn s2c.time.edu.cn s2d.time.edu.cn s2e.time.edu.cn s2f.time.edu.cn s2g.time.edu.cn s2h.time.edu.cn s2j.time.edu.cn s2k.time.edu.cn s2m.time.edu.cn clock.cuhk.edu.hk) 注释或者删掉(行首加#号注释)0.centos.pool.ntp.org、1.centos.pool.ntp.org、2.centos.pool.ntp.org,添加上述的服务器之一即可,如下所示: server ntp.sjtu.edu.cn server s1a.time.edu.cn 保存后退出 步骤3.在服务端启动你的NTP服务,并设为开机自启动。 步骤4.检查ntp启动情况 显示有UPD的123端口,证明ntp启动成功。 步骤5.运行ntpstat检测ntp服务器是否于上层服务器连接,如图显示证明成功连接202.118.1.130,如果不成,请等待一分钟在检测。 步骤6.客户端连接ntp服务端。建议客户端只需要用ntpdate + 服务端IP地址的命令向服务器提出同步请求即可,然后利用hwclock -w 命令进行写入客户端的BIOS。如果需要定时同步,可以利用crontab每小时(或者每分钟)同步一次即可,这里我用的时每分钟。 crontab -e #编辑定时任务 */1 * * * * /usr/sbin/ntpdate 192.168.1.3 >>/usr/local/logs/crontab/ntpdate.log crontab -l #查看任务 配置结束。 本文转自 河北李晓东 51CTO博客,原文链接:http://blog.51cto.com/lixiaodong2016/1787639,如需转载请自行联系原作者

优秀的个人博客,低调大师

构建基于GFS文件系统的RHCS架构集群

先创建共享存储服务器: [root@station39 ~]# yum install scsi-target-utils -y [root@station39 ~]# service tgtd start 查看下3260端口是否启动。 此时仅仅是提供的服务还没有提供任何共享的存储设备。 新建一个分区sda5,但是不要格式化: 新建一个target: [root@primary ~]# tgtadm --lld iscsi --op new --mode target --tid 1 -T iqn.2011-04.com.a.linux:appdata [root@primary ~]# tgtadm --lld iscsi --op show --mode target 新建一个逻辑单元: [root@primary ~]# tgtadm --lld iscsi --op new --mode logicalunit --tid 1 --lun 1 -b /dev/sda5 [root@primary ~]# tgtadm --lld iscsi --op show --mode target 默认情况下SCSI设备禁止任何人访问。 设置访问控制权限: [root@primary ~]# tgtadm --lld iscsi --op bind --mode target --tid 1 -I 192.168.0.0/24 [root@primary ~]# tgtadm --lld iscsi --op show --mode target OK,此时共享设备就可以被客户端访问挂载了。 三个节点: node1.a.com 192.168.0.127 node2.a.com 192.168.0.61 node3.a.com 192.168.0.23 首先确保三台节点上iscsi-initiator-utils,ricci都安装完毕,在其中一个节点上安装luci。 yum install iscsi-initiator-utils -y yum install ricci -y yum install luci -y 编辑/etc/hosts 文件,确保三台节点之间可以互相解析。 192.168.0.127 node1.a.com node1 192.168.0.61 node2.a.com node2 192.168.0.23 node3.a.com node3 分别在每台节点上编辑/etc/iscsi/initiatorname.iscsi文件,给共享存储起一个别名: InitiatorName=iqn.2011-04.com.a.node1/2/3 启动iscsi,ricci服务 ,启动一台节点上的luci服务。 使用浏览器访问https://192.168.0.23/8084开始创建集群: cluster---->Create a New Cluster 给每个节点添加fence: 添加故障转移域: 在任意一个节点上查看集群状态: # cman_tool status # clustat 实现分布式文件锁: #service rgmangager start 配置LVM支持集群的形式: #lvmconf –enable-cluster #service clvmd start 查看GFS的模块是否已经加载: #lsmod | grep gfs 启动GFS文件系统: #service gfs start #service gfs2 start 将远端的共享存储挂载到节点上 #iscsiadm –m discovery –t sendtargets –p 192.168.0.39 #iscsiadm –m node –T iqn.2011-04.com.a.linux.appdata –p 192.168.0. 39 –l 在任意一个节点上对挂载的共享存储设备创建LVM: #pvcreate /dev/sdb #vgcreate vg1 /dev/sdb #lvcreate –L 5G –n gfsdata vg1 LVM已经创建成功,下面将vg1格式化为GFS文件系统: #gfs_mkfs –p lock_dlm –t gfs:gfsdata –j 5 /dev/vg1/gfsdata 挂载到本地目录下: mount –t gfs /dve/vg1/gfsdata /gfs 此时,无论你在哪个节点上对文件系统进行创建或者修改文件,其他节点上均可以看到。 本文转自 490999122 51CTO博客,原文链接:http://blog.51cto.com/lyp0909/550640,如需转载请自行联系原作者

优秀的个人博客,低调大师

使用Docker和saltstack构建运维paas管理平台

扯淡开始: 最近有些忙,换了份差事,开始做纯开发了。但是还放不下运维的那些东西。 现在的运维朋友最常说的可能就是运维自动化了,刚培训出来的小孩,也是满口的自动化管理,让你听的发蒙 。 呵呵 ! 只是有些时候环境的部署虽然有自动化的脚本定制,但是还是会耗时间,运气差了会安不上 。 现有不少公司学的聪明了,针对一些服务做了模板的定制,比如利用kvm的模板来快速的生成主机。 像linode那样,你买主机,可以直接选定服务类型的模板。 但我们这里说的是 更加低耗的Docker容器,他避免了hypervisor层和虚拟层上面的guest os层的性能消耗。 一台服务器,跑vm主机也就能跑个10几个,当然你也可以超出。如果用docker的话,一般来说承载能力是更强的。 但是docker的缺点也明显,做资源的控制不是那么容易,可能水平不到家呀 ! 我曾经用过google的gae 和新浪的云sae,前段时间又稳固而执行了下。又尝试了下 百度的bae,百度的bae也是利用docker开发的。 这三个用法都差不多,申请服务就立马可以用,软件及服务。 和搜狗的一个朋友一直在聊paas运维管理,想要实现一个针对运维方面的云平台,现在一说云,大家一般都是想到的openstack、cloudstack这样的云平台,其实lxc docker的出现,使paas管理实现不是个事 ! 这里简单说下运维paas平台的想法和思路。 以前看过 sohu 云景那边对于docker的分享,感觉不错。 sohu 云景一开始做paas是为了解决运维的,后来才慢慢扩展成一个对外开放的paas。 我想要的功能很简单,一个加强版的shipyard,shipyard 的功能还行,只是缺少一个写个流程性质的东西。当然你可以二次开发。 但我觉得没那个必要了,我们可以自己写个简单的集成权限控制和管理的paas平台。 权限管理可以配合cmdb资产的对比。定位到你的主机,你只能申请那个网络区域的服务器机组。 你的主机是南苑的,只能申请南苑的docker容器 。 原文:http://rfyiamcool.blog.51cto.com/1030776/1543840 管理的话可以调用docker remote api,但个人不太喜欢。 既然打算用python做平台开发,docker 又提供了docker-py这个完美的api。 这里题外说下,saltstack docker的一些官方的应用。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 built corp /mysuperdocker_img : docker.built: -path: /path/to/dir/container pulled ubuntu: docker.pulled: -tag:latest pushed corp /mysuperdocker_img : docker.pushed installed mysuperdocker-container: docker.installed: -name:mysuperdocker - hostname :superdocker -image:corp /mysuperdocker_img loaded mysuperdocker- file : docker.loaded: -name:mysuperdocker - source :salt: //_files/tmp/docker_image . tar running my_service: docker.running: -container:mysuperdocker -port_bindings: "5000/tcp" : HostIp: "" HostPort: "5000" run /finish-install .sh: docker.run: -container:mysuperdocker -unless: grep -qsomething /var/log/foo -docker_unless: grep -q done /install_log 算了看起来着实有些费劲,咱们自己把docker-py搞成saltstack的模块,这样就很容易扩展应用,不用太关注安全,像如果用mq和rpc的话,还要想一些应用层面的安全问题,甚是蛋疼。 下面做了小片的功能 , 其实主要还是想法,大家有时间都在自己公司折腾实现下吧。 关于文档 看saltstack的api,然后用docker api的使用,那下面的这玩意也绝对可以做出来了。 原文:http://rfyiamcool.blog.51cto.com/1030776/1543840 运维平台也做了不少,不知道为啥现在总是提不起精神 ~ 啥事做多了也就干吐了,别想歪了。 呵呵 有时间再说,忙 ! 本文转自 rfyiamcool 51CTO博客,原文链接:http://blog.51cto.com/rfyiamcool/1543840,如需转载请自行联系原作者

优秀的个人博客,低调大师

springCloud(13):使用Zuul构建微服务网关-简介

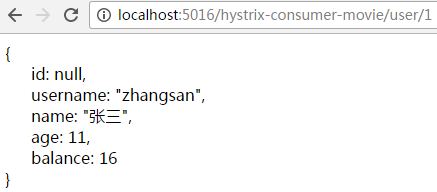
一、为什么要使用微服务网关 不同的微服务一般会有不同的网络地址,而外部客户端可能需要调用多个服务的接口才能完成一个业务需求。如:一个电影购票的手机APP,可能会调用多个微服务,才能完成一次购票的业务流程。如果让客户端直接与各个微服务通信,会有以下的问题: 1、客户端会多次请求不同的微服务,增加了客户端的复杂性; 2、存在跨域请求,在一定场景下处理相对复杂; 3、认证复杂,每个服务都需要独立认证; 4、难以重构,随着项目的迭代,可能需要重新划分微服务,如果客户端直接与微服务通信,那么重构将会很难实施; 5、某些微服务可能使用了防火墙/浏览器不友好的协议,直接访问会有一定的困难。 以上问题可借助微服务网关解决,微服务网关是介于客户端和服务端之间的中间层,所有的外部请求都会先经过微服务网关,然后由微服务网关请求各个微服务。 微服务网关封装了应用程序的内部结构,客户端只须跟网关交互,而无须直接调用特定微服务的接口,这样,开发就可以得到简化。不仅如此,使用微服务网关还有以下优点: 1、易于监控。可在微服务网关收集监控数据并将其推送到外部系统进行分析; 2、易于认证。可在微服务网关上进行认证,然后再将请求转发到后端的微服务,而无须再每个微服务中进行认证; 3、减少了客户端与各个微服务之间的交互次数。 二、Zuul简介 Zuul是Netflix开源的微服务网关,它可以和Eureka、Ribbon、Hystrix等组件配合使用。 Zuul的核心是一系列的过滤器,这些过滤器可以完成以下功能: 1、身份认证与安全:识别每个资源的验证要求,并拒绝那些与要求不符的请求; 2、审查与监控:在边缘位置追踪有意义的数据和统计结果,从而带来精确的生产视图; 3、动态路由:动态地将请求路由到不同的后端集群; 4、压力测试:逐渐增加指向集群的流量,以了解性能; 5、负载分配:为每一种负载类型分配对应容量,并弃用超出限定值的请求; 6、静态响应处理:在边缘位置直接建立部分响应,从而避免其转发到内部集群; 7、多区域弹性:跨域AWS Region进行请求路由。 Spring Cloud对Zuul进行了整合与增强。目前,Zuul使用的默认HTTP客户端是Apache HTTP Client。 三、编写一个Zuul微服务网关 1、添加依赖 1 2 3 4 5 <!--zuul--> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-zuul</artifactId> </dependency> 2、在启动类上添加@EnableZuulProxy注解,声明一个Zuul代理,改代理使用Ribbon来定位注册在EurekaServer中的微服务;同时,改代理还整合了hystrix,所有经过Zuul的请求都会在Hystrix命令中执行。 3、编写application.yml 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 spring: profiles: active: -dev application: name:microservice-gateway-zuul eureka: client: service-url: defaultZone:http://liuy2:5010/eureka/ #设置与EurekaServer交互的地址,查询服务和注册服务都需要依赖这个地址,多个用逗号分隔 instance: prefer-ip-address:true --- spring: profiles: active:dev server: port:5016 这样,一个简单的微服务网关就编写完成了。这里仅是添加了Zuul的依赖,并将Zuul注册到Eureka Server上。 四、测试 4.1、测试路由规则 1、依次启动eureka-server(4010)、provide-user(4011)、hystrix-consumer-movie(5012)、microservice-gateway-zuul(5016) 2、访问http://localhost:5016/hystrix-consumer-movie/user/1,请求会被转发到http://localhost:5012/user/1 3、访问http://localhost:5016/provide-user/1,请求会被转发到http://localhost:4011/1 总结: 说明默认情况下,Zuul会代理所有注册到Eureka Server的微服务,并且Zuul的路由规则如下:http://ZUUL_HOST:ZUUL_PORT/微服务在Eureka上的serviceId/**会被转发到serviceId对应的微服务。 4.2、测试Hystrix容错与监控 1、依次启动eureka-server(4010)、provide-user(4011)、hystrix-consumer-movie(5012)、microservice-gateway-zuul(5016)、hystrix-dashboard(5013) 2、访问http://localhost:5016/hystrix-consumer-movie/user/1,可以获取正常用户数据 3、关闭provide-user微服务,再访问http://localhost:5016/hystrix-consumer-movie/user/1 4、访问http://localhost:5013/hystrix.stream进入Hystrix Dashboard页面,在URL栏输入http://localhost:5016/hystrix.stream,随意指定一个title,点击monitor Stream按钮。 总结:说明Zuul已经整合了Hystrix。 本文转自我爱大金子博客51CTO博客,原文链接http://blog.51cto.com/1754966750/1958373如需转载请自行联系原作者 我爱大金子

优秀的个人博客,低调大师

用commit方式构建具有sshd服务的centos镜像

1.从远程仓库中pull centos镜像 docker pull centos 2.查询镜像docker images [root@HA2 kehj]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE nginx-docker v1 20c4d11561d3 11 hours ago 451.1 MB docker.io/nginx latest f895b3fb9e30 2 weeks ago 108.5 MB docker.io/centos latest 3fa822599e10 3 weeks ago 203.5 MB docker.io/ubuntu latest 747cb2d60bbe 11 weeks ago 122 MB 3.启动centos容器 docker run -i -t centos /bin/bash [root@HA2 kehj]# docker run -i -t centos /bin/bash [root@f2595a1c0aae /]# 4.安装sshd服务 [root@f2595a1c0aae /]# yum install passwd openssl openssh-server -y Loaded plugins: fastestmirror, ovl base | 3.6 kB 00:00:00 extras | 3.4 kB 00:00:00 updates | 3.4 kB 00:00:00 (1/4): extras/7/x86_64/primary_db | 145 kB 00:00:01 (2/4): base/7/x86_64/group_gz | 156 kB 00:00:01 (3/4): updates/7/x86_64/primary_db | 4.6 MB 00:00:15 (4/4): base/7/x86_64/primary_db | 5.7 MB 00:00:23 Determining fastest mirrors * base: mirrors.163.com * extras: mirrors.163.com * updates: mirrors.163.com Package passwd-0.79-4.el7.x86_64 already installed and latest version Resolving Dependencies --> Running transaction check ---> Package openssh-server.x86_64 0:7.4p1-13.el7_4 will be installed --> Processing Dependency: openssh = 7.4p1-13.el7_4 for package: openssh-server-7.4p1-13.el7_4.x86_64 --> Processing Dependency: fipscheck-lib(x86-64) >= 1.3.0 for package: openssh-server-7.4p1-13.el7_4.x86_64 --> Processing Dependency: libwrap.so.0()(64bit) for package: openssh-server-7.4p1-13.el7_4.x86_64 --> Processing Dependency: libfipscheck.so.1()(64bit) for package: openssh-server-7.4p1-13.el7_4.x86_64 ---> Package openssl.x86_64 1:1.0.2k-8.el7 will be installed --> Processing Dependency: make for package: 1:openssl-1.0.2k-8.el7.x86_64 --> Running transaction check ---> Package fipscheck-lib.x86_64 0:1.4.1-6.el7 will be installed --> Processing Dependency: /usr/bin/fipscheck for package: fipscheck-lib-1.4.1-6.el7.x86_64 ---> Package make.x86_64 1:3.82-23.el7 will be installed ---> Package openssh.x86_64 0:7.4p1-13.el7_4 will be installed ---> Package tcp_wrappers-libs.x86_64 0:7.6-77.el7 will be installed --> Running transaction check ---> Package fipscheck.x86_64 0:1.4.1-6.el7 will be installed --> Finished Dependency Resolution Dependencies Resolved ==================================================================================================================== Package Arch Version Repository Size ==================================================================================================================== Installing: openssh-server x86_64 7.4p1-13.el7_4 updates 458 k openssl x86_64 1:1.0.2k-8.el7 base 492 k Installing for dependencies: fipscheck x86_64 1.4.1-6.el7 base 21 k fipscheck-lib x86_64 1.4.1-6.el7 base 11 k make x86_64 1:3.82-23.el7 base 420 k openssh x86_64 7.4p1-13.el7_4 updates 509 k tcp_wrappers-libs x86_64 7.6-77.el7 base 66 k Transaction Summary ==================================================================================================================== Install 2 Packages (+5 Dependent packages) Total download size: 1.9 M Installed size: 4.9 M Downloading packages: warning: /var/cache/yum/x86_64/7/base/packages/fipscheck-lib-1.4.1-6.el7.x86_64.rpm: Header V3 RSA/SHA256 Signature, key ID f4a80eb5: NOKEY Public key for fipscheck-lib-1.4.1-6.el7.x86_64.rpm is not installed (1/7): fipscheck-lib-1.4.1-6.el7.x86_64.rpm | 11 kB 00:00:00 (2/7): fipscheck-1.4.1-6.el7.x86_64.rpm | 21 kB 00:00:00 Public key for openssh-7.4p1-13.el7_4.x86_64.rpm is not installed ] 206 kB/s | 681 kB 00:00:06 ETA (3/7): openssh-7.4p1-13.el7_4.x86_64.rpm | 509 kB 00:00:01 (4/7): tcp_wrappers-libs-7.6-77.el7.x86_64.rpm | 66 kB 00:00:01 (5/7): openssl-1.0.2k-8.el7.x86_64.rpm | 492 kB 00:00:02 (6/7): openssh-server-7.4p1-13.el7_4.x86_64.rpm | 458 kB 00:00:03 (7/7): make-3.82-23.el7.x86_64.rpm | 420 kB 00:00:04 -------------------------------------------------------------------------------------------------------------------- Total 403 kB/s | 1.9 MB 00:00:04 Retrieving key from file:///etc/pki/rpm-gpg/RPM-GPG-KEY-CentOS-7 Importing GPG key 0xF4A80EB5: Userid : "CentOS-7 Key (CentOS 7 Official Signing Key) <security@centos.org>" Fingerprint: 6341 ab27 53d7 8a78 a7c2 7bb1 24c6 a8a7 f4a8 0eb5 Package : centos-release-7-4.1708.el7.centos.x86_64 (@CentOS) From : /etc/pki/rpm-gpg/RPM-GPG-KEY-CentOS-7 Running transaction check Running transaction test Transaction test succeeded Running transaction Installing : fipscheck-1.4.1-6.el7.x86_64 1/7 Installing : fipscheck-lib-1.4.1-6.el7.x86_64 2/7 Installing : openssh-7.4p1-13.el7_4.x86_64 3/7 Installing : 1:make-3.82-23.el7.x86_64 4/7 Installing : tcp_wrappers-libs-7.6-77.el7.x86_64 5/7 Installing : openssh-server-7.4p1-13.el7_4.x86_64 6/7 Installing : 1:openssl-1.0.2k-8.el7.x86_64 7/7 Verifying : fipscheck-lib-1.4.1-6.el7.x86_64 1/7 Verifying : 1:openssl-1.0.2k-8.el7.x86_64 2/7 Verifying : tcp_wrappers-libs-7.6-77.el7.x86_64 3/7 Verifying : fipscheck-1.4.1-6.el7.x86_64 4/7 Verifying : openssh-7.4p1-13.el7_4.x86_64 5/7 Verifying : openssh-server-7.4p1-13.el7_4.x86_64 6/7 Verifying : 1:make-3.82-23.el7.x86_64 Installed: openssh-server.x86_64 0:7.4p1-13.el7_4 openssl Dependency Installed: fipscheck.x86_64 0:1.4.1-6.el7 fipscheck-lib.x86_64 0:1.4.1-6.el7 make.x86_64 1:3.82-23.el7 Complete! 5.执行 /usr/sbin/sshd -D,报错: [root@f2595a1c0aae /]# /usr/sbin/sshd -D Could not load host key: /etc/ssh/ssh_host_rsa_key Could not load host key: /etc/ssh/ssh_host_ecdsa_key Could not load host key: /etc/ssh/ssh_host_ed25519_key sshd: no hostkeys available -- exiting. 6.执行以下三条命令: ssh-keygen -q -t rsa -b 2048 -f /etc/ssh/ssh_host_rsa_key -N '' ssh-keygen -q -t ecdsa -f /etc/ssh/ssh_host_ecdsa_key -N '' ssh-keygen -t dsa -f /etc/ssh/ssh_host_ed25519_key -N '' [root@f2595a1c0aae /]# ssh-keygen -q -t rsa -b 2048 -f /etc/ssh/ssh_host_rsa_key -N '' [root@f2595a1c0aae /]# ssh-keygen -q -t ecdsa -f /etc/ssh/ssh_host_ecdsa_key -N '' [root@f2595a1c0aae /]# ssh-keygen -t dsa -f /etc/ssh/ssh_host_ed25519_key -N '' Generating public/private dsa key pair. Your identification has been saved in /etc/ssh/ssh_host_ed25519_key. Your public key has been saved in /etc/ssh/ssh_host_ed25519_key.pub. The key fingerprint is: SHA256:U9G/RvoqxZtn/9oTzTwba8t8b3P2KoTYQ7nbC9aD7M4 root@f2595a1c0aae The key's randomart image is: +---[DSA 1024]----+ | .. | | .. | | .. . | | .o o | | S+ + o +.| | .o=o= o++| | =*o= *| | +o.=.*B=| | .E.o*+X/| +----[SHA256]-----+ 7.vi /etc/ssh/sshd_config 修改配置文件 UsePAM yes 修改为 UsePAM no UsePrivilegeSeparation sandbox 修改改为 UsePrivilegeSeparation no 8.修改密码passwd root [root@f2595a1c0aae/]# passwd root Changing password for user root. New password: BAD PASSWORD: The password is shorter than 8 characters Retype new password: passwd: all authentication tokens updated successfully. 9.exit退出容器 10.执行提交命令,生成镜像 docker commit -m "add sshd" -a "kehaojian"f2595a1c0aaesshd_centos [root@HA2 kehj]# docker commit -m "add sshd" -a "kehaojian" f2595a1c0aae sshd_centos sha256:0ece1cad37782006b4175fb6f7268aac206d8729b6a844eabdd999240e904f9a 11.执行docker images [root@HA2 kehj]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE sshd_centos latest 0ece1cad3778 8 seconds ago 293.3 MB nginx-docker v1 20c4d11561d3 11 hours ago 451.1 MB docker.io/nginx latest f895b3fb9e30 2 weeks ago 108.5 MB docker.io/centos latest 3fa822599e10 3 weeks ago 203.5 MB docker.io/ubuntu latest 747cb2d60bbe 11 weeks ago 122 MB 12.测试 [kehj@HA2 ~]$ ssh root@localhost -p 10022 The authenticity of host '[localhost]:10022 ([::1]:10022)' can't be established. ECDSA key fingerprint is SHA256:wFHqfr8EPuT5cUla5cllCBf0HQ5GnTmZruj0LQI8VRg. ECDSA key fingerprint is MD5:74:6a:da:84:64:35:50:78:c8:9a:38:de:45:f3:71:16. Are you sure you want to continue connecting (yes/no)? yes Warning: Permanently added '[localhost]:10022' (ECDSA) to the list of known hosts. root@localhost's password: [root@e14d9841c1e6 ~]# 本文转自gauyanm 51CTO博客,原文链接:http://blog.51cto.com/gauyanm/2055270,如需转载请自行联系原作者

优秀的个人博客,低调大师

使用python构建基于hadoop的mapreduce日志分析平台

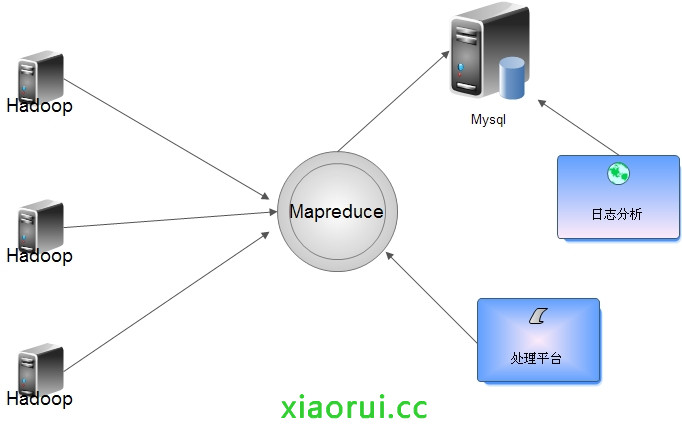
出处:http://rfyiamcool.blog.51cto.com/1030776/1340057 流量比较大的日志要是直接写入Hadoop对Namenode负载过大,所以入库前合并,可以把各个节点的日志凑并成一个文件写入HDFS。 根据情况定期合成,写入到hdfs里面。 咱们看看日志的大小,200G的dns日志文件,我压缩到了18G,要是用awk perl当然也可以,但是处理速度肯定没有分布式那样的给力。 Hadoop Streaming原理 mapper和reducer会从标准输入中读取用户数据,一行一行处理后发送给标准输出。Streaming工具会创建MapReduce作业,发送给各个tasktracker,同时监控整个作业的执行过程。 任何语言,只要是方便接收标准输入输出就可以做mapreduce~ 再搞之前我们先简单测试下shell模拟mapreduce的性能速度~ 看下他的结果,350M的文件用时35秒左右。 这是2G的日志文件,居然用了3分钟。 当然和我写的脚本也有问题,我们是模拟mapreduce的方式,而不是调用shell下牛逼的awk,gawk处理。 awk的速度 !果然很霸道,处理日志的时候,我也很喜欢用awk,只是学习的难度有点大,不像别的shell组件那么灵活简单。 这是官方的提供的两个demo ~ map.py 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 #!/usr/bin/env python "" "A more advanced Mapper, using Python iterators and generators." "" import sys def read_input(file): for line in file: # split the line into words yield line.split() def main(separator= '\t' ): # input comes from STDIN (standard input) data = read_input(sys.stdin) for words in data: # write the results to STDOUT (standard output); # what we output here will be the input for the # Reduce step, i.e. the input for reducer.py # # tab-delimited; the trivial word count is 1 for word in words: print '%s%s%d' % (word, separator, 1 ) if __name__ == "__main__" : main() reduce.py的修改方式 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 #!/usr/bin/env python "" "A more advanced Reducer, using Python iterators and generators." "" from itertools import groupby from operator import itemgetter import sys def read_mapper_output(file, separator= '\t' ): for line in file: yield line.rstrip().split(separator, 1 ) def main(separator= '\t' ): # input comes from STDIN (standard input) data = read_mapper_output(sys.stdin, separator=separator) # groupby groups multiple word-count pairs by word, # and creates an iterator that returns consecutive keys and their group: # current_word - string containing a word (the key) # group - iterator yielding all [ "<current_word>" , "<count>" ] items for current_word, group in groupby(data, itemgetter( 0 )): try : total_count = sum( int (count) for current_word, count in group) print "%s%s%d" % (current_word, separator, total_count) except ValueError: # count was not a number, so silently discard this item pass if __name__ == "__main__" : main() 咱们再简单点: 1 2 3 4 5 6 7 #!/usr/bin/env python import sys for line in sys.stdin: line = line.strip() words = line.split() for word in words: print '%s\t%s' % (word, 1 ) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 #!/usr/bin/env python from operator import itemgetter import sys current_word = None current_count = 0 word = None for line in sys.stdin: line = line.strip() word, count = line.split( '\t' , 1 ) try : count = int (count) except ValueError: continue if current_word == word: current_count += count else : if current_word: print '%s\t%s' % (current_word, current_count) current_count = count current_word = word if current_word == word: print '%s\t%s' % (current_word, current_count) 咱们就简单模拟下数据,跑个测试 剩下就没啥了,在hadoop集群环境下,运行hadoop的steaming.jar组件,加入mapreduce的脚本,指定输出就行了. 下面的例子我用的是shell的成分。 1 2 3 4 5 [root@ 101 cron]#$HADOOP_HOME/bin/hadoop jar $HADOOP_HOME/contrib/streaming/hadoop-*-streaming.jar \ -input myInputDirs \ -output myOutputDir \ -mapper cat \ -reducer wc 详细的参数,对于咱们来说提供性能可以把tasks的任务数增加下,根据情况自己测试下,也别太高了,增加负担。 (1)-input:输入文件路径 (2)-output:输出文件路径 (3)-mapper:用户自己写的mapper程序,可以是可执行文件或者脚本 (4)-reducer:用户自己写的reducer程序,可以是可执行文件或者脚本 (5)-file:打包文件到提交的作业中,可以是mapper或者reducer要用的输入文件,如配置文件,字典等。 (6)-partitioner:用户自定义的partitioner程序 (7)-combiner:用户自定义的combiner程序(必须用java实现) (8)-D:作业的一些属性(以前用的是-jonconf),具体有: 1)mapred.map.tasks:map task数目 2)mapred.reduce.tasks:reduce task数目 3)stream.map.input.field.separator/stream.map.output.field.separator: map task输入/输出数 据的分隔符,默认均为\t。 4)stream.num.map.output.key.fields:指定map task输出记录中key所占的域数目 5)stream.reduce.input.field.separator/stream.reduce.output.field.separator:reduce task输入/输出数据的分隔符,默认均为\t。 6)stream.num.reduce.output.key.fields:指定reduce task输出记录中key所占的域数目 这里是统计dns的日志文件有多少行 ~ 在mapreduce作为参数的时候,不能用太多太复杂的shell语言,他不懂的~ 可以写成shell文件的模式; 1 2 3 4 5 6 7 8 #! /bin/bash while read LINE; do # for word in $LINE # do # echo "$word 1" awk '{print $5}' done done 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 #! /bin/bash count= 0 started= 0 word= "" while read LINE; do goodk=`echo $LINE | cut -d ' ' -f 1 ` if [ "x" == x "$goodk" ];then continue fi if [ "$word" != "$goodk" ];then [ $started -ne 0 ] && echo -e "$word\t$count" word=$goodk count= 1 started= 1 else count=$(( $count + 1 )) fi done 有时候会出现这样的问题,好好看看自己写的mapreduce程序 ~ 13/12/14 13:26:52 INFO streaming.StreamJob: Tracking URL: http://101.rui.com:50030/jobdetails.jsp?jobid=job_201312131904_0030 13/12/14 13:26:53 INFO streaming.StreamJob: map 0% reduce 0% 13/12/14 13:27:16 INFO streaming.StreamJob: map 100% reduce 100% 13/12/14 13:27:16 INFO streaming.StreamJob: To kill this job, run: 13/12/14 13:27:16 INFO streaming.StreamJob: /usr/local/hadoop/libexec/../bin/hadoop job -Dmapred.job.tracker=localhost:9001 -kill job_201312131904_0030 13/12/14 13:27:16 INFO streaming.StreamJob: Tracking URL: http://101.rui.com:50030/jobdetails.jsp?jobid=job_201312131904_0030 13/12/14 13:27:16 ERROR streaming.StreamJob: Job not successful. Error: # of failed Map Tasks exceeded allowed limit. FailedCount: 1. LastFailedTask: task_201312131904_0030_m_000000 13/12/14 13:27:16 INFO streaming.StreamJob: killJob... Streaming Command Failed! python做为mapreduce执行成功后,结果和日志一般是放在你指定的目录下的,结果是在part-00000文件里面~ 本文转自大角牛博客51CTO博客,原文链接http://blog.51cto.com/jingshengsun888/1341123如需转载请自行联系原作者 运维的戏子


资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册