首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

图解kubernetes资源QOS机制实现原理

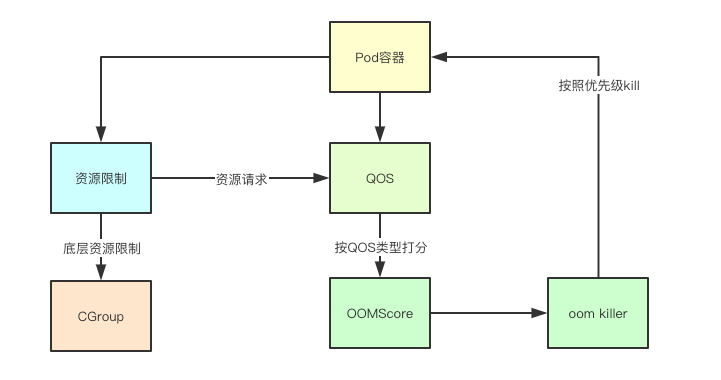
QOS是k8s中一种资源保护机制,其主要是针对不可压缩资源比如的内存的一种控制技术,比如在内存中其通过为不同的Pod和容器构造OOM评分,并且通过内核的策略的辅助,从而实现当节点内存资源不足的时候,内核可以按照策略的优先级,优先kill掉哪些优先级比较低(分值越高优先级越低)的Pod,今天来分析下背后的实现 1.关键基础特性 1.1 一切皆文件 在Linux中一切皆文件,控制CGroup本身也是通过配置文件进行的,这是我创建的一个内存Lmits为200M的Pod的容器的配置 # pwd /sys/fs/cgroup # cat ./memory/kubepods/pod8e172a5c-57f5-493d-a93d-b0b64bca26df/f2fe67dc90cbfd57d873cd8a81a972213822f3f146ec4458adbe54d868cf410c/memory.limit_in_bytes 209715200 1.2 内核内存配置 这里我们重点关注内存相关的两个配置:VMOvercommitMemory其值为1,表示运行分配所有的物理内存资源,注意不包括SWAP资源VMPanicOnOOM其值为0:表示当内存不足的时候触发oom_killer进行选择部分进程进行kill,QOS也是通过影响其kill流程来实现的 func setupKernelTunables(option KernelTunableBehavior) error { desiredState := map[string]int{ utilsysctl.VMOvercommitMemory: utilsysctl.VMOvercommitMemoryAlways, utilsysctl.VMPanicOnOOM: utilsysctl.VMPanicOnOOMInvokeOOMKiller, utilsysctl.KernelPanic: utilsysctl.KernelPanicRebootTimeout, utilsysctl.KernelPanicOnOops: utilsysctl.KernelPanicOnOopsAlways, utilsysctl.RootMaxKeys: utilsysctl.RootMaxKeysSetting, utilsysctl.RootMaxBytes: utilsysctl.RootMaxBytesSetting, } 2.QOS打分机制与判定实现 QOS打分机制主要是根据Requests和limits里面的资源限制来进行类型判定与打分的,我们就来快速看下这部分的实现 2.1 根据容器判定QOS类型 2.1.1 构建容器列表 遍历所有的容器列表,注意这里会包含所有的初始化容器和业务容器 requests := v1.ResourceList{} limits := v1.ResourceList{} zeroQuantity := resource.MustParse("0") isGuaranteed := true allContainers := []v1.Container{} allContainers = append(allContainers, pod.Spec.Containers...) // 追加所有的初始化容器 allContainers = append(allContainers, pod.Spec.InitContainers...) 2.1.2 处理Requests和limits 这里遍历所有的Requests和Limits限制的资源,分别加入到不同的资源集合汇总,其中判定是不是Guaranteed主要是根据limits里面的资源是否包含CPU和内存两种资源,都包含才可能是Guaranteed for _, container := range allContainers { // process requests for name, quantity := range container.Resources.Requests { if !isSupportedQoSComputeResource(name) { continue } if quantity.Cmp(zeroQuantity) == 1 { delta := quantity.DeepCopy() if _, exists := requests[name]; !exists { requests[name] = delta } else { delta.Add(requests[name]) requests[name] = delta } } } // process limits qosLimitsFound := sets.NewString() for name, quantity := range container.Resources.Limits { if !isSupportedQoSComputeResource(name) { continue } if quantity.Cmp(zeroQuantity) == 1 { qosLimitsFound.Insert(string(name)) delta := quantity.DeepCopy() if _, exists := limits[name]; !exists { limits[name] = delta } else { delta.Add(limits[name]) limits[name] = delta } } } if !qosLimitsFound.HasAll(string(v1.ResourceMemory), string(v1.ResourceCPU)) { // 必须是全部包含cpu和内存限制 isGuaranteed = false } } 2.1.3 BestEffort 如果Pod里面的容器没有任何requests和limits的限制则就是BestEffort if len(requests) == 0 && len(limits) == 0 { return v1.PodQOSBestEffort } 2.1.4 Guaranteed 要是Guaranteed必须是资源相等,并且限定的数量相同 // Check is requests match limits for all resources. if isGuaranteed { for name, req := range requests { if lim, exists := limits[name]; !exists || lim.Cmp(req) != 0 { isGuaranteed = false break } } } if isGuaranteed && len(requests) == len(limits) { return v1.PodQOSGuaranteed } 2.1.5 Burstable 如果不是上面两种就是最后一种burstable了 return v1.PodQOSBurstable 2.2 QOS OOM打分机制 2.2.1 OOM打分机制 其中guaranteedOOMScoreAdj是-998其实这跟OOM实现有关系,一台node节点上主要是三部分组成:kubelet主进程、docker进程、业务容器进程,而OOM的打分里面-1000表示该进程不会被oom所kill, 那一个业务进程最少也就只能是-999因为你不能保证自己的业务永远不会出现问题,所以在QOS里面-999其实就是kubelet和docker进程所保留的,剩下的才能作为业务容器分配(分值越高越容易被kill) // KubeletOOMScoreAdj is the OOM score adjustment for Kubelet KubeletOOMScoreAdj int = -999 // DockerOOMScoreAdj is the OOM score adjustment for Docker DockerOOMScoreAdj int = -999 // KubeProxyOOMScoreAdj is the OOM score adjustment for kube-proxy KubeProxyOOMScoreAdj int = -999 guaranteedOOMScoreAdj int = -998 besteffortOOMScoreAdj int = 1000 2.2.2 关键Pod 关键Pod是一种特殊的存在,它可以是Burstable或者BestEffort类型的Pod,但是OOM打分却可以跟Guaranteed一样,这种类型的Pod主要包含三种:静态Pod、镜像Pod和高优先级Pod if types.IsCriticalPod(pod) { return guaranteedOOMScoreAdj } 判定实现 func IsCriticalPod(pod *v1.Pod) bool { if IsStaticPod(pod) { return true } if IsMirrorPod(pod) { return true } if pod.Spec.Priority != nil && IsCriticalPodBasedOnPriority(*pod.Spec.Priority) { return true } return false } 2.2.3 Guaranteed与BestEffort 这两种类型都有各自默认的值分别为Guaranteed(-998)和BestEffort(1000) switch v1qos.GetPodQOS(pod) { case v1.PodQOSGuaranteed: // Guaranteed containers should be the last to get killed. return guaranteedOOMScoreAdj case v1.PodQOSBestEffort: return besteffortOOMScoreAdj } 2.2.4 Burstable 其中关键的一行就是:oomScoreAdjust := 1000 - (1000memoryRequest)/memoryCapacity,从这个计算里面可以看出,如果我们申请的资源越多,那么 (1000memoryRequest)/memoryCapacity这个里面计算出来的时机值就会越小,即最终结果就越大,其实也就表明如果我们占用的内存越少,则打分就越高,这类容器就相对比较容易被kill memoryRequest := container.Resources.Requests.Memory().Value() oomScoreAdjust := 1000 - (1000*memoryRequest)/memoryCapacity // A guaranteed pod using 100% of memory can have an OOM score of 10. Ensure that burstable pods have a higher OOM score adjustment. if int(oomScoreAdjust) < (1000 + guaranteedOOMScoreAdj) { return (1000 + guaranteedOOMScoreAdj) } // Give burstable pods a higher chance of survival over besteffort pods. if int(oomScoreAdjust) == besteffortOOMScoreAdj { return int(oomScoreAdjust - 1) } return int(oomScoreAdjust) 好了今天就到这里,看之前还很懵逼,看完有种豁然开朗的感觉,还是那句话说的对,源码面前了无秘密,加油 k8s源码阅读电子书地址: https://www.yuque.com/baxiaoshi/tyado3 > 微信号:baxiaoshi2020 > 关注公告号阅读更多源码分析文章 > 更多文章关注 www.sreguide.com > 本文由博客一文多发平台 OpenWrite 发布

优秀的个人博客,低调大师

解密 云HBase 冷热分离技术原理

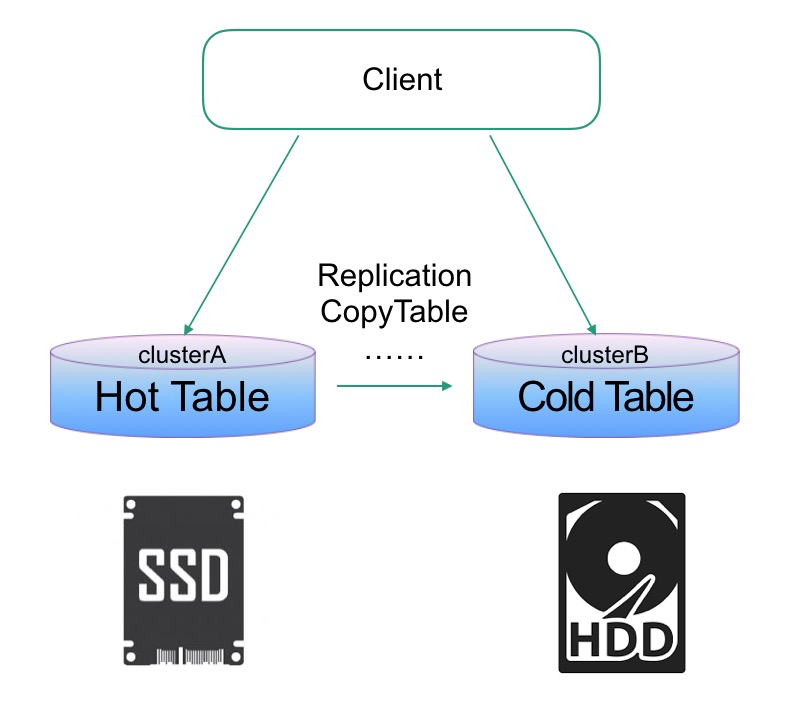
前言 HBase是当下流行的一款海量数据存储的分布式数据库。往往海量数据存储会涉及到一个成本问题,如何降低成本。常见的方案就是通过冷热分离来治理数据。冷数据可以用更高的压缩比算法(ZSTD),更低副本数算法(Erasure Coding),更便宜存储设备(HDD,高密集型存储机型)。 HBase冷热分离常见解决方案 1.主备集群 备(冷)集群用更廉价的硬件,主集群设置TTL,这样当数据热度退去,冷数据自然只在冷集群有。 优点:方案简单,现成内核版本都能搞缺点:维护开销大,冷集群CPU存在浪费 1.x版本的HBase在不改内核情况下,基本只能有这种方案。 2.HDFS Archival Storage + HBase CF-level Storage Policy 需要在2.x之后的版本才能使用。结合HDFS分层存储能力 + 在Table层面指定数据存储策略,实现同集群下,不同表数据的冷热分离。 优点:同一集群冷热分离,维护开销少,更灵活的配置不同业务表的策略缺点:磁盘配比是个很大的问题,不同业务冷热配比是不一样的,比较难整合在一起,一旦业务变动,集群硬件配置是没法跟着变的。 云HBase冷热分离解决方案 上述2套方案都不是最好的方案,对于云上来说。第一套方案就不说了,客户搞2个集群,对于数据量不大的客户其实根本降不了成本。第二套方案,云上客户千千万,业务各有各样,磁盘配置是很难定制到合适的状态。 云上要做 cloud native 的方案,必须满足同集群下,极致的弹性伸缩,才能真正意义上做到产品化。云上低成本,弹性存储,只有OSS了。所以很自然的想到如下架构: 实现这样的架构,最直接的想法是直接改HBase内核:1)增加冷表数据标记 2)根据标记增加写OSS的IO路径。 这样做的缺陷非常明显,你的外部系统(如:备份恢复,数据导入导出)很难兼容这些改动,他们需要感知哪些是冷文件得去OSS哪个位置读,哪些是热文件得去部署在云盘上的HDFS上读。这些本质上都是一些重复的工作,所以从架构设计角度来看必须抽象出一层。这一层能读写HDFS文件,读写OSS文件,感知冷热文件。这一层也就是我最后设计出的ApsaraDB FileSystem,实现了Hadoop FileSystem API。对于HBase,备份恢复,数据导入导出等系统只要替换原先FileSystem的实现即可获得冷热分离的功能。 下面将详细阐述,这套FileSystem设计的细节与难点。 ApsaraDB FileSystem 设计 核心难点A 1.OSS并非文件系统 OSS并不是一个真正意义上的文件系统,它仅仅是两级映射 bucket/object,所以它是对象存储。你在OSS上看到类似这样一个文件:/root/user/gzh/file。你会以为有3层目录+1个文件。实际上只有一个对象,这个对象的key包含了/字符罢了。 这么带来的一个问题是,你要想在其上模拟出文件系统,你必须先能创建目录。很自然想到的是用/结尾的特殊对象代表目录对象。Hadoop社区开源的OssFileSystem就是这么搞的。有了这个方法,就能判断到底存不存在某个目录,能不能创建文件,不然会凭空创建出一个文件,而这个文件没有父目录。 当然你这么做依然会有问题。除了开销比较大(创建深层目录多次HTTP请求OSS),最严重的是正确性的问题。试想一下下面这个场景:把目录/root/user/source rename 成 /root/user/target。这个过程除了该目录,它底下的子目录,子目录里的子文件都会跟着变。类似这样:/root/user/source/file => /root/user/target/file。这很好理解,文件系统就是一颗树,你rename目录,实际是把某颗子树移动到另一个节点下。这个在NameNode里的实现也很简单,改变下树结构即可。 但是如果是在OSS上,你要做rename,那你不得不递归遍历/root/user/source把其下所有目录对象,文件对象都rename。因为你没法通过移动子树这样一个简单操作一步到位。这里带来的问题就是,假设你递归遍历到一半,挂了。那么就可能会出现一半目录或文件到了目标位置,一半没过去。这样rename这个操作就不是原子的了,本来你要么rename成功,整个目录下的内容到新的地方,要么没成功就在原地。所以正确性会存在问题,像HBase这样依赖rename操作将临时数据目录移动到正式目录来做数据commit,就会面临风险。 2.OSS rename实则是数据拷贝 前面我们提到了rename,在正常文件系统中应该是一个轻量级的,数据结构修改操作。但是OSS并没有rename这个操作实际上,rename得通过 CopyObject + DeleteObject 两个操作完成。首先是copy成目标名字,然后delete掉原先的Object。这里有2个明显的问题,一个是copy是深度拷贝开销很大,直接会影响HBase的性能。另一个是rename拆分成2个操作,这2个操作是没法在一个事物里的,也就是说:可能存在copy成功,没delete掉的情况,此时你需要回滚,你需要delete掉copy出来的对象,但是delete依然可能不成功。所以rename操作本身实现上,正确性就难以保证了。 解决核心难点A 解决上面2个问题,需要自己做元数据管理,即相当于自己维护一个文件系统树,OSS上只放数据文件。而因为我们环境中仍然有HDFS存储在(为了放热数据),所以直接复用NameNode代码,让NodeNode帮助管理元数据。所以整体架构就出来了: ApsaraDB FileSystem(以下简称ADB FS)将云端存储分为:主存(PrimaryStorageFileSystem)和 冷存(ColdStorageFileSystem)。由ApsaraDistributedFileSystem类(以下简称ADFS)负责管理这两类存储文件系统,并且由ADFS负责感知冷热文件。 ApsaraDistributedFileSystem: 总入口,负责管理冷存和主存,数据该从哪里读,该写入哪里(ADFS)。主存:PrimaryStorageFileSystem 默认实现是 DistributedFileSystem(HDFS)冷存:ColdStorageFileSystem 默认实现是 HBaseOssFileSystem(HOFS) ,基于OSS实现的Hadoop API文件系统,可以模拟目录对象单独使用,也可以只作为冷存读写数据,相比社区版本有针对性优化,后面会讲。 具体,NameNode如何帮助管理冷存上的元数据,很简单。ADFS在主存上创建同名索引文件,文件内容是索引指向冷存中对应的文件。实际数据在冷存中,所以冷存中的文件有没有目录结构无所谓,只有一级文件就行。我们再看下一rename操作过程,就明白了: rename目录的场景也同理,直接在NameNode中rename就行。对于热文件,相当于全部代理HDFS操作即可,冷文件要在HDFS上创建索引文件,然后写数据文件到OSS,然后关联起来。 核心难点B 引入元数据管理解决方案,又会遇到新的问题:是索引文件和冷存中数据文件一致性问题。我们可能会遇到如下场景: 主存索引文件存在,冷存数据文件不存在 冷存数据文件存在,主存索引文件不存住 主存索引文件信息不完整,无法定位冷存数据文件 先排除BUG或者人为删除数据文件因素,上诉3种情况都会由于程序crash产生。也就是说我们要想把法,把生成索引文件,写入并生成冷数据文件,关联,这3个操作放在一个事物里。这样才能具备原子性,才能保证要么创建冷文件成功,那么索引信息是完整的,也指向一个存在的数据文件。要么创建冷文件失败(包括中途程序crash),永远也见不到这个冷文件。 解决核心难点B 核心思想是利用主存的rename操作,因为主存的rename是具备原子性的。我们先在主存的临时目录中生产索引文件,此时索引文件内容已经指向冷存中的一个路径(但是实际上这个路径的数据文件还没开始写入)。在冷存完成写入,正确close后,那么此时我们已经有完整且正确的索引文件&数据文件。然后通过rename一把将索引文件改到用户实际需要写入到目标路径,即可。 如果中途进程crash,索引文件要么已经rename成功,要么索引文件还在临时目录。在临时目录我们认为写入没有完成,是失败的。然后我们通过清理线程,定期清理掉N天以前临时目录的文件即可。所以一旦rename成功,那目标路径上的索引文件一定是完整的,一定会指向一个写好的数据文件。 为什么我们需要先写好路径信息在索引文件里?因为如果先写数据文件,在这个过程中crash了,那我们是没有索引信息指向这个数据文件的,从而造成类似“内存泄漏”的问题。 冷热文件标记 对于主存,需要实现给文件冷热标记的功能,通过标记判断要打开怎样的数据读写流。这点NameNode可以通过给文件设置StoragePolicy实现。这个过程就很简单了,不详细赘述,下面说HBaseOssFileSystem写入优化设计。 HBaseOssFileSystem 写入优化 在说HOFS写设计之前,我们先要理解Hadoop社区版本的OssFileSystem设计(这也是社区用户能直接使用的版本)。 社区版本写入设计 Write -> OutputStream -> disk buffer(128M) -> FileInputStream -> OSS 这个过程就是先写入磁盘,磁盘满128M后,将这128M的block包装成FileInputStream再提交给OSS。这个设计主要是考虑了OSS请求成本,OSS每次请求都是要收费的,但是内网流量不计费。如果你1KB写一次,费用就很高了,所以必须大块写。而且OSS大文件写入,设计最多让你提交10000个block(OSS中叫MultipartUpload),如果block太小,那么你能支持的最大文件大小也是受限。 所以要攒大buffer,另外一个因素是Hadoop FS API提供的是OutputStream让你不断write。OSS提供的是InputStream,让你提供你要写入内容,它自己不断读取。这样你必然要通过一个buffer去转换。 这里会有比较大的一个问题,就是性能慢。写入磁盘,再读取磁盘,多了这么两轮会比较慢,虽然有PageCache存在,读取过程不一定有IO。那你肯定想,用内存当buffer不就好了。内存当buffer的问题就是前面说的,有费用,所以buffer不能太小。所以你每个文件要开128M内存,是不可能的。更何况当你提交给OSS的时候,你要保证能继续写入新数据,你得有2块128M内存滚动,这个开销几乎不能接受。 HBaseOssFileSystem 写入设计 我们既要解决费用问题,也要解决性能问题,同时要保证开销很低,看似不可能,那么怎么做呢? 这里要利用的就是这个InputStream,OSS让你提供InputStream,并从中读取你要写入的内容。那么我们可以设计一个流式写入,当我传入这个InputStream给OSS的时候,流中并不一定得有数据。此时OSS调read读取数据会block在read调用上。等用户真的写入数据,InputStream中才会有数据,这时候OSS就能顺利读到数据。当OSS读了超过128M数据时候,InputStream会自动截断,返回EOF,这样OSS会以为流已经结束了,那么这块数据就算提交完成。 所以我们本质只要开发这么一个特殊的InputStream即可。用户向Hadoop API提供的OutputStream中写入数据,数据每填满一个page(2M)就发给InputStream让其可读取。OuputStream相当于生产者,InputStream相当于消费者。这里的内存开销会非常低,因为生产者速度和消费者速度相近时,也就2个page的开销。最后将这整套实现封装成OSSOutputStream类,当用户要写入冷文件时,实际提供的是OSSOutputStream,这里面就包含了这个特殊InputStream的控制过程。 当然实际生产中,我们会对page进行控制,每个文件设置最多4个page。并且这4个page循环利用,减少对GC对影响。所以最后我们得到下面一个环形缓冲的写入模式: 性能对比1:社区版本 vs 云HBase版 因为不用写磁盘,所以写入吞吐可以比社区的高很多,下图为HBase1.0上测试结果。在一些大KV,写入压力更大的场景,实测可以接近1倍。这个比较是通过替换ADFS冷存的实现(用社区版本和云HBase版本),都避免了rename深拷贝问题。如果直接裸用社区版本而不用ADFS那性能会差数倍。 性能对比2:热表 vs 冷表 热表数据在云盘,冷表数据在OSS。 得益于上述优化,加上冷表WAL也是放HDFS的,并且OSS相对HBase来说是大集群(吞吐上限高),冷表的HDFS只用抗WAL写入压力。所以冷表吞吐反而会比热表略高一点点。 不管怎么说,冷表的写入性能和热表相当了,这样的表现已经相当不错了。基本是不会影响用户灌数据,否则使用冷存后,吞吐掉很多,那意味着要更多机器,那这功能就没什么意义了。 总结 这大约是1年多前落地的项目,已经稳定运行很久。之前也有出去分享过,但是没有今天这么细致。现在写出来主要是自我总结下。当设计一个服务去解决某个问题的时候,上下游的关系,可能存在的问题得考虑清楚。在做这个项目最初的时候,想把HBase直接架设在社区版本OssFileSytem上,发现性能不行外,正确性也存在很大风险。不断思考,考虑各种情况后才有了今天这套方案。

优秀的个人博客,低调大师

源码分析ElasticJob选主实现原理

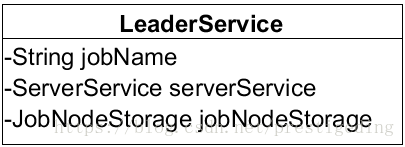
ElasticJob各分布式调度服务器有两个角色:主服务器、从服务器。这里主从服务器与数据库的主从同步不一样,也不是传统意义上的主备,从执行调度任务这一视角来看ElasticJob主从服务器的地位是相同的,都是任务调度执行服务器(彼此之间共同组成一个集群平等的执行分配给自己的数据执行调度任务),主从服务器共同构成任务调度的分片节点。ElasticJob的主服务器的职责是根据当前存活的任务调度服务器生成分片信息,然后拉取属于该分片的任务数据执行任务。为了避免分片信息的不统一,ElasticJob必须从所有的调度服务器中选择一台为主服务器,由该台服务器统一计算分片信息,其他服务根据该分片信息进行任务调度。ElasticJob选主实现由LeaderService实现,从上文可知,在Job调度服务器的启动流程中:ListenerManager#startAllListeners 方法首先会启动ElectionListenerManager(主节点选举监听管理器),然后调用LeaderService.electLeader方法执行选主过程(SchedulerFacade#registerStartUpInfo)。 1、选主实现LeaderService.electLeader String jobName:任务名称。 ServiceService serverService:作业服务器服务服务API。 JobNodeStorage jobNodeStorage:job节点存储实现类,操作ZK api。 LeaderService#electLeader /** * 选举主节点. */ public void electLeader() { log.debug("Elect a new leader now."); jobNodeStorage.executeInLeader(LeaderNode.LATCH, new LeaderElectionExecutionCallback()); log.debug("Leader election completed."); } 选主使用的分布式锁节点目录: {Namespace}/{JobName}/leader/election/latch,LeaderService$LeaderElectionExecutionCallback,获取分布式锁后的回调逻辑。 /** * 在主节点执行操作. * * @param latchNode 分布式锁使用的作业节点名称 * @param callback 执行操作的回调 */ public void executeInLeader(final String latchNode, final LeaderExecutionCallback callback) { try (LeaderLatch latch = new LeaderLatch(getClient(), jobNodePath.getFullPath(latchNode))) { latch.start(); // @1 latch.await(); // @2 callback.execute(); //@3 //CHECKSTYLE:OFF } catch (final Exception ex) { //CHECKSTYLE:ON handleException(ex); } } 选主直接使用cautor开源框架提供的实现类org.apache.curator.framework.recipes.leader.LeaderLatch。LeaderLatch需要传入两个参数: CuratorFramework client:curator框架客户端。 latchPath:锁节点路径,elasticJob的latchPath为:${namespace}/${Jobname}/leader/election/latch。 代码@1、@2:启动 LeaderLatch,其主要过程就是去锁路径下创建一个临时排序节点,如果创建的节点序号最小,await 方法将返回,否则在前一个节点监听该节点事件,并阻塞,如何获得分布式锁后,执行callback回调方法。 LeaderService$LeaderElectionExecutionCallback @RequiredArgsConstructor class LeaderElectionExecutionCallback implements LeaderExecutionCallback { @Override public void execute() { if (!hasLeader()) { jobNodeStorage.fillEphemeralJobNode(LeaderNode.INSTANCE, JobRegistry.getInstance().getJobInstance(jobName).getJobInstanceId()); } } } 成功获取选主的分布式锁后,如果{namespace}/{jobname}/leader/election/instance节点不存在,则创建该临时节点,节点存储的内容为IP地址@-@进程ID,其代码为:jobInstanceId = IpUtils.getIp() + "@-@"+ ManagementFactory.getRuntimeMXBean().getName().split("@")[0]; 选主流程如图所示: 上面完成一次选主过程,如果主服务器宕机怎么办?从节点如何接管主服务器的角色呢?基于ZK的开发模式一般是监听节点的变化事件,做成相应的处理。 2、ElectionListenerManager主节点选举监听管理器 String jobName:job名称。 LeaderNode leaderNode:主节点信息,封装主节点在zk中存储节点信息。 ServerNode serverNode:服务器节点信息。 LeaderService leaderService:选主服务实现类。 ServerService serverService:作业服务器服务类。 LeaderNode、ServerNode 代表存储在 zk 服务器上的路径, LeaderNode 的类图如图所示: 其中 JobNamePath 定义了每一个 Job 在 zk 服务器的存储组织目录,根据器代码显示,例如数据同步项目(MyProject)下定义了两个定时任务(SyncUserJob、SyncRoleJob)。 注册中心命名空间取名为项目名:MyProject,在zk的节点存储节点类似如下目录结构,节点存放内容在具体用到时再分析。 2.1 ElectionListenerManager#start public void start() { addDataListener(new LeaderElectionJobListener()); addDataListener(new LeaderAbdicationJobListener()); } 首先关注一下使用ZK如何添加自定义监听器。 JobNodeStorage#addDataListener /** * 注册数据监听器. * * @param listener 数据监听器 */ public void addDataListener(final TreeCacheListener listener) { TreeCache cache = (TreeCache) regCenter.getRawCache("/" + jobName); cache.getListenable().addListener(listener); } 首先获取 TreeCache,然后获取 cahce.getListenable().addListener(TreeCacheListener)。 根据节点路径创建TreeCache的方法如下: ZookeeperRegistryCenter#addCacheData public void addCacheData(final String cachePath) { TreeCache cache = new TreeCache(client, cachePath); try { cache.start(); //CHECKSTYLE:OFF } catch (final Exception ex) { //CHECKSTYLE:ON RegExceptionHandler.handleException(ex); } caches.put(cachePath + "/", cache); } 2.2 LeaderElectionJobListener 选主事件监听器,监听节点主节点 LeaderNode.INSTANCE{namespace}/{jobname}/leader/election/instance。 如果主节点失去与 zk 的连接,由于 LeaderNode.INSTANCE 为临时节点,当节点被 zk 删除后,会触发其他从节点的选主,但由于任务调度服务器重新建立与zk的连接后,并不能直接参与选主,所以当LeaderNode.INSTANCE 每发送一次变化后,尝试发起一次选主,调用 LeaderService.electLeader 方法。 LeaderElectionJobListener #dataChanged protected void dataChanged(final String path, final Type eventType, final String data) { if (!JobRegistry.getInstance().isShutdown(jobName) && (isActiveElection(path, data) || isPassiveElection(path, eventType))) { leaderService.electLeader(); } } 如果该job未停止,并且可以进行选主或LeaderNode.INSTANCE节点被删除时,触发一次选主。 LeaderElectionJobListener #isActiveElection private boolean isActiveElection(final String path, final String data) { return !leaderService.hasLeader() && isLocalServerEnabled(path, data); } 如果当前节点不是主节点,并且当前服务器运行正常,运行正常的依据是存在{namespace}/{jobname}/servers/server-ip,并且节点内容不为DISABLED。 LeaderElectionJobListener #isPassiveElection private boolean isPassiveElection(final String path, final Type eventType) { return isLeaderCrashed(path, eventType) && serverService.isAvailableServer(JobRegistry.getInstance().getJobInstance(jobName).getIp()); } 如果当前事件节点为 LeaderNode.INSTANCE 并且事件类型为删除,并且该 job 的当前对应的实例({namespace}/{jobname}/instances/ip)存在并且状态不为DISABLED。 2.3 LeaderAbdicationJobListener 主退位监听器,其目的就是删除 LeaderNode.INSTANCE 节点。 class LeaderAbdicationJobListener extends AbstractJobListener { @Override protected void dataChanged(final String path, final Type eventType, final String data) { if (leaderService.isLeader() && isLocalServerDisabled(path, data)) { leaderService.removeLeader(); } } private boolean isLocalServerDisabled(final String path, final String data) { return serverNode.isLocalServerPath(path) && ServerStatus.DISABLED.name().equals(data); } } 本文选主机制就分析到这里,基于 ZK 来开发的常规讨论,就是创建节点、监听节点事件。这个监听器的目的:如果设置了某个节点的服务为 disable,当前节点正好是leader的话,则这个监听器执行leaderService.removeLeader() ;操作退位。 原文发布时间为:2018-12-01本文作者:丁威,《RocketMQ技术内幕》作者。本文来自中间件兴趣圈,了解相关信息可以关注中间件兴趣圈。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册