首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

PostgreSQL从库只读的实现原理

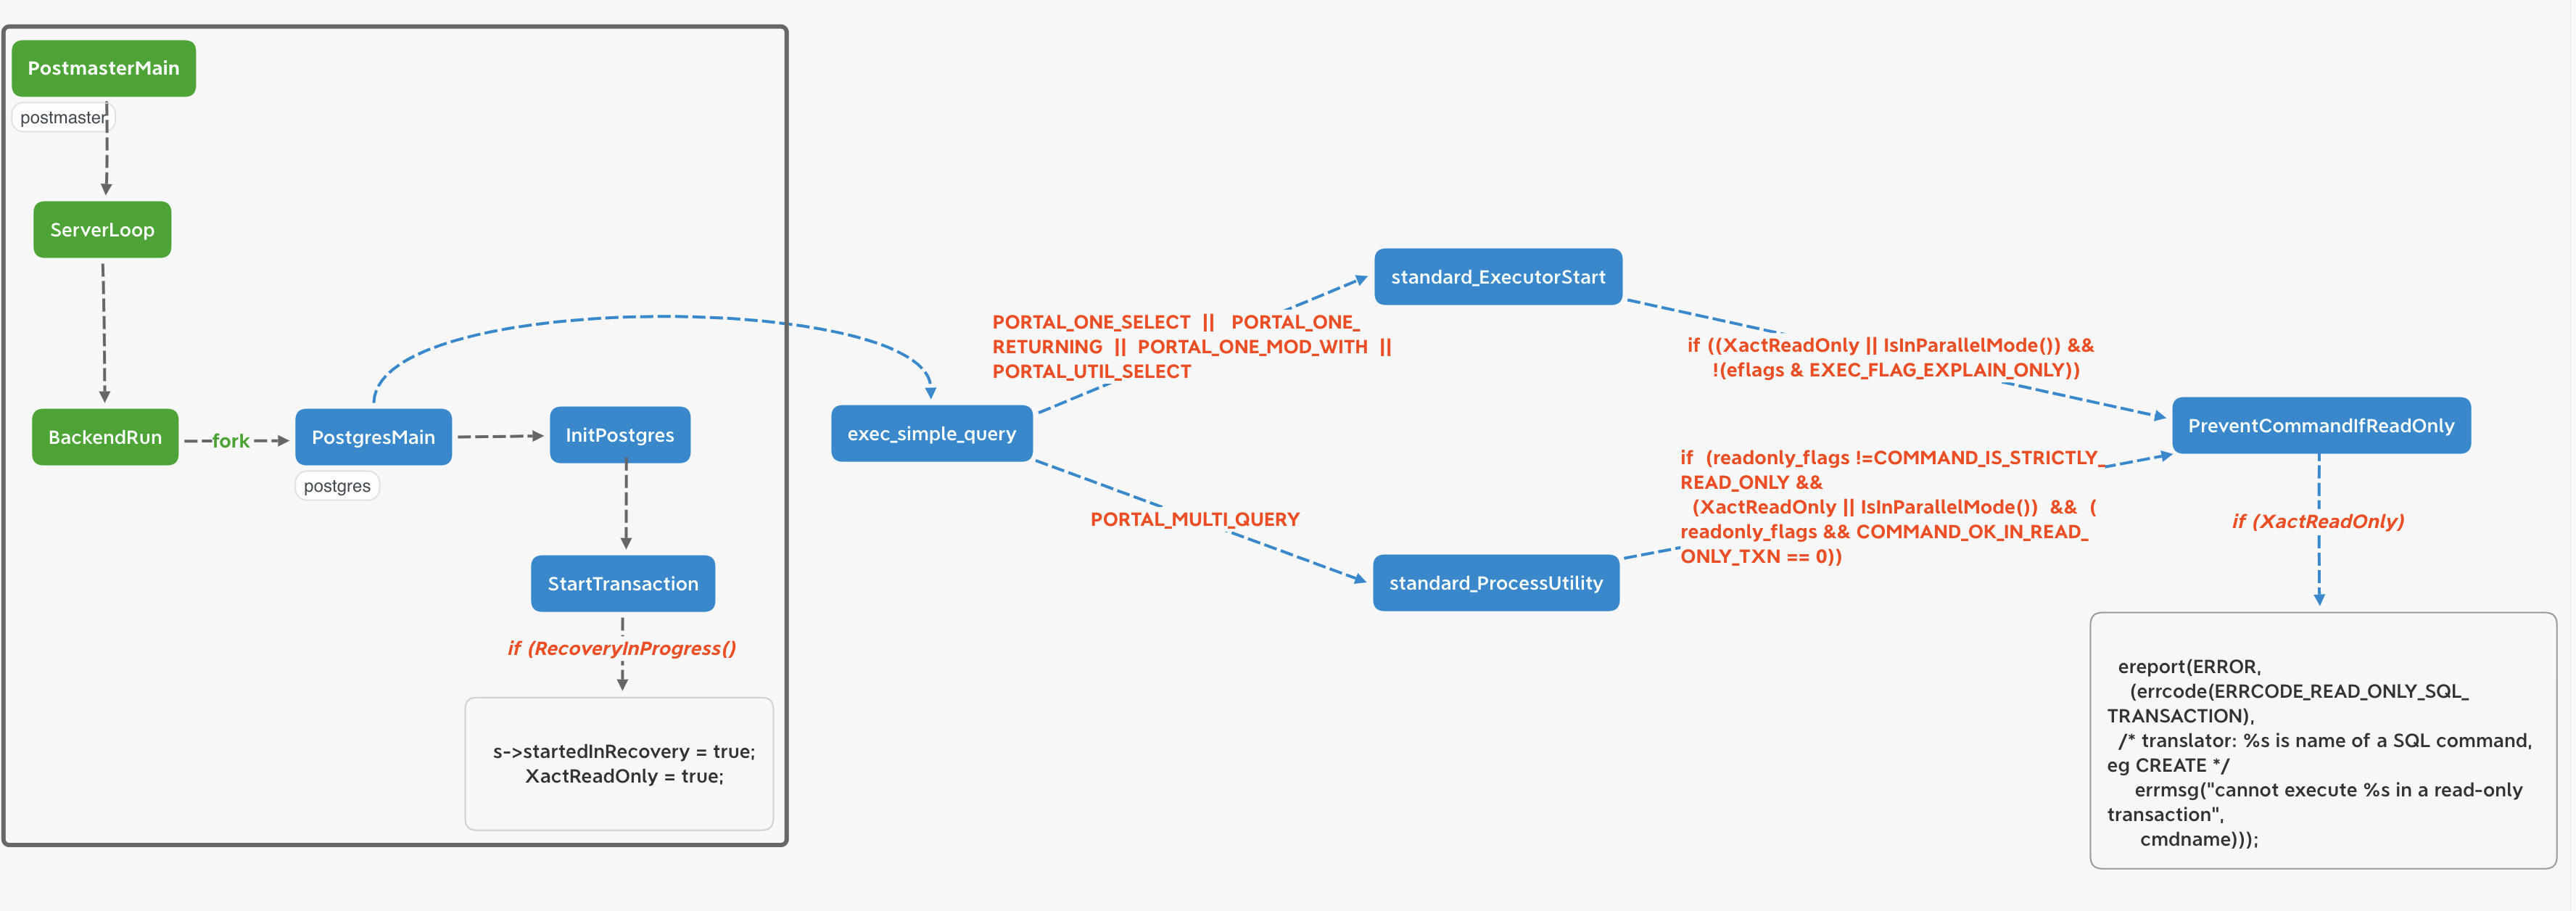
我们接触到的数据库,基本都提供了只读实例的功能。在业务允许的情况下可以将一些读取数据的请求下发至只读实例,减缓primary的压力,以获得更佳的性能。 物理从库只读已经是一个常识问题,在PostgreSQL中具体是怎么实现的呢,一起来看看 一、报错分析 从报错入手分析,在只读库里执行写操作,报错如下: postgres=# select * into tbl_t from tbl_test; ERROR: cannot execute SELECT INTO in a read-only transaction postgres=# 报错的函数为: /* * PreventCommandIfReadOnly: throw error if XactReadOnly * * This is useful partly to ensure consistency of the error message wording; * some callers have checked XactReadOnly for themselves. */ void PreventCommandIfReadOnly(const char *cmdname) { if (XactReadOnly) ereport(ERROR, (errcode(ERRCODE_READ_ONLY_SQL_TRANSACTION), /* translator: %s is name of a SQL command, eg CREATE */ errmsg('cannot execute %s in a read-only transaction', cmdname))); } 当XactReadOnly为true时,就抛出报错,XactReadOnly是一个Bool类型的全局变量。那这里大概明白设计思路了,当执行一些操作时调用PreventCommandIfReadOnly函数,如果库是只读状态进行写操作就抛出报错。 报错堆栈: (gdb) bt #0 PreventCommandIfReadOnly (cmdname=0xbab6f8 'SELECT INTO') at utility.c:409 #1 0x00000000008c24a5 in standard_ProcessUtility (pstmt=0x1faef00, queryString=0x1fae098 'select * into tbl_t from tbl_test;', context=PROCESS_UTILITY_TOPLEVEL, params=0x0, queryEnv=0x0, dest=0x1fafa18, qc=0x7ffc8ac8a180) at utility.c:566 #2 0x00000000008c23cc in ProcessUtility (pstmt=0x1faef00, queryString=0x1fae098 'select * into tbl_t from tbl_test;', context=PROCESS_UTILITY_TOPLEVEL, params=0x0, queryEnv=0x0, dest=0x1fafa18, qc=0x7ffc8ac8a180) at utility.c:524 #3 0x00000000008c14e2 in PortalRunUtility (portal=0x1fffa58, pstmt=0x1faef00, isTopLevel=true, setHoldSnapshot=false, dest=0x1fafa18, qc=0x7ffc8ac8a180) at pquery.c:1157 #4 0x00000000008c16ce in PortalRunMulti (portal=0x1fffa58, isTopLevel=true, setHoldSnapshot=false, dest=0x1fafa18, altdest=0x1fafa18, qc=0x7ffc8ac8a180) at pquery.c:1303 #5 0x00000000008c0c6c in PortalRun (portal=0x1fffa58, count=9223372036854775807, isTopLevel=true, run_once=true, dest=0x1fafa18, altdest=0x1fafa18, qc=0x7ffc8ac8a180) at pquery.c:779 #6 0x00000000008bb204 in exec_simple_query (query_string=0x1fae098 'select * into tbl_t from tbl_test;') at postgres.c:1239 #7 0x00000000008bf053 in PostgresMain (argc=1, argv=0x1fd7af0, dbname=0x1fd7a28 'postgres', username=0x1fd7a08 'postgres') at postgres.c:4315 #8 0x0000000000820e1f in BackendRun (port=0x1fd13f0) at postmaster.c:4536 #9 0x0000000000820630 in BackendStartup (port=0x1fd13f0) at postmaster.c:4220 #10 0x000000000081cf62 in ServerLoop () at postmaster.c:1739 #11 0x000000000081c843 in PostmasterMain (argc=3, argv=0x1fa9d70) at postmaster.c:1412 #12 0x0000000000733286 in main (argc=3, argv=0x1fa9d70) at main.c:210 (gdb) p XactReadOnly $1 = true 接下来追踪全局变量XactReadOnly 在什么时候被赋值为true。 二、变量追踪 走读代码:postmaster守护进程fork出postgres后,在InitPostgres阶段StartTransaction()函数根据是否RecoveryInProgress来赋值,如果RecoveryInProgress()为true就设置XactReadOnly = true /* * Make sure we've reset xact state variables * * If recovery is still in progress, mark this transaction as read-only. * We have lower level defences in XLogInsert and elsewhere to stop us * from modifying data during recovery, but this gives the normal * indication to the user that the transaction is read-only. */ if (RecoveryInProgress()) { s->startedInRecovery = true; XactReadOnly = true; } 使用gdb attach postmasterPID 后,抓到了这个过程 Breakpoint 3, StartTransaction () at xact.c:1895 1895 s = &TopTransactionStateData; (gdb) bt #0 StartTransaction () at xact.c:1895 #1 0x0000000000536318 in StartTransactionCommand () at xact.c:2827 #2 0x0000000000a40778 in InitPostgres (in_dbname=0x1fd7a28 'postgres', dboid=0, username=0x1fd7a08 'postgres', useroid=0, out_dbname=0x0, overrid e_allow_connections=false) at postinit.c:739 #3 0x00000000008beb60 in PostgresMain (argc=1, argv=0x1fd7af0, dbname=0x1fd7a28 'postgres', username=0x1fd7a08 'postgres') at postgres.c:3933 #4 0x0000000000820e1f in BackendRun (port=0x1fd13f0) at postmaster.c:4536 #5 0x0000000000820630 in BackendStartup (port=0x1fd13f0) at postmaster.c:4220 #6 0x000000000081cf62 in ServerLoop () at postmaster.c:1739 #7 0x000000000081c843 in PostmasterMain (argc=3, argv=0x1fa9d70) at postmaster.c:1412 #8 0x0000000000733286 in main (argc=3, argv=0x1fa9d70) at main.c:210 (gdb) p XactReadOnly $1 = false (gdb) list 1890 VirtualTransactionId vxid; 1891 1892 /* 1893 * Let's just make sure the state stack is empty 1894 */ 1895 s = &TopTransactionStateData; 1896 CurrentTransactionState = s; 1897 1898 Assert(!FullTransactionIdIsValid(XactTopFullTransactionId)); 1899 (gdb) n 1896 CurrentTransactionState = s; (gdb) 1909 s->state = TRANS_START; (gdb) 1910 s->fullTransactionId = InvalidFullTransactionId; /* until assigned */ (gdb) n 1913 xact_is_sampled = log_xact_sample_rate != 0 && (gdb) 1922 s->nestingLevel = 1; (gdb) 1923 s->gucNestLevel = 1; (gdb) 1924 s->childXids = NULL; (gdb) 1925 s->nChildXids = 0; (gdb) 1926 s->maxChildXids = 0; (gdb) 1932 GetUserIdAndSecContext(&s->prevUser, &s->prevSecContext); (gdb) 1945 if (RecoveryInProgress()) (gdb) 1947 s->startedInRecovery = true; (gdb) p RecoveryInProgress() $2 = true (gdb) n 1948 XactReadOnly = true; (gdb) p XactReadOnly $3 = true XactReadOnly赋值是在StartTransaction ()函数中完成的,首次赋值是在InitPostgres环节,除此之外,后续每次启动事务后会重新赋值。 XactReadOnly是否为ture取决于RecoveryInProgress()的返回值是否为true。对于Primary实例 startup进程不是常驻内存的,因此只有在启动过程中以及crash后进行recovery,完成后startup进程退出;对于standby 实例来说startup进程是常驻内存的,一直通过redo来回放primary发送的日志,因此RecoveryInProgress()一直为ture。 RecoveryInProgress()函数逻辑很简单,返回值取决于共享内存xlogctl->SharedRecoveryState的值,只有在StartupXlog函数退出时会修改为RECOVERY_STATE_DONE;因此在standby实例中RecoveryInProgress()函数一直返回true /* * Is the system still in recovery * * Unlike testing InRecovery, this works in any process that's connected to * shared memory. * * As a side-effect, we initialize the local TimeLineID and RedoRecPtr * variables the first time we see that recovery is finished. */ bool RecoveryInProgress(void) { /* * We check shared state each time only until we leave recovery mode. We * can't re-enter recovery, so there's no need to keep checking after the * shared variable has once been seen false. */ if (!LocalRecoveryInProgress) return false; else { /* * use volatile pointer to make sure we make a fresh read of the * shared variable. */ volatile XLogCtlData *xlogctl = XLogCtl; LocalRecoveryInProgress = (xlogctl->SharedRecoveryState != RECOVERY_STATE_DONE); /* * Initialize TimeLineID and RedoRecPtr when we discover that recovery * is finished. InitPostgres() relies upon this behaviour to ensure * that InitXLOGAccess() is called at backend startup. (If you change * this, see also LocalSetXLogInsertAllowed.) */ if (!LocalRecoveryInProgress) { /* * If we just exited recovery, make sure we read TimeLineID and * RedoRecPtr after SharedRecoveryState (for machines with weak * memory ordering). */ pg_memory_barrier(); InitXLOGAccess(); } /* * Note: We don't need a memory barrier when we're still in recovery. * We might exit recovery immediately after return, so the caller * can't rely on 'true' meaning that we're still in recovery anyway. */ return LocalRecoveryInProgress; } } 三、小结 通过前边的分析,将设定只读,以及只读处理的过程通过框图来表示。 1、 左边灰色框表示只读的设定,在fork出postgres之后,根据是否RecoveryInProgress来设定是否只读,实例为standby角色则设置为只读; 2、 右边框图表示只读处理的过程,执行器进行判断,如果实例为standby角色,并且执行写操作,则调用PreventCommandIfReadOnly函数抛出报错终止写操作 整体来看pg通过一个bool全局变量XactReadOnly,设定相关的逻辑,来操作实例是否只读,以及只读处理。 四、延伸 1、XactReadOnly变量对应guc参数transaction_read_only,可以使用show命令查看;但是这个参数是GUC_NO_RESET_ALL类,也就是说不能通过alter system方式修改; 2、如何设置primary实例为只读状态? Alter system set default_transaction_read_only to on; select pg_reload_conf(); 即可 { {'default_transaction_read_only', PGC_USERSET, CLIENT_CONN_STATEMENT, gettext_noop('Sets the default read-only status of new transactions.'), NULL }, &DefaultXactReadOnly, false, NULL, NULL, NULL }, { {'transaction_read_only', PGC_USERSET, CLIENT_CONN_STATEMENT, gettext_noop('Sets the current transaction's read-only status.'), NULL, GUC_NO_RESET_ALL | GUC_NOT_IN_SAMPLE | GUC_DISALLOW_IN_FILE }, &XactReadOnly, false, check_transaction_read_only, NULL, NULL },
优秀的个人博客,低调大师

PHP依赖注入原理与用法分析

你知道什么是依赖注入吗? 依赖注入(DI)的概念虽然听起来很深奥,但是如果你用过一些新兴的php框架的话,对于DI一定不陌生,因为它们多多少少都用到了依赖注入来处理类与类之间的依赖关系。 php中传递依赖关系的三种方案 其实要理解DI,首先要明白在php中如何传递依赖关系。 第一种方案,也是最不可取的方案,就是在A类中直接用new关键词来创建一个B类,如下代码所示: <?php class A { public function __construct() { $b = new B(); } } 为什么这种方案不可取呢?因为这样的话,A与B就耦合在了一起,也就是说A类无法脱离B类工作。 第二种方案就是在A类的方法中传入需要的B类,如下代码所示: <?php class A { public function __construct(B $b) { } } 这种方法比第一种方案有了改进,A类不必与B类捆绑在一起,只要传入的类满足A类的需求,也可以是C类,也可以是D类等等。 但是这种方案的弊端在于如果A类依赖的类较多,参数列表会很长,容易发生混乱。 第三种方案是使用set方法传入,如下代码所示: 这种方法比第一种方案有了改进,A类不必与B类捆绑在一起,只要传入的类满足A类的需求,也可以是C类,也可以是D类等等。 但是这种方案的弊端在于如果A类依赖的类较多,参数列表会很长,容易发生混乱。 第三种方案是使用set方法传入,如下代码所示: <?php class A { public function setB(B $b) { $this->b = $b; } } 这种方案同样存在和第二种方案一样的弊端,当依赖的类增多时,我们需要些很多很多的set方法。 这时我们在想如果有一个专门的类(或者说一个容器)可以帮我们管理这些依赖关系就好了。 一个简单的依赖注入的例子 如下代码来自twittee: <?php class Container { private $s=array(); function __set($k, $c) { $this->s[$k]=$c; } function __get($k) { return $this->s[$k]($this); } } 有了container类之后我们可以怎样管理A与B之间的依赖关系呢,用代码说话吧: <?php class A { private $container; public function __construct(Container $container) { $this->container = $container; } public function doSomeThing() { //do something which needs class B $b = $this->container->getB(); //to do } } 再将B类注入到容器类中: $c = new Container(); $c->setB(new B()); 还可以传入一个匿名函数,这样B类就不会在传入时就立即实例化,而是在真正调用时才完成实例化的工作: $c = new Container(); $c->setB(function (){ return new B(); }); 以上内容希望帮助到大家,更多PHP大厂PDF面试文档,PHP进阶架构视频资料,PHP精彩好文免费获取可以微信搜索关注公众号:PHP开源社区,或者访问: 2021金三银四大厂面试真题集锦,必看! 四年精华PHP技术文章整理合集——PHP框架篇 四年精华PHP技术文合集——微服务架构篇 四年精华PHP技术文合集——分布式架构篇 四年精华PHP技术文合集——高并发场景篇 四年精华PHP技术文章整理合集——数据库篇

优秀的个人博客,低调大师

几种常见负载均衡算法工作原理

轮询 顾名思义将请求按顺序轮流地分配到后端服务器上,它均衡地对待后端的每一台服务器,而不关心服务器实际的连接数和当前的系统负载。 优点 缺点 服务器请求数据相同 服务器压力不同,不适合根据服务器配置不同的情况 随机 通过系统的随机算法,根据后端服务器的列表大小值来随机选取其中的一台服务器进行访问。由概率统计理论可以得知,随着客户端调用服务端的次数增多,其实际效果越来越接近于平均分配调用量到后端的每一台服务器,也就是轮询的结果。 优点 缺点 使用简单 服务器压力不同,不适合根据服务器配置不同的情况 源地址哈希 源地址哈希的思想是根据获取客户端的IP地址,通过哈希函数计算得到的一个数值,用该数值对服务器列表的大小进行取模运算,得到的结果便是客服端要访问服务器的序号。采用源地址哈希法进行负载均衡,同一IP地址的客户端,当后端服务器列表不变时,它每次都会映射到同一台后端服务器进行访问。 优点 缺点 将来自同一IP地址的请求,同一会话期内,转发到相同的服务器;实现会话粘滞。 目标服务器宕机后,会话会丢失 加权轮询法 不同的后端服务器可能机器的配置和当前系统的负载并不相同,因此它们的抗压能力也不相同。给配置高、负载低的机器配置更高的权重,让其处理更多的请;而配置低、负载高的机器,给其分配较低的权重,降低其系统负载,加权轮询能很好地处理这一问题,并将请求顺序且按照权重分配到后端。 优点 缺点 根据权重,调节转发服务器的请求数目 使用相对复杂 加权随机法 与加权轮询法一样,加权随机法也根据后端机器的配置,系统的负载分配不同的权重。不同的是,它是按照权重随机请求后端服务器,而非顺序。 最小连接数法 最小连接数算法比较灵活和智能,由于后端服务器的配置不尽相同,对于请求的处理有快有慢,它是根据后端服务器当前的连接情况,动态地选取其中当前积压连接数最少的一台服务器来处理当前的请求,尽可能地提高后端服务的利用效率,将负责合理地分流到每一台服务器。 优点 缺点 根据服务器当前的请求处理情况,动态分配 算法实现相对复杂,需要监控服务器请求连接数

优秀的个人博客,低调大师

kafka快速实战与原理了解

基本介绍 最初由Linkedin公司开发,2010捐给Apache 特性:分布式、分区、多副本 基于zk协调的分布式消息系统 可实时处理大数据量消息 应用场景:基于hadoop的批处理、Spark流失处理、web服务器日志、系统访问日志等 scala语言开发 业务应用场景 日志手机 消息系统 用户行为跟踪 运营指标监控 基本概念 Broker:消息处理节点,可理解为就是一个kafka节点 Topic:对消息进行归类 Producer/Consumer:生产者与消费者 ConsumerGroup:消费组,一条消息可被多个不同消费组消费,同一消费组内,只有一个消费者能消费某条消息 Partition:分区,物理概念,一个Topic可分为多个分区,每个分区内的消息是有序的;个人理解与RocketMQ中的Queue概念相似 基本使用 环境准备:kafka为Scala语言开发,需运行在jvm上,所以需准备JDK环境 kafka依赖zk做协调器,需安装zk 下载kafka,主要修改config/server.properties 关键属性: #broker.id属性在kafka集群中必须要是唯一 broker.id=0 #kafka部署的机器ip和提供服务的端口号 listeners=PLAINTEXT://192.168.65.60:9092 #kafka的消息存储文件 log.dir=/usr/local/data/kafka-logs #kafka连接zookeeper的地址,ZK集群以逗号隔开 zookeeper.connect=192.168.65.60:2181 启动脚本语法:kafka-server-start.sh [-daemon] server.properties 启动后可进入zk查看zk下的节点数据 停止:bin/kafka-server-stop.sh 创建主题 主题默认:分区数为1,副本数为1,最小写成功数为1 bin/kafka-topics.sh --create --zookeeper 192.168.65.60:2181 --replication-factor 1 --partitions 1 --topic test 主题在生产者发布消息时若不存在,则会自动创建 发送消息 自带bin/kafka-console-producer.sh命令客户端 bin/kafka-console-producer.sh --broker-list 192.168.65.60:9092 --topic test >this is a msg >this is a another msg 消费消息 自带消费消息命令终端:bin/kafka-console-consumer.sh bin/kafka-console-consumer.sh --bootstrap-server 192.168.65.60:9092 --topic test 带参数--from-beginning,表示可消费之前全部消息 带参数--whitelist "test|test-2" 同时消费多个主题 单播与多播 单播:一条消息只让一个消费者消费,类似Queue模式;我们让所有消费者在同一个消费者内即可实现; 多播:一条消息可让多个消费者同时都消费,类似发布订阅模式;我们让每个消费者存在不同消费组即可实现; 其他命令 // 查看消费组组名 bin/kafka-consumer-groups.sh --bootstrap-server 192.168.65.60:9092 --list // 查看消费组消费偏移量 bin/kafka-consumer-groups.sh --bootstrap-server 192.168.65.60:9092 --describe --group testGroup current-offset:当前消费组的已消费偏移量 log-end-offset:主题对应分区消息的结束偏移量(HW) lag:当前消费组未消费的消息数 Topic与Log Topic即为一个消息类别名称,同类消息一般发到同一Topic下 每个Topic下对应有多个分区日志文件 分区是一个有序的消息队列,消息被按序添加到commit log文件中 每个消息在一个分区中有唯一的标识,称为offset 不同分区中的消息,其offset可能相同 消息一般不会自动删除,默认被保留约最近7天 消费者基于自己在提交日志中消费的进度(offset)进行工作 offset由消费者自己维护 所以消费者可按序逐条消费commit log消息,也可指定offset来重复或跳过消费某些消息 // 创建2个分区的主题 bin/kafka-topics.sh --create --zookeeper 192.168.65.60:2181 --replication-factor 1 --partitions 2 --topic test1 查看下topic的情况 bin/kafka-topics.sh --describe --zookeeper 192.168.65.60:2181 --topic test1 leader节点:负责给定分区的所有读写请求 replicas节点:某分区存在的备份,不管是不是leader,甚至中途挂了都会列出 isr:是replicas的子集,只列存活且一同步备份了该分区的节点 消息日志主要存在分区文件夹以log结尾的文件 目前支持对topic分区数据量进行动态扩容,单不支持缩减 思考:为什么需要分区? 日志文件受到机器文件大小限制,分区后则可将不同分区放到集群中的不同机器上,相当于分布式存储;其次为了提高生产消息与消费消息的并行度;

优秀的个人博客,低调大师

大数据开发-Spark Join原理详解

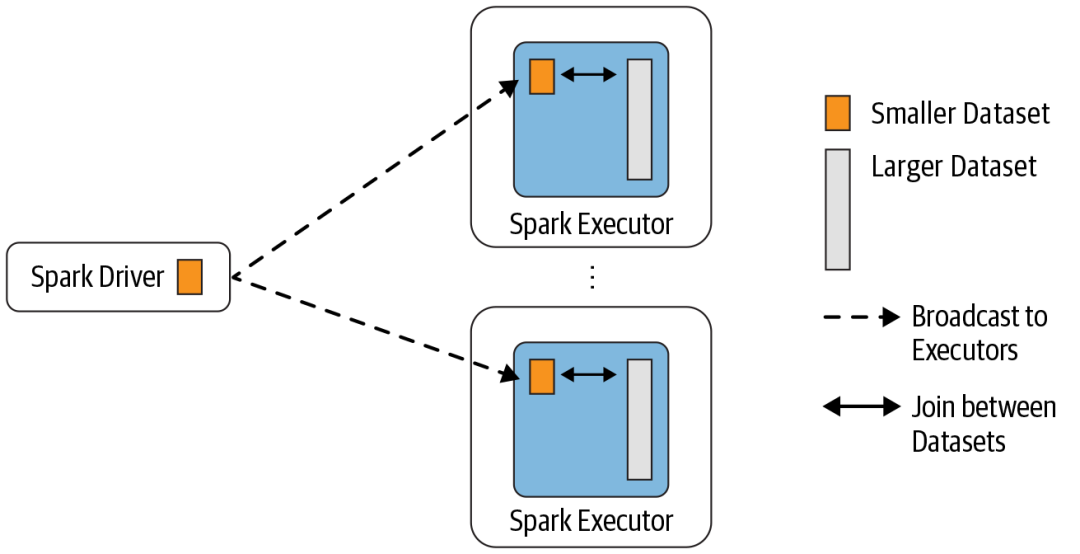
数据分析中将两个数据集进行 Join 操作是很常见的场景。在 Spark 的物理计划阶段,Spark 的 Join Selection 类会根 据 Join hints 策略、Join 表的大小、 Join 是等值 Join 还是不等值以及参与 Join 的 key 是否可以排序等条件来选择最 终的 Join 策略,最后 Spark 会利用选择好的 Join 策略执行最终的计算。当前 Spark 一共支持五种 Join 策略: Broadcast hash join (BHJ) Shuffle hash join(SHJ) Shuffle sort merge join (SMJ) Shuffle-and-replicate nested loop join,又称笛卡尔积(Cartesian product join) Broadcast nested loop join (BNLJ) 其中 BHJ 和 SMJ 这两种 Join 策略是我们运行 Spark 作业最常见的。JoinSelection 会先根据 Join 的 Key 为等值 Join 来选择 Broadcast hash join、Shuffle hash join 以及 Shuffle sort merge join 中的一个;如果 Join 的 Key 为不等值 Join 或者没有指定 Join 条件,则会选择 Broadcast nested loop join 或 Shuffle-and-replicate nested loop join。 不同的 Join 策略在执行上效率差别很大,了解每种 Join 策略的执行过程和适用条件是很有必要的。 1、Broadcast Hash Join Broadcast Hash Join 的实现是将小表的数据广播到 Spark 所有的 Executor 端,这个广播过程和我们自己去广播数 据没什么区别: 利用 collect 算子将小表的数据从 Executor 端拉到 Driver 端 在 Driver 端调用 sparkContext.broadcast 广播到所有 Executor 端 在 Executor 端使用广播的数据与大表进行 Join 操作(实际上是执行map操作) 这种 Join 策略避免了 Shuffle 操作。一般而言,Broadcast Hash Join 会比其他 Join 策略执行的要快。 使用这种 Join 策略必须满足以下条件: 小表的数据必须很小,可以通过 spark.sql.autoBroadcastJoinThreshold 参数来配置,默认是 10MB 如果内存比较大,可以将阈值适当加大 将 spark.sql.autoBroadcastJoinThreshold 参数设置为 -1,可以关闭这种连接方式 只能用于等值 Join,不要求参与 Join 的 keys 可排序 2、Shuffle Hash Join 当表中的数据比较大,又不适合使用广播,这个时候就可以考虑使用 Shuffle Hash Join。 Shuffle Hash Join 同样是在大表和小表进行 Join 的时候选择的一种策略。它的计算思想是:把大表和小表按照相同 的分区算法和分区数进行分区(根据参与 Join 的 keys 进行分区),这样就保证了 hash 值一样的数据都分发到同一 个分区中,然后在同一个 Executor 中两张表 hash 值一样的分区就可以在本地进行 hash Join 了。在进行 Join 之 前,还会对小表的分区构建 Hash Map。Shuffle hash join 利用了分治思想,把大问题拆解成小问题去解决。 要启用 Shuffle Hash Join 必须满足以下条件: 仅支持等值 Join,不要求参与 Join 的 Keys 可排序 spark.sql.join.preferSortMergeJoin 参数必须设置为 false,参数是从 Spark 2.0.0 版本引入的,默认值为 true,也就是默认情况下选择 Sort Merge Join 小表的大小(plan.stats.sizeInBytes)必须小于 spark.sql.autoBroadcastJoinThreshold * spark.sql.shuffle.partitions(默认值200) 而且小表大小(stats.sizeInBytes)的三倍必须小于等于大表的大小(stats.sizeInBytes),也就是 a.stats.sizeInBytes * 3 < = b.stats.sizeInBytes 3、Shuffle Sort Merge Join 前面两种 Join 策略对表的大小都有条件的,如果参与 Join 的表都很大,这时候就得考虑用 Shuffle Sort Merge Join 了。 Shuffle Sort Merge Join 的实现思想: 将两张表按照 join key 进行shuffle,保证join key值相同的记录会被分在相应的分区 对每个分区内的数据进行排序 排序后再对相应的分区内的记录进行连接 无论分区有多大,Sort Merge Join都不用把一侧的数据全部加载到内存中,而是即用即丢;因为两个序列都有序。从 头遍历,碰到key相同的就输出,如果不同,左边小就继续取左边,反之取右边。从而大大提高了大数据量下sql join 的稳定性。 要启用 Shuffle Sort Merge Join 必须满足以下条件: 仅支持等值 Join,并且要求参与 Join 的 Keys 可排序 4、Cartesian product join 如果 Spark 中两张参与 Join 的表没指定连接条件,那么会产生 Cartesian product join,这个 Join 得到的结果其实 就是两张表行数的乘积。 5、Broadcast nested loop join 可以把 Broadcast nested loop join 的执行看做下面的计算: for record_1 in relation_1: for record_2 in relation_2: join condition is executed 可以看出 Broadcast nested loop join 在某些情况会对某张表重复扫描多次,效率非常低下。从名字可以看出,这种 join 会根据相关条件对小表进行广播,以减少表的扫描次数。 Broadcast nested loop join 支持等值和不等值 Join,支持所有的 Join 类型。 大数据开发,更多关注查看个人资料

优秀的个人博客,低调大师

Spring循环依赖原理,如何解决?

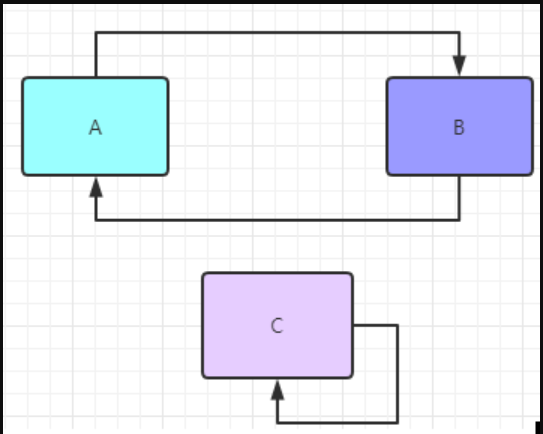
什么是循环依赖? 从字面上来理解就是A依赖B的同时B也依赖了A,就像上面这样,或者C依赖与自己本身。体现到代码层次就是这个样子 @Component publicclassA{ //A中注入了B @Autowired privateBb; } --- @Component publicclassA{ //A中注入了B @Autowired privateBb; } --- //自己依赖自己 @Component publicclassC{ //C中注入了C @Autowired privateCc; } 虽然体现形式不一样,但是实际上都是循环依赖的问题。 什么情况下循环依赖可以被处理? Spring解决循环依赖是有前置条件的 出现循环依赖的Bean必须要是单例(singleton),如果依赖prototype则完全不会有此需求。 依赖注入的方式不能全是构造器注入的方式(只能解决setter方法的循环依赖,这是错误的) 1. AB 均采用setter方法注入 结果OK 2. AB 均采用属性Autowired注入 结果ok 3. AB均采用构造器方法注入 出现循环依赖 4. A中注入B的方式为setter方法,B中注入A的方式为构造器 5. A中注入B的方式为构造器,B中注入A的方式为setter方法。 结论 依赖情况 依赖注入方式 是否解决 AB相互依赖(循环依赖) 均采用setter方法注入 是 AB相互依赖(循环依赖) 均采用属性自动注入 是 AB相互依赖(循环依赖) 均采用构造器注入 否 AB相互依赖(循环依赖) A中注入B的方式为setter方法,B中注入A的方式为构造器 是 AB相互依赖(循环依赖) B中注入A的方式为setter方法,A中注入B的方式为构造器,Spring在创建Bean时默认会根据自然排序进行创建,A会先于B进行创建 否 从上面的测试结果我们可以看到,不是只有在setter方法注入的情况下循环依赖才能被解决,即使存在构造器注入的场景下,循环依赖依然被可以被正常处理掉。 Spring循环依赖的通俗说 Spring bean 的创建,其本质上还是一个对象的创建,既然是对象,一定要明白一点就是,一个完整的对象包含两部分:当前对象实例化和对象属性的实例化。在Spring中,对象的实例化是通过反射实现的,而对象的属性则是在对象实例化之后通过一定的方式设置的。这个过程可以按照如下方式进行理解: 大致绘制依赖流程图如下: 图中getBean()表示调用Spring的ApplicationContext.getBean()方法,而该方法中的参数,则表示我们要尝试获取的目标对象。图中的黑色箭头表示一开始的方法调用走向,走到最后,返回了Spring中缓存的A对象之后,表示递归调用返回了,此时使用绿色箭头表示。从图中我们可以很清楚的看到,B对象的a属性是在第三步中注入的半成品A对象,而A对象的b属性是在第二步中注入的成品B对象,此时半成品的A对象也就变成了成品的A对象,因为其属性已经设置完成了。 到这里,Spring整个解决循环依赖问题的实现思路已经比较清楚了。对于整体过程只要理解两点: Spring是通过递归的方式获取目标bean及其所依赖的bean的; Spring实例化一个bean的时候,是分两步进行的,首先实例化目标bean,然后为其注入属性。 结合这两点,也就是说,Spring在实例化一个bean的时候,是首先递归的实例化其所依赖的所有bean,直到某个bean没有依赖其他bean,此时就会将该实例返回,然后反递归的将获取到的bean设置为各个上层bean的属性的。 Spring循环依赖进阶 一个对象一般创建过程有3部分组成: 实例化:简单理解就是new了一个对象 属性注入:为实例化中new出来的对象填充属性 初始化:执行aware接口中的方法,初始化方法,完成AOP代理 Spring是通过「三级缓存」来解决上述问题的: singletonObjects:一级缓存 存储的是所有创建好了的单例Bean earlySingletonObjects:完成实例化,但是还未进行属性注入及初始化的对象 singletonFactories:提前暴露的一个单例工厂,二级缓存中存储的就是从这个工厂中获取到的对象 然后接下来说下普通循环依赖跟带AOP的循环依赖。 普通循环依赖图 结论:没有进行AOP的Bean间的循环依赖 从上图分析可以看出,这种情况下「三级缓存根本没用」!所以不会存在什么提高了效率的说法 带AOP循环依赖 带AOP的跟不带AOP的其实几乎一样,只是在三级缓存中存放的是函数式接口,在需要调用时直接返回代理对象。三级缓存存在的意义: ❝ 只有真正发生循环依赖的时候,才去提前生成代理对象,否则只会创建一个工厂并将其放入到三级缓存中,但是不会去通过这个工厂去真正创建对象 ❞ 是否可以用二级缓存而不用三级缓存? ❝ 答案:不可以,违背Spring在结合AOP跟Bean的生命周期的设计!Spring结合AOP跟Bean的生命周期(看下图)本身就是通过AnnotationAwareAspectJAutoProxyCreator这个后置处理器来完成的,在这个后置处理的postProcessAfterInitialization方法中对初始化后的Bean完成AOP代理。如果出现了循环依赖,那没有办法,只有给Bean先创建代理,但是没有出现循环依赖的情况下,设计之初就是让Bean在生命周期的「最后一步完成代理而不是在实例化后就立马完成代理」。 ❞ 使用了三级缓存的情况下,A、B的创建流程 不使用三级缓存,直接在二级缓存中 结论:上面两个流程的唯一区别在于为A对象创建代理的时机不同,使用三级缓存的情况下为A创建代理的时机是在B中需要注入A的时候,而不使用三级缓存的话在A实例化后就需要马上为A创建代理然后放入到二级缓存中去。三级缓存是无法提速的! 回答模板 Spring如何解决循环依赖的 答:Spring通过三级缓存解决了循环依赖,其中一级缓存为单例池(singletonObjects),二级缓存为早期曝光对象earlySingletonObjects,三级缓存为早期曝光对象工厂(singletonFactories)。 当A、B两个类发生循环引用时,在A完成实例化后,就使用实例化后的对象去创建一个对象工厂,添加到三级缓存中,如果A被AOP代理,那么通过这个工厂获取到的就是A代理后的对象,如果A没有被AOP代理,那么这个工厂获取到的就是A实例化的对象。 当A进行属性注入时,会去创建B,同时B又依赖了A,所以创建B的同时又会去调用getBean(a)来获取需要的依赖,此时的getBean(a)会从缓存中获取: ❝ 第一步:先获取到三级缓存中的工厂; 第二步:调用对象工工厂的getObject方法来获取到对应的对象,得到这个对象后将其注入到B中。紧接着B会走完它的生命周期流程,包括初始化、后置处理器等。 第三步:当B创建完后,会将B再注入到A中,此时A再完成它的整个生命周期。至此,循环依赖结束! ❞ 面试官:为什么要使用三级缓存呢?二级缓存能解决循环依赖吗? ❝ 答:如果要使用二级缓存解决循环依赖,意味着所有Bean在实例化后就要完成AOP代理,这样违背了Spring设计的原则,Spring在设计之初就是通过AnnotationAwareAspectJAutoProxyCreator这个后置处理器来在Bean生命周期的最后一步来完成AOP代理,而不是在实例化后就立马进行AOP代理。 ❞ 跟踪核心大致流程

优秀的个人博客,低调大师

Martian-cloud 传染机制的原理

先解释下什么是传染机制 常规的分布式采用的是【生产者->注册中心->消费者】模型,生产者将接口给注册中心,消费者从注册中心发现其他的服务,实现调用 传染机制就是丢弃注册中心,可以把接口看做病毒,服务看做是人,服务之间只要有直接或者间接的联系,最终都会被染上病毒(接口) 如何实现的 假如现在有三个服务 此时,需要发布这三个服务,那我们可以先规划下,将他们连在一起,连在一起的意思是在配置里写好谁连谁。 连接方式可以是这样【图1】 也可以是这样【图2】 也可以是这样【图3】 总之,只要别让任何服务落单就行,随便怎么连,你甚至可以来一个五花大绑(不过不建议) ----------------------------------------------------------------- 连接以后就到发布阶段了,那么发布的时候,这些服务之间会发生什么呢? 发布时会发生什么 我们拿【图1】来举例 1. 首先我们启动A服务,启动后由于其他服务还未启动,所以A连接不到B,所以此时A的本地接口缓存表是空的,如下图 2. 为了避免大家觉得过程过于理想,所以接下来我启动C,而不是启动B C启动后,由于B还没启动,所以他无法被发现,此时他是孤立的,所以本地缓存的接口依然如下: 3. 接下来就是启动B了,当B启动后,会立刻被A发现,所以A会从B获取一次接口,此时本地缓存如下: A获取到接口以后还会再做一件事,那就是发广播,流程如下: 由于本地缓存的是接口,而很多接口都来自同一个服务,所以需要从本地缓存中先提取出这些服务的ip和端口号 经过了第1步以后,会得到一批ip和端口号(按照本示例来说,提取出来的就是B的ip和端口) A会将自己的所有接口(是自己的所有接口,不是本地缓存的接口)广播给这批IP和端口号,(按照本示例来说,A会把自己的接口广播给B) 经过广播以后,此时本地接口缓存变成了下面这样: 上面是A发现B的过程,那么C的接口如何传染给别人呢? 我们刚才都是用【图1】在举例,所以在【图1】我们可以看出B连接的是C,所以当B启动时,除了被A发现完成上面讲述的一系列流程,他还会去发现C,发现C以后,他会从C获取一次接口,所以本地缓存如下: B拿到接口后,依然会像A一样发起一次广播,广播以后本地缓存就变成了这样: 接下来就有意思了,A和C是如何传染的? 很简单,我们先来回顾一下 服务启动时的过程: 从连接的服务上获取接口【如果服务已经启动了,那就是随机从本地缓存的接口中提取一个服务,去获取那个服务上缓存的接口】 给这些服务发起广播【已经被广播过的服务直接忽略】 其实,这个流程是轮询的,并不是一次性的, 所以接下来就轮到A再次执行这个过程了,当他再次执行这个过程的时候,他会从B获取到C的接口,然后将自己的接口广播给C,所以此刻变成了这样: 这样一来,所有的服务都被对方发现了。 服务宕机怎么办 1. 首先是自私机制 所谓的自私机制,就是每个服务只顾自己,不管别人,每个服务如果发现自己本地缓存的接口连接不上,那就会从本地把他下掉,至于别人,他是不管的。 2. 投票机制 这是每个服务的内部投票,跟外面无关,如果一个服务发现他本地缓存的某个接口连接不上,那么他就会给这个接口指向的服务投一票,让它从本机下线,当调通后会把票数清0,当票数积累到一定程度时,这个服务的所有接口都会被从当前服务上清理掉。【每个服务都有一套这样的机制,来维护自己的本地接口缓存】 3. 如果(下线某个服务的决定)是误判怎么办 有一个补偿机制,就是每个服务在下掉别的服务的时候,都会给被下掉的那个服务发一个通知,让他把自己从已广播列表中移除(比如A服务调不通B服务的接口,当票数累积到一定程度后,A会把B的接口全部清理掉,清理后A会给B发一个通知,让B把A从已广播列表移除,这样如果B服务没挂,那么B在下一次轮询时 会把接口重新广播给A) 如果B服务明明没挂,但是A服务连续调不通,而且连下线通知都无法通知到B服务,那我只能说B服务活该了,即使是误判也比留着报错影响性能好吧。 4. 调不通的情况有很多,不一定是服务挂了,那么什么样的情况会给服务投下线票 很简单,当调用接口时,出现了以下三种异常,就会投票 ConnectException ,连接不上,这不是404之类的,而是根本连不上这个ip:port UnknownHostException,无法解析地址,提供的 ip:port 无法被解析识别 SocketTimeoutException,连接超时,不是read time out,而是 connect time out 5. 然后是垃圾回收机制 垃圾回收很简单,就是定时去本地缓存中扫描出被下线的服务的接口,然后删除掉。 上面这这一套机制,可以保证当服务宕机以后,接口会自动从其他的服上下线 被链接的那个服务宕机了 如何实现传染 假如B挂了,这个链条就断了,传染是否会受影响呢? 其实不会,因为这个链条 只是启动时有用,启动后就作废了,拿A来说,A只有启动时会去B获取接口,下次轮询的时候,是从本地缓存的接口中随机挑选一个服务 去获取,所以链条不会断。 至于广播,也是广播给本地缓存的服务,并不是配置的这个服务。 所以宕机是不会影响接口传染的 要新添一个服务咋办 很简单,只需要将他连接到正在运行的 任意一个服务上即可,很快它就会浑身染满病毒(接口) 官方网站 http://mars-framework.com

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册