首页 文章 精选 留言 我的

精选列表

搜索[本地知识库],共10000篇文章
优秀的个人博客,低调大师

微软开源 Fara-7B:本地运行的计算机智能助手

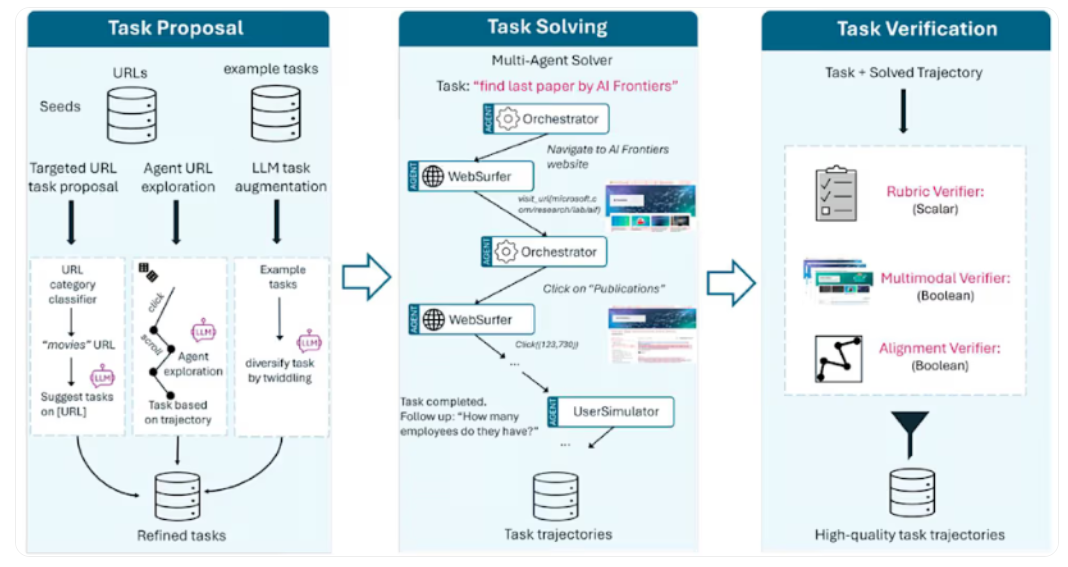
微软开源了 Fara-7B,这是一款拥有70亿参数的新型计算机使用智能助手(Computer Use Agent, CUA),旨在直接在用户的设备上执行复杂任务。 Fara-7B 凭借其小巧的体积,成功突破了企业在数据安全性方面的主要障碍,允许用户自动化处理敏感工作流,比如管理内部账户或处理公司机密数据,而这些信息无需离开设备。 Fara-7B 的工作方式是通过视觉方式识别网页,就像人类使用鼠标和键盘一样。该模型通过截屏来感知网页,并预测特定坐标以执行点击、输入和滚动等操作。与其他依赖于 “可访问性树” 的系统不同,Fara-7B 完全依赖像素级的视觉数据,这使得它在面对复杂或混淆的网页代码时依然能够进行有效互动。 在性能测试中,Fara-7B 在 WebVoyager 这一标准基准上实现了73.5% 的任务成功率,超越了资源占用更大的系统,如 GPT-4o(65.1%)和本土的 UI-TARS-1.5-7B(66.4%)。此外,Fara-7B 的效率也很突出,平均仅需约16个步骤就能完成任务,而 UI-TARS-1.5-7B 大约需要41个步骤。 尽管 Fara-7B 的推出令人期待,但它也面临与其他 AI 模型相同的风险,比如可能出现的误判和在复杂指令下的执行错误。为了解决这些问题,Fara-7B 经过训练,可以识别 “关键点”,即在需要用户个人数据或同意的情况下,主动暂停并请求用户批准,以避免不可逆的操作。微软研究团队设计了一种名为 Magentic-UI 的用户界面,旨在平衡这些关键点和用户体验,以减少用户疲劳。 Fara-7B 的开发也展示了知识蒸馏的趋势,将复杂系统的能力压缩成更高效的小模型。未来的版本将致力于使模型更加智能,而非单纯增大体积,并探讨在实时沙盒环境中通过强化学习来进行学习。

优秀的个人博客,低调大师

本地环境运行Llama 3大型模型:可行性与实践指南

简介: Llama 是由 Meta(前身为 Facebook)的人工智能研究团队开发并开源的大型语言模型(LLM),它对商业用途开放,对整个人工智能领域产生了深远的影响。继之前发布的、支持4096个上下文的Llama 2模型之后,Meta 进一步推出了性能更卓越的 Meta Llama 3系列语言模型,包括一个8B(80亿参数)模型和一个70B(700亿参数)模型。Llama 3 70B 的性能媲美 Gemini 1.5 Pro,全面超越 Claude 大杯,而 400B+ 的模型则有望与 Claude 超大杯和新版 GPT-4 Turbo 掰手腕 在各种测试基准中,Llama 3系列模型展现了其卓越的性能,它们在实用性和安全性评估方面与市场上其他流行的闭源模型相媲美,甚至在某些方面有所超越。Meta Llama 3系列的发布,不仅巩固了其在大型语言模型领域的竞争地位,而且为研究人员、开发者和企业提供了强大的工具,以推动语言理解和生成技术的进一步发展。 项目地址: https://github.com/meta-llama/llama3 llama2和llama3的差异 llama3和GPT4的差异 指标 Llama 3 GPT-4 模型规模 70B、400B+ 100B、175B、500B 参数类型 Transformer Transformer 训练目标 Masked Language Modeling、Perplexity Masked Language Modeling、Perplexity 训练数据 Books、WebText Books、WebText 性能 SOTA(问答、文本摘要、机器翻译等) SOTA(问答、文本摘要、机器翻译等) 开源 是 否 Llama 3 的亮点 面向所有人开放:Meta 通过开源 Llama 3 的轻量版本,让前沿的 AI 技术变得触手可及。无论是开发者、研究人员还是对 AI 技术好奇的小伙伴,都可以自由地探索、创造和实验。 Llama 3 提供了易于使用的 API,方便研究人员和开发者使用。 模型规模大:Llama 3 400B+ 模型的参数规模达到了 4000 亿,属于大型语言模型。 即将融入各种应用: Llama 3 目前已经赋能 Meta AI,Meta AI体验地址:https://www.meta.ai/ 在 Windows 上使用 Ollama,运行Llama3模型 访问https://ollama.com/download/windows页面,下载OllamaSetup.exe安装程序。 安装后,根据自身电脑配置,选择对应模型参数安装(运行 7B 至少需要 8GB 内存,运行 13B 至少需要 16GB 内存) 我这里运行的是Llama3:8b,可以看出,中文还是有点问题 Model Parameters Size Download Llama 3 8B 4.7GB ollama run llama3 Llama 3 70B 40GB ollama run llama3:70b Mistral 7B 4.1GB ollama run mistral Dolphin Phi 2.7B 1.6GB ollama run dolphin-phi Phi-2 2.7B 1.7GB ollama run phi Neural Chat 7B 4.1GB ollama run neural-chat Starling 7B 4.1GB ollama run starling-lm Code Llama 7B 3.8GB ollama run codellama Llama 2 Uncensored 7B 3.8GB ollama run llama2-uncensored Llama 2 13B 13B 7.3GB ollama run llama2:13b Llama 2 70B 70B 39GB ollama run llama2:70b Orca Mini 3B 1.9GB ollama run orca-mini LLaVA 7B 4.5GB ollama run llava Gemma 2B 1.4GB ollama run gemma:2b Gemma 7B 4.8GB ollama run gemma:7b Solar 10.7B 6.1GB ollama run solar Hugging Face 使用 访问:https://huggingface.co/chat/ 然后切换Models Replicate 使用 8B 模型:https://replicate.com/meta/meta-llama-3-8b 70B 模型:https://replicate.com/meta/meta-llama-3-70b 本文是转载文章 珩小派,版权归原作者所有。建议访问原文,转载本文请联系原作者。

优秀的个人博客,低调大师

本地运行 Google 最新开源的 Gemma 系列模型,只需5分钟

昨天,Google 宣布开源 Gemma 模型,其中包含了 Gemma-2b-it 与 Gemma-7b-it,加入开源 LLM 大家庭。 Google Gemma 模型系列专为一系列文本生成任务而设计,例如问答、摘要和推理。 这些轻量级、最先进的模型采用与 Gemini 模型相同的技术构建,提供文本生文本、仅限 decoder 的功能。 Gemma 系列是英文大模型,有开放权重、预训练变体和指令调整版本,使其适合在资源有限的环境中部署。根据谷歌的文章,Gemma-7b 比 同样参数的 Llama-2 7B性能更好,甚至超越了 Llama-2 13B。 本文中,以 Gemma-7b-it 为例,我们将介绍一下内容。你可以参考本文,更改命令行上的模型名称来运行 Gemma-2b-it。 如何在自己的设备上运行 Gemma-7b-it 如何为 Gemma-7b-it 创建兼容OpenAI的API服务 我们将使用 LlamaEdge(Rust + Wasm技术栈)来为该模型开发和部署应用程序。无需安装复杂的 Python 包或 C++ 工具链!了解我们为何选择此技术栈。 在自己的设备上运行 Gemma-7b-it 步骤1:通过以下命令行安装WasmEdge。 curl -sSf https://raw.githubusercontent.com/WasmEdge/WasmEdge/master/utils/install.sh | bash -s -- --plugin wasi_nn-ggml 步骤2:下载 Gemma-7b-it 模型 GGUF 文件。模型大小为 5.88G ,下载可能需要一定时间。内存有限的话,也可以使用 Gemma-2b-it,Q5_K_M 的大小为 1.36G,并且性能相当不错。 curl -LO https://huggingface.co/second-state/Gemma-7b-it-GGUF/resolve/main/gemma-7b-it-Q5_K_M.gguf 步骤3:下载一个跨平台的可移植 Wasm 文件,用于聊天应用。该应用让你能在命令行中与模型聊天。该应用的 Rust 源代码在这里。 curl -LO https://github.com/LlamaEdge/LlamaEdge/releases/latest/download/llama-chat.wasm 就是这样。可以通过输入以下命令在终端与模型聊天。 wasmedge --dir .:. --nn-preload default:GGML:AUTO:gemma-7b-it-Q5_K_M.gguf llama-chat.wasm -p gemma-instruct -c 4096 这个可移植的 Wasm 应用会自动调用设备上的硬件加速器(例如GPU加速)。 [You]: Create JSON for the following: There are 3 people, two males, One is named Mark. Another is named Joe. And a third person, who is a woman, is named Sam. The women is age 30 and the two men are both 19. [Bot]: { "people": [ { "name": "Mark", "age": 19 }, { "name": "Joe", "age": 19 }, { "name": "Sam", "age": 30 } ] } 为 Gemma-7b-it 创建兼容 OpenAI 的 API 服务 一个兼容 OpenAI 的 Web API 能让模型与不同的 LLM 工具和代理框架(如 flows.network、LangChain 和 LlamaIndex)一起工作。 下载一个 API 服务器应用。它也是一个跨平台的可移植 Wasm 应用,可以在不同 CPU、GPU 等设备运行。 curl -LO https://github.com/LlamaEdge/LlamaEdge/releases/latest/download/llama-api-server.wasm 然后,下载聊天机器人 Web UI,从而通过聊天机器人 UI 与模型进行交互。 curl -LO https://github.com/LlamaEdge/chatbot-ui/releases/latest/download/chatbot-ui.tar.gz tar xzf chatbot-ui.tar.gz rm chatbot-ui.tar.gz 接下来,使用以下命令行启动模型的 API 服务器。然后,打开浏览器访问 http://localhost:8080 开始聊天! wasmedge --dir .:. --nn-preload default:GGML:AUTO:gemma-7b-it-Q5_K_M.gguf llama-chat.wasm -p gemma-instruct -c 4096 从另一个终端, 你可以使用 curl 与 API 服务器进行交互。 curl -X POST http://localhost:8080/v1/chat/completions \ -H 'accept:application/json' \ -H 'Content-Type: application/json' \ -d '{"messages":[{"role":"system", "content": "You are a sentient, superintelligent artificial general intelligence, here to teach and assist me."}, {"role":"user", "content": "Write a short story about Goku discovering kirby has teamed up with Majin Buu to destroy the world."}], "model":"Gemma-7b-it"}' 就是这样啦。WasmEdge 是运行 LLM 应用最简单、最快、最安全的方式。试试看吧! 联系我们! 加入 WasmEdge discord 提问并分享见解。 对运行此模型有疑问?请访问 second-state/LlamaEdge 提 issue 或预约演示,跨设备上享运行 LLM!


资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册