首页 文章 精选 留言 我的

精选列表

搜索[文档解析],共10000篇文章
优秀的个人博客,低调大师

Taro on HarmonyOS 技术架构深度解析

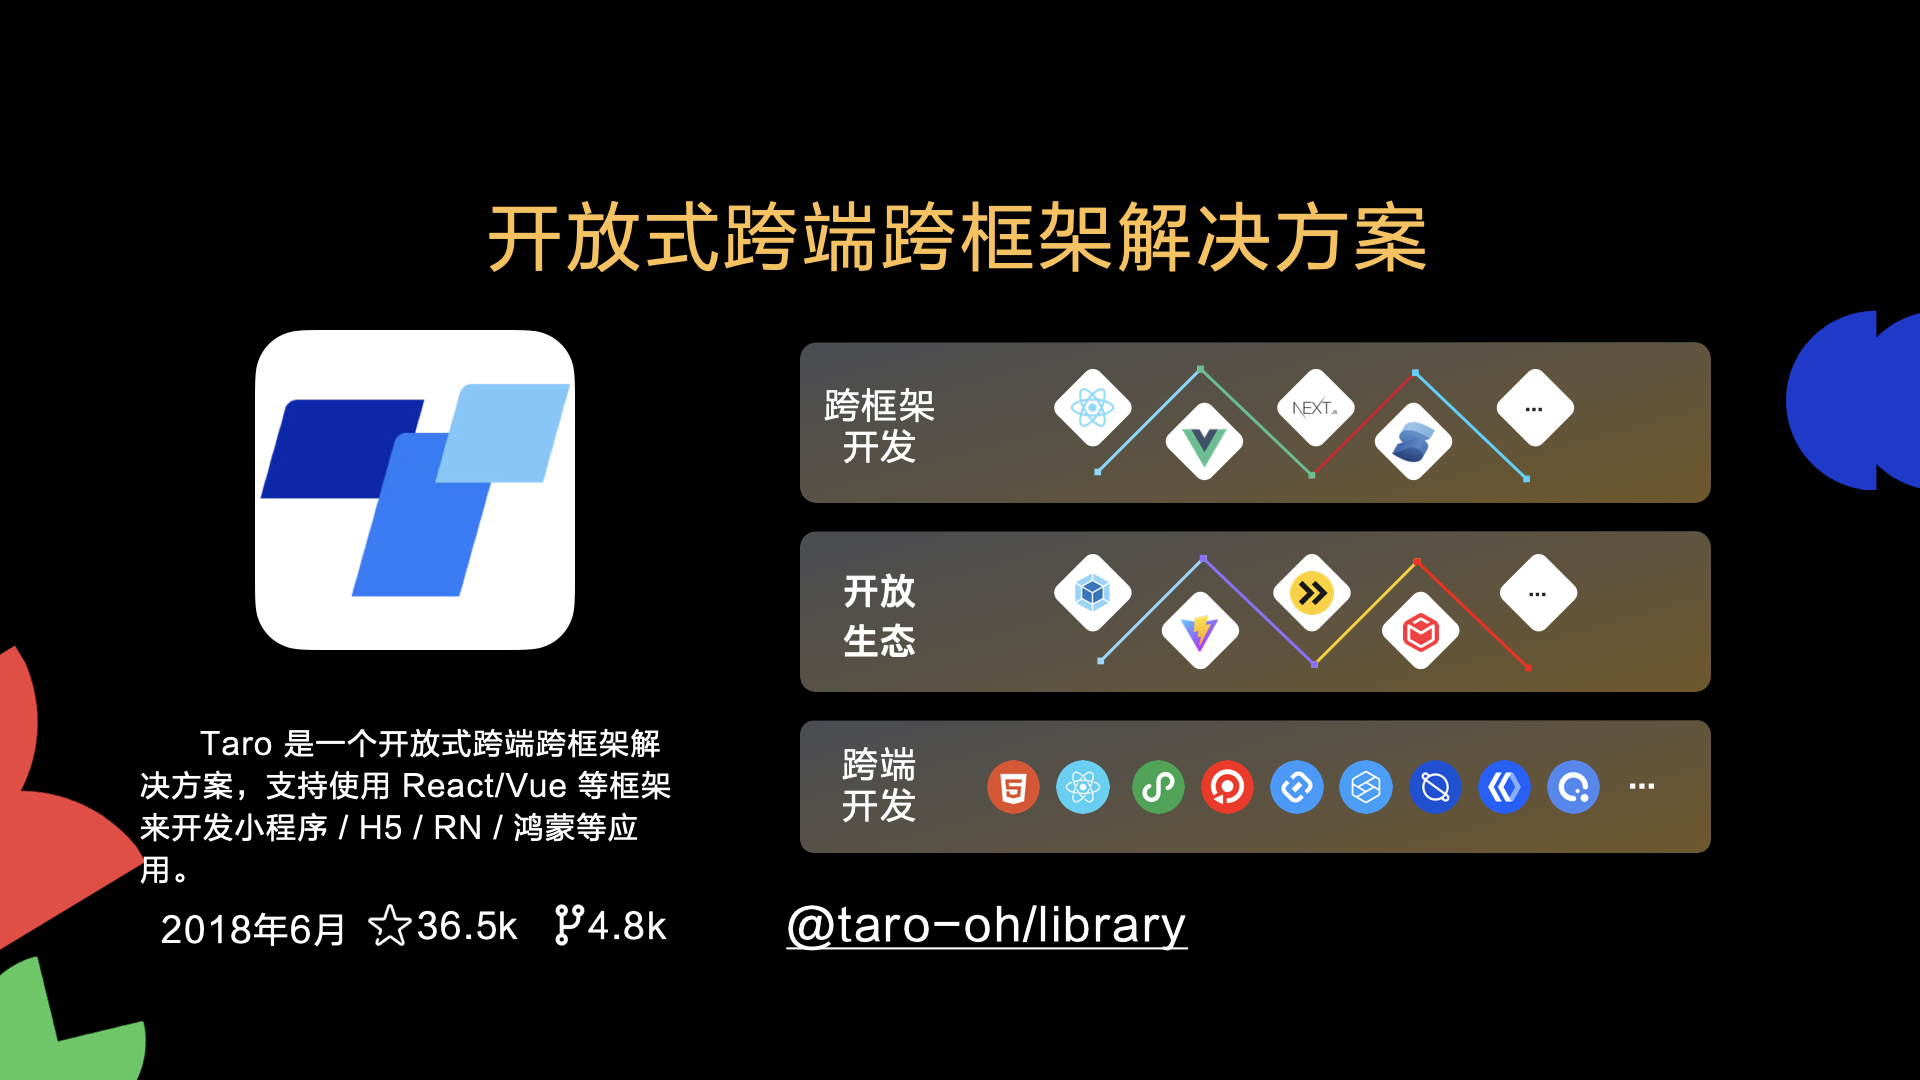
2025 年 6 月,在华为开发者大会 2025 开发者场景技术共建分论坛,本文作者进行了《京东 Taro 框架鸿蒙版本正式开源 助力鸿蒙版三方应用开发》专题演讲。期间阐述了 Taro on HarmonyOS 的技术实现方案、核心优化策略,以及开源版本的主要特性。 本文将详细介绍 Taro on HarmonyOS 的技术架构、性能优化实践和开源进展,分享我们在跨端开发中遇到的问题和解决思路。 期待更多人可以参与开源共建,一起交流讨论! 背景 回顾 Taro 的发展历程,从 2018 年 6 月开源至今,作为开放式的跨端跨框架解决方案在众多热心开源贡献者的支持下,从初出茅庐逐步迈向成熟。 从最初仅支持面向编译时的小程序端解决方案,到如今拥有支持多种前端框架和 UI 库的强大能力;从单一的构建工具,到通过开放生态为开发者提供 Webpack、Vite、ESBuild 等丰富的工具选择,让团队能够定制专属的研发流程;从专注小程序开发,到覆盖各大小程序平台以及 Web、iOS、Android、HarmonyOS 等移动端场景——Taro 的每一步成长都离不开社区的力量。 这些年来,我们在 GitHub 上收获了 36,000+ star 和近 5,000 fork,更重要的是得到了众多企业团队和个人开发者贡献的宝贵功能特性。在此,我们要向所有支持 Taro 发展的朋友们表示衷心的感谢! 技术架构演进 说到 HarmonyOS,Taro 从 2022 年开始布局鸿蒙适配,走过了一条持续演进的技术路径。最初我们推出了 JSUI 版本的端平台插件,为鸿蒙支持打下基础;2023 年开源了 ETS 版本的端平台插件,大幅提升了开发体验和业务性能;而在最近释出的 4.1 版本中,C-API 版本的 Harmony 端平台插件也正式发布了,这标志着 Taro 鸿蒙支持能力的重要突破。 目前,我们仍在持续优化 Harmony C-API 插件的性能表现。团队正在推进多线程以及更多版本特性的内部验证,期待在验证完成后能够将其开源,为开发者在鸿蒙端带来更优秀的研发体验。 面向多端研发 面向多端的复杂场景,从来都不是一件容易的事情。在传统的多端开发中,开发者往往需要面对各端语法标准不统一、组件和 API 接口各异、开发环境复杂多样等诸多挑战。当业务逻辑需要调整时,开发者必须在多个平台上重复实现相同功能,代码复用率极低,维护工作量成倍增长。 如图所示,Taro 现已成功在 HarmonyOS 平台上实现了与 Web 端、小程序及其他平台一致的 UI 呈现效果。 基于 Taro 跨端研发标准推进业务实现,开发者只需编写一套代码,就能够在多个平台上获得统一的用户体验,最大限度地节省多端业务的研发成本,让团队能够将更多精力投入到业务创新上。 京东鸿蒙版 以京东鸿蒙版本为例,基于 Taro on HarmonyOS 解决方案,成功在研发效率与应用性能之间达成了理想平衡,其性能表现和稳定性均位居行业前列。 对于商品详情页等高复杂度、高数据量的核心业务场景,该方案展现出强大的技术适配能力。仅是在单线程 C-API 架构的支持下,这些重载业务场景的运行性能已达到与原生应用相当的水准,充分验证了跨端技术在复杂场景下的可行性。 技术架构 为了达成这一目标,我们需要在技术架构层面进行深度优化。 Taro 在各平台的适配逻辑保持高度一致性。开发者通过统一的 DSL以及标准化的组件和 API 库即可完成全部代码开发,样式规范完全遵循 W3C 标准,使前端开发者能够以极低的学习成本快速上手。 在编译层面,Taro 通过 CLI 工具和插件系统实现各端的差异化处理。各个端平台插件可以在编译核心中选择基于 Webpack、Vite 或 Metro 为基础的编译流程,将开发者的源代码高效转换为各目标平台的可执行代码。 在运行时中,通过集成语法适配器、DOM、BOM 模拟实现以及其他核心模块,确保开发者项目能够在 HarmonyOS 等各类平台上稳定运行,真正实现一码多端的开发愿景。 渲染层适配 尽管 Taro 在 HarmonyOS 平台的插件架构历经多轮重大版本升级,但其核心架构设计依旧可从以下几个维度来理解: 代码转换流程:从开发者编写的 React 代码出发,通过与 React Reconciler 的深度集成,系统构建出完整的虚拟节点树。随后,运行时环境通过模拟的 DOM 和 BOM API,实现 React 节点树与 Taro 内部节点树的精确映射。 平台适配实现:结合标准化的组件库和 API 库,系统将抽象的节点结构转换为 HarmonyOS 平台的原生原子组件,最终构建出完整的 ArkUI 渲染树,并呈现在用户界面上。 扩展能力支持:除了核心渲染流程外,运行时还集成了布局计算、事件处理、动画效果等关键模块,并持续接入更多 HarmonyOS 平台特有能力,为开发者提供完整的跨平台开发体验。 架构方案迭代 在技术架构层面,ETS 方案与 C-API 方案本质上都遵循着相同的设计理念。两者均构建了一套完整的三层节点树体系:应用层的 React 节点树首先转换为中间层的 Taro 节点树,随后进一步映射到底层的 ArkUI 节点树,最终实现界面的完整渲染。 然而,尽管在宏观架构上两种方案展现出高度的相似性,我们仍然坚定地推进从 ETS 向 C-API 的技术转型。这一决策的背后,是团队对性能极致追求的不懈努力。在移动应用开发的激烈竞争中,每一毫秒的性能提升都可能成为用户体验的关键差异点,而 C-API 方案正是在这样的背景下应运而生的技术选择。 C-API 方案带来的性能提升是全方位的。在节点操作层面,我们彻底摒弃了传统的声明式递归构建模式,转而采用更加灵活的实现方式,这为底层节点 API 的深度优化创造了前所未有的空间。同时,通过引入指令式节点操作机制,不同节点树之间的数据交互效率得到了显著改善,原本复杂的跨树通信变得更加高效流畅。 更为重要的是,我们将样式处理、布局计算、事件管理等核心功能模块全面下沉至 C++ 原生层。这一架构调整不仅大幅减少了跨语言调用的频次和开销,更从根本上提升了系统的执行效率。通过这些多维度的优化措施,整个应用的性能表现实现了质的飞跃。 跨端研发标准 在适配鸿蒙和其他各端能力的基础上,Taro 正在构建一套完整的跨端研发标准体系。这套标准不仅能够最大限度地节约不同端之间的适配成本,更重要的是能够充分兼容现有的前端生态系统,让团队多年积累的组件库、工具链和技术沉淀得以无缝复用。 目前,以 React 作为 UI 基础库,该标准已涵盖了 View、Text 等 26 个常用组件和网络请求、图片等 88 个常用 API。在样式规范方面,我们遵循 W3C 标准实现了包含 93 条常用规范的样式子集。与此同时,我们正在持续努力扩充这套标准体系,不断增加新的组件类型、API 接口和样式规范,以满足日益复杂的业务场景需求。 更为关键的是,这套不断完善的标准体系具备良好的扩展性和兼容性,能够与团队现有的 UI 组件库、业务组件以及各类前端工具库形成有机整合。我们致力于通过标准的持续演进,确保开发团队能够在跨端开发中充分发挥既有技术资产的价值,避免重复建设带来的资源浪费,同时为未来更多端侧适配需求预留充足的扩展空间。 为实现跨平台开发的一致性标准,我们设计了 C++ 底层样式处理架构。该架构整合了包括 Yoga 这类成熟布局引擎,构建统一的布局计算体系,保障各端样式渲染的视觉一致性。通过将样式计算逻辑完全迁移至 C-API 底层,系统获得了显著的性能优化潜力——不仅消除了对主渲染线程和业务逻辑的性能干扰,还通过 C++ 的高效执行特性实现了跨端样式处理的统一化管理,从根本上提升了整体渲染效率。 针对鸿蒙端的特殊需求,我们在编译阶段引入了创新的预处理机制。通过在编译流程中的 Rust 插件集成 lightingCSS,我们能够将标准样式预先转换为鸿蒙平台可以识别的样式,进一步节省运行时运算的负担。这一机制不仅实现了 W3C 标准属性到各端专用单位和属性值的智能转换,更为跨端样式的统一管理奠定了坚实的底层基础。 基于这套完善的 C++ 样式处理体系,UI 库和业务团队能够轻松应对各种复杂场景的适配需求。无论是折叠屏的多形态展示、关怀模式的无障碍优化,还是暗黑模式的主题切换,都可以通过灵活的样式选择器机制实现精准控制。同时,动画效果和过渡转场也能够通过高效的样式更新和节点刷新机制,呈现出极为流畅的用户体验。 方案特性 基于此架构,Taro on HarmonyOS 方案积累了丰富的核心特性。 研发效能层面:通过兼容 React 生态体系和 W3C 样式规范,开发者能够充分利用前端成熟的工具链和生态资源,高效完成业务功能迭代与开发调试工作,完善鸿蒙端的开发体验。同时,开发者编写的样式代码可在鸿蒙、小程序和 Web 端无缝复用,实现真正的"一次编写,多端运行"。 生态扩展层面:提供灵活的组件和 API 扩展机制,支持业务团队根据实际需求定制运行时环境。更重要的是,通过跨端统一的原生混合调用方案,Taro C++ 模块与 ArkTS 原生模块可实现双向互调,为团队间协作提供了更多可能性,有效避免重复开发,提升整体研发效率。 性能体验 在 C-API 方案中,我们围绕卓越性能体验实现了多项核心特性: 运行时性能优化 将 DOM Tree、事件处理、样式计算等高频操作模块完全下沉至 C++ 层,显著提升运行时执行效率。通过底层优化,减少了 JavaScript 与原生层之间的频繁通信开销,避免了数据序列化/反序列化的性能损耗。同时,C++ 层的内存管理更加高效,能够更好地控制对象生命周期,减少内存碎片,为复杂应用场景提供更稳定的性能表现。 高阶组件能力 基于 HarmonyOS 原生的 List、WaterFlow 等组件特性,深度定制实现虚拟列表、瀑布流等高性能组件,充分发挥系统级优势。 这些高阶组件不仅继承了系统组件的原生性能,还针对前端开发习惯进行了接口封装,支持动态数据加载、智能缓存策略、滚动性能优化等特性。开发者可以像使用传统前端组件一样轻松实现大数据量的列表展示,无需关心底层的复杂优化逻辑。 图片处理模块 构建专门服务于样式渲染、背景绘制、Image 组件的图片处理系统,实现更优秀的图片加载性能和内存管理。该模块集成了多级缓存机制,支持内存缓存、磁盘缓存和网络缓存的智能调度,大幅减少重复加载时间。 同时提供了图片压缩、格式转换、尺寸适配等功能,能够根据设备性能和网络状况自动选择最优的图片处理策略,有效降低内存占用和网络带宽消耗。 文字与绘图支持 通过 PixelMap 技术为文字组件提供丰富的字体属性和渲染能力,同时为 Canvas 组件及相关 API 提供底层支持,覆盖分享海报生成等复杂业务绘制场景。文字渲染支持多种字体格式、文字效果(阴影、描边、渐变等)和排版布局,满足不同设计需求。 Canvas 绘图能力则支持路径绘制、图形变换、滤镜效果等高级功能,为数据可视化、游戏开发、创意设计等场景提供强大的图形处理能力。 视频播放能力 基于 AVPlayer 重构 Video 组件和相关 API 实现,在 C-API 层直接接入,减少调用链路,为业务提供更灵活的视频适配方案。新的视频播放架构支持多种视频格式和编码标准,提供了精确的播放控制、实时进度反馈、音视频同步等核心功能。 总结展望 Taro 在 HarmonyOS 平台的深度适配,旨在为全场景应用开发开辟新的技术路径。通过构建完善的鸿蒙端能力体系,我们致力于为更广泛的业务场景提供技术支撑,推动跨平台开发在鸿蒙生态中的创新应用。 在实际应用中,Taro 成功支撑了京东鸿蒙 APP 的商业化落地。该应用的首页、搜索推荐以及核心购物流程等关键业务模块均基于 Taro 技术栈开发,在确保快速迭代交付的同时,实现了业界领先的性能表现和系统稳定性。应用上线后迅速在华为应用市场购物类别中登顶,充分验证了技术方案的商业价值。 生态建设与合作拓展 基于成功实践的示范效应,更多京东生态应用正在加速鸿蒙化进程,包括一号会员店、七鲜等重要业务线的鸿蒙版本已上架鸿蒙应用市场或者进入开发阶段。同时,我们的技术方案也获得了外部合作伙伴的认可,58同城、朴朴超市等知名企业均选择采用 Taro 相关的鸿蒙开发解决方案,共同构建更加繁荣的鸿蒙应用生态。 未来展望 我们将持续深化开源战略,在内部版本充分验证后,逐步向社区开放多线程等更多核心技术特性。同时不断扩展跨端标准覆盖范围,让更多组件和 API 实现跨平台一致性,为开发者提供更优质的开发体验和更完善的调试工具链,也为动态化能力构建更坚实的技术基础。 在性能优化方面,我们将持续推进更多核心模块向 C++ 层迁移,包括 React 的 C++ 版本实现和高频 API 运行时模块优化,同时积极借鉴节点树扁平化等社区验证的优秀实践。 虽然 Taro on HarmonyOS 的 C-API 版本插件开源时间不长,但已经吸引了众多开发者的积极参与。我们期待更多技术同仁能够加入这个充满活力的开源生态,共同推动 Taro on HarmonyOS 方案的不断完善,在开源共建的道路上续写跨端开发的新篇章。

优秀的个人博客,低调大师

ThreadLocal源码解析及实战应用

作者:京东物流 闫鹏勃 1 什么是ThreadLocal? ThreadLocal是一个关于创建线程局部变量的类。 通常情况下,我们创建的变量是可以被任何一个线程访问并修改的。而使用ThreadLocal创建的变量只能被当前线程访问,其他线程则无法访问和修改。ThreadLocal在设计之初就是为解决并发问题而提供一种方案,每个线程维护一份自己的数据,达到线程隔离的效果。 2 有什么作用? 2.1 set once,get everywhere 在现在的系统设计中,前后端分离已基本成为常态,分离之后如何获取用户信息就成了一件麻烦事,通常在用户登录后, 用户信息会保存在Session或者Token中。这个时候,我们如果使用常规的手段去获取用户信息会很费劲,拿Session来说,我们要在接口参数中加上HttpServletRequest对象,然后调用 getSession方法,且每一个需要用户信息的接口都要加上这个参数,才能获取Session,这样实现就很麻烦了。 在实际的系统设计中,我们肯定不会采用上面所说的这种方式,而是使用ThreadLocal,我们会选择在拦截器的业务中, 获取到保存的用户信息,然后存入ThreadLocal,那么当前线程在任何地方如果需要拿到用户信息都可以使用ThreadLocal的get()方法 (异步程序中ThreadLocal是不可靠的) 2.2 线程安全,空间换时间 在Spring的Web项目中,我们通常会将业务分为Controller层,Service层,Dao层, 我们都知道@Autowired注解默认使用单例模式,那么不同请求线程进来之后,由于Dao层使用单例,那么负责数据库连接的Connection也只有一个, 如果每个请求线程都去连接数据库,那么就会造成线程不安全的问题,Spring是如何解决这个问题的呢? 在Spring项目中Dao层中装配的Connection肯定是线程安全的,其解决方案就是采用ThreadLocal方法,当每个请求线程使用Connection的时候, 都会从ThreadLocal获取一次,如果为null,说明没有进行过数据库连接,连接后存入ThreadLocal中,如此一来,每一个请求线程都保存有一份 自己的Connection。于是便解决了线程安全问题 3 ThreadLocal实战应用 3.1 ehr中的使用 在登录拦截器中将用户信息写入,后续使用时方便取值 3.2 分页插件PageHelper中的应用 3.3 AopContext 4 源码解读 你是否有这样的疑惑?为什么可以直接拿到?对象存放在哪里?存在什么问题? 4.1 get方法 在 get() 方法中也会获取到当前线程的 ThreadLocalMap,如果 ThreadLocalMap 不为 null,则把获取 key 为当前 ThreadLocal 的值;否则调用 setInitialValue() 方法返回初始值,并保存到新创建的 ThreadLocalMap 中。 4.2 set方法 调用set时,直接调用set(T value) 方法中,首先获取当前线程,然后在获取到当前线程的 ThreadLocalMap,如果 ThreadLocalMap 不为 null,则将 value 保存到 ThreadLocalMap 中,并用当前 ThreadLocal 作为 key;否则创建一个 ThreadLocalMap 并给到当前线程,然后保存 value。 ThreadLocalMap 相当于一个 HashMap,是真正保存值的地方 map的set,如果map为空,则创建一个 4.3 initialValue() 方法 initialValue() 是 ThreadLocal 的初始值,默认返回 null,子类可以重写改方法,用于设置 ThreadLocal 的初始值。 4.4 remove() 方法 ThreadLocal 还有一个 remove() 方法,用来移除当前 ThreadLocal 对应的值。同样也是同过当前线程的 ThreadLocalMap 来移除相应的值。 getMap拿到了什么? 在 set,get,initialValue 和 remove 方法中都会获取到当前线程,然后通过当前线程获取到 ThreadLocalMap,如果 ThreadLocalMap 为 null,则会创建一个 ThreadLocalMap,并给到当前线程 此处t是Thread,直接可以“点”拿到这个map 每个Thread对象内部都维护了一个ThreadLocalMap这样一个ThreadLocal的Map,可以存放若干个ThreadLocal 在使用 ThreadLocal 类型变量进行相关操作时,都会通过当前线程获取到 ThreadLocalMap 来完成操作。每个线程的 ThreadLocalMap 是属于线程自己的,ThreadLocalMap 中维护的值也是属于线程自己的。这就保证了 ThreadLocal 类型的变量在每个线程中是独立的,在多线程环境下不会相互影响。 5 使用注意事项 1)有可能导致内存泄漏,使用完毕后,需要remove 在 ThreadLocalMap 的 set(),get() 和 remove() 方法中,都有清除无效 Entry 的操作,这样做是为了降低内存泄漏发生的可能。 Entry 中的 key 使用了弱引用的方式,这样做是为了降低内存泄漏发生的概率,但不能完全避免内存泄漏。 假设 Entry 的 key 没有使用弱引用的方式,而是使用了强引用:由于 ThreadLocalMap 的生命周期和当前线程一样长,那么当引用 ThreadLocal 的对象被回收后,由于 ThreadLocalMap 还持有 ThreadLocal 和对应 value 的强引用,ThreadLocal 和对应的 value 是不会被回收的,这就导致了内存泄漏。所以 Entry 以弱引用的方式避免了 ThreadLocal 没有被回收而导致的内存泄漏,但是此时 value 仍然是无法回收的,依然会导致内存泄漏。 ThreadLocalMap 已经考虑到这种情况,并且有一些防护措施:在调用 ThreadLocal 的 get(),set() 和 remove() 的时候都会清除当前线程 ThreadLocalMap 中所有 key 为 null 的 value。这样可以降低内存泄漏发生的概率。所以我们在使用 ThreadLocal 的时候,每次用完 ThreadLocal 都调用 remove() 方法,清除数据,防止内存泄漏。 2)使用线程池时,父子线程传递慎用,因为初始化时机为线程创建时 3)针对2有什么方案可以解决? TransmittableThreadLocal 源码地址:https://github.com/alibaba/transmittable-thread-local 详解:https://www.jianshu.com/p/e0774f965aa3

优秀的个人博客,低调大师

使用 dotMemory 优化 dotMemory | 技术解析

dotMemory1是 JetBrains 推出的一款 .NET 内存分析器。我要讲一个经典的内部测试故事,在故事里我们用自己的工具 dotMemory 和dotTrace2 优化了 dotMemory 的一种算法。我们还使用 dotTrace 对其进行了更多改进,并使用 BenchmarkDotNet3完成了优化过程。 最开始,一位同事在 Slack 中给我发送消息,告诉我他在 dotMemory 的支配树4上遇到了问题。树的数据计算时间太长了,他实在等不到进程结束。好在问题是内部的,我们收集内存快照并展开了调查。 在本地机器上重现问题时,我们发现内存使用以每秒 1.17 GB 的速度快速增长,迫使进程开始使用交换文件。发生这种情况通常就意味着无法在合理的时间范围内收到结果。接下来,该用 dotMemory 解决 dotMemory 中的问题了。 进程完全耗尽物理内存后,快照会难以捕获,甚至操作系统也不再稳定。因此,我们决定在内存使用开始快速增长时捕获快照,但物理内存还有一些剩余。dotMemory 控制台分析器5是完成这项工作的最佳工具: 此命令以分析模式启动dotMemory.UI.64.exe。它会在“private bytes”量达到 20 GB 时立即捕获快照,并在分析完成后在 dotMemory 中打开快照。在我们的情况中,我们不得不手动停止分析(否则我们最终会再次交换)。我们一直等到数据足够,然后按 Ctrl+C。 现在有了快照,我们在 dotMemory 中将其打开。首先,分析支配树 – 我的同事无法获得的支配树,我在快照中得到了: 内存中充斥着大约 6000 万个CompactDominatorTreeNode+Builder对象,每个对象都包含一个字典。显然,对于大多数字典来说,大小 < 容量,这意味着大量内存被浪费了。 我们必须看看这些字典的用途,也许我们不需要这么多?我选择了 CompactDominatorTreeNode+Builder节点并导航到它的声明(使用上下文菜单或按 Ctrl+L)。这将我导航到我的 IDE (Rider6) 并打开了相应的类。运行 Find Usages7(查找用法)将我带到了CompactDominatorTree.Build方法,其中包含支配树压缩算法。 介绍一点背景:首先,dotMemory 构建一个支配树,如下所示。对于每个对象,它会搜索专门保留它的对象并保存该保留对象,如果没有,则保存表示缺少此类保留对象的标记。树可能会变得非常大,没有必要“按原样”向用户展示。因此,dotMemory 在树的每一级按对象类型对树节点进行分组。CompactDominatorTreeNode+Builder表示正在构建的紧凑(压缩)树的节点,字典用于按类型对节点进行分组。 算法以“下级→上级”格式接收树,每个对象都与其支配上级匹配。它按顺序遍历快照中的所有对象。每有一个支配上级尚未被处理的对象,紧凑树中就会创建一个新的组节点。当前节点成为组节点中的下级节点(现有节点或新创建的节点)。 使用这种方法,树以任意顺序遍历,每个节点都必须存储一个字典,字典按类型对节点进行分组。在大多数情况下,这都不是问题,因为紧凑树比包含所有对象的树要小得多,并且没有显著的内存过度使用。但是这个快照属于极端情况,因为即使是紧凑的树也很大。 现在的问题是,“我们怎样才能使用更少的字典?”,如果我们只有一个带组合键的字典,该怎么办?这将迫使我们必须执行分解,再次导致内存过度使用或更复杂的计算。我们不得不考虑其他方案。 我们退后一步,更全面地分析问题。使用不同的方式遍历树如何?比如广度优先搜索?这种方式看起来很可行。一个具有常规键的字典就足够了。这样,每当我们构建完成紧凑树的新级别,我们都会清除字典,从而可以在下一次迭代中重用它。 不过注意:“下级→上级”格式不适合广度优先搜索,因为检索给定节点的下级节点的计算开销过大。我们需要不同的输入树格式。好在我们已经有了一个备选方案:dotMemory 也能将支配树存储为“上级→下级”邻接列表。这意味着,我们可以在不增加计算复杂性的情况下更改算法以使用广度优先搜索。 我们进行了相应编辑并运行。我们看到内存使用的增长速度比以前慢得多,从每秒 1.17 GB 变为仅仅每秒 7 MB,但该进程仍然未能完成而且再次开始使用交换文件。 我们回到绘图板。我们捕获了另一个快照并将其打开。新的支配树看起来像这样: 这次仅紧凑树就占用了 16 GB。这个大小合理吗?也许我们还可以用更经济的方式存储这棵树? 我们按类型对节点进行分组以查找我们有多少个节点: 在 16 GB 的总大小中,树的 9000 万个节点仅占用 6 GB。这有些可疑。我们导航到 CompactDominatorTree2+Node声明的代码: publicsealedclassNode{publicDfsNumberDfsNumber{get;}//8bytespublicTypeIdObjectsType{get;}//4bytespublicintObjectsCount{get;}//4bytespublicintRetainedObjectsCount{get;}//4bytespubliculongRetainedBytes{get;}//8bytespublicboolIsContainedInSet{get;}//1bytepublicNodeParent{get;}//8bytesinternalJetArray<Node>ChildrenImpl{get;}//8bytes//wehaveomittedunnecessarydetails} 这里的有效负载只有 45 字节,但加上标题和对齐,一个 Node 对象就占用了 72 字节。它保留的更多,平均 192 字节。为了查看详细信息,我们切换到 Instances(实例)选项卡,使用查询CompactDominatorTree2+Node !g !a筛选内容(!g排除泛型,!a排除数组)。这是一个随机实例: 实例详情: 这可是好些开销。 现在,我们可以清楚地看到JetMutableArray并不是为大型树存储下级节点的最有效方式。我们想到的第一个解决方案当然是优化下级节点的存储。例如,我们可以将它们存储在标准数组中。但我们选择了一条更激进的道路。 大型数据结构在 dotMemory 中很常见。例如,对象图被存储为邻接列表,使用两个通过整数数组索引相互引用的结构数组。这很有趣,因为在 dotMemory 中,我们刚刚停止使用托管数组而转移到我们自己的基于内存映射文件的实现。这有助于我们在访问元素时实现最小开销(C 中的原生内存索引形式),以及加载和保存数组的快速方式(完全在操作系统级别),并且在序列化/反序列化时没有开销。另外,即使没有我们的参与,这些数组的片段也可以从内存中卸载,帮助我们在顺序遍历数组时释放物理内存。 我们决定在紧凑支配树上使用相同的方式。我们还将IsContainedInSet特性变成了一个位标志,并消除了没有使用的Parent属性。最后,我们为树节点得到了以下结构: [StructLayout(LayoutKind.Sequential,Pack=4)]publicreadonlystructNode{publicreadonlyTypeIdObjectsType;privatereadonlyuint_objectsCount;publicintObjectsCount=>(int)(_objectsCount&0x7FFFFFFF);publicboolIsContainedInSet=>(_objectsCount&0x80000000)!=0;publicreadonlyintRetainedObjectsCount;publicreadonlyulongRetainedBytes;publicreadonlyDfsNumberDfsEnter;publicreadonlyRange<uint>Children; 值得注意的是,通过这种顺序表示,我们甚至可以只使用一个指向下级节点的整数链接。不过,我们使用了一个范围,该范围允许我们按RetainedBytes升序对构建树的下级节点进行排序以帮助我们构建旭日图。对于上面显示的表示,节点 #1、#2 和 #3 的顺序可能会改变。 我们屏住呼吸,运行了程序。成了!内存使用峰值仅为 12 GB。支配树成功构建,耗时 55 分钟 – 仍然比我们期望的要长,但可以接受。快照现在总共包含 2.75 亿个对象,紧凑树包含 2 亿个节点。 这显然是一个好结果。我们一开始无法将大小降至 32 GB 以下,计算需要很长时间,现在,它已经降到 12 GB 并能在 55 分钟内就绪。然而,我们还是感觉我们可以做得更好。55 分钟绝对算不上理想。我们决定查明这些时间都用在了哪里。进入 dotTrace: 好在我们不需要等待进程完成,记录几分钟的性能就足够了。我们使用--timeout=3m键在 3 分钟后自动停止分析。我们打开快照,应用筛选以识别正在执行我们任务的线程,这是长时间保持完全加载的线程。调用树是这样的: 令人震惊的是,92% 的时间显然都被Dictionary.Clear占用了!我们简直不敢相信。Clear在标准库字典上怎么会表现得如此糟糕?原来,问题是字典在算法的第一次迭代中已经膨胀到了 22K 的巨大元素,而随后的迭代通常只涉及几十个元素。Dictionary.Clear的计算复杂度与Capacity(不是Count)成正比,特别是buckets.Length,它与Capacity成线性关系。这意味着我们在不断清除空元素!事实证明,选择清除和重用字典时,我们对模型进行了过多的优化。 再退一步,我们现在尝试了最直接的方式 – 为每次迭代创建一个新字典。我们再次启动秒表,运行代码,这次充满期待。哇!1 分 46 秒!垃圾回收器上的负载增加了,但它分布均匀并且管理良好,我们使用 dotTrace 验证了这一事实。就是这样。我们在不到 2 分钟的时间内处理了 2.75 亿个对象,内存使用峰值仅为 12 GB。我们相当高兴,准备好将优化的代码提交到仓库。 后来,我们决定再做一次测试。我们在不同的快照上运行了旧算法和新算法,比较性能。我们找到了一个大小相同但拓扑不同的快照,旧算法也可以处理,然后把它馈送给两种算法。令我们大吃一惊的是,新算法比旧算法慢了 33%,尽管计算复杂度没有变化。但这就是另一个故事了,我们以后再讲。如果您有兴趣,请在下方留言或直接联系我们! 相关链接: dotMemory:https://www.jetbrains.com.cn/dotmemory/ dotTrace:https://www.jetbrains.com.cn/profiler/ BenchmarkDotNet:https://github.com/dotnet/BenchmarkDotNet 支配树:https://www.jetbrains.com/help/dotmemory/Retained_by.html dotMemory 控制台分析器:https://www.jetbrains.com.cn/dotmemory/download/#section=commandline Rider:https://www.jetbrains.com.cn/rider/ Find Usages:https://www.jetbrains.com/help/rider/Navigation_and_Search__Finding_Usages.html 本博文英文原作者:Ilya Ivanov 关于 dotMemory .NET 内存分析器 用于优化 .NET 应用程序的内存使用,检测内存泄漏和克服各类内存问题。 扫码查看详情页开启30天免费试用 »»» ⏬ 戳「阅读原文」了解更多 本文分享自微信公众号 - JetBrains(JetBrainsChina)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

RocketMQ基础概念剖析&源码解析

Topic Topic是一类消息的集合,是一种逻辑上的分区。为什么说是逻辑分区呢?因为最终数据是存储到Broker上的,而且为了满足高可用,采用了分布式的存储。 这和Kafka中的实现如出一辙,Kafka的Topic也是一种逻辑概念,每个Topic的数据会分成很多份,然后存储在不同的Broker上,这个「份」叫Partition。而在RocketMQ中,Topic的数据也会分布式的存储,这个「份」叫MessageQueue。 其分布可以用下图来表示。 这样一来,如果某个Broker所在的机器意外宕机,而且刚好MessageQueue中的数据还没有持久化到磁盘,那么该Topic下的这部分消息就会完全丢失。此时如果有备份的话,MQ就可以继续对外提供服务。 为什么还会出现没有持久化到磁盘的情况呢?现在的OS当中,程序写入数据到文件之后,并不会立马写入到磁盘,因为磁盘I/O是非常耗时的操作,在计算机来看是非常慢的一种操作。所以写入文件的数据会先写入到OS自己的缓存中去,然后择机异步的将Buffer中的数据刷入磁盘。 通过多副本冗余的机制,使得RocketMQ具有了高可用的特性。除此之外,分布式存储能够应对后期业务大量的数据存储。如果不使用分布式进行存储,那么随着后期业务发展,消息量越来越大,单机是无论如何也满足不了RocketMQ消息的存储需求的。如果不做处理,那么一台机器的磁盘总有被塞满的时候,此时的系统就不具备可伸缩的特性,也无法满足业务的使用要求了。 但是这里的可伸缩,和微服务中的服务可伸缩还不太一样。因为在微服务中,各个服务是无状态的。而Broker是有状态的,每个Broker上存储的数据都不太一样,因为Producer在发送消息的时候会通过指定的算法,从Message Queue列表中选出一个MessageQueue发送消息。 如果不是很理解这个横向扩展,那么可以把它当成Redis的Cluster,通过一致性哈希,选择到Redis Cluster中的具体某个节点,然后将数据写入Redis Master中去。如果此时想要扩容很方便,只需要往Redis Cluster中新增Master节点就好了。 所以,数据分布式的存储本质上是一种数据分片的机制。在此基础上,通过冗余多副本,达成了高可用。 Broker Broker可以理解为我们微服务中的一个服务的某个实例,因为微服务中我们的服务一般来说都会多实例部署,而RocketMQ也同理,多实例部署可以帮助系统扛住更多的流量,也从某种方面提高了系统的健壮性。 在RocketMQ4.5之前,它使用主从架构,每一个Master Broker都有一个自己的Slave Broker。 那RocketMQ的主从Broker是如何进行数据同步的呢? Broker启动的时候,会启动一个定时任务,定期的从Master Broker同步全量的数据。 这块可以先不用纠结,后面我们会通过源码来验证这个主从同步逻辑。 上面提到了Broker会部署很多个实例,那么既然多实例部署,那必然会存在一个问题,客户端是如何得知自己是连接的哪个服务器?如何得知对应的Broker的IP地址和端口?如果某个Broker突然挂了怎么办? NameServer 这就需要NameServer了,NameServer是什么? 这里先拿Spring Cloud举例子——Spring Cloud中服务启动的时候会将自己注册到Eureka注册中心上。当服务实例启动的时候,会从Eureka拉取全量的注册表,并且之后定期的从Eureka增量同步,并且每隔30秒发送心跳到Eureka去续约。如果Eureka检测到某个服务超过了90秒没有发送心跳,那么就会该服务宕机,就会将其从注册表中移除。 RocketMQ中,NameServer充当的也是类似的角色。两者从功能上也有一定的区别。 Broker在启动的时候会向NameServer注册自己,并且每隔30秒向NameServerv发送心跳。如果某个Broker超过了120秒没有发送心跳,那么就会认为该Broker宕机,就会将其从维护的信息中移除。这块后面也会从源码层面验证。 当然NameServer不仅仅是存储了各个Broker的IP地址和端口,还存储了对应的Topic的路由数据。什么是路由数据呢?那就是某个Topic下的哪个Message Queue在哪台Broker上。 Producer 总体流程 接下来,我们来看看Producer发送一条消息到Broker的时候会做什么事情,整体的流程如下。 检查消息合法性 整体来看,其实是个很简单的操作,跟我们平时写代码是一样的,来请求了先校验请求是否合法。Producer启动这里会去校验当前Topic数据的合法性。 Topic名称中是否包含了非法字符 Topic名称长度是否超过了最大的长度限制,由常量TOPIC_MAX_LENGTH来决定,其默认值为127 当前消息体是否是NULL或者是空消息 当前消息体是否超过了最大限制,由常量maxMessageSize决定,值为1024 * 1024 * 4,也就是4M。 都是些很常规的操作,和我们平时写的checker都差不多。 获取Topic的详情 当通过了消息的合法性校验之后,就需要继续往下走。此时的关注点就应该从消息是否合法转移到我要发消息给谁。 此时就需要通过当前消息所属的Topic拿到Topic的详细数据。 获取Topic的方法源码在上面已经给出来了,首先会从内存中维护的一份Map中获取数据。顺带一提,这里的Map是ConcurrentHashMap,是线程安全的,和Golang中的Sync.Map类似。 当然,首次发送的话,这个Map肯定是空的,此时会调用NameServer的接口,通过Topic去获取详情的Topic数据,此时会在上面的方法中将其加入到Map中去,这样一来下次再往该Topic发送消息就能够直接从内存中获取。这里就是简单的实现的缓存机制 。 从方法名称来看,是通过Topic获取路由数据。实际上该方法,通过调用NameServer提供的API,更新了两部分数据,分别是: Topic路由信息 Topic下的Broker相关信息 而这两部分数据都来源于同一个结构体TopicRouteData。其结构如下。 通过源码可以看到,就包含了该Topic下所有Broker下的Message Queue相关的数据、所有Broker的地址信息。 发送的具体Queue 此时我们获取到了需要发送到的Broker详情,包括地址和MessageQueue,那么此时问题的关注点又该从「消息发送给谁」转移到「消息具体发送到哪儿」。 什么叫发送到哪儿? 开篇提到过一个Topic下会被分为很多个MessageQueue,「发送到哪儿」指的就是具体发送到哪一个Message Queue中去。 Message Queue选择机制 核心的选择逻辑 还是先给出流程图 核心逻辑,用大白话讲就是将一个随机数和Message Queue的容量取模。这个随机数存储在Thread Local中,首次计算的时候,会直接随机一个数。 此后,都直接从ThreadLocal中取出该值,并且+1返回,拿到了MessageQueue的数量和随机数两个关键的参数之后,就会执行最终的计算逻辑。 接下来,我们来看看选择Message Queue的方法SelectOneMessageQueue都做了什么操作吧。 可以看到,主逻辑被变量sendLatencyFaultEnable分为了两部分。 容错机制下的选择逻辑 该变量表意为发送延迟故障。本质上是一种容错的策略,在原有的MessageQueue选择基础上,再过滤掉不可用的Broker,对之前失败的Broker,按一定的时间做退避。 可以看到,如果调用Broker信息发生了异常,那么就会调用updateFault这个方法,来更新Broker的Aviable情况。注意这个参数isolation的值为true。接下来我们从源码级别来验证上面说的退避3000ms的事实。 可以看到,isolation值是true,则duration通过三元运算符计算出来结果为30000,也就是30秒。所以我们可以得出结论,如果发送消息抛出了异常,那么直接会将该Broker设置为30秒内不可用。 而如果只是发送延迟较高,则会根据如下的map,根据延迟的具体时间,来判断该设置多少时间的不可用。 例如,如果上次请求的latency超过550ms,就退避3000ms;超过1000,就退避60000; 正常情况下的选择逻辑 而正常情况下,如果当前发送故障延迟没有启用,则会走常规逻辑,同样的会去for循环计算,循环中取到了MessageQueue之后会去判断是否和上次选择的MessageQueue属于同一个Broker,如果是同一个Broker,则会重新选择,直到选择到不属于同一个Broker的MessageQueue,或者直到循环结束。这也是为了将消息均匀的分发存储,防止数据倾斜。 发送消息 选到了具体的Message Queue之后就会开始执行发送消息的逻辑,就会调用底层Netty的接口给发送出去,这块暂时没啥可看的。 Broker的启动流程 主从同步 在上面提到过,RocketMQ有自己的主从同步,但是有两个不同的版本,版本的分水岭是在4.5版本。这两个版本区别是什么呢? 4.5之前:有点类似于Redis中,我们手动的将某台机器通过命令slave of 变成另一台Redis的Slave节点,这样一来就变成了一个较为原始的一主一从的架构。为什么说原始呢?因为如果此时Master节点宕机,我们需要人肉的去做故障转移。RocketMQ的主从架构也是这种情况。 4.5之后:引入了Dleger,可以实现一主多从,并且实现自动的故障转移。这就跟Redis后续推出了Sentinel是一样的。Dleger也是类似的作用。 下图是Broker启动代码中的源码。 可以看到判断了是否开启了Dleger,默认是不开启的。所以就会执行其中的逻辑。 刚好我们就看到了,里面有Rocket主从同步数据的相关代码。 如果当前Broker节点的角色是Slave,则会启动一个周期性的定时任务,定期(也就是10秒)去Master Broker同步全量的数据。同步的数据包括: Topic的相关配置 Cosumer的消费偏移量 延迟消息的Offset 订阅组的相关数据和配置 注册Broker 完成了主动同步定时任务的启动之后,就会去调用registerBrokerAll去注册Broker。可能这里会有点疑问,我这里是Broker启动,只有当前一个Broker实例,那这个All是什么意思呢? All是指所有的NameServer,Broker启动的时候会将自己注册到每一个NameServer上去。为什么不只注册到一个NameServer就完事了呢?这样一来还可以提高效率。归根结底还是高可用的问题。 如果Broker只注册到了一台NameServer上,万一这台NameServer挂了呢?这个Broker对所有客户端就都不可见了。实际上Broker还在正常的运行。 进到registerBrokerAll中去。 可以看到,这里会判断是否需要进行注册。通过上面的截图可以看到,此时forceRegister的值为true,而是否要注册,决定权就交给了needRegister 为什么需要判断是否需要注册呢?因为Broker一旦注册到了NameServer之后,由于Producer不停的在写入数据,Consumer也在不停的消费数据,Broker也可能因为故障导致某些Topic下的Message Queue等关键的路由信息发生变动。 这样一来,NameServer中的数据和Broker中的数据就会不一致。 如何判断是否需要注册 大致的思路是,Broker会从每一个NameServer中获取到当前Broker的数据,并和当前Broker节点中的数据做对比。但凡有一台NameServer数据和当前Broker不一致,都会进行注册操作。 接下来,我们从源码层面验证这个逻辑。关键的逻辑我在图中也标注了出来。 可以看到, 就是通过对比Broker中的数据版本和NameServer中的数据版本来实现的。这个版本,注册的时候会写到注册的数据中存入NameServer中。 这里由于是有多个,所以RocketMQ用线程池来实现了多线程操作,并且用CountDownLatch来等待所有的返回结果。经典的用空间换时间,Golang里面也有类似的操作,那就是sync.waitGroup。 关于任何一个数据不匹配,都会进行重新注册的事实,我们也从源码层面来验证一下。 可以看到,如果任何一台NameServer的数据发生了Change,都会break,返回true。 这里的结果列表使用的是CopyOnWriteList来实现的。 因为这里是多线程去执行的判断逻辑,而正常的列表不是线程安全的。CopyOnWriteArrayList之所以是线程安全的,这归功于COW(Copy On Write),读请求时共用同一个List,涉及到写请求时,会复制出一个List,并在写入数据的时候加入独占锁。比起直接对所有操作加锁,读写锁的形式分离了读、写请求,使其互不影响,只对写请求加锁,降低了加锁的次数、减少了加锁的消耗,提升了整体操作的并发。 执行注册逻辑 这块就是构建数据,然后多线程并发的去发送请求,用CopyOnWriteArrayList来保存结果。不过,上面我们提到过,Broker注册的时候,会把数据版本发送到NameServer并且存储起来,这块我们可以看看发送到NameServer的数据结构。 可以看到,Topic的数据分为了两部分,一部分是核心的逻辑,另一部分是DataVersion,也就是我们刚刚一直提到的数据版本。 Broker如何存储数据 刚刚在聊Producer最后提到的是,发送消息到Broker就完了。不知道大家有没有想过Broker是如何存储消息的? Commit log 先给出流程图 然后给出结论,Producer发送的消息是存储在一种叫commit log的文件中的,Producer端每次写入的消息是不等长的,当该CommitLog文件写入满1G,就会新建另一个新的CommitLog,继续写入。此次采取的是顺序写入。 那么问题来了,Consumer来消费的时候,Broker是如何快速找到对应的消息的呢?我们首先排除遍历文件查找的方法, 因为RocketMQ是以高吞吐、高性能著称的,肯定不可能采取这种对于很慢的操作。那RocketMQ是如何做的呢? 答案是ConsumerQueue ConsumerQueue ConsumerQueue是什么?是文件。引入的目的是什么呢?提高消费的性能。 Broker在收到一条消息的时候,写入Commit Log的同时,还会将当前这条消息在commit log中的offset、消息的size和对应的Tag的Hash写入到consumer queue文件中去。 每个MessageQueue都会有对应的ConsumerQueue文件存储在磁盘上,每个ConsumerQueue文件包含了30W条消息,每条消息的size大小为20字节,包含了8字节CommitLog的Offset、4字节的消息长度、8字节的Tag的哈希值。这样一来,每个ConsumerQueue的文件大小就约为5.72M。 当该ConsumerQueue文件写满了之后,就会再新建一个ConsumerQueue文件,继续写入。 所以,ConsumerQueue文件可以看成是CommitLog文件的索引。 负载均衡 什么意思呢?假设我们总共有6个MessageQueue,然后此时分布在了3台Broker上,每个Broker上包含了两个queue。此时Consumer有3台,我们可以大致的认为每个Consumer负责2个MessageQueue的消费。但是这里有一个原则,那就是一个MessageQueue只能被一台Consumer消费,而一台Consumer可以消费多个MessageQueue。 为什么?道理很简单,RocketMQ支持的顺序消费,是指的分区顺序性,也就是在单个MessageQueue中,消息是具有顺序性的,而如果多台Consumer去消费同一个MessageQueue,就很难去保证顺序消费了。 由于有很多个Consumer在消费多个MessageQueue,所以为了不出现数据倾斜,也为了资源的合理分配利用,在Producer发送消息的时候,需要尽可能的将消息均匀的分发给多个MessageQueue。 同时,上面那种一个Consumer消费了2个MessageQueue的情况,万一这台Consumer挂了呢?这两个MessageQueue不就没人消费了? 以上两种情况分别是Producer端的负载均衡、Consumer端的负载均衡。 Producer端负载均衡 关于Producer端上面的负载均衡,上面的流程图已经给了出来,并且给出了源码的验证。首先是容错策略,会去避开一段时间有问题的Broker,并且加上如果选择了上次的Broker,就会重新进行选择。 Consumer端负载均衡 首先Consumer端的负责均衡可以由两个对象触发: Broker Consumer自身 Consumer也会向所有的Broker发送心跳,将消息的消费组名称、订阅关系集合、消息的通信模式和客户端的ID等等。Broker收到了Consumer的心跳之后,会将其存在Broker维护的一个Manager中,名字叫ConsumerManager。当Broker监听到了Consumer数量发生了变动,就会通知Consumer进行Rebalance。 但是如果Broker通知Consumer进行Rebalance的消息丢了呢?这也就是为什么需要第Consumer自身进行触发的原因。Consumer会在启动的时候启动定时任务,周期性的执行rebalance操作。 默认是20秒执行一次。具体的代码如下。 具体流程 首先,Consumer的Rebalance会获取到本地缓存的Topic的全部数据,然后向Broker发起请求,拉取该Topic和ConsumerGroup下的所有的消费者信息。此处的Broker数据来源就是Consumer之前的心跳发送过去的数据。然后会对Topic中MessageQueue和消费者ID进行排序,然后用消息队列默认分配算法来进行分配,这里的默认分配策略是平均分配。 首先会均匀的按照类似分页的思想,将MessageQueue分配给Consumer,如果分配的不均匀,则会依次的将剩下的MessageQueue按照排序的顺序,从上往下的分配。所以在这里Consumer 1被分配到了4个MessageQueue,而Consumer 2被分配到了3个MessageQueue。 Rebalance完了之后,会将结果和Consumer缓存的数据做对比,移除不在ReBalance结果中的MessageQueue,将原本没有的MessageQueue给新增到缓存中。 触发时机 Consumer启动时 启动之后会立马进行Rebalance Consumer运行中 运行中会监听Broker发送过来的Rebalance消息,以及Consumer自身的定时任务触发的Rebalance Consumer停止运行 停止时没有直接的调用Rebalance,而是会通知Broker自己下线了,然后Broker会通知其余的Consumer进行Rebalance。 换一个角度来分析,其实就是两个方面,一个是队列信息发生了变化,另一种是消费者发生了变化。 源码验证 然后给出核心的代码验证,获取数据的逻辑如下 验证了我们刚刚说的获取了本地的Topic数据缓存,和从Broker端拉取所有的ConsumerID。 接下来是验证刚说的排序逻辑。 接下来是看判断结果是否发生了变化的源码。 可以看到,Consumer通知Broker策略,其本质上就是发送心跳,将更新后的数据通过心跳发送给所有的Broker。 Consumer更多的细节 可能关于Consumer,我们使用的更多一点。例如我们知道我们可以设置集群消费和广播消息,分别对应RocketMQ中的CLUSTERING和BROADCASTING**。 再比如我们知道,我们可以设置顺序消费和并发消费等等,接下来就让我们用源码来看看这些功能在RocketMQ中是怎么实现的。 消费模型 在Consumer中,默认都是采用集群消费,这块在Consumer的代码中也有体现。 而消费模式的不同,会影响到管理offset的具体实现。 可以看到,当消费模型是广播模式时,Offset的持久化管理会使用实现LocalFileOffsetStorage 当消费模式是集群消费时,则会使用RemoteBrokerOffsetStore。 具体原因是什么呢?首先我们得知道广播模式和集群模式的区别在哪儿: 广播模式下,一条消息会被ConsumerGroup中的每一台机器所消费 集群模式下,一条消息只会被ConsumerGroup中的一台机器消费 所以在广播模式下,每个ConsumerGroup的消费进度都不一样,所以需要由Consumer自身来管理Offset。而集群模式下,同个ConsumerGroup下的消费进度其实是一样的,所以可以交由Broker统一管理。 消费模式 消费模式则分为顺序消费和并发消费,分别对应实现MessageListenerOrderly和MessageListenerConcurrently两种方式。 不同的消费方式会采取不同的底层实现,配置完成之后就会调用start。 拉取消息 接下来我们来看一个跟我们最最相关的问题,那就是我们平时消费的消息到底是怎么样从Broker发到的Consumer。在靠近启动Rebalance的地方,Consumer也开启了一个定时拉取消息的线程。 这个线程做了什么事呢?它会不停的从一个维护在内存中的Queue中获取一个在写入的时候就构建好的PullRequest对象,调用具体实现去不停的拉取消息了。 处理消费结果 在这里是否开启AutoCommit,所做的处理差不了很多,大家也都知道,唯一区别就在于是否自动的提交Offset。对于处理成功的逻辑也差不多,我们平时业务逻辑中可能也并不关心消费成功的消息。我们更多关注的是如果消费失败了,RocketMQ是怎么处理的? 这是在AutoCommit下,如果消费失败了的处理逻辑。会记录一个失败的TPS,然后这里有一个非常关键的逻辑,那就是checkReconsumeTimes。 如果当前消息的重试次数,如果大于了最大的重试消费次数,就会把消费发回给Broker。那最大重试次数是如何定义的。 如果值为-1,那么最大次数就是MAX_VALUE,也就是2147483647。这里有点奇怪啊,按照我们平常的认知,难道不是重试16次吗?然后就看到了很骚的一句注释。 -1 means 16 times,这代码确实有点,一言难尽。 然后,如果超过了最大的次数限制,就会将该消息调用Prodcuer的默认实现,将其发送到死信队列中。当然,死信队列也不是什么特殊的存在,就是一个单独的Topic而已。 通过getRetryTopic来获取的,默认是给当前的ConsumerGroup名称加上一个前缀。 好了以上就是本篇博客的全部内容了,如果你觉得这篇文章对你有帮助,还麻烦点个赞,关个注,分个享,留个言。 欢迎微信搜索关注【SH的全栈笔记】,查看更多相关文章

优秀的个人博客,低调大师

Netty(一):server启动流程解析

netty作为一个被广泛应用的通信框架,有必要我们多了解一点。 实际上netty的几个重要的技术亮点: 1. reactor的线程模型; 2. 安全有效的nio非阻塞io模型应用; 3. pipeline流水线式的灵活处理过程; 4. channelHandler的灵活实现; 5. 提供许多开箱即用的处理器和编解码器; 我们可以从这些点去深入理解其过人之处。 1. 一个NettyServer的demo 要想深入理解某个框架,一般还是要以demo作为一个抓手点的。以下,我们可以看到一个简单的nettyServer的创建过程,即netty的quick start样例吧。 @Slf4j public class NettyServerHelloApplication { /** * 一个server的样例 */ public static void main(String[] args) throws Exception { // 1. 创建对应的EventLoop线程池备用, 分bossGroup和workerGroup EventLoopGroup bossGroup = new NioEventLoopGroup(1); EventLoopGroup workerGroup = new NioEventLoopGroup(4); try { // 2. 创建netty对应的入口核心类 ServerBootstrap ServerBootstrap b = new ServerBootstrap(); // 3. 设置server的各项参数,以及应用处理器 b.group(bossGroup, workerGroup) .channel(NioServerSocketChannel.class) .option(ChannelOption.SO_BACKLOG, 100) // 设置tcp协议的请求等待队列 .childHandler(new ChannelInitializer<SocketChannel>() { @Override public void initChannel(SocketChannel ch) throws Exception { // 3.2. 最重要的,将各channelHandler绑定到netty的上下文中(暂且这么说吧) ChannelPipeline p = ch.pipeline(); p.addLast(new LoggingHandler(LogLevel.INFO)); p.addLast("encoder", new MessageEncoder()); p.addLast("decoder", new MessageDecoder()); p.addLast(new EchoServerHandler()); } }); // 4. 绑定tcp端口开启服务端监听, sync() 保证执行完成所有任务 ChannelFuture f = b.bind(ServerConstant.PORT).sync(); // 5. 等待关闭信号,让业务线程去服务业务了 f.channel().closeFuture().sync(); } finally { // 6. 收到关闭信号后,优雅关闭server的线程池,保护应用 bossGroup.shutdownGracefully(); workerGroup.shutdownGracefully(); } } } 以上,就是一个简版的nettyServer的整个框架了,这也基本上整个nettyServer的编程范式了。主要即分为这么几步: 1. 创建对应的EventLoop线程池备用, 分bossGroup和workerGroup; 2. 创建netty对应的入口核心类 ServerBootstrap; 3. 设置server的各项参数,以及应用处理器(必备的channelHandler业务接入过程); 4. 绑定tcp端口开启服务端监听; 5. 等待关闭信号,让业务线程去服务业务了; 6. 收到关闭信号后,优雅关闭server的线程池,保护应用; 事实上,如果我们直接基于jdk提供的ServerSocketChannel是否也差不了多少呢?是的,至少表面看起来是的,但我们要处理许多的异常情况,且可能面对变化繁多的业务类型。又该如何呢? 毕竟一个框架的成功,绝非偶然。下面我们就这几个过程来看看netty都是如何处理的吧! 2. EventLoop 的创建 EventLoop 直译为事件循环,但在这里我们也可以理解为一个线程池,因为所有的事件都是提交给其处理的。那么,它倒底是个什么样的循环呢? 首先来看下其类继承情况: 从类图可以看出,EventLoop也是一个executor或者说线程池的实现,它们也许有相通之处。 // 调用方式如下 EventLoopGroup bossGroup = new NioEventLoopGroup(1); EventLoopGroup workerGroup = new NioEventLoopGroup(4); // io.netty.channel.nio.NioEventLoopGroup#NioEventLoopGroup(int, java.util.concurrent.ThreadFactory) /** * Create a new instance using the specified number of threads, the given {@link ThreadFactory} and the * {@link SelectorProvider} which is returned by {@link SelectorProvider#provider()}. */ public NioEventLoopGroup(int nThreads, ThreadFactory threadFactory) { this(nThreads, threadFactory, SelectorProvider.provider()); } public NioEventLoopGroup( int nThreads, Executor executor, final SelectorProvider selectorProvider) { this(nThreads, executor, selectorProvider, DefaultSelectStrategyFactory.INSTANCE); } public NioEventLoopGroup(int nThreads, Executor executor, final SelectorProvider selectorProvider, final SelectStrategyFactory selectStrategyFactory) { super(nThreads, executor, selectorProvider, selectStrategyFactory, RejectedExecutionHandlers.reject()); } // io.netty.channel.MultithreadEventLoopGroup#MultithreadEventLoopGroup(int, java.util.concurrent.Executor, java.lang.Object...) protected MultithreadEventLoopGroup(int nThreads, Executor executor, Object... args) { // 默认线程是 cpu * 2 super(nThreads == 0 ? DEFAULT_EVENT_LOOP_THREADS : nThreads, executor, args); } // io.netty.util.concurrent.MultithreadEventExecutorGroup#MultithreadEventExecutorGroup(int, java.util.concurrent.Executor, java.lang.Object...) /** * Create a new instance. * * @param nThreads the number of threads that will be used by this instance. * @param executor the Executor to use, or {@code null} if the default should be used. * @param args arguments which will passed to each {@link #newChild(Executor, Object...)} call */ protected MultithreadEventExecutorGroup(int nThreads, Executor executor, Object... args) { this(nThreads, executor, DefaultEventExecutorChooserFactory.INSTANCE, args); } // io.netty.util.concurrent.MultithreadEventExecutorGroup#MultithreadEventExecutorGroup(int, java.util.concurrent.Executor, io.netty.util.concurrent.EventExecutorChooserFactory, java.lang.Object...) /** * Create a new instance. * * @param nThreads the number of threads that will be used by this instance. * @param executor the Executor to use, or {@code null} if the default should be used. * @param chooserFactory the {@link EventExecutorChooserFactory} to use. * @param args arguments which will passed to each {@link #newChild(Executor, Object...)} call */ protected MultithreadEventExecutorGroup(int nThreads, Executor executor, EventExecutorChooserFactory chooserFactory, Object... args) { if (nThreads <= 0) { throw new IllegalArgumentException(String.format("nThreads: %d (expected: > 0)", nThreads)); } // 创建一个执行器,该执行器每提交一个任务,就创建一个线程来运行,即并没有队列的概念 if (executor == null) { executor = new ThreadPerTaskExecutor(newDefaultThreadFactory()); } // 使用一个数组来保存整个可用的线程池 children = new EventExecutor[nThreads]; for (int i = 0; i < nThreads; i ++) { boolean success = false; try { // 为每个child创建一个线程运行, 该方法由子类实现 children[i] = newChild(executor, args); success = true; } catch (Exception e) { // TODO: Think about if this is a good exception type throw new IllegalStateException("failed to create a child event loop", e); } finally { if (!success) { // 如果创建失败,则把已经创建好的线程池关闭掉 // 不过值得注意的是,当某个线程池创建失败后,并没有立即停止后续创建工作,即无 return 操作,这是为啥? // 实际上,发生异常时,Exeception 已经被抛出,此处无需关注 for (int j = 0; j < i; j ++) { children[j].shutdownGracefully(); } for (int j = 0; j < i; j ++) { EventExecutor e = children[j]; try { while (!e.isTerminated()) { e.awaitTermination(Integer.MAX_VALUE, TimeUnit.SECONDS); } } catch (InterruptedException interrupted) { // Let the caller handle the interruption. Thread.currentThread().interrupt(); break; } } } } } // 创建选择器,猜测是做负载均衡时使用 // 此处的chooser默认是 DefaultEventExecutorChooserFactory chooser = chooserFactory.newChooser(children); final FutureListener<Object> terminationListener = new FutureListener<Object>() { @Override public void operationComplete(Future<Object> future) throws Exception { if (terminatedChildren.incrementAndGet() == children.length) { terminationFuture.setSuccess(null); } } }; for (EventExecutor e: children) { e.terminationFuture().addListener(terminationListener); } Set<EventExecutor> childrenSet = new LinkedHashSet<EventExecutor>(children.length); Collections.addAll(childrenSet, children); readonlyChildren = Collections.unmodifiableSet(childrenSet); } // io.netty.channel.nio.NioEventLoopGroup#newChild @Override protected EventLoop newChild(Executor executor, Object... args) throws Exception { // 注意此处的参数类型是由外部进行保证的,在此直接做强转操作 return new NioEventLoop(this, executor, (SelectorProvider) args[0], ((SelectStrategyFactory) args[1]).newSelectStrategy(), (RejectedExecutionHandler) args[2]); } // io.netty.channel.nio.NioEventLoop#NioEventLoop NioEventLoop(NioEventLoopGroup parent, Executor executor, SelectorProvider selectorProvider, SelectStrategy strategy, RejectedExecutionHandler rejectedExecutionHandler) { // 此构造器会做很多事,比如创建队列,开启nio selector... super(parent, executor, false, DEFAULT_MAX_PENDING_TASKS, rejectedExecutionHandler); if (selectorProvider == null) { throw new NullPointerException("selectorProvider"); } if (strategy == null) { throw new NullPointerException("selectStrategy"); } provider = selectorProvider; final SelectorTuple selectorTuple = openSelector(); selector = selectorTuple.selector; unwrappedSelector = selectorTuple.unwrappedSelector; selectStrategy = strategy; } // io.netty.util.concurrent.DefaultEventExecutorChooserFactory#newChooser @SuppressWarnings("unchecked") @Override public EventExecutorChooser newChooser(EventExecutor[] executors) { // 如: 1,2,4,8... 都会创建 PowerOfTwoEventExecutorChooser if (isPowerOfTwo(executors.length)) { return new PowerOfTwoEventExecutorChooser(executors); } else { return new GenericEventExecutorChooser(executors); } } // io.netty.util.concurrent.DefaultPromise#addListener @Override public Promise<V> addListener(GenericFutureListener<? extends Future<? super V>> listener) { checkNotNull(listener, "listener"); synchronized (this) { addListener0(listener); } if (isDone()) { notifyListeners(); } return this; } 以上,就是 NioEventLoopGroup 的创建过程了. 本质上其就是一个个的单独的线程组成的数组列表, 等待被调用. 3. ServerBootstrap 的创建 ServerBootstrap是Netty的一个服务端核心入口类, 它可以很快速的创建一个稳定的netty服务. ServerBootstrap 的类图如下: 还是非常纯粹的啊!其中有意思是的, ServerBootstrap继承自 AbstractBootstrap, 而这个 AbstractBootstrap 是一个自依赖的抽象类: AbstractBootstrap<B extends AbstractBootstrap<B, C>, C extends Channel> , 这样,即父类可以直接返回子类的信息了。 其默认构造方法为空,所以所以参数都使用默认值, 因为还有后续的参数设置过程,接下来,我们看看其一些关键参数的设置: // 1. channel的设定 // io.netty.bootstrap.AbstractBootstrap#channel /** * The {@link Class} which is used to create {@link Channel} instances from. * You either use this or {@link #channelFactory(io.netty.channel.ChannelFactory)} if your * {@link Channel} implementation has no no-args constructor. */ public B channel(Class<? extends C> channelClass) { if (channelClass == null) { throw new NullPointerException("channelClass"); } // 默认使用构造器反射的方式创建 channel return channelFactory(new ReflectiveChannelFactory<C>(channelClass)); } // io.netty.bootstrap.AbstractBootstrap#channelFactory(io.netty.channel.ChannelFactory<? extends C>) /** * {@link io.netty.channel.ChannelFactory} which is used to create {@link Channel} instances from * when calling {@link #bind()}. This method is usually only used if {@link #channel(Class)} * is not working for you because of some more complex needs. If your {@link Channel} implementation * has a no-args constructor, its highly recommend to just use {@link #channel(Class)} for * simplify your code. */ @SuppressWarnings({ "unchecked", "deprecation" }) public B channelFactory(io.netty.channel.ChannelFactory<? extends C> channelFactory) { return channelFactory((ChannelFactory<C>) channelFactory); } // io.netty.bootstrap.AbstractBootstrap#channelFactory(io.netty.bootstrap.ChannelFactory<? extends C>) /** * @deprecated Use {@link #channelFactory(io.netty.channel.ChannelFactory)} instead. */ @Deprecated public B channelFactory(ChannelFactory<? extends C> channelFactory) { if (channelFactory == null) { throw new NullPointerException("channelFactory"); } if (this.channelFactory != null) { throw new IllegalStateException("channelFactory set already"); } this.channelFactory = channelFactory; return self(); } @SuppressWarnings("unchecked") private B self() { return (B) this; } // 2. option 参数选项设置, 它会承包各种特殊配置的设置, 是一个通用配置项设置的入口 /** * Allow to specify a {@link ChannelOption} which is used for the {@link Channel} instances once they got * created. Use a value of {@code null} to remove a previous set {@link ChannelOption}. */ public <T> B option(ChannelOption<T> option, T value) { if (option == null) { throw new NullPointerException("option"); } // options 是一个 new LinkedHashMap<ChannelOption<?>, Object>(), 即非线程安全的容器, 所以设置值时要求使用 synchronized 保证线程安全 // value 为null时代表要将该选项设置删除, 如果key相同,后面的配置将会覆盖前面的配置 if (value == null) { synchronized (options) { options.remove(option); } } else { synchronized (options) { options.put(option, value); } } return self(); } // 3. childHandler 添加channelHandler, 这是一个最重要的一个方法, 它会影响到后面的业务处理统筹 // 调用该方法仅将 channelHandler的上下文加入进来, 实际还未进行真正的添加操作 .childHandler(new ChannelInitializer<SocketChannel>() { ServerBootstrap b = new ServerBootstrap(); b.group(bossGroup, workerGroup) .channel(NioServerSocketChannel.class) .option(ChannelOption.SO_BACKLOG, 100) // 设置tcp协议的请求等待队列 .childHandler(new ChannelInitializer<SocketChannel>() { @Override public void initChannel(SocketChannel ch) throws Exception { ChannelPipeline p = ch.pipeline(); p.addLast(new LoggingHandler(LogLevel.INFO)); p.addLast("encoder", new MessageEncoder()); p.addLast("decoder", new MessageDecoder()); p.addLast(new EchoServerHandler()); } }); /** * Set the {@link ChannelHandler} which is used to serve the request for the {@link Channel}'s. */ public ServerBootstrap childHandler(ChannelHandler childHandler) { if (childHandler == null) { throw new NullPointerException("childHandler"); } // 仅将 channelHandler 绑定到netty的上下文中 this.childHandler = childHandler; return this; } // 4. bossGroup, workGroup 如何被分配 ? /** * Set the {@link EventLoopGroup} for the parent (acceptor) and the child (client). These * {@link EventLoopGroup}'s are used to handle all the events and IO for {@link ServerChannel} and * {@link Channel}'s. */ public ServerBootstrap group(EventLoopGroup parentGroup, EventLoopGroup childGroup) { // parentGroup 是给acceptor使用的, 主要用于对socket连接的接入,所以一般一个线程也够了 super.group(parentGroup); if (childGroup == null) { throw new NullPointerException("childGroup"); } if (this.childGroup != null) { throw new IllegalStateException("childGroup set already"); } // childGroup 主要用于接入后的socket的事件的处理,一般要求数量较多,视业务属性决定 this.childGroup = childGroup; return this; } bind 绑定tcp端口,这个是真正触发server初始化的一步,工作量比较大,我们另开一段讲解。 4. nettyServer 的初始化 前面所有工作都是在准备, 都并未体现在外部, 而 bind 则会是开启一个对外服务, 对外可见, 真正启动server. // io.netty.bootstrap.AbstractBootstrap#bind(int) /** * Create a new {@link Channel} and bind it. */ public ChannelFuture bind(int inetPort) { return bind(new InetSocketAddress(inetPort)); } // io.netty.bootstrap.AbstractBootstrap#bind(java.net.SocketAddress) /** * Create a new {@link Channel} and bind it. */ public ChannelFuture bind(SocketAddress localAddress) { // 先验证各种参数是否设置完整, 如线程池是否设置, channelHandler 是否设置... validate(); if (localAddress == null) { throw new NullPointerException("localAddress"); } // 绑定tcp端口 return doBind(localAddress); } private ChannelFuture doBind(final SocketAddress localAddress) { // 1. 创建一些channel使用, 与eventloop绑定, 统一管理嘛 final ChannelFuture regFuture = initAndRegister(); final Channel channel = regFuture.channel(); if (regFuture.cause() != null) { return regFuture; } if (regFuture.isDone()) { // At this point we know that the registration was complete and successful. ChannelPromise promise = channel.newPromise(); // 2. 注册成功之后, 开始实际的 bind() 操作, 实际就是调用 channel.bind() // doBind0() 是一个异步的操作,所以使用的一个 promise 作为结果驱动 doBind0(regFuture, channel, localAddress, promise); return promise; } else { // Registration future is almost always fulfilled already, but just in case it's not. final PendingRegistrationPromise promise = new PendingRegistrationPromise(channel); regFuture.addListener(new ChannelFutureListener() { @Override public void operationComplete(ChannelFuture future) throws Exception { Throwable cause = future.cause(); if (cause != null) { // Registration on the EventLoop failed so fail the ChannelPromise directly to not cause an // IllegalStateException once we try to access the EventLoop of the Channel. promise.setFailure(cause); } else { // Registration was successful, so set the correct executor to use. // See https://github.com/netty/netty/issues/2586 promise.registered(); doBind0(regFuture, channel, localAddress, promise); } } }); return promise; } } 所以,从整体来说,bind()过程分两大步走:1. 初始化channel,与nio关联; 2. 落实channel和本地端口的绑定工作; 我们来细看下: 4.1 初始化channel 初始化channel, 并注册到 selector上, 这个操作实际上非常重要。 // 以下我们先看下执行框架 // io.netty.bootstrap.AbstractBootstrap#initAndRegister final ChannelFuture initAndRegister() { Channel channel = null; try { // 即根据前面设置的channel 使用反射创建一个实例出来 // 即此处将会实例化出一个 ServerSocketChannel 出来 // 所以如果你想用jdk的nio实现,则设置channel时使用 NioServerSocketChannel.class即可, 而你想使用其他更优化的实现时比如EpollServerSocketChannel时,改变一下即可 // 而此处的 channelFactory 就是一个反射的实现 ReflectiveChannelFactory, 它会调用如上channel的无参构造方法实例化 // 重点工作就需要在这个无参构造器中完成,我们接下来看看 channel = channelFactory.newChannel(); // 初始化channel的一些公共参数, 相当于做一些属性的继承, 因为后续它将不再依赖 ServerBootstrap, 它需要有独立自主能力 init(channel); } catch (Throwable t) { if (channel != null) { // channel can be null if newChannel crashed (eg SocketException("too many open files")) channel.unsafe().closeForcibly(); // as the Channel is not registered yet we need to force the usage of the GlobalEventExecutor return new DefaultChannelPromise(channel, GlobalEventExecutor.INSTANCE).setFailure(t); } // as the Channel is not registered yet we need to force the usage of the GlobalEventExecutor return new DefaultChannelPromise(new FailedChannel(), GlobalEventExecutor.INSTANCE).setFailure(t); } // 注册创建好的 channel 到eventLoop中 ChannelFuture regFuture = config().group().register(channel); if (regFuture.cause() != null) { if (channel.isRegistered()) { channel.close(); } else { channel.unsafe().closeForcibly(); } } // If we are here and the promise is not failed, it's one of the following cases: // 1) If we attempted registration from the event loop, the registration has been completed at this point. // i.e. It's safe to attempt bind() or connect() now because the channel has been registered. // 2) If we attempted registration from the other thread, the registration request has been successfully // added to the event loop's task queue for later execution. // i.e. It's safe to attempt bind() or connect() now: // because bind() or connect() will be executed *after* the scheduled registration task is executed // because register(), bind(), and connect() are all bound to the same thread. return regFuture; } // 1. 先看看 NioServerSocketChannel 的构造过程 // io.netty.channel.socket.nio.NioServerSocketChannel#NioServerSocketChannel() /** * Create a new instance */ public NioServerSocketChannel() { // newSocket 简单说就是创建一个本地socket, api调用: SelectorProvider.provider().openServerSocketChannel() // 但此时本 socket 并未和任何端口绑定 this(newSocket(DEFAULT_SELECTOR_PROVIDER)); } /** * Create a new instance using the given {@link ServerSocketChannel}. */ public NioServerSocketChannel(ServerSocketChannel channel) { // 注册 OP_ACCEPT 事件 super(null, channel, SelectionKey.OP_ACCEPT); // 此处的 javaChannel() 实际就是 channel, 这样调用只是为统一吧 // 创建一个新的 socket 传入 NioServerSocketChannelConfig 中 // 主要用于一些 RecvByteBufAllocator 的设置,及channel的保存 config = new NioServerSocketChannelConfig(this, javaChannel().socket()); } // io.netty.channel.nio.AbstractNioChannel#AbstractNioChannel /** * Create a new instance * * @param parent the parent {@link Channel} by which this instance was created. May be {@code null} * @param ch the underlying {@link SelectableChannel} on which it operates * @param readInterestOp the ops to set to receive data from the {@link SelectableChannel} */ protected AbstractNioChannel(Channel parent, SelectableChannel ch, int readInterestOp) { // 先让父类初始化必要的上下文 super(parent); // 保留 channel 信息,并设置非阻塞标识 this.ch = ch; this.readInterestOp = readInterestOp; try { ch.configureBlocking(false); } catch (IOException e) { try { ch.close(); } catch (IOException e2) { if (logger.isWarnEnabled()) { logger.warn( "Failed to close a partially initialized socket.", e2); } } throw new ChannelException("Failed to enter non-blocking mode.", e); } } // io.netty.channel.AbstractChannel#AbstractChannel(io.netty.channel.Channel) /** * Creates a new instance. * * @param parent * the parent of this channel. {@code null} if there's no parent. */ protected AbstractChannel(Channel parent) { // 初始化上下文 this.parent = parent; // DefaultChannelId id = newId(); // NioMessageUnsafe unsafe = newUnsafe(); // new DefaultChannelPipeline(this); // 比较重要,将会初始化 head, tail 节点 pipeline = newChannelPipeline(); } // io.netty.channel.DefaultChannelPipeline#DefaultChannelPipeline protected DefaultChannelPipeline(Channel channel) { this.channel = ObjectUtil.checkNotNull(channel, "channel"); succeededFuture = new SucceededChannelFuture(channel, null); voidPromise = new VoidChannelPromise(channel, true); // 初始化 head, tail tail = new TailContext(this); head = new HeadContext(this); // 构成双向链表 head.next = tail; tail.prev = head; } // 2. 初始化channel, 有个最重要的动作是将 Acceptor 接入到 pipeline 中 // io.netty.bootstrap.ServerBootstrap#init @Override void init(Channel channel) throws Exception { final Map<ChannelOption<?>, Object> options = options0(); // 根据前面的设置, 将各种属性copy过来, 放到 config 字段中 // 同样, 因为 options 和 attrs 都不是线程安全的, 所以都要上锁操作 synchronized (options) { setChannelOptions(channel, options, logger); } final Map<AttributeKey<?>, Object> attrs = attrs0(); synchronized (attrs) { for (Entry<AttributeKey<?>, Object> e: attrs.entrySet()) { @SuppressWarnings("unchecked") AttributeKey<Object> key = (AttributeKey<Object>) e.getKey(); channel.attr(key).set(e.getValue()); } } // 此处的pipeline, 就是在 NioServerSocketChannel 中初始化好head,tail的pipeline ChannelPipeline p = channel.pipeline(); // childGroup 实际就是外部的 workGroup final EventLoopGroup currentChildGroup = childGroup; final ChannelHandler currentChildHandler = childHandler; final Entry<ChannelOption<?>, Object>[] currentChildOptions; final Entry<AttributeKey<?>, Object>[] currentChildAttrs; synchronized (childOptions) { currentChildOptions = childOptions.entrySet().toArray(newOptionArray(childOptions.size())); } synchronized (childAttrs) { currentChildAttrs = childAttrs.entrySet().toArray(newAttrArray(childAttrs.size())); } // 这个就比较重要了, 关联 ServerBootstrapAcceptor // 主动添加一个 initializer, 它将作为第一个被调用的 channelInitializer 存在 // 而 channelInitializer 只会被调用一次 p.addLast(new ChannelInitializer<Channel>() { @Override public void initChannel(final Channel ch) throws Exception { final ChannelPipeline pipeline = ch.pipeline(); ChannelHandler handler = config.handler(); if (handler != null) { pipeline.addLast(handler); } ch.eventLoop().execute(new Runnable() { @Override public void run() { // 添加 Acceptor 到 pipeline 中, 形成一个 head -> ServerBootstrapAcceptor -> tail 的pipeline pipeline.addLast(new ServerBootstrapAcceptor( ch, currentChildGroup, currentChildHandler, currentChildOptions, currentChildAttrs)); } }); } }); // 此操作过后,当前pipeline中,就只有此一handler } 4.2 handler的添加过程 addLast() 看起来只是一个添加元素的过程, 总体来说就是一个双向链表的添加, 但也蛮有意思的, 有兴趣可以戳开详情看看. // io.netty.channel.ChannelHandler @Override public final ChannelPipeline addLast(ChannelHandler... handlers) { return addLast(null, handlers); } // io.netty.channel.DefaultChannelPipeline#addLast(io.netty.util.concurrent.EventExecutorGroup, io.netty.channel.ChannelHandler...) @Override public final ChannelPipeline addLast(EventExecutorGroup executor, ChannelHandler... handlers) { if (handlers == null) { throw new NullPointerException("handlers"); } // 支持同时添加多个 handler for (ChannelHandler h: handlers) { if (h == null) { break; } addLast(executor, null, h); } return this; } // io.netty.channel.DefaultChannelPipeline#addLast(io.netty.util.concurrent.EventExecutorGroup, java.lang.String, io.netty.channel.ChannelHandler) @Override public final ChannelPipeline addLast(EventExecutorGroup group, String name, ChannelHandler handler) { final AbstractChannelHandlerContext newCtx; synchronized (this) { // 重复性检查 @Shareable 参数使用 checkMultiplicity(handler); // 生成一个新的上下文, filterName()将会生成一个唯一的名称, 如 ServerBootstrap$1#0 newCtx = newContext(group, filterName(name, handler), handler); // 将当前ctx添加到链表中 addLast0(newCtx); // If the registered is false it means that the channel was not registered on an eventloop yet. // In this case we add the context to the pipeline and add a task that will call // ChannelHandler.handlerAdded(...) once the channel is registered. if (!registered) { newCtx.setAddPending(); // 未注册情况下, 不会进行下一步了 callHandlerCallbackLater(newCtx, true); return this; } // 而已注册情况下, 则会使用 executor 提交callHandlerAdded0, 即调用 pipeline 的头节点 EventExecutor executor = newCtx.executor(); if (!executor.inEventLoop()) { newCtx.setAddPending(); executor.execute(new Runnable() { @Override public void run() { callHandlerAdded0(newCtx); } }); return this; } } callHandlerAdded0(newCtx); return this; } private AbstractChannelHandlerContext newContext(EventExecutorGroup group, String name, ChannelHandler handler) { return new DefaultChannelHandlerContext(this, childExecutor(group), name, handler); } private void addLast0(AbstractChannelHandlerContext newCtx) { // 一个双向链表保存上下文 AbstractChannelHandlerContext prev = tail.prev; newCtx.prev = prev; newCtx.next = tail; prev.next = newCtx; tail.prev = newCtx; } // 添加ctx到队列尾部 private void callHandlerCallbackLater(AbstractChannelHandlerContext ctx, boolean added) { assert !registered; PendingHandlerCallback task = added ? new PendingHandlerAddedTask(ctx) : new PendingHandlerRemovedTask(ctx); PendingHandlerCallback pending = pendingHandlerCallbackHead; if (pending == null) { pendingHandlerCallbackHead = task; } else { // Find the tail of the linked-list. while (pending.next != null) { pending = pending.next; } pending.next = task; } } // 对每一次添加 handler, 则都会产生一个事件, 通知现有的handler, handlerAdded() private void callHandlerAdded0(final AbstractChannelHandlerContext ctx) { try { // We must call setAddComplete before calling handlerAdded. Otherwise if the handlerAdded method generates // any pipeline events ctx.handler() will miss them because the state will not allow it. ctx.setAddComplete(); ctx.handler().handlerAdded(ctx); } catch (Throwable t) { boolean removed = false; try { remove0(ctx); try { ctx.handler().handlerRemoved(ctx); } finally { ctx.setRemoved(); } removed = true; } catch (Throwable t2) { if (logger.isWarnEnabled()) { logger.warn("Failed to remove a handler: " + ctx.name(), t2); } } if (removed) { fireExceptionCaught(new ChannelPipelineException( ctx.handler().getClass().getName() + ".handlerAdded() has thrown an exception; removed.", t)); } else { fireExceptionCaught(new ChannelPipelineException( ctx.handler().getClass().getName() + ".handlerAdded() has thrown an exception; also failed to remove.", t)); } } } 4.3 注册channel,绑定eventloop线程 经过前面两步, channel已经创建好和初始化好了, 但还没有看到 eventLoop 的影子. 实际上eventloop和channel间就差一个注册了. 也就是前面看到的 ChannelFuture regFuture = config().group().register(channel); 此处的group 即是 bossGroup. // io.netty.channel.MultithreadEventLoopGroup#register(io.netty.channel.Channel) @Override public ChannelFuture register(Channel channel) { // next() 相当于是一个负载均衡器, 会选择出一个合适的 eventloop 出来, 默认是round-robin return next().register(channel); } // io.netty.channel.MultithreadEventLoopGroup#next @Override public EventLoop next() { return (EventLoop) super.next(); } // io.netty.util.concurrent.MultithreadEventExecutorGroup#next @Override public EventExecutor next() { // 使用前面创建的 PowerOfTwoEventExecutorChooser 进行调用 // 默认实现为轮询 return chooser.next(); } // io.netty.util.concurrent.DefaultEventExecutorChooserFactory.PowerOfTwoEventExecutorChooser#next @Override public EventExecutor next() { return executors[idx.getAndIncrement() & executors.length - 1]; } // io.netty.channel.SingleThreadEventLoop#register(io.netty.channel.Channel) @Override public ChannelFuture register(Channel channel) { // 使用 DefaultChannelPromise 封装channel, 再注册到 eventloop 中 return register(new DefaultChannelPromise(channel, this)); } @Override public ChannelFuture register(final ChannelPromise promise) { ObjectUtil.checkNotNull(promise, "promise"); // NioMessageUnsafe promise.channel().unsafe().register(this, promise); return promise; } // io.netty.channel.AbstractChannel.AbstractUnsafe#register @Override public final void register(EventLoop eventLoop, final ChannelPromise promise) { if (eventLoop == null) { throw new NullPointerException("eventLoop"); } if (isRegistered()) { promise.setFailure(new IllegalStateException("registered to an event loop already")); return; } if (!isCompatible(eventLoop)) { promise.setFailure( new IllegalStateException("incompatible event loop type: " + eventLoop.getClass().getName())); return; } AbstractChannel.this.eventLoop = eventLoop; // inEventLoop() 判断当前线程是否在 eventLoop 中 // 判断方式为直接比较 eventloop 线程也当前线程是否是同一个即可 Thread.currentThread() == this.thread; // 核心注册方法 register0() if (eventLoop.inEventLoop()) { register0(promise); } else { // 不在 eventLoop 中, 则异步提交任务给 eventloop 处理 try { eventLoop.execute(new Runnable() { @Override public void run() { register0(promise); } }); } catch (Throwable t) { logger.warn( "Force-closing a channel whose registration task was not accepted by an event loop: {}", AbstractChannel.this, t); closeForcibly(); closeFuture.setClosed(); safeSetFailure(promise, t); } } } // register0() 做真正的注册 // io.netty.channel.AbstractChannel.AbstractUnsafe#register0 private void register0(ChannelPromise promise) { try { // check if the channel is still open as it could be closed in the mean time when the register // call was outside of the eventLoop if (!promise.setUncancellable() || !ensureOpen(promise)) { return; } boolean firstRegistration = neverRegistered; // 具体的注册逻辑由子类实现, NioServerSocketChannel doRegister(); neverRegistered = false; registered = true; // Ensure we call handlerAdded(...) before we actually notify the promise. This is needed as the // user may already fire events through the pipeline in the ChannelFutureListener. // 几个扩展点: fireHandlerAdded() -> fireChannelRegistered() -> fireChannelActive() // part1: fireChannelAdded(), 它将会回调上面的 ServerBootstrapAcceptor 的添加 channelInitializer pipeline.invokeHandlerAddedIfNeeded(); safeSetSuccess(promise); // part2: fireChannelRegistered() pipeline.fireChannelRegistered(); // Only fire a channelActive if the channel has never been registered. This prevents firing // multiple channel actives if the channel is deregistered and re-registered. if (isActive()) { if (firstRegistration) { pipeline.fireChannelActive(); } else if (config().isAutoRead()) { // This channel was registered before and autoRead() is set. This means we need to begin read // again so that we process inbound data. // // See https://github.com/netty/netty/issues/4805 beginRead(); } } } catch (Throwable t) { // Close the channel directly to avoid FD leak. closeForcibly(); closeFuture.setClosed(); safeSetFailure(promise, t); } } // io.netty.channel.nio.AbstractNioChannel#doRegister @Override protected void doRegister() throws Exception { boolean selected = false; // 进行注册即是 JDK 的 ServerSocketChannel.register() 过程 // 即 netty 与 socket 建立了关系连接, ops=0, 代表监听所有读事件 for (;;) { try { // 一直注册直到成功 // 此处 ops=0, 即不关注任何事件哦, 那么前面的 OP_ACCEPT 和这里又是什么关系呢? selectionKey = javaChannel().register(eventLoop().unwrappedSelector(), 0, this); return; } catch (CancelledKeyException e) { if (!selected) { // Force the Selector to select now as the "canceled" SelectionKey may still be // cached and not removed because no Select.select(..) operation was called yet. eventLoop().selectNow(); selected = true; } else { // We forced a select operation on the selector before but the SelectionKey is still cached // for whatever reason. JDK bug ? throw e; } } } } 4.4 ServerBootstrapAcceptor 速览 前面我们看到, 在做 register() 完了之后, netty 会触发一个invokeHandlerAddedIfNeeded, 从而调用fireHandlerAdded. 此时将会触发 handlerAdded() 从而首次调用 ChannelInitializer.initChannel(), 从而将 ServerBootstrapAcceptor 添加到pipeline进来. ServerBootstrapAcceptor 独立做的事情不多,更多是交给父类处理。 ServerBootstrapAcceptor( final Channel channel, EventLoopGroup childGroup, ChannelHandler childHandler, Entry<ChannelOption<?>, Object>[] childOptions, Entry<AttributeKey<?>, Object>[] childAttrs) { this.childGroup = childGroup; this.childHandler = childHandler; this.childOptions = childOptions; this.childAttrs = childAttrs; // Task which is scheduled to re-enable auto-read. // It's important to create this Runnable before we try to submit it as otherwise the URLClassLoader may // not be able to load the class because of the file limit it already reached. // // See https://github.com/netty/netty/issues/1328 // enableAutoReadTask = new Runnable() { @Override public void run() { channel.config().setAutoRead(true); } }; } // ServerBootstrapAcceptor 大部分情况下都是普通的 InboundHandler, 除了 channelRead() 时 // io.netty.bootstrap.ServerBootstrap.ServerBootstrapAcceptor#channelRead @Override @SuppressWarnings("unchecked") public void channelRead(ChannelHandlerContext ctx, Object msg) { final Channel child = (Channel) msg; child.pipeline().addLast(childHandler); setChannelOptions(child, childOptions, logger); for (Entry<AttributeKey<?>, Object> e: childAttrs) { child.attr((AttributeKey<Object>) e.getKey()).set(e.getValue()); } try { // 它会向 childGroup 中提交channel过去, 从而使用 childGroup 产生作用 childGroup.register(child).addListener(new ChannelFutureListener() { @Override public void operationComplete(ChannelFuture future) throws Exception { if (!future.isSuccess()) { forceClose(child, future.cause()); } } }); } catch (Throwable t) { forceClose(child, t); } } 4.5 端口的绑定 doBind0 经过前面的channel的创建,初始化, Acceptor 的添加到handlerAdded(), 整个pipeline已经work起来了. 然后netty会回调之前添加好的 listeners, 其中一个便是 doBind0(); // 回顾下: ... // Registration future is almost always fulfilled already, but just in case it's not. final PendingRegistrationPromise promise = new PendingRegistrationPromise(channel); regFuture.addListener(new ChannelFutureListener() { @Override public void operationComplete(ChannelFuture future) throws Exception { Throwable cause = future.cause(); if (cause != null) { // Registration on the EventLoop failed so fail the ChannelPromise directly to not cause an // IllegalStateException once we try to access the EventLoop of the Channel. promise.setFailure(cause); } else { // Registration was successful, so set the correct executor to use. // See https://github.com/netty/netty/issues/2586 promise.registered(); doBind0(regFuture, channel, localAddress, promise); } } }); ... // io.netty.bootstrap.AbstractBootstrap#doBind0 private static void doBind0( final ChannelFuture regFuture, final Channel channel, final SocketAddress localAddress, final ChannelPromise promise) { // This method is invoked before channelRegistered() is triggered. Give user handlers a chance to set up // the pipeline in its channelRegistered() implementation. // 这还是一个异步过程 channel.eventLoop().execute(new Runnable() { @Override public void run() { // channel.bind(), channel 与 端口绑定 if (regFuture.isSuccess()) { channel.bind(localAddress, promise).addListener(ChannelFutureListener.CLOSE_ON_FAILURE); } else { promise.setFailure(regFuture.cause()); } } }); } // io.netty.channel.AbstractChannel#bind(java.net.SocketAddress, io.netty.channel.ChannelPromise) @Override public ChannelFuture bind(SocketAddress localAddress, ChannelPromise promise) { // bind() 被当作一个普通的出站事件, 在pipeline中被传递 return pipeline.bind(localAddress, promise); } // io.netty.channel.DefaultChannelPipeline#bind(java.net.SocketAddress, io.netty.channel.ChannelPromise) @Override public final ChannelFuture bind(SocketAddress localAddress, ChannelPromise promise) { // 从tail开始传递 return tail.bind(localAddress, promise); } // io.netty.channel.AbstractChannelHandlerContext#bind(java.net.SocketAddress, io.netty.channel.ChannelPromise) @Override public ChannelFuture bind(final SocketAddress localAddress, final ChannelPromise promise) { if (localAddress == null) { throw new NullPointerException("localAddress"); } if (isNotValidPromise(promise, false)) { // cancelled return promise; } // 同样是一个pipeline式调用, bind() 是一个出站事件, 所以查找 outbound // 最终会调到 DefaultChannelPipeline 中 // netty的pipeline机制就体现在这里, 它会一直查找可用的handler, 然后执行它, 直到结束 final AbstractChannelHandlerContext next = findContextOutbound(); // 获取其绑定的 executor EventExecutor executor = next.executor(); if (executor.inEventLoop()) { next.invokeBind(localAddress, promise); } else { safeExecute(executor, new Runnable() { @Override public void run() { next.invokeBind(localAddress, promise); } }, promise, null); } return promise; } // ------------------------------------------------------------------------- // 出入站handler的查找实现, 非常简单, 却很有效 (该方法在 AbstractChannelHandlerContext 中实现,被所有handler通用) // io.netty.channel.AbstractChannelHandlerContext#findContextInbound private AbstractChannelHandlerContext findContextInbound() { // 以当前节点作为起点开始查找, 取第一个入站handler返回, 没有则说明 pipeline 已结束 AbstractChannelHandlerContext ctx = this; do { ctx = ctx.next; } while (!ctx.inbound); return ctx; } // io.netty.channel.AbstractChannelHandlerContext#findContextOutbound private AbstractChannelHandlerContext findContextOutbound() { // 以当前节点作为起点开始查找, 取第一个出站handler返回, 没有则说明 pipeline 已结束 AbstractChannelHandlerContext ctx = this; do { ctx = ctx.prev; } while (!ctx.outbound); return ctx; } // ------------------------------------------------------------------------- // io.netty.channel.AbstractChannelHandlerContext#invokeBind private void invokeBind(SocketAddress localAddress, ChannelPromise promise) { if (invokeHandler()) { try { ((ChannelOutboundHandler) handler()).bind(this, localAddress, promise); } catch (Throwable t) { notifyOutboundHandlerException(t, promise); } } else { bind(localAddress, promise); } } // 最终传递到 HeadContext 中进行处理 // io.netty.channel.DefaultChannelPipeline.HeadContext#bind @Override public void bind( ChannelHandlerContext ctx, SocketAddress localAddress, ChannelPromise promise) throws Exception { // unsafe 处理bind() 操作 unsafe.bind(localAddress, promise); } // io.netty.channel.AbstractChannel.AbstractUnsafe#bind @Override public final void bind(final SocketAddress localAddress, final ChannelPromise promise) { assertEventLoop(); if (!promise.setUncancellable() || !ensureOpen(promise)) { return; } // See: https://github.com/netty/netty/issues/576 if (Boolean.TRUE.equals(config().getOption(ChannelOption.SO_BROADCAST)) && localAddress instanceof InetSocketAddress && !((InetSocketAddress) localAddress).getAddress().isAnyLocalAddress() && !PlatformDependent.isWindows() && !PlatformDependent.maybeSuperUser()) { // Warn a user about the fact that a non-root user can't receive a // broadcast packet on *nix if the socket is bound on non-wildcard address. logger.warn( "A non-root user can't receive a broadcast packet if the socket " + "is not bound to a wildcard address; binding to a non-wildcard " + "address (" + localAddress + ") anyway as requested."); } boolean wasActive = isActive(); try { // 这里会调用 jdk 的ServerSocketChannel接口, 实现真正的端口绑定 // 至此, 服务对外可见 doBind(localAddress); } catch (Throwable t) { safeSetFailure(promise, t); closeIfClosed(); return; } // 判断是否是首次创建 channel, 如果是, 则调用 fireChannelActive() 传播channelActive事件 if (!wasActive && isActive()) { // 这将会被稍后执行 invokeLater(new Runnable() { @Override public void run() { pipeline.fireChannelActive(); } }); } // 触发一些通知什么的, 结束了 safeSetSuccess(promise); } // 最终的bind(), 是通过 jdk 底层的 serverSocketChannel 开启socket监听 // io.netty.channel.socket.nio.NioServerSocketChannel#doBind @Override protected void doBind(SocketAddress localAddress) throws Exception { if (PlatformDependent.javaVersion() >= 7) { // 调用 serverSocketChannel bind() 方法,开启socket监听 javaChannel().bind(localAddress, config.getBacklog()); } else { javaChannel().socket().bind(localAddress, config.getBacklog()); } } 至此, bind 工作总算是完成了.我们来总结下它的主要工作: 1. 初始化一个channel, 根据设置里来, 我们使用 NioServerSocketChannel; 2. 过继现有的配置项给到channel; 3. 将channel与eventloop绑定做注册, 添加 ServerBootstrapAcceptor 到 pipeline 中; 4. 绑定完成后, 通知现有的handler, 触发系列事件: fireHandlerAdded() -> fireChannelRegistered() -> fireChannelActive(); 5. 而bind()则作为一个出站事件, 被处理, 最终调用 jdk的ServerSocketChannel.register() 完成端口的开启; 不过有一点需要注意, 在这个过程中, 只有 bossGroup 起作用, 所有的 workGroup 都还在待命中. 我们目前看到的 pipeline 是这样的: head -> Acceptor -> tail; 讲了这么多, 有一种绕了一大圈的感觉有木有, 如果你自己直接使用nio写, 估计10行代码都不要就搞定了. 尴尬! 5. netty eventloop 主循环 evenloop是netty的重要概念, 但在前面我们并未细讲这玩意如何起作用(仅看过其创建过程而已), 不过这并不意味着它还没起作用, 而是我们暂时忽略了它. 每次要执行任务时, 总是会调用 eventloop().execute(...), 实际上这就是 eventloop的入口: // io.netty.util.concurrent.SingleThreadEventExecutor#execute @Override public void execute(Runnable task) { // execute 在线程池中, 是一个异步任务的提交方法, eventloop中同样也一样 // 但是大部分情况下只是添加队列, 因为 eventloop 是单线程的 if (task == null) { throw new NullPointerException("task"); } // 向eventLoop队列中添加task boolean inEventLoop = inEventLoop(); addTask(task); // 如果自身就是运行在 eventloop 环境中, 添加完task后则不再做更多的事 if (!inEventLoop) { // 如果不是在eventLoop线程中,则都会尝试创建新线程运行, 但实际会重新检测线程是否创建 startThread(); if (isShutdown() && removeTask(task)) { reject(); } } if (!addTaskWakesUp && wakesUpForTask(task)) { wakeup(inEventLoop); } } // io.netty.util.concurrent.SingleThreadEventExecutor#addTask /** * Add a task to the task queue, or throws a {@link RejectedExecutionException} if this instance was shutdown * before. */ protected void addTask(Runnable task) { if (task == null) { throw new NullPointerException("task"); } // taskQueue = MpscUnsafeUnboundedArrayQueue, 基于Unsafe 和 cas 实现的线程安全的队列 if (!offerTask(task)) { // 添加失败,则走拒绝策略 reject(task); } } // startThread, 看起来是开启线程的意思, 却又不太一样 private void startThread() { // 所以实际上只会创建一次线程 if (state == ST_NOT_STARTED) { // 抢到锁的线程才能调用start()方法 if (STATE_UPDATER.compareAndSet(this, ST_NOT_STARTED, ST_STARTED)) { try { doStartThread(); } catch (Throwable cause) { STATE_UPDATER.set(this, ST_NOT_STARTED); PlatformDependent.throwException(cause); } } } } // 开启eventLoop的线程 // io.netty.util.concurrent.SingleThreadEventExecutor#doStartThread private void doStartThread() { assert thread == null; // 它并不是简单的thread.start() executor.execute(new Runnable() { @Override public void run() { thread = Thread.currentThread(); if (interrupted) { thread.interrupt(); } boolean success = false; updateLastExecutionTime(); try { // 核心方法,由 SingleThreadEventExecutor.run() 实现 // 当然是由具体的executor具体实现了, 此文为 NioEventLoop.run() SingleThreadEventExecutor.this.run(); success = true; } catch (Throwable t) { logger.warn("Unexpected exception from an event executor: ", t); } finally { // 线程池关闭,优雅停机 ... } } }); } 核心: 事件循环主框架, 既然是事件循环,则其必然是不会退出的。 // io.netty.channel.nio.NioEventLoop#run @Override protected void run() { // 一个死循环检测任务, 这就 eventloop 的大杀器哦 for (;;) { try { switch (selectStrategy.calculateStrategy(selectNowSupplier, hasTasks())) { case SelectStrategy.CONTINUE: continue; // 有任务时执行任务, 否则阻塞等待网络事件, 或被唤醒 case SelectStrategy.SELECT: // select.select(), 带超时限制 select(wakenUp.getAndSet(false)); // 'wakenUp.compareAndSet(false, true)' is always evaluated // before calling 'selector.wakeup()' to reduce the wake-up // overhead. (Selector.wakeup() is an expensive operation.) // // However, there is a race condition in this approach. // The race condition is triggered when 'wakenUp' is set to // true too early. // // 'wakenUp' is set to true too early if: // 1) Selector is waken up between 'wakenUp.set(false)' and // 'selector.select(...)'. (BAD) // 2) Selector is waken up between 'selector.select(...)' and // 'if (wakenUp.get()) { ... }'. (OK) // // In the first case, 'wakenUp' is set to true and the // following 'selector.select(...)' will wake up immediately. // Until 'wakenUp' is set to false again in the next round, // 'wakenUp.compareAndSet(false, true)' will fail, and therefore // any attempt to wake up the Selector will fail, too, causing // the following 'selector.select(...)' call to block // unnecessarily. // // To fix this problem, we wake up the selector again if wakenUp // is true immediately after selector.select(...). // It is inefficient in that it wakes up the selector for both // the first case (BAD - wake-up required) and the second case // (OK - no wake-up required). if (wakenUp.get()) { selector.wakeup(); } // fall through default: } cancelledKeys = 0; needsToSelectAgain = false; // ioRatio 为io操作的占比, 和运行任务相比, 默认为 50:50 final int ioRatio = this.ioRatio; if (ioRatio == 100) { try { // step1. 运行io操作 processSelectedKeys(); } finally { // Ensure we always run tasks. // step2. 运行task任务 runAllTasks(); } } else { final long ioStartTime = System.nanoTime(); try { processSelectedKeys(); } finally { // Ensure we always run tasks. final long ioTime = System.nanoTime() - ioStartTime; // 运行任务的最长时间 runAllTasks(ioTime * (100 - ioRatio) / ioRatio); } } } catch (Throwable t) { handleLoopException(t); } // Always handle shutdown even if the loop processing threw an exception. try { if (isShuttingDown()) { closeAll(); if (confirmShutdown()) { return; } } } catch (Throwable t) { handleLoopException(t); } } } // select, 事件循环的依据 private void select(boolean oldWakenUp) throws IOException { Selector selector = this.selector; try { int selectCnt = 0; long currentTimeNanos = System.nanoTime(); // 带超时限制, 默认最大超时1s, 但当有延时任务处理时, 以它为标准 long selectDeadLineNanos = currentTimeNanos + delayNanos(currentTimeNanos); for (;;) { long timeoutMillis = (selectDeadLineNanos - currentTimeNanos + 500000L) / 1000000L; if (timeoutMillis <= 0) { // 超时则立即返回 if (selectCnt == 0) { selector.selectNow(); selectCnt = 1; } break; } // If a task was submitted when wakenUp value was true, the task didn't get a chance to call // Selector#wakeup. So we need to check task queue again before executing select operation. // If we don't, the task might be pended until select operation was timed out. // It might be pended until idle timeout if IdleStateHandler existed in pipeline. if (hasTasks() && wakenUp.compareAndSet(false, true)) { selector.selectNow(); selectCnt = 1; break; } int selectedKeys = selector.select(timeoutMillis); selectCnt ++; if (selectedKeys != 0 || oldWakenUp || wakenUp.get() || hasTasks() || hasScheduledTasks()) { // - Selected something, // - waken up by user, or // - the task queue has a pending task. // - a scheduled task is ready for processing break; } if (Thread.interrupted()) { // Thread was interrupted so reset selected keys and break so we not run into a busy loop. // As this is most likely a bug in the handler of the user or it's client library we will // also log it. // // See https://github.com/netty/netty/issues/2426 if (logger.isDebugEnabled()) { logger.debug("Selector.select() returned prematurely because " + "Thread.currentThread().interrupt() was called. Use " + "NioEventLoop.shutdownGracefully() to shutdown the NioEventLoop."); } selectCnt = 1; break; } long time = System.nanoTime(); if (time - TimeUnit.MILLISECONDS.toNanos(timeoutMillis) >= currentTimeNanos) { // timeoutMillis elapsed without anything selected. selectCnt = 1; } else if (SELECTOR_AUTO_REBUILD_THRESHOLD > 0 && selectCnt >= SELECTOR_AUTO_REBUILD_THRESHOLD) { // The selector returned prematurely many times in a row. // Rebuild the selector to work around the problem. logger.warn( "Selector.select() returned prematurely {} times in a row; rebuilding Selector {}.", selectCnt, selector); rebuildSelector(); selector = this.selector; // Select again to populate selectedKeys. selector.selectNow(); selectCnt = 1; break; } currentTimeNanos = time; } if (selectCnt > MIN_PREMATURE_SELECTOR_RETURNS) { if (logger.isDebugEnabled()) { logger.debug("Selector.select() returned prematurely {} times in a row for Selector {}.", selectCnt - 1, selector); } } } catch (CancelledKeyException e) { if (logger.isDebugEnabled()) { logger.debug(CancelledKeyException.class.getSimpleName() + " raised by a Selector {} - JDK bug?", selector, e); } // Harmless exception - log anyway } } 反正整体就是这样了, 循环检测select, 运行io事件及execute task. 有了这个 eventloop, 整体server就可以run起来了, 不管是有外部请求进来, 还是有内部任务提交, 都将被eventloop执行. 不过还有一点未澄清的: 前面在做channel.register()时传递了一个 ops=0, 那它是如何监听新连接事件的呢? 实际上它是在注册激活完成之后, 再进行了一个read()的操作, 重新将 OP_ACCEPT 添加到 selectionKey 中了.(没错,底层永远没那么多花招) // io.netty.channel.DefaultChannelPipeline.HeadContext#channelActive @Override public void channelActive(ChannelHandlerContext ctx) throws Exception { ctx.fireChannelActive(); // 会触发 read() 流程, 修改 selectionKey 的 ops 标志位 readIfIsAutoRead(); } ... // io.netty.channel.AbstractChannel.AbstractUnsafe#beginRead @Override public final void beginRead() { assertEventLoop(); if (!isActive()) { return; } try { doBeginRead(); } catch (final Exception e) { invokeLater(new Runnable() { @Override public void run() { pipeline.fireExceptionCaught(e); } }); close(voidPromise()); } } // io.netty.channel.nio.AbstractNioMessageChannel#doBeginRead @Override protected void doBeginRead() throws Exception { if (inputShutdown) { return; } super.doBeginRead(); } // io.netty.channel.nio.AbstractNioChannel#doBeginRead @Override protected void doBeginRead() throws Exception { // Channel.read() or ChannelHandlerContext.read() was called final SelectionKey selectionKey = this.selectionKey; if (!selectionKey.isValid()) { return; } readPending = true; final int interestOps = selectionKey.interestOps(); if ((interestOps & readInterestOp) == 0) { // readInterestOp, 即是前面设置的 OP_ACCEPT selectionKey.interestOps(interestOps | readInterestOp); } } 本文有点长了, 留点东西下篇继续: io事件如何处理? 任务如何执行? 看完三件事❤️ 如果你觉得这篇内容对你还蛮有帮助,我想邀请你帮我三个小忙: 点赞,转发,有你们的 『点赞和评论』,才是我创造的动力。 关注公众号 『java烂猪皮』,不定期分享原创知识。 同时可以期待后续文章ing🚀 作者:等你归去来 出处:https://www.cnblogs.com/yougewe/p/13415440.html
优秀的个人博客,低调大师

Java 8 Stream原理解析

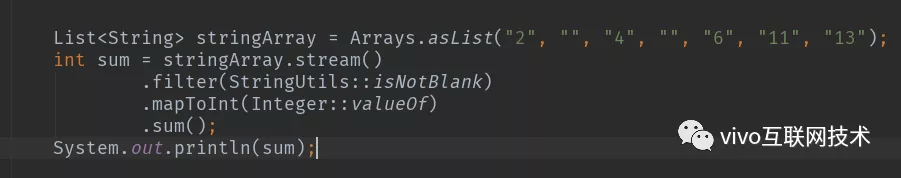
说起 Java 8,我们知道 Java 8 大改动之一就是增加函数式编程,而 Stream API 便是函数编程的主角,Stream API 是一种流式的处理数据风格,也就是将要处理的数据当作流,在管道中进行传输,并在管道中的每个节点对数据进行处理,如过滤、排序、转换等。 首先我们先看一个使用Stream API的示例,具体代码如下: code1 Stream example 这是个很简单的一个Stream使用例子,我们过滤掉空字符串后,转成int类型并计算出最大值,这其中包括了三个操作:filter、mapToInt、sum。相信大多数人再刚使用Stream API的时候都会有个疑问,Stream是指怎么实现的,是每一次函数调用就执行一次迭代吗?答案肯定是否,因为如果真的是每一次函数调用就执行一次迭代,这个效率是很难接受的,Stream也不会那么受欢迎。 其实Stream内部是通过流水线(Pipeline)的方式来实现的,基本思想是在迭代的时候顺着流水线尽可能的执行更多的操作,从而避免多次迭代。为了对Stream的操作有更清晰的认识,我们汇总了Stream的所有操作。 从上表可以看出Stream将所有操作分为两类:中间操作和终止操作。其中中间操作分为无状态和有状态,终止操作分为非短路操作和短路操作,下面是针对这几个操作的含义说明: 1、中间操作:中间操作只是一种标记,只有结束操作才会触发实际计算 无状态:指元素的处理不受前面元素的影响; 有状态:有状态的中间操作必须等到所有元素处理之后才知道最终结果,比如排序是有状态操作,在读取所有元素之前并不能确定排序结果。 2、终止操作:顾名思义,就是得出最后计算结果的操作 短路操作:指不用处理全部元素就可以返回结果; 非短路操作:指必须处理所有元素才能得到最终结果。 Stream流水线解决方案 通过上面的介绍,我们了解到Stream在执行中间操作时仅仅是记录,当用户调用终止操作时,会在一个迭代里将已经记录的操作顺着流水线全部执行掉。沿着这个思路,有几个问题需要解决: 用户的操作如何记录? 操作如何叠加? 叠加之后的操作如何执行? 1、操作如何记录 图1-1 关于操作如何记录,在JDK源码注释中多次用(操作)stage来标识用户的每一次操作,而通常情况下Stream的操作又需要一个回调函数,所以一个完整的操作是由数据来源、操作、回调函数组成的三元组来表示。而在具体实现中,使用实例化的ReferencePipeline来表示,即图1-1中的Head、StatelessOp、StatefulOp的实例。接下来我们来看下Stream几个常用方法的源码。 code2 Collection.Stream() code3StreamSupport.stream() code4 ReferencePipeline.map() 从上面源码中可以看出来,我们调用stream()方法时最终会创建一个Head实例来表示流操作的头,当调用map()方法时则会创建无状态的中间操作实例StatelessOp,同样调用其他操作对应的方法也会生成一个ReferencePipeline实例,在这里就不一一列举。在用户调用一系列操作后,最终会形成一个双向链表,如下图所示: 图1-2 2、操作如何叠加 上面我们说明了Stream是通过stage记录操作,但stage只保存当前操作,它并不知道下个stage如何操作,需要什么操作。所以要执行的话还需要某种协议将各个stage关联起来。jdk中就是使用Slink接口来实现的,Slink接口定义begin()、end()、cancellationRequested()、accept()四个方法,如下表所示。 往回看code3 ReferencePipeline.map()的方法,我们会发现我们在创建一个ReferencePipeline实例的时候,需要重写opWrapSink方法来生成对应Sink实例。而且通过阅读源码会发现常用的操作都会创建一个ChainedReference实例。我们可以看下code5 ChainedReference抽象类的源码实现,因为ChainedReference只是个抽象实现,不携带具体操作的特性,所以是更能体现作者的设计理念。 通过查看源码可以发现ChainedReference会持有下一个操作的Slink,并在调用begin、end、cancellationRequested方法会调用下一个操作的Slink的相应方法,以此来达到叠加的效果。 code5ChainedReference 3、叠加之后的操作如何执行 Sink完美封装了Stream每一步操作,并给出了[处理->转发]的模式来叠加操作。这一连串的齿轮已经咬合,就差最后一步拨动齿轮启动执行。是什么启动这一连串的操作呢?也许你已经想到了启动的原始动力就是结束操作(Terminal Operation),一旦调用某个结束操作,就会触发整个流水线的执行。 结束操作之后不能再有别的操作,所以结束操作不会创建新的流水线阶段(Stage),直观的说就是流水线的链表不会在往后延伸了。结束操作会创建一个包装了自己操作的Sink,这也是流水线中最后一个Sink,这个Sink只需要处理数据而不需要将结果传递给下游的Sink(因为没有下游)。对于Sink的[处理->转发]模型,结束操作的Sink就是调用链的出口。 我们再来考察一下上游的Sink是如何找到下游Sink的。一种可选的方案是在PipelineHelper中设置一个Sink字段,在流水线中找到下游Stage并访问Sink字段即可。但Stream类库的设计者没有这么做,而是设置了一个Sink AbstractPipeline.opWrapSink(int flags, Sink downstream)方法来得到Sink,该方法的作用是返回一个新的包含了当前Stage代表的操作以及能够将结果传递给downstream的Sink对象。为什么要产生一个新对象而不是返回一个Sink字段?这是因为使用opWrapSink()可以将当前操作与下游Sink(上文中的downstream参数)结合成新Sink。试想只要从流水线的最后一个Stage开始,不断调用上一个Stage的opWrapSink()方法直到最开始(不包括stage0,因为stage0代表数据源,不包含操作),就可以得到一个代表了流水线上所有操作的Sink,用代码表示就是这样: code6AbstractPipeline.wrapSink 现在流水线上从开始到结束的所有的操作都被包装到了一个Sink里,执行这个Sink就相当于执行整个流水线,执行Sink的代码如下: code7AbstractPipeline.copyInto 上述代码首先调用wrappedSink.begin()方法告诉Sink数据即将到来,然后调用spliterator.forEachRemaining()方法对数据进行迭代,最后调用wrappedSink.end()方法通知Sink数据处理结束。逻辑如此清晰。 作者:Huang Rongpeng

优秀的个人博客,低调大师

Atomikos事务恢复流程源码解析

Atomikos-XA事务恢复 说事务恢复流程之前,我们来讨论下,会啥会出现事务恢复?XA二阶段提交协议不是强一致性的吗?要解答这个问题,我们就要来看看XA二阶段协议有什么问题? 问题一 :单点故障 由于协调者的重要性,一旦协调者TM发生故障。参与者RM会一直阻塞下去。尤其在第二阶段,协调者发生故障,那么所有的参与者还都处于锁定事务资源的状态中,而无法继续完成事务操作。(如果是协调者挂掉,可以重新选举一个协调者,但是无法解决因为协调者宕机导致的参与者处于阻塞状态的问题) 问题二 :数据不一致 数据不一致。在二阶段提交的阶段二中,当协调者向参与者发送commit请求之后,发生了局部网络异常或者在发送commit请求过程中协调者发生了故障,这回导致只有一部分参与者接受到了commit请求。而在这部分参与者接到commit请求之后就会执行commit操作。但是其他部分未接到commit请求的机器则无法执行事务提交。于是整个分布式系统便出现了数据不一致性的现象。 如何解决? 解决的方案简单,就是我们在事务的操作的每一步,我们都需要对事务状态的日志进行人为的记录,我们可以把日志记录存储在我们想存储的地方,可以是本地存储,也可以中心化的存储。atomikos的开源版本,我们之前也分析了,它是使用内存 + file的方式,存储在本地,这样的话,如果在一个集群系统里面,如果有节点宕机,日志又存储在本地,所以事务不能及时的恢复(需要重启服务)。 Atomikos 多场景下事务恢复。 Atomikos 提供了二种方式,来应对不同场景下的异常情况。 场景一: 服务节点不宕机,因为其他的原因,产生需要事务恢复的情况。 这个时候才要定时任务进行恢复。 具体的代码 com.atomikos.icatch.imp.TransactionServiceImp.init() 方法,会初始化一个定时任务,进行事务的恢复。 public synchronized void init ( Properties properties ) throws SysException { shutdownInProgress_ = false; control_ = new com.atomikos.icatch.admin.imp.LogControlImp ( (AdminLog) this.recoveryLog ); ConfigProperties configProperties = new ConfigProperties(properties); long recoveryDelay = configProperties.getRecoveryDelay(); recoveryTimer = new PooledAlarmTimer(recoveryDelay); recoveryTimer.addAlarmTimerListener(new AlarmTimerListener() { @Override public void alarm(AlarmTimer timer) { //进行事务恢复 performRecovery(); } }); TaskManager.SINGLETON.executeTask(recoveryTimer); initialized_ = true; } 最终会进入com.atomikos.datasource.xa.XATransactionalResource.recover() 方法。 public void recover() { XaResourceRecoveryManager xaResourceRecoveryManager = XaResourceRecoveryManager.getInstance(); if (xaResourceRecoveryManager != null) { //null for LogCloud recovery try { xaResourceRecoveryManager.recover(getXAResource()); } catch (Exception e) { refreshXAResource(); //cf case 156968 } } } 场景二: 当服务节点宕机重启动过程中进行事务的恢复。具体实现在com.atomikos.datasource.xa.XATransactionalResource.setRecoveryService()方法里面 @Override public void setRecoveryService ( RecoveryService recoveryService ) throws ResourceException { if ( recoveryService != null ) { if ( LOGGER.isTraceEnabled() ) LOGGER.logTrace ( "Installing recovery service on resource " + getName () ); this.branchIdentifier=recoveryService.getName(); //进行事务恢复 recover(); } } com.atomikos.datasource.xa.XATransactionalResource.recover() 流程详解。 主代码: public void recover(XAResource xaResource) throws XAException { // 根据XA recovery 协议获取 xid List<XID> xidsToRecover = retrievePreparedXidsFromXaResource(xaResource); Collection<XID> xidsToCommit; try { // xid 与日志记录的xid进行匹配 xidsToCommit = retrieveExpiredCommittingXidsFromLog(); for (XID xid : xidsToRecover) { if (xidsToCommit.contains(xid)) { //执行 XA commit xid 进行提交 replayCommit(xid, xaResource); } else { attemptPresumedAbort(xid, xaResource); } } } catch (LogException couldNotRetrieveCommittingXids) { LOGGER.logWarning("Transient error while recovering - will retry later...", couldNotRetrieveCommittingXids); } } 我们来看一下如何根据 XA recovery 协议获取RM端存储的xid。 进入方法 retrievePreparedXidsFromXaResource(xaResource), 最后进入 com.atomikos.datasource.xa.RecoveryScan.recoverXids()方法。 public static List<XID> recoverXids(XAResource xaResource, XidSelector selector) throws XAException { List<XID> ret = new ArrayList<XID>(); boolean done = false; int flags = XAResource.TMSTARTRSCAN; Xid[] xidsFromLastScan = null; List<XID> allRecoveredXidsSoFar = new ArrayList<XID>(); do { xidsFromLastScan = xaResource.recover(flags); flags = XAResource.TMNOFLAGS; done = (xidsFromLastScan == null || xidsFromLastScan.length == 0); if (!done) { // TEMPTATIVELY SET done TO TRUE // TO TOLERATE ORACLE 8.1.7 INFINITE // LOOP (ALWAYS RETURNS SAME RECOVER // SET). IF A NEW SET OF XIDS IS RETURNED // THEN done WILL BE RESET TO FALSE done = true; for ( int i = 0; i < xidsFromLastScan.length; i++ ) { XID xid = new XID ( xidsFromLastScan[i] ); // our own XID implements equals and hashCode properly if (!allRecoveredXidsSoFar.contains(xid)) { // a new xid is returned -> we can not be in a recovery loop -> go on allRecoveredXidsSoFar.add(xid); done = false; if (selector.selects(xid)) { ret.add(xid); } } } } } while (!done); return ret; } 我们重点关注xidsFromLastScan = xaResource.recover(flags); 这个方法,如果我们使用MySQL,那么久会进入 MysqlXAConnection.recover()方法。执行 XA recovery xid 语句来获取 xid。 protected static Xid[] recover(Connection c, int flag) throws XAException { /* * The XA RECOVER statement returns information for those XA transactions on the MySQL server that are in the PREPARED state. (See Section 13.4.7.2, ???XA * Transaction States???.) The output includes a row for each such XA transaction on the server, regardless of which client started it. * * XA RECOVER output rows look like this (for an example xid value consisting of the parts 'abc', 'def', and 7): * * mysql> XA RECOVER; * +----------+--------------+--------------+--------+ * | formatID | gtrid_length | bqual_length | data | * +----------+--------------+--------------+--------+ * | 7 | 3 | 3 | abcdef | * +----------+--------------+--------------+--------+ * * The output columns have the following meanings: * * formatID is the formatID part of the transaction xid * gtrid_length is the length in bytes of the gtrid part of the xid * bqual_length is the length in bytes of the bqual part of the xid * data is the concatenation of the gtrid and bqual parts of the xid */ boolean startRscan = ((flag & TMSTARTRSCAN) > 0); boolean endRscan = ((flag & TMENDRSCAN) > 0); if (!startRscan && !endRscan && flag != TMNOFLAGS) { throw new MysqlXAException(XAException.XAER_INVAL, Messages.getString("MysqlXAConnection.001"), null); } // // We return all recovered XIDs at once, so if not TMSTARTRSCAN, return no new XIDs // // We don't attempt to maintain state to check for TMNOFLAGS "outside" of a scan // if (!startRscan) { return new Xid[0]; } ResultSet rs = null; Statement stmt = null; List<MysqlXid> recoveredXidList = new ArrayList<MysqlXid>(); try { // TODO: Cache this for lifetime of XAConnection stmt = c.createStatement(); rs = stmt.executeQuery("XA RECOVER"); while (rs.next()) { final int formatId = rs.getInt(1); int gtridLength = rs.getInt(2); int bqualLength = rs.getInt(3); byte[] gtridAndBqual = rs.getBytes(4); final byte[] gtrid = new byte[gtridLength]; final byte[] bqual = new byte[bqualLength]; if (gtridAndBqual.length != (gtridLength + bqualLength)) { throw new MysqlXAException(XAException.XA_RBPROTO, Messages.getString("MysqlXAConnection.002"), null); } System.arraycopy(gtridAndBqual, 0, gtrid, 0, gtridLength); System.arraycopy(gtridAndBqual, gtridLength, bqual, 0, bqualLength); recoveredXidList.add(new MysqlXid(gtrid, bqual, formatId)); } } catch (SQLException sqlEx) { throw mapXAExceptionFromSQLException(sqlEx); } finally { if (rs != null) { try { rs.close(); } catch (SQLException sqlEx) { throw mapXAExceptionFromSQLException(sqlEx); } } if (stmt != null) { try { stmt.close(); } catch (SQLException sqlEx) { throw mapXAExceptionFromSQLException(sqlEx); } } } int numXids = recoveredXidList.size(); Xid[] asXids = new Xid[numXids]; Object[] asObjects = recoveredXidList.toArray(); for (int i = 0; i < numXids; i++) { asXids[i] = (Xid) asObjects[i]; } return asXids; } 这里要注意如果Mysql的版本 <5.7.7 ,则不会有任何数据,在以后的版本中Mysql进行了修复,因此如果我们想要使用MySQL充当RM,版本必须 >= 5.7.7 ,原因是: MySQL 5.6版本在客户端退出的时候,自动把已经prepare的事务回滚了,那么MySQL为什么要这样做?这主要取决于MySQL的内部实现,MySQL 5.7以前的版本,对于prepare的事务,MySQL是不会记录binlog的(官方说是减少fsync,起到了优化的作用)。只有当分布式事务提交的时候才会把前面的操作写入binlog信息,所以对于binlog来说,分布式事务与普通的事务没有区别,而prepare以前的操作信息都保存在连接的IO_CACHE中,如果这个时候客户端退出了,以前的binlog信息都会被丢失,再次重连后允许提交的话,会造成Binlog丢失,从而造成主从数据的不一致,所以官方在客户端退出的时候直接把已经prepare的事务都回滚了! 回到主线再从自己记录的事务日志里面获取XID Collection<XID> xidsToCommit = retrieveExpiredCommittingXidsFromLog(); 我们来看下获取事务日志里面的XID的retrieveExpiredCommittingXidsFromLog()方法。 然后进入com.atomikos.recovery.imp.RecoveryLogImp.getCommittingParticipants()方法。 public Collection<ParticipantLogEntry> getCommittingParticipants() throws LogReadException { Collection<ParticipantLogEntry> committingParticipants = new HashSet<ParticipantLogEntry>(); Collection<CoordinatorLogEntry> committingCoordinatorLogEntries = repository.findAllCommittingCoordinatorLogEntries(); for (CoordinatorLogEntry coordinatorLogEntry : committingCoordinatorLogEntries) { for (ParticipantLogEntry participantLogEntry : coordinatorLogEntry.participants) { committingParticipants.add(participantLogEntry); } } return committingParticipants; } 到这里我们来简单介绍一下,事务日志的存储结构。首先是 CoordinatorLogEntry,这是一次XA事务的所有信息实体类。 public class CoordinatorLogEntry implements Serializable { //全局事务id public final String id; //是否已经提交 public final boolean wasCommitted; /** * Only for subtransactions, null otherwise. */ public final String superiorCoordinatorId; //参与者集合 public final ParticipantLogEntry[] participants; } 再来看一下参与者实体类 ParticipantLogEntry : public class ParticipantLogEntry implements Serializable { private static final long serialVersionUID = 1728296701394899871L; /** * The ID of the global transaction as known by the transaction core. */ public final String coordinatorId; /** * Identifies the participant within the global transaction. */ public final String uri; /** * When does this participant expire (expressed in millis since Jan 1, 1970)? */ public final long expires; /** * Best-known state of the participant. */ public final TxState state; /** * For diagnostic purposes, null if not relevant. */ public final String resourceName; } 回到com.atomikos.recovery.xa.DefaultXaRecoveryLog.getExpiredCommittingXids() 方法,可以到获取了一次XA事务过程中,存储的事务日志中的xid。 public Set<XID> getExpiredCommittingXids() throws LogReadException { Set<XID> ret = new HashSet<XID>(); Collection<ParticipantLogEntry> entries = log.getCommittingParticipants(); for (ParticipantLogEntry entry : entries) { if (expired(entry) && !http(entry)) { XID xid = new XID(entry.coordinatorId, entry.uri); ret.add(xid); } } return ret; } 如果从RM中通过XA recovery取出的XID,包含在从事务日志中取出的XID,则进行commit,否则进行rollback. List<XID> xidsToRecover = retrievePreparedXidsFromXaResource(xaResource); Collection<XID> xidsToCommit; try { xidsToCommit = retrieveExpiredCommittingXidsFromLog(); for (XID xid : xidsToRecover) { if (xidsToCommit.contains(xid)) { replayCommit(xid, xaResource); } else { attemptPresumedAbort(xid, xaResource); } } } catch (LogException couldNotRetrieveCommittingXids) { LOGGER.logWarning("Transient error while recovering - will retry later...", couldNotRetrieveCommittingXids); } replayCommit 方法如下: private void replayCommit(XID xid, XAResource xaResource) { if (LOGGER.isDebugEnabled()) LOGGER.logDebug("Replaying commit of xid: " + xid); try { //进行事务提交 xaResource.commit(xid, false); //更新事务日志 log.terminated(xid); } catch (XAException e) { if (alreadyHeuristicallyTerminatedByResource(e)) { handleHeuristicTerminationByResource(xid, xaResource, e, true); } else if (xidTerminatedInResourceByConcurrentCommit(e)) { log.terminated(xid); } else { LOGGER.logWarning("Transient error while replaying commit - will retry later...", e); } } } attemptPresumedAbort(xid, xaResource); 方法如下: private void attemptPresumedAbort(XID xid, XAResource xaResource) { try { log.presumedAborting(xid); if (LOGGER.isDebugEnabled()) LOGGER.logDebug("Presumed abort of xid: " + xid); try { //进行回滚 xaResource.rollback(xid); //更新日志状态 log.terminated(xid); } catch (XAException e) { if (alreadyHeuristicallyTerminatedByResource(e)) { handleHeuristicTerminationByResource(xid, xaResource, e, false); } else if (xidTerminatedInResourceByConcurrentRollback(e)) { log.terminated(xid); } else { LOGGER.logWarning("Unexpected exception during recovery - ignoring to retry later...", e); } } } catch (IllegalStateException presumedAbortNotAllowedInCurrentLogState) { // ignore to retry later if necessary } catch (LogException logWriteException) { LOGGER.logWarning("log write failed for Xid: "+xid+", ignoring to retry later", logWriteException); } } 文章到此,已经写的很长很多了,我们分析了ShardingSphere对于XA方案,提供了一套SPI解决方案,对Atomikos进行了整合,也分析了Atomikos初始化流程,开始事务流程,获取连接流程,提交事务流程,回滚事务流程,事务恢复流程。 希望对大家理解XA的原理有所帮助。 作者介绍: 肖宇,Apache ShardingSphere Committer,开源hmily分布式事务框架作者, 开源soul网关作者,热爱开源,追求写优雅代码。目前就职入京东数科,参与ShardingSphere的开源建设,以及分布式数据库的研发工作。

优秀的个人博客,低调大师

Apache ShardingSphere整合Atomikos源码解析

Shardingsphere整合Atomikos对XA分布式事务的支持 Apache ShardingSphere 是一套开源的分布式数据库中间件解决方案组成的生态圈,它由 JDBC、Proxy 和 Sidecar(规划中)这 3 款相互独立,却又能够混合部署配合使用的产品组成。 它们均提供标准化的数据分片、分布式事务和数据库治理功能,可适用于如 Java 同构、异构语言、云原生等各种多样化的应用场景。 ShardingSphere 已于2020年4月16日成为 Apache 软件基金会的顶级项目。 咋们话不多,接上篇,我们直接进入正题。 Atomikos简单介绍 Atomikos(https://www.atomikos.com/),其实是一家公司的名字,提供了基于JTA规范的XA分布式事务TM的实现。其旗下最著名的产品就是事务管理器。产品分两个版本: TransactionEssentials:开源的免费产品; ExtremeTransactions:上商业版,需要收费。 这两个产品的关系如下图所示: ExtremeTransactions在TransactionEssentials的基础上额外提供了以下功能(重要的): 支持TCC:这是一种柔性事务 支持通过RMI、IIOP、SOAP这些远程过程调用技术,进行事务传播。 事务日志云存储,云端对事务进行恢复,并且提供了完善的管理后台。 org.apache.shardingsphere.transaction.xa.XAShardingTransactionManager详解 我们简单的来回顾下org.apache.shardingsphere.transaction.spi.ShardingTransactionManager public interface ShardingTransactionManager extends AutoCloseable { /** * Initialize sharding transaction manager. * * @param databaseType database type * @param resourceDataSources resource data sources */ void init(DatabaseType databaseType, Collection<ResourceDataSource> resourceDataSources); /** * Get transaction type. * * @return transaction type */ TransactionType getTransactionType(); /** * Judge is in transaction or not. * * @return in transaction or not */ boolean isInTransaction(); /** * Get transactional connection. * * @param dataSourceName data source name * @return connection * @throws SQLException SQL exception */ Connection getConnection(String dataSourceName) throws SQLException; /** * Begin transaction. */ void begin(); /** * Commit transaction. */ void commit(); /** * Rollback transaction. */ void rollback(); } 我们重点县关注init方法,从它的命名,你就应该能够看出来,这是整个框架的初始化方法,让我们来看看它是如何进行初始化的。 private final Map<String, XATransactionDataSource> cachedDataSources = new HashMap<>(); private final XATransactionManager xaTransactionManager = XATransactionManagerLoader.getInstance().getTransactionManager(); @Override public void init(final DatabaseType databaseType, final Collection<ResourceDataSource> resourceDataSources) { for (ResourceDataSource each : resourceDataSources) { cachedDataSources.put(each.getOriginalName(), new XATransactionDataSource(databaseType, each.getUniqueResourceName(), each.getDataSource(), xaTransactionManager)); } xaTransactionManager.init(); } 首先SPI的方式加载XATransactionManager的具体实现类,这里返回的就是org.apache.shardingsphere.transaction.xa.atomikos.manager.AtomikosTransactionManager。 我们在关注下 new XATransactionDataSource() , 进入 org.apache.shardingsphere.transaction.xa.jta.datasource。XATransactionDataSource类的构造方法。 public XATransactionDataSource(final DatabaseType databaseType, final String resourceName, final DataSource dataSource, final XATransactionManager xaTransactionManager) { this.databaseType = databaseType; this.resourceName = resourceName; this.dataSource = dataSource; if (!CONTAINER_DATASOURCE_NAMES.contains(dataSource.getClass().getSimpleName())) { // 重点关注 1 ,返回了xaDatasource xaDataSource = XADataSourceFactory.build(databaseType, dataSource); this.xaTransactionManager = xaTransactionManager; // 重点关注2 注册资源 xaTransactionManager.registerRecoveryResource(resourceName, xaDataSource); } } 我们重点来关注 XADataSourceFactory.build(databaseType, dataSource),从名字我们就可以看出,这应该是返回JTA规范里面的XADataSource,在ShardingSphere里面很多的功能,可以从代码风格的命名上就能猜出来,这就是优雅代码(吹一波)。不多逼逼,我们进入该方法。 public final class XADataSourceFactory { public static XADataSource build(final DatabaseType databaseType, final DataSource dataSource) { return new DataSourceSwapper(XADataSourceDefinitionFactory.getXADataSourceDefinition(databaseType)).swap(dataSource); } } 首先又是一个SPI定义的 XADataSourceDefinitionFactory,它根据不同的数据库类型,来加载不同的方言。然后我们进入 swap方法。 public XADataSource swap(final DataSource dataSource) { XADataSource result = createXADataSource(); setProperties(result, getDatabaseAccessConfiguration(dataSource)); return result; } 很简明,第一步创建,XADataSource,第二步给它设置属性(包含数据的连接,用户名密码等),然后返回。 返回 XATransactionDataSource 类,关注 xaTransactionManager.registerRecoveryResource(resourceName, xaDataSource); 从名字可以看出,这是注册事务恢复资源。这个我们在事务恢复的时候详解。 返回 XAShardingTransactionManager.init() ,我们重点来关注: xaTransactionManager.init();,最后进入AtomikosTransactionManager.init()。流程图如下: 代码: public final class AtomikosTransactionManager implements XATransactionManager { private final UserTransactionManager transactionManager = new UserTransactionManager(); private final UserTransactionService userTransactionService = new UserTransactionServiceImp(); @Override public void init() { userTransactionService.init(); } } 进入UserTransactionServiceImp.init() private void initialize() { //添加恢复资源 不用关心 for (RecoverableResource resource : resources_) { Configuration.addResource ( resource ); } for (LogAdministrator logAdministrator : logAdministrators_) { Configuration.addLogAdministrator ( logAdministrator ); } //注册插件 不用关心 for (TransactionServicePlugin nxt : tsListeners_) { Configuration.registerTransactionServicePlugin ( nxt ); } //获取配置属性 重点关心 ConfigProperties configProps = Configuration.getConfigProperties(); configProps.applyUserSpecificProperties(properties_); //进行初始化 Configuration.init(); } 我们重点关注,获取配置属性。最后进入com.atomikos.icatch.provider.imp.AssemblerImp.initializeProperties()方法。 @Override public ConfigProperties initializeProperties() { //读取classpath下的默认配置transactions-defaults.properties Properties defaults = new Properties(); loadPropertiesFromClasspath(defaults, DEFAULT_PROPERTIES_FILE_NAME); //读取classpath下,transactions.properties配置,覆盖transactions-defaults.properties中相同key的值 Properties transactionsProperties = new Properties(defaults); loadPropertiesFromClasspath(transactionsProperties, TRANSACTIONS_PROPERTIES_FILE_NAME); //读取classpath下,jta.properties,覆盖transactions-defaults.properties、transactions.properties中相同key的值 Properties jtaProperties = new Properties(transactionsProperties); loadPropertiesFromClasspath(jtaProperties, JTA_PROPERTIES_FILE_NAME); //读取通过java -Dcom.atomikos.icatch.file方式指定的自定义配置文件路径,覆盖之前的同名配置 Properties customProperties = new Properties(jtaProperties); loadPropertiesFromCustomFilePath(customProperties); //最终构造一个ConfigProperties对象,来表示实际要使用的配置 Properties finalProperties = new Properties(customProperties); return new ConfigProperties(finalProperties); } 接下来重点关注, Configuration.init(), 进行初始化。 ublic static synchronized boolean init() { boolean startupInitiated = false; if (service_ == null) { startupInitiated = true; //SPI方式加载插件注册,无需过多关心 addAllTransactionServicePluginServicesFromClasspath(); ConfigProperties configProperties = getConfigProperties(); //调用插件的beforeInit方法进行初始化话,无需过多关心 notifyBeforeInit(configProperties); //进行事务日志恢复的初始化,很重要,接下来详解 assembleSystemComponents(configProperties); //进入系统注解的初始化,一般重要 initializeSystemComponents(configProperties); notifyAfterInit(); if (configProperties.getForceShutdownOnVmExit()) { addShutdownHook(new ForceShutdownHook()); } } return startupInitiated; } 我们先来关注 assembleSystemComponents(configProperties); 进入它,进入com.atomikos.icatch.provider.imp.AssemblerImp.assembleTransactionService()方法: @Override public TransactionServiceProvider assembleTransactionService( ConfigProperties configProperties) { RecoveryLog recoveryLog =null; //打印日志 logProperties(configProperties.getCompletedProperties()); //生成唯一名字 String tmUniqueName = configProperties.getTmUniqueName(); long maxTimeout = configProperties.getMaxTimeout(); int maxActives = configProperties.getMaxActives(); boolean threaded2pc = configProperties.getThreaded2pc(); //SPI方式加载OltpLog ,这是最重要的扩展地方,如果用户没有SPI的方式去扩展那么就为null OltpLog oltpLog = createOltpLogFromClasspath(); if (oltpLog == null) { LOGGER.logInfo("Using default (local) logging and recovery..."); //创建事务日志存储资源 Repository repository = createRepository(configProperties); oltpLog = createOltpLog(repository); //??? Assemble recoveryLog recoveryLog = createRecoveryLog(repository); } StateRecoveryManagerImp recoveryManager = new StateRecoveryManagerImp(); recoveryManager.setOltpLog(oltpLog); //生成唯一id生成器,以后生成XID会用的到 UniqueIdMgr idMgr = new UniqueIdMgr ( tmUniqueName ); int overflow = idMgr.getMaxIdLengthInBytes() - MAX_TID_LENGTH; if ( overflow > 0 ) { // see case 73086 String msg = "Value too long : " + tmUniqueName; LOGGER.logFatal ( msg ); throw new SysException(msg); } return new TransactionServiceImp(tmUniqueName, recoveryManager, idMgr, maxTimeout, maxActives, !threaded2pc, recoveryLog); } 我们重点来分析createOltpLogFromClasspath(), 采用SPI的加载方式来获取,默认这里会返回 null, 什么意思呢? 就是当没有扩展的时候,atomikos,会创建框架自定义的资源,来存储事务日志。 private OltpLog createOltpLogFromClasspath() { OltpLog ret = null; ServiceLoader<OltpLogFactory> loader = ServiceLoader.load(OltpLogFactory.class,Configuration.class.getClassLoader()); int i = 0; for (OltpLogFactory l : loader ) { ret = l.createOltpLog(); i++; } if (i > 1) { String msg = "More than one OltpLogFactory found in classpath - error in configuration!"; LOGGER.logFatal(msg); throw new SysException(msg); } return ret; } 我们跟着进入 Repository repository = createRepository(configProperties); private CachedRepository createCoordinatorLogEntryRepository( ConfigProperties configProperties) throws LogException { //创建内存资源存储 InMemoryRepository inMemoryCoordinatorLogEntryRepository = new InMemoryRepository(); //进行初始化 inMemoryCoordinatorLogEntryRepository.init(); //创建使用文件存储资源作为backup FileSystemRepository backupCoordinatorLogEntryRepository = new FileSystemRepository(); //进行初始化 backupCoordinatorLogEntryRepository.init(); //内存与file资源进行合并 CachedRepository repository = new CachedRepository(inMemoryCoordinatorLogEntryRepository, backupCoordinatorLogEntryRepository); repository.init(); return repository; } 这里就会创建出 CachedRepository,里面包含了 InMemoryRepository 与 FileSystemRepository 回到主线 com.atomikos.icatch.config.Configuration.init(), 最后来分析下notifyAfterInit(); private static void notifyAfterInit() { //进行插件的初始化 for (TransactionServicePlugin p : tsListenersList_) { p.afterInit(); } for (LogAdministrator a : logAdministrators_) { a.registerLogControl(service_.getLogControl()); } //设置事务恢复服务,进行事务的恢复 for (RecoverableResource r : resourceList_ ) { r.setRecoveryService(recoveryService_); } } 插件的初始化会进入com.atomikos.icatch.jta.JtaTransactionServicePlugin.afterInit() public void afterInit() { TransactionManagerImp.installTransactionManager(Configuration.getCompositeTransactionManager(), autoRegisterResources); //如果我们自定义扩展了 OltpLog ,这里就会返回null,如果是null,那么XaResourceRecoveryManager就是null RecoveryLog recoveryLog = Configuration.getRecoveryLog(); long maxTimeout = Configuration.getConfigProperties().getMaxTimeout(); if (recoveryLog != null) { XaResourceRecoveryManager.installXaResourceRecoveryManager(new DefaultXaRecoveryLog(recoveryLog, maxTimeout),Configuration.getConfigProperties().getTmUniqueName()); } } 重点注意 RecoveryLog recoveryLog = Configuration.getRecoveryLog(); ,如果用户采用SPI的方式,扩展了com.atomikos.recovery.OltpLog ,这里就会返回 null。 如果是null,则不会对 XaResourceRecoveryManager 进行初始化。 回到 notifyAfterInit(), 我们来分析 setRecoveryService。 public void setRecoveryService ( RecoveryService recoveryService ) throws ResourceException { if ( recoveryService != null ) { if ( LOGGER.isTraceEnabled() ) LOGGER.logTrace ( "Installing recovery service on resource " + getName () ); this.branchIdentifier=recoveryService.getName(); recover(); } } 我们进入 recover() 方法: public void recover() { XaResourceRecoveryManager xaResourceRecoveryManager = XaResourceRecoveryManager.getInstance(); //null for LogCloud recovery if (xaResourceRecoveryManager != null) { try { xaResourceRecoveryManager.recover(getXAResource()); } catch (Exception e) { refreshXAResource(); //cf case 156968 } } } 看到最关键的注释了吗,如果用户采用SPI的方式,扩展了com.atomikos.recovery.OltpLog,那么XaResourceRecoveryManager 为null,则就会进行云端恢复,反之则进行事务恢复。 事务恢复很复杂,我们会单独来讲。 到这里atomikos的基本的初始化已经完成。 atomikos事务begin流程 我们知道,本地的事务,都会有一个 trainsaction.begin, 对应XA分布式事务来说也不另外,我们再把思路切换回XAShardingTransactionManager.begin(), 会调用com.atomikos.icatch.jta.TransactionManagerImp.begin()。流程图如下: 代码: public void begin ( int timeout ) throws NotSupportedException, SystemException { CompositeTransaction ct = null; ResumePreviousTransactionSubTxAwareParticipant resumeParticipant = null; ct = compositeTransactionManager.getCompositeTransaction(); if ( ct != null && ct.getProperty ( JTA_PROPERTY_NAME ) == null ) { LOGGER.logWarning ( "JTA: temporarily suspending incompatible transaction: " + ct.getTid() + " (will be resumed after JTA transaction ends)" ); ct = compositeTransactionManager.suspend(); resumeParticipant = new ResumePreviousTransactionSubTxAwareParticipant ( ct ); } try { //创建事务补偿点 ct = compositeTransactionManager.createCompositeTransaction ( ( ( long ) timeout ) * 1000 ); if ( resumeParticipant != null ) ct.addSubTxAwareParticipant ( resumeParticipant ); if ( ct.isRoot () && getDefaultSerial () ) ct.setSerial (); ct.setProperty ( JTA_PROPERTY_NAME , "true" ); } catch ( SysException se ) { String msg = "Error in begin()"; LOGGER.logError( msg , se ); throw new ExtendedSystemException ( msg , se ); } recreateCompositeTransactionAsJtaTransaction(ct); } 这里我们主要关注 compositeTransactionManager.createCompositeTransaction(), public CompositeTransaction createCompositeTransaction ( long timeout ) throws SysException { CompositeTransaction ct = null , ret = null; ct = getCurrentTx (); if ( ct == null ) { ret = getTransactionService().createCompositeTransaction ( timeout ); if(LOGGER.isDebugEnabled()){ LOGGER.logDebug("createCompositeTransaction ( " + timeout + " ): " + "created new ROOT transaction with id " + ret.getTid ()); } } else { if(LOGGER.isDebugEnabled()) LOGGER.logDebug("createCompositeTransaction ( " + timeout + " )"); ret = ct.createSubTransaction (); } Thread thread = Thread.currentThread (); setThreadMappings ( ret, thread ); return ret; } 创建了事务补偿点,然后把他放到了用当前线程作为key的Map当中,这里思考,为啥它不用 threadLocal。 到这里atomikos的事务begin流程已经完成。 大家可能有些疑惑,begin好像什么都没有做,XA start 也没调用? 别慌,下一节继续来讲。 XATransactionDataSource getConnection() 流程 我们都知道想要执行SQL语句,必须要获取到数据库的connection。让我们再回到 XAShardingTransactionManager.getConnection() 最后会调用到org.apache.shardingsphere.transaction.xa.jta.datasourceXATransactionDataSource.getConnection()。流程图如下: 代码 : public Connection getConnection() throws SQLException, SystemException, RollbackException { //先检查是否已经有存在的connection,这一步很关心,也是XA的关键,因为XA事务,必须在同一个connection if (CONTAINER_DATASOURCE_NAMES.contains(dataSource.getClass().getSimpleName())) { return dataSource.getConnection(); } //获取数据库连接 Connection result = dataSource.getConnection(); //转成XAConnection,其实是同一个连接 XAConnection xaConnection = XAConnectionFactory.createXAConnection(databaseType, xaDataSource, result); //获取JTA事务定义接口 Transaction transaction = xaTransactionManager.getTransactionManager().getTransaction(); if (!enlistedTransactions.get().contains(transaction)) { //进行资源注册 transaction.enlistResource(new SingleXAResource(resourceName, xaConnection.getXAResource())); transaction.registerSynchronization(new Synchronization() { @Override public void beforeCompletion() { enlistedTransactions.get().remove(transaction); } @Override public void afterCompletion(final int status) { enlistedTransactions.get().clear(); } }); enlistedTransactions.get().add(transaction); } return result; } 首先第一步很关心,尤其是对shardingsphere来说,因为在一个事务里面,会有多个SQL语句,打到相同的数据库,所以对相同的数据库,必须获取同一个XAConnection,这样才能进行XA事务的提交与回滚。 我们接下来关心 transaction.enlistResource(new SingleXAResource(resourceName, xaConnection.getXAResource()));, 会进入com.atomikos.icatch.jta.TransactionImp.enlistResource(), 代码太长,截取一部分。 try { restx = (XAResourceTransaction) res .getResourceTransaction(this.compositeTransaction); // next, we MUST set the xa resource again, // because ONLY the instance we got as argument // is available for use now ! // older instances (set in restx from previous sibling) // have connections that may be in reuse already // ->old xares not valid except for 2pc operations restx.setXAResource(xares); restx.resume(); } catch (ResourceException re) { throw new ExtendedSystemException( "Unexpected error during enlist", re); } catch (RuntimeException e) { throw e; } addXAResourceTransaction(restx, xares); 我们直接看 restx.resume(); public synchronized void resume() throws ResourceException { int flag = 0; String logFlag = ""; if (this.state.equals(TxState.LOCALLY_DONE)) {// reused instance flag = XAResource.TMJOIN; logFlag = "XAResource.TMJOIN"; } else if (!this.knownInResource) {// new instance flag = XAResource.TMNOFLAGS; logFlag = "XAResource.TMNOFLAGS"; } else throw new IllegalStateException("Wrong state for resume: " + this.state); try { if (LOGGER.isDebugEnabled()) { LOGGER.logDebug("XAResource.start ( " + this.xidToHexString + " , " + logFlag + " ) on resource " + this.resourcename + " represented by XAResource instance " + this.xaresource); } this.xaresource.start(this.xid, flag); } catch (XAException xaerr) { String msg = interpretErrorCode(this.resourcename, "resume", this.xid, xaerr.errorCode); LOGGER.logWarning(msg, xaerr); throw new ResourceException(msg, xaerr); } setState(TxState.ACTIVE); this.knownInResource = true; } 哦多尅,看见了吗,各位,看见了 this.xaresource.start(this.xid, flag); 了吗????,我们进去,假设我们使用的Mysql数据库: public void start(Xid xid, int flags) throws XAException { StringBuilder commandBuf = new StringBuilder(300); commandBuf.append("XA START "); appendXid(commandBuf, xid); switch(flags) { case 0: break; case 2097152: commandBuf.append(" JOIN"); break; case 134217728: commandBuf.append(" RESUME"); break; default: throw new XAException(-5); } this.dispatchCommand(commandBuf.toString()); this.underlyingConnection.setInGlobalTx(true); } 组装XA start Xid SQL语句,进行执行。 到这里,我们总结下,在获取数据库连接的时候,我们执行了XA协议接口中的 XA start xid atomikos事务commit流程 好了,上面我们已经开启了事务,现在我们来分析下事务commit流程,我们再把视角切换回XAShardingTransactionManager.commit(),最后我们会进入com.atomikos.icatch.imp.CompositeTransactionImp.commit() 方法。流程图如下: 代码: public void commit () throws HeurRollbackException, HeurMixedException, HeurHazardException, SysException, SecurityException, RollbackException { //首先更新下事务日志的状态 doCommit (); setSiblingInfoForIncoming1pcRequestFromRemoteClient(); if ( isRoot () ) { //真正的commit操作 coordinator.terminate ( true ); } } 我们关注 coordinator.terminate ( true ); protected void terminate ( boolean commit ) throws HeurRollbackException, HeurMixedException, SysException, java.lang.SecurityException, HeurCommitException, HeurHazardException, RollbackException, IllegalStateException { synchronized ( fsm_ ) { if ( commit ) { //判断有几个参与者,如果只有一个,直接提交 if ( participants_.size () <= 1 ) { commit ( true ); } else { //否则,走XA 2阶段提交流程,先prepare, 再提交 int prepareResult = prepare (); // make sure to only do commit if NOT read only if ( prepareResult != Participant.READ_ONLY ) commit ( false ); } } else { rollback (); } } } 首先会判断参与者的个数,这里我们可以理解为MySQL的database数量,如果只有一个,退化成一阶段,直接提交。 如果有多个,则走标准的XA二阶段提交流程。 我们来看 prepare (); 流程,最后会走到com.atomikos.icatch.imp.PrepareMessage.send() ---> com.atomikos.datasource.xa.XAResourceTransaction.prepare() int ret = 0; terminateInResource(); if (TxState.ACTIVE == this.state) { // tolerate non-delisting apps/servers suspend(); } // duplicate prepares can happen for siblings in serial subtxs!!! // in that case, the second prepare just returns READONLY if (this.state == TxState.IN_DOUBT) return Participant.READ_ONLY; else if (!(this.state == TxState.LOCALLY_DONE)) throw new SysException("Wrong state for prepare: " + this.state); try { // refresh xaresource for MQSeries: seems to close XAResource after // suspend??? testOrRefreshXAResourceFor2PC(); if (LOGGER.isTraceEnabled()) { LOGGER.logTrace("About to call prepare on XAResource instance: " + this.xaresource); } ret = this.xaresource.prepare(this.xid); } catch (XAException xaerr) { String msg = interpretErrorCode(this.resourcename, "prepare", this.xid, xaerr.errorCode); if (XAException.XA_RBBASE <= xaerr.errorCode && xaerr.errorCode <= XAException.XA_RBEND) { LOGGER.logWarning(msg, xaerr); // see case 84253 throw new RollbackException(msg); } else { LOGGER.logError(msg, xaerr); throw new SysException(msg, xaerr); } } setState(TxState.IN_DOUBT); if (ret == XAResource.XA_RDONLY) { if (LOGGER.isDebugEnabled()) { LOGGER.logDebug("XAResource.prepare ( " + this.xidToHexString + " ) returning XAResource.XA_RDONLY " + "on resource " + this.resourcename + " represented by XAResource instance " + this.xaresource); } return Participant.READ_ONLY; } else { if (LOGGER.isDebugEnabled()) { LOGGER.logDebug("XAResource.prepare ( " + this.xidToHexString + " ) returning OK " + "on resource " + this.resourcename + " represented by XAResource instance " + this.xaresource); } return Participant.READ_ONLY + 1; } 终于,我们看到了这么一句 ret = this.xaresource.prepare(this.xid); 但是等等,我们之前不是说了,XA start xid 以后要先 XA end xid 吗? 答案就在 suspend(); 里面。 public synchronized void suspend() throws ResourceException { // BugzID: 20545 // State may be IN_DOUBT or TERMINATED when a connection is closed AFTER // commit! // In that case, don't call END again, and also don't generate any // error! // This is required for some hibernate connection release strategies. if (this.state.equals(TxState.ACTIVE)) { try { if (LOGGER.isDebugEnabled()) { LOGGER.logDebug("XAResource.end ( " + this.xidToHexString + " , XAResource.TMSUCCESS ) on resource " + this.resourcename + " represented by XAResource instance " + this.xaresource); } //执行了 xa end 语句 this.xaresource.end(this.xid, XAResource.TMSUCCESS); } catch (XAException xaerr) { String msg = interpretErrorCode(this.resourcename, "end", this.xid, xaerr.errorCode); if (LOGGER.isTraceEnabled()) LOGGER.logTrace(msg, xaerr); // don't throw: fix for case 102827 } setState(TxState.LOCALLY_DONE); } } 到了这里,我们已经执行了 XA start xid -> XA end xid --> XA prepare xid, 接下来就是最后一步 commit 我们再回到 terminate(false) 方法,来看 commit()流程。其实和 prepare流程一样,最后会走到 com.atomikos.datasource.xa.XAResourceTransaction.commit()。 commit执行完,数据提交 //繁杂代码过多,就显示核心的 this.xaresource.commit(this.xid, onePhase); 思考:这里的参与者提交是在一个循环里面,一个一个提交的,如果之前的提交了,后面的参与者提交的时候,挂了,就会造成数据的不一致性。 Atomikos rollback() 流程 上面我们已经分析了commit流程,其实rollback流程和commit流程一样,我们在把目光切换回 org.apache.shardingsphere.transaction.xa.XAShardingTransactionManager.rollback() ,最后会执行到com.atomikos.icatch.imp.CompositeTransactionImp.rollback()。 public void rollback () throws IllegalStateException, SysException { //清空资源,更新事务日志状态等 doRollback (); if ( isRoot () ) { try { coordinator.terminate ( false ); } catch ( Exception e ) { throw new SysException ( "Unexpected error in rollback: " + e.getMessage (), e ); } } } 重点关注 coordinator.terminate ( false ); ,这个和 commit流程是一样的,只不过在 commit流程里面,参数传的是true。 protected void terminate ( boolean commit ) throws HeurRollbackException, HeurMixedException, SysException, java.lang.SecurityException, HeurCommitException, HeurHazardException, RollbackException, IllegalStateException { synchronized ( fsm_ ) { if ( commit ) { if ( participants_.size () <= 1 ) { commit ( true ); } else { int prepareResult = prepare (); // make sure to only do commit if NOT read only if ( prepareResult != Participant.READ_ONLY ) commit ( false ); } } else { //如果是false,走的是rollback rollback (); } } } 我们重点关注 rollback() ,最后会走到com.atomikos.datasource.xa.XAResourceTransaction.rollback()。 public synchronized void rollback() throws HeurCommitException, HeurMixedException, HeurHazardException, SysException { terminateInResource(); if (rollbackShouldDoNothing()) { return; } if (this.state.equals(TxState.TERMINATED)) { return; } if (this.state.equals(TxState.HEUR_MIXED)) throw new HeurMixedException(); if (this.state.equals(TxState.HEUR_COMMITTED)) throw new HeurCommitException(); if (this.xaresource == null) { throw new HeurHazardException("XAResourceTransaction " + getXid() + ": no XAResource to rollback?"); } try { if (this.state.equals(TxState.ACTIVE)) { // first suspend xid suspend(); } // refresh xaresource for MQSeries: seems to close XAResource after // suspend??? testOrRefreshXAResourceFor2PC(); if (LOGGER.isDebugEnabled()) { LOGGER.logDebug("XAResource.rollback ( " + this.xidToHexString + " ) " + "on resource " + this.resourcename + " represented by XAResource instance " + this.xaresource); } this.xaresource.rollback(this.xid); 先在supend()方法里面执行了 XA end xid 语句, 接下来执行 this.xaresource.rollback(this.xid); 进行数据的回滚。 文章到此,已经写的很长很多了,我们分析了ShardingSphere对于XA方案,提供了一套SPI解决方案,对Atomikos进行了整合,也分析了Atomikos初始化流程,开始事务流程,获取连接流程,提交事务流程,回滚事务流程。希望对大家理解XA的原理有所帮助。 作者介绍: 肖宇,Apache ShardingSphere Committer,开源hmily分布式事务框架作者, 开源soul网关作者,热爱开源,追求写优雅代码。目前就职入京东数科,参与ShardingSphere的开源建设,以及分布式数据库的研发工作。

优秀的个人博客,低调大师

ThinkPHP框架执行流程源码解析

本文主要介绍框架的执行流程 前言 如果不清楚框架是怎么执行的,那么看在多的代码都是只是认识代码而已,阅读源码是为了学习其框架的设计思想和代码模式。 而执行流程则是将我们学习的东西串联在一起,从而更好地理解。咔咔也会给大家把执行流程用思维导图的方式画出来。 只要大家在本文学习到一点点的知识点,咔咔也是心满意足的。 这个流程图只是针对initialize的执行过程,其余的执行过程后期会进行补充,都是以脑图的形式呈现给大家的。 一、框架执行流程之初始化应用的数据设置 这里的内容跟容器的内容有点重复,因为执行流程是从入口文件开始的,并且最后也是通过容器执行的。 然后就会进入到文件thinkphp/library/think/App.php的run方法,在这个方法中主要就是下图框出来的地方,执行的initialize方法。 来到initialize这个方法,先看上半部分。 microtime(true);返回的是unix的微秒数 memory_get_usage返回的是分配给PHP的内存量,单位为字节 在接下来就是对框架的几个路径进行设置 static::setInstance($this);这里是将app这个实例设置为容器实例 $this->instance('app', $this);这个在之前容器章节就提到了,就是为了把app这个类绑定到容器里边去,也就是注册树模式。 这里有一个小的问题点给大家提出来,在初始化应用的这个方法里边存在这样一行代码。 有没有小伙伴对这个$this->env和下边的$this->config这俩个调用有疑惑。 如果你有疑惑那就跟着咔咔一起来看,没疑惑的就可以继续往下看了。 App这个类是继承的容器类,那么这个env和config不论是在app还是container类中都是没有这俩个属性的。 那么怎么就可以直接调用呢!而且代码追踪都会追踪到env类和container类中。 需要知道这个源头就需要我们去在大致的看一遍container类的代码。 经过一番苦读之后,可以看到下图的几行代码。这几行代码全部使用的是魔术方法。 当访问env类不存在的时候就会去执行make方法。 make这个方法在容器那一章节进行的细的不能再细的解读了。 这个make方法最终会返回一个类的实例,并且还会存到容器里边。 这里只放一个make方法的代码,如果有不会的可以去看之前的文章。 最后就是加载一系列的数据,加载详情请看前言的思维导图。 二、如何查看一个方法都在哪里执行了 在阅读源码的过程中,有一个很难把控的问题就是一个方法在不同的地方进行了调用,但是咱们确一时半会根本不知道都在哪里调用了。 这里用init方法来做一个演示。 init方法是初始化应用或者模块的一个方法,但是这里的module参数确实一个空值。 先做一个断点查看一下相关的数据信息。 打印的结果就是空,这就是一些新学习的伙伴会犯的一个错误,因为这个方法不可能只调用一次的。 如果初始化模块都是空那么这个方法就没有存在的必要了。 那么正确的断点方式应该是这个样子的。 此时就会有一个问题,这个init方法明显是被调用了俩次的,那么另一次调用的地方是在哪里呢! 如果在不知道新的技巧之前,就会进行一系列的断点打印,看在哪里进行了执行,比如在这个init的上层去打印。 也就是在initialize那个方法里边去打印做断点,但是这样很是麻烦的,而且很有可能浪费了大量的时间还是找不到正确的地方。 小技巧之debug_backtrace() 这个方法会产生一条回溯追踪,会显示出一个方法所有的调用位置。 使用方式就是如下图,只需要把debug_backtrace这个方法打印出来即可。 根据得到的数据信息,就可以非常快的进行定位。 第一次就是在app类的215行。 第二次是在thinkphp/library/think/route/dispatch/Module.php类的60行 可以在这里做一个打印,看一下这个module是否为index 所以说有了这个方法就可以非常快速地定位调用位置。 三、框架执行流程之初始化应用init分析 上文给大家提供了一个小技巧debug_backtrace实战演示了如何查看一个方法都在哪里执行的。 并且案例也是使用的init这个方法来演示的,因为接下来就是要对init这个方法进行深入的了解。 在init方法里边主要做的事情在上边的脑图已经描述的很清楚了。 从一开始就对模块的定位,就是在第二节中的对init方法的调用,会传入对应的模块 加载app目录下的tags文件,在tags文件里边就是对行为扩展定义的文件。在之前门面的文章中定义钩子执行就在这个文件中设置的。 加载common文件,也就是公共文件,所以说公共文件就是在这里进行加载的。 加载助手函数文件helper,在助手函数里边有一个大家特别熟悉的一个方法,那就是dump。这就是为什么在有的地方使用dump会报错的原因。 加载中间件文件,这里的直接给出的是直接加载app目录下的中间件文件,但是在框架中我们需要在定义一个目录为http,在这个目录下定义中间件文件。 注册服务的容器对象实例,这里注册就使用的是容器类中的bindTo方法进行绑定注册的。 读取配置文件,这段在配置文件加载那一节中已经进行深入的说明了, 这里就不提了。配置文件会读取俩个地方一个是第一步模块下的config文件,另一个就是config目录下的配置文件。 设置模块路径,会把第一步获取到的模块进行env环境变量配置里边 最后一步就是对容器中的对象实例进行配置更新,具体更新了什么在后文中给大家详细说来。 /** * 初始化应用或模块 * @access public * @param string $module 模块名 * @return void */ public function init($module = '') { // 定位模块目录 $module = $module ? $module . DIRECTORY_SEPARATOR : ''; /** * 第一次:D:\phpstudy_pro\WWW\ThinkPHPSourceCodeAnalysis\application\ * 第二次:D:\phpstudy_pro\WWW\ThinkPHPSourceCodeAnalysis\application\index\ */ $path = $this->appPath . $module; // 加载初始化文件 if (is_file($path . 'init.php')) { include $path . 'init.php'; } elseif (is_file($this->runtimePath . $module . 'init.php')) { include $this->runtimePath . $module . 'init.php'; } else { // 加载行为扩展文件 if (is_file($path . 'tags.php')) { $tags = include $path . 'tags.php'; if (is_array($tags)) { $this->hook->import($tags); } } // 加载公共文件 if (is_file($path . 'common.php')) { include_once $path . 'common.php'; } if ('' == $module) { // 加载系统助手函数 include $this->thinkPath . 'helper.php'; } // 加载中间件 if (is_file($path . 'middleware.php')) { $middleware = include $path . 'middleware.php'; if (is_array($middleware)) { $this->middleware->import($middleware); } } // 注册服务的容器对象实例 if (is_file($path . 'provider.php')) { $provider = include $path . 'provider.php'; if (is_array($provider)) { $this->bindTo($provider); } } /** * $path : "D:\phpstudy_pro\WWW\ThinkPHPSourceCodeAnalysis\application\" * "D:\phpstudy_pro\WWW\ThinkPHPSourceCodeAnalysis\application\index\" */ // 自动读取配置文件 if (is_dir($path . 'config')) { $dir = $path . 'config' . DIRECTORY_SEPARATOR; } elseif (is_dir($this->configPath . $module)) { // D:\phpstudy_pro\WWW\ThinkPHPSourceCodeAnalysis\config\ $dir = $this->configPath . $module; } // scandir:以升序的方式读取目录中的文件 // 返回就是config目录中的所有文件 $files = isset($dir) ? scandir($dir) : []; foreach ($files as $file) { /** * $this->configExt:配置文件的后缀 * pathinfo返回的是文件后缀,关于pathinfo共有三个可选的参数PATHINFO_DIRNAME、PATHINFO_BASENAME、PATHINFO_EXTENSION,分别为只返回文件名,文件目录名,文件扩展 */ if ('.' . pathinfo($file, PATHINFO_EXTENSION) === $this->configExt) { /** * 俩个参数分别为 * 1.目录+config目录下的文件 * 2.config目录下文件名 */ $this->config->load($dir . $file, pathinfo($file, PATHINFO_FILENAME)); } } } $this->setModulePath($path); if ($module) { // 对容器中的对象实例进行配置更新 $this->containerConfigUpdate($module); } } 这里附带上一份代码,可以对着代码看上边的执行流程,对每一步都做了简单的说明。 咔咔个人见解对源码进行优化 在设置模块的这步代码咔咔感觉不是很是严谨,因为init方法会在俩个地方进行执行。 第一次的模块为空,这块代码执行是没有任何意义的。 下面在对容器的对象实例进行配置更新时进行了一次判断,判断模块的这个参数是否为空,如果不为空才会执行。 那么同样的道理,咔咔感觉在设置模块路径这块也应该在这个判断里边。 虽说第二次执行会把第一次的结果覆盖掉,但是咔咔感觉下图这样使用才会更好。 四、对容器中的对象实例进行更新配置 在上一节中这里就是最后的内容,那这个对实例进行更新配置,到底更新了什么,怎么更新没有说明。 在这一小节中就会做出说明,同样可以配合着前言的思维导图看。 先会把config目录下的所有配置信息全部获取出来 从app配置文件中将注册异常处理类 第三大块是把第一步获取出来的所有配置信息给对应的类进行注册配置。 第四步就是在把模块确定下来之后加载对应的语言包,语言包功能就可以实现多语言功能,之前咔咔写过一篇文章实现多语言功能,如果感兴趣的可以去查看。 最后一步就是根据app配置文件中的三个属性进行缓存的处理 在这一节中咔咔感觉最重要的就是下图的内容了。 我们可以随意追踪一到俩个方法查看一下那边到底执行了什么方法。 追踪方法Db::init() 追踪方法过来后可以看到就是对Db类中的config属性进行赋值,把database中的值赋值给Db类中的config属性。 追踪方法$this->middleware->setConfig() 来到中间件这个类里边,可以看到就是把本类的配置和传递过来的参数类进行合并,同样也是进行config属性的赋值。 跟上边案例的Db类的init方法实现的效果是一致的。 这里在提一嘴就是在对容器中的对象实例进行更新配置这一幅图中可以看到紫色部分是在本类中没有引用的。 那么这是怎么可以进行执行的呢!是因为App类继承了容器类,容器类中有四个魔术方法,其中有一个__get方法,就是在获取不存在的属性时会执行那个方法。 在魔术方法__get方法中执行了一个make方法,这个make方法说了好多次了,这个方法最终会返回一个应用的实例,然后用这个实例调用对应实例类的方法。 这一块一定要理解好,阅读源码就是这个样子,我们需要对一切未知的进行的解决,只有这样才能提高我们的编程能力和思想。 五、浅谈调试模式以及代码冗余 本节会对调试模式做出简单的说明,并且会对框架代码冗余情况进行简单的提出。 没有人写的代码是没有漏洞的,如果有那就是你还没有达到一定的造诣。 调试模式 在第一节中只提到了initialize方法的上半部分,因为在这一节之前聊的都是关于应用初始化init的内容。 接下来会对这一块的内容进行简单的说明。 从app配置文件中获取到app_debug的配置项 给环境变量设置debug级别 当框架中的debug是关闭状态时会执行ini_set这个方法,这个方法是为一个配置选项进行赋值。 接下来的内容估计不是很好理解,都是平时在工作中根本使用不到的。 ob_get_level:返回输出缓冲机制的嵌套级别,那么怎么去理解呢!其实就是当缓存区不起作用时会返回0。 ob_get_clean:这个函数将会返回输出缓冲的内容并终止输出缓冲。如果缓冲区没有有效内容则返回false。本质上相当于同时执行了ob_getcontens()和ob_end_clean()。 ob_start:打开输出控制缓冲 上边这三个先暂时认识就行,后期如果有机会会专门出一篇文章做解释的。 关于框架代码冗余 这里也仅仅代表咔咔个人的观点。 可以先看看这部分的代码,这俩处代码是不是很是熟悉,没错就是在上文的init方法中容器对象实例配置更新见到过。 如图 这块也就是咔咔个人提出的见解,由于咔咔式针对5.1做的源码解读,不太了解新版版是否做出了改动。 六、总结 本节主要是针对框架执行流程中的初始化应用做了简单的探讨。 至于在app类的run方法下面还有很多的执行过程在这一节中没有做过多的解释。 在阅读源码的过程中给大家提了一个很好得小技巧,那就是如何去查看一个方法都在哪里进行了执行。 这个方法为debug_backtrace,这个方法需要大家多使用几次就知道怎么使用了,因为在打印出来的结果中也存在很多无用的信息。 这个方法在调试源码的过程中是非常有效的,一定要好好利用这个方法。 在就是对初始化应用init方法进行了特别详细的介绍。 其中咔咔感觉这块设计最好的就是在容器中的对象实例进行更新配置那一块,先读取所有的配置,然后在通过各个类的方法进行配置的设置。 这种代码规划和设计思路值得我们去学习。 最后聊到了调试模式和框架的代码冗余问题,关于调试模式这里咔咔给大家提个醒项目在线上的调试模式一定要关闭。 否则你的项目就类似于裸奔的存在,没有一点点的安全可言。 这块有点不好理解的就是对于缓冲区,关于这块的内容咔咔认为暂时没有必要去钻牛角尖,先认识认识然后在进行深入的研究。 缓冲区的这块内容估计工作了三四年的也很少有人使用,所以先认识,知道怎么一回事,咔咔后期学习了之后在给大家进行补充。 直到这里关于框架的执行流程之初始化应用就结束了,这一节没有过深需要学习的,主要是其中的代码设计模式和实现思路。 最后这个图大家一定要跟着源码看一看哈! 坚持学习、坚持写博、坚持分享是咔咔从业以来一直所秉持的信念。希望在偌大互联网中咔咔的文章能带给你一丝丝帮助。我是咔咔,下期见。

优秀的个人博客,低调大师

基于synchronized锁的深度解析

1. 问题引入 小伙伴们都接触过线程,也都会使用线程,今天我们要讲的是线程安全相关的内容,在这之前我们先来看一个简单的代码案例。 代码案例: /** * @url: i-code.online * @author: AnonyStar * @time: 2020/10/14 15:39 */ public class ThreadSafaty { //共享变量 static int count = 0; public static void main(String[] args) { //创建线程 Runnable runnable = () -> { for (int i = 0; i < 5; i++) { count ++; try { Thread.sleep(1); } catch (InterruptedException e) { e.printStackTrace(); } } }; for (int i = 0; i < 100; i++) { new Thread(runnable,"Thread-"+i).start(); } try { Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("count = "+ count); } } 执行结果: 问题说明 在上面的代码中我们可以看到,定义了一个线程 runnable 里面对公共成员变量进行 ++ 操作,并循环五次,每次睡眠一毫秒,之后我们在主线程 main 方法中创建一百个线程并且启动,然后主线程睡眠等待五秒以此来等所有的线程执行结束。我们预期结果应该是 500 。但是实际执行后我们发现 count 的值是不固定的 ,是小于 500 的,这里就是多线程并行导致的数据安全性问题! 通过上述案例我们可以清楚的看到线程安全的问题,那么我们想想是否有什么办法来避免这种安全问题尼 ?我们可以想到导致这种安全问题的原因是因为我们访问了共享数据,那么我们是否能将线程访问共享数据的过程变成串行的过程那么不就是不存在这个问题了。这里我们可以想到之前说的**锁** ,我们知道锁是处理并发的一种同步方式,同时他也具备互斥性,在Java中实现加锁是通过 synchronized 关键字 2. 锁的基本认识 2.1 Synchronized 的认识 在Java 中我们知道有一个元老级的关键字 synchronized ,它是实现加锁的关键,但是我们一直都认为它是一个重量级锁,其实早在 jdk1.6 时就对其进行了大量的优化,让它已经变成非常灵活。也不再一直是重量级锁了,而是引入了 **偏向锁 **和 **轻量级锁。 **关于这些内容我们将详细介绍。 synchronized的基础使用 synchronized 修饰实例方法,作用于当前实例加锁 synchronized 修饰静态方法,作用于当前类对象加锁, synchronized 修饰代码块,指定加锁对象,对给定对象加锁, 在上述情况中,我们要进入被 synchronized 修饰的同步代码前,必须获得相应的锁,其实这也体现出来针对不同的修饰类型,代表的是锁的控制粒度 我们修改一下前面我们写的案例,通过使用 synchronized 关键字让其实现线程安全 //创建线程 Runnable runnable = () -> { synchronized (ThreadSafaty.class){ for (int i = 0; i < 5; i++) { count ++; try { Thread.sleep(1); } catch (InterruptedException e) { e.printStackTrace(); } } } }; 只需要添加 synchronized (ThreadSafaty.class) 的修饰,将操作的内容放入代码块中,那么就会实现线程安全 通过上面的实践我们可以直观感受 synchronized 的作用,这是我们平时开发中常规使用,大家有没有过疑问,这个锁到底是怎么存储实现的?那么下面我们将对探索其中的奥秘 Java中锁的实现 我们知道锁是具有互斥性(Mutual Exclusion)的 ,那么它是在什么地方标记存在的尼? 我们也知道多个线程都可以获取锁,那么锁必然是可以共享的 我们最熟悉的 synchronized 它获取锁的过程到底是怎么样的呢?它的锁是如何存储的呢? 我们可以注意观察 synchronized 的语法,可以看到 **synchronized(lock) 是基于 lock 的生命周期来实现控制锁粒度的,**这里一定要理解,我们获得锁时都时一个对象,那么锁是不是会和这个对象有关系呢? 到这里为止,我们将所有的关键信息都指向了对象,那么我们有必要以此为切入点,来首先了解对象在 jvm 中的分布形式,再来看锁是怎么被实现的。 对象的内存布局 这里我们只谈论对象在 Heap 中的布局,而不会涉及过多的关于对象的创建过程等细节,这些内容我们再单独文章详细阐述,可以关注 i-code.online 博客或wx "云栖简码" 在我们最常用的虚拟机 hotspot 中对象在内存中的分布可以分为三个部分:对象头(Header)、实列数据(Instance Data)、对其填充(Padding) 通过上述的图示我们可以看到,对象在内存中,包含三个部分, 其中对象头内分为 对象标记与类元信息,在对象标记中主要包含如图所示 hashcode、GC分代年龄、锁标记状态、偏向锁持有线程id、线程持有的锁(monitor)等六个内容,这部分数据的长度在 32 位和64位的虚拟机中分别为32bit 和 64bit,在官方将这部分称为 Mark Word 。 Mark Word 实际是一中可以动态定义的数据结构,这样可以让极小的空间存储尽量多的数据,根据对象的状态复用自己的内存空间,比如在32位的虚拟机中,如果对象未被同步锁锁定的状态下, Mark Word 的32个比特存储单元中,25个用于存储哈希码,4个用于存储GC分代年龄,2个存锁标记位,1个固定位0,针对各个状态下的分布可以直观的参看下面的图表 32位HotSpot虚拟机对象头Mark Word 锁状态 25bit 4bit 1bit(是否是偏向锁) 2bit(锁标志位) 23bit 2bit 无锁 对象的HashCode 分代年龄 0 01 偏向锁 线程ID Epoch(偏向时间戳) 分代年龄 1 01 轻量级锁 指向栈中锁记录的指针 00 重量级锁 指向重量级锁的指针 10 GC标记 空 11 上述说的是32位虚拟机,需要注意。关于对象头的另一部分是类型指针,这里我们不展开再细说了,想了解的关注 i-code.online ,会持续更新相关内容😁😊 下面内容会涉及到源码的查看,需要提前下载源码,如果你不知道如何来下载,可以参看《下载JDK 与 Hotspot 虚拟机源码》这篇文章,或者关注 云栖简码。 在我们熟悉的虚拟机 Hotspot 中实现 Mark Word 的代码在 markOop.cpp 中,我们可以看下面片段,这是描述了虚拟机中MarkWord 的存储布局: 当我们在 new 一个对象时,虚拟机层面实际会创建一个 instanceOopDesc 对象,我们熟悉的 Hotspot 虚拟机采用了 OOP-Klass 模型来描述 Java 对象实例,其中 OOP 就是我们熟悉的普通对象指针,而 Klass 则是描述对象的具体类型,在Hotspot 中分别用 instanceOopDesc 和 arrayOopDesc 来描述,其中arrayOopDesc 用来描述数组类型, 对于 instanceOopDesc 的实现我们可以从 Hotspot 源码中找到。对应在 instanceOop.hpp 文件中,而相应的 arrayOopDesc 在 arrayOop.hpp 中,下面我们来看一下相关的内容: 我们可以看到 instanceOopDesc 继承了 oopDesc,而 oopDesc 则定义在 oop.hpp 中, 上述图示中我们可以看到相关信息,具体也注释了文字,那么接下来我们要探索一下 _mark 的实现定义了,如下,我们看到它是markOopDesc 通过代码跟进我们可以在找到 markOopDesc 的定义在 markOop.hpp 文件中,如下图所示: 在上述图片中我们可以看到,内部有一个枚举。记录了 markOop 中存储项,所以在我们实际开发时,当 synchronized 将某个对象作为锁时那么之后的一系列锁的信息都和 markOop 相关。如上面表格中 mark word的分布记录所示具体的各个部分的含义 因为我们创建对象时实际在jvm层面都会生成一个native 的c++ 对象 oop/oopdesc 来映射的,而每个对象都带有一个 monitor 的监视器对象,可以在 markOop.hpp 中看到,其实在多线程中抢夺锁就是在争夺 monitor 来修改相应的标记 Synchronized 的深入 在 Java 中 synchronized 是实现互斥同步最基本的方法,它是一个块结构(Block Structured)的同步语法,在经过javac 编译后会在块的前后分别形成 monitorrenter 和 monitorexit 两个字节码指令,而它们又都需要一个 reference 类型的参数来指明锁对象,具体锁对象取决于 synchronized 修饰的内容,上面已经说过不在阐述。 《深入理解Java虚拟机》中有这样的描述: 根据《Java虚拟机规范》的要求,在执行monitorenter指令时,首先要去尝试获取对象的锁。如果 这个对象没被锁定,或者当前线程已经持有了那个对象的锁,就把锁的计数器的值增加一,而在执行 monitorexit指令时会将锁计数器的值减一。一旦计数器的值为零,锁随即就被释放了。如果获取对象 锁失败,那当前线程就应当被阻塞等待,直到请求锁定的对象被持有它的线程释放为止 所以被 synchronized 修饰的代码块对同一个线程是可重入的,这也就避免了同线程反复进入导致死锁的可能 在synchronized 修饰的代码块直接结束释放锁之前,会阻塞后面的其他线程 为什么说synchronized是重量级锁 从执行成本来说,持有锁是一个重量级(Heavy-Weight)的操作过程,因为在Java中线程都是映射到操作系统的原生内核线程上的,如果要阻塞和唤醒某一个线程都需要经过操作系统来调度,而这就不可避免的会进行用户态和内核态的转换,但是这种转换是非常耗费处理器时间的,尤其对于本身业务代码简单的程序,可能在这里耗费的时间比业务代码自身执行的时间还长,所以说synchronized 是一个重量级的操作,不过在 jdk6 后对其做了大量的优化,让它不再显得那么重 锁的优化 在 JDK5 升级到 JDK6 后进行一系列关于锁的改进,通过多种技术手段来优化锁,让 synchronized 不再像以前一样显的很重,这其中涉及到适应性自旋(Adaptive Spinning)、锁消除(Lock Elimination)、锁膨胀(Lock Coarsening)、轻量级锁(LightWeight Locking)、偏向锁(Biased Locking)等,这些都是用来优化和提高多线程访问共享数据的竞争问题。 锁消除 锁消除是虚拟机在即时编译器运行时对一些代码要求同步,但是被检测到不可能存在共享数据竞争的锁进行消除,其中主要的判定依据是基于逃逸分析技术来实现的,关于这块内容不在这里展开,后续相关文章介绍。这里我们简单理解就是,如果一段代码中,在堆上的数据都不会逃逸出去被其他线程访问到,那么就可以把它们当作栈上的数据来对来,认为它们都是线程私有的,从而也就不需要同步加锁了, 关于代码中变量是否逃逸,对虚拟机来说需要通过复杂分析才能得到,但是对我们开发人员来说还是相对直观的,那可能有人会疑惑既然开发人员能清楚还为什么要多余的加锁同步呢?,其实实际上,程序上非常多的同步措施并不是我们开发人员自己加入的,而是 java 内部就有大量的存在,比如下面这个典型的例子,下面展示的是字符串的相加 private String concatString(String s1,String s2,String s3){ return s1 + s2 + s3; } 我们知道String 类是被 final 修饰的不可变类,所以对于字符串的相加都是通过生成新的String 对象来试试先的,因此编译器会对这种操作做优化处理,在JDK5 之前会转换为 StringBuffer 对象的append() 操作,而在JDK5 及其之后则转换为StringBuilder 对象来操作。所以上述代码在jdk5可能会变成如下: private String concatString(String s1,String s2,String s3){ StringBuffer sb = new StringBuffer(); sb.append(s1); sb.append(s2); sb.append(s3); return sb.toString(); } 这时候,就可以看到,对于StringBuffer。append() 方法是一个同步方法,带有同步快,锁对象就是 sb ,这时候虚拟机通过分析发现 sb 的作用域被限制在方法内部,而不可能逃逸出方法外让其他线程访问到,所以这是在经过服务端编译器的即时编译后,这段代码的所有同步措施都会失效而直接执行。 上述代码是为了方便演示而选择了String,实际来说在jdk5之后都是转换为Stringbuilder ,也就不存在这个问题了,但是在jdk中类似这种还是非常多的。 锁粗化 关于锁的粗话其实也是很简单的理解,我们在开发时总是推荐同步代码块要作用范围尽量小,尽量只在共享数据的实际作用域中才进行同步,这样的目的是为了尽可能减少同步的操作,让其他线程能更快的拿到锁 这是多大多数情况,但是总有一些特殊情况,比如在某个系列连续操作的都是对同一个对象反复的加锁和解锁,那么这会导致不必要的性能损耗 也如同上面String 的案例,在连续的append 操作都是零碎的同步块,而且都是同一个锁对象,这时候会将锁的范围扩展,到整个操作序列外部,也就是第一个append 之前到最后一个append 操作之后,将这些全部放入一个同步锁中就可以了,这样就避免了多次的锁获取和释放。 自旋锁 通过之前的了解,我们知道挂起线程和恢复线程都是会涉及到用户态和内核态的转换,而这些都是非常耗时的,这会直接影响虚拟机的并发性能。 在我们平时开发中,如果共享数据的锁定状态只会持续很短的时间,那么为了这很短的时间而去挂起阻塞线程是非常浪费资源的。尤其现在的电脑都基本是多核处理器,所以在这种前提下,我们是是否可以让另一个请求锁对象的线程不去挂起,而是稍微等一下,这个等待并不会放弃CPU 的执行时间。等待观察持有锁的线程是否能很快的释放锁,其实这个等待就好比是一个空的循环,这种技术就是一个所谓的自旋锁 自旋锁在JDK6 中及已经是默认开启的了,在jdk4时就引入了。自旋锁并不是阻塞也代替不了阻塞。 自旋锁对处理器数量有一定的要求,同时它是会占用CPU 时间的,虽然它避免了线程切换的开销,但是这之间时存在平衡关系的,假如锁被占用的时间很短那么自旋就非常有价值,会节省大量的时间开销,但是相反,如果锁占用的时间很长,那么自旋的线程就会白白消耗处理器资源,造成性能的浪费。 所以自旋锁必须有一个限度,也就是它自旋的次数,规定一个自旋次数,如果超过这个次数则不再自旋转而用传统方式挂起线程, 自旋的次数默认时十次。但是我们也可以通过 -XX: PreBlockSpin 参数来自定义设置 自适应自旋锁 在前面我们知道可以自定义自旋次数,但是这个很难有个合理的值,毕竟在程序中怎么样的情况都有,我们不可能通过全局设置一个。所以在JDK6 之后引入了自适应自旋锁,也就是对原有的自旋锁进行了优化 自适应自旋的时间不再是固定的,而是由前一次在同一个锁上的自旋时间及锁的拥有者的状态决定的,如果在同一个锁对象上,自旋等待刚刚成功获得过锁,并且支持有锁的线程正在运行中,那么虚拟机就会任务这次自旋也极有再次获得锁,那么就会允许自旋的持续时间更长 相应的 ,如果对于某个锁,自旋获得锁的次数非常少,那么在之后要获取锁的时候将直接忽略掉自旋的过程进而直接阻塞线程避免浪费处理器资源 轻量级锁 轻量级锁也是 JDK6 时加入的新的锁机制,它的轻量级是相对于通过操作系统互斥量来实现的传统锁而言的,轻量级锁也是一种优化,而不是能替代重量级锁,轻量级锁的涉及初衷就是在没有多线程竞争下减少传统重量级锁使用操作系统互斥量产生的性能消耗。 要想了解轻量级锁我们必须对对象在Heap 中的分布了解,也就是上面说到的内容。 轻量级锁加锁 当代码执行到同步代码块时,如果同步对象没有被锁定也就是锁标志位为01 状态,那么虚拟机首先将在当前线程的栈帧中建立一个名为锁记录Lock Record 的空间 这块锁记录空间用来存储锁对象目前的 Mark Word 的拷贝,官方给其加了个Displaced 的前缀,即 Displaced Mark Word ,如下图所示,这是在CAS 操作之前堆栈与对象的状态 当复制结束后虚拟机会通过CAS 操作尝试把对象的Mark Word 更新为指向Lock Record 的指针,如果更新成功则代表该线程拥有了这个对象的锁,并且将Mark Word 的锁标志位(最后两个比特)转变为 “00”,此时表示对象处于轻量级锁定状态,此时的堆栈与对象头的状态如下: 如果上述操作失败了,那说明至少存在一条线程与当前线程竞争获取该对象的锁,虚拟机会首先检查对象的Mark Word 是否指向当前线程的栈帧,如果是,则说明当前线程已经拥有了这个对象的锁,那么直接进入同步代码块执行即可。否则则说明这个对象已经被其他线程抢占了。 如果有超过两条以上的线程争夺同一个锁的情况,那么轻量级锁就不再有效,必须膨胀为重量级锁,锁的标记位也变为“10”,此时Mark Word 中存储的就是指向重量级锁的指针,等待的线程也必须进入阻塞状态 轻量级锁的解锁 轻量级锁的解锁同样是通过CAS 操作来进行的 如果对象的 Mark Word 仍然指向线程的锁记录,那么就用CAS 操作把对象当前的 Mark Word 和线程中复制的 Displaced Mark Word 替换回来 如果替换成功则整个同步过程结束,若失败则说明有其他线程正在尝试获取该锁,那就要在释放锁的同时,唤醒被挂起的线程 轻量级锁适用的场景是对于绝大部分锁在整个同步周期内都是不存在竞争的,因为如果没有竞争,轻量级锁便可以通过CAS 操作成功避免了使用互斥量的开销,但是如果确实存在锁竞争,那么除了互斥量本身的开销外还得额外发生了CAS 操作的开销,这种情况下反而比重量级锁更慢 下面通过完整的流程图来直观看一下轻量级锁的加锁解锁及膨胀过程 偏向锁 偏向锁也是JDK6 引入的一种锁优化技术,如果说轻量级锁是在无竞争情况下通过CAS 操作消除了同步使用的互斥量,那么偏向锁则是再无竞争情况下把整个同步都给消除掉了,连CAS 操作都不再去做了,可以看出这比轻量级锁更加轻 从对象头的分布上看,偏向锁中是没有哈希值的而是多了线程ID与Epoch 两个内容 偏向锁的意思就是锁会偏向第一个获得它的线程,如果接下来的执行过程中该锁一直没有被其他线程获取,那么只有偏向锁的线程将永远不需要再进行同步 偏向锁的获取和撤销 当代码执行到同步代码块时,在第一次被线程执行到时,锁对象是第一次被线程获取,此时虚拟机会将对象头中的锁标志改为“01”,同时把偏向锁标志位改为“1”,表示当前锁对象进入偏向锁模式。 接下来线程通过CAS 操作来将这个帧的线程ID记录到对象头中,如果CAS 成功了。则持有锁对象的线程再之后进入同步代码不再进行任何同步操作(如获取锁解锁等操作)。每次都会通过判断当前线程与锁对象中记录的线程id是否一致。 如果 上述的 CAS 操作失败了,那说明肯定存在另外一个线程在获取这个锁,并且获取成功了。这种情况下说明存在锁竞争,则偏向模式马上结束,偏向锁的撤销,需要等待全局安全点(在这个时间点上没有正在执行的字节码)。它会首先暂停拥有偏向锁的线程,会根据锁对象是否处于锁定状态来决定是否撤销偏向也就是将偏向锁标志位改为“0”,如果撤销则会变为未锁定(“01”)或者轻量级锁(“00”) 如果锁对象未锁定,则撤销偏向锁(设置偏向锁标志位为“0”),此时锁处于未锁定不可以偏向状态,因为具有哈希值,进而变为轻量级锁 如果锁对象还在锁定状态则直接进入轻量级锁状态 偏向锁的开关 偏向锁在JDK6 及其之后是默认启用的。由于偏向锁适用于无锁竞争的场景,如果我们应用程序里所有的锁通常情况下处于竞争状态,可以通过JVM参数关闭偏向锁:-XX:-UseBiasedLocking=false,那么程序默认会进入轻量级锁状态。 如果要开启偏向锁可以用: -XX:+UseBiasedLocking -XX:BiasedLockingStartupDelay=0 重量级锁 重量级锁也就是上述几种优化都无效后,膨胀为重量级锁,通过互斥量来实现,我们先来看下面的代码 上面代码是一个简单使用了synchronized 的代码,我们通过字节码工具可以看到右侧窗口。我们发现,在同步代码块的前后分别形成了monitorenter 和 monitorexit 两条指令 在Java对现中都会有一个monitor 的监视器,这里的monitorenter 指令就是去获取一个对象的监视器。而相应的monitorexit 则表示释放监视器monitor 的所有权,允许被其他线程来获取 monitor 是依赖于系统的 MutexLock (互斥锁) 来实现的,当线程阻塞后进入内核态事,就会造成系统在用户态和内核态之间的切换,进而影响性能 总结 上面是阐述了关于synchronized 锁的一些优化与转换,在我们开启偏向锁和自旋时,锁的转变是 无锁 -> 偏向锁 -> 轻量级锁 -> 重量级锁, 自旋锁实际是一种锁的竞争机制,而不是一种状态。在偏向锁和轻量级锁中都使用到了自旋 偏向锁适用于无锁竞争的场景,轻量级锁适合无多个线程竞争的场景 偏向锁和轻量级锁都依赖与CAS操作,但是偏向锁中只有在第一次时才会CAS操作 当一个对象已经被计算过一致性哈希值时,那么这个对象就再也不无法进入到偏向锁状态了,如果对象正处于偏向锁状态,而接收到计算哈希值的请求,那么他的偏向锁状态会被立即撤销,并且会膨胀为重量级锁。这要是为什么偏向锁状态时MarkWord 中没有哈希值 本文由 AnonyStar 发布,可转载但需声明原文出处。 欢迎关注微信公账号 :云栖简码 获取更多优质文章 更多文章关注笔者博客 :云栖简码 i-code.online

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册