首页 文章 精选 留言 我的

精选列表

搜索[文档解析],共10000篇文章
优秀的个人博客,低调大师

Redis GeoHash核心原理解析

1. 引言 小麦同学是个吃货+技术宅,平日里就喜欢拿着手机地图点点按按来查询一些好玩的东西。某一天到北海公园游玩,肚肚饿了,于是乎打开手机地图,搜索北海公园附近的餐馆,并选了其中一家用餐。饱暖思yin欲的麦叔饭后思考地图后台如何根据自己所在位置查询来查询附近餐馆的呢?苦思冥想了半天,小麦想出了个方法:计算所在位置P与北京所有餐馆的距离,然后返回距离<=1000米的餐馆。小得意了一会儿,小麦发现北京的餐馆何其多啊,这样计算不得了,于是想了,既然知道经纬度了,那它应该知道自己在西城区,那应该计算所在位置P与西城区所有餐馆的距离啊,机机运用了递归的思想,想到了西城区也很多餐馆啊,应该计算所在位置P与所在街道所有餐馆的距离,这样计算量又小了,效率也提升了。 小麦的计算思想很朴素,就是通过过滤的方法来减小参与计算的餐馆数目,从某种角度上讲,机机在使用索引技术。 一提到索引,大家脑子里马上浮现出B树索引,因为大量的数据库(如MySQL、oracle、PostgreSQL等)都在使用B树。B树索引本质上是对索引字段进行排序,然后通过类似二分查找的方法进行快速查找,即它要求索引的字段是可排序的,一般而言,可排序的是一维字段,比如时间、年龄、薪水等等。但是对于空间上的一个点(二维,包括经度和纬度),如何排序呢?又如何索引呢?解决的方法很多,下文介绍一种方法来解决这一问题。 思想:如果能通过某种方法将二维的点数据转换成一维的数据,那样不就可以继续使用B树索引了嘛。那这种方法真的存在嘛,答案是肯定的。目前很火的GeoHash算法就是运用了上述思想,下面我们就开始GeoHash之旅吧。 2. 感性认识 先来两个干货,在线查看GPS某个区域的GeoHash值。 1. http://geohash.gofreerange.com/ 在这里插入图片描述 2. http://www.geohash.cn/ 跟更好用些 3. 通俗说 GeoHash将二维的经纬度转换成字符串,比如下图展示了北京9个区域的GeoHash字符串,分别是WX4ER,WX4G2、WX4G3等等,每一个字符串代表了某一矩形区域。也就是说,这个矩形区域内所有的点(经纬度坐标)都共享相同的GeoHash字符串,这样既可以保护隐私(只表示大概区域位置而不是具体的点),又比较容易做缓存,比如左上角这个区域内的用户不断发送位置信息请求餐馆数据,由于这些用户的GeoHash字符串都是WX4ER,所以可以把WX4ER当作key,把该区域的餐馆信息当作value来进行缓存,而如果不使用GeoHash的话,由于区域内的用户传来的经纬度是各不相同的,很难做缓存。字符串越长,表示的范围越精确。如图所示,5位的编码能表示10平方千米范围的矩形区域,而6位编码能表示更精细的区域(约0.34平方千米)字符串相似的表示距离相近(特殊情况后文阐述),这样可以利用字符串的前缀匹配来查询附近的POI信息。如下两个图所示,第一个在城区,第二个在郊区,城区的GeoHash字符串之间比较相似,郊区的字符串之间也比较相似,而城区和郊区的GeoHash字符串相似程度要低些。通过上面的介绍我们知道了GeoHash就是一种将经纬度转换成字符串的方法,并且使得在大部分情况下,字符串前缀匹配越多的距离越近,回到我们的案例,根据所在位置查询来查询附近餐馆时,只需要将所在位置经纬度转换成GeoHash字符串,并与各个餐馆的GeoHash字符串进行前缀匹配,匹配越多的距离越近。 4. GeoHash算法的步骤 下面以北海公园附近随便一个位置为例介绍GeoHash算法的计算步骤,先用百度 GPS反定位系统查找看下经纬度。纬度=116.395371,经度=39.931957。 根据经纬度计算GeoHash二进制编码 地球纬度区间是[-90,90], 北海公园的纬度是39.928167,可以通过下面算法对纬度39.928167进行逼近编码: 区间[-90,90]进行二分为[-90,0),[0,90],称为左右区间,可以确定39.928167属于右区间[0,90],给标记为1; 接着将区间[0,90]进行二分为 [0,45),[45,90],可以确定39.928167属于左区间 [0,45),给标记为0; 递归上述过程39.928167总是属于某个区间[a,b]。随着每次迭代区间[a,b]总在缩小,并越来越逼近39.928167; 如果给定的纬度x(39.928167)属于左区间,则记录0,如果属于右区间则记录1,这样随着算法的进行会产生一个序列1011100,序列的长度跟给定的区间划分次数有关。 39.928167 根据纬度算编码 bit min mid max 1 -90.000 0.000 90.000 0 0.000 45.000 90.000 1 0.000 22.500 45.000 1 22.500 33.750 45.000 1 33.750 39.375 45.000 0 39.375 42.188 45.000 0 39.375 40.7815 42.188 0 39.375 40.07825 40.7815 1 39.375 39.726625 40.07825 1 39.726625 39.9024375 40.07825 同理,地球经度区间是[-180,180],可以对经度116.389550进行编码。根据经度算编码 bit min mid max 1 -180 0.000 180 1 0.000 90 180 0 90 135 180 1 90 112.5 135 0 112.5 123.75 135 0 112.5 118.125 123.75 1 112.5 115.3125 118.125 0 115.3125 116.71875 118.125 1 115.3125 116.015625 116.71875 1 116.015625 116.3671875 116.71875 组码 通过上述计算,纬度产生的编码为10111 00011,经度产生的编码为11010 01011。偶数位放经度,奇数位放纬度,把2串编码组合生成新串:11100 11101 00100 01111。最后使用用0-9、b-z(去掉a, i, l, o)这32个字母进行base32编码,首先将11100 11101 00100 01111转成十进制,对应着28、29、4、15,十进制对应的编码就是wx4g。同理,将编码转换成经纬度的解码算法与之相反,具体不再赘述。 5. GeoHash Base32编码长度与精度 可以看出,当geohash base32编码长度为8时,精度在19米左右,而当编码长度为9时,精度在2米左右,编码长度需要根据数据情况进行选择。 一、经纬度距离换算 在纬度相等的情况下: 经度每隔0.00001度,距离相差约1米; 每隔0.0001度,距离相差约10米; 每隔0.001度,距离相差约100米; 每隔0.01度,距离相差约1000米; 每隔0.1度,距离相差约10000米。 在经度相等的情况下: 纬度每隔0.00001度,距离相差约1.1米; 每隔0.0001度,距离相差约11米; 每隔0.001度,距离相差约111米; 每隔0.01度,距离相差约1113米; 每隔0.1度,距离相差约11132米。 6. GeoHash算法 上文讲了GeoHash的计算步骤,仅仅说明是什么而没有说明为什么?为什么分别给经度和维度编码?为什么需要将经纬度两串编码交叉组合成一串编码?本节试图回答这一问题。 如下图所示,我们将二进制编码的结果填写到空间中,当将空间划分为四块时候,编码的顺序分别是左下角00,左上角01,右下脚10,右上角11,也就是类似于Z的曲线,当我们递归的将各个块分解成更小的子块时,编码的顺序是自相似的(分形),每一个子快也形成Z曲线,这种类型的曲线被称为Peano空间填充曲线。 这种类型的空间填充曲线的优点是将二维空间转换成一维曲线(事实上是分形维),对大部分而言,编码相似的距离也相近, 但Peano空间填充曲线最大的缺点就是突变性,有些编码相邻但距离却相差很远,比如0111与1000,编码是相邻的,但距离相差很大。 除Peano空间填充曲线外,还有很多空间填充曲线,如图所示,其中效果公认较好是Hilbert空间填充曲线,相较于Peano曲线而言,Hilbert曲线没有较大的突变。为什么GeoHash不选择Hilbert空间填充曲线呢?可能是Peano曲线思路以及计算上比较简单吧,事实上,Peano曲线就是一种四叉树线性编码方式。 7. 使用注意点 1. 临界问题 由于GeoHash是将区域划分为一个个规则矩形,并对每个矩形进行编码,这样在查询附近POI信息时会导致以下问题,比如红色的点是我们的位置,绿色的两个点分别是附近的两个餐馆,但是在查询的时候会发现距离较远餐馆的GeoHash编码与我们一样(因为在同一个GeoHash区域块上),而较近餐馆的GeoHash编码与我们不一致。这个问题往往产生在边界处。 解决的思路很简单,我们查询时,除了使用定位点的GeoHash编码进行匹配外,还使用周围8个区域的GeoHash编码,这样可以避免这个问题。 2. 注意点 我们已经知道现有的GeoHash算法使用的是Peano空间填充曲线,这种曲线会产生突变,造成了编码虽然相似但距离可能相差很大的问题,因此在查询附近餐馆时候,首先筛选GeoHash编码相似的POI(point of interest)点,然后进行实际距离计算。 3. 使用心得 GeoHash只是空间索引的一种方式,特别适合点数据,而对线、面数据采用R树索引更有优势(可为什么需要空间索引)。 GeoHash值可以区分精度,位数越多,精度越高,表达的地理位置越精细;如一位的GeoHash值把地球划分为32个矩形,8位的geohash值把地球划分为32^8个小矩形 适合根据某个经纬度坐标position计算出GeoHash值,然后和数据库中精度更高的GeoHash值做前缀比较 8.空间索引 常见问题:如何根据自己所在位置查询来查询附近50米的POI(point of interest,比如商家、景点等)呢(图1a)?每个POI都有经纬度信息,用图1b的SQL语句在mySQL中建立了POI_spatial的表,其中lat和lng两个字段来代表纬度和经度。为后续分析方便起见,我人造了40万个POI数据。 方法一:暴力方法 该方法的思路很直接:计算位置与所有POI的距离,并保留距离小于50米的POI。 插句题外话,计算经纬度之间的距离不能像求欧式距离那样平方开根号,因为地球是个不规整的球体(图2a),普通计算适合都是默认按最简单的完美球体假设,两点之间的距离函数应该如图2b所示。 该方法的复杂度为:40万*距离函数。我们将球体距离函数写为mysql存储过程distance,之后我们执行查询操作(图3),发现花费了4.66秒。 方法二:矩形过滤方法 该方法采用逐步细化的方式,一般分为两部: 先用矩形框过滤(图4a),判断一个点在矩形框内很简单,只要进行两次判断(LtMin<lat<LtMax; LnMin<lng<LnMax),落在矩形框内的POI个数为n(n<<40万); 用球面距离公式计算位置与矩形框内n个POI的距离(图4b),并保留距离小于50米的POI 矩形过滤方法的复杂度:40万矩形过滤函数 + n距离函数(n<<40万)。 根据这个思路我们执行SQl查询(图5)(注:经度或纬度每隔0.001度,距离相差约100米,由此推算出矩形左下角和右上角坐标),发现过滤后正好剩下两个POI。 此查询花费了0.36秒,相比于方法一查询时间大大降低,但是对于一次查询来说还是很长。时间长的原因在于遍历了40万次。 方法三:B树对经度或纬度建立索引 方法二耗时的原因在于执行了遍历操作,为了不进行遍历,我们自然想到了索引。我们对纬度进行了B树索引。 altertablepoi_spatialaddindexlatindex(lat);altertablepoi_spatialaddindexlngindex(lng); 此方法包括三个步骤: 通过B树快速找到某纬度范围的POI(图6a),个数为m(m<40万),复杂度为Log(40万)*过滤函数; 在步骤a过滤得到的m个POI中查找某经度范围的POI(图6b),个数为n(n<m),复杂度为m*过滤函数; 用球面距离公式计算位置与步骤b得到的n个POI的距离(图6c),并保留距离小于50米的POI 执行SQL查询(图7),发现时间已经大大降低,从方法2的0.36秒下降到0.01秒 三、B树能索引空间数据吗? 这时候有人会说了:方法三效果如此好,能够满足我们附近POI查询问题啊,看来B树用来索引空间数据也是可以的嘛!那么B树真的能够索引空间数据吗? 只能对经度或纬度索引(一维索引),与期望的不符 我们期待的是快速找出落在某一空间范围的POI(如矩形)(图8a),而不是快速找出落在某纬度或经度范围的POI(图8b),想象一下,我要查询北京某区的POI,但是B树索引不仅给我找出了北京的,还有与北京同一维度的天津、大同、甚至国外城市的POI,当数据量很大时,效率很低。 当数据是多维,比如三维(x,y,z),B树怎么索引?比如z可能是高程值,也可能是时间。有人会说B树其实可以对多个字段进行索引,但这时需要指定优先级,形成一个组合字段,而空间数据在各个维度方向上不存在优先级,我们不能说纬度比经度更重要,也不能说纬度比高程更重要。 当空间数据不是点,而是线(道路、地铁、河流等),面(行政区边界、建筑物等),B树怎么索引?对于面来说,它由一系列首尾相连的经纬度坐标点组成,一个面可能有成百上千个坐标,这时数据库怎么存储,B树怎么索引,这些都是问题。 既然传统的索引不能很好的索引空间数据,我们自然需要一种方法能对空间数据进行索引,即空间索引。 参考 Java实现GPS范围查找 浙大大佬通俗说GPS 本文分享自微信公众号 - sowhat1412(sowhat9094)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Class文件结构全面解析(下)

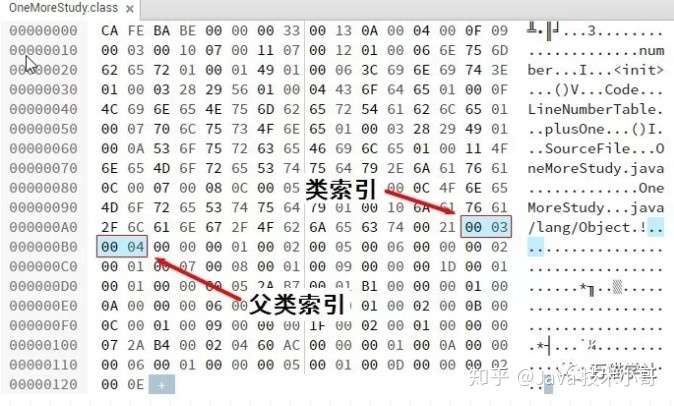
类索引和父类索引 类索引(this_class)和父类索引(super_class)都是一个u2类型的数据,类索引用于确定这个类的全限定名,父类索引用于确定这个类的父类全限定名。由于java语言不允许多重继承,所以父类索引只有一个。 类索引和父类索引各自指向常量池中类型为CONSTANT_Class_info的类描述符,再通过类描述符中的索引值找到常量池中类型为CONSTANT_Utf8_info的字符串。再来看一下之前的Class文件例子: 结合之前javap分析出来的常量池内容: #3 = Class #17 // OneMoreStudy #4 = Class #18 // java/lang/Object #17 = Utf8 OneMoreStudy #18 = Utf8 java/lang/Object 类索引为0x0003,去常量池里找索引为3的类描述符,类描述符中的索引为17,再去找索引为17的字符串,就是“OneMoreStudy”。 父类索引为0x0004,去常量池里找索引为4的类描述符,类描述符中的索引为18,再去常量池里找索引为18的字符串,就是“java/lang/Object”。 接口索引集合 接口索引集合(interface)是一组u2类型的数据的集合,由于java语言允许实现多个接口,所以接口索引也有多个,它们按照implements语句后的接口顺序从左到右依次排列在接口索引集合中。接口索引集合的第一项数据是接口集合计数值(interfaces_count),表示有多少接口索引。如果该类没有实现任何接口,那么该计数值为0,后面的接口索引表不占任何字节。之前的例子OneMoreStudy类没有实现任何接口,所以接口集合计数值就是0,如下图: 字段表集合 字段表(field_info)是用来描述接口或类中声明的变量。包括类级变量(静态变量)和实例级变量(成员变量),但是不包括在方法内部声明的局部变量。具体结构如下表: 字段表中的access_flags,和类的access_flags是非常类似的,但是标识和含义是不一样的。具体如下表: 这里提到了简单名称、描述符,和全限定名有什么区别呢?稍微说一下。 简单名称是没有类型和参数修饰的方法或字段名称,比如OneMoreStudy类中的number字段和plusOne()方法的简单名称分别是“number”和“plusOne”。 全限定名是把类全名中的“.”替换成“/”就可以了,比如java.lang.Object类的全限定名就是“java/lang/Object”。 描述符是用来描述字段的数据类型、方法的参数列表(包括数量、类型以及顺序)和返回值。基础数据类型和无返回的void类型都有一个大写字母表示,对象类型用字符L加对象的全限定名来表示,如下表: 对于数组类型,每一维度使用一个前置的“[”字符来描述,比如java.lang.Object[][]的二维数据,就是“[[Ljava/lang/Object”。在描述方法时,按照先参数列表,后返回值的顺序描述,参数列表按照严格顺序放在“()”值中,比如boolean equals(Object anObject),就是“(Ljava/lang/Object)B”。 再来看一下之前的Class文件例子: OneMoreStudy类中只有一个字段number,所以字段计数值为0x0001。字段number只被private修饰,没有其他修饰,所以字段的访问标志位为0x0002。字段的简单名称索引是0x0005,去常量池中找索引为5的字符串,为“number”。字段的描述符索引为0x0006,去常量池中找索引为6的字符串,为“I”,是基本类型int。以下是常量池相关内容: #5 = Utf8 number #6 = Utf8 I 字段number的属性计数值为0x0000,也就是没有需要额外描述的信息。 字段表集合中不会列出从父类或者父接口中继承而来的字段,但有可能列出原版Java代码中没有的字段,比如在内部类中为了保持对外部类的访问性,会自动添加指向外部类实例的字段。 方法表集合 方法表的结构和字段表的是一样的,也是依次包括了访问标志(access_flags)、名称索引(name_index)、描述符索引(descriptor_index)和属性表集合(attributes)。具体如下表: 对于方法的访问标志,所有标志位和取值如下表: 方法中的Java代码,经过编译器编程成字节码指令后,放在方法属性表集合中一个名为“Code”的属性里,后面会有更多分享。 再来看一下之前的Class文件例子: 方法计算值为0x0003,表示集合中有两个方法(编译器自动添加的无参构造方法和源码中的plusOne方法)。第一个方法的访问标志是0x0001,表示只有ACC_PUBLIC标志为true。 名称索引为0x0007,在常量池中为索引为7的字符串为“”,这就是编译器自动添加的无参构造方法。描述符索引为0x0008,在常量池中为索引为7的字符串为“()V”,方法的属性计数值为0x0001,表示该方法有1个属性,属性名称索引为0x0009,在常量池中为索引为7的字符串为“Code”。以下是常量池相关内容: #7 = Utf8 <init> #8 = Utf8 ()V #9 = Utf8 Code 属性表集合 属性表(attribute_info)在前面的分享中出现了几次,在Class文件、字段表、方法表都可以有自己的属性表集合,用来描述某些场景下特有的信息。 属性表不在要求具有严格的顺序,并且只要不与已有的属性名重复,任何人实现的编译器都可以写入自己定义的属性信息,Java虚拟机在运行时会忽略掉它不认识的属性。 我总结了一些比较常见的属性,如下表: 对于每个属性,它的名称都从常量池中引用一个CONSTANT_Utf8_info类型的常量,而属性值的结构则是完全自定义的,只需要用一个u4类型来说明属性值所占的位数就可以了。具体结构如下: 总结 Class文件主要由魔数、次版本号、主版本号、常量池集合、访问标志、类索引、父类索引、接口索引集合、字段表集合、方法表集合和属性表集合组成。随着JDK版本的不断升级,Class文件结构也在不断更新,学习之路,永不止步。

优秀的个人博客,低调大师

Class文件结构全面解析(上)

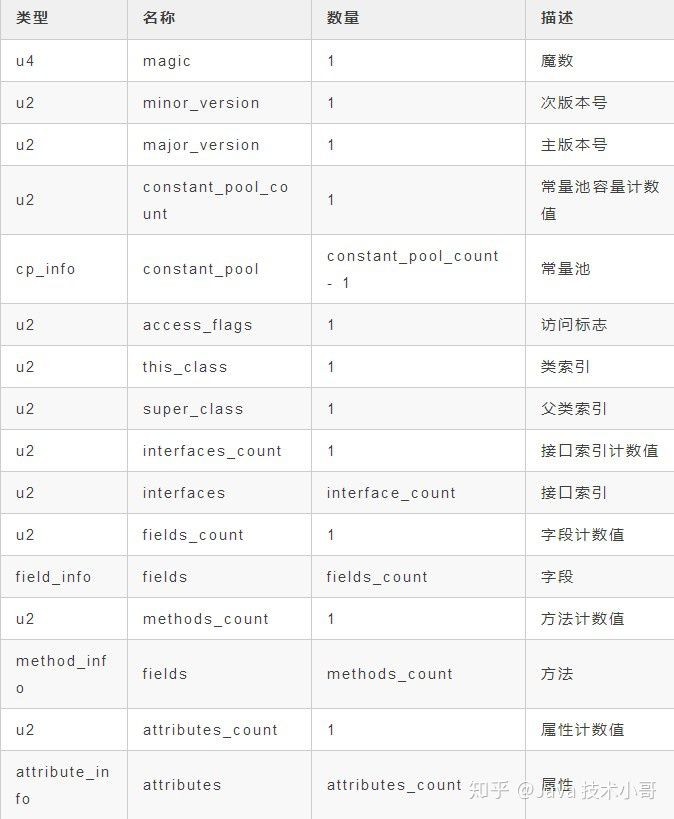
什么是Class文件? 在Java刚刚诞生的时候就提出了一个非常著名的口号:“一次编写,到处运行。(Write Once,Run Anywhere)”。为了实现平台无关性,各种不同平台的虚拟机都统一使用一种程序储存格式,就是字节码(ByteCode)。它就以二进制字节流的方式被存放在Class文件中,其中包含了Java虚拟机指令集和符号表以及其他辅助信息。 为什么需要了解Class文件结构? 一般对于数据结构的分享难免比较枯燥,但是了解Class文件结构是了解Java虚拟机的重要基础之一。如果想比较深入地了解Java虚拟机,那么Class文件结构是不能不接触的。我会力求在保证逻辑准确的基础上,尽量通俗易懂地分享,并结合实际案例。 Class文件结构简介 Class文件是一组以8位字节为基础单位的二进制流,各个数据项目严格按照顺序准确地排列在Class文件中,中间没有任何分隔符。当遇到8位字节以上的数据时,就按照高位在前的方式(最高位字节在地址最低位、最低位字节在地址最高位的顺序储存)分割成多个8位字节储存。 Class文件格式采用一种类似于C语言结构体的伪结构来储存数据的,这种伪结构有两种数据类型:无符号数和表。 无符号数用u1、u2、u4、u8分别代表1个字节、2个字节、4个字节和8个字节的无符号数,可以用来描述数字、索引引用、数量值或者UTF-8编码构成的字符串值。 表是由多个无符号数或其他表作为数据项构成的复合数据类型,所有的表都习惯地以“_info”结尾。表的数据结构和树很类似,无符号数相当于它的叶子节点,其他的表相当于它的子节点。整个Class文件就本质上也是一个表,具体结构如下: 可以发现,无论是无符号数还是表,当需要描述同一种类型又数量不定的多条数据时,就会用一个前置的计数器加几个连续的数据项的方式,这个时候我们就把这种一系列连续的某种类型的数据叫做这个类型的集合。 在Class文件中,无论是顺序还是数量,甚至是数据存储的字节序,都必须严格按照上面表格进行设定,哪个字节代表什么含义,长度是多少,先后顺序怎么样,都不允许改变。接下来看一下各个数据项的具体含义。 魔数 魔数(Magic Number)是每个Class文件的前4个字节,它用来确定当前文件是否是一个被Java虚拟机所接受的Class文件。很多文件存储标准中都使用了魔数进行身份识别,比如gif、jpeg等图片文件中都有魔数。使用魔数而不使用扩展名是出于安全考虑,因为扩展名更容易被修改。文件格式制定者可以自主选择魔数,只要这个魔数没有被广泛使用又不和其他文件混淆就可以。 Class文件的魔数是:0xCAFEBABE,这个魔数在Java还被称为“Oak”语言的时候就确定下来了,据Java开发小组最初的关键成员Patrick Naughton说:“我们一直在寻找一些好玩的、容易记忆的东西,选择0xCAFEBABE是因为它象征着著名咖啡品牌Peet's Coffee中深受欢迎的Baristas咖啡”,他们是真的很喜欢喝咖啡啊,可能也预示着日后“Java”这个名字的出现。 为了更快的理解,我准备了一个实际案例,一段非常简单的Java代码: public class OneMoreStudy { private int number; private int plusOne() { return number + 1; } } 使用JDK 1.7把这段代码编译成Class文件,用HexEd打开,就可以到魔数了,如下图: 在接下来的分享中,也会经常使用这个Class文件。 次版本号和主版本号 紧跟着魔数的第5和第6个字节是次版本号(Minor Version),第7和第8个字节是主版本号(Major Version)。Java的主版本号是从45开始的,从JDK 1.1以后每个JDK大版本发布主版本号都加1,高版本的JDK向下兼容低版本的Class文件,但不能运行更高版本的Class文件,即使Class文件的格式没有发生任何变化,Java虚拟机也会拒绝运行超过其版本号的Class文件。 再来看一下之前的Class文件例子: 表示次版本号的第5和第6个字节值为0x0000,表示主版本号的第7和第8个字节值为0x0033,也就是十进制的51,说明这个Class文件可以被JDK 1.7及其以上版本的Java虚拟机运行。 常量池 紧跟着主版本号的就是常量池,它可以理解为Class文件的资源仓库,也是Class文件结构中与其他数据项关联最多的数据类型。因为在常量池中的常量数量是不固定的,所以首先有一个u2类型的数据,表示常量池容量大小(constant_pool_count)。 常量池的容量计数不是从0开始的,而是从1开始的,这是因为0有它的特殊用用途,那就是为了表达在特殊情况下需要表达“不引用任何一个常量池项目”的含义。在Class文件结构中只有常量池的容量计数是从1开始的,对于其他集合,包括接口索引集合、字段集合、方法集合等的容量计数都是从0开始的。 再来看一下之前的Class文件例子: 常量池容器计数值为0x0013,也就是十进制的19,它表示常量池中有18个常量,索引值范围从1到18。 常量池中主要存储两种常量:字面量(Literal)和符号引用(Symbolic References)。字面量比较接近Java语言层面的常量,比如文本字符串、声明为final的常量值。符号引用则是编译原理层次的概念,它包括以下三种: 类和接口的全限定名 字段的名称和描述符 方法的名称和描述符 常量池中每一个常量都是一个表,共有14种不同的常量类型(JDK1.7及之前版本),每一种类型的表在第一位都有一个u1类型的标志位,具体如下表: 有个一个专门分析Class文件字节码的工具javap,我们用它直接看一下之前的Class文件例子里的18个常量(常量池以外的信息已省略): E:\>javap -verbose OneMoreStudy Compiled from "OneMoreStudy.java" minor version: 0 major version: 51 Constant pool: #1 = Methodref #4.#15 // java/lang/Object."<init>":()V #2 = Fieldref #3.#16 // OneMoreStudy.number:I #3 = Class #17 // OneMoreStudy #4 = Class #18 // java/lang/Object #5 = Utf8 number #6 = Utf8 I #7 = Utf8 <init> #8 = Utf8 ()V #9 = Utf8 Code #10 = Utf8 LineNumberTable #11 = Utf8 plusOne #12 = Utf8 ()I #13 = Utf8 SourceFile #14 = Utf8 OneMoreStudy.java #15 = NameAndType #7:#8 // "<init>":()V #16 = NameAndType #5:#6 // number:I #17 = Utf8 OneMoreStudy #18 = Utf8 java/lang/Object 其中,有一些常量好像在代码里没有出现过,如“I”、“”、“Code”、“LineNumberTable”、“SourceFile”。它们其实自动生成的,是后面要分享的字段表、方法表、属性表引用到的,用于描述一些不方便使用“固定字节”进行表达的内容。 访问标志 紧跟着常量池的2个字节表示访问标志(access_flags),它用于识别一些类或接口层次的访问信息,具体见下表: 其中,ACC_SUPER在JDK 1.0.2之后编译出来的Class文件必须为true;ACC_ABSTRACT对于接口或抽象类来说为true,其他类为false。 之前的例子OneMoreStudy是一个普通的类,不是接口、注解或枚举,只被public修饰,没有被声明为final或abstract,而且是JDK 1.7编译的,所以只有ACC_PUBLIC和ACC_SUPER为true,所以它的访问标志应该是0x0001 | 0x0020 = 0x0021,如下图:

优秀的个人博客,低调大师

Cassandra源码解析系列启动模块

以3.11.4为基础 Cassandra 启动流程从bin下面的cassandra脚本开始进去看,会涉及到cassandra-env.sh进行进程启动的一些参数设置比如堆上内存分配,日志参数配置,基本环境设置等,我们直接看到启动的进程,也就是launch_service 这个函数,然后看到里面的exec 执行JAVA的进程,也就是class(launch_service参数传进来的classname为org.apache.cassandra.service.CassandraDaemon类);大概的流程是: cassandra -> lauch_service -> JAVA启动org.apache.cassandra.service.CassandraDaemon; 接下来就是看到org.apache.cassandra.service.CassandraDaemon这个类,直接在这个类里面通过main函数找到启动的入口: public static void main(String[] args) { instance.activate(); } 在active函数里面有3个主要要看的函数: // Do not put any references to DatabaseDescriptor above the forceStaticInitialization call. try { applyConfig(); MBeanWrapper.instance.registerMBean(new StandardMBean(new NativeAccess(), NativeAccessMBean.class), MBEAN_NAME, MBeanWrapper.OnException.LOG); if (FBUtilities.isWindows) { // We need to adjust the system timer on windows from the default 15ms down to the minimum of 1ms as this // impacts timer intervals, thread scheduling, driver interrupts, etc. WindowsTimer.startTimerPeriod(DatabaseDescriptor.getWindowsTimerInterval()); } setup(); String pidFile = System.getProperty("cassandra-pidfile"); if (pidFile != null) { new File(pidFile).deleteOnExit(); } start(); } catch (Throwable e) { boolean logStackTrace = e instanceof ConfigurationException ? ((ConfigurationException)e).logStackTrace : true; System.out.println("Exception (" + e.getClass().getName() + ") encountered during startup: " + e.getMessage()); if (logStackTrace) { if (runManaged) logger.error("Exception encountered during startup", e); // try to warn user on stdout too, if we haven't already detached e.printStackTrace(); exitOrFail(3, "Exception encountered during startup", e); } else { if (runManaged) logger.error("Exception encountered during startup: {}", e.getMessage()); // try to warn user on stdout too, if we haven't already detached System.err.println(e.getMessage()); exitOrFail(3, "Exception encountered during startup: " + e.getMessage()); } } applyConfig();主要是用来初始化cassandra.yaml配置文件里的基本的配置,setup主要是做一些单节点初始化的时候的一些初始化工作,比如load本地的sstable元信息到内存,清除无用的sstable文件,启动的时候没有commit的transaction 执行或回滚,commitlog 的启动以及回放,集群元信息的效验,启动compaction,启动7000端口内部交流server等等事情; start函数主要是启动9042的client监听端口,主要是netty的server,当然如果是thrift的话,也启动9160 端口服务;

优秀的个人博客,低调大师

Aspectj实例探究,解析SentinelResourceAspect实现

为了学习SentinelResourceAspect,这篇文章里我用Aspectj实现一个AOP实例,一起来看下。 Sentinel 提供了 @SentinelResource 注解用于定义资源,支持 AspectJ 的扩展用于自动定义资源、处理 BlockException 等。 SentinelResourceAspect是Sentinel中的核心切面,Sentinel对限流,拦截等的支持都依赖 SentinelResourceAspect,本文回顾AOP相关知识,实现一个AspectJ实例,然后带你从源码角度,探究SentinelResourceAspect的实现。 1、回顾 Spring AOP 知识 AOP为Aspect Oriented Programming的缩写,意为:面向切面编程,通过预编译方式和运行期动态代理实现程序功能的统一维护的一种技术。 利用AOP可以对业务逻辑的各个部分进行隔离,从而使得业务逻辑各部分之间的耦合度降低,提高程序的可重用性,同时提高了开发的效率。 常见使用场景 性能监控 在方法调用前后记录调用时间,方法执行太长或超时报警。 缓存代理 缓存某方法的返回值,下次执行该方法时,直接从缓存里获取。 软件破解 使用AOP修改软件的验证类的判断逻辑。 记录日志 在方法执行前后记录系统日志。 工作流系统 工作流系统需要将业务代码和流程引擎代码混合在一起执行,那么我们可以使用AOP将其分离,并动态挂接业务。 权限验证 方法执行前验证是否有权限执行当前方法,没有则抛出没有权限执行异常,由业务代码捕捉。 AOP的一些概念 Aspect Aspect : 声明类似于 Java 中的类声明,在 Aspect 中会包含着一些 Pointcut 以及相应的 Advice。 Joint point : 拦截点,如某个业务方法, 表示在程序中明确定义的点,典型的包括方法调用,对类成员的访问以及异常处理程序块的执行等等,它自身还可以嵌套其它 joint point。 Pointcut : 表示一组 joint point,这些 joint point 或是通过逻辑关系组合起来,或是通过通配、正则表达式等方式集中起来,即Joinpoint的表达式,表示拦截哪些方法。一个Pointcut对应多个Joinpoint Advice Advice : 定义了在 pointcut 里面定义的程序点具体要做的操作,即要切入的逻辑,它通过 before、after 和 around 来区别是在每个 joint point 之前、之后还是代替执行的代码。 Target : 被aspectj横切的对象。我们所说的joinPoint就是Target的某一行,如方法开始执行的地方、方法类调用某个其他方法的代码 在Spring 中,AOP有多种实现方式,AspectJ是其中一种,另外还有JDK 和 Cglig的动态代理等。 2、基于 AspectJ 和@annotation拦截方法实现AOP 在学习 SentinelResourceAspect 源码之前,我先动手实现一个 AspectJ 的AOP实例,完成这个实例以后,SentinelResourceAspect的原理只要看一眼源码就可以明白。 (1)编写Annotation类 @Target({ElementType.METHOD,ElementType.TYPE}) @Documented @Inherited public @interface WorkflowLogAnnotation { String field(); } (2)编写接口和实现类 编写接口类WorkflowService,编写实现类WorkflowServiceImpl,注意此处在方法上增加WorkflowLogAnnotation public class WorkflowServiceImpl implements WorkflowService { @Override @WorkflowLogAnnotation public void start(String bpmnXml) { System.out.println("启动流程"); } } (3)加入切面动作 在流程启动前和启动后做一些操作,增加通知,注意Pointcut表达式改为拦截器方式。 @Aspect public class WorkflowServiceAdviceAspect { public WorkflowServiceAdviceAspect(){ } @Pointcut("annotation(Spring.WorkflowLogAnnotation)") public void startPoint() @Before("startPoint()") public void before(Method arg0, Object[] arg1, Object arg2) throws Throwable { System.out.println("执行方法前"); } @AfterReturning("startPoint()") public void afterReturning(Object arg0, Method arg1, Object[] arg2, Object arg3) throws Throwable { System.out.println("执行方法后"); } } (4)增加配置 在Xml中增加配置,如果WorkflowServiceAdviceAspect和WorkflowServiceImpl类上增加了@Component,下面的bean声明可以用Spring的自动扫描来替代。 <aop:aspectj-autoproxy /> <!-- 定义通知内容,也就是切入点执行前后需要做的事情 --> <bean id="workflowServiceAdviceAspect" class="Spring.WorkflowServiceAdviceAspect"></bean> <!-- 定义被代理者 --> <bean id="workflowService" class="business.WorkflowServiceImpl"></bean> (5)完成验证 完成上面的操作,一个 AspectJ 实例就完成了,是不是很简单,下面看下 SentinelResourceAspect的源码。 3、SentinelResourceAspect源码 可以看到,SentinelResourceAspect切面和我们上面的实例实现方式是一样的。 public class SentinelResourceAspect extends AbstractSentinelAspectSupport { @Pointcut("@annotation(com.alibaba.csp.sentinel.annotation.SentinelResource)") public void sentinelResourceAnnotationPointcut() { } @Around("sentinelResourceAnnotationPointcut()") public Object invokeResourceWithSentinel(ProceedingJoinPoint pjp) throws Throwable { Method originMethod = resolveMethod(pjp); SentinelResource annotation = originMethod.getAnnotation(SentinelResource.class); if (annotation == null) { // Should not go through here. throw new IllegalStateException("Wrong state for SentinelResource annotation"); } String resourceName = getResourceName(annotation.value(), originMethod); EntryType entryType = annotation.entryType(); Entry entry = null; try { entry = SphU.entry(resourceName, entryType, 1, pjp.getArgs()); Object result = pjp.proceed(); return result; } catch (BlockException ex) { return handleBlockException(pjp, annotation, ex); } catch (Throwable ex) { Class<? extends Throwable>[] exceptionsToIgnore = annotation.exceptionsToIgnore(); // The ignore list will be checked first. if (exceptionsToIgnore.length > 0 && exceptionBelongsTo(ex, exceptionsToIgnore)) { throw ex; } if (exceptionBelongsTo(ex, annotation.exceptionsToTrace())) { traceException(ex, annotation); return handleFallback(pjp, annotation, ex); } // No fallback function can handle the exception, so throw it out. throw ex; } finally { if (entry != null) { entry.exit(1, pjp.getArgs()); } } } } (1)进入方法调用SphU.entry SentinelResourceAspect 使用aspect的around拦截,拦截标注有SentinelResource的注解,进入方法之前调用SphU.entry(resourceName, entryType),结束之后调用entry.exit(); entry = SphU.entry(resourceName, entryType, 1, pjp.getArgs()); Object result = pjp.proceed(); 这个使用方式和我们单机使用 Sentinel的方式是一样的。 (2)handleBlockException处理异常 异常的时候调用handleBlockException方法,会先判断是否是降级需要处理的异常,是的话,则调用fallback方法,否则调用block handler方法。 Method blockHandlerMethod = extractBlockHandlerMethod(pjp, annotation.blockHandler(), annotation.blockHandlerClass()); if (blockHandlerMethod != null) { Object[] originArgs = pjp.getArgs(); // Construct args. Object[] args = Arrays.copyOf(originArgs, originArgs.length + 1); args[args.length - 1] = ex; if (isStatic(blockHandlerMethod)) { return blockHandlerMethod.invoke(null, args); } return blockHandlerMethod.invoke(pjp.getTarget(), args); } // If no block handler is present, then go to fallback. return handleFallback(pjp, annotation, ex); 4、总结 Sentinel 使用了Aspectj来实现切面,可以更方便的应用Sentinel。

优秀的个人博客,低调大师

AnalyticDB for MySQL 3.0 技术架构解析

企业数据需求不断变化,近年来变化趋势日益明显,从数据的3V特性看:体积,速度和变化;Big Data强调数据量,PB级以上,是静态数据。而Fast Data在数据量的基础上,意味着速度和和变化,意味着客户可以更加实时化、更加快速地进行数据处理。在Forrester最近的一项研究中,超过75%的受访公司已经使用Fast Data解决方案。 在接受调查的人中,88%表示他们需要近乎实时地对数据执行分析。 AnalyticDB是阿里巴巴自主研发、唯一经过超大规模以及核心业务验证的PB级实时数据仓库,是FastData的最佳代表。自2012年第一次在集团发布上线以来,至今已累计迭代发布近百个版本,支撑起集团内的电商、广告、菜鸟、文娱、飞猪等众多在线分析业务。AnalyticDB于2014年在阿里云开始正式对外输出,支撑行业既包括传统的大中型

优秀的个人博客,低调大师

go源码解析-Println的故事

本文主要通过平常常用的go的一个函数,深入源码,了解其底层到底是如何实现的。 Println Println函数接受参数a,其类型为…interface{}。用过Java的对这个应该比较熟悉,Java中也有…的用法。其作用是传入可变的参数,而interface{}类似于Java中的Object,代表任何类型。 所以,…interface{}转换成Java的概念,就是Object args ...。 Println函数中没有什么实现,只是return了Fprintln函数。 func Println(a ...interface{}) (n int, err error) { return Fprintln(os.Stdout, a...) } 而在此处的…放在了参数的后面。我们知道...interface{}是代表可变参数,即函数可接收任意数量的参数,而且参数参数分开写的。 当我们再调用这个函数的时候,我们就没有必要再将参数一个一个传给被调用函数了,直接使用a…就可以达到相同的效果。 Fprintln 该函数接收参数os.Stdout.write,和需要打印的数据作为参数。 func Fprintln(w io.Writer, a ...interface{}) (n int, err error) { p := newPrinter() p.doPrintln(a) n, err = w.Write(p.buf) p.free() return } sync.Pool 从广义上看,newPrinter申请了一个临时对象池。我们逐行来看newPrinter函数做了什么。 var ppFree = sync.Pool{ New: func() interface{} { return new(pp) }, } // newPrinter allocates a new pp struct or grabs a cached one. func newPrinter() *pp { p := ppFree.Get().(*pp) p.panicking = false p.erroring = false p.wrapErrs = false p.fmt.init(&p.buf) return p } sync.Pool是go的临时对象池,用于存储被分配了但是没有被使用,但是未来可能会使用的值。以此来减少 GC的压力。 ppFree.Get ppFree.Get()上有大量的注释。 Get selects an arbitrary item from the Pool, removes it from the Pool, and returns it to the caller. Get may choose to ignore the pool and treat it as empty. Callers should not assume any relation between values passed to Put and the values returned by Get. If Get would otherwise return nil and p.New is non-nil, Get returns the result of calling p.New. 麻瓜翻译一波。 Get会从临时对象池中任意选一个printer返回给调用者,并且将此项从对象池中移除。 Get也可以选择把临时对象池当成空的忽略。调用者不应该假设传递给Put方法的值和Get返回的值之间存在任何关系。 如果Get函数没有获取到资源但是p.New函数可以申请到新的资源,就直接返回p.New的值。 上面提到的Put方法,作用是将对象加入到临时对象池中。 p := ppFree.Get().(*pp)下面的三个参数分别代表什么呢? 参数名 用途 p.panicking 由catchPanic设置,是为了避免在panic和recover中无限循环 p.erroring 当打印错误的标识符的时候,防止调用handleMethods p.wrapErrs 当格式字符串包含了动词时的设置 fmt.init 初始化 fmt 配置,会设置 buf 并且清空 fmtFlags 标志位 然后就返回这个新建的printer给调用方。 doPrintln 接下来是doPrintln函数。 doPrintln就跟doPrint类似,但是doPrintln总是会在参数之间添加一个空格,并且在最后一个参数后面添加换行符。以下是两种输出方式的对比。 fmt.Println("test", "hello", "word") // test hello word fmt.Print("test", "hello", "word") // testhelloword% 看了样例,我们再具体看一下doPrintln的具体实现。 func (p *pp) doPrintln(a []interface{}) { for argNum, arg := range a { if argNum > 0 { p.buf.writeByte(' ') } p.printArg(arg, 'v') } p.buf.writeByte('\n') } 这个函数的思路很清晰。遍历所有传入的需要print的参数,在除了第一个 参数以外的所有参数的前面加上一个空格,写入buffer中。然后调用printArg函数,再将换行符写入buffer中。 writeByte的实现很简单,使用了append函数,将传入的参数,append到buffer中。 func (b *buffer) writeByte(c byte) { *b = append(*b, c) } printArg 从上可以看出,调用printArg函数的时候,传入了两个参数。 第一个是需要打印的参数,第二个则是verb,在doPrintln中我们传的是单引号的v。那么在go中的单引号和双引号有什么区别呢?下面我们通过一个表格来对比一下在不同的语言中,单引号和双引号的区别。 语言 单引号 双引号 Java char String JavaScript string string go rune String Python string string rune 那么rune到底是什么类型呢?rune是int32的别名,在任何方面等于int32相同,用于区分字符串和整形。其实现很简单,type rune = int32,rune常用来表示Unicode中的码点,其例子如下所示。 str := "hello 你好" fmt.Println([]rune(str)) // [104 101 108 108 111 32 20320 22909] 说到了rune就不得不说一下byte。同样,我们通过例子来看一下byte和rune的区别。 str := "hello 你好" fmt.Println([]rune(str)) // [104 101 108 108 111 32 20320 22909] fmt.Println([]byte(str)) // [104 101 108 108 111 32 228 189 160 229 165 189] 没错,区别就在类型上。rune是type rune = int32,四个字节;而byte是type byte = uint8,一个字节。实际上,golang中的字符串的底层是靠byte数组实现的。如果我们处理的数据中出现了中文字符,都可用rune来处理。例如。 str := "hello 你好" fmt.Println(len(str)) // 12 fmt.Println(len([]rune(str))) // 8 printArg具体实现 func (p *pp) printArg(arg interface{}, verb rune) { p.arg = arg p.value = reflect.Value{} if arg == nil { switch verb { case 'T', 'v': p.fmt.padString(nilAngleString) default: p.badVerb(verb) } return } switch verb { case 'T': p.fmt.fmtS(reflect.TypeOf(arg).String()) return case 'p': p.fmtPointer(reflect.ValueOf(arg), 'p') return } switch f := arg.(type) { case bool: p.fmtBool(f, verb) case float32: p.fmtFloat(float64(f), 32, verb) case float64: p.fmtFloat(f, 64, verb) case complex64: p.fmtComplex(complex128(f), 64, verb) case complex128: p.fmtComplex(f, 128, verb) case int: p.fmtInteger(uint64(f), signed, verb) case int8: p.fmtInteger(uint64(f), signed, verb) case int16: p.fmtInteger(uint64(f), signed, verb) case int32: p.fmtInteger(uint64(f), signed, verb) case int64: p.fmtInteger(uint64(f), signed, verb) case uint: p.fmtInteger(uint64(f), unsigned, verb) case uint8: p.fmtInteger(uint64(f), unsigned, verb) case uint16: p.fmtInteger(uint64(f), unsigned, verb) case uint32: p.fmtInteger(uint64(f), unsigned, verb) case uint64: p.fmtInteger(f, unsigned, verb) case uintptr: p.fmtInteger(uint64(f), unsigned, verb) case string: p.fmtString(f, verb) case []byte: p.fmtBytes(f, verb, "[]byte") case reflect.Value: if f.IsValid() && f.CanInterface() { p.arg = f.Interface() if p.handleMethods(verb) { return } } p.printValue(f, verb, 0) default: if !p.handleMethods(verb) { p.printValue(reflect.ValueOf(f), verb, 0) } } } 可以看到有一部分类型是通过反射获取到的,而大部分都是switch case出来的,并不是所有的类型都用的反射,相对的提高了效率。 例如,我们传入的是字符串。则接下来就会走到fmtString。 fmtString 从printArg中带来的参数有需要打印的字符串,以及rune类型的'v'。 func (p *pp) fmtString(v string, verb rune) { switch verb { case 'v': if p.fmt.sharpV { p.fmt.fmtQ(v) } else { p.fmt.fmtS(v) } case 's': p.fmt.fmtS(v) case 'x': p.fmt.fmtSx(v, ldigits) case 'X': p.fmt.fmtSx(v, udigits) case 'q': p.fmt.fmtQ(v) default: p.badVerb(verb) } } p.fmt.sharpV在过程中没有被重新赋值,初始化的零值为false。所以下一步会进入fmtS。 fmtS func (f *fmt) fmtS(s string) { s = f.truncateString(s) f.padString(s) } 如果存在设定的精度,则truncate将字符串s截断为指定的精度。多用于需要输出数字时。 func (f *fmt) truncateString(s string) string { if f.precPresent { n := f.prec for i := range s { n-- if n < 0 { return s[:i] } } } return s } 而padString则将字符串s写入buffer中,最后调用io的包输出就好了。 free func (p *pp) free() { if cap(p.buf) > 64<<10 { return } p.buf = p.buf[:0] p.arg = nil p.value = reflect.Value{} p.wrappedErr = nil ppFree.Put(p) } 在前面讲过,要打印的时候,需要从临时对象池中获取一个对象,避免重复创建。而在此处,用完之后就需要通过Put函数将其放回临时对象池中,已备下次调用。 当然,并不是无限的将用过的变量放入对象池。如果缓冲区的大小超过了设定的阙值也就是65535,就无法再执行后续的操作了。 写在最后 看源码是个技术活,其实这篇博客也算是一种尝试。最近看到一个图很有意思,跟大家分享一下。这张图讲的是你以为的看源码。 然后是实际上的你看源码。 这张图特别形象。当你打算看一个开源项目的源码的时候,往往像一个饿了很多天没吃饭的人看到一桌美食一样,恨不得几分钟就把桌上的东西全部吃完,最后撑的半死,全部吐了出来;又或许像上面两张图里的水一样,接的太快,最后杯子里剩的反而越少。 相反,如果我们慢慢的品味美食,慢慢的去接水,肚子里的食物和水杯的水就一定会慢慢增加,直到适量为止。 我认为看源码,不应该一口吃成胖子,细水长流。从某一个小功能开始,慢慢的展开,这样才能了解到更多的东西。

优秀的个人博客,低调大师

Java 源码解析实战 - ThreadLocal 原理

说起CS游戏,应该是每个中二少年的年少回忆了.游戏开始时,每个人能够领到一把枪,枪把上有三个数字:子弹数、杀敌数、自己的命数,为其设置的初始值分别为1500、0、10. 设战场上的每个人都是一个线程,那么这三个初始值写在哪里呢?如果每个线程都写死这三个值,万一将初始子弹数统一改成 1000发呢?如果共享,那么线程之间的并发修改会导致数据不准确.能不能构造这样一个对象,将这个对象设置为共享变量,统一设置初始值,但是每个线程对这个值的修改都是互相独立的.这个对象就是ThreadLocal 注意不能将其翻译为线程本地化或本地线程英语恰当的名称应该叫作:CopyValueIntoEveryThread 示例代码该示例中,无 set 操作,那么初始值又是如何进入每个线程成为独立拷贝的呢?首先,虽然ThreadLocal在定义时重写了initial

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册