首页 文章 精选 留言 我的

精选列表

搜索[全文搜索],共10000篇文章
优秀的个人博客,低调大师

基于LDAP的通讯录(阿里云邮)搜索查询的实现

为了让用户用好新零售风险防控中心,尽可能给用户提供方便…… 说吧,要什么? 就是阿里云邮箱的那个通讯录,能够查询邮件组的接口。 又是烦阿里云邮的同学,你要的目前没有,HSF、HTTP也都没有,不过感谢同学还是给我指了个方向,开放的LDAP协议,我的f**k,书到用时方恨少,各种百度谷歌…… 概念性的百科知识那些什么的大家请自学哈。 ldap java apihttp://directory.apache.org/api/java-api.html ⭐️UnboundID LDAP sdk for javahttps://docs.ldap.com/ldap-sdk/docs/index.html 我这次用的是我直接借力UnboundID LDAP去实现的,下面直接把结果和代码晒给大家(springboot工程): 个人邮箱查询结果 邮件组信息查询结

优秀的个人博客,低调大师

一个简单的二叉搜索树(C++实现)

参考:http://www.cnblogs.com/skywang12345/p/3576373.html 这里主要就是自己实现的代码,删除动作有点不一样: #ifndef __BSTREE_H__ #define __BSTREE_H__ /* 参考:http://www.cnblogs.com/skywang12345/p/3576373.html 这里是介绍二叉查找树 1)若任意结点的左子树不空,则左子树上所有的结点的值均小于它的根结点的值 2)若任意结点的右子树不空,则左子树上所有的结点的值均大于它的根结点的值 3)任意结点的左右子树也分别为二叉查找树 4)没有键值相等的结点(但是这里实现的可以有相同key值的结点)。当键值相同时,插入在右子树中。 */ #include<iomanip> #include<iostream> using namespace std; template <class T> class BSTNode { public: T key; BSTNode *left; BSTNode *right; BSTNode *parent; BSTNode(T value, BSTNode *p, BSTNode *l, BSTNode *r):key(value), parent(p),left(l), right(r) { //cout << "BSTNode() +++ " << endl; } }; template <class T> class BSTree { private: public: BSTNode <T> *mRoot; public: BSTree(); ~BSTree(); void insert(T key); void print(); void preOrder(); T maximum(); T minimum(); int remove(T data); void destory(); private: void insert(BSTNode<T> *&tree, BSTNode<T> *z); void print(BSTNode<T> *tree, T key, int direction); void preOrder(BSTNode<T> *tree) const; BSTNode<T>* maximum(BSTNode<T> *tree); BSTNode<T>* minimum(BSTNode<T> *tree); BSTNode<T>* getNode(T data); void destory(BSTNode<T> *tree); }; template <class T> BSTree<T>::BSTree() { mRoot = NULL; } template <class T> BSTree<T>::~BSTree() { } template <class T> void BSTree<T>::insert(T key) { BSTNode<T> *z = new BSTNode<T>(key, NULL, NULL, NULL); if(z) { insert(mRoot, z); } } // 这里的&是引用传递 template <class T> void BSTree<T>::insert(BSTNode<T> *&tree, BSTNode<T> *pNode) { BSTNode<T> *pIndex = NULL; BSTNode<T> *pTemp = tree; // 先找到插入的位置 while(pTemp != NULL) { pIndex = pTemp; if(pNode->key < pTemp->key) pTemp = pTemp->left; else pTemp = pTemp->right; } pNode->parent = pIndex; if(!pIndex) tree = pNode; else if(pNode->key < pIndex->key) pIndex->left = pNode; else pIndex->right = pNode; } template <class T> void BSTree<T>::print() { if(mRoot) { print(mRoot, mRoot->key, 0); } } /* key:结点的键值 direction: -1 - 表示为左孩子 0 - 表示为根节点 1 - 表示为左孩子 */ template <class T> void BSTree<T>::print(BSTNode<T> *tree, T key, int direction) { if(tree) { if(direction == 0) cout << setw(2) << tree->key << " is root" << endl; else cout << setw(2) << tree->key << " is " << setw(2) << key << "'s " << setw(12) << (direction==1?"right child":"left child") << endl; print(tree->left, tree->key, -1); print(tree->right, tree->key, 1); } } template <class T> void BSTree<T>::preOrder() { cout << "preOrder: "; preOrder(mRoot); cout << endl; } // 这里是遍历。 template <class T> void BSTree<T>::preOrder(BSTNode<T> *tree) const { if(tree) { #if 1 // 前置遍历 cout << tree->key << " "; preOrder(tree->left); preOrder(tree->right); #endif #if 0 // 中序遍历 preOrder(tree->left); cout << tree->key << " "; preOrder(tree->right); #endif #if 0 // 后序遍历 preOrder(tree->left); preOrder(tree->right); cout << tree->key << " "; #endif } } // 找二叉查找树中的最大值,返回key值最大的那个结点 template <class T> BSTNode<T> * BSTree<T>::maximum(BSTNode<T> *tree) { BSTNode<T> *temp = tree; if(temp) { while(temp->right) { temp = temp->right; } return temp; } else { return NULL; } } // 找二叉查找树中的最小值,返回key值最小的那个结点 template <class T> BSTNode<T> * BSTree<T>::minimum(BSTNode<T> *tree) { BSTNode<T> *temp = tree; if(temp) { while(temp->left) { temp = temp->left; } return temp; } else { return NULL; } } template <class T> T BSTree<T>::maximum() { BSTNode<T> *temp = maximum(mRoot); if(temp) { return temp->key; } return NULL; } template <class T> T BSTree<T>::minimum() { BSTNode<T> *temp = minimum(mRoot); if(temp) { return temp->key; } return NULL; } // 通过data去获取结点。 template <class T> BSTNode<T>* BSTree<T>::getNode(T data) { BSTNode<T> *temp = mRoot; if(!temp) { return NULL; } while(temp) { if(temp->key == data) return temp; else if(temp->key < data) temp = temp->right; else temp = temp->left; } return NULL; } // 这个仅仅是用来打印结点的。测试用的 template <class T> void showNode(BSTNode<T>* node) { if(node->parent) { cout << " parent: " << node->parent->key << endl; } else { cout << " parent is NULL" << endl; } if(node->left) { cout << " left: " << node->left->key << endl; } else { cout << " left is NULL" << endl; } if(node->right) { cout << " right: " << node->right->key << endl; } else { cout << " right is NULL" << endl; } } /* 参考:http://blog.csdn.net/zq17865815296/article/details/52658908 先说一下如何删除二叉树查找树的节点吧。总共有三种情况 1.被删除的节点是叶子节点,这时候只要把这个节点删除,再把指向这个节点的父节点指针置为空就行 2.被删除的节点有左子树,或者有右子树,而且只有其中一个,那么只要把当前删除节点的父节点指向被删除节点的左子树或者右子树就行。 3.被删除的节点既有左子树而且又有右子树,这时候需要把左子树的最右边的节点或者右子树最左边的节点提到被删除节点的位置,为什么要这样呢, 根据二叉查找树的性质,父节点的指针一定比所有左子树的节点值大而且比右子树的节点的值小,为了删除父节点不破坏二叉查找树的平衡性, 应当把左子树最大的节点或者右子树最小的节点放在父节点的位置,这样的话才能维护二叉查找树的平衡性。(我是找的右子树的最小节点) */ template <class T> int BSTree<T>::remove(T data) { cout << "remove :" << data << endl; BSTNode<T>* node = getNode(data);// 这里要找到要删除的结点。 if(node) { showNode(node); if(node->parent == NULL)// 删除根结点 { // 这里选择的是把左子树接到右子树中key最小的那个结点的左结点上。还有一种是把右子树接到左子树的key最大的那个右结点上 BSTNode<T> *temp = minimum(node->right); if(temp) { temp->left = node->left; mRoot = node->right;// 要更新根节点 } delete node; node = NULL; return 0; } if((node->right == NULL) && (node->left == NULL)) // 删除叶子结点 { if(node->parent->left == node) { node->parent->left = NULL; } else { node->parent->right = NULL; } } else if(node->right && node->left) // 删除有两个子节点的 { BSTNode<T> *temp = minimum(node->right); // 获取后继结点,这个结点一定是没有左子树的。 cout << "have left and right child, mimmum :" << temp->key << endl; if(temp == temp->parent->left) // 后继结点如果是左结点,就将它的右子树接到它父亲的左子树中。 { temp->parent->left = temp->right; } else // 后继结点如果是右结点,就将它的右子树接到它父亲的右子树中。 { temp->parent->right = temp->right; } node->key = temp->key; // 把后继结点的key保存在要删除的结点中 delete temp; // 其实是删除的后继结点。 temp = NULL; } else // 删除只有一个只有一个子结点。 { if(node->right) // 有右子节点 { if(node->parent->left == node) { node->parent->left = node->right; } else { node->parent->right = node->right; } } else { if(node->parent->left == node) { node->parent->left = node->left; } else { node->parent->right = node->left; } } delete node; node = NULL; } } else { return -1; } return 0; } template <class T> void BSTree<T>::destory(BSTNode<T> *tree) { if(tree) { if(tree->left) destory(tree->left); if(tree->right) destory(tree->right); delete tree; tree = NULL; } } template <class T> void BSTree<T>::destory() { destory(mRoot); } #endif // __BSTREE_H__ 下面是测试代码: #include<iostream> #include"bstree.h" using namespace std; /* 可以插入相同的,会插入在右子树中。 */ void fun() { cout << "fun() +++ " << endl; int i = 0, len = 0; BSTree<int>* tree = new BSTree<int>; if(tree->mRoot == NULL) cout << "fun() mRoot is NULL" << endl; int arr[] = {2, 15, 4, 44, 30, 36, 50, 12, 55, 414}; int count = sizeof(arr)/sizeof(int); for(int i = 0; i<count; i++) { tree->insert(arr[i]); } tree->insert(125); tree->insert(5); tree->preOrder(); int maxkey = tree->maximum(); cout << "Max key = " << maxkey << endl; int minkey = tree->minimum(); cout << "Min key = " << minkey << endl; tree->remove(12); tree->remove(2); tree->preOrder(); //tree->print(); tree->destory(); cout << "fun() --- " << endl; } int main() { cout << "hello world" << endl; fun(); return 0; } 注意:上面只有bstree.h,没有bstree.cpp。 关于为何C++的模板类声明和实现要放在一起可以参考:http://www.cnblogs.com/xcywt/p/8039574.html

优秀的个人博客,低调大师

如何开发自己的搜索帝国之安装ik分词器

Elasticsearch默认提供的分词器,会把每个汉字分开,而不是我们想要的根据关键词来分词,我是中国人不能简单的分成一个个字,我们更希望 “中国人”,“中国”,“我”这样的分词,这样我们就需要安装中文分词插件,ik就是实现这个功能的。 elasticsearch-analysis-ik 是一款中文的分词插件,支持自定义词库。 现在开始安装ik分词器,安装之前,先说明一些变化: 之前可以在node节点上配置index默认的分词器,如果是多节点,那么在每个节点上都配置就行了。这个有点不灵活,所以。5.0之后,ES已经不再支持在elasticsearch.yml中配置分词器,改而在新建索引时,使用settings去配置,这个会在后面的编程中说到。 之前使用delete-by-query插件来实现type的整个删除。这个插件也是从5.0开始没有了,被整合到了ES的Core中 3.从5.0开始ik的tokenizer发生了变化,提供了两种,一种为ik_smart,一种为ik_max_word。直接一点,ik_max_word会尽量从输入中拆分出更多 token,而ik_smart则相反,个人感觉,ik_max_word就是原来的ik,ik_smart是新加的。 下载 有两种方式,一个是下载源码自己编译好后再上传到ES的插件库,第二种方法是直接下载编译好的上传。 1.源码安装 源码地址: https://github.com/medcl/elasticsearch-analysis-ik,git clone下来。 cd elasticsearch-analysis-ik mvn clean mvn compile mvn package 拷贝和解压release下的文件: #{project_path}/elasticsearch-analysis-ik/target/releases/elasticsearch-analysis-ik-*.zip 到你的 elasticsearch 插件目录, 如: plugins/ik 重启elasticsearch 2.安装编译版 直接下载elasticsearch-analysis-ik-5.3.0.zip,网站地址为: https://github.com/medcl/elasticsearch-analysis-ik/releases 只需要把elasticsearch-analysis-ik-5.3.0.zip解压,然后拷贝到ES安装目录下的plugins文件夹内,并把elasticsearch-analysis-ik-5.3.0文件夹名修改为ik。这样,就安装好了。正如前面说的,安装完插件,现在不需要在配置文件中配置了,需要在新建索引的时候指定分词器。 重启启动ES,可以看到如下log 用kibana查看一下,后续会谈到如何这样做。 至此ES+Kibana+IK安装好了。从2.4.1到5.X版本号跨度很大,很多地方也发生了很多变化,总体来说,更简便了。 配置IKAnalyzer.cfg.xml IKAnalyzer.cfg.xml在{conf}/analysis-ik/config/IKAnalyzer.cfg.xml或{plugins}/elasticsearch-analysis-ik-*/config/IKAnalyzer.cfg.xml中 <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd"> <properties> <comment>IK Analyzer 扩展配置</comment> <!--用户可以在这里配置自己的扩展字典 --> <entry key="ext_dict">custom/mydict.dic;custom/single_word_low_freq.dic</entry> <!--用户可以在这里配置自己的扩展停止词字典--> <entry key="ext_stopwords">custom/ext_stopword.dic</entry> <!--用户可以在这里配置远程扩展字典 --> <entry key="remote_ext_dict">location</entry> <!--用户可以在这里配置远程扩展停止词字典--> <entry key="remote_ext_stopwords">http://xxx.com/xxx.dic</entry> </properties> 热更新 IK 分词使用方法 目前该插件支持热更新 IK 分词,通过上文在 IK 配置文件中提到的如下配置 <!--用户可以在这里配置远程扩展字典 --> <entry key="remote_ext_dict">location</entry> <!--用户可以在这里配置远程扩展停止词字典--> <entry key="remote_ext_stopwords">location</entry> 其中location是指一个 url,比如http://yoursite.com/getCustomDict,该请求只需满足以下两点即可完成分词热更新。 该 http 请求需要返回两个头部(header),一个是Last-Modified,一个是ETag,这两者都是字符串类型,只要有一个发生变化,该插件就会去抓取新的分词进而更新词库。 该 http 请求返回的内容格式是一行一个分词,换行符用\n即可。 满足上面两点要求就可以实现热更新分词了,不需要重启 ES 实例。 可以将需自动更新的热词放在一个 UTF-8 编码的 .txt 文件里,放在 nginx 或其他简易 http server 下,当 .txt 文件修改时,http server 会在客户端请求该文件时自动返回相应的 Last-Modified 和 ETag。可以另外做一个工具来从业务系统提取相关词汇,并更新这个 .txt 文件。 官网例子测试 1.创建一个索引 curl -XPUT http://localhost:9200/index 2.创建一个mapping curl -XPOST http://localhost:9200/index/fulltext/_mapping -d' { "properties": { "content": { "type": "text", "analyzer": "ik_max_word", "search_analyzer": "ik_max_word" } } }' 3.录入数据 curl -XPOST http://localhost:9200/index/fulltext/1 -d' {"content":"美国留给伊拉克的是个烂摊子吗"} ' curl -XPOST http://localhost:9200/index/fulltext/2 -d' {"content":"公安部:各地校车将享最高路权"} ' curl -XPOST http://localhost:9200/index/fulltext/3 -d' {"content":"中韩渔警冲突调查:韩警平均每天扣1艘中国渔船"} ' curl -XPOST http://localhost:9200/index/fulltext/4 -d' {"content":"中国驻洛杉矶领事馆遭亚裔男子枪击 嫌犯已自首"} ' 4.查询 curl -XPOST http://localhost:9200/index/fulltext/_search -d' { "query" : { "match" : { "content" : "中国" }}, "highlight" : { "pre_tags" : ["<tag1>", "<tag2>"], "post_tags" : ["</tag1>", "</tag2>"], "fields" : { "content" : {} } } } ' 结果 { "took": 14, "timed_out": false, "_shards": { "total": 5, "successful": 5, "failed": 0 }, "hits": { "total": 2, "max_score": 2, "hits": [ { "_index": "index", "_type": "fulltext", "_id": "4", "_score": 2, "_source": { "content": "中国驻洛杉矶领事馆遭亚裔男子枪击 嫌犯已自首" }, "highlight": { "content": [ "<tag1>中国</tag1>驻洛杉矶领事馆遭亚裔男子枪击 嫌犯已自首 " ] } }, { "_index": "index", "_type": "fulltext", "_id": "3", "_score": 2, "_source": { "content": "中韩渔警冲突调查:韩警平均每天扣1艘中国渔船" }, "highlight": { "content": [ "均每天扣1艘<tag1>中国</tag1>渔船 " ] } } ] } } 参考官方的常见问题 1.自定义词典为什么没有生效? 请确保你的扩展词典的文本格式为 UTF8 编码 2.分词测试失败 请在某个索引下调用analyze接口测试,而不是直接调用analyze接口 如:http://localhost:9200/your_index/_analyze?text=中华人民共和国MN&tokenizer=my_ik 3.ik_max_word 和 ik_smart 什么区别? ik_max_word: 会将文本做最细粒度的拆分,比如会将“中华人民共和国国歌”拆分为“中华人民共和国,中华人民,中华,华人,人民共和国,人民,人,民,共和国,共和,和,国国,国歌”,会穷尽各种可能的组合; ik_smart: 会做最粗粒度的拆分,比如会将“中华人民共和国国歌”拆分为“中华人民共和国,国歌”。

优秀的个人博客,低调大师

阿里搜索业务容器化中的一些经验和思考

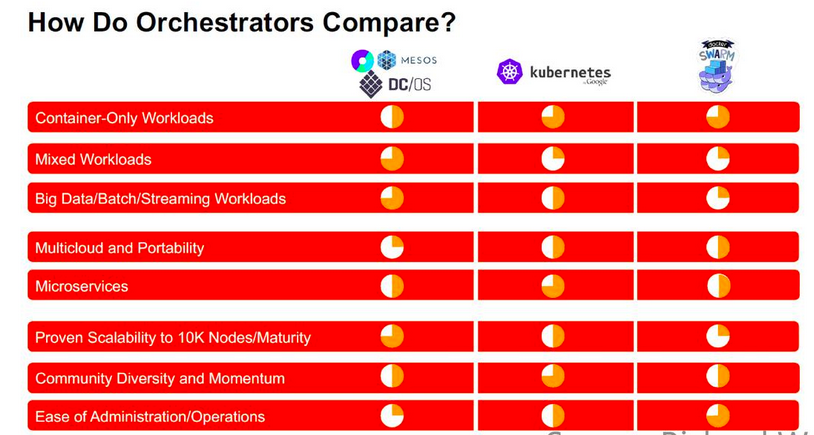
概要 参加了上一次CNUTCON 大会,有来自coreos的李响,分享了很多关于etcd的事情,以及关于k8s包括自己和coreos公司的一些观点;还有来自mesos的tim chen, 他分享了很多mesos的思路以及一些接入容器过程中踩过的一些坑;swarm kit的负责人陈东洛也分享了swarm的思路,这方面由于刚出来没多久以及分享的同学也只有他,所以东西并不多;总的来说,感触很深。 关于容器和编排,想到开源和创业 从会议分享者来看。相比去年,容器技术有了更大的发展;docker很热,每一个主题都在涉及docker。且基本上大家都认同docker的镜像。对于容器,虽然也有其他的一些选择,比如rkt,lxc等,但对于runtime以及接口,大家基本趋于一致,短期也不会期望有大的变化,大家开始从更高层次思考容器的应用,比如直接提供给用户编排的工具,服务或系统,而不是一个容器。swarmkit的发布就有这个意思,大家开始把重心转移到编排和调度。 从个人对容器的发展来看。大会上几位问到一些隔离的问题,分享嘉宾都说这个比较复杂,要么说这块他们没有解决,确实经常出问题,要么说私下来讨论;其实我们在接入和调度容器的时候,也发现了目前的容器技术在隔离上还欠缺很多,如果要能更好的提高物理机的资源利用率,降低成本,单机隔离和单机弹性将是一大关键技术和核心竞争力。 我们采用了跟mesos一样的架构和思路,因此我重点听了mesos相关的topic,希望是能够吸取到好的经验,能实际实施到我们的系统中,然后听了更多的k8s的topic。整体个人感觉,在开源解决方案中,k8s目前要热过mesos,k8s在web service这方面确实占据了很大的市场,吸引了很多开发者,但在有状态服务的应用特别是大数据上面目前并没有很好的解决方案,社区也一直在讨论和抽象当中。相反mesos在大数据服务场景下能够很好的解决,并在集群规模上也有很好的优势,但拿到mesos是不能直接解决用户的需求,需要用户写一个scheduler。swarm的思路则是另外一种哲学,或是另一个极端,跟docker的思路是同承一脉的,把更多的东西集成进系统里,提供给用户简单统一的接口,装好docker就可以编排调度了,这方面后续发展如何,很难说,暂且不论。总的来说,这一开源领域目前仍是K8s、Swarm、Mesos三足鼎立,近期也看不到谁会完全胜出。它们的功能比较如下图所示。 无论mesos这种2次调度,扩展性强的哲学,还是swarm kit这种集装箱式的哲学,其次是k8s先取其中,优先发展自己优势的思路。国外这种开源以及项目创业的一些共性值得我们思考和学习,这里举一个例子, coreos公司他们把他们的目标和使命定义为"secure the internet", 在zookeeper的发展满足不了他们需求的时候,他们能做出这么大的决定重新build一个如此大的项目,并且成功了,成为容器界基本都依赖的一个项目,这个勇气和思路值得学习。 我们的项目前身是hippo,跟google borg相似,采用自建的方式,借鉴了很多mesos的思路,但确没有使用mesos开源版本进行改进,与社区缺乏交流,不能共享mesos社区新的feature,也不能对开源进行影响;另外我们系统暂时也不能对国内技术全产生很大的影响,吸收群体的智慧有限,这是一大遗憾。都说开源是有利益目的的,你认同吗? 从mesos接入docker,想到hippo接入docker 为什么想到这个,实际上我们在接入的过程当中踩到了相同的坑,有的mesos解决的好,有的还没有解,可以作为后续改进的一个参考。 mesos和hippo容器化之路 (Containerizer) 容器接入的接口设计 我们团队关注docker很早,在hippo启动前就开始就关注docker。 14年我们直接用cgroup和namespace等标准的os feature完成了引擎进容器的demo,证明了隔离的可行性。 一直想完善我们的隔离,docker开始崭露头角,但docker在2.6.32内核上要跑到生产还不行,而t4在阿里在生产已经跑了一段时间,因此我们14年为了让混布,提高资源利用率,节省成本,选择了t4进行落地。 跟mesos一样,在容器技术没有完全统一的情况下,我们当时在设计的时候也考虑了支持不同的容器以及不同的隔离策略,以实现用户的定制需求和可插入性,或者可配置性。 mesos在最开始的时候,为了支持External Containerizer,定义了一套回调的脚本接口,用户可以在脚本里完成各个阶段的工作。但docker非常火,连k8s也在学习docker的接口设计理念,而且External Containerizer变得很难用,最终这种方式被废弃掉。 hippo是自建方案,有一个好处我们不需要考虑太多其他人的兼容性,这样我们在设计实现的时候,相对的在接口设计方面做得直接些,没有过度设计,从t4到docker基本上,对主体结构代码没有太多的侵入性。createInstance,destoryInstance,checkInstance几个简单的接口不论是什么容器,都适用。 现在的mesos,对docker是native integration。没有额外的setup。只需要docker daemon和docker client。可以说在这方面和hippo是殊途同归了。 容器接入踩了很多坑,还有很多未解决的 真的就是3个接口那么简单吗?mesos在接入docker的时候,在处理日志,recovery, tag containers, cgroup资源更新等等踩了很多坑。以docker update为例,docker在1.2以前是一直不支持的,且后续版本也支持的不够。 更能说明这个问题的是如果mesos自己跑在容器里,如何去更新其他容器的资源,因为这个时候已经chroot。mesos采用了一个跑在宿主机的docker exectute的代理(如图2)。这个方案我觉得比我们做的好,我们的pouch(阿里自研容器产品)把很多的逻辑直接做在了docker daemon,这样侵入性太高,跟踪最新的docker版本成本很高,无法及时享受修复的bug以及新的feature。 还讲到一些cgroup的坑,我们最近在升级7u的过程也踩到过。主要是systemd+docker+mesos。这三者都会涉及cgroup节点。在7u中,systemd管控了整个系统的资源。https://issues.apache.org/jira/browse/MESOS-3009 ,他们踩到一些坑复现后发现是docker创建的容器,systemd有在干预它的cgroup。hippo也踩到了这样的坑,对应的内存,cpu限制不住,我们的实际做法是通过采用cgroup driver为systemd,并在pouch里面通过systemd api来控制cgroup来避开这些冲突。 还有很多解决了的坑,暂且不论,还有很多我们未解决的坑,这些可能每一个都需要开一个topic去讨论,这里有兴趣的可以私下讨论。 docker会妨碍我们的容器发展吗? mesos的经验,docker相对比较重,在一台机器上跑很多的docker容器是会带来额外很多问题。 hippo希望做的更强大,希望能支持更多的离线和在线job,来提供资源利用率,最终降低成本。但有的场景需要很轻量级的容器,有的需要更强的隔离。比如,随着图像处理需求的增强,AR/VR的发展,对GPU的隔离需求会越来越强烈,如果我们一直等docker来提供这些feature来解决这些问题,肯定是不行的,这是一个很大的问题。因此,和mesos一样,hippo也需要考虑解决这个问题,因此可能如何支持不同级别的隔离是未来需要思考的。 容器里面跑容器 这个在集群调度中心群也集中讨论过这个问题,当时是为了解决case的资源问题,据部分同学说docker不支持这个。但mesos表态要支持这个,他们举了几个需求,这里讲一个。 一个是在跑CI(Jenkins)时,希望jenkins申请一个大的资源,然后jenkins分给跑在上面的case,tim说这样做是为了设计简单,感觉没有说到点子上,但估计他对这块不是很熟,但我们的场景有一点很明确,就是各二层测试的时候,需要部署hippo一层来创建出各类的异常case。这个时候就需要二层起的hippo跑在容器的容器里。 还有一个很重要的需求其实来源于pod。需要容器里跑容器,来进行更细粒度的资源控制,以及更灵活的调度。 How to solve utilization, fairness and performance when running all of these services at scale? 这才是最根本的问题,tee选择离开mesos,选择创业,需求也来源于此。 这个我们还在探索当中,大师从谷歌带回来的消息是,他们的cpu利用率超乎你的想象,我们还在探索当中,这里暂且不论。 其他 一口气写了这么多,零零碎碎,仅仅作为容器大会的一次观后作业。 整个2天下来,东西很多,对国内的这么大的分享也是第一次参加,会前并不太会选topic,所以会场里面的topic,有收获的,也有纯粹看热闹了,总体感觉国外请过来的嘉宾干货多,国内的广告多;国内张磊workshop专场讲k8s技术点以及发展还不错,ppt都在上面,大家可以下载下来看看,http://ppt.geekbang.org/cnutcon。 另外阿里新一代基础设施调度系统sigma正在如火如荼的统一所有资源池,后面我们也会在这方面分享对应的技术和思考。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册