首页 文章 精选 留言 我的

精选列表

搜索[趋势探讨],共10000篇文章
优秀的个人博客,低调大师

苹果内部正探讨收购 Mistral 和 Perlextity 可能性

据报道,苹果公司内部已就收购法国人工智能初创公司 Mistral 以及美国的 Perplexity 展开讨论。这一举措旨在增强其人工智能能力,以应对谷歌和三星等竞争对手的领先优势。​ 此前,苹果首席执行官蒂姆・库克在上个月暗示,公司对大规模人工智能相关收购持开放态度,以加速其人工智能发展路线图,这与苹果以往在并购方面的保守姿态有所不同。Mistral 在去年 B 轮融资后估值超过 60 亿美元,本月有报道称该公司正在洽谈以 100 亿美元估值筹集 10 亿美元资金。今年早些时候,彭博社也曾报道,苹果高管内部讨论过对 Perplexity 的潜在收购意向。​ 据《The Information》报道,苹果服务业务主管埃迪・库伊是收购人工智能公司以增强苹果产品实力的主要倡导者,他曾提议收购 Netflix 和特斯拉,但均被库克否决。而软件业务主管克雷格・费德里吉则对大规模人工智能收购持谨慎态度,他认为苹果有能力内部构建人工智能技术。 目前,苹果对这两起潜在收购仍存顾虑,因其可能涉及巨额资金,而苹果历史上极少有超亿美元的收购交易。若联邦裁决终止苹果与谷歌 200 亿美元的默认搜索引擎合作,苹果或更有动力收购人工智能搜索初创公司填补空缺。 截至目前,苹果、Mistral 和 Perplexity 均未对此置评。​

优秀的个人博客,低调大师

互联网高可用架构探讨 | 京东云技术团队

高可用指标与问题 高可用,英文单词High Availability,缩写HA,它是分布式系统架构设计中一个重要的度量。业界通常用多个9来衡量系统的可用性,如下表: 既然有可用率,有一定会存在不可用的情况。系统宕机一般分为有计划的和无计划的,有计划的如日常维护、系统升级等,无计划的如设备故障、突发断电等。我们对此作如下分类: 1.设备故障:机房断电、硬盘损坏、交换机故障。 2.网络故障:网络带宽拥堵、网络连接中断。 3.安全问题:利用系统漏洞进行网络攻击。 4.性能问题:CPU利用率太高、内存不足、磁盘IO过载、数据库慢SQL。 5.升级维护:由于业务变更或技术改进而引起的系统升级。 6.系统问题:分布式系统中存在服务的依赖而导致数据的不一致性,或是核心服务出现异常。 高可用主要手段 负载均衡 负载均衡(Load Balance),它将工作任务分发到多个工作单元上进行运行,它可以提高网络设备的带宽,提升网络数据处理能力,增强网络的稳定性。可防止机房断电、网络设备故障等问题。 负载均衡的实现可分为硬件负载与软件负载。硬件负载由专门的设备完成专门的任务,这种方式性能较高同时成本也高;软件负载通过软件代码实现,此种方式耗费操作系统资源,性能较低,容易出现BUG,也容易引起安全问题。 负载策略一般有轮询策略、随机策略、最小连接策略以及最短响应时间策略。 轮询策略:讲用户请求轮流分配给服务器,这种算法比较简单。 随机策略:随机选择一台服务器来执行任务。 最小连接策略:把请求分配给活动连接数最小的后端服务器。 最短响应时间策略:将请求分配给平均响应时间最短的服务器。 限流 限流就是避免服务过载,随着流量的提高,无论负载策略如何高效,系统的某个环节总会过载。就如木桶能装多少水取决于最短的那块木板,我们是无法保证系统的每个部分都保持同样的高吞吐量,因此要考虑如何优雅地提供有损服务。 常用的三种限流算法:计数器算法、滑动窗口算法、漏桶算法、令牌桶算法。 计数器算法:使用计数器在一定周期内累加某个接口的访问次数,当达到限流阈值时,触发限流策略,进入下一个周期后,重新开始计数。此算法较为简单,但会降低服务器的负载能力。 滑动窗口算法:将时间周期划分成更小的周期,按小周期来进行计数,根据时间滑动删除过期的小周期。这种算法使得周期划分得越小服务器的负载能力越高。 漏桶算法:将请求直接放入漏桶中,如果当前访问量超出漏桶的限流值,则把后来的请求予以丢弃,这样可以最大限度地提高服务器的负载能力。 令牌桶算法:以(时间周期/限流值)的速度向令牌桶里增加令牌,直到装满桶的容量,当请求到达时,分配一个令牌让其通过,如果没有获取到令牌则触发限流机制。 异步调用 异步调用一般有两种方式:一种是异步回调,一种是消息队列。消息队列方式也算是限流的一种手段,可以让请求一个一个地被处理,避免并发太高而引起的应用无法及时处理。这种方式相对与限流来讲,是一种无损的解决方案。但这种方案仅适用于非实时响应的业务。 超时重试与幂等设计 很多文章把超时重试与幂等设计分开来讨论,但我却认为它们是相辅相成,密切相关的。在设计超时重试时,一定要考虑幂等设计 超时重试机制:由于服务器宕机、网络延时、服务器线程死锁等原因,导致应用程序无法先限定时间内对服务调用方进行响应。因此当发生调用超时后,应用程序可根据调度策略进行重试。被调用的服务没有及时响应,可能会存在两种情况,一是服务内部发生异常,导致执行失败,没有返回任何消息;一是执行的服务耗时太长,没有及时响应,但实际已经执行成功。所以针对第二种情况要做幂等设计。 幂等设计:多次相同参数的请求对系统造成的作业都是相同的。常见的幂等方案有:MCVV多版本并发、唯一索引、token机制、悲观锁、状态机幂等、只读操作等。 降级与熔断 服务降级与服务熔断都是为了解决服务雪崩的问题,但不要把他们混为一谈,它们是有本质区别的。 降级是对系统的某个功能进行降级,可以只提供部分功能也可以完全停止该功能。降级一般由开关来进行控制,在不重启服务的情况下,对功能进行降级。它常常发生在高并发时段、机器卡顿、下游不太重要的服务异常等情况下。 熔断没有开关,它是一个框架级的设计,常常被称作断路器。它的主要作用是,当下游的服务因为某种原因变得不可用或服务不及时,为了保证整体服务的可用性,不再调用目标服务,直接返回默认处理或容错处理,从而使得整体服务可以快速响应。例如SpringCloud中的Hystrix。 降级与熔断的主要区别是手动与自动。降级主要是通过配置中心的热刷新功能,人为地对开关进行打开与关闭操作。而熔断则是根据事先设计好的策略,系统自动地根据策略来进行开关操作。但它们都是对功能进行关闭。 架构模式 主备模式 实际是一主多备,master负责提供读写服务,slave作为数据备份,一旦主机宕机,将其中一个备节点作为主节点。 主从复制 实际是一主多从,master对外提供读写服务,slave作为数据备份提供只读服务。主机定期复制数据给从机。多副本的关键问题是保证数据一致性,通常需要考虑数据同步延时的问题。 集群分片 集群分片是为了解决每台机器上存储全量数据的问题,面对大数据单机的存储量总是有上限的,当面对PB级数据时,单机是无法支撑的,因此就需要对数据进行分片。 异地多活 异地就是指在地理位置上不同的地方,可分为同城异地、跨城异地、跨国异地,多活就是指不同地理位置上的系统都能够提供服务。这种架构的复杂度较高,且部署成本也会提高。 设计原则: 1、 只把核心业务设计为异地多活,比如流量大、盈利高的业务 2、 保证核心数据的一致性与实时性,且可丢失、可恢复 3、 可采用多种数据同步的方案,比如存储系统同步、消息队列同步 4、 异地多活仅适用于大部分用户,以地区来论,覆盖主要城区 总结 在互联网架构设计中,高可用是必不可少的环节,要从网络架构、服务架构、数据架构以及软硬件架构等多方面来分析设计,是架构师必备的技能之一。 作者:京东零售 谷伟 来源:京东云开发者社区

优秀的个人博客,低调大师

探讨AIGC的崛起历程,浅析其背后技术发展

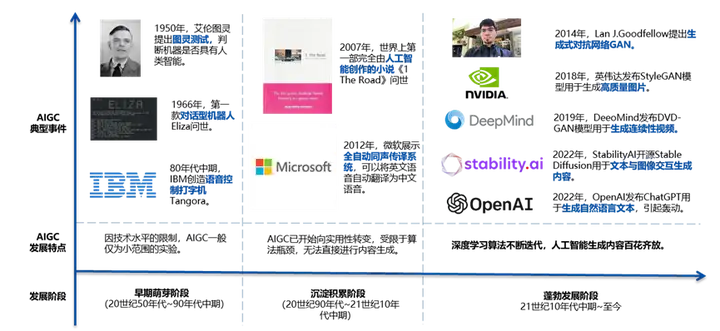
摘要:本文主要讨论了AIGC(人工智能生成内容)的发展历程、现状、应用,浅析其背后技术发展、与华为云的联系,以及面临的挑战和展望。 本文分享自华为云社区《AIGC:人工智能生成内容的崛起与未来展望》,作者:杜甫盖房子。 AIGC被认为是继专业生成内容(PGC)和用户生成内容(UGC)之后,利用人工智能技术自动生成内容的新型生产方式。随着技术的发展,如Stable Diffusion和ChatGPT等领先技术的出现,AIGC逐渐在文字、图像、音乐、视频、3D等多种形式内容的生产上发挥作用。然而,AIGC的快速发展同时也面临一系列挑战,包括技术、安全、合规等方面。因此,我们既要拥抱变化,也要直视挑战,以期在不久的未来,AIGC能够在更多领域大放异彩,开启云计算产业链新一轮的景气周期。 发展历程 AIGC(Artificial Intelligence Generated Content),国内产学研各界对它的理解是“继专业生成内容(Professional Generated Content,PGC)和用户生成内容(User Generated Content,UGC)之后,利用人工智能技术自动生成内容的新型生产方式”。 2022.09.23红杉美国发表了文章:《Generative AI: A Creative New World》,认为AIGC将带来新一轮的范式转移。2022.11.30 ChatGPT发布,用户飞速增长,AIGC走进了大众视野中。无论是技术工作者、内容生产工作者还是营销推广工作者,都应该对AIGC有一定的了解。 AI的发展大致可以划分为三个阶段,我们用一张图简单展示一下有关AICG的发展历程与典型事件: 参考:中国信息通信研究院 目前,AIGC正处于蓬勃发展的时期,大型企业加强投资布局,发布多领域的预训练模型,如谷歌发布了BERT、Imagen等模型,Facebook发布了OPT-175B、M2M-100等模型,微软投资OpenAI,发布了GPT4、Codex等模型,百度也在大模型领域深耕,发布了文心系列模型。此外,创业企业融资高涨,2022年10月,Stability AI获得约1亿美元融资,估值高达10亿美元,Jasper拿下1.25亿美元A轮融资,估值15亿美元。在应用侧,热点AIGC应用的用户数量呈指数级增长,例如ChatGPT用户破亿仅用了两个月。我们认为,AIGC 技术正逐渐渗透到人们的生活、工作场景中,AIGC技术发展与产业形态已初步形成,处于方兴未艾大有可为之时。 现状及应用 AIGC的发展依托于底层算力、算法的发展,从生成对抗网络(Generative Adversarial Network,GAN)开始,AI生成高质量内容的能力快速提升,一些具有代表性的算法模型的发展历程如下: 图源:《A Comprehensive Survey of AI-Generated Content (AIGC): A History of Generative AI from GAN to ChatGPT》 依托于这些算法,不同任务领域内涌现了一批预训练模型与应用: 从技术场景上看,AIGC逐步在文字、图像、音乐、视频、3D等多种形式内容的生产上发挥作用,在新闻稿、财报等结构化写作场景有较好的表现,在图像生成领域可以在细粒度上遵循人类指导完成指定主题内容的创作,如Copilot等生产力工具也纷纷涌现。 从更多的延展场景上看,AIGC可以有更广泛的应用,如合成数据,生成虚构但与目标场景保持一致属性的虚拟数据,从而避免AI一直为人诟病的数据偏见与隐私泄露问题;基于AIGC的虚拟陪伴也会带来更多的社会价值,已经有一些企业将人工智能技术应用到精神健康的数字诊疗服务上,为临床患者和广大心理亚健康人群提供高质量、低成本、个性化、全天候的情绪支持、心理咨询和干预方案。 技术浅析 这一波火爆的AIGC技术中,Stable Diffusion 开源模型与 ChatGPT 分别引领了图像与文本生成领域的热潮,AIGC也逐渐从简单的降本增效(如结构化写作)向创造额外价值(如AI绘画)转移,我们将对这两个模型的发展与其中涉及到的图像与文本相关技术进行简单介绍。 Stable Diffusion AI绘画在过去的一年中一直是AIGC领域的热点话题,随着Stable Diffusion的开源,众多不同风格的模型纷纷涌现。而高效参数微调方法LoRA与精细控制生成内容的ControlNet的发布,更进一步让AI绘画发展为产业可用的解决方案。 Stable Diffusion从实现原理上,可以通俗的理解为这几步: 为了提升模型训练推理效率,捕捉高维信息,Stable Diffusion首先使用图像编码器,将图像从像素空间压缩到低维度的潜在空间; 使用如CLIP的文本编码器,将描述文本转换为文本向量; 在低维度的潜在空间中,基于一些条件(如文本向量)进行Diffusion过程; 使用图像解码器将潜在空间中的向量转换回像素空间来生成最终图像。 图源:《The Illustrated Stable Diffusion》 我们对Stable Diffusion中涉及两个关键概念:CLIP与Diffusion进行简单解释: CLIP(Contrastive Language–Image Pre-training)是 OpenAI 在 2021 年提出的图文对训练的多模态模型,可以通俗的理解,CLIP可以判断图片和文本的相似度。预训练的CLIP模型拥有建立文本潜在空间与图片潜在空间对应关系的能力,使用CLIP对文本进行编码可以实现文字描述控制图像生成的需求。 Diffusion Model是 AI 绘画中非常常用的模型,在训练过程中,正向过程通过随时间逐步向图片中加噪的方式,让图片变成纯噪点图;逆向过程则是学习如何将一张噪点图恢复为高清图。在推理时,网络会随机初始化一个噪声向量,训练好的Diffusion Model在条件向量(如文本向量)的控制下逐渐恢复出图像向量,再通过图像解码器恢复为像素图像。 ChatGPT ChatGPT (GPT,Generative Pre-training Transformer) 是一个能够理解人类语言并做出相应反应的人工智能系统,在ChatGPT发布之前,GPT系列大模型已经经过几轮迭代。 然而,之前的模型中存在一个典型的对齐问题,即大模型生成的响应不一定符合用户意图。产生问题的原因是,从本质上讲,语言模型训练的目标是预测下一个词,而不是按照用户意图来生成。为了解决这个问题,在ChatGPT的训练过程中引入了基于人类反馈的强化学习(Reinforcement Learning from Human Feedback,RLHF)方法,通过手动收集反馈数据 -> 训练奖励模型 -> 强化学习的训练流程提升了模型理解人类思维的准确性,可以通过一个简单的图示来展示这一训练过程: ChatGPT多数令人惊艳的行为,如响应人类指令,利用思维链进行复杂推理等都是RLHF的产物 。 参考:How does GPT Obtain its Ability? Tracing Emergent Abilities of Language Models to their Sources ChatGPT的成功,在技术上可以给我们带来几点启示: 细致的数据工程是模型成功必不可少的工作; 监督微调和强化学习是矫正模型生成内容的关键技术。 AIGC与华为云 目前,AIGC的市场结构可以粗略的划分如下: AIGC与云联系紧密,AIGC应用依托于大模型的能力构建,而大模型的开发与运行都依赖云侧充足的算力。以ChatGPT为例,根据OpenAI报告, ChatGPT是在InstructGPT 基础上微调而来,参数量约13亿,因此预计ChatGPT训练所需算力为27.5PFlop/s-day,如果用NVIDIA V100训练需要220天。可见,AIGC应用浪潮对算力的需求是前所未有的,这将迅速拉动云计算需求。知名投资机构a16z在报告中阐述,几乎所有的AIGC相关应用都或多或少依赖云端的算力,因此a16z预测AIGC市场的大量资金最终流向了基础设施公司,平均来说,AIGC应用开发公司将大约20-40% 的收入用于模型推理与微调,而这部分通常直接支付给算力提供的云厂商。 算力作为AIGC的重要支撑,是影响AIGC发展的核心要素;除此之外,构筑在算力底座上的AI平台,又能直接影响AIGC应用的开发和运行效率。华为云拥有全栈全场景的AI能力,基于鲲鹏、昇腾的算力底座,提供了稳定高效的AI开发平台ModelArts,从数据处理到模型训练、模型推理,可以大幅提升AI开发效率。 此外,在ModelArts的资产社区AI Gallery中,也有很多AIGC相关的低门槛案例,如一键运行的AI作画案例,已有18,000+的累计运行: 如果对AIGC感兴趣可以到AI Gallery体验相关案例。 挑战及展望 随着AIGC的快速发展,一些问题也逐渐浮现。在技术上,目前语言模型是基于统计的,这一机制导致回答偏差的存在,进而导致虚假信息传播的法律风险;数理领域中的生成内容错误较多,无法应用到银行、医院等专业性强的领域;模型仍不可解释与不可控,可能存在后门攻击、数据中毒、训练数据泄露等问题。在安全合规上,AIGC模型在训练过程中的数据使用合规问题、生成内容的知识产权问题,甚至是训练推理过程中带来的碳排放问题等,仍然存在很多挑战。 身处人工智能的下一个时代,我们不仅要拥抱变化,也要直视挑战。在技术方面,如何理解大模型的基本工作机制对模型安全与继续发展至关重要;除此之外,大模型训练与迁移流程优化是AI走向通用人工智能的关键。在技术发展的同时,AIGC的合规与治理应该引起重视。相信在不久的未来,AIGC将在更多领域大放异彩,也将开启云计算产业链新一轮的景气周期。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

深入探讨 Room 2.4.0 的最新进展

在 Google I/O 2019,我们分享了 Room 2.2 的最新进展。尽管当时已经支持了很多功能,如 支持 Flow API,支持预填充数据库,支持一对一及多对多数据库关系,但是开发者们对 Room 有着更高的期望,我们也致力于此,在 2.2.0 - 2.4.0 版本中发布了很多开发者们期待的新功能!包括自动化迁移,关系查询方法以及支持 Kotlin Symbol Processing (KSP) 等等。下面我们就来逐一介绍这些新功能! 如果您更喜欢通过视频了解此内容,请 点击此处 查看。 自动化迁移 在谈自动化迁移之前,先看看什么是数据库迁移。假如您更改了数据库 schema,就需要根据数据库版本进行迁移,以防用户设备内置数据库中现有数据丢失。 如果您使用 Room,那么在 数据库迁移 过程中会进行检查并验证更新后的 schema,另外您也可以在 @Database 中设置 exportSchema,来导出 schema 信息。 对于 Room 2.4.0 版本之前的数据库迁移,您需要实现 Migration 类,并在其中编写大量复杂冗长的 SQL 语句,来处理不同版本之间的迁移。这种手动迁移的形式,非常容易引发各种错误。 现在 Room 支持了自动迁移,让我们通过两个示例来对比手动迁移和自动迁移: 修改表名 假设有一个包含两个表的数据库,表名分别是 Artist 和 Track,现在想要将表名 Track 改为 Song。 如果使用手动迁移,必须编写和执行 SQL 语句才能更改,需要如下操作: val MIGRATION_1_2: Migration = Migration(1, 2) { fun migrate(database: SupportSQLiteDatabase) { database.execSQL("ALTER TABLE `Track` RENAME TO `Song`") } } 如果使用自动迁移,您只需要在定义数据库时添加 @AutoMigration 配置,同时提供两个版本数据库导出的 schema。Auto Migration API 将为您生成并实现 migrate 函数,编写并执行迁移所需的 SQL 语句。代码如下: @Database( version = MusicDatabase.LATEST_VERSION entities = {Song.class, Artist.class} autoMigrations = { @AutoMigration (from = 1,to = 2) } exprotSchema = true ) 修改字段名 现在,演示一个更复杂的场景,假设我们要将 Artist 表中的 singerName 字段修改为 artistName。 虽然这看起来很简单,但是由于 SQLite 并没有提供用于此操作的 API,因此我们需要根据 ALERT TABLE 实现,有如下几步操作: 获取需要执行更改的表 创建一个新表,满足更改后的表结构 将旧表的数据插入到新表中 删除旧表 把新表重命名为原表名称 进行外键检查 迁移代码如下: val MIGRATION_1_2: Migration = Mirgation(1, 2) { fun migrate(db: SupportSQLiteDatabase) { db.execSQL("CREATE TABLE IF NOT EXISTS `_new_Artist`(`id` INTEGER NOT NULL, artistName` TEXT, PRIMARY KEY(`id`)" ) db.execSQL("INSERT INTO `_new_Artist` (id,artistName) SELECT id, singerName FROM `Artist`" ) db.execSQL("DROP TABLE `Artist`") db.execSQL("ALTER TABLE `_new_Artist` RENAME TO `Artist`") db.execSQL("PRAGMA foreign_key_check(`Artist`)") } } 从上面的代码就可以看出,如果使用手动迁移,即使两个版本之间仅有一处更改,也可能需要繁琐的操作,并且这些操作极易出错。 那我们来看看自动迁移该如何使用。在上面的示例中,自动迁移无法直接处理重命名表中的某一列,因为 Room 在进行自动迁移时,会遍历两个版本的数据库 schema,通过比较来检测两者之间的更改。在处理列或者表的重命名时,Room 无法明确发生了什么更改,此时可能有两种情况,是删除后新添加的?还是进行了重命名?处理列或者表的删除操作时也会有同样问题。 所以我们需要给 Room 添加一些配置来说明这些不确定的场景——定义 AutoMigrationSpec。AutoMigrationSpec 是定义自动迁移规范的接口,我们需要实现该类,并在实现类上添加和修改相对应的注解。本例中,我们使用 @RenameColumn 注解,并在注解参数中,提供表名、列的原始名称以及更新后的名称。如果在迁移完成之后,还需要执行其他任务,可以在 AutoMigrationSpec 的 onPostMigrate 函数中进行处理,相关代码如下: @RenameColumn( tableName = "Artist", fromColumnName = "singerName", toColumnName = "artistName" ) static class MySpec : AutoMigrationSpec { override fun onPostMigrate(db: SupportSQLiteDatabase) { // 迁移工作完成后处理任务的回调 } } 完成 AutoMigrationSpec 的实现后,还需要将其添加到数据库定义时配置的 @AutoMigation 中,同时提供两个版本的数据库 schema,Auto Migration API 将生成和实现 migrate 函数,配置代码如下: @Database( version = MusicDatabase.LATEST_VERSION entities = {Song.class, Artist.class} autoMigrations = { @AutoMigration (from = 1,to = 2,spec = MySpec.class) } exprotSchema = true ) 上面的案例提到了 @RenameColumn,相关的变更处理注解有如下几种: @DeleteColumn @DeleteTable @RenameColumn @RenameTable 假设在同一迁移中有多个更改需要配置,我们还可以通过这些可复用的注解简化处理。 测试自动迁移 假设您在一开始就使用了自动迁移,现在希望测试其是否正常工作,可以使用现有的 MigrationTestHelper API 无需任何更改。如以下代码: @Test fun v1ToV2() { val helper = MigrationTestHelper( InstrumentationRegisty.getInstrumentation(), AutoMigrationDbKotlin::class.java ) val db: SupportSQLiteDatabase = helper.runMigrationsAndValidate( name = TEST_DB, version = 2, validateDroppedTables = true ) } 在无需额外配置的情况下,MigrationTestHelper 将自动运行并验证所有自动迁移。在 Room 内部,如果存在自动迁移,它们将自动添加到需要运行和验证的迁移列表中。 需要注意的是,开发者提供的迁移具有更高的优先级,也就是说,如果您定义自动迁移的两个版本之间,已经定义了手动迁移,那么手动迁移将优先于自动迁移。 关系查询方法 关系查询也是新增的一个重要功能,我们还是用一个示例说明。 假设我们使用与之前相同的数据库和表,现在表名分别为 Artist 和 Song。如果我们希望获得音乐人到歌曲的映射集合,就要在 artistName 和 songName 之间建立关系。如下图中 Purple Lloyd 与其热门歌曲《Another Tile in the Ceiling》和《The Great Pig in the Sky》匹配,AB/CD 将与其热门歌曲《Back in White》和《Highway to Heaven》匹配。 使用 @Relation 如果使用 @Relation 和 @Embedded 反应该映射关系,则有如下代码: data class ArtistAndSongs( @Embedded val artist: Artist, @Relation(...) val songs: List<Song> ) @Query("SELECT * FROM Artist") fun getArtistsAndSongs(): List<ArtistAndSongs> 在此方案中,我们创建了全新的 数据类,将音乐人和歌曲列表相关系。但是这种额外创建 data 类的方式,容易造成代码繁冗的问题。而 @Relation 中并不支持过滤、排序、分组或组合键,其设计初衷也是用于数据库中只有一些简单的关系,虽然受限于关系结果,但这是一种快速完成较简单任务的便捷方法。 所以为了支持复杂关系的处理,我们并没有扩展 @Relation,而是希望您充分发挥 SQL 的潜能,因为它的功能非常强大。 接下来让我们来看看 Room 如何利用全新的功能来解决这一问题。 使用全新关系查询功能 为了表示前面所示的音乐人与其歌曲之间的关系,我们现在可以编写一个简单的 DAO 方法,其返回类型为 Map,而我们需要做的仅仅是提供 @Query 和返回标记,Room 将为您处理其余的一切!相关代码如下: @Query("SELECT * FROM Artist JOIN Song ON Artist.artistName = Song.songArtistName") fun getAllArtistAndTheirSongsList(): Map<Artist, List<Song>> 在 Room 内部,实际上要做的是找到音乐人、歌曲和 Cursor 并将它们放入 Map 中的 Key 和 Value 中。 在本例中,涉及到一对多的映射关系,其中单个音乐人映射到一个歌曲集合。当然我们也可以使用一对一映射,如下文所示: // 一对一映射关系 @Query("SELECT * FROM Song JOIN Artist ON Song.songArtistName = Artist.artistName") fun getSongAndArtist(): Map<Song, Artist> 使用 @MapInfo 实际上,您可以通过 @MapInfo 在映射的使用中更加灵活。 MapInfo 是用于说明开发者配置的辅助程序 API,类似于前面谈到的自动迁移更改注解。您可以使用 MapInfo 明确说明您希望如何处理查询到的 Cursor 所包含的信息。使用 MapInfo 注解您可以指定输出的数据结构中用于查询的 Key 和 Value 所映射的列。需要注意,用于 Key 的类型必须实现 equals 和 hashCode 函数因为这对映射过程非常重要。 假设我们希望以 artistName 作为 Key,获得歌曲列表作为 Value,则代码实现如下: @MapInfo(keyColumn = "artistName") @Query("SELECT * FROM Artist JOIN Song ON Artist.artistName = Song.songArtistName") fun getArtistNameToSongs(): Map<String, List<Song>> 在该示例中,artistName 用作 Key,音乐人被映射到其歌曲名称列表,最后 artistName 被映射到其歌曲名称列表。 MapInfo 注解使您可以灵活地使用特定列,而不是整个 data 类从而进行更加自定义的映射。 其他优势 关系查询方法的另一个好处是支持更多的数据操作,可以通过这个新功能来支持分组、筛选等功能。示例代码如下: @MapInfo(valueColumn = "songCount") @Query(" SELECT *, COUNT(songId) as songCount FROM Artist JOIN Song ON Artist.artistName = Song.songArtistName GROUP BY artistName WHERE songCount = 2 ") fun getArtistAndSongCountMap(): Map<Artist, Integer> 最后需要注意多重映射是一个核心返回类型,可以使用 Room 已经支持的各种可观察类型封装 (包括 LiveData、Flowable、Flow)。因此,关系查询方法可让您轻松地在数据库中定义任意数量的关联关系。 更多新功能 内置 Enum 类型转换器 现在,如果系统未提供任何类型转换器,Room 将默认使用 "枚举 - 字符串" 双向类型转换器。如果已存在适用于枚举的类型转换器,Room 将优先使用该转换器,而不使用默认转换器。 支持查询回调 现在,Room 提供了一个通用 callback API RoomDatabase.QueryCallback,此 API 会在执行查询时被调用,这将非常有助于我们在 Debug 模式下记录日志。可通过 RoomDatabase.Builder#setQueryCallback() 设置此回调。 如果您希望记录查询以了解数据库中发生了什么,该功能可以帮助您进行记录,示例代码如下: fun setUp() { database = databaseBuilder.setQueryCallback( RoomDatabase.QueryCallback{ sqlQuery, bindArgs -> // 记录所有触发的查询 Log.d(TAG, "SQL Query $sqlQuery") }, myBackgroundExecutor ).build() } 支持原生 Paging 3.0 API Room 现在支持为返回值类型为 androidx.paging.PagingSource 且带 @Query 注解的方法生成实现。 支持 RxJava3 Room 现在支持 RxJava3 类型。通过依赖 androidx.room:room-rxjava3,您可以声明返回值类型为 Flowable、Single、Maybe 和 Completable 的 DAO 方法。 支持 Kotlin Symbol Processing (KSP) KSP 用于替代 KAPT,它能够在 Kotlin 编译器上以原生方式运行注解处理器,从而显著缩短构建时间。 对于 Room,使用 KSP 有如下好处: 提高 2 倍的构建速度; 直接处理 Kotlin 代码,更好的支持空安全。 随着 KSP 的稳定,Room 将使用其功能实现 value 类、生成 Kotlin 代码等。 从 KAPT 迁移到 KSP 非常简单,只需使用 KSP 插件替换 KAPT 插件,并使用 KSP 配置 Room 注解处理器,示例代码如下: plugins{ // 使用 KSP 插件替换 KATP 插件 // id("kotlin-kapt") id("com.google.devtools.ksp") } dependencies{ // 使用 KSP 配置替代 KAPT // kapt "androidx.room:room-compiler:$version" ksp "androidx.room:room-compiler:$version" } 总结 自动化迁移、关系查询方法、KSP——Room 带来了很多新功能,希望大家和我们一样对所有这些 Room 更新感到兴奋,记得查看并开始在您的应用中使用这些新功能! 欢迎您 点击这里 向我们提交反馈,或分享您喜欢的内容、发现的问题。您的反馈对我们非常重要,感谢您的支持!

优秀的个人博客,低调大师

从 DevOps 到 NoOps,Serverless 技术的落地方式探讨

Serverless 技术正以一种全新的方式,帮助云上客户进一步节省云的使用成本,实践 NoOps 理念,同时,他也正深刻变革着开发者们的编程模式,所谓“Write locally, compile to the cloud”。 本文将介绍 Serverless 技术来降低云的使用成本和提升运维效率的业务背景和由来,并结合 Serverless 应用引擎(SAE)这款产品来呈现 Serverless 技术的落地方式。 云上业务开发和运维现状 目前,很多客户的上云仍处于资源云化的阶段,以降低资源购置成本为主要驱动力,应用运行在到虚拟化环境中,应用的开发和运维还需要消耗大量的人力。 如上图,在这种模式下,客户除了要完成业务逻辑开发外,还需要完成以下工作: 评估系统容量:包括系统总访问量、平均访问量、压测找出单机 QPS、线上冗余情况等等,整个容量评估工作是一个十分复杂的过程; 准备基础设施:包括网络拓扑规划,以及ECS 虚拟机资源、外网访问入口SLB、存储资源RDS、NAT等云产品的购买; 应用部署:对虚拟机资源进行初始化,需要手动或自建自动化部署流程完成应用部署;如果是微服务形态的应用,还需要考虑注册中心和服务之间的依赖关系管理; 系统运维:需要进行系统监控、应用监控,并对异常情况报警,并自建运维体系和运维工具。 痛点分析 系统上线后,随着用户越来越多,系统承载的流量也会越来越大。流量可能会出现规律性的波峰和波谷,也有可能会出现突发大流量的场景,当流量陡增将要或已经超出系统承受能力时,需要系统扩容,而扩容是需要按照容量评估、准备云上资源、应用部署几个流程重新操作一遍,效率较低,可能扩容完成时流量波峰已经过去了,还有可能出现因系统资源不足而造成的系统不可用。当系统流量再正常到正常水位,又会出现资源利用率低的问题,再相应的进行缩容,但缩容的时机很难把握,势必会造成一定的闲置资源的浪费。 那我们期望的系统反馈是什么样的呢? 如上图,我们期望的是,资源需求和实际的资源使用量走势能有一个很好的拟合,能够从容应对突发流量,并且能够有效降低闲置资源成本。为了达到这个目标,系统需要具备哪些能力呢? 实时监控和数据分析:做到按需弹性,首先需要对把系统运行和应用运行状态监控起来,并具备监控数据的分析能力; 弹性策略设置:提供可配置的弹性策略,并根据应用运行情况设置进行合理的设置; 秒级弹性:基于监控数据分析和弹性策略设置,系统可以实现自动弹性的能力,弹性能力越强越好,能达到秒级弹性; 细粒度计量:上云的目标是降成本、提效率,因此需要配置细颗粒度的计量计费能力,支持小规格的计算资源配置才能真正达到降本的目的; 应用实例能够自动水平扩缩:上面介绍的几种能力都是基于一个前提,应用实例能够自动水平扩缩,这需要应用实例是无状态的或者系统自动维护应用的状态。 上面的几点分析可以提取几个关键词:按需弹性、细粒度计费、实时监控,这正是我们今天需要讨论的 serverless 技术所需要解决的问题,接下来我们看下阿里云现有的4个 serverless 产品形态。 阿里云的 Serverless 产品形态 ECI/Serverless Kubernetes:是面向容器的 Serverless Container,应用的载体是容器镜像,灵活性好,配合调度系统可以支持各种类型应用,无需管理底层基础架构。 函数计算:是面向函数的 Function as a Service,提供了事件驱动的编程方式,用户只需实现函数的处理逻辑,开发效率很高;按照调用量计费,可以根据业务流量平滑调整计算资源,采用 FaaS 最大的挑战是需要改变应用架构和开发交付模型。 Serverless 应用引擎(SAE):是面向应用的 Serverless 产品,用户不需要要改变应用架构和开发交付模型,只需提供应用实现,无需管理底层计算资源。SAE 提供了优化的弹性策略、支持秒级计费,并且提供了丰富的服务治理能力,可以方便地实现服务的灰度发布、熔断、降级,并与现有CI/CD系统集成。 什么是阿里云Serverless 应用引擎(SAE) Serverless 应用引擎(SAE)基于神龙裸金属服务器和 ECI 计算资源构建 Kubernetes 集群平台,并实现了多租户管理,在 Runtime 层实现了应用生命周期管理、发布策略管理、弹性伸缩、微服务管理等能力。简单讲,就是面向微服务和其他在线负载提供 Serverless 技术的落地方案。 如上图,SAE 为主流的微服务框架的应用提供了 Serverless 应用托管能力,包括 Spring Cloud、Apache Dubbo 或者阿里云 HSF 框架等,支持多种部署渠道,包括UI、云效、插件等,支持多种部署方式,包括WAR、JAR、镜像等。对于单体应用和采用 Spring Cloud、Dubbo、HSF框架开发的 Java 应用,SAE 支持零代码改造,即可完成迁移。 多租户应用托管能力实现 SAE 基于 Kubetnetes 集群对多用户提供应用托管能力,那 SAE 如何实现多租管理的呢?对于租户的隔离,主要有4个方面,包括系统隔离、数据隔离、服务隔离和网络隔离: 系统隔离:基于安全沙箱容器技术的应用运行时环境,拥有独立的内核,能够提供多租户环境下对系统调用、内核的隔离能力; 数据隔离:安全容器启动时,通过 devicemapper 在宿主机上提供一个独占的存储空间作为 rootfs; 服务隔离:SAE 命名空间是逻辑隔离环境,和微服务级别租户信息(例如T1、T2、T3)绑定,与 K8S 中 namesapce 一一对应,微服务租户信息下发到 K8S Secret 中保存; 网络隔离:SAE 命名空间和唯一的 VPC 绑定,底层通过 ENI 网卡打通同一个VPC 网络,实现不同用户的 POD 属于不同网络平台,并且 POD 和宿主机属于不同网络平面,VPC 实现用户专属网络隔离。 核心优势-免IaaS运维 用户只需对网络进行规划,无需管理底层计算资源,完成业务开发后,可以直接通过程序包或者镜像部署应用,极大提高用户开发和运维效率;SAE 对接了多个云产品,如SLB、SLS、NAT等,在应用部署时可以选择使用,可以一站式支持流量访问、日志收集、存储等能力。 核心优势-弹性能力 SAE 支持定时弹性和指标弹性功能,定时弹性适用于资源画像有周期性的应用场景,多用于证券、医疗、政府、教育等行业;指标弹性目前支持 CPU 和内存指标弹性,适用于有突发流量或典型脉冲的应用场景,多用于互联网、游戏、社交平台等行业。 核心优势-一键启停开发测试环境 企业开发测试环境一般晚上不使用,但需要长期保有应用实例,闲置资源成本高。使用 SAE 一键启停功能能够高效管理开发测试环境,按需释放闲置资源,做到节省成本。 产品数据 容器启动时长为20s:支持突发场景快速扩容,启动时长指的是 100M 大小的镜像从Pull image 到容器正常启动的耗时,不含应用启动时间。 最小实例规格为0.5C1G:支持细粒度资源诉求,0.5C1G 建议用在开发测试环境中; 多套环境按需启停,成本可以节省47%~57%:按一套环境 5 台 ECS 每天使用 8 小时,分别针对 ECS 按量付费和包年包月两种情况计算来对比资源成本,方案详情可以查看。 运维体验 ECS 应用部署方案和使用 SAE 进行应用托管方案在运维方面的对比如下: 欢迎加入 SAE 的用户交流钉钉群:23198618

优秀的个人博客,低调大师

探讨 Git 代码托管平台的若干问题 - 2019 版

关于 Git 版本控制软件种类繁多,维基百科收录的最早的版本控制系统是 1972 年贝尔实验室开发的 Source Code Control System。1986 年 Concurrent Versions System(CVS) 诞生,CVS 曾非常流行,但今时用之寥寥无几,不过 OpenBSD 仍在使用 CVS。2000 年 CollabNet 创建了 Subversion 项目,2009年,Subversion 被 Apache 基金会接受成为顶级项目并被命名为 Apache Subversion。2005 年 Linus Torvalds 创建了 Git,2007 Github 诞生后,Git 随着 Github 的发展愈发流行,14 年间,Git 成为了最流行的版本控制系统,无论是 Windows 还是 Linux 或是 Android,MySQL 等等大型软件都使用 git 进行版本控制。纵观版本控制系统流行史,前有 CVS 后有 SVN,今日 Git 更风流。俱往矣,数风流人物,还看今朝,版本控制系统莫不如斯。 与 CVS/Subversion 这种集中式版本控制系统不同的是,Git 的存储库数据会被存储在本地,提交也是发生在本地,远程可以看作是本地存储库的一个镜像。而 CVS/Subversion 的提交都是在线的。这就是分布式版本控制系统的核心特征。(理解这一问题的关联在于区分工作树 worktree 和存储库 repository。) Git 的源码托管在 git.kernel.org 上,Github 上也有只读镜像 github.com/git/git。Git 主页 https://git-scm.com 的网页源码则托管在 Github 上。通常给 git 提交 PR 需要注册 public-inbox.org 邮件列表,然后发送补丁。者通常比较麻烦,好在有微软开发者Johannes Schindelin 使用 TypeScript 开发 gitgitgadget ,当你在 Github 上像 gitgitgadget/git 提交 PR 时,gitgitgadget 会将你的 PR 发送到 public-inbox,一旦补丁被 git 维护者接受,gitgitgadget 则会关闭那个 PR。gitgitgadget 简化了给 git 贡献代码的难度,省去了注册 Inbox 的麻烦,这年头开发者大多都有 Github 帐号。我就使用 gitgitgadget 给 git 提交了一个补丁用于支持 HTTP/2。 Johannes Schindelin 此人也是 git-for-windows 的维护者。 Git 的维护者则是 Google 的开发者 Junio C Hamano。大多数 Git 开发者来自于 Google/Microsoft(包括 Github)。libgit2 的开发者主要来自 Microsoft(包括 Github)。而 JGit 的开发者则主要来自 Google。已故 JGit 的创始人 Shawn Pearce 还开发了著名的 Gerrit Code Review。这些开发者的无私奉献才能使我们用上这么优秀的版本控制系统,感谢他们的付出。 Git 与远程存储库之间的传输协议有 HTTP, GIT(git://),SSH. 在 《Pro Git - 2nd Edition》4.1 Git on the Server - The Protocols 中有介绍。其中 HTTP 协议包括哑协议和智能协议,由于哑协议是只读协议,目前大多数代码托管平台均不再提供支持。HTTP 智能协议和 GIT 协议,SSH 协议类似,都是特定几组 客户端/服务端 git 命令之间的输入输出数据传输和交换。Git 传输协议较为简单,以智能传输协议 v1 为例,基本的 fetch/push 流程如下: Git 拉取流程: Git 推送流程: 虽然在 2018 年 5 月,git 推出了 Wire Protocol(即 Git v2 协议),增加了 Git 协议的复杂性,但在服务器上支持 git 协议(包括 v2 协议)仍然只需要在服务器上运行 git-upload-pack/git-receive-pack。这使得开发者很容易实现对 git 协议的支持。正因为 Git 协议表征的简单,所以针对不同的用户和存储库数量规模,Git 也都比 Subversion,Mercurial 有更多的选择。 Git 使用文件快照记录文件变更,当对象存储到松散文件目录时,每一次大小不变的文件修改相当于存储库中增加特定文件的大小,Git 使用 zlib deflate 压缩对象,对象头包括对象类型,原始大小。基于快照的方式使得 Git 在提交代码,检出文件时都比较高效,但存储库的占用缺比较高。但运行 git gc 时,Git 会将松散的对象打包到 pack 文件中,这个时候会使用特定的机制存储一部分文件的 OFS_DELTA,这样就能节省一部分空间。 zlib(deflate) 压缩算法通常来说除了没有版权限制,无论是压缩比还是速度,CPU 使用率都不是一个最佳的选择,引用来自的 https://github.com/facebook/zstd 基准测试,zlib 看起来必后起之秀 brotli/zstd 差多了: Compressor name Ratio Compression Decompress. zstd 1.4.0 -1 2.884 530 MB/s 1360 MB/s zlib 1.2.11 -1 2.743 110 MB/s 440 MB/s brotli 1.0.7 -0 2.701 430 MB/s 470 MB/s quicklz 1.5.0 -1 2.238 600 MB/s 800 MB/s lzo1x 2.09 -1 2.106 680 MB/s 950 MB/s lz4 1.8.3 2.101 800 MB/s 4220 MB/s snappy 1.1.4 2.073 580 MB/s 2020 MB/s lzf 3.6 -1 2.077 440 MB/s 930 MB/s 当开发者要将 git 集成到其他软件或者系统中时,可以通过命令行调用 git 命令捕获输出,也可以使用 libgit2/JGit 等库。 libgit2 最初是由 Shawn Pearce 创建了初始 commit。目前主要维护者来自微软。libgit2 提供一些基础的 API,功能基本上是完整的,除了一部分实现性能没有 git 那么好,其他方面令人满意,并且有多种语言绑定,包括 C++/D/Golang/Ruby/.NET/Node.js/Perl/Perl6/Ruby/Rust 等等。Gitee 原生钩子就使用了 libgit2,Gitee-gitlab 项目使用了 rugged。 JGit 也是有 Shawn Pearce 创建的,目前属于 Eclipse 基金会,运行在 JVM 上,国内腾讯的工峰的 TGit 也是使用的 JGit。 在 Git Rev News 第48期,编辑推荐了 gitbase 通过 SQL 的方式查询 git 存储库,这个工具基于 src-d/go-git,go-git 是纯 Golang 实现的,如果基于 Golang 的项目需要简单的读写存储库,可以使用 go-git。与 libgit2 的 Golang 绑定 git2go 相比,不需要使用 CGO。 当然还有一些其他的 git 实现,大多是实验性的,不建议用于生产环境,比如基于 Rust 的 git-rs。 不同伸缩性的 Git 代码托管平台 基于内置工具搭建 Git 代码托管服务 Git 最初由 Linus Torvalds 开发用来取代 BitKeeper 作为 Linux 内核源码的版本控制工具,所以 Git 一直和 Linux 内核源码托管在同一个服务器上。官方地址是:https://git.kernel.org/。在 git.kernel.org 上,Git 代码托管功能是由 git 内置的工具实现的。用户使用 HTTPS 协议访问 https://git.kernel.org/ 时,Nginx 会以 CGI 的方式将浏览器的请求转发到 GitWeb。GitWeb 是一个使用 Perl 编写的 CGI 程序,为用户提供简单的 git 在线交互图形界面。GitWeb 的源码地址可以在 Github Git 镜像 中查看。GitWeb 界面比较不够精美,相比于 Github 这样的代码托管平台,功能寥寥无几。当用户需要使用 HTTP/HTTPS 协议拉取推送源码时,Nginx 会以 CGI的方式将请求转发给 git-http-backend 处理。git-http-backend 是 Git Over HTTP 的服务端实现。当用户 GIT 协议 (git://) 在 git.kernel.org 上拉取源码是,请求会被 git-daemon 处理。git-daemon 默默的监听 9418 端口,静静的等待 git 客户端的访问。 使用 Git 内置的 GitWeb/git-http-backend/git-daemon,我们能够搭建一个简易的 Git 代码托管服务器,但这里没有 SSH 协议支持。而实现 SSH 协议支持也非常简单,只需要在服务器上运行 sshd (OpenSSH),并允许命令 git-upload-pack/git-receive-pack/git-upload-archive 命令的运行,对于 SSH 协议的验证,我们则可以使用 authorized_keys 机制,将需要允许的用户的 SSH 公钥添加到 authorized_keys 文件。 这种方案通常使用 Gitolite 增强访问控制,Gitolite 主要使用 Perl 编写,这和 GitWeb 一致,ssh 的验证是将 gitolite-shell 添加到 ~/.ssh/authorized_keys 中被 sshd 调用实现的。git.kernenl.org 正是使用 Gitolite 实现 Git Over SSH 访问控制。 https://git.kernel.org/ 网站托管了 Linux 内核源码,驱动,文档等大概有 1000 多个存储库,较大的存储库比如 Linux 内核源码磁盘占用大概是 2GB,因此在理想情况下,一块 2TB 磁盘的服务器便可支撑 https://git.kernel.org/ 这个网站的运行(实际情况则并不是如此,由于 Linux 内核的流行,git.kernel.org 的请求将比较多,对硬件的需求将更高一点)。基于 Git 内置功能搭建的代码托管服务,麻雀虽小五脏俱全,不过回过头来说,这样的代码托管服务功能有限,可伸缩性和扩展性不佳。 小型的 Git 代码托管平台 当用户需要搭建一个几人到几十几百人规模的 Git 代码托管服务,通常有非常多的选择,下面是几个目前仍然比较活跃的小型 Git 代码托管平台。 名称 平台 语言 技术概述 Bonobo Git Server Windows Only C# 基于 .Net Famework 4.6(迁移到 .Net Core 的建议在 2017 年便被提出,但截至目前仍为迁移到 .Net Core)。使用 LibGit2Sharp 操作存储库,但版本较老,不支持 SSH 协议访问。 Gogs Cross Platform Golang 基于 Golang 编写,Web 读写 Git 存储库由 git-module 封装 Git 命令实现,SSH 由 Golang crypto/ssh 提供,支持多种数据库,是一个极简的代码托管平台,可以在 Raspberry Pi 上运行 Gitea Cross Platform Golang 是 Gogs 的开源分叉,Web 读写 Git 存储库使用了 src-d/go-git,使用 gliderlabs/ssh 提供 SSH 接入功能,支持多种数据库,可以在 Raspberry Pi 上运行。 GitBucket Cross Platform Scala/Java 使用 Apache Mina SSHD 实现 SSH 功能。Mina SSHD 还专门针对 JGit 实现了一个 sshd-git 模块,但 GitBucket 是直接使用 JGit 的 transport 相关类。Eclipse JGit 主要由 Google 开发者参与贡献。 除了上述定位为代码托管平台的服务,还有像 Phabricator 这样的 Web 软件也提供 Git 代码托管功能,但 Phabricator 的重点更多是缺陷追踪,代码审核。LLVM https://reviews.llvm.org/ 和 libssh https://bugs.libssh.org/ 就是基于 Phabricator。 云服务级别的 Git 代码托管平台 随着用户规模和存储库规模的增长,达到一定级别后,上述代码托管平台往往变得力不从心,而下面的代码托管平台却深耕于此,能够支撑巨大规模的用户量和存储库数量。 Github 是全球最大的代码托管平台,目前 Github 官方数据显示注册用户数量为 4000万,项目数量为 1亿。Github 网站主要的技术是 Ruby on Rails 内部进程名为 github-unicorn,最近他们将其升级到了 Rails 6.0。Github 使用 Spokes 负责文件系统上存储库的复制,同步和备份。Github 之前使用 libssh 开发 Git SSH 服务器,目前的 SSH 服务器的标识为 babeld-*,但不确定 babeld 是否依然基于 libssh。Git 验证服务为 github-gitauth。Github 的大多数服务都是闭源的,因此分析 Github 的技术内幕通常是 Github 官方的一些技术博客, 当然也可以分析 Github Enterprise 去窥测 Github 内幕。 关于 Github Spokes 的大致原理可以阅读 Introducing DGit 和 Building resilience in Spokes。 在开发 Gitaly 之后, Gitlab 摆脱了 NFS 的禁锢,在平台的伸缩性方面得到了巨大的提升。要知道 Gitlab 使用 Gitaly 的原因可以阅读 The road to Gitaly v1.0。Gitaly 使用 RPC 将存储服务器上的 git 命令包转成前端服务机器上的 git 命令,并为 gitlab 服务提供存储库的读写。 Gitlab 的 SSH 功能仍然由 OpenSSH 提供,而一些静态资源,文件下载,附件等功能则由 Golang 编写的 gitlab-workhorse 实现,gitlab-workhorse 需要与 Gitaly 通信。 Bitbucket 是 Atlassian 开发的代码托管平台,与 Github/Gitlab 不同,Bitbucket 还提供了原生 Mercurial 支持,不过最近,Bitbucket 宣布要逐步关闭 Mercurial 的支持。Atlassian 还开发了 Jira/Sourcetree 这样著名的软件,Bitbucket 源码没有开发,推测主要使用 Java 技术栈(这个从一次 Bitbucket VFSForGit 安装包分析可得)。 Gitee 是目前国内最大的代码托管平台之一,早在 2015 年便开始了分布式改造,并编写了一系列服务实现分布式架构,编写了 Nginx 路由模块实现动态路由,基于 libssh 开发了 Basalt v1 SSH 服务器,基于 Golang 开发了 Basalt v2 SSH 服务器,还开发了 git-srv 智能服务后端,brzox Git HTTP/Archive 服务。以及 git-diamond git 协议内部传输服务等等。Gitee 最初代码基于 Gitlab,几年之间已经与 Gitlab 有了很大的差异,现在 Gitee 已经逐步将一些功能从 gitlab 中剥离,实现云平台的微服务,比如目前的 git/svn/hook 验证服务是基于 Golang 编写的 banjo。Gitee 需要以有限的硬件实现更多的用户接入,所以在服务的设计上更倾向于提供资源使用率,对一些比较容易造成计算资源紧张的服务进行降级。 Git 代码托管平台服务实现 <!--SSH/HTTP/GIT, LFS, GitVFS....--> Git 代码托管平台的基本服务应该包括浏览器接入支持和 git 客户端接入支持,前者需要平台开发网页提供若干服务供用户访问。后者需要支持 git 客户端推拉代码。通过网站访问存储库意味着 HTTP 服务需要通过一定的途径读写存储库,在 GitWeb 中,这通常使用 git 命令实现,比如使用 git tree 查看 tree,使用 git archive 打包文件等等。在 Gogs 中,使用的 git-module 同样使用了命令读写存储库。而 Gogs 的分叉 Gitea 则使用的是 src-d/go-git 读写存储库。实际上我们常常有那种感觉,使用命令行可能会比直接调用 API 慢,并且错误难以处理,这通常是对的。比如我们查看 HEAD 对应的引用,使用命令我们可以运行 git symbolic-ref HEAD,运行这个命令我们需要 fork 出一个进程,fork 成功后马上在子进程中执行 exec git symbolic-ref,为了读取 git symbolic-ref 的输出,我们还需要创建几对 Pipe,并检测 git symbolic-ref 的退出值。而使用 libgit2 API 我们只需要调用 git_repository_open,git_reference_open,git_reference_symbolic_target 即可拿到对应的引用。而对于服务程序而言,fork-exec 的代价可能不小。当然你也可以直接使用 open("/path/to/.git/HEAD") 然后解析 HEAD 对应的引用。GitBucket 使用 JGit 读写存储库,Gitlab 曾经历了 Grit (Grit 部分命令部分 Git 纯 Ruby 实现,Github 曾经使用)。后来的 Rugged,到现在 Gitaly 的纯命令 + Ruby Repository(Gitlab 现在的架构我对其保留意见,至少 IO 复制将增加多次)。Github 目前使用 Rugged 读写存储库,当然一些更多的细节因为没有源码不得而知。Gitee 目前使用 Rugged,但一部分 libgit2 实现不佳的则直接采用 git 命令实现。 实现 Git Over HTTP,Gitlab 最初采用了 Grack, 运行在 unicorn 中的 Grack 并发有限且容易影响 Web 访问(即 Git 请求较多时,Web 拒绝服务),而基于 Golang 开发的 Gogs,Gitea 使用 Golang 原生 HTTP 库编写 Git HTTP Server 功能,这要比 Grack 好要好很多,Golang HTTP 模型能够支撑更多的并发。目前 Gitee 的 Git HTTP Server Brzox 也是使用 Golang 编写。 实现 Git Over SSH,Gitlab 目前依然使用的是 OpenSSH,而不像 Github/BitBucket/Gitee 直接编写 SSH 服务器,直接编写 SSH 服务器可以禁用 SSH 登录,自定义错误消息,简化验证流程,减少数据拷贝。Github 早先是基于 libssh 编写的 SSH Server, 目前不得而知。BitBucket 技术上偏向 Java, 则有可能使用 Apache Mina SSHD, GitBucket 使用 Apache Mina SSHD + JGit 实现 Git Over SSH 功能。而 Gogs/Gitea 在虽然使用 Golang crypto/ssh 编写了 SSH 服务,但在实现时仍然使用了中间命令,这就导致数据拷贝次数的增加,观测 Gogs/Gitea 的各种服务实现,这可能是设计不足的妥协吧。 实现 Git Over TCP (git:// 协议)也非常简单,但 Git 协议并不提供验证机制,Git 代码托管平台提不提供 Git 协议支持也无关紧要,但 Git 协议无需加密,协议简单,作为平台内部传输服务倒是可以,目前 Gitee 使用 C++ Asio 编写 git-diamond 支持内部同步,企业存储库备份等功能。 Git 代码托管平台的伸缩性 <!--存储库分片,分布式文件系统--> 伸缩性是 Git 代码托管能否支撑成千上万用户/存储库的重要指标。像 Gogs/Gitea 这样的代码托管系统尽量认为自身运行在单一服务器上,因此这类 Git 代码托管平台伸缩性非常有限,当然如果使用 NFS/Ceph 这类分布式文件系统能够在单一服务器上支持更多的存储库,但 NFS/Ceph 这种分布式系统的做为 Git 代码托管系统的存储层,除了分布式文件系统带来的性能下降,还会带来内网带宽过高等更多的问题。 我们以使用 NFS 挂载实现伸缩性的平台和 Gitee 分布式模型 git 请求 对比,I/O 细节简化如下: NFS I/O 细节: Gitee Basalt I/O 细节: 计算机是质朴的,流程的增加往往需要更多的计算资源,与 Basalt-GitSrv 相比,NFS 的 I/O 拷贝要多一些,排除 Git 协议影响我们可能会认为 Basalt 的机制要比 NFS 更节省 I/O。如果考虑到 Git 协议的影响,我们应该确信如此,git 推送或者拉取都需要耗费大量的 CPU 计算资源,而在 NFS 模型中,计算全部都是发生在前端服务器,当请求数量较多时,前端服务器则容易出现 CPU 竞争的局面,这将非常影响服务器性能,另外,对于 NFS 这样的文件系统,读写 Git 松散对象都是不得力的。另外,由于 NFS 的缓存机制,负载较高时会出现 master.lock 这样的锁定情况,导致用户使用异常。而对于 Basalt,git 则是在存储服务器上直接操作存储库,打包压缩,解压等对 CPU 需求较高的活动也在存储服务器上,这样意味着,CPU 计算被摊薄到存储服务器上了,另外 basalt-gitsrv 中间传输的是打包后的数据,这与 NFS 读写多个文件相比,网络数据量实际上是下降的。 Gitee 作为国内最早的 Git 代码托管平台之一,最开始使用 NFS 实现伸缩性,随着用户规模增长很快出现了上述所有 NFS 容易遇到的问题,后来尝试切换到 Ceph,git 松散对象给其致命一击,上线便宣告失败,出现了严重的宕机事故,数据被毁,只能从备份恢复。后来迁移到分布式架构后基本稳定运行至今(这种方案基本上增加机器即可,前端负载高加前端,存储满了加存储)。 Github 目前有大约 1亿个项目,我们假设 Github 上存储库大小平均为 10MB,目前 Github 存储库使用三副本机制,大概需要的磁盘容量为 2861 TB,按照硬盘出厂的规则(1000GB=1TB),则是需要最小 3PB。这么大的磁盘容量并不是一个标准服务器能够提供的,按照目前企业级硬盘容量较大的每个 16TB, 则需要硬盘大概 188 块。你能想象到这样大的规模能够简单的运行在分布式文件系统上吗?目前的技术基本上不太现实。 实现 Git 代码托管平台的可伸缩性重要的是实现资源的分片,最开始 Gitee 分布式时使用的是基于用户(namespace)的资源分片,也就是存储库所在的机器与 namespace 所属的机器像匹配,这实际上是一种先入为主的设计,在使用 NFS 挂载的时代,Gitee 的存储库就是按照 namespace 的前两个字母分片存储到不同服务器上,挂载到前端服务器上。因此,基于 namespace 的分片带来了一些问题,比如用户转移存储库可能需要跨机器,fork 存储库也可能需要跨机器,这就无法实现高效的轻量级 fork 功能。从去年开始迁移到基于存储库的分片,基于存储库分片基本上可以解决这些问题,但由于历史原因,轻量级 fork 等功能道阻且长。 资源的分片和请求的路由相伴而生,将存储库存储到不同服务器上后,则需要在这些服务器上实现对应的服务支持前端的请求,而前端也需要实现特定的路由机制,关于 Gitee 的路由机制架构,可以参考相关演讲或者博客。Gitee 存储服务器上使用了 git-srv 作为 Git 传输协议后端服务,而 Github 则使用了 DGit/Spokes,Gitlab 使用了 Gitaly。不同平台的技术各有侧重,比如 Gitlab Gitaly 侧重兼容旧的 OpenSSH,而 Gitee 的 Basalt-GitSrv 针对实际情况优化,与 Gitaly 相比要少一次 I/O 拷贝。 Gitee 目前不足之处是存没有完全剥离 Web(基于早期 Gitlab 发展而来),而 Gitaly 也有 Ruby 代码实现存储库读写(这块代码用 Golang 封装 I/O 多了一次拷贝)。与 Gitee 类似,Gitea 还有另一种方案,即将 Gitea 部署到多个服务器上共用 DB 支持分片,比如 gitea.com 便是这样的平台,但 gitea.com 似乎并不支持 SSH,因此并不能算有效的分片。 前端服务器的扩展性实际上要比存储服务器好,前端服务器的迁移一般不需要像存储服务器那样转移存储库,服务也一般更简单。 存储库分片之后还是无法避免特定存储库请求过多的问题,Github 的解决方案是使用三副本读写分离的 Spokes 机制,这一方案最多能够提供 3倍于单一服务器的并发读取能力,但不支持并发写入存储库。三副本机制需要解决分布式系统常见的一致性问题,引入并发写入可能会带来更多的数据冲突,破坏一致性,因此 Github 完全禁止并发写入存储库副本(即同时有不同的写存储库请求)。Gitlab 没有实现这样的技术,BitBucket 则没有披露相关资讯,Gitee 受限与硬件限制和开发资源限制,也没有实施。 github-dfs: 除了存储库的分片,代码托管平台还需要考虑数据库 SQL/NoSQL 能否支撑大规模并发,数据库的分布式集群是一个比较成熟的方案,而 Redis 最新的版本也支持集群,因此数据库的伸缩性一般不会存在太大问题,增加机器搭建集群即可。选择关系性数据库时还需要考虑许可证,数据库自身的功能等,比如 Gitlab 目前已经放弃对 MySQL 的支持,而是选择了 PostgreSQL,不过 Gitlab 的选择对于其他代码托管平台来说,也只能算作仅作参考。MariaDB 是 MySQL 的分支版本,随着 MySQL 被 Oracle 收购,开源社区渐渐丧失了对 MySQL 的兴趣,虽然 MySQL 8.0 发布已经很久,但采用 MySQL 8.0 的发行版本寥寥无几,很多还停留在 MySQL 5.X,有些发行版还使用 mariadb-connector-c 替代 libmysqlclient 作为数据库连接器,使用 MySQL 的平台很容易迁移到 MariaDB 而不用修改客户端数据库连接代码 ,MariaDB 支持线程池,而 MySQL 仅在企业版中支持线程池。一些 MariaDB 与 MySQL 的对比这里不赘述了。Gogs/Gitea 还支持使用 SQLite,但其使用 SQLite 时,基本上是放弃了伸缩性,不过目前有一个使用 Raft+libuv 实现的分布式 SQLite canonical/dqlite,可以尝试一下。Redis 一般可以作为 Web 缓存或者任务队列的中间件,目前 Redis 虽然支持集群,但就单机 Redis 而言,由于它是单线程的服务,在将内存数据持久化到磁盘是还是可能出现超时,并且单线程服务性能终究有限,在 Github 上,KeyDB 是官方 Redis 的另一个选择,KeyDB 是 Redis 的分支,完全兼容 Redis 协议,KeyDB 支持多线程,有更好的内存效率和高吞吐量。 Git 代码托管平台的增强功能 <!--大存储库,大文件,保护分支,只读目录,安全,两步验证/WebAuthn (https://github.com/duo-labs/webauthn)...--> 除了支持用户通过 Git 协议或者通过网页方式读写远程存储库,代码托管平台一般还需要提供一些与开发相关的功能增强用户体验,这些功能在不同平台之间的对比时显得非常重要。 缺陷追踪 SQLite3 使用 2007 年诞生的版本控制系统 Fossil 托管其源码,与前辈 Git 相比,它集成了 Bug 追踪,Wiki,论坛和技术报告。而对于 Git 来说,这些则需要 Git 代码托管平台自己实现,当然现在无论是 Github/Gitee/Gitlab/BitBucket 还是 Gogs/Gitea 都提供了 Issues这样的机制方便开发者第一时间报告软件缺陷或者提出功能建议。Issues 这样的功能实现主要在于让用户参与其中,也就是用的人多了,才有人气。而 Github 的 Issues 相比其他平台是最活跃的。另外 Github 还提供依赖警报功能(详情可以阅读 Introducing security alerts on GitHub),另外 Github 还收购了 Semmle 代码分析用于连续漏洞检测 (参考:Securing software, together),这也是其他 Git 代码托管平台可以借鉴的功能。 持续集成 在微软收购 Github之后,Github 有了更充足的财力在给用户提供持续集成功能,今年以来 Github 推出了 GitHub Package Registry 和 Github Actions (相关文章:GitHub Actions now supports CI/CD, free for public repositories,Introducing GitHub Package Registry),在推出 Github Actions 之前,开发者在 Github 上大多是通过第三方软件实现 CI/CD 功能,比如我的 M2Team/Privexec 就使用 Appveroy。Windows Terminal 则使用 Azure Pipeline。平台的生态繁荣得益于第三方的支持,而对于其他平台,这些 CI/CD 支持就没有这么大的力度了,这也促使其他代码托管平台的 API 趋向 Github 化,WebHook 也逐步趋同,Github 形成了事实上的标准。比如 Gitee 的 APIv5 就保持了对 Github 的兼容。 保护分支和只读目录 Gitee 很早就实现了类似 SVN 的保护分支功能,而 Github 目前也同样支持保护分支。实现保护分支的途径很很多条,通常通过服务端 Git 钩子实现,我曾写过 《服务端 Git 钩子的妙用》 介绍了如何通过钩子实现保护分支功能。 只读目录功能同样可以通过钩子实现,如果不通过钩子,而是在 git 命令中实现,则要面临修改 git 源码,需要投入大量人力维护的情况。《服务端 Git 钩子的妙用》和 《实现 Git 目录权限控制》对实现目录权限控制有详细介绍。 其他版本控制系统接入 将使用其他版本控制系统的存储库转为 Git 非常简单,git 自身提供了 git svn 命令,可以将远程 svn 存储库一个个版本递归的转变为 Git 存储库,详细的操作可以参考 《Pro Git 2nd Edition》9.2 Git and Other Systems - Migrating to Git,这种方案的缺点比较是比较耗时,Gitee 开发者曾经帮助国内某汽车制造企业将 Subversion 存储库迁移到 Git,一开始使用 git svn,发现耗费时间太长,于是我找到了一个开源工具: git-svn-fast-import,将其编译好并修复特定 BUG 交给相关同事,后来该企业的迁移工作顺利完成。这个工具直接解析存储库将其转换为 git 存储库,省去了网络传输的消耗。 除了支持从其他版本控制系统导入外,一些代码 Git 代码托管平台也支持其他协议接入,Github/Gitee 都支持 Subversion 接入,也就是同一个存储库同时支持 git 客户端和 svn 客户端接入(像 BitBucket 支持 Mercurial 的实现实际上是单独搭建 Mercurial 存储库,不属于此类情况)。实现 Subversion 的接入几个难点,一是 Subversion 各种传输协议细节完全不同,HTTP 基于 WebDAV,而 SVN 协议又是一种自定义的 ABNF 格式协议,如果在考虑支持 Subversion 接入时还需要考虑选择哪种协议,两类协议都支持通常是不现实的,费时费力。二是 Subversion 自身也在不断发展,但实际上在愿意在 Git 代码托管平台使用 svn 的毕竟还是少数,实现 Subversion 接入通常是费力不讨好,投入与产出不成正比。 Github 实现的是 svn HTTP 协议,将 git 存储库的 commit 映射到 svn 的 revs。Github 的实现并不完美,由于需要通过 commit 计算 svn 版本信息,第一次通过 svn 协议访问存储库时会比较慢,如果当存储库较大时,检出还很容易失败,并且一次检出操作可能需要发送的非常多的请求,大概是所有目录所有文件数目之和。 Gitee 使用了 git-as-svn 实现对 svn 的支持,支持的协议有 svn:// 和 svn+ssh://,svn+ssh:// 实际上是 svn:// 协议通过 SSH 隧道传输,在 Gitee 中,当 Basalt 接收到客户端请求在远程服务器上运行 svnserve -t 命令,则会将请求转发到 git-as-svn。在 Gitea 开发者的贡献下,git-as-svn 增加了 svnserve 命令包装,即当 Gitea 接收到 svn+ssh:// 协议请求时,则是启动包装的命令,进行一些列授权后然后在 shell 中与使用命令 exec 3<>/dev/tcp/localhost/3690 与 git-as-svn 通信,Gitee 的设计简化了验证流程,能够支持分布式架构,Gitea 目前还不能做到。git-as-svn 的基于 Java 开发,早期,开发者似乎对 git 的理念研究不够透彻,git-as-svn 的内部实现细节变动非常大,早前的实现机制不太理想,性能不佳。在 Gitee 中,我们为了避免存储库较大时开启 svn 支持带来的性能下降,额外增加了对通过 svn 协议访问存储库的限制,目前是通过 svn 协议访问存储库时,存储库的大小限制为 400MB。 在早期,兼容其他版本控制系统可能是吸引用户的一大法宝,但随着 Git 的越来越流行,支持其他版本控制系统接入逐渐成了鸡肋,前人有言:“食之无肉,弃之可惜”,正是如此。像 Github/Gitee 这样的平台虽然支持 svn,但 svn 访问的还是极少数,而支持 svn 则需要花费一些人力物力,并且在系统架构设计时增加了复杂度。如果现在开发一个 Git 代码托管平台则没有必要支持 svn。Gitee 虽然支持 svn,但 svn 每日的请求数不足 1%,在这 1% 中,又有 50% 以上的请求是特定的用户使用定时命令发送的。 大文件大存储库 公共 Git 代码托管平台很多时候实际上是给用户提供免费服务,为了过多避免大文件大存储库占用平台资源,对其作出限制必不可少,通常是大文件限制 100MB, 存储库限制 1GB. 存储库的检测简单的遍历存储库 objects 目录即可,而大文件的检测则复杂一些。Gitee 最初使用 Grit 检测 commit 是否引入了 blob 原始大小大于限制的文件,但这种机制需要解析 Git 对象,检测容易坍塌(一是检测超时,二是检测逃逸,三是存储库体积膨胀),后开使用原生钩子,改变了检测机制,则避免了这些问题。详细情况可以阅读《服务端 Git 钩子的妙用》。 禁止大文件推送这只是堵,那么大文件应该如何存放呢?Github 推出了 LFS 方案,目前 LFS 功能已经被大多数平台支持,Github 将 LFS 存储到 AWS 上,而 Gitee/Gitlab/Gogs/Gitea 大多使用自建的 LFS 服务器,存储在特定服务器上。 如果一个存储库自身就已经非常大了,如何去解决用户的访问难题呢?比如 Windows 源码超过 300GB,如果用户克隆存储库,按照每秒 1MB/s 的速度,需要 85 小时,这在任何代码托管平台都是不太现实的,好在微软 2017 年发布了 GVFS(现在叫 VFSforGit),在使用 VFSforGit 获取远程存储库时,可以只获得目录结构,并在本地创建占位文件,但用户操作这些占位文件时,VFSforGit 客户端才会去请求服务器下载对应的对象,这大大改善了巨型存储库的操作体验。VFSforGit 本地涉及到的主要技术是 ProjFS,在 Windows 上,VFSforGit 会创建 IO_REPARSE_TAG_PROJFS 类型的 ReparsePoint(NTFS 重解析点),读写到这些重解析点时,ProjFS 驱动会转发到 VFSForGit 客户端下载相应的对象。微软很多开发者在 macOS 上开发,所以官方增加了对 macOS 的支持,而 Github 的 VFSForGit fork 则增加了对 Linux 的支持,不过离实用还有一些时日,Github ProjFS 实现库是 libprojfs。 Git 代码托管平台支持 VFSforGit 客户端比较容易,目前除了 Visual Studio Online,还有 BitBucket 也增加了对 VFSforGit 的支持。我曾用 libgit2 开发了一个 git-vfs-serve 命令,用户访问 brzox 时,brzox 请求 git-srv,git-srv 执行 git-vfs-serve 便可以支持 VFSforGit 客户端的访问,不过并未上线。 安全性增强 Github 最近宣布了支持 WebAuthn: GitHub supports Web Authentication (WebAuthn) for security keys,这种机制可以使用生物识别从而避免输入用户密码,随着信息技术的不断发展,一方面,安全机制不断完善,另一方面,用户面临的风险也会多样化,复杂化。代码托管平台管理了开发者的核心资产,因此在安全上绝不能掉以轻心。当然需要做的不仅仅是及时跟进新的安全机制,还需要对整个系统及时进行安全升级,淘汰旧的协议(比如 SSL3/TLS1.1),旧的加密,哈希算法(DSA,MD5/SHA1),及时采用新的协议(TLS1.3),新的加密,哈希算法(ED25519,SHA3)等等。 文件服务 <!--附件下载,发布文件,Archive 下载--> 一个优秀的 Git 代码托管平台,应该在软件的开发整个周期都给用户提供帮助,比如下载源码,软件发布。源码下载主要指 Archive 功能,软件的发布则需要平台提供 Release/附件下载功能。 Archive 我们知道 git-archive 命令可以将存储库特定的 commit/branch 打包成一个 zip/tar 文件,而在 Git Over SSH(Git Over TCP) 实现中,只要我们允许 git-upload-archive 命令在远程服务器上运行,就打包远程服务器上的存储库的特定分支。但由于 git-upload-archive 与 git-upload-pack/git-receive-pack 存在一些不同,是的 HTTP 协议无法实现 archive 协商。提供 archive 下载则需要另辟蹊径。 我们在远程服务器上运行 git-archive 将其输出作为响应体的内容返回给 HTTP Client 便可实现 archive 下载功能,由于 archive 下载实际上是将 git tree/blob 遍历然后写入到归档文件后压缩(tar.gz/tar.bz2 ...)或者是压缩后写入文件(zip),二者都非常消耗 CPU 资源,因此我们在实现 archive 下载功能的同时应该设计 archive 的缓存功能(当然缓存应该支持过期)。gitlab-workhorse 实现的 archive 下载功能便是先尝试命中缓存,如果没有缓存则调用 git 命令然后生成写入到缓存文件。Gitee 最近实现的 blaze-archive 也采用了类似的机制,但 blaze-archive 是一个独立的命令,这个命令实际上是被 git-srv 调用,brzox 与 git-srv 通信,brzox 将 archive 返回给 HTTP Client,而缓存的删除则是 blaze 负责的。 附件,Release 附件,Release 可以选择云方案,如果要将附件和 LFS 统一管理,实际上国内的阿里云,腾讯云之类的并不合适,这些平台对并不支持类似 AWS x-amz-content-sha256 这样的头部,而是 Content-MD5 因此这些云平台要支持 LFS 则要花费多一些功夫。选择国外的 AWS, Azure 则需要考虑经济,网络等问题。当然无论如何使用云平台都需要考虑经济问题。 平台自建附件,Release 功能可以使用分布式文件系统,如 FastDFS, 但 FastFDS 并不是一个好的选择,历史比较久,存储机制安全机制现在来说都不是很优秀。有个更好的选择是 Minio, minio 使用 Golang 开发,支持 AWS API。许可协议是 Apache 2.0,商用没有阻碍,因此是用来搭建附件,Release 以及 LFS 存储服务器的不二选择。 Git 的未来 Git 虽然是当前最受欢迎的代码托管系统,但 Git 也面临了一些难题,一类是如何支持大文件大存储库,这些问题有 Git LFS, VFSforGit 这样的第三方解决方案,也有微软,Google 开发者参与的官方 Partial Clone,部分克隆需要 Wire 协议支持,离可用还为时尚早。 2017年2月,Google 开发者宣布攻破 SHA1,这曾经给一些 git 用户带来了担忧,因为 git 使用 SHA1 计算对象 ID,但 git 使用的实际上是一种特殊的 SHA1,将对象类型对象长度以及对象内容合并在一起计算 SHA1,由于有长度校验,这使得 SHA1 的冲突可能被降低了,但无论如何,SHA1 也不再是安全的,Git 在源码中增加了 sha1collisiondetection 来避免 SHA1 冲突,并且增加了计划迁移到 SHA-256,并且将一些涉及到 Hash 的代码从单一的 SHA1 转变成 object_id。 关于 Hash 转换,可以查看文档 Git hash function transition。 Git 从 SHA1 迁移到 SHA-256 困难重重,从首次增加文档距今已经有两年时间,而 SHA-256 的实现还不见全貌。与 Hash 迁移相比,压缩算法的演进不重要更难实施,时至今日,zlib 压缩已经不再优秀,但 Git 可能还要负重前行。 道路漫漫 软件开发一直是一个飞速变化的领域,而代码托管也要不断面临新的挑战,道路漫漫,吾辈不休。

优秀的个人博客,低调大师

高速公路视图大数据处理应用探讨

近年来,随着高速公路通车里程的迅猛增长和车流量的快速增加,高速公路运营管理中暴露的新情况、新问题也逐年增多,特别是逃漏通行费问题,给正常运营秩序带来较大的冲击。为了解决偷逃漏费、路径识别等业务需求,其中在高速公路收费卡口逐步进行了监控高清化与智能化改造。在视图智能化处理方面将面临以下几个问题: 如何建立一个安全、实时、有效、智能化的视图大数据系统处理系统,利用车辆视图"多特征识别"真正满足高速公路偷逃漏费稽查工作高时效、高正确率要求; 如何建设一个适合高速公路场景高性能计算平台,实现大规模数据的云存储、云计算,满足数据实时查询,同时满足海量数据离线分析,实现更多的预测,统计和稽查等业务。 如何保证收费站的收费数据实时性、收费高清图像传输的可靠性,以及高业务量将引起存储容量,网络带宽,并发处理能力的高要求。 在现代的高速公路建设上,充分利用收费站、交通路段和重要场所的视频结构化信息,获得高速公路收费与稽查视图大数据处理解决方案,从而使得高速公路运行更加安全畅通,有效打击高速公路偷逃漏费现象。 一、高速视图大数据处理 针对高速公路监控视频提供车辆"多特征识别"结构化处理。通过对收费站出入卡扣收费视频图像数据的有效结构化处理,提供收费车辆特征描述,用以辅助高速公路收费人员进行实时在线偷逃漏费稽查工作。 图-1高速公路收费系统图片大数据处理系统 图-1高速公路收费系统图片大数据处理系统。在功能模块中,包含收费出入口收费高清图片大数据处理,采用先进的深度学习、高性能运算及大数据技术,集视频结构化分析、数据存储、数据应用于一体的高性能、高密度计算设备,支持高并发能力、分析识别准、运算速度快、检索效率高等能力。在图片处理模块中,力求解决高速公路等目标的异常行为检测和快速检索,以实现收费稽查等多种应用,提高收费准确性。主要功能包括目标检测、跟踪、分类、车辆特征识别、以图搜图和实时报警等。在信源输入部分,支持实时的收费出入口图像数据,路段视频监控数据,同时还支持移动路政输入数据。亦可进行视综数据处理,收费系统历史视图等进行处理。进行离线的图像处理,用以更多的离线分析业务。 图-2高速公路视图大数据处理智能应用 图-2高速公路视图大数据处理智能应用中涵盖了车辆特征提、实时预览、智能检索和以图搜图等模块。其中在车辆特征提取中包含抓拍车辆的车型、车款、车身颜色、车牌、年检标、遮阳板、纸巾盒、挂件、摆件、安全带等细分特征。智能检索部分包含对车辆任意特征值进行快速搜索,得以快速定位车辆的入口站点等,同时支持多种特征和条件的组合检索。以图搜图支持通过车辆图片框选快速搜索同一车辆的入口信息等功能。所有智能应用满足高速公路收费系统快速稽查,并有效打击偷逃漏费的现象。 二、高速公路视图大数据处理云平台建设 为建设一个适合高速公路场景高性能计算平台,实现收费与监控系统视图大规模数据的云存储、云计算。考虑到目前收费业务功能集中由省收费中心承担,必然带来省中心业务数据存储容量、网络带宽、应用并发能力严重不足的问题。鉴于以上问题,高速公路收费视图大数据处理需要利用各个区域收费中心承担省中心部分职能,分担省中心的计算、储存、网络带宽及应用高并发处理能力处理。采用省中心为主,其他区域分中心协同的分布式云数据中心架构构建高速收费视图大数据处理平台。对现有业务系统的进一步云化整合。 图-3高速公路视图大数据处理云平台部署方案 省中心,各个区域分中心部署视图大数据处理业务系统。各个数据中心部署云计算平台,大数据分析平台和大数据存储平台。满足视图大数据处理的业务需求。 多数据中心统一管理 提供针对省中心,区域分中心多数据中心的统一的运维、运营管理能力。融合资源池的管理系统可以集中管理和监控各个数据中心的计算、存储、网络资源和使用情况,提供统一的资源管理、跨DC资源部署、运维管理、服务管理和自助服务等能力。 融合的基础架构 从一个统一的云管理平台下发业务到不同的资源池,支持快速的业务下发,支持不同虚拟化平台,从而将异构的计算资源池,异构的存储资源池作为服务提供,提供资源的共享和灵活分配,提供统一的分权分域管理。 快捷的应用管理 通过虚机模板、应用模板,以及用户自定义编排等能力,提供应用快速、自动化部署的能力。 分布式高速公路视图大数据处理云平台建设以及对现有业务系统的进一步云化整合,可以带来如下价值: 收费视图大数据处理系统将有效打击高速公路偷逃漏费行为,并且每年将挽回损失几个亿。同时积累下来的大数据会对后续的高速公路运营服务和管理提供帮助。 精简IT资源,降低运维成本,利用云数据中心统一资源管理,统一的运维管理平台,降低维护维护成本,从降成本中贡献净利润 云数据中心一次规划,多次(按需)部署,降低规划难度,规避投资风险,柔性十足,便利的扩减容机制,可随时调整以匹配业务或IT的变化等。 通过云计算HA、FT、热迁移功能,能够有效减少设备故障时间,确保收费等核心业务的连续性,避免传统IT,单点故障导致的业务不可用。 综上所述,借助大数据云计算及视图分析技术,将以其视图智能化、运维管理自动化,IT资源弹性调度,快速部署以及优异的扩展性等优势,将为高速公路收费稽查发展夯实基础。 本文作者:佚名 来源:51CTO

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册